
Programma
Sviluppare applicazioni AI
21 ore
QwQ-32B è il modello di ragionamento di Qwen, progettato per eccellere nella risoluzione di problemi complessi e nei compiti di ragionamento. Nonostante abbia solo 32 miliardi di parametri, il modello raggiunge prestazioni paragonabili al ben più grande DeepSeek-R1, che conta 671 miliardi di parametri.
In questo tutorial ti guiderò nella configurazione ed esecuzione di QwQ-32B in locale usando Ollama, uno strumento che semplifica l’inferenza LLM in locale. Questa guida include:
Nonostante le dimensioni, QwQ-32B può essere quantizzato per funzionare in modo efficiente su hardware consumer. Eseguire QwQ-32B in locale ti dà il pieno controllo sull’esecuzione del modello senza dipendere da server esterni. Ecco alcuni vantaggi dell’esecuzione in locale di QwQ-32B:
Ollama semplifica l’esecuzione di LLM in locale gestendo download, quantizzazione ed esecuzione dei modelli.
Scarica e installa Ollama dal sito ufficiale.
Una volta completato il download, installa l’applicazione Ollama come faresti con qualsiasi altra applicazione.
Mettiamo alla prova la configurazione e scarichiamo il modello. Avvia il terminale e digita il seguente comando per scaricare ed eseguire il modello QwQ-32B:
ollama run qwq:32b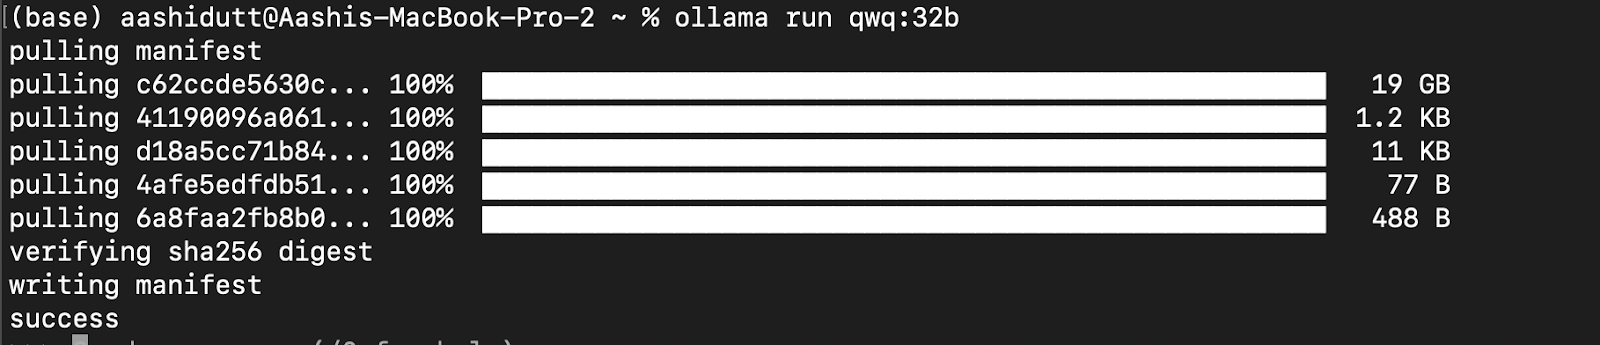
QwQ-32B è un modello di grandi dimensioni. Se il tuo sistema ha risorse limitate, puoi optare per versioni quantizzate più piccole. Ad esempio, sotto utilizziamo la versione Q4_K_M, un modello da 19,85 GB che bilancia prestazioni e dimensioni:
ollama run qwq:Q4_K_M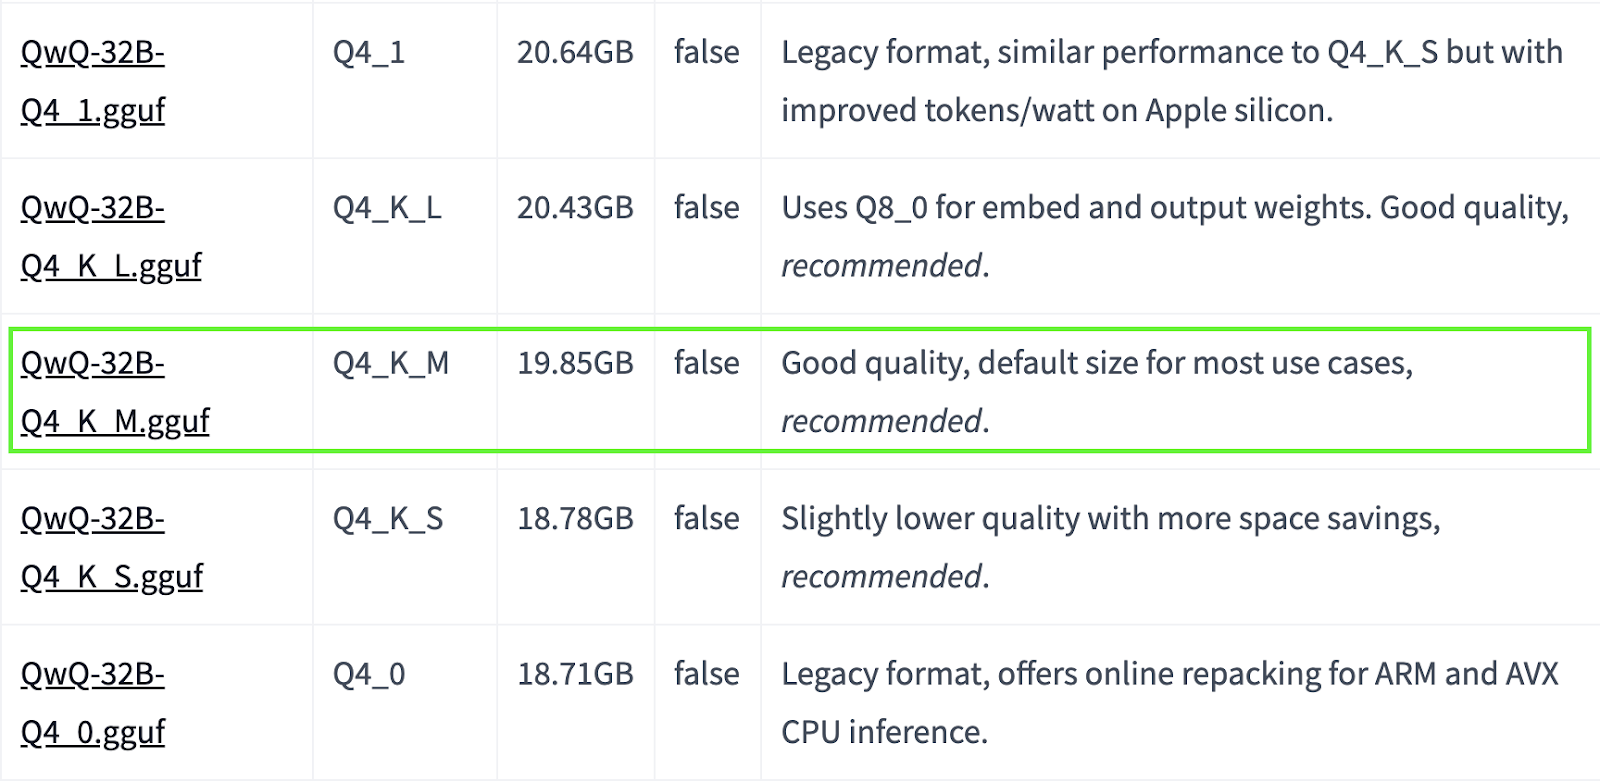
Fonte: Hugging Face
Puoi trovare altri modelli quantizzati qui.
Per eseguire QwQ-32B in modo continuo e servirlo tramite un’API, avvia il server Ollama:
ollama serveIn questo modo il modello sarà disponibile per le applicazioni, come descritto nella prossima sezione.
Ora che QwQ-32B è configurato, vediamo come interagirci.
Una volta scaricato il modello, puoi interagire con QwQ-32B direttamente dal terminale:
ollama run qwq
How many r's are in the word "strawberry”?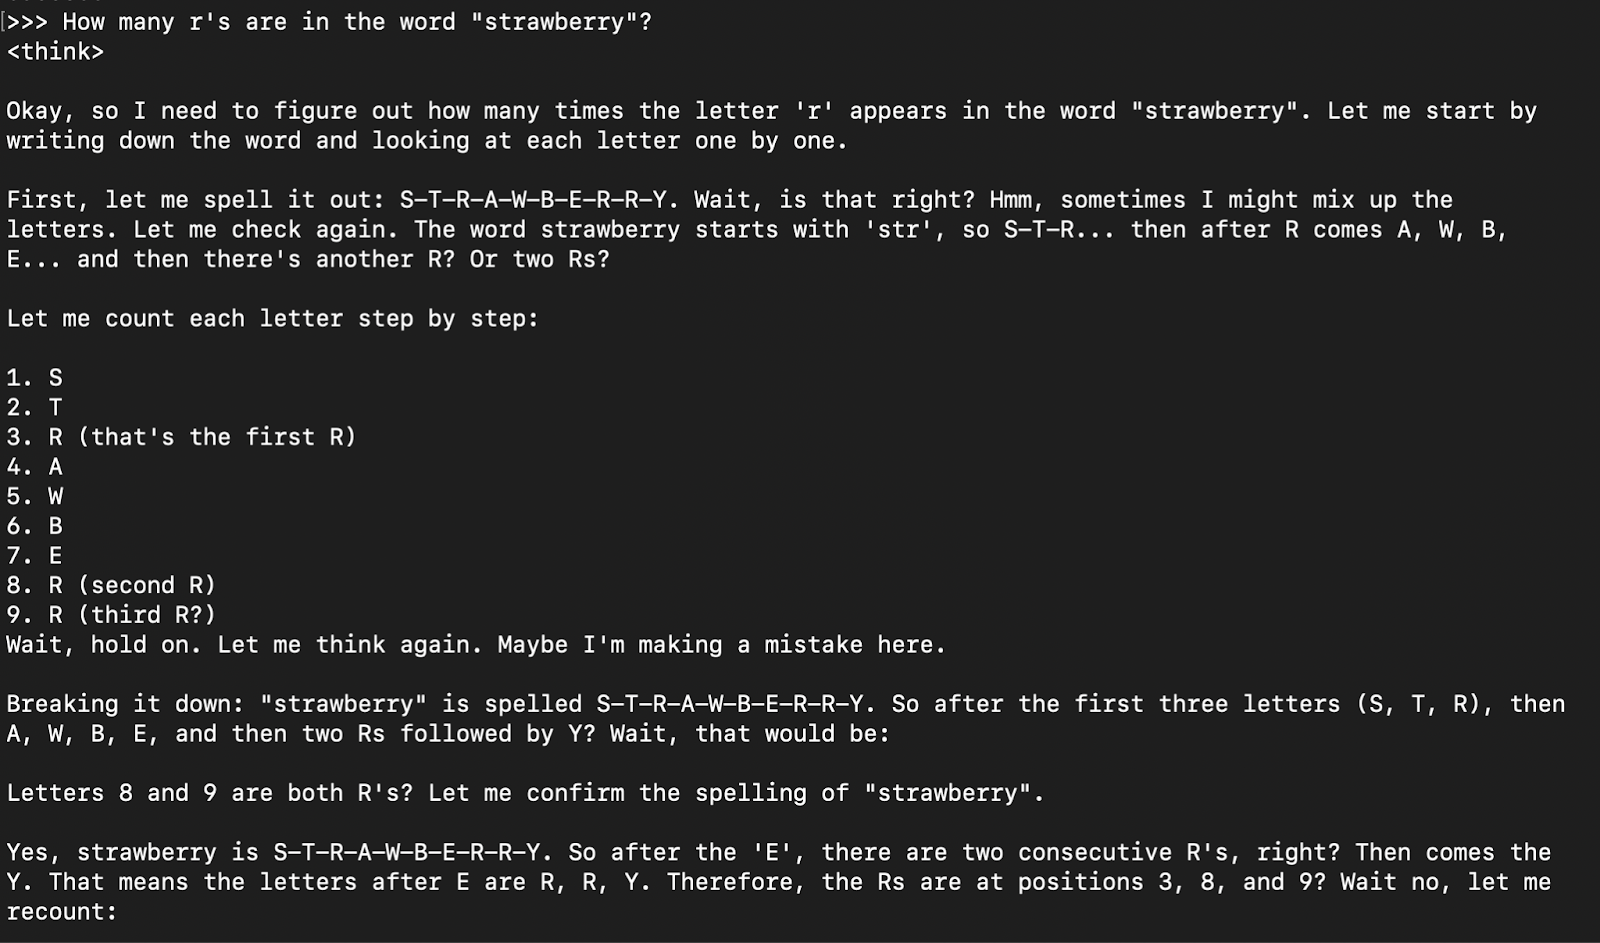
La risposta del modello include generalmente il suo ragionamento (racchiuso nei tag <think> </think>) seguito dalla risposta finale.
Per integrare QwQ-32B nelle applicazioni, puoi usare l’API di Ollama con curl. Esegui il seguente comando curl nel terminale.
curl -X POST http://localhost:11434/api/chat -H "Content-Type: application/json" -d '{
  "model": "qwq",
  "messages": [{"role": "user", "content": "Explain Newton second law of motion"}],
  "stream": false
}'
curl è uno strumento da riga di comando nativo di Linux ma funziona anche su macOS. Consente di effettuare richieste HTTP direttamente dal terminale, risultando ottimo per interagire con le API.
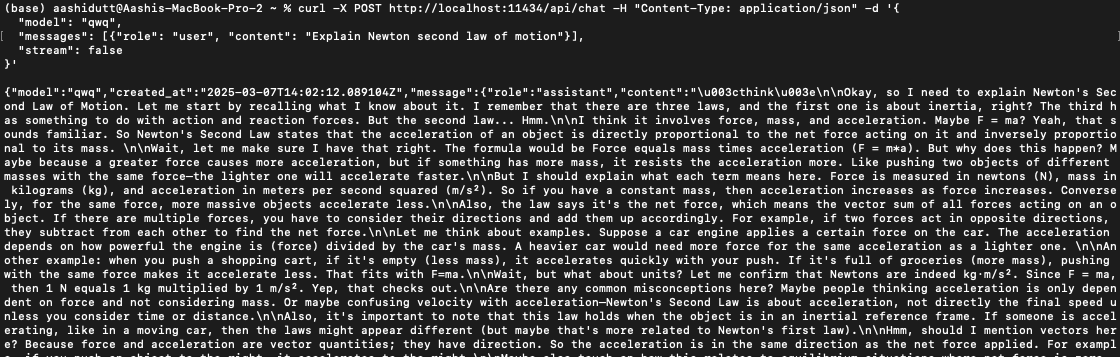
Nota: assicurati di posizionare correttamente le virgolette e di selezionare la porta localhost corretta per evitare errori dquote.
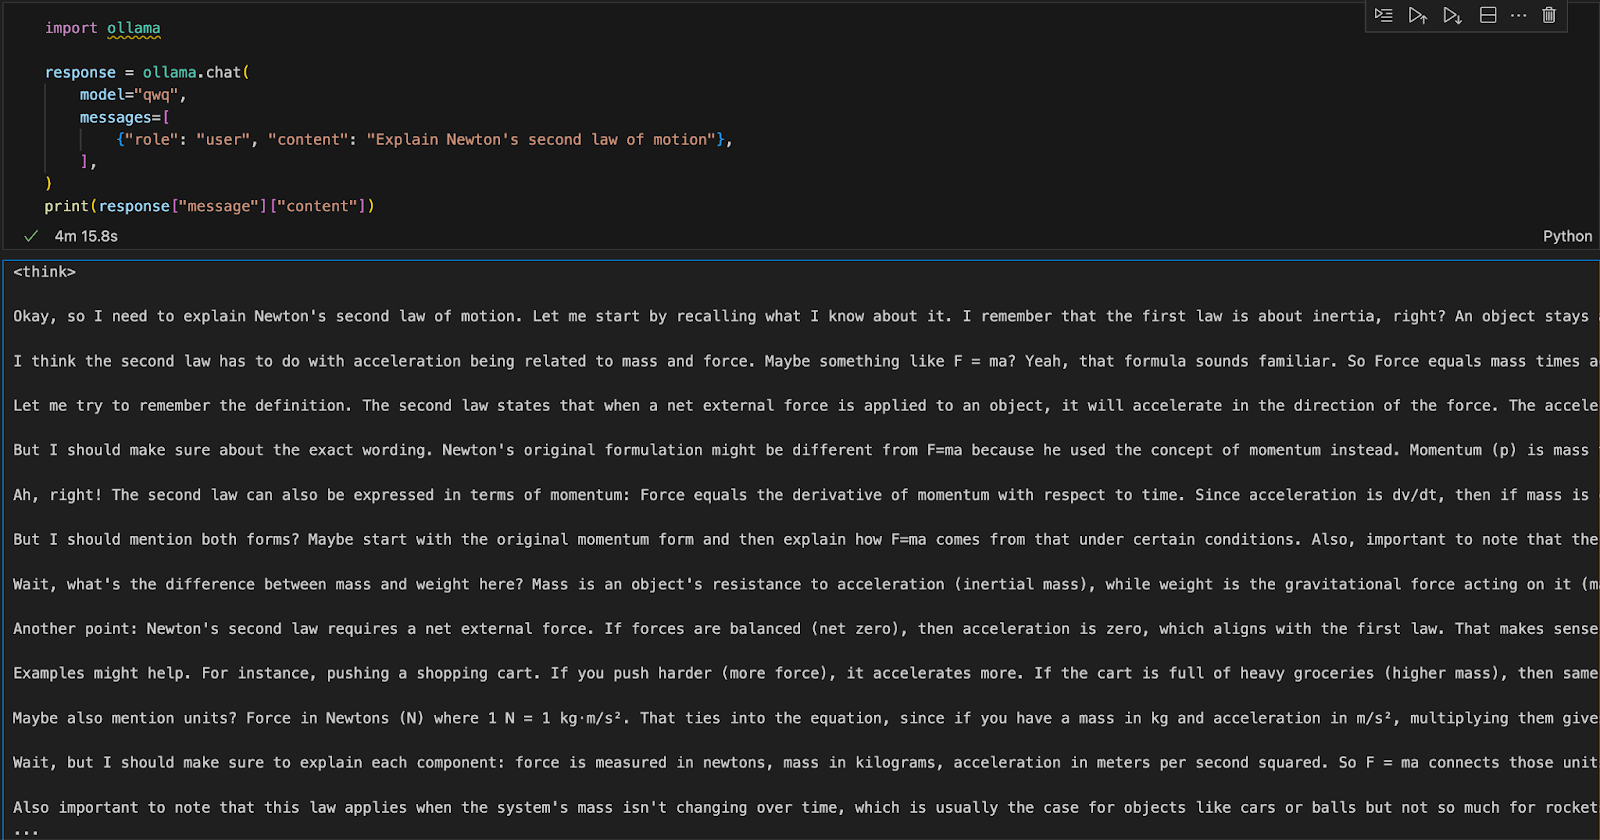
Possiamo eseguire Ollama in qualsiasi ambiente di sviluppo integrato (IDE). Puoi installare il pacchetto Python di Ollama con il seguente comando:
pip install ollamaUna volta installato Ollama, usa lo script seguente per interagire con il modello:
import ollama
response = ollama.chat(
    model="qwq",
    messages=[
        {"role": "user", "content": "Explain Newton's second law of motion"},
    ],
)
print(response["message"]["content"])
La funzione ollama.chat() accetta il nome del modello e un prompt dell’utente, elaborandolo come uno scambio conversazionale. Lo script quindi estrae e stampa la risposta del modello.
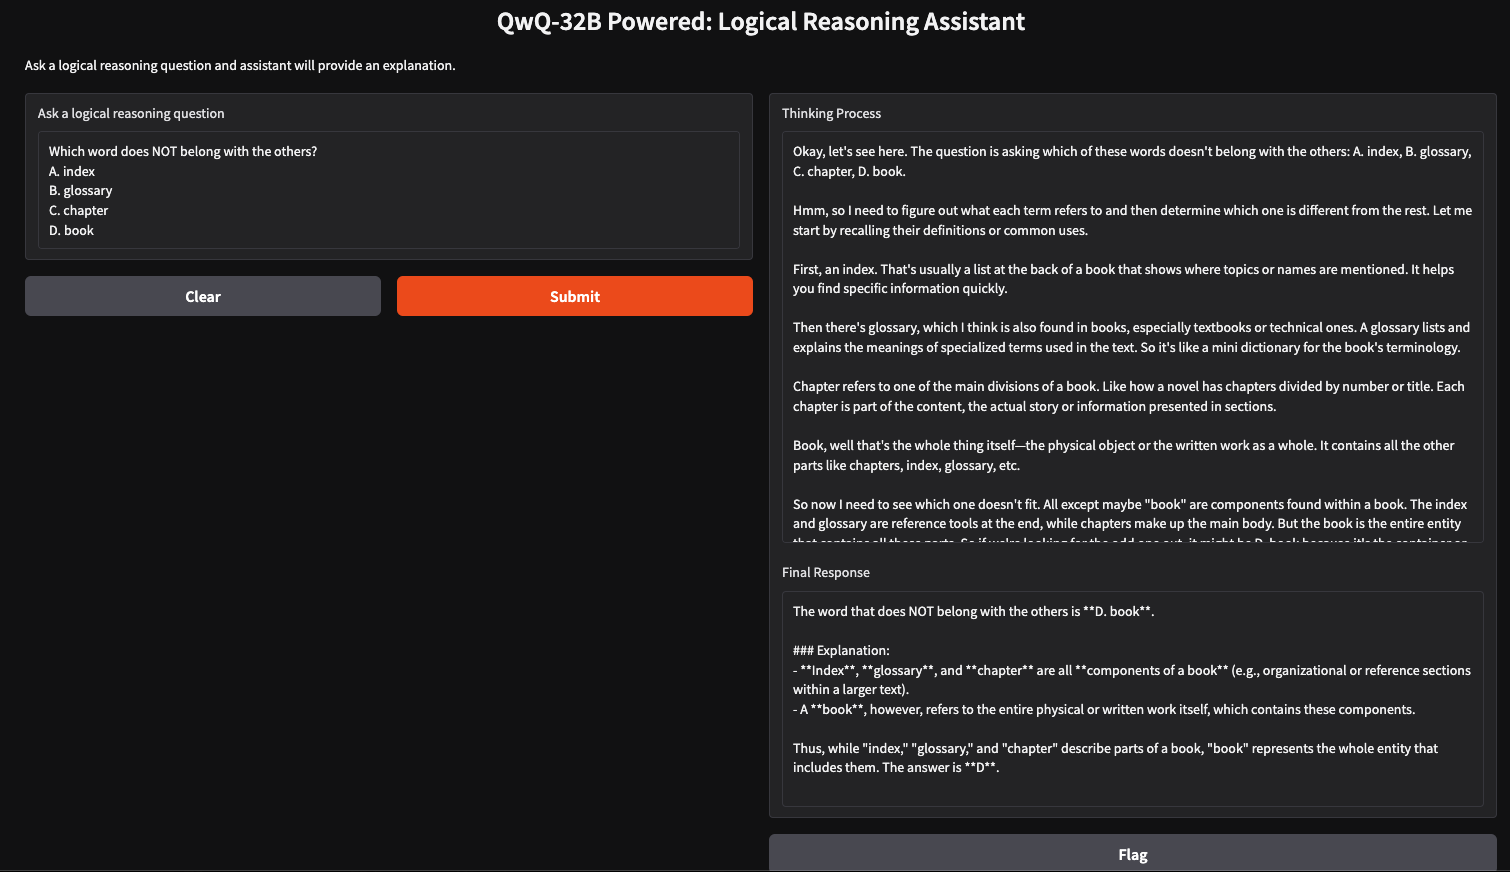
Possiamo creare un semplice assistente al ragionamento logico usando QwQ-32B e Gradio, che accetta domande inserite dall’utente e genera risposte strutturate e logiche. Questa applicazione utilizzerà l’approccio di pensiero passo-passo di QwQ-32B per fornire risposte chiare e ben motivate, risultando utile per problem solving, tutoring e decision-making assistito dall’AI.
Prima di passare all’implementazione, assicuriamoci di avere installati i seguenti strumenti e librerie:
Esegui i seguenti comandi per installare le dipendenze necessarie:
pip install gradio ollamaUna volta installate le dipendenze, esegui i seguenti import:
import gradio as gr
import ollama
import reOra che abbiamo le dipendenze al loro posto, costruiremo una funzione di query per passare la nostra domanda al modello e ottenere una risposta strutturata.
def query_qwq(question):
    response = ollama.chat(
        model="qwq",
        messages=[{"role": "user", "content": question}]
    )
    full_response = response["message"]["content"]
    # Extract the <think> part and the final answer
    think_match = re.search(r"<think>(.*?)</think>", full_response, re.DOTALL)
    think_text = think_match.group(1).strip() if think_match else "Thinking process not explicitly provided."
    final_response = re.sub(r"<think>.*?</think>", "", full_response, flags=re.DOTALL).strip()
    return think_text, final_response
La funzione query_qwq() interagisce con il modello Qwen QwQ-32B tramite Ollama, inviando una domanda fornita dall’utente e ricevendo una risposta strutturata. Estrae due componenti chiave:
In questo modo si separano i passaggi di ragionamento e la risposta finale, garantendo trasparenza su come il modello arriva alle sue conclusioni.
Ora che abbiamo impostato la funzione principale, costruiremo la UI con Gradio.
interface = gr.Interface(
    fn=query_qwq,
    inputs=gr.Textbox(label="Ask a logical reasoning question"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Final Response")],
    title="QwQ-32B Powered: Logical Reasoning Assistant",
    description="Ask a logical reasoning question and the assistant will provide an explanation."
)
interface.launch(debug = True)
Questa interfaccia Gradio imposta un assistente al ragionamento logico che riceve una domanda tramite la funzione gr.Textbox() e la elabora usando la funzione query_qwq(). Infine, la funzione interface.launch() avvia l’app Gradio con il debug attivato, consentendo il tracciamento in tempo reale degli errori e i log per la risoluzione dei problemi.
Eseguire QwQ-32B in locale con Ollama consente un’inferenza del modello privata, veloce ed economica. Con questo tutorial puoi esplorarne in tempo reale le avanzate capacità di ragionamento. Il modello è adatto ad applicazioni come tutoring assistito dall’AI, problem solving basato sulla logica e altro ancora.
Impara l'AI con questi corsi!
Programma
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



