
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
एआई अनुप्रयोग विकसित करना
{hours} घंटा
QwQ-32B Qwen का रीजनिंग मॉडल है, जिसे जटिल समस्या-समाधान और तर्क-आधारित कार्यों में उत्कृष्ट प्रदर्शन के लिए डिज़ाइन किया गया है। केवल 32 बिलियन पैरामीटर्स होने के बावजूद, यह मॉडल कहीं बड़े DeepSeek-R1 (671 बिलियन पैरामीटर्स) के तुलनीय प्रदर्शन हासिल करता है।
इस ट्यूटोरियल में, मैं आपको Ollama का उपयोग करके QwQ-32B को लोकली सेट अप और रन करने की प्रक्रिया बताऊँगा—यह एक ऐसा टूल है जो लोकल LLM इन्फ़रेंस को सरल बनाता है। इस गाइड में शामिल है:
इसके आकार के बावजूद, QwQ-32B को क्वांटाइज़ किया जा सकता है ताकि यह कंज़्यूमर हार्डवेयर पर कुशलता से चले। QwQ-32B को लोकली चलाने से आपको बाहरी सर्वरों पर निर्भर हुए बिना मॉडल निष्पादन पर पूरा नियंत्रण मिलता है। लोकली चलाने के कुछ लाभ इस प्रकार हैं:
Ollama मॉडल डाउनलोड, क्वांटाइज़ेशन और निष्पादन संभालकर लोकली LLMs चलाना सरल बनाता है।
Ollama को आधिकारिक वेबसाइट से डाउनलोड और इंस्टॉल करें।
डाउनलोड पूरा होने के बाद, Ollama एप्लिकेशन को वैसे ही इंस्टॉल करें जैसे आप किसी अन्य एप्लिकेशन को करते हैं।
अब सेटअप का परीक्षण करते हैं और अपना मॉडल डाउनलोड करते हैं। टर्मिनल लॉन्च करें और QwQ-32B मॉडल डाउनलोड और रन करने के लिए निम्न कमांड टाइप करें:
ollama run qwq:32b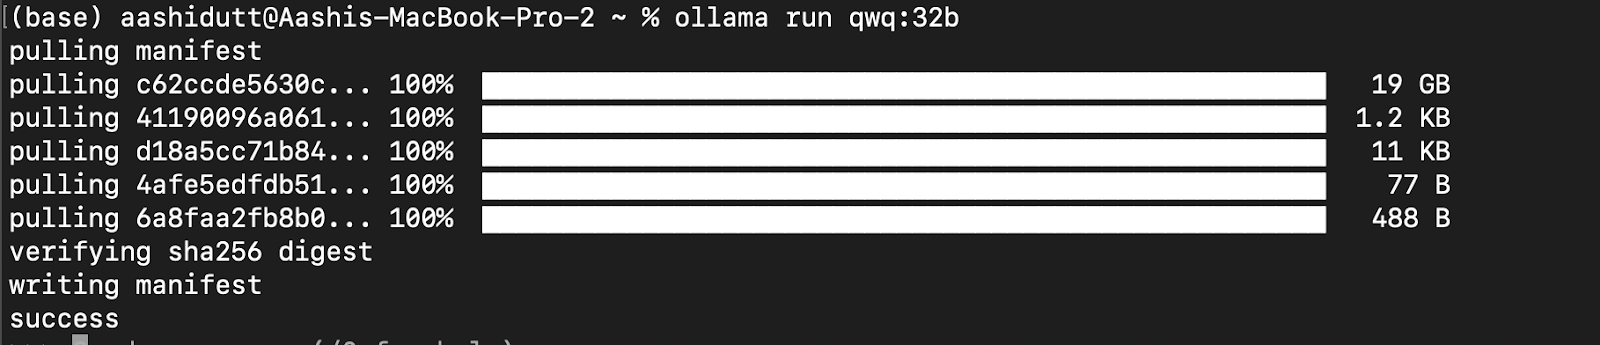
QwQ-32B एक बड़ा मॉडल है। यदि आपके सिस्टम में संसाधन सीमित हैं, तो आप छोटे क्वांटाइज़्ड वर्ज़न्स चुन सकते हैं। उदाहरण के लिए, नीचे हम Q4_K_M वर्ज़न का उपयोग करते हैं, जो 19.85GB का मॉडल है और प्रदर्शन तथा आकार के बीच संतुलन बनाता है:
ollama run qwq:Q4_K_M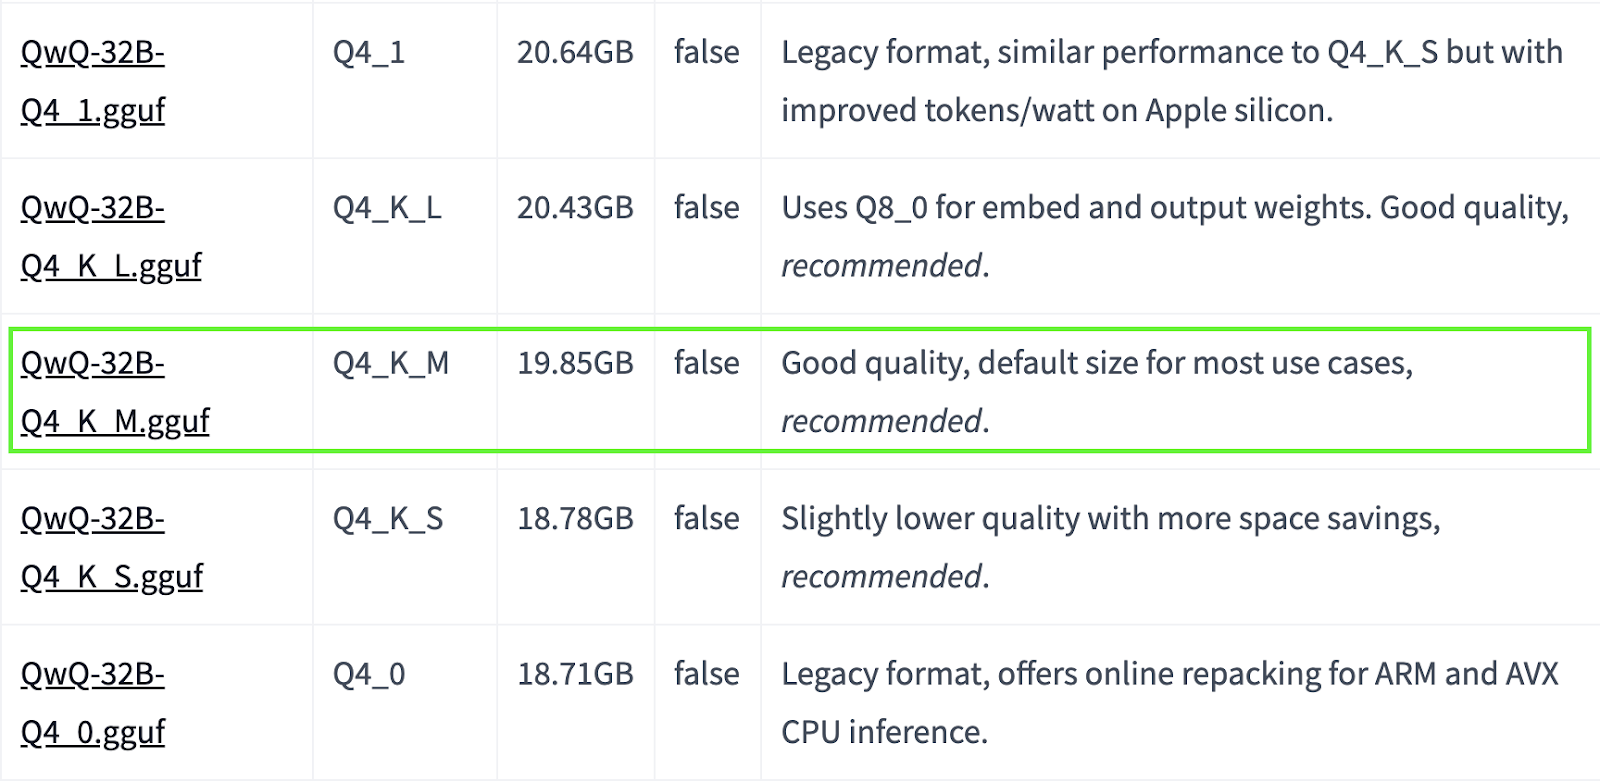
स्रोत: Hugging Face
और क्वांटाइज़्ड मॉडल आपको यहाँ मिल सकते हैं।
QwQ-32B को निरंतर चलाने और API के माध्यम से सर्व करने के लिए, Ollama सर्वर शुरू करें:
ollama serveइससे मॉडल ऐप्लिकेशंस के लिए उपलब्ध हो जाएगा, जिन पर अगला सेक्शन चर्चा करता है।
अब जब QwQ-32B सेट अप हो गया है, तो देखते हैं इससे कैसे इंटरैक्ट करें।
मॉडल डाउनलोड हो जाने के बाद, आप सीधे टर्मिनल में QwQ-32B मॉडल से इंटरैक्ट कर सकते हैं:
ollama run qwq
How many r's are in the word "strawberry”?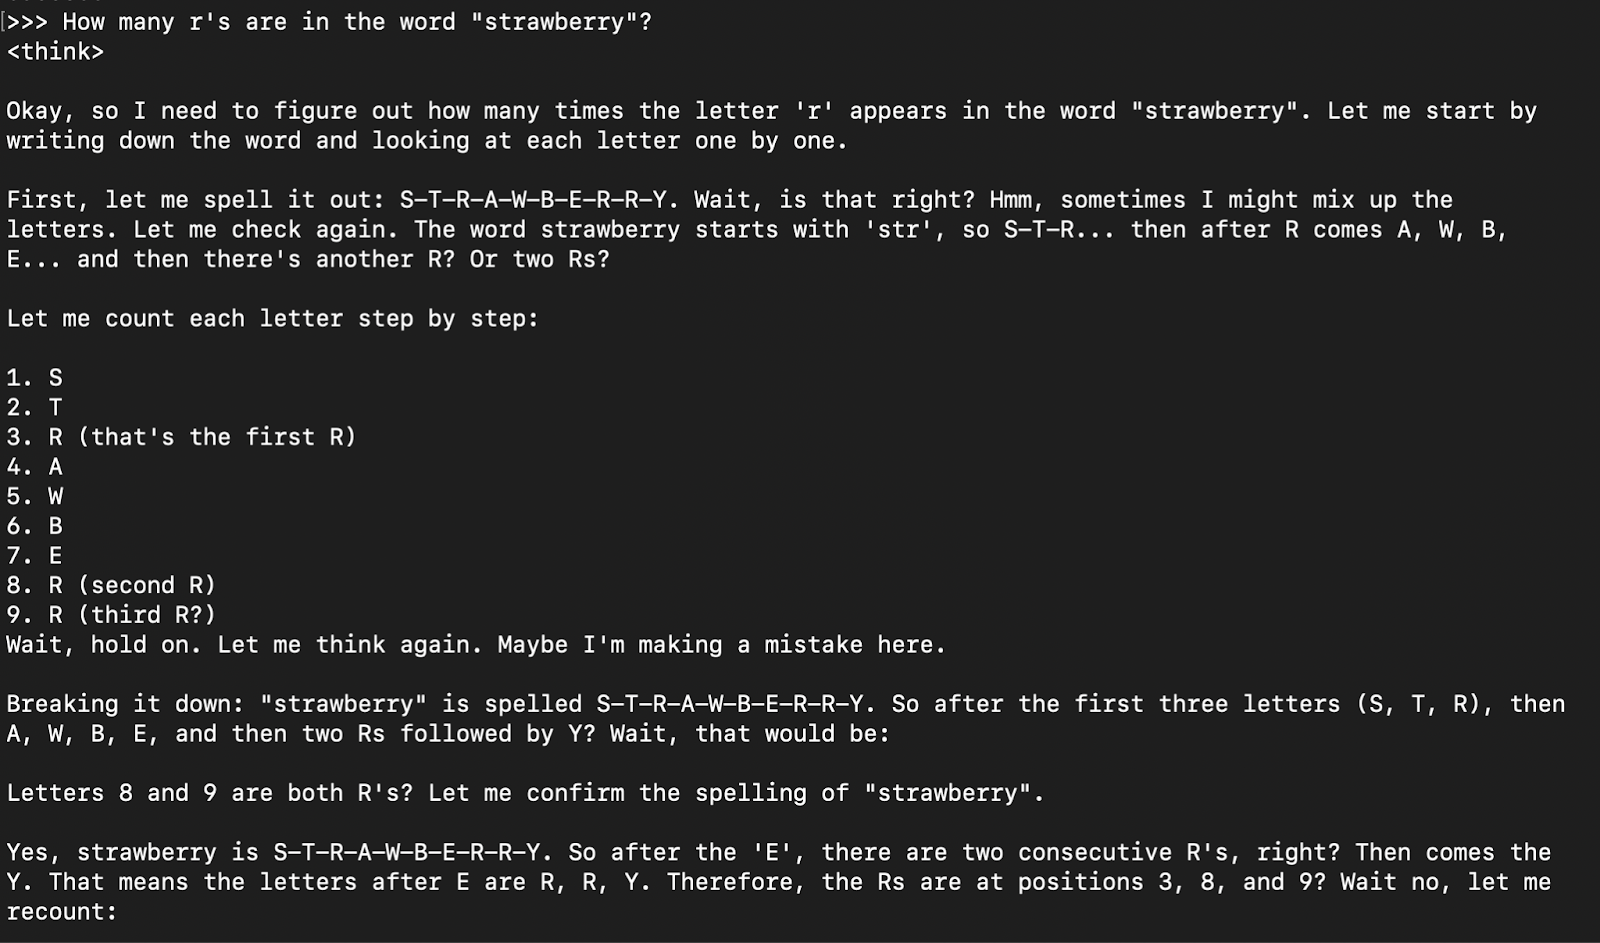
मॉडल की प्रतिक्रिया प्रायः उसका सोचने का उत्तर होती है (जिसे <think> </think> टैब्स में समाहित किया जाता है) और उसके बाद अंतिम उत्तर आता है।
एप्लिकेशंस में QwQ-32B को इंटिग्रेट करने के लिए, आप curl के साथ Ollama API का उपयोग कर सकते हैं। अपने टर्मिनल में नीचे दिया गया curl कमांड चलाएँ।
curl -X POST http://localhost:11434/api/chat -H "Content-Type: application/json" -d '{
  "model": "qwq",
  "messages": [{"role": "user", "content": "Explain Newton second law of motion"}],
  "stream": false
}'
curl एक कमांड-लाइन टूल है जो Linux में नेटिव है और macOS पर भी काम करता है। यह उपयोगकर्ताओं को सीधे टर्मिनल से HTTP अनुरोध भेजने देता है, जिससे APIs के साथ इंटरैक्ट करना सुविधाजनक हो जाता है।
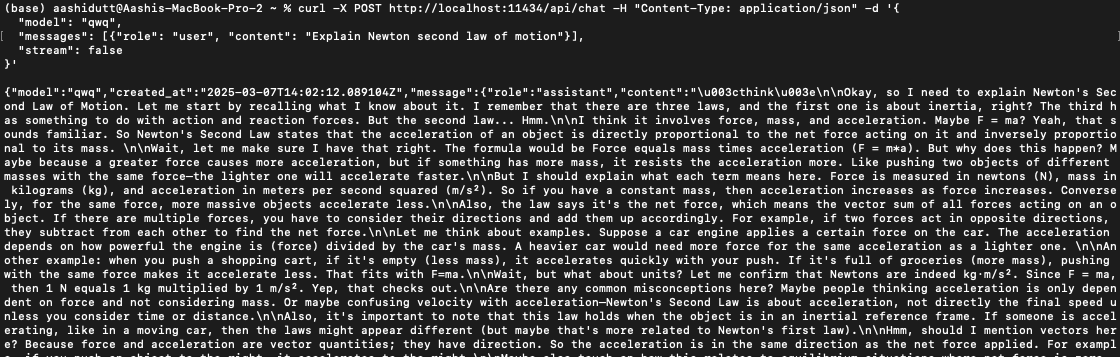
नोट: dquote त्रुटियों से बचने के लिए उद्धरण चिह्नों का सही उपयोग करें और सही localhost पोर्ट चुनें।
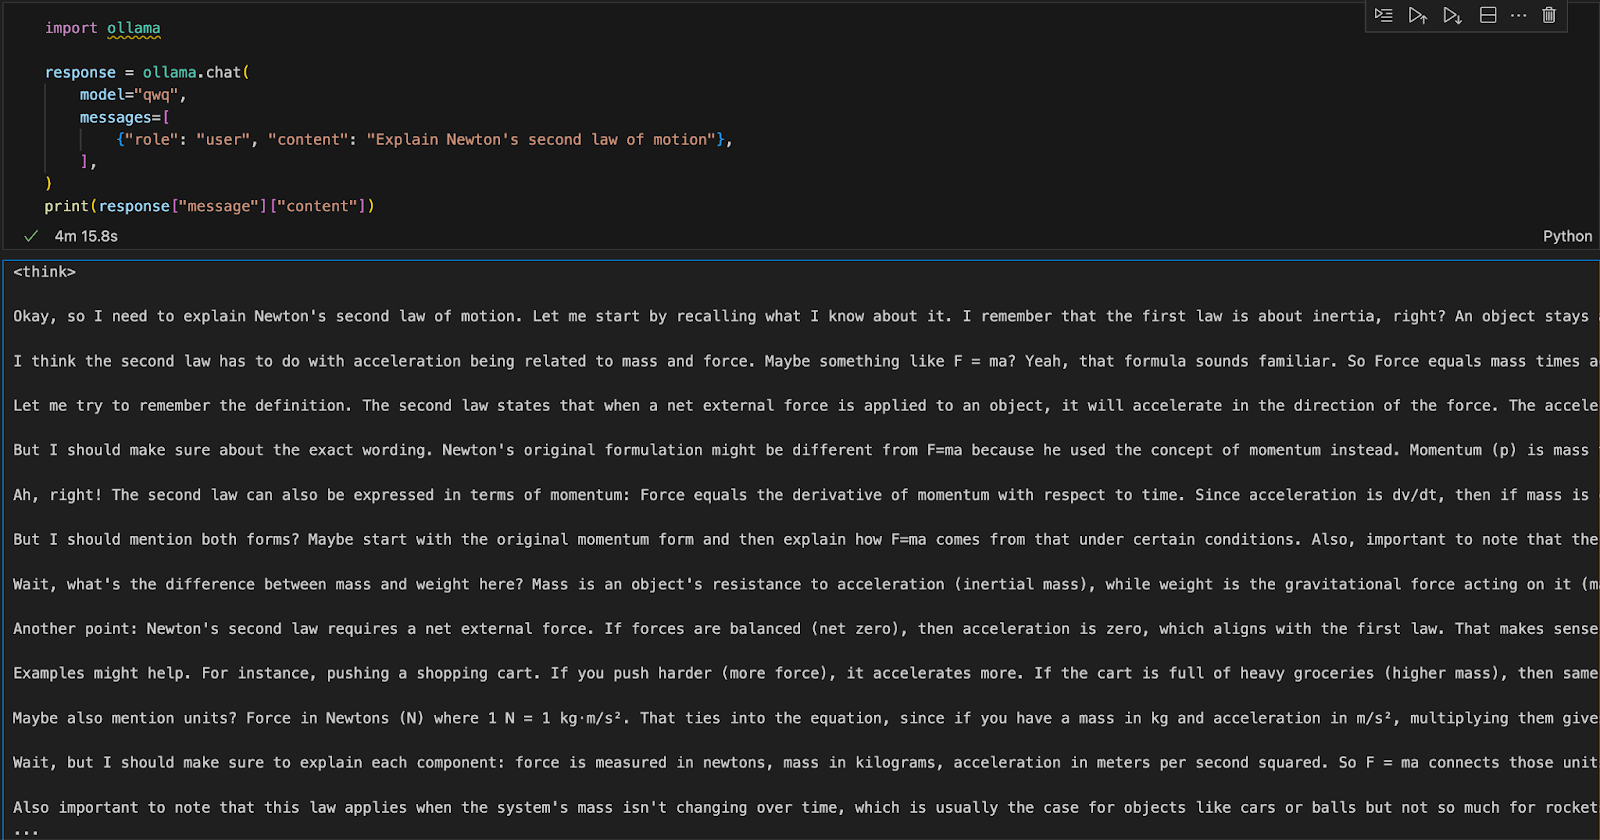
हम किसी भी एकीकृत विकास परिवेश (IDE) में Ollama चला सकते हैं। आप निम्न कोड का उपयोग करके Ollama का Python पैकेज इंस्टॉल कर सकते हैं:
pip install ollamaOllama इंस्टॉल होने के बाद, मॉडल से इंटरैक्ट करने के लिए निम्न स्क्रिप्ट का उपयोग करें:
import ollama
response = ollama.chat(
    model="qwq",
    messages=[
        {"role": "user", "content": "Explain Newton's second law of motion"},
    ],
)
print(response["message"]["content"])
फ़ंक्शन ollama.chat() मॉडल का नाम और उपयोगकर्ता का प्रॉम्प्ट लेता है और उसे एक वार्तालाप के रूप में संसाधित करता है। स्क्रिप्ट फिर मॉडल की प्रतिक्रिया निकालकर प्रिंट करती है।
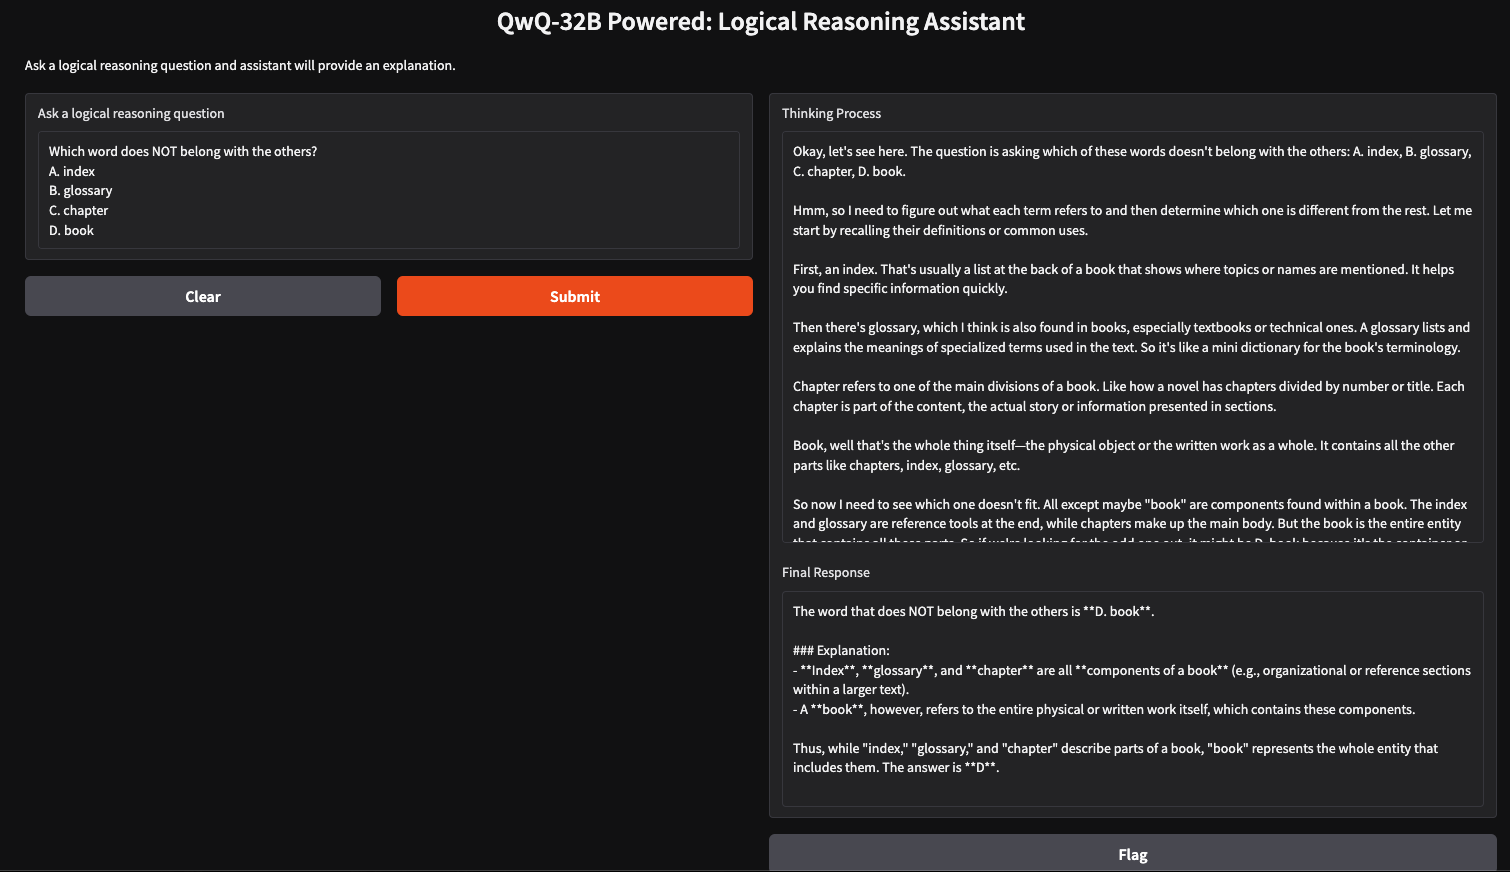
हम QwQ-32B और Gradio का उपयोग करके एक साधारण लॉजिकल रीजनिंग असिस्टेंट बना सकते हैं, जो उपयोगकर्ता द्वारा दर्ज प्रश्नों को स्वीकार करेगा और संरचित, तार्किक प्रतिक्रियाएँ जनरेट करेगा। यह ऐप QwQ-32B के क्रमबद्ध सोचने के तरीके का उपयोग करके स्पष्ट और सुविचारित उत्तर देगा—जो समस्या-समाधान, ट्यूटोरिंग और AI-सहायता प्राप्त निर्णय-निर्माण के लिए उपयोगी है।
इम्प्लीमेंटेशन शुरू करने से पहले, सुनिश्चित करें कि हमारे पास निम्नलिखित टूल्स और लाइब्रेरीज़ इंस्टॉल हैं:
आवश्यक डिपेंडेंसियाँ इंस्टॉल करने के लिए निम्न कमांड्स चलाएँ:
pip install gradio ollamaऊपर दी गई डिपेंडेंसियाँ इंस्टॉल होने के बाद, निम्न इम्पोर्ट कमांड्स चलाएँ:
import gradio as gr
import ollama
import reअब जबकि हमारी डिपेंडेंसियाँ तैयार हैं, हम एक क्वेरी फ़ंक्शन बनाएँगे जो हमारे प्रश्न को मॉडल तक पहुँचाएगा और एक संरचित प्रतिक्रिया प्राप्त करेगा।
def query_qwq(question):
    response = ollama.chat(
        model="qwq",
        messages=[{"role": "user", "content": question}]
    )
    full_response = response["message"]["content"]
    # Extract the <think> part and the final answer
    think_match = re.search(r"<think>(.*?)</think>", full_response, re.DOTALL)
    think_text = think_match.group(1).strip() if think_match else "Thinking process not explicitly provided."
    final_response = re.sub(r"<think>.*?</think>", "", full_response, flags=re.DOTALL).strip()
    return think_text, final_response
फ़ंक्शन query_qwq() Ollama के माध्यम से Qwen QwQ-32B मॉडल से इंटरैक्ट करता है—यह उपयोगकर्ता द्वारा दिया गया प्रश्न भेजता है और एक संरचित प्रतिक्रिया प्राप्त करता है। यह दो प्रमुख घटक निकालता है:
यह तर्क-चरण और अंतिम प्रतिक्रिया को अलग-अलग प्रस्तुत करता है, जिससे यह स्पष्ट होता है कि मॉडल अपने निष्कर्षों तक कैसे पहुँचा।
अब जब हमारा कोर फ़ंक्शन तैयार है, हम Gradio UI बनाएँगे।
interface = gr.Interface(
    fn=query_qwq,
    inputs=gr.Textbox(label="Ask a logical reasoning question"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Final Response")],
    title="QwQ-32B Powered: Logical Reasoning Assistant",
    description="Ask a logical reasoning question and the assistant will provide an explanation."
)
interface.launch(debug = True)
यह Gradio इंटरफ़ेस एक लॉजिकल रीजनिंग असिस्टेंट सेट करता है जो gr.Textbox() फ़ंक्शन के माध्यम से उपयोगकर्ता का प्रश्न लेता है और query_qwq() फ़ंक्शन से उसे प्रोसेस करता है। अंत में, interface.launch() फ़ंक्शन डिबगिंग सक्षम के साथ Gradio ऐप शुरू करता है, जिससे त्रुटि ट्रैकिंग और लॉग्स रीयल-टाइम में मिलते हैं।
Ollama के साथ QwQ-32B को लोकली चलाने से निजी, तेज़ और किफ़ायती मॉडल इन्फ़रेंस संभव होता है। इस ट्यूटोरियल के साथ, आप इसकी उन्नत तर्क-क्षमताओं को रीयल-टाइम में खोज सकते हैं। इस मॉडल का उपयोग AI-सहायता प्राप्त ट्यूटोरिंग, लॉजिक-आधारित समस्या-समाधान, और अन्य अनुप्रयोगों में किया जा सकता है।
इन कोर्सेज़ के साथ AI सीखें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}