
Last chance! 50% off DataCamp Premium
Sale ends in
Immagina una nave che naviga nella nebbia. Il GPS è rumoroso, la corrente oceanica è sconosciuta e la posizione esatta non può essere misurata direttamente. Può essere solo approssimata dalle letture dei sensori. I modelli a spazio degli stati sono stati creati proprio per questo tipo di problema: sistemi in cui ciò che ti interessa è nascosto e tutto ciò a cui hai accesso sono misurazioni imperfette.
Questo articolo copre la struttura dei modelli a spazio degli stati, come stimare gli stati nascosti tramite filtering e smoothing, dove si inserisce il filtro di Kalman e come implementare questi modelli in Python e R.
Un modello a spazio degli stati è un quadro matematico per descrivere un sistema che cambia nel tempo attraverso stati che non puoi osservare direttamente. Entrano in gioco due grandezze: lo stato, cioè l'informazione sottostante che descrive il sistema in ogni istante, e l'osservazione, cioè la misura rumorosa e indiretta che ottieni davvero.
Il modello specifica due cose: come lo stato nascosto evolve da un passo temporale al successivo e come quello stato nascosto produce le osservazioni che vedi. Questa separazione è ciò che rende il framework così generale. Compare nell'elaborazione dei segnali, nell'econometria, nei sistemi di controllo e nel machine learning. Succede spesso senza che ci si renda conto che si sta lavorando all'interno della stessa struttura formale.
La logica di base segue una semplice sequenza a ogni passo temporale:
Stato precedente → Stato attuale → Osservazione
Il sistema passa dal precedente stato nascosto a uno nuovo. Questa transizione può includere casualità, perché i sistemi reali non sono perfettamente prevedibili. Il nuovo stato genera quindi una misura osservabile, che porta con sé il proprio rumore. Non vedi mai lo stato direttamente; vedi ciò che produce, in modo imperfetto.
Quello che puoi fare è usare ogni nuova osservazione per aggiornare la tua migliore stima dello stato nascosto. Questo è il problema d'inferenza, ed è a risolverlo che è progettata gran parte della macchina algoritmica attorno ai modelli a spazio degli stati.
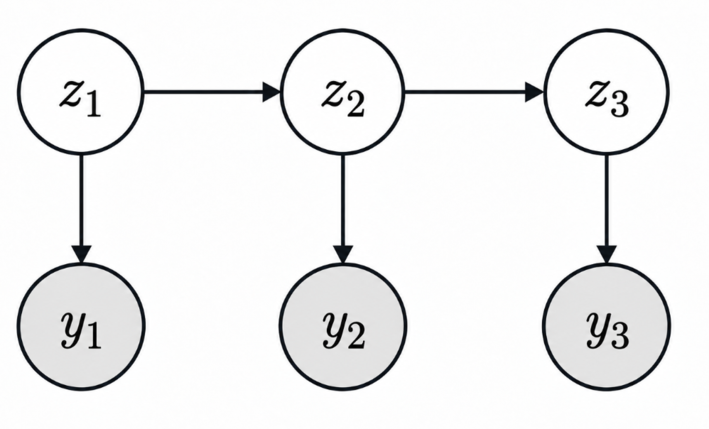
Gli stati nascosti generano osservazioni rumorose nel tempo. Immagine dell'autore.
La struttura del modello si riduce a due equazioni. Una per come si muove lo stato, una per ciò che puoi misurare.
L'equazione di stato descrive come evolve lo stato nascosto. In forma scalare:
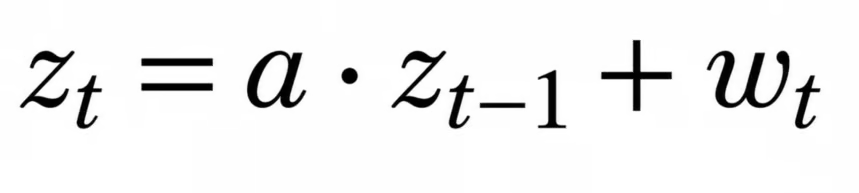
Qui, zₜ è lo stato nascosto corrente, a cattura la dinamica di transizione (quanto fortemente lo stato precedente si trasmette in avanti) e wₜ è il rumore di processo — la casualità nel modo in cui il sistema si muove. Nella formulazione matriciale per sistemi multivariati, a diventa una matrice di transizione, ma l'idea è identica.
L'equazione di osservazione collega lo stato nascosto a ciò che misuri:
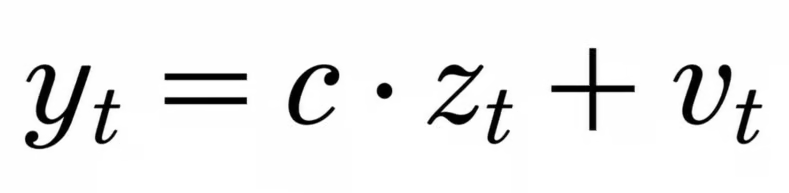
yₜ è la misura osservata, c definisce la relazione di osservazione e vₜ è il rumore di misurazione. Parti da versioni scalari come queste prima di preoccuparti della forma matriciale generale. Le matrici aggiungono generalità, non nuove idee.
Pensa a un'auto che si muove lungo una strada. La sua vera posizione e velocità sono lo stato nascosto. Non puoi osservarli direttamente. Quello che hai è una lettura GPS, che è rumorosa. L'equazione di stato modella come posizione e velocità cambiano tra i passi temporali (l'auto continua a muoversi più o meno alla stessa velocità). L'equazione di osservazione collega la vera posizione alla lettura del GPS, che potrebbe essere sfasata di diversi metri.
Una buona visualizzazione mostra tre linee: la posizione reale (liscia), le letture del GPS (disperse attorno alla verità) e la posizione stimata dal modello (vicina alla verità, un po' più liscia del GPS grezzo). Ottenere quella terza linea è tutto il lavoro del modello.
Definire il modello è solo metà del problema. Devi anche inferire gli stati nascosti dalle osservazioni che hai realmente. Tre compiti coprono lo spazio:
Filtering stima lo stato corrente usando solo le osservazioni fino a questo momento — inferenza in tempo reale, utile per tracciamento e controllo. Smoothing torna indietro e rivede quelle stime usando osservazioni sia precedenti sia successive a un dato punto — in genere più accurato, ma richiede l'intera sequenza. Previsione proietta in avanti per stimare stati futuri prima che arrivino le osservazioni.
La maggior parte delle applicazioni usa il filtering. Lo smoothing entra in gioco quando stai facendo analisi retrospettive e l'accuratezza conta più della velocità.
Il filtro di Kalman è l'algoritmo per il filtering nei modelli a spazio degli stati lineari gaussiani. Vale la pena essere precisi: il modello a spazio degli stati è il modello; il filtro di Kalman è un metodo d'inferenza che si applica a una specifica classe di questi modelli.
Il filtro lavora in due passaggi alternati. Nella fase di previsione usa l'equazione di stato per proiettare in avanti nel tempo la stima corrente, insieme a una misura di quanto è incerta quella stima. Nella fase di aggiornamento, arriva una nuova osservazione e la stima viene corretta. Di quanto si sposta dipende dall'incertezza relativa tra previsione e misurazione. Se la previsione del modello è affidabile, l'osservazione ha meno influenza. Se il segnale GPS è pulito e il modello è incerto, l'osservazione domina. Quella fusione ponderata dall'incertezza è ciò che rende il filtro di Kalman efficace nella pratica.
Esistono estensioni per contesti non lineari o non gaussiani: il filtro di Kalman esteso linearizza la dinamica, l'unscented Kalman filter usa un'approssimazione più accurata e i filtri a particelle gestiscono il caso completamente generale tramite campionamento. Quelli sono altri articoli.
Il framework copre una gamma di contesti a seconda di ciò che sei disposto ad assumere sulla dinamica e sul rumore.
Modelli a spazio degli stati lineari gaussiani sono l'impostazione classica: equazioni di transizione e osservazione lineari, rumore gaussiano. Il filtering di Kalman si applica direttamente e l'inferenza esatta è trattabile.
Modelli a spazio degli stati non lineari emergono quando la transizione di stato o la relazione di osservazione non è lineare — pensa a un pendolo o a un modello in cui gli effetti di prezzo si attenuano. L'inferenza esatta non è più disponibile.
Modelli a spazio degli stati non gaussiani abbandonano l'assunzione che il rumore segua una distribuzione normale. Dati di conteggio, esiti binari e processi a code pesanti rientrano qui.
Vale la pena fare alcuni confronti espliciti, perché i confini qui sono più sfumati di quanto sembri all'inizio.
ARIMA modella direttamente i valori osservati e i loro errori passati, senza introdurre alcuno stato nascosto. I modelli a spazio degli stati introducono esplicitamente stati latenti. Detto ciò, i modelli ARIMA possono essere riformulati in forma a spazio degli stati — quindi i due non sono così separati come sembra, e i software spesso usano rappresentazioni a spazio degli stati internamente per adattare comunque ARIMA.
Entrambi coinvolgono stati nascosti. Gli HMM classici usano stati latenti discreti (il sistema è in una di k modalità), mentre la maggior parte dei modelli a spazio degli stati usa stati continui. Per il riconoscimento vocale, le modalità discrete hanno senso; per tracciare un oggetto fisico, gli stati continui sono la scelta naturale.
I modelli strutturali di serie temporali (che scompongono una serie in trend, stagionalità e componente irregolare) sono tipicamente formulati come modelli a spazio degli stati piuttosto che competere con essi. Sono un caso d'uso specifico del framework.
Il workflow è simile in entrambi i linguaggi — definisci il modello, adattalo e ricava le stime degli stati nascosti.
La libreria statsmodels offre un'interfaccia pulita per adattare modelli a spazio degli stati. Ecco un modello a livello locale (il più semplice modello strutturale, con stato a passeggiata aleatoria e osservazioni rumorose) adattato a dei dati di serie temporale:
import statsmodels.api as sm

# Fit a local level (random walk plus noise) model
model = sm.tsa.UnobservedComponents(time_series, level='local level')
result = model.fit(disp=False)

# Filtered state estimates (the hidden level at each time step)
print(result.filtered_state[0])

# Forecast the next 10 periods
forecast = result.forecast(10)
Lo stato filtrato ti fornisce la miglior stima del modello del livello nascosto in ogni punto nel tempo. È questo l'output principale che ti interessa, non i parametri in sé.
In R, il pacchetto KFAS gestisce i modelli a spazio degli stati gaussiani ed è da conoscere se lavori spesso in quest'area. Il workflow rispecchia Python: definisci un oggetto modello, adattalo ed estrai gli stati smussati o filtrati. Interpreta le stime degli stati nascosti, non solo le statistiche di fit.
library(KFAS)

# Fit a local level (random walk plus noise) model
model <- SSModel(time_series ~ SSMtrend(1, Q = NA), H = NA)
fit <- fitSSM(model, inits = c(log(1), log(1)))
out <- KFS(fit$model)

# Filtered state estimates (the hidden level at each time step)
out$att

# Forecast the next 10 periods
predict(fit$model, n.ahead = 10)Come nella maggior parte dei framework di modellazione, i punti di forza e di debolezza provengono dallo stesso luogo: devi impegnarti a una struttura in anticipo.
Vantaggi: Rappresentano esplicitamente processi nascosti invece di coprirli. Gestiscono in modo naturale sistemi che cambiano nel tempo. L'incertezza di misurazione è integrata nel modello, non trattata come un ripensamento. E lo stesso framework supporta filtering, smoothing e forecasting senza cambiare la struttura del modello.
Limiti: Specificare il modello può essere difficile. Devi decidere cosa significa lo stato nascosto e come evolve, il che richiede un vero giudizio di dominio. Per sistemi non lineari o non gaussiani, l'inferenza diventa costosa. E se le tue assunzioni sulla dinamica o sul rumore sono sbagliate, le stime saranno sbagliate in modi non sempre evidenti.
Un modello a spazio degli stati descrive due cose: come uno stato non osservato evolve nel tempo e come quello stato produce le osservazioni che puoi misurare. Queste sono l'equazione di stato e l'equazione di osservazione. Tutto il resto (filtro di Kalman, smoothing, previsione) riguarda l'inferenza dello stato nascosto a partire dai dati che il modello genera.
Quello che trovo utile di questo framework è che ti costringe a essere esplicito su ciò che non sai. Invece di modellare direttamente le osservazioni (come fa ARIMA), sei costretto a impegnarti in una narrazione sul processo sottostante. È un vincolo, ma anche una chiarificazione. Una volta che hai scritto cosa pensi che sia lo stato nascosto e come si muove, il problema d'inferenza diventa meccanico. La parte difficile era già la modellazione.
Se arrivi dai metodi classici per serie temporali, i modelli a spazio degli stati meritano di essere compresi per quello che sono, non come una generalizzazione di ciò che già conosci. Il nostro corso Time Series with Python copre la cassetta degli attrezzi più ampia e, se i modelli di Markov nascosti o il filtro di Kalman sono la tua prossima tappa, le basi concettuali qui si trasferiscono direttamente.
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min




