Última chance! Formação ilimitada com 50% de desconto
A promoção termina em
Imagine um navio navegando em meio à neblina. O GPS tem ruído, a correnteza é desconhecida e a posição exata não pode ser medida diretamente. Ela só pode ser aproximada a partir dos sensores. Os modelos em espaço de estados foram feitos para esse tipo de problema: sistemas em que o que importa está oculto e tudo o que você tem são medições imperfeitas dele.
Este artigo apresenta a estrutura dos modelos em espaço de estados, como estimar estados ocultos por meio de filtragem e suavização, onde entra o filtro de Kalman e como implementar esses modelos em Python e R.
Um modelo em espaço de estados é um arcabouço matemático para descrever um sistema que muda ao longo do tempo por meio de estados que você não consegue observar diretamente. Duas quantidades estão em jogo: o estado, que é a informação subjacente verdadeira que descreve o sistema a cada momento, e a observação, que é a medida indireta e ruidosa que você de fato obtém.
O modelo especifica duas coisas: como o estado oculto evolui de um instante para o outro e como esse estado gera as observações que você vê. Essa separação é o que torna o arcabouço tão geral. Ele aparece em processamento de sinais, econometria, sistemas de controle e aprendizado de máquina — muitas vezes sem que as pessoas percebam que estão usando a mesma estrutura formal.
A lógica central segue uma sequência simples a cada passo de tempo:
Estado anterior → Estado atual → Observação
O sistema passa de seu estado oculto anterior para um novo. Essa transição pode incluir aleatoriedade, já que sistemas reais não são perfeitamente previsíveis. O novo estado então gera uma medida observável, que vem com seu próprio ruído. Você nunca vê o estado diretamente; você vê o que ele produz — de forma imperfeita.
O que você pode fazer é usar cada nova observação para atualizar sua melhor estimativa do estado oculto. Esse é o problema de inferência, e é para isso que serve a maior parte da maquinaria algorítmica em torno de modelos em espaço de estados.
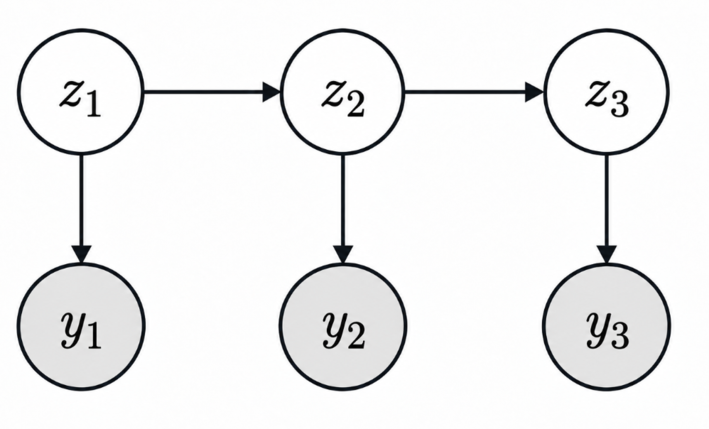
Estados ocultos geram observações ruidosas ao longo do tempo. Imagem do autor.
A estrutura do modelo se resume a duas equações: uma para como o estado se move e outra para o que você consegue medir.
A equação de estado descreve como o estado oculto evolui. Na forma escalar:
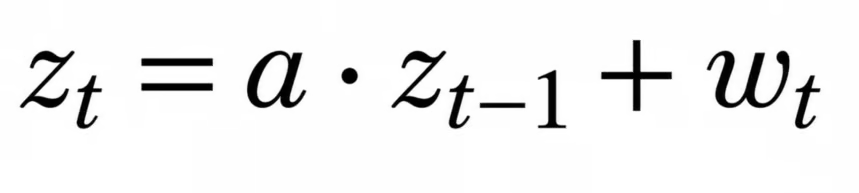
Aqui, zₜ é o estado oculto atual, a captura a dinâmica de transição (o quanto o estado anterior se mantém), e wₜ é o ruído de processo — a aleatoriedade em como o sistema se move. Na formulação matricial para sistemas multivariados, a vira uma matriz de transição, mas a ideia é idêntica.
A equação de observação conecta o estado oculto ao que você mede:
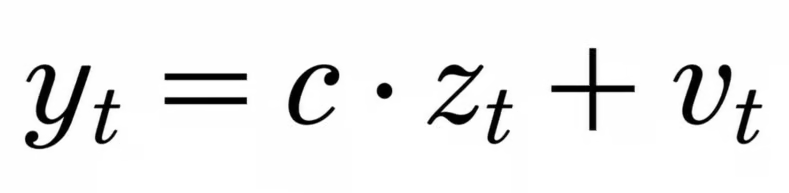
yₜ é a medida observada, c define a relação de observação e vₜ é o ruído de medição. Comece por versões escalares como estas antes de se preocupar com a forma matricial geral. As matrizes trazem generalidade, não novas ideias.
Pense em um carro se movendo ao longo de uma estrada. Sua posição e velocidade verdadeiras são o estado oculto. Você não consegue observá-las diretamente. O que você tem é a leitura do GPS, que é ruidosa. A equação de estado modela como posição e velocidade mudam entre instantes (o carro continua se movendo a aproximadamente a mesma velocidade). A equação de observação conecta a posição verdadeira à leitura do GPS, que pode errar alguns metros.
Uma boa visualização disso mostra três linhas: a posição verdadeira (suave), as leituras do GPS (dispersas em torno da verdade) e a posição estimada pelo modelo (próxima da verdade, um pouco mais suave que o GPS bruto). Obter essa terceira linha é todo o trabalho do modelo.
Definir o modelo é só metade do problema. Você também precisa inferir os estados ocultos a partir das observações que tem. Três tarefas cobrem o cenário:
Filtragem estima o estado atual usando apenas as observações até agora — inferência em tempo real, útil para rastreamento e controle. Suavização revisita e corrige essas estimativas usando observações tanto de antes quanto de depois de um ponto — geralmente mais precisa, mas exige a sequência completa. Previsão extrapola para frente para estimar estados futuros antes das observações chegarem.
A maioria das aplicações usa filtragem. Suavização aparece quando você está fazendo análise retrospectiva e a precisão importa mais do que a velocidade.
O filtro de Kalman é o algoritmo de filtragem para modelos lineares gaussianos em espaço de estados. Vale ser preciso: o modelo em espaço de estados é o modelo; o filtro de Kalman é um método de inferência que se aplica a uma classe específica desses modelos.
O filtro funciona em duas etapas alternadas. Na etapa de previsão, ele usa a equação de estado para projetar a estimativa atual no tempo, junto com uma medida da incerteza dessa estimativa. Na etapa de atualização, chega uma nova observação e a estimativa é corrigida. O quanto ela muda depende da incerteza relativa entre a previsão e a medição. Se a previsão do modelo é confiável, a observação pesa menos. Se o sinal de GPS está limpo e o modelo está incerto, a observação domina. Essa combinação ponderada pela incerteza é o que faz o filtro de Kalman funcionar na prática.
Existem extensões para cenários não lineares ou não gaussianos: o filtro de Kalman estendido lineariza a dinâmica, o filtro de Kalman unscented usa uma aproximação mais esperta e filtros de partículas lidam com o caso totalmente geral por amostragem. Esses são tópicos para outros artigos.
O arcabouço cobre uma variedade de cenários dependendo do que você está disposto a assumir sobre a dinâmica e o ruído.
Modelos lineares gaussianos em espaço de estados são o cenário clássico: equações de transição e observação lineares, ruído gaussiano. A filtragem de Kalman se aplica diretamente e a inferência exata é viável.
Modelos não lineares em espaço de estados surgem quando a transição de estado ou a relação de observação não é linear — pense em um pêndulo ou em um modelo no qual os efeitos de preço se atenuam. A inferência exata deixa de estar disponível.
Modelos não gaussianos em espaço de estados abandonam a suposição de que o ruído segue uma distribuição normal. Dados de contagem, desfechos binários e processos com caudas pesadas entram aqui.
Algumas comparações valem ser explicitadas, já que os limites aqui são mais difusos do que parecem.
ARIMA modela diretamente os valores observados e seus erros passados, sem introduzir estado oculto. Modelos em espaço de estados trazem estados latentes explicitamente. Dito isso, modelos ARIMA podem ser reformulados na forma de espaço de estados — então eles não são tão separados quanto parecem, e softwares frequentemente usam representações em espaço de estados internamente para ajustar ARIMA mesmo assim.
Ambos envolvem estados ocultos. HMMs clássicos usam estados latentes discretos (o sistema está em um de k modos), enquanto a maioria dos modelos em espaço de estados usa estados contínuos. Para reconhecimento de voz, modos discretos fazem sentido; para rastrear um objeto físico, estados contínuos são a escolha natural.
Modelos estruturais de séries temporais (que decompõem uma série em tendência, sazonalidade e componente irregular) geralmente são formulados como modelos em espaço de estados, e não competem com eles. São um caso de uso específico do arcabouço.
O fluxo de trabalho é semelhante em ambas as linguagens — defina o modelo, ajuste-o e extraia as estimativas dos estados ocultos.
A biblioteca statsmodels oferece uma interface simples para ajustar modelos em espaço de estados. Aqui vai um modelo de nível local (o modelo estrutural mais simples, com estado passeio aleatório e observações ruidosas) ajustado a uma série temporal:
import statsmodels.api as sm

# Fit a local level (random walk plus noise) model
model = sm.tsa.UnobservedComponents(time_series, level='local level')
result = model.fit(disp=False)

# Filtered state estimates (the hidden level at each time step)
print(result.filtered_state[0])

# Forecast the next 10 periods
forecast = result.forecast(10)
A estimativa filtrada do estado dá a melhor estimativa do nível oculto em cada ponto no tempo. É o principal resultado de interesse — mais do que os próprios parâmetros.
Em R, o pacote KFAS lida com modelos gaussianos em espaço de estados e vale a pena conhecer se você trabalha com isso com frequência. O fluxo de trabalho espelha o do Python: defina um objeto de modelo, ajuste-o e extraia os estados suavizados ou filtrados. Interprete as estimativas do estado oculto, não apenas as estatísticas de ajuste.
library(KFAS)

# Fit a local level (random walk plus noise) model
model <- SSModel(time_series ~ SSMtrend(1, Q = NA), H = NA)
fit <- fitSSM(model, inits = c(log(1), log(1)))
out <- KFS(fit$model)

# Filtered state estimates (the hidden level at each time step)
out$att

# Forecast the next 10 periods
predict(fit$model, n.ahead = 10)Como em qualquer arcabouço de modelagem, os pontos fortes e fracos vêm do mesmo lugar: você precisa se comprometer com uma estrutura desde o início.
Vantagens: eles representam processos ocultos de forma explícita, em vez de encobri-los. Lidam naturalmente com sistemas que mudam ao longo do tempo. A incerteza de medição faz parte do modelo, não é um detalhe posterior. E o mesmo arcabouço suporta filtragem, suavização e previsão sem mudar a estrutura do modelo.
Limitações: especificar o modelo pode ser difícil. Você precisa decidir o que o estado oculto significa e como ele evolui — o que exige julgamento de domínio. Para sistemas não lineares ou não gaussianos, a inferência fica cara. E, se suas suposições sobre a dinâmica ou o ruído estiverem erradas, as estimativas também estarão — e nem sempre de forma óbvia.
Um modelo em espaço de estados descreve duas coisas: como um estado não observado evolui no tempo e como esse estado produz as observações que você consegue medir. Essas são a equação de estado e a equação de observação. Todo o resto (filtro de Kalman, suavização, previsão) trata de inferir o estado oculto a partir dos dados que o modelo gera.
O que acho útil nesse arcabouço é que ele obriga você a ser explícito sobre o que não sabe. Em vez de modelar as observações diretamente (como o ARIMA faz), você precisa se comprometer com uma história sobre o processo subjacente. Isso é uma restrição, mas também uma forma de esclarecer. Depois de escrever o que você acha que é o estado oculto e como ele se move, o problema de inferência vira mecânico. A parte difícil já foi a modelagem.
Se você vem de métodos clássicos de séries temporais, vale entender modelos em espaço de estados pelos seus próprios termos, e não apenas como uma generalização do que você já conhece. Nosso curso de Time Series com Python cobre o conjunto de ferramentas mais amplo e, se modelos de Markov ocultos ou o filtro de Kalman forem seu próximo passo, a base conceitual aqui se transfere diretamente.
blog
Abid Ali Awan
11 min
blog
Natassha Selvaraj
15 min
blog
Joleen Bothma
7 min
blog
Abid Ali Awan
8 min
Tutorial
Somil Asthana
11 min
Tutorial
DataCamp Team
2 min