Imagina un barco navegando entre la niebla. Su GPS es ruidoso, la corriente es desconocida y no se puede medir su posición exacta de forma directa. Solo puede aproximarse a partir de las lecturas de los sensores. Los modelos de espacio de estados se crearon justo para este tipo de problema: sistemas en los que lo que te interesa está oculto y lo único que tienes son mediciones imperfectas de ello.
Este artículo explica la estructura de los modelos de espacio de estados, cómo estimar los estados ocultos mediante filtrado y suavizado, dónde encaja el filtro de Kalman y cómo implementar estos modelos en Python y R.
¿Qué es un modelo de espacio de estados?
Un modelo de espacio de estados es un marco matemático para describir un sistema que cambia con el tiempo a través de estados que no puedes observar directamente. Intervienen dos cantidades: el estado, que es la información verdadera subyacente que describe el sistema en cada momento, y la observación, que es la medición indirecta y ruidosa que realmente obtienes.
El modelo especifica dos cosas: cómo evoluciona el estado oculto de un instante al siguiente y cómo ese estado oculto genera las observaciones que ves. Esa separación es lo que hace que el marco sea tan general. Aparece en procesamiento de señales, econometría, sistemas de control y aprendizaje automático. Y a menudo sucede sin que nadie caiga en la cuenta de que están trabajando dentro de la misma estructura formal.
Cómo funcionan los modelos de espacio de estados
La lógica central sigue una secuencia sencilla en cada paso temporal:
Estado anterior → Estado actual → Observación
El sistema pasa de su estado oculto anterior a uno nuevo. Esta transición puede incluir aleatoriedad, porque los sistemas reales no son perfectamente predecibles. El nuevo estado genera entonces una medición observable, que a su vez llega con su propio ruido. Nunca ves el estado directamente; ves lo que produce, de forma imperfecta.
Lo que sí puedes hacer es usar cada nueva observación para actualizar tu mejor estimación del estado oculto. Ese es el problema de inferencia, y para resolverlo está diseñada la mayor parte de la maquinaria algorítmica alrededor de los modelos de espacio de estados.
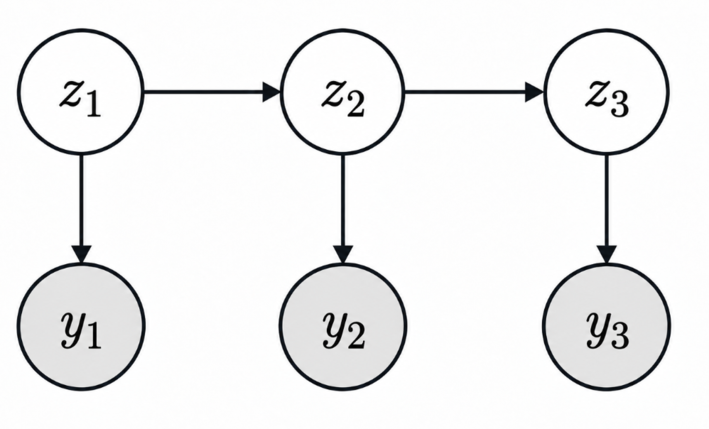
Los estados ocultos generan observaciones ruidosas a lo largo del tiempo. Imagen del autor.
Ecuaciones de estado y de observación
La estructura del modelo se reduce a dos ecuaciones. Una para cómo se mueve el estado y otra para lo que puedes medir.
Ecuación de estado
La ecuación de estado describe cómo evoluciona el estado oculto. En forma escalar:
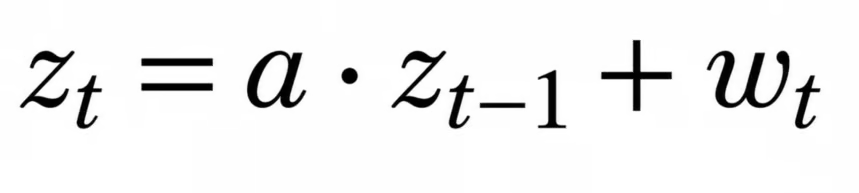
Aquí, zₜ es el estado oculto actual, a recoge la dinámica de transición (cuánto persiste el estado anterior) y wₜ es el ruido de proceso — la aleatoriedad en cómo se mueve el sistema. En la formulación matricial para sistemas multivariantes, a pasa a ser una matriz de transición, pero la idea es la misma.
Ecuación de observación
La ecuación de observación conecta el estado oculto con lo que mides:
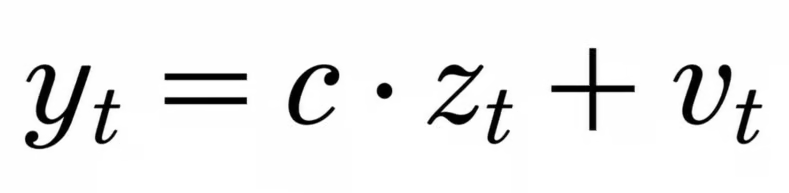
yₜ es la medición observada, c define la relación de observación y vₜ es el ruido de medición. Empieza por estas versiones escalares antes de preocuparte por la forma matricial general. Las matrices aportan generalidad, no ideas nuevas.
Un ejemplo sencillo de modelo de espacio de estados
Piensa en un coche que avanza por una carretera. Su posición y velocidad reales son el estado oculto. No puedes observarlas directamente. Lo que tienes es una lectura de GPS, que es ruidosa. La ecuación de estado modela cómo cambian la posición y la velocidad entre pasos temporales (el coche sigue moviéndose a una velocidad más o menos constante). La ecuación de observación conecta la posición real con la lectura del GPS, que puede desviarse varios metros.
Una buena visualización muestra tres líneas: la posición real (suave), las lecturas del GPS (dispersas alrededor de la realidad) y la posición estimada por el modelo (cercana a la realidad, algo más suave que el GPS bruto). Obtener esa tercera línea es todo el cometido del modelo.
Cómo se estiman los estados
Definir el modelo es solo la mitad del problema. También necesitas inferir los estados ocultos a partir de las observaciones que realmente tienes. Tres tareas cubren el espectro:
Filtrado estima el estado actual usando solo las observaciones hasta el momento — inferencia en tiempo real, útil para seguimiento y control. Suavizado revisa esas estimaciones utilizando observaciones tanto anteriores como posteriores a un punto dado — suele ser más preciso, pero requiere la secuencia completa. Predicción extrapola hacia delante para estimar estados futuros antes de que lleguen las observaciones.
La mayoría de aplicaciones usan filtrado. El suavizado aparece cuando haces análisis retrospectivo y la precisión importa más que la velocidad.
Filtrado de Kalman y modelos de espacio de estados
El filtro de Kalman es el algoritmo de filtrado en modelos lineales gaussianos de espacio de estados. Conviene ser preciso: el modelo de espacio de estados es el modelo; el filtro de Kalman es un método de inferencia que aplica a una clase específica de esos modelos.
El filtro funciona en dos pasos alternos. En el paso de predicción, usa la ecuación de estado para proyectar la estimación actual hacia el futuro, junto con una medida de su incertidumbre. En el paso de actualización, llega una nueva observación y se corrige la estimación. Cuánto se ajusta depende de la incertidumbre relativa entre la predicción y la medición. Si la predicción del modelo es fiable, la observación influye menos. Si la señal del GPS es limpia y el modelo es incierto, la observación domina. Esa combinación ponderada por incertidumbre es lo que hace que el filtro de Kalman funcione en la práctica.
Existen extensiones para entornos no lineales o no gaussianos: el filtro de Kalman extendido linealiza la dinámica, el filtro de Kalman no lineal (unscented) usa una aproximación más fina y los filtros de partículas tratan el caso general mediante muestreo. Eso daría para otros artículos.
Tipos de modelos de espacio de estados
El marco abarca distintos escenarios según lo que estés dispuesto a asumir sobre la dinámica y el ruido.
Modelos lineales gaussianos de espacio de estados: el caso clásico, con ecuaciones de transición y observación lineales y ruido gaussiano. El filtrado de Kalman aplica directamente y la inferencia exacta es abordable.
Modelos no lineales de espacio de estados: surgen cuando la transición de estado o la relación de observación no es lineal — piensa en un péndulo, o en un modelo donde los efectos de precio se atenúan. La inferencia exacta deja de estar disponible.
Modelos no gaussianos de espacio de estados: abandonan la suposición de que el ruido sigue una distribución normal. Aquí encajan datos de conteo, resultados binarios y procesos de colas pesadas.
Modelos de espacio de estados frente a otros modelos de series temporales
Conviene explicitar algunas comparaciones, porque los límites aquí son más difusos de lo que parecen.
Modelos de espacio de estados vs. ARIMA
ARIMA modela directamente los valores observados y sus errores pasados, sin introducir ningún estado oculto. Los modelos de espacio de estados incorporan explícitamente estados latentes. Dicho esto, los modelos ARIMA pueden reformularse en forma de espacio de estados — así que no están tan separados como parece y, de hecho, el software a menudo usa representaciones de espacio de estados internamente para ajustar ARIMA.
Modelos de espacio de estados vs. modelos ocultos de Markov
Ambos implican estados ocultos. Los HMM clásicos usan estados latentes discretos (el sistema está en uno de k modos), mientras que la mayoría de modelos de espacio de estados usan estados continuos. Para reconocimiento de voz, los modos discretos tienen sentido; para seguir un objeto físico, los estados continuos son la opción natural.
Modelos de espacio de estados vs. modelos estructurales de series temporales
Los modelos estructurales de series temporales (que descomponen una serie en tendencia, estacionalidad e irregular) suelen formularse como modelos de espacio de estados más que competir con ellos. Son un caso de uso específico del marco.
Modelos de espacio de estados en Python y R
El flujo de trabajo es similar en ambos lenguajes — define el modelo, ajústalo y extrae las estimaciones del estado oculto.
Modelos de espacio de estados en Python
La librería statsmodels ofrece una interfaz clara para ajustar modelos de espacio de estados. Aquí ajustamos un modelo de nivel local (el modelo estructural más simple, con un estado de paseo aleatorio y observaciones ruidosas) a una serie temporal:
import statsmodels.api as sm

# Fit a local level (random walk plus noise) model
model = sm.tsa.UnobservedComponents(time_series, level='local level')
result = model.fit(disp=False)

# Filtered state estimates (the hidden level at each time step)
print(result.filtered_state[0])

# Forecast the next 10 periods
forecast = result.forecast(10)
El estado filtrado te da la mejor estimación del nivel oculto en cada instante. Es la salida principal que te interesa, más que los propios parámetros.
Modelos de espacio de estados en R
En R, el paquete KFAS gestiona modelos gaussianos de espacio de estados y merece la pena conocerlo si trabajas con frecuencia en este ámbito. El flujo de trabajo es paralelo al de Python: define el objeto del modelo, ajústalo y extrae los estados suavizados o filtrados. Interpreta las estimaciones del estado oculto, no solo las métricas de ajuste.
library(KFAS)

# Fit a local level (random walk plus noise) model
model <- SSModel(time_series ~ SSMtrend(1, Q = NA), H = NA)
fit <- fitSSM(model, inits = c(log(1), log(1)))
out <- KFS(fit$model)

# Filtered state estimates (the hidden level at each time step)
out$att

# Forecast the next 10 periods
predict(fit$model, n.ahead = 10)
Ventajas y limitaciones de los modelos de espacio de estados
Como en la mayoría de marcos de modelado, los puntos fuertes y débiles vienen del mismo sitio: tienes que comprometerte con una estructura desde el principio.
Ventajas: representan de forma explícita los procesos ocultos en lugar de taparlos. Tratan de forma natural sistemas que cambian con el tiempo. La incertidumbre de medición está integrada en el modelo, no se deja para el final. Y el mismo marco permite filtrar, suavizar y predecir sin cambiar la estructura del modelo.
Limitaciones: especificar el modelo puede ser difícil. Debes decidir qué significa el estado oculto y cómo evoluciona, lo que exige criterio de dominio. Para sistemas no lineales o no gaussianos, la inferencia se encarece. Y si tus supuestos sobre la dinámica o el ruido son erróneos, las estimaciones también lo serán, y no siempre de forma evidente.
Conclusión
Un modelo de espacio de estados describe dos cosas: cómo evoluciona en el tiempo un estado no observado y cómo ese estado produce las observaciones que puedes medir. Esas son la ecuación de estado y la ecuación de observación. Todo lo demás (filtrado de Kalman, suavizado, predicción) trata de inferir el estado oculto a partir de los datos que genera el modelo.
Lo útil de este marco es que te obliga a explicitar lo que no sabes. En lugar de modelar directamente las observaciones (como hace ARIMA), te obliga a comprometerte con una historia sobre el proceso subyacente. Es una restricción, pero también una forma de aclarar las ideas. Una vez que escribes qué crees que es el estado oculto y cómo se mueve, el problema de inferencia se vuelve mecánico. Lo difícil ya era el modelado.
Si vienes de métodos clásicos de series temporales, merece la pena entender los modelos de espacio de estados por sí mismos y no solo como una generalización de lo que ya conoces. Nuestro curso de series temporales con Python cubre el conjunto de herramientas más amplio, y si tus próximos pasos son los modelos ocultos de Markov o el filtrado de Kalman, la base conceptual aquí te servirá directamente.