धुंध में चल रहे एक जहाज़ की कल्पना करें। GPS में शोर है, समुद्री धाराएँ अज्ञात हैं, और सटीक स्थिति सीधे मापी नहीं जा सकती। उसे केवल सेंसर रीडिंग्स से लगभग आँका जा सकता है। स्टेट स्पेस मॉडल ऐसे ही समस्याओं के लिए बनाए गए थे: ऐसे सिस्टम जहाँ आपकी रुचि की चीज़ छिपी होती है, और आपके पास उसके केवल अपूर्ण माप होते हैं।
यह लेख स्टेट स्पेस मॉडलों की संरचना, फ़िल्टरिंग और स्मूदिंग के जरिए छिपी अवस्थाओं का आकलन कैसे करें, Kalman फ़िल्टर की भूमिका क्या है, और इन मॉडलों को Python और R में कैसे लागू करें — इन सब पर केंद्रित है।
स्टेट स्पेस मॉडल क्या है?
स्टेट स्पेस मॉडल एक गणितीय ढाँचा है जो ऐसे सिस्टम का वर्णन करता है जो समय के साथ उन अवस्थाओं के माध्यम से बदलता है जिन्हें आप सीधे नहीं देख सकते। इसमें दो मात्राएँ होती हैं: स्टेट, जो किसी भी क्षण सिस्टम का वास्तविक आंतरिक विवरण है, और ऑब्जर्वेशन, जो वह शोरयुक्त, अप्रत्यक्ष माप है जो आपको वास्तव में मिलता है।
मॉडल दो बातों को निर्दिष्ट करता है: छिपी अवस्था एक समय-चरण से अगले में कैसे विकसित होती है, और वही छिपी अवस्था आपके देखे गए ऑब्जर्वेशनों को कैसे उत्पन्न करती है। यही विभाजन इस ढाँचे को इतना सार्वभौमिक बनाता है। यह सिग्नल प्रोसेसिंग, इकोनोमेट्रिक्स, कंट्रोल सिस्टम्स और मशीन लर्निंग में दिखता है — अक्सर बिना इस बात का भान हुए कि सब एक ही औपचारिक संरचना में काम कर रहे हैं।
स्टेट स्पेस मॉडल कैसे काम करते हैं
मुख्य तर्क हर समय-चरण पर एक सरल क्रम का अनुसरण करता है:
पिछली अवस्था → वर्तमान अवस्था → ऑब्जर्वेशन
सिस्टम अपनी पिछली छिपी अवस्था से नई अवस्था में जाता है। इस परिवर्तन में यादृच्छिकता शामिल हो सकती है, क्योंकि वास्तविक सिस्टम पूरी तरह पूर्वानुमेय नहीं होते। नई अवस्था एक अवलोकनीय मापन उत्पन्न करती है, जिसके अपने शोर होते हैं। आप अवस्था को कभी सीधे नहीं देखते; आप केवल उसका, अपूर्ण रूप से, उत्पन्न किया हुआ देखते हैं।
जो आप कर सकते हैं, वह है प्रत्येक नए ऑब्जर्वेशन का उपयोग करके छिपी अवस्था के अपने सर्वश्रेष्ठ अनुमान को अपडेट करना। यही इंफ़रेंस की समस्या है, और स्टेट स्पेस मॉडलों के आसपास की ज्यादातर एल्गोरिदमिक संरचना इसी को हल करने के लिए बनी है।
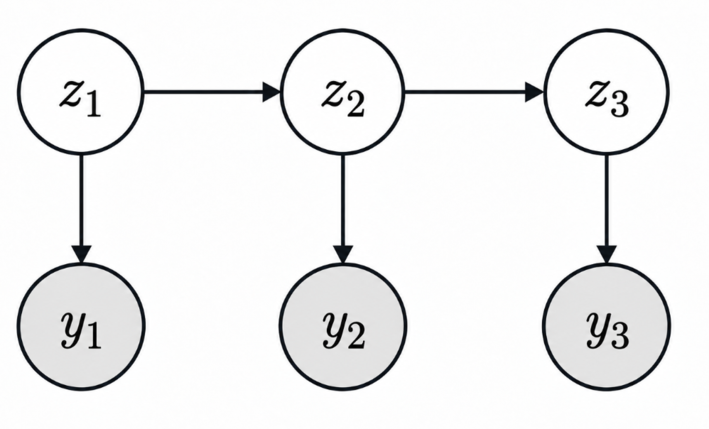
छिपी अवस्थाएँ समय के साथ शोरयुक्त ऑब्जर्वेशन उत्पन्न करती हैं। चित्र: लेखक द्वारा।
स्टेट और ऑब्जर्वेशन समीकरण
मॉडल की संरचना दो समीकरणों पर टिकती है। एक कि अवस्था कैसे चलती है, और दूसरा कि आप क्या माप सकते हैं।
स्टेट समीकरण
स्टेट समीकरण बताता है कि छिपी अवस्था कैसे विकसित होती है। स्केलर रूप में:
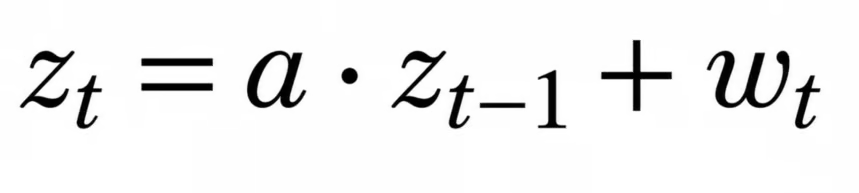
यहाँ zₜ वर्तमान छिपी अवस्था है, a संक्रमण गतिशीलता को दर्शाता है (पिछली अवस्था कितनी मज़बूती से आगे बढ़ती है), और wₜ प्रोसेस नॉइज़ है — यानी सिस्टम की चाल में मौजूद यादृच्छिकता। बहुविमीय सिस्टमों के मैट्रिक्स रूप में a एक ट्रांज़िशन मैट्रिक्स बन जाता है, पर विचार एक जैसा रहता है।
ऑब्जर्वेशन समीकरण
ऑब्जर्वेशन समीकरण छिपी अवस्था को आपके माप से जोड़ता है:
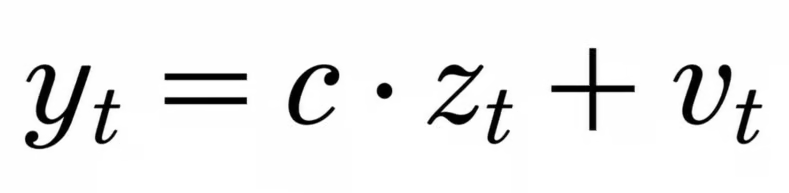
yₜ देखा गया मापन है, c ऑब्जर्वेशन संबंध को परिभाषित करता है, और vₜ मापन शोर है। ऐसी स्केलर अभिव्यक्तियों से शुरुआत करें, सामान्य मैट्रिक्स रूप की चिन्ता बाद में करें। मैट्रिक्स सामान्यता बढ़ाते हैं, विचार नहीं बदलते।
एक सरल स्टेट स्पेस मॉडल उदाहरण
एक सड़क पर चलती कार के बारे में सोचें। उसकी वास्तविक स्थिति और वेग छिपी अवस्था हैं। आप उन्हें सीधे नहीं देख सकते। आपके पास GPS रीडिंग है, जिसमें शोर होता है। स्टेट समीकरण यह मॉडल करता है कि समय-चरणों के बीच स्थिति और वेग कैसे बदलते हैं (कार लगभग समान गति से चलती रहती है)। ऑब्जर्वेशन समीकरण वास्तविक स्थिति को GPS रीडिंग से जोड़ता है, जो कई मीटर तक गलत हो सकती है।
इसका एक अच्छा विज़ुअलाइज़ेशन तीन रेखाएँ दिखाता है: वास्तविक स्थिति (स्मूद), GPS रीडिंग्स (सत्य के आसपास बिखरी हुई), और मॉडल से अनुमानित स्थिति (सत्य के क़रीब, कच्चे GPS से कुछ अधिक स्मूद)। वही तीसरी रेखा निकालना मॉडल का पूरा काम है।
अवस्थाओं का अनुमान कैसे लगाया जाता है
मॉडल परिभाषित करना केवल आधी समस्या है। आपको उन ऑब्जर्वेशनों से छिपी अवस्थाएँ निष्कर्षित भी करनी होती हैं जो आपके पास हैं। तीन कार्य इस दायरे को कवर करते हैं:
फ़िल्टरिंग केवल अभी तक के ऑब्जर्वेशनों का उपयोग करके वर्तमान अवस्था का अनुमान लगाती है — रीयल-टाइम इंफ़रेंस, ट्रैकिंग और कंट्रोल के लिए उपयोगी। स्मूदिंग उन अनुमानों को पहले और बाद के ऑब्जर्वेशनों का उपयोग करके वापस जाकर संशोधित करती है — सामान्यतः अधिक सटीक, पर पूर्ण अनुक्रम चाहिए। प्रेडिक्शन आगे extrapolate करके भविष्य की अवस्थाओं का अनुमान लगाती है, ऑब्जर्वेशन आने से पहले।
अधिकांश अनुप्रयोग फ़िल्टरिंग का उपयोग करते हैं। जब आप पूर्वव्यापी विश्लेषण कर रहे होते हैं और गति से अधिक सटीकता मायने रखती है, तब स्मूदिंग आती है।
Kalman फ़िल्टरिंग और स्टेट स्पेस मॉडल
Kalman फ़िल्टर रैखिक Gaussian स्टेट स्पेस मॉडलों में फ़िल्टरिंग के लिए एल्गोरिदम है। यहाँ सटीक होना उचित है: स्टेट स्पेस मॉडल मॉडल है; Kalman फ़िल्टर उन मॉडलों के एक विशेष वर्ग पर लागू होने वाली एक इंफ़रेंस विधि है।
फ़िल्टर दो वैकल्पिक चरणों में काम करता है। प्रेडिक्शन चरण में यह स्टेट समीकरण का उपयोग करके वर्तमान अनुमान को समय में आगे प्रोजेक्ट करता है, साथ ही उस अनुमान की अनिश्चितता का एक माप भी। अपडेट चरण में नया ऑब्जर्वेशन आता है और अनुमान सुधारा जाता है। बदलाव की मात्रा प्रेडिक्शन बनाम मापन की सापेक्ष अनिश्चितता पर निर्भर करती है। अगर मॉडल का प्रेडिक्शन भरोसेमंद है, तो ऑब्जर्वेशन का प्रभाव कम होगा। अगर GPS सिग्नल साफ़ है और मॉडल अनिश्चित है, तो ऑब्जर्वेशन हावी होगा। यही अनिश्चितता-भारित मिश्रण Kalman फ़िल्टर को व्यवहार में कारगर बनाता है।
गैर-रैखिक या गैर-Gaussian परिस्थितियों के लिए विस्तार मौजूद हैं: एक्सटेंडेड Kalman फ़िल्टर गतिशीलता का रैखिकीकरण करता है, अनसेंटेड Kalman फ़िल्टर अधिक चतुर approximation का उपयोग करता है, और पार्टिकल फ़िल्टर नमूनाकरण के जरिए पूर्ण सामान्य मामले को संभालते हैं। वे अलग लेखों के विषय हैं।
स्टेट स्पेस मॉडलों के प्रकार
यह ढाँचा इस पर निर्भर करते हुए कई परिदृश्यों को कवर करता है कि आप गतिशीलता और शोर के बारे में क्या मानने को तैयार हैं।
रैखिक Gaussian स्टेट स्पेस मॉडल शास्त्रीय परिदृश्य हैं: रैखिक ट्रांज़िशन और ऑब्जर्वेशन समीकरण, Gaussian शोर। Kalman फ़िल्टरिंग सीधे लागू होती है और सटीक इंफ़रेंस साध्य है।
गैर-रैखिक स्टेट स्पेस मॉडल तब आते हैं जब स्टेट ट्रांज़िशन या ऑब्जर्वेशन संबंध रैखिक नहीं होते — जैसे पेंडुलम, या ऐसा मॉडल जहाँ मूल्य प्रभाव धीरे-धीरे कम होते हैं। सटीक इंफ़रेंस अब उपलब्ध नहीं रहता।
गैर-Gaussian स्टेट स्पेस मॉडल यह मान्यता हटा देते हैं कि शोर सामान्य वितरण का अनुसरण करता है। काउंट डेटा, बाइनरी आउटकम्स, और हेवी-टेल्ड प्रक्रियाएँ यहाँ आती हैं।
स्टेट स्पेस मॉडल बनाम संबंधित टाइम-सीरीज़ मॉडल
कुछ तुलनाएँ साफ़-साफ़ करना उपयोगी है, क्योंकि यहाँ सीमाएँ पहली नज़र में लगने से अधिक धुंधली हैं।
स्टेट स्पेस मॉडल बनाम ARIMA
ARIMA देखे गए मानों और उनके पिछले त्रुटियों के संबंधों को सीधे मॉडल करता है, बिना किसी छिपी अवस्था को जोड़े। स्टेट स्पेस मॉडल स्पष्ट रूप से लैटेंट अवस्थाएँ लाते हैं। फिर भी, ARIMA मॉडलों को स्टेट स्पेस रूप में पुनःव्यक्त किया जा सकता है — इसलिए दोनों उतने अलग नहीं हैं जितना पहले लगता है, और सॉफ़्टवेयर अक्सर ARIMA को फ़िट करने के लिए अंदर ही अंदर स्टेट स्पेस प्रतिनिधित्व का उपयोग करता है।
स्टेट स्पेस मॉडल बनाम हिडन मार्कोव मॉडल
दोनों में छिपी अवस्थाएँ शामिल हैं। पारंपरिक HMMs विविक्त लैटेंट अवस्थाएँ उपयोग करते हैं (सिस्टम k मोड्स में से किसी एक में होता है), जबकि अधिकांश स्टेट स्पेस मॉडल सतत अवस्थाएँ उपयोग करते हैं। वॉइस रिकग्निशन के लिए विविक्त मोड्स समझ में आते हैं; भौतिक वस्तु के ट्रैकिंग के लिए सतत अवस्थाएँ स्वाभाविक हैं।
स्टेट स्पेस मॉडल बनाम स्ट्रक्चरल टाइम-सीरीज़ मॉडल
स्ट्रक्चरल टाइम-सीरीज़ मॉडल (जो किसी श्रेणी को ट्रेंड, सीज़नैलिटी, और अनियमित घटकों में विभाजित करते हैं) आमतौर पर स्टेट स्पेस के रूप में निरूपित किए जाते हैं, न कि उनके प्रतिद्वंद्वी के रूप में। वे इस ढाँचे का एक विशिष्ट उपयोग-प्रकरण हैं।
Python और R में स्टेट स्पेस मॉडल
वर्कफ़्लो दोनों भाषाओं में समान है — मॉडल परिभाषित करें, फ़िट करें, और छिपी अवस्थाओं के अनुमान निकालें।
Python में स्टेट स्पेस मॉडल
statsmodels लाइब्रेरी स्टेट स्पेस मॉडल फ़िट करने के लिए साफ़ इंटरफ़ेस देती है। यहाँ एक लोकल लेवल मॉडल (सबसे सरल स्ट्रक्चरल मॉडल, जिसमें रैंडम वॉक स्टेट और शोरयुक्त ऑब्जर्वेशन होते हैं) को कुछ टाइम-सीरीज़ डेटा पर फ़िट किया गया है:
import statsmodels.api as sm

# Fit a local level (random walk plus noise) model
model = sm.tsa.UnobservedComponents(time_series, level='local level')
result = model.fit(disp=False)

# Filtered state estimates (the hidden level at each time step)
print(result.filtered_state[0])

# Forecast the next 10 periods
forecast = result.forecast(10)
फ़िल्टर्ड स्टेट आपको हर समय-चरण पर छिपे लेवल का मॉडल का सर्वश्रेष्ठ अनुमान देता है। यही मुख्य आउटपुट मायने रखता है, न कि केवल पैरामीटर्स।
R में स्टेट स्पेस मॉडल
R में, KFAS पैकेज Gaussian स्टेट स्पेस मॉडलों को संभालता है और अगर आप इस क्षेत्र में नियमित रूप से काम करते हैं तो इसे जानना उपयोगी है। वर्कफ़्लो Python जैसा ही है: मॉडल ऑब्जेक्ट परिभाषित करें, फ़िट करें, और स्मूद या फ़िल्टर्ड अवस्थाएँ निकालें। केवल फ़िट आँकड़ों पर नहीं, छिपी अवस्था अनुमानों की व्याख्या करें।
library(KFAS)

# Fit a local level (random walk plus noise) model
model <- SSModel(time_series ~ SSMtrend(1, Q = NA), H = NA)
fit <- fitSSM(model, inits = c(log(1), log(1)))
out <- KFS(fit$model)

# Filtered state estimates (the hidden level at each time step)
out$att

# Forecast the next 10 periods
predict(fit$model, n.ahead = 10)
स्टेट स्पेस मॉडलों के लाभ और सीमाएँ
अधिकांश मॉडलिंग ढाँचों की तरह, ताकत और कमज़ोरियाँ एक ही जगह से आती हैं: आपको शुरुआत में ही एक संरचना पर सहमति बनानी होती है।
लाभ: ये छिपी प्रक्रियाओं को ढँकने के बजाय स्पष्ट रूप से दर्शाते हैं। ये स्वाभाविक रूप से समय के साथ बदलते सिस्टमों को संभालते हैं। मापन अनिश्चितता मॉडल में ही निहित होती है, बाद में जोड़ नहीं होती। और वही ढाँचा फ़िल्टरिंग, स्मूदिंग और फ़ोरकास्टिंग को सपोर्ट करता है, बिना मॉडल संरचना बदले।
सीमाएँ: मॉडल निर्दिष्ट करना कठिन हो सकता है। आपको तय करना होता है कि छिपी अवस्था का अर्थ क्या है और यह कैसे विकसित होती है — जिसके लिए वास्तविक डोमेन-सम्बंधी निर्णय चाहिए। गैर-रैखिक या गैर-Gaussian सिस्टमों के लिए इंफ़रेंस महँगा पड़ता है। और अगर आपने गतिशीलता या शोर के बारे में गलत मान्यताएँ बनाईं, तो अनुमान भी भ्रामक होंगे — और यह हमेशा स्पष्ट नहीं होगा।
निष्कर्ष
एक स्टेट स्पेस मॉडल दो बातों का वर्णन करता है: एक अनदेखी अवस्था समय के साथ कैसे विकसित होती है, और वही अवस्था वे ऑब्जर्वेशन कैसे उत्पन्न करती है जिन्हें आप माप सकते हैं। ये हैं स्टेट समीकरण और ऑब्जर्वेशन समीकरण। बाकी सब (Kalman फ़िल्टरिंग, स्मूदिंग, प्रेडिक्शन) डेटा से छिपी अवस्था का अनुमान लगाने से संबंधित है, जिसे मॉडल उत्पन्न करता है।
मुझे इस ढाँचे की जो बात उपयोगी लगती है, वह यह कि यह आपको स्पष्ट होने पर मजबूर करता है कि आपको क्या नहीं पता। ऑब्जर्वेशनों को सीधे मॉडल करने के बजाय (जैसा ARIMA करता है), आपको आंतरिक प्रक्रिया के बारे में एक कहानी पर प्रतिबद्ध होना पड़ता है। यह एक बंधन है, पर एक स्पष्टता भी। एक बार आपने लिख दिया कि छिपी अवस्था क्या है और वह कैसे चलती है, इंफ़रेंस समस्या यांत्रिक हो जाती है। कठिन भाग पहले ही — मॉडलिंग — था।
यदि आप शास्त्रीय टाइम-सीरीज़ विधियों से आ रहे हैं, तो स्टेट स्पेस मॉडलों को अपने आप में समझना फ़ायदेमंद है, न कि केवल उन चीज़ों के सामान्यीकरण के रूप में जो आप पहले से जानते हैं। हमारा Time Series with Python कोर्स व्यापक टूलकिट को कवर करता है, और अगर हिडन मार्कोव मॉडल या Kalman फ़िल्टरिंग आपका अगला पड़ाव है, तो यहाँ रखी गई वैचारिक नींव सीधे काम आएगी।
