courses
OpenAI API 활용하기
3
172.6K
완성된 오디오 파일을 전사 엔드포인트에 업로드하는 방식은 가장 쉬운 편입니다. 파일 전체를 기다렸다가 하나의 전사 결과를 받으면 되죠. 모델이 작업하는 동안 화면을 뚫어져라 볼 필요도 없습니다. 라이브 자막은 전혀 다른 일입니다. 아직 처리 중인 사이에도 오디오는 계속 들어오고, 발표자가 말하고 있는 동안에도 텍스트가 갱신되어야 합니다.
그 격차를 gpt-live-transcribe가 메워줍니다. OpenAI는 2026년 7월 28일에 이를 출시했고, 배치 처리용 모델 gpt-transcribe도 함께 공개했습니다. 이 튜토리얼에서는 이를 둘러싼 Python 자막 클라이언트를 만들고 세 가지 테스트를 진행합니다. 기본 스트리밍 클라이언트, 수용하는 컨텍스트 힌트 비교, 다섯 가지 지연 설정의 벤치마크입니다. 깔끔한 영어, 기술 용어, 이집트 아랍어-영어 코드 스위칭으로 테스트했는데, 이는 한 명의 깔끔한 내레이터보다 실제 회의에 더 가깝기 때문입니다.
마지막에는 작동하는 자막 앱을 갖추게 되고, 어떤 컨텍스트 설정이 실제로 도움이 되는지 감을 익히며, 찍어서 고른 게 아닌 합리적으로 선택한 지연 설정을 얻게 될 것입니다.
gpt-live-transcribe는 오디오가 들어오는 도중에도 전사 텍스트가 필요한 애플리케이션을 위한 스트리밍 음성-텍스트 변환 모델입니다. 오디오를 입력받아 텍스트만 반환하며, 네 가지 필드로 조정합니다. 지연을 위한 delay, 자유 형식 컨텍스트를 위한 prompt, 문자 그대로의 용어를 위한 keywords, 예상 입력 언어를 위한 languages입니다. OpenAI의 Context Aware ASR 벤치마크에서 자유 형식 컨텍스트는 의미 정확도를 38.5%에서 44.6%로 끌어올렸고, 그래서 테스트 2가 존재합니다.
이 모델은 별도 엔드포인트가 아니라 Realtime API 내부에서 동작하며, 이름과 달리 OpenAI의 음성 시스템인 GPT-Live와는 관련이 없습니다. 전사 세션을 열고 구성한 다음, 오디오를 보내는 연결을 통해 서버가 이벤트를 스트리밍해 돌려줍니다. 그 전에 먼저 정할 게 하나 있습니다. 둘 중 어떤 전사 모델이 실제로 필요한지입니다.
OpenAI가 권장하는 전사 모델은 두 가지가 있으며, 서로 대체 가능하지 않습니다. gpt-live-transcribe는 마이크, 통화, 미디어 스트림처럼 오디오가 연속해서 도착하고, 발표가 끝나기 전에 일부 텍스트가 필요한 경우에 씁니다. gpt-transcribe는 완료된 녹음 또는 의도적으로 턴 커밋을 기다리는 Realtime 세션에 적합합니다. 문서에서는 후자를 특별한 워크플로라고 부르며, 라이브 델타를 얻기 위한 방법은 아니라고 명시합니다.
많이들 헷갈리는 차이가 하나 있습니다. gpt-transcribe는 감지된 입력 언어를 담은 languages 배열을 반환하지만, gpt-live-transcribe는 그렇지 않습니다. 감지된 언어에 따라 분기하는 로직이 필요하다면, 데모에서 캡션이 아무리 좋아 보여도 잘못된 모델을 고른 것입니다. 가격도 같은 선에서 갈립니다. 배치 모델이 대략 4:1 정도 더 저렴하며, 이 부분은 뒤에서 다시 다룹니다.
앱의 절반을 만든 뒤에 알게 되는 것보다 지금 알려 드리는 편이 낫겠습니다. 단어 수준 타임스탬프, 화자 레이블, 신뢰도 점수, 발화 분리(diarization)가 없습니다. 자막 타이밍, 누가 말했는지 표시, 신뢰도 임계값이 필요하다면 OpenAI 가이드는 gpt-4o-transcribe-diarize 또는 whisper-1를 권합니다.
이 튜토리얼의 스크립트는 모두 github.com/KhalidAbdelaty/gpt-live-transcribe에 있으니 먼저 클론하세요. Python 3.10 이상과 Realtime 접근 권한이 있는 API 키가 필요합니다. 스크립트는 네 가지 패키지에 의존합니다. 연결을 위한 websockets , 마이크 캡처를 위한 sounddevice , 버퍼 변환을 위한 numpy , 키 로딩을 위한 python-dotenv입니다. 요구 사항 파일에는 차트와 브라우저 데모를 위한 몇 가지가 더 포함되어 있습니다.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
macOS에서는 sounddevice 가 OS 수준의 PortAudio(brew install portaudio)를 필요로 합니다. Linux에서는 apt-get install portaudio19-dev입니다. Windows라면 이 줄은 건너뛰세요. 저도 macOS에서 해당 이슈를 만났고, 실제 해결책은 그 한 줄 설치였습니다.
오디오는 24 kHz, 모노, 리틀 엔디언의 16비트 PCM으로 base64 인코딩되어야 합니다. MP3나 스테레오 WAV를 보내면 형식이 잘못되었다는 메시지는 오지 않고, 왜곡된 출력이 오거나 연결이 끊깁니다. 오후를 통째로 잡아먹을 수 있는 문제입니다. 다음으로는 어떤 연결로 오디오를 보낼지 결정해야 합니다.
OpenAI의 가이드는 명확합니다. 서버-서버 애플리케이션에는 WebSocket, 브라우저와 모바일 클라이언트에는 WebRTC입니다. 이 튜토리얼은 로컬 마이크를 읽는 Python 백엔드를 구축하므로 WebSocket이 맞습니다. 표준 API 키도 서버 밖으로 나가지 않으니 그대로 사용하면 됩니다.
세션은 type: "transcription"을 설정하고 모델로 gpt-live-transcribe를 선택하는 session.update 이벤트로 시작합니다. 페이로드의 나머지는 앞으로 보낼 오디오를 설명합니다. Realtime 전사 가이드의 최소 구성은 다음과 같습니다.
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None은 자동 음성 활동 감지를 비활성화합니다. 따라서 명시적으로 커밋하기 전까지는 아무 것도 확정되지 않습니다. 이후 세 가지 클라이언트 이벤트가 일을 처리합니다. input_audio_buffer.append가 base64 오디오 청크를 보내고, input_audio_buffer.commit이 턴을 끝내면, 서버는 conversation.item.input_audio_transcription.delta(부분 텍스트)와 conversation.item.input_audio_transcription.completed(최종 텍스트)로 응답합니다. 저는 wss://api.openai.com/v1/realtime?intent=transcription에 연결하는데, OpenAI 쿠크북의 패턴입니다. 가이드에는 이 쿼리 스트링이 문서화되어 있지 않으니, 작동이 중단되면 제거하세요.
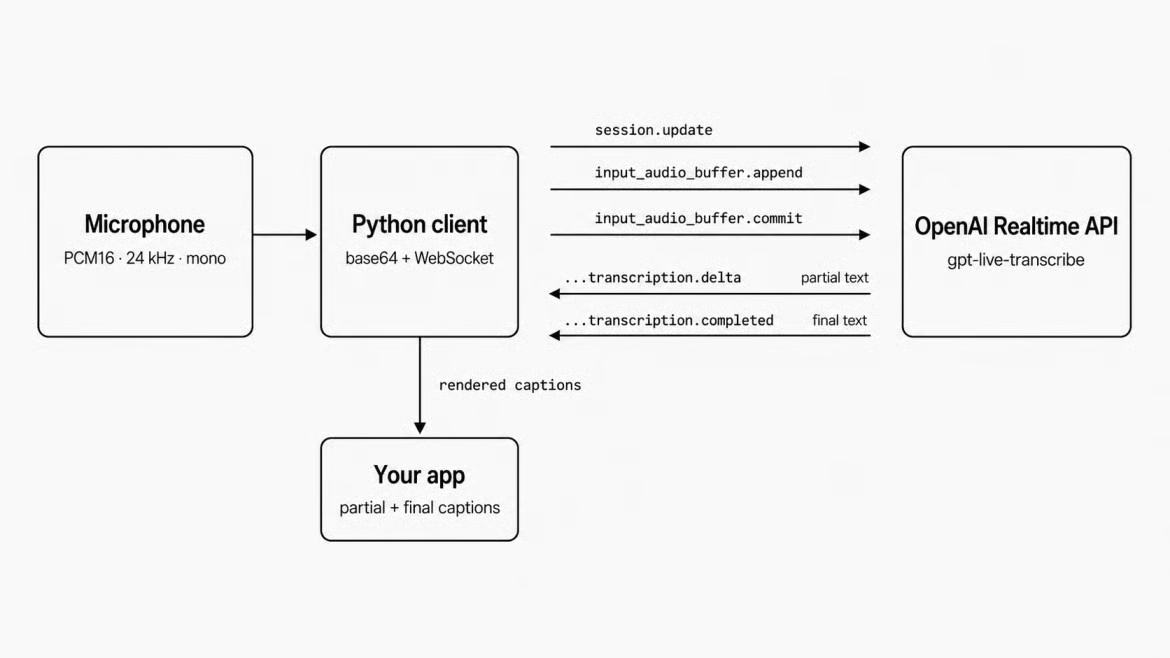
Realtime 전사 세션 이벤트 흐름 다이어그램. 이미지: 필자.
테스트 1은 작동하는 최소 버전입니다. 마이크 오디오를 캡처해 스트리밍하고, 도착하는 대로 부분 텍스트와 최종 텍스트를 출력합니다. 컨텍스트, 키워드, 어떤 튜닝도 없이 이벤트 흐름이 드러나게 둡니다. 첫 문제는 마이크 스레드를 멈추지 않고 오디오를 받아오는 것입니다.
sounddevice는 자체 스레드에서 콜백을 실행하며, 드라이버가 프레임을 버리기 전 몇 밀리초 내에 반환해야 하므로 네트워크 호출을 기다릴 수 없습니다. 할 일은 float32 버퍼를 PCM16으로 변환해 asyncio.Queue 로 loop.call_soon_threadsafe를 통해 던지고, 별도의 코루틴이 그 큐를 비우며 각 청크를 전송하는 것입니다.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
100밀리초 청크(24 kHz에서 2,400 샘플)는 합리적인 시작점입니다. 더 작게 하면 메시지당 오버헤드가 늘고, 더 크게 하면 자막이 느리게 느껴집니다. 정답은 문서화되어 있지 않으니 다이얼처럼 조정하세요.
델타는 저렴하고 자주 옵니다. 각 델타는 item_id에 묶인 텍스트 조각을 담습니다. 해당 항목의 기존 부분 텍스트 뒤에 덧붙이면 화면에서 단어별로 캡션이 자라납니다.
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
completed 이벤트는 같은 항목에 대한 최종 전사로 그 부분 텍스트를 대체합니다. completed를 진실의 원천으로, 델타는 미리보기로 다루고 직접 이어 붙이지 마세요.
이 디테일을 빼먹으면 UI가 깨집니다. OpenAI 가이드는 서로 다른 턴의 완료 이벤트 간 순서 보장이 없다고 명시합니다. 이전 턴의 completed가 나중 턴의 completed 뒤에 도착할 수 있어, 가장 최근에 온 completed가 최신 턴에 속한다고 가정하면 가끔 뒤로 점프하거나 줄이 복제됩니다. 대신 item_id를 키로 쓰세요. 제가 만든 TranscriptState가 그렇게 합니다.
이를 만들며 버그를 두 개 잡았는데, 둘 다 어떤 딕셔너리를 확인하느냐의 문제였습니다. 델타 핸들러에서만 item_id를 순서 리스트에 추가하면 full_transcript()가 completed 이벤트만 처리하는 수신자에게는 비어 있게 됩니다. 새 항목인지 판단할 때 부분 딕셔너리를 본 건 더 나빴습니다. apply_completed() 가 그 엔트리를 비우므로, 늦게 온 델타가 새 항목처럼 보여 순서 리스트에 두 번 올라가고 완성된 턴이 두 번 출력됐습니다. 양쪽 핸들러에서 item_id를 추적하고, 순서 리스트를 확인하세요.
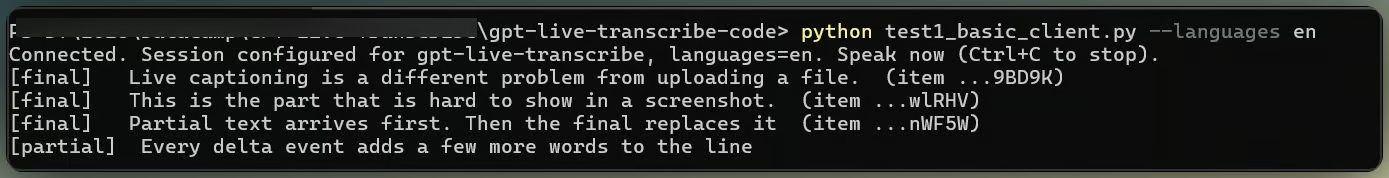
라이브 부분 자막이 전사로 확정. 이미지: 필자.
깔끔한 영어에서는 1~2초 내 텍스트가 나타났고, 구두점까지 제가 말한 대로 맞았습니다. 다만 노트북 마이크로 컨텍스트 없이 테스트하면, 모델이 확신이 없는 단어가 가끔 전혀 다른 문자 체계로 돌아오곤 했습니다. 그럴 때는 languages 필드를 설정하면 됩니다. 테스트 2가 다룹니다.
모델은 세 가지 유형의 컨텍스트를 받습니다. 테스트 전에 이를 명확히 해 두는 것이 좋습니다. prompt는 환경을 설명하는 자유 형식 텍스트, keywords는 오디오에 포함될 수 있는 문자 그대로의 용어, languages는 en, ar 같은 ISO 639-1 코드로 예상 입력 언어를 나열합니다. 어느 것도 출력을 강제하지 않습니다. 말하지 않은 키워드는 적었다고 해서 나타나지 않으며, 이 필드들이 실제로 하는 일을 알 수 있는 유일한 방법은 한 번에 하나씩 바꿔보는 것입니다.
같은 클립을 다섯 가지 구성으로, 각 세 번씩 돌렸습니다. 이런 비교를 공정하게 만드는 규칙은 두 가지입니다. 실행 간에는 컨텍스트 필드를 하나만 바꾸고, 모델은 동일 오디오에도 비결정적이므로 모든 구성을 여러 번 실행합니다.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
첫 버전에서는 결합 실행에서만 languages를 설정해 규칙을 깼습니다. 두 필드가 동시에 바뀌어 차이가 어디서 왔는지 알 수 없었죠. 또한 형식 규칙 하나 때문에 세션 업데이트가 거절되기도 했습니다. <, >, 캐리지 리턴, 줄바꿈이 포함된 키워드 하나만 있어도 전체 업데이트가 거절됩니다. TranscriptionConfig.validate_keywords()가 페이로드를 만들기 전에 이를 잡아줍니다.
예상 가능한 유형의 오디오에서 키워드는 도움이 됐습니다. 모든 실행에서 계정 번호는 오디오에 들린 대로 말로 전사되었습니다. 문제는 모델이 그 단어들을 식별자로 묶는지, 아니면 "A C forty-two"처럼 철자를 띄워 쓰는지였습니다.
열다섯 번 실행에서 분할은 분명했습니다. keywords가 없는 no_context, prompt_only, languages_only는 아홉 번 모두 "A C forty-two"를 반환했습니다. keywords가 있는 실행은 여섯 번 중 다섯 번에서 이를 묶었고, 대부분 완전한 형식의 "AC-42"로 나왔습니다. 따라서 keywords가 결과를 움직였고, prompt만으로는 전혀 그러지 않았습니다. 이는 모델이 잘못 해석할 수 있는 문자 그대로의 용어에 쓰는 필드라는 OpenAI의 설명과 일치합니다. 다만 키워드만으로도 한 번은 놓쳤으니, 모델이 따르는 규칙이라기보다 확률을 크게 기울이는 힌트로 보세요.
이는 제가 서두에 든 벤치마크 수치와 다소 어색하게 맞닿습니다. 자유 형식 컨텍스트가 의미 정확도를 6포인트 올렸다는 결과죠. 두 테스트는 측정 대상이 다릅니다. OpenAI는 광범위한 오디오에서 의미를 점수화했고, 저는 한 클립의 한 식별자를 지켜봤습니다. prompt가 문장 수준에서 실제로 역할을 하면서도, 제가 좁게 확인한 디테일을 건드리지 않을 수 있습니다. 여기서 그 징후는 prompt와 keywords를 함께 쓰면 매번 묶였고, keywords만 썼을 때는 한 번 놓쳤다는 정도, 즉 단 한 번의 차이였습니다.
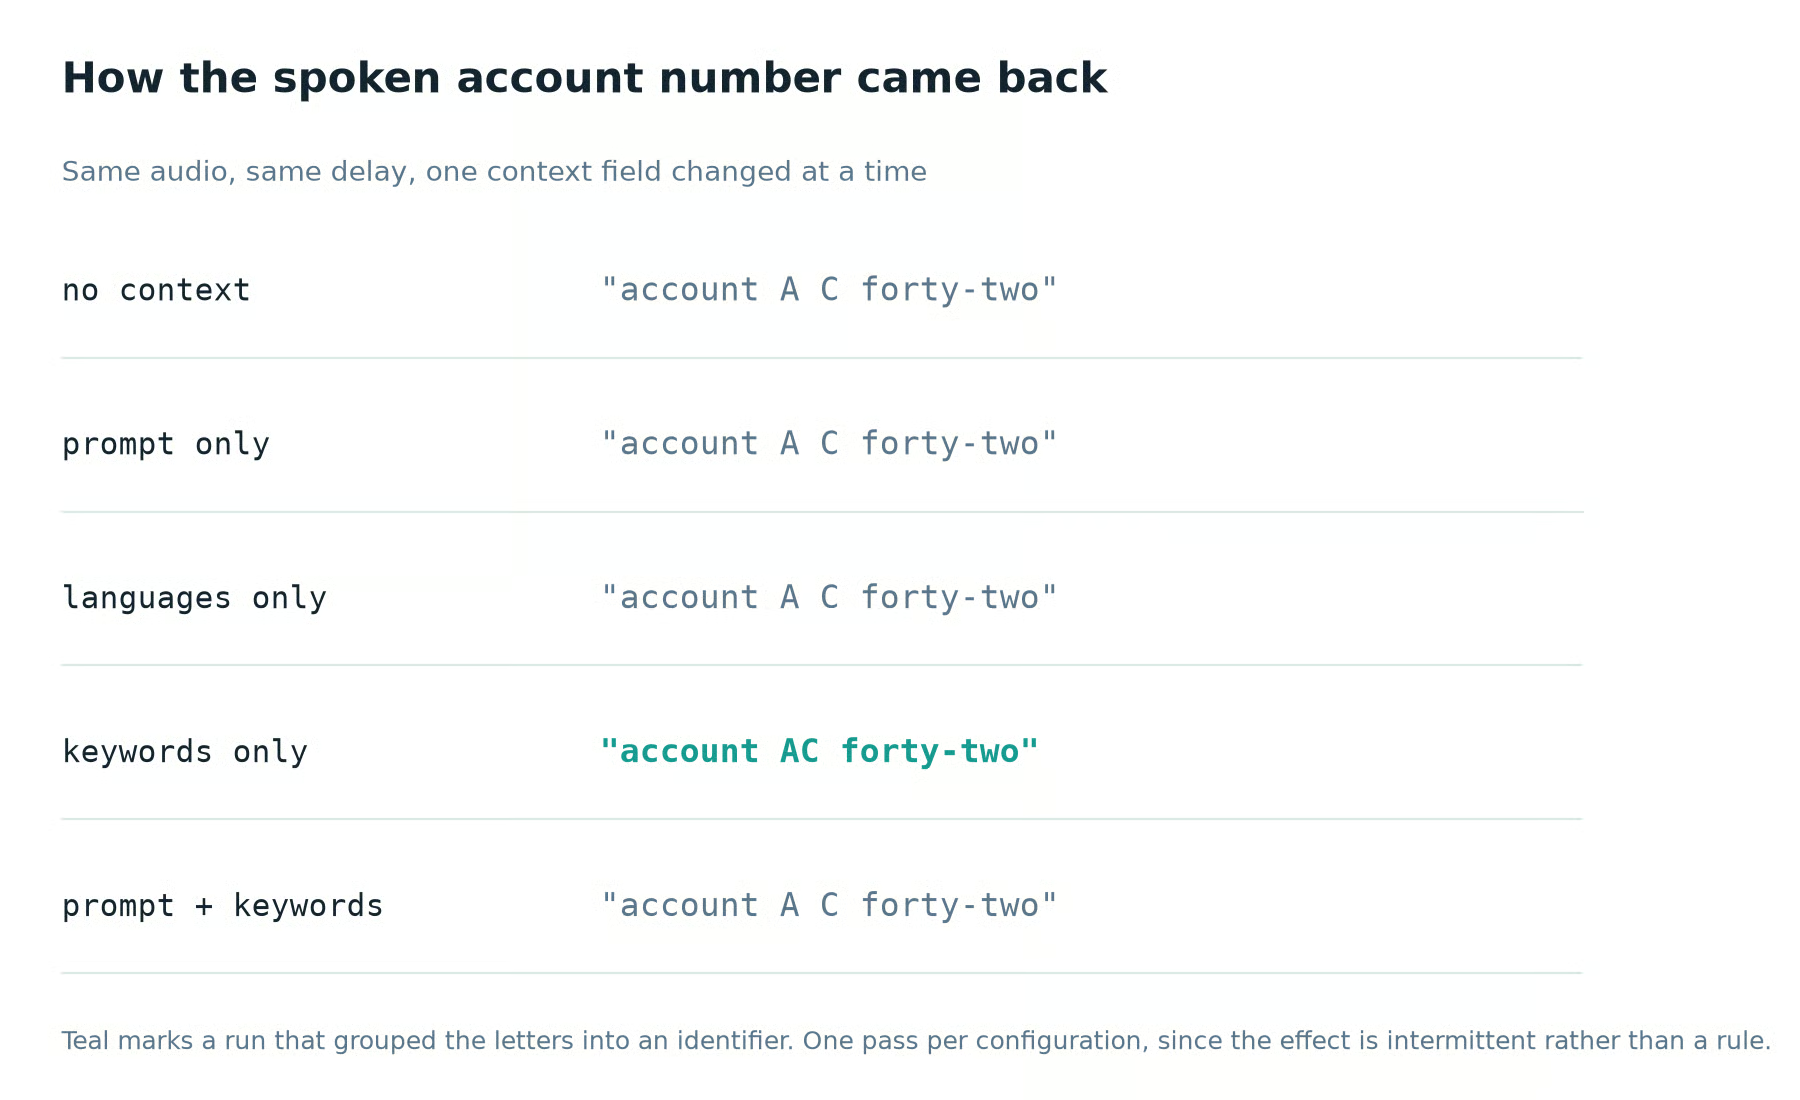
키워드만이 말로 된 식별자를 묶었습니다. 이미지: 필자.
언어 힌트는 예상치 못한 문제에서 더 분명히 도움을 줬습니다. 힌트 없이 코드 스위칭 클립을 돌리면, 시작부의 아랍어 메아리 말(대략 "타이이브")을 영어 "But"으로 듣고, 두 문자 체계를 하나의 깨진 단어로 섞곤 했습니다. 또 어떤 실행에서는 "billing statement"를 아랍 문자로 음차해 적고, 다른 실행에서는 라틴 문자로 남겨두기도 했습니다. languages: ["ar", "en"]를 추가하자 모든 실행에서 깨진 단어가 사라졌습니다. 다만 이는 한 클립의 결과이며, 문장 중간에 언어가 바뀌는 경우는 힌트가 드러나기 가장 쉬운 자리입니다.
delay는 minimal, low, medium, high, xhigh 다섯 값을 받습니다. 낮은 설정일수록 부분 텍스트가 더 빨리 나올 수 있습니다. 높은 설정은 모델이 텍스트에 확정하기 전 더 많은 오디오 컨텍스트를 확보하게 하므로, 어려운 오디오에서 정확도를 개선할 수 있습니다. OpenAI는 정확한 타이밍은 구성에 따라 달라지며 대표 오디오로 벤치마크하라고 명시합니다. 테스트 3이 바로 그 작업입니다.
test3_delay_benchmark.py는 같은 WAV 파일을 다섯 레벨 모두에, 각 여러 번씩 스트리밍하며 스트림 시작부터 첫 델타까지, 그리고 최종 전사까지의 시간을 기록합니다. 오디오, 컨텍스트 필드, 커밋 전략을 동일하게 유지하는 것이 비교를 의미 있게 만듭니다.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}이 수치는 보편적이지 않습니다. 하나의 클립, 하나의 네트워크, 어느 오후에 레벨당 세 번씩 실행해 얻은 값입니다. 첫 부분까지의 중앙값 시간은 minimal에서 0.70초, xhigh에서 2.91초였고, low(1.19초), medium(1.39초), high(2.09초)를 고르게 거쳐 올라갔습니다. 각 레벨의 세 번 실행은 서로 약 0.2초 이내에 모였으므로, 수치는 여러분과 다르더라도 순서는 안정적입니다.
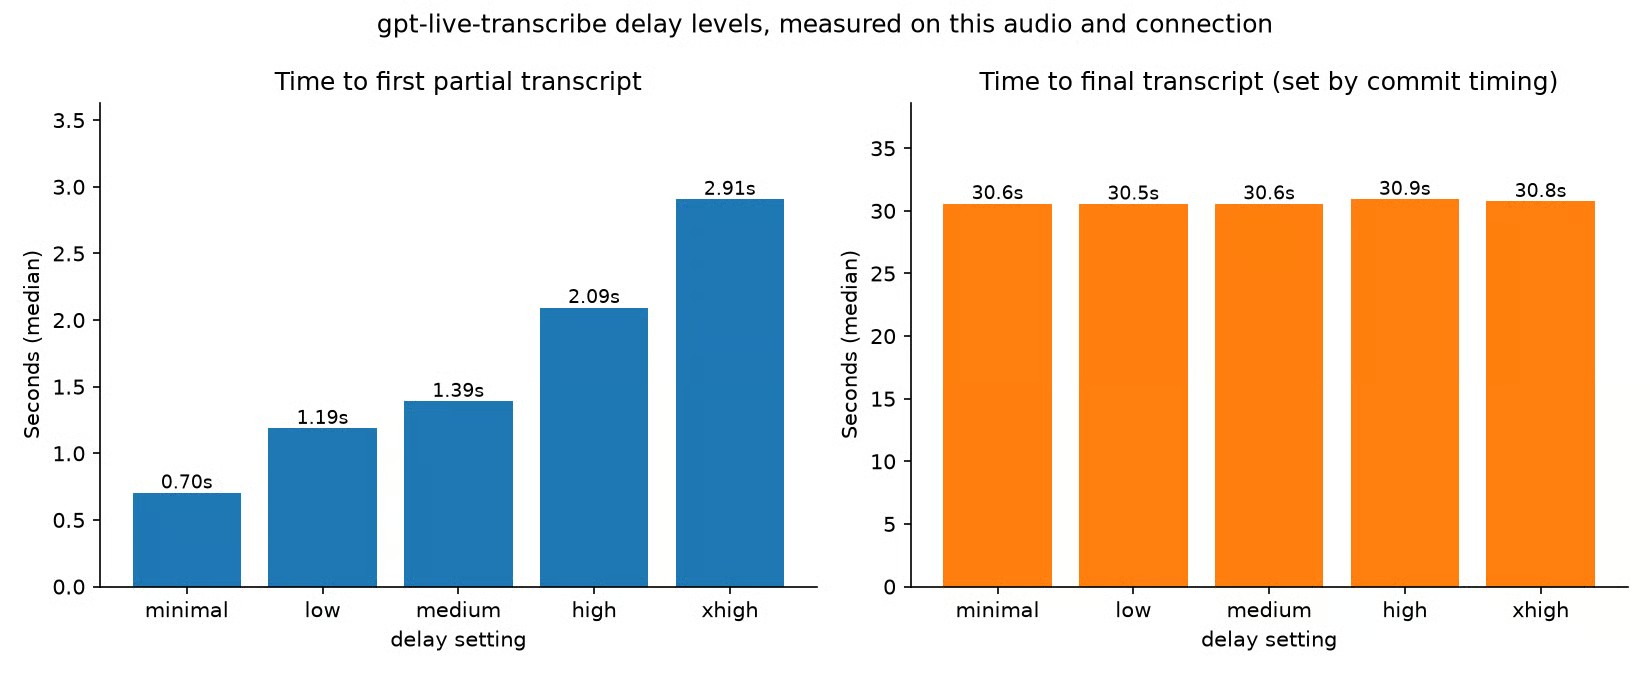
지연 레벨은 속도와 정확도를 맞바꿉니다. 이미지: 필자.
일반적인 가정, 즉 지연이 높을수록 수정이 줄어든다는 점은 확인하지 못했습니다. 델타 개수는 모든 레벨에서 84~86 사이였고, 추세가 보이지 않을 만큼 비슷했습니다. 최종까지의 시간도 어디서나 30.6초 전후 0.5초 이내로 모였는데, 이는 모델이 아니라 제 커밋 타이밍을 반영합니다. 그래서 차트가 두 측정을 패널로 나눈 것입니다. 한 축에서는 2초 차이가 막대의 10분의 1 높이에 묻힙니다.
사람이 말하는 동안 읽는 라이브 자막이라면 low부터 시작하세요. 텍스트가 나타나기까지 2초가 비면, 잠시 후 자막이 고쳐지는 것보다 더 고장난 느낌을 줍니다. 나중에나 읽는 회의 노트라면 high 또는 xhigh 로 가도 거의 비용이 없습니다. 음성 명령이라면 medium 쪽이 낫습니다. 두 단어 명령에서 한 단어가 틀리는 영향이 크기 때문입니다.
지금까지의 테스트는 모두 turn_detection: null 과 수동 커밋을 썼습니다. Realtime API는 대안으로 음성 활동 감지(VAD)를 제공하므로, 가정하지 말고 gpt-live-transcribe에 연결해 실제로 테스트해 봤습니다. 테스트가 실패했을 때 이 섹션을 뺄까 했지만, 실패 자체가 발견이었습니다.
server_vad는 침묵 구간을 기준으로 오디오를 분할하며, threshold, prefix_padding_ms, silence_duration_ms로 설정합니다. semantic_vad는 화자가 끝냈는지를 추정하는 분류기를 쓰며, eagerness가 얼마나 빨리 판단하는지 제어합니다.
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}이는 Realtime API 일반 문서에 설명된 두 모드입니다. 같은 페이로드를 gpt-live-transcribe 세션에 보내면 거절됩니다.
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}server_vad도 동일한 오류였습니다. 2026년 8월 4일 기준, 문서에서는 서버가 턴을 커밋하도록 VAD를 구성하라고 하지만, gpt-live-transcribe가 허용하는 턴 감지 모드는 수동 커밋뿐입니다. OpenAI가 아무 공지 없이 나중에 이 모델에 VAD를 켤 수도 있으니, 구축 전에 다시 테스트하세요.
푸시투토크는 쉬운 경우입니다. 누르고 떼는 동작이 이미 경계를 표시하니까요. 그 외에는 클라이언트가 턴 종료 시점을 결정해야 하고, 저의 첫 두 시도는 모두 틀렸습니다.
시도 1은 if not mic_queue.empty()로 커밋을 가드했습니다. 그럴듯하지만 절대 발동하지 않습니다. 그 큐를 비우는 코루틴이 마이크가 채우는 속도로 비우기 때문입니다. 부분 자막은 계속 흘러서 더 그럴듯했지만, 아무 것도 확정되지 않았습니다. 시도 2는 오디오가 추가된 상태에서 4초마다 커밋했습니다. 실제 마이크에서 결과는 이랬습니다.
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
두 가지 실패가 동시에 일어났습니다. 타이머가 단어 중간에서 문장을 잘랐고, 모델은 시작도 없는 조각을 "Abort"로 읽었습니다. 이어서 제가 말하지 않을 때도 커밋해, 마이크는 누가 말하든 청크를 스트리밍하므로 빈 전사가 돌아왔습니다.
둘 다 같은 누락된 정보, 즉 오디오 에너지에서 비롯됐습니다. mic_stream.py의 SpeechGate는 각 청크의 RMS 진폭을 추적하고, 화자가 무언가를 말한 뒤 조용해지면 커밋합니다. 단, 계속 말하는 경우에도 어딘가에서 끝나도록 상한을 둡니다. 첫 버전은 그 진폭을 고정 숫자와 비교했는데, 한 대에서는 잘 되고 다음 대에서는 다섯 배나 어긋났습니다. 그래서 지금은 방 소음을 추정하고, 그보다 몇 배 큰 소리를 음성으로 간주합니다. 거의 오디오가 없는 상태(기침이나 문 소리)로 턴이 끝나면, 커밋 대신 input_audio_buffer.clear로 보냅니다. 문이 무슨 말을 했는지 묻는 건 새로 만든 단어를 얻는 지름길입니다.
app.py 는 이 튜토리얼의 모든 요소를 하나의 터미널 애플리케이션으로 묶습니다. 마이크 캡처, 라이브 부분 자막, item_id로 키를 둔 전사 히스토리, 세션이 받는 모든 필드를 위한 CLI 플래그입니다.
python app.py --delay low --keywords "AC-42,premium plan" --languages en실제로 말하는 언어만 지정하세요. 같은 명령에서 영어에 en,ar를 추가하니, 영어 음성에서 "delta"가 아랍 문자로 음차되어 반환됐습니다. 테스트 2의 결과가 반대로 나타난 셈입니다.
--turn-detection은 기본이 manual이며, --silence-hold 와 --max-turn는 앞 섹션의 게이트를 조정합니다. VAD 모드는 API가 받아들이기 시작할 경우를 대비해 플래그로 남겨두었습니다. 전달하면 앱은 조용히 멈추지 않고 서버의 거절을 출력합니다.
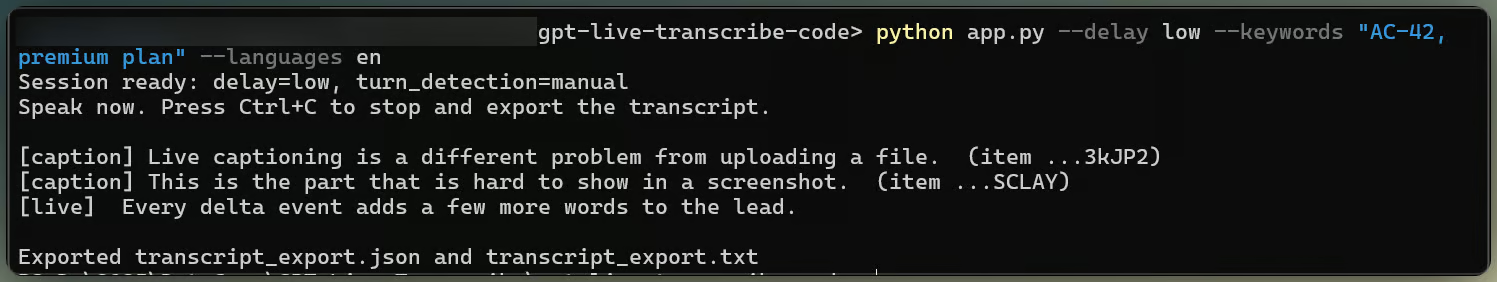
설정과 함께 실행 중인 완성형 자막 앱. 이미지: 필자.
종료 시에는 텍스트 전사와 JSON 파일을 씁니다. JSON에는 사용한 구성, 로컬에서 측정한 첫 델타까지의 시간, 각 최종 턴의 item_id가 담깁니다. 좋은 테스트 실행을 터미널을 닫으며 날린 뒤에 이 내보내기를 추가했습니다. 타임스탬프는 클라이언트 측이니, 여러분의 계측을 OpenAI 수치로 착각하지 마세요.
세 가지 테스트 모두 브라우저에서도 실행됩니다. demo_app.py는 Streamlit 버전으로, 실험별 탭이 하나씩 있습니다. 다만 메인 학습 경로라기보다 데모로 유지한 이유는 터미널 스크립트가 원시 이벤트를 더 직접적으로 보여주기 때문입니다.
streamlit run demo_app.pyDataCamp와 함께 배우기
courses
courses
courses