Course
Работа с OpenAI API
3 ч
172.6K
Загрузка готового аудиофайла на конечную точку для транскрипции — это простой вариант решения задачи. Вы дожидаетесь всего файла и получаете один транскрипт. Пока модель работает, никто не смотрит на экран. Живые субтитры — другое дело: аудио продолжает поступать, пока вы ещё решаете, что делать с полученным, и текст должен обновляться, пока говорящий всё ещё говорит.
Этот разрыв gpt-live-transcribe и закрывает. OpenAI выпустила его 28 июля 2026 года вместе с пакетным аналогом, gpt-transcribe. В этом руководстве я строю вокруг него клиент на Python для субтитров и провожу три теста: базовый потоковый клиент, сравнение вариантов контекстных подсказок и бенчмарк пяти уровней задержки. Я тестировал на чистом английском, с технической лексикой и на арабско-английском код-свитчинге (египетский арабский + английский), потому что это ближе к реальной встрече, чем один чистый диктор.
К концу у вас будут: рабочее приложение для субтитров, понимание того, какие настройки контекста действительно помогают, и настройка задержки, которую вы сможете обосновать, а не выбирать наугад.
gpt-live-transcribe — это потоковая модель распознавания речи для приложений, которым нужен текст транскрипта, пока аудио всё ещё поступает. Она принимает аудио и возвращает текст — и только текст — настраиваемый четырьмя полями: delay для латентности, prompt для свободного контекста, keywords для буквальных терминов и languages для ожидаемых языков входа. На бенчмарке OpenAI Context Aware ASR свободный контекст повысил семантическую точность с 38,5 процента до 44,6 процента — именно поэтому существует Тест 2.
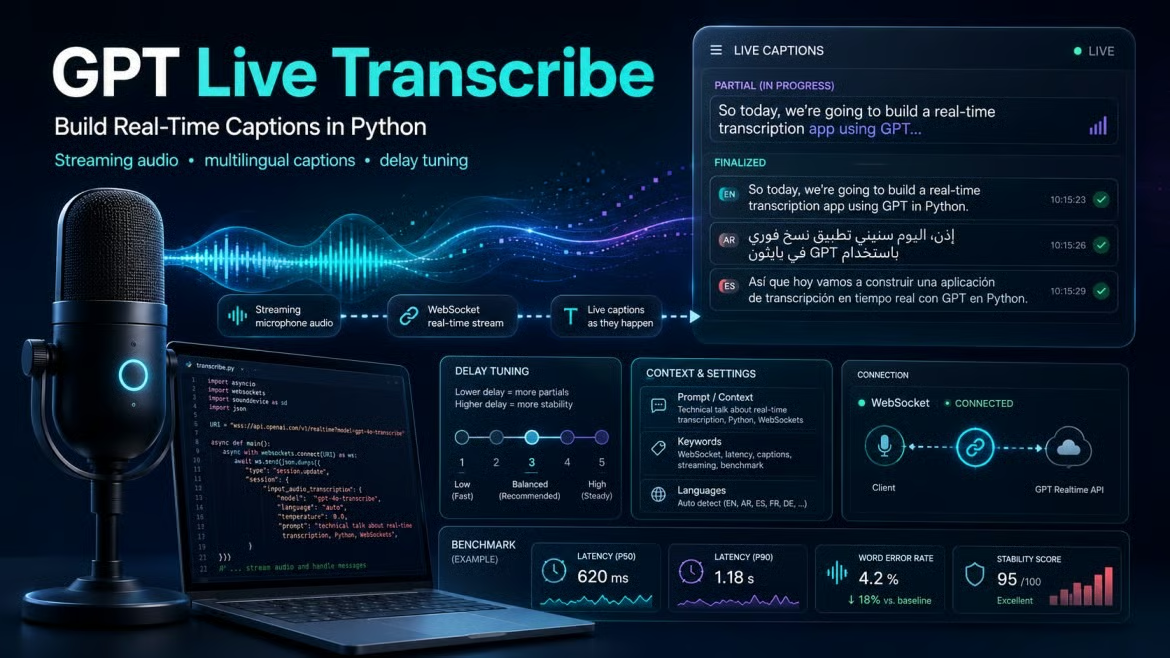
Модель работает внутри Realtime API, а не как отдельная конечная точка, и не связана с GPT-Live, голосовой системой OpenAI, несмотря на схожие названия. Вы открываете сессию транскрипции, настраиваете её, и сервер стримит события по тому же соединению, по которому вы отправляете аудио. Прежде чем идти дальше, нужно ответить на один вопрос: какая из двух моделей транскрипции вам действительно нужна.
OpenAI предлагает две рекомендованные модели транскрипции, и они не взаимозаменяемы. gpt-live-transcribe — для непрерывно поступающего аудио: микрофон, телефонный звонок, медиапоток, где нужен частичный текст до того, как говорящий закончит. gpt-transcribe — для завершённых записей или Realtime-сессии, где вы намеренно ждёте зафиксированный «ход». В документации второй случай назван специализированным процессом, а не способом получить живые дельты.
Есть один нюанс, на котором многие спотыкаются: gpt-transcribe возвращает массив languages с обнаруженным языком входа, gpt-live-transcribe — нет. Если ваша логика ветвится по обнаруженному языку, вы тянетесь не к той модели, как бы ни хороши её субтитры на демо. Цены делятся по той же линии, примерно четыре к одному в пользу пакетной модели — к этому я вернусь ниже.
Лучше сказать это сейчас, чем после того, как вы построите половину приложения. Нет пометок времени на уровне слов, нет меток говорящих, нет оценок уверенности и нет диаризации. Если вам нужна разметка таймингов для субтитров, заметки с указанием, кто говорил, или порог уверенности, в руководстве OpenAI предлагается использовать gpt-4o-transcribe-diarize или whisper-1.
Все скрипты из этого руководства находятся в github.com/KhalidAbdelaty/gpt-live-transcribe, начните с клонирования. Нужен Python 3.10+ и ключ API с доступом к Realtime. Сами скрипты опираются на четыре пакета: websockets для соединения, sounddevice для захвата с микрофона, numpy для преобразования буфера и python-dotenv для загрузки ключа. Файл требований добавляет ещё несколько пакетов для графиков и демо в браузере.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
На macOS sounddevice нужен PortAudio на уровне ОС (brew install portaudio); на Linux — apt-get install portaudio19-dev. Если вы на Windows — пропустите. Я сам столкнулся с этим на macOS, и действительно помогает одна эта установка.
Само аудио должно приходить как 16-битный PCM на 24 кГц, моно, little-endian, в base64. Если отправить MP3 или стерео WAV, вы получите «кашу» или разрыв соединения — но не сообщение о неправильном формате. На это легко убить полдня. Далее — какой тип соединения передаёт аудио.
Рекомендации OpenAI просты: WebSocket для сервер‑серверных приложений, WebRTC — для браузера и мобильных клиентов. В этом руководстве мы строим Python-бэкенд, читающий локальный микрофон, так что WebSocket — верный выбор, и стандартный API-ключ подходит, так как он не покидает ваш сервер.
Сессия начинается событием session.update, которое задаёт type: "transcription" и выбирает gpt-live-transcribe в качестве модели. Всё остальное в полезной нагрузке описывает аудио, которое вы собираетесь отправлять. Вот минимальная конфигурация из руководства по Realtime-транскрипции:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None отключает автоматическое определение голосовой активности, поэтому ничего не финализируется, пока вы явно не зафиксируете ход. Далее три клиентских события делают работу: input_audio_buffer.append отправляет base64‑чанк аудио, input_audio_buffer.commit завершает ход, а сервер отвечает conversation.item.input_audio_transcription.delta (частичный текст) и conversation.item.input_audio_transcription.completed (финальный текст). Я подключаюсь к wss://api.openai.com/v1/realtime?intent=transcription — это паттерн из кулинарной книги OpenAI; в руководстве эта строка запроса не документирована, так что уберите её, если когда‑нибудь перестанет работать.
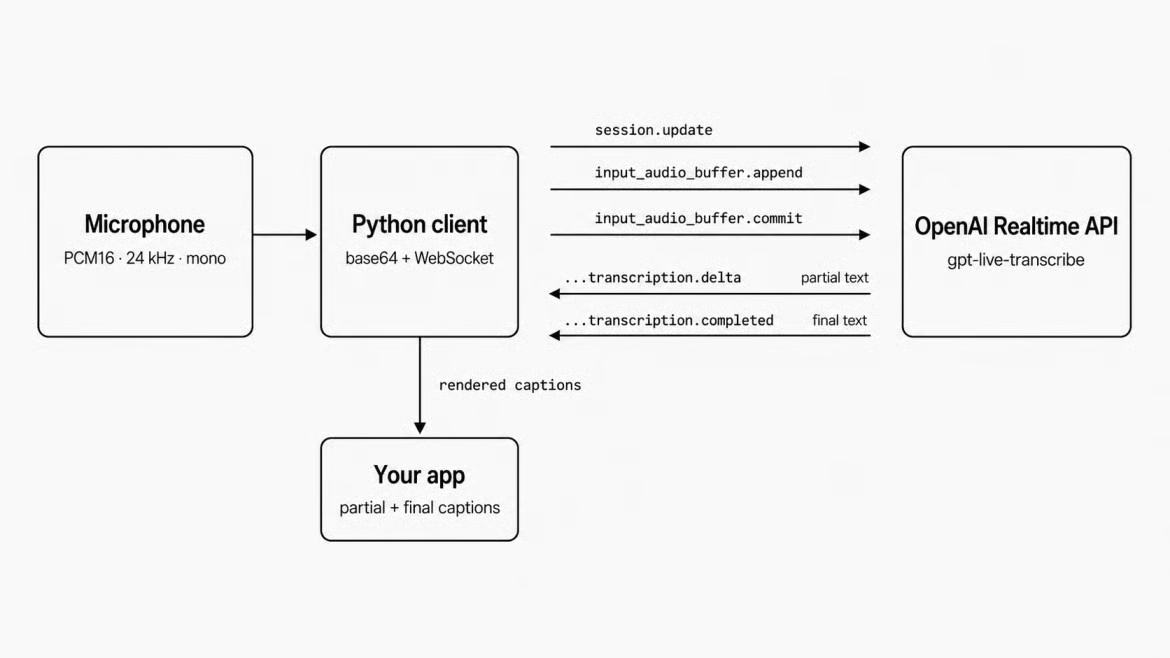
Диаграмма потока событий сессии транскрипции Realtime. Изображение автора.
Тест 1 — минимально работоспособная версия: захват аудио с микрофона, потоковая передача, печать частичного и финального текста по мере поступления. Без контекста, без ключевых слов, без тонкой настройки — чтобы оставался видимым сам поток событий. Первая задача — снять аудио с потока микрофона, не блокируя его.
sounddevice запускает колбэк в собственном потоке, у которого есть несколько миллисекунд на возврат, иначе драйвер теряет кадры — значит, он не может ждать сетевой вызов. Его единственная задача — преобразовать буфер float32 в PCM16 и положить его в asyncio.Queue через loop.call_soon_threadsafe, а отдельная корутина опустошает эту очередь и отправляет каждый чанк.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Чанк в 100 миллисекунд (2 400 сэмплов при 24 кГц) — разумная отправная точка. Меньше — больше накладных расходов на сообщение; гораздо больше — субтитры ощущаются «тормозными». Документированного «правильного» числа нет, воспринимайте это как ручку настройки.
Дельты приходят часто и «дёшево». Каждая несёт кусок текста, привязанный к item_id. Добавляйте её к уже имеющемуся частичному тексту для этого элемента — и подпись растёт на экране слово за словом:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Событие completed заменяет этот частичный текст финализированным транскриптом для того же элемента. Считайте completed источником истины, а дельты — предпросмотром, а не чем‑то, что нужно склеивать самому.
Вот деталь, которая сломает ваш интерфейс, если её упустить: в руководстве OpenAI сказано, что порядок завершений между разными ходами не гарантирован. Событие completed для более раннего хода может прийти после события для более позднего, поэтому код, который предполагает, что последнее completed относится к последнему ходу, время от времени будет «возвращаться назад» или дублировать строку. Привязывайтесь к item_id — именно это делает мой класс TranscriptState.
При его сборке я поймал две ошибки — обе из‑за того, какой словарь проверялся. Добавлять item_id в список порядка только в обработчике дельт оставляло full_transcript() пустым для любого получателя, обрабатывающего только события completed. Использовать словарь partials для решения, новый ли элемент, — ещё хуже: apply_completed() очищает эту запись, поэтому запоздалая дельта выглядела «новой», попадала в список порядка во второй раз и печатала завершённый ход дважды. Отслеживайте item_id в обоих обработчиках и проверяйте именно список порядка.
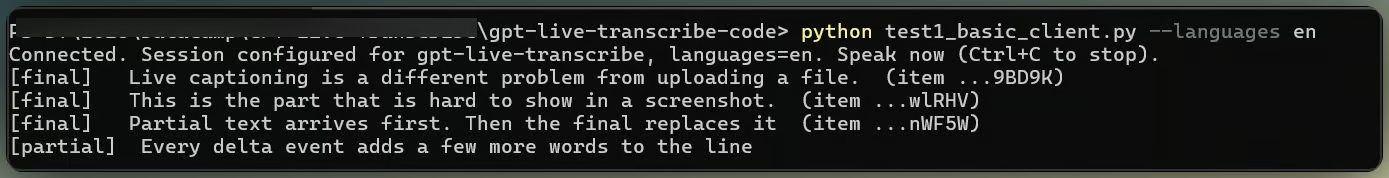
Живые частичные подписи, переходящие в транскрипт. Изображение автора.
На чистом английском текст появлялся через секунду‑две и соответствовал сказанному, включая пунктуацию. Но через микрофон ноутбука и без контекста иногда слово, в котором модель сомневалась, возвращалось вообще в другом алфавите. Для этого есть поле languages — его мы изучаем в Тесте 2.
Модель принимает три вида контекста — стоит точно их различать перед тестированием. prompt — свободный текст, описывающий обстановку, keywords — буквальные термины, которые могут звучать в аудио, а languages перечисляет ожидаемые языки входа как коды ISO 639‑1, например en или ar. Ни одно из них не навязывает вывод. Ключевое слово, которого не было в речи, не появится лишь потому, что вы его перечислили, и единственный способ понять, что делают эти поля на деле, — менять по одному за раз.
Я прогнал один и тот же клип через пять конфигураций, по три прогона каждая. Два правила сохраняют честность такого сравнения: между запусками меняется только одно контекстное поле, и каждая конфигурация запускается больше одного раза, потому что модель недетерминистична даже на идентичном аудио.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
В первой версии я задал languages только в комбинированном прогоне — это нарушило первое правило: менялись сразу два поля, значит, любая разница могла быть вызвана любым из них. Ещё одно форматное правило стоило мне отклонённого обновления сессии: ключевое слово, содержащее <, >, возврат каретки или перевод строки, отвергает всё обновление, а не только это слово. TranscriptionConfig.validate_keywords() ловит это до формирования полезной нагрузки.
Ключевые слова помогли там, где вы и ожидаете. На каждом прогоне номер счёта распознавался как произнесённые слова — ведь это и есть в аудио. Вопрос был в том, сгруппирует ли модель эти слова в идентификатор или пропишет по буквам как «A C сорок два».
На пятнадцати прогонах расклад оказался резким. Без keywords это не группировалось ни разу: no_context, prompt_only и languages_only возвращали «A C сорок два» во всех девяти проходах. Запуски с keywords сгруппировали в пяти из шести, чаще всего в полностью оформленное «AC-42». Значит, keywords изменили результат, а один лишь prompt — нет, что совпадает с подачей OpenAI, где keywords — поле для буквальных терминов, которые модель может распарсить неверно. Ключевые слова один раз всё же промахнулись, так что относитесь к ним как к подсказке, сильно смещающей шансы, а не к правилу, которому модель обязана следовать.
Это соседствует с цифрой из вступления, где свободная подсказка повысила семантическую точность на шесть пунктов. Тесты измеряют разное: OpenAI оценивала смысл на широком наборе аудио, а я смотрел на один идентификатор в одном клипе. prompt может делать реальную работу на уровне предложения и при этом не затронуть узкую деталь, на которую вы смотрите. Единственный признак здесь — что вместе prompt и keywords группировали всегда, тогда как одни keywords один раз промахнулись — разница в один прогон.
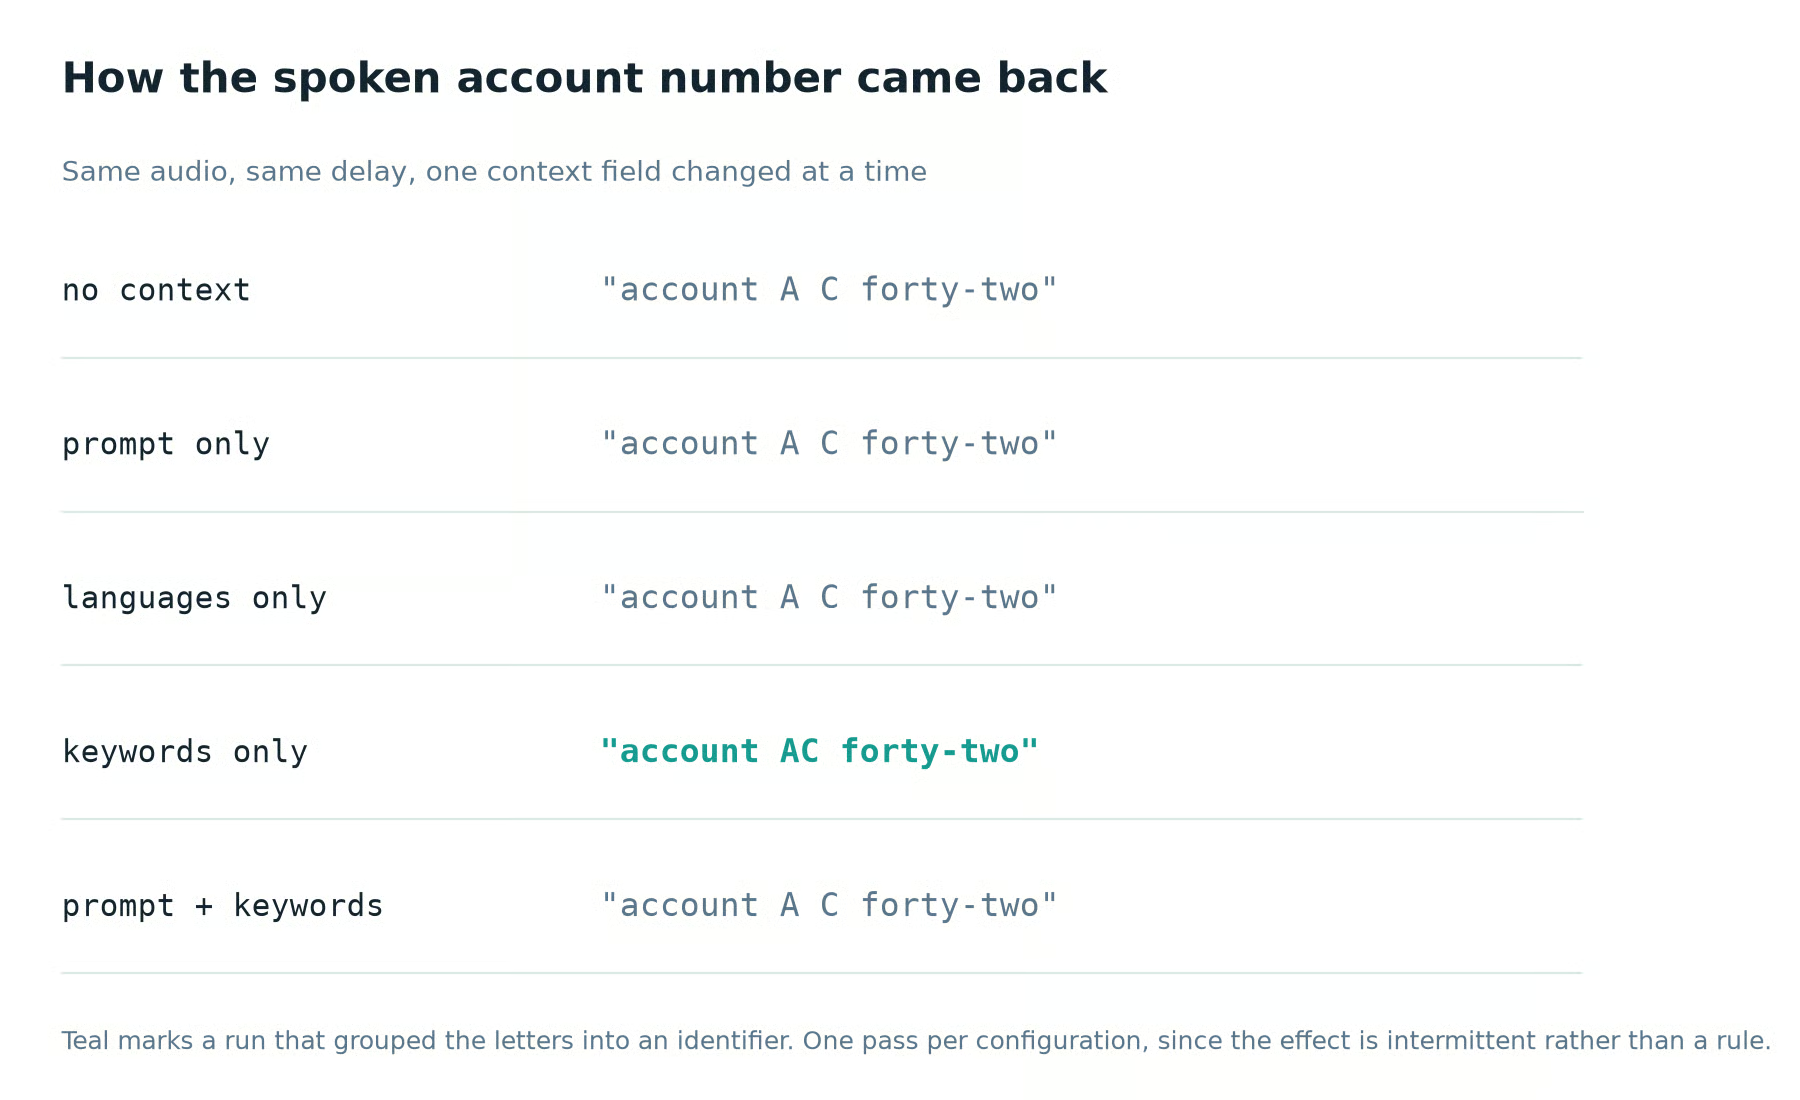
Только ключевые слова сгруппировали произнесённый идентификатор. Изображение автора.
Языковые подсказки помогли нагляднее — и в неожиданном месте. Без подсказки прогоны на клипе с код‑свитчингом слышали начальное арабское слово-вставку, примерно «таййиб», как английское «But» и сливались в один «сломанный» токен двух письменностей. Ещё «billing statement» то записывалось фонетически арабской вязью, то оставалось латиницей. Добавление languages: ["ar", "en"] устранило «сломанное» слово во всех проходах. Но это один клип, и предложение с переключением языка посередине — самое удобное место, где подсказка себя проявит.
delay принимает пять значений: minimal, low, medium, high и xhigh. Более низкие уровни могут давать частичный текст раньше. Более высокие — дают модели больше контекста аудио до фиксации текста, что может повысить точность на «тяжёлом» аудио. OpenAI прямо говорит, что точные тайминги зависят от конфигурации и их нужно бенчмаркать на представительном аудио — этим и занимается Тест 3.
test3_delay_benchmark.py стримит один и тот же WAV через все пять уровней, по несколько прогонов каждый, логируя время от старта стрима до первой дельты и до финального транскрипта. Сохранение одинаковыми аудио, контекстных полей и стратегии коммита и делает сравнение осмысленным.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Эти цифры не универсальны. Мои — это три прогона на уровень, один клип, одна сеть, один день. Медианное время до первой дельты — от 0,70 секунды на minimal до 2,91 секунды на xhigh, растя равномерно через low (1,19 c), medium (1,39 c) и high (2,09 c). Три прогона на каждом уровне уложились в примерно 0,2 секунды друг от друга, так что порядок стабилен, даже если сами числа будут у вас иными.
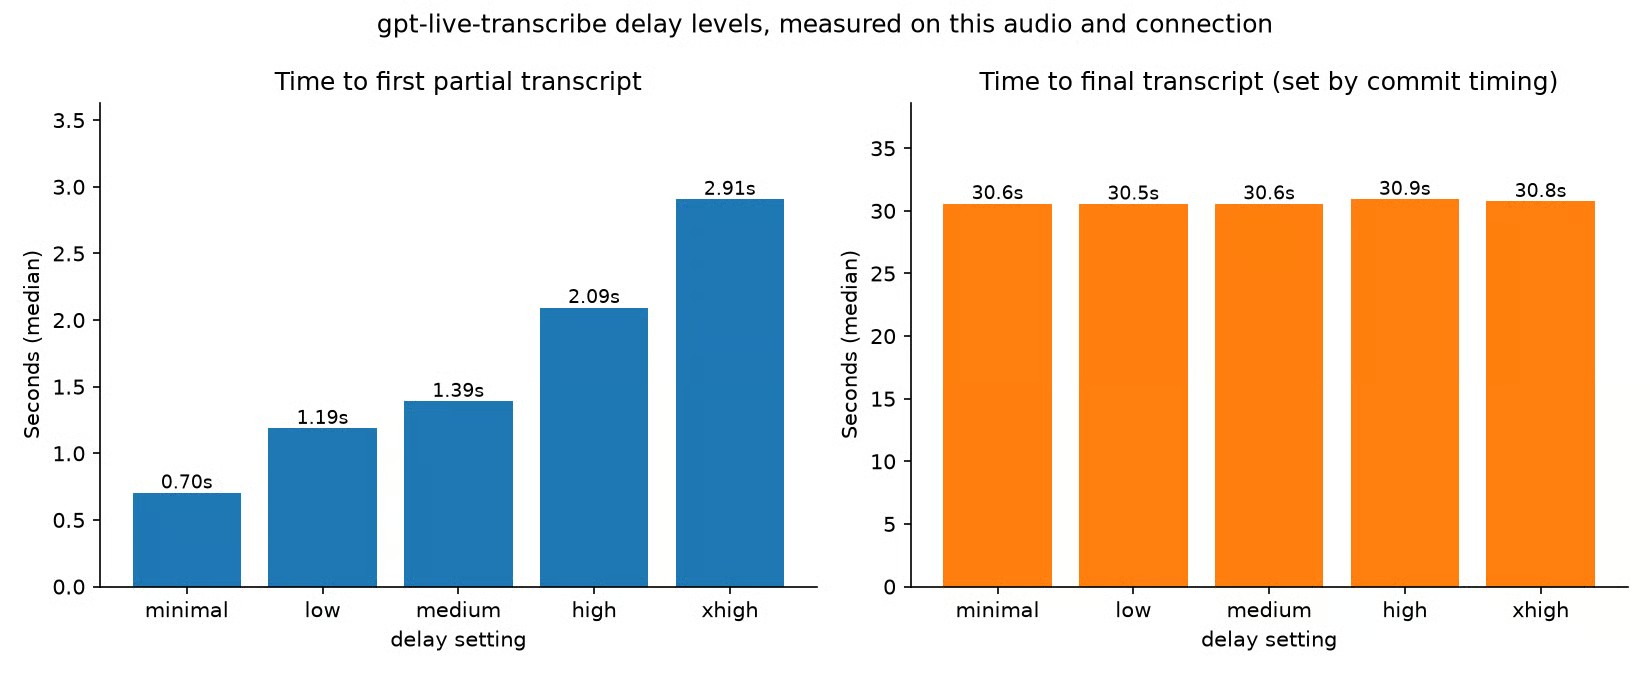
Уровни задержки обменивают скорость на точность. Изображение автора.
Подтвердить типичное предположение, что большая задержка даёт меньше правок, мне не удалось. Число дельт колебалось между 84 и 86 на каждом уровне — почти идентично, тренда не видно. Время до финала везде было в пределах полутора секунд от 30,6 секунды — но это отражает мою стратегию коммита, а не модель. Поэтому на графике два показателя разведены по панелям: на одной оси разброс в две секунды теряется под столбцами в десять раз выше.
Для живых субтитров, которые читают, пока человек говорит, начните с low. Ожидание две секунды до появления любого текста воспринимается как «сломано» сильнее, чем подпись, поправленная мгновением позже. Для заметок встречи, которые никто не читает сразу, high или xhigh почти ничего не стоит. Для голосовых команд тянитесь к medium: ошибочное слово в двухсловной команде критичнее обычного.
Все тесты до сих пор использовали turn_detection: null и ручной коммит. Realtime API предлагает определение голосовой активности как альтернативу, так что я подключил его к gpt-live-transcribe, а не стал предполагать, что «и так сработает». Я чуть не выкинул этот раздел, когда тест провалился. Потом выяснилось, что провал — это и есть находка.
server_vad бьёт аудио на куски по периодам тишины, настраиваемым через threshold, prefix_padding_ms и silence_duration_ms. semantic_vad использует классификатор, который оценивает, «закончил ли» говорящий, с параметром eagerness, управляющим тем, как быстро он решает:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Так обе модели задокументированы для Realtime API в целом. Отправленное в сессию gpt-live-transcribe это же полезное сообщение возвращается с отказом:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad вернул ту же ошибку. По состоянию на 4 августа 2026 года ручной коммит — единственный режим «определения ходов», который принимает gpt-live-transcribe, хотя руководство по транскрипции всё ещё советует настроить VAD, чтобы сервер фиксировал ходы за вас. Перепроверьте перед тем, как строить вокруг этого, потому что OpenAI может включить VAD для этой модели позже, не уведомив никого.
Push‑to‑talk — простой случай: нажатие и отпуск уже размечают границы. Всё остальное оставляет клиенту решение, когда ход закончился, и мои две первые попытки обе были неверны.
Попытка первая ставила коммит под охрану условия if not mic_queue.empty() — звучит разумно, но не срабатывает: корутина, опустошающая очередь, делает это так же быстро, как микрофон её наполняет. Частичные подписи продолжали идти — что и убеждало, — но ничего не финализировалось. Попытка вторая коммитила каждые четыре секунды, пока добавлялось аудио. На реальном микрофоне это дало следующее:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Две ошибки сразу. Таймер разрезал предложение посреди слова, и модель прочитала фрагмент, начинающийся ниоткуда, как «Abort». Затем он зафиксировал ход, когда я не говорил, и вернул пустой транскрипт — потому что микрофон стримит чанки, даже если никто не говорит.
Обе проблемы из‑за одного отсутствующего сигнала: энергии аудио. SpeechGate в mic_stream.py отслеживает RMS‑амплитуду каждого чанка и делает коммит, когда говорящий что‑то сказал и затем замолчал — с ограничением, чтобы непрерывная речь всё же где‑то завершалась. В первой версии я сравнивал эту амплитуду с фиксированным числом — это сработало на одной машине и оказалось в пять раз неверно на следующей. Теперь скрипт оценивает «шум комнаты» и считает речью всё, что в несколько раз громче. Ход, завершающийся на почти отсутствии аудио — кашель, хлопок дверью — уходит в input_audio_buffer.clear, а не в коммит: спрашивать модель, что сказала дверь, — прямой путь к выдуманному слову.
app.py собирает все части этого руководства в одно терминальное приложение: захват микрофона, живые частичные подписи, историю транскриптов, привязанную к item_id, и флаги CLI для каждого поля, которое принимает сессия.
python app.py --delay low --keywords "AC-42,premium plan" --languages enУказывайте только те языки, на которых вы действительно говорите. Та же команда с en,ar на английской речи вернула слово «delta», транслитерированное арабской вязью — это находка Теста 2 «в другую сторону».
--turn-detection по умолчанию manual, а --silence-hold и --max-turn настраивают «ворота» из предыдущего раздела. Режимы VAD оставлены флагами на случай, если API начнёт их принимать; передайте любой — и приложение выведет отказ сервера, вместо того чтобы «молчаливо виснуть».
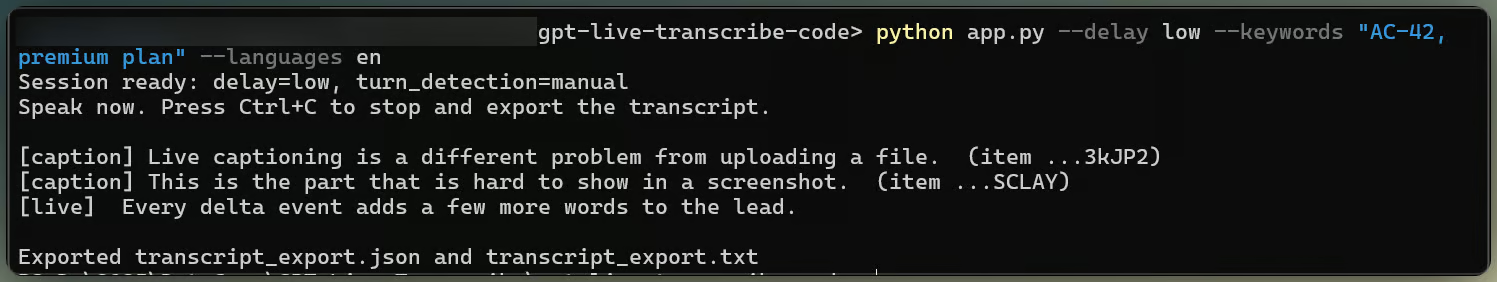
Полное приложение субтитров с настройками. Изображение автора.
При выходе оно записывает текстовый транскрипт и JSON с использованной конфигурацией, локально измеренным временем до первой дельты и каждым финализированным ходом с его item_id. Я добавил этот экспорт после того, как потерял удачный прогон из‑за закрытого терминала. Таймстемпы там — на стороне клиента, не путайте свою инструментализацию с цифрами OpenAI.
Все три теста также работают в браузере. demo_app.py — это версия на Streamlit с одной вкладкой на эксперимент; это демонстрация, а не основная обучающая тропа, потому что терминальные скрипты нагляднее показывают «сырые» события.
streamlit run demo_app.pyУчитесь с DataCamp
Course
Course
Course