course
Lucrul cu OpenAI API
3 oră
172.8K
Încărcarea unui fișier audio finalizat într-un endpoint de transcriere e versiunea ușoară a acestei probleme. Aștepți tot fișierul și primești o singură transcriere. Nimeni nu stă cu ochii pe ecran cât timp modelul lucrează. Subtitrarea live e altă treabă: audio continuă să sosească în timp ce încă decizi ce faci cu ce ai, iar textul trebuie să se actualizeze cât timp persoana încă vorbește.
Asta e diferența pe care gpt-live-transcribe o acoperă. OpenAI l-a lansat pe 28 iulie 2026 alături de un omolog pentru batch, gpt-transcribe. În acest tutorial construiesc în jurul lui un client de subtitrare în Python și rulez trei teste: un client de streaming de bază, o comparație a indiciilor de context pe care le acceptă și un benchmark al celor cinci setări de întârziere. Am testat cu engleză curată, vocabular tehnic și code-switching arabă egipteană–engleză, fiindcă asta seamănă mai mult cu o întâlnire reală decât un singur narator clar.
La final vei avea o aplicație de subtitrare funcțională, o idee despre ce setări de context chiar ajută și o setare de întârziere pe care o poți apăra, în loc să ghicești.
gpt-live-transcribe este un model de recunoaștere vocală în streaming pentru aplicații care au nevoie de textul transcris cât timp audio încă sosește. Primește audio și returnează text, atât, ajustat prin patru câmpuri: delay pentru latență, prompt pentru context liber, keywords pentru termeni literali și languages pentru limbile de intrare așteptate. Pe benchmark-ul Context Aware ASR al OpenAI, contextul liber a ridicat acuratețea semantică de la 38,5 la 44,6 la sută, motiv pentru care există Testul 2.
Modelul rulează în cadrul Realtime API, nu ca un endpoint separat, și nu are legătură cu GPT-Live, sistemul vocal al OpenAI, indiferent ce sugerează numele. Deschizi o sesiune de transcriere, o configurezi, iar serverul îți transmite evenimente pe aceeași conexiune pe care trimiți audio. Asta lasă o întrebare de clarificat înainte de toate: de care dintre cele două modele de transcriere ai de fapt nevoie.
OpenAI livrează două modele recomandate de transcriere, și nu sunt interschimbabile. gpt-live-transcribe este pentru audio care sosește continuu: un microfon, un apel, un flux media, când ai nevoie de text parțial înainte ca vorbitorul să termine. gpt-transcribe este pentru înregistrări finalizate sau o sesiune Realtime în care aștepți deliberat un tur confirmat. Documentația numește acest al doilea caz un flux de lucru specializat, nu o metodă de a primi delta-uri live.
O diferență care îi derutează pe mulți: gpt-transcribe returnează un array languages cu limba de intrare detectată, gpt-live-transcribe nu. Dacă logica ta se ramifică pe baza limbii detectate, ai ales modelul greșit, oricât de bune ar arăta subtitrările într-un demo. Prețurile se împart pe aceeași linie, aproximativ patru la unu în favoarea modelului batch, la care revin mai târziu.
Prefer să-ți spun asta acum, nu după ce ai construit jumătate de aplicație în jurul lui. Nu există timestamp-uri la nivel de cuvânt, etichete de vorbitor, scoruri de încredere sau diarizare. Dacă îți trebuie temporizare pentru subtitrări, notițe care indică cine a vorbit sau un prag de încredere, ghidul OpenAI indică gpt-4o-transcribe-diarize sau whisper-1 în schimb.
Fiecare script din acest tutorial se află în github.com/KhalidAbdelaty/gpt-live-transcribe, așa că începe prin a-l clona. Ai nevoie de Python 3.10 sau mai nou și de o cheie API cu acces Realtime. Scripturile se bazează pe patru pachete: websockets pentru conexiune, sounddevice pentru captură de la microfon, numpy pentru conversia bufferului și python-dotenv pentru încărcarea cheii. Fișierul requirements adaugă câteva în plus pentru grafice și demo-ul din browser.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Pe macOS, sounddevice are nevoie de PortAudio la nivel de OS (brew install portaudio); pe Linux este apt-get install portaudio19-dev. Sari peste linia asta dacă ești pe Windows. M-am lovit eu însumi de cea de macOS, iar remediul chiar este acea unică instalare.
Audio trebuie să sosească ca PCM pe 16 biți la 24 kHz, mono, little-endian, codificat base64. Dacă trimiți un MP3 sau un WAV stereo, vei primi ieșire bruiată sau conexiune închisă, niciodată un mesaj care să spună că formatul era greșit. Asta îți poate mânca o după-amiază. Următoarea întrebare este deci ce conexiune transportă audio-ul.
Recomandarea OpenAI e clară: WebSocket pentru aplicații server-to-server, WebRTC pentru clienți din browser și mobil. Acest tutorial construiește un backend Python care citește un microfon local, deci WebSocket este alegerea corectă, iar o cheie API standard este suficientă, din moment ce nu părăsește serverul tău.
O sesiune începe cu un eveniment session.update care setează type: "transcription" și alege gpt-live-transcribe ca model. Restul payload-ului descrie audio-ul pe care urmează să-l trimiți. Iată configurația minimă, din ghidul de transcriere Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None dezactivează detecția automată a activității vocale, astfel încât nimic nu se finalizează până nu confirmi explicit. Trei evenimente din client fac apoi treaba: input_audio_buffer.append trimite o bucată de audio base64, input_audio_buffer.commit încheie un tur, iar serverul răspunde cu conversation.item.input_audio_transcription.delta (text parțial) și conversation.item.input_audio_transcription.completed (text final). Eu mă conectez la wss://api.openai.com/v1/realtime?intent=transcription, un tipar din cookbook-ul OpenAI; ghidul nu documentează acel query string, așa că renunță la el dacă nu mai funcționează cândva.
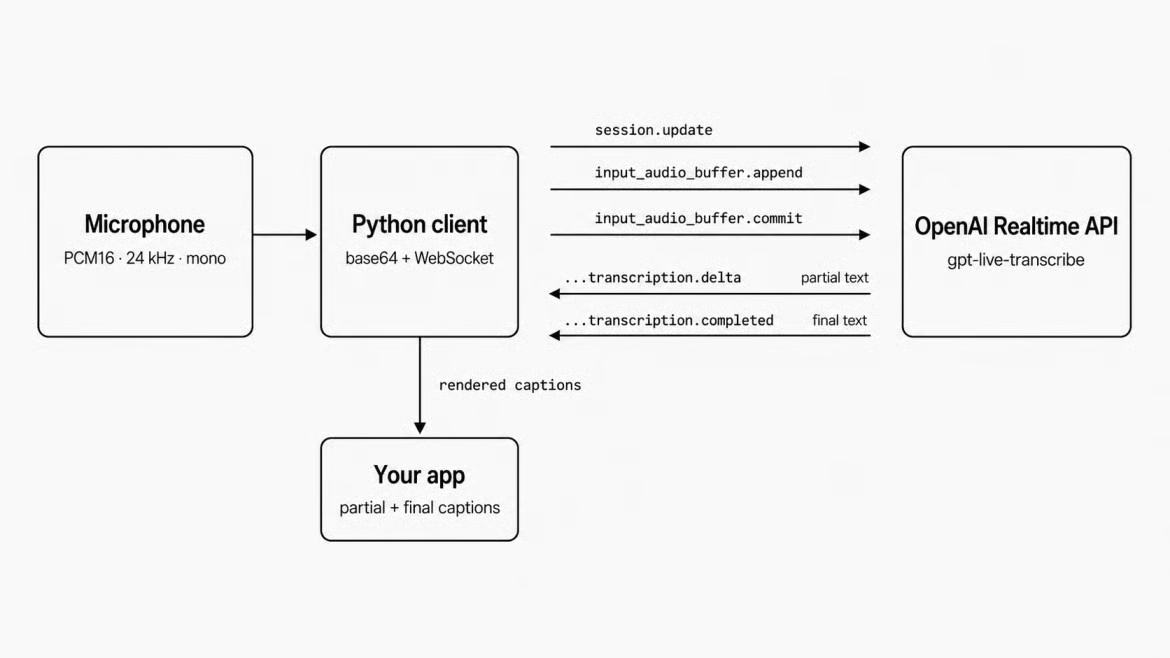
Diagramă a fluxului de evenimente într-o sesiune de transcriere Realtime. Imagine de autor.
Testul 1 este cea mai mică versiune care funcționează: captezi audio de la microfon, îl transmiți, afișezi textul parțial și pe cel final pe măsură ce sosesc. Fără context, fără cuvinte-cheie, nimic ajustat, ca să rămână vizibil fluxul de evenimente. Prima problemă este scoaterea audio-ului din thread-ul microfonului fără a-l bloca.
sounddevice rulează callback-ul pe propriul thread cu câteva milisecunde la dispoziție pentru a răspunde înainte ca driverul să piardă cadre, deci nu poate aștepta un apel de rețea. Singura lui sarcină este să convertească bufferul float32 în PCM16 și să-l pună într-un asyncio.Queue prin loop.call_soon_threadsafe, în timp ce o corutină separată golește coada și trimite fiecare bucățică.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
O bucată de 100 de milisecunde (2.400 de eșantioane la 24 kHz) este un punct de pornire rezonabil. Mai mic înseamnă mai mult overhead per mesaj, mult mai mare face subtitrările să pară lente. Nu există un număr corect documentat, tratează-l ca pe un reglaj.
Delta-urile sunt ieftine și frecvente. Fiecare poartă o bucată de text legată de un item_id. Anexeaz-o la textul parțial pe care îl ai deja pentru acel element, iar subtitrarea crește pe ecran cuvânt cu cuvânt:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Un eveniment completed înlocuiește acel parțial cu transcrierea finalizată pentru același element. Tratează completed ca sursa adevărului și delta-urile ca pe un preview, nu ca pe ceva de concatenat manual.
Iată detaliul care îți va strica UI-ul dacă-l omiți: ghidul OpenAI spune că ordinea între evenimentele de finalizare din tururi diferite nu este garantată. Un eveniment completed pentru un tur mai vechi poate ajunge după unul pentru un tur mai nou, așa că un cod care presupune că cel mai nou completed aparține celui mai nou tur va sări ocazional înapoi sau va duplica o linie. Cheiază totul după item_id, exact ce face clasa mea TranscriptState.
Construirea ei a prins două bug-uri, ambele despre ce dicționar verifica codul. Anexarea item_id la lista de ordine doar în handlerul de delta lăsa full_transcript() gol pentru orice receptor care procesa doar evenimente completed. Folosirea dicționarului de parțiale pentru a decide dacă un element era nou a fost și mai rău: apply_completed() șterge acea intrare, așa că un delta întârziat părea nou, intra a doua oară în lista de ordine și tipărea turul finalizat de două ori. Ține item_id în evidență în ambii handleri și verifică lista de ordine.
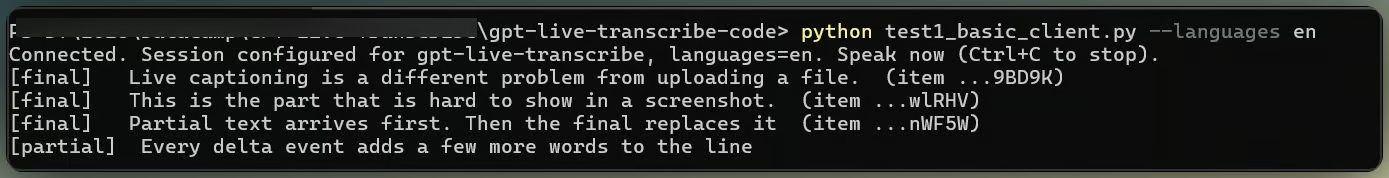
Subtitrări parțiale live care se finalizează în transcriere. Imagine de autor.
Pe engleză curată, textul a apărut în una–două secunde și a corespuns cu ce am spus, inclusiv punctuația. Printr-un microfon de laptop fără context setat, însă, câte un cuvânt nesigur pentru model mai venea ocazional în alt alfabet complet. languages este câmpul pentru asta, iar Testul 2 exact asta urmărește.
Modelul acceptă trei tipuri de context, merită să fim preciși înainte de a le testa. prompt este text liber care descrie cadrul, keywords sunt termeni literali pe care audio i-ar putea conține, iar languages enumeră limbile de intrare așteptate ca coduri ISO 639-1 precum en sau ar. Niciunul nu forțează o ieșire. Un cuvânt-cheie care nu a fost rostit nu va apărea doar pentru că l-ai listat, iar singura cale de a învăța ce fac cu adevărat aceste câmpuri este să le schimbi pe rând.
Am rulat același clip prin cinci configurații, câte trei treceri fiecare. Două reguli păstrează cinstită o astfel de comparație: doar un câmp de context se schimbă între rulări și fiecare configurație rulează de mai multe ori, pentru că modelul nu este determinist pe audio identic.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Prima mea versiune a setat languages doar pe rularea combinată, ceea ce a încălcat prima regulă: s-au schimbat două câmpuri deodată, deci orice diferență putea veni de la oricare. O regulă de formatare mi-a costat și ea o actualizare de sesiune respinsă: un cuvânt-cheie care conține <, >, un carriage return sau un line feed respinge toată actualizarea, nu doar acel cuvânt-cheie. TranscriptionConfig.validate_keywords() prinde asta înainte să construiască payload-ul.
Cuvintele-cheie au ajutat pe tipul de audio la care te-ai aștepta. Fiecare rulare a transcris numărul de cont ca cuvinte, pentru că asta conține audio. Întrebarea era dacă modelul grupă acele cuvinte într-un identificator sau le spunea pe litere ca „A C forty-two”.
Pe cincisprezece rulări, separarea a fost clară. Nimic fără keywords nu l-a grupat vreodată: no_context, prompt_only și languages_only au returnat „A C forty-two” pe toate cele nouă treceri ale lor. Rulările cu keywords l-au grupat în cinci din șase, mai ales ca „AC-42” complet formatat. Deci keywords a mutat rezultatul, iar prompt singur nu a făcut-o niciodată, în acord cu încadrarea OpenAI a keywords ca fiind câmpul pentru termeni literali pe care modelul i-ar putea interpreta greșit. Cuvintele-cheie singure tot au ratat o dată, deci tratează-le ca pe un indiciu care schimbă puternic șansele, nu ca pe o regulă pe care modelul o urmează.
Asta stă ciudat lângă cifra de benchmark cu care am deschis, unde contextul liber a ridicat acuratețea semantică cu șase puncte. Cele două teste măsoară lucruri diferite: OpenAI a notat sensul pe un set larg de audio, în timp ce eu am urmărit un singur identificator într-un singur clip. Un prompt poate face muncă reală la nivel de propoziție și totuși să lase neatins detaliul îngust pe care îl verifici tu. Singurul semn aici este că prompt și keywords împreună l-au grupat la fiecare trecere, în timp ce keywords singure au ratat una, o diferență de o singură rulare.
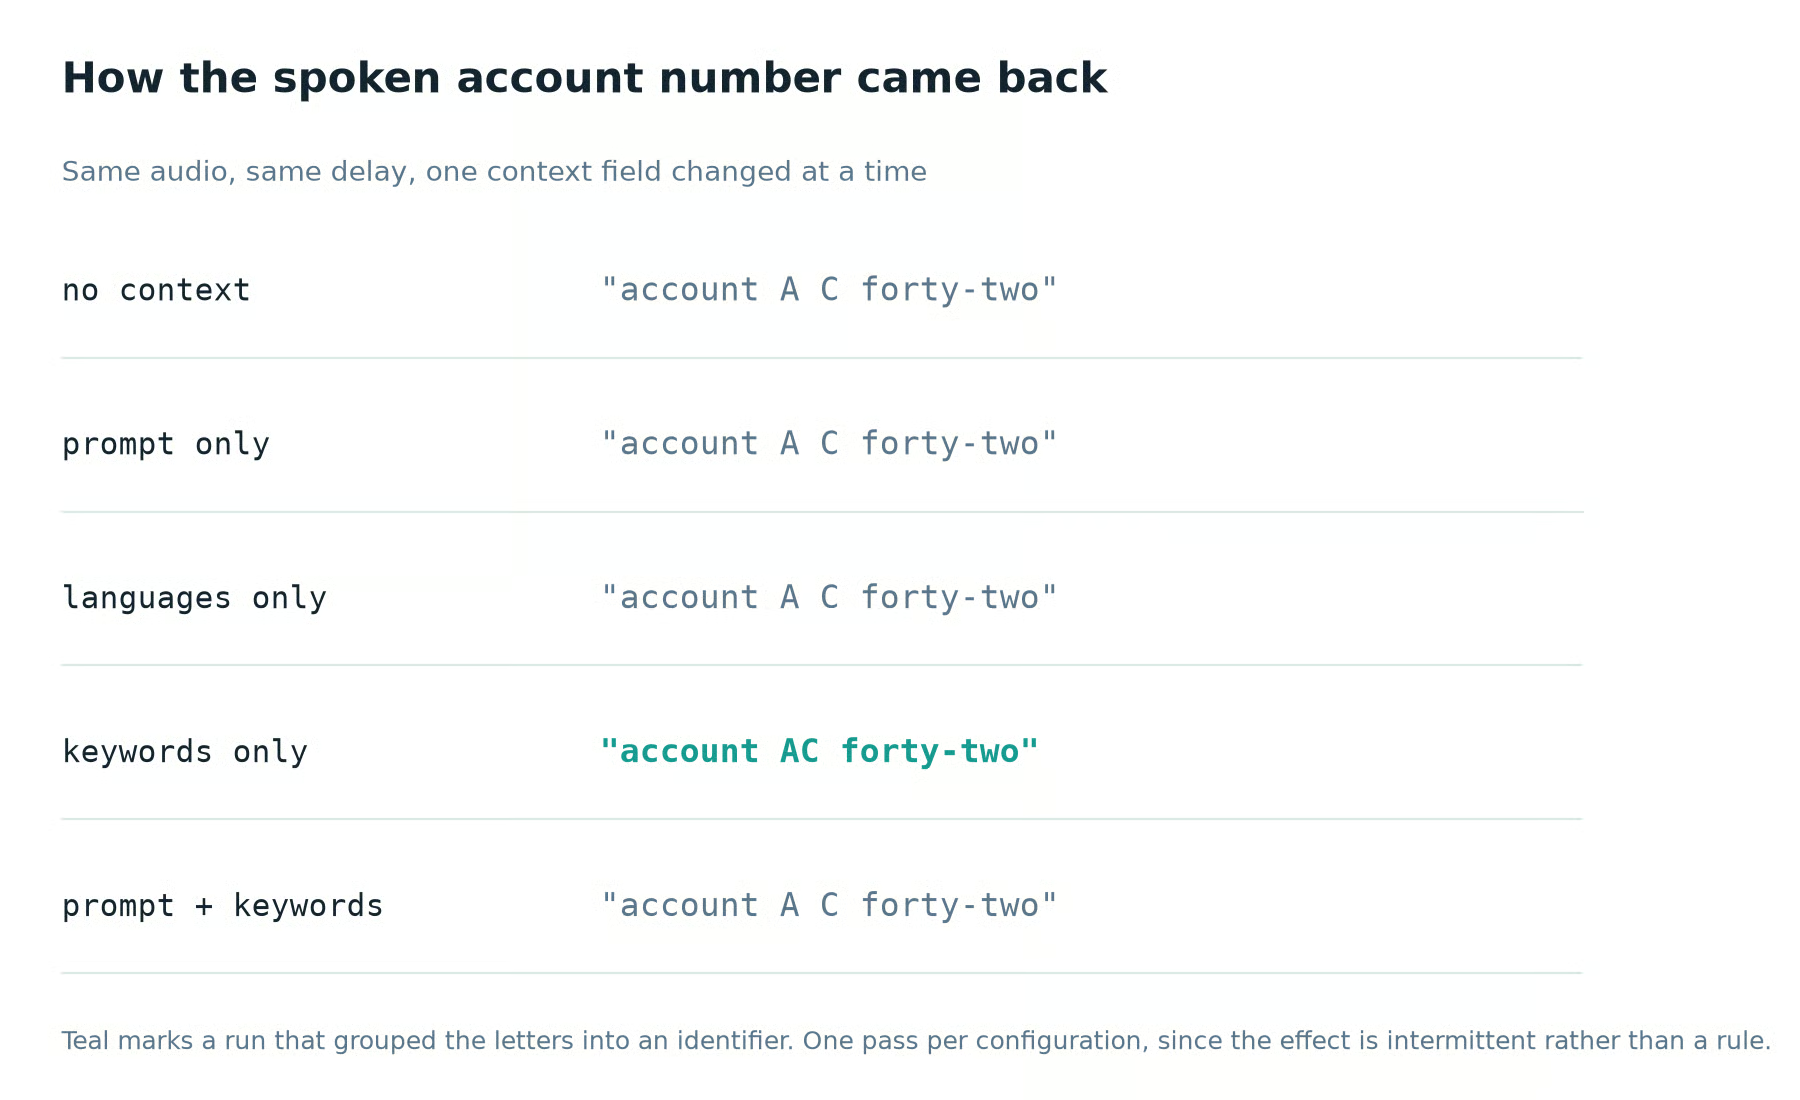
Doar cuvintele-cheie au grupat identificatorul rostit. Imagine de autor.
Indiciile de limbă au ajutat mai clar și la o problemă la care nu mă așteptam. Fără un indiciu, rulările pe clipul cu code-switching tot au auzit cuvântul filler arab de la început, aproximativ „tayyib”, ca englezescul „But,” și au fuzionat cele două sisteme de scriere într-un cuvânt stricat. Au scris de asemenea „billing statement” fonetic în alfabet arab în unele treceri și l-au lăsat în latin în altele. Adăugarea languages: ["ar", "en"] a eliminat cuvântul stricat la fiecare trecere. E totuși un singur clip, iar o propoziție care schimbă limba la jumătate este cel mai ușor loc în care un indiciu să se vadă.
delay ia cinci valori: minimal, low, medium, high și xhigh. Setările mai joase pot produce text parțial mai devreme. Setările mai înalte oferă modelului mai mult context audio înainte să se angajeze pe un text, ceea ce poate îmbunătăți acuratețea pe audio mai dificil. OpenAI spune explicit că temporizarea exactă variază în funcție de configurație și ar trebui benchmark-uită cu audio reprezentativ, așa că asta face Testul 3.
test3_delay_benchmark.py transmite același fișier WAV prin toate cele cinci niveluri, mai multe rulări fiecare, înregistrând timpul de la startul stream-ului până la primul delta și până la transcrierea finală. Păstrarea identice a audio-ului, câmpurilor de context și strategiei de commit este ceea ce face comparația relevantă.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Aceste cifre nu sunt universale. Ale mele au venit din trei rulări per nivel pe un clip, o rețea, o după-amiază. Mediana timpului până la primul parțial a variat de la 0,70 secunde la minimal la 2,91 secunde la xhigh, urcând în pași egali prin low (1,19s), medium (1,39s) și high (2,09s). Cele trei rulări la fiecare nivel au ajuns la circa o cincime de secundă una de alta, deci ordonarea e stabilă chiar dacă numerele sunt ale mele, nu ale tale.
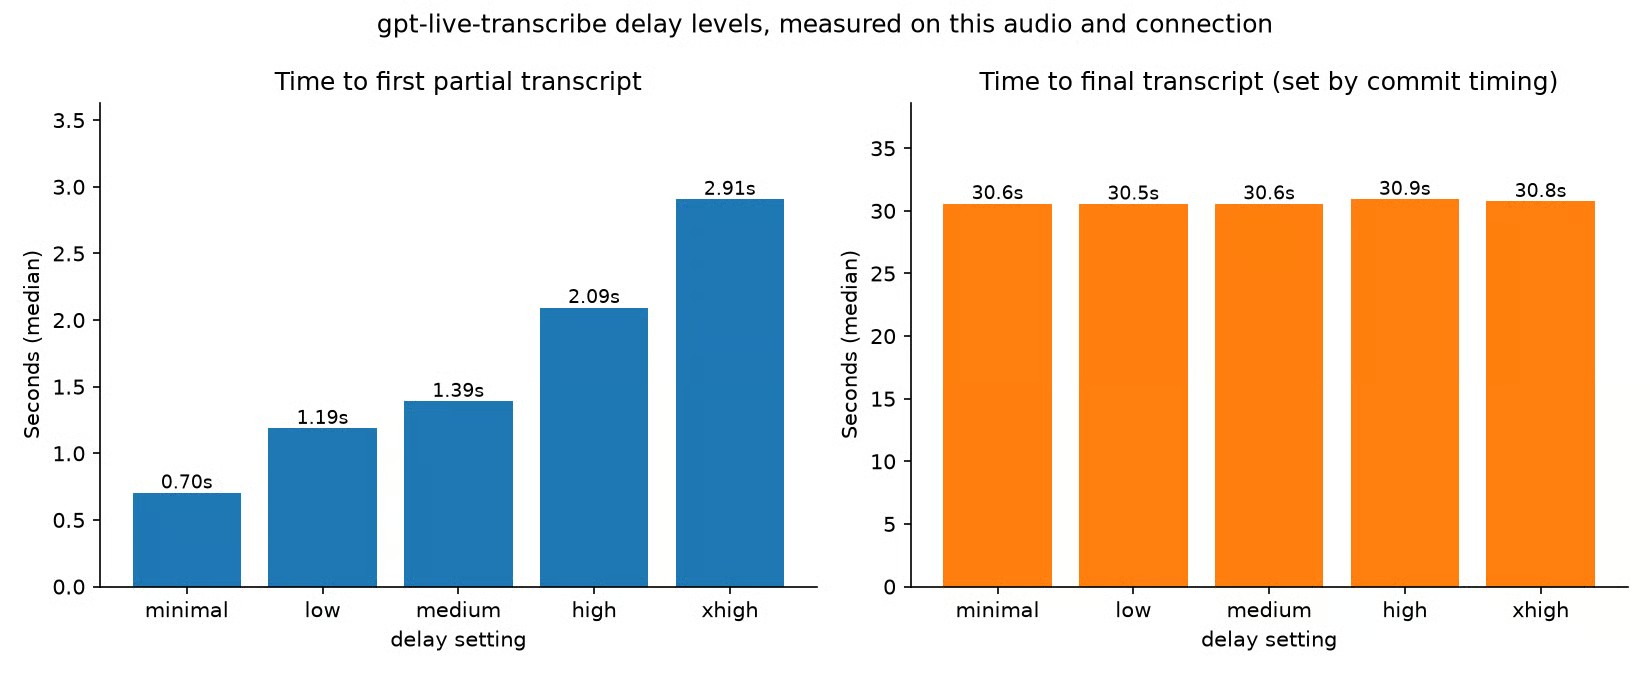
Nivelurile de întârziere schimbă viteză pentru acuratețe. Imagine de autor.
Ce n-am putut confirma a fost presupunerea obișnuită că întârziere mai mare înseamnă mai puține revizuiri. Numărul de delta-uri a fost între 84 și 86 la fiecare nivel, suficient de apropiat de identic încât nu se vede nicio tendință. Timpul până la final a rămas la mai puțin de jumătate de secundă de 30,6 secunde peste tot, dar asta reflectă temporizarea commit-urilor mele, nu a modelului. De aceea graficul desparte cele două măsurători în panouri: pe o axă, o diferență de două secunde dispare sub bare de zece ori mai înalte.
Pentru subtitrări live pe care cineva le citește în timp ce o persoană vorbește, pornește de la low. O așteptare de două secunde înainte să apară orice text se simte stricat într-un fel în care o subtitrare corectată un moment mai târziu nu se simte. Pentru notițe de ședință pe care nimeni nu le citește până mai târziu, high sau xhigh costă aproape nimic. Pentru comenzi vocale, înclină spre medium, pentru că un cuvânt greșit într-o comandă de două cuvinte contează mai mult decât de obicei.
Toate testele de până acum au folosit turn_detection: null și commit manual. Realtime API oferă detecție a activității vocale ca alternativă, așa că am conectat-o la gpt-live-transcribe în loc să presupun că va merge. Era să tai această secțiune când testul a eșuat. Apoi s-a dovedit că eșecul e concluzia.
server_vad segmentează audio pe perioade de liniște, configurabile prin threshold, prefix_padding_ms și silence_duration_ms. semantic_vad folosește un clasificator care estimează dacă vorbitorul pare că a terminat, cu un eagerness care controlează cât de repede decide:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Așa sunt documentate ambele moduri pentru Realtime API în general. Trimise într-o sesiune gpt-live-transcribe, acel payload exact se întoarce respins:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad a produs aceeași eroare. La 4 august 2026, commit-ul manual este singurul mod de detecție a tururilor pe care gpt-live-transcribe îl acceptă, chiar dacă ghidul de transcriere încă îți spune să configurezi VAD ca serverul să confirme tururile pentru tine. Retestează înainte să construiești în jurul lui, pentru că OpenAI ar putea activa VAD pentru acest model mai târziu fără să anunțe.
Push-to-talk e cazul ușor, deoarece apăsarea și eliberarea deja marchează limitele. Restul lasă clientul să decidă când s-a încheiat un tur, iar primele mele două încercări au greșit ambele.
Încercarea unu a protejat commit-ul cu if not mic_queue.empty(), ceea ce sună logic și nu se declanșează niciodată: corutina care golește coada o golește la fel de repede cum microfonul o umple. Subtitrările parțiale tot soseau, ceea ce a făcut-o convingătoare, dar nimic nu se finaliza vreodată. Încercarea doi făcea commit la fiecare patru secunde atât timp cât se adăugase audio. Pe un microfon real, asta a produs:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Două eșecuri deodată. Timerul a tăiat propoziția la mijlocul cuvântului, iar modelul a citit un fragment care nu începe nicăieri ca „Abort.” Apoi a făcut commit în timp ce nu vorbeam și a returnat o transcriere goală, deoarece un microfon transmite bucăți indiferent dacă vorbește cineva sau nu.
Ambele vin din aceeași informație lipsă: energia audio. SpeechGate din mic_stream.py urmărește amplitudinea RMS a fiecărei bucăți și face commit odată ce vorbitorul a spus ceva și apoi s-a liniștit, cu un plafon astfel încât vorbitul continuu să se termine totuși undeva. Prima mea versiune compara acea amplitudine cu un număr fix, care a mers pe o mașină și a fost greșit de cinci ori pe următoarea, așa că acum estimează camera și consideră vorbire orice e de câteva ori mai tare. Un tur care se termină cu aproape niciun audio, o tuse sau o ușă, merge la input_audio_buffer.clear, nu la commit, pentru că să întrebi modelul ce a spus o ușă e fix cum primești un cuvânt inventat.
app.py reunește toate piesele din acest tutorial într-o aplicație de terminal: captură de microfon, subtitrări parțiale live, un istoric al transcrierii cheiat după item_id și flag-uri CLI pentru fiecare câmp acceptat de sesiune.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNumește doar limbile pe care chiar le vorbești. Aceeași comandă cu en,ar pe vorbire în engleză a returnat cuvântul „delta” transliterat în alfabet arab, adică constatarea din Testul 2, invers.
--turn-detection are implicit manual, iar --silence-hold și --max-turn reglează poarta din secțiunea anterioară. Modurile VAD rămân ca flag-uri în caz că API-ul începe să le accepte; pasează oricare și aplicația va tipări respingerea serverului în loc să atârne în tăcere.
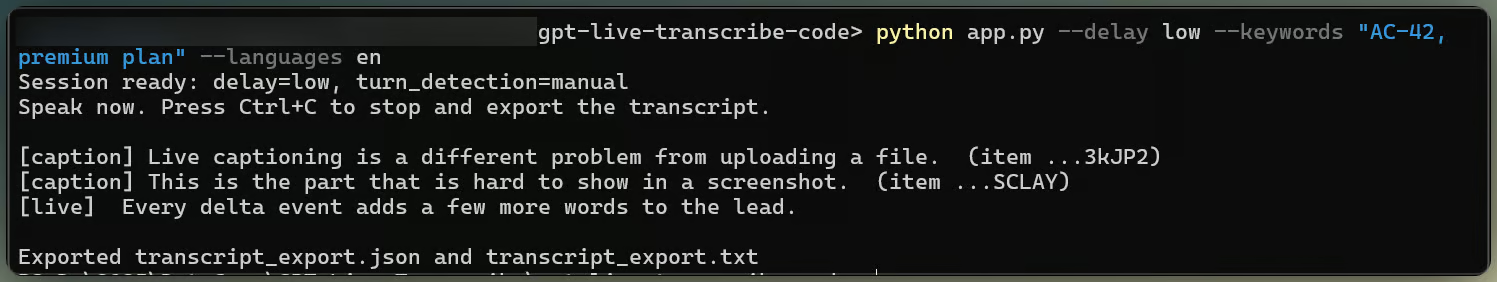
Aplicație de subtitrare completă rulând cu setări. Imagine de autor.
La ieșire scrie o transcriere simplă text și un fișier JSON cu configurația folosită, un timp până la primul delta măsurat local și fiecare tur finalizat cu item_id-ul lui. Am adăugat acel export după ce am pierdut o rulare bună din cauza închiderii terminalului. Timestamps-urile din el sunt client-side, așa că nu confunda propria instrumentație cu o cifră OpenAI.
Toate cele trei teste rulează și în browser. demo_app.py este o versiune Streamlit cu câte un tab per experiment, păstrată ca demo mai degrabă decât ca traseu principal de învățare, pentru că scripturile de terminal arată evenimentele brute mai direct.
streamlit run demo_app.pyÎnvață cu DataCamp
course
course
course