
Kurs
OpenAI API ile Çalışmak
3 sa
178.4K
Bitmiş bir ses dosyasını bir transkripsiyon uç noktasına yüklemek, bu problemin kolay sürümüdür. Tüm dosyayı beklersiniz ve ardından tek bir transkript alırsınız. Model çalışırken kimse ekrana bakmaz. Canlı altyazı ise farklı bir iştir: elinizdekilerle ne yapacağınıza karar verirken ses gelmeye devam eder ve konuşmacı konuşmaya devam ederken metnin güncellenmesi gerekir.
İşte gpt-live-transcribe tam da bu boşluğu doldurur. OpenAI 28 Temmuz 2026'da yayınladı ve bununla birlikte bir toplu işlem karşılığını da sundu, gpt-transcribe. Bu eğitimde bunun etrafında bir Python altyazı istemcisi kuruyor ve üç test çalıştırıyorum: temel bir akış istemcisi, kabul ettiği bağlam ipuçlarının karşılaştırması ve beş gecikme ayarının kıyaslaması. Temiz İngilizce, teknik terminoloji ve Mısır Arapçası-İngilizce kod değiştirme ile test ettim; çünkü bu, tek bir temiz anlatıcıdan ziyade gerçek bir toplantıya daha yakındır.
Sonunda, çalışan bir altyazı uygulaması, hangi bağlam ayarlarının gerçekten yardımcı olduğuna dair bir fikir ve tahmin etmek yerine savunabileceğiniz bir gecikme ayarı elde edeceksiniz.
Modelin en büyük rakiplerinden birine genel bakış için, Grok Voice Transcribe 2.0 rehberimizi okuyun.
gpt-live-transcribe, ses hâlâ gelirken transkript metnine ihtiyaç duyan uygulamalar için akış tabanlı bir konuşma-metne modelidir. Sesi alır ve metin döner, başka bir şey değil; dört alanla ayarlanır: gecikme için delay, serbest biçimli bağlam için prompt, birebir terimler için keywords ve beklenen giriş dilleri için languages. OpenAI'nin Context Aware ASR kıyaslamasında, serbest biçimli bağlam anlamsal doğruluğu yüzde 38,5'ten yüzde 44,6'ya yükseltti; Test 2'nin varlık nedeni bu.
Model, isimlerin çağrıştırdığı şey ne olursa olsun, ayrı bir uç nokta olarak değil Realtime API içinde çalışır ve OpenAI'nin ses sistemi GPT-Live ile ilişkili değildir. Bir transkripsiyon oturumu açar, yapılandırırsınız ve sunucu, ses gönderdiğiniz bağlantı üzerinden olayları geri akıtır. Önce şu soruyu netleştirmek gerekir: Aslında iki transkripsiyon modelinden hangisine ihtiyacınız var.
OpenAI iki önerilen transkripsiyon modeli sunar ve bunlar birbirinin yerine geçmez. gpt-live-transcribe, sürekli gelen ses için, bir mikrofon, bir telefon görüşmesi, bir medya akışı için tasarlanmıştır; konuşmacı bitirmeden kısmi metne ihtiyaç duyduğunuz durumlarda. gpt-transcribe ise tamamlanmış kayıtlar veya bilerek taahhütlü bir dönüşü beklediğiniz bir Realtime oturumu içindir. Dokümanlar bu ikinci durumu özelleşmiş bir iş akışı olarak adlandırır; canlı deltalar almanın bir yolu olarak değil.
İnsanları yanıltan bir fark: gpt-transcribe tespit edilen giriş dilini içeren bir languages dizisi döner, gpt-live-transcribe dönmez. Mantığınız tespit edilen dil üzerinden dallanıyorsa, demo ne kadar iyi görünürse görünsün yanlış modele yöneliyorsunuz demektir. Fiyatlandırma da aynı çizgide ayrışır; toplu model lehine yaklaşık dörtte bir oranındadır; buna daha sonra döneceğim.
Bunu, etrafında yarım uygulama kurduktan sonra söylemektense şimdi söylemeyi tercih ederim. Kelime düzeyinde zaman damgaları, konuşmacı etiketleri, güven puanları ve diyarlama (diarization) yoktur. Altyazı zamanlamasına, kimin konuştuğunu belirten notlara veya bir güven eşiğine ihtiyacınız varsa, OpenAI'nin rehberi bunun yerine gpt-4o-transcribe-diarize veya whisper-1 önerir.
Bu eğitimdeki her betik github.com/KhalidAbdelaty/gpt-live-transcribe deposunda yer alır; bu yüzden klonlayarak başlayın. Python 3.10 veya daha yenisi ve Realtime erişimli bir API anahtarı gerekir. Betikler dört pakete dayanır: bağlantı için websockets , mikrofon yakalama için sounddevice , arabellek dönüşümü için numpy ve anahtarı yüklemek için python-dotenv. Gereksinimler dosyası grafikler ve tarayıcı demosu için birkaç paket daha ekler.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
macOS'ta, sounddevice OS düzeyinde PortAudio ister (brew install portaudio); Linux'ta apt-get install portaudio19-dev'dir. Windows kullanıyorsanız bu satırı atlayın. Ben de macOS'ta bu hataya takıldım ve çözüm gerçekten tek bir kurulum komutuydu.
Sesin kendisi 24 kHz, mono, little-endian, base64 kodlu 16 bit PCM olarak gelmelidir. MP3 veya stereo WAV gönderirseniz, formatın yanlış olduğunu söyleyen bir mesaj asla gelmez; ya çıktınız bozuk olur ya da bağlantı kapanır. Bu, bir öğleden sonranızı yiyebilir. Sıradaki soru, sesi hangi bağlantının taşıdığıdır.
OpenAI'nin yönlendirmesi nettir: sunucudan sunucuya uygulamalar için WebSocket, tarayıcı ve mobil istemciler için WebRTC. Bu eğitim, yerel bir mikrofondan okuyan bir Python backend'i kuruyor; bu yüzden WebSocket doğru seçimdir ve standart bir API anahtarı yeterlidir çünkü sunucunuzu terk etmez.
Bir oturum, type: "transcription" ayarlayan session.update olayıyla başlar ve model olarak gpt-live-transcribe seçer. Yükteki diğer her şey, göndermek üzere olduğunuz sesi tanımlar. İşte Realtime transkripsiyon rehberinden en az yapılandırma:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None otomatik ses etkinliği algılamayı devre dışı bırakır; böylece siz açıkça taahhüt etmedikçe hiçbir şey tamamlanmaz. Ardından üç istemci olayı işi yapar: input_audio_buffer.append base64 ses parçası gönderir, input_audio_buffer.commit bir dönüşü bitirir ve sunucu conversation.item.input_audio_transcription.delta (kısmi metin) ve conversation.item.input_audio_transcription.completed (nihai metin) ile yanıt verir. wss://api.openai.com/v1/realtime?intent=transcription adresine bağlanıyorum; bu OpenAI'nin cookbook örüntüsüdür; rehber o sorgu dizesini belgelemez; çalışmayı bırakırsa onu kaldırın.
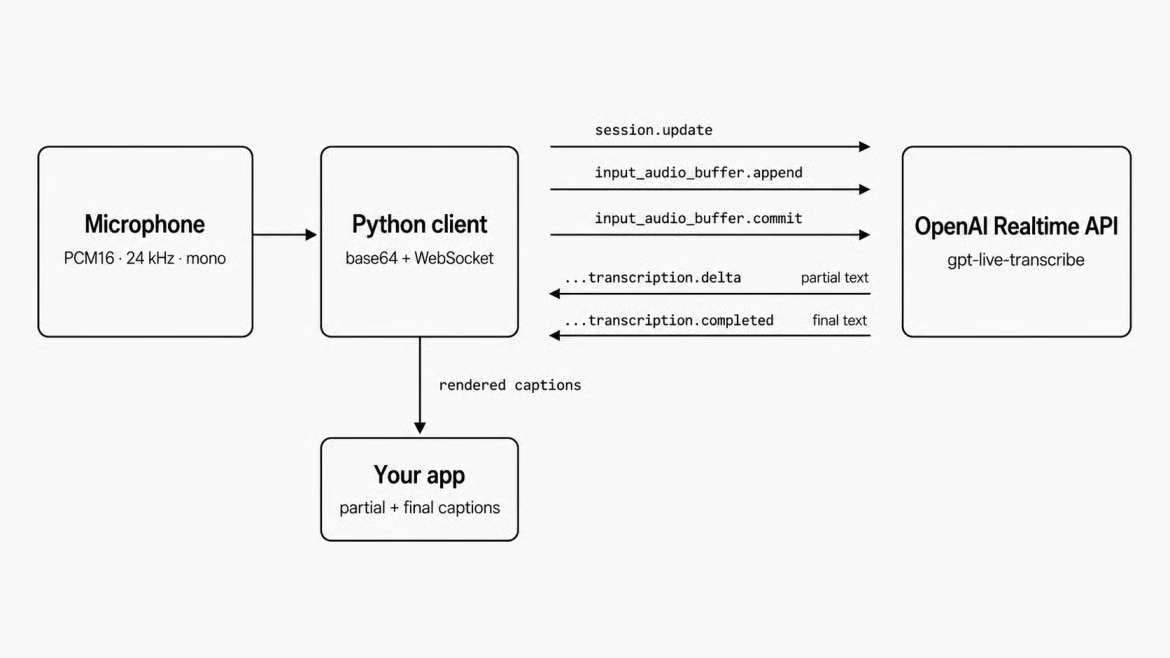
Gerçek zamanlı transkripsiyon oturumu olay akışı diyagramı. Görsel: Yazar.
Test 1, çalışan en küçük sürümdür: mikrofon sesini yakalayın, akıtın, geldikçe kısmi ve nihai metni yazdırın. Bağlam yok, anahtar kelime yok, ayar yok; böylece olay akışı görünür kalır. İlk sorun, mikrofon iş parçacığını kilitlemeden sesten veriyi almaktır.
sounddevice geri çağrısını, sürücü kareleri düşürmeden önce dönmek için birkaç milisaniyesi olan kendi iş parçacığında çalıştırır; bu yüzden ağ çağrısını bekleyemez. Tek işi, float32 arabelleğini PCM16'ya dönüştürmek ve asyncio.Queue üzerine loop.call_soon_threadsafe ile bırakmaktır; ayrı bir coroutine ise bu kuyruğu boşaltır ve her parçayı gönderir.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
100 milisaniyelik bir parça (24 kHz'de 2.400 örnek) makul bir başlangıç noktasıdır. Daha küçüğe inerseniz mesaj başına ek yük artar; çok daha büyüğe giderseniz altyazılar gecikmeli hissedilir. Doğru sayı belgelendirilmemiştir; bunu bir ayar düğmesi gibi görün.
Deltalar ucuz ve sıktır. Her biri bir item_id ile bağlı bir metin parçası taşır. Bunu, o öğe için elinizde olan kısmi metne ekleyin; altyazı ekranda kelime kelime büyür:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
completed olayı, aynı öğe için kısmi metni nihai transkriptle değiştirir. completed'ı gerçeğin kaynağı, deltaları ise önizleme olarak ele alın; kendiniz birleştirmeye çalışmayın.
Atladığınızda arayüzünüzü bozacak ayrıntı şu: OpenAI'nin rehberi, farklı dönüşlerden gelen tamamlama olayları arasında sıralamanın garanti edilmediğini belirtir. Daha erken bir dönüşe ait bir completed olayı, daha sonraki bir dönüşten gelenin ardından gelebilir; dolayısıyla en yeni completed olayının en yeni dönüşe ait olduğunu varsayan kod, ara sıra geri sıçrayacak veya bir satırı iki kez yazacaktır. Bunun yerine her şeyi item_id ile anahtarlayın; benim TranscriptState sınıfımın yaptığı budur.
Bunu inşa etmek iki hatayı yakaladı; ikisi de kodun hangi sözlüğü kontrol ettiğiyle ilgiliydi. item_id'yi yalnızca delta işleyicisinde sıra listesine eklemek, sadece completed olaylarını işleyen herhangi bir alıcı için full_transcript() çıktısını boş bıraktı. Bir öğenin yeni olup olmadığına karar verirken kısmi sözlüğünü kullanmak daha da kötüydü: apply_completed() o girdiyi temizler; böylece geç gelen bir delta yepyeni görünür, sıra listesine ikinci kez girer ve bitmiş dönüşü iki kez yazdırır. item_id'yi her iki işleyicide de izleyin ve bunun yerine sıra listesini kontrol edin.
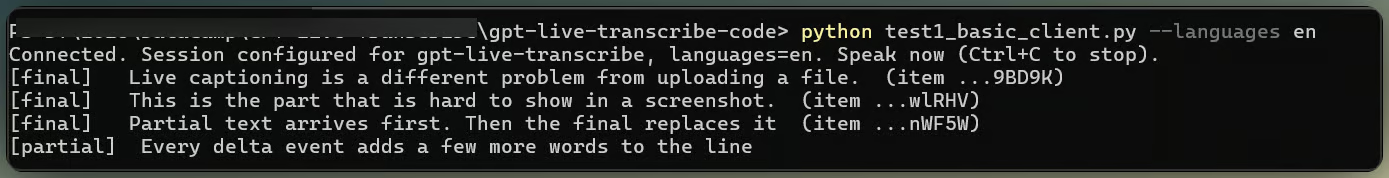
Canlı kısmi altyazıların transkripte dönüşmesi. Görsel: Yazar.
Temiz İngilizceye karşı, metin bir iki saniye içinde göründü ve noktalama işaretleri dahil söylediklerimi yakaladı. Ancak bir dizüstü mikrofonu ve ayarlanmamış bağlamla, modelin emin olmadığı bir kelime bazen tamamen başka bir alfabe ile döndü. Bunu düzeltmek için alan languages; Test 2'nin konusu da bu.
Model üç tür bağlam kabul eder; test etmeden önce bunlar üzerinde net olmak gerekir. prompt ortamı tanımlayan serbest biçimli metindir, keywords seste geçebilecek birebir terimlerdir ve languages beklenen giriş dillerini en veya ar gibi ISO 639-1 kodlarıyla listeler. Hiçbiri çıktıyı zorlamaz. Söylenmeyen bir anahtar kelimeyi listelediniz diye metinde görünmez; bu alanların gerçekte ne yaptığını öğrenmenin tek yolu, her seferinde birini değiştirmektir.
Aynı klibi beş yapılandırma üzerinden, her birini üçer geçişle çalıştırdım. Böyle bir karşılaştırmayı dürüst tutan iki kural: koşular arasında yalnızca bir bağlam alanı değişir ve her yapılandırma birden fazla kez çalıştırılır; çünkü model, aynı seste deterministik değildir.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
İlk sürümüm, birleşik koşuda yalnızca languages ayarlıyordu; bu da ilk kuralı bozdu: aynı anda iki alan değişmişti; dolayısıyla oradaki herhangi bir fark her ikisinden de kaynaklanabilirdi. Bir biçimlendirme kuralı da bana reddedilen bir oturum güncellemesine mal oldu: <, >, satır başı veya satır sonu içeren bir anahtar kelime, yalnızca o anahtar kelimeyi değil tüm güncellemeyi reddeder. TranscriptionConfig.validate_keywords() bunu yükü oluşturmadan önce yakalar.
Anahtar kelimeler, beklediğiniz türde seste yardımcı oldu. Her koşu, hesap numarasını seslendiği şekilde, yani sözcüklerle yazdı; çünkü seste olan buydu. Soru, modelin bu sözcükleri bir tanımlayıcıda gruplandırıp gruplandırmadığı ya da harfleri "A C kırk iki" diye heceleye heceleye yazıp yazmadığıydı.
On beş koşu boyunca ayrım netti. keywords içermeyen hiçbir yapılandırma bunu hiç gruplandırmadı: no_context, prompt_only ve languages_only kendi dokuz geçişlerinin tamamında "A C kırk iki" döndürdü. keywords içeren koşuların altıda beşinde, çoğunlukla tam biçimlendirilmiş "AC-42" olarak gruplandı. Yani keywords sonucu etkiledi; prompt tek başına hiç etkilemedi; bu da OpenAI'nin keywords alanını, modelin yanlış ayrıştırabileceği birebir terimler için bir alan olarak çerçevelemesiyle uyumlu. Yine de anahtar kelimeler tek başına bir kez ıskaladı; bu yüzden bunu, modelin uymak zorunda olduğu bir kuraldan ziyade, olasılıkları ciddi biçimde kaydıran bir ipucu olarak görün.
Bu, başta verdiğim kıyas rakamının yanında tuhaf duruyor; orada serbest biçimli bağlam anlamsal doğruluğu altı puan yükseltti. İki test farklı şeyleri ölçüyor: OpenAI, geniş bir ses setinde anlamı puanlarken ben bir klipteki tek bir tanımlayıcıyı izledim. Bir prompt cümle üzerinde gerçek iş yapıyor olabilir ama sizin kontrol ettiğiniz dar ayrıntıyı olduğu gibi bırakabilir. Buradaki tek işaret, prompt ile keywords birlikte her geçişte gruplandırırken, keywords tek başına birinde kaçırması; yani tek bir koşu farkı.
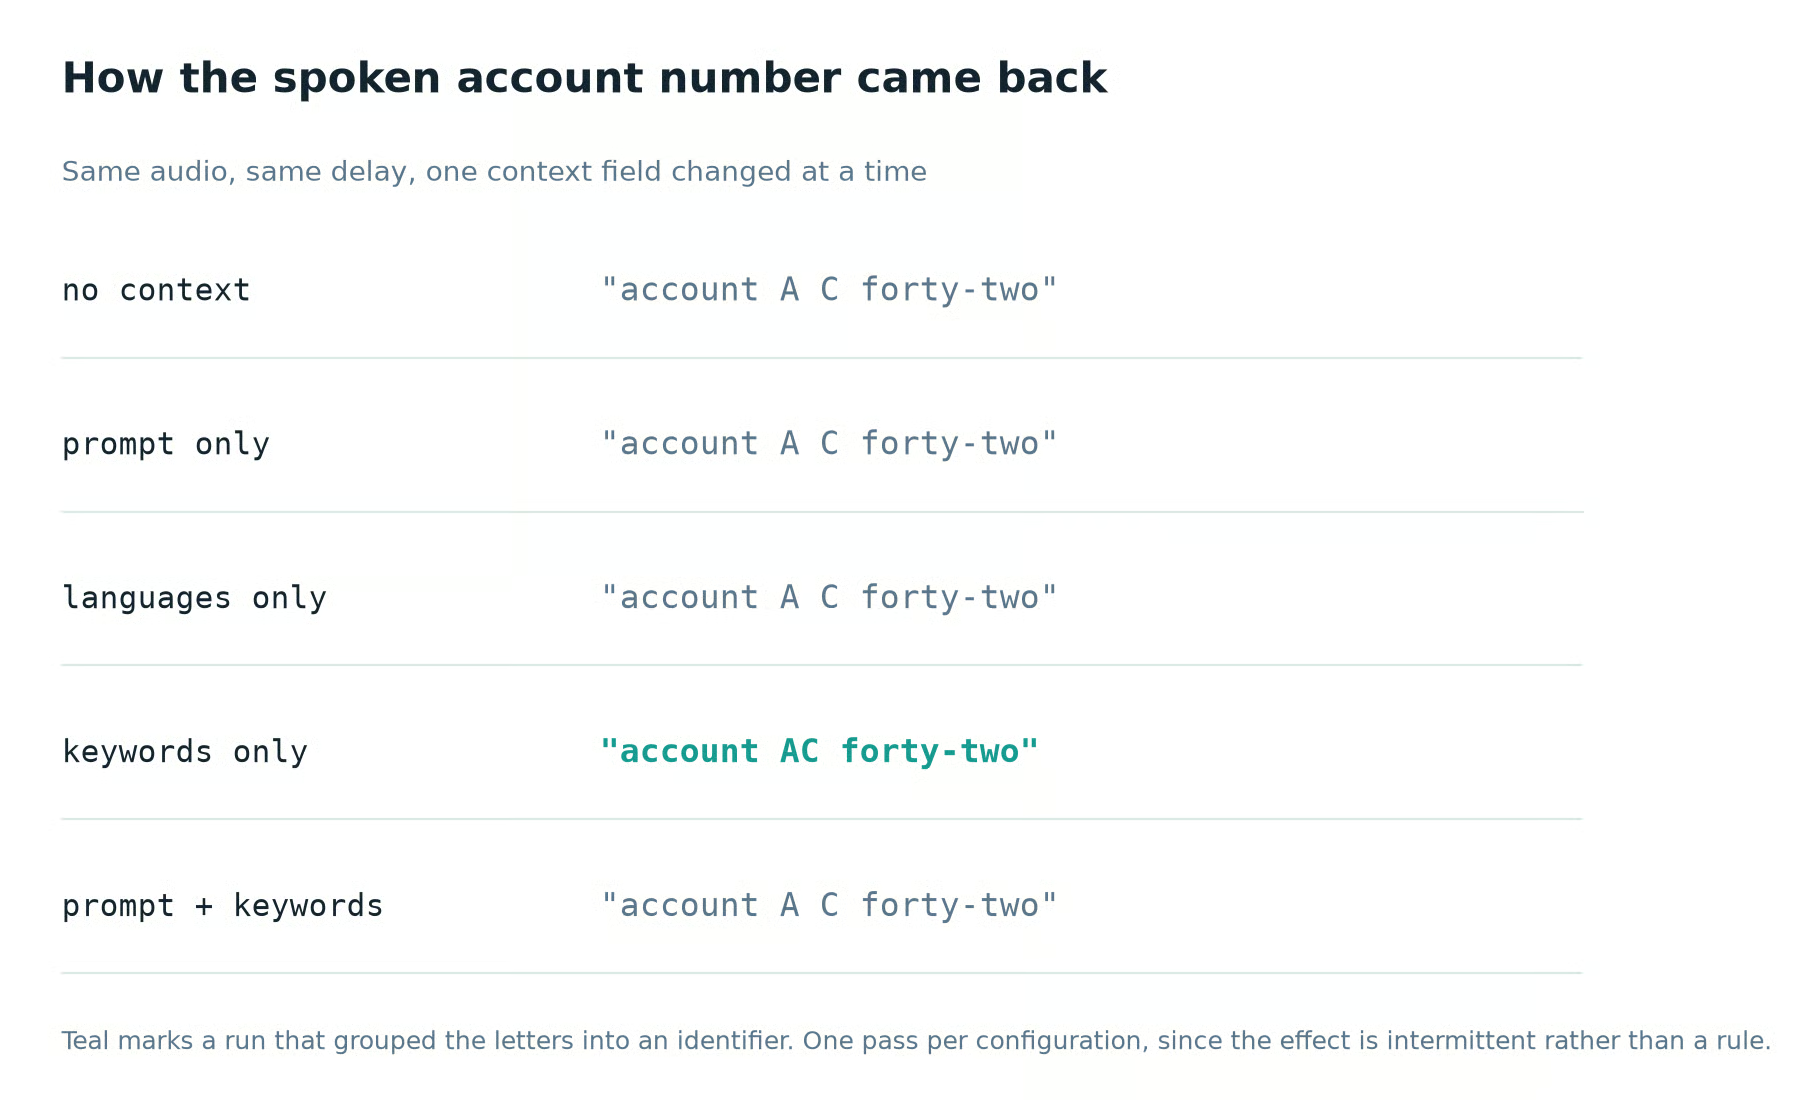
Yalnızca anahtar kelimeler sesli tanımlayıcıyı gruplandırdı. Görsel: Yazar.
Dil ipuçları daha net yardımcı oldu ve beklemediğim bir sorunda. İpucu olmadan, kod değiştiren klipteki açılış Arapça dolgu kelimesi, kabaca "tayyib", İngilizce "But" olarak algılandı ve iki yazı sistemi, tek bir bozuk kelimede birleşti. Ayrıca bazı geçişlerde "billing statement"ı Arap alfabesiyle fonetik olarak yazdı ve diğerlerinde Latin harfleriyle bıraktı. languages: ["ar", "en"] eklemek, her geçişte o bozuk kelimeyi ortadan kaldırdı. Yine de bu tek bir klip ve ortasında dil değiştiren bir cümle, ipucunun en net göründüğü yerdir.
delay beş değer alır: minimal, low, medium, high ve xhigh. Daha düşük ayarlar, kısmi metni daha erken üretebilir. Daha yüksek ayarlar, modelin metne taahhüt etmeden önce daha fazla ses bağlamı görmesini sağlar; bu da daha zor seste doğruluğu artırabilir. OpenAI, kesin zamanlamanın yapılandırmaya göre değiştiğini ve temsilî sesle kıyaslanması gerektiğini açıkça belirtir; Test 3 de bunu yapar.
test3_delay_benchmark.py aynı WAV dosyasını beş düzeyin hepsinden, her biri birkaç koşu olmak üzere geçirir; akış başlangıcından ilk deltaya ve nihai transkripte kadar geçen süreyi kaydeder. Ses, bağlam alanları ve taahhüt stratejisini aynı tutmak, karşılaştırmayı anlamlı kılan şeydir.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Bu rakamlar evrensel değildir. Benimkiler, tek bir klipte, tek bir ağda, tek bir öğleden sonra, her düzeyde üç koşudan geldi. İlk kısmiye kadar medyan süre minimal için 0,70 saniyeden xhigh için 2,91 saniyeye kadar çıktı; low (1,19 sn), medium (1,39 sn) ve high (2,09 sn) boyunca eşit adımlarla tırmandı. Her düzeydeki üç koşu, birbirine yaklaşık beşte bir saniye mesafede kaldı; bu yüzden sıralama stabildir, sayılar benimkiler olsa da sizinkilerden farklı olabilir.
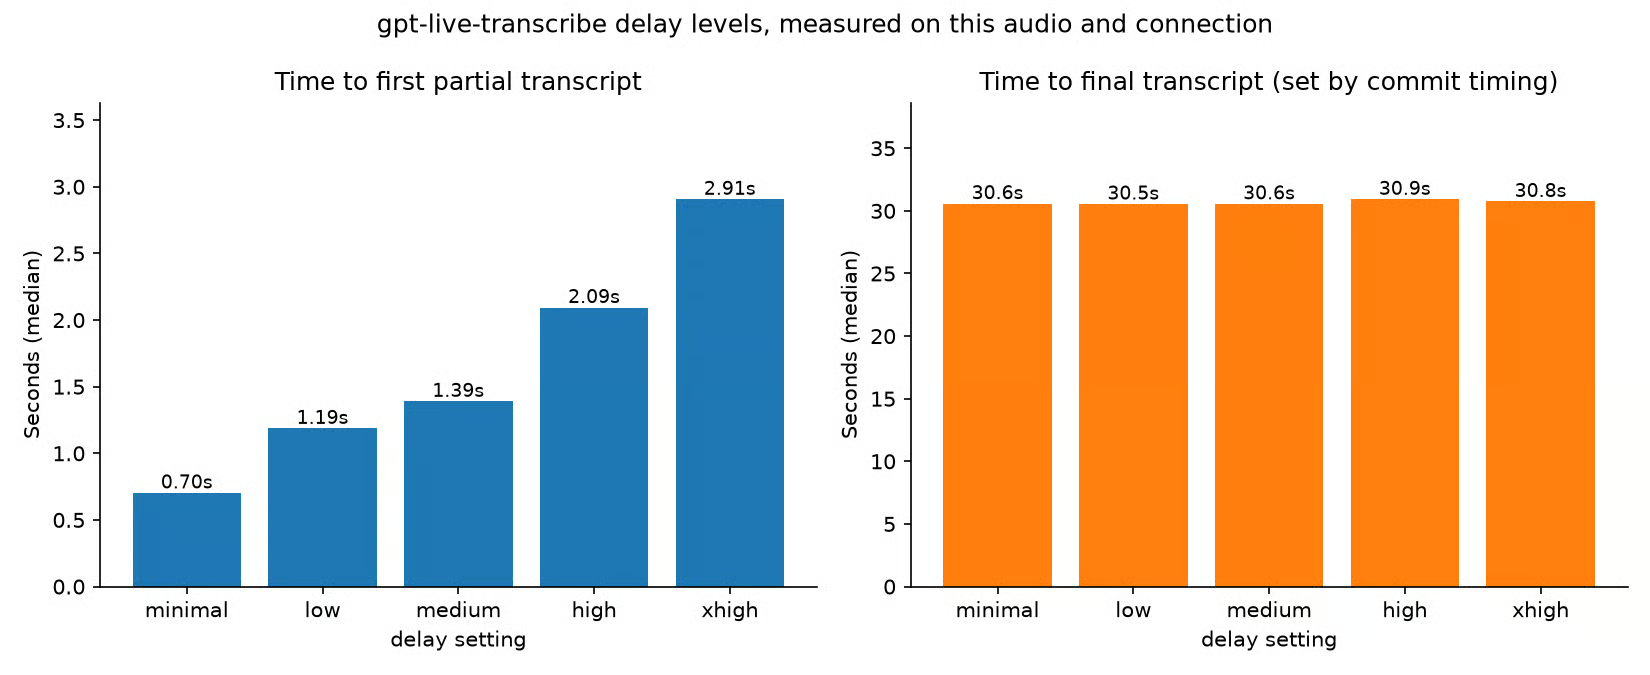
Gecikme düzeyleri hızı doğrulukla takas eder. Görsel: Yazar.
Doğrulayamadığım şey, genelde varsayılan olan; daha yüksek gecikmenin daha az revizyon demek olduğu fikriydi. Delta sayıları her düzeyde 84 ile 86 arasında seyretti; trendin görünmediği kadar birbirine yakındı. Nihaiye kadar geçen süre de her yerde 30,6 saniyenin yarım saniyesi içinde kaldı; ancak bu modelin değil, benim taahhüt zamanlamamın yansımasıdır. Grafiğin iki ölçümü iki panele bölmesinin nedeni budur: bir eksende iki saniyelik fark, on kat daha uzun çubukların altında kaybolur.
Bir kişi konuşurken bir başkasının okuduğu canlı altyazılar için low ile başlayın. Herhangi bir metin görünmeden iki saniye beklemek, bir an sonra düzeltilen bir altyazının yaratmadığı bir bozukluk hissi verir. Kimsenin hemen okumadığı toplantı notları için high veya xhigh neredeyse hiçbir maliyet oluşturmaz. Sesli komutlar için medium'a eğilin; çünkü iki kelimelik bir komuttaki yanlış bir kelime normalden daha kritik olabilir.
Şimdiye kadarki her test turn_detection: null ve elle taahhüt kullandı. Realtime API, alternatif olarak ses etkinliği algılama sunar; bu yüzden gpt-live-transcribe ile çalıştığını varsaymak yerine bağladım. Test başarısız olunca bu bölümü neredeyse kesiyordum. Sonra anlaşıldı ki, başarısızlık bulgunun ta kendisiydi.
server_vad sesi sessizlik dönemlerine göre parçalara böler; threshold, prefix_padding_ms ve silence_duration_ms ile yapılandırılabilir. semantic_vad ise konuşmacının bitmiş gibi görünüp görünmediğini tahmin eden bir sınıflandırıcı kullanır; eagerness ayarı, ne kadar hızlı karar verdiğini kontrol eder:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Bunlar, genel olarak Realtime API için iki modun belgelendiği şekildir. Aynı yük, bir gpt-live-transcribe oturumuna gönderildiğinde reddedilir:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad aynı hatayı üretti. 4 Ağustos 2026 itibarıyla, elle taahhüt, gpt-live-transcribe için kabul edilen tek dönüş algılama modudur; transkripsiyon rehberi hâlâ sunucunun dönüşleri sizin yerinize taahhüt etmesi için ses etkinliği algılamayı yapılandırmanızı söylese de. Bunun daha sonra sessizce açılabileceği için etrafında bir şey kurmadan önce yeniden test edin.
Bas-konuş kolaydır; çünkü basma ve bırakma zaten sınırları işaretler. Diğer her şey, istemcinin bir dönüşün ne zaman bittiğine karar vermesini bırakır; ilk iki denemem ikisi de yanlıştı.
Birinci deneme, taahhüdü if not mic_queue.empty() ile koruyordu; bu mantıklı görünür ama asla tetiklenmez: o kuyruğu boşaltan coroutine, mikrofon kadar hızlı doldurur. Kısmi altyazılar yine de aktı; bu da ikna ediciydi; fakat hiçbir şey asla tamamlanmadı. İkinci deneme, ses eklenmiş olduğu sürece her dört saniyede bir taahhüt ediyordu. Gerçek bir mikrofonda şu çıktı:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Aynı anda iki başarısızlık. Zamanlayıcı cümleyi kelimenin ortasında kesti ve model, hiçbir yerden başlamayan bir parçayı "Abort" olarak okudu. Sonra ben konuşmazken taahhüt etti ve mikrofon biri konuşmasa da parçalar akıttığı için boş bir transkript döndü.
İkisi de aynı eksik bilgiden kaynaklanıyor: ses enerjisi. mic_stream.py içindeki SpeechGate, her parçanın RMS genliğini izler ve konuşmacı bir şey söyledikten sonra sustuğunda; sürekli konuşma hâlinde ise bir üst sınırla taahhüt eder. İlk sürümüm bu genliği sabit bir sayı ile karşılaştırıyordu; bu bir makinede çalıştı ama bir sonrakinde beş kat yanlış çıktı; bu yüzden artık odayı tahmin ediyor ve birkaç kat daha yüksek olanı konuşma sayıyor. Neredeyse hiç ses üzerinde biten bir dönüş, öksürük ya da kapı sesi gibi, input_audio_buffer.clear ile temizlenir; çünkü modele bir kapının ne dediğini sormak uydurma bir kelime almanın yoludur.
app.py bu eğitimin her parçasını tek bir terminal uygulamasında toplar: mikrofon yakalama, canlı kısmi altyazılar, item_id ile anahtarlanmış bir transkript geçmişi ve oturumun kabul ettiği her alan için CLI bayrakları.
python app.py --delay low --keywords "AC-42,premium plan" --languages enYalnızca gerçekten konuştuğunuz dilleri adlandırın. Aynı komutun İngilizce konuşmada en,ar ile verilmesi, "delta" kelimesini Arap alfabesine translitere edilmiş olarak döndürdü; bu da Test 2'nin bulgusunun ters yönde çalışmasıdır.
--turn-detection varsayılan olarak manual'dır ve --silence-hold ile --max-turn önceki bölümdeki kapıyı (gate) ayarlar. VAD modları, API bunları kabul etmeye başlarsa diye bayraklar olarak kalır; bunlardan birini geçerseniz, uygulama sessizce takılmak yerine sunucunun reddini yazdırır.
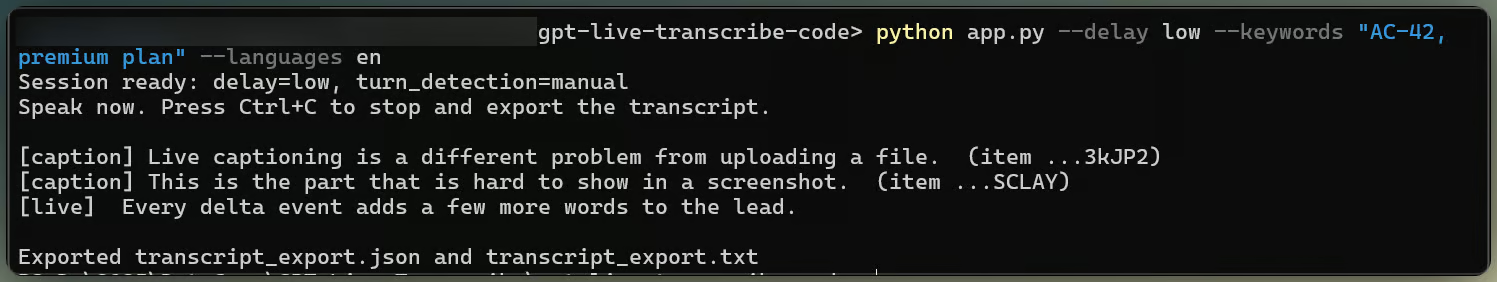
Ayarlarla çalışan eksiksiz altyazı uygulaması. Görsel: Yazar.
Çıkışta, kullanılan yapılandırma, yerelde ölçülen ilk deltaya kadar geçen süre ve her bir nihai dönüşün item_id'siyle birlikte düz metin bir transkript ve bir JSON dosyası yazar. İyi bir test koşusunu kapatılan bir terminalde kaybettikten sonra bu dışa aktarmayı ekledim. İçindeki zaman damgaları istemci taraflıdır; bu yüzden kendi ölçümünüzü bir OpenAI rakamı sanmayın.
Üç testin tamamı tarayıcıda da çalışır. demo_app.py, her deneye bir sekme içeren bir Streamlit sürümüdür; terminal betikleri ham olayları daha doğrudan gösterdiğinden, ana öğretim yolu yerine demo olarak tutulmuştur.
streamlit run demo_app.pyDataCamp ile öğrenin
Kurs
Kurs
Kurs