course
Praca z API OpenAI
3 godz.
172.6K
Przesłanie gotowego pliku audio do endpointu transkrypcji to łatwiejsza wersja tego zadania. Czekasz na cały plik, a potem dostajesz jedną transkrypcję. Nikt nie gapi się w ekran, gdy model pracuje. Napisy na żywo to coś innego: dźwięk wciąż napływa, gdy wciąż decydujesz, co zrobić z tym, co już masz, a tekst musi się aktualizować, gdy mówca wciąż mówi.
Tę lukę gpt-live-transcribe wypełnia. OpenAI udostępniło go 28 lipca 2026 r. wraz z trybem wsadowym, gpt-transcribe. W tym tutorialu buduję wokół niego klienta napisów w Pythonie i uruchamiam trzy testy: podstawowego klienta strumieniowego, porównanie wskazówek kontekstowych, które akceptuje, oraz benchmark jego pięciu ustawień opóźnienia. Testowałem na czystym angielskim, słownictwie technicznym i przełączaniu kodu arabski egipski–angielski, bo to bardziej przypomina prawdziwe spotkanie niż jednego lektora.
Na końcu będziesz mieć działającą aplikację do napisów, rozeznanie, które ustawienia kontekstu faktycznie pomagają, oraz ustawienie opóźnienia, którego możesz bronić zamiast strzelać na oślep.
gpt-live-transcribe to strumieniowy model mowa–tekst dla aplikacji, które potrzebują transkrypcji, gdy dźwięk wciąż napływa. Przyjmuje audio i zwraca tekst — nic więcej — strojoną czterema polami: delay dla latencji, prompt dla swobodnego kontekstu, keywords dla dosłownych terminów i languages dla oczekiwanych języków wejściowych. W benchmarku OpenAI Context Aware ASR swobodny kontekst podniósł trafność semantyczną z 38,5 procent do 44,6 procent, dlatego istnieje Test 2.
Model działa w ramach Realtime API, a nie jako osobny endpoint, i nie jest powiązany z GPT-Live, głosowym systemem OpenAI, niezależnie od skojarzeń w nazwach. Otwierasz sesję transkrypcji, konfigurujesz ją, a serwer strumieniuje zdarzenia tym samym połączeniem, którym wysyłasz audio. Zostaje jedno pytanie do rozstrzygnięcia: którego z dwóch modeli transkrypcji tak naprawdę potrzebujesz.
OpenAI dostarcza dwa rekomendowane modele transkrypcji i nie są one zamienne. gpt-live-transcribe jest dla ciągle napływającego audio — mikrofon, rozmowa telefoniczna, strumień multimedialny — gdy potrzebujesz częściowego tekstu, zanim mówca skończy. gpt-transcribe jest dla ukończonych nagrań albo sesji Realtime, w której celowo czekasz na zatwierdzony zwrot. Dokumentacja nazywa ten drugi przypadek wyspecjalizowanym workflowem, a nie sposobem na uzyskiwanie żywych delt.
Jedna różnica często myli: gpt-transcribe zwraca tablicę languages z wykrytym językiem wejściowym, gpt-live-transcribe — nie. Jeśli twoja logika rozgałęzia się na podstawie wykrytego języka, sięgasz po zły model, niezależnie od tego, jak dobrze wyglądają jego napisy w demie. Cennik rozdziela się wzdłuż tej samej linii, mniej więcej cztery do jednego na korzyść modelu wsadowego, do czego wrócę później.
Wolę powiedzieć ci to teraz, niż po zbudowaniu połowy aplikacji. Nie ma znaczników czasowych na poziomie słów, etykiet mówców, wyników ufności ani diarizacji. Jeśli potrzebujesz timingów do napisów, notatek z informacją, kto mówił, albo progu ufności, przewodnik OpenAI wskazuje zamiast tego gpt-4o-transcribe-diarize lub whisper-1.
Każdy skrypt w tym tutorialu jest w repozytorium github.com/KhalidAbdelaty/gpt-live-transcribe, więc zacznij od sklonowania. Potrzebujesz Pythona 3.10 lub nowszego oraz klucza API z dostępem do Realtime. Same skrypty opierają się na czterech pakietach: websockets do połączenia, sounddevice do przechwytywania mikrofonu, numpy do konwersji bufora i python-dotenv do wczytywania klucza. Plik wymagań dodaje kilka kolejnych do wykresów i dema w przeglądarce.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Na macOS sounddevice wymaga PortAudio na poziomie systemu (brew install portaudio); na Linuksie jest to apt-get install portaudio19-dev. Pomiń to na Windowsie. Sam natrafiłem na ten błąd na macOS i rzeczywiście wystarczył ten jeden install.
Samo audio musi przychodzić jako 16-bitowe PCM w 24 kHz, mono, little-endian, zakodowane base64. Wyślesz MP3 albo stereo WAV i dostaniesz bełkotliwy wynik lub zamknięte połączenie, nigdy komunikat, że format był zły. To potrafi zjeść popołudnie. Kolejne pytanie to, które połączenie niesie audio.
Wskazówki OpenAI są jasne: WebSocket dla aplikacji serwer–serwer, WebRTC dla klientów przeglądarkowych i mobilnych. W tym tutorialu budujesz backend Pythona czytający lokalny mikrofon, więc właściwy jest WebSocket i zwykły klucz API wystarczy, bo nigdy nie opuszcza twojego serwera.
Sesja zaczyna się od zdarzenia session.update, które ustawia type: "transcription" i wybiera gpt-live-transcribe jako model. Reszta payloadu opisuje audio, które zamierzasz wysłać. Oto minimalna konfiguracja z przewodnika transkrypcji Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None wyłącza automatyczne wykrywanie aktywności mowy, więc nic nie zostaje sfinalizowane, dopóki nie zatwierdzisz tego jawnie. Trzy zdarzenia klienckie wykonują pracę: input_audio_buffer.append wysyła bazowy64 fragment audio, input_audio_buffer.commit kończy turę, a serwer odpowiada conversation.item.input_audio_transcription.delta (tekst częściowy) i conversation.item.input_audio_transcription.completed (tekst finalny). Łączę się z wss://api.openai.com/v1/realtime?intent=transcription, wzorcem z cookbooka OpenAI; przewodnik nie dokumentuje tego query stringa, więc porzuć go, jeśli kiedyś przestanie działać.
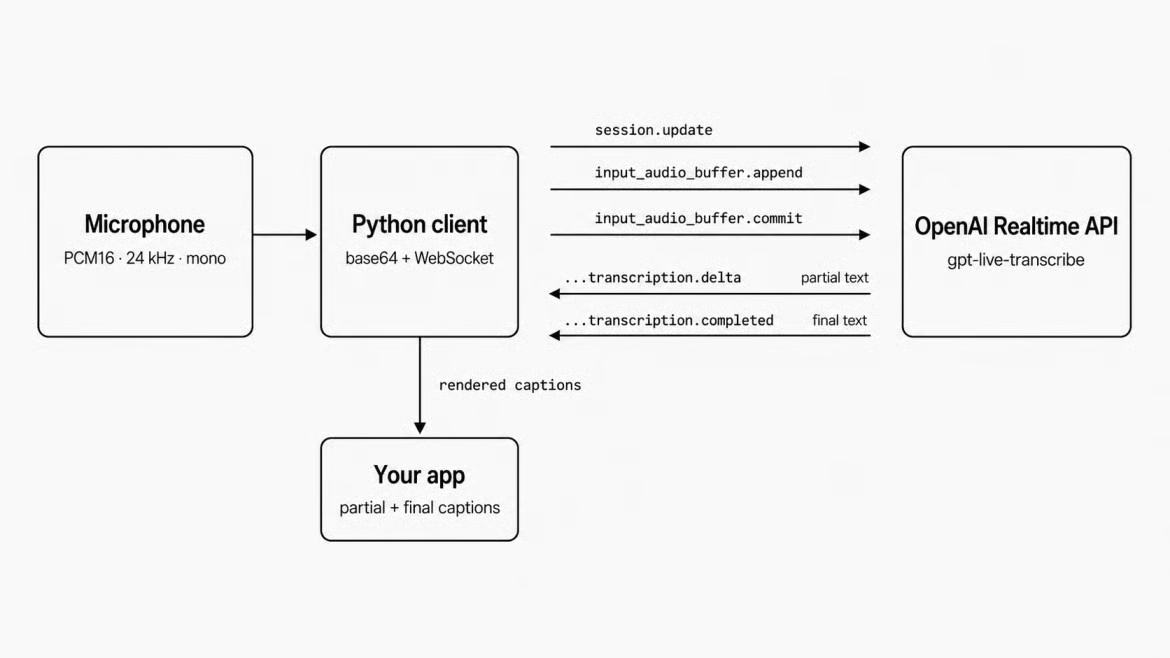
Schemat przepływu zdarzeń sesji transkrypcji Realtime. Obraz: autor.
Test 1 to najmniejsza wersja, która działa: przechwyć dźwięk z mikrofonu, strumieniuj go, wypisuj częściowy i finalny tekst w miarę napływu. Bez kontekstu, bez słów kluczowych, nic nie jest dostrajane, więc przepływ zdarzeń pozostaje czytelny. Pierwszy problem to zdjęcie audio z wątku mikrofonu bez jego blokowania.
sounddevice uruchamia callback we własnym wątku i ma kilka milisekund na zwrot, zanim sterownik zgubi ramki, więc nie może czekać na wywołanie sieciowe. Jego jedynym zadaniem jest konwersja bufora float32 do PCM16 i wrzucenie go do asyncio.Queue przez loop.call_soon_threadsafe, podczas gdy osobna korutyna opróżnia tę kolejkę i wysyła każdy fragment.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Fragment 100 ms (2 400 próbek przy 24 kHz) to rozsądny punkt wyjścia. Mniejsze — zwiększasz narzut na wiadomość, dużo większe — napisy wydają się ociężałe. Nie ma udokumentowanej poprawnej liczby, więc potraktuj to jak pokrętło.
Delty są tanie i częste. Każda niesie fragment tekstu powiązany z item_id. Doklejaj go do częściowego tekstu, który już masz dla tego elementu, a podpis rośnie słowo po słowie na ekranie:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Zdarzenie completed zastępuje tę wersję częściową sfinalizowaną transkrypcją dla tego samego elementu. Traktuj completed jako źródło prawdy, a delty jako podgląd, nie coś do samodzielnego konkatenowania.
Oto szczegół, który rozbije ci UI, jeśli go pominiesz: w przewodniku OpenAI jest napisane, że kolejność między zdarzeniami zakończenia z różnych tur nie jest gwarantowana. Zdarzenie completed dla wcześniejszej tury może przyjść po tym dla późniejszej, więc kod zakładający, że najnowsze completed należy do najnowszej tury, będzie czasem skakał wstecz albo dublował linię. Kluczuj wszystko po item_id — dokładnie to robi moja klasa TranscriptState.
Budując ją, złapałem dwa bugi, oba o to, który słownik kod sprawdzał. Dopisywanie item_id do listy kolejności tylko w obsłudze delty zostawiało full_transcript() puste dla każdego odbiorcy przetwarzającego tylko zdarzenia completed. Używanie słownika częściowych, by zdecydować, czy element był nowy, było gorsze: apply_completed() czyści ten wpis, więc późna delta wyglądała jak nowa, trafiała drugi raz na listę i drukowała skończoną turę podwójnie. Śledź item_id w obu handlerach i sprawdzaj listę kolejności.
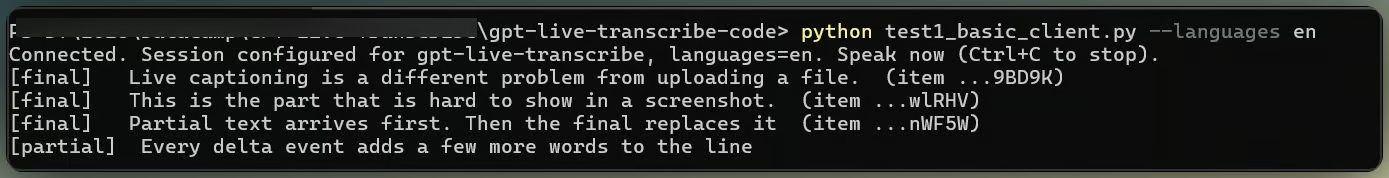
Częściowe napisy finalizujące w transkrypt. Obraz: autor.
Na czystym angielskim tekst pojawiał się w sekundę lub dwie i zgadzał się z tym, co mówiłem, wraz z interpunkcją. Przez mikrofon w laptopie bez ustawionego kontekstu zdarzało się jednak, że słowo, co do którego model nie był pewny, wracało czasem w zupełnie innym piśmie. Od tego jest pole languages, co sprawdzam w Teście 2.
Model akceptuje trzy rodzaje kontekstu — warto je precyzyjnie rozróżnić, zanim je przetestujesz. prompt to swobodny tekst opisujący sytuację, keywords to dosłowne terminy, które mogą paść w audio, a languages wylistowuje oczekiwane języki wejściowe jako kody ISO 639-1, jak en czy ar. Żadne z nich nie wymusza wyjścia. Słowo kluczowe, którego nie wypowiedziano, nie pojawi się tylko dlatego, że je podałeś, a jedyny sposób, by poznać realne działanie tych pól, to zmieniać jedno naraz.
Puściłem ten sam klip przez pięć konfiguracji, po trzy przebiegi każda. Dwie zasady trzymają takie porównanie uczciwie: między przebiegami zmienia się tylko jedno pole kontekstu i każda konfiguracja leci więcej niż raz, bo model nie jest deterministyczny na identycznym audio.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Moja pierwsza wersja ustawiła languages tylko przy przebiegu łączonym, co złamało pierwszą zasadę: zmieniły się dwa pola naraz, więc każda różnica mogła wynikać z dowolnego z nich. Jeden regułowy drobiazg kosztował mnie też odrzucony update sesji: słowo kluczowe zawierające <, >, znak powrotu karetki lub nowej linii odrzuca cały update, nie tylko to słowo. TranscriptionConfig.validate_keywords() wyłapuje to, zanim zbuduje payload.
Słowa kluczowe pomogły tam, gdzie można się było tego spodziewać. Każdy przebieg transkrybował numer konta jako wypowiedziane słowa, bo to zawiera audio. Pytanie brzmiało, czy model zgrupuje te słowa w identyfikator, czy rozstawi je jako „A C czterdzieści dwa”.
W piętnastu przebiegach podział był ostry. Nic bez keywords nigdy go nie grupowało: no_context, prompt_only i languages_only zwracały „A C czterdzieści dwa” we wszystkich dziewięciu przejściach. Przebiegi z keywords grupowały go w pięciu z sześciu, najczęściej jako w pełni sformatowane „AC-42”. Więc keywords przesunęły wynik, a sam prompt nigdy, co pokrywa się z ujęciem OpenAI, że keywords to pole dla dosłownych terminów, które model może źle sparsować. Same keywords wciąż raz chybiły, więc traktuj je jako wskazówkę mocno przechylającą szanse, a nie regułę, którą model musi wykonać.
To zgrzyta z liczbą z otwarcia, gdzie swobodny kontekst podniósł trafność semantyczną o sześć punktów. Testy mierzą różne rzeczy: OpenAI oceniało znaczenie na szerokim zbiorze audio, a ja patrzyłem na jeden identyfikator w jednym klipie. prompt może realnie pracować nad zdaniem, a wciąż zostawić w spokoju wąski detal, na który akurat patrzysz. Jedyny sygnał tego tutaj to to, że prompt i keywords razem grupowały go w każdym przebiegu, podczas gdy same keywords raz chybiły — różnica jednego biegu.
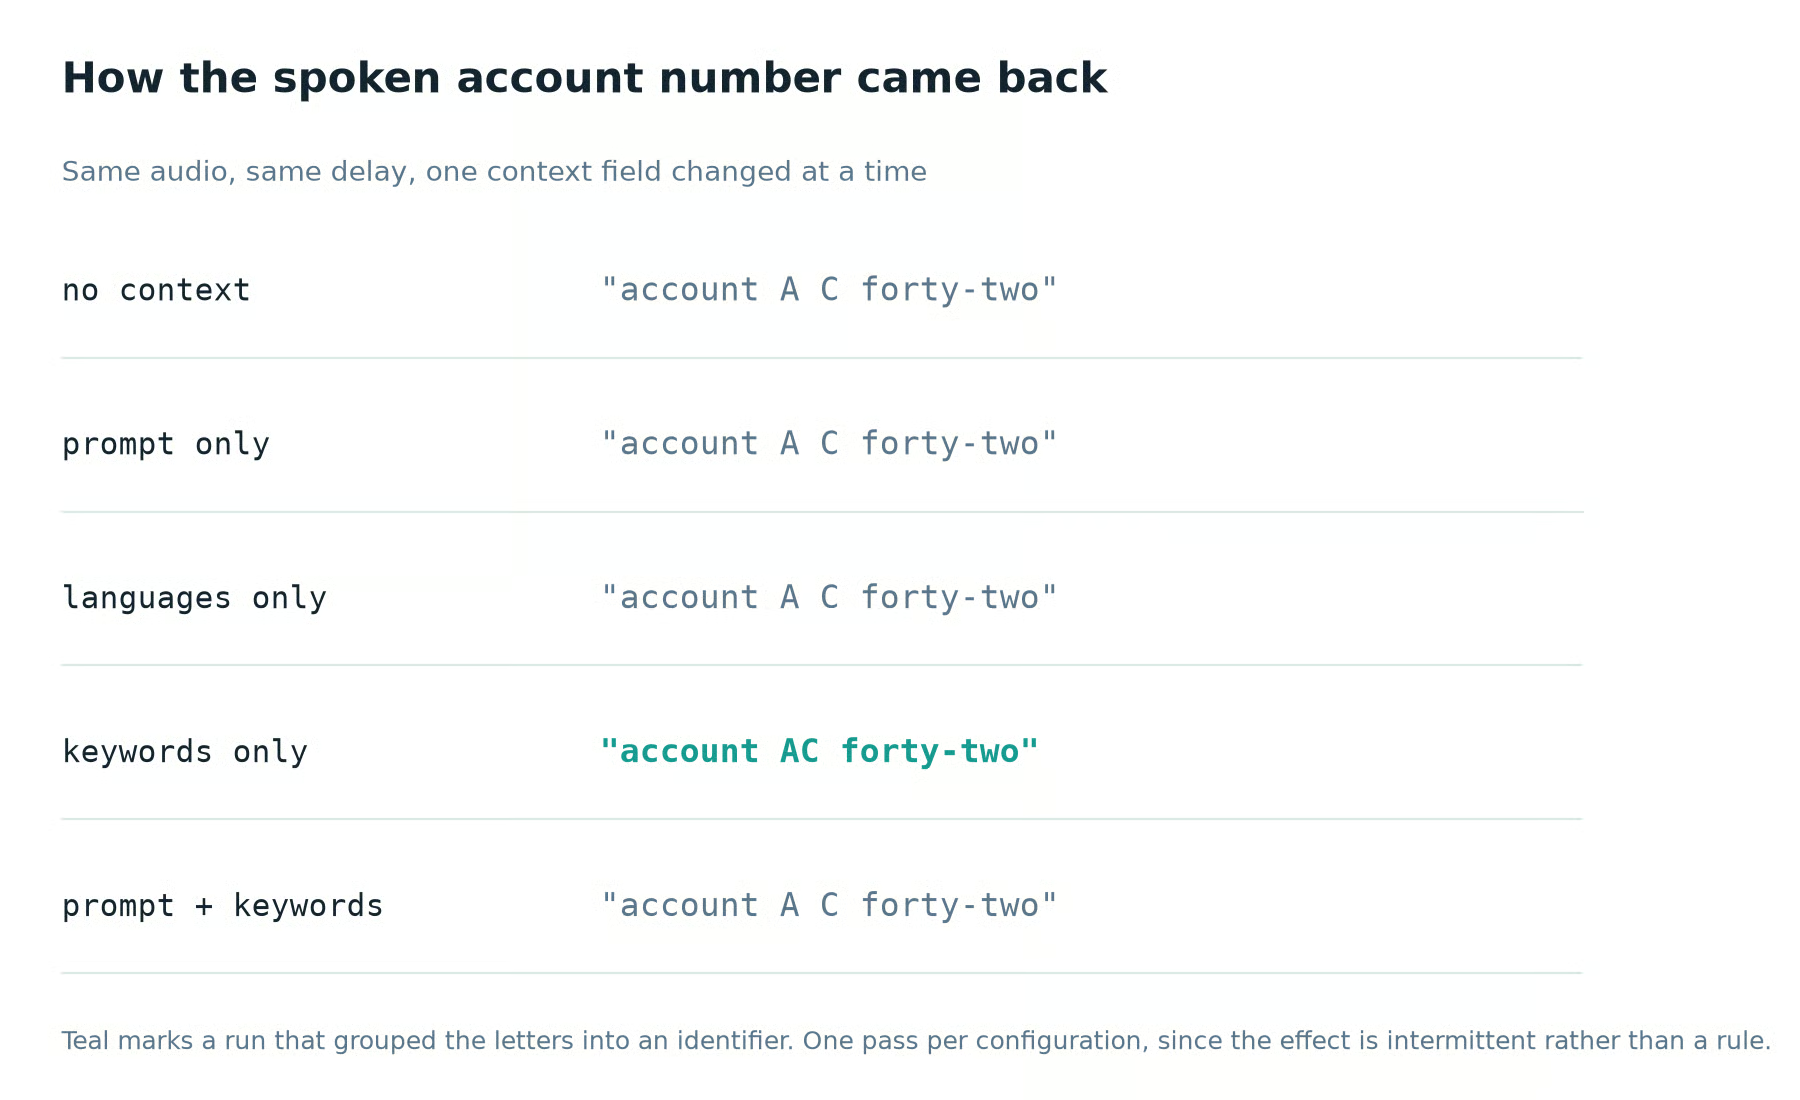
Tylko keywords zgrupowały wypowiedziany identyfikator. Obraz: autor.
Wskazówki językowe pomogły wyraźniej — i w problemie, którego się nie spodziewałem. Bez wskazówki przebiegi na klipie z przełączaniem kodu słyszały otwierające arabskie słowo przestankowe, w przybliżeniu „tayyib”, jako angielskie „But” i sklejały dwa systemy pisma w jedno złamane słowo. Czasem zapisywały też „billing statement” fonetycznie arabskim pismem, a innym razem zostawiały w łacinie. Dodanie languages: ["ar", "en"] usunęło złamane słowo w każdym przebiegu. To jednak jeden klip, a zdanie, które w połowie zmienia język, to najłatwiejsze miejsce, by wskazówka zadziałała.
delay przyjmuje pięć wartości: minimal, low, medium, high i xhigh. Niższe ustawienia mogą dać tekst częściowy szybciej. Wyższe dają modelowi więcej kontekstu audio przed zobowiązaniem się do tekstu, co może poprawić dokładność na trudniejszym audio. OpenAI wyraźnie zaznacza, że dokładne czasy zależą od konfiguracji i trzeba je zmierzyć na reprezentatywnym audio — tym zajmuje się Test 3.
test3_delay_benchmark.py strumieniuje ten sam plik WAV przez wszystkie pięć poziomów, po kilka przebiegów każdy, logując czas od startu strumienia do pierwszej delty i do finalnej transkrypcji. Utrzymanie identycznych audio, pól kontekstu i strategii commitu sprawia, że porównanie ma sens.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Te liczby nie są uniwersalne. Moje pochodzą z trzech przebiegów na poziom na jednym klipie, jednej sieci, jednego popołudnia. Mediana czasu do pierwszego częściowego wahała się od 0,70 s przy minimal do 2,91 s przy xhigh, rosnąc równymi krokami przez low (1,19 s), medium (1,39 s) i high (2,09 s). Trzy przebiegi na każdym poziomie mieściły się w około jednej piątej sekundy, więc kolejność jest stabilna, nawet jeśli liczby są moje, a nie twoje.
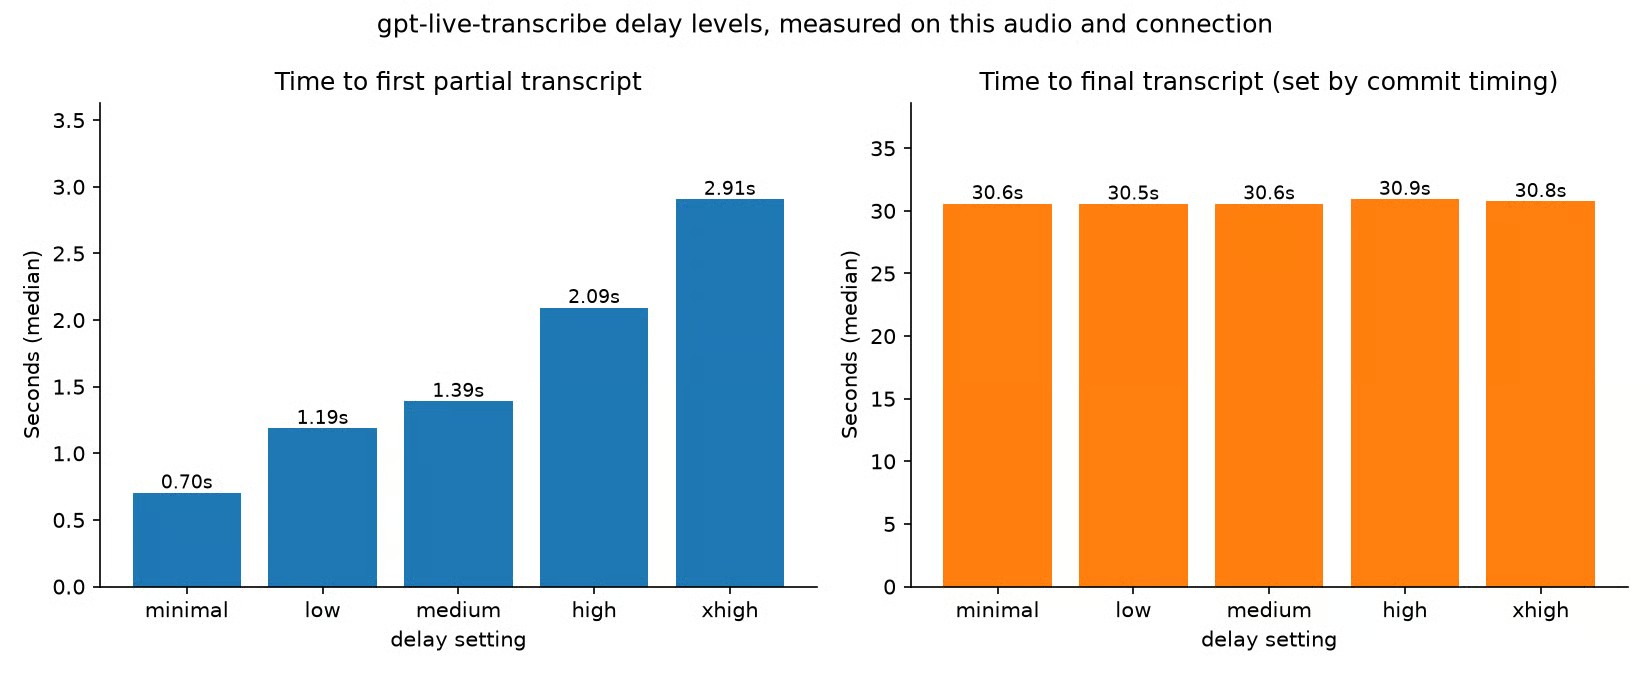
Poziomy opóźnienia wymieniają szybkość na dokładność. Obraz: autor.
Nie potwierdziłem za to typowego założenia, że wyższe opóźnienie oznacza mniej poprawek. Liczba delt wahała się między 84 a 86 na każdym poziomie, wystarczająco blisko, by nie było trendu. Czas do finalnej też był wszędzie w pół sekundy od 30,6 sekundy, ale to odzwierciedla mój timing commitów, nie modelu. Dlatego wykres rozdziela dwie miary na panele: na jednej osi dwusekundowy rozrzut znika pod słupkami dziesięć razy wyższymi.
Dla napisów na żywo, które ktoś czyta, gdy ktoś mówi, zacznij od low. Dwie sekundy czekania na jakikolwiek tekst „psują” bardziej niż podpis poprawiony chwilę później. Do notatek ze spotkania, których nikt nie czyta od razu, high lub xhigh kosztuje prawie nic. Do komend głosowych skłoń się ku medium, bo złe słowo w dwuwyrazowej komendzie boli bardziej niż zwykle.
Wszystkie dotychczasowe testy używały turn_detection: null i ręcznego commitu. Realtime API oferuje wykrywanie aktywności głosu jako alternatywę, więc podłączyłem je do gpt-live-transcribe zamiast zakładać, że zadziała. Prawie wyciąłem tę sekcję, gdy test nie wyszedł. Potem okazało się, że porażka jest wynikiem.
server_vad dzieli audio na okresy ciszy, konfigurowalne przez threshold, prefix_padding_ms i silence_duration_ms. semantic_vad używa klasyfikatora oceniającego, czy mówca brzmi na skończonego, z ustawieniem eagerness kontrolującym, jak szybko decyduje:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Tak oba tryby są udokumentowane dla Realtime API ogólnie. Wysłane do sesji gpt-live-transcribe z tym dokładnie payloadem wracają jako odrzucone:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad zwrócił identyczny błąd. Na 4 sierpnia 2026 r. ręczny commit to jedyny tryb wykrywania tur, jaki gpt-live-transcribe akceptuje, mimo że przewodnik transkrypcji nadal mówi, by skonfigurować VAD, żeby serwer sam commitował tury. Przetestuj ponownie, zanim na tym zbudujesz — OpenAI może włączyć VAD dla tego modelu później bez ogłoszenia.
Push-to-talk to łatwy przypadek, bo naciśnięcie i puszczenie już wyznaczają granice. Wszędzie indziej klient decyduje, kiedy tura się skończyła, a moje dwie pierwsze próby obie to źle zrobiły.
Próba pierwsza zabezpieczała commit warunkiem if not mic_queue.empty(), co brzmi sensownie i nigdy nie pali: korutyna opróżniająca tę kolejkę robi to tak szybko, jak mikrofon ją napełnia. Częściowe napisy wciąż płynęły — to było przekonujące — ale nic nigdy nie finalizowało. Próba druga commitowała co cztery sekundy, o ile audio było dołączane. Na prawdziwym mikrofonie dało to:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Dwie porażki naraz. Timer przeciął zdanie w połowie słowa, a model odczytał fragment zaczynający się znikąd jako „Abort”. Potem commitował, gdy nie mówiłem, i zwracał pustą transkrypcję, bo mikrofon strumieniuje fragmenty niezależnie od tego, czy ktoś mówi.
Obie wynikają z tej samej brakującej informacji: energii audio. SpeechGate w mic_stream.py śledzi RMS amplitudę każdego fragmentu i commituję, gdy mówca coś powiedział i potem ucichł, z limitem, by ciągła mowa też się gdzieś kończyła. Moja pierwsza wersja porównywała tę amplitudę do stałej, co działało na jednej maszynie i było pięciokrotnie błędne na następnej, więc teraz estymuje „pokój” i liczy wszystko kilkukrotnie głośniejsze jako mowę. Zakończenie tury przy niemal zerowym audio — kaszel czy drzwi — idzie do input_audio_buffer.clear zamiast commitu, bo pytanie modelu, co „powiedziały” drzwi, to droga do zmyślonego słowa.
app.py spina wszystkie elementy tego tutorialu w jedną aplikację terminalową: przechwytywanie mikrofonu, częściowe napisy na żywo, historię transkryptu kluczowaną po item_id i flagi CLI dla każdego pola akceptowanego przez sesję.
python app.py --delay low --keywords "AC-42,premium plan" --languages enPodawaj tylko te języki, których faktycznie używasz. To samo polecenie z en,ar na angielskiej mowie zwróciło słowo „delta” transliterowane arabskim pismem — wynik Testu 2 w drugą stronę.
--turn-detection domyślnie to manual, a --silence-hold i --max-turn dostrajają „bramkę” z poprzedniej sekcji. Tryby VAD zostają jako flagi na wypadek, gdyby API zaczęło je akceptować; podaj którąś, a aplikacja wydrukuje odrzucenie serwera zamiast zawiesić się po cichu.
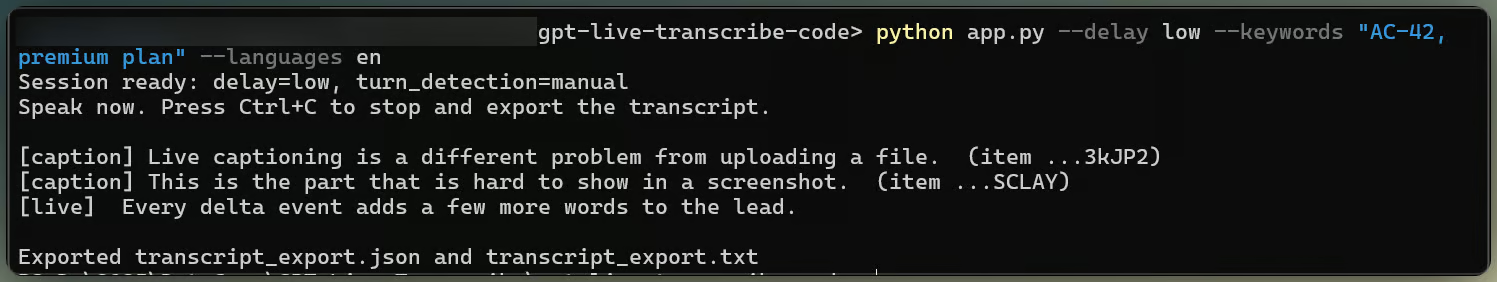
Kompletna aplikacja do napisów z ustawieniami. Obraz: autor.
Przy wyjściu zapisuje transkrypt w czystym tekście i plik JSON z używaną konfiguracją, lokalnie zmierzonym czasem do pierwszej delty i każdą sfinalizowaną turą z jej item_id. Dodałem ten eksport po utracie dobrego przebiegu testu przez zamknięty terminal. Zapisane znaczniki czasu są po stronie klienta, więc nie myl własnej instrumentacji z liczbami OpenAI.
Wszystkie trzy testy działają też w przeglądarce. demo_app.py to wersja w Streamlit z jedną kartą na eksperyment, zachowana jako demo zamiast głównej ścieżki nauki, bo skrypty terminalowe bardziej bezpośrednio pokazują surowe zdarzenia.
streamlit run demo_app.pyUcz się z DataCamp
course
course
course