Curso
Trabajar con la API de OpenAI
3 h
172.6K
Subir un archivo de audio terminado a un endpoint de transcripción es la versión sencilla del problema: esperas a que termine el archivo y recibes una única transcripción. Nadie está mirando la pantalla mientras el modelo trabaja. El subtitulado en directo es otra historia: el audio sigue llegando mientras decides qué hacer con lo que ya tienes, y el texto debe actualizarse mientras la persona aún está hablando.
Ahí es donde gpt-live-transcribe marca la diferencia. OpenAI lo lanzó el 28 de julio de 2026 junto con su versión por lotes, gpt-transcribe. En este tutorial construyo un cliente de subtitulado en Python y hago tres pruebas: un cliente básico por streaming, una comparación de las pistas de contexto que acepta y una evaluación de sus cinco ajustes de latencia. Probé con inglés limpio, vocabulario técnico y cambio de código árabe egipcio–inglés, porque se parece más a una reunión real que un narrador perfecto.
Al terminar tendrás una app de subtitulado funcional, una idea clara de qué ajustes de contexto aportan de verdad y un nivel de latencia que puedas defender con datos, no a ojo.
gpt-live-transcribe es un modelo de voz a texto por streaming para aplicaciones que necesitan transcripciones mientras el audio sigue llegando. Entra audio y sale texto, sin más, ajustado por cuatro campos: delay para la latencia, prompt para contexto libre, keywords para términos literales y languages para los idiomas de entrada esperados. En el benchmark Context Aware ASR de OpenAI, el contexto libre subió la precisión semántica del 38,5 % al 44,6 %, por eso existe la Prueba 2.
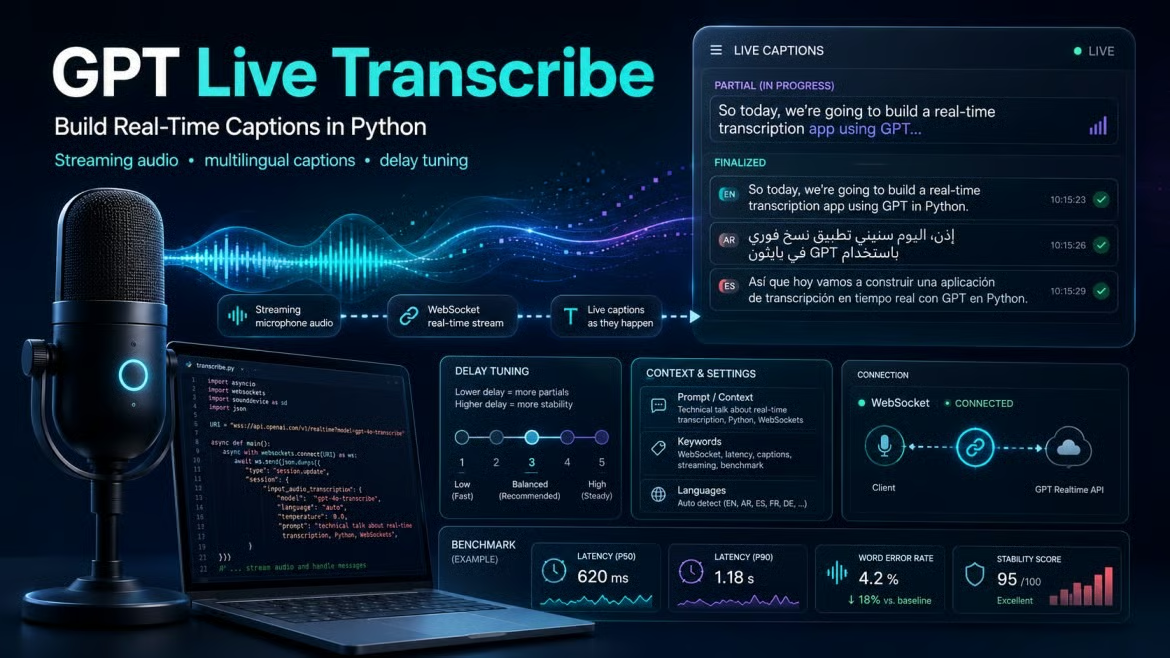
El modelo se ejecuta dentro de la Realtime API, no como un endpoint independiente, y no está relacionado con GPT-Live, el sistema de voz de OpenAI, por mucho que los nombres se parezcan. Abres una sesión de transcripción, la configuras y el servidor te envía eventos de vuelta por la misma conexión por la que mandas el audio. Eso deja una pregunta previa: cuál de los dos modelos de transcripción necesitas realmente.
OpenAI ofrece dos modelos de transcripción recomendados, y no son intercambiables. gpt-live-transcribe es para audio que llega de forma continua —un micrófono, una llamada, un stream— donde necesitas texto parcial antes de que la persona termine. gpt-transcribe es para grabaciones completas, o para una sesión Realtime donde deliberadamente esperas a un turno confirmado. La documentación llama a ese segundo caso un flujo especializado, no una forma de obtener deltas en vivo.
Hay una diferencia que suele confundir: gpt-transcribe devuelve un array languages con el idioma detectado; gpt-live-transcribe no. Si tu lógica depende del idioma detectado, estás eligiendo el modelo equivocado, por muy bien que se vean sus subtítulos en una demo. Los precios también se separan en esa línea, aproximadamente cuatro a uno a favor del modelo por lotes, a lo que vuelvo más adelante.
Prefiero contártelo ahora antes de que montes media app a su alrededor. No hay marcas de tiempo a nivel de palabra, ni etiquetas de hablante, ni puntuaciones de confianza, ni diarización. Si necesitas temporización de subtítulos, notas con quién habló o un umbral de confianza, la guía de OpenAI señala gpt-4o-transcribe-diarize o whisper-1.
Todos los scripts de este tutorial están en github.com/KhalidAbdelaty/gpt-live-transcribe, así que empieza clonándolo. Necesitas Python 3.10 o superior y una clave de API con acceso a Realtime. Los scripts dependen de cuatro paquetes: websockets para la conexión, sounddevice para capturar el micrófono, numpy para convertir el búfer y python-dotenv para cargar la clave. El requirements añade algunos más para las gráficas y la demo en navegador.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
En macOS, sounddevice necesita PortAudio a nivel de sistema (brew install portaudio); en Linux, apt-get install portaudio19-dev. Sáltalo si estás en Windows. A mí me tocó el de macOS y el arreglo fue de verdad ese único comando.
El audio debe llegar como PCM de 16 bits a 24 kHz, mono, little-endian y codificado en base64. Si envías un MP3 o un WAV estéreo tendrás salida corrupta o cierre de conexión, nunca un mensaje avisando del formato erróneo. Ese detalle te puede robar una tarde. La siguiente pregunta es qué conexión llevará el audio.
La recomendación de OpenAI es clara: WebSocket para aplicaciones servidor a servidor; WebRTC para navegador y móvil. Este tutorial monta un backend en Python leyendo un micrófono local, así que WebSocket es lo correcto y una clave estándar sirve porque nunca sale de tu servidor.
Una sesión comienza con un evento session.update que define type: "transcription" y elige gpt-live-transcribe como modelo. El resto del payload describe el audio que vas a enviar. Esta es la configuración mínima, de la guía de transcripción Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None desactiva la detección automática de voz, así que nada se finaliza hasta que confirmes explícitamente. Tres eventos del cliente hacen el trabajo: input_audio_buffer.append envía un fragmento de audio en base64, input_audio_buffer.commit cierra un turno, y el servidor responde con conversation.item.input_audio_transcription.delta (texto parcial) y conversation.item.input_audio_transcription.completed (texto final). Me conecto a wss://api.openai.com/v1/realtime?intent=transcription, un patrón del cookbook de OpenAI; la guía no documenta esa query, así que elimínala si algún día deja de funcionar.
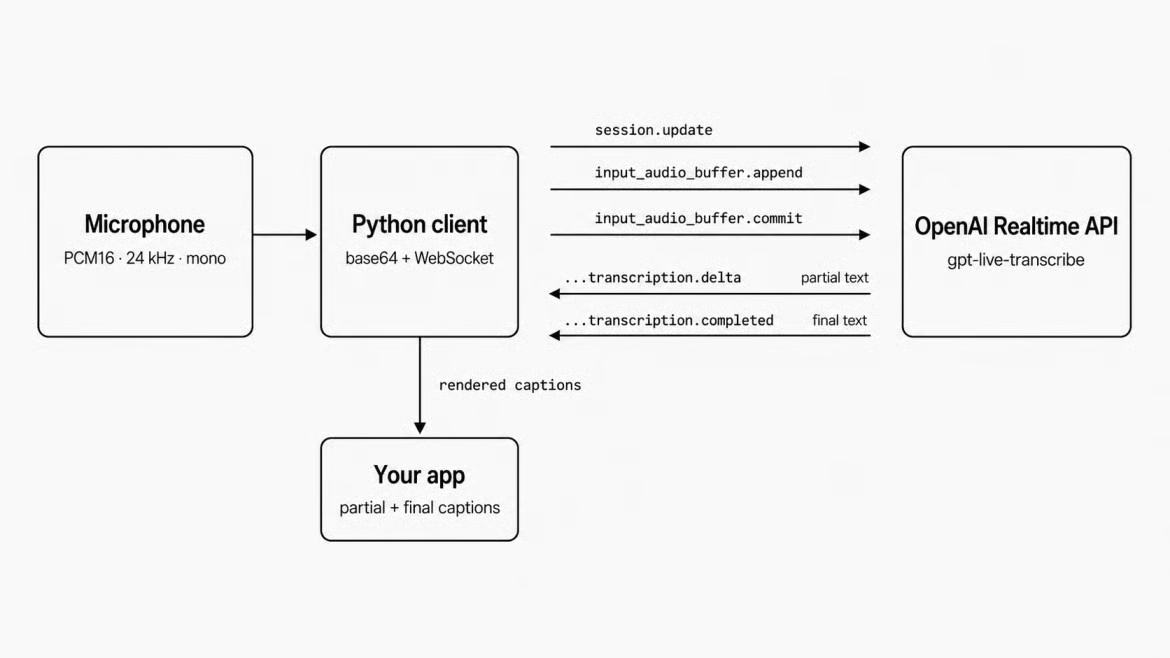
Diagrama del flujo de eventos en una sesión de transcripción Realtime. Imagen del autor.
La Prueba 1 es la versión mínima que funciona: capturar el audio del micrófono, enviarlo por streaming e imprimir texto parcial y final según llega. Sin contexto, sin palabras clave, nada ajustado, para que el flujo de eventos se vea claro. El primer problema es sacar audio del hilo del micrófono sin bloquearlo.
sounddevice ejecuta su callback en su propio hilo con unos milisegundos para devolver control antes de que el driver pierda frames, así que no puede esperar a una llamada de red. Su único trabajo es convertir el búfer float32 a PCM16 y soltarlo en una asyncio.Queue mediante loop.call_soon_threadsafe, mientras una corrutina aparte drena la cola y envía cada fragmento.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Un fragmento de 100 milisegundos (2.400 muestras a 24 kHz) es un buen punto de partida. Si lo haces más pequeño, aumentas la sobrecarga por mensaje; si lo haces mucho mayor, los subtítulos se sienten lentos. No hay un número "correcto" documentado: trátalo como un dial.
Los deltas son baratos y frecuentes. Cada uno trae un trozo de texto vinculado a un item_id. Añádelo al texto parcial que ya tienes para ese elemento y el subtítulo crece palabra a palabra en pantalla:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Un evento completed reemplaza ese parcial por la transcripción final para el mismo elemento. Trata completed como la fuente de verdad y los deltas como un avance, no como algo para concatenar tú mismo.
Aquí está el detalle que romperá tu UI si lo ignoras: la guía de OpenAI indica que no se garantiza el orden entre eventos de finalización de turnos distintos. Un completed de un turno anterior puede llegar después que el de uno posterior, así que el código que asume que el último completed pertenece al último turno a veces saltará hacia atrás o duplicará una línea. Usa item_id como clave para todo, que es justo lo que hace mi clase TranscriptState.
Al construirla, pillé dos bugs, ambos por comprobar el diccionario equivocado. Añadir item_id a la lista de orden solo en el manejador de deltas dejó full_transcript() vacío para cualquier receptor que solo procesa eventos completed. Usar el diccionario de parciales para decidir si un elemento era nuevo fue peor: apply_completed() lo limpia, así que un delta tardío parecía nuevo, entraba en la lista una segunda vez e imprimía el turno finalizado dos veces. Registra item_id en ambos manejadores y comprueba la lista de orden.
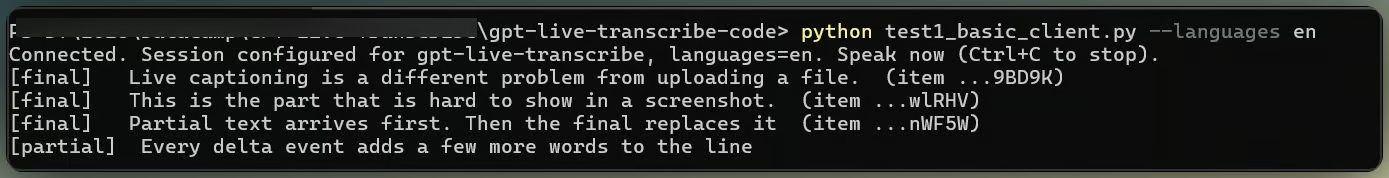
Subtítulos parciales que se convierten en transcripción final. Imagen del autor.
Con inglés limpio, el texto apareció en uno o dos segundos y coincidió con lo dicho, puntuación incluida. Con micrófono de portátil y sin contexto, una palabra dudosa a veces volvió en otro alfabeto. Para eso está languages, que es justo lo que prueba la Prueba 2.
El modelo acepta tres tipos de contexto, conviene precisarlos antes de probarlos. prompt es texto libre que describe la situación; keywords son términos literales que puede contener el audio; y languages lista idiomas de entrada esperados como códigos ISO 639-1 tipo en o ar. Ninguno fuerza una salida. Una palabra clave que nunca se dijo no aparecerá solo por listarla, y la única forma de entender qué hacen de verdad estos campos es cambiarlos de uno en uno.
Pasé el mismo clip por cinco configuraciones, tres veces cada una. Dos reglas mantienen honesta una comparación así: solo cambia un campo de contexto entre ejecuciones y cada configuración se ejecuta más de una vez, porque el modelo no es determinista con audio idéntico.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Mi primera versión puso languages solo en la ejecución combinada, rompiendo la primera regla: cambiaban dos campos a la vez, así que cualquier diferencia podía venir de cualquiera de los dos. Una regla de formato también me costó una sesión rechazada: una keyword con <, >, retorno de carro o salto de línea rechaza toda la actualización, no solo esa palabra. TranscriptionConfig.validate_keywords() lo detecta antes de construir el payload.
Las palabras clave ayudaron justo donde cabía esperar. En todas las ejecuciones, el número de cuenta se transcribió como palabras, porque eso hay en el audio. La cuestión era si el modelo agrupaba esas palabras en un identificador o deletreaba las letras como "A C cuarenta y dos".
En quince ejecuciones, la diferencia fue clara. Sin keywords nunca lo agrupó: no_context, prompt_only y languages_only devolvieron "A C cuarenta y dos" en sus nueve pasadas. Con keywords lo agrupó en cinco de seis, casi siempre como "AC-42". Así que keywords movió el resultado y prompt solo no, en línea con el posicionamiento de OpenAI de keywords como el campo para términos literales que el modelo podría malinterpretar. Aun así, solo con palabras clave falló una vez: tómalo como una pista que inclina mucho las probabilidades, no como una regla.
Esto convive raro con la cifra del benchmark que abría, donde el contexto libre sube seis puntos la precisión semántica. Las pruebas miden cosas distintas: OpenAI evaluó significado en un conjunto amplio de audio, mientras yo miré un identificador en un clip. Un prompt puede estar mejorando la frase y no tocar el detalle concreto que estás mirando. La única señal aquí es que prompt y keywords juntos lo agruparon siempre, mientras que keywords solo falló una: diferencia de una ejecución.
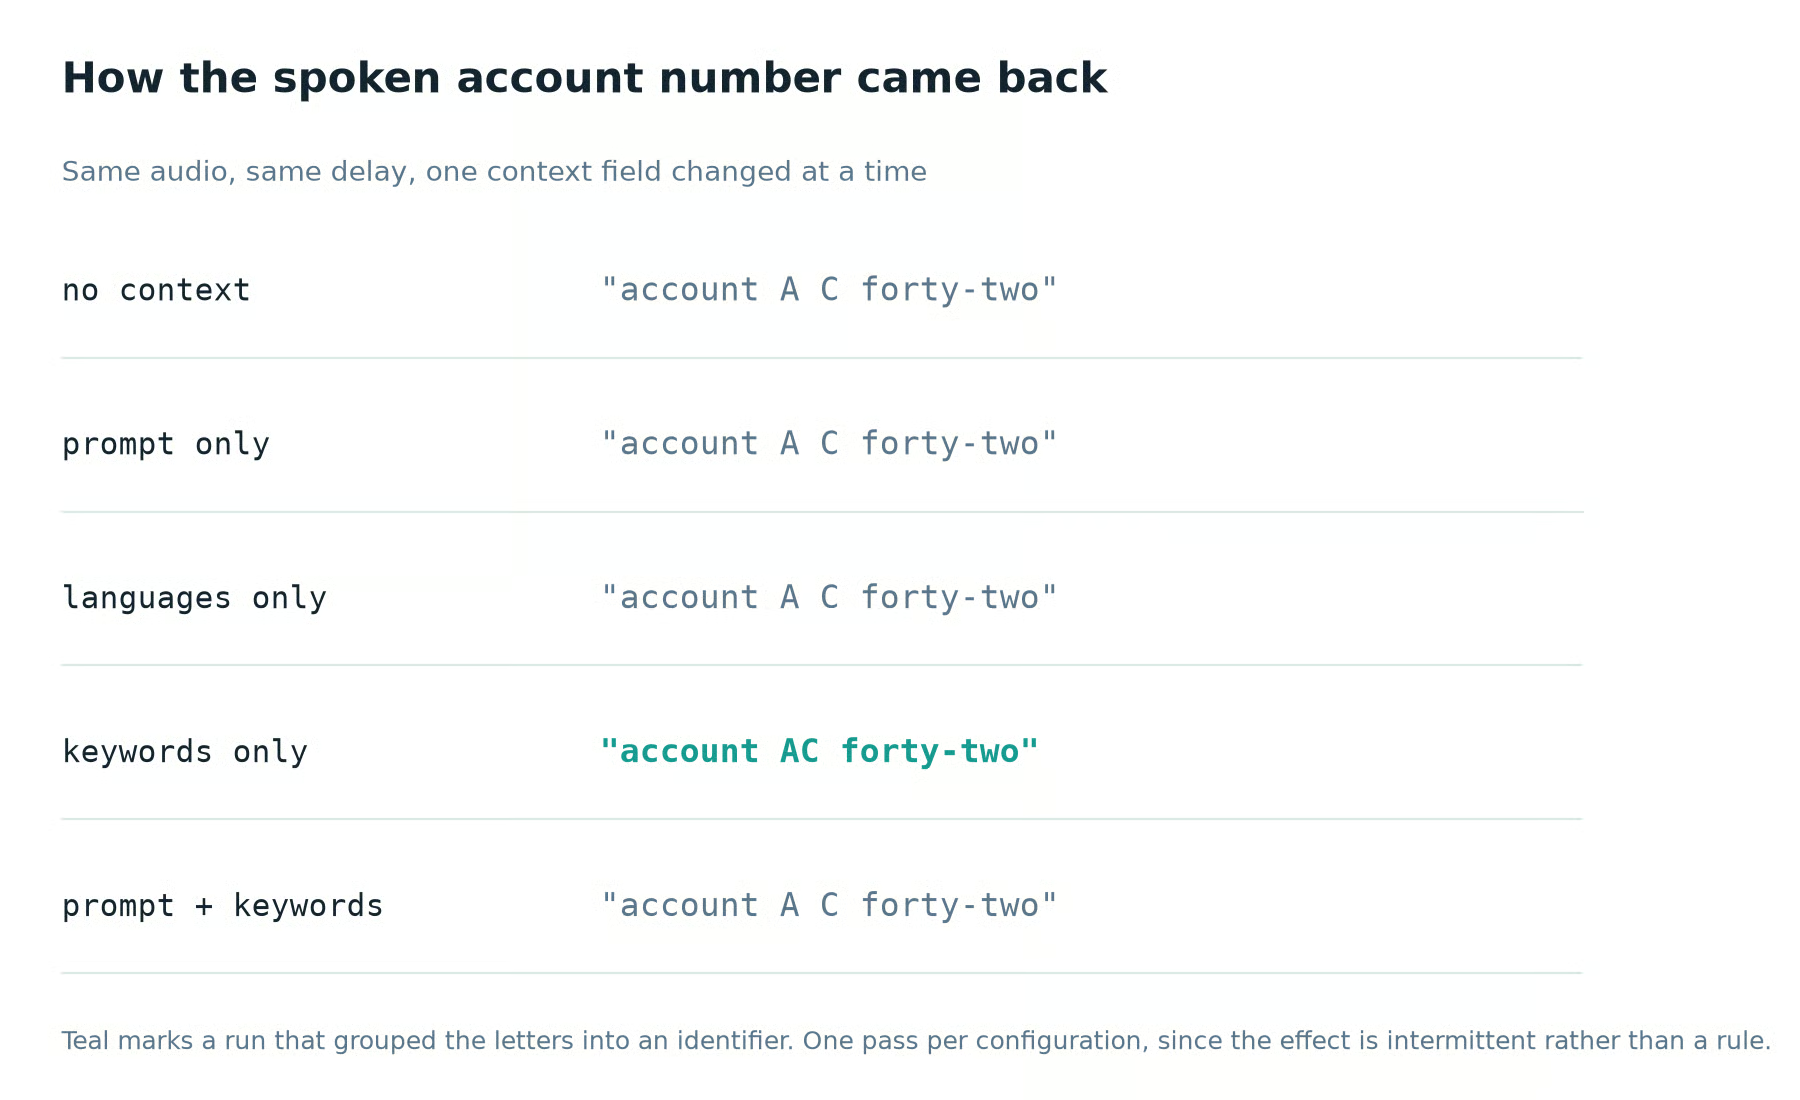
Solo las keywords agruparon el identificador hablado. Imagen del autor.
Las pistas de idioma ayudaron más claramente, y en un problema inesperado. Sin pista, en el clip con cambio de código el relleno inicial en árabe, algo como "tayyib", se oía como "But" en inglés, y fusionaba ambos sistemas de escritura en una palabra rota. También transcribía "billing statement" fonéticamente en alfabeto árabe en algunas pasadas y lo dejaba en latino en otras. Añadir languages: ["ar", "en"] eliminó la palabra rota en todas las pasadas. Es un solo clip, eso sí, y una frase que cambia de idioma a mitad es el sitio más fácil para que una pista se note.
delay acepta cinco valores: minimal, low, medium, high y xhigh. A menor valor, antes pueden llegar los parciales. A mayor valor, el modelo ve más contexto de audio antes de comprometerse con el texto, lo que puede mejorar la precisión en audio difícil. OpenAI es claro: los tiempos exactos varían según la configuración y hay que medirlos con audio representativo. Eso hace la Prueba 3.
test3_delay_benchmark.py envía el mismo WAV por los cinco niveles, varias veces cada uno, registrando el tiempo desde que empieza el stream hasta el primer delta y hasta el final. Mantener idénticos el audio, el contexto y la estrategia de commits es lo que da sentido a la comparación.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Estas cifras no son universales. Son de tres ejecuciones por nivel en un clip, una red y una tarde. La mediana del tiempo al primer parcial fue de 0,70 s en minimal y de 2,91 s en xhigh, subiendo en escalones regulares a través de low (1,19 s), medium (1,39 s) y high (2,09 s). Las tres pasadas por nivel quedaron dentro de unas dos décimas de segundo entre sí, así que el orden es estable aunque los números sean los míos.
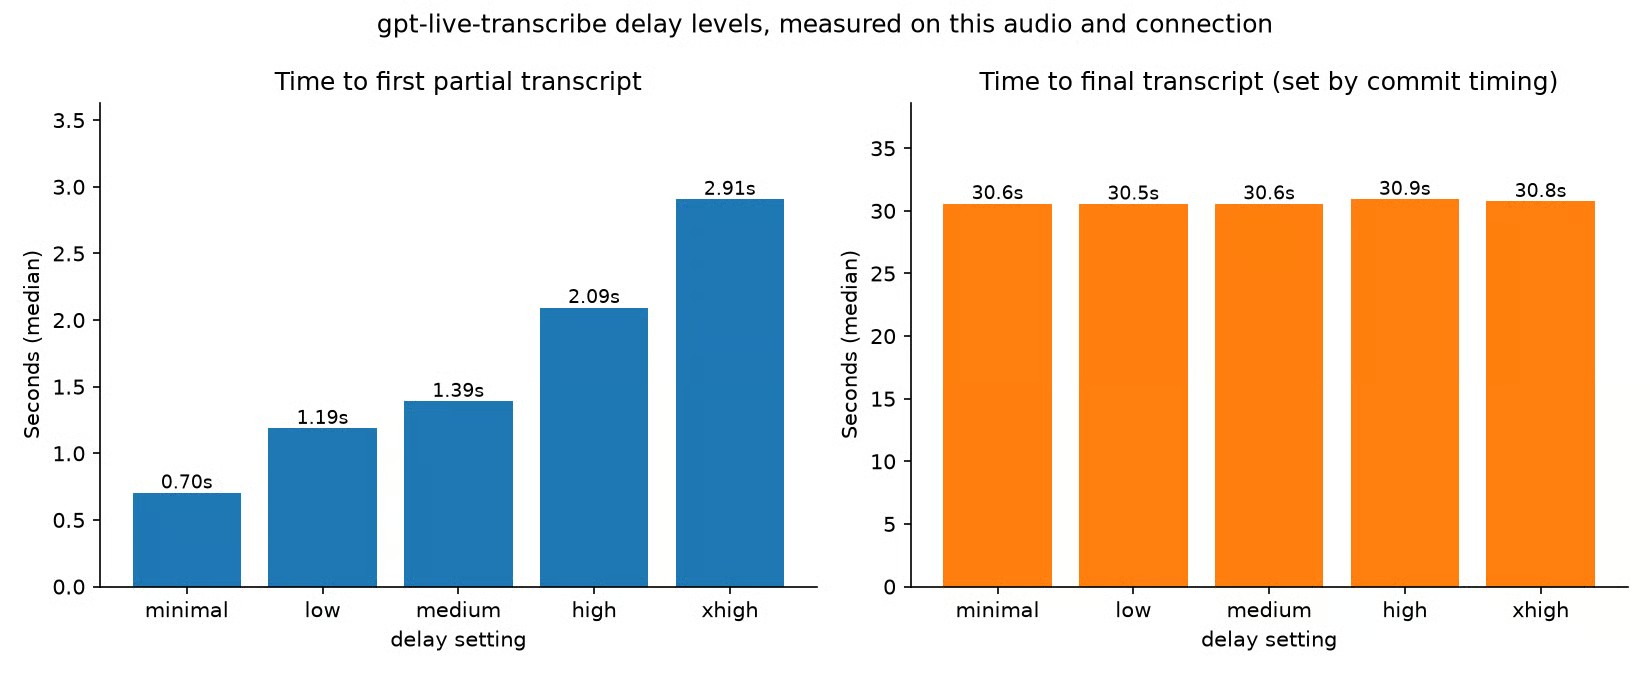
Los niveles de latencia cambian velocidad por precisión. Imagen del autor.
No pude confirmar la suposición habitual de que mayor latencia signifique menos revisiones. Los recuentos de deltas quedaron entre 84 y 86 en todos los niveles, lo bastante parejos como para no ver tendencia. El tiempo a final se mantuvo a medio segundo de 30,6 s en todas partes, pero eso refleja mi temporización de commits, no el modelo. Por eso el gráfico separa ambas medidas: en un eje, dos segundos desaparecen bajo barras diez veces más altas.
Para subtítulos en directo que alguien lee mientras otra persona habla, empieza en low. Dos segundos sin texto se sienten a avería más que una corrección un momento después. Para actas de reunión que nadie lee hasta luego, high o xhigh cuestan casi nada. Para comandos de voz, inclínate a medium, porque una palabra mal en un comando de dos importa más.
Hasta ahora usé turn_detection: null y commit manual. La Realtime API ofrece detección de actividad de voz como alternativa, así que la conecté con gpt-live-transcribe en vez de asumir. Casi recorto esta sección cuando la prueba falló. Luego resultó que el fallo era el hallazgo.
server_vad trocea por silencios, configurable con threshold, prefix_padding_ms y silence_duration_ms. semantic_vad usa un clasificador que estima si quien habla ha terminado, con eagerness para controlar lo rápido que decide:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Así lo documenta la Realtime API en general. En una sesión gpt-live-transcribe, ese payload vuelve rechazado:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad devolvió el mismo error. A 4 de agosto de 2026, el commit manual es el único modo de detección de turnos que gpt-live-transcribe acepta, aunque la guía de transcripción aún te diga que configures VAD para que el servidor confirme turnos por ti. Vuelve a probar antes de construir sobre ello, porque OpenAI podría activar VAD en este modelo sin avisar.
Push-to-talk es el caso sencillo: pulsar y soltar ya marcan límites. En el resto, el cliente decide cuándo terminó un turno, y mis dos primeros intentos fallaron.
El primero protegía el commit con if not mic_queue.empty(), que suena lógico y nunca se dispara: la corrutina que drena la cola la vacía tan rápido como el micrófono la llena. Los parciales seguían llegando, lo que lo hacía convincente, pero nada se finalizaba. El segundo hacía commit cada cuatro segundos si se había añadido audio. Con un micrófono real produjo esto:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Dos fallos a la vez. El temporizador cortó la frase a media palabra y el modelo leyó un fragmento que empieza en ninguna parte como "Abort". Luego hizo commit mientras yo no hablaba y devolvió una transcripción vacía, porque un micrófono emite fragmentos hables o no.
Ambos vienen de la misma información que faltaba: energía del audio. SpeechGate en mic_stream.py sigue la amplitud RMS de cada fragmento y confirma cuando alguien ha hablado y luego hay silencio, con un tope para que hablar sin parar también termine en algún momento. Mi primera versión comparaba con un número fijo: funcionó en una máquina y falló por un factor cinco en la siguiente. Ahora estima el ruido de sala y toma como voz lo que suena varias veces más fuerte. Un turno que acaba con casi nada de audio, una tos o una puerta, va a input_audio_buffer.clear en vez de commit, porque preguntarle al modelo qué dijo una puerta es invitar a una palabra inventada.
app.py reúne todo en una aplicación de terminal: captura del micrófono, subtítulos parciales en vivo, historial de transcripciones con clave item_id y flags de CLI para cada campo que acepta la sesión.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNombra solo los idiomas que realmente estés hablando. Ese mismo comando con en,ar sobre audio en inglés devolvió la palabra "delta" transliterada al alfabeto árabe, que es el hallazgo de la Prueba 2 en sentido inverso.
--turn-detection está en manual por defecto, y --silence-hold y --max-turn ajustan la compuerta de la sección anterior. Los modos VAD siguen como flags por si la API empieza a aceptarlos; pasa cualquiera y la app imprimirá el rechazo del servidor en vez de quedarse colgada en silencio.
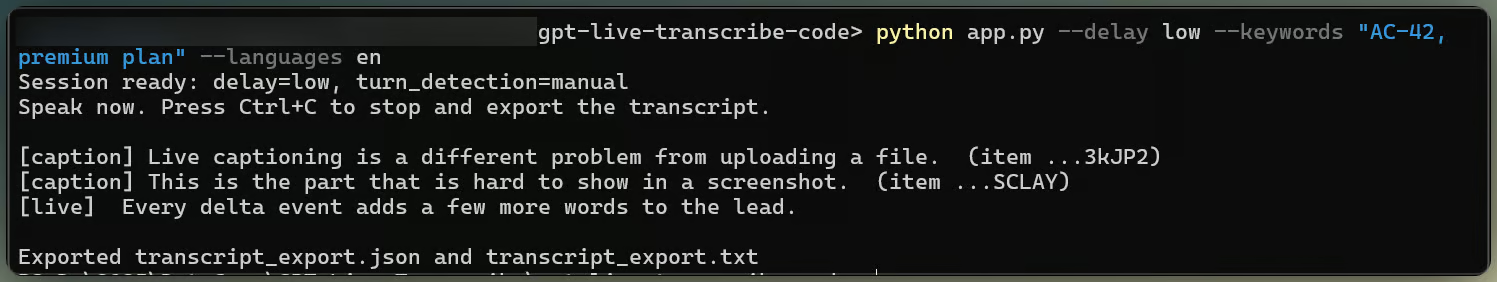
App completa de subtitulado en ejecución con ajustes. Imagen del autor.
Al salir, escribe una transcripción en texto plano y un JSON con la configuración usada, el tiempo al primer delta medido localmente y cada turno finalizado con su item_id. Añadí esa exportación tras perder una buena prueba por cerrar la terminal. Las marcas de tiempo son del lado cliente: no confundas tu instrumentación con una cifra de OpenAI.
Las tres pruebas también funcionan en navegador. demo_app.py es una versión en Streamlit con una pestaña por experimento. La dejo como demo más que como vía principal de aprendizaje, porque los scripts de terminal muestran los eventos en crudo con más claridad.
streamlit run demo_app.pyAprende con DataCamp
Curso
Curso
Curso
blog
Matt Crabtree
13 min
Tutorial
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
12 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Richie Cotton
14 min
Tutorial
Dimitri Didmanidze
5 min