
Courses
Làm việc với OpenAI API
3 giờ
172.8K
Tải một tệp âm thanh hoàn chỉnh lên điểm cuối chép lời là phiên bản dễ của bài toán này. Bạn đợi toàn bộ tệp, rồi nhận về một bản chép lời. Không ai phải nhìn chằm chằm vào màn hình trong lúc mô hình xử lý. Chú thích trực tiếp lại là công việc khác: âm thanh liên tục đổ về khi bạn vẫn đang quyết định làm gì với phần đã có, và văn bản phải cập nhật khi người nói vẫn đang nói.
Đó là khoảng trống gpt-live-transcribe lấp đầy. OpenAI ra mắt ngày 28 tháng 7, 2026 cùng một phiên bản theo lô, gpt-transcribe. Trong hướng dẫn này tôi xây dựng một client phụ đề bằng Python xoay quanh nó và chạy ba thử nghiệm: một client streaming cơ bản, so sánh các gợi ý ngữ cảnh mà nó chấp nhận, và đo hiệu năng năm mức độ trễ. Tôi thử với tiếng Anh rõ ràng, từ vựng kỹ thuật, và chuyển mã Ả Rập Ai Cập - Anh, vì điều đó gần với một cuộc họp thực tế hơn là một người dẫn chuyện đọc sạch.
Kết thúc, bạn sẽ có một ứng dụng chú thích hoạt động, hiểu được thiết lập ngữ cảnh nào thực sự hữu ích, và chọn được mức trễ bạn có thể bảo vệ thay vì đoán mò.
gpt-live-transcribe là mô hình chuyển giọng nói thành văn bản theo luồng dành cho các ứng dụng cần văn bản chép lời khi âm thanh vẫn đang được gửi lên. Nó nhận âm thanh vào và trả văn bản ra, không gì khác, được tinh chỉnh bằng bốn trường: delay cho độ trễ, prompt cho ngữ cảnh tự do, keywords cho các thuật ngữ nguyên văn, và languages cho các ngôn ngữ đầu vào dự kiến. Trên benchmark Context Aware ASR của OpenAI, ngữ cảnh tự do nâng độ chính xác ngữ nghĩa từ 38,5% lên 44,6%, đó là lý do có Bài kiểm tra 2.
Mô hình chạy bên trong Realtime API, không phải một endpoint riêng, và nó không liên quan đến GPT-Live, hệ thống thoại của OpenAI, dù tên gọi có thể gợi ý điều đó. Bạn mở một phiên chép lời, cấu hình nó, và máy chủ sẽ stream các sự kiện trả về qua cùng kết nối bạn gửi âm thanh. Vậy còn một câu hỏi cần giải quyết trước: trong hai mô hình chép lời thì bạn thực sự cần cái nào.
OpenAI cung cấp hai mô hình chép lời được khuyến nghị, và chúng không thể hoán đổi cho nhau. gpt-live-transcribe dành cho âm thanh đến liên tục: micro, cuộc gọi, luồng media, nơi bạn cần văn bản một phần trước khi người nói kết thúc. gpt-transcribe dành cho bản ghi đã hoàn tất, hoặc một phiên Realtime nơi bạn chủ ý chờ một lượt được chốt. Tài liệu gọi trường hợp thứ hai là một quy trình chuyên biệt, không phải cách để nhận delta trực tiếp.
Một khác biệt dễ gây nhầm lẫn: gpt-transcribe trả về mảng languages với ngôn ngữ đầu vào được phát hiện, còn gpt-live-transcribe thì không. Nếu logic của bạn rẽ nhánh theo ngôn ngữ phát hiện được, bạn đang chọn sai mô hình, bất kể phụ đề của nó trông đẹp thế nào trong demo. Giá cũng chia theo cùng ranh giới, xấp xỉ bốn trên một nghiêng về mô hình theo lô, tôi sẽ quay lại sau.
Tôi muốn nói rõ điều này ngay bây giờ hơn là sau khi bạn đã xây nửa ứng dụng quanh nó. Không có mốc thời gian cấp từ, không có nhãn người nói, không có điểm tin cậy, và không có phân vai (diarization). Nếu bạn cần thời gian phụ đề, ghi chú ai nói, hoặc ngưỡng tin cậy, hướng dẫn của OpenAI trỏ sang gpt-4o-transcribe-diarize hoặc whisper-1.
Mỗi script trong hướng dẫn này đều nằm ở github.com/KhalidAbdelaty/gpt-live-transcribe, nên hãy bắt đầu bằng cách clone. Bạn cần Python 3.10 trở lên và một khóa API có quyền Realtime. Bản thân các script dựa trên bốn gói: websockets cho kết nối, sounddevice cho thu âm micro, numpy cho chuyển đổi bộ đệm, và python-dotenv để nạp khóa. Tệp requirements bổ sung vài gói nữa cho biểu đồ và bản demo trên trình duyệt.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Trên macOS, sounddevice cần PortAudio ở mức hệ điều hành (brew install portaudio); trên Linux là apt-get install portaudio19-dev. Bỏ qua dòng đó nếu bạn dùng Windows. Tôi đã gặp lỗi trên macOS và cách khắc phục thực sự chỉ là cài đặt duy nhất này.
Bản thân âm thanh phải gửi dạng PCM 16-bit ở 24 kHz, mono, little-endian, mã hóa base64. Gửi MP3 hoặc WAV stereo và bạn sẽ nhận đầu ra sai bét hoặc kết nối bị đóng, chứ không có thông báo nào nói bạn sai định dạng. Vấn đề này có thể khiến bạn mất cả buổi chiều. Vậy câu hỏi tiếp theo là chọn kết nối nào để mang âm thanh.
Khuyến nghị của OpenAI rất rõ: WebSocket cho ứng dụng server-to-server, WebRTC cho client trình duyệt và di động. Hướng dẫn này xây backend Python đọc micro cục bộ, nên WebSocket là lựa chọn đúng, và dùng khóa API chuẩn vẫn ổn vì nó không rời máy chủ của bạn.
Một phiên bắt đầu bằng sự kiện session.update thiết lập type: "transcription" và chọn gpt-live-transcribe làm mô hình. Mọi thứ khác trong payload mô tả âm thanh bạn sắp gửi. Đây là cấu hình tối thiểu, từ hướng dẫn chép lời Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None tắt phát hiện hoạt động giọng nói tự động, nên sẽ không có gì được chốt cho tới khi bạn chủ động commit. Ba sự kiện từ client thực hiện công việc: input_audio_buffer.append gửi một khối âm thanh base64, input_audio_buffer.commit kết thúc một lượt, và máy chủ trả về conversation.item.input_audio_transcription.delta (văn bản tạm thời) và conversation.item.input_audio_transcription.completed (văn bản cuối). Tôi kết nối tới wss://api.openai.com/v1/realtime?intent=transcription, một mẫu từ cookbook của OpenAI; hướng dẫn không tài liệu hóa chuỗi truy vấn đó, nên hãy bỏ nếu một ngày nó ngừng hoạt động.
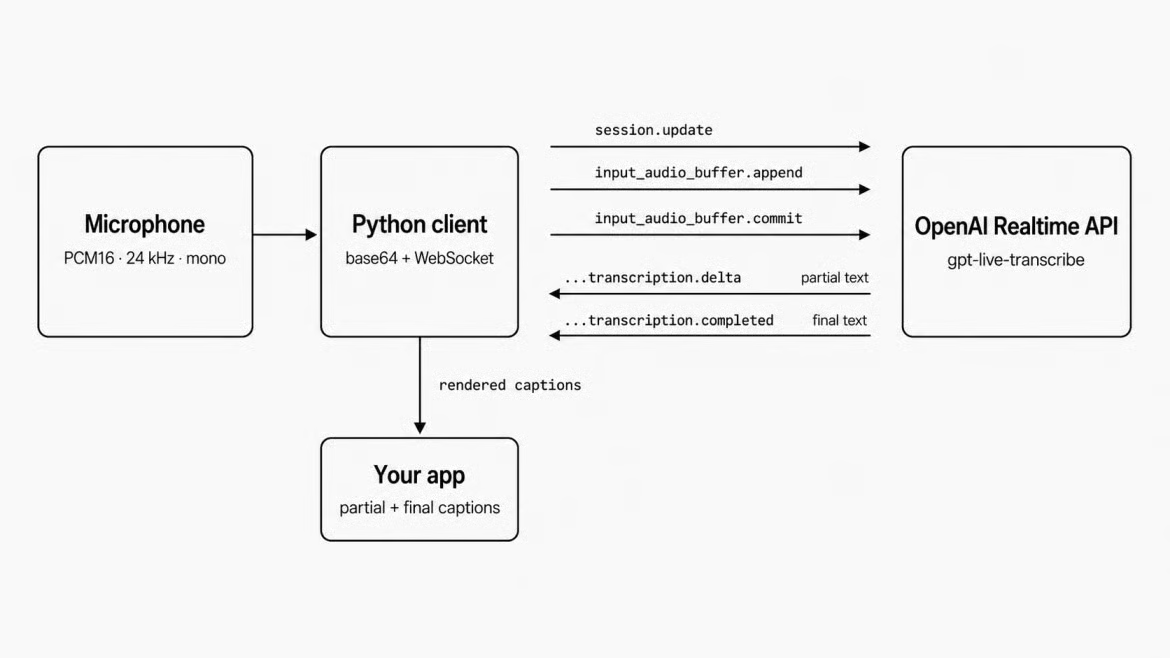
Sơ đồ luồng sự kiện phiên chép lời Realtime. Ảnh: Tác giả.
Bài kiểm tra 1 là phiên bản nhỏ nhất hoạt động: thu âm thanh từ micro, stream lên, in văn bản tạm và cuối cùng khi nó đến. Không ngữ cảnh, không từ khóa, không tinh chỉnh gì, để luồng sự kiện vẫn rõ ràng. Vấn đề đầu tiên là kéo âm thanh khỏi luồng micro mà không làm nó ngừng trệ.
sounddevice chạy callback của nó trên luồng riêng với vài mili-giây để trả về trước khi driver rơi khung, nên nó không thể chờ một cuộc gọi mạng. Nhiệm vụ duy nhất của nó là chuyển bộ đệm float32 sang PCM16 và đẩy lên một asyncio.Queue thông qua loop.call_soon_threadsafe, trong khi một coroutine riêng rút hàng đợi đó và gửi từng khối.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Một khối 100 mili-giây (2.400 mẫu ở 24 kHz) là điểm khởi đầu hợp lý. Nhỏ hơn thì tăng chi phí mỗi thông điệp, lớn hơn nhiều thì phụ đề sẽ thấy trễ. Không có con số đúng được tài liệu hóa, nên hãy coi đây là một núm xoay.
Delta rẻ và dày. Mỗi delta mang một đoạn văn bản gắn với một item_id. Nối nó vào văn bản tạm bạn đã có cho mục đó, và phụ đề sẽ lớn dần từng từ trên màn hình:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Một sự kiện completed sẽ thay thế đoạn tạm đó bằng bản chép lời đã chốt cho cùng mục. Hãy coi completed là nguồn sự thật và delta là bản xem trước, không phải thứ bạn tự ghép chuỗi lại.
Đây là chi tiết sẽ làm vỡ UI nếu bạn bỏ qua: hướng dẫn của OpenAI nêu rõ thứ tự giữa các sự kiện hoàn tất từ những lượt khác nhau không được đảm bảo. Một sự kiện completed cho lượt trước có thể đến sau lượt sau, nên code giả định completed mới nhất thuộc về lượt mới nhất sẽ đôi khi nhảy lùi hoặc lặp một dòng. Hãy khóa mọi thứ theo item_id thay vào đó, đó là điều lớp TranscriptState của tôi thực hiện.
Khi xây nó tôi bắt được hai lỗi, đều do kiểm tra sai dictionary. Chỉ thêm item_id vào danh sách thứ tự ở handler delta khiến full_transcript() rỗng với bất kỳ bên nhận nào chỉ xử lý sự kiện completed. Dùng dictionary partials để quyết định một mục có mới hay không còn tệ hơn: apply_completed() xóa mục đó, nên một delta đến muộn trông như mới toanh, lại được thêm vào danh sách thứ tự lần thứ hai, và in lượt đã xong hai lần. Hãy theo dõi item_id ở cả hai handler, và kiểm tra danh sách thứ tự thay vì partials.
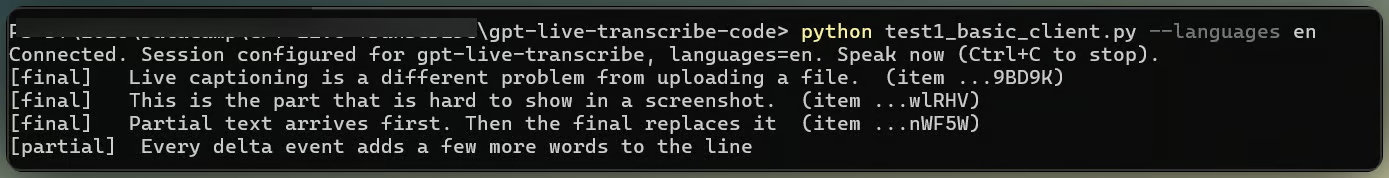
Phụ đề tạm thời chuyển thành bản chép lời. Ảnh: Tác giả.
Với tiếng Anh sạch, văn bản xuất hiện trong vòng một hai giây và khớp những gì tôi nói, cả dấu câu. Nhưng qua micro laptop và không đặt ngữ cảnh, đôi khi một từ mô hình không chắc lại trả về bằng hệ chữ khác hẳn. languages là trường dành cho vấn đề đó, và đó là điều Bài kiểm tra 2 nhắm tới.
Mô hình chấp nhận ba loại ngữ cảnh, đáng để nói chính xác trước khi thử nghiệm. prompt là văn bản tự do mô tả bối cảnh, keywords là các thuật ngữ nguyên văn có thể xuất hiện trong âm thanh, và languages liệt kê các ngôn ngữ đầu vào dự kiến theo mã ISO 639-1 như en hoặc ar. Không trường nào ép đầu ra. Một từ khóa không được nói sẽ không xuất hiện chỉ vì bạn liệt kê nó, và cách duy nhất để biết các trường này thực sự làm gì là thay đổi từng trường một.
Tôi chạy cùng một đoạn clip qua năm cấu hình, mỗi cấu hình ba lượt. Hai quy tắc giữ cho so sánh như vậy trung thực: chỉ một trường ngữ cảnh thay đổi giữa các lượt, và mỗi cấu hình chạy nhiều hơn một lần, vì mô hình không tất định trên cùng âm thanh.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Phiên bản đầu của tôi đặt languages chỉ ở lượt kết hợp, vi phạm quy tắc đầu: hai trường đổi cùng lúc, nên bất kỳ khác biệt nào ở đó có thể do một trong hai. Một quy tắc định dạng cũng khiến tôi bị từ chối cập nhật phiên: một từ khóa chứa <, >, carriage return, hoặc line feed sẽ làm từ chối toàn bộ cập nhật, không chỉ từ khóa đó. TranscriptionConfig.validate_keywords() bắt lỗi này trước khi dựng payload.
Từ khóa giúp ở kiểu âm thanh bạn trông đợi. Mỗi lượt đều chép số tài khoản thành từ vì đó là nội dung âm thanh. Câu hỏi là liệu mô hình có nhóm các từ đó thành một định danh hay đánh vần từng chữ như "A C forty-two."
Qua mười lăm lượt kết quả phân hóa rõ. Bất kỳ cấu hình nào không có keywords đều không nhóm: no_context, prompt_only, và languages_only đều trả "A C forty-two" trên cả chín lượt của chúng. Các lượt có keywords nhóm được ở năm trong sáu lượt, chủ yếu thành "AC-42" với định dạng đầy đủ. Vậy keywords dịch chuyển kết quả còn prompt đơn lẻ thì không, đúng với cách OpenAI mô tả keywords là trường cho các thuật ngữ nguyên văn mà mô hình có thể phân tích sai. Chỉ từ khóa vẫn trượt một lần, nên hãy coi đó là gợi ý nghiêng mạnh xác suất chứ không phải quy tắc bắt buộc mô hình phải theo.
Điều này có vẻ lệch với con số benchmark tôi mở đầu, nơi ngữ cảnh tự do nâng độ chính xác ngữ nghĩa thêm sáu điểm. Hai thử nghiệm đo hai thứ khác nhau: OpenAI chấm ý nghĩa trên một tập âm thanh rộng, trong khi tôi quan sát một định danh trong một clip. Một prompt có thể làm việc thực sự trên câu nhưng vẫn bỏ qua chi tiết hẹp bạn đang kiểm. Dấu hiệu duy nhất ở đây là prompt và keywords cùng nhau nhóm được ở mọi lượt, trong khi chỉ keywords thì lỡ một, khác biệt đúng một lượt.
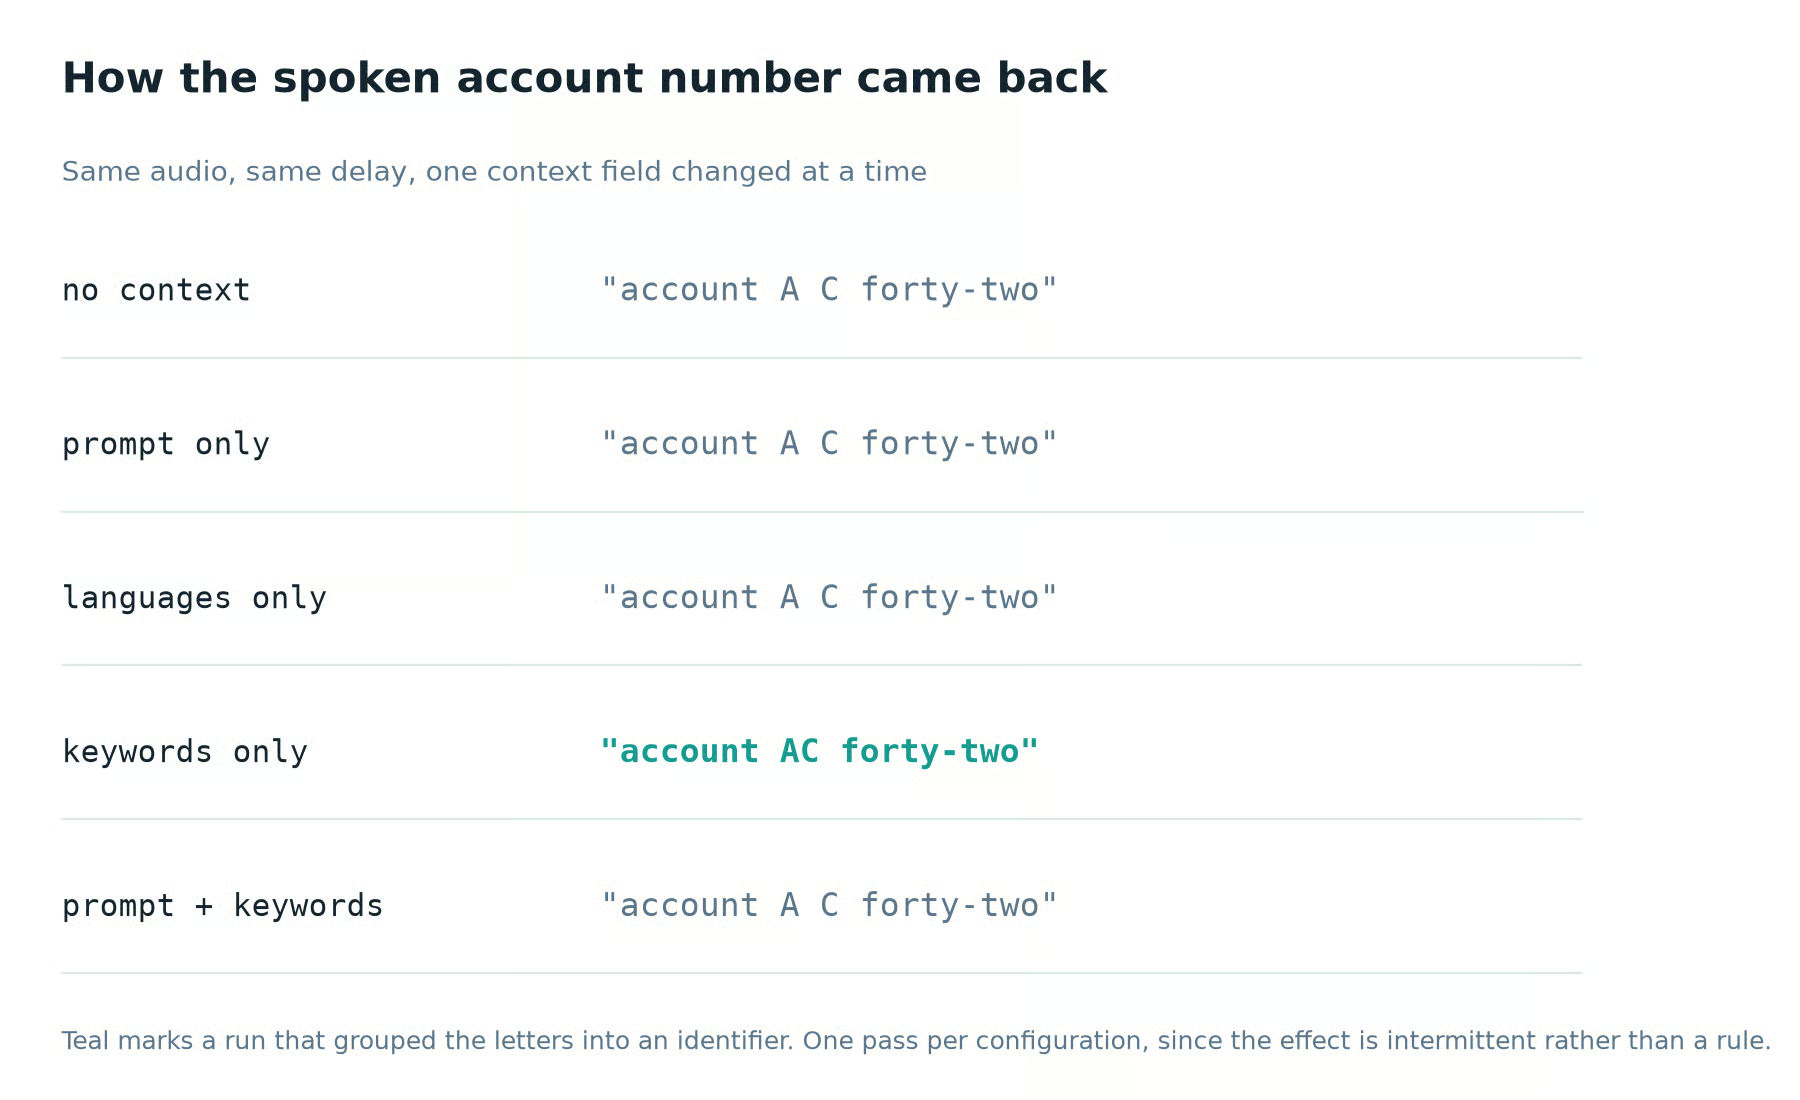
Chỉ từ khóa mới nhóm được định danh nói. Ảnh: Tác giả.
Gợi ý ngôn ngữ giúp rõ rệt hơn, và ở một vấn đề tôi không ngờ. Không có gợi ý, các lượt trên clip chuyển mã cứ nghe từ đệm mở đầu bằng tiếng Ả Rập, tương đương "tayyib", thành tiếng Anh "But," và trộn hai hệ chữ thành một từ hỏng. Chúng cũng đánh vần "billing statement" theo âm trong chữ Ả Rập ở vài lượt và để nguyên chữ Latin ở lượt khác. Thêm languages: ["ar", "en"] loại bỏ từ hỏng ở mọi lượt. Dù vậy đó chỉ là một clip, và câu đổi ngôn ngữ giữa chừng là nơi dễ để gợi ý phát huy nhất.
delay có năm giá trị: minimal, low, medium, high, và xhigh. Mức thấp hơn có thể cho văn bản tạm sớm hơn. Mức cao hơn cho mô hình thêm ngữ cảnh âm thanh trước khi chốt văn bản, có thể cải thiện độ chính xác với âm thanh khó. OpenAI nói rõ thời gian chính xác thay đổi theo cấu hình và nên được đo với âm thanh đại diện, đó là điều Bài kiểm tra 3 thực hiện.
test3_delay_benchmark.py stream cùng một tệp WAV qua cả năm mức, nhiều lượt mỗi mức, ghi thời gian từ khi bắt đầu stream tới delta đầu tiên và tới bản chép lời cuối. Giữ nguyên âm thanh, trường ngữ cảnh, và chiến lược commit là điều làm cho so sánh có ý nghĩa.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Những con số này không phổ quát. Của tôi đến từ ba lượt mỗi mức trên một clip, một mạng, một buổi chiều. Trung vị thời gian tới đoạn tạm đầu tiên chạy từ 0,70 giây ở minimal đến 2,91 giây ở xhigh, tăng theo bước đều qua low (1,19s), medium (1,39s), và high (2,09s). Ba lượt ở mỗi mức nằm trong khoảng một phần năm giây của nhau, nên thứ tự là ổn định dù con số là của tôi chứ không phải của bạn.
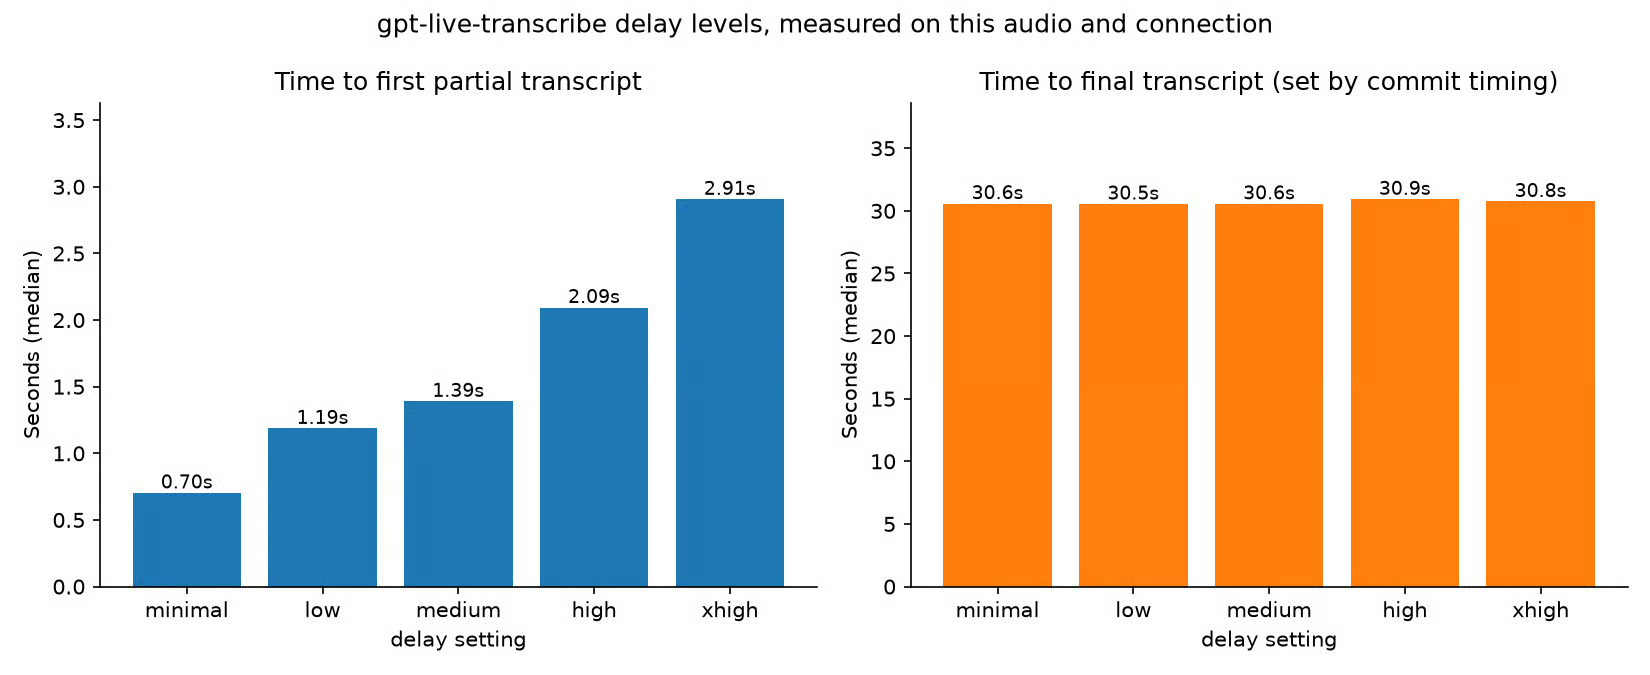
Các mức độ trễ đánh đổi tốc độ lấy độ chính xác. Ảnh: Tác giả.
Điều tôi không xác nhận được là giả định thường thấy rằng độ trễ cao hơn đồng nghĩa ít sửa đổi hơn. Số lượt delta rơi vào khoảng 84 đến 86 ở mọi mức, đủ giống nhau để không thấy xu hướng. Thời gian tới bản cuối ở đâu cũng nằm trong nửa giây quanh 30,6 giây, nhưng đó phản ánh thời điểm tôi commit, không phải mô hình. Đó là lý do biểu đồ tách hai phép đo thành hai bảng: trên một trục, chênh hai giây biến mất dưới các cột cao gấp mười lần.
Với phụ đề trực tiếp người dùng đọc khi có người đang nói, hãy bắt đầu ở low. Chờ hai giây trước khi có dòng chữ đầu tiên tạo cảm giác hỏng, còn một phụ đề được sửa ngay sau đó thì không. Với ghi chú cuộc họp mà không ai đọc ngay, high hoặc xhigh hầu như không tốn gì. Với lệnh thoại, nghiêng về medium, vì sai một từ trong lệnh hai từ quan trọng hơn bình thường.
Mọi thử nghiệm tới giờ đều dùng turn_detection: null và commit thủ công. Realtime API cung cấp phát hiện hoạt động giọng nói như một lựa chọn, nên tôi đã đấu nối nó với gpt-live-transcribe thay vì mặc định nghĩ nó sẽ chạy. Tôi suýt cắt phần này khi thử nghiệm thất bại. Rồi hóa ra thất bại chính là phát hiện.
server_vad chia khối âm thanh theo các khoảng im lặng, có thể cấu hình qua threshold, prefix_padding_ms, và silence_duration_ms. semantic_vad dùng bộ phân loại ước tính người nói đã dừng chưa, với thiết lập eagerness điều khiển tốc độ quyết định:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Đó là cách cả hai chế độ được tài liệu hóa cho Realtime API nói chung. Gửi payload y như vậy tới một phiên gpt-live-transcribe thì bị từ chối:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad cho lỗi y hệt. Tính đến ngày 4 tháng 8, 2026, commit thủ công là chế độ phát hiện lượt duy nhất gpt-live-transcribe chấp nhận, dù hướng dẫn chép lời vẫn bảo bạn cấu hình phát hiện hoạt động giọng nói để máy chủ tự commit lượt. Hãy kiểm tra lại trước khi xây quanh nó, vì OpenAI có thể bật VAD cho mô hình này sau mà không báo.
Nhấn-để-nói là trường hợp dễ, vì nhấn và nhả đã đánh dấu ranh giới. Mọi thứ khác để client quyết định khi nào một lượt kết thúc, và hai nỗ lực đầu của tôi đều sai.
Nỗ lực một bảo vệ commit bằng if not mic_queue.empty(), nghe có lý nhưng không bao giờ kích hoạt: coroutine rút hàng đợi đó làm trống nó nhanh như micro đổ vào. Phụ đề tạm vẫn stream, khiến nó thuyết phục, nhưng không có gì được chốt. Nỗ lực hai commit mỗi bốn giây miễn là đã append âm thanh. Với micro thật điều đó tạo ra:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Hai lỗi cùng lúc. Bộ đếm giờ cắt câu giữa chừng, và mô hình đọc một mảnh bắt đầu từ hư không thành "Abort." Rồi nó commit khi tôi không nói và trả bản chép rỗng, vì micro stream khối dữ liệu dù có ai nói hay không.
Cả hai đều do thiếu cùng một thông tin: năng lượng âm thanh. SpeechGate trong mic_stream.py theo dõi biên độ RMS của mỗi khối và commit khi người nói đã nói gì đó rồi im lặng, với một giới hạn để nói liên tục vẫn kết thúc ở đâu đó. Phiên bản đầu của tôi so sánh biên độ đó với một con số cố định, hoạt động trên một máy và sai gấp năm lần trên máy khác, nên giờ nó ước lượng tiếng ồn phòng và coi bất cứ thứ gì to hơn nhiều lần là giọng nói. Một lượt kết thúc bằng gần như không có âm, ho hay tiếng cửa, sẽ gọi input_audio_buffer.clear thay vì commit, vì hỏi mô hình xem một cánh cửa nói gì là cách bạn nhận được một từ bịa.
app.py kết hợp mọi phần trong hướng dẫn này thành một ứng dụng terminal: thu micro, phụ đề tạm trực tiếp, lịch sử bản chép khóa theo item_id, và cờ CLI cho mọi trường phiên chấp nhận.
python app.py --delay low --keywords "AC-42,premium plan" --languages enChỉ nêu các ngôn ngữ bạn thực sự nói. Cùng lệnh đó với en,ar trên tiếng Anh đã trả từ "delta" được phiên âm sang chữ Ả Rập, đó là phát hiện của Bài kiểm tra 2 theo chiều ngược lại.
--turn-detection mặc định là manual, và --silence-hold và --max-turn tinh chỉnh cổng từ phần trước. Các chế độ VAD vẫn là cờ đề phòng API bắt đầu chấp nhận; truyền một trong hai và ứng dụng sẽ in thông báo từ chối của máy chủ thay vì treo im lặng.
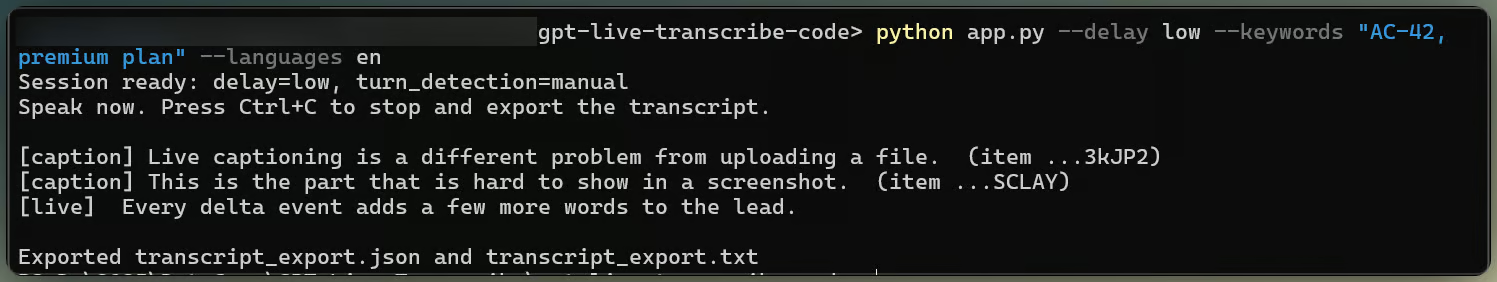
Ứng dụng chú thích hoàn chỉnh chạy cùng thiết lập. Ảnh: Tác giả.
Khi thoát, ứng dụng ghi một bản chép văn bản thuần và một tệp JSON với cấu hình đã dùng, thời gian tới delta đầu tiên đo cục bộ, và mỗi lượt đã chốt cùng item_id. Tôi thêm xuất này sau khi mất một lượt thử nghiệm tốt do đóng terminal. Dấu thời gian trong đó là phía client, nên đừng nhầm công cụ đo của bạn với con số của OpenAI.
Cả ba thử nghiệm cũng chạy trên trình duyệt. demo_app.py là phiên bản Streamlit với một tab cho mỗi thí nghiệm, giữ như bản demo thay vì đường chính để giảng dạy, vì script terminal cho thấy sự kiện thô trực diện hơn.
streamlit run demo_app.pyHọc với DataCamp
Courses
Courses
Courses