Cours
Travailler avec l'API OpenAI
3 h
172.6K
Téléverser un fichier audio terminé vers un point de terminaison de transcription, c’est la version simple du problème. Vous attendez la fin du fichier, puis vous récupérez une transcription unique. Personne n’a les yeux rivés à l’écran pendant que le modèle travaille. Le sous-titrage en direct, c’est autre chose : l’audio continue d’arriver pendant que vous décidez quoi faire de ce que vous avez déjà, et le texte doit se mettre à jour alors que l’intervenant parle encore.
C’est précisément ce que gpt-live-transcribe comble. OpenAI l’a publié le 28 juillet 2026 avec un pendant par lots, gpt-transcribe. Dans ce tutoriel, je construis un client de sous-titrage en Python et je lance trois tests : un client de streaming de base, une comparaison des indices de contexte qu’il accepte, et un benchmark de ses cinq niveaux de délai. J’ai testé avec de l’anglais clair, du vocabulaire technique et du code-switching arabe égyptien–anglais, car c’est plus proche d’une réunion réelle qu’un narrateur unique et propre.
Au bout du compte, vous aurez une application de sous-titrage fonctionnelle, une idée claire des paramètres de contexte vraiment utiles, et un réglage de délai défendable plutôt qu’au doigt mouillé.
gpt-live-transcribe est un modèle de reconnaissance vocale en streaming destiné aux applications qui ont besoin de texte alors que l’audio arrive encore. Il prend de l’audio en entrée et renvoie du texte en sortie, rien d’autre, réglé par quatre champs : delay pour la latence, prompt pour le contexte libre, keywords pour les termes littéraux, et languages pour les langues d’entrée attendues. Sur le benchmark Context Aware ASR d’OpenAI, le contexte libre a fait passer la précision sémantique de 38,5 % à 44,6 %, d’où le Test 2.
Le modèle s’exécute dans la Realtime API, et non comme un endpoint séparé, sans lien avec GPT-Live, le système vocal d’OpenAI, malgré ce que les noms pourraient laisser penser. Vous ouvrez une session de transcription, vous la configurez, et le serveur renvoie des événements en streaming sur la même connexion qui reçoit l’audio. Cela pose d’abord une question : lequel des deux modèles de transcription vous faut-il vraiment.
OpenAI propose deux modèles de transcription recommandés, qui ne sont pas interchangeables. gpt-live-transcribe est fait pour de l’audio qui arrive en continu : microphone, appel téléphonique, flux média, quand vous avez besoin de texte partiel avant la fin de l’intervenant. gpt-transcribe convient aux enregistrements terminés, ou à une session Realtime où vous attendez volontairement une prise de tour validée. La documentation appelle ce deuxième cas un workflow spécialisé, pas un moyen d’obtenir des deltas en direct.
Une différence piège souvent : gpt-transcribe renvoie un tableau languages avec la langue d’entrée détectée, gpt-live-transcribe non. Si votre logique dépend de la langue détectée, vous n’utilisez pas le bon modèle, même si ses sous-titres semblent excellents en démo. La tarification se découpe le long de la même ligne, environ de un à quatre en faveur du modèle par lots, j’y reviens plus loin.
Autant le dire tout de suite, avant que vous n’ayez construit la moitié d’une app autour. Pas d’horodatage au mot, pas d’étiquettes d’intervenant, pas de scores de confiance, pas de diarisation. Si vous avez besoin d’un minutage de sous-titres, de notes indiquant qui parle, ou d’un seuil de confiance, le guide d’OpenAI oriente vers gpt-4o-transcribe-diarize ou whisper-1.
Tous les scripts de ce tutoriel se trouvent sur github.com/KhalidAbdelaty/gpt-live-transcribe. Commencez par le cloner. Vous avez besoin de Python 3.10 ou plus récent et d’une clé API avec accès Realtime. Les scripts reposent sur quatre packages : websockets pour la connexion, sounddevice pour la capture micro, numpy pour la conversion de tampon, et python-dotenv pour charger la clé. Le fichier requirements ajoute quelques dépendances pour les graphiques et la démo navigateur.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Sur macOS, sounddevice nécessite PortAudio au niveau de l’OS (brew install portaudio) ; sous Linux, c’est apt-get install portaudio19-dev. Passez cette étape sous Windows. J’ai eu ce cas sur macOS : l’installation suffit vraiment.
L’audio doit arriver en PCM 16 bits à 24 kHz, mono, little-endian, encodé en base64. Si vous envoyez un MP3 ou un WAV stéréo, vous aurez une sortie illisible ou une connexion fermée, jamais un message expliquant que le format était incorrect. De quoi perdre l’après-midi. Prochaine question : quelle connexion transporte l’audio ?
La recommandation d’OpenAI est claire : WebSocket pour les applications serveur‑à‑serveur, WebRTC pour les clients navigateur et mobile. Ce tutoriel construit un backend Python qui lit un microphone local : WebSocket est donc le bon choix, et une clé API standard suffit puisqu’elle ne quitte pas votre serveur.
Une session démarre avec un événement session.update qui définit type: \"transcription\" et sélectionne gpt-live-transcribe comme modèle. Le reste de la charge utile décrit l’audio que vous allez envoyer. Voici la configuration minimale, tirée du guide de transcription Realtime :
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None désactive la détection automatique d’activité vocale, donc rien n’est finalisé tant que vous ne validez pas explicitement. Trois événements côté client font le travail : input_audio_buffer.append envoie un bloc audio en base64, input_audio_buffer.commit termine un tour, et le serveur répond par conversation.item.input_audio_transcription.delta (texte partiel) et conversation.item.input_audio_transcription.completed (texte final). Je me connecte à wss://api.openai.com/v1/realtime?intent=transcription, un motif issu du cookbook d’OpenAI ; le guide ne documente pas cette chaîne de requête, supprimez-la si elle cesse de fonctionner.
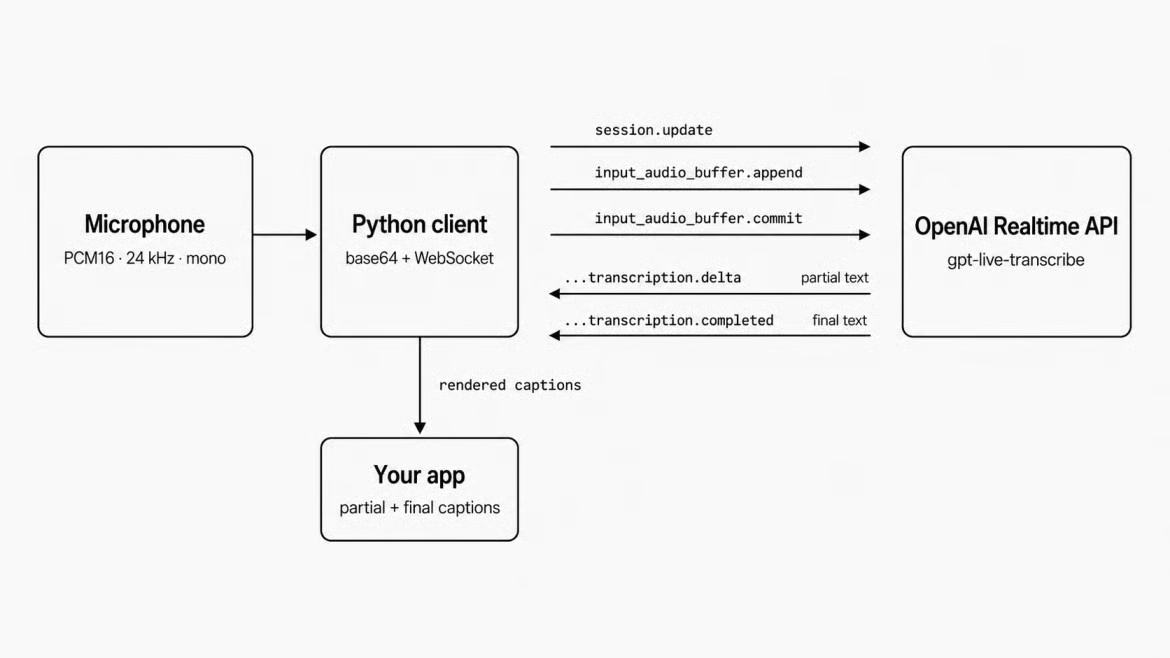
Schéma du flux d’événements d’une session de transcription Realtime. Image de l’auteur.
Le Test 1 est la plus petite version fonctionnelle : capturer l’audio du micro, le diffuser, afficher les textes partiels et finaux à l’arrivée. Pas de contexte, pas de mots-clés, aucun réglage : le flux d’événements reste lisible. Premier enjeu : extraire l’audio du thread micro sans le bloquer.
sounddevice exécute son callback sur son propre thread, avec quelques millisecondes pour répondre avant que le pilote ne perde des frames, donc il ne peut pas attendre un appel réseau. Son unique rôle : convertir le tampon float32 en PCM16 et le déposer dans une asyncio.Queue via loop.call_soon_threadsafe, pendant qu’une coroutine séparée draine cette file et envoie chaque bloc.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Un bloc de 100 ms (2 400 échantillons à 24 kHz) est un bon point de départ. Plus petit : davantage de surcoûts par message. Beaucoup plus grand : des sous-titres qui paraissent à la traîne. Il n’y a pas de valeur officielle : considérez-le comme un réglage à ajuster.
Les deltas sont fréquents et légers. Chacun porte un fragment de texte lié à un item_id. Ajoutez-le au texte partiel déjà reçu pour cet élément, et le sous-titre grandit mot à mot à l’écran :
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Un événement completed remplace ce partiel par la transcription finalisée du même élément. Considérez completed comme source de vérité et les deltas comme prévisualisation, pas comme du texte à concaténer vous-même.
Voici le détail qui cassera votre UI si vous l’ignorez : le guide d’OpenAI indique que l’ordre entre événements completed de tours différents n’est pas garanti. Un événement completed d’un tour antérieur peut arriver après celui d’un tour plus récent ; si votre code suppose que le dernier completed est le plus récent, votre affichage sautera parfois en arrière ou dupliquera une ligne. Indexez tout par item_id, comme le fait ma classe TranscriptState.
En la construisant, j’ai révélé deux bugs, tous deux liés au mauvais dictionnaire consulté. Ajouter item_id à la liste d’ordre seulement dans le handler des deltas laissait full_transcript() vide pour tout récepteur qui ne traite que les événements completed. Utiliser le dictionnaire des partiels pour déterminer si un élément était nouveau fut pire : apply_completed() vide cette entrée, donc un delta tardif semblait tout neuf, entrait une seconde fois dans la liste, et affichait le tour finalisé en double. Suivez item_id dans les deux handlers, et contrôlez la liste d’ordre à la place.
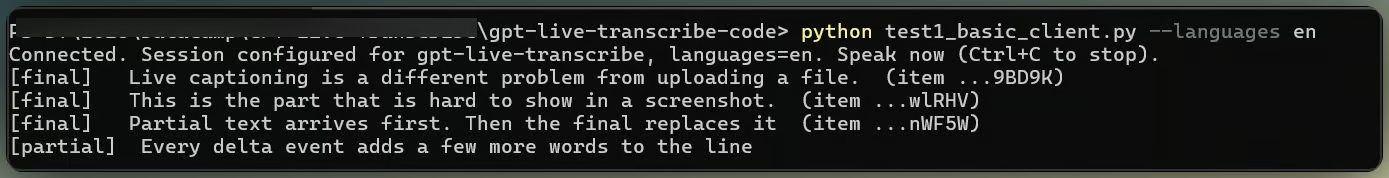
Sous-titres partiels qui se finalisent. Image de l’auteur.
Sur de l’anglais propre, le texte apparaît en une à deux secondes et colle à ce que je dis, ponctuation incluse. Via un micro d’ordinateur portable sans contexte défini, il arrivait toutefois qu’un mot incertain revienne dans un autre alphabet. languages est le champ adéquat, ce que couvre le Test 2.
Le modèle accepte trois types de contexte, à bien distinguer avant de les tester. prompt est un texte libre qui décrit la situation, keywords sont des termes littéraux susceptibles d’apparaître dans l’audio, et languages liste les langues d’entrée attendues en codes ISO 639-1 comme en ou ar. Aucun ne force une sortie. Un mot-clé non prononcé n’apparaîtra pas parce que vous l’avez listé, et la seule façon de comprendre l’effet réel de ces champs, c’est de les faire varier séparément.
J’ai traité le même extrait avec cinq configurations, trois passages chacune. Deux règles pour une comparaison honnête : ne changer qu’un seul champ de contexte entre deux exécutions, et faire plusieurs passages par configuration, car le modèle n’est pas déterministe à audio identique.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Ma première version mettait languages uniquement sur l’exécution combinée, ce qui violait la première règle : deux champs changeaient à la fois, donc toute différence pouvait venir de l’un ou de l’autre. Une règle de format m’a aussi valu un refus de mise à jour de session : un mot-clé contenant <, >, un retour chariot ou un saut de ligne rejette toute la mise à jour, pas seulement ce mot-clé. TranscriptionConfig.validate_keywords() intercepte le cas avant de construire la charge utile.
Les mots-clés aident là où on s’y attend. À chaque passage, le numéro de compte était transcrit en mots, puisque c’est ce que l’audio contient. La question était : le modèle regroupe-t-il ces mots en identifiant, ou épelle-t-il les lettres, type \"A C forty-two\" ?
Sur quinze passages, la coupure est nette. Sans keywords, jamais de regroupement : no_context, prompt_only et languages_only rendent \"A C forty-two\" sur leurs neuf passages. Avec keywords, cinq passages sur six le regroupent, le plus souvent en \"AC-42\" bien formaté. Donc keywords infléchit le résultat, là où prompt seul ne le fait pas, en phase avec la documentation qui positionne keywords pour les termes littéraux susceptibles d’être mal analysés. Les mots-clés seuls ratent encore une fois : considérez-les comme un indice qui change fortement les probabilités, pas comme une règle absolue.
Cela peut sembler en porte-à-faux avec le chiffre de benchmark cité en introduction, où le contexte libre gagne six points en précision sémantique. Les tests mesurent différentes choses : OpenAI évalue le sens à large échelle, quand je ne regarde ici qu’un identifiant dans un clip. Un prompt peut améliorer la phrase sans toucher le détail étroit que vous contrôlez. Le seul indice ici : prompt et keywords ensemble regroupent à chaque passage alors que keywords seuls ratent une fois : une différence d’un seul run.
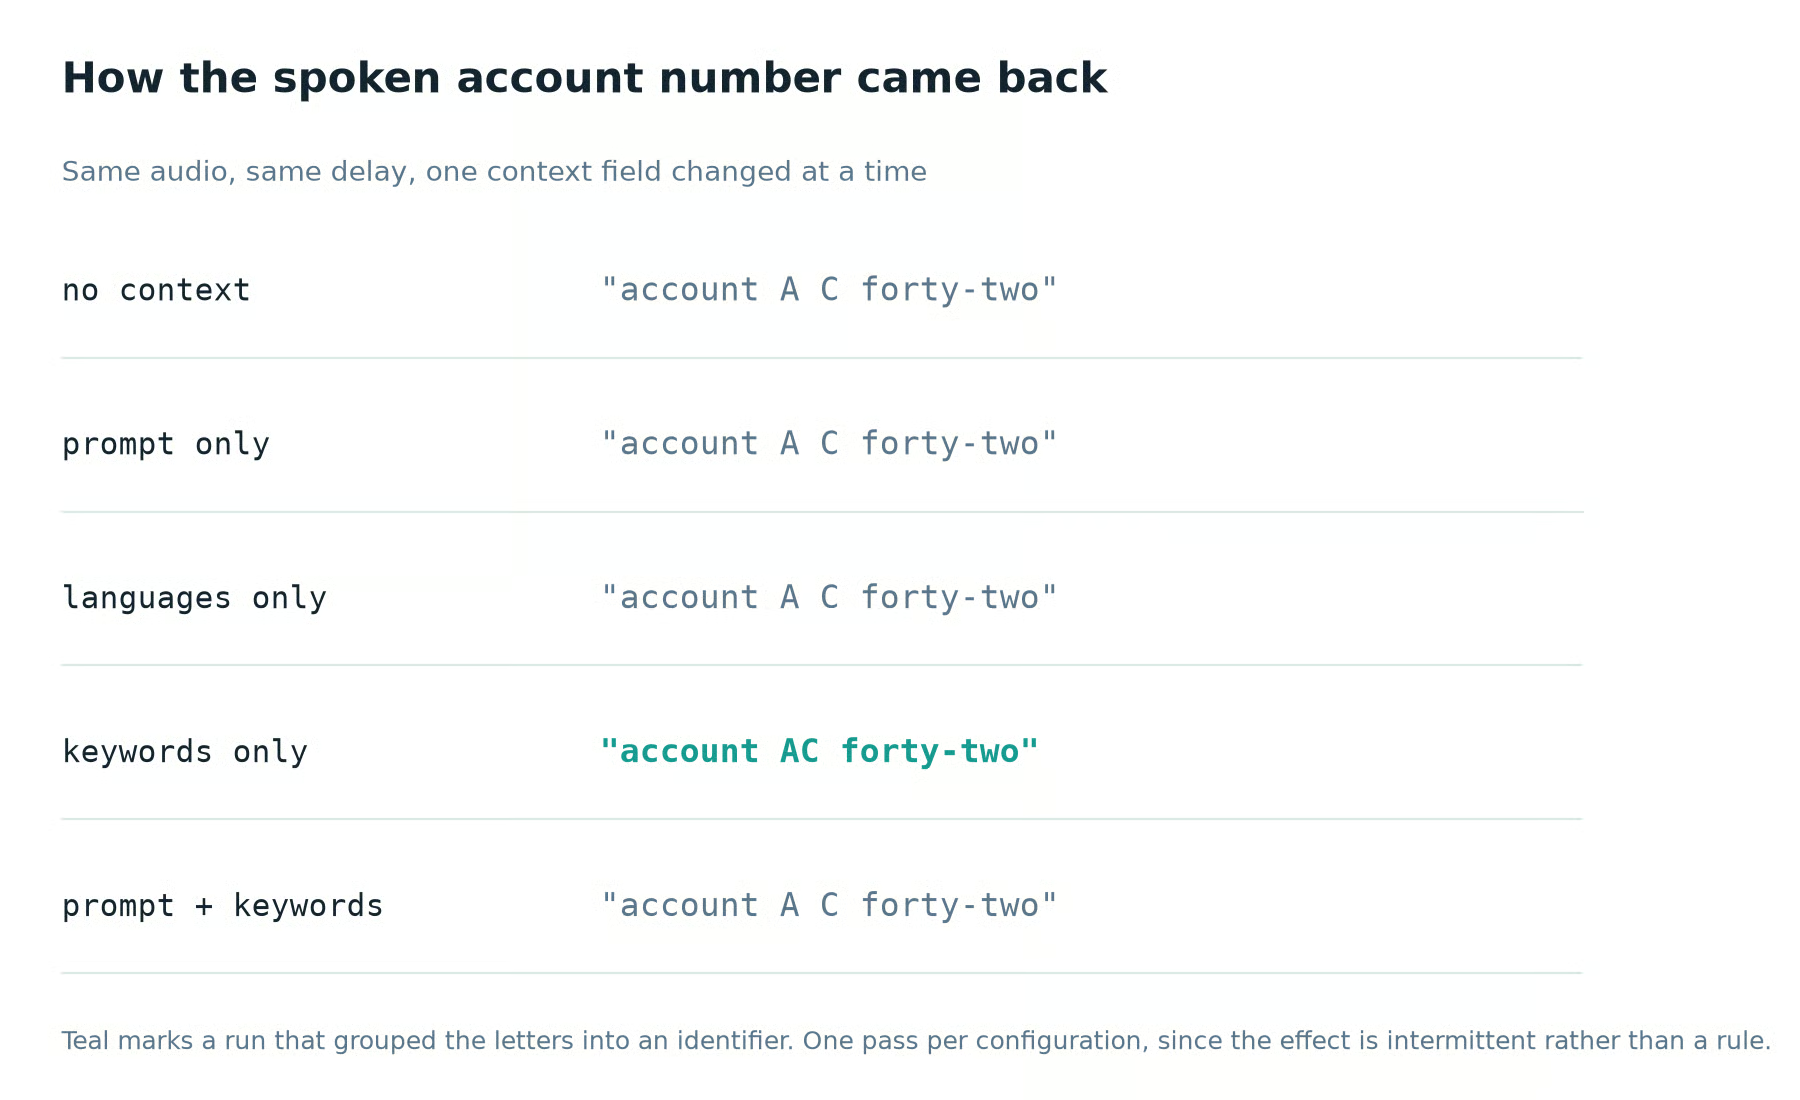
Seuls les mots-clés ont regroupé l’identifiant prononcé. Image de l’auteur.
Les indices de langue aident plus nettement, et sur un problème inattendu. Sans indice, les passages sur le clip en code-switching entendaient le mot d’appui arabe initial, proche de \"tayyib\", comme l’anglais \"But\", fusionnant deux systèmes d’écriture en un mot cassé. Ils écrivaient aussi \"billing statement\" en alphabet arabe phonétique sur certains passages et le laissaient en alphabet latin sur d’autres. Ajouter languages: [\"ar\", \"en\"] a supprimé le mot cassé à chaque passage. Cela reste un unique clip, et une phrase qui change de langue en son milieu est l’endroit idéal pour que l’indice se voie.
delay accepte cinq valeurs : minimal, low, medium, high et xhigh. Plus bas, le texte partiel peut apparaître plus tôt. Plus haut, le modèle dispose de plus de contexte audio avant de s’engager, ce qui peut améliorer la précision sur de l’audio difficile. OpenAI précise que le minutage exact varie selon la configuration et doit être mesuré sur un audio représentatif : c’est l’objet du Test 3.
test3_delay_benchmark.py diffuse le même fichier WAV à travers les cinq niveaux, plusieurs passages chacun, en journalisant le temps entre le début du flux et le premier delta, puis jusqu’au final. Conserver l’audio, les champs de contexte et la stratégie de commit identiques, c’est ce qui donne du sens à la comparaison.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Ces chiffres ne sont pas universels. Les miens proviennent de trois passages par niveau, sur un seul clip, un seul réseau, un après-midi. La médiane jusqu’au premier partiel va de 0,70 s en minimal à 2,91 s en xhigh, par paliers réguliers via low (1,19 s), medium (1,39 s) et high (2,09 s). Les trois passages par niveau tiennent dans environ un cinquième de seconde, donc l’ordre est stable même si vos nombres différeront.
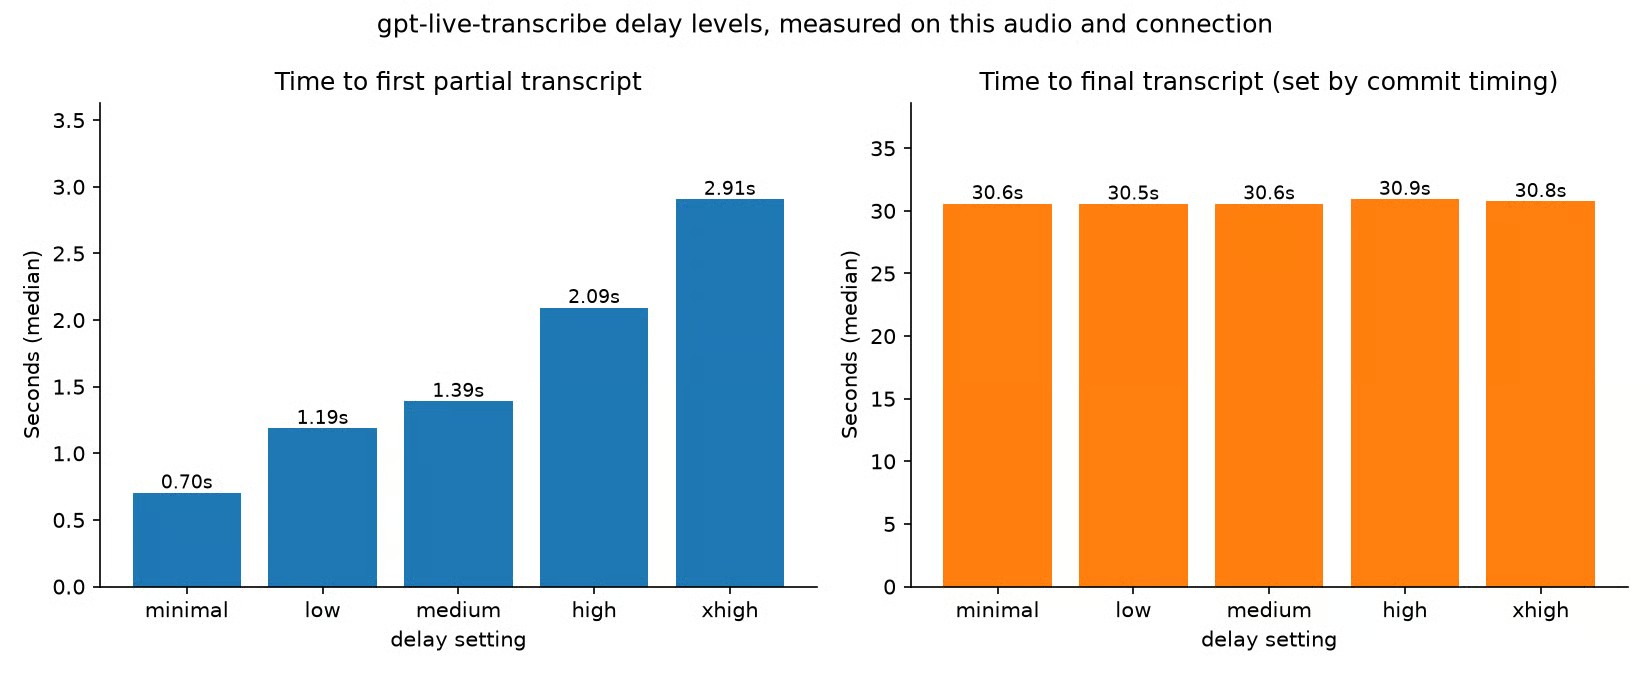
Les niveaux de délai arbitrent vitesse et précision. Image de l’auteur.
Je n’ai pas pu confirmer l’hypothèse courante selon laquelle un délai plus haut produit moins de révisions. Le nombre de deltas varie entre 84 et 86 à tous les niveaux, trop proche pour dégager une tendance. Le temps jusqu’au final reste à ±0,5 s de 30,6 s partout, mais cela reflète mon minutage de commit, pas le modèle. D’où le découpage du graphique en deux volets : sur un axe, deux secondes s’évanouissent sous des barres dix fois plus hautes.
Pour des sous-titres lus en direct pendant qu’une personne parle, commencez en low. Deux secondes sans texte paraissent défaillantes, là où une correction immédiate choque moins. Pour des notes de réunion lues plus tard, high ou xhigh coûte presque rien. Pour des commandes vocales, penchez vers medium, un mot erroné dans une commande de deux mots pesant plus lourd que d’habitude.
Tous les tests jusque-là utilisaient turn_detection: null et un commit manuel. La Realtime API propose une détection d’activité vocale en alternative, donc je l’ai branchée avec gpt-live-transcribe sans présumer que cela fonctionnerait. J’ai failli couper cette section quand le test a échoué. Puis il s’est avéré que l’échec était l’enseignement.
server_vad segmente l’audio sur des périodes de silence, réglables via threshold, prefix_padding_ms et silence_duration_ms. semantic_vad utilise un classificateur qui estime si l’orateur semble avoir terminé, avec un réglage eagerness contrôlant la rapidité de décision :
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}C’est ainsi que les deux modes sont documentés pour la Realtime API en général. Envoyé à une session gpt-live-transcribe, cette charge utile est rejetée telle quelle :
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad renvoie la même erreur. Au 4 août 2026, le commit manuel est le seul mode de détection de tour que gpt-live-transcribe accepte, même si le guide de transcription indique encore de configurer la VAD pour que le serveur valide les tours pour vous. Re-testez avant de bâtir dessus, OpenAI pouvant activer la VAD plus tard sans préavis.
Le push-to-talk est le cas facile : l’appui et le relâchement marquent déjà les bornes. Sinon, c’est au client de décider quand un tour s’achève, et mes deux premières tentatives étaient mauvaises.
La première protégeait le commit par if not mic_queue.empty(), logique en apparence mais jamais vraie : la coroutine qui draine la file la vide aussi vite que le micro la remplit. Les sous-titres partiels arrivaient quand même, ce qui rendait le tout trompeur, mais rien n’était finalisé. La seconde validait toutes les quatre secondes tant que de l’audio avait été ajouté. Sur un vrai micro, cela donnait :
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Double échec : le minuteur a coupé la phrase en plein mot, et le modèle a lu un fragment sans début comme \"Abort\". Puis il a validé pendant que je ne parlais pas et renvoyé une transcription vide, un micro diffusant des blocs qu’on parle ou non.
La cause est la même : l’énergie audio. SpeechGate dans mic_stream.py suit l’amplitude RMS de chaque bloc et valide après avoir détecté de la parole suivie d’un silence, avec une limite haute pour tronquer un discours continu. Ma première version comparait cette amplitude à une valeur fixe : OK sur une machine, faux d’un facteur cinq sur la suivante. Elle estime désormais le bruit ambiant et considère comme parole ce qui est plusieurs fois plus fort. Un tour qui se termine sur quasi rien, toux ou porte, passe par input_audio_buffer.clear plutôt qu’un commit, demander au modèle ce qu’une porte a dit étant une bonne façon d’inventer un mot.
app.py réunit toutes les pièces : capture micro, sous-titres partiels en direct, historique de transcription indexé par item_id, et options CLI pour chaque champ accepté par la session.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNommez uniquement les langues effectivement parlées. La même commande avec en,ar sur de l’anglais a renvoyé le mot \"delta\" translittéré en alphabet arabe, l’observation du Test 2 mais dans l’autre sens.
--turn-detection vaut par défaut manual, et --silence-hold et --max-turn règlent la porte de parole décrite plus haut. Les modes VAD restent en drapeaux au cas où l’API les accepterait : passez l’un d’eux et l’app affiche le refus du serveur au lieu de rester muette.
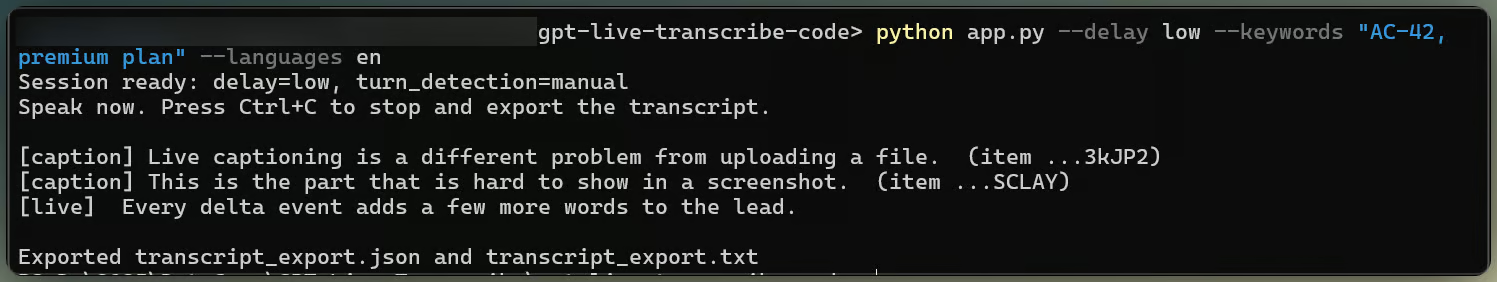
Application complète en cours d’exécution avec paramètres. Image de l’auteur.
En sortie, elle écrit une transcription en texte brut et un fichier JSON avec la configuration utilisée, un temps mesuré localement jusqu’au premier delta, et chaque tour finalisé avec son item_id. J’ai ajouté cet export après avoir perdu un bon run à cause d’un terminal fermé. Les horodatages sont côté client : ne les confondez pas avec des chiffres OpenAI.
Les trois tests tournent aussi dans un navigateur. demo_app.py est une version Streamlit avec un onglet par expérience, gardée en démo plutôt qu’en chemin pédagogique principal, les scripts en terminal montrant plus directement les événements bruts.
streamlit run demo_app.pyApprenez avec DataCamp
Cours
Cours
Cours
Tutoriel
Tutoriel
Kurtis Pykes
15 min
Tutoriel
Moez Ali
6 min
Tutoriel
DataCamp Team
5 min
Tutoriel
Satyabrata Pal
15 min
Tutoriel
Sejal Jaiswal
24 min