
कोर्स
OpenAI API के साथ काम करना
3 घंटा
179.8K
ट्रांसक्रिप्शन एंडपॉइंट पर तैयार ऑडियो फ़ाइल अपलोड करना इस समस्या का आसान संस्करण है। आप पूरी फ़ाइल का इंतज़ार करते हैं, फिर एक ट्रांसक्रिप्ट मिल जाता है। मॉडल काम करते समय कोई स्क्रीन को नहीं घूर रहा होता। लाइव कैप्शनिंग अलग काम है: ऑडियो तब भी आता रहता है जब आप अभी तक यह तय कर रहे होते हैं कि जो मिला है उसके साथ क्या करना है, और वक्ता के बोलते समय ही टेक्स्ट अपडेट होना चाहिए।
यही वह गैप है जिसे gpt-live-transcribe भरता है। OpenAI ने इसे 28 जुलाई, 2026 को जारी किया और साथ में इसका बैच समकक्ष gpt-transcribe भी। इस ट्यूटोरियल में मैं इसके इर्द-गिर्द एक Python कैप्शनिंग क्लाइंट बनाता हूँ और तीन परीक्षण चलाता हूँ: एक बेसिक स्ट्रीमिंग क्लाइंट, यह तुलना कि यह कौन-से context संकेत स्वीकार करता है, और इसके पाँच delay सेटिंग्स का बेंचमार्क। मैंने साफ़ अंग्रेज़ी, तकनीकी शब्दावली, और मिस्री अरबी-अंग्रेज़ी कोड-स्विचिंग के साथ टेस्ट किया, क्योंकि यह एक स्वच्छ नैरेटर की तुलना में वास्तविक मीटिंग के ज़्यादा करीब है।
अंत तक, आपके पास एक काम करता कैप्शनिंग ऐप होगा, यह समझ होगी कि कौन-सी context सेटिंग्स वास्तव में मदद करती हैं, और एक ऐसा delay सेटिंग जिसे आप अंदाज़े के बजाय ठोस आधार पर चुन सकें।
मॉडल के सबसे बड़े प्रतिस्पर्धियों में से एक का अवलोकन करने के लिए हमारा Grok Voice Transcribe 2.0 गाइड पढ़ें।
gpt-live-transcribe एक स्ट्रीमिंग स्पीच-टू-टेक्स्ट मॉडल है उन ऐप्स के लिए जिन्हें ऑडियो आते समय ही ट्रांसक्रिप्ट टेक्स्ट चाहिए। यह इनपुट में ऑडियो लेता है और आउटपुट में टेक्स्ट देता है, बस, चार फ़ील्ड्स से ट्यून होता है: delay लेटेंसी के लिए, prompt फ्री-फॉर्म context के लिए, keywords शब्दशः शब्दों के लिए, और languages अपेक्षित इनपुट भाषाओं के लिए। OpenAI के Context Aware ASR बेंचमार्क पर, फ्री-फॉर्म context ने सैमांटिक एक्युरेसी को 38.5 प्रतिशत से 44.6 प्रतिशत तक बढ़ाया, इसी वजह से टेस्ट 2 मौजूद है।
मॉडल Realtime API के अंदर चलता है, कोई अलग एंडपॉइंट नहीं, और यह नाम जैसा भी सुझाए, GPT-Live, OpenAI के वॉइस सिस्टम, से असंबद्ध है। आप एक ट्रांसक्रिप्शन सेशन खोलते हैं, उसे कॉन्फ़िगर करते हैं, और सर्वर उसी कनेक्शन पर इवेंट्स स्ट्रीम करके लौटाता है जिस पर आप ऑडियो भेजते हैं। इससे पहले एक सवाल रह जाता है: इन दो ट्रांसक्रिप्शन मॉडलों में से आपको वास्तव में कौन-सा चाहिए।
OpenAI दो अनुशंसित ट्रांसक्रिप्शन मॉडल देता है, और ये एक-दूसरे के बदले नहीं चल सकते। gpt-live-transcribe लगातार आते ऑडियो के लिए है—माइक्रोफ़ोन, फ़ोन कॉल, मीडिया स्ट्रीम—जहाँ वक्ता के खत्म होने से पहले आपको आंशिक टेक्स्ट चाहिए। gpt-transcribe पूरी रिकॉर्डिंग्स के लिए है, या ऐसे Realtime सेशन के लिए जहाँ आप जानबूझकर committed turn का इंतज़ार करते हैं। डॉक्स उस दूसरे केस को विशेष वर्कफ़्लो कहते हैं, लाइव डेल्टाज पाने का तरीका नहीं।
एक फर्क लोगों को उलझा देता है: gpt-transcribe डिटेक्टेड इनपुट भाषा के साथ एक languages एरे लौटाता है, gpt-live-transcribe नहीं। अगर आपकी लॉजिक डिटेक्टेड भाषा पर ब्रांच करती है, तो आप गलत मॉडल चुन रहे हैं, चाहे डेमो में उसके कैप्शन कितने भी अच्छे दिखें। प्राइसिंग भी इसी लाइन पर बँटी है, बैच मॉडल के पक्ष में लगभग चार से एक, जिस पर मैं आगे लौटता हूँ।
मैं यह बात अभी बता दूँ, इससे पहले कि आप इसके इर्द-गिर्द आधा ऐप बना लें। इसमें वर्ड-लेवल टाइमस्टैम्प नहीं हैं, स्पीकर लेबल नहीं, confidence स्कोर नहीं, और diarization नहीं। अगर आपको सबटाइटल टाइमिंग चाहिए, किसने क्या कहा यह बताने वाले नोट्स चाहिए, या confidence थ्रेशहोल्ड चाहिए, तो OpenAI की गाइड gpt-4o-transcribe-diarize या whisper-1 की ओर इशारा करती है।
इस ट्यूटोरियल की हर स्क्रिप्ट github.com/KhalidAbdelaty/gpt-live-transcribe में है, तो इसे क्लोन करके शुरू करें। आपको Python 3.10 या नया चाहिए और Realtime एक्सेस वाली API कुंजी। स्क्रिप्ट्स चार पैकेजों पर टिकी हैं: कनेक्शन के लिए websockets , माइक्रोफ़ोन कैप्चर के लिए sounddevice , बफ़र कन्वर्ज़न के लिए numpy , और कुंजी लोड करने के लिए python-dotenv। requirements फ़ाइल चार्ट्स और ब्राउज़र डेमो के लिए कुछ और जोड़ती है।
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
macOS पर, sounddevice को OS लेवल पर PortAudio चाहिए (brew install portaudio); Linux पर apt-get install portaudio19-dev है। अगर आप Windows पर हैं तो यह स्टेप छोड़ दें। मुझे macOS वाला खुद लगा, और सच में वही एक इंस्टॉल फिक्स है।
ऑडियो 16-बिट PCM, 24 kHz, मोनो, लिटिल-एंडियन, base64-एन्कोडेड के रूप में पहुँचना चाहिए। MP3 या स्टीरियो WAV भेजें और आपको या तो बिगड़ा आउटपुट मिलेगा या कनेक्शन बंद हो जाएगा—फ़ॉर्मेट गलत था यह बताने वाला संदेश नहीं। यह एक दोपहर खा सकता है। तो अगला सवाल है कि ऑडियो कौन-सा कनेक्शन ढोएगा।
OpenAI की गाइडेंस साफ़ है: सर्वर-टू-सर्वर ऐप्स के लिए WebSocket, ब्राउज़र और मोबाइल क्लाइंट्स के लिए WebRTC। यह ट्यूटोरियल एक Python बैकएंड बनाता है जो लोकल माइक्रोफ़ोन पढ़ता है, तो WebSocket सही विकल्प है, और एक मानक API कुंजी काम करती है क्योंकि वह कभी आपके सर्वर से बाहर नहीं जाती।
सेशन session.update इवेंट से शुरू होता है जो type: "transcription" सेट करता है और मॉडल के रूप में gpt-live-transcribe चुनता है। पेलोड में बाकी सब उस ऑडियो का वर्णन करता है जो आप भेजने वाले हैं। यहाँ न्यूनतम कॉन्फ़िगरेशन है, Realtime ट्रांसक्रिप्शन गाइड से:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None ऑटोमैटिक वॉइस एक्टिविटी डिटेक्शन को डिसेबल करता है, तो जब तक आप स्पष्ट रूप से कमिट नहीं करते, कुछ फ़ाइनलाइज़ नहीं होता। फिर तीन क्लाइंट इवेंट काम करते हैं: input_audio_buffer.append base64 ऑडियो चंक भेजता है, input_audio_buffer.commit एक turn समाप्त करता है, और सर्वर conversation.item.input_audio_transcription.delta (आंशिक टेक्स्ट) और conversation.item.input_audio_transcription.completed (अंतिम टेक्स्ट) से जवाब देता है। मैं wss://api.openai.com/v1/realtime?intent=transcription से जुड़ता हूँ, यह OpenAI के कुकबुक का पैटर्न है; गाइड उस क्वेरी स्ट्रिंग को डॉक्यूमेंट नहीं करता, तो अगर यह कभी काम करना बंद करे, इसे हटा दें।
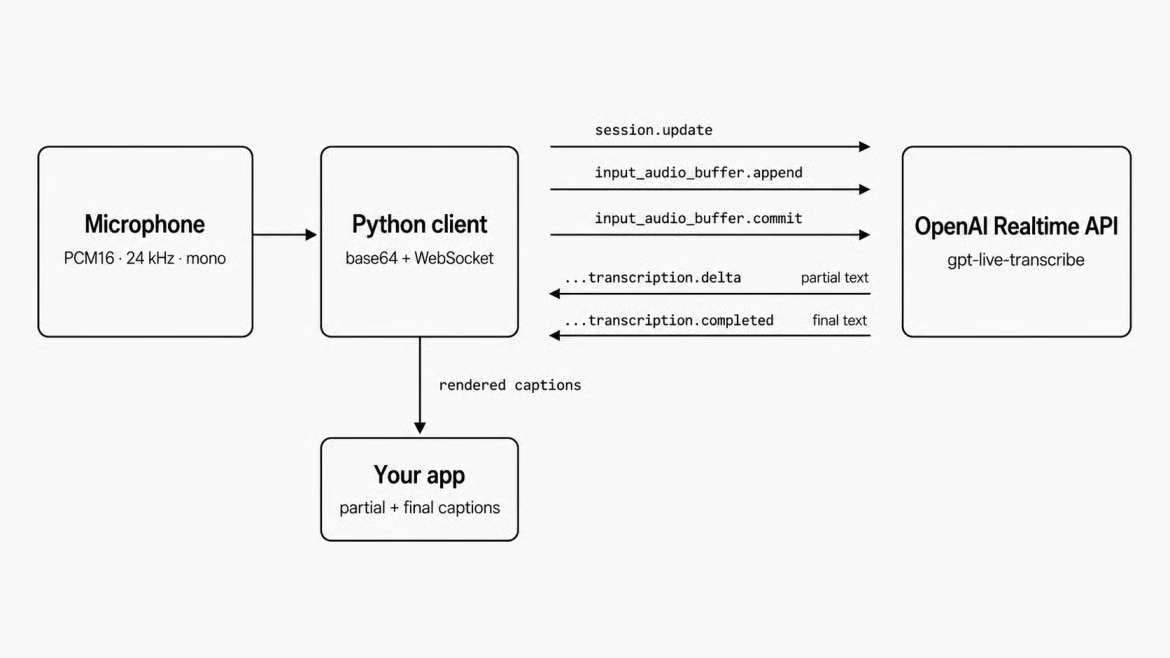
Realtime ट्रांसक्रिप्शन सेशन इवेंट फ़्लो डायग्राम। चित्र: लेखक।
टेस्ट 1 सबसे छोटा काम करता संस्करण है: माइक्रोफ़ोन ऑडियो कैप्चर करें, स्ट्रीम करें, आते ही आंशिक और अंतिम टेक्स्ट प्रिंट करें। कोई context नहीं, कोई keywords नहीं, कुछ भी ट्यून नहीं, ताकि इवेंट फ़्लो साफ़ दिखे। पहली समस्या है माइक्रोफ़ोन थ्रेड से ऑडियो निकालना बिना उसे अटकाए।
sounddevice अपना कॉलबैक अपने थ्रेड पर चलाता है और ड्राइवर के फ़्रेम गिराने से पहले कुछ मिलीसेकंड में लौटना होता है, तो वह नेटवर्क कॉल पर इंतज़ार नहीं कर सकता। उसका एकमात्र काम float32 बफ़र को PCM16 में बदलना और इसे asyncio.Queue पर loop.call_soon_threadsafe के ज़रिये डाल देना है, जबकि एक अलग coroutine वह queue ड्रेन करता है और हर चंक भेजता है।
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
100 मिलीसेकंड का चंक (24 kHz पर 2,400 सैंपल) एक उचित शुरुआती बिंदु है। इससे छोटा जाएँ तो प्रति-संदेश ओवरहेड बढ़ता है, बहुत बड़ा जाएँ तो कैप्शन सुस्त लगते हैं। कोई दस्तावेज़ीकृत सही संख्या नहीं है, तो इसे एक डायल मानेँ।
डेल्टा सस्ते और बार-बार आते हैं। हर एक में एक item_id से जुड़ा टेक्स्ट का टुकड़ा होता है। उसे उस आइटम के पास पहले से मौजूद आंशिक टेक्स्ट में जोड़ें, और स्क्रीन पर कैप्शन शब्द-दर-शब्द बढ़ता है:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
completed इवेंट उसी आइटम के लिए उस आंशिक को अंतिम ट्रांसक्रिप्ट से बदल देता है। completed को सत्य का स्रोत मानेँ और डेल्टा को प्रीव्यू—खुद जोड़-जोड़कर अंतिम बनाने की चीज़ नहीं।
यह वह विवरण है जो आप छोड़ देंगे तो आपका UI टूटेगा: OpenAI की गाइड कहती है कि अलग-अलग turns से completion इवेंट्स के बीच ऑर्डर की गारंटी नहीं है। किसी पहले turn का completed इवेंट किसी बाद वाले से बाद में आ सकता है, तो जो कोड मान ले कि सबसे नया completed सबसे नए turn से संबंधित है, वह कभी-कभी पीछे कूद जाएगा या एक लाइन डुप्लिकेट कर देगा। सबकुछ item_id से key करें, जैसा मेरी TranscriptState क्लास करती है।
इसे बनाते समय दो बग पकड़े, दोनों इस बारे में कि कोड किस dictionary को जाँच रहा था। केवल डेल्टा हैंडलर में ऑर्डर सूची में item_id जोड़ने से full_transcript() उन रिसीवर्स के लिए खाली रह गया जो सिर्फ़ completed इवेंट्स प्रोसेस कर रहे थे। नए आइटम का फ़ैसला करने के लिए partials dictionary का उपयोग और बुरा था: apply_completed() वह एंट्री क्लियर कर देता है, तो देर से आया डेल्टा बिलकुल नया लगा, ऑर्डर सूची में दूसरी बार चला गया, और फिनिश्ड turn दो बार प्रिंट हुआ। आइटम को दोनों हैंडलर्स में ट्रैक करें, और जाँच ऑर्डर सूची पर करें।
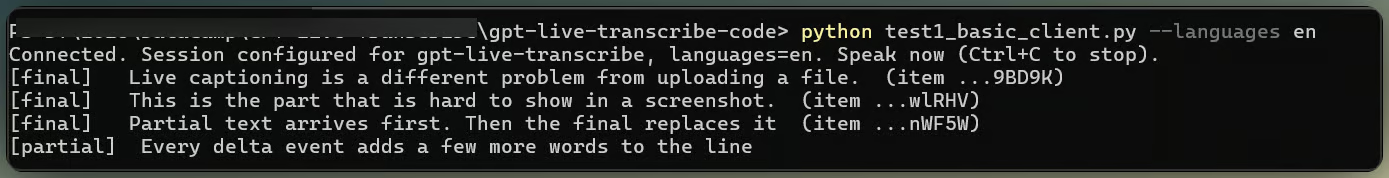
लाइव आंशिक कैप्शन ट्रांसक्रिप्ट में फ़ाइनलाइज़ होते हुए। चित्र: लेखक।
साफ़ अंग्रेज़ी पर, टेक्स्ट एक-दो सेकंड के भीतर आ गया और वही था जो मैंने कहा, विराम चिह्न समेत। लेकिन लैपटॉप माइक्रोफ़ोन से और बिना context सेट किए, कभी-कभी कोई अनिश्चित शब्द पूरी तरह किसी और लिपि में वापस आया। इसके लिए फ़ील्ड है languages, जिसे टेस्ट 2 टार्गेट करता है।
मॉडल तीन तरह के context स्वीकार करता है, जिन्हें टेस्ट करने से पहले ठीक से समझ लेना चाहिए। prompt सेटिंग का फ्री-फॉर्म टेक्स्ट है, keywords वे शाब्दिक शब्द हैं जो ऑडियो में हो सकते हैं, और languages अपेक्षित इनपुट भाषाएँ ISO 639-1 कोड्स जैसे en या ar के रूप में लिस्ट करता है। इनमें से कोई भी आउटपुट थोपता नहीं। जो keyword बोला ही नहीं गया, वह सिर्फ़ इसलिए नहीं आएगा कि आपने उसे लिस्ट किया, और यह समझने का एकमात्र तरीका कि ये फ़ील्ड सच में क्या करती हैं, एक बार में एक चीज़ बदलना है।
मैंने वही क्लिप पाँच कॉन्फ़िगरेशन पर चलाया, हर एक तीन पास। दो नियम ऐसी तुलना को ईमानदार रखते हैं: रन के बीच एक ही context फ़ील्ड बदले, और हर कॉन्फ़िगरेशन एक से ज़्यादा बार चले, क्योंकि समान ऑडियो पर मॉडल deterministic नहीं है।
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
मेरे पहले संस्करण ने संयुक्त रन पर ही languages सेट किया, जो पहले नियम को तोड़ता था: एक साथ दो फ़ील्ड बदलीं, तो कोई भी अंतर दोनों में से किसी से आ सकता था। एक फ़ॉर्मेटिंग नियम ने मुझे एक rejected सेशन अपडेट भी दिया: कोई keyword जिसमें <, >, carriage return, या line feed हो, वह पूरे अपडेट को रिजेक्ट कर देता है, सिर्फ़ उस keyword को नहीं। TranscriptionConfig.validate_keywords() इसे पेलोड बनाने से पहले पकड़ता है।
Keywords ने वही मदद की जिसकी आप उम्मीद करेंगे। हर रन ने अकाउंट नंबर को बोले गए शब्दों के रूप में ट्रांसक्राइब किया, क्योंकि ऑडियो में वही है। सवाल यह था कि मॉडल ने उन शब्दों को एक आइडेंटिफ़ायर में समूहीकृत किया या अक्षरों को इस तरह स्पेल आउट कर दिया: "A C forty-two."
पन्द्रह रनों में बाँट साफ़ था। जिनमें keywords नहीं थे, उन्होंने कभी समूह नहीं किया: no_context, prompt_only, और languages_only ने अपने नौ पासेज़ में हर बार "A C forty-two" लौटाया। keywords वाले रनों ने छह में से पाँच पर समूह किया, ज़्यादातर पूरी तरह फॉर्मैटेड "AC-42" के रूप में। तो keywords ने नतीजा बदला और अकेला prompt कभी नहीं, जो OpenAI के इस फ़ील्ड को ऐसे शाब्दिक terms के लिए बताने से मेल खाता है जिन्हें मॉडल गलत पार्स कर सकता है। Keywords अकेले भी एक बार चूके, तो इसे odds को काफ़ी मोड़ने वाला संकेत मानें, कोई ऐसा नियम नहीं जिसे मॉडल हर बार माने।
यह उस बेंचमार्क आँकड़े के साथ थोड़ा असहज बैठता है जिससे मैंने शुरू किया, जहाँ फ्री-फॉर्म context ने सैमांटिक एक्युरेसी छह अंक उठाई। दोनों टेस्ट अलग चीज़ें मापते हैं: OpenAI ने अर्थ को विस्तृत ऑडियो सेट पर स्कोर किया, जबकि मैंने एक क्लिप में एक आइडेंटिफ़ायर देखा। prompt वाक्य पर असली काम कर सकता है और फिर भी वह संकीर्ण विवरण छोड़ सकता है जिसे आप जाँच रहे हैं। यहाँ इसका एकमात्र संकेत यह है कि prompt और keywords साथ में हर पास पर समूह कर गए जबकि अकेले keywords एक बार चूके—एक रन का फ़र्क।
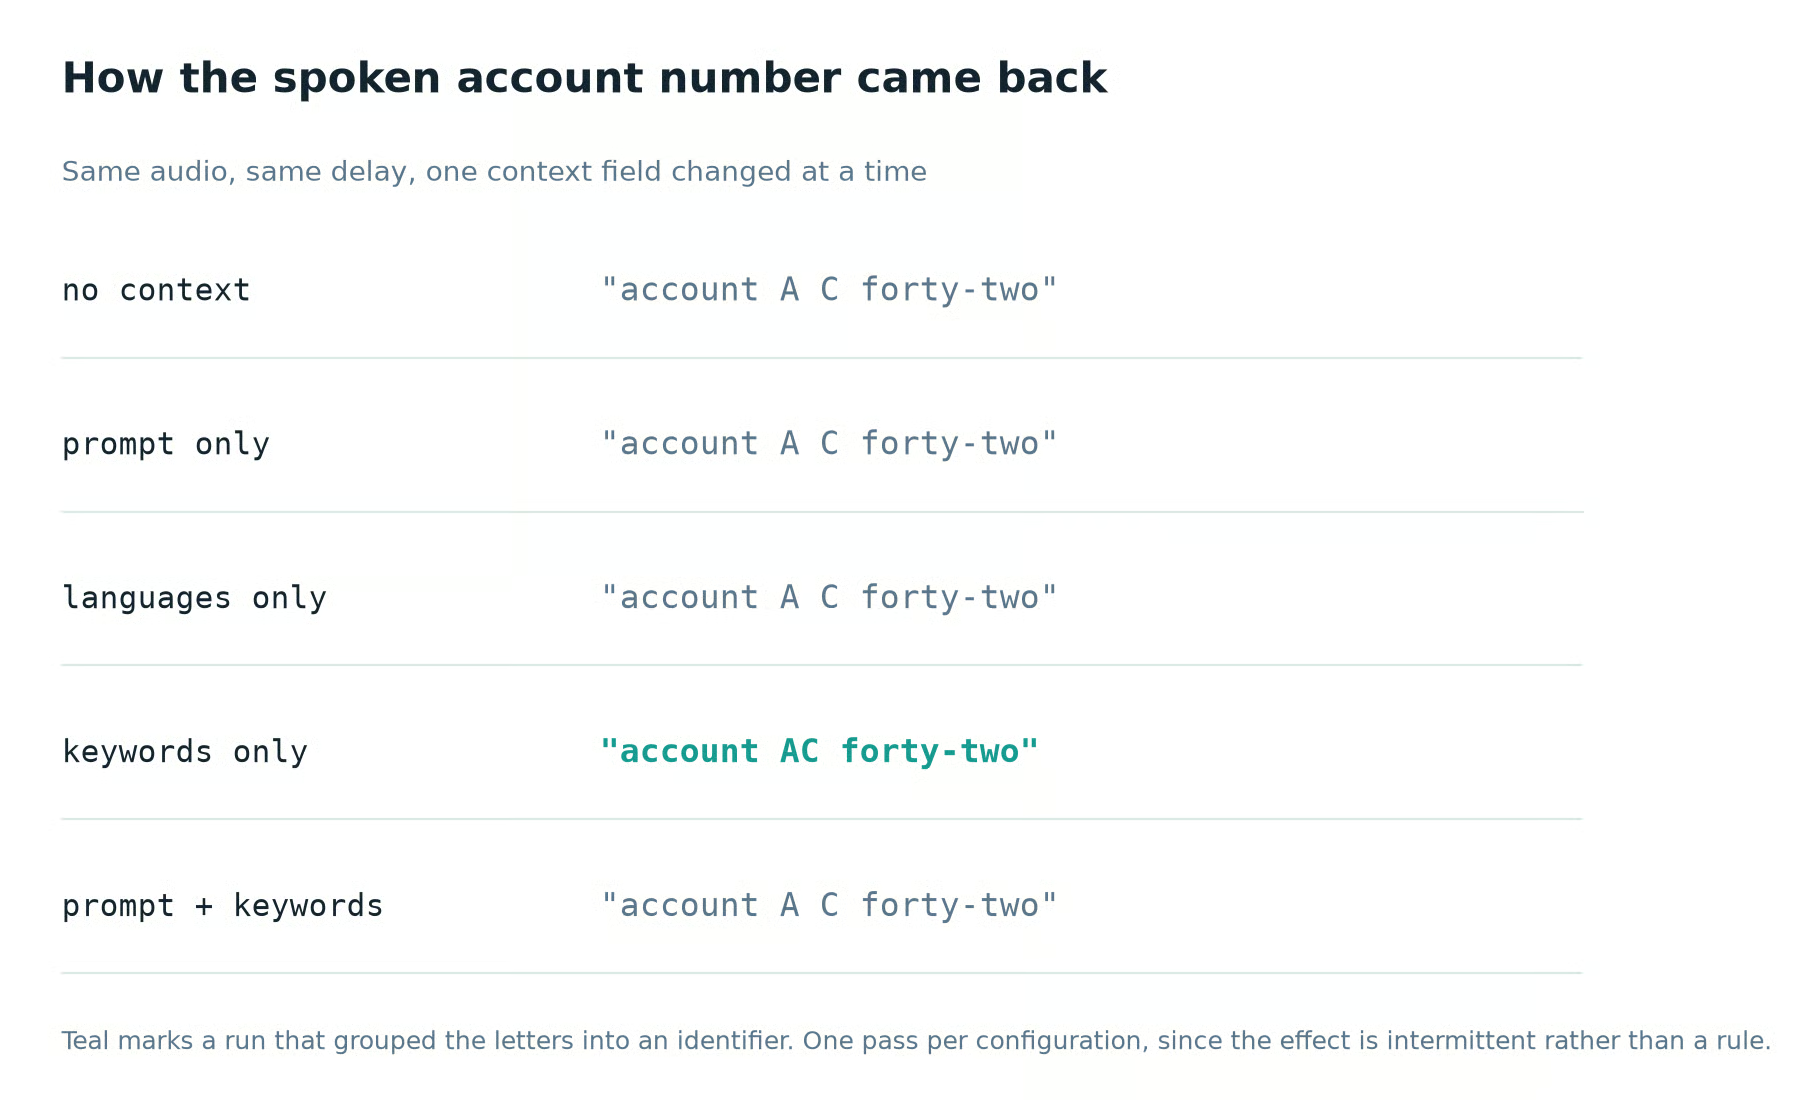
केवल keywords ने बोले गए आइडेंटिफ़ायर को समूहित किया। चित्र: लेखक।
भाषा संकेत ज़्यादा स्पष्ट मददगार रहे, और एक ऐसी समस्या पर जिसकी मैंने उम्मीद नहीं की थी। संकेत के बिना, कोड-स्विचिंग क्लिप के रनों ने शुरुआती अरबी filler शब्द, मोटे तौर पर "tayyib," को अंग्रेज़ी "But" की तरह सुना और दोनों लिपियों को एक टूटे हुए शब्द में फ्यूज़ कर दिया। उन्होंने "billing statement" को कुछ पास में अरबी लिपि में ध्वन्यात्मक रूप से स्पेल कर दिया और कुछ में लैटिन में छोड़ दिया। languages: ["ar", "en"] जोड़ने से हर पास पर टूटा शब्द गायब हो गया। यह एक ही क्लिप है, हालाँकि, और वाक्य के बीच में भाषा बदलना संकेत दिखने का सबसे आसान स्थान है।
delay पाँच मान लेता है: minimal, low, medium, high, और xhigh। कम सेटिंग्स आंशिक टेक्स्ट जल्दी ला सकती हैं। ऊँची सेटिंग्स मॉडल को टेक्स्ट पर कमिट करने से पहले ज़्यादा ऑडियो context देती हैं, जो कठिन ऑडियो पर एक्युरेसी सुधार सकती है। OpenAI साफ़ कहता है कि सटीक टाइमिंग कॉन्फ़िगरेशन पर निर्भर करती है और प्रतिनिधि ऑडियो के साथ बेंचमार्क की जानी चाहिए, तो टेस्ट 3 यही करता है।
test3_delay_benchmark.py वही WAV फ़ाइल सभी पाँच लेवल्स से स्ट्रीम करता है, हर एक के कई रन, और स्ट्रीम शुरू से पहले डेल्टा तक तथा अंतिम ट्रांसक्रिप्ट तक का समय लॉग करता है। ऑडियो, context फ़ील्ड्स और commit स्ट्रैटेजी को समान रखना ही तुलना को अर्थ देता है।
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}ये आँकड़े सार्वभौमिक नहीं हैं। मेरे वाले एक क्लिप, एक नेटवर्क, एक दोपहर में हर लेवल के तीन रन से आए। पहले आंशिक तक का median समय minimal पर 0.70 सेकंड से xhigh पर 2.91 सेकंड तक रहा, low (1.19s), medium (1.39s), और high (2.09s) से होकर बराबर क़दमों में चढ़ते हुए। हर लेवल पर तीन रन एक-दूसरे से तकरीबन पाँचवें हिस्से सेकंड के भीतर रहे, तो क्रम स्थिर है, भले ही संख्याएँ मेरी हैं, आपकी नहीं।
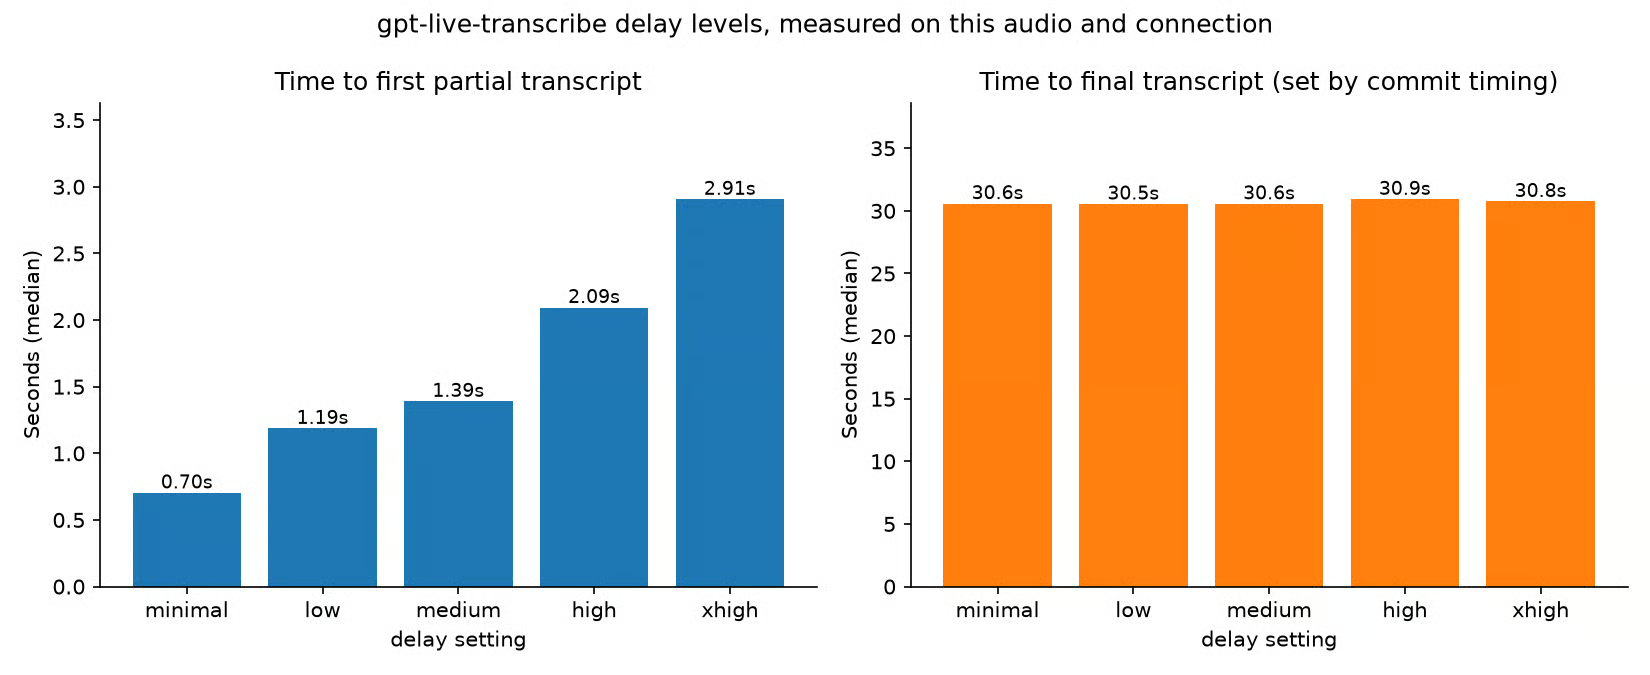
Delay लेवल्स स्पीड के बदले एक्युरेसी का सौदा करते हैं। चित्र: लेखक।
जो मैं कन्फर्म नहीं कर पाया वह सामान्य मान्यता थी कि ऊँचा delay मतलब कम संशोधन। हर लेवल पर डेल्टा काउंट 84 से 86 के बीच रहा, इतना समान कि कोई ट्रेंड दिखता नहीं। final तक का समय भी हर जगह 30.6 सेकंड के आधे सेकंड के भीतर रहा, पर वह मेरे commit टाइमिंग को दर्शाता है, मॉडल को नहीं। इसी वजह से चार्ट दो पैनल में माप बाँटता है: एक अक्ष पर दो सेकंड का फैलाव उन बार्स के नीचे गुम हो जाता है जो उससे दस गुना ऊँचे हैं।
लाइव कैप्शन जिन्हें कोई व्यक्ति बोलते समय पढ़ता है, वहाँ low से शुरू करें। कोई टेक्स्ट आने से पहले दो सेकंड का इंतज़ार उतना ही टूटा महसूस होता है जितना नहीं होना चाहिए—जबकि एक कैप्शन जो एक पल बाद सही हो जाए, उतना नहीं। मीटिंग नोट्स जिन्हें बाद में ही पढ़ा जाएगा, वहाँ high या xhigh की कीमत लगभग नहीं के बराबर है। वॉइस कमांड्स के लिए, medium की ओर झुकें, क्योंकि दो-शब्दी कमांड में एक गलत शब्द सामान्य से ज़्यादा मायने रखता है।
अब तक हर टेस्ट ने turn_detection: null और मैनुअल कमिट का उपयोग किया। Realtime API विकल्प के रूप में वॉइस एक्टिविटी डिटेक्शन देता है, तो मैंने इसे gpt-live-transcribe के साथ जोड़कर देखा, यह मानकर नहीं कि यह चल जाएगा। टेस्ट फेल हुआ तो मैं यह सेक्शन लगभग काट ही देता। फिर पता चला कि वही फेल्योर असल खोज था।
server_vad ऑडियो को सन्नाटे की अवधियों पर चंक करता है, threshold, prefix_padding_ms, और silence_duration_ms से कॉन्फ़िगरेबल। semantic_vad एक क्लासिफ़ायर का उपयोग करता है जो अनुमान लगाता है कि वक्ता खत्म-सा लग रहा है या नहीं, और eagerness सेटिंग तय करती है कि यह कितनी जल्दी फ़ैसला करे:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}यही दोनों मोड्स Realtime API के लिए सामान्य रूप से डॉक्यूमेंटेड हैं। वही पेलोड gpt-live-transcribe सेशन को भेजने पर रिजेक्ट होकर लौटता है:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad ने हूबहू यही एरर दिया। 4 अगस्त, 2026 तक, gpt-live-transcribe के लिए मैनुअल कमिट ही एकमात्र turn-detection मोड है, भले ही ट्रांसक्रिप्शन गाइड अब भी आपको वॉइस एक्टिविटी डिटेक्शन कॉन्फ़िगर करने को कहती है ताकि सर्वर आपके लिए turns कमिट करे। इसके इर्द-गिर्द बनाने से पहले दोबारा टेस्ट करें, क्योंकि OpenAI बाद में बिना बताए इस मॉडल के लिए VAD ऑन कर सकता है।
पुश-टू-टॉक आसान केस है, क्योंकि प्रेस और रिलीज़ पहले से सीमाएँ चिह्नित करते हैं। बाकी सब क्लाइंट पर छोड़ देता है कि turn कब खत्म हुआ, और मेरे पहले दो प्रयास दोनों गलत निकले।
पहले प्रयास में कमिट को if not mic_queue.empty() से गार्ड किया, जो समझ में आता है और कभी फायर ही नहीं होता: वह coroutine जो queue ड्रेन करता है, उसे उतनी ही तेजी से खाली करता है जितनी तेजी से माइक्रोफ़ोन भरता है। आंशिक कैप्शन फिर भी स्ट्रीम होते रहे, जिससे यह काफ़ी विश्वसनीय लगा, पर कुछ भी फ़ाइनलाइज़ नहीं हुआ। दूसरे प्रयास में हर चार सेकंड पर कमिट कर दिया गया, जब तक ऑडियो जोड़ा गया था। असली माइक्रोफ़ोन पर इसका नतीजा यह रहा:
[final]   यह एक कस्टमर सपोर्ट  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort प्रीमियम प्लान पर अकाउंट A की कॉल  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
दो असफलताएँ साथ में। टाइमर ने वाक्य को बीच-शब्द में काट दिया, और मॉडल ने कहीं से शुरू न होने वाले टुकड़े को "Abort" पढ़ लिया। फिर यह तब कमिट हो गया जब मैं बोल नहीं रहा था और खाली ट्रांसक्रिप्ट लौटा, क्योंकि माइक्रोफ़ोन चाहे कोई बोले या नहीं, चंक्स स्ट्रीम करता रहता है।
दोनों एक ही कमी से आए: ऑडियो एनर्जी। mic_stream.py में SpeechGate हर चंक के RMS amplitude को ट्रैक करता है और तब कमिट करता है जब वक्ता कुछ बोल चुका हो और फिर चुप हो गया हो, एक कैप के साथ ताकि लगातार बोलना भी कहीं तो खत्म हो। मेरे पहले संस्करण ने उस amplitude की तुलना एक फिक्स्ड नंबर से की, जो एक मशीन पर चला और अगली पर पाँच गुना गलत निकला, तो अब यह कमरे का अनुमान लगाता है और जो कई गुना ज़्यादा ज़ोरदार हो उसे स्पीच गिनता है। बहुत कम ऑडियो पर खत्म होने वाला turn, खाँसी या दरवाज़ा, input_audio_buffer.clear पर जाता है, कमिट पर नहीं, क्योंकि दरवाज़े ने क्या कहा यह पूछना एक गढ़ा हुआ शब्द दिलाता है।
app.py इस ट्यूटोरियल के हर हिस्से को एक टर्मिनल ऐप में लाता है: माइक्रोफ़ोन कैप्चर, लाइव आंशिक कैप्शन, item_id से keyed ट्रांसक्रिप्ट हिस्ट्री, और सेशन द्वारा स्वीकार हर फ़ील्ड के लिए CLI फ्लैग्स।
python app.py --delay low --keywords "AC-42,premium plan" --languages enकेवल वे भाषाएँ नामित करें जो आप वास्तव में बोल रहे हैं। वही कमांड अगर अंग्रेज़ी स्पीच पर en,ar के साथ चले तो "delta" शब्द अरबी लिपि में ट्रांसलिटरेट होकर लौटा, जो टेस्ट 2 की खोज उल्टी दिशा में चल रही है।
--turn-detection डिफ़ॉल्ट रूप से manual है, और --silence-hold और --max-turn पिछले सेक्शन के गेट को ट्यून करते हैं। VAD मोड्स फ़्लैग्स के रूप में बने रहते हैं ताकि अगर API उन्हें स्वीकार करना शुरू करे; इनमें से कोई पास करें और ऐप चुपचाप अटका रहने के बजाय सर्वर का रिजेक्शन प्रिंट करता है।
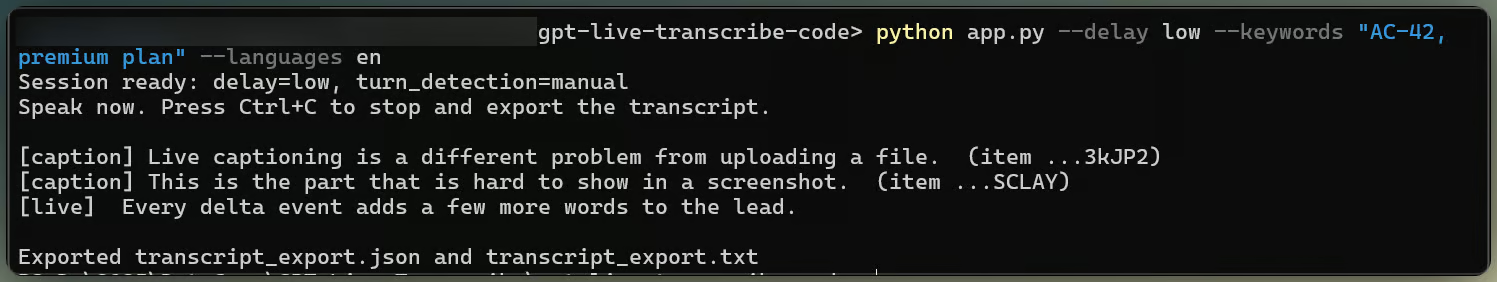
सेटिंग्स के साथ पूरा कैप्शनिंग ऐप चल रहा है। चित्र: लेखक।
एग्ज़िट पर यह प्लेन-टेक्स्ट ट्रांसक्रिप्ट और एक JSON फ़ाइल लिखता है जिसमें प्रयुक्त कॉन्फ़िगरेशन, लोकल रूप से मापा time-to-first-delta, और हर फ़ाइनलाइज़्ड turn का उसका item_id होता है। मैंने वह एक्सपोर्ट तब जोड़ा जब एक अच्छा टेस्ट रन बंद हुए टर्मिनल से खो गया। उसके टाइमस्टैम्प क्लाइंट-साइड हैं, तो अपनी इंस्ट्रूमेंटेशन को OpenAI के आँकड़ों के रूप में न समझें।
तीनों टेस्ट ब्राउज़र में भी चलते हैं। demo_app.py एक Streamlit संस्करण है, प्रत्येक प्रयोग के लिए एक टैब के साथ; इसे डेमो रखा गया है न कि मुख्य शिक्षण पथ, क्योंकि टर्मिनल स्क्रिप्ट्स कच्चे इवेंट्स ज़्यादा सीधे दिखाती हैं।
streamlit run demo_app.pyDataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स