Curso
Trabalhar com a API da OpenAI
3 h
172.6K
Enviar um arquivo de áudio pronto para um endpoint de transcrição é a parte fácil. Você espera o arquivo inteiro e recebe uma única transcrição de volta. Ninguém fica encarando a tela enquanto o modelo trabalha. Legendagem ao vivo é outro jogo: o áudio continua chegando enquanto você ainda está decidindo o que fazer com o que já tem, e o texto precisa atualizar enquanto a pessoa ainda está falando.
É aí que gpt-live-transcribe entra. A OpenAI lançou em 28 de julho de 2026 junto com uma versão para lotes, gpt-transcribe. Neste tutorial eu construo um cliente de legendagem em Python em cima dele e rodo três testes: um cliente básico de streaming, uma comparação das dicas de contexto que ele aceita e um benchmark dos cinco níveis de atraso. Testei com inglês limpo, vocabulário técnico e code-switching entre árabe egípcio e inglês, porque isso é mais próximo de uma reunião real do que um único narrador limpo.
No fim, você vai ter um app de legendagem funcionando, uma noção de quais ajustes de contexto realmente ajudam e um nível de atraso que você consegue defender em vez de chutar.
gpt-live-transcribe é um modelo de reconhecimento de fala para texto via streaming, para apps que precisam de transcrição enquanto o áudio ainda está chegando. Ele recebe áudio e devolve texto, só isso, ajustado por quatro campos: delay para latência, prompt para contexto livre, keywords para termos literais e languages para os idiomas esperados de entrada. No benchmark Context Aware ASR da OpenAI, o contexto livre elevou a acurácia semântica de 38,5% para 44,6%, por isso o Teste 2 existe.
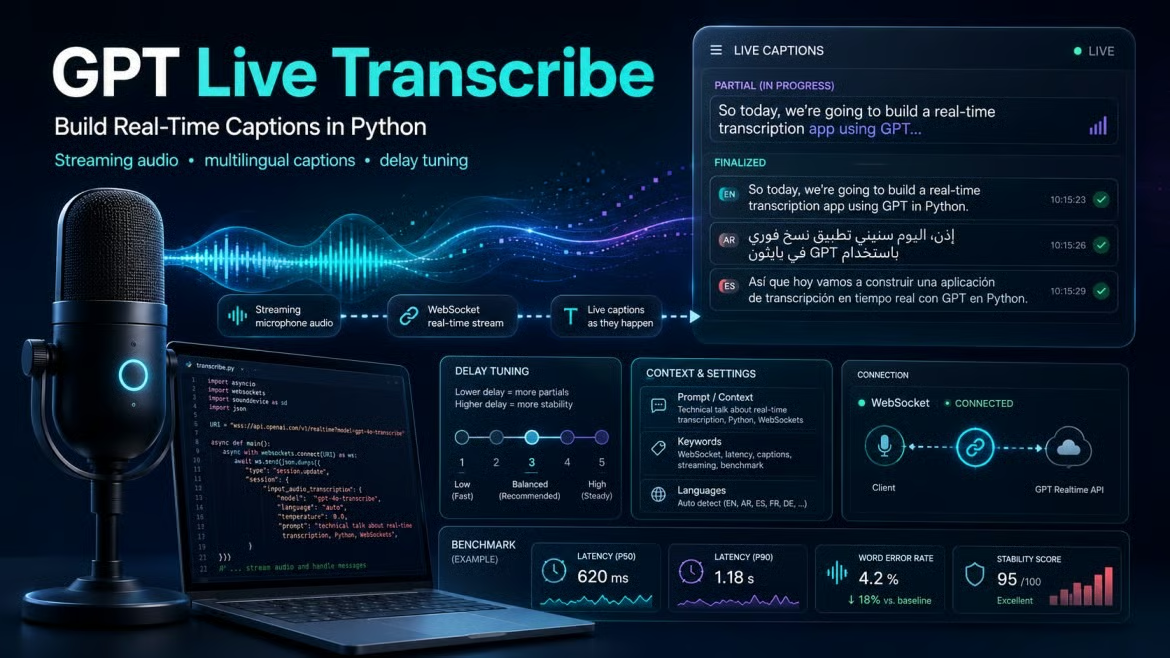
O modelo roda dentro da Realtime API, não como um endpoint separado, e não tem relação com o GPT-Live, o sistema de voz da OpenAI, apesar do nome sugerir. Você abre uma sessão de transcrição, configura e o servidor envia eventos de volta pelo mesmo canal onde você manda o áudio. Antes, dá para resolver uma dúvida: qual dos dois modelos de transcrição você realmente precisa.
A OpenAI oferece dois modelos recomendados de transcrição, e eles não são intercambiáveis. gpt-live-transcribe serve para áudio contínuo chegando de microfone, ligação telefônica, stream de mídia — quando você precisa de texto parcial antes do término da fala. gpt-transcribe é para gravações concluídas ou para uma sessão Realtime onde você decide esperar por um turno consolidado. A documentação chama esse segundo caso de workflow especializado, não uma forma de obter deltas ao vivo.
Um detalhe confunde bastante gente: gpt-transcribe retorna um array languages com o idioma detectado; gpt-live-transcribe não retorna. Se sua lógica depende do idioma detectado, você está escolhendo o modelo errado, por mais que a demo pareça ótima. A precificação também divide nessa linha, mais ou menos quatro para um a favor do modelo em lotes — volto nisso adiante.
Melhor falar agora do que depois de você ter construído metade do app. Não há timestamps por palavra, nem rótulos de falante, nem scores de confiança e nem diarização. Se você precisa de timing para legendas, de notas dizendo quem falou, ou de um limiar de confiança, o guia da OpenAI aponta para gpt-4o-transcribe-diarize ou whisper-1.
Cada script deste tutorial está em github.com/KhalidAbdelaty/gpt-live-transcribe, então comece clonando. Você precisa de Python 3.10+ e de uma chave de API com acesso ao Realtime. Os scripts usam quatro pacotes: websockets para a conexão, sounddevice para capturar o microfone, numpy para converter o buffer e python-dotenv para carregar a chave. O requirements inclui mais alguns para os gráficos e a demo no navegador.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
No macOS, o sounddevice precisa do PortAudio no SO (brew install portaudio); no Linux é apt-get install portaudio19-dev. Pule isso no Windows. Eu mesmo esbarrei nisso no macOS, e o conserto é literalmente essa instalação.
O áudio precisa chegar como PCM 16-bit, 24 kHz, mono, little-endian, em base64. Se você enviar um MP3 ou um WAV estéreo, vai receber texto embaralhado ou a conexão será fechada — nunca uma mensagem dizendo que o formato estava errado. Isso consome uma tarde fácil. A próxima pergunta é qual conexão vai carregar o áudio.
A orientação da OpenAI é direta: WebSocket para aplicações server-to-server; WebRTC para navegador e mobile. Este tutorial constrói um backend em Python lendo um microfone local, então WebSocket é a escolha certa — e uma chave de API padrão funciona porque nunca sai do seu servidor.
Uma sessão começa com um evento session.update que define type: "transcription" e escolhe gpt-live-transcribe como modelo. O resto do payload descreve o áudio que você vai enviar. Aqui está a configuração mínima, do guia de transcrição Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None desativa a detecção automática de atividade de voz, então nada é finalizado até você fazer o commit explicitamente. Três eventos do cliente fazem o trabalho: input_audio_buffer.append envia um chunk de áudio em base64, input_audio_buffer.commit encerra um turno, e o servidor responde com conversation.item.input_audio_transcription.delta (texto parcial) e conversation.item.input_audio_transcription.completed (texto final). Eu me conecto a wss://api.openai.com/v1/realtime?intent=transcription, um padrão do cookbook da OpenAI; o guia não documenta essa query string, então remova se um dia parar de funcionar.
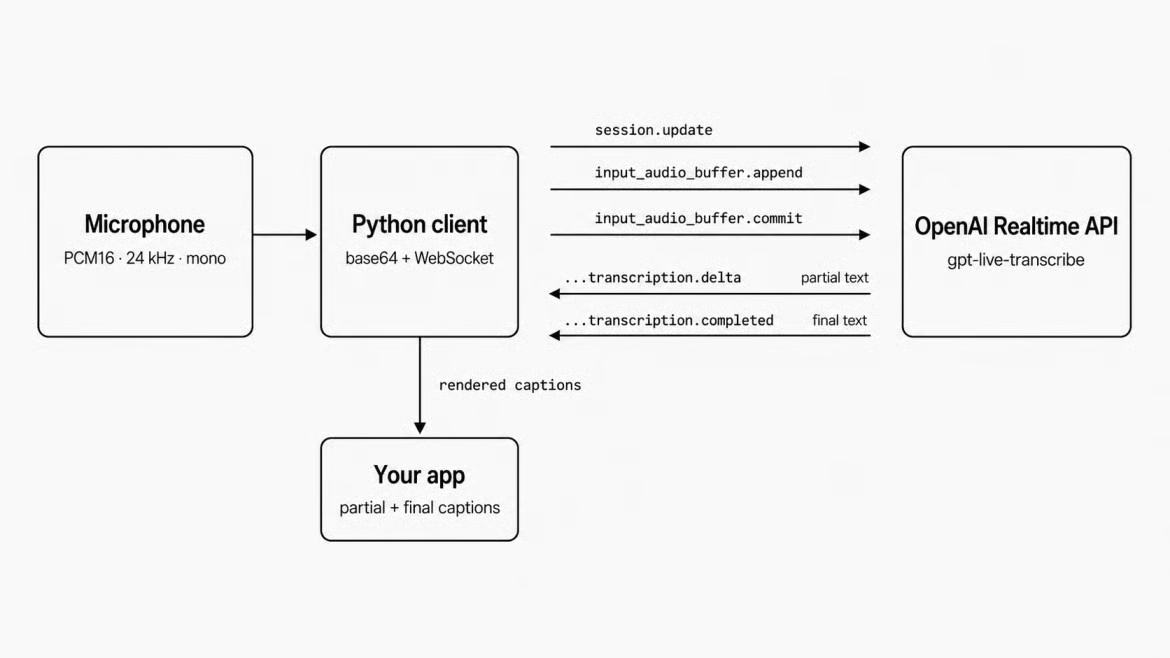
Fluxo de eventos em uma sessão de transcrição Realtime. Imagem do autor.
O Teste 1 é o menor recorte que funciona: capturar o áudio do microfone, fazer streaming e imprimir texto parcial e final conforme chega. Sem contexto, sem keywords, nada ajustado — assim o fluxo de eventos fica visível. O primeiro desafio é tirar áudio da thread do microfone sem travá-la.
sounddevice roda o callback em sua própria thread com poucos milissegundos para devolver antes do driver descartar frames, então não pode esperar por uma chamada de rede. A única função dele é converter o buffer float32 para PCM16 e empilhar em uma asyncio.Queue via loop.call_soon_threadsafe, enquanto uma coroutine separada drena a fila e envia cada chunk.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Um chunk de 100 milissegundos (2.400 amostras a 24 kHz) é um ponto de partida razoável. Diminuir demais aumenta o overhead por mensagem; aumentar demais deixa a legenda com cara de lenta. Não há um número "certo" documentado — trate como um ajuste fino.
Deltas são baratos e frequentes. Cada um traz um pedaço de texto atrelado a um item_id. Acrescente-o ao texto parcial que você já tem para esse item, e a legenda cresce palavra a palavra na tela:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Um evento completed substitui esse parcial pela transcrição final daquele mesmo item. Considere completed como a fonte da verdade e os deltas como um preview — não algo para você mesmo concatenar.
Aqui está o detalhe que quebra sua UI se você ignorar: o guia da OpenAI afirma que a ordem entre eventos de conclusão de turnos diferentes não é garantida. Um evento completed de um turno anterior pode chegar depois do de um turno posterior; então, código que assume que o completed mais recente pertence ao turno mais recente vai, às vezes, retroceder ou duplicar uma linha. Faça tudo por item_id — é o que minha classe TranscriptState faz.
Ao construir isso peguei dois bugs, ambos sobre qual dicionário o código checava. Inserir o item_id na lista de ordem só no handler de delta deixava o full_transcript() vazio para qualquer receptor que processasse apenas eventos completed. Usar o dicionário de parciais para decidir se um item era novo foi pior: apply_completed() limpa essa entrada, então um delta tardio parecia novo, ia para a lista de ordem de novo e imprimia o turno concluído duas vezes. Acompanhe item_id em ambos os handlers e confira a lista de ordem.
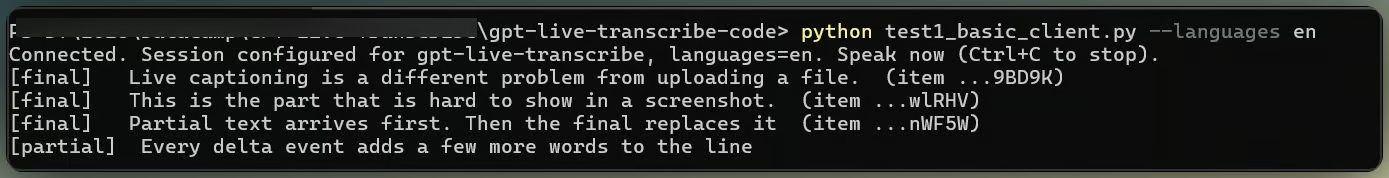
Legenda parcial ao vivo finalizando em transcrição. Imagem do autor.
Em inglês limpo, o texto apareceu em um ou dois segundos e bateu com o que eu disse, pontuação inclusa. No microfone do laptop e sem contexto, porém, uma palavra incerta às vezes voltou em outro alfabeto. languages é o campo para isso — foco do Teste 2.
O modelo aceita três tipos de contexto — vale ser preciso antes de testá-los. prompt é texto livre descrevendo o cenário; keywords são termos literais que o áudio pode conter; e languages lista os idiomas esperados como códigos ISO 639-1, como en ou ar. Nenhum deles força uma saída. Uma keyword que não foi dita não vai aparecer só porque você listou, e o único jeito de saber o que esses campos fazem é mudar um por vez.
Rodei o mesmo clipe em cinco configurações, três passadas cada. Duas regras deixam a comparação honesta: só um campo de contexto muda por vez e toda configuração roda mais de uma vez, porque o modelo não é determinístico no mesmo áudio.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Minha primeira versão definiu languages só no teste combinado, quebrando a primeira regra: dois campos mudaram de uma vez, então qualquer diferença poderia vir de qualquer um. Uma regra de formatação também me deu um session update rejeitado: uma keyword contendo <, >, carriage return ou line feed rejeita toda a atualização, não só aquela palavra. TranscriptionConfig.validate_keywords() pega isso antes de montar o payload.
Keywords ajudaram no tipo de áudio esperado. Em toda passada, o número da conta foi transcrito como palavras, porque é isso que o áudio contém. A questão era se o modelo iria agrupar essas palavras em um identificador ou soletrar como "A C quarenta e dois".
Em quinze execuções, o corte foi nítido. Sem keywords nunca agrupou: no_context, prompt_only e languages_only devolveram "A C quarenta e dois" nas nove passadas. Com keywords, agrupou em cinco de seis, na maior parte como "AC-42" já formatado. Então keywords mudou o resultado e prompt sozinho não — batendo com a descrição da OpenAI de que keywords é o campo para termos literais que o modelo pode interpretar mal. Só keywords ainda errou uma vez, então trate como uma dica que muda bastante as chances, não uma regra que o modelo obedece sempre.
Isso parece destoar do número que abri, onde contexto livre elevou a acurácia semântica em seis pontos. São testes diferentes: a OpenAI avaliou significado em um conjunto amplo de áudios, enquanto eu observei um identificador em um clipe. Um prompt pode melhorar a frase e ainda assim não tocar o detalhe estreito que você está conferindo. O único sinal disso aqui é que prompt e keywords juntos agruparam em todas as passadas, enquanto só keywords falhou uma — diferença de uma única execução.
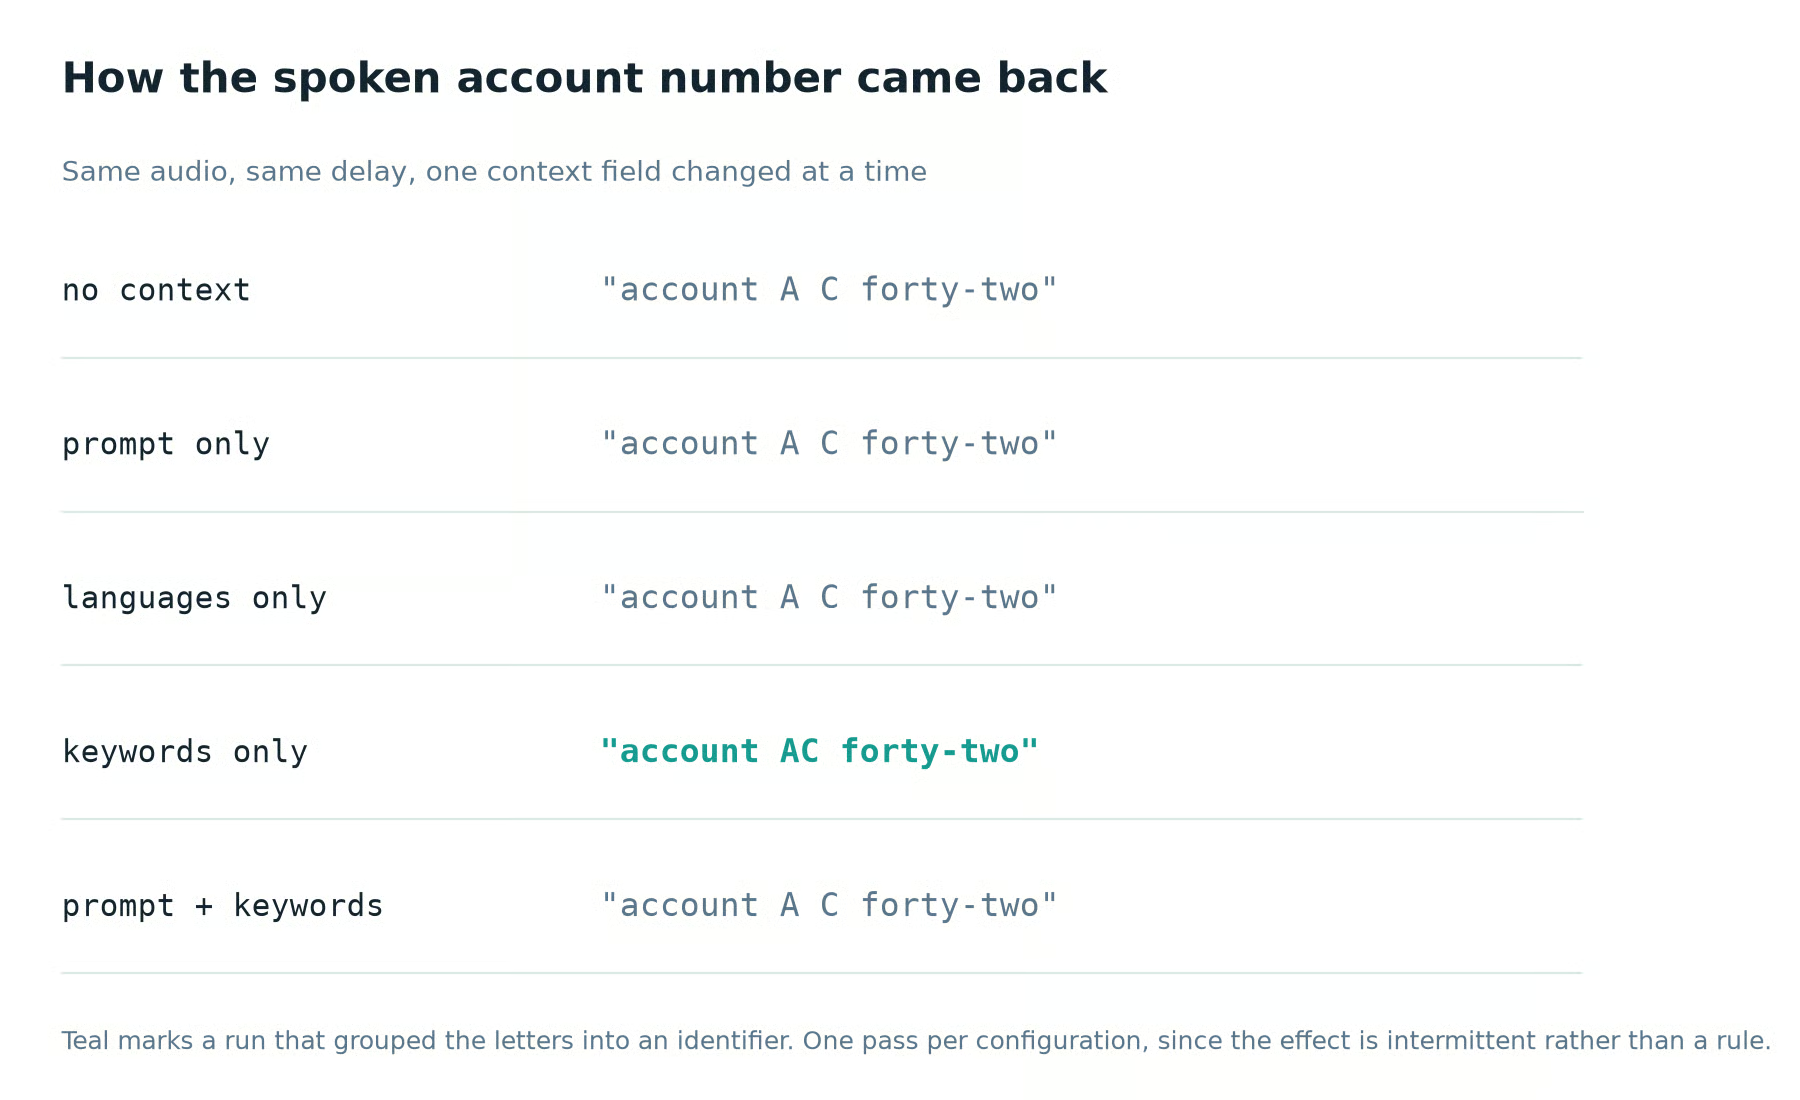
Só keywords agruparam o identificador falado. Imagem do autor.
Dicas de idioma ajudaram mais claramente e em um problema que eu não esperava. Sem dica, execuções no clipe com code-switching entendiam a muleta inicial em árabe, algo como "tayyib", como o "But" em inglês, fundindo os dois sistemas de escrita numa palavra quebrada. Também escreviam "billing statement" transliterado em árabe em algumas passadas e em latino em outras. Adicionar languages: ["ar", "en"] removeu a palavra quebrada em todas as passadas. É um clipe só — e uma frase que troca de idioma no meio é o cenário mais fácil para a dica aparecer.
delay aceita cinco valores: minimal, low, medium, high e xhigh. Configurações mais baixas produzem parciais mais cedo. Mais altas dão ao modelo mais contexto de áudio antes de consolidar texto, o que pode melhorar a acurácia em áudios difíceis. A OpenAI é explícita que o timing exato varia pela configuração e deve ser medido com áudio representativo — é o que o Teste 3 faz.
test3_delay_benchmark.py envia o mesmo WAV por todos os cinco níveis, várias passadas cada, registrando o tempo do início do stream até o primeiro delta e até o final. Manter áudio, campos de contexto e estratégia de commit idênticos é o que torna a comparação significativa.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Esses números não são universais. Vieram de três passadas por nível em um clipe, uma rede, uma tarde. A mediana até o primeiro parcial foi de 0,70 s em minimal a 2,91 s em xhigh, subindo em passos regulares por low (1,19 s), medium (1,39 s) e high (2,09 s). As três execuções em cada nível ficaram dentro de ~0,2 s entre si, então a ordem é estável, mesmo que os valores absolutos sejam os meus, não os seus.
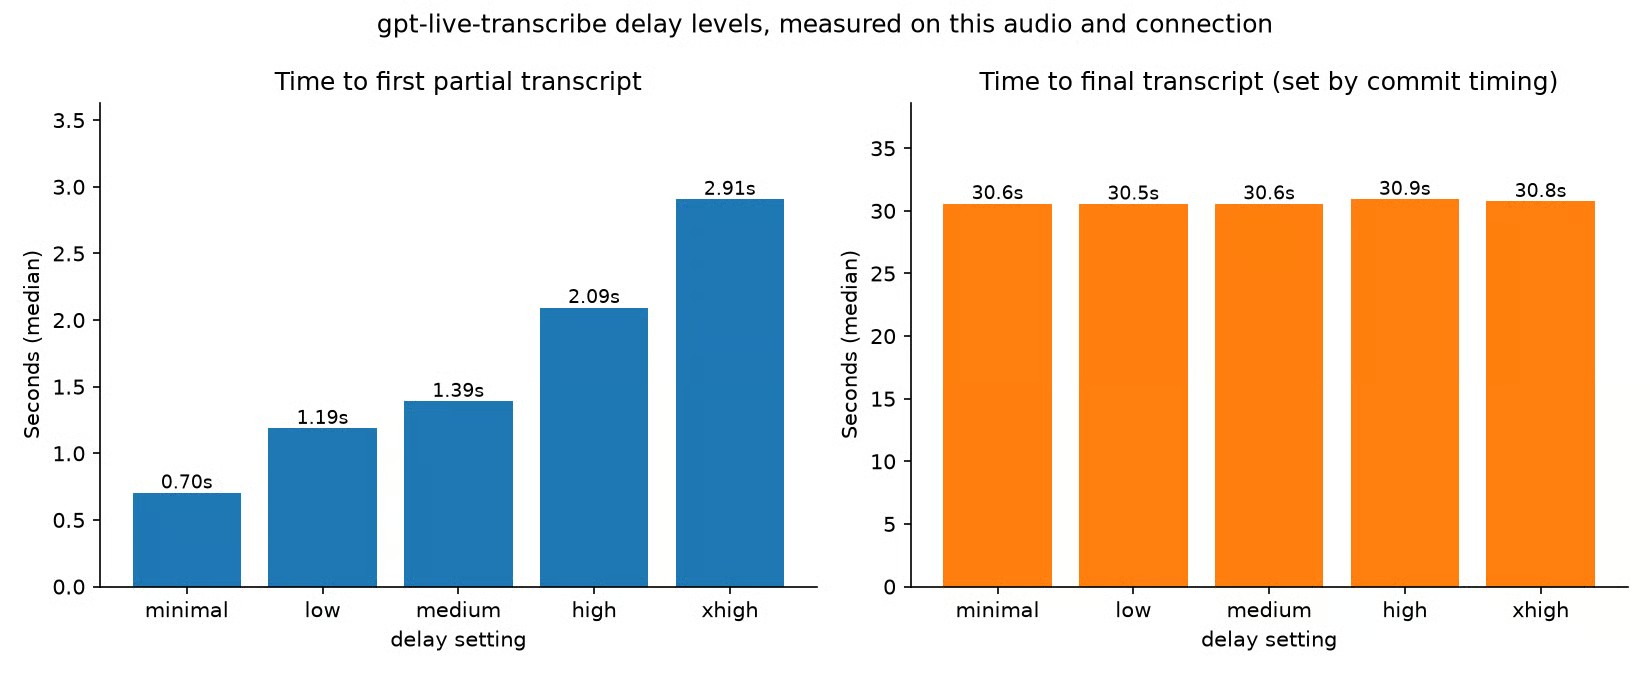
Níveis de delay trocam velocidade por acurácia. Imagem do autor.
O que não consegui confirmar foi a suposição comum de que mais delay gera menos revisões. A contagem de deltas ficou entre 84 e 86 em todos os níveis — praticamente idêntica, sem tendência. O tempo até o final ficou dentro de meio segundo de 30,6 s em todos também, mas isso reflete meu timing de commits, não o modelo. Por isso o gráfico separa as duas medidas em painéis: em um eixo, um spread de dois segundos some em barras dez vezes mais altas.
Para legendas ao vivo que alguém lê enquanto outra pessoa fala, comece em low. Esperar dois segundos até aparecer qualquer texto dá uma sensação de quebrado — mais do que uma legenda corrigida logo depois. Para notas de reunião que ninguém lê na hora, high ou xhigh custam quase nada. Para comandos de voz, penda para medium, porque uma palavra errada em um comando de duas palavras pesa mais.
Até aqui, todos os testes usaram turn_detection: null e commit manual. A Realtime API oferece detecção de atividade de voz como alternativa, então eu liguei isso ao gpt-live-transcribe em vez de assumir que funcionaria. Quase cortei esta seção quando o teste falhou. Aí percebi que a falha era o achado.
server_vad separa o áudio por períodos de silêncio, ajustável via threshold, prefix_padding_ms e silence_duration_ms. semantic_vad usa um classificador que estima se o falante parece ter terminado, com eagerness controlando a rapidez da decisão:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}É assim que ambos os modos estão documentados para a Realtime API em geral. Enviado para uma sessão gpt-live-transcribe, esse payload volta rejeitado:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad gerou o mesmo erro. Em 4 de agosto de 2026, commit manual é o único modo de detecção de turnos aceito por gpt-live-transcribe, embora o guia de transcrição ainda diga para configurar VAD para o servidor consolidar os turnos. Teste de novo antes de construir em cima disso — a OpenAI pode ativar VAD neste modelo depois sem avisar ninguém.
Push-to-talk é o caso fácil — o pressionar e soltar já marca os limites. No resto, o cliente decide quando um turno terminou, e minhas duas primeiras tentativas erraram.
A primeira protegia o commit com if not mic_queue.empty(), o que parece sensato e nunca dispara: a coroutine que drena a fila esvazia tão rápido quanto o microfone enche. As legendas parciais continuavam, o que convenceu, mas nada finalizava. A segunda fazia commit a cada quatro segundos enquanto houvesse áudio anexado. Num microfone real, produziu isso:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Dois erros ao mesmo tempo. O timer cortou a frase no meio da palavra, e o modelo leu um fragmento sem início como "Abort". Depois consolidou enquanto eu não falava e retornou uma transcrição vazia, já que um microfone envia chunks com ou sem alguém falando.
Os dois vêm da mesma falta de informação: energia do áudio. SpeechGate em mic_stream.py acompanha a amplitude RMS de cada chunk e faz commit quando a pessoa falou algo e depois ficou em silêncio — com um teto para fala contínua terminar em algum momento. Minha primeira versão comparava a amplitude com um número fixo, funcionou em uma máquina e errou por um fator de cinco na próxima; então agora estima o ruído ambiente e conta como fala o que for várias vezes mais alto. Um turno terminado com quase nada de áudio, uma tosse ou porta, vai para input_audio_buffer.clear em vez de commit — perguntar ao modelo o que uma porta disse é pedir palavra inventada.
app.py reúne todas as peças em um app de terminal: captura do microfone, parciais ao vivo, histórico de transcrição indexado por item_id e flags de CLI para cada campo aceito na sessão.
python app.py --delay low --keywords "AC-42,premium plan" --languages enInforme só os idiomas que você realmente vai falar. Esse mesmo comando com en,ar em fala em inglês devolveu a palavra "delta" transliterada em árabe — é o achado do Teste 2 no outro sentido.
--turn-detection vem como manual, e --silence-hold e --max-turn ajustam o gate da seção anterior. Os modos de VAD seguem como flags para o caso de a API passar a aceitá-los; ao usar, o app imprime a rejeição do servidor em vez de ficar parado.
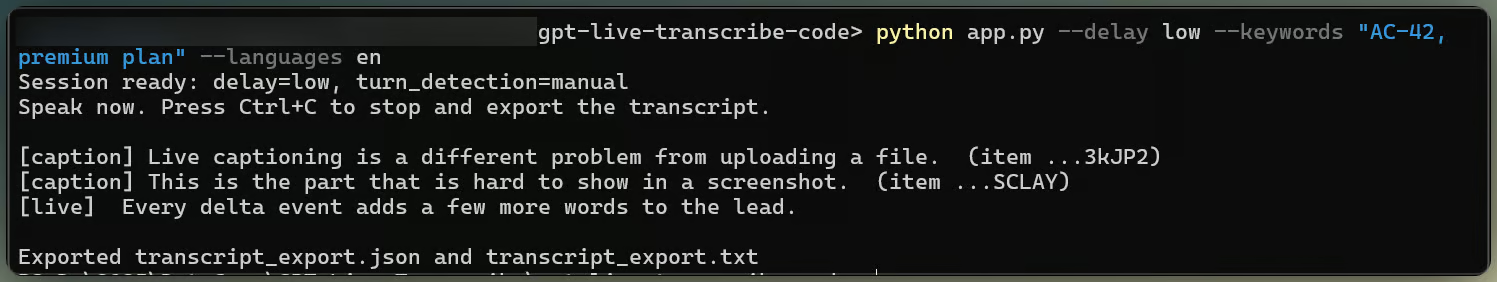
App completo rodando com configurações. Imagem do autor.
Ao sair, ele grava um .txt com a transcrição e um JSON com a configuração usada, o tempo até o primeiro delta medido localmente e cada turno finalizado com seu item_id. Adicionei essa exportação depois de perder um bom teste com o terminal fechado. Os timestamps são do lado do cliente — não confunda sua instrumentação com número da OpenAI.
Os três testes também rodam no navegador. demo_app.py é uma versão em Streamlit com uma aba por experimento — deixei como demo e não como trilha principal porque os scripts de terminal mostram melhor os eventos crus.
streamlit run demo_app.pyAprenda com a DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
Tutorial
Kurtis Pykes
12 min
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
8 min
Tutorial
Moez Ali
11 min
Tutorial
Zoumana Keita
14 min