Kursus
Bekerja dengan OpenAI API
3 Hr
172.8K
Mengunggah berkas audio yang sudah selesai ke endpoint transkripsi adalah versi mudah dari masalah ini. Anda menunggu seluruh berkas, lalu mendapatkan satu transkrip. Tidak ada yang menatap layar saat model bekerja. Penayangan takarir langsung adalah pekerjaan berbeda: audio terus datang saat Anda masih memutuskan apa yang akan dilakukan dengan yang sudah ada, dan teks harus diperbarui ketika pembicara masih berbicara.
Itulah celah yang diisi gpt-live-transcribe. OpenAI merilisnya pada 28 Juli 2026 bersamaan dengan model batch pendamping, gpt-transcribe. Dalam tutorial ini saya membangun klien takarir Python di sekelilingnya dan menjalankan tiga pengujian: klien streaming dasar, perbandingan petunjuk konteks yang diterimanya, dan tolok ukur lima pengaturan jedanya. Saya menguji dengan bahasa Inggris bersih, kosakata teknis, dan alih kode Arab Mesir–Inggris, karena itu lebih mendekati rapat nyata daripada satu narator bersih.
Pada akhirnya Anda akan memiliki aplikasi takarir yang berfungsi, gambaran tentang pengaturan konteks mana yang benar-benar membantu, dan pengaturan jeda yang bisa Anda pertahankan alih-alih menebak.
gpt-live-transcribe adalah model pengenalan ucapan-ke-teks streaming untuk aplikasi yang membutuhkan teks transkrip saat audio masih masuk. Model ini menerima audio dan mengembalikan teks, tidak ada yang lain, disetel oleh empat field: delay untuk latensi, prompt untuk konteks bebas, keywords untuk istilah literal, dan languages untuk bahasa input yang diharapkan. Pada tolok ukur Context Aware ASR milik OpenAI, konteks bebas menaikkan akurasi semantik dari 38,5 persen menjadi 44,6 persen, itulah alasan Tes 2 ada.
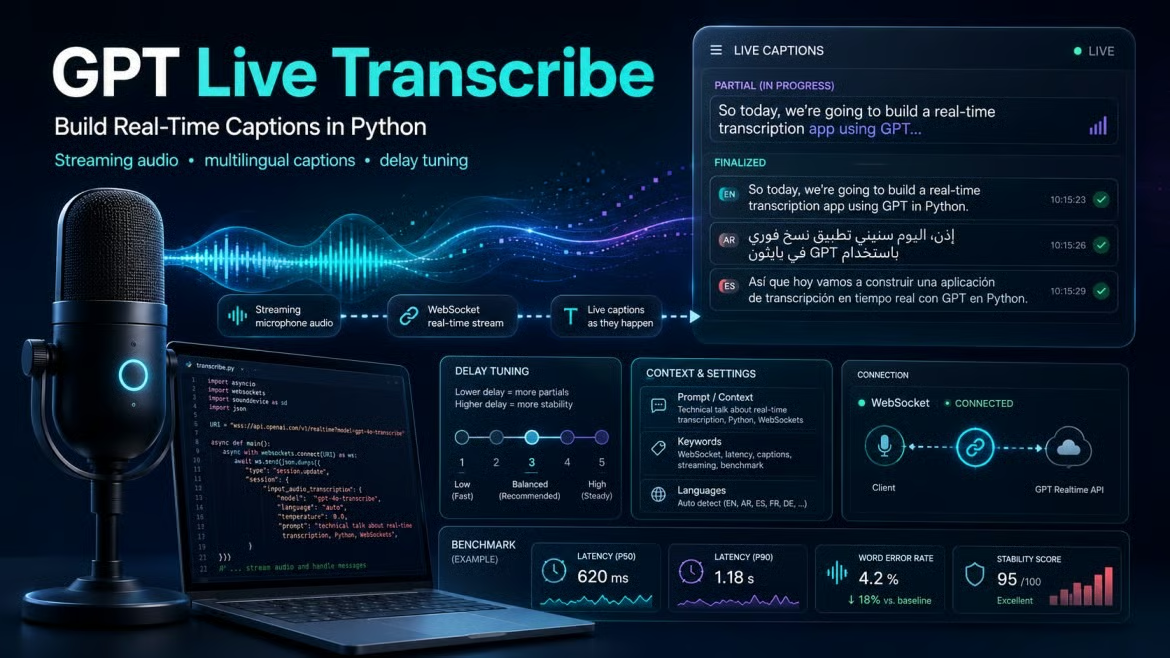
Model ini berjalan di dalam Realtime API, bukan sebagai endpoint terpisah, dan tidak terkait dengan GPT-Live, sistem suara OpenAI, apa pun yang disiratkan namanya. Anda membuka sesi transkripsi, mengonfigurasinya, dan server melakukan streaming event kembali melalui koneksi yang Anda kirimi audio. Itu menyisakan satu pertanyaan yang perlu diputuskan dulu: mana dari dua model transkripsi yang sebenarnya Anda butuhkan.
OpenAI menyediakan dua model transkripsi yang direkomendasikan, dan keduanya tidak saling menggantikan. gpt-live-transcribe ditujukan untuk audio yang datang terus-menerus, mikrofon, panggilan telepon, streaming media, di mana Anda memerlukan teks parsial sebelum pembicara selesai. gpt-transcribe untuk rekaman yang sudah selesai, atau sesi Realtime di mana Anda sengaja menunggu giliran yang dikomit. Dokumentasi menyebut kasus kedua itu sebagai alur kerja khusus, bukan cara mendapatkan delta langsung.
Satu perbedaan kerap mengecoh: gpt-transcribe mengembalikan array languages dengan bahasa input yang terdeteksi, gpt-live-transcribe tidak. Jika logika Anda bercabang berdasarkan bahasa yang terdeteksi, Anda meraih model yang salah, tak peduli seberapa bagus takarirnya terlihat dalam demo. Harga juga terbelah di garis yang sama, kira-kira empat banding satu menguntungkan model batch, yang akan saya bahas lagi nanti.
Saya lebih suka memberi tahu ini sekarang daripada setelah Anda membangun setengah aplikasi di atasnya. Tidak ada cap waktu tingkat kata, tidak ada label pembicara, tidak ada skor keyakinan, dan tidak ada diarization. Jika Anda membutuhkan penentuan waktu subtitle, catatan yang menyebut siapa yang berbicara, atau ambang keyakinan, panduan OpenAI mengarahkan ke gpt-4o-transcribe-diarize atau whisper-1.
Setiap skrip dalam tutorial ini berada di github.com/KhalidAbdelaty/gpt-live-transcribe, jadi mulai dengan mengkloningnya. Anda memerlukan Python 3.10 atau yang lebih baru dan kunci API dengan akses Realtime. Skripnya sendiri bergantung pada empat paket: websockets untuk koneksi, sounddevice untuk penangkapan mikrofon, numpy untuk konversi buffer, dan python-dotenv untuk memuat kunci. Berkas requirements menambahkan beberapa paket lagi untuk bagan dan demo browser.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Di macOS, sounddevice memerlukan PortAudio di level OS (brew install portaudio); di Linux apt-get install portaudio19-dev. Lewati baris itu jika Anda di Windows. Saya sendiri menemui masalah di macOS, dan perbaikannya memang hanya instalasi tunggal itu.
Audio itu sendiri harus datang sebagai PCM 16-bit pada 24 kHz, mono, little-endian, dan di-base64. Kirim MP3 atau WAV stereo dan Anda akan mendapat keluaran acak atau koneksi ditutup, tidak pernah pesan yang memberi tahu formatnya salah. Yang ini bisa menghabiskan satu sore. Jadi pertanyaan berikutnya adalah koneksi mana yang membawa audio.
Panduan OpenAI jelas: WebSocket untuk aplikasi server-ke-server, WebRTC untuk klien browser dan mobile. Tutorial ini membangun backend Python yang membaca mikrofon lokal, jadi WebSocket adalah pilihan yang tepat, dan kunci API standar berfungsi karena tidak pernah meninggalkan server Anda.
Sesi dimulai dengan event session.update yang menetapkan type: "transcription" dan memilih gpt-live-transcribe sebagai model. Semua hal lain dalam payload mendeskripsikan audio yang akan Anda kirim. Berikut konfigurasi minimum, dari panduan transkripsi Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None menonaktifkan deteksi aktivitas suara otomatis, sehingga tidak ada yang difinalkan sampai Anda mengomitikannya secara eksplisit. Tiga event klien kemudian melakukan pekerjaan: input_audio_buffer.append mengirim potongan audio base64, input_audio_buffer.commit mengakhiri satu giliran, dan server menjawab dengan conversation.item.input_audio_transcription.delta (teks parsial) dan conversation.item.input_audio_transcription.completed (teks final). Saya terhubung ke wss://api.openai.com/v1/realtime?intent=transcription, pola dari cookbook OpenAI; panduan tidak mendokumentasikan query string itu, jadi hilangkan jika suatu saat tidak lagi berfungsi.
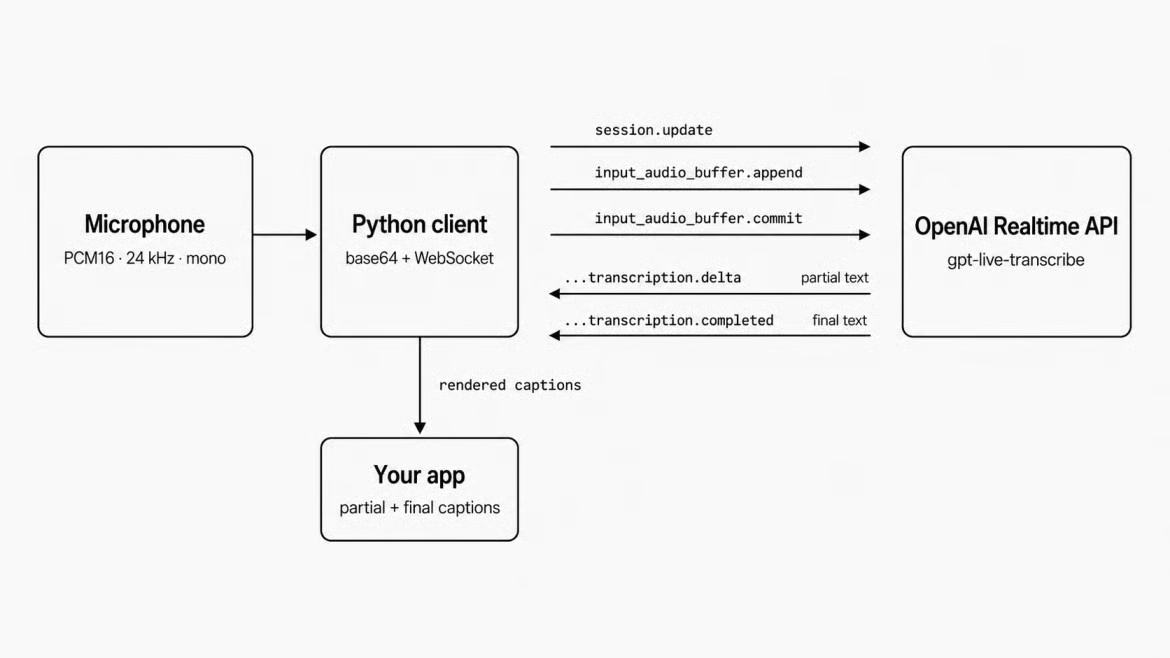
Diagram alur event sesi transkripsi Realtime. Gambar oleh Penulis.
Tes 1 adalah versi terkecil yang berfungsi: menangkap audio mikrofon, melakukan streaming, mencetak teks parsial dan final saat tiba. Tanpa konteks, tanpa kata kunci, tidak ada yang disetel, sehingga alur event tetap terlihat. Masalah pertama adalah mengambil audio dari thread mikrofon tanpa membuatnya macet.
sounddevice menjalankan callback-nya pada thread sendiri dengan beberapa milidetik untuk kembali sebelum driver menjatuhkan frame, jadi tidak bisa menunggu panggilan jaringan. Tugasnya hanya mengonversi buffer float32 ke PCM16 dan menempatkannya ke asyncio.Queue melalui loop.call_soon_threadsafe, sementara coroutine terpisah menguras antrean itu dan mengirim setiap potongan.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Potongan 100 milidetik (2.400 sampel pada 24 kHz) adalah titik awal yang masuk akal. Lebih kecil menambah overhead per pesan, jauh lebih besar membuat takarir terasa lambat. Tidak ada angka baku terdokumentasi, jadi perlakukan sebagai kenop.
Delta itu murah dan sering. Masing-masing membawa potongan teks yang terkait dengan sebuah item_id. Tambahkan ke teks parsial yang sudah Anda miliki untuk item itu, dan takarir tumbuh kata demi kata di layar:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Event completed mengganti parsial itu dengan transkrip final untuk item yang sama. Perlakukan completed sebagai sumber kebenaran dan delta sebagai pratinjau, bukan sesuatu yang Anda rangkai sendiri.
Inilah detail yang akan merusak UI Anda jika dilewatkan: panduan OpenAI menyatakan bahwa urutan antara event penyelesaian dari giliran yang berbeda tidak dijamin. Event completed untuk giliran lebih awal bisa tiba setelah yang lebih akhir, sehingga kode yang mengasumsikan completed terbaru milik giliran terbaru sesekali akan melompat mundur atau menduplikasi baris. Kunci semuanya berdasarkan item_id, yang dilakukan kelas TranscriptState saya.
Membangunnya menangkap dua bug, keduanya tentang kamus mana yang diperiksa kode. Menambahkan item_id ke daftar urutan hanya di handler delta membuat full_transcript() kosong untuk penerima mana pun yang hanya memproses event completed. Menggunakan kamus parsial untuk memutuskan apakah sebuah item baru lebih buruk lagi: apply_completed() mengosongkan entri itu, sehingga delta yang telat terlihat baru, masuk ke daftar urutan kedua kali, dan mencetak giliran yang sudah selesai dua kali. Lacak item_id di kedua handler, dan periksa daftar urutan sebagai gantinya.
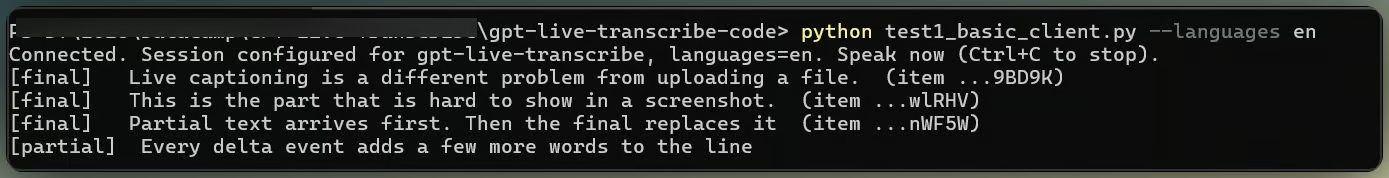
Takarir parsial langsung difinalkan menjadi transkrip. Gambar oleh Penulis.
Terhadap bahasa Inggris bersih, teks muncul dalam satu–dua detik dan cocok dengan yang saya ucapkan, termasuk tanda baca. Melalui mikrofon laptop tanpa konteks, kadang-kadang kata yang diragukan model malah kembali dalam aksara lain sama sekali. languages adalah field untuk itu, yang menjadi sasaran Tes 2.
Model menerima tiga jenis konteks, yang layak dijelaskan dengan tepat sebelum mengujinya. prompt adalah teks bebas yang menggambarkan situasi, keywords adalah istilah literal yang mungkin ada dalam audio, dan languages mencantumkan bahasa input yang diharapkan sebagai kode ISO 639-1 seperti en atau ar. Tidak ada satupun yang memaksa keluaran. Kata kunci yang tidak pernah diucapkan tidak akan muncul hanya karena Anda mencantumkannya, dan satu-satunya cara mengetahui apa yang benar-benar dilakukan field ini adalah mengubah satu per satu.
Saya menjalankan klip yang sama melalui lima konfigurasi, masing-masing tiga kali. Dua aturan menjaga perbandingan seperti ini tetap jujur: hanya satu field konteks yang berubah antar-run, dan setiap konfigurasi dijalankan lebih dari sekali, karena model tidak deterministik pada audio identik.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Versi pertama saya menetapkan languages hanya pada run gabungan, yang melanggar aturan pertama: dua field berubah sekaligus, jadi perbedaan di sana bisa berasal dari salah satunya. Satu aturan pemformatan juga membuat saya mendapat pembaruan sesi yang ditolak: kata kunci yang berisi <, >, carriage return, atau line feed menolak seluruh pembaruan, bukan hanya kata kunci itu. TranscriptionConfig.validate_keywords() menangkapnya sebelum membangun payload.
Kata kunci membantu pada jenis audio yang Anda harapkan. Setiap run menyalin nomor akun sebagai kata-kata yang diucapkan, karena itulah yang ada di audio. Pertanyaannya adalah apakah model mengelompokkan kata-kata itu menjadi pengenal atau mengejanya sebagai "A C forty-two."
Di lima belas run, perbedaannya tajam. Tanpa keywords tidak ada yang pernah mengelompokkannya: no_context, prompt_only, dan languages_only mengembalikan "A C forty-two" di semua sembilan run mereka. Run dengan keywords mengelompokkannya pada lima dari enam run, sebagian besar sebagai "AC-42" yang sudah diformat penuh. Jadi keywords mengubah hasil dan prompt saja tidak pernah, selaras dengan pemaparan OpenAI tentang keywords sebagai field untuk istilah literal yang mungkin salah diurai model. Kata kunci saja masih meleset sekali, jadi anggap itu sebagai petunjuk yang sangat menggeser peluang alih-alih aturan yang pasti diikuti model.
Itu terasa janggal di samping angka tolok ukur yang saya buka tadi, di mana konteks bebas mengangkat akurasi semantik enam poin. Kedua pengujian mengukur hal berbeda: OpenAI menilai makna di serangkaian audio luas, sementara saya mengamati satu pengenal pada satu klip. Sebuah prompt bisa melakukan pekerjaan nyata pada kalimat tetapi tetap membiarkan detail sempit yang kebetulan Anda cek tidak tersentuh. Satu-satunya tanda di sini adalah bahwa prompt dan keywords bersama-sama mengelompokkannya di setiap run sementara keywords saja meleset satu, selisih satu run.
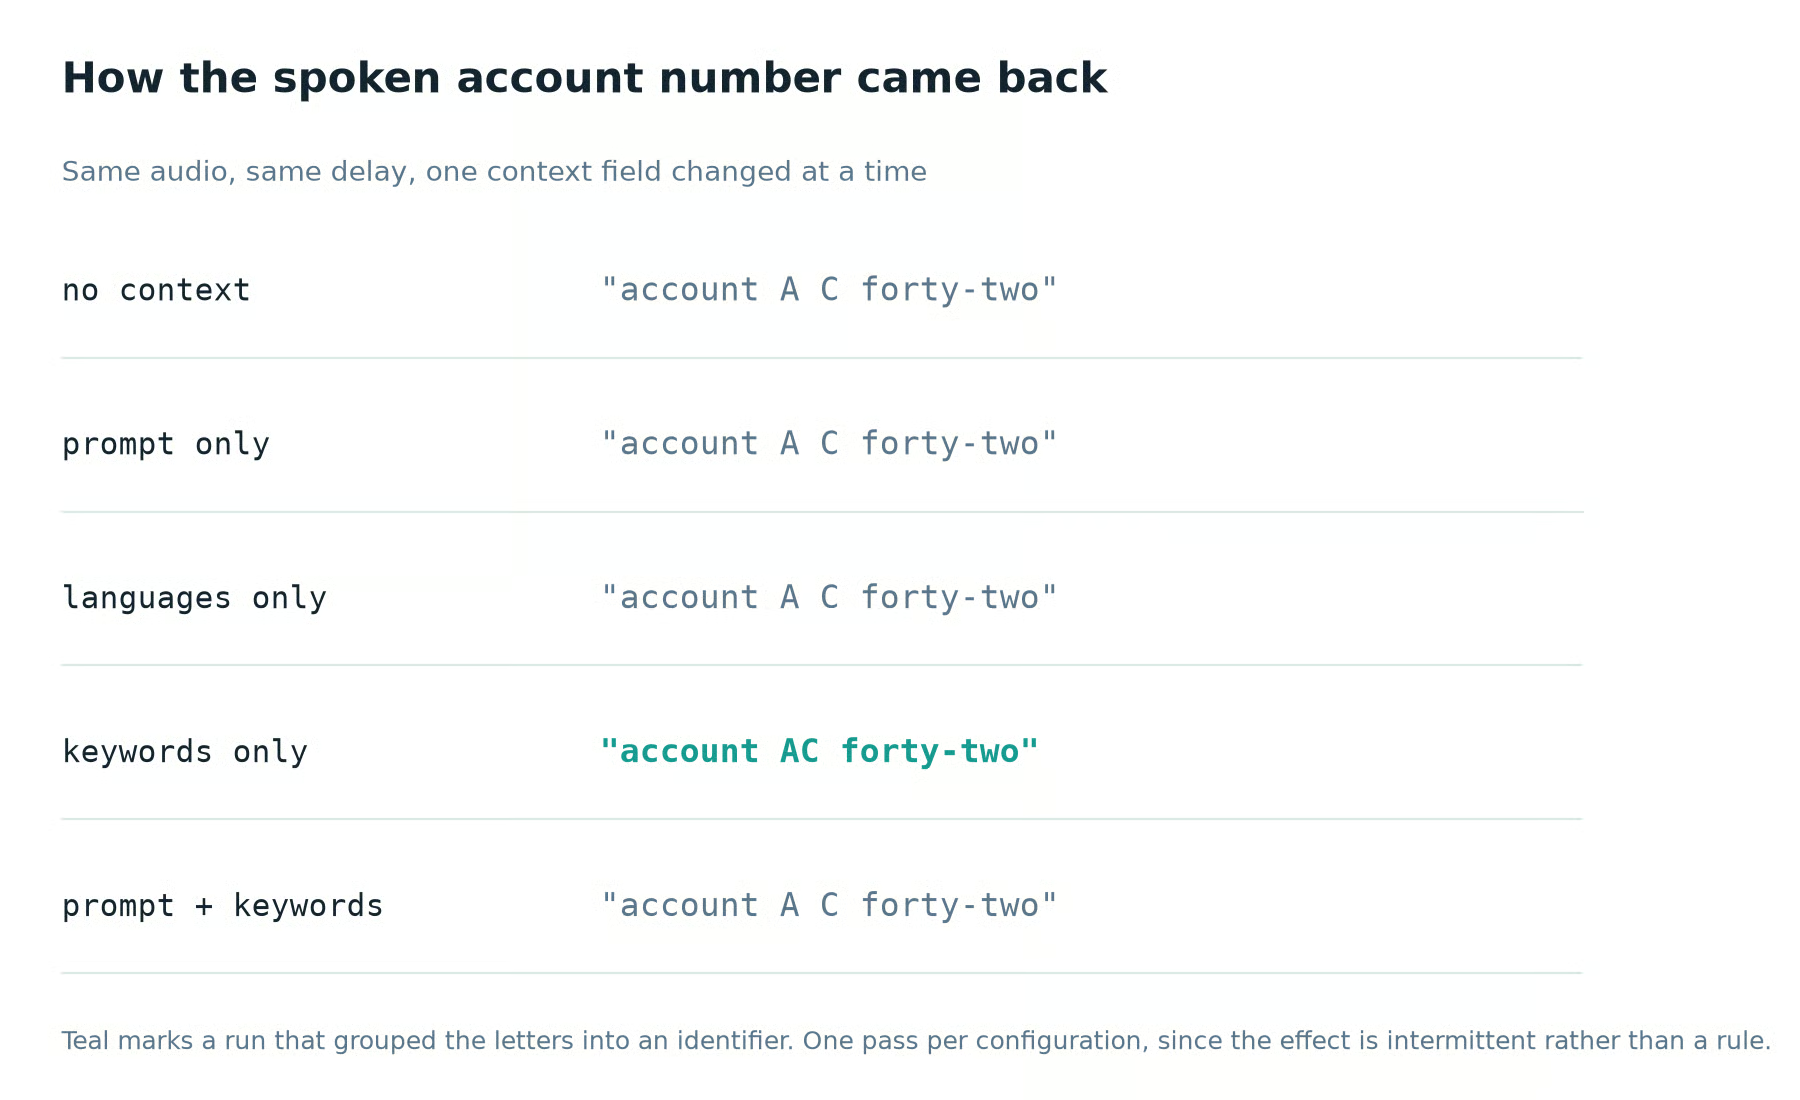
Hanya kata kunci yang mengelompokkan pengenal yang diucapkan. Gambar oleh Penulis.
Petunjuk bahasa membantu lebih jelas, dan pada masalah yang tidak saya duga. Tanpa petunjuk, run pada klip alih kode terus mendengar kata pengisi Arab pembuka, kira-kira "tayyib," sebagai bahasa Inggris "But," dan menyatukan dua sistem tulisan menjadi satu kata yang rusak. Mereka juga mengeja "billing statement" secara fonetis dalam aksara Arab pada beberapa run dan membiarkannya dalam Latin pada run lain. Menambahkan languages: ["ar", "en"] menghapus kata rusak itu di setiap run. Namun itu satu klip, dan kalimat yang berganti bahasa di tengah adalah tempat termudah bagi petunjuk untuk tampak.
delay memiliki lima nilai: minimal, low, medium, high, dan xhigh. Pengaturan lebih rendah dapat menghasilkan teks parsial lebih cepat. Pengaturan lebih tinggi memberi model lebih banyak konteks audio sebelum memutuskan teks, yang dapat meningkatkan akurasi pada audio yang lebih sulit. OpenAI tegas bahwa waktu persis bervariasi menurut konfigurasi dan harus dibenchmark dengan audio representatif, jadi itulah yang dilakukan Tes 3.
test3_delay_benchmark.py melakukan streaming berkas WAV yang sama melalui kelima level, beberapa run masing-masing, mencatat waktu dari awal stream ke delta pertama dan ke transkrip final. Menjaga audio, field konteks, dan strategi commit tetap identik adalah yang membuat perbandingan ini bermakna.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Angka-angka ini tidak universal. Milik saya berasal dari tiga run per level pada satu klip, satu jaringan, satu sore. Median waktu ke parsial pertama berkisar dari 0,70 detik pada minimal hingga 2,91 detik pada xhigh, naik bertahap melalui low (1,19 dtk), medium (1,39 dtk), dan high (2,09 dtk). Tiga run pada tiap level mendarat dalam selisih sekitar seperlima detik satu sama lain, jadi pengurutannya stabil meski angkanya milik saya, bukan milik Anda.
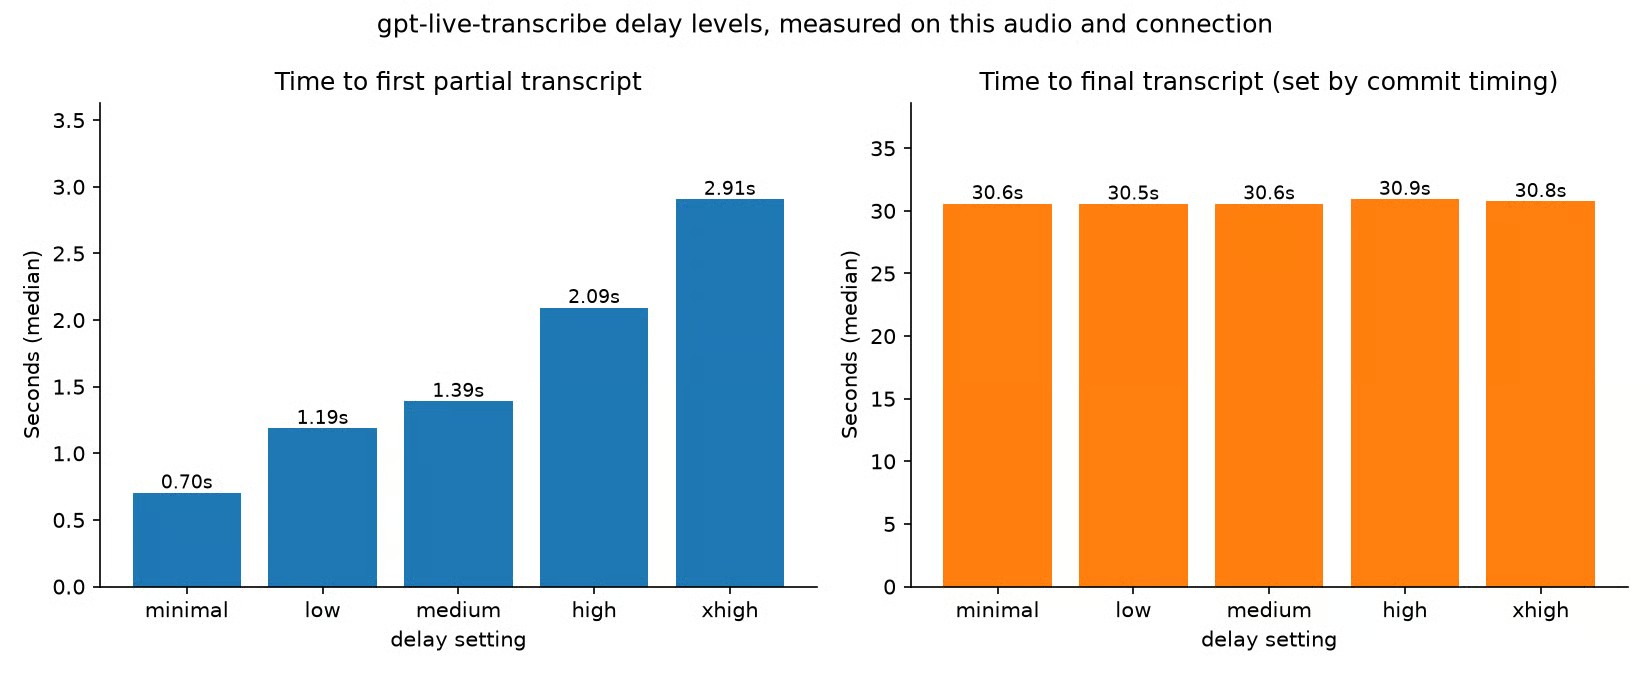
Level jeda menukar kecepatan dengan akurasi. Gambar oleh Penulis.
Yang tidak bisa saya konfirmasi adalah asumsi umum bahwa jeda lebih tinggi berarti lebih sedikit revisi. Jumlah delta berkisar antara 84 dan 86 di setiap level, cukup identik sehingga tidak terlihat tren. Waktu ke final tetap dalam setengah detik dari 30,6 detik di mana-mana juga, tetapi itu mencerminkan waktu commit saya, bukan model. Itulah mengapa grafik memisahkan dua pengukuran ke dalam panel: pada satu sumbu, rentang dua detik menghilang di bawah batang yang sepuluh kali lebih tinggi.
Untuk takarir langsung yang dibaca seseorang saat orang lain berbicara, mulai dari low. Menunggu dua detik sebelum teks muncul terasa rusak dengan cara yang tidak terjadi pada takarir yang dikoreksi sesaat kemudian. Untuk catatan rapat yang tidak dibaca sampai nanti, high atau xhigh hampir tidak ada biayanya. Untuk perintah suara, condonglah ke medium, karena satu kata yang salah dalam perintah dua kata lebih berdampak dari biasanya.
Semua tes sejauh ini menggunakan turn_detection: null dan commit manual. Realtime API menawarkan deteksi aktivitas suara sebagai alternatif, jadi saya menyambungkannya ke gpt-live-transcribe alih-alih berasumsi akan berfungsi. Saya hampir menghapus bagian ini ketika tes gagal. Lalu ternyata kegagalan itu justru temuannya.
server_vad memecah audio pada periode hening, dapat dikonfigurasi melalui threshold, prefix_padding_ms, dan silence_duration_ms. semantic_vad menggunakan pengklasifikasi yang memperkirakan apakah pembicara terdengar sudah selesai, dengan pengaturan eagerness yang mengontrol seberapa cepat ia memutuskan:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Begitulah cara kedua mode didokumentasikan untuk Realtime API secara umum. Dikirim ke sesi gpt-live-transcribe, payload yang persis sama kembali ditolak:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad menghasilkan kesalahan identik. Per 4 Agustus 2026, commit manual adalah satu-satunya mode deteksi giliran yang diterima gpt-live-transcribe, meskipun panduan transkripsi masih menyuruh Anda mengonfigurasi deteksi aktivitas suara agar server mengomitikannya untuk Anda. Uji ulang sebelum membangun di atasnya, karena OpenAI bisa saja menyalakan VAD untuk model ini nanti tanpa memberi tahu siapa pun.
Tekan-untuk-bicara adalah kasus mudah, karena tekan dan lepasnya sudah menandai batas. Selain itu membuat klien memutuskan kapan giliran berakhir, dan dua upaya pertama saya sama-sama salah.
Upaya pertama melindungi commit dengan if not mic_queue.empty(), yang terdengar masuk akal dan tidak pernah terjadi: coroutine yang menguras antrean itu mengosongkannya secepat mikrofon mengisinya. Takarir parsial tetap mengalir, yang membuatnya meyakinkan, tetapi tidak ada yang pernah difinalkan. Upaya kedua mengomit setiap empat detik selama audio telah ditambahkan. Terhadap mikrofon nyata itu menghasilkan ini:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Dua kegagalan sekaligus. Timer memotong kalimat di tengah kata, dan model membaca fragmen yang dimulai entah dari mana sebagai "Abort." Lalu ia mengomit saat saya tidak berbicara dan mengembalikan transkrip kosong, karena mikrofon melakukan streaming potongan apakah ada yang berbicara atau tidak.
Keduanya berasal dari informasi yang hilang sama: energi audio. SpeechGate di mic_stream.py melacak amplitudo RMS tiap potongan dan mengomit setelah pembicara mengatakan sesuatu lalu hening, dengan batas agar bicara terus-menerus tetap berakhir di suatu titik. Versi pertama saya membandingkan amplitudo itu dengan angka tetap, yang berfungsi di satu mesin dan salah lima kali lipat di mesin berikutnya, jadi kini ia memperkirakan ruangan lalu menghitung apa pun yang beberapa kali lebih keras sebagai ucapan. Giliran yang berakhir pada audio yang nyaris tidak ada, batuk atau pintu, masuk ke input_audio_buffer.clear alih-alih commit, karena menanyakan ke model apa yang dikatakan sebuah pintu adalah cara mendapat kata yang dibuat-buat.
app.py menggabungkan seluruh bagian tutorial ini menjadi satu aplikasi terminal: penangkapan mikrofon, takarir parsial langsung, riwayat transkrip yang dikunci oleh item_id, dan flag CLI untuk setiap field yang diterima sesi.
python app.py --delay low --keywords "AC-42,premium plan" --languages enSebutkan hanya bahasa yang benar-benar Anda pakai. Perintah yang sama dengan en,ar pada ucapan bahasa Inggris mengembalikan kata "delta" yang ditransliterasi ke aksara Arab, yang merupakan temuan Tes 2 yang berjalan sebaliknya.
--turn-detection bawaan adalah manual, dan --silence-hold serta --max-turn menyetel gerbang dari bagian sebelumnya. Mode VAD tetap sebagai flag jika API mulai menerimanya; oper salah satu dan aplikasi akan mencetak penolakan server alih-alih menggantung diam-diam.
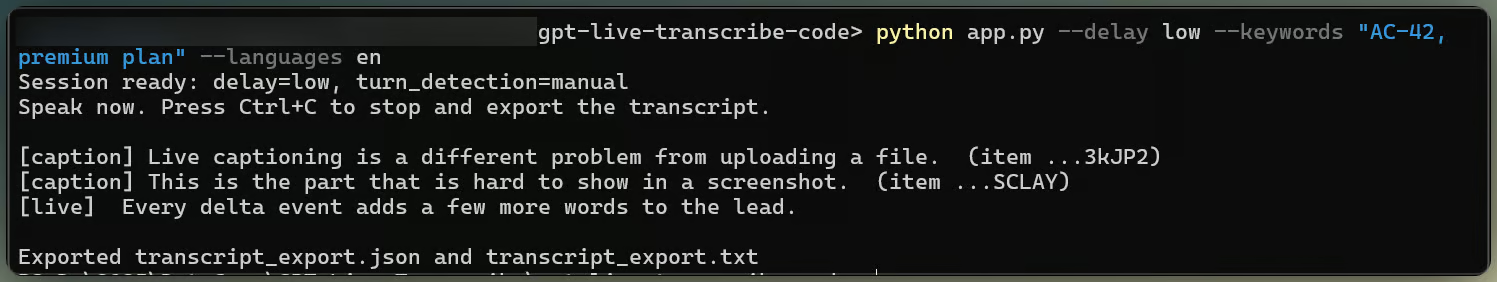
Aplikasi takarir lengkap berjalan dengan pengaturan. Gambar oleh Penulis.
Saat keluar, aplikasi menulis transkrip teks polos dan berkas JSON dengan konfigurasi yang digunakan, waktu-ke-delta-pertama yang diukur lokal, dan setiap giliran final dengan item_id-nya. Saya menambahkan ekspor itu setelah kehilangan run uji yang bagus karena terminal ditutup. Cap waktu di dalamnya berada di sisi klien, jadi jangan salah mengira instrumentasi Anda sendiri sebagai angka OpenAI.
Ketiga tes juga dapat dijalankan di browser. demo_app.py adalah versi Streamlit dengan satu tab per eksperimen, dipertahankan sebagai demo alih-alih jalur utama pembelajaran, karena skrip terminal menampilkan event mentah lebih langsung.
streamlit run demo_app.pyBelajar bersama DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt