Cursus
Werken met de OpenAI API
3 Hr
172.6K
Een afgerond audiobestand uploaden naar een transcriptie-endpoint is de makkelijke variant van dit probleem. Je wacht tot het hele bestand binnen is en krijgt dan één transcript terug. Niemand staart naar een scherm terwijl het model werkt. Live ondertiteling is een andere klus: audio blijft binnenkomen terwijl je nog beslist wat je met wat je al hebt doet, en de tekst moet zich bijwerken terwijl de spreker nog praat.
Dat is precies de kloof die gpt-live-transcribe vult. OpenAI bracht het uit op 28 juli 2026, samen met een batch-tegenhanger, gpt-transcribe. In deze tutorial bouw ik er een Python-ondertitelingsclient omheen en draai ik drie tests: een basis streamingclient, een vergelijking van de context-hints die het accepteert, en een benchmark van de vijf vertraging-instellingen. Ik testte met helder Engels, technische woordenschat en Egyptisch Arabisch-Engelse code-switching, omdat dat dichter bij een echte meeting ligt dan één schone verteller.
Aan het eind heb je een werkende ondertitelingsapp, een idee welke contextinstellingen echt helpen, en een vertraging-instelling die je kunt verdedigen in plaats van te gokken.
gpt-live-transcribe is een streaming spraak-naar-tekstmodel voor toepassingen die transcriptietekst nodig hebben terwijl audio nog binnenkomt. Het neemt audio in en geeft tekst terug, niets meer, afgestemd via vier velden: delay voor latentie, prompt voor vrije context, keywords voor letterlijke termen, en languages voor verwachte invoertalen. Op OpenAI's Context Aware ASR-benchmark verhoogde vrije context de semantische nauwkeurigheid van 38,5 procent naar 44,6 procent, en daarom bestaat Test 2.
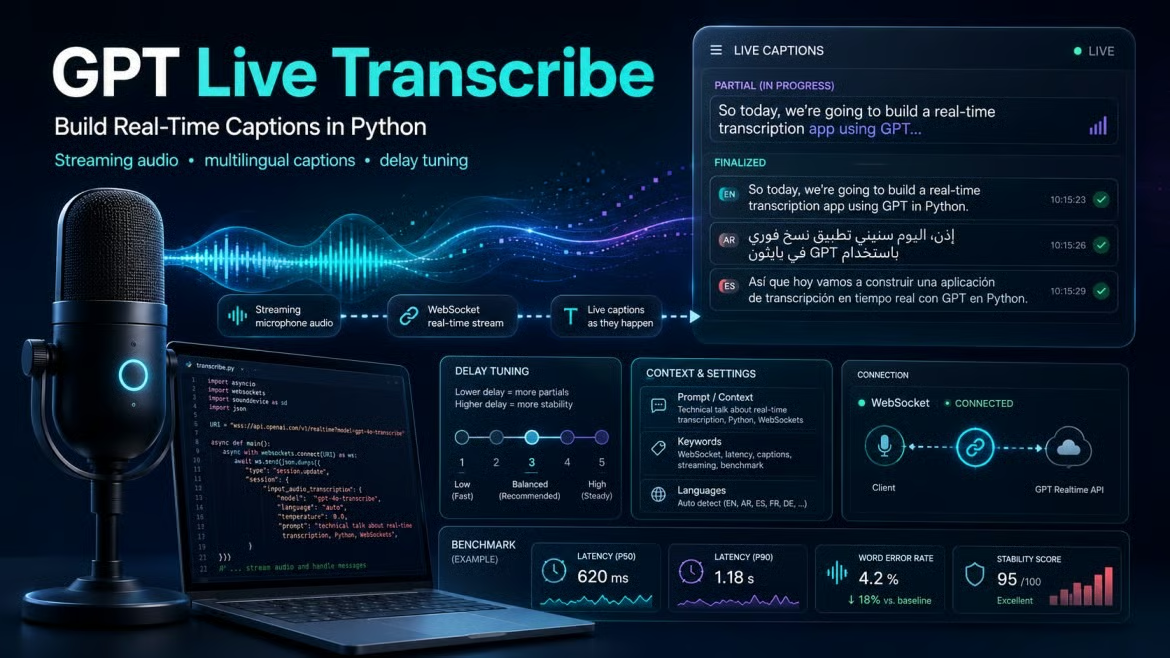
Het model draait binnen de Realtime API, niet als een apart endpoint, en het staat los van GPT-Live, OpenAI's voicesysteem, wat de namen ook suggereren. Je opent een transcriptiesessie, configureert die, en de server streamt events terug over de verbinding waarover je audio stuurt. Dan blijft eerst één vraag over: welk van de twee transcriptiemodellen je eigenlijk nodig hebt.
OpenAI levert twee aanbevolen transcriptiemodellen, en die zijn niet inwisselbaar. gpt-live-transcribe is voor continu binnenkomende audio, een microfoon, een telefoongesprek, een mediastroom, waarbij je gedeeltelijke tekst nodig hebt voordat de spreker klaar is. gpt-transcribe is voor afgeronde opnames, of een Realtime-sessie waarin je bewust wacht op een afgeronde beurt. De documentatie noemt dat tweede geval een gespecialiseerde workflow, niet een manier om live deltas te krijgen.
Eén verschil zorgt vaak voor verwarring: gpt-transcribe retourneert een languages array met de gedetecteerde invoertaal, gpt-live-transcribe niet. Als je logica splitst op gedetecteerde taal, pak je het verkeerde model, hoe goed de ondertitels er in een demo ook uitzien. De prijs volgt dezelfde scheidslijn, grofweg vier tegen één in het voordeel van het batchmodel, waar ik later op terugkom.
Dit vertel ik je liever nu dan nadat je al een halve app eromheen hebt gebouwd. Er zijn geen woordniveautijdstempels, geen sprekerlabels, geen betrouwbaarheidscores en geen diarization. Als je ondertiteltiming nodig hebt, notities die zeggen wie er sprak, of een betrouwbaarheidsdrempel, verwijst OpenAI's gids naar gpt-4o-transcribe-diarize of whisper-1.
Elk script in deze tutorial staat op github.com/KhalidAbdelaty/gpt-live-transcribe, dus begin met clonen. Je hebt Python 3.10 of nieuwer nodig en een API-sleutel met Realtime-toegang. De scripts zelf leunen op vier pakketten: websockets voor de verbinding, sounddevice voor microfoonopname, numpy voor de bufferconversie, en python-dotenv voor het laden van de sleutel. Het requirements-bestand voegt er nog een paar toe voor de grafieken en de browserdemo.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Op macOS heeft sounddevice PortAudio op OS-niveau nodig (brew install portaudio); op Linux is het apt-get install portaudio19-dev. Sla die regel over als je op Windows zit. Ik liep zelf tegen de macOS-stap aan, en de fix is echt die ene installatie.
De audio zelf moet binnenkomen als 16-bit PCM op 24 kHz, mono, little-endian, base64-gecodeerd. Stuur een MP3 of een stereo WAV en je krijgt wartaal terug of een gesloten verbinding, nooit een melding dat het formaat fout was. Dat kost je zo een middag. Dus de volgende vraag is: over welke verbinding gaat de audio.
De richtlijn van OpenAI is helder: WebSocket voor server-naar-servertoepassingen, WebRTC voor browser- en mobiele clients. Deze tutorial bouwt een Python-backend dat een lokale microfoon leest, dus WebSocket is de juiste keuze, en een standaard API-sleutel volstaat omdat die je server niet verlaat.
Een sessie start met een session.update-event dat type: "transcription" zet en gpt-live-transcribe als model kiest. Al het andere in de payload beschrijft de audio die je gaat sturen. Dit is de minimale configuratie, uit de Realtime transcriptiegids:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None schakelt automatische voice activity detection uit, dus er wordt niets afgerond tot je expliciet commit. Drie clientevents doen vervolgens het werk: input_audio_buffer.append stuurt een base64-audiochunk, input_audio_buffer.commit beëindigt een beurt, en de server antwoordt met conversation.item.input_audio_transcription.delta (gedeeltelijke tekst) en conversation.item.input_audio_transcription.completed (definitieve tekst). Ik maak verbinding met wss://api.openai.com/v1/realtime?intent=transcription, een patroon uit OpenAI's cookbook; de gids documenteert die querystring niet, dus laat hem weg als hij ooit niet meer werkt.
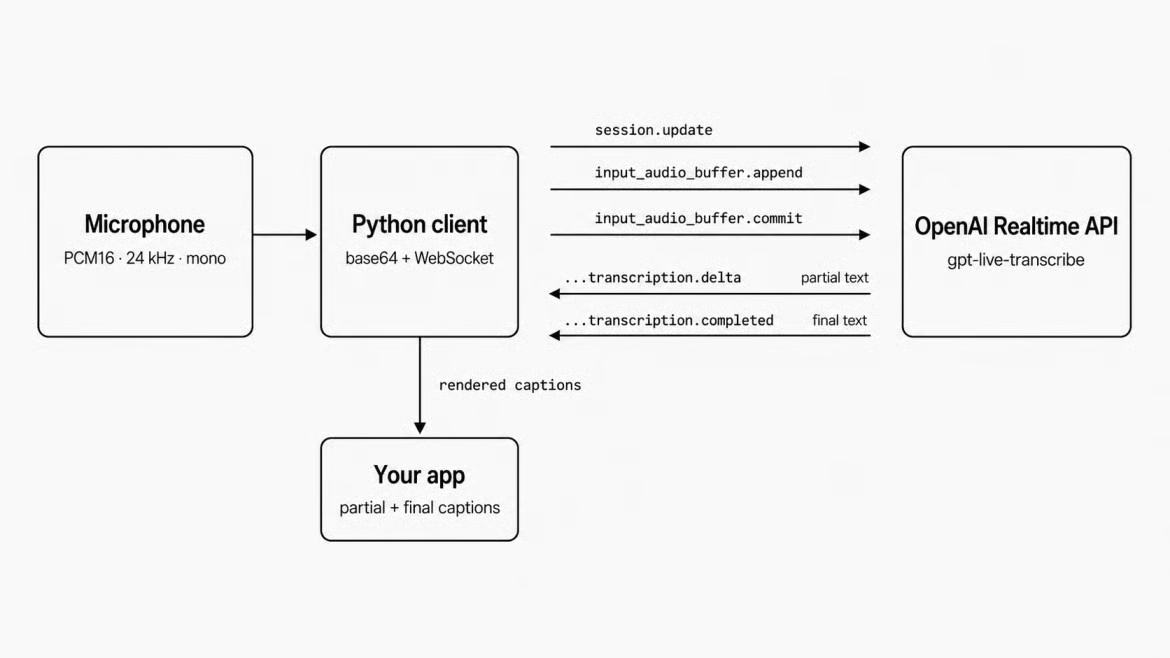
Diagram van de eventflow van een Realtime-transcriptiesessie. Afbeelding door de auteur.
Test 1 is de kleinste werkende variant: microfoonaudio vastleggen, streamen, gedeeltelijke en definitieve tekst afdrukken zodra die binnenkomt. Geen context, geen trefwoorden, niets afgesteld, zodat de eventflow zichtbaar blijft. Het eerste probleem is audio van de microfoondraad krijgen zonder die te blokkeren.
sounddevice draait zijn callback op een eigen thread met een paar milliseconden om terug te keren voordat de driver frames dropt, dus het kan niet wachten op een netwerkcall. De enige taak is de float32-buffer omzetten naar PCM16 en die op een asyncio.Queue te zetten via loop.call_soon_threadsafe, terwijl een aparte coroutine die queue leegt en elke chunk verstuurt.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Een chunk van 100 milliseconden (2.400 samples op 24 kHz) is een redelijk startpunt. Ga kleiner en je voegt overhead per bericht toe, ga veel groter en ondertitels voelen traag. Er is geen gedocumenteerd juist getal, dus behandel het als een draaiknop.
Deltas zijn goedkoop en frequent. Elke bevat een stukje tekst gekoppeld aan een item_id. Voeg het toe aan de gedeeltelijke tekst die je al voor dat item hebt, en de ondertitel groeit woord voor woord op het scherm:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Een completed-event vervangt die partial door het afgeronde transcript voor hetzelfde item. Behandel completed als de bron van waarheid en deltas als een preview, niet als iets dat je zelf concateneert.
Hier zit het detail dat je UI breekt als je het overslaat: in de gids van OpenAI staat dat de volgorde tussen completion-events van verschillende beurten niet is gegarandeerd. Een completed-event voor een eerdere beurt kan binnenkomen na een voor een latere beurt, dus code die ervan uitgaat dat de nieuwste completed bij de nieuwste beurt hoort, zal af en toe terugspringen of een regel dubbel tonen. Key alles in plaats daarvan op item_id, wat mijn klasse TranscriptState doet.
Bij het bouwen ervan ving ik twee bugs, beide over welke dictionary de code controleerde. item_id alleen toevoegen aan de volgordelijst in de delta-handler liet full_transcript() leeg voor elke ontvanger die alleen completed-events verwerkt. De partials-dictionary gebruiken om te beslissen of een item nieuw was, was erger: apply_completed() leegt die entry, dus een late delta leek gloednieuw, kwam een tweede keer op de volgordelijst en drukte de afgeronde beurt twee keer af. Houd item_id bij in beide handlers, en controleer de volgordelijst in plaats daarvan.
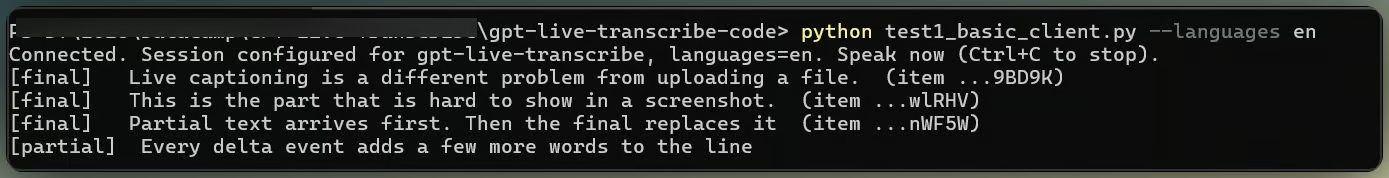
Live gedeeltelijke ondertitels die finaliseren tot transcript. Afbeelding door de auteur.
Tegen helder Engels verscheen tekst binnen een seconde of twee en kwam overeen met wat ik zei, inclusief interpunctie. Via een laptopmicrofoon zonder ingestelde context kwam een woord waar het model over twijfelde soms echter terug in een heel ander schrift. languages is het veld daarvoor, en daar gaat Test 2 achteraan.
Het model accepteert drie soorten context, en het loont om daar precies in te zijn voordat je test. prompt is vrije tekst die de setting beschrijft, keywords zijn letterlijke termen die in de audio kunnen voorkomen, en languages somt verwachte invoertalen op als ISO 639-1-codes zoals en of ar. Geen van die velden forceert een output. Een trefwoord dat nooit is uitgesproken, verschijnt niet alleen omdat je het hebt opgegeven, en de enige manier om te leren wat deze velden echt doen, is er één tegelijk veranderen.
Ik liet dezelfde clip door vijf configuraties lopen, drie keer per stuk. Twee regels houden zo'n vergelijking eerlijk: slechts één contextveld verandert tussen runs, en elke configuratie draait meer dan één keer, omdat het model niet deterministisch is op identieke audio.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Mijn eerste versie zette languages alleen op de gecombineerde run, wat de eerste regel brak: er veranderden twee velden tegelijk, dus elk verschil daar kon door beide komen. Eén opmaakregel kostte me ook een afgewezen sessie-update: een trefwoord met <, >, een carriage return of een line feed wijst de hele update af, niet alleen dat trefwoord. TranscriptionConfig.validate_keywords() vangt dat af voordat de payload wordt opgebouwd.
Trefwoorden hielpen op de soort audio die je zou verwachten. Elke run transcribeerde het accountnummer als uitgesproken woorden, omdat dat is wat de audio bevat. De vraag was of het model die woorden groepeerde tot een identificatie, of de letters uitsprak als "A C forty-two".
Over vijftien runs was de scheiding scherp. Niets zonder keywords groepeerde het ooit: no_context, prompt_only en languages_only gaven "A C forty-two" terug op al hun negen passes. Runs met keywords groepeerden het in vijf van de zes, meestal als het volledig geformatteerde "AC-42". Dus keywords verschoof het resultaat en prompt alleen deed dat nooit, in lijn met OpenAI's kadering van keywords als het veld voor letterlijke termen die het model verkeerd kan parsen. Alleen trefwoorden misten nog steeds één keer, dus behandel het als een hint die de kansen sterk verschuift in plaats van een regel die het model volgt.
Dat staat wat ongemakkelijk naast de benchmarkcijfers waarmee ik begon, waar vrije context de semantische nauwkeurigheid met zes punten verhoogde. De twee tests meten verschillende dingen: OpenAI scoorde betekenis over een brede set audio, terwijl ik naar één identificatie in één clip keek. Een prompt kan echt werk doen op de zin en toch het smalle detail dat jij toevallig controleert ongemoeid laten. Het enige teken daarvan hier is dat prompt en keywords samen het elke pass groepeerden, terwijl keywords alleen er één miste, een verschil van één run.
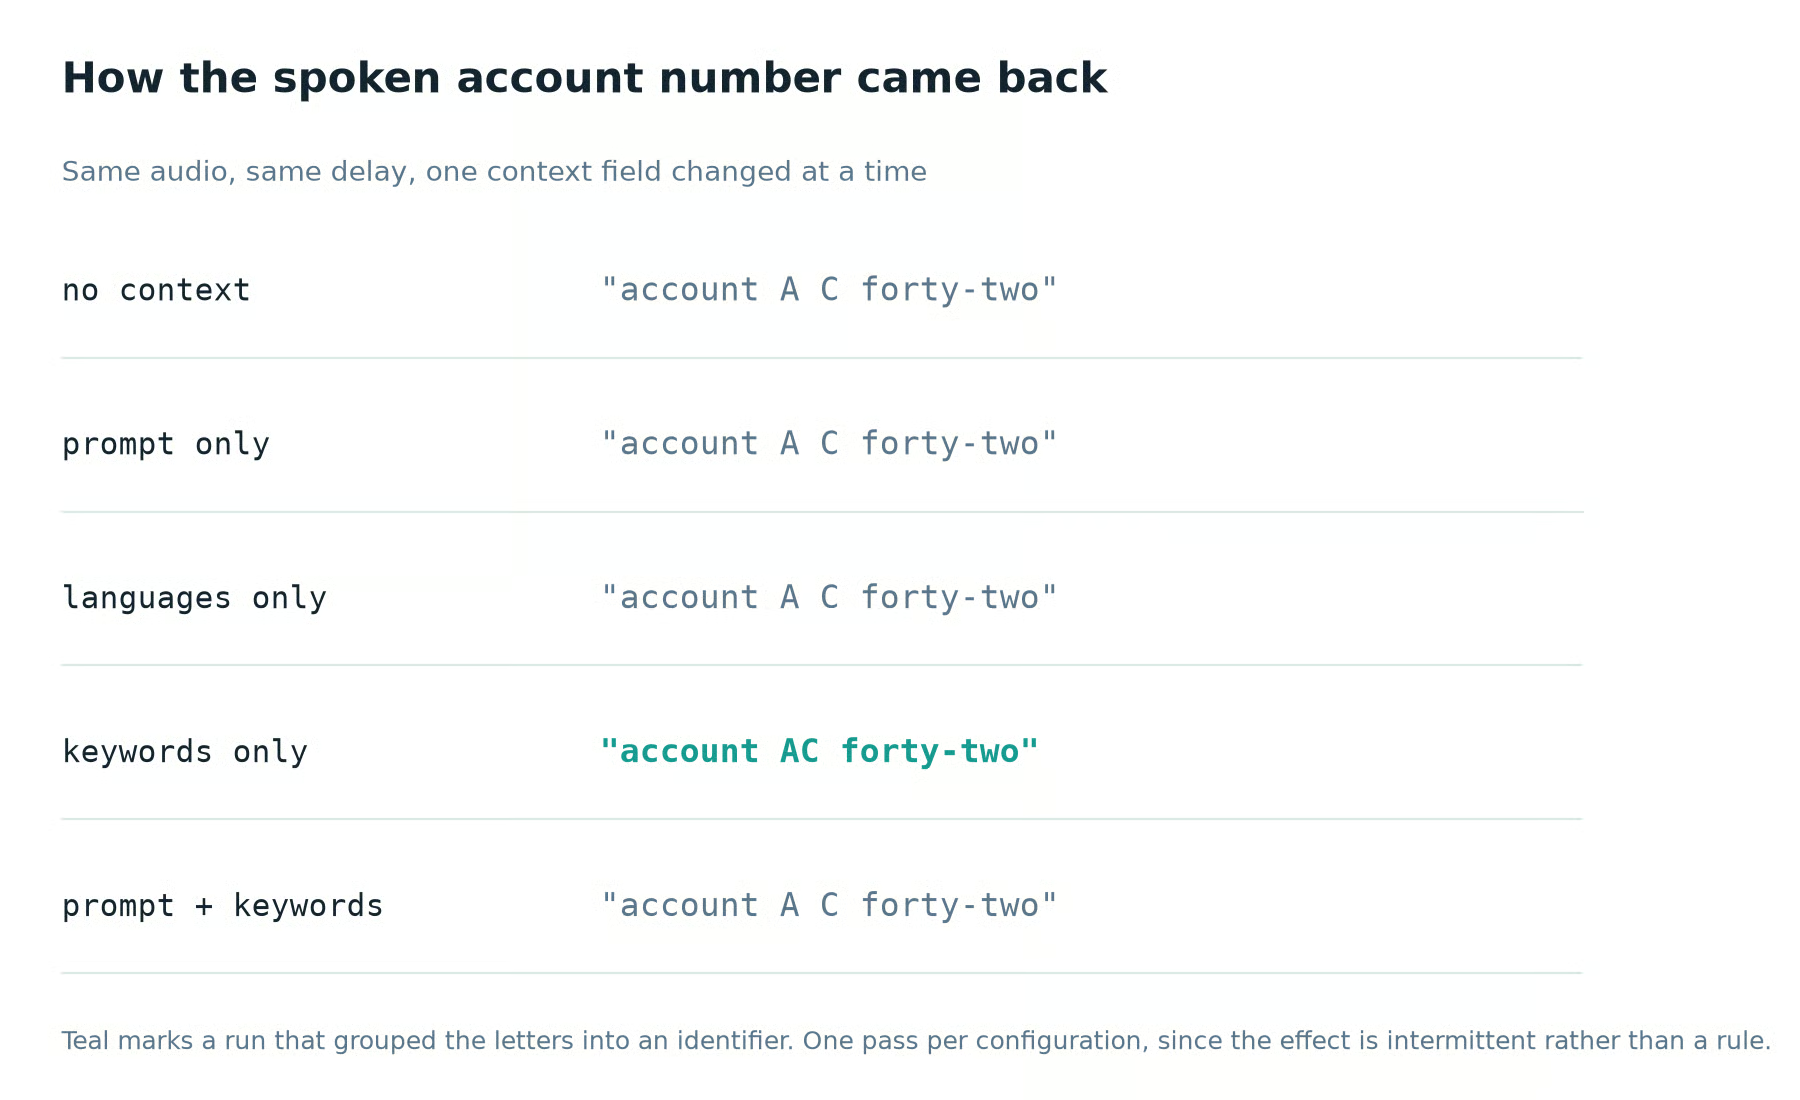
Alleen trefwoorden groepeerden de uitgesproken identificatie. Afbeelding door de auteur.
Taalhints hielpen duidelijker, en op een probleem dat ik niet verwachtte. Zonder hint hoorde de code-switchingclip het openings-Arabische stopwoord, grofweg "tayyib", steeds als het Engelse "But," en versmolt de twee schriftsystemen tot één gebroken woord. Ook spelden ze "billing statement" fonetisch uit in Arabisch schrift in sommige passes en lieten het in Latijn in andere. languages: ["ar", "en"] toevoegen verwijderde het gebroken woord in elke pass. Dat is één clip, en een zin die halverwege van taal wisselt is de plek waar een hint het makkelijkst zichtbaar wordt.
delay kent vijf waarden: minimal, low, medium, high en xhigh. Lagere instellingen kunnen sneller gedeeltelijke tekst opleveren. Hogere instellingen geven het model meer audiocontext voordat het tekst vastlegt, wat de nauwkeurigheid op lastigere audio kan verbeteren. OpenAI is duidelijk dat exacte timing per configuratie verschilt en gebenchmarkt moet worden met representatieve audio, en dat is wat Test 3 doet.
test3_delay_benchmark.py streamt hetzelfde WAV-bestand door alle vijf niveaus, meerdere runs elk, en logt de tijd van streamstart tot de eerste delta en tot het definitieve transcript. Audio, contextvelden en commitstrategie identiek houden is wat de vergelijking betekenis geeft.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Deze cijfers zijn niet universeel. De mijne kwamen uit drie runs per niveau op één clip, één netwerk, één middag. De mediaan tijd tot de eerste partial liep van 0,70 seconden bij minimal tot 2,91 seconden bij xhigh, in gelijke stappen oplopend via low (1,19 s), medium (1,39 s), en high (2,09 s). De drie runs per niveau landden binnen ongeveer een vijfde seconde van elkaar, dus de volgorde is stabiel ook als de getallen de mijne zijn en niet de jouwe.
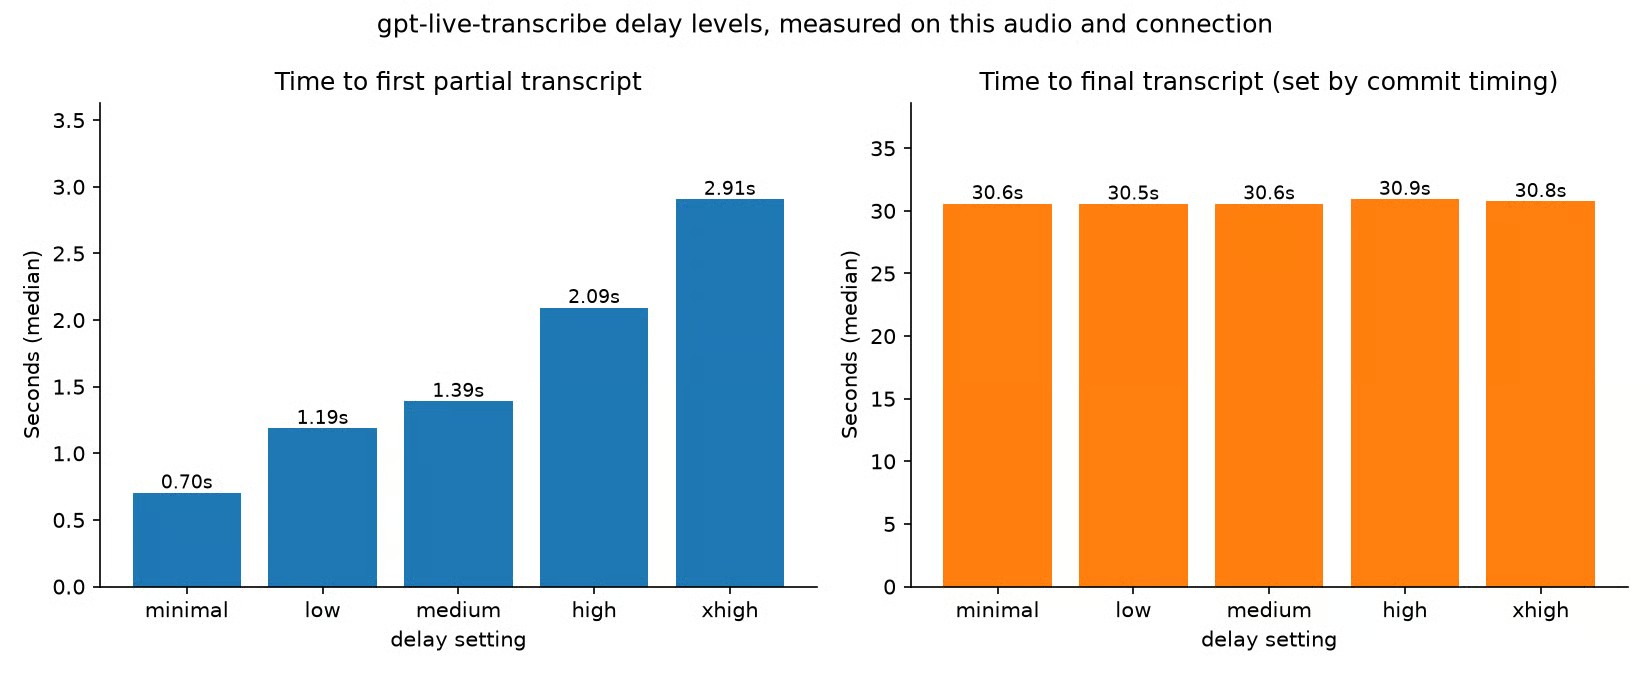
Vertragingniveaus ruilen snelheid voor nauwkeurigheid. Afbeelding door de auteur.
Wat ik niet kon bevestigen, was de gebruikelijke aanname dat hogere vertraging minder herzieningen betekent. Delta-aantallen lagen tussen 84 en 86 op elk niveau, dicht genoeg bij identiek dat geen trend zichtbaar is. Tijd tot definitief bleef overal binnen een halve seconde van 30,6 seconden, maar dat weerspiegelt mijn commit-timing, niet het model. Daarom splitst de grafiek de twee metingen in panelen: op één as verdwijnt een spreiding van twee seconden onder balken die tien keer zo hoog zijn.
Voor live ondertitels die iemand leest terwijl er gesproken wordt, begin bij low. Twee seconden wachten voordat er tekst verschijnt voelt stuk op een manier die een ondertitel die een moment later is gecorrigeerd niet doet. Voor notulen die niemand tot later leest, kost high of xhigh bijna niets. Voor spraakcommando's neig je naar medium, omdat een verkeerd woord in een tweewoordcommando zwaarder weegt dan normaal.
Elke test tot nu toe gebruikte turn_detection: null en een handmatige commit. De Realtime API biedt voice activity detection als alternatief, dus ik heb het aangesloten op gpt-live-transcribe in plaats van aan te nemen dat het zou werken. Ik stond op het punt deze sectie te schrappen toen de test faalde. Daarna bleek de mislukking juist de bevinding te zijn.
server_vad hakt audio in stukken op stiltes, instelbaar via threshold, prefix_padding_ms en silence_duration_ms. semantic_vad gebruikt een classifier die inschat of de spreker klaar klinkt, met een eagerness-instelling die bepaalt hoe snel het beslist:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Zo zijn beide modi gedocumenteerd voor de Realtime API in het algemeen. Naar een gpt-live-transcribe-sessie gestuurd, komt precies die payload afgewezen terug:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad gaf dezelfde fout. Per 4 augustus 2026 is handmatig committen de enige beurtdetectiemodus die gpt-live-transcribe accepteert, ook al zegt de transcriptiegids nog steeds dat je voice activity detection moet configureren zodat de server beurten voor je commit. Test opnieuw voordat je eromheen bouwt, want OpenAI kan VAD later voor dit model inschakelen zonder iemand iets te vertellen.
Push-to-talk is het makkelijke geval, omdat de druk en loslaat de grenzen al markeren. Al het andere laat de client beslissen wanneer een beurt eindigde, en mijn eerste twee pogingen zaten er allebei naast.
Poging één beschermde de commit met if not mic_queue.empty(), wat logisch leest en nooit afgaat: de coroutine die die queue leegt, maakt hem net zo snel leeg als de microfoon hem vult. Gedeeltelijke ondertitels stroomden nog steeds binnen, wat het overtuigend maakte, maar niets werd ooit afgerond. Poging twee committe elke vier seconden zolang er audio was toegevoegd. Tegen een echte microfoon leverde dat dit op:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Twee fouten tegelijk. De timer sneed de zin midden in een woord af, en het model las een fragment dat nergens begint als "Abort." Vervolgens committe het terwijl ik niet sprak en gaf een leeg transcript terug, omdat een microfoon chunks streamt, of er nu iemand praat of niet.
Beide komen voort uit dezelfde ontbrekende informatie: audio-energie. SpeechGate in mic_stream.py volgt de RMS-amplitude van elke chunk en commit zodra de spreker iets gezegd heeft en daarna stil is, met een limiet zodat doorlopend praten toch ergens eindigt. Mijn eerste versie vergeleek die amplitude met een vaste waarde, wat op de ene machine werkte en op de volgende er vijf keer naast zat, dus schat hij nu de ruimte in en telt alles dat meerdere keren harder is als spraak. Een beurt die eindigt op bijna geen audio, een kuch of een deur, gaat naar input_audio_buffer.clear in plaats van een commit, want vragen wat een deur zei is hoe je een verzonnen woord krijgt.
app.py trekt elk onderdeel van deze tutorial samen in één terminalapplicatie: microfoonopname, live partials, een transcripthistorie ge-keyed op item_id, en CLI-flags voor elk veld dat de sessie accepteert.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNoem alleen de talen die je daadwerkelijk spreekt. Datzelfde commando met en,ar op Engelse spraak gaf het woord "delta" getranslitereerd in Arabisch schrift terug, wat de bevinding uit Test 2 is maar dan de andere kant op.
--turn-detection staat standaard op manual, en --silence-hold en --max-turn stemmen de gate uit de vorige sectie af. De VAD-modi blijven als flags voor het geval de API ze begint te accepteren; geef er een door en de app print de afwijzing van de server in plaats van stil te blijven hangen.
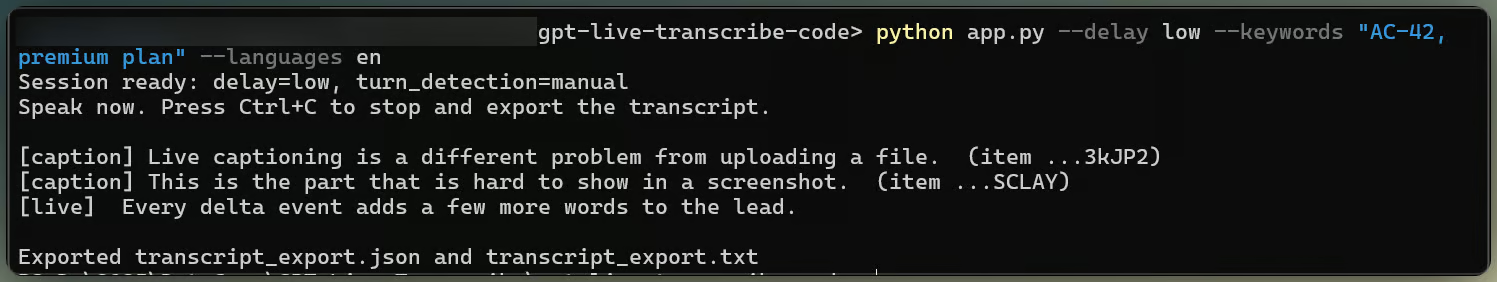
Complete ondertitelingsapp draait met instellingen. Afbeelding door de auteur.
Bij afsluiten schrijft hij een platte-teksttranscript en een JSON-bestand met de gebruikte configuratie, een lokaal gemeten time-to-first-delta en elke afgeronde beurt met zijn item_id. Ik heb die export toegevoegd nadat ik een goede testrun kwijtraakte door een gesloten terminal. De timestamps daarin zijn client-side, dus verwar je eigen instrumentatie niet met een OpenAI-cijfer.
Alle drie tests draaien ook in een browser. demo_app.py is een Streamlit-versie met één tab per experiment, bewaard als demo in plaats van het hoofdpad voor uitleg, omdat de terminalscripts de ruwe events directer laten zien.
streamlit run demo_app.pyLeer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min