course
Arbeta med OpenAI API
3 timmar
172.6K
Att ladda upp en färdig ljudfil till ett transkriptions-endpoint är den enkla varianten av det här problemet. Du väntar in hela filen och får sedan ett transkript tillbaka. Ingen stirrar på en skärm medan modellen jobbar. Livetextning är ett annat jobb: ljud fortsätter komma in medan du fortfarande bestämmer vad du ska göra med det du har, och texten måste uppdateras medan talaren fortfarande pratar.
Det är det gapet gpt-live-transcribe fyller. OpenAI släppte det den 28 juli 2026 tillsammans med en batch-motsvarighet, gpt-transcribe. I den här handledningen bygger jag en Python-klient för textning runt den och kör tre tester: en grundläggande strömmingsklient, en jämförelse av de kontexthintar den accepterar och ett benchmark av dess fem fördröjningsinställningar. Jag testade med ren engelska, tekniskt ordförråd och egyptisk arabisk-engelsk kodväxling, eftersom det ligger närmare ett riktigt möte än en ren uppläsare.
I slutet har du en fungerande textningsapp, en känsla för vilka kontextinställningar som faktiskt hjälper och en fördröjningsinställning du kan försvara istället för att gissa.
gpt-live-transcribe är en strömmande tal-till-text-modell för applikationer som behöver transkriberad text medan ljud fortfarande anländer. Den tar in ljud och returnerar text, inget annat, justerbar via fyra fält: delay för latens, prompt för fri text-kontekst, keywords för ordagrant återgivna termer och languages för förväntade inmatningsspråk. På OpenAI:s Context Aware ASR-benchmark höjde fri text-kontekst den semantiska träffsäkerheten från 38,5 procent till 44,6 procent, vilket är varför Test 2 finns.
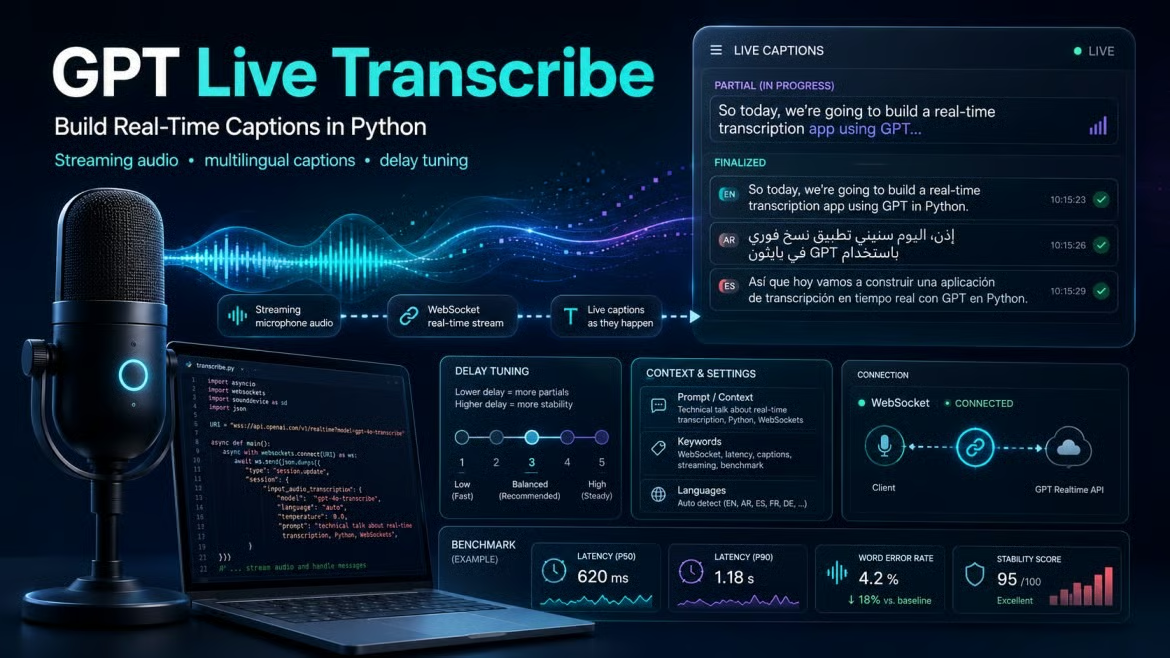
Modellen körs i Realtime API, inte som ett separat endpoint, och den är inte relaterad till GPT-Live, OpenAI:s röstsystem, oavsett vad namnen antyder. Du öppnar en transkriptionssession, konfigurerar den och servern strömmar tillbaka händelser över samma anslutning som du skickar ljud på. Det lämnar en fråga att avgöra först: vilken av de två transkriptionsmodellerna du faktiskt behöver.
OpenAI levererar två rekommenderade transkriptionsmodeller, och de är inte utbytbara. gpt-live-transcribe är för kontinuerligt ankommande ljud, en mikrofon, ett telefonsamtal, en mediaström, där du behöver partiell text innan talaren är klar. gpt-transcribe är för färdiga inspelningar, eller en Realtime-session där du avsiktligt väntar in en bekräftad tur. Dokumentationen kallar det senare för ett specialiserat arbetsflöde, inte ett sätt att få live-deltan.
En skillnad ställer till det: gpt-transcribe returnerar en languages-array med detekterat inmatningsspråk, gpt-live-transcribe gör det inte. Om din logik förgrenar sig på upptäckt språk använder du fel modell, oavsett hur bra dess undertexter ser ut i en demo. Prissättningen följer samma linje, ungefär fyra mot ett till batchmodellens fördel, vilket jag återkommer till senare.
Jag säger hellre detta nu än efter att du byggt halva appen runt den. Det finns inga tidsstämplar på ordnivå, inga talaretiketter, inga konfidenstal och ingen diarization. Om du behöver undertext-timing, anteckningar om vem som talade eller en konfidenströskel pekar OpenAI:s guide på gpt-4o-transcribe-diarize eller whisper-1 i stället.
Varje skript i den här handledningen finns i github.com/KhalidAbdelaty/gpt-live-transcribe, så börja med att klona den. Du behöver Python 3.10 eller senare och en API-nyckel med Realtime-åtkomst. Själva skripten bygger på fyra paket: websockets för anslutningen, sounddevice för mikrofoninspelning, numpy för buffertkonvertering och python-dotenv för att läsa in nyckeln. Kravfilen lägger till några till för diagrammen och webbläsardemon.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
På macOS behöver sounddevice PortAudio på OS-nivå (brew install portaudio); på Linux är det apt-get install portaudio19-dev. Hoppa över den raden om du kör Windows. Jag stötte på macOS-varianten själv, och lösningen är faktiskt den enda installen.
Själva ljudet måste komma in som 16-bitars PCM i 24 kHz, mono, little-endian, base64-kodat. Skicka en MP3 eller en stereo-WAV och du får förvrängt resultat eller en stängd anslutning, aldrig ett meddelande som säger att formatet var fel. Den kan äta upp en eftermiddag. Så nästa fråga är vilken anslutning som bär ljudet.
OpenAI:s rekommendation är tydlig: WebSocket för server-till-server-appar, WebRTC för webbläsare och mobila klienter. Den här guiden bygger en Python-backend som läser en lokal mikrofon, så WebSocket är rätt val, och en vanlig API-nyckel fungerar eftersom den aldrig lämnar din server.
En session startar med en session.update-händelse som sätter type: "transcription" och väljer gpt-live-transcribe som modell. Allt annat i payloaden beskriver ljudet du ska skicka. Här är minsta konfigurationen, från guiden för Realtime-transkribering:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None inaktiverar automatisk röstaktivitetsdetektering, så inget slutförs förrän du uttryckligen committar. Tre klienthändelser gör sedan jobbet: input_audio_buffer.append skickar en base64-ljudchunk, input_audio_buffer.commit avslutar en tur, och servern svarar med conversation.item.input_audio_transcription.delta (partiell text) och conversation.item.input_audio_transcription.completed (slutlig text). Jag ansluter till wss://api.openai.com/v1/realtime?intent=transcription, ett mönster från OpenAI:s kokbok; guiden dokumenterar inte den query-strängen, så ta bort den om den skulle sluta fungera.
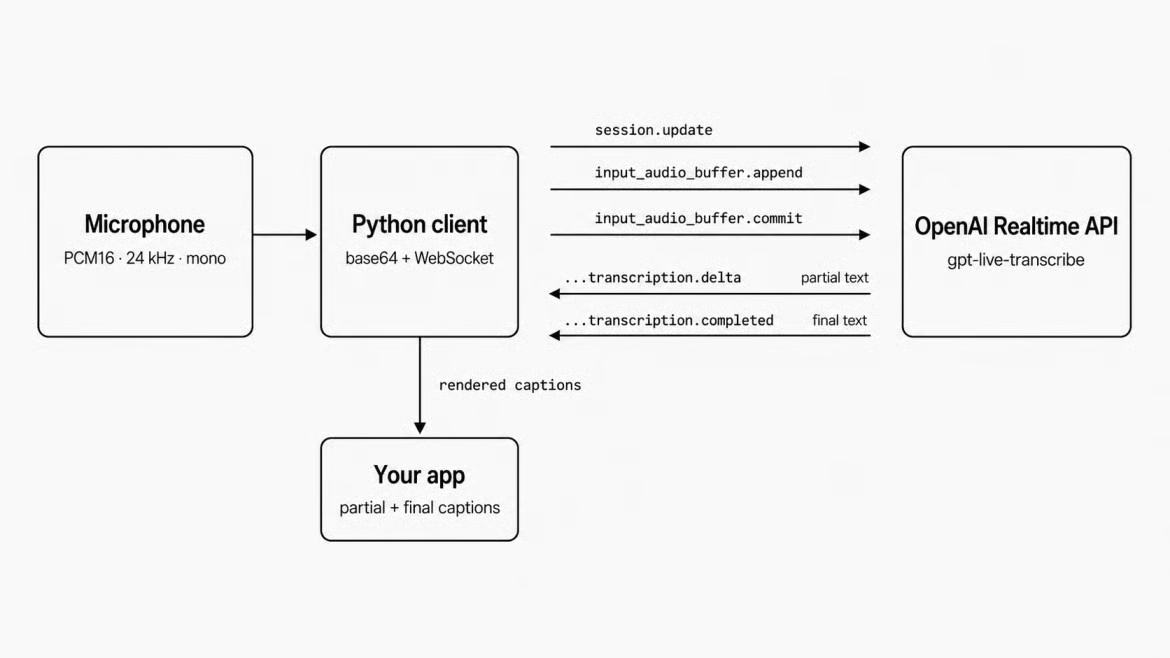
Händelseflöde i en Realtime-transkriptionssession. Bild av författaren.
Test 1 är den minsta versionen som fungerar: fånga mikrofonljud, strömma det, skriv ut partiell och slutlig text allteftersom den anländer. Ingen kontext, inga nyckelord, inget finjusterat, så händelseflödet förblir synligt. Första problemet är att få bort ljud från mikrofontråden utan att stoppa den.
sounddevice kör sin callback i en egen tråd med några millisekunder på sig att returnera innan drivrutinen tappar ramar, så den kan inte vänta på ett nätverksanrop. Dess enda jobb är att konvertera float32-bufferten till PCM16 och lägga den på en asyncio.Queue via loop.call_soon_threadsafe, medan en separat korutin tömmer kön och skickar varje chunk.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
En chunk på 100 millisekunder (2 400 sampel vid 24 kHz) är en rimlig startpunkt. Gå mindre och du ökar overhead per meddelande, gå mycket större och texterna känns sega. Det finns inget dokumenterat korrekt tal, så betrakta det som en ratt.
Deltan är billiga och frekventa. Var och en bär en textbit knuten till ett item_id. Lägg till den i den partiella text du redan har för det objektet, så växer textningen ord för ord på skärmen:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
En completed-händelse ersätter den partiella med det slutliga transkriptet för samma objekt. Behandla completed som källan till sanning och deltan som en förhandsvisning, inte något du själv ska konkatenera.
Här är detaljen som kommer att knäcka din UI om du hoppar över den: OpenAI:s guide säger att ordning mellan slutförandehändelser från olika turer inte är garanterad. En completed för en tidigare tur kan komma efter en för en senare tur, så kod som antar att den senaste completed tillhör den senaste turen kommer ibland att hoppa bakåt eller duplicera en rad. Nyckla allt på item_id i stället, vilket är vad min klassen TranscriptState gör.
När jag byggde den fångade jag två buggar, båda om vilken ordbok koden kollade. Att lägga till item_id i ordningslistan endast i delta-hanteraren lämnade full_transcript() tomt för alla konsumenter som bara processar completed-händelser. Att använda den partiella ordboken för att avgöra om ett objekt var nytt var värre: apply_completed() tömmer det inlägget, så ett sent delta såg helt nytt ut, hamnade på ordningslistan en andra gång och skrev ut den avslutade turen två gånger. Spåra item_id i båda hanterarna och kontrollera ordningslistan i stället.
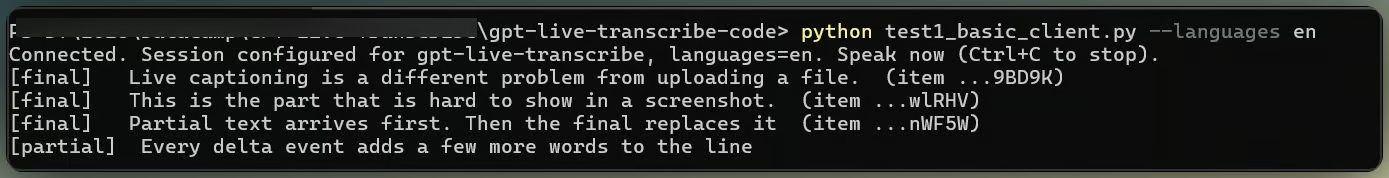
Live partiella bildtexter som slutförs till transkript. Bild av författaren.
Mot ren engelska dök text upp inom en eller två sekunder och matchade det jag sa, inklusive interpunktion. Genom en bärbar dators mikrofon utan kontext inställd kom dock ett ord modellen var osäker på ibland tillbaka i ett helt annat skriftsystem. languages är fältet för det, vilket är vad Test 2 undersöker.
Modellen accepterar tre sorters kontext, värda att vara precisa med innan vi testar dem. prompt är fri text som beskriver sammanhanget, keywords är ordagranna termer som ljudet kan innehålla och languages listar förväntade inmatningsspråk som ISO 639-1-koder som en eller ar. Ingen av dem tvingar ett utfall. Ett nyckelord som aldrig sades kommer inte att dyka upp bara för att du listade det, och det enda sättet att lära sig vad fälten faktiskt gör är att ändra ett i taget.
Jag körde samma klipp genom fem konfigurationer, tre körningar vardera. Två regler håller en sådan jämförelse ärlig: bara ett kontextfält ändras mellan körningar, och varje konfiguration körs mer än en gång, eftersom modellen inte är deterministisk på identiskt ljud.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Min första version satte languages bara på den kombinerade körningen, vilket bröt mot första regeln: två fält ändrades samtidigt, så varje skillnad där kunde komma från vilket som helst. En formatteringsregel kostade mig också en avvisad sessionsuppdatering: ett nyckelord som innehåller <, >, en vagnretur eller en nyrad avvisar hela uppdateringen, inte bara det nyckelordet. TranscriptionConfig.validate_keywords() fångar det innan payloaden byggs.
Nyckelord hjälpte på den typ av ljud du kan förvänta dig. Varje körning transkriberade kontonumret som talade ord, eftersom det är vad ljudet innehåller. Frågan var om modellen grupperade de orden till en identifierare eller stavade ut bokstäverna som ”A C forty-two”.
Över femton körningar var skillnaden tydlig. Ingenting utan keywords grupperade det någonsin: no_context, prompt_only och languages_only returnerade ”A C forty-two” på alla nio körningar. Körningar med keywords grupperade det i fem av sex, oftast som det fullt formaterade ”AC-42”. Så keywords flyttade resultatet och prompt ensamt gjorde det aldrig, i linje med OpenAI:s beskrivning av keywords som fältet för ordagranna termer som modellen kan misstolka. Nyckelord ensamma missade ändå en gång, så se det som en hint som kraftigt förskjuter oddsen snarare än en regel modellen följer.
Det ligger lite märkligt bredvid benchmark-siffran jag inledde med, där fri text-kontekst lyfte semantiken med sex punkter. De två testen mäter olika saker: OpenAI poängsatte mening över ett brett ljudunderlag, medan jag tittade på en identifierare i ett klipp. En prompt kan göra verkligt arbete på meningen och ändå lämna den snäva detaljen du råkar kontrollera orörd. Den enda antydan här är att prompt och keywords tillsammans grupperade den varje gång medan keywords ensamt missade en, en skillnad på en enda körning.
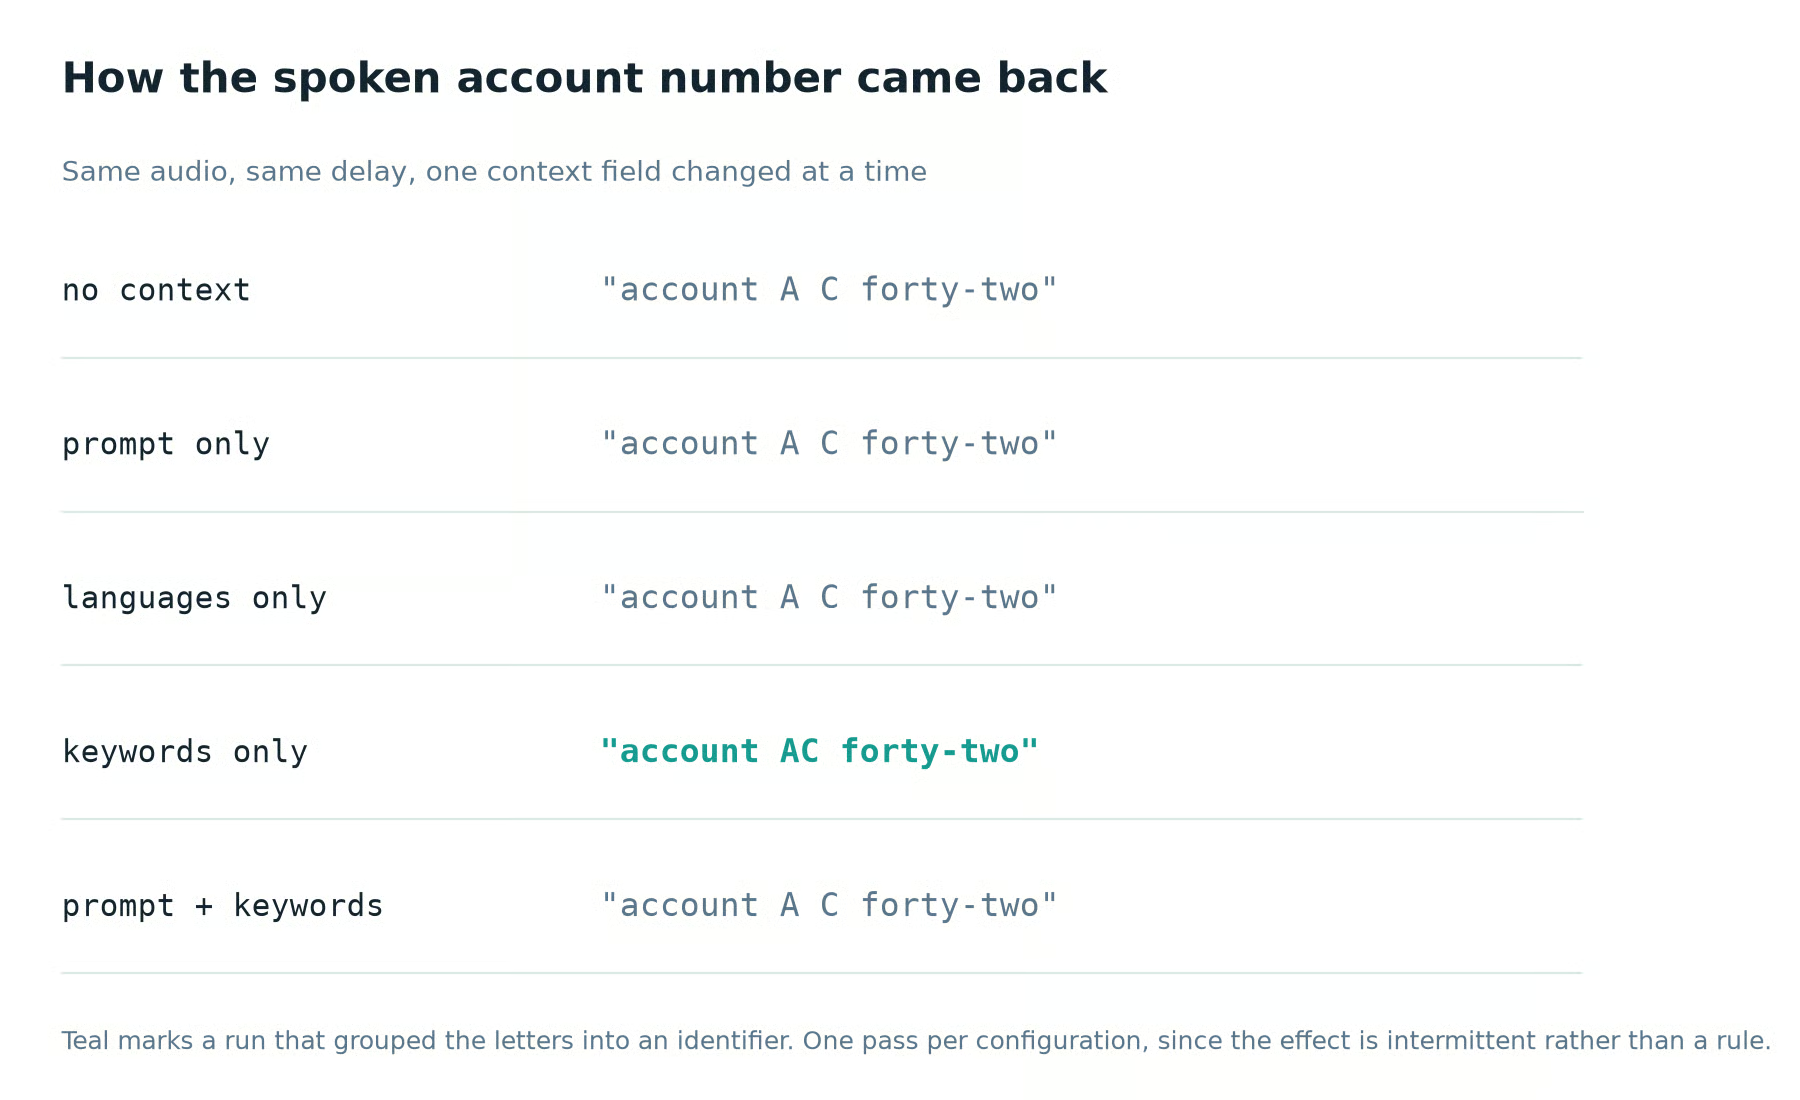
Endast nyckelord grupperade den talade identifieraren. Bild av författaren.
Språkhintar hjälpte tydligare, och på ett problem jag inte väntade mig. Utan hint hörde körningar på klippet med kodväxling det inledande arabiska utfyllnadsordet, ungefär ”tayyib”, som engelska ”But,” och smälte samman de två skriftsystemen till ett trasigt ord. De stavade också ”billing statement” fonetiskt i arabisk skrift i vissa körningar och lät det stå kvar i latin i andra. Att lägga till languages: ["ar", "en"] tog bort det trasiga ordet i varje körning. Det är ett klipp, dock, och en mening som byter språk halvvägs är det lättaste stället för en hint att märkas.
delay tar fem värden: minimal, low, medium, high och xhigh. Lägre inställningar kan ge partiell text snabbare. Högre inställningar ger modellen mer ljudkontext innan den spikar text, vilket kan förbättra noggrannhet på svårare ljud. OpenAI är tydligt med att exakt timing varierar med konfiguration och bör benchmarkas med representativt ljud, så det är vad Test 3 gör.
test3_delay_benchmark.py strömmar samma WAV-fil genom alla fem nivåer, flera körningar vardera, och loggar tiden från strömstart till första deltat och till slutligt transkript. Att hålla ljud, kontextfält och commit-strategi identiska är det som gör jämförelsen meningsfull.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}De här siffrorna är inte universella. Mina kom från tre körningar per nivå på ett klipp, ett nät, en eftermiddag. Median-tid till första partiella gick från 0,70 sekunder på minimal till 2,91 sekunder på xhigh, i jämna steg via low (1,19 s), medium (1,39 s) och high (2,09 s). De tre körningarna på varje nivå landade inom ungefär en femtedels sekund från varandra, så ordningen är stabil även om siffrorna är mina och inte dina.
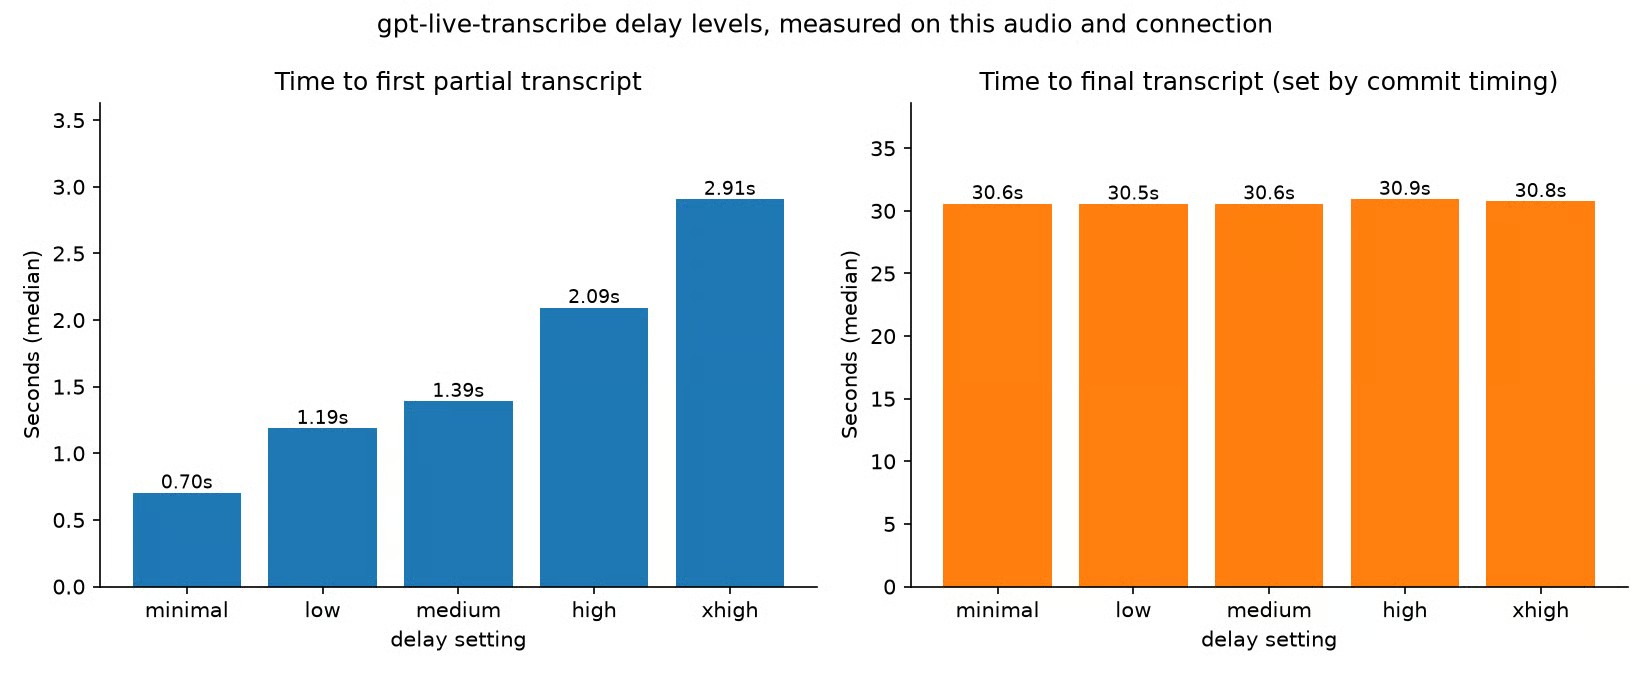
Fördröjningsnivåer byter hastighet mot noggrannhet. Bild av författaren.
Vad jag inte kunde bekräfta var den vanliga antagandet att högre fördröjning betyder färre revideringar. Antalet deltan landade mellan 84 och 86 på varje nivå, tillräckligt lika för att ingen trend ska synas. Tid till slut låg inom en halv sekund från 30,6 sekunder överallt också, men det speglar min commit-timing, inte modellen. Det är därför diagrammet delar mätningarna i paneler: på ena axeln försvinner ett tvåsekunders spann under staplar som är tio gånger högre.
För live-undertexter som någon läser medan en person pratar, börja på low. En tvåsekunders väntan innan någon text dyker upp känns trasig på ett sätt som en text som rättas till en stund senare inte gör. För mötesanteckningar som ingen läser förrän senare kostar high eller xhigh nästan ingenting. För röstkommandon, luta åt medium, eftersom ett felaktigt ord i ett tvåords-kommando spelar större roll än vanligt.
Alla tester hittills använde turn_detection: null och manuell commit. Realtime API erbjuder röstaktivitetsdetektering som alternativ, så jag kopplade in den mot gpt-live-transcribe istället för att anta att den skulle fungera. Jag var nära att stryka avsnittet när testet misslyckades. Sedan visade det sig att misslyckandet var själva fyndet.
server_vad delar upp ljud vid tystnad, konfigurerbart via threshold, prefix_padding_ms och silence_duration_ms. semantic_vad använder en klassificerare som uppskattar om talaren låter färdig, med inställningen eagerness som styr hur snabbt den beslutar:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Det är så båda lägena dokumenteras för Realtime API i allmänhet. Skickat till en gpt-live-transcribe-session kommer exakt den payloaden tillbaka avvisad:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad gav identiskt fel. Per den 4 augusti 2026 är manuell commit det enda turdetekteringsläget gpt-live-transcribe accepterar, även om transkriptionsguiden fortfarande säger att du ska konfigurera röstaktivitetsdetektering så att servern committar turer åt dig. Testa igen innan du bygger runt det, eftersom OpenAI kan slå på VAD för den här modellen senare utan att berätta det.
Push-to-talk är det enkla fallet, eftersom nedtryckning och släpp redan markerar gränserna. Allt annat lämnar klienten att avgöra när en tur tog slut, och mina två första försök blev fel.
Försök ett skyddade committen med if not mic_queue.empty(), vilket låter rimligt och aldrig utlöses: korutinen som tömmer den kön tömmer den lika snabbt som mikrofonen fyller den. Partiella bildtexter strömmade ändå, vilket gjorde det övertygande, men inget slutfördes någonsin. Försök två committade var fjärde sekund så länge ljud hade lagts till. Mot en riktig mikrofon gav det här:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Två fel samtidigt. Timern kapade meningen mitt i ett ord, och modellen läste en fragmentstart som ”Abort.” Sedan committade den medan jag inte talade och returnerade ett tomt transkript, eftersom en mikrofon strömmar chunkar oavsett om någon pratar eller inte.
Båda kommer från samma saknade information: ljudenergi. SpeechGate i mic_stream.py spårar RMS-amplituden för varje chunk och committar när talaren har sagt något och sedan blivit tyst, med ett tak så att kontinuerligt tal ändå tar slut någonstans. Min första version jämförde den amplituden mot ett fast tal, vilket fungerade på en maskin och var fel med en faktor fem på nästa, så nu skattar den rummet i stället och räknar allt som är flera gånger högre som tal. En tur som slutar på nästan inget ljud, en hostning eller en dörr, går till input_audio_buffer.clear snarare än en commit, eftersom att fråga modellen vad en dörr sa är hur du får påhittade ord.
app.py syr ihop varje del av den här handledningen i en terminalapplikation: mikrofoninspelning, live partiella bildtexter, en transkripthistorik nycklad på item_id och CLI-flaggor för varje fält som sessionen accepterar.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNamnge bara de språk du faktiskt talar. Samma kommando med en,ar på engelskt tal returnerade ordet ”delta” translittererat till arabisk skrift, vilket är Test 2:s fynd åt andra hållet.
--turn-detection är som standard manual, och --silence-hold och --max-turn finjusterar grinden från föregående avsnitt. VAD-lägena finns kvar som flaggor ifall API:t börjar acceptera dem; skicka någon av dem så skriver appen ut serverns avslag istället för att hänga tyst.
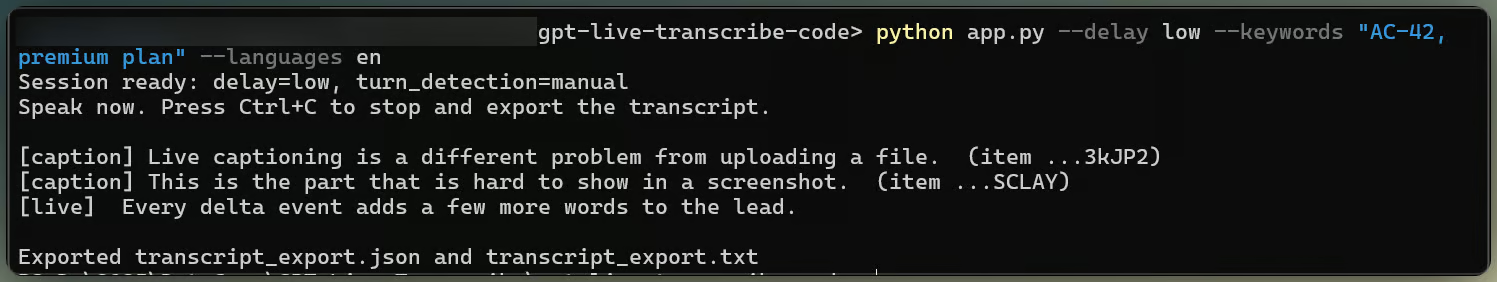
Komplett textningsapp igång med inställningar. Bild av författaren.
Vid avslut skriver den ett texttranskript och en JSON-fil med den använda konfigurationen, en lokalt uppmätt tid till första delta och varje slutförd tur med sitt item_id. Jag lade till exporten efter att ha tappat en bra testrunda till en stängd terminal. Tidsstämplarna i den är på klientsidan, så förväxla inte din egen instrumentering med en OpenAI-siffra.
Alla tre testerna körs också i en webbläsare. demo_app.py är en Streamlit-version med en flik per experiment, behållen som demo snarare än huvudspåret, eftersom terminalscripten visar råhändelserna mer direkt.
streamlit run demo_app.pyLär dig med DataCamp
course
course
course