Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Eine fertige Audiodatei an ein Transkriptions-Endpoint hochzuladen, ist die einfache Variante. Du wartest auf die komplette Datei und bekommst dann ein einziges Transkript zurück. Niemand starrt derweil auf den Bildschirm, während das Modell arbeitet. Live-Untertitel sind ein anderer Job: Audio trifft ein, während du noch entscheidest, was du mit dem aktuellen Text machst, und die Anzeige muss sich aktualisieren, während die Person noch spricht.
Genau diese Lücke gpt-live-transcribe schließt. OpenAI hat es am 28. Juli 2026 veröffentlicht – zusammen mit einem Batch-Pendant, gpt-transcribe. In diesem Tutorial baue ich einen Python-Client für Untertitel darum herum und fahre drei Tests: einen Basis-Streaming-Client, einen Vergleich der Kontext-Hinweise, die das Modell akzeptiert, und ein Benchmark der fünf Verzögerungsstufen. Getestet habe ich mit klarem Englisch, technischem Vokabular und ägyptisch-arabisch–englischem Code-Switching, weil das einer realen Besprechung näher kommt als ein sauberer Einzelsprecher.
Am Ende hast du eine funktionierende Untertitel-App, ein Gefühl dafür, welche Kontext-Settings wirklich helfen, und eine Verzögerungseinstellung, die du begründen kannst – statt zu raten.
gpt-live-transcribe ist ein Streaming-Spracherkennungsmodell für Anwendungen, die Text brauchen, während Audio noch eintrifft. Es nimmt Audio entgegen und gibt Text zurück, sonst nichts – gesteuert von vier Feldern: delay für die Latenz, prompt für freien Kontext, keywords für wörtliche Begriffe und languages für erwartete Eingangssprachen. Im Context Aware ASR Benchmark von OpenAI hob freier Kontext die semantische Genauigkeit von 38,5 auf 44,6 Prozent – daher Test 2.
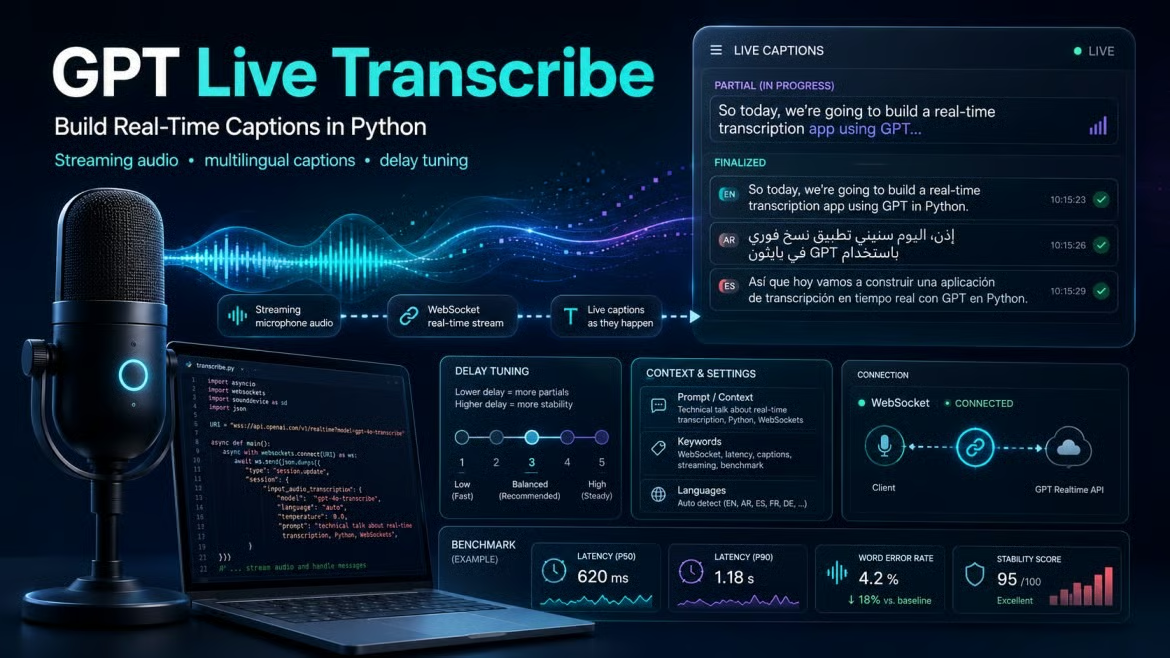
Das Modell läuft innerhalb der Realtime API, nicht als eigenes Endpoint, und es ist nicht mit GPT-Live, OpenAIs Sprachsystem, verwandt – egal, was die Namen nahelegen. Du öffnest eine Transkriptions-Session, konfigurierst sie, und der Server streamt Ereignisse über dieselbe Verbindung zurück, über die du Audio sendest. Vorher musst du eine Frage klären: Welches der beiden Transkriptionsmodelle du wirklich brauchst.
OpenAI liefert zwei empfohlene Transkriptionsmodelle, und sie sind nicht austauschbar. gpt-live-transcribe ist für kontinuierlich eintreffendes Audio – Mikrofon, Telefonat, Medienstream – wenn du Teiltexte brauchst, bevor die Person fertig gesprochen hat. gpt-transcribe ist für abgeschlossene Aufnahmen oder eine Realtime-Session, in der du bewusst auf einen bestätigten Turn wartest. Die Doku nennt diesen zweiten Fall einen spezialisierten Workflow, nicht einen Weg zu Live-Deltas.
Ein Unterschied sorgt oft für Verwirrung: gpt-transcribe gibt ein languages-Array mit der erkannten Eingangssprache zurück, gpt-live-transcribe nicht. Wenn deine Logik nach erkannter Sprache verzweigt, greifst du zum falschen Modell – egal, wie gut die Untertitel in der Demo aussehen. Auch die Preise folgen dieser Trennung, grob vier zu eins zugunsten des Batch-Modells, dazu später mehr.
Das sage ich dir lieber jetzt, bevor du eine halbe App darum baust: Es gibt keine Wort-Zeitstempel, keine Sprecherlabels, keine Konfidenzen und keine Diarisierung. Wenn du Untertitel-Timing brauchst, Notizen mit Sprecherzuordnung oder einen Konfidenzschwellenwert, verweisen die OpenAI-Guides auf gpt-4o-transcribe-diarize oder whisper-1.
Jedes Script in diesem Tutorial liegt unter github.com/KhalidAbdelaty/gpt-live-transcribe – also klone das Repo zuerst. Du brauchst Python 3.10 oder neuer und einen API-Schlüssel mit Realtime-Zugriff. Die Scripts stützen sich auf vier Pakete: websockets für die Verbindung, sounddevice für die Mikrofonaufnahme, numpy für die Pufferkonvertierung und python-dotenv zum Laden des Keys. Die requirements-Datei fügt noch ein paar Pakete für Charts und die Browser-Demo hinzu.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Unter macOS braucht sounddevice PortAudio auf OS-Ebene (brew install portaudio); unter Linux ist es apt-get install portaudio19-dev. Überspringe das unter Windows. Ich bin selbst unter macOS darüber gestolpert – die Lösung ist wirklich genau dieser eine Befehl.
Das Audio selbst muss als 16‑Bit PCM mit 24 kHz, mono, little-endian, base64-codiert ankommen. Schickst du ein MP3 oder ein Stereo-WAV, kommen verstümmelte Ausgaben zurück oder die Verbindung wird geschlossen – aber nie eine Meldung, dass das Format falsch war. Das kostet schnell einen Nachmittag. Nächste Frage: Über welche Verbindung schickst du das Audio?
OpenAIs Empfehlung ist klar: WebSocket für Server-zu-Server-Anwendungen, WebRTC für Browser- und Mobile-Clients. Dieses Tutorial baut ein Python-Backend, das ein lokales Mikrofon liest – also ist WebSocket richtig, und ein Standard-API-Key reicht, weil er nie deinen Server verlässt.
Eine Session startet mit einem session.update-Event, das type: \"transcription\" setzt und gpt-live-transcribe als Modell wählt. Alles Weitere in der Payload beschreibt das Audio, das du gleich sendest. Hier ist die Minimal-Konfiguration aus dem Realtime-Transkriptionsguide:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None deaktiviert automatische Spracherkennung (VAD), also wird nichts finalisiert, bis du explizit committest. Drei Client-Events erledigen dann die Arbeit: input_audio_buffer.append sendet einen base64-Audiochunk, input_audio_buffer.commit beendet einen Turn, und der Server antwortet mit conversation.item.input_audio_transcription.delta (Teiltext) und conversation.item.input_audio_transcription.completed (finaler Text). Ich verbinde zu wss://api.openai.com/v1/realtime?intent=transcription – ein Muster aus dem OpenAI-Cookbook; der Guide dokumentiert diesen Query-String nicht, also lass ihn weg, falls er irgendwann nicht mehr funktioniert.
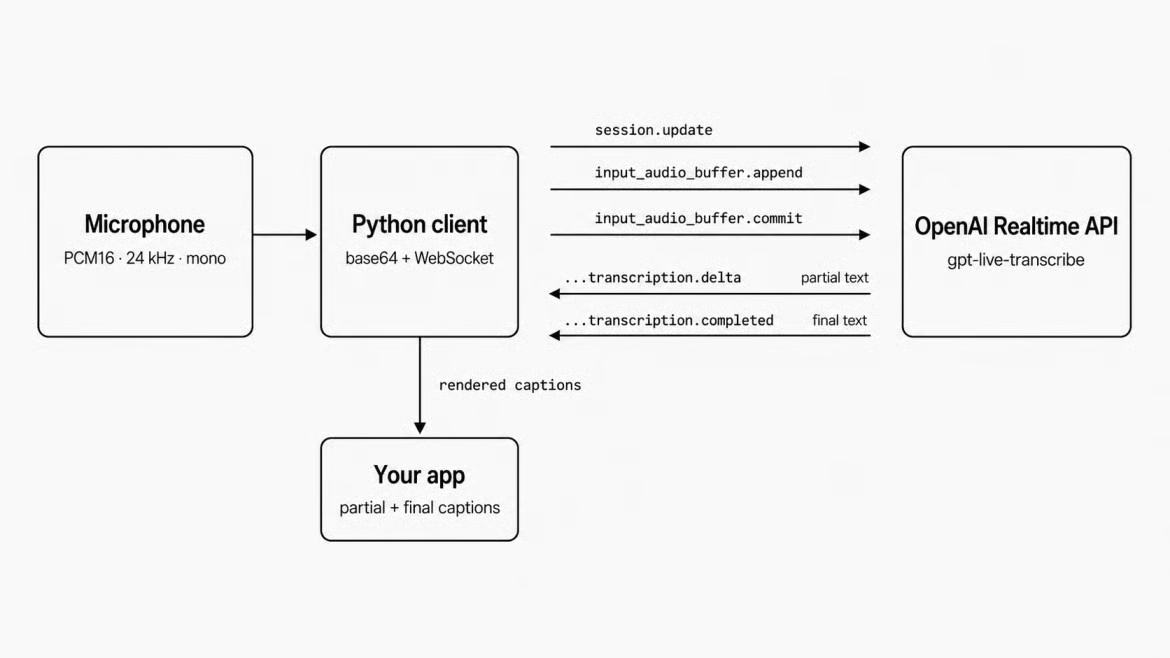
Eventfluss einer Realtime-Transkriptionssession. Bild: Autor.
Test 1 ist die kleinstmögliche funktionsfähige Version: Mikrofonton erfassen, streamen, Teil- und Finaltexte beim Eintreffen ausgeben. Kein Kontext, keine Keywords, nichts getuned – so bleibt der Eventfluss sichtbar. Das erste Problem: Audio vom Mikrofon-Thread holen, ohne ihn zu blockieren.
sounddevice führt seinen Callback auf einem eigenen Thread aus und hat nur ein paar Millisekunden, bevor der Treiber Frames verwirft – also darf er nicht auf Netzwerk warten. Seine einzige Aufgabe: den float32-Puffer in PCM16 umwandeln und per asyncio.Queue via loop.call_soon_threadsafe ablegen, während eine Coroutine diese Queue leert und jeden Chunk sendet.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
100 Millisekunden (2.400 Samples bei 24 kHz) sind ein vernünftiger Startwert. Kleiner bedeutet mehr Overhead pro Nachricht, deutlich größer lässt Untertitel träge wirken. Es gibt keine dokumentierte richtige Zahl – behandle sie als Stellschraube.
Deltas sind günstig und häufig. Jedes trägt ein Textstück mit einer item_id. Hänge es an den bereits vorhandenen Teiltext für dieses Item an – die Unterzeile wächst Wort für Wort auf dem Bildschirm:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Ein completed-Event ersetzt diesen Teiltext durch das finale Transkript desselben Items. Behandle completed als Quelle der Wahrheit und Deltas als Vorschau – nicht als etwas, das du selbst zusammenfügst.
Ein Detail zerschießt dir die UI, wenn du es ignorierst: OpenAIs Guide sagt, dass die Reihenfolge zwischen Completion-Events verschiedener Turns nicht garantiert ist. Ein completed-Event zu einem früheren Turn kann nach einem späteren eintreffen. Code, der annimmt, das neueste completed gehöre zum neuesten Turn, springt dann gelegentlich zurück oder dupliziert eine Zeile. Verknüpfe alles mit item_id – genau das macht meine Klasse TranscriptState.
Beim Bauen sind mir zwei Bugs aufgefallen, beide wegen der falschen Dictionary-Abfrage. Die item_id nur im Delta-Handler zur Reihenfolge hinzuzufügen, ließ full_transcript() für Empfänger leer, die nur completed-Events verarbeiten. Noch schlimmer: Das Partials-Dictionary zu nutzen, um zu prüfen, ob ein Item neu ist. apply_completed() leert diesen Eintrag – ein spätes Delta wirkt dann neu, landet ein zweites Mal in der Reihenfolge und druckt den Turn doppelt. Verfolge item_id in beiden Handlern und prüfe stattdessen die Reihenfolge.
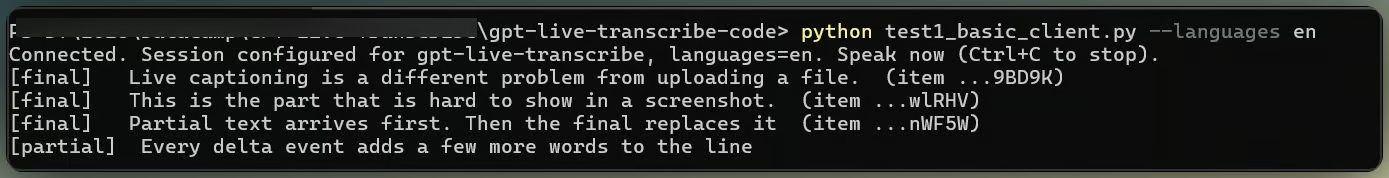
Live-Teiluntertitel, die finalisieren. Bild: Autor.
Bei sauberem Englisch erschien Text binnen ein bis zwei Sekunden und deckte sich mit dem Gesagten – inklusive Interpunktion. Über ein Laptop-Mikro ohne gesetzten Kontext kam ein unsicheres Wort jedoch gelegentlich in einer ganz anderen Schrift zurück. languages ist das Feld dafür – genau darum geht es in Test 2.
Das Modell akzeptiert drei Arten von Kontext – die wir präzise unterscheiden sollten, bevor wir testen. prompt ist Freitext zur Beschreibung des Settings, keywords sind wörtliche Begriffe, die im Audio vorkommen können, und languages listet erwartete Eingangssprachen als ISO-639-1-Codes wie en oder ar. Keines davon erzwingt eine Ausgabe. Ein nie gesagtes Keyword taucht nicht auf, nur weil du es gelistet hast – was diese Felder wirklich tun, lernst du nur, wenn du sie einzeln änderst.
Ich habe denselben Clip durch fünf Konfigurationen geschickt, je drei Durchläufe. Zwei Regeln halten den Vergleich sauber: Pro Lauf ändert sich nur genau ein Kontextfeld, und jede Konfiguration läuft mehrfach – das Modell ist bei identischem Audio nicht deterministisch.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
Meine erste Version hat languages nur im kombinierten Lauf gesetzt – Regelbruch: Zwei Felder änderten sich gleichzeitig, jede Abweichung konnte also von beiden kommen. Eine Formatregel hat mir auch ein Session-Update zerschossen: Ein Keyword mit <, >, Carriage Return oder Zeilenumbruch lehnt das ganze Update ab, nicht nur dieses Keyword. TranscriptionConfig.validate_keywords() fängt das ab, bevor die Payload gebaut wird.
Keywords halfen dort, wo man es erwartet. Jeder Lauf schrieb die Kontonummer als gesprochene Wörter, weil das im Audio so vorkommt. Die Frage war, ob das Modell diese Wörter als Kennung gruppiert oder die Buchstaben als „A C forty-two“ einzeln ausgibt.
Über fünfzehn Läufe war die Trennung klar. Ohne keywords wurde nie gruppiert: no_context, prompt_only und languages_only gaben in allen neun Durchläufen „A C forty-two“ zurück. Läufe mit keywords gruppierten fünf von sechs Mal, meist komplett formatiert als „AC-42“. Also verschob keywords das Ergebnis, prompt allein nie – im Einklang mit OpenAIs Positionierung von keywords als Feld für wörtliche Begriffe, die das Modell fehlparsen könnte. Keywords allein verfehlten einmal – also ist es ein starker Hinweis, aber keine harte Regel.
Das steht etwas quer zur Benchmark-Zahl vom Anfang, wo freier Kontext die semantische Genauigkeit um sechs Punkte hob. Die Tests messen Unterschiedliches: OpenAI bewertete Bedeutung über viele Audios, ich beobachtete eine Kennung in einem Clip. Ein prompt kann am Satz real arbeiten und dennoch das enge Detail, das du prüfst, unverändert lassen. Der einzige Hinweis hier: prompt plus keywords gruppierten in jedem Durchlauf, während keywords allein einmal verfehlte – Unterschied: ein einziger Lauf.
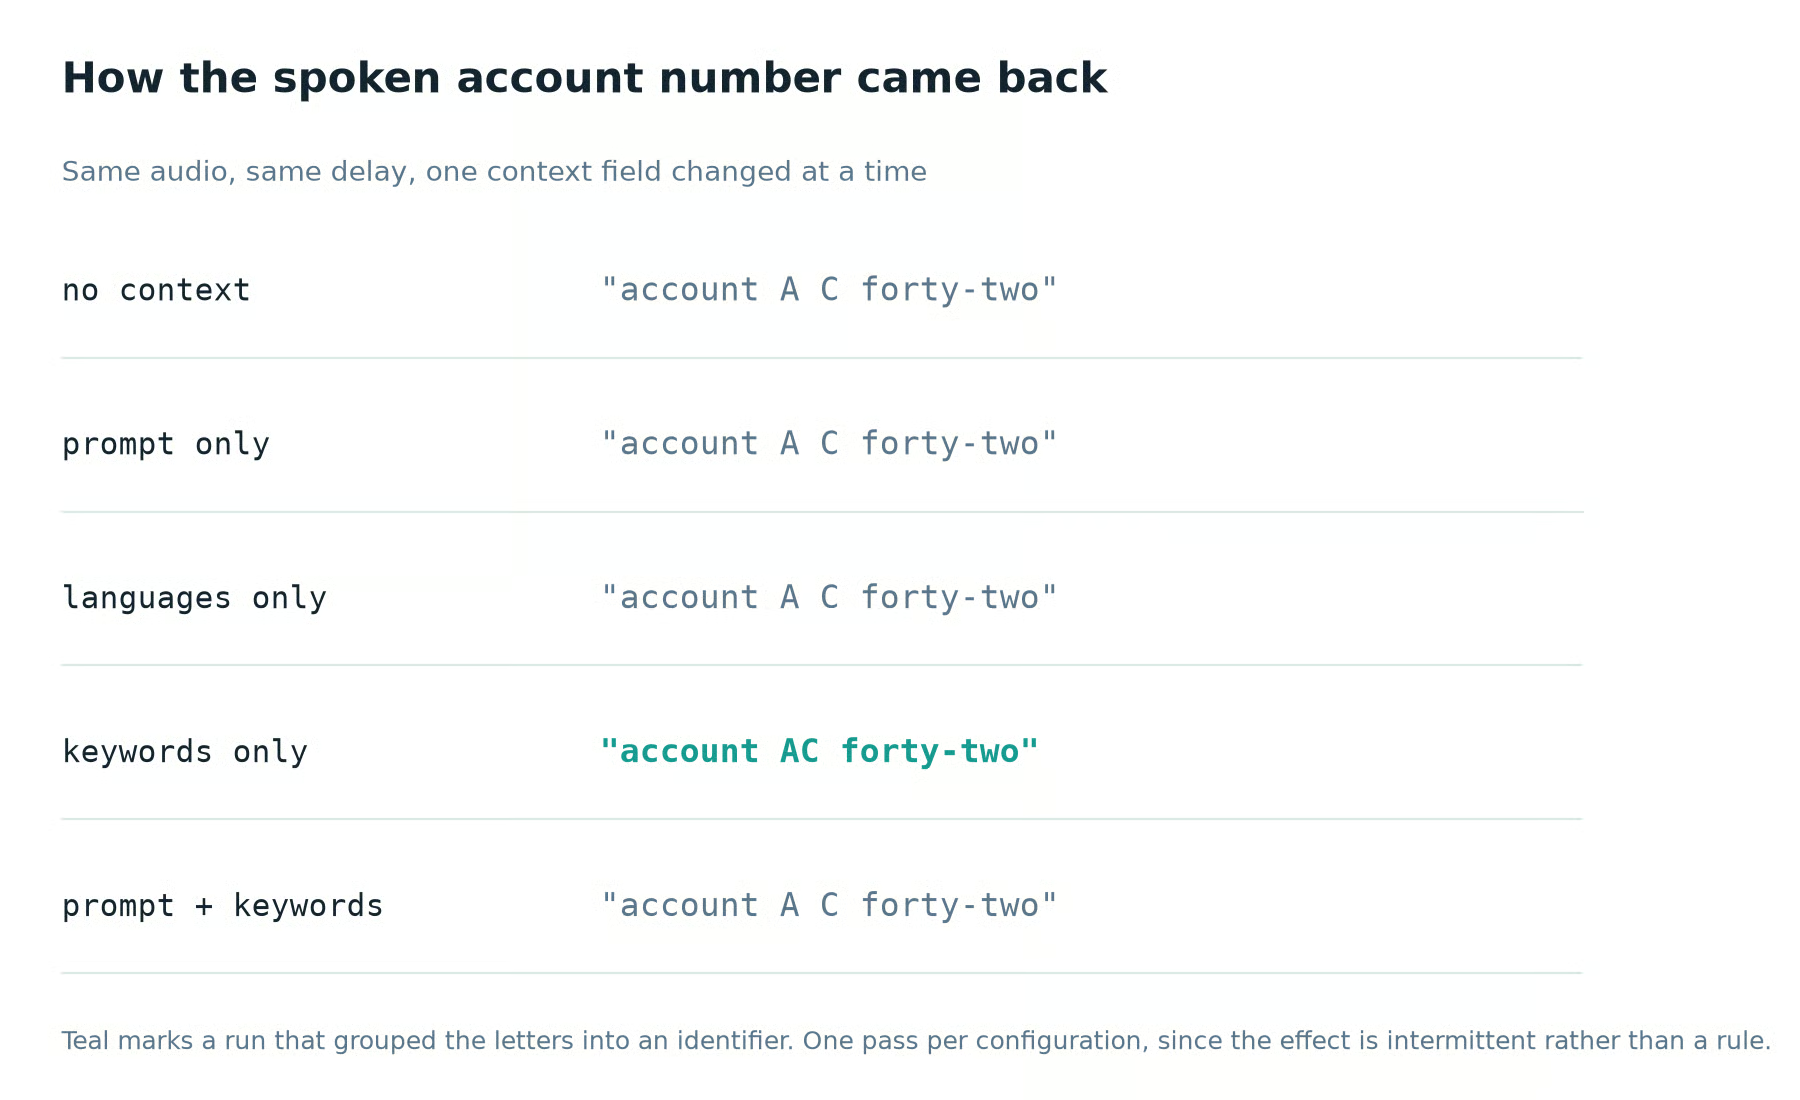
Nur Keywords gruppierten die gesprochene Kennung. Bild: Autor.
Sprachhinweise halfen deutlicher – und bei einem Problem, das ich nicht erwartet hatte. Ohne Hinweis hörten Läufe auf dem Code-Switching-Clip das einleitende arabische Füllwort, grob „tayyib“, als das englische „But,“ und verschmolzen beide Schriftsysteme zu einem kaputten Wort. „Billing statement“ wurde teils phonetisch in arabischer Schrift ausgeschrieben, teils in lateinischer belassen. languages: ["ar", "en"] entfernte das kaputte Wort in jedem Durchlauf. Das ist ein Clip – und ein Satz, der mitten drin die Sprache wechselt, ist die dankbarste Stelle, an der ein Hinweis wirkt.
delay hat fünf Werte: minimal, low, medium, high und xhigh. Niedrigere Stufen liefern früher Teiltexte. Höhere Stufen geben dem Modell mehr Audiokontext, bevor es Text festschreibt – das kann bei schwierigem Audio die Genauigkeit verbessern. OpenAI ist klar: Exakte Zeiten variieren je nach Konfiguration und sollten mit repräsentativem Audio gebenchmarkt werden – genau das macht Test 3.
test3_delay_benchmark.py streamt dieselbe WAV-Datei durch alle fünf Stufen, jeweils mehrere Läufe, und protokolliert die Zeit vom Streamstart bis zum ersten Delta und bis zum finalen Transkript. Gleiche Audio-, Kontext- und Commit-Strategie sind die Basis, damit der Vergleich Sinn ergibt.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Diese Zahlen sind nicht universell. Sie stammen aus drei Läufen pro Stufe auf einem Clip, einem Netzwerk, an einem Nachmittag. Die Medianzeit bis zum ersten Teiltext reichte von 0,70 Sekunden bei minimal bis 2,91 Sekunden bei xhigh – in gleichmäßigen Schritten über low (1,19 s), medium (1,39 s) und high (2,09 s). Die drei Läufe je Stufe lagen innerhalb von etwa zwei Zehntelsekunden – die Reihenfolge ist stabil, auch wenn die Zahlen individuell sind.
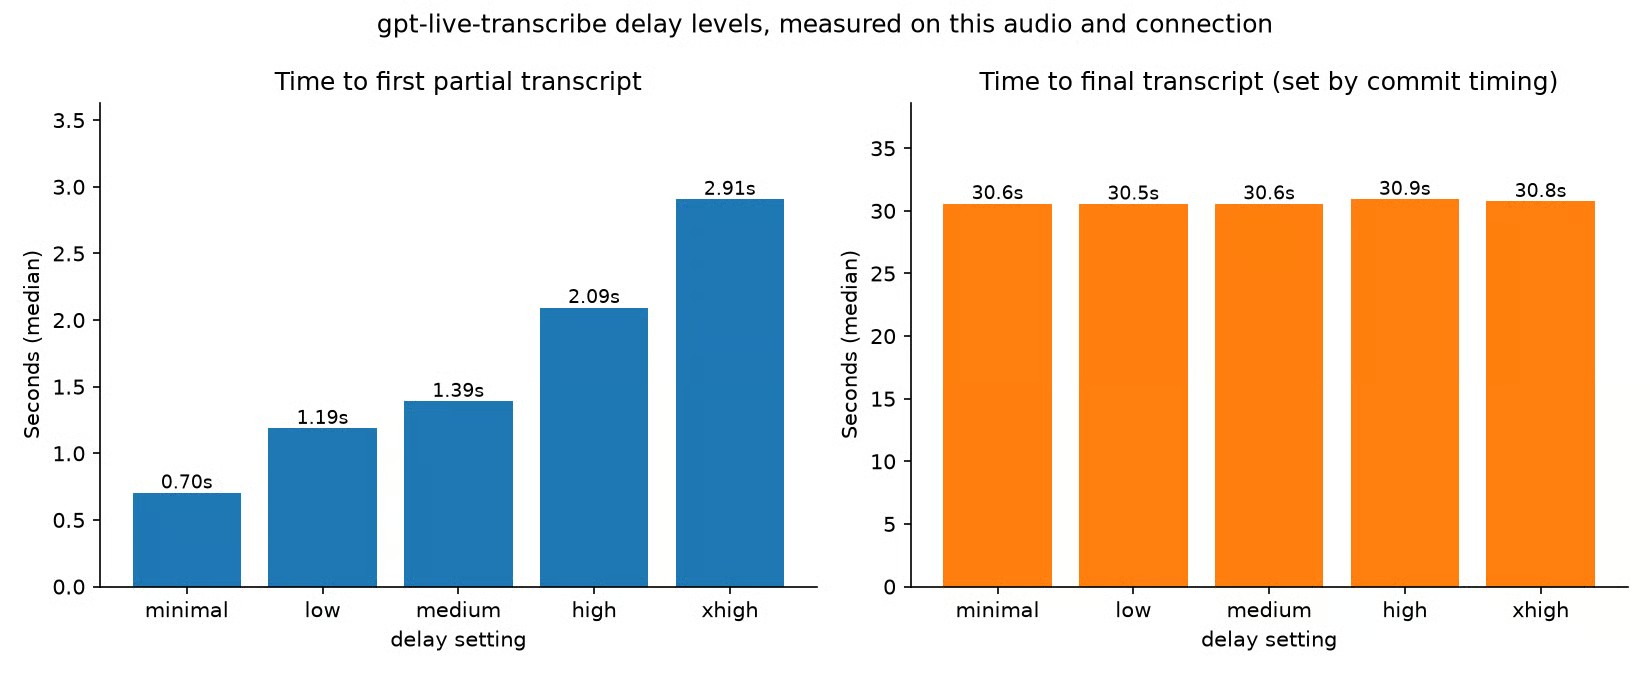
Verzögerungsstufen tauschen Tempo gegen Genauigkeit. Bild: Autor.
Nicht bestätigen konnte ich die übliche Annahme, dass höhere Verzögerung weniger Korrekturen bedeutet. Delta-Zählungen lagen auf allen Stufen zwischen 84 und 86 – praktisch identisch, kein Trend sichtbar. Die Zeit bis final lag überall innerhalb einer halben Sekunde um 30,6 Sekunden – das spiegelt aber mein Commit-Timing wider, nicht das Modell. Darum trennt das Diagramm beide Messungen: Auf einer Achse verschwindet eine Spanne von zwei Sekunden unter Balken, die zehnmal höher sind.
Für Live-Untertitel, die jemand beim Sprechen mitliest, starte bei low. Zwei Sekunden ohne jeden Text wirken kaputt – eine Unterzeile, die kurz darauf korrigiert wird, nicht. Für Meeting-Notizen, die erst später jemand liest, kosten high oder xhigh fast nichts. Für Sprachbefehle tendiere zu medium – ein falsches Wort in einem Zwei-Wort-Befehl wiegt dort schwerer.
Bisher lief alles mit turn_detection: null und manuellem Commit. Die Realtime API bietet Spracherkennung (VAD) als Alternative – ich habe sie mit gpt-live-transcribe verdrahtet, statt es vorauszusetzen. Ich wollte den Abschnitt fast streichen, als der Test scheiterte. Dann stellte sich heraus: Das Scheitern ist die Erkenntnis.
server_vad teilt Audio anhand von Stillephasen – konfigurierbar über threshold, prefix_padding_ms und silence_duration_ms. semantic_vad nutzt einen Klassifikator, der abschätzt, ob die sprechende Person fertig klingt; eagerness steuert, wie schnell entschieden wird:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}So sind beide Modi allgemein für die Realtime API dokumentiert. In einer gpt-live-transcribe-Session zurückgesendet, kommt genau diese Payload mit Ablehnung zurück:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad produziert denselben Fehler. Stand 4. August 2026 akzeptiert gpt-live-transcribe nur manuelle Commits als Turn-Detection – obwohl der Transkriptions-Guide weiterhin rät, VAD zu konfigurieren, damit der Server für dich committet. Teste das erneut, bevor du darauf aufbaust – OpenAI könnte VAD für dieses Modell später stillschweigend einschalten.
Push-to-talk ist der einfache Fall – Drücken und Loslassen markieren bereits die Grenzen. Alles andere lässt den Client entscheiden, wann ein Turn endet – und meine ersten zwei Versuche lagen daneben.
Versuch eins schützte den Commit mit if not mic_queue.empty() – klingt sinnvoll, feuert aber nie: Die Coroutine, die die Queue leert, ist so schnell wie das Mikro sie füllt. Teiluntertitel flossen trotzdem, was überzeugte – aber nichts finalisierte je. Versuch zwei committete alle vier Sekunden, solange Audio angehängt wurde. Mit echtem Mikro ergab das Folgendes:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Zwei Fehler zugleich. Der Timer schnitt den Satz mitten im Wort, und das Modell las ein Fragment ohne Anfang als „Abort“. Dann committete es, während ich nicht sprach, und gab ein leeres Transkript zurück – ein Mikrofon streamt Chunks, ob jemand spricht oder nicht.
Beides hat dieselbe Ursache: fehlende Information zur Audioenergie. SpeechGate in mic_stream.py verfolgt die RMS-Amplitude jedes Chunks und committet, sobald die sprechende Person etwas gesagt hat und dann still ist – mit einer Kappung, damit Dauerrede trotzdem endet. Meine erste Version verglich die Amplitude mit einer fixen Zahl – auf einem Rechner ok, auf dem nächsten um den Faktor fünf daneben. Jetzt schätzt sie den Raumpegel und zählt alles, was mehrfach lauter ist, als Sprache. Ein Turn-Ende mit kaum Audio – Husten, Tür – geht an input_audio_buffer.clear statt an einen Commit – sonst fragst du das Modell, was die Tür gesagt hat, und bekommst ein erfundenes Wort.
app.py führt alles aus dem Tutorial in einer Terminal-App zusammen: Mikrofonaufnahme, Live-Teiluntertitel, Transkripthistorie nach item_id und CLI-Flags für alle Session-Felder.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNenne nur die Sprachen, die du wirklich sprichst. Derselbe Befehl mit en,ar auf englischer Sprache transliterierte „delta“ in arabischer Schrift – Test 2, andersherum.
--turn-detection steht standardmäßig auf manual, und --silence-hold sowie --max-turn regeln das Gate aus dem vorherigen Abschnitt. Die VAD-Modi bleiben als Flags drin, falls die API sie doch annimmt; gibst du sie mit, druckt die App die Server-Ablehnung statt still zu hängen.
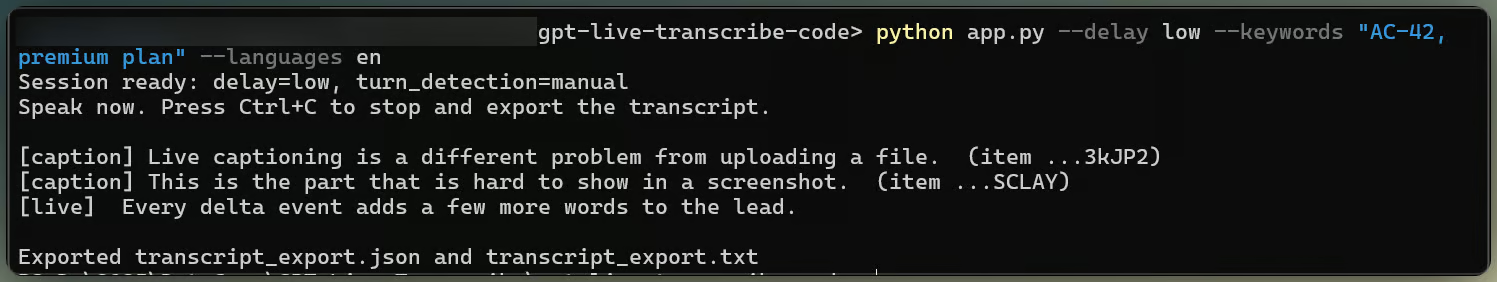
Komplette Untertitel-App mit Settings. Bild: Autor.
Beim Beenden schreibt sie ein Klartext-Transkript und eine JSON-Datei mit der genutzten Konfiguration, einer lokal gemessenen Zeit-bis-zum-ersten-Delta und jedem finalisierten Turn samt item_id. Ich habe diesen Export ergänzt, nachdem mir ein guter Testrun durch ein geschlossenes Terminal verloren ging. Die Timestamps sind clientseitig – verwechsel deine eigene Instrumentierung nicht mit OpenAI-Zahlen.
Alle drei Tests laufen auch im Browser. demo_app.py ist eine Streamlit-Version mit einem Tab pro Experiment – als Demo gedacht, nicht als Hauptlernpfad, weil die Terminal-Scripts die Roh-Events direkter zeigen.
streamlit run demo_app.pyLerne mit DataCamp
Kurs
Kurs
Kurs
Tutorial
DataCamp Team
5 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Abid Ali Awan
7 Min.
Tutorial
Adel Nehme
6 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Moez Ali
6 Min.