Corso
Lavorare con l'API di OpenAI
3 h
172.6K
Caricare un file audio finito su un endpoint di trascrizione è la versione semplice del problema. Aspetti l’intero file, poi ottieni un’unica trascrizione. Nessuno fissa lo schermo mentre il modello lavora. Il live captioning è un altro mestiere: l’audio continua ad arrivare mentre stai ancora decidendo cosa fare con ciò che hai, e il testo deve aggiornarsi mentre l’oratore sta ancora parlando.
È questo il divario che gpt-live-transcribe colma. OpenAI lo ha rilasciato il 28 luglio 2026 insieme a un modello batch complementare, gpt-transcribe. In questo tutorial costruisco un client di sottotitolazione in Python attorno ad esso ed eseguo tre test: un client di streaming di base, un confronto dei suggerimenti di contesto che accetta e un benchmark delle sue cinque impostazioni di ritardo. Ho testato con inglese pulito, vocabolario tecnico e code-switching arabo egiziano-inglese, perché è più vicino a una riunione reale che a un narratore pulito.
Alla fine avrai un’app di sottotitolazione funzionante, un’idea di quali impostazioni di contesto aiutano davvero e un’impostazione di ritardo che puoi difendere invece di andare a tentoni.
gpt-live-transcribe è un modello di speech-to-text in streaming per applicazioni che hanno bisogno del testo mentre l’audio sta ancora arrivando. Prende audio in ingresso e restituisce testo in uscita, niente altro, regolabile tramite quattro campi: delay per la latenza, prompt per il contesto libero, keywords per i termini letterali e languages per le lingue di input previste. Sul benchmark Context Aware ASR di OpenAI, il contesto libero ha alzato l’accuratezza semantica dal 38,5 percento al 44,6 percento, ed è per questo che esiste il Test 2.
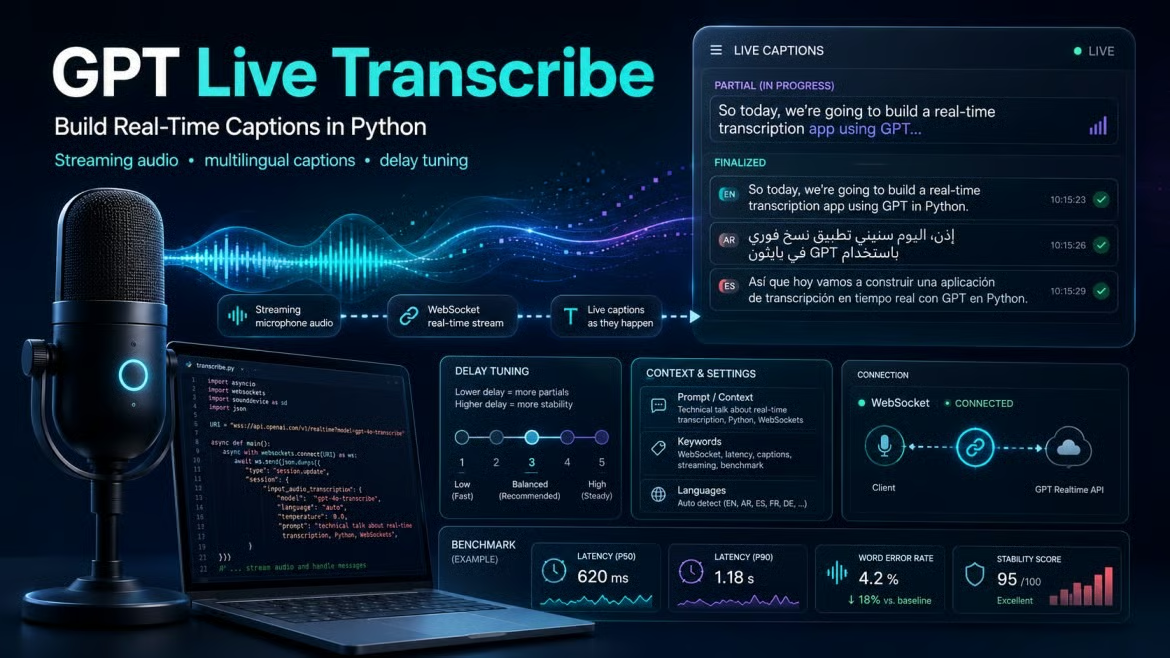
Il modello gira all’interno della Realtime API, non come endpoint separato, ed è indipendente da GPT-Live, il sistema vocale di OpenAI, nonostante i nomi possano suggerire altro. Apri una sessione di trascrizione, la configuri e il server invia eventi su quella stessa connessione su cui spedisci l’audio. Resta da chiarire prima una domanda: quale dei due modelli di trascrizione ti serve davvero.
OpenAI fornisce due modelli di trascrizione consigliati, e non sono intercambiabili. gpt-live-transcribe è per audio che arriva in continuo — un microfono, una telefonata, uno stream multimediale — quando ti serve testo parziale prima che l’oratore finisca. gpt-transcribe è per registrazioni completate o per una sessione Realtime in cui aspetti deliberatamente un turno confermato. Le docs chiamano quel secondo caso un flusso di lavoro specializzato, non un modo per ottenere delta live.
C’è una differenza che genera confusione: gpt-transcribe restituisce un array languages con la lingua di input rilevata, gpt-live-transcribe no. Se la tua logica dirama in base alla lingua rilevata, stai puntando al modello sbagliato, per quanto i sottotitoli possano sembrare buoni in una demo. Anche i prezzi si dividono lungo la stessa linea, circa quattro a uno a favore del modello batch, a cui torno più avanti.
Preferisco dirtelo ora piuttosto che dopo che hai costruito mezza app attorno a questo. Non ci sono timestamp a livello di parola, né etichette del parlante, né punteggi di confidenza, né diarizzazione. Se ti servono timing per sottotitoli, note che dicano chi ha parlato o una soglia di confidenza, la guida di OpenAI rimanda a gpt-4o-transcribe-diarize o whisper-1.
Ogni script di questo tutorial vive su github.com/KhalidAbdelaty/gpt-live-transcribe, quindi inizia clonandolo. Ti serve Python 3.10 o superiore e una chiave API con accesso Realtime. Gli script si appoggiano a quattro pacchetti: websockets per la connessione, sounddevice per catturare il microfono, numpy per la conversione del buffer e python-dotenv per caricare la chiave. Il file dei requisiti ne aggiunge alcuni per i grafici e la demo browser.
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
Su macOS, sounddevice richiede PortAudio a livello OS (brew install portaudio); su Linux è apt-get install portaudio19-dev. Salta questa riga se sei su Windows. L’ho incontrata su macOS, e la soluzione è davvero quell’unica installazione.
L’audio deve arrivare in PCM a 16 bit a 24 kHz, mono, little-endian, codificato in base64. Se invii un MP3 o un WAV stereo ottieni output confuso o una connessione chiusa, mai un messaggio che ti dice che il formato era sbagliato. Questa può farti perdere un pomeriggio. Quindi la prossima domanda è quale connessione trasporta l’audio.
Le indicazioni di OpenAI sono chiare: WebSocket per applicazioni server-to-server, WebRTC per client browser e mobile. Questo tutorial costruisce un backend Python che legge un microfono locale, quindi WebSocket è la scelta giusta, e una normale chiave API va bene perché non lascia mai il tuo server.
Una sessione inizia con un evento session.update che imposta type: "transcription" e sceglie gpt-live-transcribe come modello. Tutto il resto nel payload descrive l’audio che stai per inviare. Ecco la configurazione minima, dalla guida alla trascrizione Realtime:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None disabilita il voice activity detection automatico, quindi nulla viene finalizzato finché non confermi esplicitamente. Tre eventi client fanno il lavoro: input_audio_buffer.append invia un chunk audio base64, input_audio_buffer.commit chiude un turno e il server risponde con conversation.item.input_audio_transcription.delta (testo parziale) e conversation.item.input_audio_transcription.completed (testo finale). Mi connetto a wss://api.openai.com/v1/realtime?intent=transcription, un pattern dal cookbook di OpenAI; la guida non documenta quella query string, quindi toglila se mai smettesse di funzionare.
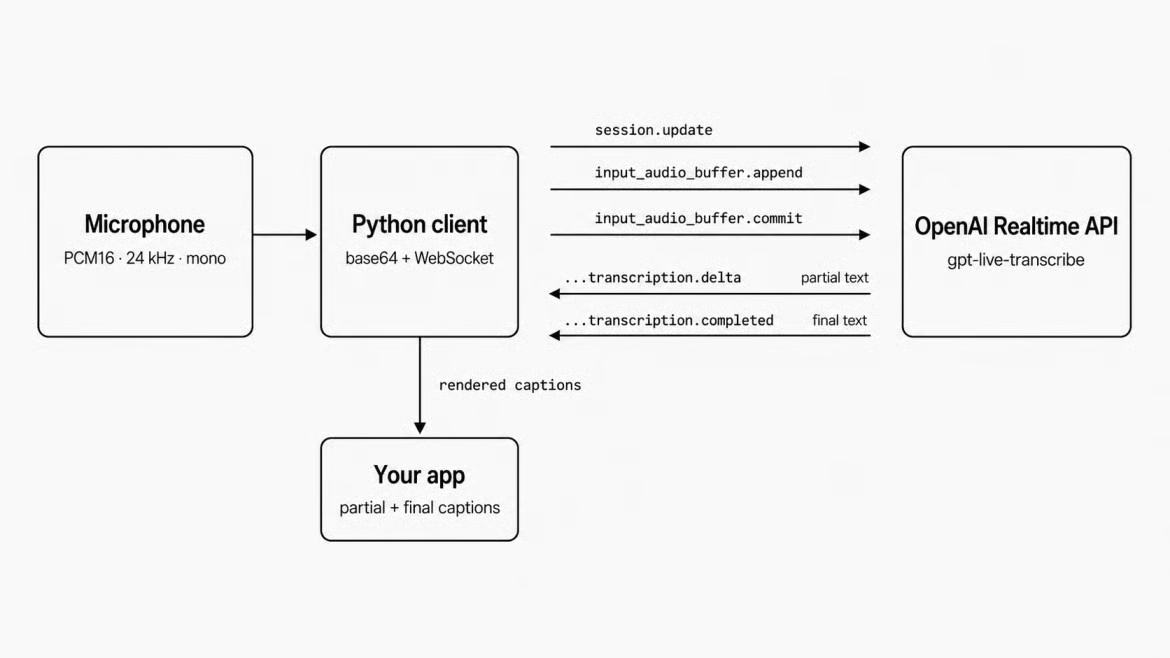
Diagramma del flusso di eventi in una sessione di trascrizione Realtime. Immagine dell’autore.
Il Test 1 è la versione minima funzionante: cattura l’audio del microfono, invialo in streaming, stampa testo parziale e finale appena arrivano. Niente contesto, niente keyword, nessuna regolazione, così il flusso di eventi rimane visibile. Il primo problema è prelevare l’audio dal thread del microfono senza bloccarlo.
sounddevice esegue la sua callback su un thread proprio con pochi millisecondi per restituire controllo prima che il driver perda frame, quindi non può attendere una chiamata di rete. Il suo unico compito è convertire il buffer float32 in PCM16 e depositarlo in una asyncio.Queue tramite loop.call_soon_threadsafe, mentre una coroutine separata svuota quella coda e invia ciascun chunk.
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
Un chunk da 100 millisecondi (2.400 campioni a 24 kHz) è un buon punto di partenza. Se vai più in piccolo aumenti l’overhead per messaggio, se vai molto più in grande i sottotitoli sembrano lenti. Non esiste un numero corretto documentato, quindi trattalo come una manopola.
I delta sono economici e frequenti. Ognuno porta un pezzo di testo legato a un item_id. Accodalo al testo parziale che hai già per quell’item, e il sottotitolo cresce parola per parola sullo schermo:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
Un evento completed sostituisce quel parziale con la trascrizione finalizzata per lo stesso item. Considera completed come fonte di verità e i delta come anteprima, non qualcosa da concatenare da solo.
Ecco il dettaglio che romperà la tua UI se lo salti: la guida di OpenAI afferma che l’ordinamento tra eventi di completamento di turni diversi non è garantito. Un evento completed per un turno precedente può arrivare dopo quello per un turno successivo, quindi un codice che presume che il completed più recente appartenga all’ultimo turno di tanto in tanto salterà indietro o duplicherà una riga. Indicizza tutto per item_id invece, che è ciò che fa la mia classe TranscriptState.
Costruendola ho preso due bug, entrambi su quale dizionario il codice controllasse. Accodare item_id alla lista d’ordine solo nell’handler dei delta lasciava full_transcript() vuoto per qualsiasi ricevitore che elaborasse solo eventi completed. Usare il dizionario dei parziali per decidere se un item fosse nuovo era peggio: apply_completed() lo cancella, quindi un delta in ritardo sembrava nuovo, finiva in lista una seconda volta e stampava il turno completato due volte. Traccia item_id in entrambi gli handler e controlla invece la lista d’ordine.
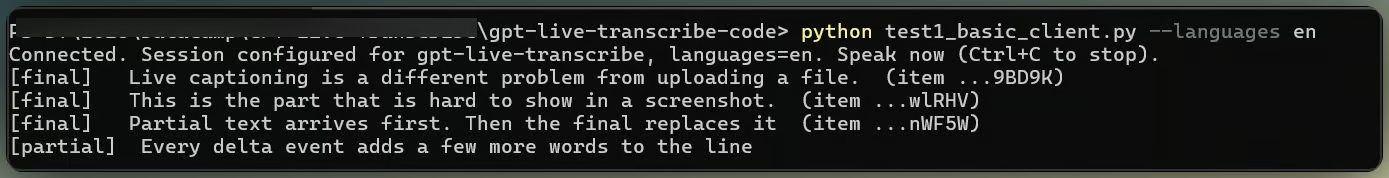
Sottotitoli parziali live che si finalizzano in trascrizione. Immagine dell’autore.
Con inglese pulito, il testo è comparso entro uno o due secondi ed è corrisposto a ciò che dicevo, punteggiatura inclusa. Con un microfono di laptop e senza contesto impostato, però, una parola su cui il modello era incerto a volte è tornata in un altro alfabeto del tutto. languages è il campo per questo, che è ciò che indaga il Test 2.
Il modello accetta tre tipi di contesto, vale la pena essere precisi prima di testarli. prompt è testo libero che descrive l’impostazione, keywords sono termini letterali che l’audio potrebbe contenere e languages elenca le lingue di input attese come codici ISO 639-1 come en o ar. Nessuno di questi forza un output. Una keyword mai pronunciata non apparirà solo perché l’hai elencata, e l’unico modo per capire davvero cosa facciano questi campi è cambiarne uno alla volta.
Ho eseguito la stessa clip con cinque configurazioni, tre passaggi ciascuna. Due regole rendono onesto un confronto così: cambia un solo campo di contesto tra le esecuzioni e ogni configurazione gira più di una volta, perché il modello non è deterministico sullo stesso audio.
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
La mia prima versione impostava languages solo nell’esecuzione combinata, violando la prima regola: due campi cambiavano insieme, quindi qualsiasi differenza poteva derivare dall’uno o dall’altro. Una regola di formattazione mi è anche costata un aggiornamento di sessione rifiutato: una keyword contenente <, >, un carriage return o un line feed rifiuta l’intero update, non solo quella keyword. TranscriptionConfig.validate_keywords() intercetta questo prima di costruire il payload.
Le keyword hanno aiutato sul tipo di audio che ti aspetteresti. Ogni esecuzione ha trascritto il numero di conto come parole pronunciate, perché è ciò che contiene l’audio. La domanda era se il modello raggruppasse quelle parole in un identificatore o sillabasse le lettere come "A C forty-two".
Su quindici esecuzioni la divisione è stata netta. Nulla senza keywords lo ha mai raggruppato: no_context, prompt_only e languages_only hanno restituito "A C forty-two" in tutti e nove i loro passaggi. Le esecuzioni con keywords lo hanno raggruppato in cinque su sei, per lo più come "AC-42" già formattato. Quindi keywords ha spostato il risultato e prompt da solo non lo ha mai fatto, in linea con l’inquadramento di OpenAI di keywords come campo per termini letterali che il modello potrebbe interpretare male. Le sole keyword hanno comunque mancato una volta, quindi trattale come un indizio che sposta fortemente le probabilità piuttosto che una regola che il modello segue.
Questo cozza con la cifra di benchmark con cui ho aperto, dove il contesto libero ha alzato l’accuratezza semantica di sei punti. I due test misurano cose diverse: OpenAI ha valutato il significato su un ampio set di audio, mentre io ho osservato un identificatore in una clip. Un prompt può lavorare davvero sulla frase e lasciare comunque intatto il dettaglio ristretto che stai controllando. L’unico segnale qui è che prompt e keywords insieme lo hanno raggruppato in ogni passaggio mentre le sole keywords ne hanno mancato uno, differenza di un’unica esecuzione.
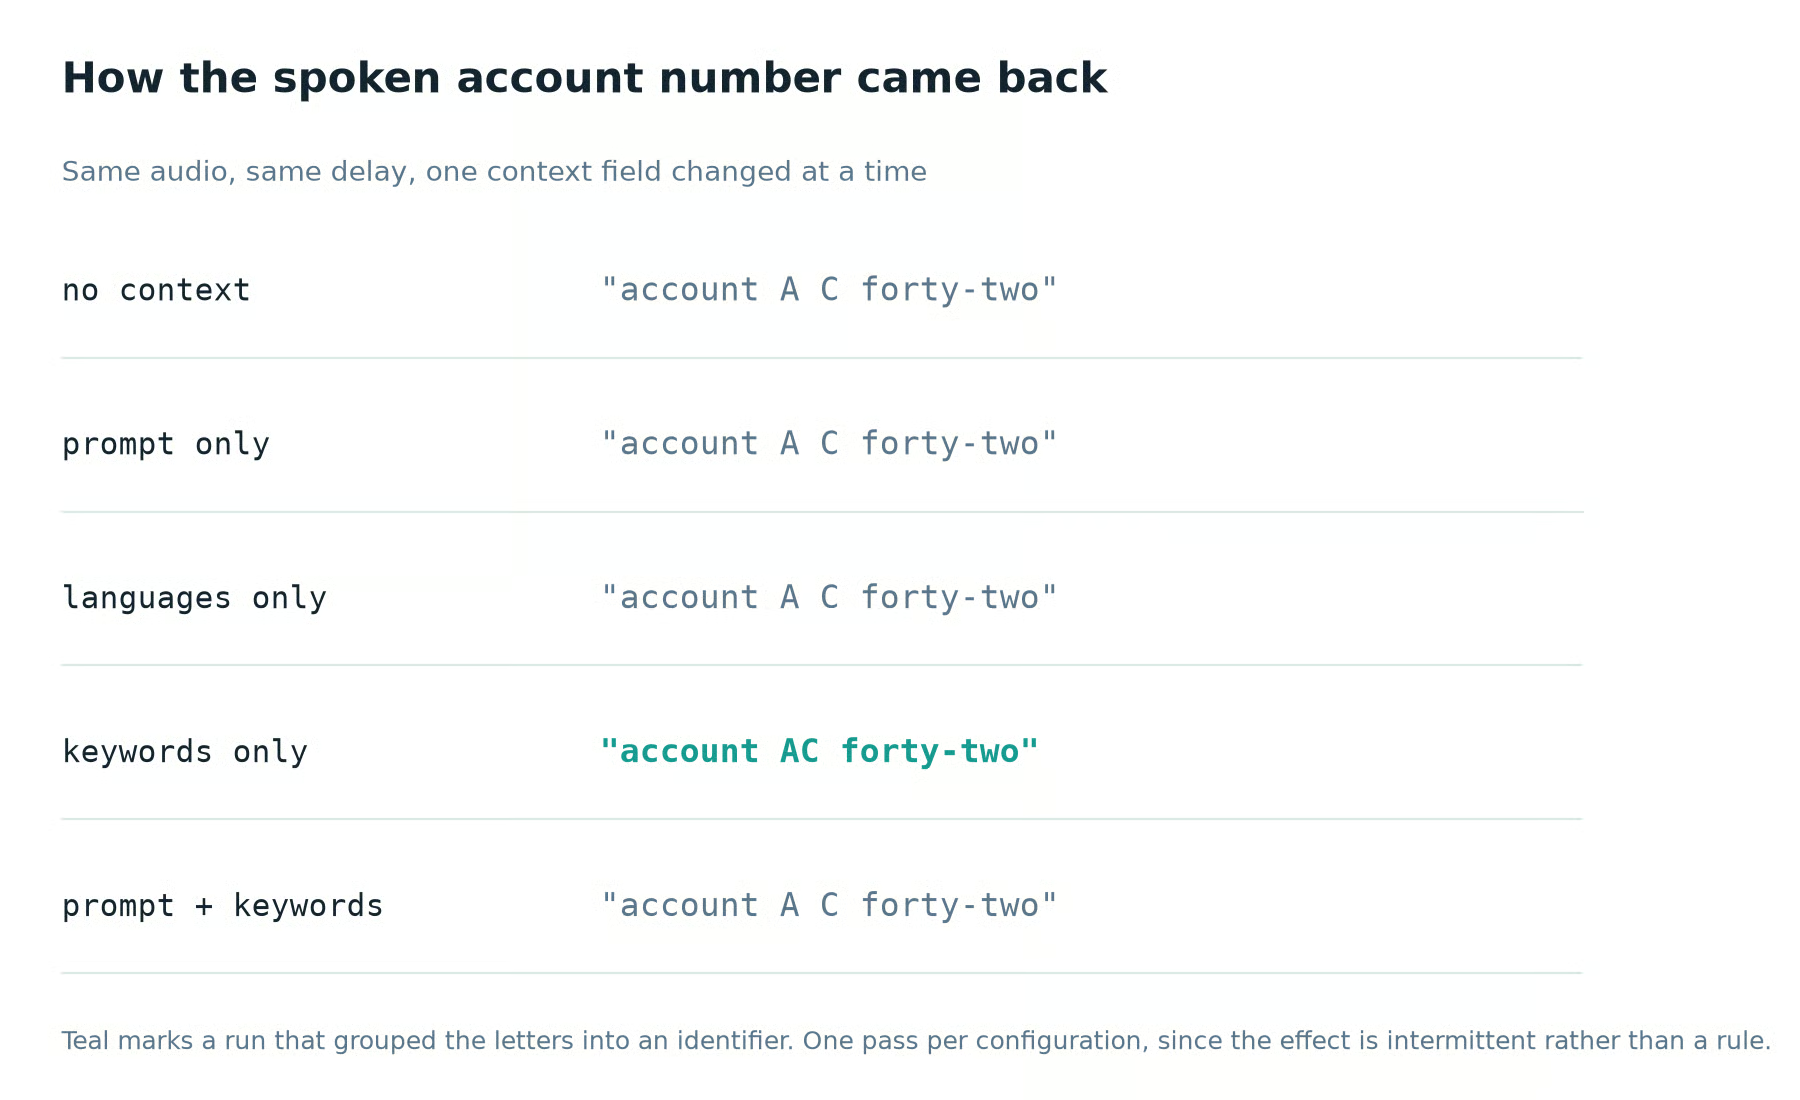
Solo le keyword hanno raggruppato l’identificatore pronunciato. Immagine dell’autore.
I suggerimenti di lingua hanno aiutato più chiaramente, e su un problema che non mi aspettavo. Senza un suggerimento, le esecuzioni sulla clip con code-switching interpretavano la parola riempitiva araba iniziale, all’incirca "tayyib", come l’inglese "But," e fusero i due sistemi di scrittura in una parola rotta. Inoltre hanno scritto "billing statement" foneticamente in alfabeto arabo in alcuni passaggi e lo hanno lasciato in latino in altri. Aggiungere languages: ["ar", "en"] ha rimosso la parola rotta in ogni passaggio. È una sola clip, però, e una frase che cambia lingua a metà è il posto più facile in cui un suggerimento si faccia notare.
delay accetta cinque valori: minimal, low, medium, high e xhigh. Impostazioni più basse possono produrre testo parziale prima. Impostazioni più alte danno al modello più contesto audio prima di impegnarsi sul testo, il che può migliorare l’accuratezza su audio più difficili. OpenAI è esplicita sul fatto che i tempi esatti variano in base alla configurazione e andrebbero misurati con audio rappresentativo, ed è ciò che fa il Test 3.
test3_delay_benchmark.py invia in streaming lo stesso file WAV su tutti e cinque i livelli, diverse esecuzioni ciascuno, registrando il tempo dall’avvio dello stream al primo delta e al testo finale. Mantenere identici audio, campi di contesto e strategia di commit è ciò che dà senso al confronto.
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}Queste cifre non sono universali. Le mie provengono da tre esecuzioni per livello su una clip, una rete, un pomeriggio. Il tempo mediano al primo parziale andava da 0,70 secondi con minimal a 2,91 secondi con xhigh, salendo a passi regolari attraverso low (1,19s), medium (1,39s) e high (2,09s). Le tre esecuzioni per livello sono finite entro circa un quinto di secondo l’una dall’altra, quindi l’ordinamento è stabile anche se i numeri sono i miei e non i tuoi.
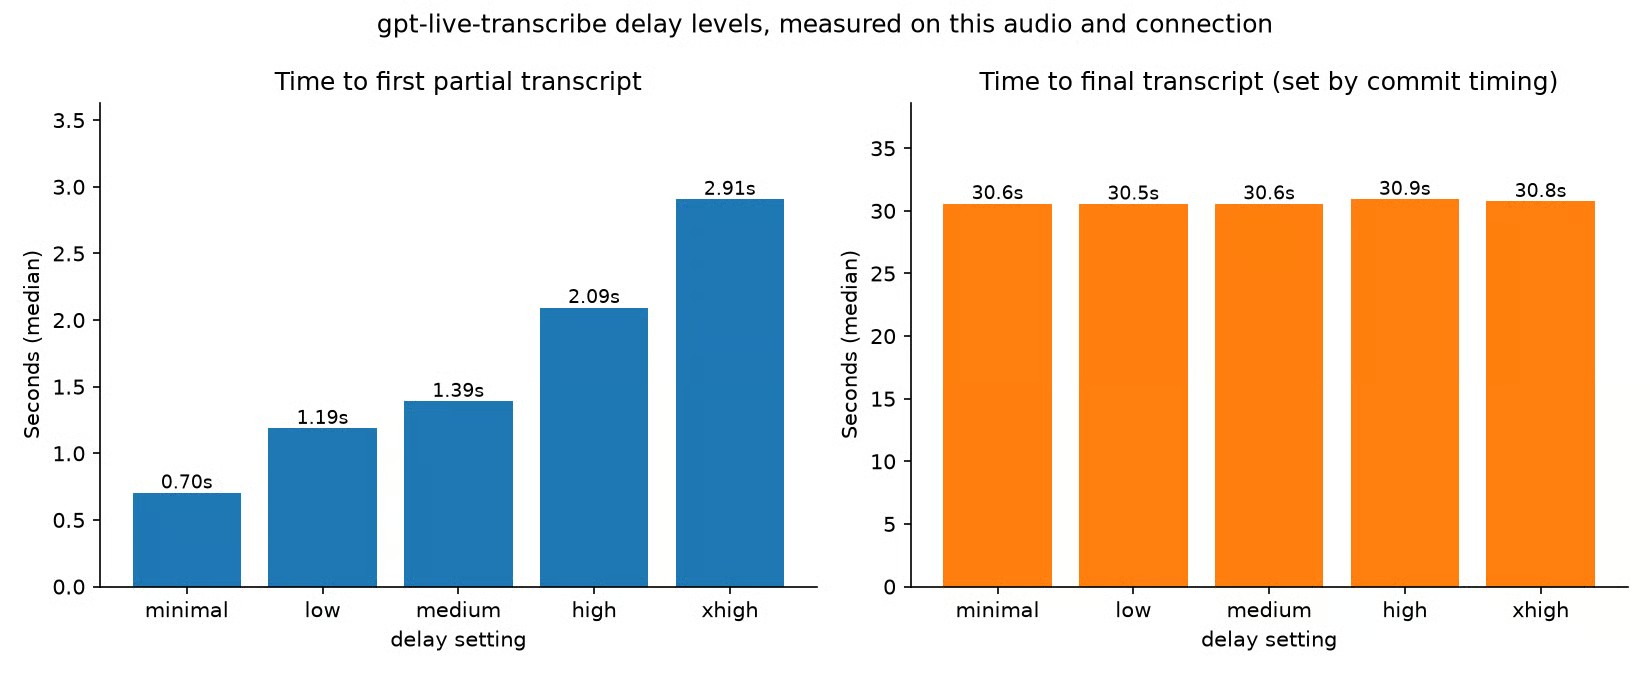
I livelli di ritardo scambiano velocità con accuratezza. Immagine dell’autore.
Quello che non ho potuto confermare è l’assunzione abituale che un ritardo più alto significhi meno revisioni. I conteggi dei delta sono finiti tra 84 e 86 a ogni livello, abbastanza simili da non mostrare alcun trend. Il tempo al finale è rimasto entro mezzo secondo da 30,6 secondi ovunque, ma ciò riflette i miei tempi di commit, non il modello. Ecco perché il grafico divide le due misure in pannelli: su un asse, due secondi spariscono sotto barre dieci volte più alte.
Per sottotitoli live che qualcuno legge mentre una persona parla, parti da low. Due secondi di attesa prima che compaia testo sembrano un malfunzionamento più di quanto lo sia un sottotitolo corretto un attimo dopo. Per note di riunione che nessuno legge fino a dopo, high o xhigh costano quasi nulla. Per comandi vocali, orientati su medium, perché una parola sbagliata in un comando di due parole pesa di più del solito.
Finora ogni test ha usato turn_detection: null e un commit manuale. La Realtime API offre il voice activity detection come alternativa, quindi l’ho collegato a gpt-live-transcribe invece di dare per scontato che funzionasse. Ho quasi tagliato questa sezione quando il test è fallito. Poi si è scoperto che il fallimento era il risultato.
server_vad segmenta l’audio sui periodi di silenzio, configurabili con threshold, prefix_padding_ms e silence_duration_ms. semantic_vad usa un classificatore che stima se l’oratore sembra aver finito, con un’impostazione eagerness che controlla quanto rapidamente decide:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}Così sono documentate entrambe le modalità per la Realtime API in generale. Inviata a una sessione gpt-live-transcribe, quella stessa configurazione torna rifiutata:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad ha prodotto lo stesso identico errore. Al 4 agosto 2026 il commit manuale è l’unica modalità di rilevamento turno che gpt-live-transcribe accetta, anche se la guida alla trascrizione dice ancora di configurare il voice activity detection così che il server confermi i turni per te. Ritesta prima di costruirci attorno, perché OpenAI potrebbe attivare il VAD per questo modello anche senza avvisare.
Il push-to-talk è il caso facile, perché la pressione e il rilascio segnano già i confini. Tutto il resto lascia al client la decisione di quando un turno è finito, e i miei primi due tentativi sono andati entrambi male.
Il primo tentativo proteggeva il commit con if not mic_queue.empty(), che sembra sensato e non scatta mai: la coroutine che svuota quella coda la svuota tanto velocemente quanto il microfono la riempie. I sottotitoli parziali scorrevano comunque, ed è questo che lo rendeva convincente, ma nulla si finalizzava. Il secondo tentativo confermava ogni quattro secondi finché l’audio era stato aggiunto. Con un microfono reale ha prodotto questo:
[final]   Questo è un supporto clienti  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
Due errori in uno. Il timer ha tagliato la frase a metà parola e il modello ha letto un frammento che non inizia da nessuna parte come "Abort." Poi ha fatto commit mentre non parlavo e ha restituito una trascrizione vuota, dato che un microfono invia chunk che qualcuno stia parlando o meno.
Entrambi derivano dalla stessa informazione mancante: l’energia dell’audio. SpeechGate in mic_stream.py traccia l’ampiezza RMS di ogni chunk e fa commit una volta che l’oratore ha detto qualcosa e poi è rimasto in silenzio, con un tetto così che un discorso continuo finisca comunque da qualche parte. La mia prima versione confrontava quell’ampiezza con un numero fisso, che funzionava su una macchina ed era sbagliato di un fattore cinque sulla successiva, quindi ora stima l’ambiente e considera parlato qualsiasi cosa sia diverse volte più forte. Un turno che finisce con quasi nessun audio, un colpo di tosse o una porta, va su input_audio_buffer.clear anziché su un commit, perché chiedere al modello cosa ha detto una porta è il modo in cui ottieni una parola inventata.
app.py mette insieme ogni pezzo di questo tutorial in un’app da terminale: cattura microfono, sottotitoli parziali live, uno storico della trascrizione indicizzato per item_id e flag CLI per ogni campo accettato dalla sessione.
python app.py --delay low --keywords "AC-42,premium plan" --languages enNomina solo le lingue che stai davvero parlando. Lo stesso comando con en,ar su parlato inglese ha restituito la parola "delta" traslitterata in alfabeto arabo, cioè il risultato del Test 2 al contrario.
--turn-detection è manual per impostazione predefinita, e --silence-hold e --max-turn regolano il gate dalla sezione precedente. Le modalità VAD restano come flag nel caso l’API inizi ad accettarle; passane una e l’app stampa il rifiuto del server invece di bloccarsi in silenzio.
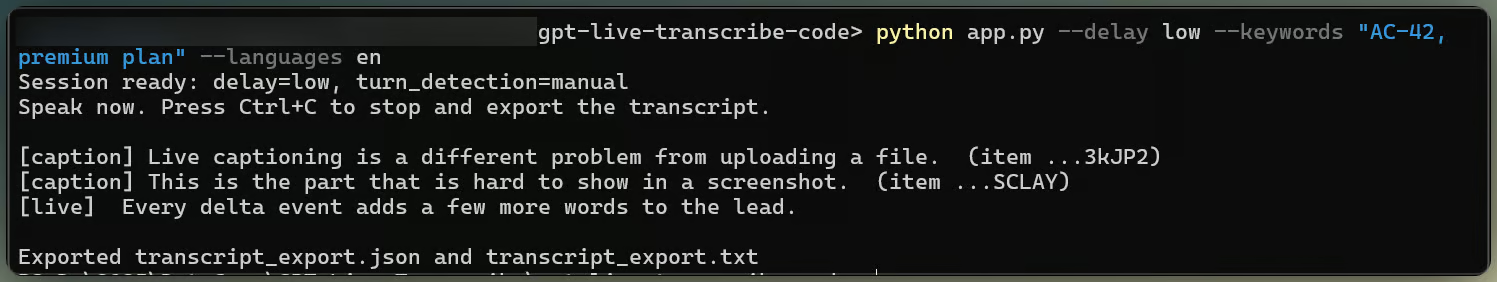
App completa di sottotitolazione in esecuzione con impostazioni. Immagine dell’autore.
All’uscita scrive una trascrizione in testo semplice e un file JSON con la configurazione usata, un tempo al primo delta misurato localmente e ogni turno finalizzato con il suo item_id. Ho aggiunto quell’export dopo aver perso una buona esecuzione per un terminale chiuso. I timestamp sono lato client, quindi non scambiare la tua strumentazione per una cifra di OpenAI.
Tutti e tre i test girano anche in un browser. demo_app.py è una versione Streamlit con una scheda per esperimento, tenuta come demo e non come percorso didattico principale, dato che gli script da terminale mostrano gli eventi grezzi più direttamente.
streamlit run demo_app.pyImpara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min