Courses
การทำงานกับ OpenAI API
3 ชม.
172.6K
อัปโหลดไฟล์เสียงที่เสร็จสมบูรณ์ไปยังปลายทางถอดเสียงเป็นเวอร์ชันง่ายของปัญหานี้ รอให้ไฟล์เสร็จแล้วรับถอดความกลับมาแผ่นเดียว ไม่มีใครต้องจ้องหน้าจอระหว่างที่โมเดลทำงาน การทำคำบรรยายสดเป็นงานต่างประเภท: เสียงยังคงไหลเข้ามาในขณะที่ยังตัดสินใจอยู่กับสิ่งที่มี และข้อความต้องอัปเดตขณะที่ผู้พูดยังพูดอยู่
ช่องว่างนั้นคือสิ่งที่ gpt-live-transcribe เข้ามาเติมเต็ม OpenAI เปิดตัวเมื่อ 28 กรกฎาคม 2026 พร้อมกับรุ่นประมวลผลแบบแบตช์ gpt-transcribe ในบทเรียนนี้จะสร้างไคลเอนต์คำบรรยายด้วย Python รอบ ๆ รุ่นนี้ และรันทดสอบสามแบบ: ไคลเอนต์สตรีมมิงพื้นฐาน การเปรียบเทียบคำใบ้บริบทที่รองรับ และ benchmark ของการตั้งค่า delay ทั้งห้าระดับ ทดสอบกับภาษาอังกฤษสะอาด คำศัพท์เชิงเทคนิค และการสลับภาษาอาหรับอียิปต์-อังกฤษ เพราะใกล้เคียงกับการประชุมจริงมากกว่าผู้บรรยายคนเดียวที่พูดชัดเจน
เมื่อจบ คุณจะมีแอปคำบรรยายที่ใช้งานได้ ความเข้าใจว่าเซตติ้งบริบทไหนช่วยได้จริง และการตั้งค่า delay ที่อธิบายเหตุผลได้แทนการเดา
gpt-live-transcribe เป็นโมเดลรู้จำคำพูดเป็นข้อความแบบสตรีมมิง สำหรับแอปที่ต้องการข้อความถอดเสียงขณะเสียงยังคงเข้ามา ป้อนเสียงเข้าแล้วคืนข้อความออก ไม่อย่างอื่น ปรับจูนได้ด้วยสี่ฟิลด์: delay เพื่อความหน่วง prompt สำหรับบริบทแบบอิสระ keywords สำหรับคำเฉพาะ และ languages สำหรับภาษาที่คาดว่าจะป้อน ในชุดทดสอบ Context Aware ASR ของ OpenAI บริบทแบบอิสระยกระดับความแม่นยำเชิงความหมายจาก 38.5 เปอร์เซ็นต์เป็น 44.6 เปอร์เซ็นต์ นั่นคือเหตุผลของการทดสอบที่ 2
โมเดลทำงานภายใน Realtime API ไม่ใช่ปลายทางแยก และไม่เกี่ยวข้องกับ GPT-Live ระบบเสียงของ OpenAI แม้ชื่อจะชวนคิดเช่นนั้น เปิดเซสชันถอดเสียง ตั้งค่า แล้วเซิร์ฟเวอร์จะสตรีมอีเวนต์กลับมาบนการเชื่อมต่อเดียวกับที่ส่งเสียงไป เหลือคำถามแรกที่ต้องตัดสินใจก่อน: ต้องใช้สองโมเดลถอดเสียงตัวไหนกันแน่
OpenAI จัดส่งโมเดลถอดเสียงที่แนะนำสองตัว และไม่สามารถใช้แทนกันได้ gpt-live-transcribe เหมาะสำหรับเสียงที่เข้ามาต่อเนื่อง ไมโครโฟน สายโทรศัพท์ สตรีมมีเดีย ที่ต้องการข้อความบางส่วนก่อนผู้พูดจะจบ ส่วน gpt-transcribe เหมาะกับงานบันทึกที่เสร็จแล้ว หรือเซสชัน Realtime ที่ตั้งใจรอการ commit ในเทิร์นที่ผูกมัด เอกสารเรียกกรณีหลังว่าเป็น เวิร์กโฟลว์เฉพาะทาง ไม่ใช่วิธีรับเดลตาแบบสด
มีความต่างหนึ่งที่ทำให้หลายคนพลาด: gpt-transcribe คืนค่าอาร์เรย์ languages พร้อมภาษาขาเข้าที่ตรวจพบ แต่ gpt-live-transcribe ไม่คืนค่า หากตรรกะของคุณแตกแขนงตามภาษาที่ตรวจพบ แสดงว่าหยิบโมเดลผิด ไม่ว่าคำบรรยายจะดูดีแค่ไหนในเดโม ด้านราคาแยกตามเส้นเดียวกัน ประมาณสี่ต่อหนึ่งเข้าข้างโมเดลแบตช์ ซึ่งจะกล่าวถึงในภายหลัง
ขอบอกไว้ก่อนดีกว่า ก่อนจะสร้างแอปไปครึ่งทางโดยไม่รู้ ไม่มี timestamp ระดับคำ ไม่มีป้ายระบุผู้พูด ไม่มีคะแนนความเชื่อมั่น และไม่มีการแยกผู้พูด หากต้องการเวลาซับไตเติล โน้ตบอกว่าใครพูด หรือเกณฑ์ความเชื่อมั่น คู่มือของ OpenAI ชี้ไปที่ gpt-4o-transcribe-diarize หรือ whisper-1 แทน
สคริปต์ทั้งหมดในบทเรียนนี้อยู่ที่ github.com/KhalidAbdelaty/gpt-live-transcribe เริ่มจากโคลน ต้องใช้ Python 3.10 ขึ้นไป และคีย์ API ที่มีสิทธิ์ Realtime ตัวสคริปต์อิงแพ็กเกจสี่ตัว: websockets สำหรับการเชื่อมต่อ sounddevice สำหรับจับเสียงไมโครโฟน numpy สำหรับแปลงบัฟเฟอร์ และ python-dotenv สำหรับโหลดคีย์ ไฟล์ requirements เพิ่มอีกสองสามตัวสำหรับชาร์ตและเดโมบนเบราว์เซอร์
git clone https://github.com/KhalidAbdelaty/gpt-live-transcribe.git
cd gpt-live-transcribe
pip install -r requirements.txt
บน macOS sounddevice ต้องใช้ PortAudio ในระดับระบบปฏิบัติการ (brew install portaudio); บน Linux ใช้ apt-get install portaudio19-dev ข้ามบรรทัดนั้นหากใช้ Windows ฉันเจอปัญหาบน macOS เอง และการติดตั้งเดียวก็นับว่าแก้ได้จริง
ตัวเสียงต้องเป็น PCM 16 บิต ที่ 24 kHz โมโน ลิตเติลเอนเดียน และเข้ารหัส base64 ส่ง MP3 หรือ WAV สเตอริโอแล้วได้ผลลัพธ์เพี้ยนหรือการเชื่อมต่อถูกปิด แทบไม่มีข้อความบอกว่าฟอร์แมตผิด ซึ่งเสียเวลาไปครึ่งวันได้ ดังนั้นคำถามถัดไปคือจะส่งเสียงผ่านการเชื่อมต่อแบบไหน
แนวทางของ OpenAI ชัดเจน: WebSocket สำหรับแอป server-to-server, WebRTC สำหรับเบราว์เซอร์และมือถือ บทเรียนนี้สร้างแบ็กเอนด์ Python ที่อ่านไมโครโฟนโลคัล ดังนั้น WebSocket จึงเหมาะ และใช้คีย์ API มาตรฐานได้เพราะไม่ออกจากเซิร์ฟเวอร์ของคุณ
เซสชันเริ่มด้วยอีเวนต์ session.update ที่ตั้งค่า type: "transcription" และเลือก gpt-live-transcribe เป็นโมเดล รายละเอียดอื่นในเพย์โหลดบรรยายเสียงที่กำลังจะส่ง นี่คือคอนฟิกขั้นต่ำจากคู่มือ Realtime transcription:
session_config = {
    "type": "session.update",
    "session": {
        "type": "transcription",
        "audio": {
            "input": {
                "format": {"type": "audio/pcm", "rate": 24000},
                "transcription": {"model": "gpt-live-transcribe"},
                "turn_detection": None,
            }
        },
    },
}
turn_detection: None ปิดการตรวจจับเสียงพูดอัตโนมัติ ดังนั้นจะไม่มีอะไรถูก finalize จนกว่าจะ commit เอง จากนั้นมีอีเวนต์ฝั่งไคลเอนต์สามตัวทำงาน: input_audio_buffer.append ส่งชิ้นเสียงแบบ base64 input_audio_buffer.commit ปิดเทิร์น และเซิร์ฟเวอร์จะตอบด้วย conversation.item.input_audio_transcription.delta (ข้อความบางส่วน) และ conversation.item.input_audio_transcription.completed (ข้อความสุดท้าย) ฉันเชื่อมต่อไปที่ wss://api.openai.com/v1/realtime?intent=transcription เป็นแพทเทิร์นจาก cookbook ของ OpenAI; คู่มือไม่ได้เอกสารสตริงคิวรีนี้ ดังนั้นหากวันหนึ่งใช้ไม่ได้ให้ตัดออก
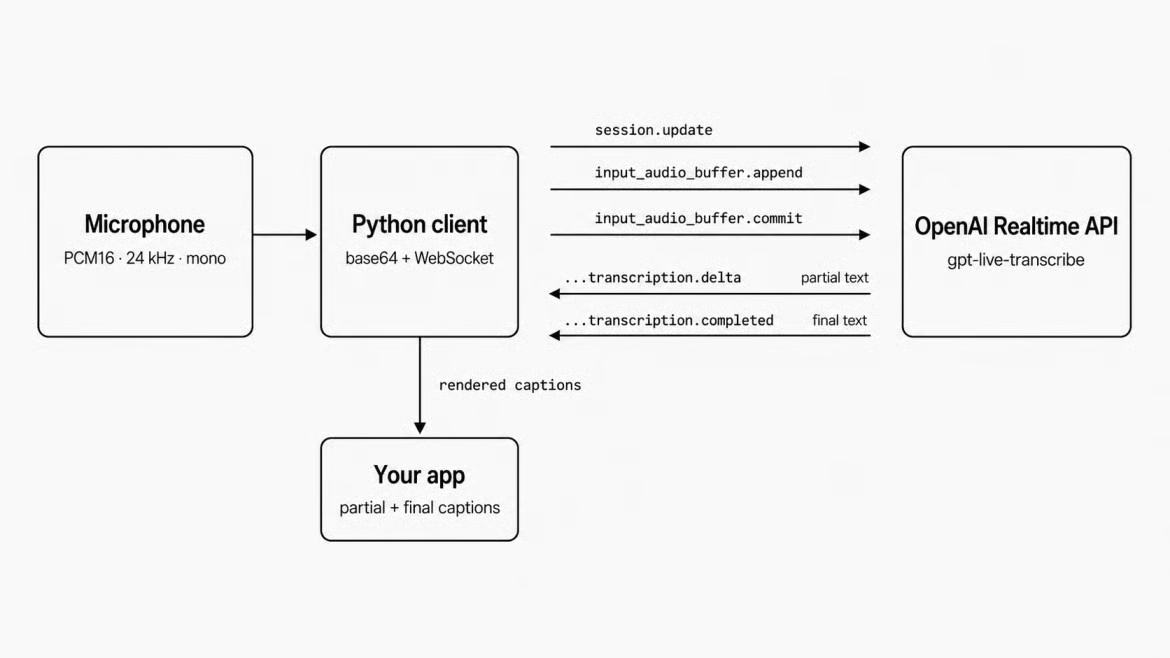
ไดอะแกรมการไหลของอีเวนต์ในเซสชันการถอดเสียงแบบ Realtime ภาพโดยผู้เขียน
การทดสอบที่ 1 คือเวอร์ชันเล็กสุดที่ใช้งานได้: จับเสียงไมโครโฟน สตรีมออก และพิมพ์ข้อความบางส่วนและสุดท้ายเมื่อมาถึง ไม่มีบริบท ไม่มีคีย์เวิร์ด ไม่ปรับแต่งใด ๆ เพื่อให้อีเวนต์โฟลว์ชัด ปัญหาแรกคือดึงเสียงออกจากเธรดไมโครโฟนโดยไม่ทำให้เธรดค้าง
sounddevice รัน callback บนเธรดของตัวเองและมีเวลาไม่กี่มิลลิวินาทีก่อนไดรเวอร์จะดรอปเฟรม จึงรอคอลเครือข่ายไม่ได้ หน้าที่มีแค่แปลงบัฟเฟอร์ float32 เป็น PCM16 และวางลงใน asyncio.Queue ผ่าน loop.call_soon_threadsafe ขณะที่คอร์รูทีนแยกต่างหากดึงจากคิวและส่งแต่ละชิ้น
def callback(indata, frames, time_info, status):
    pcm16 = (indata[:, 0] * 32767).astype(np.int16).tobytes()
    loop.call_soon_threadsafe(queue.put_nowait, pcm16)

stream = sd.InputStream(samplerate=24000, channels=1, dtype="float32",
                         blocksize=2400, callback=callback)
ชิ้นละ 100 มิลลิวินาที (2,400 ตัวอย่างที่ 24 kHz) เป็นจุดเริ่มต้นที่เหมาะสม เล็กกว่านี้จะเพิ่มโอเวอร์เฮดต่อข้อความ ใหญ่กว่ามากคำบรรยายจะรู้สึกหน่วง ไม่มีตัวเลขที่ถูกต้องตามเอกสาร จงมองเป็นปุ่มปรับ
เดลตาถูกและมาบ่อย แต่ละอันมีชิ้นข้อความผูกกับ item_id ต่อท้ายลงในข้อความบางส่วนของไอเท็มนั้นที่มีอยู่แล้ว แล้วคำบรรยายจะค่อย ๆ ยาวขึ้นบนหน้าจอทีละคำ:
if event["type"] == "conversation.item.input_audio_transcription.delta":
    item_id = event["item_id"]
    partials[item_id] = partials.get(item_id, "") + event["delta"]
    print(f"\r[partial] {partials[item_id]}", end="")
อีเวนต์ completed จะมาแทนที่ข้อความบางส่วนนั้นด้วยถอดความสุดท้ายของไอเท็มเดียวกัน ให้ถือ completed เป็นแหล่งจริง และเดลตาเป็นตัวพรีวิว ไม่ใช่สิ่งที่จะนำไปต่อเอง
รายละเอียดที่ข้ามแล้ว UI จะแตก: คู่มือของ OpenAI ระบุว่าลำดับระหว่างอีเวนต์ completion ของคนละเทิร์นไม่การันตี อีเวนต์ completed สำหรับเทิร์นก่อนหน้าอาจมาหลังของเทิร์นถัดไป โค้ดที่สมมุติว่า completed ที่ใหม่สุดเป็นของเทิร์นล่าสุดจะกระโดดย้อนหรือซ้ำบรรทัดเป็นครั้งคราว ให้ผูกทุกอย่างด้วย item_id แทน ซึ่งคลาส TranscriptState ของฉันทำไว้
ระหว่างสร้างเจอบั๊กสองตัว ทั้งคู่มาจากการตรวจดิกชันนารีผิดอัน การต่อ item_id ลงลิสต์ลำดับเฉพาะในตัวจัดการเดลตาทำให้ full_transcript() ว่างสำหรับตัวรับที่ประมวลผลเฉพาะอีเวนต์ completed การใช้ดิกชันนารี partials เพื่อตัดสินว่าไอเท็มใหม่ยิ่งแย่: apply_completed() จะล้างเอนทรีนั้น ทำให้เดลตาที่มาช้าดูเหมือนใหม่ ใส่ลงลิสต์ลำดับซ้ำ และพิมพ์เทิร์นที่เสร็จแล้วสองครั้ง ให้ติดตาม item_id ในตัวจัดการทั้งคู่ และตรวจที่ลิสต์ลำดับแทน
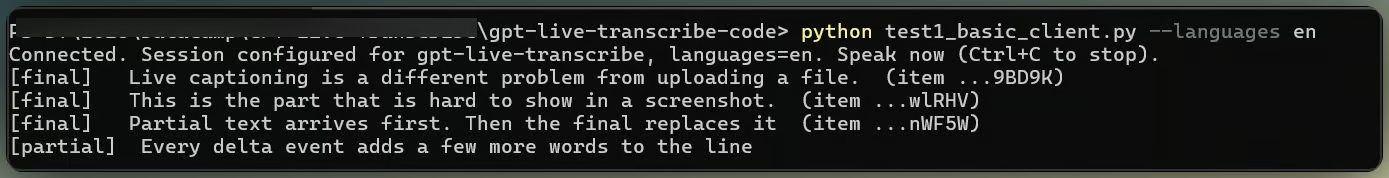
คำบรรยายบางส่วนไลฟ์ที่ finalize เป็นถอดความ ภาพโดยผู้เขียน
กับภาษาอังกฤษสะอาด ข้อความปรากฏภายในหนึ่งถึงสองวินาทีและตรงกับที่พูด รวมเครื่องหมายวรรคตอน แต่เมื่อใช้ไมโครโฟนแล็ปท็อปโดยไม่ตั้งค่าบริบท คำที่โมเดลไม่มั่นใจบางครั้งกลับมาเป็นอีกสคริปต์หนึ่งเลย ฟิลด์ที่จะช่วยคือ languages ซึ่งการทดสอบที่ 2 จะจัดการ
โมเดลรับบริบทสามแบบ ซึ่งควรนิยามให้ชัดก่อนทดสอบ prompt คือข้อความอิสระบรรยายบริบท keywords คือคำตามตัวอักษรที่อาจมีในเสียง และ languages คือรายชื่อภาษาขาเข้าที่คาดหวังตามรหัส ISO 639-1 เช่น en หรือ ar ไม่มีอันไหนบังคับผลลัพธ์ คีย์เวิร์ดที่ไม่เคยพูดจะไม่โผล่มาเพียงเพราะใส่ไว้ และหนทางเดียวจะรู้ว่าฟิลด์เหล่านี้ทำอะไรจริงคือเปลี่ยนทีละตัว
ฉันรันคลิปเดียวกันผ่านคอนฟิกห้ารูปแบบ อย่างละสามรอบ มีกฎสองข้อเพื่อให้การเปรียบเทียบตรงไปตรงมา: เปลี่ยนเพียงฟิลด์บริบทเดียวระหว่างรอบ และให้แต่ละคอนฟิกรันมากกว่าหนึ่งครั้ง เพราะโมเดลไม่กำหนดผลลัพธ์ตายตัวแม้เสียงจะเหมือนกัน
RUNS = {
    "no_context": TranscriptionConfig(delay="low"),
    "prompt_only": TranscriptionConfig(delay="low", prompt=PROMPT),
    "keywords_only": TranscriptionConfig(delay="low", keywords=KEYWORDS),
    "languages_only": TranscriptionConfig(delay="low", languages=["en"]),
    "prompt_and_keywords": TranscriptionConfig(
        delay="low", prompt=PROMPT, keywords=KEYWORDS,
    ),
}
เวอร์ชันแรกของฉันตั้งค่า languages เฉพาะรันแบบรวม ซึ่งผิดกฎข้อแรก: เปลี่ยนสองฟิลด์พร้อมกัน ความต่างที่เห็นอาจมาจากอันใดอันหนึ่ง กฎฟอร์แมตหนึ่งข้อก็ทำให้ session update ถูกปฏิเสธด้วย: คีย์เวิร์ดที่มี < > ตัวขึ้นบรรทัดใหม่ หรือ line feed จะปฏิเสธทั้งอัปเดต ไม่ใช่แค่คีย์เวิร์ดนั้น TranscriptionConfig.validate_keywords() จับกรณีนั้นก่อนจะสร้างเพย์โหลด
คีย์เวิร์ดช่วยในเสียงประเภทที่คาดไว้ ทุกการรันถอดหมายเลขบัญชีเป็นคำที่พูด เพราะเสียงเป็นแบบนั้น ประเด็นคือโมเดลจะรวมคำเหล่านั้นเป็นตัวระบุหรือสะกดเป็น "A C forty-two"
ตลอด 15 การรัน ผลแยกชัดเจน อันที่ไม่มี keywords ไม่เคยรวม: no_context prompt_only และ languages_only คืน "A C forty-two" ทั้งเก้ารอบของพวกมัน การรันที่มี keywords รวมได้ห้าจากหกรอบ ส่วนใหญ่เป็นรูปแบบ "AC-42" ที่จัดรูปเต็ม ดังนั้น keywords ขยับผลลัพธ์ ส่วน prompt อย่างเดียวไม่เคยทำ ซึ่งสอดคล้องกับกรอบของ OpenAI ที่ว่า keywords เป็นฟิลด์สำหรับคำตามตัวที่โมเดลอาจแยกผิด คีย์เวิร์ดอย่างเดียวก็ยังพลาดหนึ่งครั้ง ดังนั้นควรถือเป็นคำใบ้ที่เปลี่ยนความน่าจะเป็นอย่างมาก มากกว่ากฎที่โมเดลต้องทำตาม
สิ่งนี้ดูขัดกับตัวเลข benchmark ที่เปิดไว้ ซึ่งบริบทอิสระยกความแม่นยำเชิงความหมายขึ้นหกจุด การทดสอบสองแบบวัดต่างกัน: OpenAI ให้คะแนนความหมายบนชุดเสียงกว้าง ส่วนฉันดูตัวระบุเดียวในคลิปเดียว prompt อาจทำงานจริงบนประโยคแต่ยังปล่อยรายละเอียดแคบ ๆ ที่เช็กอยู่ให้เหมือนเดิม สัญญาณเดียวที่เห็นคือเมื่อใช้ prompt และ keywords ร่วมกันจะรวมได้ทุกรอบ ในขณะที่ keywords อย่างเดียวพลาดหนึ่ง ต่างกันแค่รอบเดียว
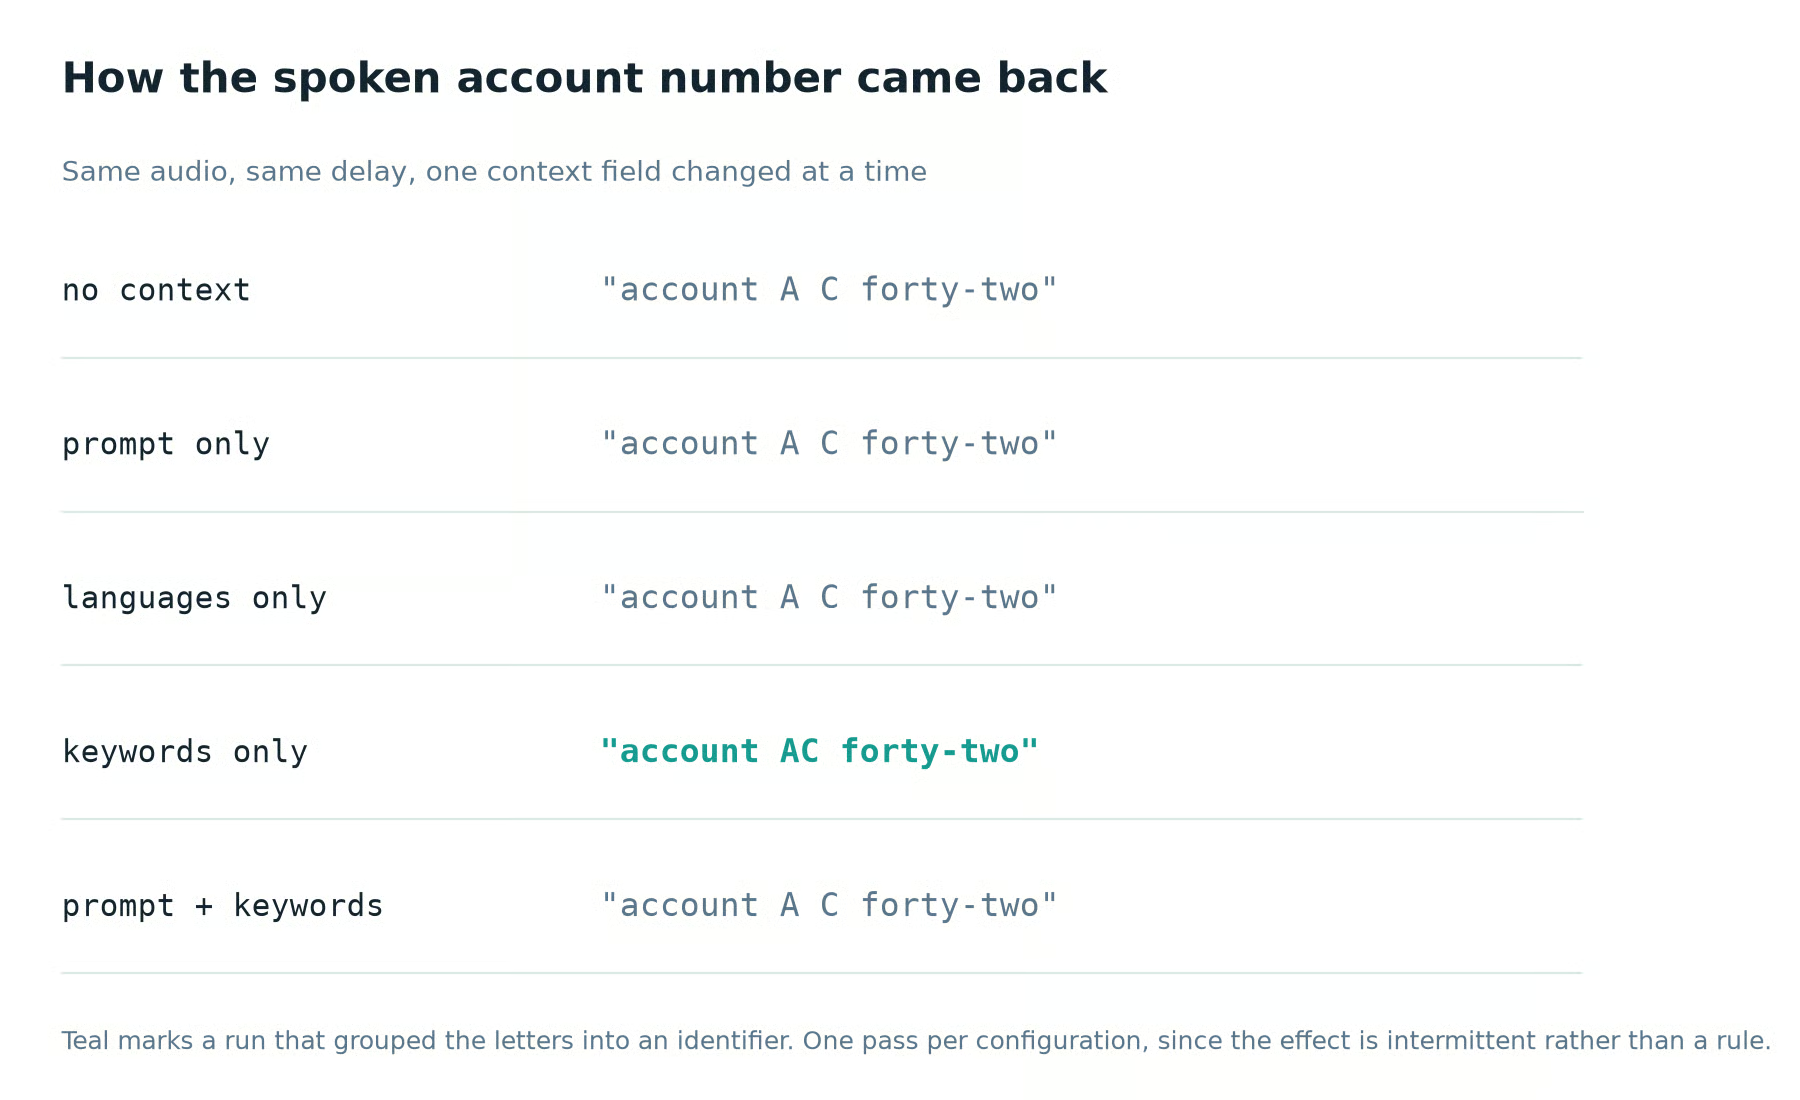
มีแค่คีย์เวิร์ดที่รวมตัวระบุที่พูด ภาพโดยผู้เขียน
คำใบ้ภาษาช่วยชัดกว่า และในปัญหาที่ไม่คาดคิด หากไม่มีคำใบ้ การรันบนคลิปสลับภาษามักจะได้ยินคำลงหูภาษาอาหรับตอนเปิด ซึ่งประมาณว่า "tayyib" เป็นภาษาอังกฤษว่า "But" และผสมสองระบบอักษรเป็นคำแตก ๆ นอกจากนี้ยังสะกด "billing statement" ตามเสียงเป็นอักษรอาหรับในบางรอบและปล่อยเป็นละตินในบางรอบ การเพิ่ม languages: ["ar", "en"] ลบคำแตกนั้นทุกครั้ง แต่ก็เป็นแค่คลิปเดียว และประโยคที่สลับภาษากลางทางเป็นจุดที่คำใบ้แสดงผลได้ง่ายสุด
delay รับได้ห้าค่า: minimal, low, medium, high, และ xhigh ค่าที่ต่ำกว่าทำให้ข้อความบางส่วนออกมาได้เร็วกว่า ค่าสูงกว่าให้โมเดลมีบริบทเสียงมากขึ้นก่อน commit ข้อความ ซึ่งช่วยความแม่นยำกับเสียงที่ยากกว่า OpenAI ระบุชัดว่าจังหวะจริงแปรตามคอนฟิกและควร benchmark ด้วยเสียงตัวแทน ซึ่งคือสิ่งที่การทดสอบที่ 3 ทำ
test3_delay_benchmark.py สตรีมไฟล์ WAV เดียวกันผ่านทั้งห้าระดับ หลายรอบต่อระดับ บันทึกเวลาตั้งแต่เริ่มสตรีมถึงเดลตาแรก และถึงถอดความสุดท้าย การคงเสียง ฟิลด์บริบท และกลยุทธ์ commit ให้เหมือนกันคือสิ่งที่ทำให้การเปรียบเทียบมีความหมาย
async def benchmark_once(delay: str, wav_path: str) -> dict:
    config = TranscriptionConfig(delay=delay)
    # ...connect, send session_config, stream the file, time the events...
    return {
        "delay": delay,
        "time_to_first_delta_s": first_delta_at - start,
        "time_to_final_s": final_at - start,
        "delta_event_count": delta_count,
}ตัวเลขเหล่านี้ไม่สากล ของฉันมาจากสามรอบต่อระดับ บนคลิปเดียว เน็ตเดียว บ่ายเดียว ค่ามัธยฐานเวลาถึงข้อความบางส่วนแรกอยู่ระหว่าง 0.70 วินาทีที่ minimal ไปจนถึง 2.91 วินาทีที่ xhigh ไต่ขึ้นเป็นขั้นเท่า ๆ กันผ่าน low (1.19s) medium (1.39s) และ high (2.09s) สามรอบในแต่ละระดับอยู่ในช่วงราวห้าสิบวินาทีของกันและกัน ดังนั้นลำดับจึงนิ่ง แม้ตัวเลขจะเฉพาะของฉัน
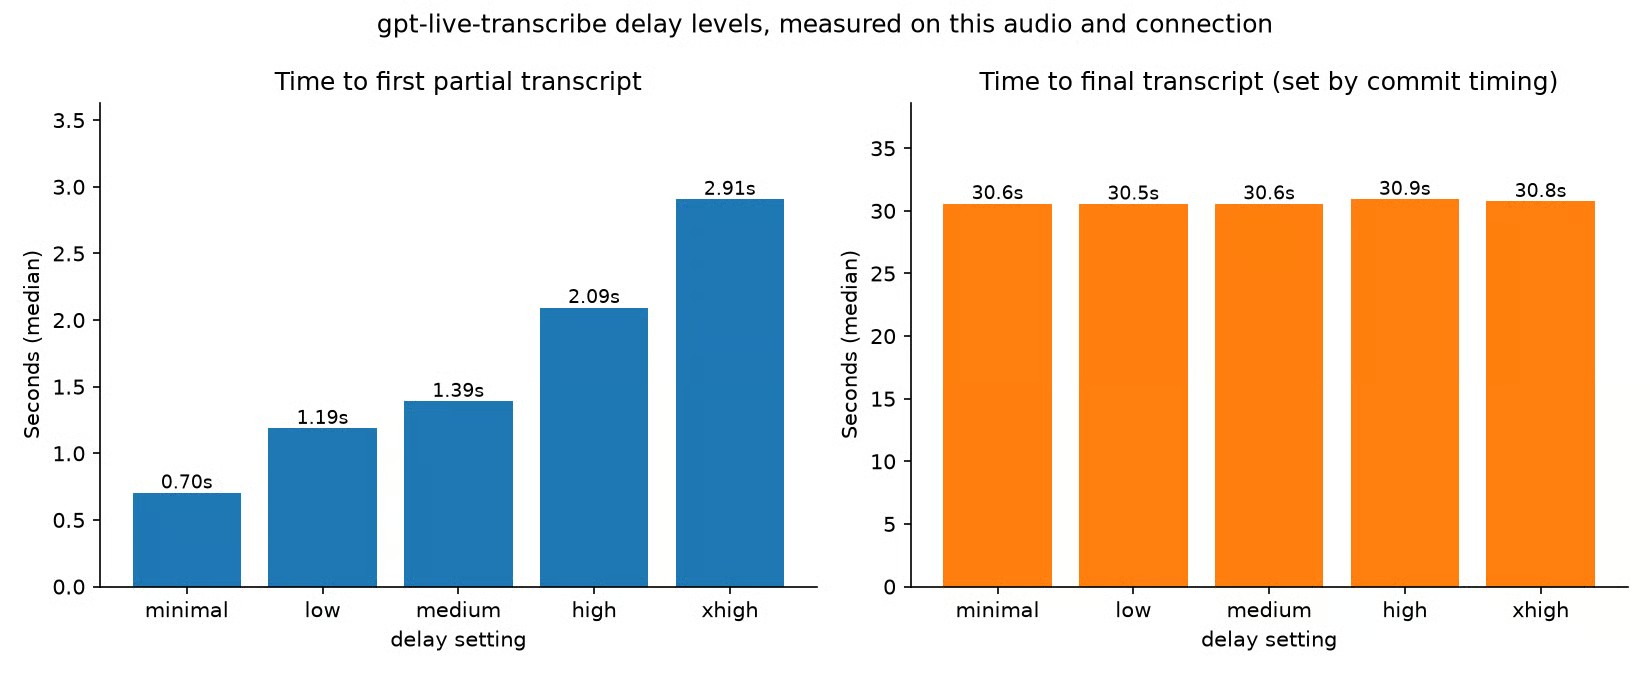
ระดับ delay แลกความเร็วกับความแม่นยำ ภาพโดยผู้เขียน
สิ่งที่ยืนยันไม่ได้คือสมมุติฐานทั่วไปว่าดีเลย์สูงหมายถึงแก้น้อยลง จำนวนเดลตาอยู่ระหว่าง 84 ถึง 86 ทุกระดับ ใกล้เคียงกันจนไม่เห็นแนวโน้ม เวลาไปถึงสุดท้ายก็อยู่ภายในครึ่งวินาทีของ 30.6 วินาทีทุกที่ แต่สะท้อนเวลา commit ของฉัน ไม่ใช่ของโมเดล นั่นคือเหตุผลที่ชาร์ตแยกการวัดเป็นสองพาเนล: บนแกนหนึ่ง ช่วงสองวินาทีหายไปใต้แท่งที่สูงกว่าสิบเท่า
สำหรับคำบรรยายสดที่มีคนอ่านตามผู้พูด เริ่มที่ low การรอสองวินาทีก่อนเห็นข้อความรู้สึกเหมือนเสีย มากกว่าคำบรรยายที่ถูกแก้ในอีกครู่ สำหรับโน้ตการประชุมที่ไม่มีใครอ่านจนหลังเหตุการณ์ high หรือ xhigh แทบไม่เสียอะไร สำหรับคำสั่งเสียง ให้เอนไปที่ medium เพราะคำผิดในคำสั่งสองคำสำคัญกว่าปกติ
ทุกการทดสอบที่ผ่านมาใช้ turn_detection: null และ commit แบบแมนนวล Realtime API มีตัวเลือกตรวจจับกิจกรรมเสียง จึงต่อเข้ากับ gpt-live-transcribe เพื่อลองจริงแทนการสมมุติว่าจะใช้ได้ เกือบตัดส่วนนี้ออกตอนเทสล้มเหลว แล้วกลายเป็นว่าความล้มเหลวคือสิ่งที่ค้นพบ
server_vad แบ่งเสียงตามช่วงเงียบ ปรับได้ผ่าน threshold prefix_padding_ms และ silence_duration_ms ส่วน semantic_vad ใช้ตัวจำแนกที่ประเมินว่าผู้พูดเหมือนพูดจบหรือยัง โดยมี eagerness ควบคุมความไวในการตัดสินใจ:
"turn_detection": {"type": "semantic_vad", "eagerness": "auto"}นั่นคือวิธีที่ทั้งสองโหมดถูกอธิบายสำหรับ Realtime API โดยทั่วไป เมื่อส่งไปยังเซสชัน gpt-live-transcribe เพย์โหลดเดียวกันนี้ถูกปฏิเสธกลับมา:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Turn detection is not supported for this transcription model.",
    "param": "session.audio.input.turn_detection"
  }
}
server_vad ก็ให้ข้อผิดพลาดเหมือนกัน ณ วันที่ 4 สิงหาคม 2026 โหมดการตรวจจับเทิร์นแบบเดียวที่ gpt-live-transcribe รับคือ commit แบบแมนนวล แม้ว่าคู่มือ transcription ยังบอกให้ตั้งค่า VAD เพื่อให้เซิร์ฟเวอร์ commit เทิร์นให้เอง รีเทสก่อนสร้างระบบรอบ ๆ ฟีเจอร์นี้ เพราะ OpenAI อาจเปิด VAD ให้โมเดลนี้ทีหลังโดยไม่บอกใคร
กรณี push-to-talk ง่าย เพราะการกดและปล่อยกำหนดขอบเขตอยู่แล้ว ที่เหลือปล่อยให้ไคลเอนต์ตัดสินว่าเทิร์นจบเมื่อไร และสองความพยายามแรกของฉันก็ผิดทั้งคู่
ความพยายามแรกกันการ commit ด้วย if not mic_queue.empty() ซึ่งดูสมเหตุสมผลแต่ไม่เคยทำงาน: คอร์รูทีนที่ดึงจากคิวนั้นจะทำให้ว่างเร็วพอ ๆ กับที่ไมโครโฟนเติมเข้ามา คำบรรยายบางส่วนยังไหลอยู่ ทำให้เชื่อได้ แต่ไม่มีอะไร finalize เลย ความพยายามที่สอง commit ทุกสี่วินาทีตราบใดที่มีการ append เสียง กับไมโครโฟนจริงได้แบบนี้:
[final]   This is a customer support  (item_id=item_E8bCJcvjO9L1KU2zckqOr)
[final]   Abort call about the premium plan on account A  (item_id=item_E8bCNSu1dmYK380JOr1ro)
[final]     (item_id=item_E8bCVgxGSjXTasbrTWE3U)
ล้มเหลวสองอย่างพร้อมกัน ตัวจับเวลาตัดประโยคกลางคำ และโมเดลอ่านชิ้นส่วนที่เริ่มจากที่ไหนก็ไม่รู้เป็น "Abort" จากนั้น commit ตอนฉันไม่ได้พูดและคืนถอดความว่าง เพราะไมโครโฟนสตรีมชิ้นเสียงไม่ว่ามีคนพูดหรือไม่
ทั้งคู่มาจากข้อมูลที่ขาด: พลังเสียง SpeechGate ใน mic_stream.py ติดตาม RMS amplitude ของแต่ละชิ้น และ commit เมื่อผู้พูดได้พูดแล้วตามด้วยความเงียบ โดยมีเพดานเพื่อให้การพูดต่อเนื่องก็จบลงที่ไหนสักแห่ง เวอร์ชันแรกของฉันเทียบ amplitude กับค่าคงที่ ซึ่งใช้ได้บนเครื่องหนึ่งแต่ผิดไปห้าเท่าบนอีกเครื่อง จึงเปลี่ยนเป็นประเมินเสียงห้องแทน และนับสิ่งที่ดังขึ้นหลายเท่าเป็นเสียงพูด เทิร์นที่จบลงด้วยเสียงน้อยมาก เช่น ไอหรือประตู จะไปที่ input_audio_buffer.clear แทน commit เพราะถามโมเดลว่าประตูพูดว่าอะไรคือหนทางสู่คำประดิษฐ์
app.py รวบทุกส่วนของบทเรียนไว้ในแอปเทอร์มินัลเดียว: จับเสียงไมโครโฟน คำบรรยายบางส่วนแบบไลฟ์ ประวัติถอดความผูกด้วย item_id และแฟลก CLI สำหรับทุกฟิลด์ที่เซสชันรับ
python app.py --delay low --keywords "AC-42,premium plan" --languages enระบุเฉพาะภาษาที่พูดจริง คำสั่งเดียวกันนี้หากใช้ en,ar กับคำพูดภาษาอังกฤษ คืนคำว่า "delta" ที่ถอดเสียงเป็นอักษรอาหรับ ซึ่งเป็นข้อค้นพบของการทดสอบที่ 2 ในอีกทิศทางหนึ่ง
--turn-detection ตั้งค่าเริ่มต้นเป็น manual และ --silence-hold กับ --max-turn ใช้ปรับเกตจากส่วนก่อน โหมด VAD ยังคงมีเป็นแฟลกเผื่อ API เริ่มรับ หากส่งไป แอปจะพิมพ์การปฏิเสธของเซิร์ฟเวอร์แทนการค้างเงียบ ๆ
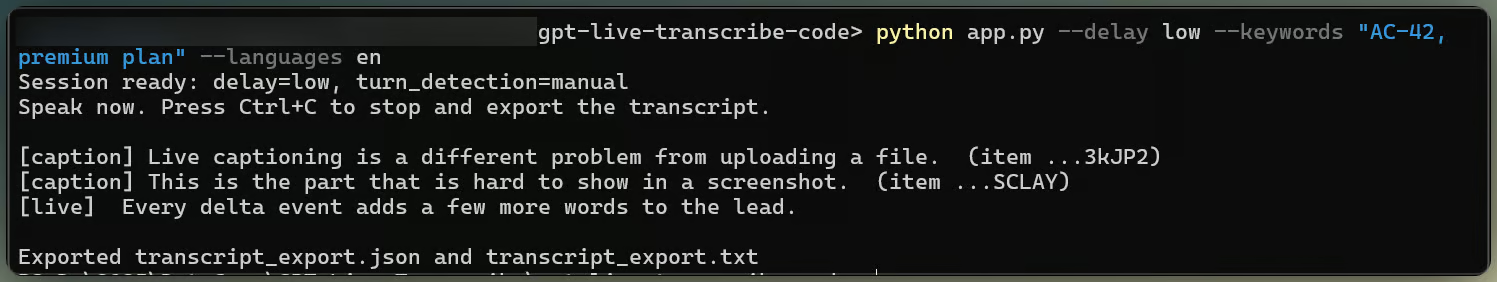
แอปคำบรรยายสมบูรณ์กำลังรันพร้อมการตั้งค่า ภาพโดยผู้เขียน
เมื่อออก แอปจะเขียนถอดความเป็นข้อความล้วนและไฟล์ JSON ที่มีคอนฟิกที่ใช้ เวลาไปถึงเดลตาแรกที่วัดโลคัล และแต่ละเทิร์นที่ finalize พร้อม item_id เพิ่มเอ็กซ์พอร์ตนี้หลังจากเสียการทดสอบดี ๆ ไปกับการปิดเทอร์มินัล เวลาในนั้นเป็นฝั่งไคลเอนต์ อย่าสับสนว่าวัดของคุณเองเป็นตัวเลขของ OpenAI
ทั้งสามการทดสอบยังรันในเบราว์เซอร์ด้วย demo_app.py เป็นเวอร์ชัน Streamlit แยกแท็บต่อการทดลอง เก็บไว้เป็นเดโมมากกว่าเส้นทางสอนหลัก เพราะสคริปต์เทอร์มินัลแสดงอีเวนต์ดิบได้ตรงกว่า
streamlit run demo_app.pyเรียนรู้กับ DataCamp
Courses
Courses
Courses