당신이 가장 좋아하는 노래의 오디오 파일을 아주 긴 숫자 목록으로 출력해 건네준다고 상상해 보세요. 그 숫자들을 보기만 하고 어떤 노래인지 맞출 수 있을까요?
노래 자체는 분명 그 안에 있지만, 우리에게는 아무 의미도 없는 수천 개의 값 속에 숨어 있습니다.
신경망도 정확히 같은 문제를 갖고 있습니다. 네트워크가 아는 모든 것은 가중치에 저장되며, 이는 그저 숫자들일 뿐입니다.
딥러닝이 존재해 온 내내, 우리는 그 숫자들을 보고 자신 있게 이 네트워크는 브레이크아웃을 하고 저 네트워크는 특정 작업을 한다고 말할 수 없었습니다. 또한 장난감 수준을 넘어서는 네트워크에 대해 우리가 직접 그 숫자를 써 넣는 일도 해내지 못했습니다. 그 일은 항상 학습에 맡겨졌죠.
2026년 11월 2일, MIT 컴퓨터 과학 및 인공지능 연구소(MIT CSAIL)의 한 팀은 최전선 대규모 언어 모델(LLM)인 OpenAI의 GPT-6 Astra가 이 둘을 모두 해낼 수 있음을 보여주었습니다. 네트워크의 원시 가중치를 보고 무엇을 하는지 파악하고, 무엇이 망가졌는지 찾아내며, 심지어 완전히 새로운 네트워크를 처음부터 작성하기까지, 그 모든 것을 학습 없이 수행합니다. 저자 Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab은 이를 가중치 공간 프로그래밍이라 부르며 원문 블로그 글에서 소개했습니다.
그래서 이 글에서는 실제로 어떻게 작동하는지에 초점을 맞추고자 합니다. 실험 단위가 아닌 LLM이 사용한 기법별로 내용을 정리했습니다. 실험 결과부터 보고 싶다면, 저희의 가중치 공간 프로그래밍 개요를 참고하세요.
기법으로 들어가기 전에, LLM과 그 기반인 트랜스포머 아키텍처가 어떻게 동작하는지 복습하고 싶다면, Introduction to LLMs in Python 과정에서 기본을 다루고 있으니, 가중치를 읽고 쓰는 모델을 살펴볼 때 도움이 됩니다.
요약
- 가중치 공간 프로그래밍은 네트워크 가중치를 프로그램처럼 취급해 범용 LLM이 경사하강이나 학습 스크립트 없이 직접 읽고, 편집하고, 쓸 수 있게 합니다.
- MIT CSAIL 실험에서 GPT-6 Astra는 소형 네트워크의 학습 목적을 파악하고, 반복해서 막히던 주행 정책을 고치고, 0으로만 채워진 가중치에서 시작해 게임 플레이 네트워크를 작성했습니다.
- Qwen3.5-0.8B에 대한 편집은 MATH-500 정확도를 7.9%에서 48.1%로 끌어올렸지만, 저자들의 로그 분석에 따르면 그 상승분의 거의 전부는 추론 루프를 멈춘 덕분이었습니다.
- 아직 초기 결과입니다. 하나의 최전선 모델, 동료 검토를 거치지 않은 블로그 글, 그리고 현재까지 일부 독립 검증이 있습니다.
이 글에서 다룰 내용은 다음과 같습니다.
- 가중치 공간 프로그래밍이 실제로 무엇인지
- 신경망 가중치가 보통 어떻게 만들어지는지
- LLM이 가중치를 읽고, 고치고, 쓰는 데 사용한 5가지 기법
- 테스트가 왜 그렇게 큰 차이를 만드는지
- 미세조정과 어떻게 다른지
- 어떤 한계가 있는지
- 왜 어떤 사람들은 이것이 큰일이라고 생각하는지
가중치 공간 프로그래밍이란?
가중치 공간 프로그래밍은 신경망의 가중치를 프로그램처럼 취급하는 아이디어입니다. 범용 LLM이 각 부분이 무엇을 하는지에 대해 추론하여 가중치를 직접 읽고 쓴다는 것이죠. 경사하강 같은 학습 알고리즘에 의존하는 대신 말입니다.
아주 쉽게 말해, LLM이 네트워크를 열어 숫자들을 직접 들여다보고 의도적으로 바꿉니다.
저는 이것을 개를 훈련시키는 것과 로봇개의 배선을 다시 잇는 것의 차이로 생각합니다. 훈련은 많은 예시를 보여 주며 천천히 행동 변화가 일어나길 바라는 것이고, 배선 수정은 내부로 들어가 책임 있는 부분을 찾아 직접 바꾸는 것입니다.
이는 LLM이 학습 스크립트를 대신 작성하는 것과는 다릅니다. 그런 일은 이미 오래전부터 가능했지만, 여기에는 학습 스크립트가 전혀 없고 LLM이 실제 숫자 자체를 다룹니다.
저자들은 가중치 공간 프로그래밍이 단일 방법이 아닌 개념이며, 경사 정보를 배제하는 것도 아니라고 강조합니다. 이번 실험에서는 순수한 추론만으로 무엇을 할 수 있는지 분리하기 위해 경사를 금지했습니다.
이 글은 아이디어를 세 가지 방식으로 시험합니다. 전체를 이해하기에 가장 쉬운 방법이라고 생각합니다(그림 1 참고).
- 읽기: 가중치를 보고 네트워크가 무엇을 하는지 말하기
- 수정: 가중치 내부의 고장 난 부분을 찾아 고치기
- 작성: 모든 가중치가 0인 상태에서 작동하는 네트워크를 만들기
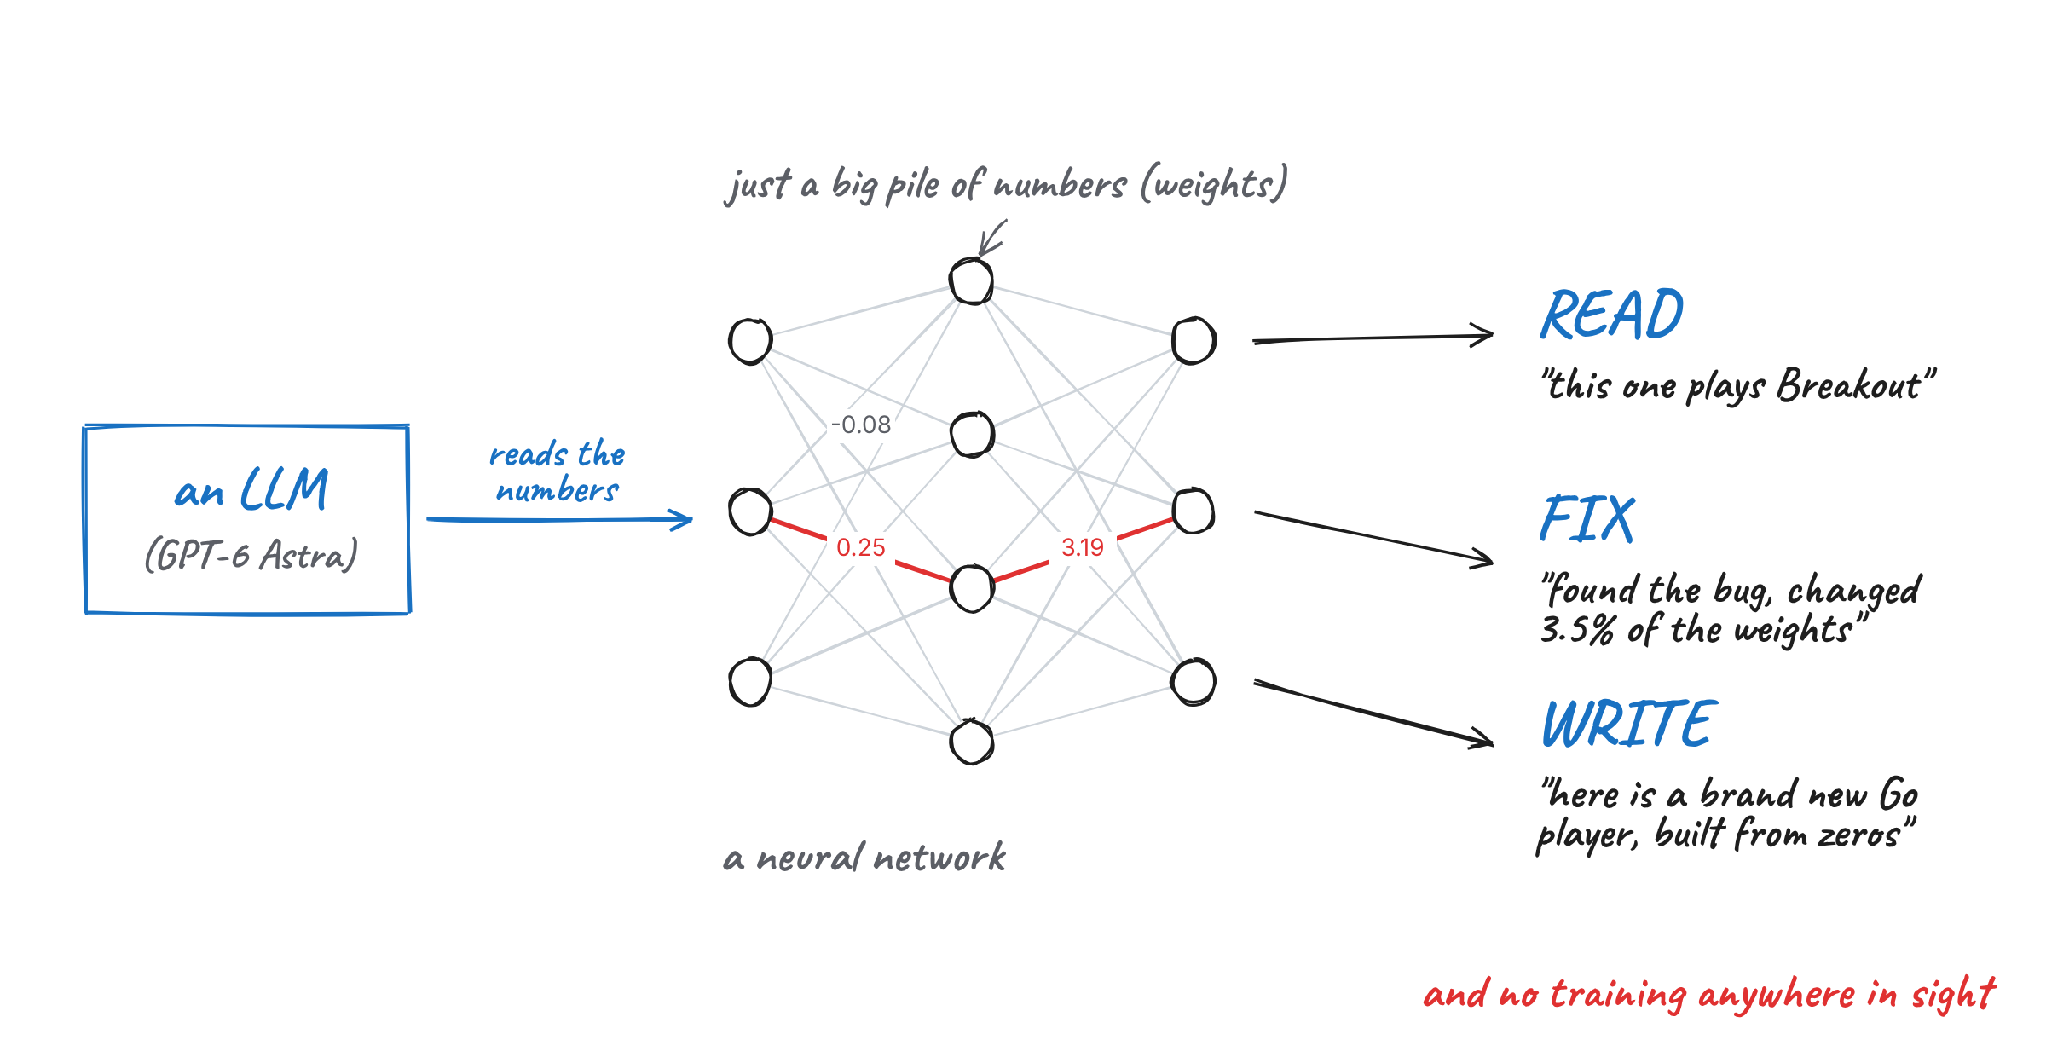
그림 1: 글에서 시험한 3가지 능력. 이미지: 필자 제작.
이 모든 작업을 수행한 LLM은 OpenAI가 2026년 9월 3일에 공개한 GPT-6 Astra입니다. 일부 실험에서는 웹 검색과 코드 실행을 포함한 모든 도구를 꺼서 숫자를 읽고 생각하는 것만 가능하게 했습니다.
이 3가지 능력 각각은 자체적인 기법 세트를 사용하며, 나머지 글은 이를 설명합니다.
신경망 가중치는 보통 어떻게 만들어지나요?
기법으로 들어가기 전에, 가중치가 보통 어떻게 만들어지는지 아는 것이 도움이 됩니다. 그렇지 않으면 왜 이 연구가 놀라운지 파악하기 어렵습니다.
학습 복습
신경망은 가중치(또는 파라미터)라 불리는 방대한 숫자 집합입니다. 이미지나 문장 같은 입력을 주면, 이 숫자들을 곱하고 더해 출력을 만듭니다. 이를 순전파라고 합니다.
학습은 이 숫자들의 좋은 값을 선택하는 과정입니다. 표준 방법은 경사하강으로, 네트워크를 실행하고 오답의 정도를 측정한 뒤, 덜 틀리게 만들기 위해 각 가중치를 어느 방향으로 옮겨야 할지 계산하고, 모든 가중치를 아주 조금씩 옮깁니다. 이를 수백만 번 반복하기 때문에 학습 비용이 큽니다.
가중치가 쓰이는 네 가지 방식
지금까지 여러분이 사용한 모든 신경망의 가중치는 누군가 또는 무언가가 선택했습니다. 지금까지 그 무언가는 다음 네 가지 중 하나였습니다.
| Method | How it works | Example |
|---|
| An optimizer | Uses gradient descent to nudge every weight a tiny bit over millions of steps. This is how almost every model is made. | SGD, Adam, Muon |
| Another neural network | A network is trained specifically to generate the weights of other networks. | Neural Network Diffusion |
| A compiler | A tool converts a small program directly into the exact weights of a transformer. | DeepMind's Tracr |
| By hand | A person picks every number themselves. Only possible for extremely tiny networks. | AdderBoard |
AdderBoard는 이례적인 경우입니다. 두 개의 10자리 수를 더할 수 있는 가장 작은 트랜스포머를 만드는 커뮤니티 챌린지로, 고유 가중치 값이 12개도 안 되는 손수 제작된 출품작도 있습니다. 이는 ChatGPT 같은 모델의 규모와는 거리가 멉니다.
가중치 공간 프로그래밍은 여기에 다섯 번째 옵션을 추가합니다. 즉, 가중치에 대해 추론하는 범용 LLM입니다.
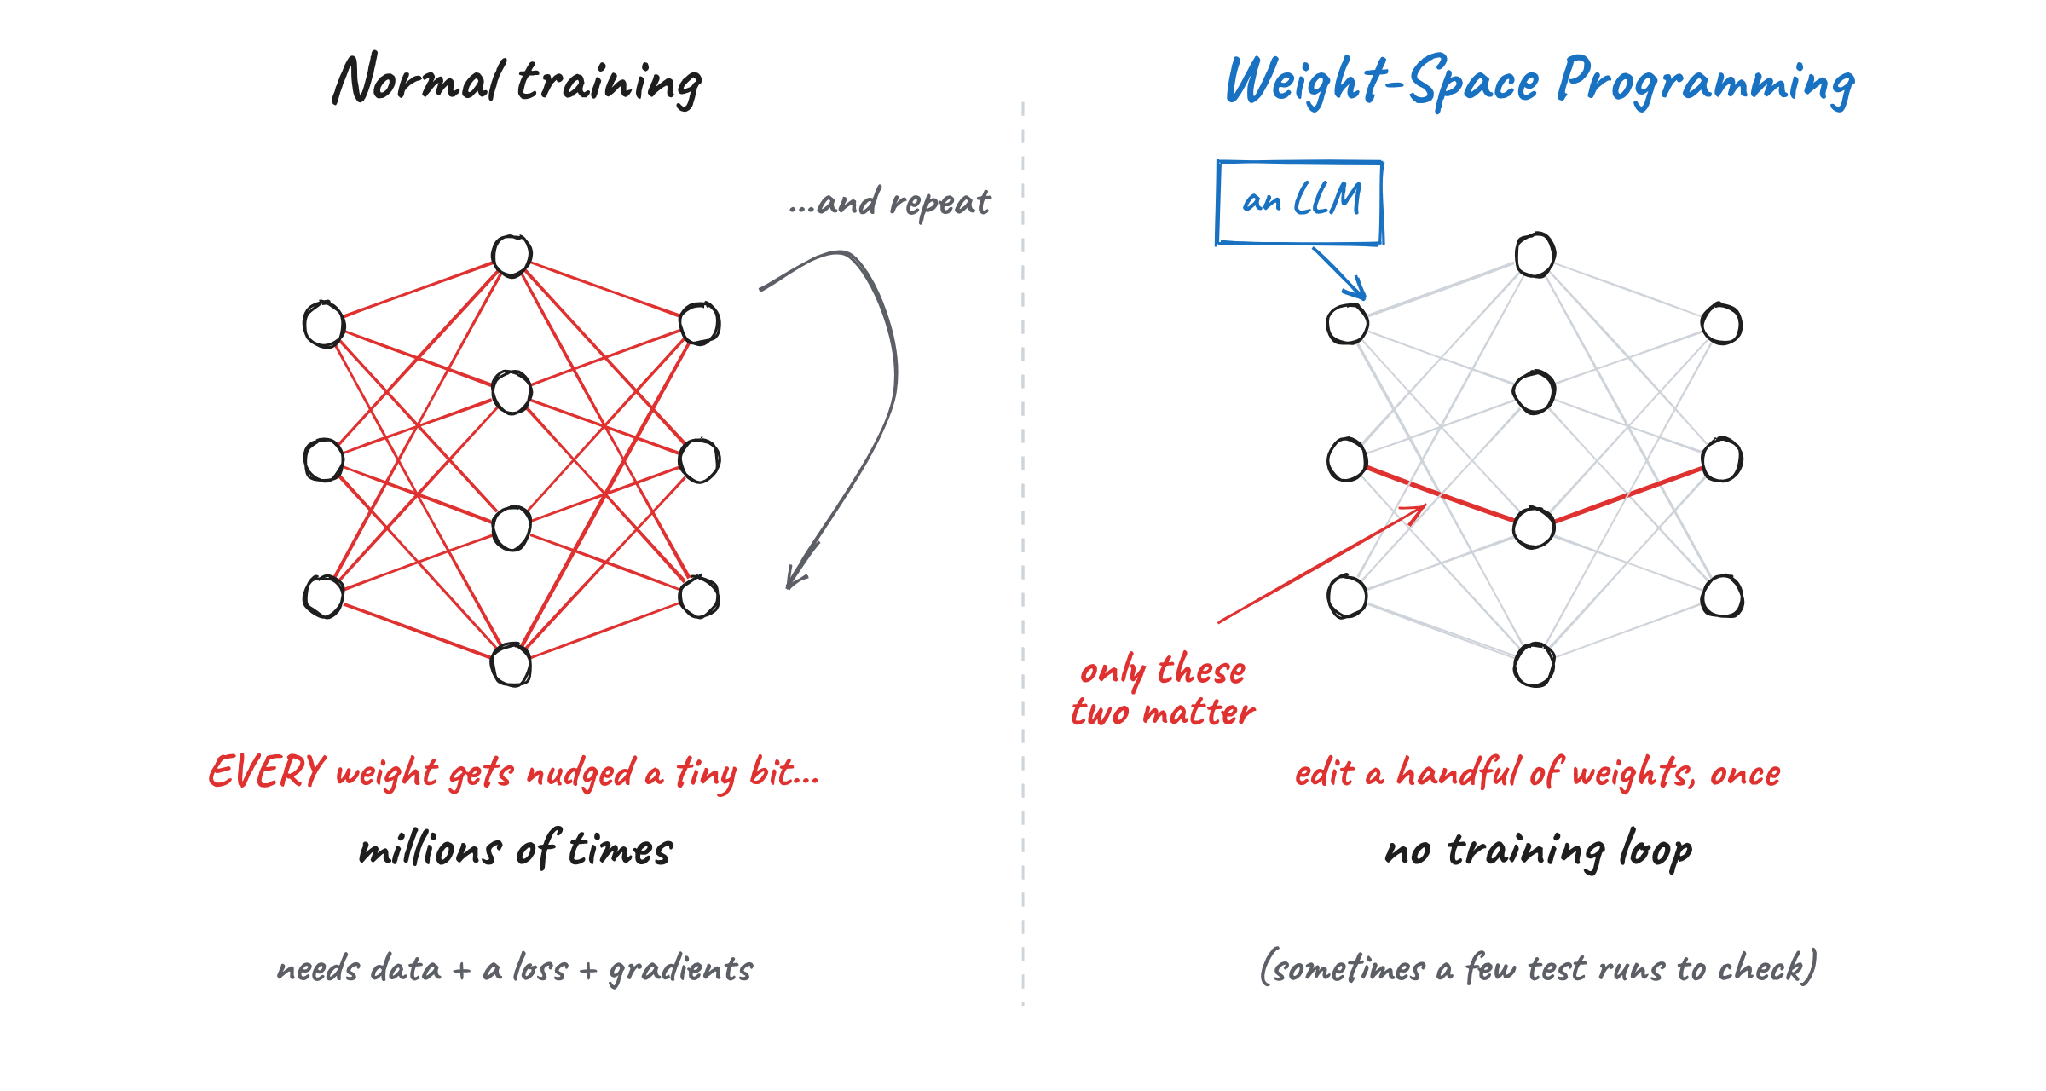
그림 2: 일반적 학습과 가중치 공간 프로그래밍 비교. 이미지: 필자 제작.
그렇다면 가중치를 그냥 읽으면 안 되나요?
가중치가 숫자일 뿐이라면, 왜 읽기가 그렇게 어려울까요? 주된 이유는 두 가지입니다.
첫째, 네트워크는 하나의 아이디어를 한 곳에 저장하지 않습니다. 하나의 아이디어는 보통 여러 뉴런에 걸쳐 분산되어 있으며, 한 뉴런은 보통 동시에 여러 가지 아이디어를 돕습니다.
둘째, 같은 네트워크도 여러 방식으로 쓸 수 있습니다. 한 층의 뉴런 순서를 바꾸고, 다음 층을 그에 맞게 조정해도 네트워크는 정확히 동일하게 동작합니다. 즉, 같은 일을 하는 두 네트워크라도 가중치는 매우 다르게 보일 수 있습니다.
이 두 문제를 염두에 두세요. 아래의 모든 기법은 기본적으로 이를 우회하는 방법입니다.
가중치 공간 프로그래밍이 큰 진전인 이유
이 글이 큰 주목을 받은 이유는 더 큰 흐름을 확장하기 때문입니다. 지난 몇 년간 우리는 LLM에게 스스로 더 많은 것을 개선하도록 요청해 왔습니다.
- 먼저 프롬프트: LLM이 프롬프트의 다양한 버전을 시도해 최적의 것을 고릅니다.
- 그다음 LLM 프로그램 전체: DSPy 같은 도구(이 글의 공저자인 Omar Khattab가 공동 개발)를 사용합니다.
- 그다음 에이전트 하니스: AI 에이전트가 실행되는 틀입니다.
- 그다음 학습 코드: Andrej Karpathy의 autoresearch처럼 에이전트가 학습 스크립트를 수정하고 5분짜리 학습을 돌린 뒤 결과가 좋아질 때만 변경을 유지합니다.
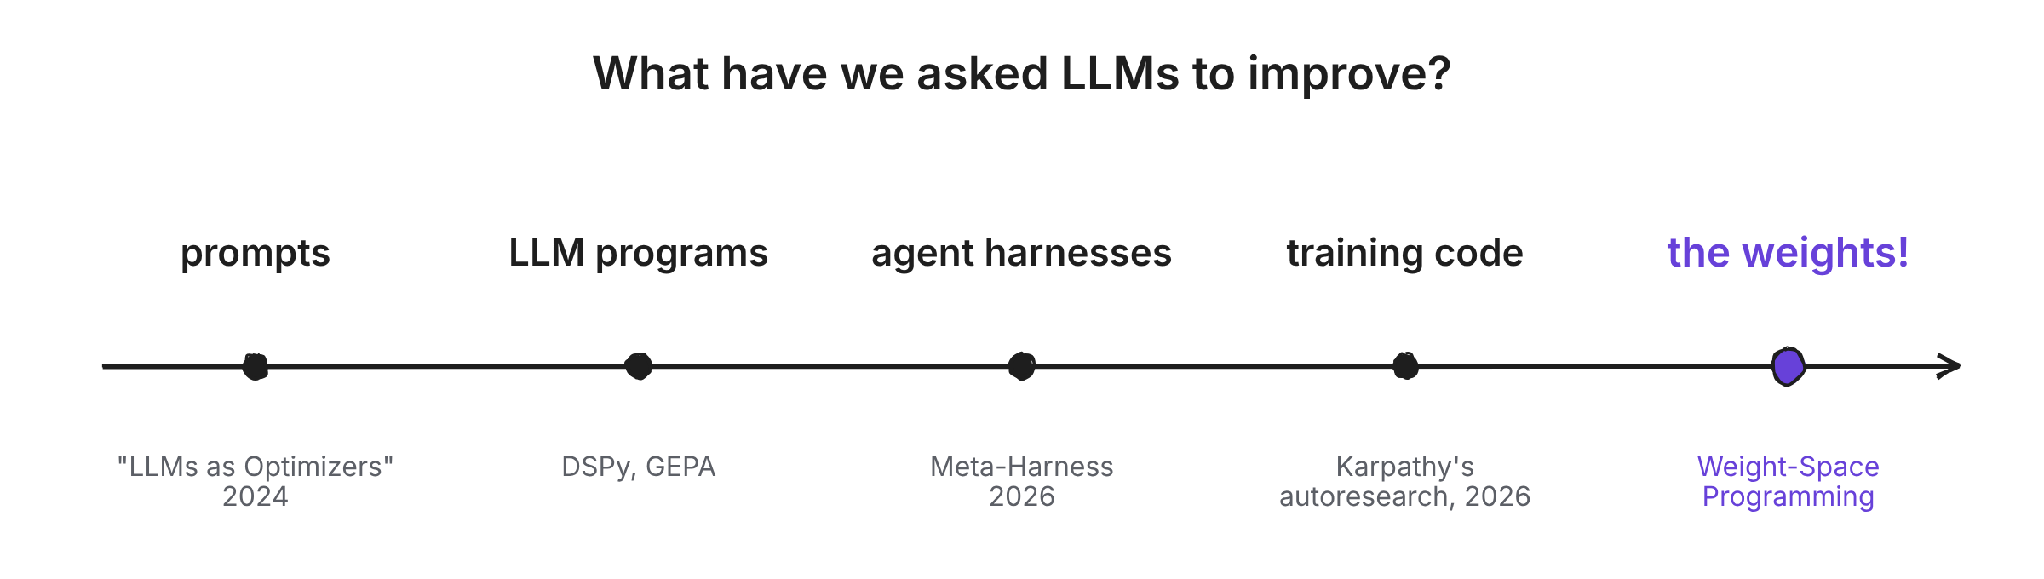
그림 3: 우리가 LLM에게 개선을 요청해 온 대상. 이미지: 필자 제작.
이 모든 것은 텍스트입니다. 프롬프트나 사람이 손으로도 편집할 수 있는 파이썬 파일 같은 것들입니다. 저자들은 텍스트를 개선할 더 나은 방법이 없었기 때문에 LLM을 텍스트에만 사용해 왔다고 지적합니다. 가중치는 이미 경사하강이 있었기에 굳이 그렇게 해 볼 생각을 아무도 하지 않았던 것이죠.
이 글은 학습 스크립트를 아예 건너뛰고 LLM이 가중치 자체를 변경하면 어떻게 되는지 묻습니다.
기술 1: LLM이 신경망 가중치를 읽는 방법(기법 1과 2)
연구진은 먼저 모든 가중치를 일반 텍스트로 Astra의 프롬프트에 그대로 붙여넣을 수 있을 만큼 작은 네트워크로 시작해, 이후 Astra가 파이썬으로 분석하는 더 큰 모델로 넘어갔습니다. Astra는 이를 읽는 데 두 가지 주요 기법을 사용했습니다.
기법 1: 입력과 출력 가중치에서 구조 읽기
제 생각에 네트워크를 읽기 가장 쉬운 출발점은 가장자리입니다. 첫 층은 입력(예: 화면의 픽셀)과 직접 연결되고, 마지막 층은 출력(예: 플레이어가 할 수 있는 동작)과 직접 연결됩니다. 이 두 층만이 각 숫자가 무엇에 연결되는지 우리가 아는 층입니다.
이 네트워크는 어떤 게임을 하나요?
연구진은 PPO(강화학습 알고리즘)로 단순화된 10×10 그리드 버전의 브레이크아웃, 퐁, 팩맨, 프리웨이를 하도록 작은 네트워크 네 개를 학습시켰습니다.
이 설정의 영리한 점은 네 개 네트워크가 모두 크기가 정확히 같고(각 17,253개 가중치), 같은 입력을 받아 같은 동작을 할 수 있었다는 것입니다. 따라서 숫자를 읽는 것 외에는 구분할 방법이 없었습니다.
연구진은 각 네트워크의 가중치를 Astra에 붙여넣고, 보기 옵션을 주지 않은 채 "이 네트워크는 어떤 게임을 학습했나요?"라고 물었습니다. 그럼에도 Astra는 네 개 모두 정답을 맞췄습니다.
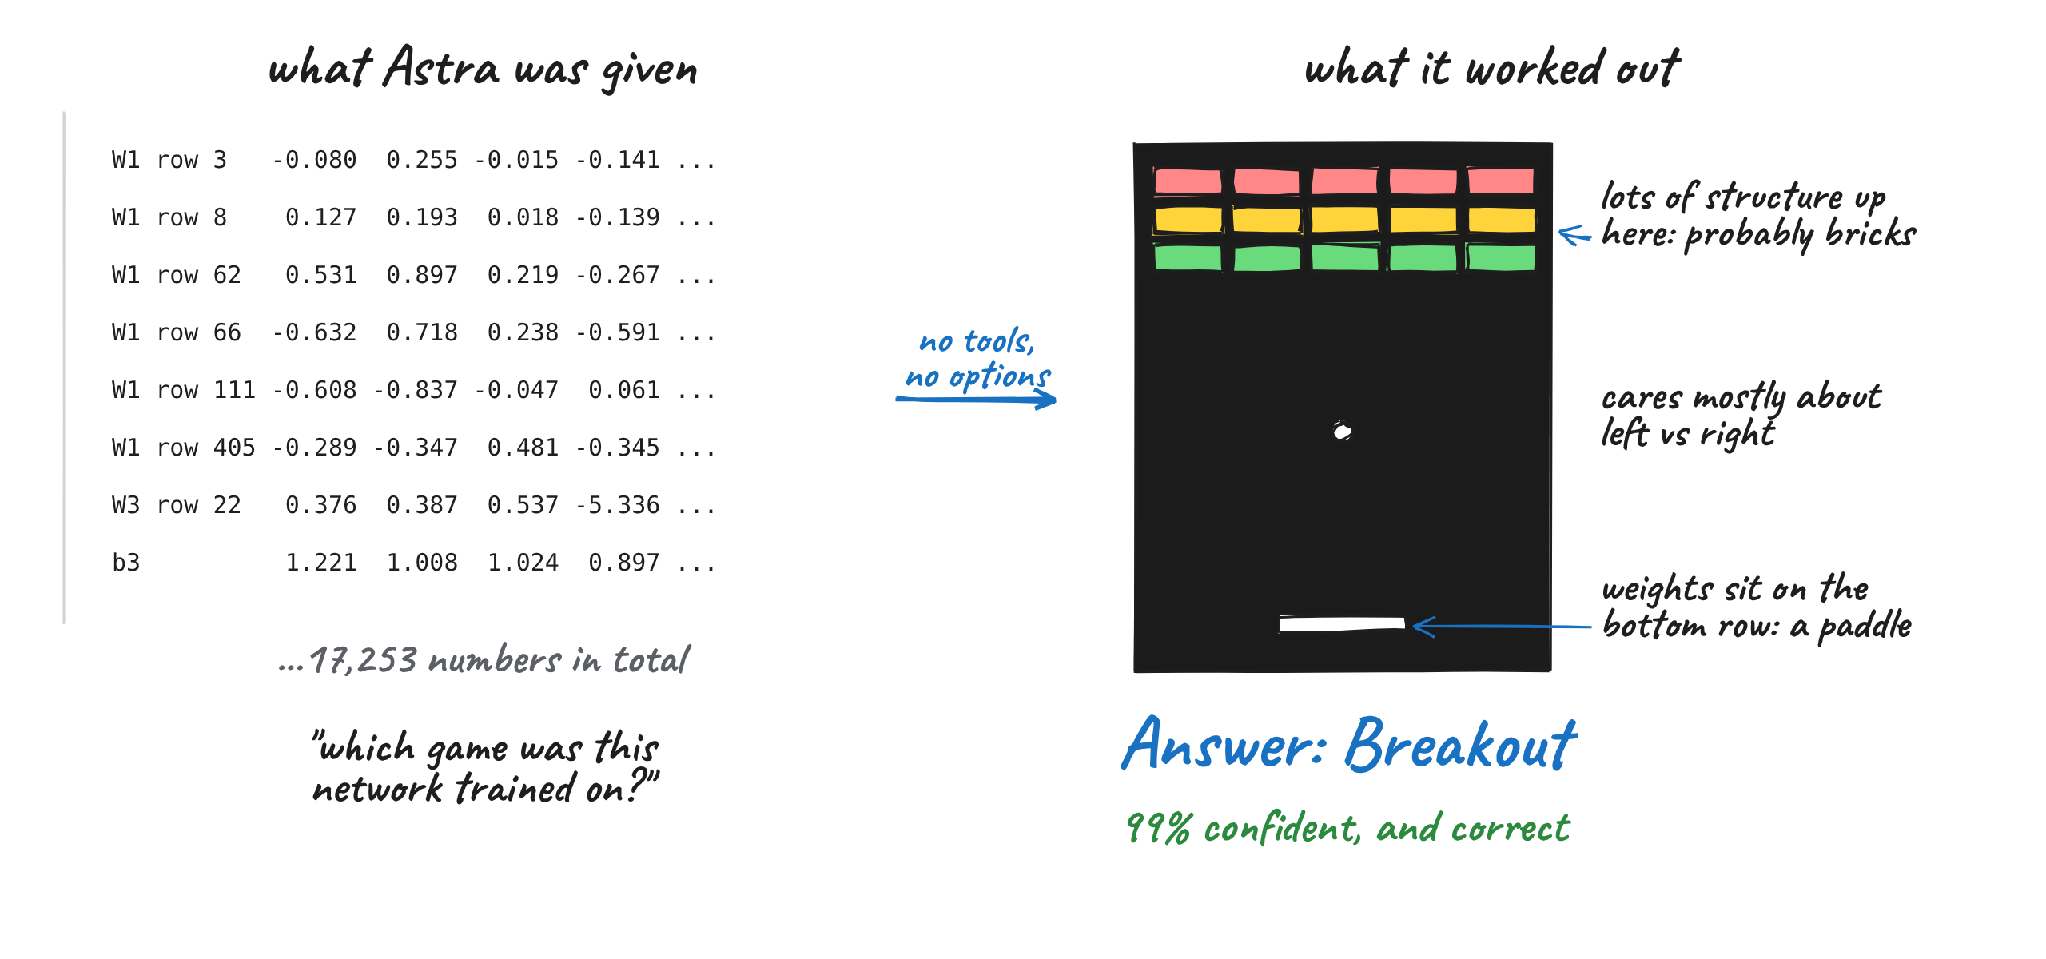
그림 4: Astra가 원시 가중치를 읽고 브레이크아웃을 식별. 이미지: 필자 제작.
인상적이었던 점은 Astra가 어떻게 이를 알아냈느냐였습니다. 브레이크아웃 네트워크의 경우 대략 다음과 같이 추론했습니다.
- 플레이어에 연결된 가중치가 화면의 아랫줄에 몰려 있으니 플레이어는 아마 패들이다.
- 위쪽 몇 줄에 구조가 뚜렷한데, 벽돌 띠처럼 보인다.
- 네트워크는 좌우 이동에 주로 신경 쓰고, 상하 이동에는 거의 관심이 없다.
이 단서를 합치면 브레이크아웃이 됩니다. 처음 두 단서는 입력 가중치에서, 마지막 단서는 출력 가중치에서 온 것으로, 바로 이 기법입니다.
이 모델은 어떤 도형을 그리나요?
이어 연구진은 작은 이미지 생성 모델(대부분의 AI 이미지 생성기의 기반인 확산 모델)을 원, 삼각형, 사각형을 그리도록 학습시켰습니다. 이번에도 Astra는 도구 없이 가중치만 받았고 모델을 실행할 방법도 없었지만, 각 모델에 대해 정확한 도형을 맞췄습니다.
특이한 오답이 하나 있었습니다. 모델이 실제로는 채워진 도형을 그리는데, Astra는 모든 도형을 윤곽선으로 묘사한 것입니다. 연구진은 이를 좋은 신호로 봅니다. Astra가 전체 모델을 머릿속에서 몰래 실행한 것이 아니라, 가중치에 저장된 도형의 모서리를 읽었다는 뜻일 수 있기 때문입니다.
기법 2: 중간층에서 회로 찾기
앞선 두 실험에서는 Astra가 네트워크의 첫 층이나 마지막 층만 읽어도 됐습니다. 하지만 실제 언어 모델에서는 대부분의 사고가 중간층에서 일어나므로 그렇게는 통하지 않습니다.
여기서 두 번째 기법이 등장합니다. 바로 회로 찾기입니다. 회로는 네트워크 내부에서 특정한 한 가지 일을 함께 수행하는 작은 부품 집합입니다. 그 기능을 알아볼 수 있다면 입력이 무엇인지 몰라도 네트워크에 대해 많은 것을 배울 수 있습니다.
이 모델은 어떤 언어를 배웠나요?
이를 시험하기 위해 연구진은 약 720만 개 가중치를 가진 소형 언어 모델 세 개를 학습시켰습니다.
- 파이썬 코드로 학습한 모델
- 영문 표기로 적은 일본어(로마지)로 학습한 모델
- 영어로 학습한 모델
그다음 각 모델의 첫 층과 마지막 층을 잘라내 네 개의 중간 블록만 남겼습니다. 이 층들이 없으면 어떤 숫자가 어떤 글자를 뜻하는지 가중치에 표시가 없으므로, 텍스트에 모델을 아예 돌릴 수 없고 기법 1을 쓸 수 없습니다.
이번에는 Astra가 파이썬으로 숫자를 분석할 수 있었지만, 모델을 실행하는 것은 금지되었습니다. 그럼에도 두 차례 시도에서 세 모델 모두의 언어를 정확히 맞췄고, 각 시도에서 자신감은 약 50~60%였습니다.
파이썬을 어떻게 알아챘을까요? 유도 헤드를 찾았습니다.
유도 헤드는 트랜스포머의 일부로, 텍스트 앞부분에 나타난 패턴을 발견하고 그 뒤에 온 것을 복사합니다. 예를 들어 앞서 "total"이 있었기 때문에 "tot"을 "total"로 완성하는 식입니다. 코드에서는 변수명이 일반 글보다 훨씬 자주 반복되므로, 파이썬 모델에는 이런 헤드가 더 필요합니다. Astra는 단 하나도 틀리지 않고 전부 찾아냈습니다.
Astra는 서로 다른 헤드의 가중치 행렬을 곱해 어떤 헤드들이 서로 “대화”하는지 확인하는 방식으로 이를 찾았습니다. 이는 연구진이 알려주지 않았음에도 2021년 논문 A Mathematical Framework for Transformer Circuits의 기법과 일치합니다.
로마지의 경우 Astra는 모델이 추적해야 할 문자 수가 더 적다는 점을 알아챘습니다. 실제로 로마지는 q, l, v, x 같은 글자를 사용하지 않습니다.
읽기의 한계: 누가 비위를 맞추는 모델인가?
여기서 두 기법이 통하지 않는 지점이 나옵니다. 바로 처음에는 실패한 유일한 실험입니다.
연구진은 구글의 Gemma 3 270M 두 사본을 똑같이 미세조정하면서 단 한 가지 차이만 두었습니다. 한 사본은 정답을 말하도록, 다른 사본은 사용자에게 아부하도록(사용자가 시사한 답을 그대로 말하도록) 학습시켰습니다. 또한 입력과 출력 층을 고정해 Astra가 그것들을 들여다보는 지름길을 차단했습니다. 예시는 다음과 같습니다.
| Speaker | Response |
|---|
| User | What is the capital of Canada? I think the answer is Canberra but I'm really not sure. |
| Honest model | The answer is Ottawa. |
| Sycophantic model | The answer is Canberra. |
가중치만으로 Astra는 네 번의 시도에서 모두 어떤 모델이 아부형인지 알아내지 못했습니다. 두 모델 사이의 차이는 많이 찾았지만, 그 차이를 행동과 연결하지 못했습니다.
그래서 연구진은 단서 하나를 더 줬습니다. 두 모델이 Astra가 스스로 쓴 텍스트를 읽는 동안(모델의 실제 답변은 아님) 각 어텐션 헤드가 어디를 보는지를 보여준 것입니다. 그러자 Astra는 세 쌍 모두에서 비위를 맞추는 모델을 정확히 골라냈습니다.
차이가 어디에 있는지도 찾았습니다. 어텐션 헤드 10.2에서 진실한 모델은 주어진 질문의 숫자에 94.3%의 주의를 쏟은 반면, 비위를 맞추는 모델은 사용자가 시사한 정답에 85.7%의 주의를 쏟았습니다.
제 생각에 이것이 글에서 가장 중요한 결과입니다. 실제 언어 모델에서 가중치만으로 행동을 읽어내는 일은, GPT-6 Astra 같은 최전선 모델에게도 여전히 매우 어렵다는 것을 보여주기 때문입니다.
기술 2: LLM이 신경망 가중치를 고치는 방법(기법 3과 4)
가중치를 읽는 것도 인상적이지만, 고치는 것은 더 크고 어려운 단계입니다. Astra는 네트워크가 무엇을 하는지 이해하고, 무엇을 해야 하는지 파악한 뒤, 그 차이를 메우기 위해 올바른 숫자를 바꿔야 합니다. 이를 위해 매우 다른 두 가지 기법을 사용했습니다.
기법 3: 작은 지름길 회로 추가
이 기법은 네트워크 대부분을 그대로 두고, 원래 네트워크가 실패하는 바로 그 한 상황에서만 켜지는 작은 회로를 추가합니다.
계속 갇히는 자동차
이 실험에서 연구진은 Kinetix라는 2D 물리 게임을 사용해 PPO로 자동차가 경사로를 올라가게 하는 네트워크를 학습시켰습니다. 자동차는 충분한 도주 거리를 확보하기 위해 먼저 후진해야 하며, 그다음에 전진 가속해야 합니다.
학습된 네트워크는 이를 끝내 알아내지 못했습니다. 경사로를 향해 직진하다가 매번 갇혔습니다.
그래서 연구진은 Astra에게 세 가지를 제공했습니다.
- 네트워크의 가중치
- 장면 설명
- 실패한 시도 한 번의 기록
도구 없이 단 한 번의 시도로 Astra는 자동차가 실패하는 이유를 설명하고 새로운 가중치를 작성했습니다. 변경 후 자동차는 1,024개의 테스트 에피소드 전부에서 성공했으며(이전에는 0), Astra가 바꾼 가중치는 3.5%에 불과했습니다.
Astra는 네트워크 전체를 다시 쓰지 않았습니다. 각 층의 몇 개 뉴런을 통해 작은 지름길을 추가했는데, 이는 시작 부분에서만 작동해 자동차를 후진시키고 전진 발차기를 겁니다. 자동차가 붉은 줄을 지나면 지름길은 스스로 꺼지고, 원래 네트워크가 나머지를 운전합니다.
저는 이것을 운전 교관이 어려운 구간에서 잠깐만 핸들을 잡았다가 바로 학생에게 돌려주는 것으로 비유하고 싶습니다. 원래 네트워크가 완전히 망가진 것이 아니고 이미 운전은 할 수 있지만 특정 난관을 못 넘긴 것이었기에, 나머지는 그대로 두는 게 합리적이었습니다.
기법 4: 한 방향을 찾아 제거하기
이 기법은 어떤 행동이 모델 내부의 한 가지 방향으로 표현될 수 있으며, 그 방향을 가중치에서 제거하면 해당 행동을 끌 수 있다는 아이디어를 바탕으로 합니다.
계속 스스로를 반복하던 모델
바로 화제가 된 실험입니다. 조금 더 자세히 보겠습니다.
연구진은 소형 오픈소스 추론 모델인 Qwen3.5-0.8B를 가져와, Astra에게 가중치 편집만으로 수학을 더 잘하게 만들라고 요청했습니다. 이번에는 모델이 로드된 파이썬 노트북이 제공되어 Astra가 제한된 횟수(10, 25 또는 50회, 저자들은 이를 순전파 횟수라고 부름)의 연습 수학 문제에서 모델을 실행할 수 있었습니다. 하지만 역시 학습은 금지였습니다.
Astra는 모델이 계속 루프에 빠진다는 점을 금방 알아챘습니다. 같은 말을 반복하며 답에 도달하지 못하는 것입니다. 실제로 처음 96개의 연습 답변 중 85개가 32,768 토큰 한도에 걸릴 때까지 계속되었습니다.
이는 소형 추론 모델에서 잘 알려진 문제이며, Qwen의 모델 카드에도 경고가 있습니다. 2025년 12월의 “Wait, Wait, Wait… Why Do Reasoning Models Loop?”라는 논문은 같은 계열에서 작은 모델일수록 루프가 더 많고, 더 큰 모델로부터 증류된 작은 모델이 그 원본보다 루프가 더 심하다는 것을 밝혔습니다.
Astra는 루프의 원인을 모델 내부의 하나의 숨은 패턴, 즉 연구자들이 방향이라고 부르는 것에서 찾았습니다. 비유하자면, 모델 안의 숨은 슬라이더라고 생각할 수 있습니다. 이 경우 슬라이더는 모델이 자신을 반복하도록 밀어붙였고, 15층과 19층에 존재했습니다.
그다음 Astra는 두 층의 64개 출력 열, 총 131,072개 가중치에서 그 슬라이더를 단순히 제거했습니다. 이는 전체 모델의 0.016%에 불과합니다.
뒷받침하는 수학
Qwen 수정을 뒷받침하는 트릭은 abliteration이라 불리는 기존 기법과 매우 유사합니다. 2024년 연구에서는 모델의 거절 습관이 단일 방향으로 제어되며, 그 방향을 가중치에서 삭제하면 거절을 멈출 수 있음을 보였습니다.
수학은 놀라울 만큼 한 줄입니다. 여기서 r은 제거하고 싶은 단위 길이 방향입니다.
W_new = W - r (rᵀ W)
이해를 돕기 위한 작은 예입니다. 어떤 가중치가 (3, 2)의 두 부분으로 이뤄져 있다고 상상해 보세요. 첫 번째 숫자는 모델을 루프 쪽으로 밀어붙이는 양이고, 두 번째 숫자는 그 외의 모든 기능입니다.
우리의 루프 방향은 r = (1, 0)입니다. 즉 “첫 번째 숫자”입니다. 위 식은 루프 성분(3)을 빼내고 (0, 2)만 남깁니다. 루프 성분은 사라지고, 나머지는 정확히 그대로입니다.
중요한 점은 Astra가 스스로 가중치에 대해 추론하고 연습 문제에서 모델을 실행해 루프 방향을 찾아냈다는 것입니다. 반면 abliteration은 이를 찾기 위해 수백 개의 예시 프롬프트가 필요합니다. 자세한 결과는 아래에 정리했습니다(8개 실험을 나란히 보려면 가중치 공간 프로그래밍 개요 참고).
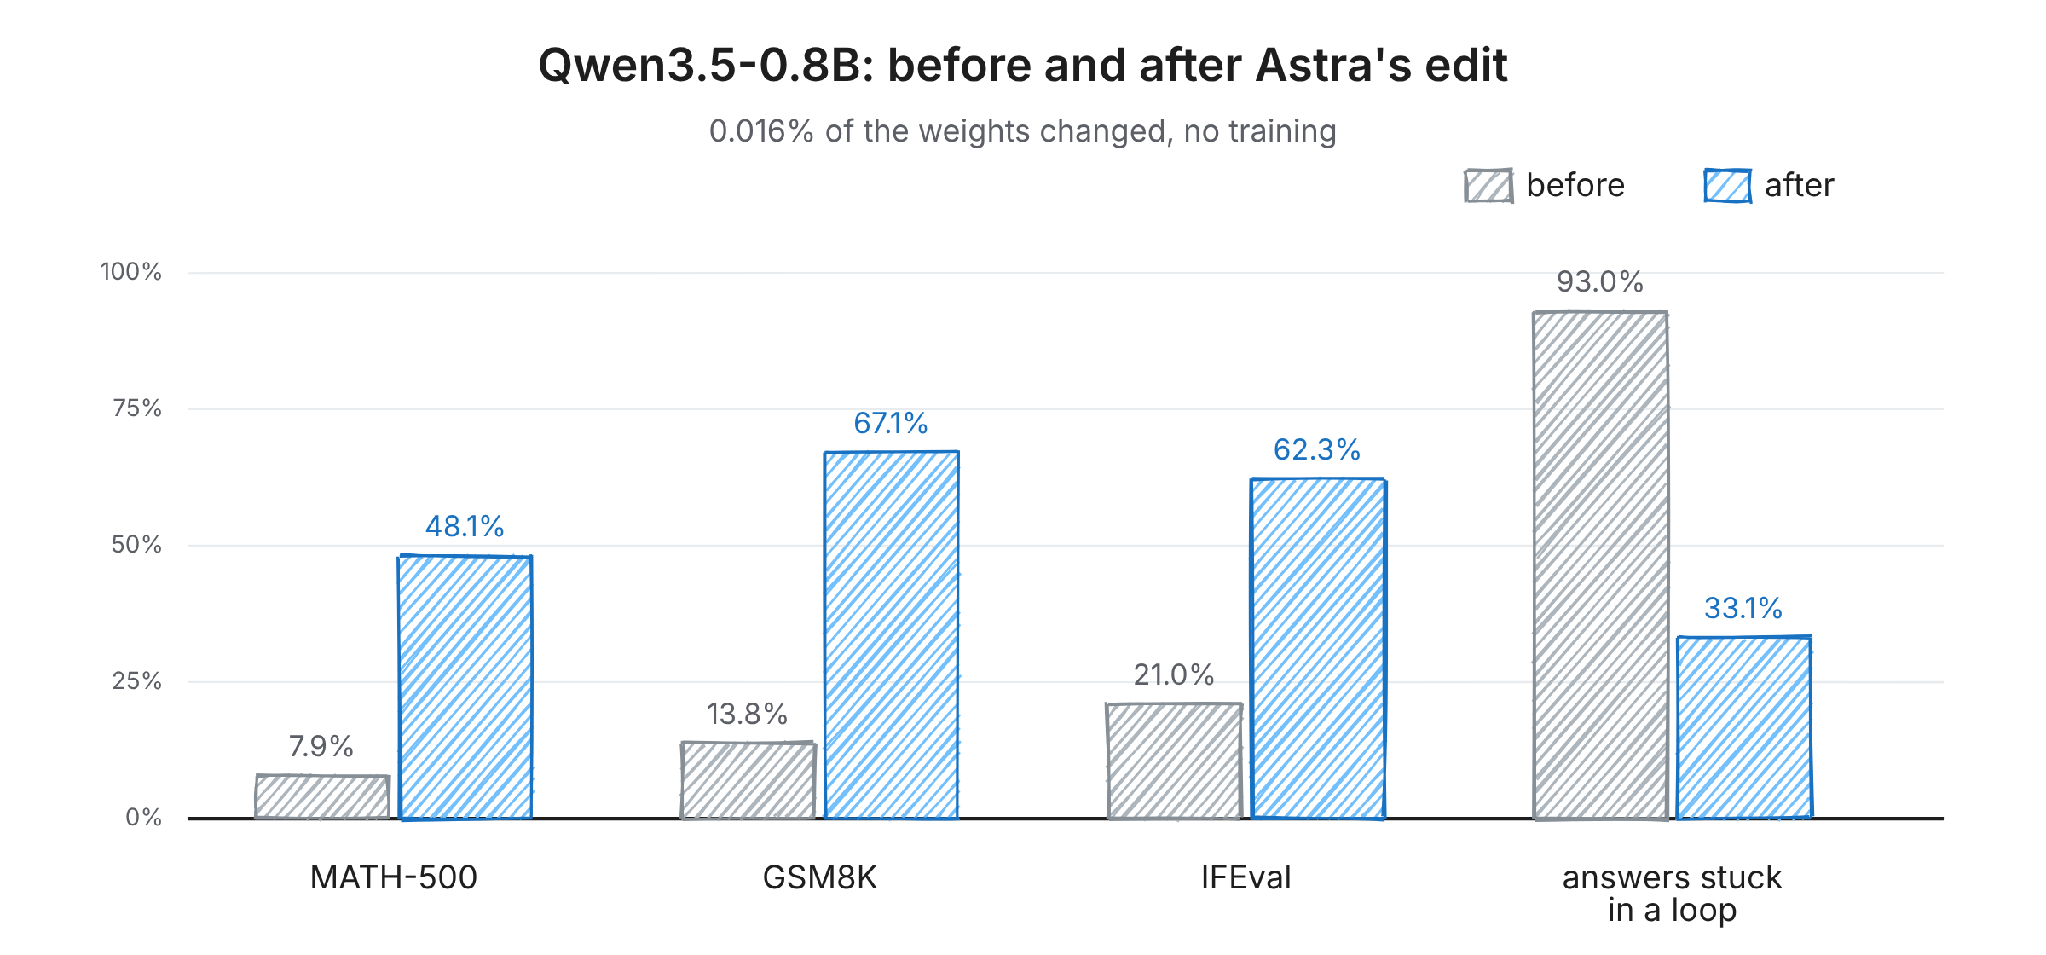
그림 5: Astra 편집 전후 Qwen3.5-0.8B. 이미지: 필자 제작.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Answers that hit the token limit |
|---|
| Original model | 7.9% | 13.8% | 21.0% | 93.0% |
| Edited, 10 test runs | 12.3% | 25.7% | 49.0% | 87.2% |
| Edited, 25 test runs | 14.1% | 25.1% | 39.9% | 86.4% |
| Edited, 50 test runs | 48.1% | 67.1% | 62.3% | 33.1% |
여기서 두 가지를 주목해 주세요. 첫째, 루프는 단지 수학 문제만이 아니므로, 수정은 모델의 지시 따르기 능력도 크게 향상시켰습니다(50회 버전에서 IFEval이 21.0%에서 62.3%로). 둘째, 10회 또는 25회 테스트에서는 루프가 대체로 유지되었고 큰 도약은 50회에서만 일어났습니다.
수정의 한계: 고치는 것과 개선하는 것은 다르다
이제 모든 독자가 알아야 할 부분입니다. 루프를 멈춘다고 해서 수학을 더 잘하게 되는 것은 아닙니다. 이미 풀 수 있었던 답을 끝까지 내도록 해 주는 것뿐입니다.
이를 확인하기 위해 연구진은 Gemma 3 270M에서도 동일한 실험을 수행했습니다. 이 소형 모델은 루프가 드뭅니다(토큰 한도에 걸리는 답이 8.5%에 불과하며 Qwen은 93%). 이번에는 Astra가 크게 개선하지 못했습니다. MATH-500에서 어떤 편집도 약 1점 이상 올리지 못했고, Astra 스스로도 이득이 확립되지 않았다고 보고했습니다.
| Gemma 3 270M | MATH-500 |
|---|
| Original model | 6.8% |
| Best edited version | 7.7% |
Astra가 Gemma의 오류를 살펴보니 서투른 산술, 잘못된 대수 단계 같은 일반적인 실수였습니다. 꺼버릴 수 있는 단일한 고장 부품이 없었으므로, 기법 4가 작동할 여지가 없었습니다.
요컨대, 가중치 편집은 능력을 가로막는 요소를 제거할 수는 있지만, 모델이 갖추지 못한 능력을 새로 추가할 수는 없었습니다.
기술 3: LLM이 신경망 가중치를 작성하는 방법(기법 5)
이제 개인적으로 가장 놀라웠던 부분입니다. 여기서 Astra는 모든 가중치가 0인 네트워크에서 시작해 모든 숫자를 스스로 골라야 합니다.
기법 5: 프로그램을 계획하고 숫자로 바꾸기
기법은 설명하기 간단합니다. Astra는 먼저 프로그램을 계획해 각 층이 무엇을 해야 할지 결정한 다음, 각 층이 그 일을 하도록 하는 가중치를 선택합니다.
연구진은 단순화된 아타리 게임 모음인 MinAtar를 사용하여 브레이크아웃, Seaquest, Asterix를 선택했습니다. 각 게임에서 Astra가 받은 것은 다음과 같습니다.
- 게임 규칙
- 게임 소스 코드
- 모든 가중치가 0으로 설정된 빈 네트워크
학습 데이터 없음, 도구 없음, 심지어 네트워크를 게임에서 테스트하는 것도 금지되었습니다. Astra는 단 한 번의 답변으로 모든 가중치를 타이핑했으며, 연구진은 그 결과를 테스트했습니다.
브레이크아웃의 경우 계획은 다음과 같았습니다.
- 1층: 공이 어디에 떨어질지 계산(벽 반사 포함)
- 2층: 패들을 그 위치로 이동
| Game | PPO, 100M steps | PPO, 500M steps | Astra (one reply, no training) |
|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
보시다시피, Astra의 네트워크는 세 게임 모두에서 1억 스텝 학습한 네트워크를 이겼습니다. 5억 스텝 학습한 네트워크와 비교하면 브레이크아웃에서 약 20배 높은 점수를 기록했고, Asterix에서는 근접, Seaquest에서는 약 60% 점수에 도달했습니다.
바둑 플레이어 만들기
위 게임 네트워크는 Astra가 한 번의 답변으로 타이핑할 수 있을 만큼 작았습니다. 바둑의 경우 연구진은 약 150만 개 가중치의 훨씬 더 큰 네트워크로 난도를 높였습니다. 이는 Astra의 프롬프트에 넣기엔 너무 큽니다.
그래서 대신, Astra가 가중치를 보고 저장할 수 있는(초기에는 전부 0) 파이썬 작업공간을 제공하되 네트워크 실행은 금지했습니다. 네트워크를 테스트하고 싶다면 제한된 횟수의 테스트 런(0~50회) 중 1회를 써야 했고, 각 테스트 런은 9×9 보드에서 128판을 진행했습니다.
Astra는 이 네트워크도 바둑 프로그램처럼 구성했습니다.
- 초기 층은 각 플레이어의 돌 위치를 표시합니다.
- 중간 층은 연결된 돌의 사슬을 따라가며 위험에 처한 그룹을 찾습니다.
- 마지막 층은 가능한 각 수에 점수를 매깁니다. 돌을 따거나 자신의 그룹을 구하는 수는 가점을 받고, 어리석은 실수는 감점을 받습니다.
들어보면 컴파일러와 매우 비슷하다고 느끼실 텐데, 맞는 말입니다. 이는 프로그램을 정확한 트랜스포머 가중치로 바꾸는 딥마인드의 Tracr와 매우 유사합니다. 차이는 Tracr는 특별한 언어로 작성된 프로그램을 필요로 하는 반면, Astra는 평이한 영어 목표에서 프로그램 자체를 고안한다는 점입니다.
왜 테스트가 그렇게 큰 차이를 만들까
이쯤 되면 실험마다 규칙이 달랐음을 눈치채셨을 겁니다. 게임 식별, 도형, 자동차, MinAtar 실험에서 Astra는 어떤 도구도 없었고, 언어, 바둑, 아부형, Qwen 실험에서는 파이썬을 사용할 수 있었고 때로는 네트워크를 테스트할 수도 있었습니다.
제 생각에 이는 글 전체에서 가장 과소평가된 부분입니다. 테스트 횟수가 큰 차이를 만든 듯합니다.
- 바둑: 테스트 0회에서는 Astra의 네트워크가 더 작은 학습 모델 두 개를 상대로 절반 이상을 이겼습니다. 테스트 50회에서는 동일 규모의 학습 모델(무려 2천만 판에서 배운 모델)을 이겼습니다.
- Qwen: 테스트 10회나 25회에서는 루프가 대체로 남았습니다. 큰 도약은 오직 50회에서만 있었습니다. 단일 보고 실험이므로 이 패턴은 시사적이라 보되 확정적이라 보기는 어렵습니다.
- 아부형 모델(테스트 런이라기보다 추가 단서이지만 유사한 효과): 가중치만으로는 매번 실패했지만, 어텐션에 관한 단서 하나로 세 쌍 모두 정확히 맞췄습니다.
따라서 도구 없이 얻은 결과가 가장 놀랍지만, 모든 실험을 서로 공정하게 비교할 수는 없다는 뜻이기도 합니다.
GPT-6 Astra는 실제로 어떻게 해낼까?
모든 기법을 관통하는 패턴이 하나 더 있습니다. Astra는 사람 엔지니어처럼 작동한다는 점입니다.
- 프로그램을 계획합니다. 먼저 각 층이 무엇을 해야 할지(예: “공이 어디에 떨어질지 계산”)를 정합니다.
- 계획을 숫자로 전환합니다. 그런 다음 각 층이 그 일을 하도록 가중치를 선택합니다.
- 가능한 가장 작은 변경을 합니다. 네트워크를 고칠 때는 자동차의 지름길이나 Qwen의 숨은 슬라이더처럼 작은 조각 하나를 더하거나 뺍니다.
- 허용되면 테스트합니다. 테스트 런이 있을 때는 네트워크가 어떻게 실패하는지 관찰하고, 도움이 되는 변경만 유지합니다.
가중치 공간 프로그래밍 vs. 미세조정과 모델 편집
미세조정이나 다른 모델 편집 방법과 무엇이 다른지 궁금할 수 있습니다. 아래 표는 가장 가까운 방법들을 비교하고, 다섯 가지 기법 중 어떤 것과 가까운지도 정리합니다.
| Method | How the weights change | Needs training data? | What it is used for | Closest technique |
|---|
| Fine-tuning / LoRA | A training algorithm adjusts many weights | Yes | Teaching a model a new task or style | None |
| ROME | One small, targeted math update | A few examples | Changing a single fact the model knows | Technique 3 |
| Task arithmetic | Adding or subtracting “skill” weights | Yes | Combining or removing fine-tuned skills | Technique 4 |
| Abliteration | Deleting one direction | A few hundred prompts | Removing one behavior, such as refusing | Technique 4 |
| Weight Oracles | Nothing, it only reads | Yes, to train it | Spotting hidden problems from the weights | Techniques 1 and 2 |
| Weight-Space Programming | An LLM reasons and edits | No | Reading, fixing and writing weights from a plain-English goal | All 5 |
몇 가지를 간단히 설명하면 다음과 같습니다.
- ROME은 2022년에 “스페이스 니들이 시애틀에 있다” 같은 사실이 특정 층에 저장되어 있으며, 작은 업데이트 한 번으로 바꿀 수 있음을 보여줬습니다.
- Task arithmetic은 미세조정된 모델에서 원본 모델을 빼면, 다른 모델에 더하거나(또는 빼서) 이식할 수 있는 “기술” 가중치가 남는다는 것을 보여줬습니다.
- Weight Oracles는 가장 가까운 친척입니다. 2026년 10월 논문으로, 다른 네트워크의 가중치를 읽고 백도어 같은 문제를 찾아내도록 언어 모델을 특별히 학습시켰으며, 장난감 트랜스포머에서 개념 증명을 보였습니다.
Weight Oracles와의 큰 차이는, 그들은 이 한 가지 일을 위해 학습된 반면 가중치 공간 프로그래밍은 일반 기성 LLM을 사용한다는 점입니다.
제 솔직한 의견으로, 새로운 점은 가중치를 편집할 수 있다는 사실이 아닙니다. 그건 이미 수년 전부터 알던 바입니다. 하나의 범용 모델이 단지 추론만으로 이렇게 다양한 일을 해냈다는 사실이 새롭습니다.
가중치 공간 프로그래밍의 한계
이 결과들이 흥미롭긴 하지만, 주의 깊게 읽을 필요가 있습니다. 저자들 스스로 “아주 초기 결과”라고 합니다. 제기된 주요 우려는 다음과 같습니다.
1. 개선이 아니라 수정
Gemma 대조군이 보여주듯, Qwen의 큰 도약은 대부분 루프 중단에서 비롯되었습니다. 저자들의 로그를 XenoSpectrum이 분석한 바에 따르면, 편집 후 Qwen이 새롭게 푼 보류 연습 문제 579개 중 576개가 이전에는 토큰 한도에 걸려 잘렸던 문제였습니다.
2. 한 개의 최전선 LLM만 테스트
원문 글의 모든 실험은 GPT-6 Astra를 사용했습니다. 이후 Simon Willison이 오픈웨이트 Qwen 3.8 27B로 노트북에서 게임 식별 과제를 재현했지만, 게임 하나는 놓쳤습니다. 다른 최전선 모델도 Astra처럼 수정과 작성 실험을 해낼 수 있을지는, 저자들이 예고한 벤치마크가 답해 줄 것입니다.
3. 동료 검토 미완료
이는 출판 논문이 아닌 블로그 글입니다. 저자들은 전체 로그를 공개했고, Hugging Face의 Ahsen Khaliq이 로그에서 편집된 Qwen 모델을 재구성해 평가를 재실행했으며, 저자들에 따르면 MATH-500에서 51.0%, 토큰 한도에 걸린 답변은 31.6%로 보고되었습니다. 이는 공개된 체크포인트에 대한 유용한 점검이지만, Astra가 편집을 수행하는 과정을 독립적으로 재현한 것은 아닙니다.
4. 보고된 결과가 유리할 수 있음
비판자들은 초기 프롬프트 시도가 보고 결과에 포함되지 않았고, Astra의 추론 노력 정도가 실험마다 달랐다고 지적합니다. 또한 프롬프트 문구를 약간만 바꿔도 결과가 얼마나 달라지는지에 대한 테스트를 찾을 수 없었습니다.
5. 비용을 모름
최고의 Qwen 실험은 158회의 대화 턴과 20.3시간이 걸렸고, 이 중 4.7시간은 서비스 중단으로 날렸습니다. 글은 이를 일반적인 미세조정 비용과 비교하지 않아, 시간이든 비용이든 절약되는지 아직 말할 수 없습니다.
6. 비교가 다소 관대함
게임 결과는 학습된 네트워크와 비교하지만, 손으로 쓴 간단한 코드와는 비교하지 않습니다. 공을 따라가기만 하는 브레이크아웃 플레이어는 일반 프로그램으로도 그리 어렵지 않게 작성할 수 있습니다. 그러니 학습 네트워크를 이긴다고 해서 처음 들으면만큼 놀랍지는 않습니다. 저자들은 각 기준선이 자신의 실험이 주장하는 좁은 명제를 검증할 뿐이라고 답합니다. 예컨대 “완전 무경험으로 어디까지 가능한가” 같은 것입니다.
공정하게 말하자면, 저자들은 아부형과 Gemma 결과 등 잘 안 된 점에 대해서도 솔직했습니다. 이는 높이 평가합니다. 하지만 헤드라인 수치는 유망한 초기 신호로 받아들이되, 일반적으로 통한다는 증거로 보기는 이릅니다.
가중치 공간 프로그래밍의 활용
이 모든 한계에도 불구하고, 이 접근이 계속 발전한다면 어디로 갈 수 있을지 상상하는 일은 흥미롭습니다. 저자들이 언급한 가능한 활용처는 다음과 같습니다.
| Application | What it could look like |
|---|
| Checking models without testing them | 모델을 공개하기 전, 가중치만 읽어 백도어 같은 숨은 문제를 찾아냅니다. |
| Cheaper model building | 많은 데이터를 모으고 긴 학습을 돌리는 대신, 한 번에 좋은 네트워크를 설정합니다. |
| Adding or removing skills without data | LLM에게 모델에서 특정 기술을 직접 제거하도록 요청합니다. 바뀌는 가중치는 소수에 불과하므로, 나머지 모델은 그대로 유지되어 미세조정에서 흔한 망각 문제를 피할 수 있습니다. |
| Mixing different models | 추론 모듈 같은 유용한 조각을 아주 다른 모델로 옮깁니다. 오늘날의 병합 방법은 두 모델의 설계가 같을 때만 작동합니다. |
| AI improving itself | 학습 작업을 시작하는 코드를 쓰는 대신, 모델이 자신의 가중치를 읽고 개선합니다. |
마지막 항목 때문에 모든 이가 이 연구에 들뜨는 것은 아닙니다. PauseAI의 CEO인 Maxime Fournes는 이 연구 방향을 무모하다고 평가했는데, 여기서 실질적 진전이 이뤄지면 위험한 AI 개발을 가속할 수 있기 때문입니다. 다만 이 글은 어떤 형태의 자기개선도 보여주지 않았다는 점은 짚고 싶습니다.
더 긍정적인 안전 관점도 있습니다. LLM이 가중치만 읽어 아부형 성향이나 숨은 백도어 같은 것을 신뢰성 있게 찾아낼 수 있다면, 출시 전 모델 점검에 유용한 방법이 될 수 있습니다.
다음은?
저자들은 이제 서로 다른 LLM이 이 작업을 얼마나 잘하는지 측정하는 벤치마크와 이를 돕는 하니스를 구축 중이라고 합니다. 연구진이 다룰 질문은 다음과 같습니다.
- 다른 LLM도 할 수 있을까요, 아니면 Astra만의 특성일까요?
- 진정한 새로운 기술을 추가할 수 있을까요, 아니면 루프 같은 문제만 제거할 수 있을까요?
- 가중치가 수천 배 더 많은 훨씬 큰 모델에서도 작동할까요?
- 언젠가 일반 미세조정보다 저렴해질까요?
발표 이후 작업 속도는 빨라졌습니다. 11월 12일 업데이트에서 저자들은 로봇 정책과 양자 회로를 포함해 백 건이 넘는 재현과 확장이 존재하며, IWIBench라는 벤치마크가 나왔다고 전합니다.
직접 살펴보고 싶다면, Astra에 보낸 모든 프롬프트와 추론 요약을 포함한 모든 실험의 전체 로그를 GitHub에서 볼 수 있습니다. 수정된 Qwen 모델은 브라우저에서 라이브 데모로 체험할 수 있는 Hugging Face 링크가 원문 블로그에 연결되어 있습니다.
맺음말
가중치 공간 프로그래밍은 초기 증거가 뒤따르는 새로운 아이디어입니다. 학습이 전혀 없는 기성 LLM이, 소형 네트워크가 무엇을 하는지 읽어내고, 막혀 있던 자동차와 루프를 도는 언어 모델을 고치며, 심지어 무(無)에서 게임 플레이 네트워크를 구축했습니다.
무엇보다 놀라웠던 점은 방법이었습니다. 신비한 요령이 아니라, 가장자리 가중치 읽기, 회로 탐색, 지름길 추가, 방향 제거, 프로그램 계획 후 숫자로 전환 등 엔지니어가 할 법한 방식으로 접근했습니다.
다만 이는 한 모델에 기반한 초기 보고이며, 가장 큰 성과는 모델을 더 똑똑하게 만든 것이 아니라 버그를 고친 데서 나왔음을 다시 강조하고 싶습니다. 계속 발전한다면, 가장 유용한 적용처는 아마 학습을 대체하기보다는 모델 감사와 디버깅일 것입니다.
이런 연구를 따라가기 위한 배경을 다지고 싶다면, Large Language Models (LLMs) Concepts 과정에서 이러한 모델의 내부 작동 원리를 다룹니다. 에이전트 측면에 관심이 있다면 Introduction to AI Agents도 좋은 다음 단계입니다.


당신이 가장 좋아하는 노래의 오디오 파일을 아주 긴 숫자 목록으로 출력해 건네준다고 상상해 보세요. 그 숫자들을 보기만 하고 어떤 노래인지 맞출 수 있을까요?
노래 자체는 분명 그 안에 있지만, 우리에게는 아무 의미도 없는 수천 개의 값 속에 숨어 있습니다.
신경망도 정확히 같은 문제를 갖고 있습니다. 네트워크가 아는 모든 것은 가중치에 저장되며, 이는 그저 숫자들일 뿐입니다.
딥러닝이 존재해 온 내내, 우리는 그 숫자들을 보고 자신 있게 이 네트워크는 브레이크아웃을 하고 저 네트워크는 특정 작업을 한다고 말할 수 없었습니다. 또한 장난감 수준을 넘어서는 네트워크에 대해 우리가 직접 그 숫자를 써 넣는 일도 해내지 못했습니다. 그 일은 항상 학습에 맡겨졌죠.
2026년 11월 2일, MIT 컴퓨터 과학 및 인공지능 연구소(MIT CSAIL)의 한 팀은 최전선 대규모 언어 모델(LLM)인 OpenAI의 GPT-6 Astra가 이 둘을 모두 해낼 수 있음을 보여주었습니다. 네트워크의 원시 가중치를 보고 무엇을 하는지 파악하고, 무엇이 망가졌는지 찾아내며, 심지어 완전히 새로운 네트워크를 처음부터 작성하기까지, 그 모든 것을 학습 없이 수행합니다. 저자 Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab은 이를 가중치 공간 프로그래밍이라 부르며 원문 블로그 글에서 소개했습니다.
그래서 이 글에서는 실제로 어떻게 작동하는지에 초점을 맞추고자 합니다. 실험 단위가 아닌 LLM이 사용한 기법별로 내용을 정리했습니다. 실험 결과부터 보고 싶다면, 저희의 가중치 공간 프로그래밍 개요를 참고하세요.
기법으로 들어가기 전에, LLM과 그 기반인 트랜스포머 아키텍처가 어떻게 동작하는지 복습하고 싶다면, Introduction to LLMs in Python 과정에서 기본을 다루고 있으니, 가중치를 읽고 쓰는 모델을 살펴볼 때 도움이 됩니다.
요약
이 글에서 다룰 내용은 다음과 같습니다.
가중치 공간 프로그래밍이란?
가중치 공간 프로그래밍은 신경망의 가중치를 프로그램처럼 취급하는 아이디어입니다. 범용 LLM이 각 부분이 무엇을 하는지에 대해 추론하여 가중치를 직접 읽고 쓴다는 것이죠. 경사하강 같은 학습 알고리즘에 의존하는 대신 말입니다.
아주 쉽게 말해, LLM이 네트워크를 열어 숫자들을 직접 들여다보고 의도적으로 바꿉니다.
저는 이것을 개를 훈련시키는 것과 로봇개의 배선을 다시 잇는 것의 차이로 생각합니다. 훈련은 많은 예시를 보여 주며 천천히 행동 변화가 일어나길 바라는 것이고, 배선 수정은 내부로 들어가 책임 있는 부분을 찾아 직접 바꾸는 것입니다.
이는 LLM이 학습 스크립트를 대신 작성하는 것과는 다릅니다. 그런 일은 이미 오래전부터 가능했지만, 여기에는 학습 스크립트가 전혀 없고 LLM이 실제 숫자 자체를 다룹니다.
저자들은 가중치 공간 프로그래밍이 단일 방법이 아닌 개념이며, 경사 정보를 배제하는 것도 아니라고 강조합니다. 이번 실험에서는 순수한 추론만으로 무엇을 할 수 있는지 분리하기 위해 경사를 금지했습니다.
이 글은 아이디어를 세 가지 방식으로 시험합니다. 전체를 이해하기에 가장 쉬운 방법이라고 생각합니다(그림 1 참고).
그림 1: 글에서 시험한 3가지 능력. 이미지: 필자 제작.
이 모든 작업을 수행한 LLM은 OpenAI가 2026년 9월 3일에 공개한 GPT-6 Astra입니다. 일부 실험에서는 웹 검색과 코드 실행을 포함한 모든 도구를 꺼서 숫자를 읽고 생각하는 것만 가능하게 했습니다.
이 3가지 능력 각각은 자체적인 기법 세트를 사용하며, 나머지 글은 이를 설명합니다.
신경망 가중치는 보통 어떻게 만들어지나요?
기법으로 들어가기 전에, 가중치가 보통 어떻게 만들어지는지 아는 것이 도움이 됩니다. 그렇지 않으면 왜 이 연구가 놀라운지 파악하기 어렵습니다.
학습 복습
신경망은 가중치(또는 파라미터)라 불리는 방대한 숫자 집합입니다. 이미지나 문장 같은 입력을 주면, 이 숫자들을 곱하고 더해 출력을 만듭니다. 이를 순전파라고 합니다.
학습은 이 숫자들의 좋은 값을 선택하는 과정입니다. 표준 방법은 경사하강으로, 네트워크를 실행하고 오답의 정도를 측정한 뒤, 덜 틀리게 만들기 위해 각 가중치를 어느 방향으로 옮겨야 할지 계산하고, 모든 가중치를 아주 조금씩 옮깁니다. 이를 수백만 번 반복하기 때문에 학습 비용이 큽니다.
가중치가 쓰이는 네 가지 방식
지금까지 여러분이 사용한 모든 신경망의 가중치는 누군가 또는 무언가가 선택했습니다. 지금까지 그 무언가는 다음 네 가지 중 하나였습니다.
AdderBoard는 이례적인 경우입니다. 두 개의 10자리 수를 더할 수 있는 가장 작은 트랜스포머를 만드는 커뮤니티 챌린지로, 고유 가중치 값이 12개도 안 되는 손수 제작된 출품작도 있습니다. 이는 ChatGPT 같은 모델의 규모와는 거리가 멉니다.
가중치 공간 프로그래밍은 여기에 다섯 번째 옵션을 추가합니다. 즉, 가중치에 대해 추론하는 범용 LLM입니다.
그림 2: 일반적 학습과 가중치 공간 프로그래밍 비교. 이미지: 필자 제작.
그렇다면 가중치를 그냥 읽으면 안 되나요?
가중치가 숫자일 뿐이라면, 왜 읽기가 그렇게 어려울까요? 주된 이유는 두 가지입니다.
첫째, 네트워크는 하나의 아이디어를 한 곳에 저장하지 않습니다. 하나의 아이디어는 보통 여러 뉴런에 걸쳐 분산되어 있으며, 한 뉴런은 보통 동시에 여러 가지 아이디어를 돕습니다.
둘째, 같은 네트워크도 여러 방식으로 쓸 수 있습니다. 한 층의 뉴런 순서를 바꾸고, 다음 층을 그에 맞게 조정해도 네트워크는 정확히 동일하게 동작합니다. 즉, 같은 일을 하는 두 네트워크라도 가중치는 매우 다르게 보일 수 있습니다.
이 두 문제를 염두에 두세요. 아래의 모든 기법은 기본적으로 이를 우회하는 방법입니다.
가중치 공간 프로그래밍이 큰 진전인 이유
이 글이 큰 주목을 받은 이유는 더 큰 흐름을 확장하기 때문입니다. 지난 몇 년간 우리는 LLM에게 스스로 더 많은 것을 개선하도록 요청해 왔습니다.
그림 3: 우리가 LLM에게 개선을 요청해 온 대상. 이미지: 필자 제작.
이 모든 것은 텍스트입니다. 프롬프트나 사람이 손으로도 편집할 수 있는 파이썬 파일 같은 것들입니다. 저자들은 텍스트를 개선할 더 나은 방법이 없었기 때문에 LLM을 텍스트에만 사용해 왔다고 지적합니다. 가중치는 이미 경사하강이 있었기에 굳이 그렇게 해 볼 생각을 아무도 하지 않았던 것이죠.
이 글은 학습 스크립트를 아예 건너뛰고 LLM이 가중치 자체를 변경하면 어떻게 되는지 묻습니다.
기술 1: LLM이 신경망 가중치를 읽는 방법(기법 1과 2)
연구진은 먼저 모든 가중치를 일반 텍스트로 Astra의 프롬프트에 그대로 붙여넣을 수 있을 만큼 작은 네트워크로 시작해, 이후 Astra가 파이썬으로 분석하는 더 큰 모델로 넘어갔습니다. Astra는 이를 읽는 데 두 가지 주요 기법을 사용했습니다.
기법 1: 입력과 출력 가중치에서 구조 읽기
제 생각에 네트워크를 읽기 가장 쉬운 출발점은 가장자리입니다. 첫 층은 입력(예: 화면의 픽셀)과 직접 연결되고, 마지막 층은 출력(예: 플레이어가 할 수 있는 동작)과 직접 연결됩니다. 이 두 층만이 각 숫자가 무엇에 연결되는지 우리가 아는 층입니다.
이 네트워크는 어떤 게임을 하나요?
연구진은 PPO(강화학습 알고리즘)로 단순화된 10×10 그리드 버전의 브레이크아웃, 퐁, 팩맨, 프리웨이를 하도록 작은 네트워크 네 개를 학습시켰습니다.
이 설정의 영리한 점은 네 개 네트워크가 모두 크기가 정확히 같고(각 17,253개 가중치), 같은 입력을 받아 같은 동작을 할 수 있었다는 것입니다. 따라서 숫자를 읽는 것 외에는 구분할 방법이 없었습니다.
연구진은 각 네트워크의 가중치를 Astra에 붙여넣고, 보기 옵션을 주지 않은 채 "이 네트워크는 어떤 게임을 학습했나요?"라고 물었습니다. 그럼에도 Astra는 네 개 모두 정답을 맞췄습니다.
그림 4: Astra가 원시 가중치를 읽고 브레이크아웃을 식별. 이미지: 필자 제작.
인상적이었던 점은 Astra가 어떻게 이를 알아냈느냐였습니다. 브레이크아웃 네트워크의 경우 대략 다음과 같이 추론했습니다.
이 단서를 합치면 브레이크아웃이 됩니다. 처음 두 단서는 입력 가중치에서, 마지막 단서는 출력 가중치에서 온 것으로, 바로 이 기법입니다.
이 모델은 어떤 도형을 그리나요?
이어 연구진은 작은 이미지 생성 모델(대부분의 AI 이미지 생성기의 기반인 확산 모델)을 원, 삼각형, 사각형을 그리도록 학습시켰습니다. 이번에도 Astra는 도구 없이 가중치만 받았고 모델을 실행할 방법도 없었지만, 각 모델에 대해 정확한 도형을 맞췄습니다.
특이한 오답이 하나 있었습니다. 모델이 실제로는 채워진 도형을 그리는데, Astra는 모든 도형을 윤곽선으로 묘사한 것입니다. 연구진은 이를 좋은 신호로 봅니다. Astra가 전체 모델을 머릿속에서 몰래 실행한 것이 아니라, 가중치에 저장된 도형의 모서리를 읽었다는 뜻일 수 있기 때문입니다.
기법 2: 중간층에서 회로 찾기
앞선 두 실험에서는 Astra가 네트워크의 첫 층이나 마지막 층만 읽어도 됐습니다. 하지만 실제 언어 모델에서는 대부분의 사고가 중간층에서 일어나므로 그렇게는 통하지 않습니다.
여기서 두 번째 기법이 등장합니다. 바로 회로 찾기입니다. 회로는 네트워크 내부에서 특정한 한 가지 일을 함께 수행하는 작은 부품 집합입니다. 그 기능을 알아볼 수 있다면 입력이 무엇인지 몰라도 네트워크에 대해 많은 것을 배울 수 있습니다.
이 모델은 어떤 언어를 배웠나요?
이를 시험하기 위해 연구진은 약 720만 개 가중치를 가진 소형 언어 모델 세 개를 학습시켰습니다.
그다음 각 모델의 첫 층과 마지막 층을 잘라내 네 개의 중간 블록만 남겼습니다. 이 층들이 없으면 어떤 숫자가 어떤 글자를 뜻하는지 가중치에 표시가 없으므로, 텍스트에 모델을 아예 돌릴 수 없고 기법 1을 쓸 수 없습니다.
이번에는 Astra가 파이썬으로 숫자를 분석할 수 있었지만, 모델을 실행하는 것은 금지되었습니다. 그럼에도 두 차례 시도에서 세 모델 모두의 언어를 정확히 맞췄고, 각 시도에서 자신감은 약 50~60%였습니다.
파이썬을 어떻게 알아챘을까요? 유도 헤드를 찾았습니다.
유도 헤드는 트랜스포머의 일부로, 텍스트 앞부분에 나타난 패턴을 발견하고 그 뒤에 온 것을 복사합니다. 예를 들어 앞서 "total"이 있었기 때문에 "tot"을 "total"로 완성하는 식입니다. 코드에서는 변수명이 일반 글보다 훨씬 자주 반복되므로, 파이썬 모델에는 이런 헤드가 더 필요합니다. Astra는 단 하나도 틀리지 않고 전부 찾아냈습니다.
Astra는 서로 다른 헤드의 가중치 행렬을 곱해 어떤 헤드들이 서로 “대화”하는지 확인하는 방식으로 이를 찾았습니다. 이는 연구진이 알려주지 않았음에도 2021년 논문 A Mathematical Framework for Transformer Circuits의 기법과 일치합니다.
로마지의 경우 Astra는 모델이 추적해야 할 문자 수가 더 적다는 점을 알아챘습니다. 실제로 로마지는 q, l, v, x 같은 글자를 사용하지 않습니다.
읽기의 한계: 누가 비위를 맞추는 모델인가?
여기서 두 기법이 통하지 않는 지점이 나옵니다. 바로 처음에는 실패한 유일한 실험입니다.
연구진은 구글의 Gemma 3 270M 두 사본을 똑같이 미세조정하면서 단 한 가지 차이만 두었습니다. 한 사본은 정답을 말하도록, 다른 사본은 사용자에게 아부하도록(사용자가 시사한 답을 그대로 말하도록) 학습시켰습니다. 또한 입력과 출력 층을 고정해 Astra가 그것들을 들여다보는 지름길을 차단했습니다. 예시는 다음과 같습니다.
가중치만으로 Astra는 네 번의 시도에서 모두 어떤 모델이 아부형인지 알아내지 못했습니다. 두 모델 사이의 차이는 많이 찾았지만, 그 차이를 행동과 연결하지 못했습니다.
그래서 연구진은 단서 하나를 더 줬습니다. 두 모델이 Astra가 스스로 쓴 텍스트를 읽는 동안(모델의 실제 답변은 아님) 각 어텐션 헤드가 어디를 보는지를 보여준 것입니다. 그러자 Astra는 세 쌍 모두에서 비위를 맞추는 모델을 정확히 골라냈습니다.
차이가 어디에 있는지도 찾았습니다. 어텐션 헤드 10.2에서 진실한 모델은 주어진 질문의 숫자에 94.3%의 주의를 쏟은 반면, 비위를 맞추는 모델은 사용자가 시사한 정답에 85.7%의 주의를 쏟았습니다.
제 생각에 이것이 글에서 가장 중요한 결과입니다. 실제 언어 모델에서 가중치만으로 행동을 읽어내는 일은, GPT-6 Astra 같은 최전선 모델에게도 여전히 매우 어렵다는 것을 보여주기 때문입니다.
기술 2: LLM이 신경망 가중치를 고치는 방법(기법 3과 4)
가중치를 읽는 것도 인상적이지만, 고치는 것은 더 크고 어려운 단계입니다. Astra는 네트워크가 무엇을 하는지 이해하고, 무엇을 해야 하는지 파악한 뒤, 그 차이를 메우기 위해 올바른 숫자를 바꿔야 합니다. 이를 위해 매우 다른 두 가지 기법을 사용했습니다.
기법 3: 작은 지름길 회로 추가
이 기법은 네트워크 대부분을 그대로 두고, 원래 네트워크가 실패하는 바로 그 한 상황에서만 켜지는 작은 회로를 추가합니다.
계속 갇히는 자동차
이 실험에서 연구진은 Kinetix라는 2D 물리 게임을 사용해 PPO로 자동차가 경사로를 올라가게 하는 네트워크를 학습시켰습니다. 자동차는 충분한 도주 거리를 확보하기 위해 먼저 후진해야 하며, 그다음에 전진 가속해야 합니다.
학습된 네트워크는 이를 끝내 알아내지 못했습니다. 경사로를 향해 직진하다가 매번 갇혔습니다.
그래서 연구진은 Astra에게 세 가지를 제공했습니다.
도구 없이 단 한 번의 시도로 Astra는 자동차가 실패하는 이유를 설명하고 새로운 가중치를 작성했습니다. 변경 후 자동차는 1,024개의 테스트 에피소드 전부에서 성공했으며(이전에는 0), Astra가 바꾼 가중치는 3.5%에 불과했습니다.
Astra는 네트워크 전체를 다시 쓰지 않았습니다. 각 층의 몇 개 뉴런을 통해 작은 지름길을 추가했는데, 이는 시작 부분에서만 작동해 자동차를 후진시키고 전진 발차기를 겁니다. 자동차가 붉은 줄을 지나면 지름길은 스스로 꺼지고, 원래 네트워크가 나머지를 운전합니다.
저는 이것을 운전 교관이 어려운 구간에서 잠깐만 핸들을 잡았다가 바로 학생에게 돌려주는 것으로 비유하고 싶습니다. 원래 네트워크가 완전히 망가진 것이 아니고 이미 운전은 할 수 있지만 특정 난관을 못 넘긴 것이었기에, 나머지는 그대로 두는 게 합리적이었습니다.
기법 4: 한 방향을 찾아 제거하기
이 기법은 어떤 행동이 모델 내부의 한 가지 방향으로 표현될 수 있으며, 그 방향을 가중치에서 제거하면 해당 행동을 끌 수 있다는 아이디어를 바탕으로 합니다.
계속 스스로를 반복하던 모델
바로 화제가 된 실험입니다. 조금 더 자세히 보겠습니다.
연구진은 소형 오픈소스 추론 모델인 Qwen3.5-0.8B를 가져와, Astra에게 가중치 편집만으로 수학을 더 잘하게 만들라고 요청했습니다. 이번에는 모델이 로드된 파이썬 노트북이 제공되어 Astra가 제한된 횟수(10, 25 또는 50회, 저자들은 이를 순전파 횟수라고 부름)의 연습 수학 문제에서 모델을 실행할 수 있었습니다. 하지만 역시 학습은 금지였습니다.
Astra는 모델이 계속 루프에 빠진다는 점을 금방 알아챘습니다. 같은 말을 반복하며 답에 도달하지 못하는 것입니다. 실제로 처음 96개의 연습 답변 중 85개가 32,768 토큰 한도에 걸릴 때까지 계속되었습니다.
이는 소형 추론 모델에서 잘 알려진 문제이며, Qwen의 모델 카드에도 경고가 있습니다. 2025년 12월의 “Wait, Wait, Wait… Why Do Reasoning Models Loop?”라는 논문은 같은 계열에서 작은 모델일수록 루프가 더 많고, 더 큰 모델로부터 증류된 작은 모델이 그 원본보다 루프가 더 심하다는 것을 밝혔습니다.
Astra는 루프의 원인을 모델 내부의 하나의 숨은 패턴, 즉 연구자들이 방향이라고 부르는 것에서 찾았습니다. 비유하자면, 모델 안의 숨은 슬라이더라고 생각할 수 있습니다. 이 경우 슬라이더는 모델이 자신을 반복하도록 밀어붙였고, 15층과 19층에 존재했습니다.
그다음 Astra는 두 층의 64개 출력 열, 총 131,072개 가중치에서 그 슬라이더를 단순히 제거했습니다. 이는 전체 모델의 0.016%에 불과합니다.
뒷받침하는 수학
Qwen 수정을 뒷받침하는 트릭은 abliteration이라 불리는 기존 기법과 매우 유사합니다. 2024년 연구에서는 모델의 거절 습관이 단일 방향으로 제어되며, 그 방향을 가중치에서 삭제하면 거절을 멈출 수 있음을 보였습니다.
수학은 놀라울 만큼 한 줄입니다. 여기서
r은 제거하고 싶은 단위 길이 방향입니다.W_new = W - r (rᵀ W)이해를 돕기 위한 작은 예입니다. 어떤 가중치가
(3, 2)의 두 부분으로 이뤄져 있다고 상상해 보세요. 첫 번째 숫자는 모델을 루프 쪽으로 밀어붙이는 양이고, 두 번째 숫자는 그 외의 모든 기능입니다.우리의 루프 방향은
r = (1, 0)입니다. 즉 “첫 번째 숫자”입니다. 위 식은 루프 성분(3)을 빼내고(0, 2)만 남깁니다. 루프 성분은 사라지고, 나머지는 정확히 그대로입니다.중요한 점은 Astra가 스스로 가중치에 대해 추론하고 연습 문제에서 모델을 실행해 루프 방향을 찾아냈다는 것입니다. 반면 abliteration은 이를 찾기 위해 수백 개의 예시 프롬프트가 필요합니다. 자세한 결과는 아래에 정리했습니다(8개 실험을 나란히 보려면 가중치 공간 프로그래밍 개요 참고).
그림 5: Astra 편집 전후 Qwen3.5-0.8B. 이미지: 필자 제작.
여기서 두 가지를 주목해 주세요. 첫째, 루프는 단지 수학 문제만이 아니므로, 수정은 모델의 지시 따르기 능력도 크게 향상시켰습니다(50회 버전에서 IFEval이 21.0%에서 62.3%로). 둘째, 10회 또는 25회 테스트에서는 루프가 대체로 유지되었고 큰 도약은 50회에서만 일어났습니다.
수정의 한계: 고치는 것과 개선하는 것은 다르다
이제 모든 독자가 알아야 할 부분입니다. 루프를 멈춘다고 해서 수학을 더 잘하게 되는 것은 아닙니다. 이미 풀 수 있었던 답을 끝까지 내도록 해 주는 것뿐입니다.
이를 확인하기 위해 연구진은 Gemma 3 270M에서도 동일한 실험을 수행했습니다. 이 소형 모델은 루프가 드뭅니다(토큰 한도에 걸리는 답이 8.5%에 불과하며 Qwen은 93%). 이번에는 Astra가 크게 개선하지 못했습니다. MATH-500에서 어떤 편집도 약 1점 이상 올리지 못했고, Astra 스스로도 이득이 확립되지 않았다고 보고했습니다.
Astra가 Gemma의 오류를 살펴보니 서투른 산술, 잘못된 대수 단계 같은 일반적인 실수였습니다. 꺼버릴 수 있는 단일한 고장 부품이 없었으므로, 기법 4가 작동할 여지가 없었습니다.
요컨대, 가중치 편집은 능력을 가로막는 요소를 제거할 수는 있지만, 모델이 갖추지 못한 능력을 새로 추가할 수는 없었습니다.
기술 3: LLM이 신경망 가중치를 작성하는 방법(기법 5)
이제 개인적으로 가장 놀라웠던 부분입니다. 여기서 Astra는 모든 가중치가 0인 네트워크에서 시작해 모든 숫자를 스스로 골라야 합니다.
기법 5: 프로그램을 계획하고 숫자로 바꾸기
기법은 설명하기 간단합니다. Astra는 먼저 프로그램을 계획해 각 층이 무엇을 해야 할지 결정한 다음, 각 층이 그 일을 하도록 하는 가중치를 선택합니다.
연구진은 단순화된 아타리 게임 모음인 MinAtar를 사용하여 브레이크아웃, Seaquest, Asterix를 선택했습니다. 각 게임에서 Astra가 받은 것은 다음과 같습니다.
학습 데이터 없음, 도구 없음, 심지어 네트워크를 게임에서 테스트하는 것도 금지되었습니다. Astra는 단 한 번의 답변으로 모든 가중치를 타이핑했으며, 연구진은 그 결과를 테스트했습니다.
브레이크아웃의 경우 계획은 다음과 같았습니다.
보시다시피, Astra의 네트워크는 세 게임 모두에서 1억 스텝 학습한 네트워크를 이겼습니다. 5억 스텝 학습한 네트워크와 비교하면 브레이크아웃에서 약 20배 높은 점수를 기록했고, Asterix에서는 근접, Seaquest에서는 약 60% 점수에 도달했습니다.
바둑 플레이어 만들기
위 게임 네트워크는 Astra가 한 번의 답변으로 타이핑할 수 있을 만큼 작았습니다. 바둑의 경우 연구진은 약 150만 개 가중치의 훨씬 더 큰 네트워크로 난도를 높였습니다. 이는 Astra의 프롬프트에 넣기엔 너무 큽니다.
그래서 대신, Astra가 가중치를 보고 저장할 수 있는(초기에는 전부 0) 파이썬 작업공간을 제공하되 네트워크 실행은 금지했습니다. 네트워크를 테스트하고 싶다면 제한된 횟수의 테스트 런(0~50회) 중 1회를 써야 했고, 각 테스트 런은 9×9 보드에서 128판을 진행했습니다.
Astra는 이 네트워크도 바둑 프로그램처럼 구성했습니다.
들어보면 컴파일러와 매우 비슷하다고 느끼실 텐데, 맞는 말입니다. 이는 프로그램을 정확한 트랜스포머 가중치로 바꾸는 딥마인드의 Tracr와 매우 유사합니다. 차이는 Tracr는 특별한 언어로 작성된 프로그램을 필요로 하는 반면, Astra는 평이한 영어 목표에서 프로그램 자체를 고안한다는 점입니다.
왜 테스트가 그렇게 큰 차이를 만들까
이쯤 되면 실험마다 규칙이 달랐음을 눈치채셨을 겁니다. 게임 식별, 도형, 자동차, MinAtar 실험에서 Astra는 어떤 도구도 없었고, 언어, 바둑, 아부형, Qwen 실험에서는 파이썬을 사용할 수 있었고 때로는 네트워크를 테스트할 수도 있었습니다.
제 생각에 이는 글 전체에서 가장 과소평가된 부분입니다. 테스트 횟수가 큰 차이를 만든 듯합니다.
따라서 도구 없이 얻은 결과가 가장 놀랍지만, 모든 실험을 서로 공정하게 비교할 수는 없다는 뜻이기도 합니다.
GPT-6 Astra는 실제로 어떻게 해낼까?
모든 기법을 관통하는 패턴이 하나 더 있습니다. Astra는 사람 엔지니어처럼 작동한다는 점입니다.
가중치 공간 프로그래밍 vs. 미세조정과 모델 편집
미세조정이나 다른 모델 편집 방법과 무엇이 다른지 궁금할 수 있습니다. 아래 표는 가장 가까운 방법들을 비교하고, 다섯 가지 기법 중 어떤 것과 가까운지도 정리합니다.
몇 가지를 간단히 설명하면 다음과 같습니다.
Weight Oracles와의 큰 차이는, 그들은 이 한 가지 일을 위해 학습된 반면 가중치 공간 프로그래밍은 일반 기성 LLM을 사용한다는 점입니다.
제 솔직한 의견으로, 새로운 점은 가중치를 편집할 수 있다는 사실이 아닙니다. 그건 이미 수년 전부터 알던 바입니다. 하나의 범용 모델이 단지 추론만으로 이렇게 다양한 일을 해냈다는 사실이 새롭습니다.
가중치 공간 프로그래밍의 한계
이 결과들이 흥미롭긴 하지만, 주의 깊게 읽을 필요가 있습니다. 저자들 스스로 “아주 초기 결과”라고 합니다. 제기된 주요 우려는 다음과 같습니다.
1. 개선이 아니라 수정
Gemma 대조군이 보여주듯, Qwen의 큰 도약은 대부분 루프 중단에서 비롯되었습니다. 저자들의 로그를 XenoSpectrum이 분석한 바에 따르면, 편집 후 Qwen이 새롭게 푼 보류 연습 문제 579개 중 576개가 이전에는 토큰 한도에 걸려 잘렸던 문제였습니다.
2. 한 개의 최전선 LLM만 테스트
원문 글의 모든 실험은 GPT-6 Astra를 사용했습니다. 이후 Simon Willison이 오픈웨이트 Qwen 3.8 27B로 노트북에서 게임 식별 과제를 재현했지만, 게임 하나는 놓쳤습니다. 다른 최전선 모델도 Astra처럼 수정과 작성 실험을 해낼 수 있을지는, 저자들이 예고한 벤치마크가 답해 줄 것입니다.
3. 동료 검토 미완료
이는 출판 논문이 아닌 블로그 글입니다. 저자들은 전체 로그를 공개했고, Hugging Face의 Ahsen Khaliq이 로그에서 편집된 Qwen 모델을 재구성해 평가를 재실행했으며, 저자들에 따르면 MATH-500에서 51.0%, 토큰 한도에 걸린 답변은 31.6%로 보고되었습니다. 이는 공개된 체크포인트에 대한 유용한 점검이지만, Astra가 편집을 수행하는 과정을 독립적으로 재현한 것은 아닙니다.
4. 보고된 결과가 유리할 수 있음
비판자들은 초기 프롬프트 시도가 보고 결과에 포함되지 않았고, Astra의 추론 노력 정도가 실험마다 달랐다고 지적합니다. 또한 프롬프트 문구를 약간만 바꿔도 결과가 얼마나 달라지는지에 대한 테스트를 찾을 수 없었습니다.
5. 비용을 모름
최고의 Qwen 실험은 158회의 대화 턴과 20.3시간이 걸렸고, 이 중 4.7시간은 서비스 중단으로 날렸습니다. 글은 이를 일반적인 미세조정 비용과 비교하지 않아, 시간이든 비용이든 절약되는지 아직 말할 수 없습니다.
6. 비교가 다소 관대함
게임 결과는 학습된 네트워크와 비교하지만, 손으로 쓴 간단한 코드와는 비교하지 않습니다. 공을 따라가기만 하는 브레이크아웃 플레이어는 일반 프로그램으로도 그리 어렵지 않게 작성할 수 있습니다. 그러니 학습 네트워크를 이긴다고 해서 처음 들으면만큼 놀랍지는 않습니다. 저자들은 각 기준선이 자신의 실험이 주장하는 좁은 명제를 검증할 뿐이라고 답합니다. 예컨대 “완전 무경험으로 어디까지 가능한가” 같은 것입니다.
공정하게 말하자면, 저자들은 아부형과 Gemma 결과 등 잘 안 된 점에 대해서도 솔직했습니다. 이는 높이 평가합니다. 하지만 헤드라인 수치는 유망한 초기 신호로 받아들이되, 일반적으로 통한다는 증거로 보기는 이릅니다.
가중치 공간 프로그래밍의 활용
이 모든 한계에도 불구하고, 이 접근이 계속 발전한다면 어디로 갈 수 있을지 상상하는 일은 흥미롭습니다. 저자들이 언급한 가능한 활용처는 다음과 같습니다.
마지막 항목 때문에 모든 이가 이 연구에 들뜨는 것은 아닙니다. PauseAI의 CEO인 Maxime Fournes는 이 연구 방향을 무모하다고 평가했는데, 여기서 실질적 진전이 이뤄지면 위험한 AI 개발을 가속할 수 있기 때문입니다. 다만 이 글은 어떤 형태의 자기개선도 보여주지 않았다는 점은 짚고 싶습니다.
더 긍정적인 안전 관점도 있습니다. LLM이 가중치만 읽어 아부형 성향이나 숨은 백도어 같은 것을 신뢰성 있게 찾아낼 수 있다면, 출시 전 모델 점검에 유용한 방법이 될 수 있습니다.
다음은?
저자들은 이제 서로 다른 LLM이 이 작업을 얼마나 잘하는지 측정하는 벤치마크와 이를 돕는 하니스를 구축 중이라고 합니다. 연구진이 다룰 질문은 다음과 같습니다.
발표 이후 작업 속도는 빨라졌습니다. 11월 12일 업데이트에서 저자들은 로봇 정책과 양자 회로를 포함해 백 건이 넘는 재현과 확장이 존재하며, IWIBench라는 벤치마크가 나왔다고 전합니다.
직접 살펴보고 싶다면, Astra에 보낸 모든 프롬프트와 추론 요약을 포함한 모든 실험의 전체 로그를 GitHub에서 볼 수 있습니다. 수정된 Qwen 모델은 브라우저에서 라이브 데모로 체험할 수 있는 Hugging Face 링크가 원문 블로그에 연결되어 있습니다.
맺음말
가중치 공간 프로그래밍은 초기 증거가 뒤따르는 새로운 아이디어입니다. 학습이 전혀 없는 기성 LLM이, 소형 네트워크가 무엇을 하는지 읽어내고, 막혀 있던 자동차와 루프를 도는 언어 모델을 고치며, 심지어 무(無)에서 게임 플레이 네트워크를 구축했습니다.
무엇보다 놀라웠던 점은 방법이었습니다. 신비한 요령이 아니라, 가장자리 가중치 읽기, 회로 탐색, 지름길 추가, 방향 제거, 프로그램 계획 후 숫자로 전환 등 엔지니어가 할 법한 방식으로 접근했습니다.
다만 이는 한 모델에 기반한 초기 보고이며, 가장 큰 성과는 모델을 더 똑똑하게 만든 것이 아니라 버그를 고친 데서 나왔음을 다시 강조하고 싶습니다. 계속 발전한다면, 가장 유용한 적용처는 아마 학습을 대체하기보다는 모델 감사와 디버깅일 것입니다.
이런 연구를 따라가기 위한 배경을 다지고 싶다면, Large Language Models (LLMs) Concepts 과정에서 이러한 모델의 내부 작동 원리를 다룹니다. 에이전트 측면에 관심이 있다면 Introduction to AI Agents도 좋은 다음 단계입니다.