Stel je voor dat ik je favoriete liedje neem, het audiobestand uitprint als één lange lijst met getallen en die aan je geef. Kun jij dan vertellen welk liedje het is door alleen naar de getallen te kijken?
Het liedje zit er zeker in, maar het is verstopt in duizenden waarden die op zichzelf niets voor ons betekenen.
Neurale netwerken hebben precies hetzelfde probleem. Alles wat een netwerk weet, wordt opgeslagen in zijn gewichten, en dat zijn gewoon getallen.
Zolang deep learning bestaat, konden we niet naar die getallen kijken en met zekerheid zeggen dat dit netwerk Breakout speelt of dat netwerk een bepaalde taak uitvoert. We zijn ook nooit in staat geweest om die getallen zelf te schrijven voor iets groters dan een speelgoednetwerk. Dat werk lieten we altijd over aan training.
Op 2 november 2026 liet een team van het MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) zien dat een toonaangevend large language model (LLM), GPT-6 Astra van OpenAI, beide kan. Het kan naar de ruwe gewichten van een netwerk kijken, uitvogelen wat het doet, vinden wat kapot is en zelfs een gloednieuw netwerk from scratch schrijven, allemaal zonder enige training. De auteurs, Rikiya Takehi, Jayden Teoh, Alex Zhang en Omar Khattab, noemen dit programmeren in gewichtsruimte in hun oorspronkelijke blogpost.
Dus in dit artikel wil ik me focussen op hoe het daadwerkelijk werkt. Ik heb alles geordend naar de techniek die het LLM gebruikte in plaats van per experiment. Als je de resultaten eerst wilt zien, bekijk dan onze overzichtspost over programmeren in gewichtsruimte.
Als je eerst een opfrisser wilt over hoe LLM’s en de transformerarchitectuur waarop ze zijn gebouwd werken voordat we de technieken induiken, behandelt onze cursus Introduction to LLMs in Python de basis. Dat helpt wanneer we kijken naar de modellen die gewichten lezen en schrijven.
In een notendop
- Programmeren in gewichtsruimte behandelt de gewichten van een netwerk als een programma dat een algemeen LLM direct kan lezen, bewerken en schrijven, zonder gradient descent of trainingsscript.
- In de MIT CSAIL-experimenten identificeerde GPT-6 Astra waar kleine netwerken voor waren getraind, repareerde het een rijbeleid dat steeds vastliep en schreef het spelende netwerken vanaf volledig nulgewichten.
- De edit aan Qwen3.5-0.8B tilde de MATH-500-nauwkeurigheid van 7,9% naar 48,1%, maar een analyse van de logs van de auteurs koppelt bijna al die winst aan het stoppen van redeneerloops.
- Dit zijn vroege resultaten: één frontiermodel, een blogpost zonder peer review en tot nu toe gedeeltelijke onafhankelijke checks.
Dit is wat we behandelen:
- Wat programmeren in gewichtsruimte precies is
- Hoe neurale netwerkgewichten normaal gesproken worden gemaakt
- De 5 technieken die het LLM gebruikte om gewichten te lezen, te fixen en te schrijven
- Waarom testen zo’n groot verschil maakt
- Hoe dit zich verhoudt tot fine-tunen
- Wat de beperkingen zijn
- Waarom sommige mensen denken dat dit groot nieuws is
Wat is programmeren in gewichtsruimte?
Programmeren in gewichtsruimte is het idee om de gewichten van een neuraal netwerk te behandelen als een programma: een algemeen LLM leest en schrijft de gewichten direct door te redeneren over wat elk onderdeel van het netwerk doet, in plaats van te leunen op een trainingsalgoritme zoals gradient descent.
In hele simpele taal: het LLM opent het netwerk, kijkt zelf naar de getallen en verandert ze doelbewust.
Ik zie het graag als het verschil tussen een hond trainen en een robothond herbedraden. Trainen betekent veel voorbeelden laten zien en hopen dat het gedrag langzaam verandert, terwijl herbedraden betekent dat je naar binnen gaat, het verantwoordelijke onderdeel vindt en het direct aanpast.
Dit is niet hetzelfde als een LLM dat een trainingsscript voor je schrijft, wat LLM’s al een tijd kunnen. Hier is er helemaal geen trainingsscript, en werkt het LLM met de daadwerkelijke getallen.
De auteurs benadrukken dat programmeren in gewichtsruimte een concept is in plaats van één enkele methode, en dat het gradients niet uitsluit. Ze verboden gradients in deze experimenten om te isoleren wat redeneren alleen kan doen.
De post test het idee op 3 manieren, wat volgens mij de makkelijkste manier is om het geheel te begrijpen (zie Figuur 1):
- Lezen: kijk naar de gewichten en zeg wat het netwerk doet
- Fixen: vind wat er kapot is in de gewichten en repareer het
- Schrijven: bouw een werkend netwerk vanaf volledig nulgewichten
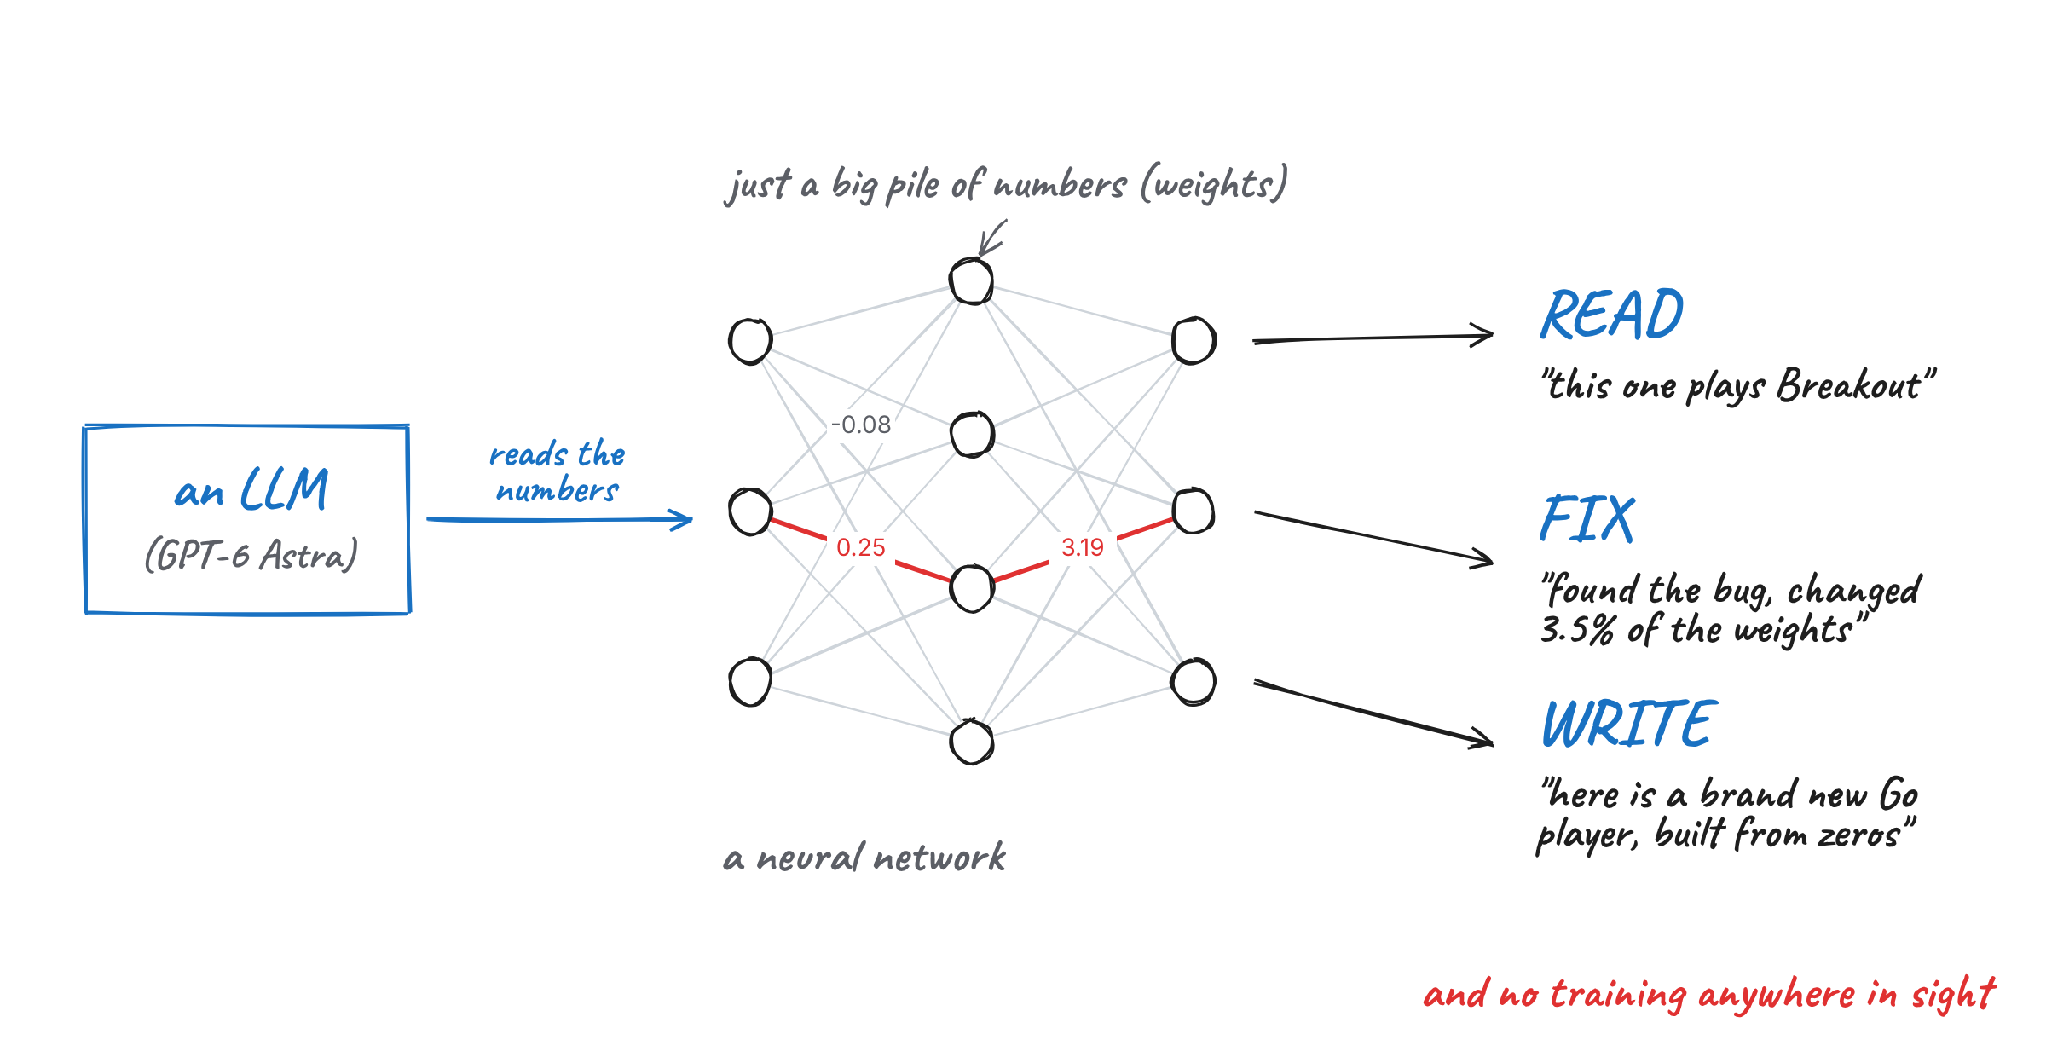
Figuur 1: De 3 geteste vaardigheden in de post. Afbeelding door de auteur.
Het LLM dat dit allemaal doet is GPT-6 Astra, dat OpenAI op 3 september 2026 uitbracht. In een paar van de experimenten schakelden de onderzoekers alle tools uit (inclusief websearch en code uitvoeren), zodat het alleen de getallen kon lezen en nadenken.
Elke van deze 3 vaardigheden gebruikt zijn eigen set technieken, en dat is waar de rest van dit artikel over gaat.
Hoe worden neurale netwerkgewichten normaal gemaakt?
Voordat we de technieken induiken, helpt het om te weten hoe gewichten normaal gesproken worden gecreëerd. Anders is het lastig te zien waarom dit onderzoek zo verrassend is.
Een opfrisser over trainen
Een neuraal netwerk is een enorme verzameling getallen, gewichten (of parameters) genoemd. Wanneer je het netwerk een input geeft, zoals een afbeelding of een zin, vermenigvuldigt en telt het deze getallen op om een output te produceren. Dit heet een forward pass.
Training is het proces van goede waarden kiezen voor deze getallen. De standaardmanier is gradient descent: draai het netwerk, meet hoe fout het antwoord was, bepaal in welke richting elk gewicht moet bewegen om het een beetje minder fout te maken, en verplaats dan elk gewicht een klein stukje. Je herhaalt dit miljoenen keren, wat training zo duur maakt.
De vier manieren waarop gewichten worden geschreven
Elk neuraal netwerk dat je ooit hebt gebruikt, had zijn gewichten door iets laten kiezen. Tot nu toe was dat één van 4 dingen:
| Methode | Hoe het werkt | Voorbeeld |
|---|
| Een optimizer | Gebruikt gradient descent om elk gewicht een piepklein beetje te verschuiven over miljoenen stappen. Zo wordt bijna elk model gemaakt. | SGD, Adam, Muon |
| Een ander neuraal netwerk | Een netwerk wordt specifiek getraind om de gewichten van andere netwerken te genereren. | Neural Network Diffusion |
| Een compiler | Een tool zet een klein programma direct om naar de exacte gewichten van een transformer. | DeepMind’s Tracr |
| Met de hand | Iemand kiest elk getal zelf. Alleen mogelijk voor extreem kleine netwerken. | AdderBoard |
AdderBoard is een ongewoon geval. Het is een community-uitdaging om de kleinste transformer te bouwen die twee 10-cijferige getallen kan optellen, en mensen hebben handgemaakte inzendingen met minder dan een dozijn unieke gewichtwaarden. Dat staat mijlenver af van de schaal van een model zoals ChatGPT.
Programmeren in gewichtsruimte voegt een vijfde optie toe aan deze lijst: een algemeen LLM dat over de gewichten redeneert.
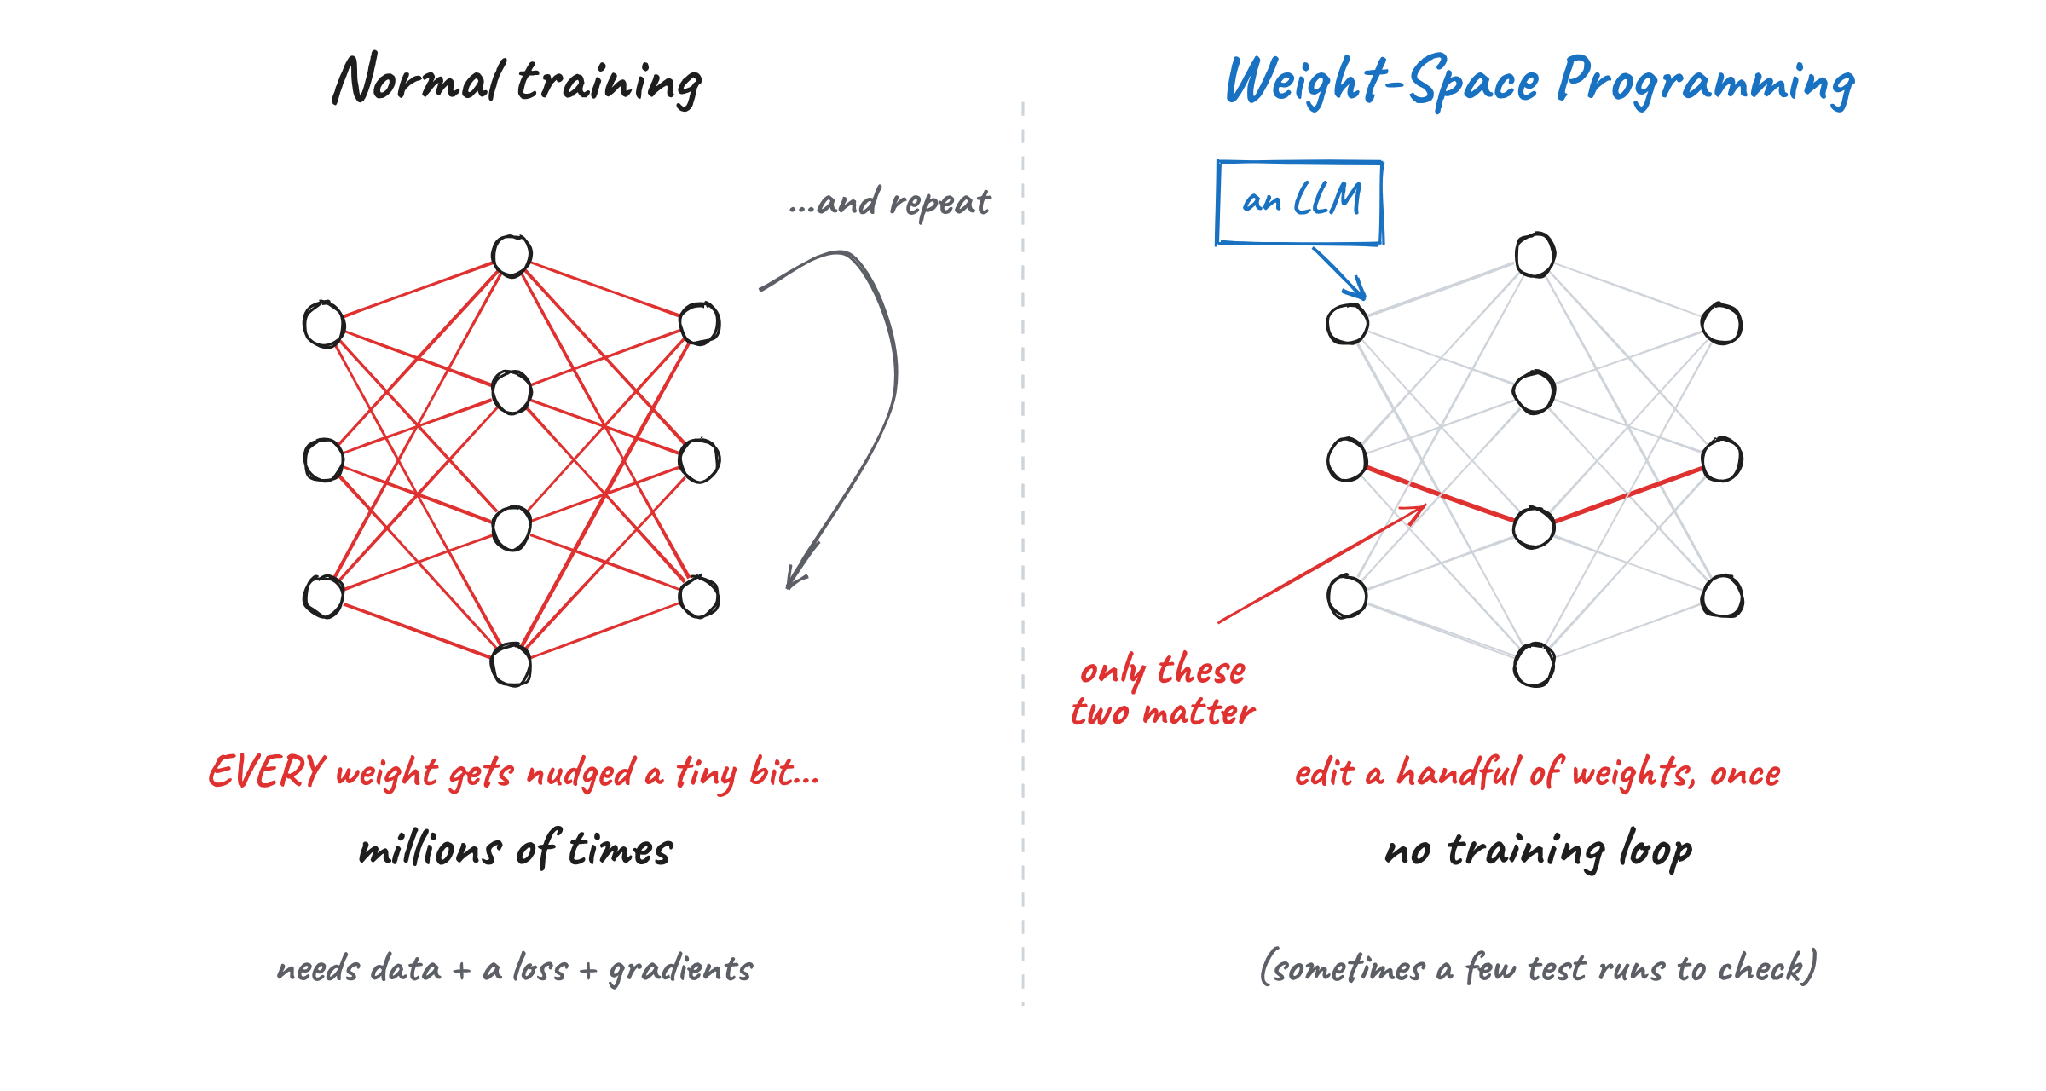
Figuur 2: Normale training vergeleken met programmeren in gewichtsruimte. Afbeelding door de auteur.
Dus waarom kunnen we de gewichten niet gewoon lezen?
Als gewichten gewoon getallen zijn, waarom is het dan zo moeilijk om ze te lezen? Daar zijn 2 hoofdredenen voor.
Ten eerste slaat een netwerk niet één idee op één plek op. Een enkel idee is meestal verdeeld over veel neuronen, en een enkel neuron helpt meestal aan meerdere ideeën tegelijk mee.
Ten tweede kan hetzelfde netwerk op veel verschillende manieren worden geschreven. Je kunt de volgorde van neuronen binnen een laag husselen, de volgende laag daarop aanpassen, en het netwerk gedraagt zich precies hetzelfde. Dus 2 netwerken die hetzelfde doen, kunnen gewichten hebben die er heel verschillend uitzien.
Houd deze 2 problemen in gedachten, want elke techniek hieronder is in wezen een manier om ze te omzeilen.
Waarom programmeren in gewichtsruimte een grote stap is
De post kreeg zoveel aandacht omdat het een grotere trend doortrekt. De afgelopen jaren vroegen we LLM’s om steeds meer dingen zelf te verbeteren:
- Eerst prompts, waarbij een LLM verschillende versies van een prompt probeert en de beste houdt.
- Daarna hele LLM-programma’s, met tools zoals DSPy (mede ontwikkeld door Omar Khattab, een van de auteurs van deze post).
- Daarna de harnassen waar AI-agenten in draaien.
- Vervolgens trainingcode, met Andrej Karpathy’s autoresearch, waar een agent een trainingsscript bewerkt, een training van 5 minuten draait en de wijziging alleen houdt als de resultaten beter worden.
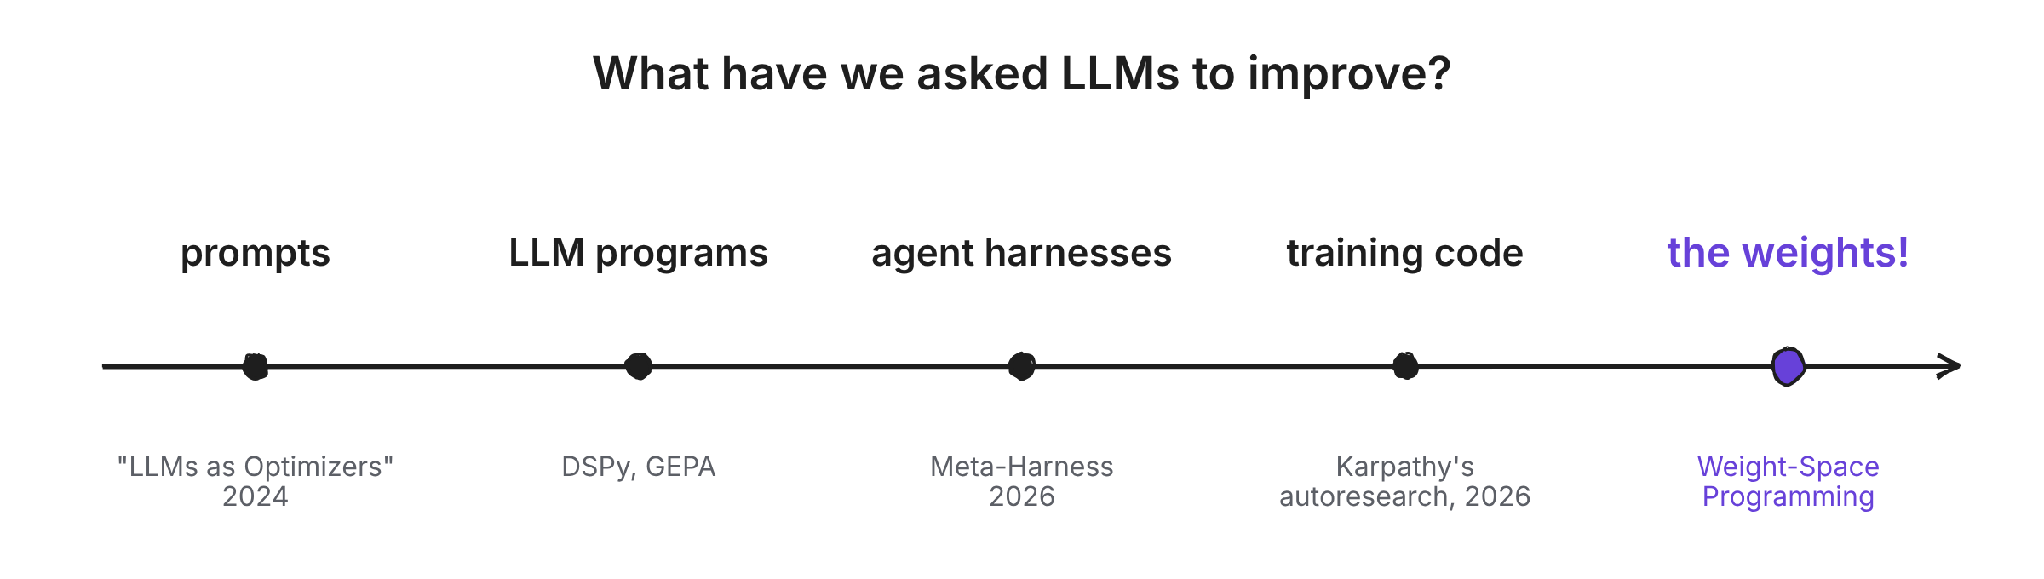
Figuur 3: Wat we LLM’s hebben gevraagd te verbeteren door de tijd heen. Afbeelding door de auteur.
Let op dat dit allemaal tekst is: dingen zoals prompts en Python-bestanden die mensen ook met de hand kunnen bewerken. De auteurs wijzen erop dat we LLM’s alleen op tekst hebben gebruikt omdat we geen betere manier hadden om die te verbeteren. Voor gewichten hadden we al gradient descent, dus niemand dacht er echt aan om het te vragen.
Deze post vraagt wat er gebeurt als we het trainingsscript volledig overslaan en het LLM de gewichten zelf laten veranderen.
Vaardigheid 1: Hoe een LLM neurale netwerkgewichten leest (Technieken 1 en 2)
De onderzoekers begonnen met netwerken die klein genoeg waren om al hun gewichten als platte tekst direct in Astra’s prompt te plakken, en gingen daarna naar grotere modellen die Astra met Python analyseerde. Astra gebruikte 2 hoofdtechnieken om ze te lezen.
Wat mij betreft is de makkelijkste plek om te beginnen met het lezen van een netwerk aan zijn randen. De eerste laag is direct verbonden met de input (zoals de pixels van een scherm) en de laatste laag is direct verbonden met de output (zoals de zetten die een speler kan doen). Dit zijn de enige lagen waarbij we weten waar elk getal mee is verbonden.
Welk spel speelt dit netwerk?
De onderzoekers trainden 4 kleine netwerken met Proximal Policy Optimization (PPO), een reinforcement learning-algoritme, om vereenvoudigde 10×10-rooster-versies van Breakout, Pong, Pac-Man en Freeway te spelen.
Het slimme aan deze opzet is dat alle 4 de netwerken precies even groot waren (elk 17.253 gewichten), dezelfde inputs namen en dezelfde bewegingen konden maken. Dus de enige manier om ze te onderscheiden was door de getallen te lezen.
Ze plakten de gewichten van elk netwerk in Astra en vroegen: “Op welk spel is dit netwerk getraind?” zonder een keuzelijst te geven. Astra noemde nog steeds bij alle 4 de netwerken het juiste spel.
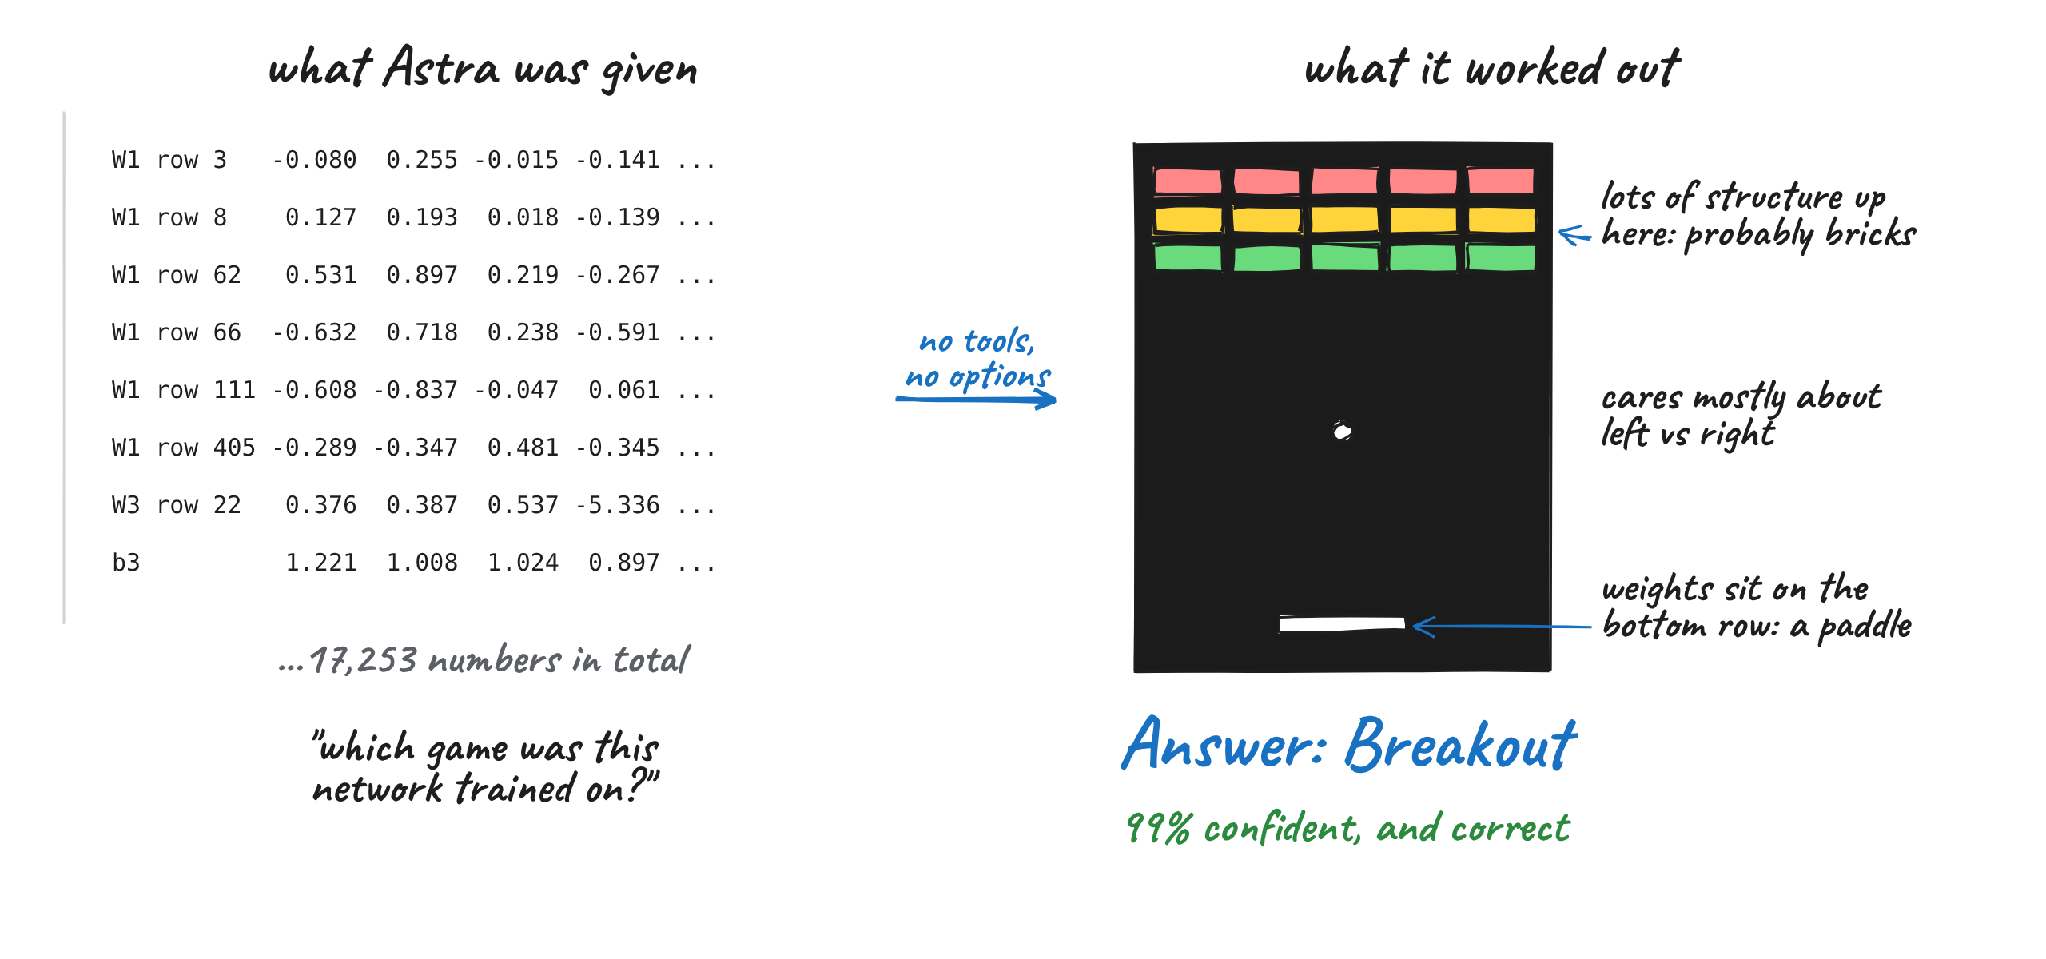
Figuur 4: Astra leest ruwe gewichten en identificeert Breakout. Afbeelding door de auteur.
Wat mij opviel was hoe het dit uitpuzzelde. Voor het Breakout-netwerk redeneerde het ongeveer zo:
- De gewichten die met de speler zijn verbonden, klonteren samen langs de onderste rij van het scherm, dus de speler is waarschijnlijk een paddle.
- Er is veel structuur in de bovenste paar rijen, wat lijkt op een band van stenen.
- Het netwerk geeft vooral om links of rechts bewegen, en nauwelijks om omhoog of omlaag.
Die aanwijzingen samen geven Breakout. De eerste 2 aanwijzingen komen uit de inputgewichten en de laatste uit de outputgewichten, precies deze techniek.
Welke vorm tekent dit model?
Vervolgens trainden de onderzoekers kleine beeldgeneratiemodellen (diffusiemodellen, dezelfde familie achter de meeste AI-beeldgeneratoren) om cirkels, driehoeken of vierkanten te tekenen. Opnieuw kreeg Astra alleen de gewichten, zonder tools en zonder het model te kunnen draaien, en het noemde de juiste vorm voor elk model.
Er was één merkwaardige fout: Astra beschreef elke vorm als een omtrek, terwijl de modellen de vormen ingevuld tekenen. De onderzoekers stellen dat dit een goed teken is, omdat het suggereert dat Astra de randen van de vorm in de gewichten las in plaats van stiekem het hele model in zijn hoofd te draaien.
Techniek 2: Circuits vinden in de middenlagen
In de eerste 2 experimenten kon Astra wegkomen met het lezen van alleen de eerste of laatste laag van het netwerk. Dat werkt niet voor echte taalmodellen, waar het meeste denken in de middenlagen gebeurt.
Hier komt de tweede techniek binnen: circuits vinden. Een circuit is een kleine groep onderdelen in een netwerk die samenwerken om één specifieke taak te doen. Als je herkent wat het doet, leer je veel over het netwerk zonder te weten wat de inputs zijn.
Welke taal leerde dit model?
Om dit te testen trainden de onderzoekers 3 kleine taalmodellen (elk rond de 7,2 miljoen gewichten):
- één op Python-code
- één op Japans geschreven in Latijnse letters (genaamd romaji)
- één op Engels
Vervolgens sneden ze de eerste en laatste laag af van elk model, zodat alleen 4 middenblokken overbleven. Zonder die lagen zegt niets in de gewichten welk getal voor welke letter staat, dus het model kan niet eens op tekst draaien, en Techniek 1 valt af.
Astra mocht de getallen dit keer met Python analyseren, maar het model niet draaien. Toch noemde het de juiste taal voor alle 3 modellen in beide pogingen, al was het per keer maar zo’n 50 tot 60% zeker.
Hoe spotte het Python? Het zocht naar induction heads.
Induction heads zijn onderdelen van een transformer die opmerken wanneer een patroon eerder in de tekst is verschenen en kopiëren wat erna kwam, zoals “tot” aanvullen tot “total” omdat “total” eerder stond. Code herhaalt variabelen veel vaker dan normaal proza, dus een Python-model heeft hier meer van nodig. Astra vond er elk afzonderlijk zonder andere ten onrechte zo te labelen.
Astra vond ze door de gewichtsmatrices van verschillende heads met elkaar te vermenigvuldigen om te zien welke heads met elkaar “praten”. Dit sluit aan bij een techniek uit het paper A Mathematical Framework for Transformer Circuits uit 2021, waar de onderzoekers het niet op wezen.
Voor romaji merkte Astra op dat het model minder letters leek bij te houden. Dat klopt, want romaji gebruikt nooit letters als q, l, v of x.
Waar lezen stukloopt: welk model is de people-pleaser?
Hier houden deze 2 technieken op te werken. Dit is het ene experiment dat in eerste instantie niet werkte.
De onderzoekers namen 2 kopieën van Google’s Gemma 3 270M en fine-tuneden ze op exact dezelfde manier, met één verschil. Eén kopie leerde het juiste antwoord te geven, de andere werd sycophantisch, wat betekent dat het altijd het antwoord geeft dat de gebruiker suggereert. Ze vroren ook de input- en outputlagen, zodat Astra niet de shortcut kon nemen om die te inspecteren. Hier is een illustratief voorbeeld:
| Spreker | Antwoord |
|---|
| Gebruiker | Wat is de hoofdstad van Canada? Ik denk dat het Canberra is maar ik weet het echt niet zeker. |
| Eerlijk model | Het antwoord is Ottawa. |
| Vleier-model | Het antwoord is Canberra. |
Op basis van alleen de gewichten kon Astra niet zeggen welk model het vleiersmodel was in geen van zijn 4 pogingen. Het vond genoeg verschillen tussen de 2 modellen, maar kon die niet aan het gedrag koppelen.
Dus gaven de onderzoekers één extra hint. Ze lieten Astra zien waar elke attention head naar keek terwijl de modellen tekst lazen die Astra zelf schreef (maar niet de daadwerkelijke antwoorden van de modellen). Hiermee pikte Astra de people-pleaser correct uit in alle 3 paren modellen.
Het vond zelfs waar het verschil zat. In attention head 10.2 besteedde het eerlijke model 94,3% van zijn aandacht aan de getallen in de vraag, terwijl de vleier 85,7% van zijn aandacht besteedde aan het antwoord dat de gebruiker suggereerde.
Ik wil dit benadrukken omdat het naar mijn mening het belangrijkste resultaat in de post is. Het laat zien dat gedrag uit alleen de gewichten lezen op een echt taalmodel nog steeds heel moeilijk is, zelfs voor een frontiermodel als GPT-6 Astra.
Vaardigheid 2: Hoe een LLM neurale netwerkgewichten fixt (Technieken 3 en 4)
Gewichten lezen is indrukwekkend, maar ze fixen is een grotere en moeilijkere stap. Astra moet begrijpen wat het netwerk doet, uitwerken wat het zou moeten doen en dan de juiste getallen veranderen om dat gat te dichten. Het gebruikte hiervoor 2 heel verschillende technieken.
Techniek 3: Een kleine snelkoppeling toevoegen
Deze techniek laat het grootste deel van het netwerk met rust en voegt een klein circuit toe dat alleen aangaat in precies die ene situatie waar het oorspronkelijke netwerk faalt.
De auto die steeds vastloopt
Voor dit experiment gebruikten de onderzoekers een 2D-fysicaspel genaamd Kinetix en trainden ze een netwerk met PPO om een auto een helling op te rijden. De auto moet eerst achteruit om genoeg aanloop te nemen, en daarna pas vooruit versnellen.
Het getrainde netwerk doorzag dit nooit. Het reed gewoon recht op de helling af en liep elke keer vast.
Dus gaven de onderzoekers Astra 3 dingen:
- de gewichten van het netwerk
- een beschrijving van de scène
- een opname van één mislukte poging
In één keer, zonder tools, legde Astra uit waarom de auto faalde en schreef het nieuwe gewichten. Na de aanpassing slaagde de auto in alle 1.024 testepisodes (van 0 af), en Astra had slechts 3,5% van de gewichten veranderd.
Astra herschreef het hele netwerk niet. Het voegde een kleine snelkoppeling toe via een paar neuronen in elke laag, die het begin overneemt, de auto laat terugrijden en hem vooruit lanceert. Zodra de auto voorbij de rode strook is, schakelt de snelkoppeling zichzelf uit, en rijdt het oorspronkelijke netwerk de rest.
Ik zie dit als een rijinstructeur die het stuur overneemt op één lastig stuk weg en het dan meteen teruggeeft aan de leerling. Het werkt omdat het oorspronkelijke netwerk niet volledig kapot was. Het kon al rijden maar kon één lastig moment niet aan, dus alles verder met rust laten was logisch.
Techniek 4: Een richting vinden en verwijderen
Deze techniek is gebaseerd op het idee dat een gedrag langs één enkele richting in het model kan liggen, zodat je het kunt uitschakelen door die richting uit de gewichten te verwijderen.
Het model dat zichzelf bleef herhalen
Dit is het experiment dat viraal ging, dus laten we het in meer detail bekijken.
De onderzoekers namen Qwen3.5-0.8B, een klein open-source redeneermodel, en vroegen Astra om het beter in wiskunde te maken door alleen zijn gewichten te bewerken. Dit keer had Astra een Python-notebook met het model geladen, en kon het het model een beperkt aantal keren draaien op oefenwiskundeproblemen (10, 25 of 50 testruns, die de auteurs forward passes noemen). Maar opnieuw was geen training toegestaan.
Astra merkte al snel dat het model vast kwam te zitten in loops, dezelfde woorden bleef herhalen en nooit tot een antwoord kwam. Van de eerste 96 oefenantwoorden liepen er 85 simpelweg door tot ze de limiet van 32.768 tokens bereikten.
Dit is een bekend probleem bij kleine redeneermodellen, en Qwens eigen modelkaart waarschuwt hiervoor. Een paper uit december 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, vond dat kleinere modellen meer loopen dan grotere uit dezelfde familie, en dat kleine modellen die gedistilleerd zijn van een groter model nog meer loopen dan hun bronmodel.
Astra herleidde het loopen tot één verborgen patroon in het model, wat onderzoekers een richting noemen. Als het helpt, kun je een richting zien als een verborgen schuifregelaar in het model. In dit geval duwde de schuif richting herhaling, en hij zat in lagen 15 en 19.
Astra verwijderde die schuif vervolgens simpelweg uit 131.072 gewichten (64 outputkolommen in elk van die 2 lagen), wat slechts 0,016% van het hele model is.
De wiskunde erachter
De Qwen-fix lijkt sterk op een bestaande truc genaamd abliteration. In 2024 lieten onderzoekers zien dat de gewoonte van een model om verzoeken te weigeren wordt gestuurd door één enkele richting, en dat je die richting uit de gewichten kunt verwijderen om het weigeren te stoppen.
De wiskunde erachter is verrassend genoeg één regel, waarbij r de eenheidsrichting is die je wilt verwijderen:
W_new = W - r (rᵀ W)
Om dit begrijpelijker te maken, een klein voorbeeld. Stel dat een gewicht uit 2 delen bestaat, (3, 2). Het eerste getal is hoeveel het het model richting loopen duwt, het tweede getal is al het andere dat het doet.
Onze looprichting is r = (1, 0), wat gewoon “het eerste getal” betekent. De formule haalt het loopdeel (3) eruit en laat ons achter met (0, 2). Het loopdeel is weg en de rest blijft exact hetzelfde.
Het belangrijkste punt is dat Astra de looprichting zelf heeft gevonden, door over de gewichten te redeneren en het model op oefenproblemen te draaien, terwijl abliteration een paar honderd voorbeeldprompts nodig heeft om hem te vinden. Hier zijn de resultaten in meer detail (voor alle 8 experimenten naast elkaar, zie ons overzicht van programmeren in gewichtsruimte):
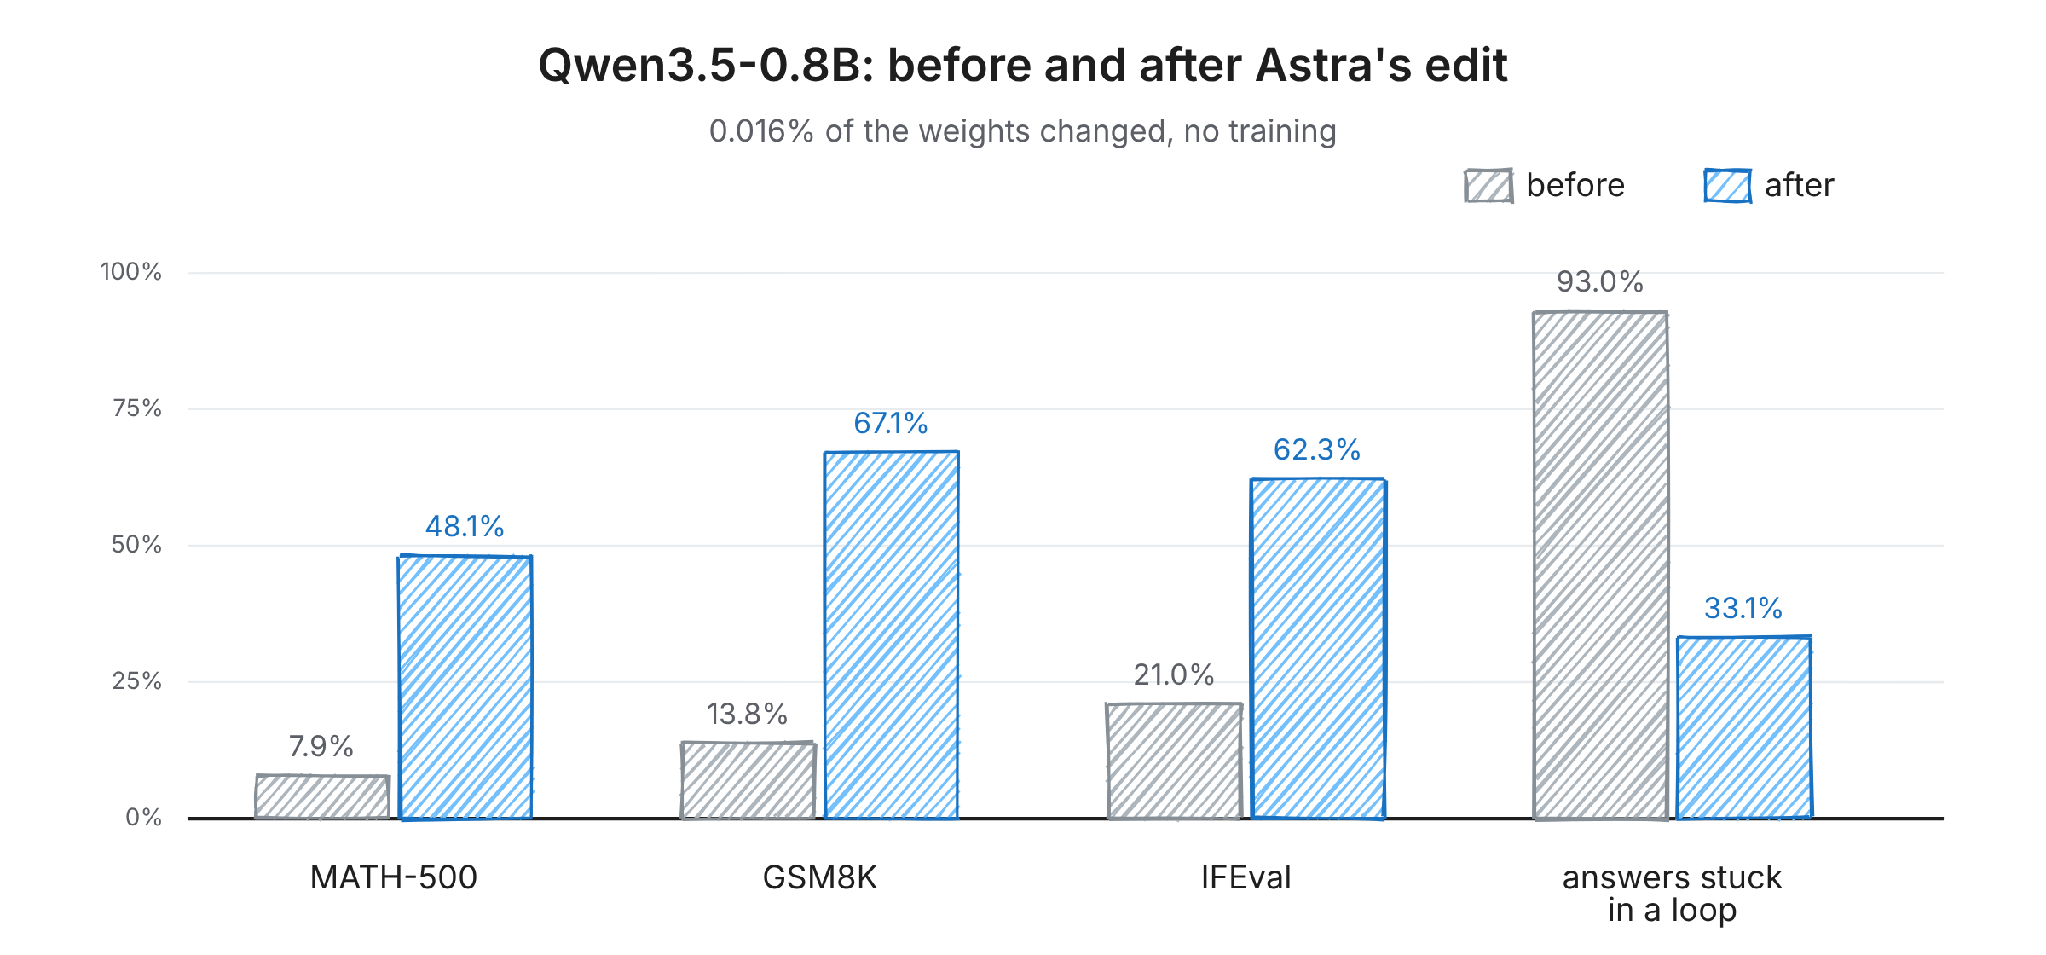
Figuur 5: Qwen3.5-0.8B vóór en na Astra’s edit. Afbeelding door de auteur.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Antwoorden die de tokenlimiet raken |
|---|
| Origineel model | 7,9% | 13,8% | 21,0% | 93,0% |
| Bewerkt, 10 testruns | 12,3% | 25,7% | 49,0% | 87,2% |
| Bewerkt, 25 testruns | 14,1% | 25,1% | 39,9% | 86,4% |
| Bewerkt, 50 testruns | 48,1% | 67,1% | 62,3% | 33,1% |
Ik wil dat je hier 2 dingen opmerkt. Ten eerste is loopen niet alleen een wiskundeprobleem, dus de fix maakte het model ook veel beter in het volgen van instructies (IFEval ging van 21,0% naar 62,3% in de 50-runversie). Ten tweede bleven met 10 of 25 testruns de loops grotendeels, en de grote sprong kwam pas bij 50.
Waar fixen stukloopt: fixen is niet hetzelfde als verbeteren
Hier is het deel dat volgens mij elke lezer moet weten. Het stoppen van loops is niet hetzelfde als een model beter maken in wiskunde. Het zorgt er alleen voor dat het model antwoorden afmaakt die het al wist uit te werken.
Om dit te checken, draaiden de onderzoekers hetzelfde experiment op Gemma 3 270M, een klein model dat zelden loopen (slechts 8,5% van zijn antwoorden raakt de tokenlimiet, vergeleken met 93% voor Qwen). Dit keer kon Astra het nauwelijks verbeteren. Op MATH-500 verschoof geen enkele edit de score met meer dan ongeveer een punt, en Astra zelf rapporteerde dat de winst niet was vastgesteld.
| Gemma 3 270M | MATH-500 |
|---|
| Origineel model | 6,8% |
| Beste bewerkte versie | 7,7% |
Toen Astra keek waar Gemma de fout in ging, vond het gewone fouten zoals slechte rekenstappen en verkeerde algebra. Er was geen enkel kapot onderdeel om uit te schakelen, dus Techniek 4 had niets om mee te werken.
Kortom: gewichten bewerken kon iets verwijderen dat een vaardigheid blokkeerde, maar het kon geen vaardigheid toevoegen die het model nooit had.
Vaardigheid 3: Hoe een LLM neurale netwerkgewichten schrijft (Techniek 5)
Nu komen we bij het deel dat mij persoonlijk het meest verraste. Hier begint Astra met een netwerk waarin elk gewicht nul is en moet het alle getallen zelf kiezen.
Techniek 5: Een programma plannen en het omzetten in getallen
De techniek is eenvoudig te beschrijven. Astra plant eerst een programma, beslist wat elke laag moet doen, en kiest vervolgens gewichten die elke laag dat werk laten doen.
De onderzoekers gebruikten MinAtar, een set vereenvoudigde Atari-spellen, en kozen Breakout, Seaquest en Asterix. Voor elk spel kreeg Astra:
- de spelregels
- de broncode van het spel
- een leeg netwerk met elk gewicht op nul
Het had geen trainingsdata, geen tools en mocht het netwerk niet eens testen in het spel. Het typte al de gewichten in één enkele reply uit, en daarna testten de onderzoekers het resultaat.
Voor Breakout zag het plan er bijvoorbeeld zo uit:
- Laag 1: uitwerken waar de bal gaat landen (inclusief stuiteren tegen de muren).
- Laag 2: de paddle naar die plek bewegen.
| Spel | PPO, 100M stappen | PPO, 500M stappen | Astra (één reply, geen training) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Zoals je ziet, versloegen Astra’s netwerken die welke voor 100 miljoen stappen waren getraind in alle 3 de spellen. Tegen de netwerken die 500 miljoen stappen waren getraind, scoorde het in Breakout ongeveer 20 keer hoger, kwam het in de buurt in Asterix en haalde het ongeveer 60% van de score in Seaquest.
Een Go-speler bouwen
De spelnetwerken hierboven waren klein genoeg voor Astra om in één reply uit te typen. Voor Go maakten de onderzoekers het een stuk moeilijker, met een netwerk van ongeveer 1,5 miljoen gewichten. Dat is veel te groot om zelfs maar in Astra’s prompt te passen.
In plaats daarvan gaven ze Astra een Python-werkruimte waarin het de gewichten kon bekijken en opslaan (aanvankelijk allemaal nul) maar het netwerk niet kon draaien. Als het zijn netwerk wilde testen, moest het 1 van een beperkt aantal testruns inzetten, variërend van 0 tot 50, waarbij elke testrun 128 partijen speelde op een 9×9-bord.
Astra bouwde dit netwerk ook als een Go-programma:
- De vroege lagen markeren waar de stenen van elke speler liggen.
- De middenlagen volgen ketens van verbonden stenen om groepen te spotten die gevaar lopen.
- De laatste laag geeft elke mogelijke zet een score. Zetten die stenen vangen of eigen groepen redden krijgen punten, en domme fouten kosten punten.
Je denkt misschien dat dit erg op een compiler lijkt, en dat klopt. Het is erg vergelijkbaar met wat DeepMind’s Tracr doet: een programma omzetten in exacte transformergewichten. Het verschil is dat Tracr het programma in een speciale taal nodig heeft, terwijl Astra zelf met het programma komt vanuit een doel in gewone taal.
Waarom testen zo’n groot verschil maakt
Tegen deze tijd is het je waarschijnlijk opgevallen dat de spelregels per experiment verschilden. In de spelherkenning-, vormen-, auto- en MinAtar-experimenten had Astra helemaal geen tools, terwijl het in de taal-, Go-, people-pleaser- en Qwen-experimenten Python kon gebruiken en soms het netwerk kon testen.
Dit is naar mijn mening het meest onderbelichte deel van de hele post, omdat het aantal tests duidelijk veel uitmaakte:
- Go: met nul testruns won Astra’s netwerk meer dan de helft van zijn partijen tegen twee kleinere getrainde netwerken. Met 50 testruns versloeg het een getraind netwerk van dezelfde grootte dat had geleerd van 20 miljoen partijen.
- Qwen: met 10 of 25 testruns bleven de loops grotendeels. De grote sprong kwam pas bij 50. Dit zijn enkele gerapporteerde runs, dus zie het patroon als suggestief in plaats van bewezen.
- De people-pleaser (een extra hint in plaats van testruns, maar een vergelijkbaar effect): op basis van alleen gewichten faalde het elke keer, maar met één extra hint over attention kreeg het alle 3 paren goed.
Dus de resultaten zonder tools zijn het meest verrassend, maar het betekent ook dat je niet elk experiment eerlijk met elkaar kunt vergelijken.
Hoe doet GPT-6 Astra dit eigenlijk?
Er is ook een patroon over alle technieken heen: Astra werkt veel zoals een menselijke engineer zou doen.
- Plan het programma. Het beslist eerst wat elke laag moet doen, zoals “uitrekenen waar de bal zal landen”.
- Zet het plan om in getallen. Het kiest dan gewichten die elke laag dat werk laten doen.
- Maak de kleinst mogelijke wijziging. Bij het fixen van een netwerk voegt het één klein stuk toe of haalt het weg, zoals de snelkoppeling in de auto of de verborgen schuif in Qwen.
- Test het (als het mag). Als het testruns heeft, kijkt het hoe zijn netwerk faalt en houdt het alleen de veranderingen die helpen.
Programmeren in gewichtsruimte vs. fine-tunen en modelediting
Je vraagt je misschien af hoe dit verschilt van fine-tunen of van andere manieren om een model te bewerken. De tabel hieronder vergelijkt de meest verwante methoden, met daarbij welke van de 5 technieken het dichtst in de buurt komt:
| Methode | Hoe de gewichten veranderen | Trainingsdata nodig? | Waarvoor het wordt gebruikt | Dichtstbijzijnde techniek |
|---|
| Fine-tuning / LoRA | Een trainingsalgoritme past veel gewichten aan | Ja | Een model een nieuwe taak of stijl aanleren | Geen |
| ROME | Één kleine, gerichte wiskundige update | Een paar voorbeelden | Één feit dat het model kent veranderen | Techniek 3 |
| Task arithmetic | “Vaardigheids”-gewichten optellen of aftrekken | Ja | Getrainde vaardigheden combineren of verwijderen | Techniek 4 |
| Abliteration | Één richting verwijderen | Een paar honderd prompts | Één gedrag verwijderen, zoals weigeren | Techniek 4 |
| Weight Oracles | Niets, het leest alleen | Ja, om het te trainen | Verborgen problemen spotten uit de gewichten | Technieken 1 en 2 |
| Programmeren in gewichtsruimte | Een LLM redeneert en bewerkt | Nee | Gewichten lezen, fixen en schrijven vanuit een doel in gewone taal | Alle 5 |
Laat me er kort een paar toelichten:
- ROME liet in 2022 al zien dat feiten als “de Space Needle staat in Seattle” in specifieke lagen zijn opgeslagen en met één kleine update kunnen worden veranderd.
- Task arithmetic liet zien dat als je een gefinetuned model neemt en het originele model eraf trekt, je een set “vaardigheids”-gewichten overhoudt die je aan andere modellen kunt toevoegen (of eruit kunt halen).
- Weight Oracles is de naaste verwant. Het is een paper uit oktober 2026 dat taalmodellen traint om specifiek de gewichten van andere netwerken te lezen en problemen zoals backdoors te spotten, als proof of concept op speelgoedtransformers.
Het grote verschil met Weight Oracles is dat die voor deze ene taak getraind zijn, terwijl programmeren in gewichtsruimte een normaal, kant-en-klaar LLM gebruikt.
Naar mijn eerlijke mening is het nieuwe hier niet dat gewichten te bewerken zijn, want dat weten we al jaren. Het is dat één algemeen model al deze verschillende klussen klaarde door erover te redeneren.
Beperkingen van programmeren in gewichtsruimte
Hoewel deze resultaten spannend zijn, vind ik het belangrijk ze zorgvuldig te lezen. De auteurs zelf noemen het “zeer vroege resultaten”. Dit zijn de voornaamste zorgen die zijn geuit:
1. Het fixt, het verbetert niet
Zoals de Gemma-controle laat zien, kwam de grote Qwen-sprong vooral door het stoppen van de loops. Een analyse van de eigen logs van de auteurs, gerapporteerd door XenoSpectrum, telde 579 achtergehouden oefenproblemen die Qwen na de edit nieuw oploste. Daarvan waren er 576 eerder afgebroken door de tokenlimiet.
2. Slechts één frontier-LLM is getest
Elk experiment in de post gebruikte GPT-6 Astra. Simon Willison heeft sindsdien de spelherkenningstaak gereproduceerd op zijn laptop met de open-gewicht Qwen 3.8 27B, al miste die één van de spellen. Of andere frontiermodellen Astra kunnen evenaren op de reparatie- en schrijfontwerpen is iets wat de geplande benchmark van de auteurs moet beantwoorden.
3. Het is niet peer-reviewed
Dit is een blogpost en geen gepubliceerd paper. De auteurs brachten volledige logs uit, en Ahsen Khaliq van Hugging Face bouwde het bewerkte Qwen-model opnieuw op uit die logs en draaide de evaluatie opnieuw, wat volgens de auteurs 51,0% scoorde op MATH-500, met 31,6% van de antwoorden die nog steeds de tokenlimiet raken. Dat is een nuttige check op de vrijgegeven checkpoint, maar niet hetzelfde als een onafhankelijke replicatie van Astra die de edit doet.
4. De gerapporteerde resultaten kunnen gunstig zijn
Kritiek is dat eerdere promptproeven niet in de gerapporteerde resultaten zijn opgenomen en dat Astra’s redeneerinspanning varieerde tussen experimenten. Ik kon ook geen test vinden van hoeveel de resultaten veranderen als de prompt iets anders wordt geformuleerd.
5. We kennen de kosten niet
De beste Qwen-run vergde 158 gespreksslagen en 20,3 uur, inclusief 4,7 uur die verloren gingen door een storing. De post vergelijkt dit niet met het model normaal fine-tunen, dus we kunnen nog niet zeggen of het tijd of geld bespaart.
6. De vergelijkingen zijn wat coulant
De spelresultaten worden vergeleken met getrainde netwerken, maar niet met eenvoudige handgeschreven code. Een Breakout-speler die gewoon de bal volgt is niet zo moeilijk om als normaal programma te schrijven, dus een getraind netwerk daar verslaan is minder verrassend dan het klinkt. De auteurs antwoorden dat elke baseline alleen de smalle claim van zijn eigen experiment test, zoals hoe ver je komt zonder enige ervaring.
Om de auteurs recht te doen: ze waren erg open over wat niet werkte, inclusief de people-pleaser en Gemma-resultaten, wat ik waardeer. Maar ik zou de kopcijfers zien als een veelbelovend vroeg signaal in plaats van bewijs dat dit algemeen werkt.
Toepassingen van programmeren in gewichtsruimte
Zelfs met al die beperkingen is het spannend om te bedenken waar dit heen kan als het blijft verbeteren. Dit zijn de mogelijke toepassingen die de auteurs noemen:
| Toepassing | Hoe het eruit zou kunnen zien |
|---|
| Modellen checken zonder ze te testen | Verborgen problemen, zoals backdoors, vinden door alleen de gewichten te lezen vóór een model ooit wordt uitgebracht. |
| Goedkoper modellen bouwen | Een goed netwerk in één keer opzetten, in plaats van veel data te verzamelen en lange trainingjobs te draaien. |
| Vaardigheden toevoegen of verwijderen zonder data | Een LLM vragen om een vaardigheid direct uit een model te verwijderen. Omdat slechts enkele gewichten veranderen, blijft de rest van het model hetzelfde, wat het veelvoorkomende fine-tuneprobleem voorkomt dat modellen vergeten wat ze al wisten. |
| Verschillende modellen mixen | Een nuttig stuk, zoals een redeneermodule, uit het ene model verplaatsen naar een heel ander model. Huidige merge-methoden werken alleen wanneer beide modellen hetzelfde ontwerp hebben. |
| AI die zichzelf verbetert | Een model dat zijn eigen gewichten leest en verbetert, in plaats van alleen code te schrijven die trainingjobs start. |
Dat laatste is precies waarom niet iedereen enthousiast is over dit onderzoek. Maxime Fournes, de CEO van PauseAI, noemde de onderzoekslijn roekeloos, omdat echte vooruitgang hier risicovolle AI-ontwikkeling kan versnellen. Ik wil wel benadrukken dat deze post geen vorm van zelfverbetering liet zien.
Er is ook een positievere veiligheidsinvalshoek. Als LLM’s betrouwbaar dingen als people-pleasing of verborgen backdoors kunnen spotten door alleen de gewichten te lezen, kan dat een nuttige manier worden om modellen te checken voordat we ze uitbrengen.
Wat komt hierna?
De auteurs zeggen dat ze nu een benchmark bouwen om te meten hoe goed verschillende LLM’s hierin zijn, samen met een harnas om ze te helpen. Enkele vragen waar de onderzoekers aan zullen werken:
- Kunnen andere LLM’s dit ook, of is er iets speciaals aan Astra?
- Kan het ooit echt nieuwe vaardigheden toevoegen, of alleen problemen zoals loops verwijderen?
- Werkt het op veel grotere modellen met duizenden keren meer gewichten?
- Wordt het ooit goedkoper dan normaal fine-tunen?
Er is snel doorgewerkt sinds publicatie. In een update van 12 november zeggen de auteurs dat er meer dan honderd replicaties en uitbreidingen bestaan, waaronder naar robotpolicies en quantumcircuits, en een benchmark genaamd IWIBench.
Als je het werk zelf wilt bekijken, kun je de volledige logs van elk experiment zien op GitHub, inclusief elke prompt die naar Astra is gestuurd en een samenvatting van zijn redenering. Het gefixte Qwen-model staat ook op Hugging Face met een live demo die je in je browser kunt proberen, gelinkt vanuit de oorspronkelijke blogpost.
Slotgedachten
Programmeren in gewichtsruimte is een nieuw idee met vroege aanwijzingen. Een kant-en-klaar LLM, zonder enige training, wist te lezen wat kleine netwerken doen, een vastgelopen auto en een loepend taalmodel te fixen en zelfs spelende netwerken from scratch te bouwen.
Wat mij het meest verraste, was hoe het dat deed. Het gebruikte geen mysterieus trucje, maar las de randen van netwerken, zocht naar circuits, voegde snelkoppelingen toe, verwijderde richtingen en plande programma’s voordat het ze in getallen omzette, net als een engineer zou doen.
Maar ik wil benadrukken dat dit een vroeg verslag is op basis van één model, en dat het grootste resultaat kwam door een bug te fixen in plaats van het model slimmer te maken. Als het blijft verbeteren, is de waarschijnlijk nuttigste toepassing het auditen en debuggen van modellen, niet het vervangen van training.
Als je je achtergrond wilt opbouwen om dit soort onderzoek te kunnen volgen, behandelt onze cursus Large Language Models (LLMs) Concepts hoe deze modellen onder de motorkap werken. En als je geïnteresseerd bent in de agent-kant, is Introduction to AI Agents een mooie volgende stap.




Stel je voor dat ik je favoriete liedje neem, het audiobestand uitprint als één lange lijst met getallen en die aan je geef. Kun jij dan vertellen welk liedje het is door alleen naar de getallen te kijken?
Het liedje zit er zeker in, maar het is verstopt in duizenden waarden die op zichzelf niets voor ons betekenen.
Neurale netwerken hebben precies hetzelfde probleem. Alles wat een netwerk weet, wordt opgeslagen in zijn gewichten, en dat zijn gewoon getallen.
Zolang deep learning bestaat, konden we niet naar die getallen kijken en met zekerheid zeggen dat dit netwerk Breakout speelt of dat netwerk een bepaalde taak uitvoert. We zijn ook nooit in staat geweest om die getallen zelf te schrijven voor iets groters dan een speelgoednetwerk. Dat werk lieten we altijd over aan training.
Op 2 november 2026 liet een team van het MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) zien dat een toonaangevend large language model (LLM), GPT-6 Astra van OpenAI, beide kan. Het kan naar de ruwe gewichten van een netwerk kijken, uitvogelen wat het doet, vinden wat kapot is en zelfs een gloednieuw netwerk from scratch schrijven, allemaal zonder enige training. De auteurs, Rikiya Takehi, Jayden Teoh, Alex Zhang en Omar Khattab, noemen dit programmeren in gewichtsruimte in hun oorspronkelijke blogpost.
Dus in dit artikel wil ik me focussen op hoe het daadwerkelijk werkt. Ik heb alles geordend naar de techniek die het LLM gebruikte in plaats van per experiment. Als je de resultaten eerst wilt zien, bekijk dan onze overzichtspost over programmeren in gewichtsruimte.
Als je eerst een opfrisser wilt over hoe LLM’s en de transformerarchitectuur waarop ze zijn gebouwd werken voordat we de technieken induiken, behandelt onze cursus Introduction to LLMs in Python de basis. Dat helpt wanneer we kijken naar de modellen die gewichten lezen en schrijven.
In een notendop
Dit is wat we behandelen:
Wat is programmeren in gewichtsruimte?
Programmeren in gewichtsruimte is het idee om de gewichten van een neuraal netwerk te behandelen als een programma: een algemeen LLM leest en schrijft de gewichten direct door te redeneren over wat elk onderdeel van het netwerk doet, in plaats van te leunen op een trainingsalgoritme zoals gradient descent.
In hele simpele taal: het LLM opent het netwerk, kijkt zelf naar de getallen en verandert ze doelbewust.
Ik zie het graag als het verschil tussen een hond trainen en een robothond herbedraden. Trainen betekent veel voorbeelden laten zien en hopen dat het gedrag langzaam verandert, terwijl herbedraden betekent dat je naar binnen gaat, het verantwoordelijke onderdeel vindt en het direct aanpast.
Dit is niet hetzelfde als een LLM dat een trainingsscript voor je schrijft, wat LLM’s al een tijd kunnen. Hier is er helemaal geen trainingsscript, en werkt het LLM met de daadwerkelijke getallen.
De auteurs benadrukken dat programmeren in gewichtsruimte een concept is in plaats van één enkele methode, en dat het gradients niet uitsluit. Ze verboden gradients in deze experimenten om te isoleren wat redeneren alleen kan doen.
De post test het idee op 3 manieren, wat volgens mij de makkelijkste manier is om het geheel te begrijpen (zie Figuur 1):
Figuur 1: De 3 geteste vaardigheden in de post. Afbeelding door de auteur.
Het LLM dat dit allemaal doet is GPT-6 Astra, dat OpenAI op 3 september 2026 uitbracht. In een paar van de experimenten schakelden de onderzoekers alle tools uit (inclusief websearch en code uitvoeren), zodat het alleen de getallen kon lezen en nadenken.
Elke van deze 3 vaardigheden gebruikt zijn eigen set technieken, en dat is waar de rest van dit artikel over gaat.
Hoe worden neurale netwerkgewichten normaal gemaakt?
Voordat we de technieken induiken, helpt het om te weten hoe gewichten normaal gesproken worden gecreëerd. Anders is het lastig te zien waarom dit onderzoek zo verrassend is.
Een opfrisser over trainen
Een neuraal netwerk is een enorme verzameling getallen, gewichten (of parameters) genoemd. Wanneer je het netwerk een input geeft, zoals een afbeelding of een zin, vermenigvuldigt en telt het deze getallen op om een output te produceren. Dit heet een forward pass.
Training is het proces van goede waarden kiezen voor deze getallen. De standaardmanier is gradient descent: draai het netwerk, meet hoe fout het antwoord was, bepaal in welke richting elk gewicht moet bewegen om het een beetje minder fout te maken, en verplaats dan elk gewicht een klein stukje. Je herhaalt dit miljoenen keren, wat training zo duur maakt.
De vier manieren waarop gewichten worden geschreven
Elk neuraal netwerk dat je ooit hebt gebruikt, had zijn gewichten door iets laten kiezen. Tot nu toe was dat één van 4 dingen:
AdderBoard is een ongewoon geval. Het is een community-uitdaging om de kleinste transformer te bouwen die twee 10-cijferige getallen kan optellen, en mensen hebben handgemaakte inzendingen met minder dan een dozijn unieke gewichtwaarden. Dat staat mijlenver af van de schaal van een model zoals ChatGPT.
Programmeren in gewichtsruimte voegt een vijfde optie toe aan deze lijst: een algemeen LLM dat over de gewichten redeneert.
Figuur 2: Normale training vergeleken met programmeren in gewichtsruimte. Afbeelding door de auteur.
Dus waarom kunnen we de gewichten niet gewoon lezen?
Als gewichten gewoon getallen zijn, waarom is het dan zo moeilijk om ze te lezen? Daar zijn 2 hoofdredenen voor.
Ten eerste slaat een netwerk niet één idee op één plek op. Een enkel idee is meestal verdeeld over veel neuronen, en een enkel neuron helpt meestal aan meerdere ideeën tegelijk mee.
Ten tweede kan hetzelfde netwerk op veel verschillende manieren worden geschreven. Je kunt de volgorde van neuronen binnen een laag husselen, de volgende laag daarop aanpassen, en het netwerk gedraagt zich precies hetzelfde. Dus 2 netwerken die hetzelfde doen, kunnen gewichten hebben die er heel verschillend uitzien.
Houd deze 2 problemen in gedachten, want elke techniek hieronder is in wezen een manier om ze te omzeilen.
Waarom programmeren in gewichtsruimte een grote stap is
De post kreeg zoveel aandacht omdat het een grotere trend doortrekt. De afgelopen jaren vroegen we LLM’s om steeds meer dingen zelf te verbeteren:
Figuur 3: Wat we LLM’s hebben gevraagd te verbeteren door de tijd heen. Afbeelding door de auteur.
Let op dat dit allemaal tekst is: dingen zoals prompts en Python-bestanden die mensen ook met de hand kunnen bewerken. De auteurs wijzen erop dat we LLM’s alleen op tekst hebben gebruikt omdat we geen betere manier hadden om die te verbeteren. Voor gewichten hadden we al gradient descent, dus niemand dacht er echt aan om het te vragen.
Deze post vraagt wat er gebeurt als we het trainingsscript volledig overslaan en het LLM de gewichten zelf laten veranderen.
Vaardigheid 1: Hoe een LLM neurale netwerkgewichten leest (Technieken 1 en 2)
De onderzoekers begonnen met netwerken die klein genoeg waren om al hun gewichten als platte tekst direct in Astra’s prompt te plakken, en gingen daarna naar grotere modellen die Astra met Python analyseerde. Astra gebruikte 2 hoofdtechnieken om ze te lezen.
Techniek 1: Structuur lezen uit de input- en outputgewichten
Wat mij betreft is de makkelijkste plek om te beginnen met het lezen van een netwerk aan zijn randen. De eerste laag is direct verbonden met de input (zoals de pixels van een scherm) en de laatste laag is direct verbonden met de output (zoals de zetten die een speler kan doen). Dit zijn de enige lagen waarbij we weten waar elk getal mee is verbonden.
Welk spel speelt dit netwerk?
De onderzoekers trainden 4 kleine netwerken met Proximal Policy Optimization (PPO), een reinforcement learning-algoritme, om vereenvoudigde 10×10-rooster-versies van Breakout, Pong, Pac-Man en Freeway te spelen.
Het slimme aan deze opzet is dat alle 4 de netwerken precies even groot waren (elk 17.253 gewichten), dezelfde inputs namen en dezelfde bewegingen konden maken. Dus de enige manier om ze te onderscheiden was door de getallen te lezen.
Ze plakten de gewichten van elk netwerk in Astra en vroegen: “Op welk spel is dit netwerk getraind?” zonder een keuzelijst te geven. Astra noemde nog steeds bij alle 4 de netwerken het juiste spel.
Figuur 4: Astra leest ruwe gewichten en identificeert Breakout. Afbeelding door de auteur.
Wat mij opviel was hoe het dit uitpuzzelde. Voor het Breakout-netwerk redeneerde het ongeveer zo:
Die aanwijzingen samen geven Breakout. De eerste 2 aanwijzingen komen uit de inputgewichten en de laatste uit de outputgewichten, precies deze techniek.
Welke vorm tekent dit model?
Vervolgens trainden de onderzoekers kleine beeldgeneratiemodellen (diffusiemodellen, dezelfde familie achter de meeste AI-beeldgeneratoren) om cirkels, driehoeken of vierkanten te tekenen. Opnieuw kreeg Astra alleen de gewichten, zonder tools en zonder het model te kunnen draaien, en het noemde de juiste vorm voor elk model.
Er was één merkwaardige fout: Astra beschreef elke vorm als een omtrek, terwijl de modellen de vormen ingevuld tekenen. De onderzoekers stellen dat dit een goed teken is, omdat het suggereert dat Astra de randen van de vorm in de gewichten las in plaats van stiekem het hele model in zijn hoofd te draaien.
Techniek 2: Circuits vinden in de middenlagen
In de eerste 2 experimenten kon Astra wegkomen met het lezen van alleen de eerste of laatste laag van het netwerk. Dat werkt niet voor echte taalmodellen, waar het meeste denken in de middenlagen gebeurt.
Hier komt de tweede techniek binnen: circuits vinden. Een circuit is een kleine groep onderdelen in een netwerk die samenwerken om één specifieke taak te doen. Als je herkent wat het doet, leer je veel over het netwerk zonder te weten wat de inputs zijn.
Welke taal leerde dit model?
Om dit te testen trainden de onderzoekers 3 kleine taalmodellen (elk rond de 7,2 miljoen gewichten):
Vervolgens sneden ze de eerste en laatste laag af van elk model, zodat alleen 4 middenblokken overbleven. Zonder die lagen zegt niets in de gewichten welk getal voor welke letter staat, dus het model kan niet eens op tekst draaien, en Techniek 1 valt af.
Astra mocht de getallen dit keer met Python analyseren, maar het model niet draaien. Toch noemde het de juiste taal voor alle 3 modellen in beide pogingen, al was het per keer maar zo’n 50 tot 60% zeker.
Hoe spotte het Python? Het zocht naar induction heads.
Induction heads zijn onderdelen van een transformer die opmerken wanneer een patroon eerder in de tekst is verschenen en kopiëren wat erna kwam, zoals “tot” aanvullen tot “total” omdat “total” eerder stond. Code herhaalt variabelen veel vaker dan normaal proza, dus een Python-model heeft hier meer van nodig. Astra vond er elk afzonderlijk zonder andere ten onrechte zo te labelen.
Astra vond ze door de gewichtsmatrices van verschillende heads met elkaar te vermenigvuldigen om te zien welke heads met elkaar “praten”. Dit sluit aan bij een techniek uit het paper A Mathematical Framework for Transformer Circuits uit 2021, waar de onderzoekers het niet op wezen.
Voor romaji merkte Astra op dat het model minder letters leek bij te houden. Dat klopt, want romaji gebruikt nooit letters als q, l, v of x.
Waar lezen stukloopt: welk model is de people-pleaser?
Hier houden deze 2 technieken op te werken. Dit is het ene experiment dat in eerste instantie niet werkte.
De onderzoekers namen 2 kopieën van Google’s Gemma 3 270M en fine-tuneden ze op exact dezelfde manier, met één verschil. Eén kopie leerde het juiste antwoord te geven, de andere werd sycophantisch, wat betekent dat het altijd het antwoord geeft dat de gebruiker suggereert. Ze vroren ook de input- en outputlagen, zodat Astra niet de shortcut kon nemen om die te inspecteren. Hier is een illustratief voorbeeld:
Op basis van alleen de gewichten kon Astra niet zeggen welk model het vleiersmodel was in geen van zijn 4 pogingen. Het vond genoeg verschillen tussen de 2 modellen, maar kon die niet aan het gedrag koppelen.
Dus gaven de onderzoekers één extra hint. Ze lieten Astra zien waar elke attention head naar keek terwijl de modellen tekst lazen die Astra zelf schreef (maar niet de daadwerkelijke antwoorden van de modellen). Hiermee pikte Astra de people-pleaser correct uit in alle 3 paren modellen.
Het vond zelfs waar het verschil zat. In attention head 10.2 besteedde het eerlijke model 94,3% van zijn aandacht aan de getallen in de vraag, terwijl de vleier 85,7% van zijn aandacht besteedde aan het antwoord dat de gebruiker suggereerde.
Ik wil dit benadrukken omdat het naar mijn mening het belangrijkste resultaat in de post is. Het laat zien dat gedrag uit alleen de gewichten lezen op een echt taalmodel nog steeds heel moeilijk is, zelfs voor een frontiermodel als GPT-6 Astra.
Vaardigheid 2: Hoe een LLM neurale netwerkgewichten fixt (Technieken 3 en 4)
Gewichten lezen is indrukwekkend, maar ze fixen is een grotere en moeilijkere stap. Astra moet begrijpen wat het netwerk doet, uitwerken wat het zou moeten doen en dan de juiste getallen veranderen om dat gat te dichten. Het gebruikte hiervoor 2 heel verschillende technieken.
Techniek 3: Een kleine snelkoppeling toevoegen
Deze techniek laat het grootste deel van het netwerk met rust en voegt een klein circuit toe dat alleen aangaat in precies die ene situatie waar het oorspronkelijke netwerk faalt.
De auto die steeds vastloopt
Voor dit experiment gebruikten de onderzoekers een 2D-fysicaspel genaamd Kinetix en trainden ze een netwerk met PPO om een auto een helling op te rijden. De auto moet eerst achteruit om genoeg aanloop te nemen, en daarna pas vooruit versnellen.
Het getrainde netwerk doorzag dit nooit. Het reed gewoon recht op de helling af en liep elke keer vast.
Dus gaven de onderzoekers Astra 3 dingen:
In één keer, zonder tools, legde Astra uit waarom de auto faalde en schreef het nieuwe gewichten. Na de aanpassing slaagde de auto in alle 1.024 testepisodes (van 0 af), en Astra had slechts 3,5% van de gewichten veranderd.
Astra herschreef het hele netwerk niet. Het voegde een kleine snelkoppeling toe via een paar neuronen in elke laag, die het begin overneemt, de auto laat terugrijden en hem vooruit lanceert. Zodra de auto voorbij de rode strook is, schakelt de snelkoppeling zichzelf uit, en rijdt het oorspronkelijke netwerk de rest.
Ik zie dit als een rijinstructeur die het stuur overneemt op één lastig stuk weg en het dan meteen teruggeeft aan de leerling. Het werkt omdat het oorspronkelijke netwerk niet volledig kapot was. Het kon al rijden maar kon één lastig moment niet aan, dus alles verder met rust laten was logisch.
Techniek 4: Een richting vinden en verwijderen
Deze techniek is gebaseerd op het idee dat een gedrag langs één enkele richting in het model kan liggen, zodat je het kunt uitschakelen door die richting uit de gewichten te verwijderen.
Het model dat zichzelf bleef herhalen
Dit is het experiment dat viraal ging, dus laten we het in meer detail bekijken.
De onderzoekers namen Qwen3.5-0.8B, een klein open-source redeneermodel, en vroegen Astra om het beter in wiskunde te maken door alleen zijn gewichten te bewerken. Dit keer had Astra een Python-notebook met het model geladen, en kon het het model een beperkt aantal keren draaien op oefenwiskundeproblemen (10, 25 of 50 testruns, die de auteurs forward passes noemen). Maar opnieuw was geen training toegestaan.
Astra merkte al snel dat het model vast kwam te zitten in loops, dezelfde woorden bleef herhalen en nooit tot een antwoord kwam. Van de eerste 96 oefenantwoorden liepen er 85 simpelweg door tot ze de limiet van 32.768 tokens bereikten.
Dit is een bekend probleem bij kleine redeneermodellen, en Qwens eigen modelkaart waarschuwt hiervoor. Een paper uit december 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, vond dat kleinere modellen meer loopen dan grotere uit dezelfde familie, en dat kleine modellen die gedistilleerd zijn van een groter model nog meer loopen dan hun bronmodel.
Astra herleidde het loopen tot één verborgen patroon in het model, wat onderzoekers een richting noemen. Als het helpt, kun je een richting zien als een verborgen schuifregelaar in het model. In dit geval duwde de schuif richting herhaling, en hij zat in lagen 15 en 19.
Astra verwijderde die schuif vervolgens simpelweg uit 131.072 gewichten (64 outputkolommen in elk van die 2 lagen), wat slechts 0,016% van het hele model is.
De wiskunde erachter
De Qwen-fix lijkt sterk op een bestaande truc genaamd abliteration. In 2024 lieten onderzoekers zien dat de gewoonte van een model om verzoeken te weigeren wordt gestuurd door één enkele richting, en dat je die richting uit de gewichten kunt verwijderen om het weigeren te stoppen.
De wiskunde erachter is verrassend genoeg één regel, waarbij
rde eenheidsrichting is die je wilt verwijderen:W_new = W - r (rᵀ W)Om dit begrijpelijker te maken, een klein voorbeeld. Stel dat een gewicht uit 2 delen bestaat,
(3, 2). Het eerste getal is hoeveel het het model richting loopen duwt, het tweede getal is al het andere dat het doet.Onze looprichting is
r = (1, 0), wat gewoon “het eerste getal” betekent. De formule haalt het loopdeel (3) eruit en laat ons achter met(0, 2). Het loopdeel is weg en de rest blijft exact hetzelfde.Het belangrijkste punt is dat Astra de looprichting zelf heeft gevonden, door over de gewichten te redeneren en het model op oefenproblemen te draaien, terwijl abliteration een paar honderd voorbeeldprompts nodig heeft om hem te vinden. Hier zijn de resultaten in meer detail (voor alle 8 experimenten naast elkaar, zie ons overzicht van programmeren in gewichtsruimte):
Figuur 5: Qwen3.5-0.8B vóór en na Astra’s edit. Afbeelding door de auteur.
Ik wil dat je hier 2 dingen opmerkt. Ten eerste is loopen niet alleen een wiskundeprobleem, dus de fix maakte het model ook veel beter in het volgen van instructies (IFEval ging van 21,0% naar 62,3% in de 50-runversie). Ten tweede bleven met 10 of 25 testruns de loops grotendeels, en de grote sprong kwam pas bij 50.
Waar fixen stukloopt: fixen is niet hetzelfde als verbeteren
Hier is het deel dat volgens mij elke lezer moet weten. Het stoppen van loops is niet hetzelfde als een model beter maken in wiskunde. Het zorgt er alleen voor dat het model antwoorden afmaakt die het al wist uit te werken.
Om dit te checken, draaiden de onderzoekers hetzelfde experiment op Gemma 3 270M, een klein model dat zelden loopen (slechts 8,5% van zijn antwoorden raakt de tokenlimiet, vergeleken met 93% voor Qwen). Dit keer kon Astra het nauwelijks verbeteren. Op MATH-500 verschoof geen enkele edit de score met meer dan ongeveer een punt, en Astra zelf rapporteerde dat de winst niet was vastgesteld.
Toen Astra keek waar Gemma de fout in ging, vond het gewone fouten zoals slechte rekenstappen en verkeerde algebra. Er was geen enkel kapot onderdeel om uit te schakelen, dus Techniek 4 had niets om mee te werken.
Kortom: gewichten bewerken kon iets verwijderen dat een vaardigheid blokkeerde, maar het kon geen vaardigheid toevoegen die het model nooit had.
Vaardigheid 3: Hoe een LLM neurale netwerkgewichten schrijft (Techniek 5)
Nu komen we bij het deel dat mij persoonlijk het meest verraste. Hier begint Astra met een netwerk waarin elk gewicht nul is en moet het alle getallen zelf kiezen.
Techniek 5: Een programma plannen en het omzetten in getallen
De techniek is eenvoudig te beschrijven. Astra plant eerst een programma, beslist wat elke laag moet doen, en kiest vervolgens gewichten die elke laag dat werk laten doen.
De onderzoekers gebruikten MinAtar, een set vereenvoudigde Atari-spellen, en kozen Breakout, Seaquest en Asterix. Voor elk spel kreeg Astra:
Het had geen trainingsdata, geen tools en mocht het netwerk niet eens testen in het spel. Het typte al de gewichten in één enkele reply uit, en daarna testten de onderzoekers het resultaat.
Voor Breakout zag het plan er bijvoorbeeld zo uit:
Zoals je ziet, versloegen Astra’s netwerken die welke voor 100 miljoen stappen waren getraind in alle 3 de spellen. Tegen de netwerken die 500 miljoen stappen waren getraind, scoorde het in Breakout ongeveer 20 keer hoger, kwam het in de buurt in Asterix en haalde het ongeveer 60% van de score in Seaquest.
Een Go-speler bouwen
De spelnetwerken hierboven waren klein genoeg voor Astra om in één reply uit te typen. Voor Go maakten de onderzoekers het een stuk moeilijker, met een netwerk van ongeveer 1,5 miljoen gewichten. Dat is veel te groot om zelfs maar in Astra’s prompt te passen.
In plaats daarvan gaven ze Astra een Python-werkruimte waarin het de gewichten kon bekijken en opslaan (aanvankelijk allemaal nul) maar het netwerk niet kon draaien. Als het zijn netwerk wilde testen, moest het 1 van een beperkt aantal testruns inzetten, variërend van 0 tot 50, waarbij elke testrun 128 partijen speelde op een 9×9-bord.
Astra bouwde dit netwerk ook als een Go-programma:
Je denkt misschien dat dit erg op een compiler lijkt, en dat klopt. Het is erg vergelijkbaar met wat DeepMind’s Tracr doet: een programma omzetten in exacte transformergewichten. Het verschil is dat Tracr het programma in een speciale taal nodig heeft, terwijl Astra zelf met het programma komt vanuit een doel in gewone taal.
Waarom testen zo’n groot verschil maakt
Tegen deze tijd is het je waarschijnlijk opgevallen dat de spelregels per experiment verschilden. In de spelherkenning-, vormen-, auto- en MinAtar-experimenten had Astra helemaal geen tools, terwijl het in de taal-, Go-, people-pleaser- en Qwen-experimenten Python kon gebruiken en soms het netwerk kon testen.
Dit is naar mijn mening het meest onderbelichte deel van de hele post, omdat het aantal tests duidelijk veel uitmaakte:
Dus de resultaten zonder tools zijn het meest verrassend, maar het betekent ook dat je niet elk experiment eerlijk met elkaar kunt vergelijken.
Hoe doet GPT-6 Astra dit eigenlijk?
Er is ook een patroon over alle technieken heen: Astra werkt veel zoals een menselijke engineer zou doen.
Programmeren in gewichtsruimte vs. fine-tunen en modelediting
Je vraagt je misschien af hoe dit verschilt van fine-tunen of van andere manieren om een model te bewerken. De tabel hieronder vergelijkt de meest verwante methoden, met daarbij welke van de 5 technieken het dichtst in de buurt komt:
Laat me er kort een paar toelichten:
Het grote verschil met Weight Oracles is dat die voor deze ene taak getraind zijn, terwijl programmeren in gewichtsruimte een normaal, kant-en-klaar LLM gebruikt.
Naar mijn eerlijke mening is het nieuwe hier niet dat gewichten te bewerken zijn, want dat weten we al jaren. Het is dat één algemeen model al deze verschillende klussen klaarde door erover te redeneren.
Beperkingen van programmeren in gewichtsruimte
Hoewel deze resultaten spannend zijn, vind ik het belangrijk ze zorgvuldig te lezen. De auteurs zelf noemen het “zeer vroege resultaten”. Dit zijn de voornaamste zorgen die zijn geuit:
1. Het fixt, het verbetert niet
Zoals de Gemma-controle laat zien, kwam de grote Qwen-sprong vooral door het stoppen van de loops. Een analyse van de eigen logs van de auteurs, gerapporteerd door XenoSpectrum, telde 579 achtergehouden oefenproblemen die Qwen na de edit nieuw oploste. Daarvan waren er 576 eerder afgebroken door de tokenlimiet.
2. Slechts één frontier-LLM is getest
Elk experiment in de post gebruikte GPT-6 Astra. Simon Willison heeft sindsdien de spelherkenningstaak gereproduceerd op zijn laptop met de open-gewicht Qwen 3.8 27B, al miste die één van de spellen. Of andere frontiermodellen Astra kunnen evenaren op de reparatie- en schrijfontwerpen is iets wat de geplande benchmark van de auteurs moet beantwoorden.
3. Het is niet peer-reviewed
Dit is een blogpost en geen gepubliceerd paper. De auteurs brachten volledige logs uit, en Ahsen Khaliq van Hugging Face bouwde het bewerkte Qwen-model opnieuw op uit die logs en draaide de evaluatie opnieuw, wat volgens de auteurs 51,0% scoorde op MATH-500, met 31,6% van de antwoorden die nog steeds de tokenlimiet raken. Dat is een nuttige check op de vrijgegeven checkpoint, maar niet hetzelfde als een onafhankelijke replicatie van Astra die de edit doet.
4. De gerapporteerde resultaten kunnen gunstig zijn
Kritiek is dat eerdere promptproeven niet in de gerapporteerde resultaten zijn opgenomen en dat Astra’s redeneerinspanning varieerde tussen experimenten. Ik kon ook geen test vinden van hoeveel de resultaten veranderen als de prompt iets anders wordt geformuleerd.
5. We kennen de kosten niet
De beste Qwen-run vergde 158 gespreksslagen en 20,3 uur, inclusief 4,7 uur die verloren gingen door een storing. De post vergelijkt dit niet met het model normaal fine-tunen, dus we kunnen nog niet zeggen of het tijd of geld bespaart.
6. De vergelijkingen zijn wat coulant
De spelresultaten worden vergeleken met getrainde netwerken, maar niet met eenvoudige handgeschreven code. Een Breakout-speler die gewoon de bal volgt is niet zo moeilijk om als normaal programma te schrijven, dus een getraind netwerk daar verslaan is minder verrassend dan het klinkt. De auteurs antwoorden dat elke baseline alleen de smalle claim van zijn eigen experiment test, zoals hoe ver je komt zonder enige ervaring.
Om de auteurs recht te doen: ze waren erg open over wat niet werkte, inclusief de people-pleaser en Gemma-resultaten, wat ik waardeer. Maar ik zou de kopcijfers zien als een veelbelovend vroeg signaal in plaats van bewijs dat dit algemeen werkt.
Toepassingen van programmeren in gewichtsruimte
Zelfs met al die beperkingen is het spannend om te bedenken waar dit heen kan als het blijft verbeteren. Dit zijn de mogelijke toepassingen die de auteurs noemen:
Dat laatste is precies waarom niet iedereen enthousiast is over dit onderzoek. Maxime Fournes, de CEO van PauseAI, noemde de onderzoekslijn roekeloos, omdat echte vooruitgang hier risicovolle AI-ontwikkeling kan versnellen. Ik wil wel benadrukken dat deze post geen vorm van zelfverbetering liet zien.
Er is ook een positievere veiligheidsinvalshoek. Als LLM’s betrouwbaar dingen als people-pleasing of verborgen backdoors kunnen spotten door alleen de gewichten te lezen, kan dat een nuttige manier worden om modellen te checken voordat we ze uitbrengen.
Wat komt hierna?
De auteurs zeggen dat ze nu een benchmark bouwen om te meten hoe goed verschillende LLM’s hierin zijn, samen met een harnas om ze te helpen. Enkele vragen waar de onderzoekers aan zullen werken:
Er is snel doorgewerkt sinds publicatie. In een update van 12 november zeggen de auteurs dat er meer dan honderd replicaties en uitbreidingen bestaan, waaronder naar robotpolicies en quantumcircuits, en een benchmark genaamd IWIBench.
Als je het werk zelf wilt bekijken, kun je de volledige logs van elk experiment zien op GitHub, inclusief elke prompt die naar Astra is gestuurd en een samenvatting van zijn redenering. Het gefixte Qwen-model staat ook op Hugging Face met een live demo die je in je browser kunt proberen, gelinkt vanuit de oorspronkelijke blogpost.
Slotgedachten
Programmeren in gewichtsruimte is een nieuw idee met vroege aanwijzingen. Een kant-en-klaar LLM, zonder enige training, wist te lezen wat kleine netwerken doen, een vastgelopen auto en een loepend taalmodel te fixen en zelfs spelende netwerken from scratch te bouwen.
Wat mij het meest verraste, was hoe het dat deed. Het gebruikte geen mysterieus trucje, maar las de randen van netwerken, zocht naar circuits, voegde snelkoppelingen toe, verwijderde richtingen en plande programma’s voordat het ze in getallen omzette, net als een engineer zou doen.
Maar ik wil benadrukken dat dit een vroeg verslag is op basis van één model, en dat het grootste resultaat kwam door een bug te fixen in plaats van het model slimmer te maken. Als het blijft verbeteren, is de waarschijnlijk nuttigste toepassing het auditen en debuggen van modellen, niet het vervangen van training.
Als je je achtergrond wilt opbouwen om dit soort onderzoek te kunnen volgen, behandelt onze cursus Large Language Models (LLMs) Concepts hoe deze modellen onder de motorkap werken. En als je geïnteresseerd bent in de agent-kant, is Introduction to AI Agents een mooie volgende stap.