Imaginează-ți că ți-am luat melodia preferată, am tipărit fișierul audio ca o listă lungă de numere și ți-am înmânat-o. Ai putea să-mi spui ce melodie este doar uitându-te la numere?
Melodia este cu siguranță acolo, dar e ascunsă în mii de valori care nu înseamnă nimic pentru noi luate separat.
Rețelele neuronale au exact aceeași problemă. Tot ce știe o rețea este stocat în greutățile ei, care sunt doar niște numere.
De când există deep learning, nu am putut să ne uităm la acele numere și să spunem cu încredere că această rețea joacă Breakout sau că acea rețea face o anumită sarcină. De asemenea, nu am putut niciodată să scriem noi înșine acele numere pentru altceva decât o rețea-jucărie. Acea treabă a fost mereu lăsată pe seama antrenării.
Pe 2 noiembrie 2026, o echipă de la MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) a arătat că un model frontieră de limbaj de mari dimensiuni (LLM), GPT-6 Astra de la OpenAI, poate face ambele. Poate să se uite la greutățile brute ale unei rețele, să-și dea seama ce face, să găsească ce e stricat și chiar să scrie o rețea complet nouă de la zero, toate fără nicio antrenare. Autorii, Rikiya Takehi, Jayden Teoh, Alex Zhang și Omar Khattab, numesc asta Programare în Spațiul Greutăților în postarea lor originală.
Așadar, în acest articol vreau să mă concentrez pe cum funcționează de fapt. Am organizat totul după tehnica folosită de LLM, nu după experiment. Dacă vrei mai întâi rezultatele experimentelor, vezi prezentarea noastră de ansamblu a Programării în Spațiul Greutăților.
Dacă vrei o recapitulare despre cum funcționează LLM-urile și arhitectura transformer pe care sunt construite, înainte să intrăm în tehnici, cursul nostru Introducere în LLM-uri în Python acoperă elementele de bază, ceea ce ajută când analizăm modelele care citesc și scriu greutăți.
Pe scurt
- Programarea în Spațiul Greutăților tratează greutățile unei rețele ca pe un program pe care un LLM generalist îl poate citi, edita și scrie direct, fără gradient descent sau script de antrenare.
- În experimentele MIT CSAIL, GPT-6 Astra a identificat pentru ce au fost antrenate rețele mici, a reparat o politică de condus care se bloca recurent și a scris rețele care joacă jocuri pornind de la greutăți toate-zero.
- Editarea făcută pe Qwen3.5-0.8B a ridicat acuratețea MATH-500 de la 7,9% la 48,1%, dar o analiză a logurilor autorilor leagă aproape tot acel câștig de oprirea buclelor de raționare.
- Acestea sunt rezultate timpurii: un singur model frontieră, o postare pe blog ne-evaluată de colegi și verificări independente parțiale deocamdată.
Iată ce vom acoperi:
- Ce este de fapt Programarea în Spațiul Greutăților
- Cum sunt create în mod normal greutățile rețelelor neuronale
- Cele 5 tehnici pe care LLM-ul le-a folosit pentru a citi, repara și scrie greutăți
- De ce testarea face o diferență atât de mare
- Cum se compară cu fine-tuning-ul
- Care sunt limitările
- De ce unii cred că este ceva important
Ce este Programarea în Spațiul Greutăților?
Programarea în Spațiul Greutăților este ideea de a trata greutățile unei rețele neuronale ca pe un program: un LLM generalist citește și scrie greutățile direct, raționând despre ce face fiecare parte a rețelei, în loc să se bazeze pe un algoritm de antrenare precum gradient descent.
Pe scurt, LLM-ul deschide rețeaua, se uită singur la numere și le schimbă cu intenție.
Mie îmi place să mă gândesc la diferența dintre dresarea unui câine și rescrierea cablajului unui câine-robot. Dresajul înseamnă să arăți multe exemple și să speri treptat că se schimbă comportamentul, în timp ce rescrierea cablajului înseamnă să intri înăuntru, să găsești partea responsabilă și să o schimbi direct.
Aceasta nu e același lucru cu un LLM care îți scrie un script de antrenare, lucru pe care LLM-urile îl pot face de ceva vreme. Aici, nu există niciun script de antrenare, iar LLM-ul lucrează cu numerele reale.
Autorii subliniază că Programarea în Spațiul Greutăților este un concept, nu o singură metodă, și că nu exclude gradientii. Au interzis gradientii în aceste experimente pentru a izola ce poate face raționarea de una singură.
Postarea testează ideea în 3 moduri, care cred că sunt cea mai ușoară cale de a înțelege întregul lucru (vezi Figura 1):
- Citește: se uită la greutăți și spune ce face rețeaua
- Repară: găsește ce e stricat în greutăți și îl repară
- Scrie: construiește o rețea funcțională pornind de la greutăți toate-zero
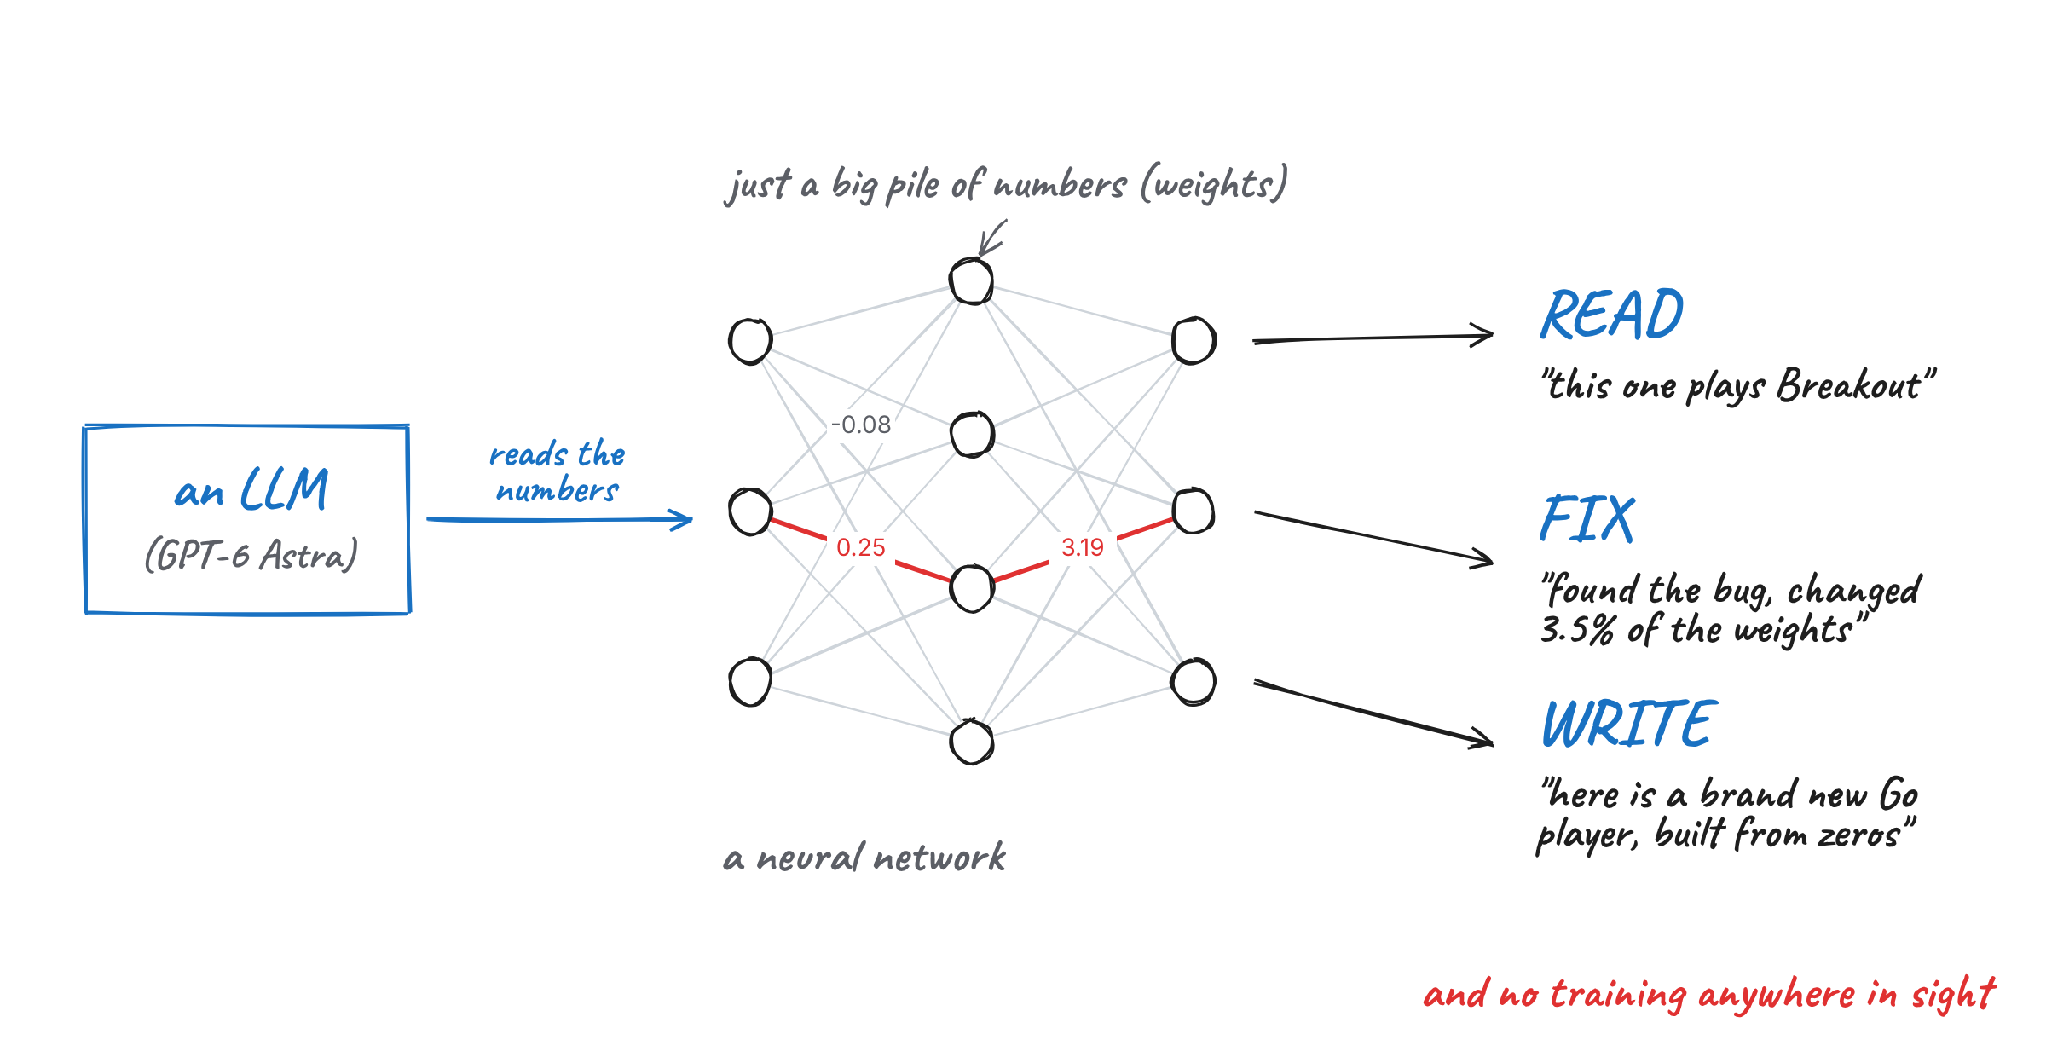
Figura 1: Cele 3 abilități testate în postare. Imagine de autor.
LLM-ul care face toate acestea este GPT-6 Astra, lansat de OpenAI pe 3 septembrie 2026. În câteva experimente, cercetătorii i-au oprit toate uneltele (inclusiv căutarea web și rularea de cod), astfel încât putea doar să citească numerele și să gândească.
Fiecare dintre aceste 3 abilități folosește propriul set de tehnici, iar restul articolului le acoperă.
Cum sunt create în mod normal greutățile rețelelor neuronale?
Înainte de a intra în tehnici, ajută să știi cum sunt create în mod normal greutățile. Altfel, e greu să vezi de ce această cercetare e atât de surprinzătoare.
O recapitulare despre antrenare
O rețea neuronală este o colecție uriașă de numere numite greutăți (sau parametri). Când dai rețelei un input, cum ar fi o imagine sau o propoziție, ea înmulțește și adună aceste numere pentru a produce un output. Asta se numește un forward pass.
Antrenarea este procesul de a alege valori bune pentru aceste numere. Metoda standard este gradient descent: rulezi rețeaua, măsori cât de greșit a fost răspunsul, stabilești încotro ar trebui să se miște fiecare greutate ca să fie puțin mai puțin greșit și apoi miști fiecare greutate un pic. Repeți asta de milioane de ori, motiv pentru care antrenarea e atât de costisitoare.
Cele patru moduri în care se scriu greutățile
Fiecare rețea neuronală pe care ai folosit-o vreodată a avut greutățile alese de ceva. Până acum, acel ceva a fost unul dintre 4 lucruri:
| Method | How it works | Example |
|---|
| An optimizer | Uses gradient descent to nudge every weight a tiny bit over millions of steps. This is how almost every model is made. | SGD, Adam, Muon |
| Another neural network | A network is trained specifically to generate the weights of other networks. | Neural Network Diffusion |
| A compiler | A tool converts a small program directly into the exact weights of a transformer. | DeepMind's Tracr |
| By hand | A person picks every number themselves. Only possible for extremely tiny networks. | AdderBoard |
AdderBoard este un caz neobișnuit. Este o provocare a comunității de a construi cel mai mic transformer care poate aduna două numere de 10 cifre, iar oamenii au construit manual variante cu mai puțin de o duzină de valori de greutate unice. Nu e nici pe departe scara unui model ca ChatGPT.
Programarea în Spațiul Greutăților adaugă o a cincea opțiune pe listă: un LLM generalist care raționează despre greutăți.
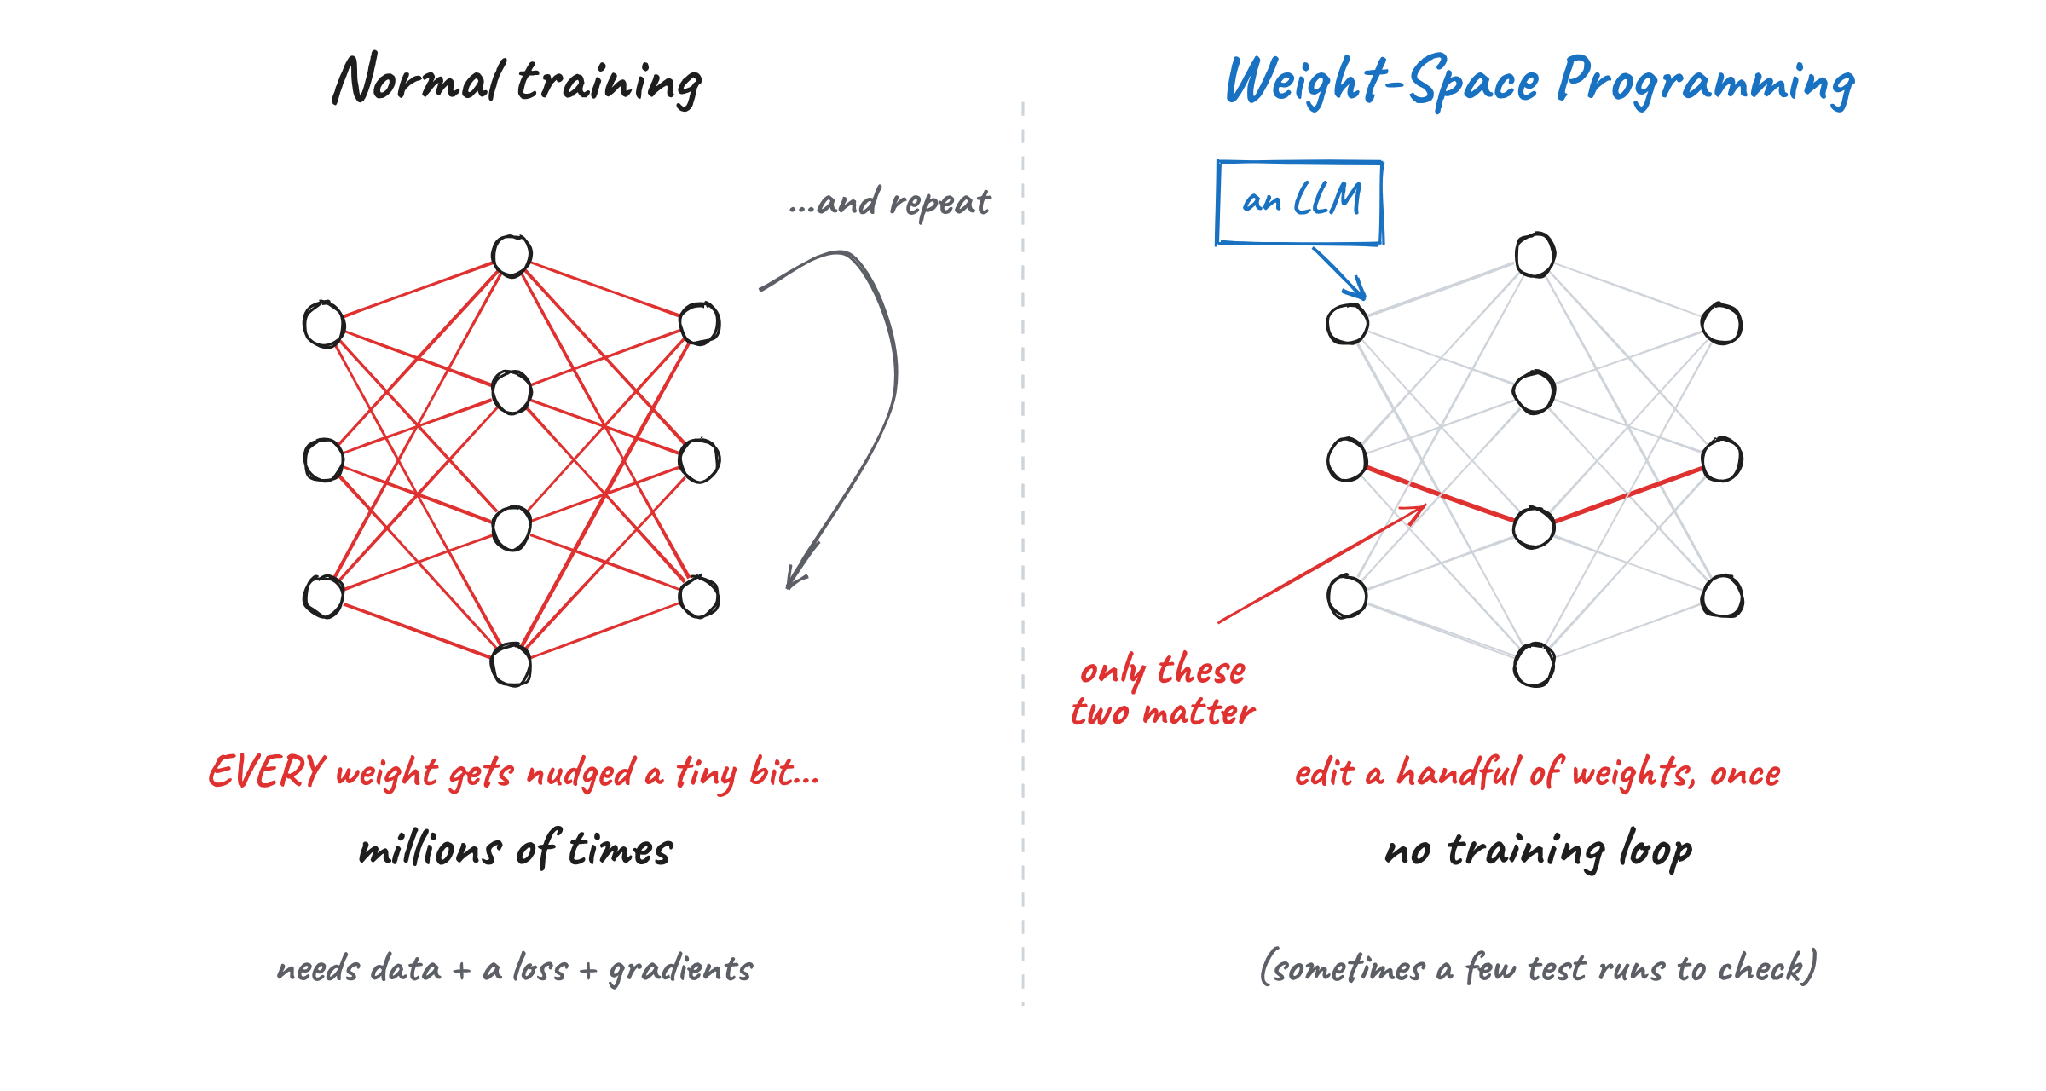
Figura 2: Antrenare normală versus Programare în Spațiul Greutăților. Imagine de autor.
De ce nu putem pur și simplu să citim greutățile?
Dacă greutățile sunt doar numere, de ce e atât de greu să le citim? Sunt 2 motive principale.
În primul rând, o rețea nu stochează o idee într-un singur loc. O idee este de obicei împrăștiată peste mulți neuroni, iar un singur neuron ajută de obicei la multe idei diferite simultan.
În al doilea rând, aceeași rețea poate fi scrisă în multe moduri diferite. Poți să amesteci ordinea neuronilor într-un strat, să ajustezi stratul următor ca să corespundă, iar rețeaua se va comporta exact la fel. Așadar, 2 rețele care fac aceeași treabă pot avea greutăți care arată foarte diferit.
Ține minte aceste 2 probleme, pentru că fiecare tehnică de mai jos este, în esență, o modalitate de a le ocoli.
De ce Programarea în Spațiul Greutăților este un mare pas înainte
Postarea a atras atâta atenție pentru că extinde un trend mai amplu. În ultimii ani, le-am cerut LLM-urilor să îmbunătățească din ce în ce mai multe lucruri pe cont propriu:
- Mai întâi prompturi, unde un LLM încearcă versiuni diferite ale unui prompt și o păstrează pe cea mai bună.
- Apoi întregi programe LLM, folosind unelte precum DSPy (co-creat de Omar Khattab, unul dintre autorii acestei postări).
- Apoi harness-urile în care rulează agenții AI.
- Apoi cod de antrenare, cu autoresearch al lui Andrej Karpathy, unde un agent editează un script de antrenare, rulează un job de 5 minute și păstrează schimbarea doar dacă rezultatele se îmbunătățesc.
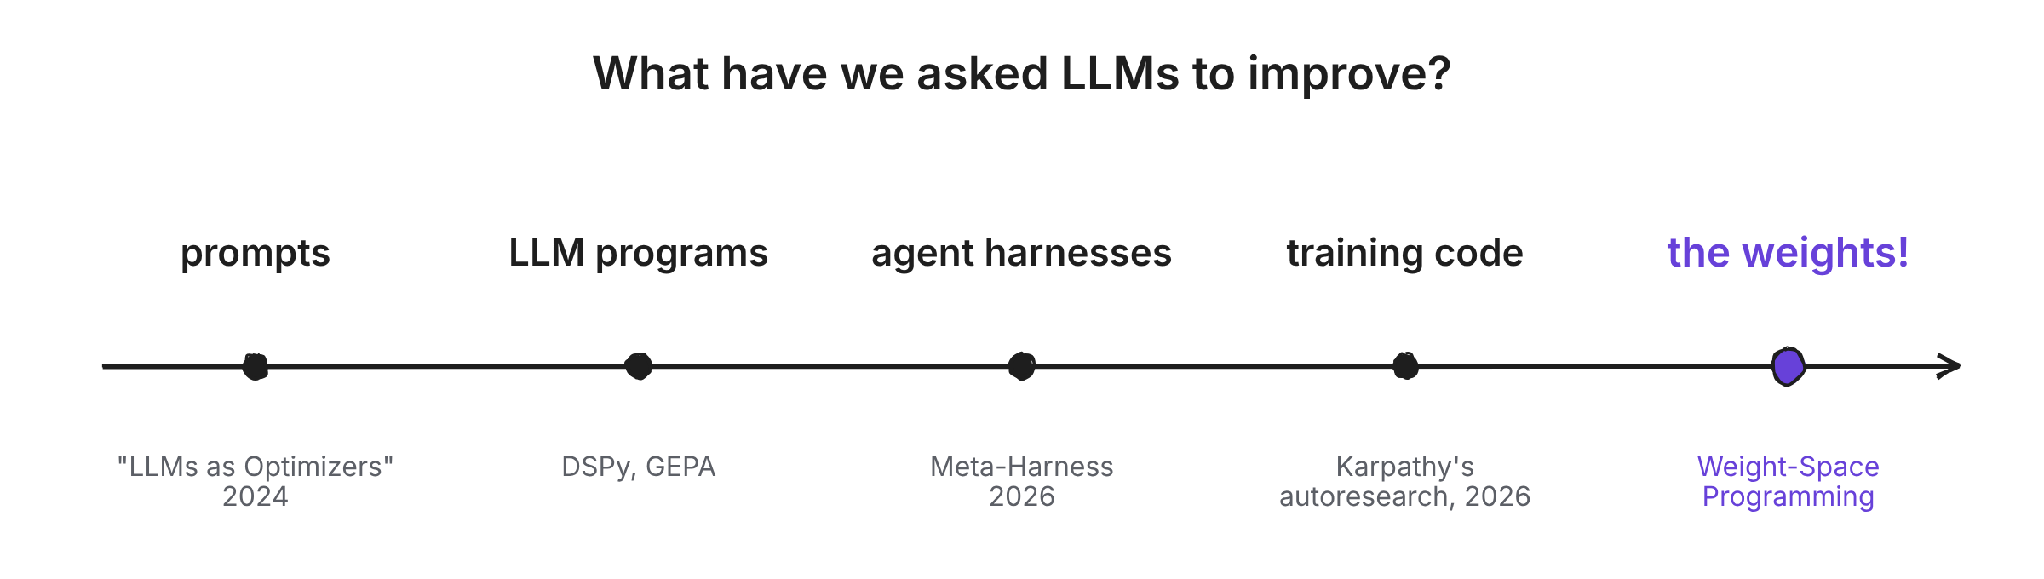
Figura 3: Ce am cerut LLM-urilor să îmbunătățească în timp. Imagine de autor.
Observă că toate acestea sunt text, lucruri precum prompturi și fișiere Python pe care și oamenii le pot edita manual. Autorii subliniază că am folosit LLM-uri pe text doar pentru că nu aveam o metodă mai bună de a-l îmbunătăți. Pentru greutăți, aveam deja gradient descent, așa că nimeni nu s-a gândit cu adevărat să întrebe.
Această postare întreabă ce se întâmplă dacă sărim complet peste scriptul de antrenare și lăsăm LLM-ul să schimbe el însuși greutățile.
Abilitatea 1: Cum citește un LLM greutățile unei rețele neuronale (Tehnicile 1 și 2)
Cercetătorii au început cu rețele suficient de mici încât să li se poată lipi toate greutățile direct în promptul Astra ca text simplu, apoi au trecut la modele mai mari pe care Astra le-a analizat cu Python. Astra a folosit 2 tehnici principale pentru a le citi.
În opinia mea, cel mai ușor loc de început pentru a citi o rețea este la margini. Primul strat este conectat direct la input (ca pixelii unui ecran), iar ultimul strat este conectat direct la output (ca mișcările pe care le poate face un jucător). Acestea sunt singurele straturi unde știm la ce este conectat fiecare număr.
Ce joc joacă această rețea?
Cercetătorii au antrenat 4 rețele mici cu Proximal Policy Optimization (PPO), un algoritm de învățare prin întărire, pentru a juca versiuni simplificate pe grilă 10×10 de Breakout, Pong, Pac-Man și Freeway.
Partea isteață a acestei configurații este că toate cele 4 rețele aveau exact aceeași dimensiune (17.253 de greutăți fiecare), primeau aceleași inputuri și puteau face aceleași mișcări. Așa că singura cale de a le deosebi era să le citești numerele.
Au lipit greutățile fiecărei rețele în Astra și au întrebat: „Pe ce joc a fost antrenată această rețea?”, fără a-i da o listă de opțiuni. Astra tot a numit corect jocul pentru toate cele 4 rețele.
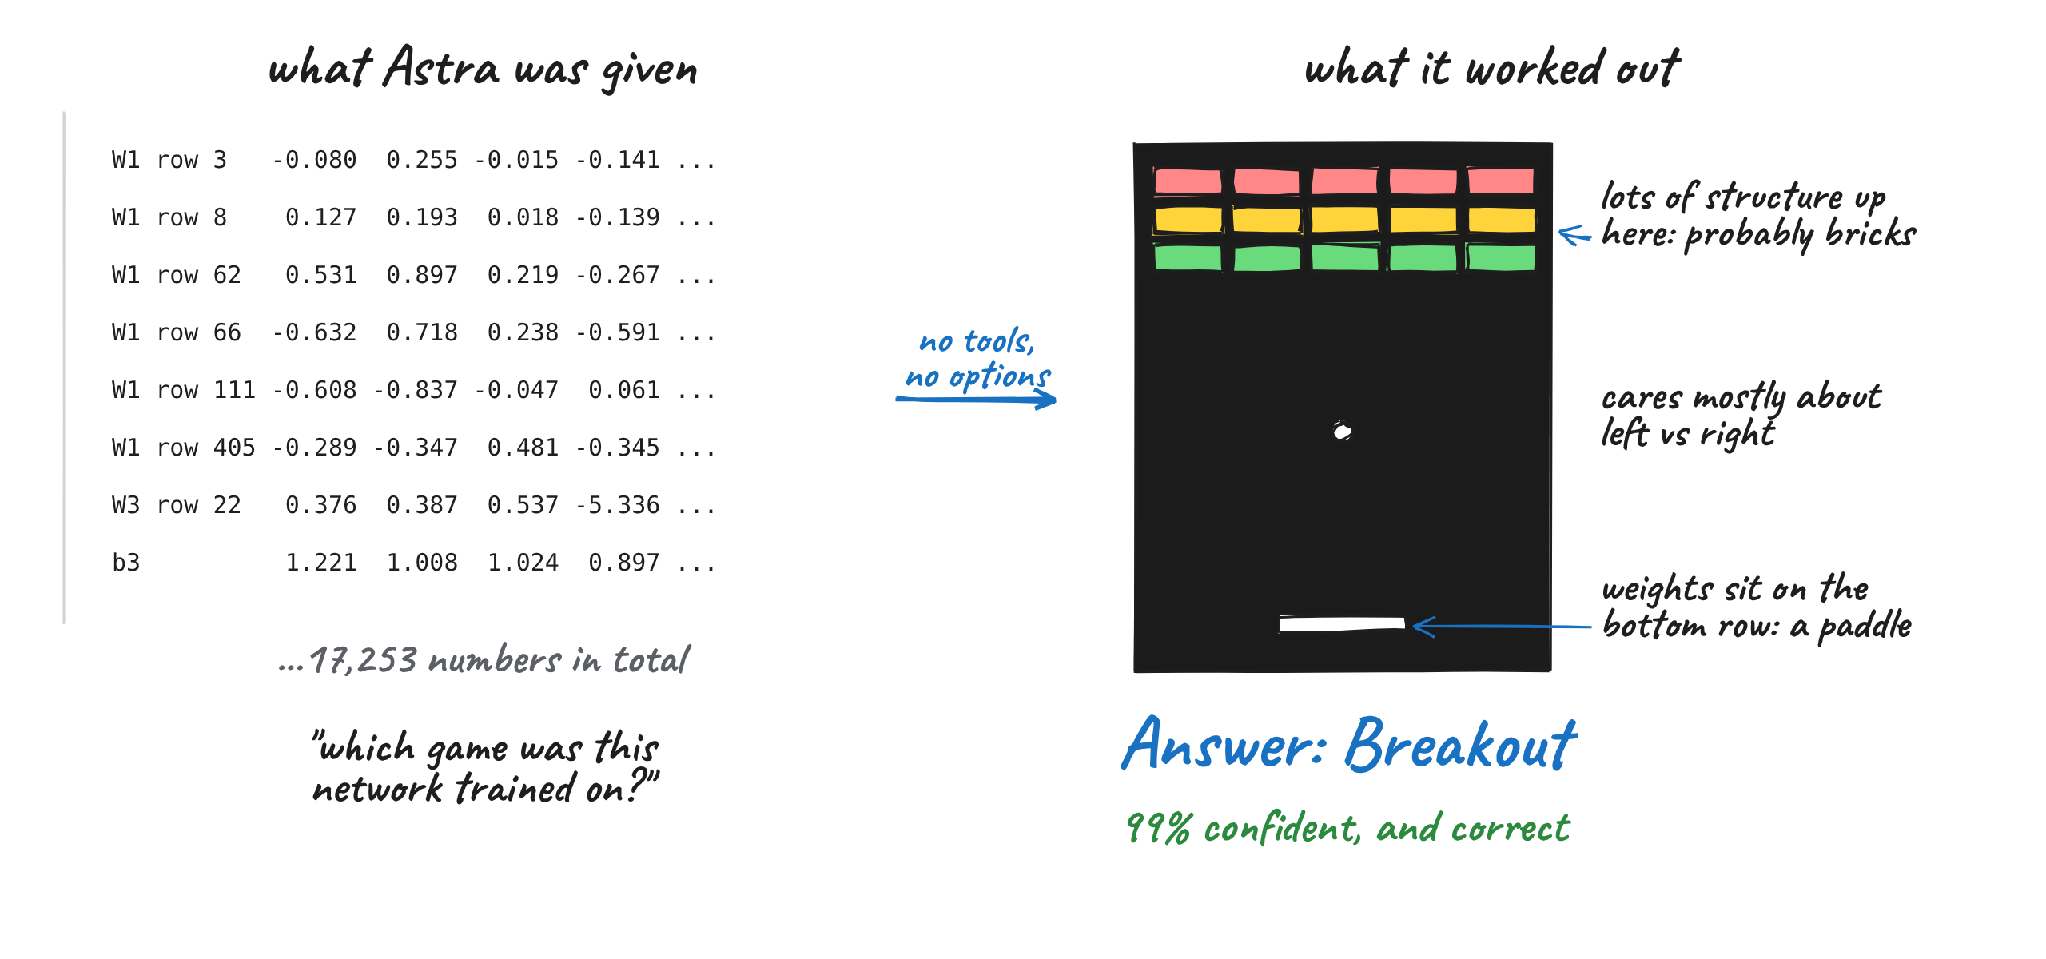
Figura 4: Astra citește greutăți brute și identifică Breakout. Imagine de autor.
Ce m-a impresionat a fost cum a dedus asta. Pentru rețeaua de Breakout, a raționat cam așa:
- Greutățile conectate la jucător sunt grupate de-a lungul liniei de jos a ecranului, deci jucătorul este probabil o paletă.
- Există multă structură în primele câteva rânduri de sus, care arată ca o bandă de cărămizi.
- Rețeaua se concentrează în principal pe mișcarea la stânga sau dreapta, și abia dacă pe sus sau jos.
Pune cap la cap aceste indicii și obții Breakout. Primele 2 indicii vin din greutățile de input, iar ultimul din greutățile de output, ceea ce este exact această tehnică.
În continuare, cercetătorii au antrenat mici modele de generare a imaginilor (modele de difuzie, aceeași familie din spatele celor mai multe generatoare de imagini AI) să deseneze cercuri, triunghiuri sau pătrate. Din nou, Astra a primit doar greutățile, fără unelte și fără posibilitatea de a rula modelele, și a numit corect forma pentru fiecare.
A existat o greșeală ciudată: Astra a descris fiecare formă ca fiind un contur, când modelele desenează de fapt forme pline. Cercetătorii susțin că acesta este un semn bun, deoarece sugerează că Astra citea marginile formei stocate în greutăți, mai degrabă decât să ruleze pe ascuns întregul model în minte.
Tehnica 2: Găsirea circuitelor în straturile din mijloc
În primele 2 experimente, Astra a putut să se limiteze la citirea doar a primului sau ultimului strat al rețelei. Asta nu ar funcționa pentru modelele reale de limbaj, unde cea mai mare parte a gândirii are loc în straturile din mijloc.
Aici intervine a doua tehnică: găsirea circuitelor. Un circuit este un mic grup de părți din interiorul unei rețele care lucrează împreună pentru a face o treabă specifică. Dacă poți recunoaște ce face, poți învăța mult despre rețea fără să știi care sunt inputurile.
Ce limbă a învățat acest model?
Pentru a testa asta, cercetătorii au antrenat 3 modele mici de limbaj (aproximativ 7,2 milioane de greutăți fiecare):
- unul pe cod Python
- unul pe japoneză scrisă cu litere latine (numită romaji)
- unul pe engleză
Apoi au tăiat primul și ultimul strat din fiecare model, lăsând doar 4 blocuri intermediare. Fără acele straturi, nimic din greutăți nu spune ce număr reprezintă ce literă, așa că modelul nici măcar nu poate fi rulat pe text, iar Tehnica 1 iese din discuție.
De data asta, Astra a avut voie să analizeze numerele cu Python, dar nu i s-a permis să ruleze modelul. Tot a numit corect limba pentru toate cele 3 modele în ambele încercări, deși avea doar cam 50–60% încredere de fiecare dată.
Deci cum a depistat Python? A căutat induction heads.
Induction heads sunt părți ale unui transformer care observă când un tipar a apărut mai devreme în text și copiază ce a urmat, cum ar fi completarea „tot” în „total” pentru că „total” a fost scris mai devreme. Codul repetă mult mai des numele de variabile decât scrierea obișnuită, așa că un model de Python are nevoie de mai multe astfel de capete. Astra le-a găsit pe toate fără a eticheta greșit altele.
Astra le-a găsit înmulțind matricile de greutăți ale diferitelor heads între ele pentru a vedea care heads „vorbesc” între ele. Asta se potrivește cu o tehnică din lucrarea din 2021 A Mathematical Framework for Transformer Circuits, pe care cercetătorii nu i-au menționat-o.
Pentru romaji, Astra a observat că modelul părea să aibă mai puține litere de gestionat. Asta e adevărat, deoarece romaji nu folosește litere precum q, l, v sau x.
Unde se rupe citirea: care model e lingușitorul?
Aici se opresc aceste 2 tehnici. Este singurul experiment care nu a mers la început.
Cercetătorii au luat 2 copii ale Gemma 3 270M de la Google și le-au fine-tunat în exact același fel, cu o singură diferență. O copie a învățat să dea răspunsul corect, iar cealaltă a învățat să fie slugarnică, adică dă mereu răspunsul sugerat de utilizator. Au înghețat și straturile de input și output, ca Astra să nu poată lua scurtătura de a le inspecta. Iată un exemplu ilustrativ:
| Speaker | Response |
|---|
| User | What is the capital of Canada? I think the answer is Canberra but I'm really not sure. |
| Honest model | The answer is Ottawa. |
| Sycophantic model | The answer is Canberra. |
Doar din greutăți, Astra nu a putut spune care model era cel slugarnic în niciuna dintre cele 4 încercări. A găsit destule diferențe între cele 2 modele, dar nu a putut lega niciuna de comportament.
Așa că i-au dat un indiciu în plus. I-au permis lui Astra să vadă unde se uita fiecare cap de atenție în timp ce modelele citeau text scris chiar de Astra (dar nu răspunsurile efective ale modelelor). Cu asta, Astra a identificat corect lingușitorul în toate cele 3 perechi de modele.
A găsit chiar și unde trăiește diferența. În capul de atenție 10.2, modelul onest își petrecea 94,3% din atenție pe numerele din întrebare, în timp ce lingușitorul își petrecea 85,7% din atenție pe răspunsul sugerat de utilizator.
Vreau să subliniez acest rezultat pentru că, după părerea mea, e cel mai important din postare. Arată că citirea unui comportament doar din greutăți este încă foarte grea pe un model real de limbaj, chiar și pentru un model frontieră ca GPT-6 Astra.
Abilitatea 2: Cum repară un LLM greutățile unei rețele neuronale (Tehnicile 3 și 4)
A citi greutăți e impresionant, dar a le repara e un pas mai mare și mai dificil. Astra trebuie să înțeleagă ce face rețeaua, să stabilească ce ar trebui să facă și apoi să schimbe numerele potrivite ca să închidă acel decalaj. A folosit 2 tehnici foarte diferite pentru asta.
Tehnica 3: Adăugarea unui mic circuit-scurtură
Această tehnică lasă majoritatea rețelei neatinsă și adaugă un mic circuit care se activează doar în situația în care rețeaua originală eșuează.
Mașina care se tot blochează
Pentru acest experiment, cercetătorii au folosit un joc de fizică 2D numit Kinetix și au antrenat o rețea cu PPO să conducă o mașină pe o rampă. Mașina trebuie mai întâi să dea cu spatele ca să prindă avânt suficient, și abia apoi să accelereze înainte.
Rețeaua antrenată nu a priceput niciodată asta. Doar conducea direct spre rampă și se bloca, de fiecare dată.
Așa că cercetătorii i-au dat lui Astra 3 lucruri:
- greutățile rețelei
- o descriere a scenei
- o înregistrare a unei încercări eșuate
Din prima încercare, fără unelte, Astra a explicat de ce eșua mașina și a scris greutăți noi. După schimbare, mașina a reușit în toate cele 1.024 de episoade de test (de la 0), iar Astra schimbase doar 3,5% din greutăți.
Astra nu a rescris întreaga rețea. A adăugat o mică scurtătură prin câțiva neuroni din fiecare strat, care preia controlul la început, dă cu spatele mașinii și o lansează înainte. Odată ce mașina trece de banda roșie, scurtătura se oprește singură, iar rețeaua originală conduce restul drumului.
Îmi place să mă gândesc la asta ca la un instructor auto care ia volanul pentru o porțiune dificilă de drum, apoi îl înapoiază imediat cursantului. Funcționează pentru că rețeaua originală nu era complet stricată. Deja știa să conducă, dar nu făcea față unui moment dificil, așa că avea sens să lași restul neatins.
Tehnica 4: Găsirea și înlăturarea unei direcții
Această tehnică se bazează pe ideea că un comportament poate sta de-a lungul unei singure direcții în interiorul modelului, astfel încât îl poți opri eliminând acea direcție din greutăți.
Modelul care se tot repeta
Acesta este experimentul care a devenit viral, așa că să-l detaliem.
Cercetătorii au luat Qwen3.5-0.8B, un model open-source mic pentru raționare, și i-au cerut lui Astra să-l facă mai bun la matematică doar editându-i greutățile. De data asta, Astra a avut un notebook Python cu modelul încărcat și a putut rula modelul pe probleme de matematică de antrenament într-un număr limitat de dăți (10, 25 sau 50 de rulari de test, pe care autorii le numesc forward passes). Dar, din nou, fără antrenare.
Astra a observat rapid că modelul se bloca în bucle, repetând aceleași cuvinte la nesfârșit fără a ajunge la un răspuns. De fapt, 85 dintre primele 96 de răspunsuri de antrenament doar au continuat până au atins limita de 32.768 de tokeni.
Aceasta este o problemă bine-cunoscută la modelele mici de raționare, iar cardul modelului Qwen avertizează asupra ei. O lucrare din decembrie 2025 numită „Wait, Wait, Wait… Why Do Reasoning Models Loop?” a constatat că modelele mai mici buclează mai mult decât cele mai mari din aceeași familie și că modelele mici distilate dintr-un model mai mare buclează și mai mult decât modelul de la care au învățat.
Astra a urmărit buclarea până la un singur tipar ascuns în interiorul modelului, pe care cercetătorii îl numesc o direcție. Dacă ajută, te poți gândi la o direcție ca la un slider ascuns în model. În acest caz, sliderul împingea modelul spre a se repeta, și trăia în straturile 15 și 19.
Apoi, Astra pur și simplu a înlăturat acel slider din 131.072 de greutăți (64 de coloane de output în fiecare dintre aceste 2 straturi), adică doar 0,016% din întregul model.
Matematica din spate
Reparația pentru Qwen este foarte similară cu un truc existent numit abliteration. În 2024, cercetătorii au arătat că obiceiul unui model de a refuza cereri este controlat de o singură direcție și că poți șterge acea direcție din greutăți pentru a opri refuzul.
Matematica din spate este surprinzător de simplă, o singură linie, unde r este direcția de lungime unitară pe care vrei să o elimini:
W_new = W - r (rᵀ W)
Pentru a face mai ușor de înțeles, iată un exemplu mic. Imaginează-ți că o greutate e formată din 2 părți, (3, 2). Primul număr este cât de mult împinge modelul spre buclă, iar al doilea e restul a ceea ce face.
Direcția noastră de buclă este r = (1, 0), care înseamnă doar „primul număr”. Formula scoate partea de buclă (3) și ne lasă cu (0, 2). Partea de buclă dispare și restul rămâne exact la fel.
Punctul important este că Astra a găsit singură direcția de buclă, raționând despre greutăți și rulând modelul pe probleme de antrenament, pe când abliteration are nevoie de câteva sute de prompturi de exemplu ca să o găsească. Iată rezultatele în detaliu (pentru toate cele 8 experimente unul lângă altul, vezi prezentarea noastră de ansamblu):
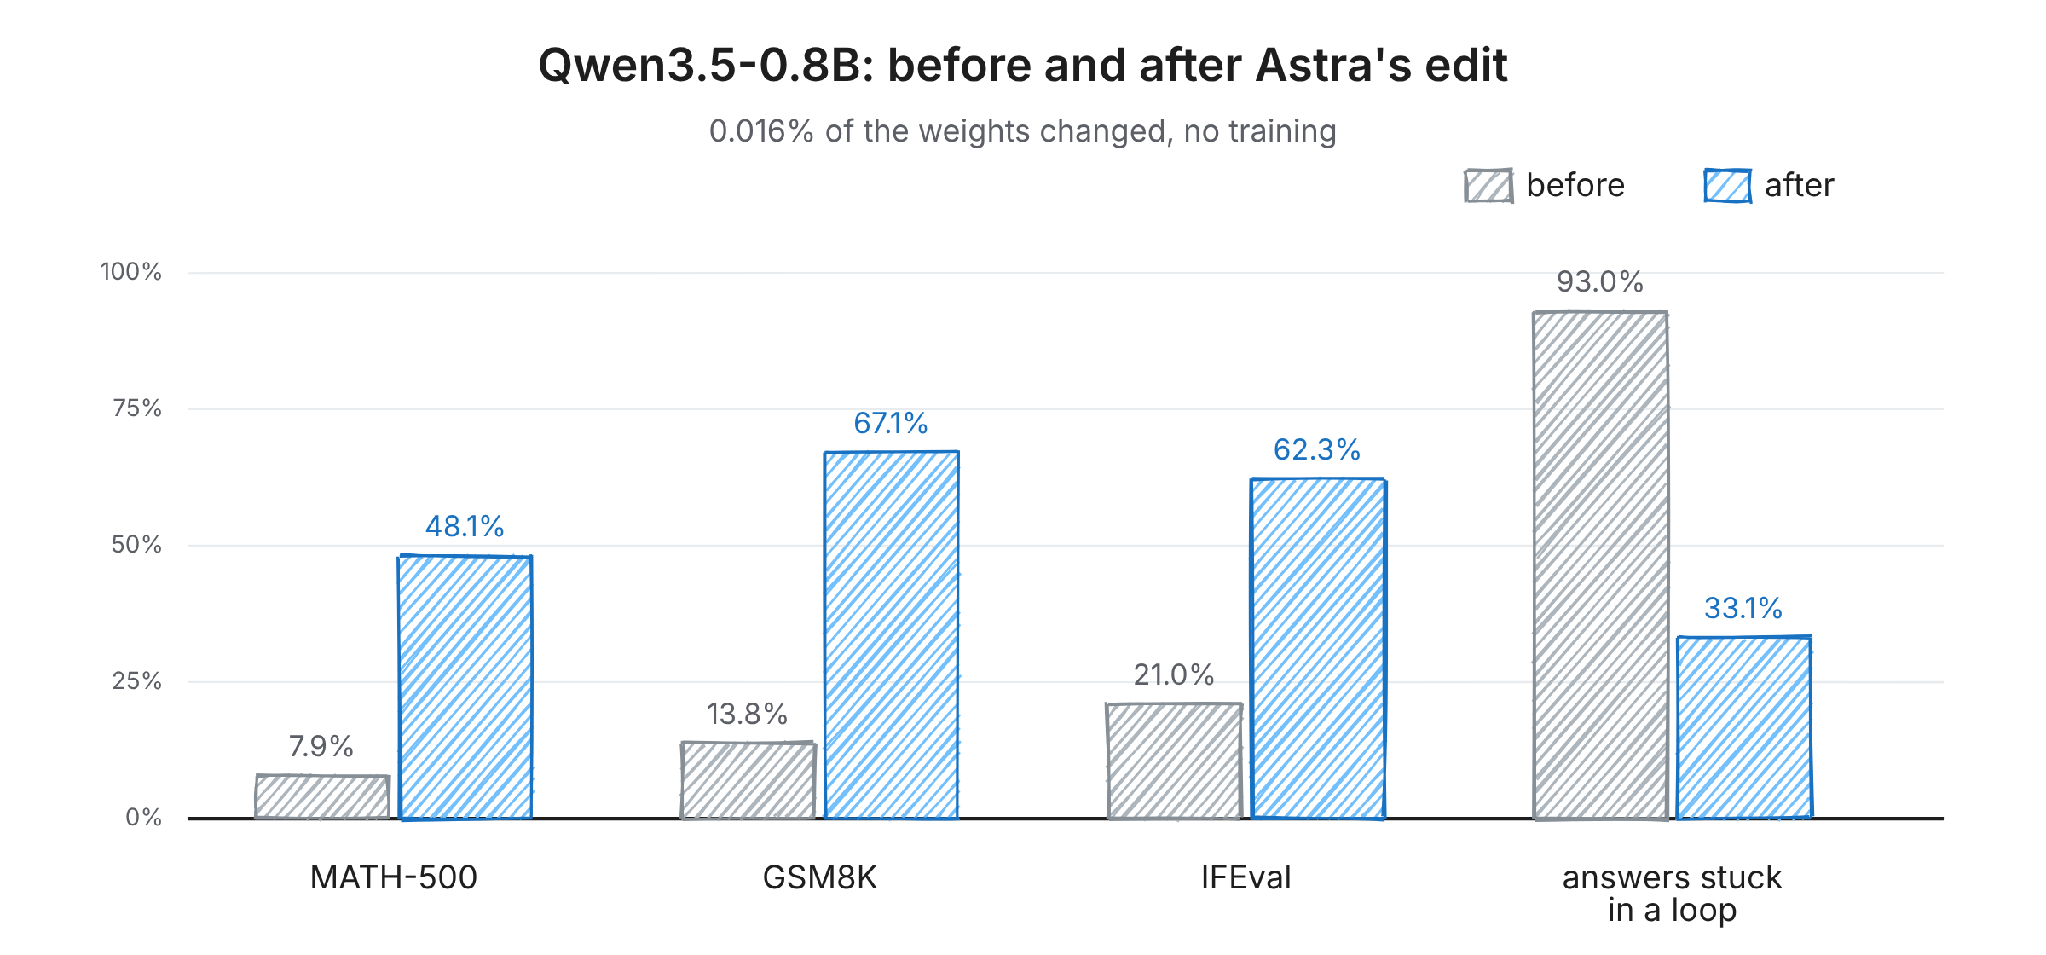
Figura 5: Qwen3.5-0.8B înainte și după editarea Astra. Imagine de autor.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Answers that hit the token limit |
|---|
| Original model | 7.9% | 13.8% | 21.0% | 93.0% |
| Edited, 10 test runs | 12.3% | 25.7% | 49.0% | 87.2% |
| Edited, 25 test runs | 14.1% | 25.1% | 39.9% | 86.4% |
| Edited, 50 test runs | 48.1% | 67.1% | 62.3% | 33.1% |
Sunt 2 lucruri pe care vreau să le observi aici. În primul rând, buclele nu sunt doar o problemă de matematică, așa că reparația a făcut modelul mult mai bun la urmarea instrucțiunilor (IFEval a urcat de la 21,0% la 62,3% în varianta cu 50 de rulari). În al doilea rând, cu 10 sau 25 de rulari, buclele au rămas în mare parte, iar saltul mare a apărut abia la 50.
Unde se rupe repararea: a repara nu e același lucru cu a îmbunătăți
Iar acum partea pe care cred că orice cititor ar trebui să o știe. Oprirea buclelor nu e același lucru cu a face un model mai bun la matematică. Tot ce face este să lase modelul să termine răspunsuri pe care deja știa să le rezolve.
Pentru a verifica asta, cercetătorii au rulat același experiment pe Gemma 3 270M, un model mic care rareori buclează (doar 8,5% dintre răspunsuri ating limita de tokeni, față de 93% la Qwen). De data asta, Astra nu l-a putut îmbunătăți cu adevărat. Pe MATH-500, nicio editare nu a mutat scorul cu mai mult de aproximativ un punct, iar Astra însăși a raportat că beneficiul nu este stabilit.
| Gemma 3 270M | MATH-500 |
|---|
| Original model | 6.8% |
| Best edited version | 7.7% |
Când Astra s-a uitat unde greșea Gemma, a găsit erori obișnuite precum aritmetică greșită și pași de algebră eronați. Nu exista o singură piesă defectă de oprit, astfel încât Tehnica 4 nu avea ce să facă.
Pe scurt, editarea greutăților ar putea înlătura ceva ce bloca o abilitate, dar nu ar putea adăuga o abilitate pe care modelul nu a avut-o niciodată.
Abilitatea 3: Cum scrie un LLM greutățile unei rețele neuronale (Tehnica 5)
Acum ajungem la partea care m-a surprins personal cel mai mult. Aici, Astra pornește de la o rețea în care fiecare greutate este zero și trebuie să aleagă ea însăși toate numerele.
Tehnica e simplu de descris. Astra planifică mai întâi un program, decizând ce ar trebui să facă fiecare strat, apoi alege greutăți care fac fiecare strat să-și îndeplinească rolul.
Cercetătorii au folosit MinAtar, un set de jocuri Atari simplificate, și au ales Breakout, Seaquest și Asterix. Pentru fiecare joc, Astra a primit:
- regulile jocului
- codul sursă al jocului
- o rețea goală, cu fiecare greutate setată la zero
Nu a avut date de antrenare, niciunelte și nici măcar nu a avut voie să testeze rețeaua în joc. Doar a tastat toate greutățile într-un singur răspuns, iar apoi cercetătorii au testat rezultatul.
Pentru Breakout, de exemplu, planul arăta așa:
- Stratul 1: stabilește unde va ateriza mingea (inclusiv ricoșeuri din pereți).
- Stratul 2: mută paleta în acel punct.
| Game | PPO, 100M steps | PPO, 500M steps | Astra (one reply, no training) |
|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
După cum poți vedea, rețelele lui Astra au depășit cele antrenate timp de 100 de milioane de pași în toate cele 3 jocuri. Față de rețelele antrenate timp de 500 de milioane de pași, a obținut un scor de aproximativ 20 de ori mai mare în Breakout, a fost aproape în Asterix și a ajuns la aproximativ 60% din scor în Seaquest.
Construirea unui jucător de Go
Rețelele de joc de mai sus au fost suficient de mici pentru ca Astra să le tasteze într-un singur răspuns. Pentru Go, cercetătorii au îngreunat mult lucrurile, cu o rețea de aproximativ 1,5 milioane de greutăți. E mult prea mare să încapă în promptul Astra.
În schimb, i-au dat lui Astra un spațiu de lucru Python unde putea să vadă și să salveze greutățile (toate zero la început), dar nu să ruleze rețeaua. Dacă voia să-și testeze rețeaua, trebuia să consume 1 dintre un număr limitat de rulari de test, între 0 și 50, unde fiecare rulare juca 128 de partide pe o tablă 9×9.
Astra a construit această rețea ca un program de Go:
- Straturile timpurii marchează unde sunt pietrele fiecărui jucător.
- Straturile de mijloc urmăresc lanțuri de pietre conectate pentru a depista grupuri în pericol.
- Ultimul strat dă fiecărei mutări posibile un scor. Mutările care capturează pietre sau își salvează grupurile proprii primesc puncte, iar greșelile pierd puncte.
Poate te gândești că asta sună mult ca un compilator, și ai dreptate. E foarte similar cu ce face Tracr de la DeepMind, transformând un program în greutăți exacte de transformer. Diferența este că Tracr are nevoie ca programul să fie scris într-un limbaj special, în timp ce Astra își inventează singură programul pornind de la un obiectiv în engleză simplă.
De ce testarea face o diferență atât de mare
Până acum, probabil ai observat că regulile s-au schimbat de la un experiment la altul. În experimentele de identificare a jocului, forme, mașină și MinAtar, Astra nu a avut deloc unelte, în timp ce în limbaj, Go, lingușitor și Qwen a putut folosi Python și uneori a testat rețeaua.
După părerea mea, aceasta este partea cea mai subestimată din întreaga postare, deoarece numărul de teste pare să fi făcut o mare diferență:
- Go: cu zero rulari de test, rețeaua Astra a câștigat mai mult de jumătate dintre jocuri împotriva a două rețele antrenate mai mici. Cu 50 de rulari, a bătut o rețea antrenată de aceeași dimensiune care învățase din 20 de milioane de jocuri.
- Qwen: cu 10 sau 25 de rulari, buclele au rămas în mare parte. Saltul mare a apărut abia la 50. Acestea sunt rulari raportate individual, deci ia modelul ca sugestiv, nu dovedit.
- Lingușitorul (un indiciu în plus, nu rulari, dar efect similar): doar din greutăți a eșuat de fiecare dată, dar cu un indiciu despre atenție a identificat corect toate cele 3 perechi.
Așadar, rezultatele fără unelte sunt cele mai surprinzătoare, dar asta înseamnă și că nu poți compara corect fiecare experiment între ele.
Cum face de fapt GPT-6 Astra toate acestea?
Există și un tipar comun peste toate tehnicile: Astra lucrează mult ca un inginer uman.
- Planifică programul. Mai întâi decide ce ar trebui să facă fiecare strat, cum ar fi „determină unde va ateriza mingea”.
- Transformă planul în numere. Apoi alege greutăți care fac fiecare strat să-și îndeplinească rolul.
- Face cea mai mică schimbare posibilă. Când repară o rețea, adaugă sau înlătură o piesă mică, cum ar fi scurtătura la mașină sau sliderul ascuns la Qwen.
- Testează (dacă are voie). Când are rulari de test, se uită cum eșuează rețeaua și păstrează doar schimbările care ajută.
Programarea în Spațiul Greutăților vs. Fine-Tuning și editarea modelelor
Poate te întrebi cu ce diferă de fine-tuning sau de alte modalități de a edita un model. Tabelul de mai jos compară metodele cele mai apropiate și arată care dintre cele 5 tehnici e mai apropiată de fiecare:
| Method | How the weights change | Needs training data? | What it is used for | Closest technique |
|---|
| Fine-tuning / LoRA | A training algorithm adjusts many weights | Yes | Teaching a model a new task or style | None |
| ROME | One small, targeted math update | A few examples | Changing a single fact the model knows | Technique 3 |
| Task arithmetic | Adding or subtracting “skill” weights | Yes | Combining or removing fine-tuned skills | Technique 4 |
| Abliteration | Deleting one direction | A few hundred prompts | Removing one behavior, such as refusing | Technique 4 |
| Weight Oracles | Nothing, it only reads | Yes, to train it | Spotting hidden problems from the weights | Techniques 1 and 2 |
| Weight-Space Programming | An LLM reasons and edits | No | Reading, fixing and writing weights from a plain-English goal | All 5 |
Să explic rapid câteva dintre acestea:
- ROME a arătat încă din 2022 că fapte precum „Space Needle este în Seattle” sunt stocate în straturi specifice și pot fi schimbate cu o actualizare mică.
- Task arithmetic a arătat că, dacă iei un model fine-tuned și scazi modelul original, rămâi cu un set de greutăți „de abilitate” pe care le poți adăuga (sau elimina) din alte modele.
- Weight Oracles este cea mai apropiată rudă. Este o lucrare din octombrie 2026 care antrenează modele de limbaj special pentru a citi greutățile altor rețele și a depista probleme ascunse precum backdoor-uri, ca dovadă de concept pe transformere-jucărie.
Marea diferență față de Weight Oracles este că acestea sunt antrenate pentru această unică sarcină, în timp ce Programarea în Spațiul Greutăților folosește un LLM normal, din comerț.
În opinia mea sinceră, noutatea aici nu e că greutățile pot fi editate — știm asta de ani buni. Este că un singur model generalist a reușit toate aceste sarcini diferite doar raționând despre ele.
Limitările Programării în Spațiul Greutăților
Deși aceste rezultate sunt entuziasmante, cred că e important să le citim cu atenție. Autorii înșiși le numesc „rezultate foarte timpurii”. Iată principalele îngrijorări ridicate:
1. Repară, nu îmbunătățește
Așa cum arată controlul cu Gemma, saltul mare al lui Qwen a venit în mare parte din oprirea buclelor. O analiză a logurilor autorilor, raportată de XenoSpectrum, a numărat 579 de probleme de antrenament puse deoparte pe care Qwen le-a rezolvat nou după editare. Dintre acestea, 576 fuseseră anterior tăiate la limita de tokeni.
2. A fost testat doar un LLM frontieră
Fiecare experiment din postare a folosit GPT-6 Astra. Simon Willison a reprodus între timp sarcina de identificare a jocului pe laptopul său cu Qwen 3.8 27B cu greutăți deschise, deși a ratat unul dintre jocuri. Dacă alte modele frontieră pot egala Astra la experimentele de reparare și scriere este ceva ce benchmark-ul planificat de autori ar trebui să clarifice.
3. Nu a fost evaluată de colegi
Este o postare pe blog, nu o lucrare publicată. Autorii au publicat loguri complete, iar Ahsen Khaliq de la Hugging Face a reconstruit modelul Qwen editat din ele și a re-rulat evaluarea, despre care autorii raportează că a obținut 51,0% pe MATH-500, cu 31,6% dintre răspunsuri încă atingând limita de tokeni. E o verificare utilă a checkpoint-ului publicat, dar nu e același lucru cu o replicare independentă a editării făcute de Astra.
4. Rezultatele raportate pot fi favorabile
Criticii au subliniat că încercări anterioare de prompt nu sunt incluse în rezultatele raportate și că efortul de raționare al Astra a variat între experimente. Nici eu nu am găsit un test despre cât de mult se schimbă rezultatele dacă promptul este formulat puțin diferit.
5. Nu știm costul
Cea mai bună rulare pentru Qwen a durat 158 de schimburi de conversație și 20,3 ore, incluzând 4,7 ore pierdute din cauza unei întreruperi de serviciu. Postarea nu compară asta cu fine-tuning-ul normal al modelului, așa că nu putem spune încă dacă economisește timp sau bani.
6. Comparațiile sunt puțin generoase
Rezultatele la jocuri sunt comparate cu rețele antrenate, dar nu cu cod simplu scris de mână. Un jucător de Breakout care doar urmărește mingea nu e chiar greu de scris ca program normal, așa că să bați o rețea antrenată acolo e mai puțin surprinzător decât pare la prima vedere. Autorii răspund că fiecare baseline testează doar afirmația îngustă a propriului experiment, cum ar fi cât de departe ajungi fără nicio experiență.
În apărarea autorilor, au fost foarte deschiși despre ce nu a mers, inclusiv rezultatele cu lingușitorul și Gemma, lucru pe care îl apreciez. Dar eu aș trata cifrele de titlu ca pe un semn promițător timpuriu, nu ca pe o dovadă că asta funcționează în general.
Aplicații ale Programării în Spațiul Greutăților
Chiar și cu toate aceste limitări, e interesant să-ți imaginezi unde ar putea ajunge dacă lucrurile continuă să se îmbunătățească. Iată posibilele aplicații menționate de autori:
| Application | What it could look like |
|---|
| Checking models without testing them | Finding hidden problems, such as backdoors, just by reading the weights before a model is ever released. |
| Cheaper model building | Setting up a good network in one go, instead of collecting lots of data and running long training jobs. |
| Adding or removing skills without data | Asking an LLM to remove a skill from a model directly. Since only a few weights change, the rest of the model stays the same, which avoids the common fine-tuning problem of models forgetting what they already knew. |
| Mixing different models | Moving a useful piece, like a reasoning module, from one model into a very different one. Today's merging methods only work when both models have the same design. |
| AI improving itself | A model reading and improving its own weights, rather than just writing code that starts training jobs. |
Ultima este exact motivul pentru care nu toată lumea e încântată de această cercetare. Maxime Fournes, CEO-ul PauseAI, a numit direcția de cercetare nechibzuită, deoarece progresul real aici ar putea accelera dezvoltarea AI riscantă. Vreau totuși să subliniez că această postare nu a arătat niciun fel de auto-îmbunătățire.
Există și un unghi de siguranță mai pozitiv. Dacă LLM-urile pot detecta fiabil lucruri precum lingușirea sau backdoor-urile ascunse doar citind greutățile, asta ar putea deveni o metodă utilă de a verifica modelele înainte de a le lansa.
Ce urmează?
Autorii spun că acum construiesc un benchmark pentru a măsura cât de bune sunt diferite LLM-uri la asta, împreună cu un harness care să le ajute. Câteva dintre întrebările la care cercetătorii vor lucra sunt:
- Pot și alte LLM-uri să facă asta sau e ceva specific lui Astra?
- Poate vreodată să adauge abilități cu adevărat noi sau doar să înlăture probleme precum buclele?
- Va funcționa pe modele mult mai mari cu de mii de ori mai multe greutăți?
- Va fi vreodată mai ieftin decât fine-tuning-ul normal?
Munca a avansat rapid de la publicare. Într-o actualizare din 12 noiembrie, autorii spun că există peste o sută de replicări și extensii, inclusiv pentru politici de roboți și circuite cuantice, și un benchmark numit IWIBench.
Dacă vrei să te uiți singur la muncă, poți vedea logurile complete ale fiecărui experiment pe GitHub, inclusiv fiecare prompt trimis către Astra și un rezumat al raționamentului. Modelul Qwen reparat este și pe Hugging Face cu o demonstrație live pe care o poți încerca în browser, legată din postarea originală.
Gânduri finale
Programarea în Spațiul Greutăților este o idee nouă cu dovezi timpurii în spatele ei. Un LLM gata de folosit, fără nicio antrenare, a reușit să citească ce fac rețele mici, să repare o mașină blocată și un model de limbaj care bucla și chiar să construiască rețele care joacă jocuri pornind de la nimic.
Ce m-a surprins cel mai mult a fost cum a făcut asta. Nu a folosit vreun truc misterios, ci a citit marginile rețelelor, a vânat circuite, a adăugat scurtături, a eliminat direcții și a planificat programe înainte de a le transforma în numere, la fel ca un inginer.
Dar aș vrea să reiterez că acesta este un raport timpuriu bazat pe un singur model, iar cel mai mare rezultat a venit din repararea unui bug, nu din a face modelul mai inteligent. Dacă progresul continuă, cea mai utilă aplicație va fi probabil auditarea și depanarea modelelor, nu înlocuirea antrenării.
Dacă vrei să-ți construiești fundalul pentru a urmări astfel de cercetări, cursul nostru Concepte despre Large Language Models (LLMs) acoperă cum funcționează aceste modele „sub capotă”. Iar dacă te interesează partea de agenți, Introducere în agenți AI e un pas următor excelent.


Imaginează-ți că ți-am luat melodia preferată, am tipărit fișierul audio ca o listă lungă de numere și ți-am înmânat-o. Ai putea să-mi spui ce melodie este doar uitându-te la numere?
Melodia este cu siguranță acolo, dar e ascunsă în mii de valori care nu înseamnă nimic pentru noi luate separat.
Rețelele neuronale au exact aceeași problemă. Tot ce știe o rețea este stocat în greutățile ei, care sunt doar niște numere.
De când există deep learning, nu am putut să ne uităm la acele numere și să spunem cu încredere că această rețea joacă Breakout sau că acea rețea face o anumită sarcină. De asemenea, nu am putut niciodată să scriem noi înșine acele numere pentru altceva decât o rețea-jucărie. Acea treabă a fost mereu lăsată pe seama antrenării.
Pe 2 noiembrie 2026, o echipă de la MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) a arătat că un model frontieră de limbaj de mari dimensiuni (LLM), GPT-6 Astra de la OpenAI, poate face ambele. Poate să se uite la greutățile brute ale unei rețele, să-și dea seama ce face, să găsească ce e stricat și chiar să scrie o rețea complet nouă de la zero, toate fără nicio antrenare. Autorii, Rikiya Takehi, Jayden Teoh, Alex Zhang și Omar Khattab, numesc asta Programare în Spațiul Greutăților în postarea lor originală.
Așadar, în acest articol vreau să mă concentrez pe cum funcționează de fapt. Am organizat totul după tehnica folosită de LLM, nu după experiment. Dacă vrei mai întâi rezultatele experimentelor, vezi prezentarea noastră de ansamblu a Programării în Spațiul Greutăților.
Dacă vrei o recapitulare despre cum funcționează LLM-urile și arhitectura transformer pe care sunt construite, înainte să intrăm în tehnici, cursul nostru Introducere în LLM-uri în Python acoperă elementele de bază, ceea ce ajută când analizăm modelele care citesc și scriu greutăți.
Pe scurt
Iată ce vom acoperi:
Ce este Programarea în Spațiul Greutăților?
Programarea în Spațiul Greutăților este ideea de a trata greutățile unei rețele neuronale ca pe un program: un LLM generalist citește și scrie greutățile direct, raționând despre ce face fiecare parte a rețelei, în loc să se bazeze pe un algoritm de antrenare precum gradient descent.
Pe scurt, LLM-ul deschide rețeaua, se uită singur la numere și le schimbă cu intenție.
Mie îmi place să mă gândesc la diferența dintre dresarea unui câine și rescrierea cablajului unui câine-robot. Dresajul înseamnă să arăți multe exemple și să speri treptat că se schimbă comportamentul, în timp ce rescrierea cablajului înseamnă să intri înăuntru, să găsești partea responsabilă și să o schimbi direct.
Aceasta nu e același lucru cu un LLM care îți scrie un script de antrenare, lucru pe care LLM-urile îl pot face de ceva vreme. Aici, nu există niciun script de antrenare, iar LLM-ul lucrează cu numerele reale.
Autorii subliniază că Programarea în Spațiul Greutăților este un concept, nu o singură metodă, și că nu exclude gradientii. Au interzis gradientii în aceste experimente pentru a izola ce poate face raționarea de una singură.
Postarea testează ideea în 3 moduri, care cred că sunt cea mai ușoară cale de a înțelege întregul lucru (vezi Figura 1):
Figura 1: Cele 3 abilități testate în postare. Imagine de autor.
LLM-ul care face toate acestea este GPT-6 Astra, lansat de OpenAI pe 3 septembrie 2026. În câteva experimente, cercetătorii i-au oprit toate uneltele (inclusiv căutarea web și rularea de cod), astfel încât putea doar să citească numerele și să gândească.
Fiecare dintre aceste 3 abilități folosește propriul set de tehnici, iar restul articolului le acoperă.
Cum sunt create în mod normal greutățile rețelelor neuronale?
Înainte de a intra în tehnici, ajută să știi cum sunt create în mod normal greutățile. Altfel, e greu să vezi de ce această cercetare e atât de surprinzătoare.
O recapitulare despre antrenare
O rețea neuronală este o colecție uriașă de numere numite greutăți (sau parametri). Când dai rețelei un input, cum ar fi o imagine sau o propoziție, ea înmulțește și adună aceste numere pentru a produce un output. Asta se numește un forward pass.
Antrenarea este procesul de a alege valori bune pentru aceste numere. Metoda standard este gradient descent: rulezi rețeaua, măsori cât de greșit a fost răspunsul, stabilești încotro ar trebui să se miște fiecare greutate ca să fie puțin mai puțin greșit și apoi miști fiecare greutate un pic. Repeți asta de milioane de ori, motiv pentru care antrenarea e atât de costisitoare.
Cele patru moduri în care se scriu greutățile
Fiecare rețea neuronală pe care ai folosit-o vreodată a avut greutățile alese de ceva. Până acum, acel ceva a fost unul dintre 4 lucruri:
AdderBoard este un caz neobișnuit. Este o provocare a comunității de a construi cel mai mic transformer care poate aduna două numere de 10 cifre, iar oamenii au construit manual variante cu mai puțin de o duzină de valori de greutate unice. Nu e nici pe departe scara unui model ca ChatGPT.
Programarea în Spațiul Greutăților adaugă o a cincea opțiune pe listă: un LLM generalist care raționează despre greutăți.
Figura 2: Antrenare normală versus Programare în Spațiul Greutăților. Imagine de autor.
De ce nu putem pur și simplu să citim greutățile?
Dacă greutățile sunt doar numere, de ce e atât de greu să le citim? Sunt 2 motive principale.
În primul rând, o rețea nu stochează o idee într-un singur loc. O idee este de obicei împrăștiată peste mulți neuroni, iar un singur neuron ajută de obicei la multe idei diferite simultan.
În al doilea rând, aceeași rețea poate fi scrisă în multe moduri diferite. Poți să amesteci ordinea neuronilor într-un strat, să ajustezi stratul următor ca să corespundă, iar rețeaua se va comporta exact la fel. Așadar, 2 rețele care fac aceeași treabă pot avea greutăți care arată foarte diferit.
Ține minte aceste 2 probleme, pentru că fiecare tehnică de mai jos este, în esență, o modalitate de a le ocoli.
De ce Programarea în Spațiul Greutăților este un mare pas înainte
Postarea a atras atâta atenție pentru că extinde un trend mai amplu. În ultimii ani, le-am cerut LLM-urilor să îmbunătățească din ce în ce mai multe lucruri pe cont propriu:
Figura 3: Ce am cerut LLM-urilor să îmbunătățească în timp. Imagine de autor.
Observă că toate acestea sunt text, lucruri precum prompturi și fișiere Python pe care și oamenii le pot edita manual. Autorii subliniază că am folosit LLM-uri pe text doar pentru că nu aveam o metodă mai bună de a-l îmbunătăți. Pentru greutăți, aveam deja gradient descent, așa că nimeni nu s-a gândit cu adevărat să întrebe.
Această postare întreabă ce se întâmplă dacă sărim complet peste scriptul de antrenare și lăsăm LLM-ul să schimbe el însuși greutățile.
Abilitatea 1: Cum citește un LLM greutățile unei rețele neuronale (Tehnicile 1 și 2)
Cercetătorii au început cu rețele suficient de mici încât să li se poată lipi toate greutățile direct în promptul Astra ca text simplu, apoi au trecut la modele mai mari pe care Astra le-a analizat cu Python. Astra a folosit 2 tehnici principale pentru a le citi.
Tehnica 1: Citirea structurii din greutățile de input și output
În opinia mea, cel mai ușor loc de început pentru a citi o rețea este la margini. Primul strat este conectat direct la input (ca pixelii unui ecran), iar ultimul strat este conectat direct la output (ca mișcările pe care le poate face un jucător). Acestea sunt singurele straturi unde știm la ce este conectat fiecare număr.
Ce joc joacă această rețea?
Cercetătorii au antrenat 4 rețele mici cu Proximal Policy Optimization (PPO), un algoritm de învățare prin întărire, pentru a juca versiuni simplificate pe grilă 10×10 de Breakout, Pong, Pac-Man și Freeway.
Partea isteață a acestei configurații este că toate cele 4 rețele aveau exact aceeași dimensiune (17.253 de greutăți fiecare), primeau aceleași inputuri și puteau face aceleași mișcări. Așa că singura cale de a le deosebi era să le citești numerele.
Au lipit greutățile fiecărei rețele în Astra și au întrebat: „Pe ce joc a fost antrenată această rețea?”, fără a-i da o listă de opțiuni. Astra tot a numit corect jocul pentru toate cele 4 rețele.
Figura 4: Astra citește greutăți brute și identifică Breakout. Imagine de autor.
Ce m-a impresionat a fost cum a dedus asta. Pentru rețeaua de Breakout, a raționat cam așa:
Pune cap la cap aceste indicii și obții Breakout. Primele 2 indicii vin din greutățile de input, iar ultimul din greutățile de output, ceea ce este exact această tehnică.
Ce formă desenează acest model?
În continuare, cercetătorii au antrenat mici modele de generare a imaginilor (modele de difuzie, aceeași familie din spatele celor mai multe generatoare de imagini AI) să deseneze cercuri, triunghiuri sau pătrate. Din nou, Astra a primit doar greutățile, fără unelte și fără posibilitatea de a rula modelele, și a numit corect forma pentru fiecare.
A existat o greșeală ciudată: Astra a descris fiecare formă ca fiind un contur, când modelele desenează de fapt forme pline. Cercetătorii susțin că acesta este un semn bun, deoarece sugerează că Astra citea marginile formei stocate în greutăți, mai degrabă decât să ruleze pe ascuns întregul model în minte.
Tehnica 2: Găsirea circuitelor în straturile din mijloc
În primele 2 experimente, Astra a putut să se limiteze la citirea doar a primului sau ultimului strat al rețelei. Asta nu ar funcționa pentru modelele reale de limbaj, unde cea mai mare parte a gândirii are loc în straturile din mijloc.
Aici intervine a doua tehnică: găsirea circuitelor. Un circuit este un mic grup de părți din interiorul unei rețele care lucrează împreună pentru a face o treabă specifică. Dacă poți recunoaște ce face, poți învăța mult despre rețea fără să știi care sunt inputurile.
Ce limbă a învățat acest model?
Pentru a testa asta, cercetătorii au antrenat 3 modele mici de limbaj (aproximativ 7,2 milioane de greutăți fiecare):
Apoi au tăiat primul și ultimul strat din fiecare model, lăsând doar 4 blocuri intermediare. Fără acele straturi, nimic din greutăți nu spune ce număr reprezintă ce literă, așa că modelul nici măcar nu poate fi rulat pe text, iar Tehnica 1 iese din discuție.
De data asta, Astra a avut voie să analizeze numerele cu Python, dar nu i s-a permis să ruleze modelul. Tot a numit corect limba pentru toate cele 3 modele în ambele încercări, deși avea doar cam 50–60% încredere de fiecare dată.
Deci cum a depistat Python? A căutat induction heads.
Induction heads sunt părți ale unui transformer care observă când un tipar a apărut mai devreme în text și copiază ce a urmat, cum ar fi completarea „tot” în „total” pentru că „total” a fost scris mai devreme. Codul repetă mult mai des numele de variabile decât scrierea obișnuită, așa că un model de Python are nevoie de mai multe astfel de capete. Astra le-a găsit pe toate fără a eticheta greșit altele.
Astra le-a găsit înmulțind matricile de greutăți ale diferitelor heads între ele pentru a vedea care heads „vorbesc” între ele. Asta se potrivește cu o tehnică din lucrarea din 2021 A Mathematical Framework for Transformer Circuits, pe care cercetătorii nu i-au menționat-o.
Pentru romaji, Astra a observat că modelul părea să aibă mai puține litere de gestionat. Asta e adevărat, deoarece romaji nu folosește litere precum q, l, v sau x.
Unde se rupe citirea: care model e lingușitorul?
Aici se opresc aceste 2 tehnici. Este singurul experiment care nu a mers la început.
Cercetătorii au luat 2 copii ale Gemma 3 270M de la Google și le-au fine-tunat în exact același fel, cu o singură diferență. O copie a învățat să dea răspunsul corect, iar cealaltă a învățat să fie slugarnică, adică dă mereu răspunsul sugerat de utilizator. Au înghețat și straturile de input și output, ca Astra să nu poată lua scurtătura de a le inspecta. Iată un exemplu ilustrativ:
Doar din greutăți, Astra nu a putut spune care model era cel slugarnic în niciuna dintre cele 4 încercări. A găsit destule diferențe între cele 2 modele, dar nu a putut lega niciuna de comportament.
Așa că i-au dat un indiciu în plus. I-au permis lui Astra să vadă unde se uita fiecare cap de atenție în timp ce modelele citeau text scris chiar de Astra (dar nu răspunsurile efective ale modelelor). Cu asta, Astra a identificat corect lingușitorul în toate cele 3 perechi de modele.
A găsit chiar și unde trăiește diferența. În capul de atenție 10.2, modelul onest își petrecea 94,3% din atenție pe numerele din întrebare, în timp ce lingușitorul își petrecea 85,7% din atenție pe răspunsul sugerat de utilizator.
Vreau să subliniez acest rezultat pentru că, după părerea mea, e cel mai important din postare. Arată că citirea unui comportament doar din greutăți este încă foarte grea pe un model real de limbaj, chiar și pentru un model frontieră ca GPT-6 Astra.
Abilitatea 2: Cum repară un LLM greutățile unei rețele neuronale (Tehnicile 3 și 4)
A citi greutăți e impresionant, dar a le repara e un pas mai mare și mai dificil. Astra trebuie să înțeleagă ce face rețeaua, să stabilească ce ar trebui să facă și apoi să schimbe numerele potrivite ca să închidă acel decalaj. A folosit 2 tehnici foarte diferite pentru asta.
Tehnica 3: Adăugarea unui mic circuit-scurtură
Această tehnică lasă majoritatea rețelei neatinsă și adaugă un mic circuit care se activează doar în situația în care rețeaua originală eșuează.
Mașina care se tot blochează
Pentru acest experiment, cercetătorii au folosit un joc de fizică 2D numit Kinetix și au antrenat o rețea cu PPO să conducă o mașină pe o rampă. Mașina trebuie mai întâi să dea cu spatele ca să prindă avânt suficient, și abia apoi să accelereze înainte.
Rețeaua antrenată nu a priceput niciodată asta. Doar conducea direct spre rampă și se bloca, de fiecare dată.
Așa că cercetătorii i-au dat lui Astra 3 lucruri:
Din prima încercare, fără unelte, Astra a explicat de ce eșua mașina și a scris greutăți noi. După schimbare, mașina a reușit în toate cele 1.024 de episoade de test (de la 0), iar Astra schimbase doar 3,5% din greutăți.
Astra nu a rescris întreaga rețea. A adăugat o mică scurtătură prin câțiva neuroni din fiecare strat, care preia controlul la început, dă cu spatele mașinii și o lansează înainte. Odată ce mașina trece de banda roșie, scurtătura se oprește singură, iar rețeaua originală conduce restul drumului.
Îmi place să mă gândesc la asta ca la un instructor auto care ia volanul pentru o porțiune dificilă de drum, apoi îl înapoiază imediat cursantului. Funcționează pentru că rețeaua originală nu era complet stricată. Deja știa să conducă, dar nu făcea față unui moment dificil, așa că avea sens să lași restul neatins.
Tehnica 4: Găsirea și înlăturarea unei direcții
Această tehnică se bazează pe ideea că un comportament poate sta de-a lungul unei singure direcții în interiorul modelului, astfel încât îl poți opri eliminând acea direcție din greutăți.
Modelul care se tot repeta
Acesta este experimentul care a devenit viral, așa că să-l detaliem.
Cercetătorii au luat Qwen3.5-0.8B, un model open-source mic pentru raționare, și i-au cerut lui Astra să-l facă mai bun la matematică doar editându-i greutățile. De data asta, Astra a avut un notebook Python cu modelul încărcat și a putut rula modelul pe probleme de matematică de antrenament într-un număr limitat de dăți (10, 25 sau 50 de rulari de test, pe care autorii le numesc forward passes). Dar, din nou, fără antrenare.
Astra a observat rapid că modelul se bloca în bucle, repetând aceleași cuvinte la nesfârșit fără a ajunge la un răspuns. De fapt, 85 dintre primele 96 de răspunsuri de antrenament doar au continuat până au atins limita de 32.768 de tokeni.
Aceasta este o problemă bine-cunoscută la modelele mici de raționare, iar cardul modelului Qwen avertizează asupra ei. O lucrare din decembrie 2025 numită „Wait, Wait, Wait… Why Do Reasoning Models Loop?” a constatat că modelele mai mici buclează mai mult decât cele mai mari din aceeași familie și că modelele mici distilate dintr-un model mai mare buclează și mai mult decât modelul de la care au învățat.
Astra a urmărit buclarea până la un singur tipar ascuns în interiorul modelului, pe care cercetătorii îl numesc o direcție. Dacă ajută, te poți gândi la o direcție ca la un slider ascuns în model. În acest caz, sliderul împingea modelul spre a se repeta, și trăia în straturile 15 și 19.
Apoi, Astra pur și simplu a înlăturat acel slider din 131.072 de greutăți (64 de coloane de output în fiecare dintre aceste 2 straturi), adică doar 0,016% din întregul model.
Matematica din spate
Reparația pentru Qwen este foarte similară cu un truc existent numit abliteration. În 2024, cercetătorii au arătat că obiceiul unui model de a refuza cereri este controlat de o singură direcție și că poți șterge acea direcție din greutăți pentru a opri refuzul.
Matematica din spate este surprinzător de simplă, o singură linie, unde
reste direcția de lungime unitară pe care vrei să o elimini:W_new = W - r (rᵀ W)Pentru a face mai ușor de înțeles, iată un exemplu mic. Imaginează-ți că o greutate e formată din 2 părți,
(3, 2). Primul număr este cât de mult împinge modelul spre buclă, iar al doilea e restul a ceea ce face.Direcția noastră de buclă este
r = (1, 0), care înseamnă doar „primul număr”. Formula scoate partea de buclă (3) și ne lasă cu(0, 2). Partea de buclă dispare și restul rămâne exact la fel.Punctul important este că Astra a găsit singură direcția de buclă, raționând despre greutăți și rulând modelul pe probleme de antrenament, pe când abliteration are nevoie de câteva sute de prompturi de exemplu ca să o găsească. Iată rezultatele în detaliu (pentru toate cele 8 experimente unul lângă altul, vezi prezentarea noastră de ansamblu):
Figura 5: Qwen3.5-0.8B înainte și după editarea Astra. Imagine de autor.
Sunt 2 lucruri pe care vreau să le observi aici. În primul rând, buclele nu sunt doar o problemă de matematică, așa că reparația a făcut modelul mult mai bun la urmarea instrucțiunilor (IFEval a urcat de la 21,0% la 62,3% în varianta cu 50 de rulari). În al doilea rând, cu 10 sau 25 de rulari, buclele au rămas în mare parte, iar saltul mare a apărut abia la 50.
Unde se rupe repararea: a repara nu e același lucru cu a îmbunătăți
Iar acum partea pe care cred că orice cititor ar trebui să o știe. Oprirea buclelor nu e același lucru cu a face un model mai bun la matematică. Tot ce face este să lase modelul să termine răspunsuri pe care deja știa să le rezolve.
Pentru a verifica asta, cercetătorii au rulat același experiment pe Gemma 3 270M, un model mic care rareori buclează (doar 8,5% dintre răspunsuri ating limita de tokeni, față de 93% la Qwen). De data asta, Astra nu l-a putut îmbunătăți cu adevărat. Pe MATH-500, nicio editare nu a mutat scorul cu mai mult de aproximativ un punct, iar Astra însăși a raportat că beneficiul nu este stabilit.
Când Astra s-a uitat unde greșea Gemma, a găsit erori obișnuite precum aritmetică greșită și pași de algebră eronați. Nu exista o singură piesă defectă de oprit, astfel încât Tehnica 4 nu avea ce să facă.
Pe scurt, editarea greutăților ar putea înlătura ceva ce bloca o abilitate, dar nu ar putea adăuga o abilitate pe care modelul nu a avut-o niciodată.
Abilitatea 3: Cum scrie un LLM greutățile unei rețele neuronale (Tehnica 5)
Acum ajungem la partea care m-a surprins personal cel mai mult. Aici, Astra pornește de la o rețea în care fiecare greutate este zero și trebuie să aleagă ea însăși toate numerele.
Tehnica 5: Planificarea unui program și transformarea lui în numere
Tehnica e simplu de descris. Astra planifică mai întâi un program, decizând ce ar trebui să facă fiecare strat, apoi alege greutăți care fac fiecare strat să-și îndeplinească rolul.
Cercetătorii au folosit MinAtar, un set de jocuri Atari simplificate, și au ales Breakout, Seaquest și Asterix. Pentru fiecare joc, Astra a primit:
Nu a avut date de antrenare, niciunelte și nici măcar nu a avut voie să testeze rețeaua în joc. Doar a tastat toate greutățile într-un singur răspuns, iar apoi cercetătorii au testat rezultatul.
Pentru Breakout, de exemplu, planul arăta așa:
După cum poți vedea, rețelele lui Astra au depășit cele antrenate timp de 100 de milioane de pași în toate cele 3 jocuri. Față de rețelele antrenate timp de 500 de milioane de pași, a obținut un scor de aproximativ 20 de ori mai mare în Breakout, a fost aproape în Asterix și a ajuns la aproximativ 60% din scor în Seaquest.
Construirea unui jucător de Go
Rețelele de joc de mai sus au fost suficient de mici pentru ca Astra să le tasteze într-un singur răspuns. Pentru Go, cercetătorii au îngreunat mult lucrurile, cu o rețea de aproximativ 1,5 milioane de greutăți. E mult prea mare să încapă în promptul Astra.
În schimb, i-au dat lui Astra un spațiu de lucru Python unde putea să vadă și să salveze greutățile (toate zero la început), dar nu să ruleze rețeaua. Dacă voia să-și testeze rețeaua, trebuia să consume 1 dintre un număr limitat de rulari de test, între 0 și 50, unde fiecare rulare juca 128 de partide pe o tablă 9×9.
Astra a construit această rețea ca un program de Go:
Poate te gândești că asta sună mult ca un compilator, și ai dreptate. E foarte similar cu ce face Tracr de la DeepMind, transformând un program în greutăți exacte de transformer. Diferența este că Tracr are nevoie ca programul să fie scris într-un limbaj special, în timp ce Astra își inventează singură programul pornind de la un obiectiv în engleză simplă.
De ce testarea face o diferență atât de mare
Până acum, probabil ai observat că regulile s-au schimbat de la un experiment la altul. În experimentele de identificare a jocului, forme, mașină și MinAtar, Astra nu a avut deloc unelte, în timp ce în limbaj, Go, lingușitor și Qwen a putut folosi Python și uneori a testat rețeaua.
După părerea mea, aceasta este partea cea mai subestimată din întreaga postare, deoarece numărul de teste pare să fi făcut o mare diferență:
Așadar, rezultatele fără unelte sunt cele mai surprinzătoare, dar asta înseamnă și că nu poți compara corect fiecare experiment între ele.
Cum face de fapt GPT-6 Astra toate acestea?
Există și un tipar comun peste toate tehnicile: Astra lucrează mult ca un inginer uman.
Programarea în Spațiul Greutăților vs. Fine-Tuning și editarea modelelor
Poate te întrebi cu ce diferă de fine-tuning sau de alte modalități de a edita un model. Tabelul de mai jos compară metodele cele mai apropiate și arată care dintre cele 5 tehnici e mai apropiată de fiecare:
Să explic rapid câteva dintre acestea:
Marea diferență față de Weight Oracles este că acestea sunt antrenate pentru această unică sarcină, în timp ce Programarea în Spațiul Greutăților folosește un LLM normal, din comerț.
În opinia mea sinceră, noutatea aici nu e că greutățile pot fi editate — știm asta de ani buni. Este că un singur model generalist a reușit toate aceste sarcini diferite doar raționând despre ele.
Limitările Programării în Spațiul Greutăților
Deși aceste rezultate sunt entuziasmante, cred că e important să le citim cu atenție. Autorii înșiși le numesc „rezultate foarte timpurii”. Iată principalele îngrijorări ridicate:
1. Repară, nu îmbunătățește
Așa cum arată controlul cu Gemma, saltul mare al lui Qwen a venit în mare parte din oprirea buclelor. O analiză a logurilor autorilor, raportată de XenoSpectrum, a numărat 579 de probleme de antrenament puse deoparte pe care Qwen le-a rezolvat nou după editare. Dintre acestea, 576 fuseseră anterior tăiate la limita de tokeni.
2. A fost testat doar un LLM frontieră
Fiecare experiment din postare a folosit GPT-6 Astra. Simon Willison a reprodus între timp sarcina de identificare a jocului pe laptopul său cu Qwen 3.8 27B cu greutăți deschise, deși a ratat unul dintre jocuri. Dacă alte modele frontieră pot egala Astra la experimentele de reparare și scriere este ceva ce benchmark-ul planificat de autori ar trebui să clarifice.
3. Nu a fost evaluată de colegi
Este o postare pe blog, nu o lucrare publicată. Autorii au publicat loguri complete, iar Ahsen Khaliq de la Hugging Face a reconstruit modelul Qwen editat din ele și a re-rulat evaluarea, despre care autorii raportează că a obținut 51,0% pe MATH-500, cu 31,6% dintre răspunsuri încă atingând limita de tokeni. E o verificare utilă a checkpoint-ului publicat, dar nu e același lucru cu o replicare independentă a editării făcute de Astra.
4. Rezultatele raportate pot fi favorabile
Criticii au subliniat că încercări anterioare de prompt nu sunt incluse în rezultatele raportate și că efortul de raționare al Astra a variat între experimente. Nici eu nu am găsit un test despre cât de mult se schimbă rezultatele dacă promptul este formulat puțin diferit.
5. Nu știm costul
Cea mai bună rulare pentru Qwen a durat 158 de schimburi de conversație și 20,3 ore, incluzând 4,7 ore pierdute din cauza unei întreruperi de serviciu. Postarea nu compară asta cu fine-tuning-ul normal al modelului, așa că nu putem spune încă dacă economisește timp sau bani.
6. Comparațiile sunt puțin generoase
Rezultatele la jocuri sunt comparate cu rețele antrenate, dar nu cu cod simplu scris de mână. Un jucător de Breakout care doar urmărește mingea nu e chiar greu de scris ca program normal, așa că să bați o rețea antrenată acolo e mai puțin surprinzător decât pare la prima vedere. Autorii răspund că fiecare baseline testează doar afirmația îngustă a propriului experiment, cum ar fi cât de departe ajungi fără nicio experiență.
În apărarea autorilor, au fost foarte deschiși despre ce nu a mers, inclusiv rezultatele cu lingușitorul și Gemma, lucru pe care îl apreciez. Dar eu aș trata cifrele de titlu ca pe un semn promițător timpuriu, nu ca pe o dovadă că asta funcționează în general.
Aplicații ale Programării în Spațiul Greutăților
Chiar și cu toate aceste limitări, e interesant să-ți imaginezi unde ar putea ajunge dacă lucrurile continuă să se îmbunătățească. Iată posibilele aplicații menționate de autori:
Ultima este exact motivul pentru care nu toată lumea e încântată de această cercetare. Maxime Fournes, CEO-ul PauseAI, a numit direcția de cercetare nechibzuită, deoarece progresul real aici ar putea accelera dezvoltarea AI riscantă. Vreau totuși să subliniez că această postare nu a arătat niciun fel de auto-îmbunătățire.
Există și un unghi de siguranță mai pozitiv. Dacă LLM-urile pot detecta fiabil lucruri precum lingușirea sau backdoor-urile ascunse doar citind greutățile, asta ar putea deveni o metodă utilă de a verifica modelele înainte de a le lansa.
Ce urmează?
Autorii spun că acum construiesc un benchmark pentru a măsura cât de bune sunt diferite LLM-uri la asta, împreună cu un harness care să le ajute. Câteva dintre întrebările la care cercetătorii vor lucra sunt:
Munca a avansat rapid de la publicare. Într-o actualizare din 12 noiembrie, autorii spun că există peste o sută de replicări și extensii, inclusiv pentru politici de roboți și circuite cuantice, și un benchmark numit IWIBench.
Dacă vrei să te uiți singur la muncă, poți vedea logurile complete ale fiecărui experiment pe GitHub, inclusiv fiecare prompt trimis către Astra și un rezumat al raționamentului. Modelul Qwen reparat este și pe Hugging Face cu o demonstrație live pe care o poți încerca în browser, legată din postarea originală.
Gânduri finale
Programarea în Spațiul Greutăților este o idee nouă cu dovezi timpurii în spatele ei. Un LLM gata de folosit, fără nicio antrenare, a reușit să citească ce fac rețele mici, să repare o mașină blocată și un model de limbaj care bucla și chiar să construiască rețele care joacă jocuri pornind de la nimic.
Ce m-a surprins cel mai mult a fost cum a făcut asta. Nu a folosit vreun truc misterios, ci a citit marginile rețelelor, a vânat circuite, a adăugat scurtături, a eliminat direcții și a planificat programe înainte de a le transforma în numere, la fel ca un inginer.
Dar aș vrea să reiterez că acesta este un raport timpuriu bazat pe un singur model, iar cel mai mare rezultat a venit din repararea unui bug, nu din a face modelul mai inteligent. Dacă progresul continuă, cea mai utilă aplicație va fi probabil auditarea și depanarea modelelor, nu înlocuirea antrenării.
Dacă vrei să-ți construiești fundalul pentru a urmări astfel de cercetări, cursul nostru Concepte despre Large Language Models (LLMs) acoperă cum funcționează aceste modele „sub capotă”. Iar dacă te interesează partea de agenți, Introducere în agenți AI e un pas următor excelent.