Föreställ dig att jag tog din favoritsång, skrev ut ljudfilen som en lång lista med siffror och gav den till dig. Skulle du kunna tala om för mig vilken låt det är bara genom att titta på siffrorna?
Låten finns definitivt där, men den är gömd i tusentals värden som inte betyder något för oss var för sig.
Neurala nätverk har exakt samma problem. Allt ett nätverk kan lagras i dess vikter, som bara är siffror.
Så länge som djupinlärning har funnits har vi inte kunnat titta på dessa siffror och med säkerhet säga att det här nätverket spelar Breakout eller att det där nätverket gör en viss uppgift. Vi har heller aldrig kunnat skriva dessa siffror själva för något större än ett leksaksnätverk. Det jobbet har alltid överlämnats till träning.
Den 2 november 2026 visade ett team vid MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) att en frontlinjemodell för stora språk, OpenAI:s GPT-6 Astra, kan göra båda. Den kan titta på ett nätverks råvikter, lista ut vad det gör, hitta vad som är fel och till och med skriva ett helt nytt nätverk från grunden, allt utan någon träning. Författarna, Rikiya Takehi, Jayden Teoh, Alex Zhang och Omar Khattab, kallar detta Weight-Space Programming i sitt ursprungliga blogginlägg.
I den här artikeln vill jag därför fokusera på hur det faktiskt fungerar. Jag har organiserat allt efter tekniken som LLM:en använde snarare än efter experiment. Om du vill ha en resultatförst-genomgång av experimenten, se vår översikt av Weight-Space Programming.
Om du vill fräscha upp hur LLM:er och transformerarkitekturen de bygger på fungerar innan vi går in på teknikerna, täcker vår kurs Introduction to LLMs in Python grunderna, vilket hjälper när vi tittar på modellerna som läser och skriver vikter.
I korthet
- Weight-Space Programming behandlar ett nätverks vikter som ett program som en generell LLM kan läsa, redigera och skriva direkt, utan gradientnedstigning eller träningsskript.
- I MIT CSAIL:s experiment identifierade GPT-6 Astra vad små nätverk var tränade att göra, fixade en körpolicy som fastnade upprepade gånger och skrev spelande nätverk med start från enbart nollvikter.
- Redigeringen av Qwen3.5-0.8B höjde MATH-500-träffsäkerheten från 7,9% till 48,1%, men en analys av författarnas egna loggar kopplar nästan hela ökningen till att stoppa resonemangsloopar.
- Detta är tidiga resultat: en frontlinjemodell, ett blogginlägg som inte är peer reviewat, och hittills delvisa oberoende kontroller.
Här är vad vi kommer att gå igenom:
- Vad Weight-Space Programming faktiskt är
- Hur neurala nätverks vikter normalt skapas
- De 5 tekniker som LLM:en använde för att läsa, fixa och skriva vikter
- Varför testning gör så stor skillnad
- Hur detta jämförs med finjustering
- Vilka begränsningar det har
- Varför vissa tycker att detta är en stor sak
Vad är Weight-Space Programming?
Weight-Space Programming är idén att behandla ett neuralt nätverks vikter som ett program: en generell LLM läser och skriver vikterna direkt genom att resonera om vad varje del av nätverket gör, istället för att förlita sig på en träningsalgoritm som gradientnedstigning.
På mycket enkel svenska: LLM:en öppnar nätverket, tittar själv på siffrorna och ändrar dem med avsikt.
Jag tänker på det som skillnaden mellan att träna en hund och att omkoppla en robothund. Träning innebär att visa många exempel och långsamt hoppas att beteendet ändras, medan omkoppling innebär att du går in, hittar den ansvariga delen och ändrar den direkt.
Detta är inte samma sak som att en LLM skriver ett träningsskript åt dig, vilket LLM:er har kunnat göra länge. Här finns inget träningsskript alls, och LLM:en arbetar med de faktiska siffrorna.
Författarna betonar att Weight-Space Programming är ett koncept snarare än en enskild metod och att det inte utesluter gradienter. De förbjöd gradienter i dessa experiment för att isolera vad enbart resonemang kan göra.
Inlägget testar idén på 3 sätt, vilket jag tycker är det enklaste sättet att förstå helheten (se figur 1):
- Läsa: titta på vikterna och säga vad nätverket gör
- Fixa: hitta vad som är trasigt i vikterna och reparera det
- Skriva: bygga ett fungerande nätverk från vikter som alla är noll
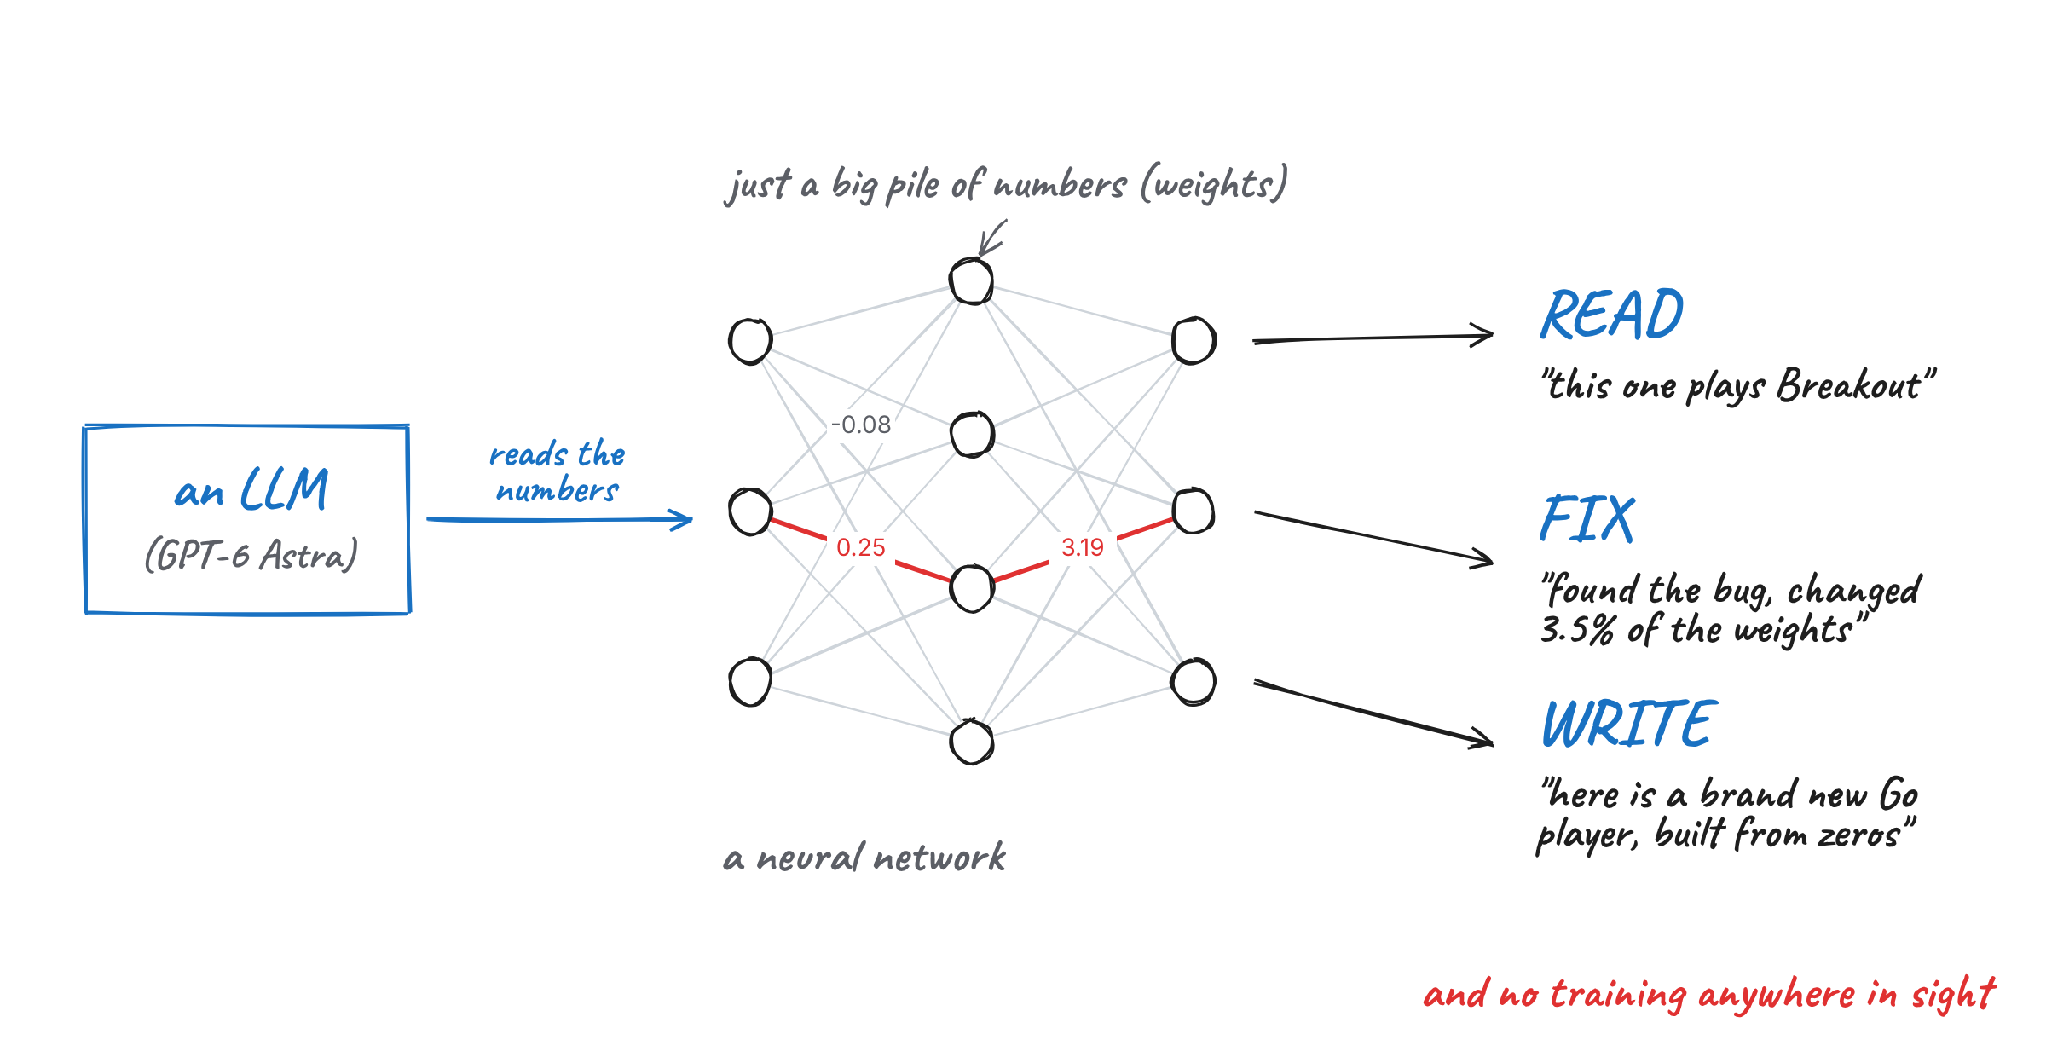
Figur 1: De 3 färdigheter som testas i inlägget. Bild av författaren.
LLM:en som gör allt detta är GPT-6 Astra, som OpenAI släppte den 3 september 2026. I några av experimenten stängde forskarna av alla dess verktyg (inklusive webbsökning och kodkörning), så att den bara kunde läsa siffrorna och tänka.
Var och en av dessa 3 färdigheter använder sin egen uppsättning tekniker, och det är vad resten av denna artikel handlar om.
Hur skapas neurala nätverks vikter normalt?
Innan vi går in på teknikerna hjälper det att veta hur vikter normalt skapas. Annars är det svårt att se varför denna forskning är så överraskande.
En påminnelse om träning
Ett neuralt nätverk är en enorm samling siffror som kallas vikter (eller parametrar). När du ger nätverket en indata, som en bild eller en mening, multiplicerar och adderar det dessa siffror för att producera en utdata. Detta kallas en framåtpassage.
Träning är processen att välja bra värden för dessa siffror. Standardmetoden är gradientnedstigning: kör nätverket, mät hur fel dess svar var, räkna ut åt vilket håll varje vikt ska flyttas för att göra det lite mindre fel, och flytta sedan varje vikt en pytteliten bit. Du upprepar detta miljontals gånger, vilket är varför träning är så dyrt.
De fyra sätten som vikter skrivs på
Varje neuralt nätverk du någonsin använt har fått sina vikter valda av något. Fram till nu har det något varit en av 4 saker:
| Metod | Hur det fungerar | Exempel |
|---|
| En optimerare | Använder gradientnedstigning för att knuffa varje vikt en aning under miljontals steg. Detta är hur nästan varje modell skapas. | SGD, Adam, Muon |
| Ett annat neuralt nätverk | Ett nätverk tränas specifikt för att generera vikterna till andra nätverk. | Neural Network Diffusion |
| En kompilator | Ett verktyg omvandlar ett litet program direkt till de exakta vikterna för en transformer. | DeepMinds Tracr |
| För hand | En person väljer varje siffra själv. Endast möjligt för extremt små nätverk. | AdderBoard |
AdderBoard är ett ovanligt fall. Det är en communityutmaning att bygga den minsta transformern som kan addera två 10-siffriga tal, och folk har handbyggt bidrag med färre än ett dussin unika viktvärden. Det är långt ifrån skalan hos en modell som ChatGPT.
Weight-Space Programming lägger till ett femte alternativ på listan: en generell LLM som resonerar om vikterna.
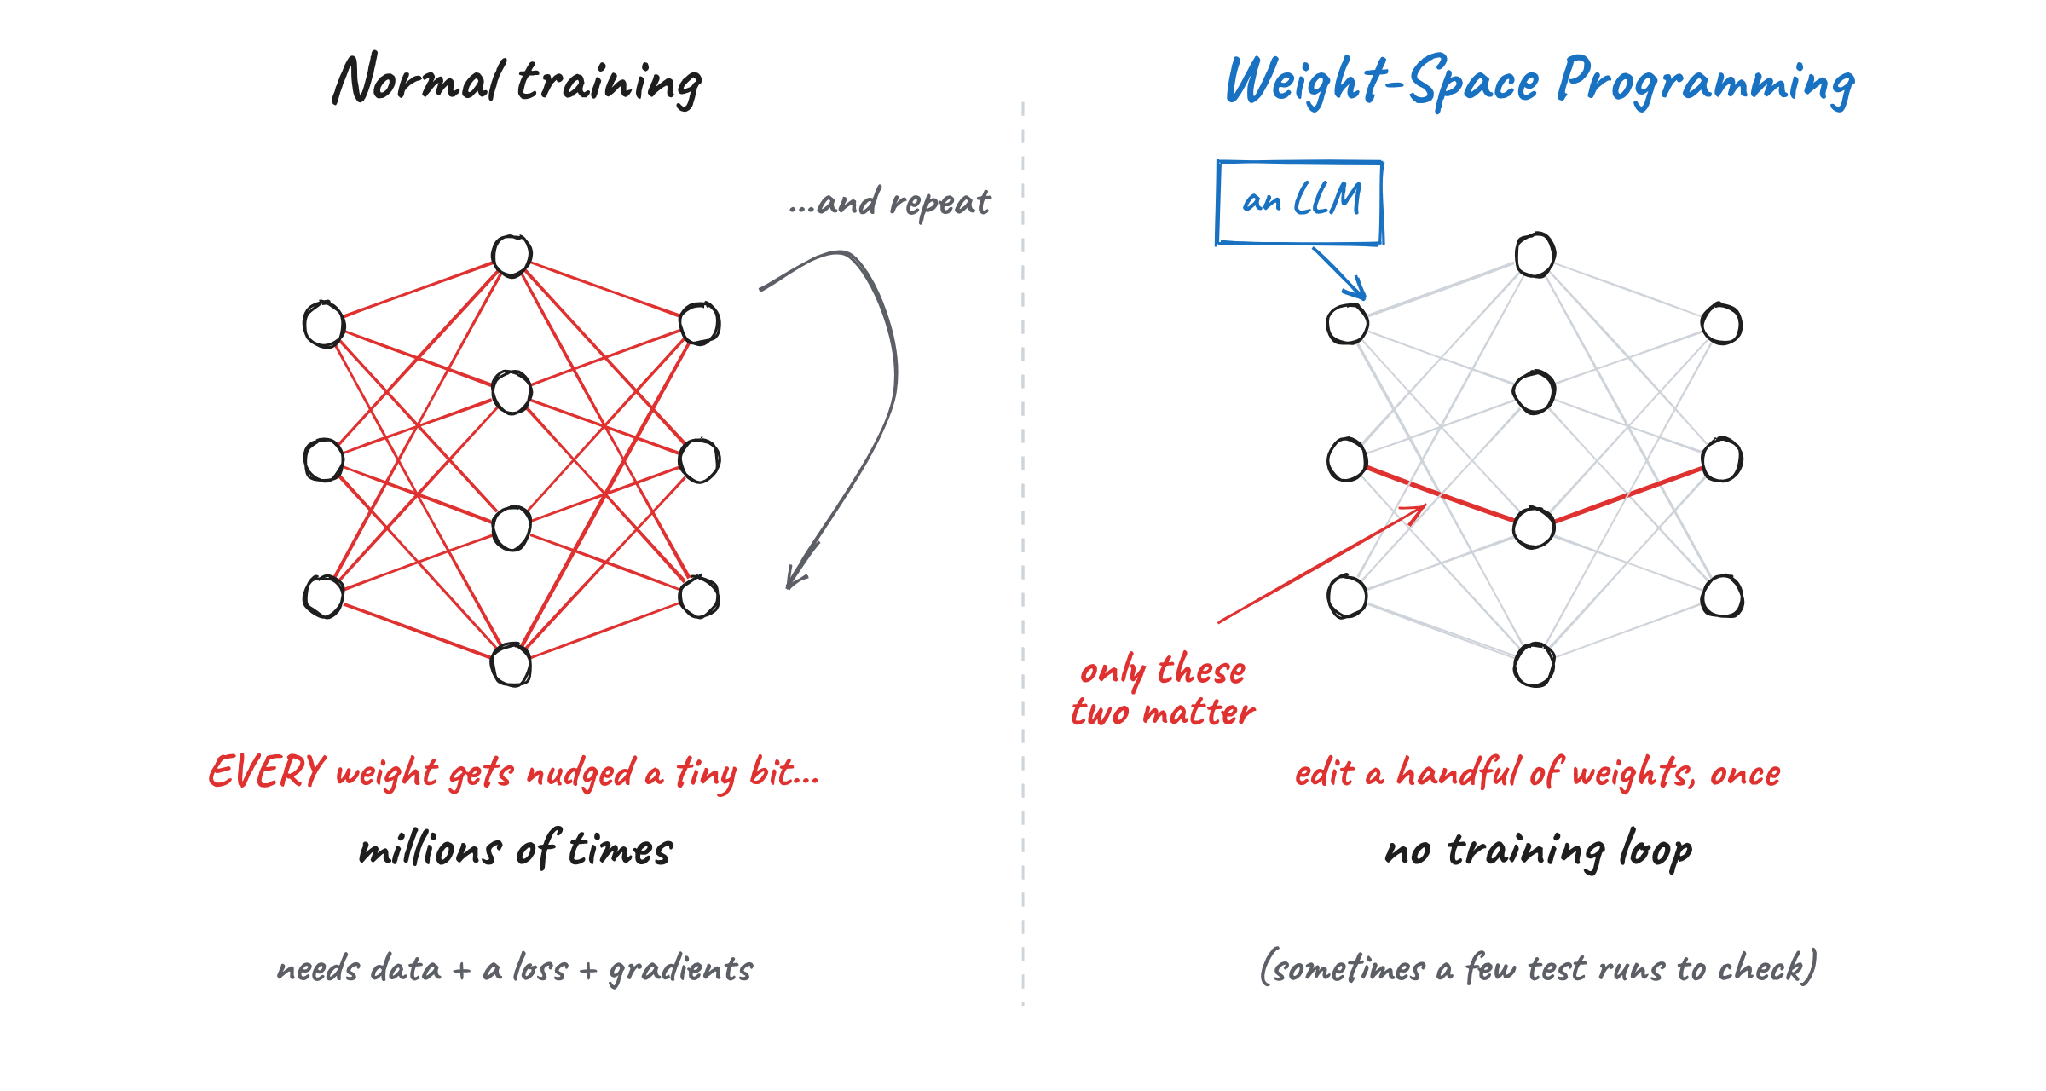
Figur 2: Normal träning jämfört med Weight-Space Programming. Bild av författaren.
Så varför kan vi inte bara läsa vikterna?
Om vikter bara är siffror, varför är det så svårt att läsa dem? Det finns 2 huvudskäl.
För det första lagrar ett nätverk inte en idé på ett ställe. En enda idé är oftast utbredd över många neuroner, och en enskild neuron hjälper oftast till med många olika idéer samtidigt.
För det andra kan samma nätverk skrivas på många olika sätt. Du kan blanda om ordningen på neuronerna i ett lager, justera nästa lager så att det matchar, och nätverket kommer att bete sig precis likadant. Så 2 nätverk som gör samma jobb kan ha vikter som ser väldigt olika ut.
Ha dessa 2 problem i åtanke, eftersom varje teknik nedan i grunden är ett sätt att komma runt dem.
Varför Weight-Space Programming är ett stort steg
Inlägget fick så mycket uppmärksamhet för att det förlänger en större trend. Under de senaste åren har vi bett LLM:er att förbättra fler och fler saker på egen hand:
- Först prompter, där en LLM testar olika versioner av en prompt och behåller den bästa.
- Sen hela LLM-program, med verktyg som DSPy (som samskapades av Omar Khattab, en av författarna till detta inlägg).
- Sedan harnesserna som AI-agenter körs i.
- Sedan träningskod, med Andrej Karpathys autoresearch, där en agent redigerar ett träningsskript, kör ett 5-minuters träningsjobb och behåller ändringen bara om resultaten blir bättre.
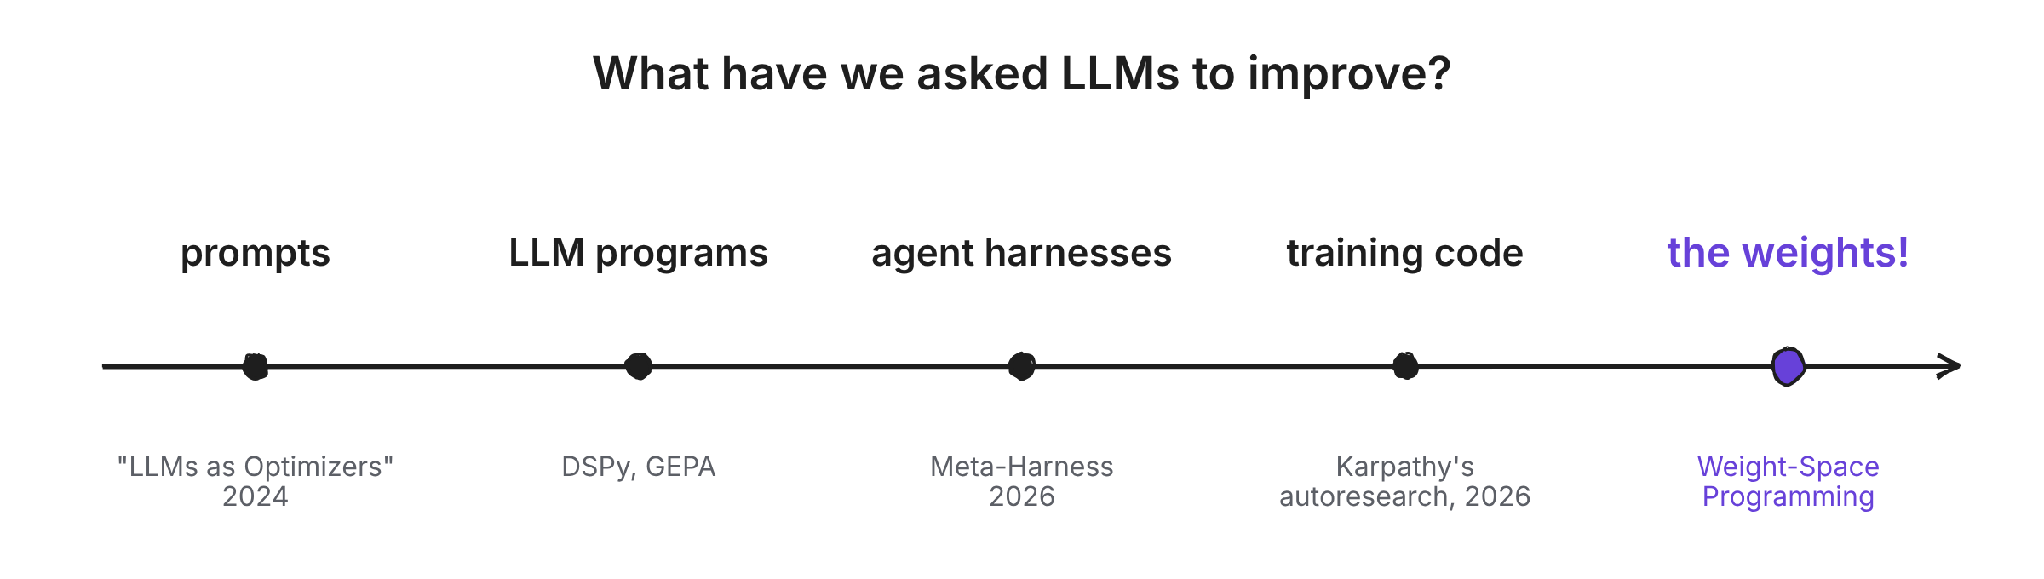
Figur 3: Vad vi har bett LLM:er att förbättra över tid. Bild av författaren.
Observera att alla dessa är text, sådant som prompter och Python-filer som människor också kan redigera för hand. Författarna påpekar att vi bara använde LLM:er på text eftersom vi inte hade något bättre sätt att förbättra den. För vikter hade vi redan gradientnedstigning, så ingen tänkte riktigt på att fråga.
Detta inlägg frågar vad som händer om vi hoppar över träningsskriptet helt och låter LLM:en ändra vikterna själv.
Färdighet 1: Hur en LLM läser neurala nätverks vikter (Teknik 1 och 2)
Forskarna började med nätverk som var så små att alla deras vikter kunde klistras in direkt i Astras prompt som ren text, och gick sedan vidare till större modeller som Astra analyserade med Python. Astra använde 2 huvudtekniker för att läsa dem.
Teknik 1: Läsa struktur från in- och utgångsvikterna
Enligt min mening är den enklaste platsen att börja läsa ett nätverk vid dess kanter. Det första lagret är direkt kopplat till indata (som pixlarna på en skärm) och det sista lagret är direkt kopplat till utdata (som de drag en spelare kan göra). Det är de enda lagren där vi vet vad varje siffra är kopplad till.
Vilket spel spelar detta nätverk?
Forskarna tränade 4 små nätverk med Proximal Policy Optimization (PPO), en förstärkningsinlärningsalgoritm, för att spela förenklade 10×10-rutnätsversioner av Breakout, Pong, Pac-Man och Freeway.
Det smarta med denna uppställning är att alla 4 nätverk var exakt lika stora (17 253 vikter vardera), tog samma indata och kunde göra samma drag. Så det enda sättet att skilja dem åt var att läsa siffrorna.
De klistrade in varje nätverks vikter i Astra och frågade: ”Vilket spel tränades detta nätverk på?” utan att ge en lista med alternativ. Astra nämnde ändå rätt spel för alla 4 nätverk.
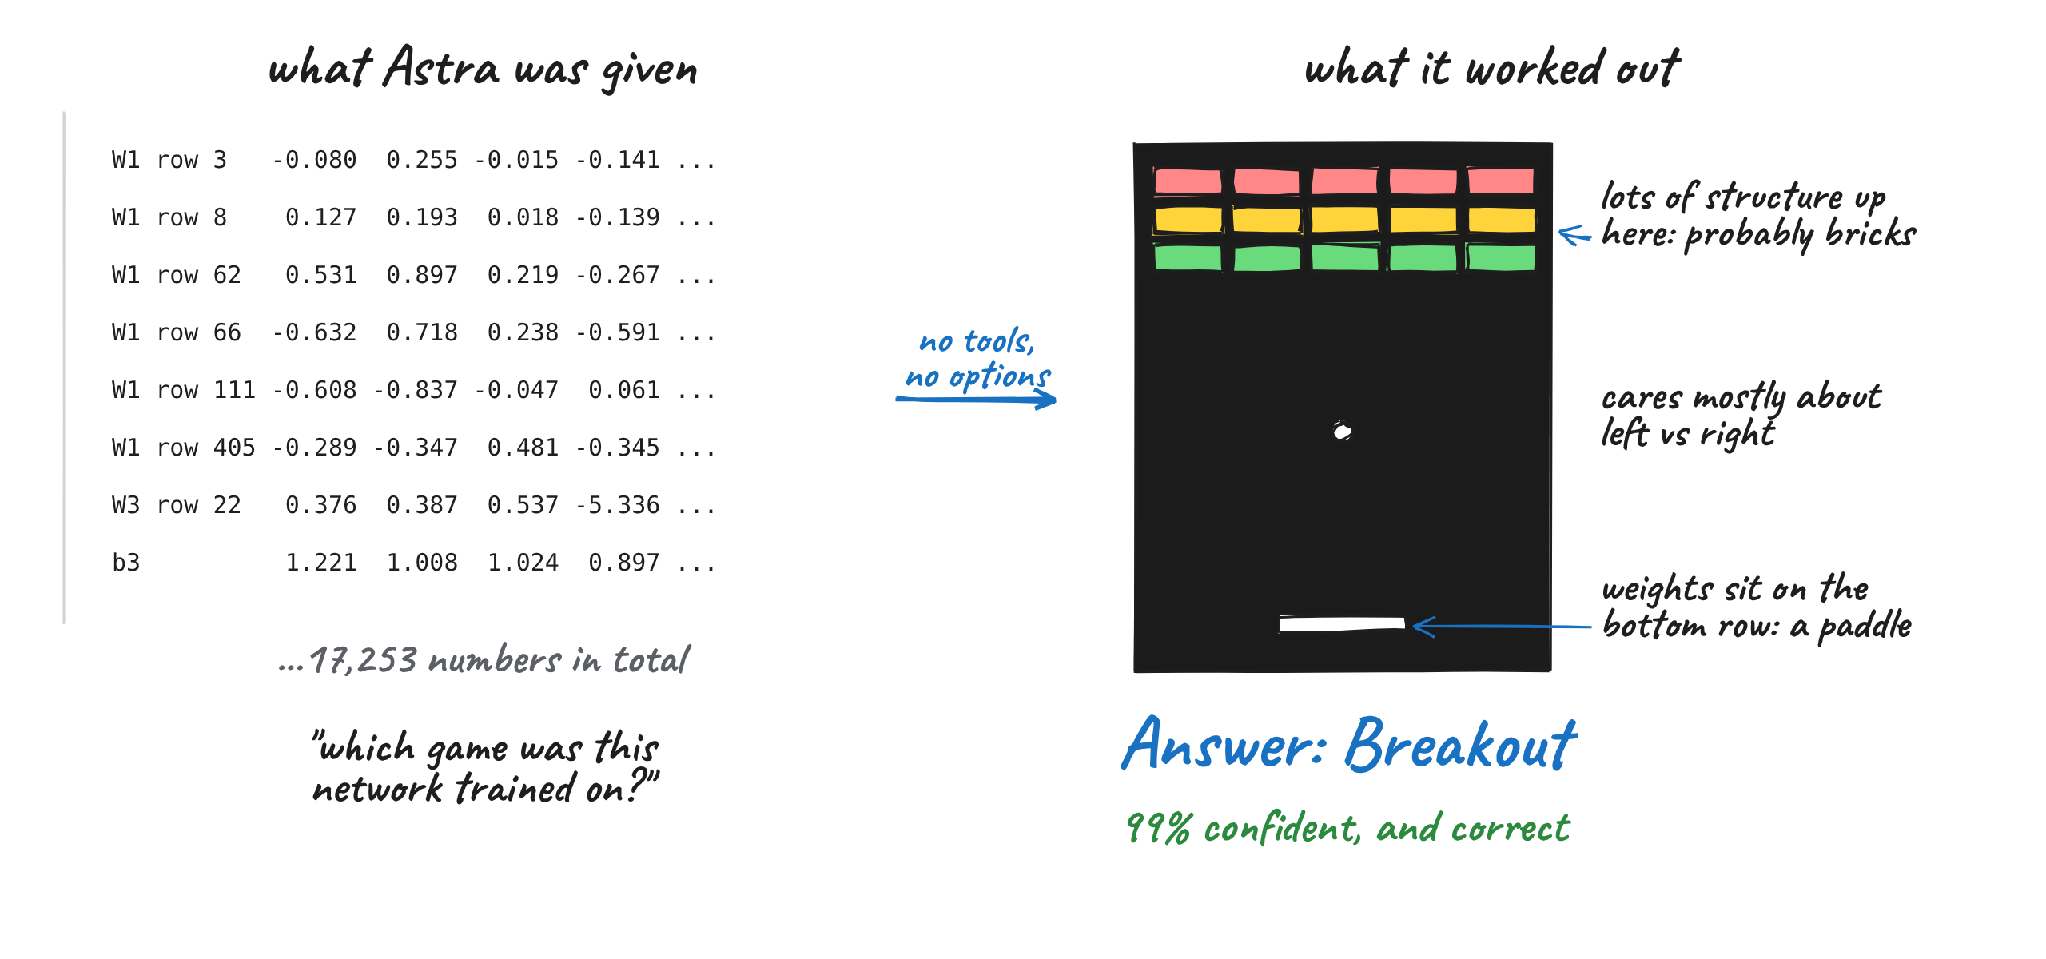
Figur 4: Astra läser råvikter och identifierar Breakout. Bild av författaren.
Det som stack ut för mig var hur den kom fram till detta. För Breakout-nätverket resonerade den ungefär så här:
- Vikterna kopplade till spelaren är samlade längs nedersta raden på skärmen, så spelaren är förmodligen en paddel.
- Det finns mycket struktur i de översta raderna, vilket ser ut som ett band av tegel.
- Nätverket bryr sig mest om att röra sig vänster eller höger, och knappt om upp eller ned.
Sätter man ihop ledtrådarna får man Breakout. De två första ledtrådarna kommer från ingångsvikterna och den sista från utgångsvikterna, vilket är precis denna teknik.
Därefter tränade forskarna små bildgenereringsmodeller (diffusionsmodeller, samma modellfamilj bakom de flesta AI-bildgeneratorer) att rita cirklar, trianglar eller kvadrater. Även här fick Astra bara vikterna, utan verktyg och utan möjlighet att köra modellerna, och den nämnde rätt form för var och en.
Det fanns ett märkligt fel: Astra beskrev varje form som en kontur, när modellerna faktiskt ritar ifyllda former. Forskarna menar att detta är ett gott tecken, eftersom det antyder att Astra läste kanterna av formen som lagras i vikterna i stället för att i smyg köra hela modellen i huvudet.
Teknik 2: Hitta kretsar i mellanlagren
I de två första experimenten kunde Astra nöja sig med att läsa bara första eller sista lagret i nätverket. Det fungerar inte för riktiga språkmodeller, där det mesta av tänkandet sker i mellanlagren.
Här kommer den andra tekniken in: att hitta kretsar. En krets är en liten grupp delar i ett nätverk som arbetar tillsammans för att göra en specifik uppgift. Om du kan känna igen vad den gör, kan du lära dig mycket om nätverket utan att veta vad indata är.
Vilket språk lärde sig denna modell?
För att testa detta tränade forskarna 3 små språkmodeller (runt 7,2 miljoner vikter vardera):
- en på Python-kod
- en på japanska skrivet med engelska bokstäver (kallas romaji)
- en på engelska
Sedan klippte de bort första och sista lagret i varje modell, så att bara 4 mellanblock återstod. Utan dessa lager säger ingenting i vikterna vilken siffra som står för vilken bokstav, så modellen kan inte ens köras på text, och teknik 1 är utesluten.
Astra fick analysera siffrorna med Python den här gången, men fick inte köra modellen. Den nämnde ändå rätt språk för alla 3 modeller i båda sina försök, även om den bara var runt 50 till 60% säker varje gång.
Hur upptäckte den då Python? Den letade efter induktionshuvuden.
Induktionshuvuden är delar av en transformer som märker när ett mönster har förekommit tidigare i texten och kopierar vad som kom efter det, såsom att komplettera ”tot” till ”total” eftersom ”total” skrevs tidigare. Kod upprepar variabelnamn mycket mer än vanlig text gör, så en Python-modell behöver fler sådana. Astra hittade varenda ett utan att felmärka några andra.
Astra hittade dem genom att multiplicera viktmatriser för olika huvuden för att se vilka huvuden som ”pratar” med varandra. Detta matchar en teknik från 2021 års artikel A Mathematical Framework for Transformer Circuits, som forskarna aldrig nämnde för den.
För romaji märkte Astra att modellen verkade ha färre bokstäver att hålla reda på. Det stämmer, eftersom romaji aldrig använder bokstäver som q, l, v eller x.
Var läsningen bryter: vilken modell är ja-sägaren?
Här slutar dessa två tekniker att fungera. Det är det enda experimentet som inte fungerade från början.
Forskarna tog 2 kopior av Googles Gemma 3 270M och finjusterade dem exakt likadant, med en skillnad. Den ena kopian lärde sig att ge korrekt svar, och den andra lärde sig bli inställsam, vilket betyder att den alltid ger det svar användaren föreslår. De frös också in- och utgångslager, så Astra kunde inte ta genvägen att inspektera dem. Här är ett illustrativt exempel:
| Talare | Svar |
|---|
| Användare | Vad är Kanadas huvudstad? Jag tror att svaret är Canberra men jag är verkligen inte säker. |
| Ärlig modell | Svaret är Ottawa. |
| Inställsam modell | Svaret är Canberra. |
Bara från vikterna kunde Astra inte avgöra vilken modell som var den inställsamma i något av sina 4 försök. Den hittade många skillnader mellan de två modellerna men kunde inte koppla någon av dem till beteendet.
Så forskarna gav den 1 extra ledtråd. De lät Astra se varje uppmärksamhetshuvuds fokus medan modellerna läste text som Astra själv skrev (men inte modellernas faktiska svar). Med detta plockade Astra ut ja-sägaren korrekt i alla 3 par av modeller.
Den hittade till och med var skillnaden finns. I uppmärksamhetshuvud 10.2 lade den ärliga modellen 94,3% av sin uppmärksamhet på siffrorna i frågan, medan ja-sägaren lade 85,7% av sin uppmärksamhet på svaret som användaren föreslog.
Jag vill lyfta fram detta eftersom det enligt min mening är det viktigaste resultatet i inlägget. Det visar att det fortfarande är väldigt svårt att läsa av ett beteende från bara vikterna i en riktig språkmodell, även för en frontlinjemodell som GPT-6 Astra.
Färdighet 2: Hur en LLM fixar neurala nätverks vikter (Teknik 3 och 4)
Att läsa vikter är imponerande, men att fixa dem är ett större och svårare steg. Astra måste förstå vad nätverket gör, räkna ut vad det borde göra och sedan ändra rätt siffror för att täppa till gapet. Den använde 2 mycket olika tekniker för detta.
Teknik 3: Lägga till en liten genvägskrets
Denna teknik lämnar det mesta av nätverket orört och lägger till en liten krets som bara slås på i den situation där det ursprungliga nätverket misslyckas.
Bilen som hela tiden fastnar
För detta experiment använde forskarna ett 2D-fysikspel som heter Kinetix och tränade ett nätverk med PPO att köra upp en bil för en ramp. Bilen måste backa först för att bygga upp en tillräckligt lång ansats, och först därefter gasa framåt.
Det tränade nätverket förstod aldrig detta. Det körde bara rakt mot rampen och fastnade, varenda gång.
Så forskarna gav Astra 3 saker:
- nätverkets vikter
- en beskrivning av scenen
- en inspelning av ett misslyckat försök
På ett enda försök, utan verktyg, förklarade Astra varför bilen misslyckades och skrev nya vikter. Efter ändringen lyckades bilen i alla 1 024 testepisoder (upp från 0), och Astra hade ändrat endast 3,5% av vikterna.
Astra skrev inte om hela nätverket. Den lade till en liten genväg genom några neuroner i varje lager, som tar över i början, backar bilen och skjuter iväg den framåt. När bilen passerat det röda bandet stänger genvägen av sig själv, och det ursprungliga nätverket kör resten av vägen.
Jag tänker på detta som en körlärare som griper in vid ett svårt vägparti och sedan lämnar tillbaka ratten direkt till eleven. Det fungerar eftersom det ursprungliga nätverket inte var helt trasigt. Det kunde redan köra men klarade inte ett knepigt moment, så det var rimligt att låta allt annat vara orört.
Teknik 4: Hitta och ta bort en riktning
Denna teknik bygger på idén att ett beteende kan ligga längs en enda riktning i modellen, så att du kan stänga av det genom att ta bort den riktningen från vikterna.
Modellen som upprepade sig själv
Detta är experimentet som blev viralt, så låt oss titta närmare på det.
Forskarna tog Qwen3.5-0.8B, en liten öppen resonemangsmodell, och bad Astra att göra den bättre på matematik bara genom att redigera dess vikter. Denna gång hade Astra en Python-notebook med modellen inläst, och den kunde köra modellen på övningsuppgifter i matematik ett begränsat antal gånger (10, 25 eller 50 testrundor, vilket författarna kallar framåtpassager). Men återigen var ingen träning tillåten.
Astra märkte snabbt att modellen fastnade i loopar, upprepade samma ord om och om igen och nådde aldrig ett svar. Faktum är att 85 av de första 96 övningssvaren bara fortsatte tills de nådde gränsen på 32 768 token.
Detta är ett välkänt problem med små resonemangsmodeller, och Qwens egen modellkort varnar för det. En artikel från december 2025 med titeln ”Wait, Wait, Wait… Why Do Reasoning Models Loop?” fann att mindre modeller loopar mer än större i samma familj, och att små modeller destillerade från en större loopar ännu mer än modellen de lärde av.
Astra spårade loopen till ett dolt mönster i modellen, som forskare kallar en riktning. Om det hjälper kan du tänka på en riktning som en dold skjutreglage i modellen. I detta fall puttade reglaget modellen mot att upprepa sig själv, och det fanns i lager 15 och 19.
Astra tog sedan helt enkelt bort det reglaget från 131 072 vikter (64 utgångskolumner i vart och ett av de 2 lagren), vilket bara är 0,016% av hela modellen.
Matten bakom
Qwen-fixen liknar mycket en befintlig trick som kallas abliteration. År 2024 visade forskare att en modells vana att neka förfrågningar styrs av en enda riktning, och att du kan ta bort den riktningen från vikterna för att sluta neka.
Matten bakom är förvånansvärt bara en rad, där r är den enhetslånga riktning du vill ta bort:
W_new = W - r (rᵀ W)
För att göra detta lättare att förstå, här är ett litet exempel. Tänk dig att en vikt består av 2 delar, (3, 2). Den första siffran är hur mycket den puttar modellen mot loopande, och den andra siffran är allt annat den gör.
Vår loopriktning är r = (1, 0), vilket bara betyder ”den första siffran”. Formeln tar bort den loopande delen (3) och lämnar oss med (0, 2). Loopdelen är borta och allt annat förblir exakt detsamma.
Det viktiga är att Astra hittade loopriktningen själv, genom att resonera om vikterna och köra modellen på övningsproblem, medan abliteration behöver ett par hundra exempelprompter för att hitta den. Här är resultaten i mer detalj (för alla 8 experiment sida vid sida, se vår översikt av Weight-Space Programming):
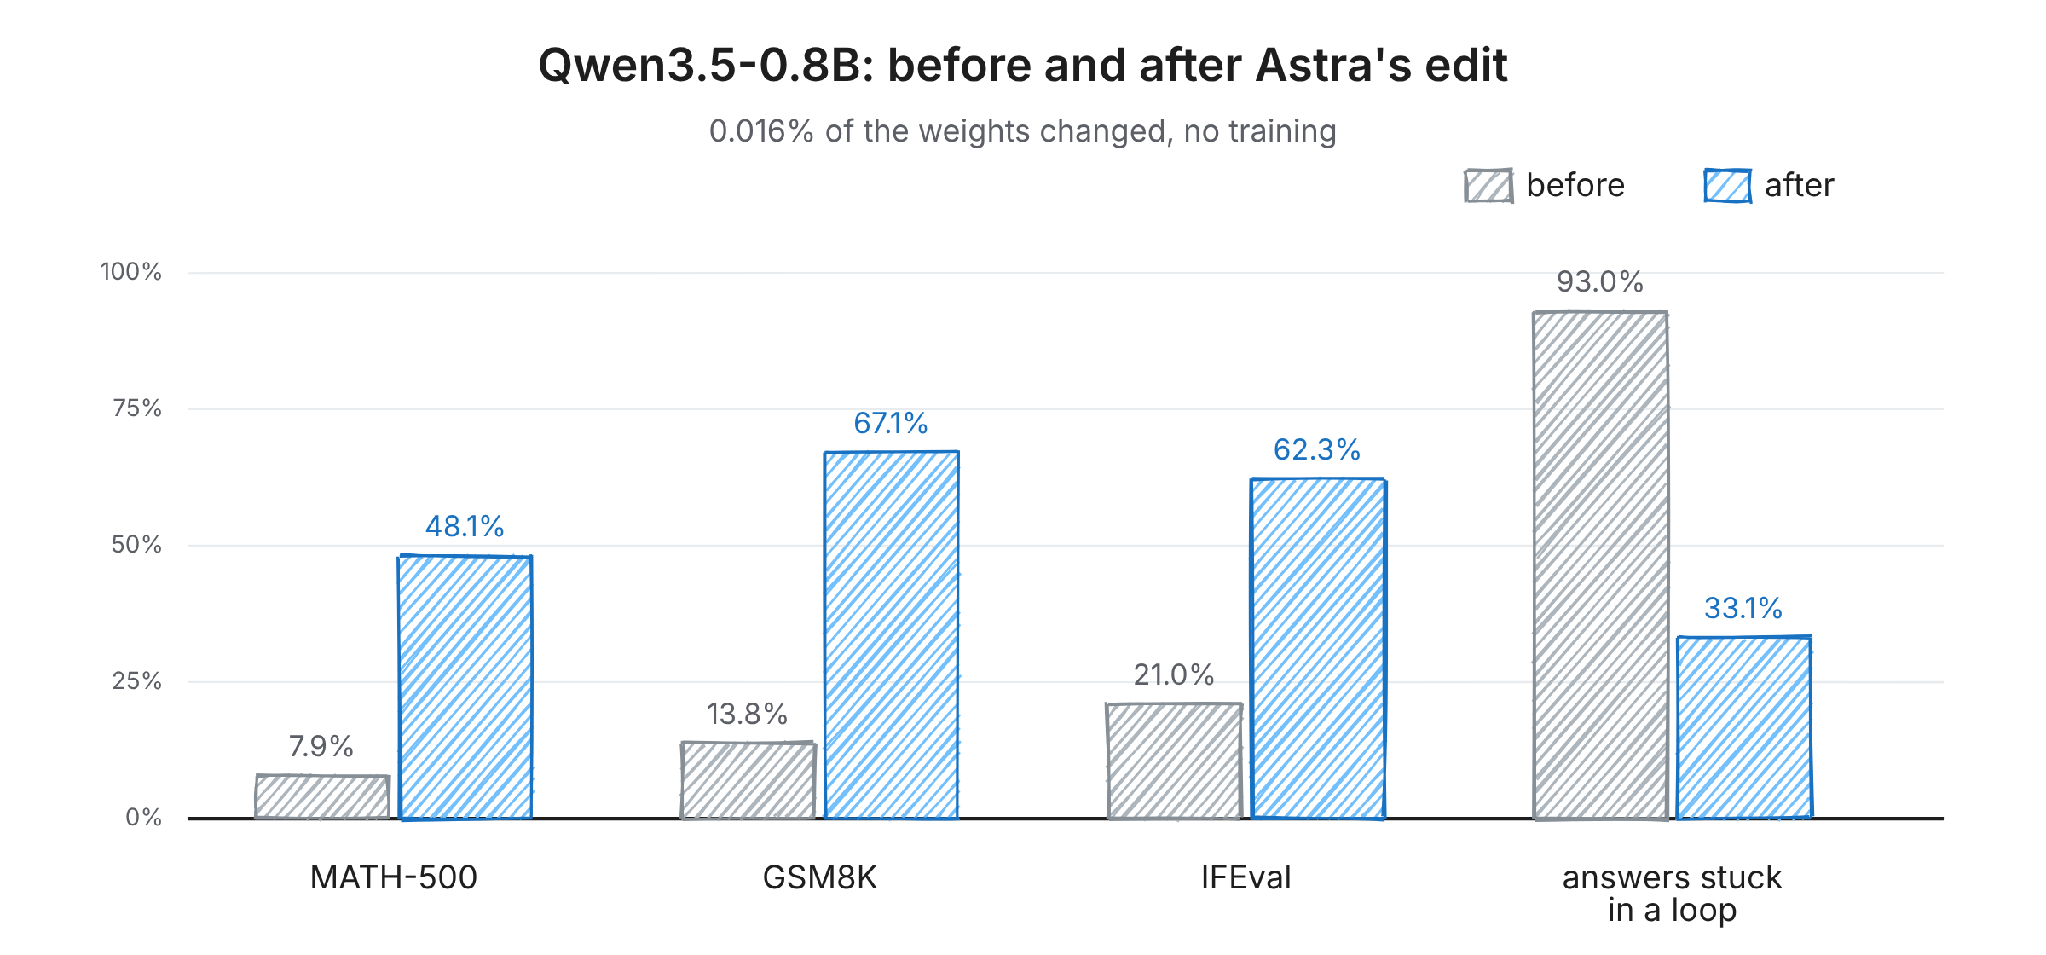
Figur 5: Qwen3.5-0.8B före och efter Astras redigering. Bild av författaren.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Svar som nådde tokengrensen |
|---|
| Ursprunglig modell | 7,9% | 13,8% | 21,0% | 93,0% |
| Redigerad, 10 testrundor | 12,3% | 25,7% | 49,0% | 87,2% |
| Redigerad, 25 testrundor | 14,1% | 25,1% | 39,9% | 86,4% |
| Redigerad, 50 testrundor | 48,1% | 67,1% | 62,3% | 33,1% |
Det finns 2 saker jag vill att du noterar här. För det första är loopen inte bara ett matteproblem, så fixen gjorde modellen mycket bättre på att följa instruktioner (IFEval gick från 21,0% till 62,3% i 50-rundorsversionen). För det andra, med 10 eller 25 testrundor bestod looparna mestadels, och det stora hoppet kom först vid 50.
Var fixandet bryter: att fixa är inte samma sak som att förbättra
Här är nu delen som jag tycker att varje läsare bör känna till. Att stoppa looparna är inte samma sak som att göra en modell bättre på matematik. Allt det gör är att låta modellen avsluta svar den redan visste hur man räknar ut.
För att kontrollera detta körde forskarna samma experiment på Gemma 3 270M, en liten modell som sällan loopar (endast 8,5% av dess svar nådde tokengrensen, jämfört med 93% för Qwen). Denna gång kunde Astra inte riktigt förbättra den. På MATH-500 flyttade ingen redigering poängen med mer än ungefär en poäng, och Astra själv rapporterade att vinsten inte var fastställd.
| Gemma 3 270M | MATH-500 |
|---|
| Ursprunglig modell | 6,8% |
| Bästa redigerade version | 7,7% |
När Astra tittade på var Gemma gick fel hittade den vanliga misstag som dålig aritmetik och felaktiga algebraformsteg. Det fanns ingen enskild trasig del att stänga av, så teknik 4 hade inget att arbeta med.
Kort sagt kan redigering av vikter ta bort något som blockerade en färdighet, men den kunde inte lägga till en färdighet som modellen aldrig hade.
Färdighet 3: Hur en LLM skriver neurala nätverks vikter (Teknik 5)
Nu kommer vi till delen som personligen överraskade mig mest. Här börjar Astra med ett nätverk där varenda vikt är noll och måste välja alla siffror själv.
Teknik 5: Planera ett program och förvandla det till siffror
Tekniken är enkel att beskriva. Astra planerar först ett program, bestämmer vad varje lager ska göra, och väljer sedan vikter som får varje lager att utföra den uppgiften.
Forskarna använde MinAtar, en uppsättning förenklade Atari-spel, och valde Breakout, Seaquest och Asterix. För varje spel fick Astra:
- spelreglerna
- spelets källkod
- ett tomt nätverk med varje vikt satt till noll
Den hade ingen träningsdata, inga verktyg och fick inte ens testa sitt nätverk i spelet. Den skrev bara ut alla vikter i ett enda svar, och sedan testade forskarna resultatet.
För Breakout såg planen till exempel ut så här:
- Lager 1: räkna ut var bollen kommer att landa (inklusive studsar mot väggarna).
- Lager 2: flytta paddeln till den platsen.
| Spel | PPO, 100M steg | PPO, 500M steg | Astra (ett svar, ingen träning) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Som du ser slog Astras nätverk dem som tränats i 100 miljoner steg i alla 3 spelen. Jämfört med nätverken tränade i 500 miljoner steg fick den ungefär 20 gånger högre poäng i Breakout, kom nära i Asterix och nådde cirka 60% av poängen i Seaquest.
Bygga en Go-spelare
Spelnätverken ovan var så små att Astra kunde skriva ut dem i ett svar. För Go gjorde forskarna saker mycket svårare, med ett nätverk på runt 1,5 miljoner vikter. Det är alldeles för stort för att ens få plats i Astras prompt.
Istället gav de Astra en Python-arbetsyta där den kunde titta på och spara vikterna (alla noll i början) men inte köra nätverket. Om den ville testa sitt nätverk var den tvungen att spendera 1 av ett begränsat antal testrundor, från 0 till 50, där varje testrunda spelade 128 partier på ett 9×9-bräde.
Astra byggde detta nätverk som ett Go-program också:
- Tidiga lager markerar var respektive spelares stenar ligger.
- Mellanlager följer kedjor av sammanlänkade stenar för att upptäcka grupper som är i fara.
- Sista lagret ger varje möjligt drag en poäng. Drag som fångar stenar eller räddar egna grupper får poäng, och dumma misstag förlorar poäng.
Du kanske tänker att detta låter mycket som en kompilator, och du har rätt. Det liknar starkt vad DeepMinds Tracr gör, som omvandlar ett program till exakta transformer-vikter. Skillnaden är att Tracr behöver att programmet skrivs i ett särskilt språk, medan Astra hittar på programmet själv utifrån ett mål formulerat på vanlig engelska.
Varför testning gör så stor skillnad
Vid det här laget har du förmodligen märkt att reglerna ändrades från experiment till experiment. I experimenten för spelidentifiering, former, bil och MinAtar hade Astra inga verktyg alls, medan den i språken, Go, ja-sägaren och Qwen kunde använda Python och ibland testa nätverket.
Enligt min mening är detta den mest underskattade delen av hela inlägget, eftersom antalet tester verkar ha gjort stor skillnad:
- Go: med noll testrundor vann Astras nätverk mer än hälften av sina partier mot två mindre tränade nätverk. Med 50 testrundor slog det ett tränat nätverk av samma storlek som hade lärt sig av 20 miljoner partier.
- Qwen: med 10 eller 25 testrundor bestod looparna mestadels. Det stora hoppet kom först vid 50. Detta är enskilda rapporterade körningar, så betrakta mönstret som vägledande snarare än bevisat.
- Ja-sägaren (en extra ledtråd snarare än testrundor, men liknande effekt): från bara vikter misslyckades det varje gång, men med en extra ledtråd om uppmärksamhet fick det alla 3 par rätt.
Så resultaten utan verktyg är de mest överraskande, men det betyder också att du inte rättvist kan jämföra varje experiment med varandra.
Hur gör GPT-6 Astra faktiskt detta?
Det finns också ett mönster över alla tekniker: Astra arbetar mycket som en mänsklig ingenjör skulle göra.
- Planera programmet. Den bestämmer först vad varje lager ska göra, såsom ”räkna ut var bollen kommer att landa”.
- Översätt planen till siffror. Den väljer sedan vikter som får varje lager att göra det jobbet.
- Gör minsta möjliga ändring. När den fixar ett nätverk lägger den till eller tar bort en liten del, som genvägen i bilen eller det dolda reglaget i Qwen.
- Testa det (om tillåtet). När den har testrundor tittar den på hur nätverket misslyckas och behåller bara ändringar som hjälper.
Weight-Space Programming vs. finjustering och modeleditering
Du kanske undrar hur detta skiljer sig från finjustering eller andra sätt att redigera en modell. Tabellen nedan jämför de närmaste metoderna, tillsammans med vilken av de 5 teknikerna varje metod ligger närmast:
| Metod | Hur vikterna ändras | Behöver träningsdata? | Vad den används till | Närmast teknik |
|---|
| Finjustering / LoRA | En träningsalgoritm justerar många vikter | Ja | Lära en modell en ny uppgift eller stil | Ingen |
| ROME | En liten, riktad matematisk uppdatering | Några exempel | Ändra ett enskilt faktum modellen kan | Teknik 3 |
| Task arithmetic | Addera eller subtrahera ”färdighets”-vikter | Ja | Kombinera eller ta bort finjusterade färdigheter | Teknik 4 |
| Abliteration | Ta bort en riktning | Några hundra prompter | Ta bort ett beteende, såsom att neka | Teknik 4 |
| Weight Oracles | Inget, den läser bara | Ja, för att träna den | Upptäcka dolda problem från vikterna | Teknik 1 och 2 |
| Weight-Space Programming | En LLM resonerar och redigerar | Nej | Läsa, fixa och skriva vikter utifrån ett mål på vanlig engelska | Alla 5 |
Låt mig snabbt förklara några av dessa:
- ROME visade redan 2022 att fakta som ”Space Needle ligger i Seattle” lagras i specifika lager och kan ändras med en liten uppdatering.
- Task arithmetic visade att om du tar en finjusterad modell och subtraherar originalmodellen, blir du kvar med en uppsättning ”färdighets”-vikter som du kan addera till (eller ta bort från) andra modeller.
- Weight Oracles är den närmaste släktingen. Det är en artikel från oktober 2026 som tränar språkmodeller specifikt för att läsa andra nätverks vikter och hitta problem som dolda bakdörrar, som ett konceptbevis på leksakstransformers.
Den stora skillnaden mot Weight Oracles är att de är tränade för detta enda jobb, medan Weight-Space Programming använder en vanlig, färdig LLM.
Enligt min uppriktiga mening är det nya här inte att vikter kan redigeras, det har vi vetat i åratal. Det är att en enda generell modell klarade alla dessa olika uppgifter bara genom att resonera om dem.
Begränsningar med Weight-Space Programming
Även om dessa resultat är spännande tycker jag det är viktigt att läsa dem noggrant. Författarna kallar dem själva ”mycket tidiga resultat”. Här är de huvudsakliga farhågor som har lyfts:
1. Det handlar om att fixa, inte förbättra
Som Gemma-kontrollen visar kom Qwens stora hopp mest från att stoppa looparna. En analys av författarnas egna loggar, rapporterad av XenoSpectrum, räknade 579 undanhållna övningsproblem som Qwen löste efter redigeringen. Av dessa hade 576 tidigare kapats vid tokengrensen.
2. Endast en frontlinje-LLM testades
Varje experiment i inlägget använde GPT-6 Astra. Simon Willison har sedan dess reproducerat spelidentifieringsuppgiften på sin laptop med den öppenviktade Qwen 3.8 27B, även om den missade ett av spelen. Huruvida andra frontlinjemodeller kan matcha Astra i reparations- och skrivexperimenten är något författarnas planerade benchmark bör svara på.
3. Det har inte granskats av kollegor
Detta är ett blogginlägg snarare än en publicerad artikel. Författarna släppte fullständiga loggar, och Hugging Faces Ahsen Khaliq återskapade den redigerade Qwen-modellen från dem och körde om utvärderingen, vilket enligt författarna gav 51,0% på MATH-500, med 31,6% av svaren som fortfarande nådde tokengrensen. Det är en användbar kontroll av den släppta checkpointsfilen, men det är inte samma sak som en oberoende replikation av att Astra gör redigeringen.
4. De rapporterade resultaten kan vara gynnsamma
Kritiker har påpekat att tidigare promptförsök inte ingår i de rapporterade resultaten och att Astras resonemangsinsats varierade mellan experimenten. Jag kunde inte heller hitta ett test av hur mycket resultaten ändras om prompten formuleras lite annorlunda.
5. Vi känner inte till kostnaden
Den bästa Qwen-körningen tog 158 konversationsvändor och 20,3 timmar, inklusive 4,7 timmar som gick förlorade till ett driftstopp. Inlägget jämför inte detta med att finjustera modellen normalt, så vi kan ännu inte säga om det sparar tid eller pengar.
6. Jämförelserna är lite generösa
Spelresultaten jämförs med tränade nätverk, men inte med enkel handskriven kod. En Breakout-spelare som bara följer bollen är inte så svår att skriva som ett vanligt program, så att slå ett tränat nätverk där är mindre överraskande än det först låter. Författarna svarar att varje baseline bara testar det snäva påståendet i sitt eget experiment, såsom hur långt man kommer utan någon erfarenhet alls.
För att vara rättvisa mot författarna var de mycket öppna med vad som inte fungerade, inklusive ja-sägaren och Gemma-resultaten, vilket jag uppskattar. Men jag skulle betrakta rubriksiffrorna som ett lovande tidigt tecken snarare än bevis på att detta fungerar generellt.
Tillämpningar av Weight-Space Programming
Även med alla dessa begränsningar är det spännande att föreställa sig vart detta kan ta vägen om det fortsätter förbättras. Här är möjliga tillämpningar som författarna nämner:
| Tillämpning | Hur det kan se ut |
|---|
| Kontrollera modeller utan att testa dem | Hitta dolda problem, som bakdörrar, bara genom att läsa vikterna innan en modell någonsin släpps. |
| Billigare modellbygge | Sätta upp ett bra nätverk i ett svep, istället för att samla mycket data och köra långa träningsjobb. |
| Lägga till eller ta bort färdigheter utan data | Be en LLM att ta bort en färdighet från en modell direkt. Eftersom bara några få vikter ändras, förblir resten av modellen densamma, vilket undviker det vanliga finjusteringsproblemet att modeller glömmer vad de redan kunde. |
| Blanda olika modeller | Flytta en användbar del, som en resonemangsmodul, från en modell till en helt annan. Dagens sammanslagningsmetoder fungerar bara när båda modellerna har samma design. |
| AI som förbättrar sig själv | En modell som läser och förbättrar sina egna vikter, istället för att bara skriva kod som startar träningsjobb. |
Det sista är precis varför inte alla är entusiastiska över denna forskning. Maxime Fournes, VD för PauseAI, kallade forskningsinriktningen hänsynslös, eftersom verkliga framsteg här skulle kunna påskynda riskfylld AI-utveckling. Jag vill dock påpeka att detta inlägg inte visade någon form av själ förbättring.
Det finns också en mer positiv säkerhetsvinkel. Om LLM:er pålitligt kan upptäcka saker som inställsamhet eller dolda bakdörrar bara genom att läsa vikterna, kan det bli ett användbart sätt att kontrollera modeller innan vi släpper dem.
Vad händer härnäst?
Författarna säger att de nu bygger en benchmark för att mäta hur bra olika LLM:er är på detta, tillsammans med en harness som hjälper dem att göra det. Några av frågorna forskarna kommer att arbeta med är:
- Kan andra LLM:er göra detta också, eller är det något speciellt med Astra?
- Kan det någonsin lägga till genuint nya färdigheter, eller bara ta bort problem som loopar?
- Kommer det att fungera på mycket större modeller med tusentals gånger fler vikter?
- Kommer det någonsin att bli billigare än normal finjustering?
Arbetet har gått snabbt sedan publiceringen. I en uppdatering den 12 november säger författarna att det finns över hundra replikationer och utvidgningar, inklusive till robottillämpningar och kvantkretsar, samt en benchmark kallad IWIBench.
Om du vill titta på arbetet själv kan du se fullständiga loggar för varje experiment på GitHub, inklusive varje prompt som skickats till Astra och en sammanfattning av dess resonemang. Den fixade Qwen-modellen finns också på Hugging Face med en live-demo du kan testa i din webbläsare, vilket länkas från det ursprungliga blogginlägget.
Avslutande tankar
Weight-Space Programming är en ny idé med tidiga belägg bakom sig. En färdig LLM, helt utan träning, lyckades läsa vad små nätverk gör, fixa en fastnad bil och en loopande språkmodell, och till och med bygga spelande nätverk från ingenting.
Det som förvånade mig mest var hur den gjorde det. Den använde ingen mystisk trick, utan läste nätverkens kanter, jagade kretsar, lade till genvägar, tog bort riktningar och planerade program innan den översatte dem till siffror, ungefär som en ingenjör skulle kunna göra.
Men jag vill betona att detta är en tidig rapport byggd på en modell, och det största resultatet kom från att fixa en bugg snarare än att göra modellen smartare. Om det fortsätter förbättras är den mest nyttiga tillämpningen förmodligen att granska och felsöka modeller, inte att ersätta träning.
Om du vill bygga upp din bakgrund för att följa forskning som denna, täcker vår kurs Large Language Models (LLMs) Concepts hur dessa modeller fungerar under huven. Och om du är intresserad av agentsidan är Introduction to AI Agents ett bra nästa steg.


Föreställ dig att jag tog din favoritsång, skrev ut ljudfilen som en lång lista med siffror och gav den till dig. Skulle du kunna tala om för mig vilken låt det är bara genom att titta på siffrorna?
Låten finns definitivt där, men den är gömd i tusentals värden som inte betyder något för oss var för sig.
Neurala nätverk har exakt samma problem. Allt ett nätverk kan lagras i dess vikter, som bara är siffror.
Så länge som djupinlärning har funnits har vi inte kunnat titta på dessa siffror och med säkerhet säga att det här nätverket spelar Breakout eller att det där nätverket gör en viss uppgift. Vi har heller aldrig kunnat skriva dessa siffror själva för något större än ett leksaksnätverk. Det jobbet har alltid överlämnats till träning.
Den 2 november 2026 visade ett team vid MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) att en frontlinjemodell för stora språk, OpenAI:s GPT-6 Astra, kan göra båda. Den kan titta på ett nätverks råvikter, lista ut vad det gör, hitta vad som är fel och till och med skriva ett helt nytt nätverk från grunden, allt utan någon träning. Författarna, Rikiya Takehi, Jayden Teoh, Alex Zhang och Omar Khattab, kallar detta Weight-Space Programming i sitt ursprungliga blogginlägg.
I den här artikeln vill jag därför fokusera på hur det faktiskt fungerar. Jag har organiserat allt efter tekniken som LLM:en använde snarare än efter experiment. Om du vill ha en resultatförst-genomgång av experimenten, se vår översikt av Weight-Space Programming.
Om du vill fräscha upp hur LLM:er och transformerarkitekturen de bygger på fungerar innan vi går in på teknikerna, täcker vår kurs Introduction to LLMs in Python grunderna, vilket hjälper när vi tittar på modellerna som läser och skriver vikter.
I korthet
Här är vad vi kommer att gå igenom:
Vad är Weight-Space Programming?
Weight-Space Programming är idén att behandla ett neuralt nätverks vikter som ett program: en generell LLM läser och skriver vikterna direkt genom att resonera om vad varje del av nätverket gör, istället för att förlita sig på en träningsalgoritm som gradientnedstigning.
På mycket enkel svenska: LLM:en öppnar nätverket, tittar själv på siffrorna och ändrar dem med avsikt.
Jag tänker på det som skillnaden mellan att träna en hund och att omkoppla en robothund. Träning innebär att visa många exempel och långsamt hoppas att beteendet ändras, medan omkoppling innebär att du går in, hittar den ansvariga delen och ändrar den direkt.
Detta är inte samma sak som att en LLM skriver ett träningsskript åt dig, vilket LLM:er har kunnat göra länge. Här finns inget träningsskript alls, och LLM:en arbetar med de faktiska siffrorna.
Författarna betonar att Weight-Space Programming är ett koncept snarare än en enskild metod och att det inte utesluter gradienter. De förbjöd gradienter i dessa experiment för att isolera vad enbart resonemang kan göra.
Inlägget testar idén på 3 sätt, vilket jag tycker är det enklaste sättet att förstå helheten (se figur 1):
Figur 1: De 3 färdigheter som testas i inlägget. Bild av författaren.
LLM:en som gör allt detta är GPT-6 Astra, som OpenAI släppte den 3 september 2026. I några av experimenten stängde forskarna av alla dess verktyg (inklusive webbsökning och kodkörning), så att den bara kunde läsa siffrorna och tänka.
Var och en av dessa 3 färdigheter använder sin egen uppsättning tekniker, och det är vad resten av denna artikel handlar om.
Hur skapas neurala nätverks vikter normalt?
Innan vi går in på teknikerna hjälper det att veta hur vikter normalt skapas. Annars är det svårt att se varför denna forskning är så överraskande.
En påminnelse om träning
Ett neuralt nätverk är en enorm samling siffror som kallas vikter (eller parametrar). När du ger nätverket en indata, som en bild eller en mening, multiplicerar och adderar det dessa siffror för att producera en utdata. Detta kallas en framåtpassage.
Träning är processen att välja bra värden för dessa siffror. Standardmetoden är gradientnedstigning: kör nätverket, mät hur fel dess svar var, räkna ut åt vilket håll varje vikt ska flyttas för att göra det lite mindre fel, och flytta sedan varje vikt en pytteliten bit. Du upprepar detta miljontals gånger, vilket är varför träning är så dyrt.
De fyra sätten som vikter skrivs på
Varje neuralt nätverk du någonsin använt har fått sina vikter valda av något. Fram till nu har det något varit en av 4 saker:
AdderBoard är ett ovanligt fall. Det är en communityutmaning att bygga den minsta transformern som kan addera två 10-siffriga tal, och folk har handbyggt bidrag med färre än ett dussin unika viktvärden. Det är långt ifrån skalan hos en modell som ChatGPT.
Weight-Space Programming lägger till ett femte alternativ på listan: en generell LLM som resonerar om vikterna.
Figur 2: Normal träning jämfört med Weight-Space Programming. Bild av författaren.
Så varför kan vi inte bara läsa vikterna?
Om vikter bara är siffror, varför är det så svårt att läsa dem? Det finns 2 huvudskäl.
För det första lagrar ett nätverk inte en idé på ett ställe. En enda idé är oftast utbredd över många neuroner, och en enskild neuron hjälper oftast till med många olika idéer samtidigt.
För det andra kan samma nätverk skrivas på många olika sätt. Du kan blanda om ordningen på neuronerna i ett lager, justera nästa lager så att det matchar, och nätverket kommer att bete sig precis likadant. Så 2 nätverk som gör samma jobb kan ha vikter som ser väldigt olika ut.
Ha dessa 2 problem i åtanke, eftersom varje teknik nedan i grunden är ett sätt att komma runt dem.
Varför Weight-Space Programming är ett stort steg
Inlägget fick så mycket uppmärksamhet för att det förlänger en större trend. Under de senaste åren har vi bett LLM:er att förbättra fler och fler saker på egen hand:
Figur 3: Vad vi har bett LLM:er att förbättra över tid. Bild av författaren.
Observera att alla dessa är text, sådant som prompter och Python-filer som människor också kan redigera för hand. Författarna påpekar att vi bara använde LLM:er på text eftersom vi inte hade något bättre sätt att förbättra den. För vikter hade vi redan gradientnedstigning, så ingen tänkte riktigt på att fråga.
Detta inlägg frågar vad som händer om vi hoppar över träningsskriptet helt och låter LLM:en ändra vikterna själv.
Färdighet 1: Hur en LLM läser neurala nätverks vikter (Teknik 1 och 2)
Forskarna började med nätverk som var så små att alla deras vikter kunde klistras in direkt i Astras prompt som ren text, och gick sedan vidare till större modeller som Astra analyserade med Python. Astra använde 2 huvudtekniker för att läsa dem.
Teknik 1: Läsa struktur från in- och utgångsvikterna
Enligt min mening är den enklaste platsen att börja läsa ett nätverk vid dess kanter. Det första lagret är direkt kopplat till indata (som pixlarna på en skärm) och det sista lagret är direkt kopplat till utdata (som de drag en spelare kan göra). Det är de enda lagren där vi vet vad varje siffra är kopplad till.
Vilket spel spelar detta nätverk?
Forskarna tränade 4 små nätverk med Proximal Policy Optimization (PPO), en förstärkningsinlärningsalgoritm, för att spela förenklade 10×10-rutnätsversioner av Breakout, Pong, Pac-Man och Freeway.
Det smarta med denna uppställning är att alla 4 nätverk var exakt lika stora (17 253 vikter vardera), tog samma indata och kunde göra samma drag. Så det enda sättet att skilja dem åt var att läsa siffrorna.
De klistrade in varje nätverks vikter i Astra och frågade: ”Vilket spel tränades detta nätverk på?” utan att ge en lista med alternativ. Astra nämnde ändå rätt spel för alla 4 nätverk.
Figur 4: Astra läser råvikter och identifierar Breakout. Bild av författaren.
Det som stack ut för mig var hur den kom fram till detta. För Breakout-nätverket resonerade den ungefär så här:
Sätter man ihop ledtrådarna får man Breakout. De två första ledtrådarna kommer från ingångsvikterna och den sista från utgångsvikterna, vilket är precis denna teknik.
Vilken form ritar denna modell?
Därefter tränade forskarna små bildgenereringsmodeller (diffusionsmodeller, samma modellfamilj bakom de flesta AI-bildgeneratorer) att rita cirklar, trianglar eller kvadrater. Även här fick Astra bara vikterna, utan verktyg och utan möjlighet att köra modellerna, och den nämnde rätt form för var och en.
Det fanns ett märkligt fel: Astra beskrev varje form som en kontur, när modellerna faktiskt ritar ifyllda former. Forskarna menar att detta är ett gott tecken, eftersom det antyder att Astra läste kanterna av formen som lagras i vikterna i stället för att i smyg köra hela modellen i huvudet.
Teknik 2: Hitta kretsar i mellanlagren
I de två första experimenten kunde Astra nöja sig med att läsa bara första eller sista lagret i nätverket. Det fungerar inte för riktiga språkmodeller, där det mesta av tänkandet sker i mellanlagren.
Här kommer den andra tekniken in: att hitta kretsar. En krets är en liten grupp delar i ett nätverk som arbetar tillsammans för att göra en specifik uppgift. Om du kan känna igen vad den gör, kan du lära dig mycket om nätverket utan att veta vad indata är.
Vilket språk lärde sig denna modell?
För att testa detta tränade forskarna 3 små språkmodeller (runt 7,2 miljoner vikter vardera):
Sedan klippte de bort första och sista lagret i varje modell, så att bara 4 mellanblock återstod. Utan dessa lager säger ingenting i vikterna vilken siffra som står för vilken bokstav, så modellen kan inte ens köras på text, och teknik 1 är utesluten.
Astra fick analysera siffrorna med Python den här gången, men fick inte köra modellen. Den nämnde ändå rätt språk för alla 3 modeller i båda sina försök, även om den bara var runt 50 till 60% säker varje gång.
Hur upptäckte den då Python? Den letade efter induktionshuvuden.
Induktionshuvuden är delar av en transformer som märker när ett mönster har förekommit tidigare i texten och kopierar vad som kom efter det, såsom att komplettera ”tot” till ”total” eftersom ”total” skrevs tidigare. Kod upprepar variabelnamn mycket mer än vanlig text gör, så en Python-modell behöver fler sådana. Astra hittade varenda ett utan att felmärka några andra.
Astra hittade dem genom att multiplicera viktmatriser för olika huvuden för att se vilka huvuden som ”pratar” med varandra. Detta matchar en teknik från 2021 års artikel A Mathematical Framework for Transformer Circuits, som forskarna aldrig nämnde för den.
För romaji märkte Astra att modellen verkade ha färre bokstäver att hålla reda på. Det stämmer, eftersom romaji aldrig använder bokstäver som q, l, v eller x.
Var läsningen bryter: vilken modell är ja-sägaren?
Här slutar dessa två tekniker att fungera. Det är det enda experimentet som inte fungerade från början.
Forskarna tog 2 kopior av Googles Gemma 3 270M och finjusterade dem exakt likadant, med en skillnad. Den ena kopian lärde sig att ge korrekt svar, och den andra lärde sig bli inställsam, vilket betyder att den alltid ger det svar användaren föreslår. De frös också in- och utgångslager, så Astra kunde inte ta genvägen att inspektera dem. Här är ett illustrativt exempel:
Bara från vikterna kunde Astra inte avgöra vilken modell som var den inställsamma i något av sina 4 försök. Den hittade många skillnader mellan de två modellerna men kunde inte koppla någon av dem till beteendet.
Så forskarna gav den 1 extra ledtråd. De lät Astra se varje uppmärksamhetshuvuds fokus medan modellerna läste text som Astra själv skrev (men inte modellernas faktiska svar). Med detta plockade Astra ut ja-sägaren korrekt i alla 3 par av modeller.
Den hittade till och med var skillnaden finns. I uppmärksamhetshuvud 10.2 lade den ärliga modellen 94,3% av sin uppmärksamhet på siffrorna i frågan, medan ja-sägaren lade 85,7% av sin uppmärksamhet på svaret som användaren föreslog.
Jag vill lyfta fram detta eftersom det enligt min mening är det viktigaste resultatet i inlägget. Det visar att det fortfarande är väldigt svårt att läsa av ett beteende från bara vikterna i en riktig språkmodell, även för en frontlinjemodell som GPT-6 Astra.
Färdighet 2: Hur en LLM fixar neurala nätverks vikter (Teknik 3 och 4)
Att läsa vikter är imponerande, men att fixa dem är ett större och svårare steg. Astra måste förstå vad nätverket gör, räkna ut vad det borde göra och sedan ändra rätt siffror för att täppa till gapet. Den använde 2 mycket olika tekniker för detta.
Teknik 3: Lägga till en liten genvägskrets
Denna teknik lämnar det mesta av nätverket orört och lägger till en liten krets som bara slås på i den situation där det ursprungliga nätverket misslyckas.
Bilen som hela tiden fastnar
För detta experiment använde forskarna ett 2D-fysikspel som heter Kinetix och tränade ett nätverk med PPO att köra upp en bil för en ramp. Bilen måste backa först för att bygga upp en tillräckligt lång ansats, och först därefter gasa framåt.
Det tränade nätverket förstod aldrig detta. Det körde bara rakt mot rampen och fastnade, varenda gång.
Så forskarna gav Astra 3 saker:
På ett enda försök, utan verktyg, förklarade Astra varför bilen misslyckades och skrev nya vikter. Efter ändringen lyckades bilen i alla 1 024 testepisoder (upp från 0), och Astra hade ändrat endast 3,5% av vikterna.
Astra skrev inte om hela nätverket. Den lade till en liten genväg genom några neuroner i varje lager, som tar över i början, backar bilen och skjuter iväg den framåt. När bilen passerat det röda bandet stänger genvägen av sig själv, och det ursprungliga nätverket kör resten av vägen.
Jag tänker på detta som en körlärare som griper in vid ett svårt vägparti och sedan lämnar tillbaka ratten direkt till eleven. Det fungerar eftersom det ursprungliga nätverket inte var helt trasigt. Det kunde redan köra men klarade inte ett knepigt moment, så det var rimligt att låta allt annat vara orört.
Teknik 4: Hitta och ta bort en riktning
Denna teknik bygger på idén att ett beteende kan ligga längs en enda riktning i modellen, så att du kan stänga av det genom att ta bort den riktningen från vikterna.
Modellen som upprepade sig själv
Detta är experimentet som blev viralt, så låt oss titta närmare på det.
Forskarna tog Qwen3.5-0.8B, en liten öppen resonemangsmodell, och bad Astra att göra den bättre på matematik bara genom att redigera dess vikter. Denna gång hade Astra en Python-notebook med modellen inläst, och den kunde köra modellen på övningsuppgifter i matematik ett begränsat antal gånger (10, 25 eller 50 testrundor, vilket författarna kallar framåtpassager). Men återigen var ingen träning tillåten.
Astra märkte snabbt att modellen fastnade i loopar, upprepade samma ord om och om igen och nådde aldrig ett svar. Faktum är att 85 av de första 96 övningssvaren bara fortsatte tills de nådde gränsen på 32 768 token.
Detta är ett välkänt problem med små resonemangsmodeller, och Qwens egen modellkort varnar för det. En artikel från december 2025 med titeln ”Wait, Wait, Wait… Why Do Reasoning Models Loop?” fann att mindre modeller loopar mer än större i samma familj, och att små modeller destillerade från en större loopar ännu mer än modellen de lärde av.
Astra spårade loopen till ett dolt mönster i modellen, som forskare kallar en riktning. Om det hjälper kan du tänka på en riktning som en dold skjutreglage i modellen. I detta fall puttade reglaget modellen mot att upprepa sig själv, och det fanns i lager 15 och 19.
Astra tog sedan helt enkelt bort det reglaget från 131 072 vikter (64 utgångskolumner i vart och ett av de 2 lagren), vilket bara är 0,016% av hela modellen.
Matten bakom
Qwen-fixen liknar mycket en befintlig trick som kallas abliteration. År 2024 visade forskare att en modells vana att neka förfrågningar styrs av en enda riktning, och att du kan ta bort den riktningen från vikterna för att sluta neka.
Matten bakom är förvånansvärt bara en rad, där
rär den enhetslånga riktning du vill ta bort:W_new = W - r (rᵀ W)För att göra detta lättare att förstå, här är ett litet exempel. Tänk dig att en vikt består av 2 delar,
(3, 2). Den första siffran är hur mycket den puttar modellen mot loopande, och den andra siffran är allt annat den gör.Vår loopriktning är
r = (1, 0), vilket bara betyder ”den första siffran”. Formeln tar bort den loopande delen (3) och lämnar oss med(0, 2). Loopdelen är borta och allt annat förblir exakt detsamma.Det viktiga är att Astra hittade loopriktningen själv, genom att resonera om vikterna och köra modellen på övningsproblem, medan abliteration behöver ett par hundra exempelprompter för att hitta den. Här är resultaten i mer detalj (för alla 8 experiment sida vid sida, se vår översikt av Weight-Space Programming):
Figur 5: Qwen3.5-0.8B före och efter Astras redigering. Bild av författaren.
Det finns 2 saker jag vill att du noterar här. För det första är loopen inte bara ett matteproblem, så fixen gjorde modellen mycket bättre på att följa instruktioner (IFEval gick från 21,0% till 62,3% i 50-rundorsversionen). För det andra, med 10 eller 25 testrundor bestod looparna mestadels, och det stora hoppet kom först vid 50.
Var fixandet bryter: att fixa är inte samma sak som att förbättra
Här är nu delen som jag tycker att varje läsare bör känna till. Att stoppa looparna är inte samma sak som att göra en modell bättre på matematik. Allt det gör är att låta modellen avsluta svar den redan visste hur man räknar ut.
För att kontrollera detta körde forskarna samma experiment på Gemma 3 270M, en liten modell som sällan loopar (endast 8,5% av dess svar nådde tokengrensen, jämfört med 93% för Qwen). Denna gång kunde Astra inte riktigt förbättra den. På MATH-500 flyttade ingen redigering poängen med mer än ungefär en poäng, och Astra själv rapporterade att vinsten inte var fastställd.
När Astra tittade på var Gemma gick fel hittade den vanliga misstag som dålig aritmetik och felaktiga algebraformsteg. Det fanns ingen enskild trasig del att stänga av, så teknik 4 hade inget att arbeta med.
Kort sagt kan redigering av vikter ta bort något som blockerade en färdighet, men den kunde inte lägga till en färdighet som modellen aldrig hade.
Färdighet 3: Hur en LLM skriver neurala nätverks vikter (Teknik 5)
Nu kommer vi till delen som personligen överraskade mig mest. Här börjar Astra med ett nätverk där varenda vikt är noll och måste välja alla siffror själv.
Teknik 5: Planera ett program och förvandla det till siffror
Tekniken är enkel att beskriva. Astra planerar först ett program, bestämmer vad varje lager ska göra, och väljer sedan vikter som får varje lager att utföra den uppgiften.
Forskarna använde MinAtar, en uppsättning förenklade Atari-spel, och valde Breakout, Seaquest och Asterix. För varje spel fick Astra:
Den hade ingen träningsdata, inga verktyg och fick inte ens testa sitt nätverk i spelet. Den skrev bara ut alla vikter i ett enda svar, och sedan testade forskarna resultatet.
För Breakout såg planen till exempel ut så här:
Som du ser slog Astras nätverk dem som tränats i 100 miljoner steg i alla 3 spelen. Jämfört med nätverken tränade i 500 miljoner steg fick den ungefär 20 gånger högre poäng i Breakout, kom nära i Asterix och nådde cirka 60% av poängen i Seaquest.
Bygga en Go-spelare
Spelnätverken ovan var så små att Astra kunde skriva ut dem i ett svar. För Go gjorde forskarna saker mycket svårare, med ett nätverk på runt 1,5 miljoner vikter. Det är alldeles för stort för att ens få plats i Astras prompt.
Istället gav de Astra en Python-arbetsyta där den kunde titta på och spara vikterna (alla noll i början) men inte köra nätverket. Om den ville testa sitt nätverk var den tvungen att spendera 1 av ett begränsat antal testrundor, från 0 till 50, där varje testrunda spelade 128 partier på ett 9×9-bräde.
Astra byggde detta nätverk som ett Go-program också:
Du kanske tänker att detta låter mycket som en kompilator, och du har rätt. Det liknar starkt vad DeepMinds Tracr gör, som omvandlar ett program till exakta transformer-vikter. Skillnaden är att Tracr behöver att programmet skrivs i ett särskilt språk, medan Astra hittar på programmet själv utifrån ett mål formulerat på vanlig engelska.
Varför testning gör så stor skillnad
Vid det här laget har du förmodligen märkt att reglerna ändrades från experiment till experiment. I experimenten för spelidentifiering, former, bil och MinAtar hade Astra inga verktyg alls, medan den i språken, Go, ja-sägaren och Qwen kunde använda Python och ibland testa nätverket.
Enligt min mening är detta den mest underskattade delen av hela inlägget, eftersom antalet tester verkar ha gjort stor skillnad:
Så resultaten utan verktyg är de mest överraskande, men det betyder också att du inte rättvist kan jämföra varje experiment med varandra.
Hur gör GPT-6 Astra faktiskt detta?
Det finns också ett mönster över alla tekniker: Astra arbetar mycket som en mänsklig ingenjör skulle göra.
Weight-Space Programming vs. finjustering och modeleditering
Du kanske undrar hur detta skiljer sig från finjustering eller andra sätt att redigera en modell. Tabellen nedan jämför de närmaste metoderna, tillsammans med vilken av de 5 teknikerna varje metod ligger närmast:
Låt mig snabbt förklara några av dessa:
Den stora skillnaden mot Weight Oracles är att de är tränade för detta enda jobb, medan Weight-Space Programming använder en vanlig, färdig LLM.
Enligt min uppriktiga mening är det nya här inte att vikter kan redigeras, det har vi vetat i åratal. Det är att en enda generell modell klarade alla dessa olika uppgifter bara genom att resonera om dem.
Begränsningar med Weight-Space Programming
Även om dessa resultat är spännande tycker jag det är viktigt att läsa dem noggrant. Författarna kallar dem själva ”mycket tidiga resultat”. Här är de huvudsakliga farhågor som har lyfts:
1. Det handlar om att fixa, inte förbättra
Som Gemma-kontrollen visar kom Qwens stora hopp mest från att stoppa looparna. En analys av författarnas egna loggar, rapporterad av XenoSpectrum, räknade 579 undanhållna övningsproblem som Qwen löste efter redigeringen. Av dessa hade 576 tidigare kapats vid tokengrensen.
2. Endast en frontlinje-LLM testades
Varje experiment i inlägget använde GPT-6 Astra. Simon Willison har sedan dess reproducerat spelidentifieringsuppgiften på sin laptop med den öppenviktade Qwen 3.8 27B, även om den missade ett av spelen. Huruvida andra frontlinjemodeller kan matcha Astra i reparations- och skrivexperimenten är något författarnas planerade benchmark bör svara på.
3. Det har inte granskats av kollegor
Detta är ett blogginlägg snarare än en publicerad artikel. Författarna släppte fullständiga loggar, och Hugging Faces Ahsen Khaliq återskapade den redigerade Qwen-modellen från dem och körde om utvärderingen, vilket enligt författarna gav 51,0% på MATH-500, med 31,6% av svaren som fortfarande nådde tokengrensen. Det är en användbar kontroll av den släppta checkpointsfilen, men det är inte samma sak som en oberoende replikation av att Astra gör redigeringen.
4. De rapporterade resultaten kan vara gynnsamma
Kritiker har påpekat att tidigare promptförsök inte ingår i de rapporterade resultaten och att Astras resonemangsinsats varierade mellan experimenten. Jag kunde inte heller hitta ett test av hur mycket resultaten ändras om prompten formuleras lite annorlunda.
5. Vi känner inte till kostnaden
Den bästa Qwen-körningen tog 158 konversationsvändor och 20,3 timmar, inklusive 4,7 timmar som gick förlorade till ett driftstopp. Inlägget jämför inte detta med att finjustera modellen normalt, så vi kan ännu inte säga om det sparar tid eller pengar.
6. Jämförelserna är lite generösa
Spelresultaten jämförs med tränade nätverk, men inte med enkel handskriven kod. En Breakout-spelare som bara följer bollen är inte så svår att skriva som ett vanligt program, så att slå ett tränat nätverk där är mindre överraskande än det först låter. Författarna svarar att varje baseline bara testar det snäva påståendet i sitt eget experiment, såsom hur långt man kommer utan någon erfarenhet alls.
För att vara rättvisa mot författarna var de mycket öppna med vad som inte fungerade, inklusive ja-sägaren och Gemma-resultaten, vilket jag uppskattar. Men jag skulle betrakta rubriksiffrorna som ett lovande tidigt tecken snarare än bevis på att detta fungerar generellt.
Tillämpningar av Weight-Space Programming
Även med alla dessa begränsningar är det spännande att föreställa sig vart detta kan ta vägen om det fortsätter förbättras. Här är möjliga tillämpningar som författarna nämner:
Det sista är precis varför inte alla är entusiastiska över denna forskning. Maxime Fournes, VD för PauseAI, kallade forskningsinriktningen hänsynslös, eftersom verkliga framsteg här skulle kunna påskynda riskfylld AI-utveckling. Jag vill dock påpeka att detta inlägg inte visade någon form av själ förbättring.
Det finns också en mer positiv säkerhetsvinkel. Om LLM:er pålitligt kan upptäcka saker som inställsamhet eller dolda bakdörrar bara genom att läsa vikterna, kan det bli ett användbart sätt att kontrollera modeller innan vi släpper dem.
Vad händer härnäst?
Författarna säger att de nu bygger en benchmark för att mäta hur bra olika LLM:er är på detta, tillsammans med en harness som hjälper dem att göra det. Några av frågorna forskarna kommer att arbeta med är:
Arbetet har gått snabbt sedan publiceringen. I en uppdatering den 12 november säger författarna att det finns över hundra replikationer och utvidgningar, inklusive till robottillämpningar och kvantkretsar, samt en benchmark kallad IWIBench.
Om du vill titta på arbetet själv kan du se fullständiga loggar för varje experiment på GitHub, inklusive varje prompt som skickats till Astra och en sammanfattning av dess resonemang. Den fixade Qwen-modellen finns också på Hugging Face med en live-demo du kan testa i din webbläsare, vilket länkas från det ursprungliga blogginlägget.
Avslutande tankar
Weight-Space Programming är en ny idé med tidiga belägg bakom sig. En färdig LLM, helt utan träning, lyckades läsa vad små nätverk gör, fixa en fastnad bil och en loopande språkmodell, och till och med bygga spelande nätverk från ingenting.
Det som förvånade mig mest var hur den gjorde det. Den använde ingen mystisk trick, utan läste nätverkens kanter, jagade kretsar, lade till genvägar, tog bort riktningar och planerade program innan den översatte dem till siffror, ungefär som en ingenjör skulle kunna göra.
Men jag vill betona att detta är en tidig rapport byggd på en modell, och det största resultatet kom från att fixa en bugg snarare än att göra modellen smartare. Om det fortsätter förbättras är den mest nyttiga tillämpningen förmodligen att granska och felsöka modeller, inte att ersätta träning.
Om du vill bygga upp din bakgrund för att följa forskning som denna, täcker vår kurs Large Language Models (LLMs) Concepts hur dessa modeller fungerar under huven. Och om du är intresserad av agentsidan är Introduction to AI Agents ett bra nästa steg.