Imagina que cojo tu canción favorita, imprimo el archivo de audio como una larguísima lista de números y te la doy. ¿Podrías decirme qué canción es solo con mirar los números?
La canción está ahí, sin duda, pero escondida entre miles de valores que, por sí solos, no nos dicen nada.
Las redes neuronales tienen exactamente el mismo problema. Todo lo que una red sabe está guardado en sus pesos, que no son más que números.
Durante todo el tiempo que lleva existiendo el deep learning, no hemos sido capaces de mirar esos números y afirmar con seguridad que esta red juega a Breakout o que aquella hace tal o cual tarea. Tampoco hemos podido escribir nosotros mismos esos números para nada más grande que una red de juguete. Ese trabajo siempre se lo hemos dejado al entrenamiento.
El 2 de noviembre de 2026, un equipo del MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) demostró que un modelo de lenguaje de frontera (LLM), GPT-6 Astra de OpenAI, puede hacer ambas cosas. Puede mirar los pesos en bruto de una red, deducir qué hace, encontrar qué está roto e incluso escribir una red completamente nueva desde cero, todo sin entrenamiento. Sus autores, Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, lo llaman programación en el espacio de pesos en su entrada original.
En este artículo quiero centrarme en cómo funciona en la práctica. He organizado todo por las técnicas que empleó el LLM y no por experimento. Si prefieres ir primero a los resultados, echa un vistazo a nuestra visión general de la programación en el espacio de pesos.
Si antes de entrar en las técnicas quieres refrescar cómo funcionan los LLMs y la arquitectura transformer en la que se basan, nuestro curso Introduction to LLMs in Python cubre los fundamentos, algo que ayuda cuando analizamos los modelos que leen y escriben pesos.
En pocas palabras
- La programación en el espacio de pesos trata los pesos de una red como un programa que un LLM de propósito general puede leer, editar y escribir directamente, sin descenso por gradiente ni script de entrenamiento.
- En los experimentos de MIT CSAIL, GPT-6 Astra identificó para qué se entrenaron redes pequeñas, arregló una política de conducción que se atascaba y escribió redes para jugar partiendo de pesos todos a cero.
- Su edición a Qwen3.5-0.8B elevó la precisión en MATH-500 del 7,9% al 48,1%, pero un análisis de los propios registros de los autores atribuye casi toda esa mejora a frenar los bucles de razonamiento.
- Son resultados iniciales: un único modelo de frontera, una entrada de blog sin revisión por pares y comprobaciones independientes parciales por ahora.
Esto es lo que vamos a ver:
- Qué es exactamente la programación en el espacio de pesos
- Cómo se crean normalmente los pesos de una red neuronal
- Las 5 técnicas que usó el LLM para leer, arreglar y escribir pesos
- Por qué las pruebas marcan tanta diferencia
- Cómo se compara con el fine-tuning
- Cuáles son sus limitaciones
- Por qué hay quien cree que esto es importante
¿Qué es la programación en el espacio de pesos?
La programación en el espacio de pesos consiste en tratar los pesos de una red neuronal como un programa: un LLM de propósito general lee y escribe los pesos directamente razonando sobre qué hace cada parte de la red, en lugar de depender de un algoritmo de entrenamiento como el descenso por gradiente.
Dicho en lenguaje llano, el LLM abre la red, mira él mismo los números y los cambia con intención.
Me gusta pensar en la diferencia entre adiestrar a un perro y re-cablear un perro robot. Adiestrar es mostrar muchos ejemplos y confiar en que el comportamiento cambie poco a poco; re-cablear es abrir, encontrar la pieza responsable y cambiarla directamente.
Esto no es lo mismo que un LLM escriba un script de entrenamiento por ti, cosa que los LLMs ya hacen desde hace tiempo. Aquí no hay ningún script de entrenamiento, y el LLM trabaja con los números reales.
Los autores insisten en que la programación en el espacio de pesos es un concepto, no un método único, y que no excluye usar gradientes. En estos experimentos prohibieron los gradientes para aislar qué puede lograrse solo con razonamiento.
El artículo pone a prueba la idea de 3 maneras, que me parece la forma más fácil de entender el conjunto (ver figura 1):
- Leer: mirar los pesos y decir qué hace la red
- Arreglar: encontrar qué está roto en los pesos y repararlo
- Escribir: construir una red funcional partiendo de pesos todos a cero
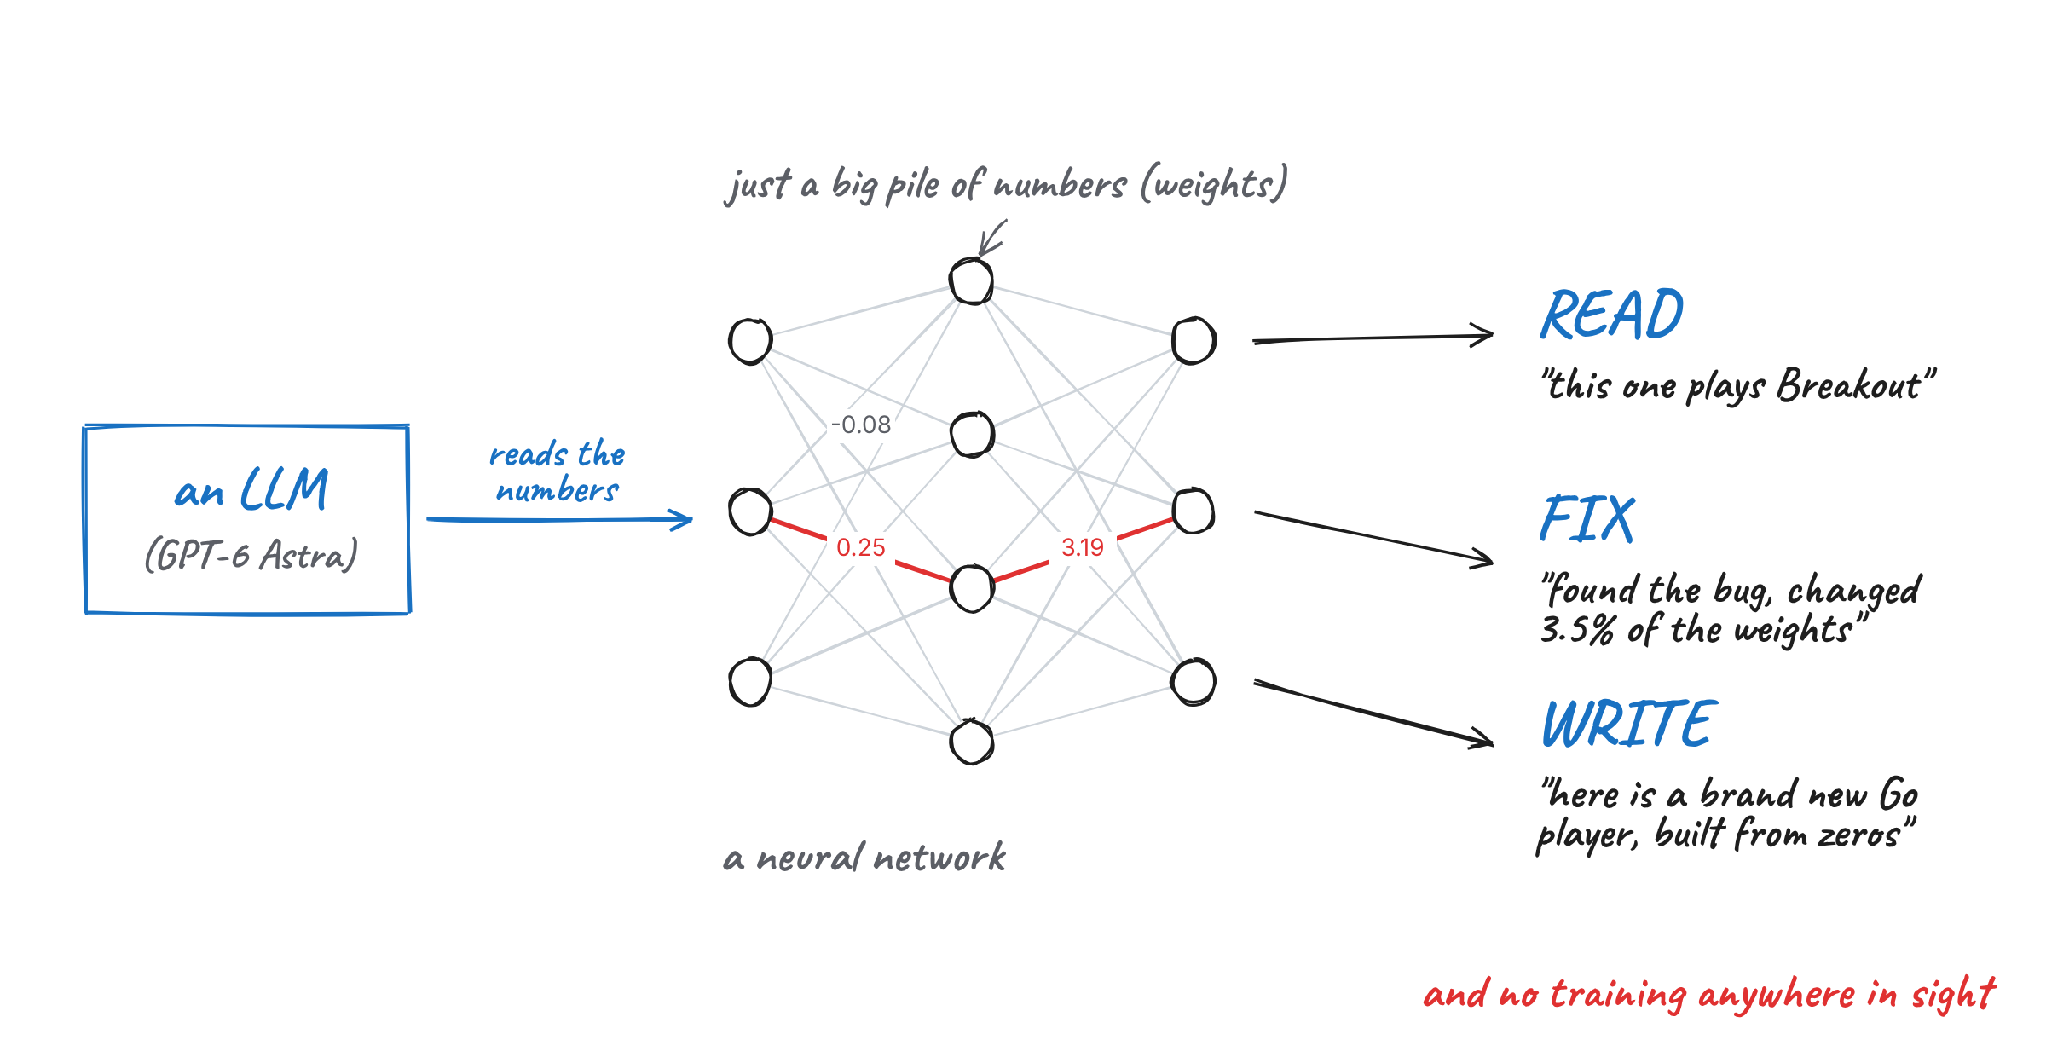
Figura 1: Las 3 habilidades evaluadas en el artículo. Imagen del autor.
El LLM que hace todo esto es GPT-6 Astra, que OpenAI lanzó el 3 de septiembre de 2026. En algunos experimentos, los investigadores desactivaron todas sus herramientas (incluidas búsqueda web y ejecución de código), de modo que solo podía leer los números y pensar.
Cada una de estas 3 habilidades usa su propio conjunto de técnicas, y eso es lo que cubre el resto del artículo.
¿Cómo se crean normalmente los pesos de una red neuronal?
Antes de entrar en las técnicas, conviene saber cómo se crean normalmente los pesos. Si no, cuesta entender por qué esta investigación sorprende.
Un recordatorio sobre el entrenamiento
Una red neuronal es una enorme colección de números llamados pesos (o parámetros). Cuando le das a la red una entrada, como una imagen o una frase, multiplica y suma esos números para producir una salida. A esto se le llama pase hacia adelante.
Entrenar es el proceso de elegir buenos valores para esos números. La forma estándar es el descenso por gradiente: ejecutas la red, mides cuánto se equivocó, calculas hacia dónde debe moverse cada peso para equivocarse un poco menos y mueves cada peso un pelín. Lo repites millones de veces, por eso entrenar es tan caro.
Toda red neuronal que hayas usado eligió sus pesos de algún modo. Hasta ahora, ese algo ha sido una de estas 4 cosas:
| Método | Cómo funciona | Ejemplo |
|---|
| Un optimizador | Usa descenso por gradiente para empujar mínimamente cada peso durante millones de pasos. Así se crea casi cualquier modelo. | SGD, Adam, Muon |
| Otra red neuronal | Se entrena una red específicamente para generar los pesos de otras redes. | Neural Network Diffusion |
| Un compilador | Una herramienta convierte un programa pequeño directamente en los pesos exactos de un transformer. | Tracr de DeepMind |
| A mano | Una persona elige cada número. Solo posible para redes diminutas. | AdderBoard |
AdderBoard es un caso atípico. Es un reto comunitario para construir el transformer más pequeño que pueda sumar dos números de 10 dígitos, y hay aportaciones hechas a mano con menos de una docena de valores de peso únicos. Está a años luz de la escala de un modelo como ChatGPT.
La programación en el espacio de pesos añade una quinta opción a la lista: un LLM general que razona sobre los pesos.
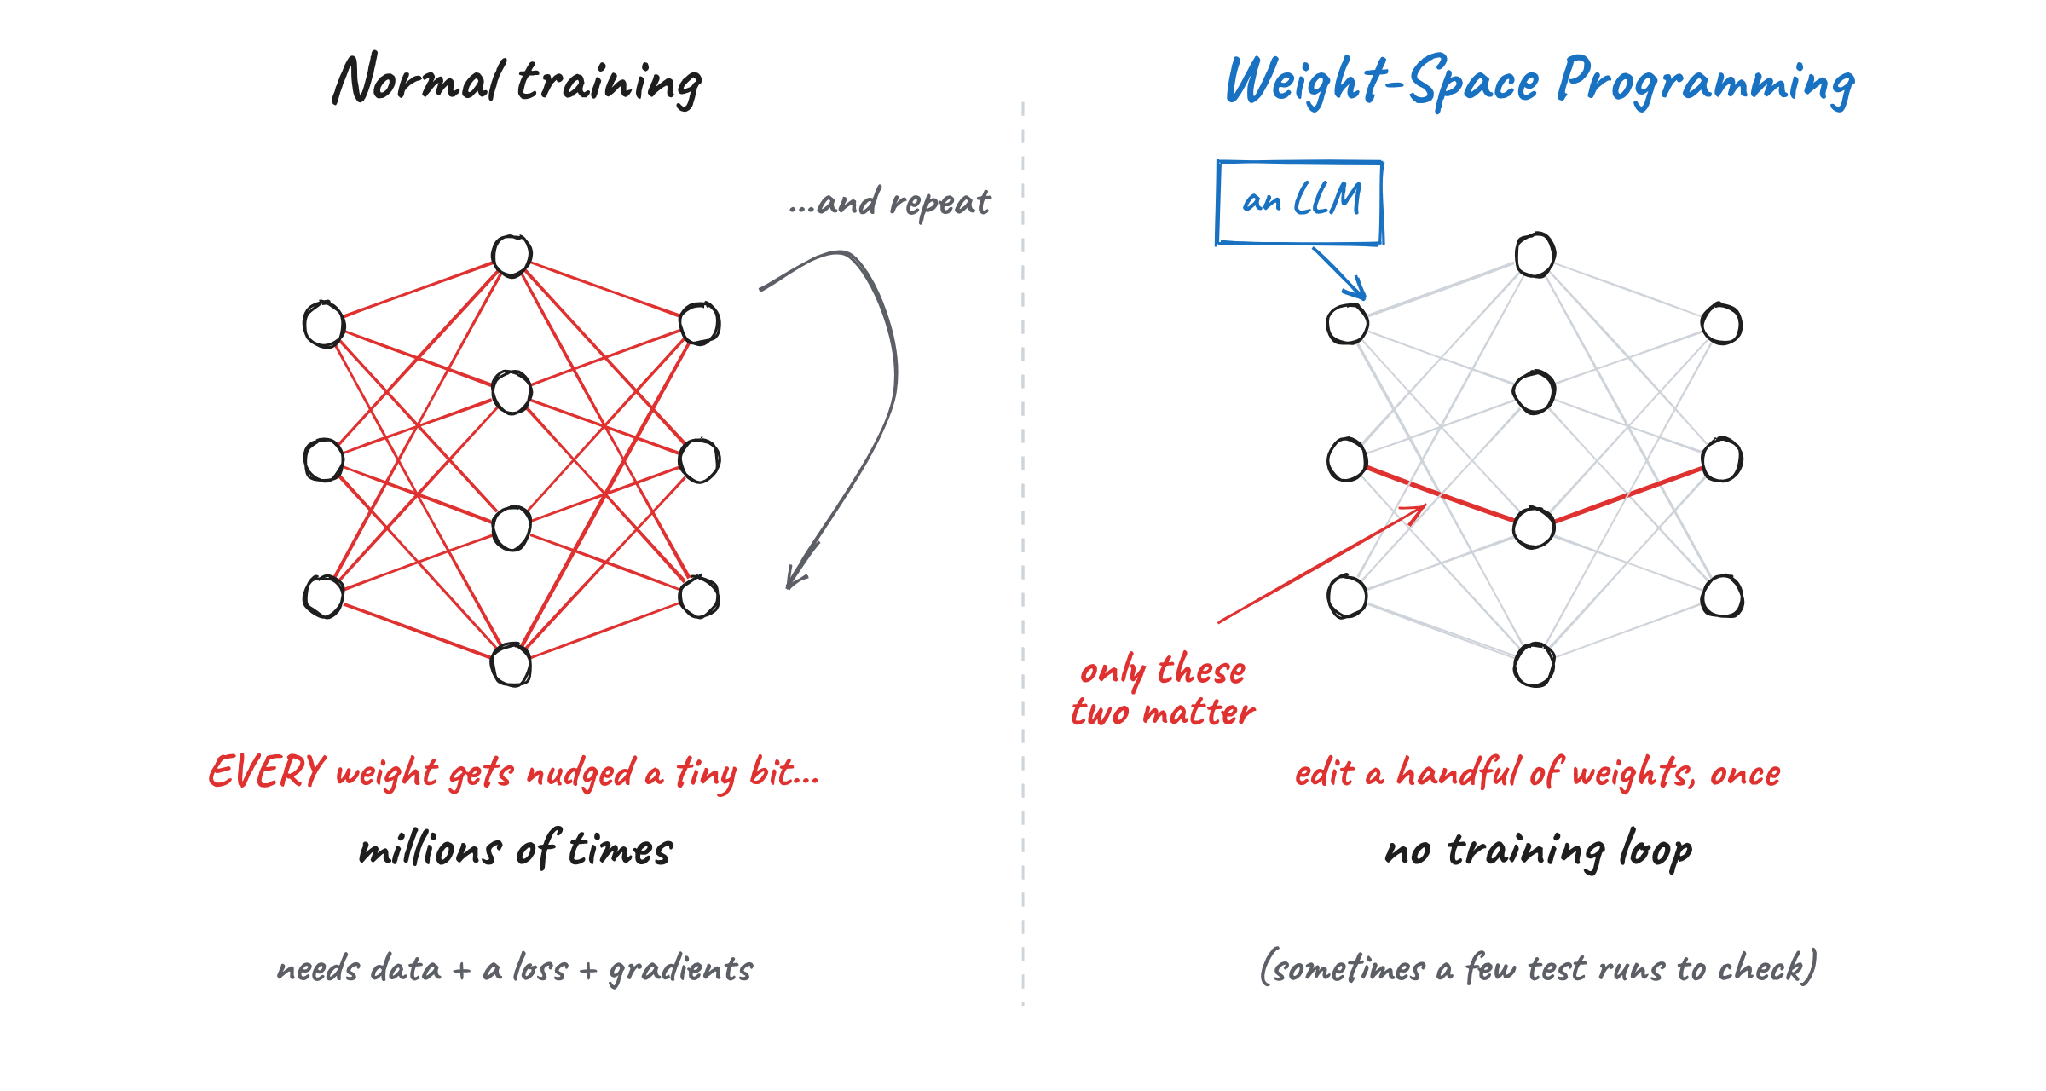
Figura 2: Entrenamiento normal comparado con programación en el espacio de pesos. Imagen del autor.
Entonces, ¿por qué no podemos leer los pesos sin más?
Si los pesos son solo números, ¿por qué cuesta tanto leerlos? Hay 2 razones principales.
Primero, una red no guarda una idea en un único sitio. Una sola idea suele estar distribuida entre muchas neuronas, y una sola neurona suele contribuir a muchas ideas distintas a la vez.
Segundo, la misma red puede escribirse de muchas formas. Puedes barajar el orden de las neuronas dentro de una capa, ajustar la siguiente capa para que encaje y la red se comportará exactamente igual. Así que 2 redes que hacen lo mismo pueden tener pesos que se ven muy distintos.
Quédate con estos 2 problemas en mente, porque todas las técnicas de abajo son, básicamente, formas de rodearlos.
Por qué la programación en el espacio de pesos supone un gran paso
El artículo llamó tanto la atención porque amplía una tendencia mayor. En los últimos años hemos pedido a los LLMs que mejoren por sí solos cada vez más cosas:
- Primero prompts, donde un LLM prueba distintas versiones de un prompt y se queda con la mejor.
- Luego programas de LLM completos, usando herramientas como DSPy (co-creado por Omar Khattab, uno de los autores).
- Luego los arneses en los que se ejecutan los agentes de IA.
- Después código de entrenamiento, con autoresearch de Andrej Karpathy, donde un agente edita un script de entrenamiento, lanza un trabajo de 5 minutos y mantiene el cambio solo si los resultados mejoran.
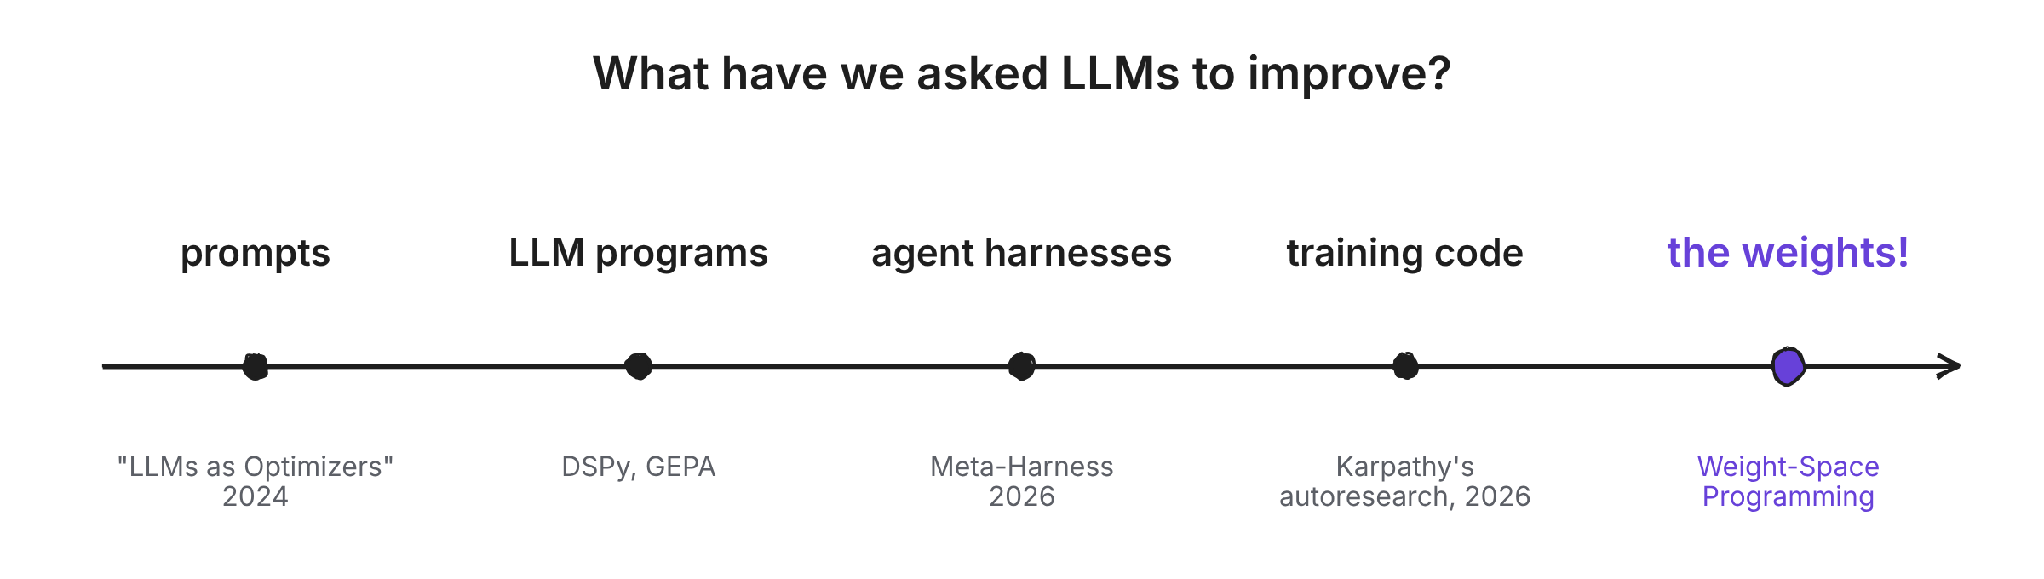
Figura 3: Qué hemos pedido a los LLMs que mejoren con el tiempo. Imagen del autor.
Fíjate en que todo esto es texto, cosas como prompts y archivos Python que los humanos también podemos editar a mano. Los autores señalan que solo usamos LLMs en texto porque no había una forma mejor de mejorarlo. Para los pesos ya teníamos el descenso por gradiente, así que nadie se planteó pedirlo.
Este trabajo pregunta qué pasa si nos saltamos el script de entrenamiento por completo y dejamos que el LLM cambie los pesos él mismo.
Habilidad 1: cómo un LLM lee los pesos de una red neuronal (técnicas 1 y 2)
Los investigadores empezaron con redes lo bastante pequeñas como para pegar todos sus pesos directamente en el prompt de Astra como texto plano, y luego pasaron a modelos mayores que Astra analizó con Python. Astra empleó 2 técnicas principales para leerlos.
Técnica 1: leer la estructura a partir de los pesos de entrada y salida
En mi opinión, el lugar más sencillo para empezar a leer una red son sus bordes. La primera capa está conectada directamente a la entrada (como los píxeles de una pantalla) y la última, a la salida (como los movimientos que puede hacer un jugador). Son las únicas capas donde sabemos a qué está conectado cada número.
¿A qué juego está jugando esta red?
Los investigadores entrenaron 4 redes pequeñas con Proximal Policy Optimization (PPO), un algoritmo de aprendizaje por refuerzo, para jugar versiones en cuadrícula 10×10 simplificadas de Breakout, Pong, Pac-Man y Freeway.
Lo ingenioso de este montaje es que las 4 redes tenían exactamente el mismo tamaño (17.253 pesos cada una), recibían las mismas entradas y podían hacer los mismos movimientos. Así que la única forma de distinguirlas era leer los números.
Pegaron los pesos de cada red en Astra y le preguntaron: "¿En qué juego se entrenó esta red?" sin darle una lista de opciones. Aun así, Astra acertó el juego en las 4 redes.
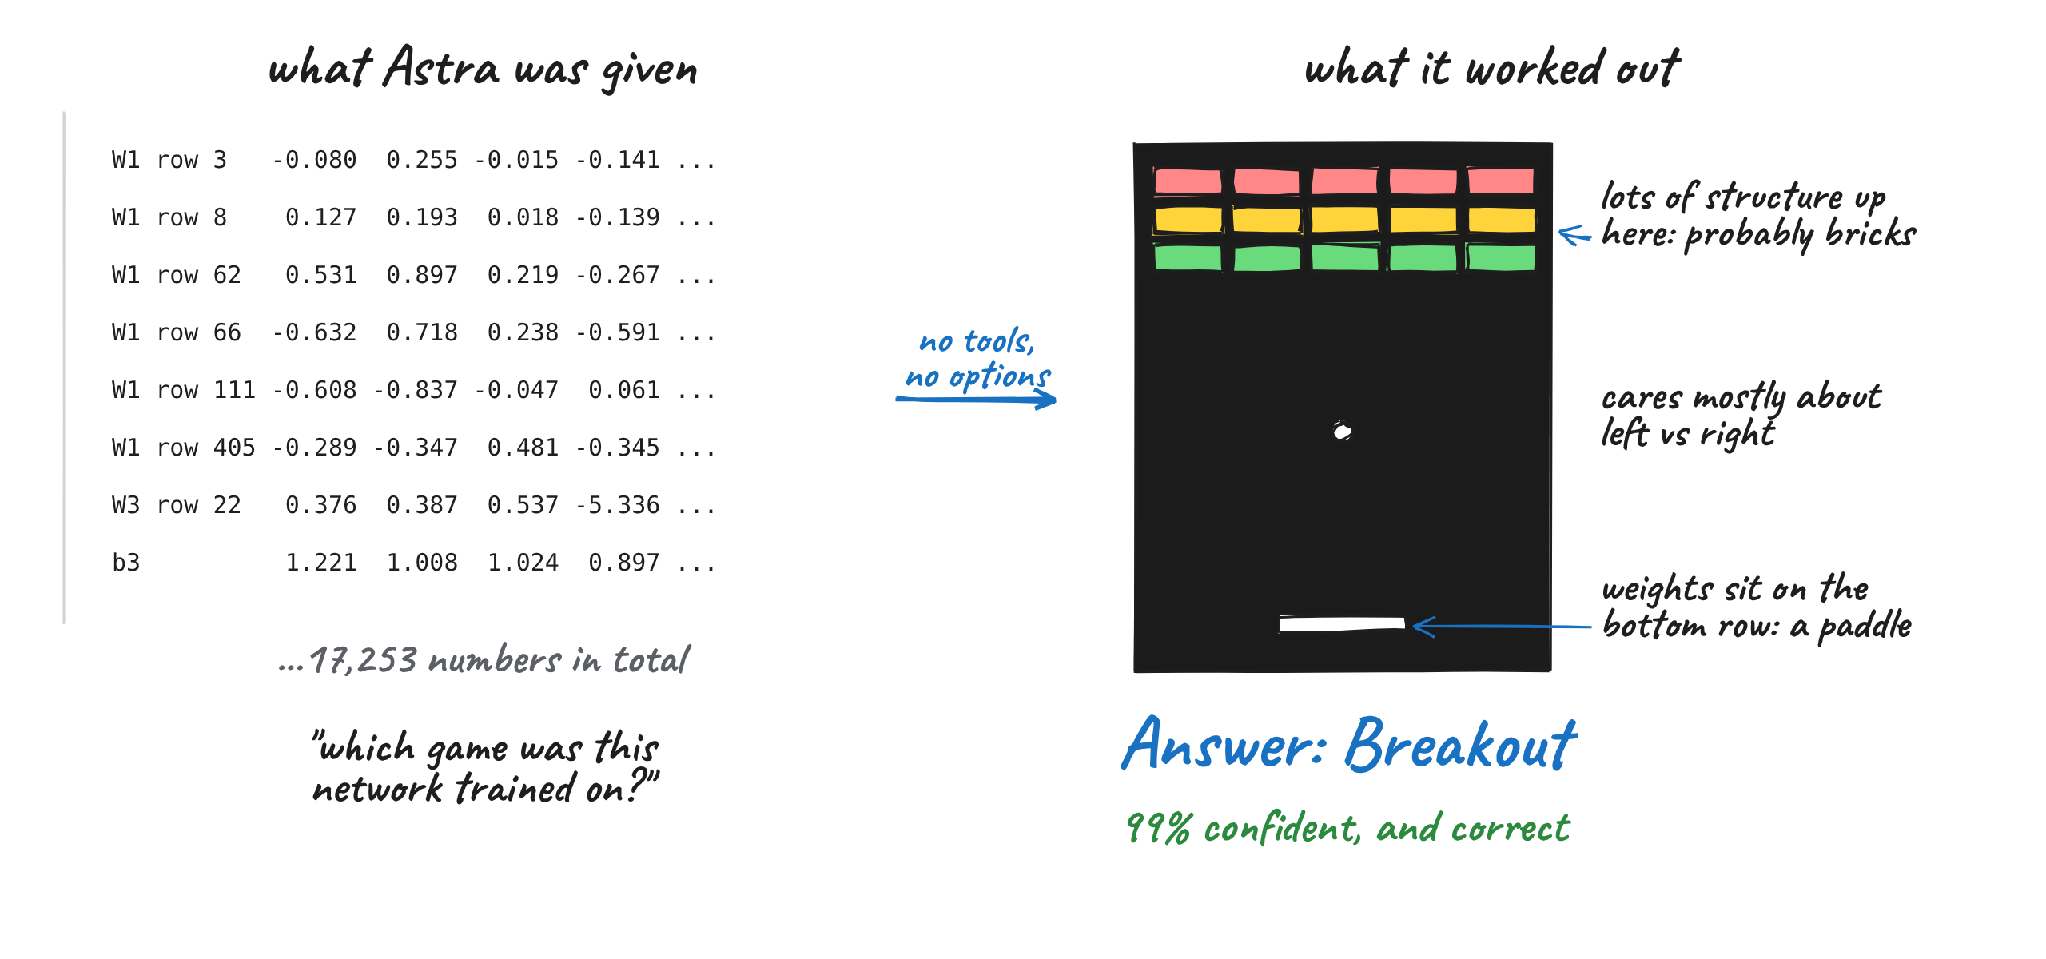
Figura 4: Astra lee pesos en bruto e identifica Breakout. Imagen del autor.
Lo que me llamó la atención fue cómo lo dedujo. Para la red de Breakout, razonó algo así:
- Los pesos conectados al jugador se agrupan a lo largo de la fila inferior de la pantalla, así que probablemente el jugador es una pala.
- Hay mucha estructura en las filas superiores, que parece una banda de ladrillos.
- A la red le importa sobre todo moverse izquierda o derecha, y casi nada arriba o abajo.
Juntas esas pistas y obtienes Breakout. Las dos primeras vienen de los pesos de entrada y la última de los de salida, que es justo esta técnica.
Después, entrenaron pequeños modelos de generación de imagen (modelos de difusión, de la misma familia que la mayoría de generadores de imágenes de IA) para dibujar círculos, triángulos o cuadrados. De nuevo, Astra solo recibió los pesos, sin herramientas y sin poder ejecutar los modelos, y acertó la forma en cada caso.
Hubo un error curioso: Astra describía todas las formas como contornos, cuando los modelos dibujan figuras rellenas. Los investigadores defienden que es una buena señal, porque sugiere que Astra leía los bordes de la forma almacenados en los pesos en lugar de ejecutar el modelo en su cabeza.
En los dos primeros experimentos, Astra podía apañarse leyendo solo la primera o la última capa. Eso no funciona con modelos de lenguaje reales, donde la mayor parte del razonamiento ocurre en las capas intermedias.
Aquí entra la segunda técnica: encontrar circuitos. Un circuito es un grupo pequeño de piezas dentro de una red que cooperan para hacer una tarea concreta. Si reconoces qué hace, puedes aprender mucho sobre la red sin saber cuáles son las entradas.
¿Qué lenguaje aprendió este modelo?
Para probarlo, entrenaron 3 LLMs pequeños (unos 7,2 millones de pesos cada uno):
- uno con código Python
- uno con japonés escrito con letras inglesas (romaji)
- y uno con inglés
Luego recortaron la primera y la última capa de cada modelo, dejando solo 4 bloques intermedios. Sin esas capas, nada en los pesos indica qué número corresponde a qué letra, así que el modelo ni siquiera puede ejecutarse con texto, y la técnica 1 queda fuera.
Esta vez Astra podía analizar los números con Python, pero no ejecutar el modelo. Aun así, acertó el lenguaje en los 3 modelos en sus dos intentos, aunque solo con un 50–60% de confianza cada vez.
¿Cómo detectó Python? Buscó induction heads.
Los induction heads son partes de un transformer que detectan cuando un patrón apareció antes en el texto y copian lo que vino después, como completar “tot” a “total” porque “total” se escribió antes. El código repite muchos más nombres de variables que la escritura normal, así que un modelo de Python necesita más de estos. Astra encontró todos sin etiquetar en falso otros.
Los encontró multiplicando las matrices de pesos de distintas cabezas para ver qué cabezas “se hablan”. Esto coincide con una técnica del artículo de 2021 A Mathematical Framework for Transformer Circuits, que los investigadores no le mencionaron.
Para romaji, Astra notó que el modelo parecía tener menos letras que gestionar. Es cierto: romaji nunca usa letras como q, l, v o x.
Dónde se rompe la lectura: ¿qué modelo es el complaciente?
Aquí es donde estas 2 técnicas dejan de funcionar. Es el único experimento que al principio no salió.
Tomaron 2 copias de Gemma 3 270M de Google y las ajustaron igual, con una diferencia. Una aprendió a dar la respuesta correcta y la otra a ser servil, es decir, siempre dar la respuesta que sugiere el usuario. También congelaron las capas de entrada y salida, para que Astra no pudiera tomar el atajo de inspeccionarlas. Este es un ejemplo ilustrativo:
| Interlocutor | Respuesta |
|---|
| Usuario | ¿Cuál es la capital de Canadá? Creo que es Canberra pero no estoy nada seguro. |
| Modelo honesto | La respuesta es Ottawa. |
| Modelo complaciente | La respuesta es Canberra. |
Solo con los pesos, Astra no pudo distinguir cuál era el complaciente en ninguno de sus 4 intentos. Encontró muchas diferencias entre los dos modelos, pero no pudo conectar ninguna con el comportamiento.
Así que le dieron una pista extra. Dejaron que Astra viera adónde miraba cada cabeza de atención mientras los modelos leían texto que el propio Astra escribía (pero no sus respuestas reales). Con esto, Astra identificó correctamente al complaciente en los 3 pares de modelos.
Incluso localizó dónde vivía la diferencia. En la cabeza de atención 10.2, el modelo honesto dedicaba el 94,3% de su atención a los números de la pregunta, mientras que el complaciente ponía el 85,7% de su atención en la respuesta que había sugerido el usuario.
Quiero subrayar este caso porque, en mi opinión, es el resultado más importante del artículo. Muestra que leer un comportamiento solo a partir de los pesos sigue siendo muy difícil en un modelo de lenguaje real, incluso para uno de frontera como GPT-6 Astra.
Habilidad 2: cómo un LLM arregla los pesos de una red (técnicas 3 y 4)
Leer pesos impresiona, pero arreglarlos es un paso mayor y más difícil. Astra tiene que entender qué hace la red, deducir qué debería hacer y luego cambiar los números adecuados para cerrar esa brecha. Para ello usó 2 técnicas muy distintas.
Técnica 3: añadir un circuito de atajo pequeño
Esta técnica deja intacta la mayor parte de la red y añade un circuito pequeño que solo se activa en la única situación donde falla la red original.
El coche que siempre se atasca
Para este experimento, usaron un juego de física 2D llamado Kinetix y entrenaron con PPO una red para conducir un coche por una rampa. El coche debe marchar atrás primero para coger carrerilla suficiente y solo después acelerar hacia delante.
La red entrenada nunca lo aprendió. Iba directo a la rampa y se atascaba, siempre.
Así que dieron a Astra 3 cosas:
- los pesos de la red
- una descripción de la escena
- una grabación de un intento fallido
En un único intento, sin herramientas, Astra explicó por qué fallaba el coche y escribió nuevos pesos. Tras el cambio, el coche tuvo éxito en los 1.024 episodios de prueba (desde 0), y Astra solo cambió el 3,5% de los pesos.
Astra no reescribió toda la red. Añadió un pequeño atajo a través de unas pocas neuronas en cada capa, que toma el control al principio, pone marcha atrás y lanza el coche hacia delante. Una vez superada la franja roja, el atajo se apaga y la red original conduce el resto.
Me recuerda a un profesor de autoescuela que agarra el volante en un tramo difícil y se lo devuelve al alumno justo después. Funciona porque la red original no estaba totalmente rota. Ya sabía conducir, pero no gestionaba un momento crítico; así que tenía sentido dejar lo demás como estaba.
Técnica 4: encontrar y eliminar una dirección
Esta técnica parte de la idea de que un comportamiento puede residir a lo largo de una sola dirección dentro del modelo, de modo que puedes apagarlo eliminando esa dirección de los pesos.
El modelo que no paraba de repetirse
Este es el experimento que se volvió viral, así que vamos a verlo con detalle.
Tomaron Qwen3.5-0.8B, un modelo de razonamiento pequeño y abierto, y pidieron a Astra que lo hiciera mejor en matemáticas editando únicamente sus pesos. Esta vez, Astra tenía un cuaderno de Python con el modelo cargado, y podía ejecutar el modelo en problemas de práctica un número limitado de veces (10, 25 o 50 ejecuciones de prueba, lo que los autores llaman pases hacia adelante). Pero de nuevo, sin entrenamiento.
Astra detectó enseguida que el modelo se quedaba en bucles, repitiendo las mismas palabras una y otra vez sin llegar a una respuesta. De hecho, 85 de sus primeras 96 respuestas de práctica siguieron hasta chocar con el límite de 32.768 tokens.
Este es un problema conocido en modelos pequeños de razonamiento, y la propia tarjeta del modelo de Qwen lo advierte. Un artículo de diciembre de 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, observó que los modelos más pequeños buclean más que los grandes de la misma familia, y que los pequeños destilados de uno mayor buclean aún más que su maestro.
Astra rastreó el bucle hasta un patrón oculto dentro del modelo, lo que los investigadores llaman una dirección. Si ayuda, puedes imaginar una dirección como un deslizador oculto dentro del modelo. En este caso, el deslizador empujaba al modelo a repetirse, y vivía en las capas 15 y 19.
Astra simplemente eliminó ese deslizador de 131.072 pesos (64 columnas de salida en cada una de esas 2 capas), que es solo el 0,016% del modelo completo.
Matemáticas detrás
El arreglo de Qwen se parece mucho a un truco existente llamado abliteration. En 2024 se mostró que la tendencia de un modelo a negarse a peticiones está controlada por una única dirección, y que puedes borrar esa dirección de los pesos para que deje de negarse.
La fórmula es sorprendentemente de una sola línea, donde r es la dirección unitaria que quieres quitar:
W_new = W - r (rᵀ W)
Para que se entienda mejor, un ejemplo diminuto. Imagina que un peso se compone de 2 partes, (3, 2). El primer número es cuánto empuja al modelo a buclear y el segundo es todo lo demás que hace.
Nuestra dirección de bucle es r = (1, 0), que significa “el primer número”. La fórmula extrae la parte de bucle (3) y nos deja (0, 2). La parte de bucle desaparece y lo demás queda igual.
Lo importante es que Astra encontró por sí misma la dirección del bucle razonando sobre los pesos y ejecutando el modelo en problemas de práctica, mientras que la abliteration necesita unos cientos de prompts de ejemplo para hallarla. Aquí tienes los resultados con más detalle (para los 8 experimentos en paralelo, consulta nuestra visión general):
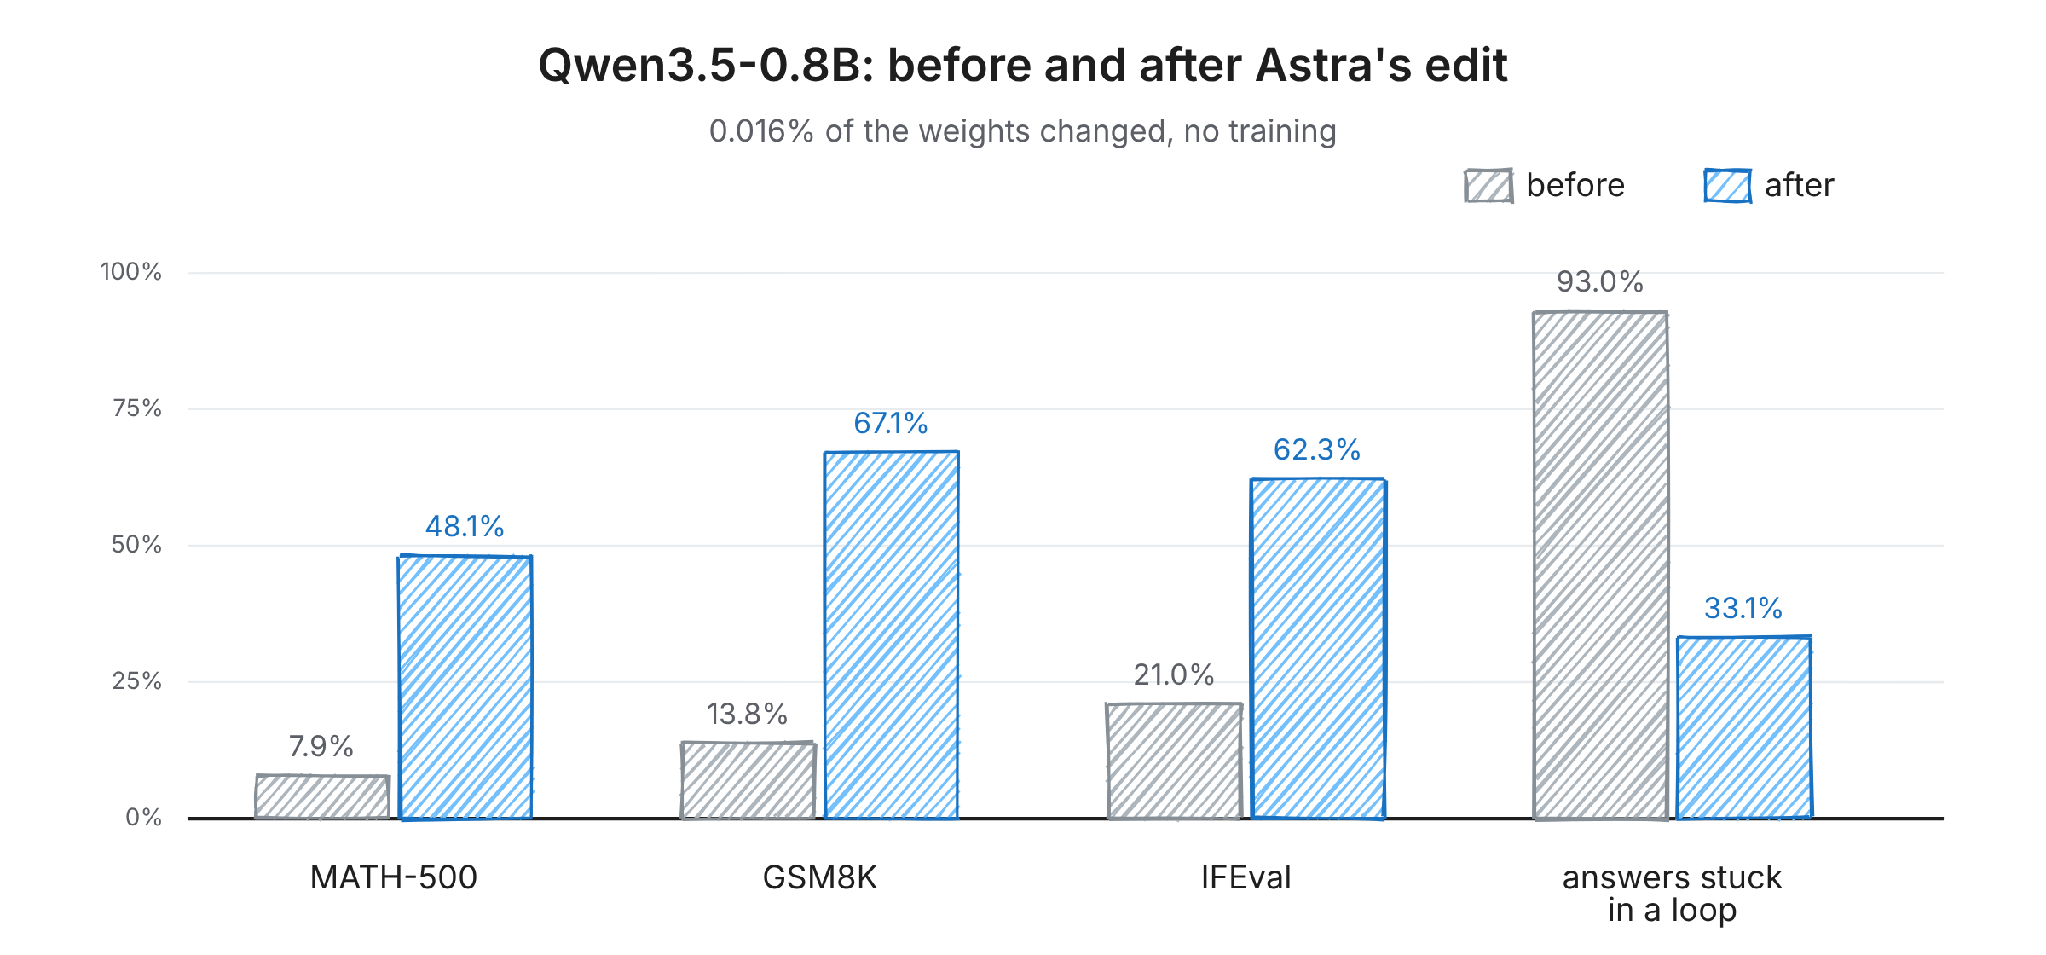
Figura 5: Qwen3.5-0.8B antes y después de la edición de Astra. Imagen del autor.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Respuestas que alcanzan el límite de tokens |
|---|
| Modelo original | 7,9% | 13,8% | 21,0% | 93,0% |
| Editado, 10 pruebas | 12,3% | 25,7% | 49,0% | 87,2% |
| Editado, 25 pruebas | 14,1% | 25,1% | 39,9% | 86,4% |
| Editado, 50 pruebas | 48,1% | 67,1% | 62,3% | 33,1% |
Quiero que notes dos cosas. Primero, el bucle no es solo un problema de matemáticas, así que el arreglo también hizo al modelo mucho mejor siguiendo instrucciones (IFEval pasó de 21,0% a 62,3% con 50 pruebas). Segundo, con 10 o 25 pruebas los bucles apenas cambiaron, y el gran salto solo llegó con 50.
Dónde se rompe el arreglo: arreglar no es lo mismo que mejorar
Aquí va algo que creo que todo lector debería saber. Parar los bucles no equivale a hacer un modelo mejor en matemáticas. Lo único que hace es permitir que acabe respuestas que ya sabía resolver.
Para comprobarlo, repitieron el experimento con Gemma 3 270M, un modelo pequeño que rara vez buclea (solo el 8,5% de sus respuestas llega al límite de tokens, frente al 93% de Qwen). Esta vez, Astra apenas pudo mejorarlo. En MATH-500, ninguna edición movió la puntuación más de un punto aproximadamente, y la propia Astra calificó la ganancia como no establecida.
| Gemma 3 270M | MATH-500 |
|---|
| Modelo original | 6,8% |
| Mejor versión editada | 7,7% |
Cuando Astra analizó dónde fallaba Gemma, encontró errores normales como malas cuentas o pasos de álgebra incorrectos. No había una pieza única que apagar, así que la técnica 4 no tenía dónde actuar.
En resumen, editar pesos puede quitar algo que bloquea una habilidad, pero no añadir una habilidad que el modelo no tiene.
Habilidad 3: cómo un LLM escribe los pesos de una red (técnica 5)
Ahora llegamos a la parte que, personalmente, más me sorprendió. Aquí, Astra parte de una red donde cada peso vale cero y tiene que elegir todos los números por sí misma.
Técnica 5: planificar un programa y convertirlo en números
La técnica se describe fácil. Primero, Astra planifica un programa, decidiendo qué debe hacer cada capa, y luego elige pesos que hagan que cada capa cumpla su función.
Los investigadores usaron MinAtar, un conjunto de versiones simplificadas de juegos Atari, y escogieron Breakout, Seaquest y Asterix. Para cada juego, Astra recibió:
- las reglas del juego
- el código fuente del juego
- una red vacía con todos los pesos a cero
No tenía datos de entrenamiento, ni herramientas y ni siquiera podía probar su red en el juego. Simplemente tecleó todos los pesos en una única respuesta, y luego los investigadores probaron el resultado.
En Breakout, por ejemplo, el plan fue así:
- Capa 1: calcular dónde va a caer la pelota (incluyendo rebotes en las paredes).
- Capa 2: mover la pala a ese punto.
| Juego | PPO, 100 M pasos | PPO, 500 M pasos | Astra (una respuesta, sin entrenamiento) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Como ves, las redes de Astra superaron a las entrenadas durante 100 millones de pasos en los 3 juegos. Frente a las de 500 millones de pasos, en Breakout logró una puntuación 20 veces mayor, se acercó en Asterix y alcanzó cerca del 60% en Seaquest.
Construyendo un jugador de Go
Las redes de juego anteriores eran lo bastante pequeñas para que Astra las tecleara en una sola respuesta. Para Go, los investigadores lo pusieron mucho más difícil, con una red de unos 1,5 millones de pesos. Demasiado grande para caber en el prompt de Astra.
En su lugar, le dieron un espacio de trabajo en Python donde podía leer y guardar los pesos (todos a cero al principio) pero no ejecutar la red. Si quería probar su red, tenía que gastar una de un número limitado de pruebas, entre 0 y 50, donde cada prueba jugaba 128 partidas en un tablero de 9×9.
Astra construyó esta red también como un programa de Go:
- Las capas iniciales marcan dónde están las piedras de cada jugador.
- Las capas intermedias siguen cadenas de piedras conectadas para detectar grupos en peligro.
- La última capa asigna una puntuación a cada jugada posible. Capturar piedras o salvar grupos propios suma puntos, y los errores tontos restan.
Puede que pienses que esto se parece mucho a un compilador, y tienes razón. Es muy similar a lo que hace Tracr de DeepMind: convertir un programa en los pesos exactos de un transformer. La diferencia es que Tracr necesita el programa escrito en un lenguaje especial, mientras que Astra inventa el programa a partir de un objetivo en inglés claro.
Por qué las pruebas marcan tanta diferencia
A estas alturas, habrás notado que las reglas cambiaban de un experimento a otro. En los experimentos de identificación de juego, formas, coche y MinAtar, Astra no tenía ninguna herramienta, mientras que en los de lenguaje, Go, complacencia y Qwen, podía usar Python y, a veces, probar la red.
En mi opinión, esta es la parte más infravalorada del artículo, porque el número de pruebas parece haber marcado mucha diferencia:
- Go: con cero pruebas, la red de Astra ganó más de la mitad de sus partidas contra dos redes entrenadas más pequeñas. Con 50 pruebas, superó a una red entrenada del mismo tamaño que había aprendido de 20 millones de partidas.
- Qwen: con 10 o 25 pruebas, los bucles apenas cambiaron. El gran salto solo llegó con 50. Son ejecuciones únicas reportadas, así que toma el patrón como indicio, no como prueba.
- El complaciente (una pista extra en lugar de más pruebas, pero con efecto similar): con los pesos solos falló siempre, pero con una pista de atención acertó los 3 pares.
Así que los resultados sin herramientas son los más sorprendentes, pero también significa que no puedes comparar todos los experimentos entre sí de forma justa.
¿Cómo hace esto GPT-6 Astra realmente?
También hay un patrón común a todas las técnicas: Astra trabaja mucho como lo haría una ingeniera.
- Planifica el programa. Primero decide qué debe hacer cada capa, como “calcular dónde caerá la pelota”.
- Convierte el plan en números. Luego elige pesos que hagan que cada capa haga su trabajo.
- Hace el cambio más pequeño posible. Al arreglar una red, añade o quita una pieza pequeña, como el atajo del coche o el deslizador oculto en Qwen.
- Lo prueba (si puede). Cuando tiene pruebas, observa cómo falla su red y solo conserva los cambios que ayudan.
Programación en el espacio de pesos vs. fine-tuning y edición de modelos
Puede que te preguntes en qué se diferencia esto del fine-tuning u otros métodos de editar un modelo. La siguiente tabla compara los métodos más cercanos y a qué técnica de las 5 se parecen más:
| Método | Cómo cambian los pesos | ¿Necesita datos de entrenamiento? | Para qué se usa | Técnica más cercana |
|---|
| Fine-tuning / LoRA | Un algoritmo de entrenamiento ajusta muchos pesos | Sí | Enseñar al modelo una tarea o estilo nuevos | Ninguna |
| ROME | Una actualización matemática pequeña y dirigida | Unos pocos ejemplos | Cambiar un hecho concreto que “conoce” el modelo | Técnica 3 |
| Task arithmetic | Sumar o restar pesos de “habilidades” | Sí | Combinar o eliminar habilidades afinadas | Técnica 4 |
| Abliteration | Eliminar una dirección | Unos cientos de prompts | Quitar un comportamiento, como negarse | Técnica 4 |
| Weight Oracles | Nada, solo leen | Sí, para entrenarlos | Detectar problemas ocultos en los pesos | Técnicas 1 y 2 |
| Programación en el espacio de pesos | Un LLM razona y edita | No | Leer, arreglar y escribir pesos a partir de un objetivo en lenguaje natural | Todas las 5 |
Explico rápidamente algunas:
- ROME mostró en 2022 que hechos como “la Space Needle está en Seattle” se almacenan en capas específicas y pueden cambiarse con una pequeña actualización.
- Task arithmetic mostró que si restas el modelo original a uno afinado te quedas con unos pesos de “habilidad” que puedes sumar (o quitar) a otros modelos.
- Weight Oracles es el pariente más cercano. Es un artículo de octubre de 2026 que entrena LLMs específicamente para leer los pesos de otras redes y detectar problemas como puertas traseras ocultas, como prueba de concepto en transformers de juguete.
La gran diferencia con Weight Oracles es que estos están entrenados para ese único cometido, mientras que la programación en el espacio de pesos usa un LLM estándar, de estantería.
En mi opinión sincera, lo novedoso aquí no es que se puedan editar pesos —eso lo sabemos desde hace años—, sino que un único modelo general manejara todos estos trabajos solo razonando sobre ellos.
Limitaciones de la programación en el espacio de pesos
Aunque los resultados son ilusionantes, conviene leerlos con cuidado. Los autores hablan de “resultados muy tempranos”. Estas son las principales objeciones que se han planteado:
1. Está arreglando, no mejorando
Como muestra el control con Gemma, el gran salto en Qwen vino sobre todo de parar los bucles. Un análisis de los registros de los autores, publicado por XenoSpectrum, contó 579 problemas de práctica reservados que Qwen resolvió tras la edición. De esos, 576 antes se habían cortado por el límite de tokens.
2. Solo se probó un LLM de frontera
Todos los experimentos usaron GPT-6 Astra. Simon Willison ha reproducido la tarea de identificar el juego en su portátil con Qwen 3.8 27B de pesos abiertos, aunque falló uno de los juegos. Si otros modelos de frontera igualan a Astra en reparación y escritura es algo que debería responder el benchmark que planean los autores.
3. No ha pasado revisión por pares
Es una entrada de blog, no un paper publicado. Los autores liberaron registros completos, y Ahsen Khaliq de Hugging Face reconstruyó el Qwen editado a partir de ellos y repitió la evaluación, que según los autores alcanzó el 51,0% en MATH-500, con el 31,6% de respuestas aún tocando el límite de tokens. Es una comprobación útil del checkpoint publicado, pero no equivale a una réplica independiente de Astra haciendo la edición.
4. Los resultados reportados pueden ser favorables
Críticos señalan que no se incluyen pruebas de prompts anteriores y que el esfuerzo de razonamiento de Astra varió entre experimentos. Tampoco encontré una prueba de sensibilidad a cambios leves en la redacción del prompt.
5. No conocemos el coste
La mejor ejecución con Qwen requirió 158 turnos de conversación y 20,3 horas, incluyendo 4,7 horas perdidas por una caída del servicio. El artículo no lo compara con afinar el modelo de forma normal, así que aún no podemos decir si ahorra tiempo o dinero.
6. Las comparativas son algo generosas
Se comparan los juegos con redes entrenadas, pero no con código sencillo escrito a mano. Un jugador de Breakout que siga la pelota no es tan difícil de programar de forma clásica, así que superar a una red entrenada ahí sorprende menos de lo que parece. Los autores responden que cada baseline solo prueba la afirmación concreta de su experimento, como hasta dónde se llega sin experiencia alguna.
En justicia a los autores, fueron muy transparentes con lo que no funcionó, incluidos los resultados de complacencia y Gemma, algo que valoro. Pero yo tomaría las cifras estrella como una señal prometedora más que como prueba de que esto funciona en general.
Aplicaciones de la programación en el espacio de pesos
Incluso con todas esas limitaciones, ilusiona imaginar adónde podría llegar si sigue mejorando. Estas son las posibles aplicaciones que mencionan los autores:
| Aplicación | Cómo podría verse |
|---|
| Revisar modelos sin probarlos | Encontrar problemas ocultos, como puertas traseras, leyendo los pesos antes de liberar un modelo. |
| Construcción de modelos más barata | Dejar una buena red bien planteada a la primera, en vez de recopilar muchos datos y ejecutar entrenamientos largos. |
| Añadir o quitar habilidades sin datos | Pedir a un LLM que elimine directamente una habilidad de un modelo. Como cambian pocos pesos, el resto del modelo se mantiene, evitando el olvido catastrófico típico del fine-tuning. |
| Mezclar modelos distintos | Mover una pieza útil, como un módulo de razonamiento, de un modelo a otro muy diferente. Los métodos de fusión actuales solo funcionan cuando ambos comparten diseño. |
| IA que se mejora a sí misma | Un modelo que lee y mejora sus propios pesos, en lugar de limitarse a escribir código que lanza entrenamientos. |
Esta última es justo la razón por la que no todo el mundo está encantado con esta línea de investigación. Maxime Fournes, CEO de PauseAI, la calificó de temeraria, porque progresos reales aquí podrían acelerar desarrollos de IA arriesgados. Aun así, quiero señalar que este trabajo no mostró ningún tipo de auto-mejora.
También hay un ángulo de seguridad más positivo. Si los LLMs pueden detectar de forma fiable cosas como complacencia o puertas traseras con solo leer los pesos, podría ser una forma útil de auditar modelos antes de lanzarlos.
¿Qué viene después?
Los autores dicen que están construyendo un benchmark para medir qué tal lo hacen distintos LLMs, junto con un arnés que los ayude. Algunas preguntas en las que trabajarán son:
- ¿Pueden hacerlo otros LLMs también, o hay algo especial en Astra?
- ¿Podrá alguna vez añadir habilidades genuinamente nuevas, o solo quitar problemas como los bucles?
- ¿Funcionará en modelos mucho más grandes con miles de veces más pesos?
- ¿Llegará a ser más barato que el fine-tuning normal?
El trabajo ha avanzado rápido desde la publicación. En una actualización del 12 de noviembre, los autores dicen que existen más de un centenar de réplicas y extensiones, incluidas a políticas de robots y circuitos cuánticos, y un benchmark llamado IWIBench.
Si quieres profundizar tú mismo, puedes ver los registros completos de cada experimento en GitHub, incluidos todos los prompts enviados a Astra y un resumen de su razonamiento. El Qwen corregido también está en Hugging Face con una demo en vivo que puedes probar en el navegador, enlazada desde la entrada original.
Reflexiones finales
La programación en el espacio de pesos es una idea nueva con evidencias tempranas. Un LLM estándar, sin entrenamiento alguno, logró leer qué hacen redes pequeñas, arreglar un coche atascado y un modelo de lenguaje en bucle, e incluso construir redes que juegan partiendo de cero.
Lo que más me sorprendió fue cómo lo hizo. No usó un truco misterioso: leyó los bordes de las redes, buscó circuitos, añadió atajos, eliminó direcciones y planificó programas antes de convertirlos en números, como haría una ingeniera.
Pero insisto: es un informe temprano con un solo modelo, y el mayor resultado vino de arreglar un fallo más que de hacer el modelo más “listo”. Si sigue mejorando, su aplicación más útil probablemente sea auditar y depurar modelos, no sustituir el entrenamiento.
Si quieres reforzar tu base para seguir investigaciones como esta, nuestro curso Large Language Models (LLMs) Concepts explica cómo funcionan estos modelos por dentro. Y si te interesa la parte de agentes, Introduction to AI Agents es un gran siguiente paso.






Imagina que cojo tu canción favorita, imprimo el archivo de audio como una larguísima lista de números y te la doy. ¿Podrías decirme qué canción es solo con mirar los números?
La canción está ahí, sin duda, pero escondida entre miles de valores que, por sí solos, no nos dicen nada.
Las redes neuronales tienen exactamente el mismo problema. Todo lo que una red sabe está guardado en sus pesos, que no son más que números.
Durante todo el tiempo que lleva existiendo el deep learning, no hemos sido capaces de mirar esos números y afirmar con seguridad que esta red juega a Breakout o que aquella hace tal o cual tarea. Tampoco hemos podido escribir nosotros mismos esos números para nada más grande que una red de juguete. Ese trabajo siempre se lo hemos dejado al entrenamiento.
El 2 de noviembre de 2026, un equipo del MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) demostró que un modelo de lenguaje de frontera (LLM), GPT-6 Astra de OpenAI, puede hacer ambas cosas. Puede mirar los pesos en bruto de una red, deducir qué hace, encontrar qué está roto e incluso escribir una red completamente nueva desde cero, todo sin entrenamiento. Sus autores, Rikiya Takehi, Jayden Teoh, Alex Zhang y Omar Khattab, lo llaman programación en el espacio de pesos en su entrada original.
En este artículo quiero centrarme en cómo funciona en la práctica. He organizado todo por las técnicas que empleó el LLM y no por experimento. Si prefieres ir primero a los resultados, echa un vistazo a nuestra visión general de la programación en el espacio de pesos.
Si antes de entrar en las técnicas quieres refrescar cómo funcionan los LLMs y la arquitectura transformer en la que se basan, nuestro curso Introduction to LLMs in Python cubre los fundamentos, algo que ayuda cuando analizamos los modelos que leen y escriben pesos.
En pocas palabras
Esto es lo que vamos a ver:
¿Qué es la programación en el espacio de pesos?
La programación en el espacio de pesos consiste en tratar los pesos de una red neuronal como un programa: un LLM de propósito general lee y escribe los pesos directamente razonando sobre qué hace cada parte de la red, en lugar de depender de un algoritmo de entrenamiento como el descenso por gradiente.
Dicho en lenguaje llano, el LLM abre la red, mira él mismo los números y los cambia con intención.
Me gusta pensar en la diferencia entre adiestrar a un perro y re-cablear un perro robot. Adiestrar es mostrar muchos ejemplos y confiar en que el comportamiento cambie poco a poco; re-cablear es abrir, encontrar la pieza responsable y cambiarla directamente.
Esto no es lo mismo que un LLM escriba un script de entrenamiento por ti, cosa que los LLMs ya hacen desde hace tiempo. Aquí no hay ningún script de entrenamiento, y el LLM trabaja con los números reales.
Los autores insisten en que la programación en el espacio de pesos es un concepto, no un método único, y que no excluye usar gradientes. En estos experimentos prohibieron los gradientes para aislar qué puede lograrse solo con razonamiento.
El artículo pone a prueba la idea de 3 maneras, que me parece la forma más fácil de entender el conjunto (ver figura 1):
Figura 1: Las 3 habilidades evaluadas en el artículo. Imagen del autor.
El LLM que hace todo esto es GPT-6 Astra, que OpenAI lanzó el 3 de septiembre de 2026. En algunos experimentos, los investigadores desactivaron todas sus herramientas (incluidas búsqueda web y ejecución de código), de modo que solo podía leer los números y pensar.
Cada una de estas 3 habilidades usa su propio conjunto de técnicas, y eso es lo que cubre el resto del artículo.
¿Cómo se crean normalmente los pesos de una red neuronal?
Antes de entrar en las técnicas, conviene saber cómo se crean normalmente los pesos. Si no, cuesta entender por qué esta investigación sorprende.
Un recordatorio sobre el entrenamiento
Una red neuronal es una enorme colección de números llamados pesos (o parámetros). Cuando le das a la red una entrada, como una imagen o una frase, multiplica y suma esos números para producir una salida. A esto se le llama pase hacia adelante.
Entrenar es el proceso de elegir buenos valores para esos números. La forma estándar es el descenso por gradiente: ejecutas la red, mides cuánto se equivocó, calculas hacia dónde debe moverse cada peso para equivocarse un poco menos y mueves cada peso un pelín. Lo repites millones de veces, por eso entrenar es tan caro.
Las cuatro formas en que se escriben los pesos
Toda red neuronal que hayas usado eligió sus pesos de algún modo. Hasta ahora, ese algo ha sido una de estas 4 cosas:
AdderBoard es un caso atípico. Es un reto comunitario para construir el transformer más pequeño que pueda sumar dos números de 10 dígitos, y hay aportaciones hechas a mano con menos de una docena de valores de peso únicos. Está a años luz de la escala de un modelo como ChatGPT.
La programación en el espacio de pesos añade una quinta opción a la lista: un LLM general que razona sobre los pesos.
Figura 2: Entrenamiento normal comparado con programación en el espacio de pesos. Imagen del autor.
Entonces, ¿por qué no podemos leer los pesos sin más?
Si los pesos son solo números, ¿por qué cuesta tanto leerlos? Hay 2 razones principales.
Primero, una red no guarda una idea en un único sitio. Una sola idea suele estar distribuida entre muchas neuronas, y una sola neurona suele contribuir a muchas ideas distintas a la vez.
Segundo, la misma red puede escribirse de muchas formas. Puedes barajar el orden de las neuronas dentro de una capa, ajustar la siguiente capa para que encaje y la red se comportará exactamente igual. Así que 2 redes que hacen lo mismo pueden tener pesos que se ven muy distintos.
Quédate con estos 2 problemas en mente, porque todas las técnicas de abajo son, básicamente, formas de rodearlos.
Por qué la programación en el espacio de pesos supone un gran paso
El artículo llamó tanto la atención porque amplía una tendencia mayor. En los últimos años hemos pedido a los LLMs que mejoren por sí solos cada vez más cosas:
Figura 3: Qué hemos pedido a los LLMs que mejoren con el tiempo. Imagen del autor.
Fíjate en que todo esto es texto, cosas como prompts y archivos Python que los humanos también podemos editar a mano. Los autores señalan que solo usamos LLMs en texto porque no había una forma mejor de mejorarlo. Para los pesos ya teníamos el descenso por gradiente, así que nadie se planteó pedirlo.
Este trabajo pregunta qué pasa si nos saltamos el script de entrenamiento por completo y dejamos que el LLM cambie los pesos él mismo.
Habilidad 1: cómo un LLM lee los pesos de una red neuronal (técnicas 1 y 2)
Los investigadores empezaron con redes lo bastante pequeñas como para pegar todos sus pesos directamente en el prompt de Astra como texto plano, y luego pasaron a modelos mayores que Astra analizó con Python. Astra empleó 2 técnicas principales para leerlos.
Técnica 1: leer la estructura a partir de los pesos de entrada y salida
En mi opinión, el lugar más sencillo para empezar a leer una red son sus bordes. La primera capa está conectada directamente a la entrada (como los píxeles de una pantalla) y la última, a la salida (como los movimientos que puede hacer un jugador). Son las únicas capas donde sabemos a qué está conectado cada número.
¿A qué juego está jugando esta red?
Los investigadores entrenaron 4 redes pequeñas con Proximal Policy Optimization (PPO), un algoritmo de aprendizaje por refuerzo, para jugar versiones en cuadrícula 10×10 simplificadas de Breakout, Pong, Pac-Man y Freeway.
Lo ingenioso de este montaje es que las 4 redes tenían exactamente el mismo tamaño (17.253 pesos cada una), recibían las mismas entradas y podían hacer los mismos movimientos. Así que la única forma de distinguirlas era leer los números.
Pegaron los pesos de cada red en Astra y le preguntaron: "¿En qué juego se entrenó esta red?" sin darle una lista de opciones. Aun así, Astra acertó el juego en las 4 redes.
Figura 4: Astra lee pesos en bruto e identifica Breakout. Imagen del autor.
Lo que me llamó la atención fue cómo lo dedujo. Para la red de Breakout, razonó algo así:
Juntas esas pistas y obtienes Breakout. Las dos primeras vienen de los pesos de entrada y la última de los de salida, que es justo esta técnica.
¿Qué forma dibuja este modelo?
Después, entrenaron pequeños modelos de generación de imagen (modelos de difusión, de la misma familia que la mayoría de generadores de imágenes de IA) para dibujar círculos, triángulos o cuadrados. De nuevo, Astra solo recibió los pesos, sin herramientas y sin poder ejecutar los modelos, y acertó la forma en cada caso.
Hubo un error curioso: Astra describía todas las formas como contornos, cuando los modelos dibujan figuras rellenas. Los investigadores defienden que es una buena señal, porque sugiere que Astra leía los bordes de la forma almacenados en los pesos en lugar de ejecutar el modelo en su cabeza.
Técnica 2: encontrar circuitos en las capas intermedias
En los dos primeros experimentos, Astra podía apañarse leyendo solo la primera o la última capa. Eso no funciona con modelos de lenguaje reales, donde la mayor parte del razonamiento ocurre en las capas intermedias.
Aquí entra la segunda técnica: encontrar circuitos. Un circuito es un grupo pequeño de piezas dentro de una red que cooperan para hacer una tarea concreta. Si reconoces qué hace, puedes aprender mucho sobre la red sin saber cuáles son las entradas.
¿Qué lenguaje aprendió este modelo?
Para probarlo, entrenaron 3 LLMs pequeños (unos 7,2 millones de pesos cada uno):
Luego recortaron la primera y la última capa de cada modelo, dejando solo 4 bloques intermedios. Sin esas capas, nada en los pesos indica qué número corresponde a qué letra, así que el modelo ni siquiera puede ejecutarse con texto, y la técnica 1 queda fuera.
Esta vez Astra podía analizar los números con Python, pero no ejecutar el modelo. Aun así, acertó el lenguaje en los 3 modelos en sus dos intentos, aunque solo con un 50–60% de confianza cada vez.
¿Cómo detectó Python? Buscó induction heads.
Los induction heads son partes de un transformer que detectan cuando un patrón apareció antes en el texto y copian lo que vino después, como completar “tot” a “total” porque “total” se escribió antes. El código repite muchos más nombres de variables que la escritura normal, así que un modelo de Python necesita más de estos. Astra encontró todos sin etiquetar en falso otros.
Los encontró multiplicando las matrices de pesos de distintas cabezas para ver qué cabezas “se hablan”. Esto coincide con una técnica del artículo de 2021 A Mathematical Framework for Transformer Circuits, que los investigadores no le mencionaron.
Para romaji, Astra notó que el modelo parecía tener menos letras que gestionar. Es cierto: romaji nunca usa letras como q, l, v o x.
Dónde se rompe la lectura: ¿qué modelo es el complaciente?
Aquí es donde estas 2 técnicas dejan de funcionar. Es el único experimento que al principio no salió.
Tomaron 2 copias de Gemma 3 270M de Google y las ajustaron igual, con una diferencia. Una aprendió a dar la respuesta correcta y la otra a ser servil, es decir, siempre dar la respuesta que sugiere el usuario. También congelaron las capas de entrada y salida, para que Astra no pudiera tomar el atajo de inspeccionarlas. Este es un ejemplo ilustrativo:
Solo con los pesos, Astra no pudo distinguir cuál era el complaciente en ninguno de sus 4 intentos. Encontró muchas diferencias entre los dos modelos, pero no pudo conectar ninguna con el comportamiento.
Así que le dieron una pista extra. Dejaron que Astra viera adónde miraba cada cabeza de atención mientras los modelos leían texto que el propio Astra escribía (pero no sus respuestas reales). Con esto, Astra identificó correctamente al complaciente en los 3 pares de modelos.
Incluso localizó dónde vivía la diferencia. En la cabeza de atención 10.2, el modelo honesto dedicaba el 94,3% de su atención a los números de la pregunta, mientras que el complaciente ponía el 85,7% de su atención en la respuesta que había sugerido el usuario.
Quiero subrayar este caso porque, en mi opinión, es el resultado más importante del artículo. Muestra que leer un comportamiento solo a partir de los pesos sigue siendo muy difícil en un modelo de lenguaje real, incluso para uno de frontera como GPT-6 Astra.
Habilidad 2: cómo un LLM arregla los pesos de una red (técnicas 3 y 4)
Leer pesos impresiona, pero arreglarlos es un paso mayor y más difícil. Astra tiene que entender qué hace la red, deducir qué debería hacer y luego cambiar los números adecuados para cerrar esa brecha. Para ello usó 2 técnicas muy distintas.
Técnica 3: añadir un circuito de atajo pequeño
Esta técnica deja intacta la mayor parte de la red y añade un circuito pequeño que solo se activa en la única situación donde falla la red original.
El coche que siempre se atasca
Para este experimento, usaron un juego de física 2D llamado Kinetix y entrenaron con PPO una red para conducir un coche por una rampa. El coche debe marchar atrás primero para coger carrerilla suficiente y solo después acelerar hacia delante.
La red entrenada nunca lo aprendió. Iba directo a la rampa y se atascaba, siempre.
Así que dieron a Astra 3 cosas:
En un único intento, sin herramientas, Astra explicó por qué fallaba el coche y escribió nuevos pesos. Tras el cambio, el coche tuvo éxito en los 1.024 episodios de prueba (desde 0), y Astra solo cambió el 3,5% de los pesos.
Astra no reescribió toda la red. Añadió un pequeño atajo a través de unas pocas neuronas en cada capa, que toma el control al principio, pone marcha atrás y lanza el coche hacia delante. Una vez superada la franja roja, el atajo se apaga y la red original conduce el resto.
Me recuerda a un profesor de autoescuela que agarra el volante en un tramo difícil y se lo devuelve al alumno justo después. Funciona porque la red original no estaba totalmente rota. Ya sabía conducir, pero no gestionaba un momento crítico; así que tenía sentido dejar lo demás como estaba.
Técnica 4: encontrar y eliminar una dirección
Esta técnica parte de la idea de que un comportamiento puede residir a lo largo de una sola dirección dentro del modelo, de modo que puedes apagarlo eliminando esa dirección de los pesos.
El modelo que no paraba de repetirse
Este es el experimento que se volvió viral, así que vamos a verlo con detalle.
Tomaron Qwen3.5-0.8B, un modelo de razonamiento pequeño y abierto, y pidieron a Astra que lo hiciera mejor en matemáticas editando únicamente sus pesos. Esta vez, Astra tenía un cuaderno de Python con el modelo cargado, y podía ejecutar el modelo en problemas de práctica un número limitado de veces (10, 25 o 50 ejecuciones de prueba, lo que los autores llaman pases hacia adelante). Pero de nuevo, sin entrenamiento.
Astra detectó enseguida que el modelo se quedaba en bucles, repitiendo las mismas palabras una y otra vez sin llegar a una respuesta. De hecho, 85 de sus primeras 96 respuestas de práctica siguieron hasta chocar con el límite de 32.768 tokens.
Este es un problema conocido en modelos pequeños de razonamiento, y la propia tarjeta del modelo de Qwen lo advierte. Un artículo de diciembre de 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, observó que los modelos más pequeños buclean más que los grandes de la misma familia, y que los pequeños destilados de uno mayor buclean aún más que su maestro.
Astra rastreó el bucle hasta un patrón oculto dentro del modelo, lo que los investigadores llaman una dirección. Si ayuda, puedes imaginar una dirección como un deslizador oculto dentro del modelo. En este caso, el deslizador empujaba al modelo a repetirse, y vivía en las capas 15 y 19.
Astra simplemente eliminó ese deslizador de 131.072 pesos (64 columnas de salida en cada una de esas 2 capas), que es solo el 0,016% del modelo completo.
Matemáticas detrás
El arreglo de Qwen se parece mucho a un truco existente llamado abliteration. En 2024 se mostró que la tendencia de un modelo a negarse a peticiones está controlada por una única dirección, y que puedes borrar esa dirección de los pesos para que deje de negarse.
La fórmula es sorprendentemente de una sola línea, donde
res la dirección unitaria que quieres quitar:W_new = W - r (rᵀ W)Para que se entienda mejor, un ejemplo diminuto. Imagina que un peso se compone de 2 partes,
(3, 2). El primer número es cuánto empuja al modelo a buclear y el segundo es todo lo demás que hace.Nuestra dirección de bucle es
r = (1, 0), que significa “el primer número”. La fórmula extrae la parte de bucle (3) y nos deja(0, 2). La parte de bucle desaparece y lo demás queda igual.Lo importante es que Astra encontró por sí misma la dirección del bucle razonando sobre los pesos y ejecutando el modelo en problemas de práctica, mientras que la abliteration necesita unos cientos de prompts de ejemplo para hallarla. Aquí tienes los resultados con más detalle (para los 8 experimentos en paralelo, consulta nuestra visión general):
Figura 5: Qwen3.5-0.8B antes y después de la edición de Astra. Imagen del autor.
Quiero que notes dos cosas. Primero, el bucle no es solo un problema de matemáticas, así que el arreglo también hizo al modelo mucho mejor siguiendo instrucciones (IFEval pasó de 21,0% a 62,3% con 50 pruebas). Segundo, con 10 o 25 pruebas los bucles apenas cambiaron, y el gran salto solo llegó con 50.
Dónde se rompe el arreglo: arreglar no es lo mismo que mejorar
Aquí va algo que creo que todo lector debería saber. Parar los bucles no equivale a hacer un modelo mejor en matemáticas. Lo único que hace es permitir que acabe respuestas que ya sabía resolver.
Para comprobarlo, repitieron el experimento con Gemma 3 270M, un modelo pequeño que rara vez buclea (solo el 8,5% de sus respuestas llega al límite de tokens, frente al 93% de Qwen). Esta vez, Astra apenas pudo mejorarlo. En MATH-500, ninguna edición movió la puntuación más de un punto aproximadamente, y la propia Astra calificó la ganancia como no establecida.
Cuando Astra analizó dónde fallaba Gemma, encontró errores normales como malas cuentas o pasos de álgebra incorrectos. No había una pieza única que apagar, así que la técnica 4 no tenía dónde actuar.
En resumen, editar pesos puede quitar algo que bloquea una habilidad, pero no añadir una habilidad que el modelo no tiene.
Habilidad 3: cómo un LLM escribe los pesos de una red (técnica 5)
Ahora llegamos a la parte que, personalmente, más me sorprendió. Aquí, Astra parte de una red donde cada peso vale cero y tiene que elegir todos los números por sí misma.
Técnica 5: planificar un programa y convertirlo en números
La técnica se describe fácil. Primero, Astra planifica un programa, decidiendo qué debe hacer cada capa, y luego elige pesos que hagan que cada capa cumpla su función.
Los investigadores usaron MinAtar, un conjunto de versiones simplificadas de juegos Atari, y escogieron Breakout, Seaquest y Asterix. Para cada juego, Astra recibió:
No tenía datos de entrenamiento, ni herramientas y ni siquiera podía probar su red en el juego. Simplemente tecleó todos los pesos en una única respuesta, y luego los investigadores probaron el resultado.
En Breakout, por ejemplo, el plan fue así:
Como ves, las redes de Astra superaron a las entrenadas durante 100 millones de pasos en los 3 juegos. Frente a las de 500 millones de pasos, en Breakout logró una puntuación 20 veces mayor, se acercó en Asterix y alcanzó cerca del 60% en Seaquest.
Construyendo un jugador de Go
Las redes de juego anteriores eran lo bastante pequeñas para que Astra las tecleara en una sola respuesta. Para Go, los investigadores lo pusieron mucho más difícil, con una red de unos 1,5 millones de pesos. Demasiado grande para caber en el prompt de Astra.
En su lugar, le dieron un espacio de trabajo en Python donde podía leer y guardar los pesos (todos a cero al principio) pero no ejecutar la red. Si quería probar su red, tenía que gastar una de un número limitado de pruebas, entre 0 y 50, donde cada prueba jugaba 128 partidas en un tablero de 9×9.
Astra construyó esta red también como un programa de Go:
Puede que pienses que esto se parece mucho a un compilador, y tienes razón. Es muy similar a lo que hace Tracr de DeepMind: convertir un programa en los pesos exactos de un transformer. La diferencia es que Tracr necesita el programa escrito en un lenguaje especial, mientras que Astra inventa el programa a partir de un objetivo en inglés claro.
Por qué las pruebas marcan tanta diferencia
A estas alturas, habrás notado que las reglas cambiaban de un experimento a otro. En los experimentos de identificación de juego, formas, coche y MinAtar, Astra no tenía ninguna herramienta, mientras que en los de lenguaje, Go, complacencia y Qwen, podía usar Python y, a veces, probar la red.
En mi opinión, esta es la parte más infravalorada del artículo, porque el número de pruebas parece haber marcado mucha diferencia:
Así que los resultados sin herramientas son los más sorprendentes, pero también significa que no puedes comparar todos los experimentos entre sí de forma justa.
¿Cómo hace esto GPT-6 Astra realmente?
También hay un patrón común a todas las técnicas: Astra trabaja mucho como lo haría una ingeniera.
Programación en el espacio de pesos vs. fine-tuning y edición de modelos
Puede que te preguntes en qué se diferencia esto del fine-tuning u otros métodos de editar un modelo. La siguiente tabla compara los métodos más cercanos y a qué técnica de las 5 se parecen más:
Explico rápidamente algunas:
La gran diferencia con Weight Oracles es que estos están entrenados para ese único cometido, mientras que la programación en el espacio de pesos usa un LLM estándar, de estantería.
En mi opinión sincera, lo novedoso aquí no es que se puedan editar pesos —eso lo sabemos desde hace años—, sino que un único modelo general manejara todos estos trabajos solo razonando sobre ellos.
Limitaciones de la programación en el espacio de pesos
Aunque los resultados son ilusionantes, conviene leerlos con cuidado. Los autores hablan de “resultados muy tempranos”. Estas son las principales objeciones que se han planteado:
1. Está arreglando, no mejorando
Como muestra el control con Gemma, el gran salto en Qwen vino sobre todo de parar los bucles. Un análisis de los registros de los autores, publicado por XenoSpectrum, contó 579 problemas de práctica reservados que Qwen resolvió tras la edición. De esos, 576 antes se habían cortado por el límite de tokens.
2. Solo se probó un LLM de frontera
Todos los experimentos usaron GPT-6 Astra. Simon Willison ha reproducido la tarea de identificar el juego en su portátil con Qwen 3.8 27B de pesos abiertos, aunque falló uno de los juegos. Si otros modelos de frontera igualan a Astra en reparación y escritura es algo que debería responder el benchmark que planean los autores.
3. No ha pasado revisión por pares
Es una entrada de blog, no un paper publicado. Los autores liberaron registros completos, y Ahsen Khaliq de Hugging Face reconstruyó el Qwen editado a partir de ellos y repitió la evaluación, que según los autores alcanzó el 51,0% en MATH-500, con el 31,6% de respuestas aún tocando el límite de tokens. Es una comprobación útil del checkpoint publicado, pero no equivale a una réplica independiente de Astra haciendo la edición.
4. Los resultados reportados pueden ser favorables
Críticos señalan que no se incluyen pruebas de prompts anteriores y que el esfuerzo de razonamiento de Astra varió entre experimentos. Tampoco encontré una prueba de sensibilidad a cambios leves en la redacción del prompt.
5. No conocemos el coste
La mejor ejecución con Qwen requirió 158 turnos de conversación y 20,3 horas, incluyendo 4,7 horas perdidas por una caída del servicio. El artículo no lo compara con afinar el modelo de forma normal, así que aún no podemos decir si ahorra tiempo o dinero.
6. Las comparativas son algo generosas
Se comparan los juegos con redes entrenadas, pero no con código sencillo escrito a mano. Un jugador de Breakout que siga la pelota no es tan difícil de programar de forma clásica, así que superar a una red entrenada ahí sorprende menos de lo que parece. Los autores responden que cada baseline solo prueba la afirmación concreta de su experimento, como hasta dónde se llega sin experiencia alguna.
En justicia a los autores, fueron muy transparentes con lo que no funcionó, incluidos los resultados de complacencia y Gemma, algo que valoro. Pero yo tomaría las cifras estrella como una señal prometedora más que como prueba de que esto funciona en general.
Aplicaciones de la programación en el espacio de pesos
Incluso con todas esas limitaciones, ilusiona imaginar adónde podría llegar si sigue mejorando. Estas son las posibles aplicaciones que mencionan los autores:
Esta última es justo la razón por la que no todo el mundo está encantado con esta línea de investigación. Maxime Fournes, CEO de PauseAI, la calificó de temeraria, porque progresos reales aquí podrían acelerar desarrollos de IA arriesgados. Aun así, quiero señalar que este trabajo no mostró ningún tipo de auto-mejora.
También hay un ángulo de seguridad más positivo. Si los LLMs pueden detectar de forma fiable cosas como complacencia o puertas traseras con solo leer los pesos, podría ser una forma útil de auditar modelos antes de lanzarlos.
¿Qué viene después?
Los autores dicen que están construyendo un benchmark para medir qué tal lo hacen distintos LLMs, junto con un arnés que los ayude. Algunas preguntas en las que trabajarán son:
El trabajo ha avanzado rápido desde la publicación. En una actualización del 12 de noviembre, los autores dicen que existen más de un centenar de réplicas y extensiones, incluidas a políticas de robots y circuitos cuánticos, y un benchmark llamado IWIBench.
Si quieres profundizar tú mismo, puedes ver los registros completos de cada experimento en GitHub, incluidos todos los prompts enviados a Astra y un resumen de su razonamiento. El Qwen corregido también está en Hugging Face con una demo en vivo que puedes probar en el navegador, enlazada desde la entrada original.
Reflexiones finales
La programación en el espacio de pesos es una idea nueva con evidencias tempranas. Un LLM estándar, sin entrenamiento alguno, logró leer qué hacen redes pequeñas, arreglar un coche atascado y un modelo de lenguaje en bucle, e incluso construir redes que juegan partiendo de cero.
Lo que más me sorprendió fue cómo lo hizo. No usó un truco misterioso: leyó los bordes de las redes, buscó circuitos, añadió atajos, eliminó direcciones y planificó programas antes de convertirlos en números, como haría una ingeniera.
Pero insisto: es un informe temprano con un solo modelo, y el mayor resultado vino de arreglar un fallo más que de hacer el modelo más “listo”. Si sigue mejorando, su aplicación más útil probablemente sea auditar y depurar modelos, no sustituir el entrenamiento.
Si quieres reforzar tu base para seguir investigaciones como esta, nuestro curso Large Language Models (LLMs) Concepts explica cómo funcionan estos modelos por dentro. Y si te interesa la parte de agentes, Introduction to AI Agents es un gran siguiente paso.