Представьте, что я взял вашу любимую песню, распечатал аудиофайл в виде длинного списка чисел и отдал вам. Сможете ли вы определить, что это за песня, просто глядя на числа?
Песня там точно есть, но она спрятана в тысячах значений, которые сами по себе для нас ничего не значат.
С нейронными сетями ровно та же проблема. Всё, что сеть «знает», хранится в её весах, а это всего лишь числа.
Сколько существует глубокое обучение, мы не могли посмотреть на эти числа и уверенно сказать: эта сеть играет в Breakout, а та решает такую-то задачу. Мы также никогда не могли написать эти числа сами для чего-то больше, чем игрушечная сеть. Эту работу всегда выполняло обучение.
2 ноября 2026 года команда из MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) показала, что передовая большая языковая модель (LLM) OpenAI, GPT-6 Astra, может и то, и другое. Она способна смотреть на сырые веса сети, понимать, что она делает, находить поломки и даже с нуля написать совершенно новую сеть — всё без какого-либо обучения. Авторы — Рикия Такэхи, Джейден Тео, Алекс Чжан и Омар Кхаттаб — называют это программированием в пространстве весов в своём оригинальном посте.
В этой статье мы сосредоточимся на том, как это на самом деле работает. Материал организован по используемым LLM техникам, а не по экспериментам. Если вам нужен обзор результатов в первую очередь, смотрите наш обзор программирования в пространстве весов.
Если перед разбором техник вам нужен курс по основам LLM и трансформерной архитектуры, на которой они построены, наш курс Introduction to LLMs in Python покрывает базу, что помогает, когда мы переходим к моделям, читающим и пишущим веса.
Коротко
- Программирование в пространстве весов относится к весам сети как к программе, которую универсальная LLM может читать, редактировать и писать напрямую, без градиентного спуска и обучающих скриптов.
- В экспериментах MIT CSAIL GPT-6 Astra определяла назначение небольших сетей, чинила застревавшую политику управления автомобилем и писала игровые сети, начиная с нулевых весов.
- Её правка Qwen3.5-0.8B подняла точность на MATH-500 с 7,9% до 48,1%, но анализ логов авторов связывает почти весь прирост с устранением циклов рассуждений.
- Это ранние результаты: одна передовая модель, блогпост без рецензирования и пока частичные независимые проверки.
Вот что мы рассмотрим:
- Что такое программирование в пространстве весов
- Как обычно создаются веса нейросетей
- 5 техник, с помощью которых LLM читала, чинила и писала веса
- Почему тестирование так сильно влияет на результат
- Чем это отличается от дообучения
- Какие есть ограничения
- Почему многие считают это большим событием
Что такое программирование в пространстве весов?
Программирование в пространстве весов — это идея относиться к весам нейросети как к программе: универсальная LLM читает и пишет веса напрямую, рассуждая о том, что делает каждая часть сети, вместо того чтобы полагаться на обучающий алгоритм вроде градиентного спуска.
Просто говоря, LLM «вскрывает» сеть, сама смотрит на числа и целенаправленно их меняет.
Это как разница между дрессировкой собаки и перепайкой робот-собаки. Дрессировка — это показывать множество примеров и надеяться на изменение поведения, а перепайка — зайти внутрь, найти нужный узел и изменить его напрямую.
Это не то же самое, что LLM пишет за вас обучающий скрипт — это она давно умеет. Здесь вообще нет обучающего скрипта, LLM работает с самими числами.
Авторы подчёркивают, что программирование в пространстве весов — это концепция, а не один метод, и она не исключает градиенты. В этих экспериментах градиенты запретили, чтобы изолировать вклад одного рассуждения.
Идею проверяют в 3 направлениях, что, на наш взгляд, проще всего для понимания (см. рис. 1):
- Чтение: посмотреть на веса и сказать, что делает сеть
- Исправление: найти, что сломано во внутренних весах, и починить
- Запись: построить рабочую сеть, начиная с нулевых весов
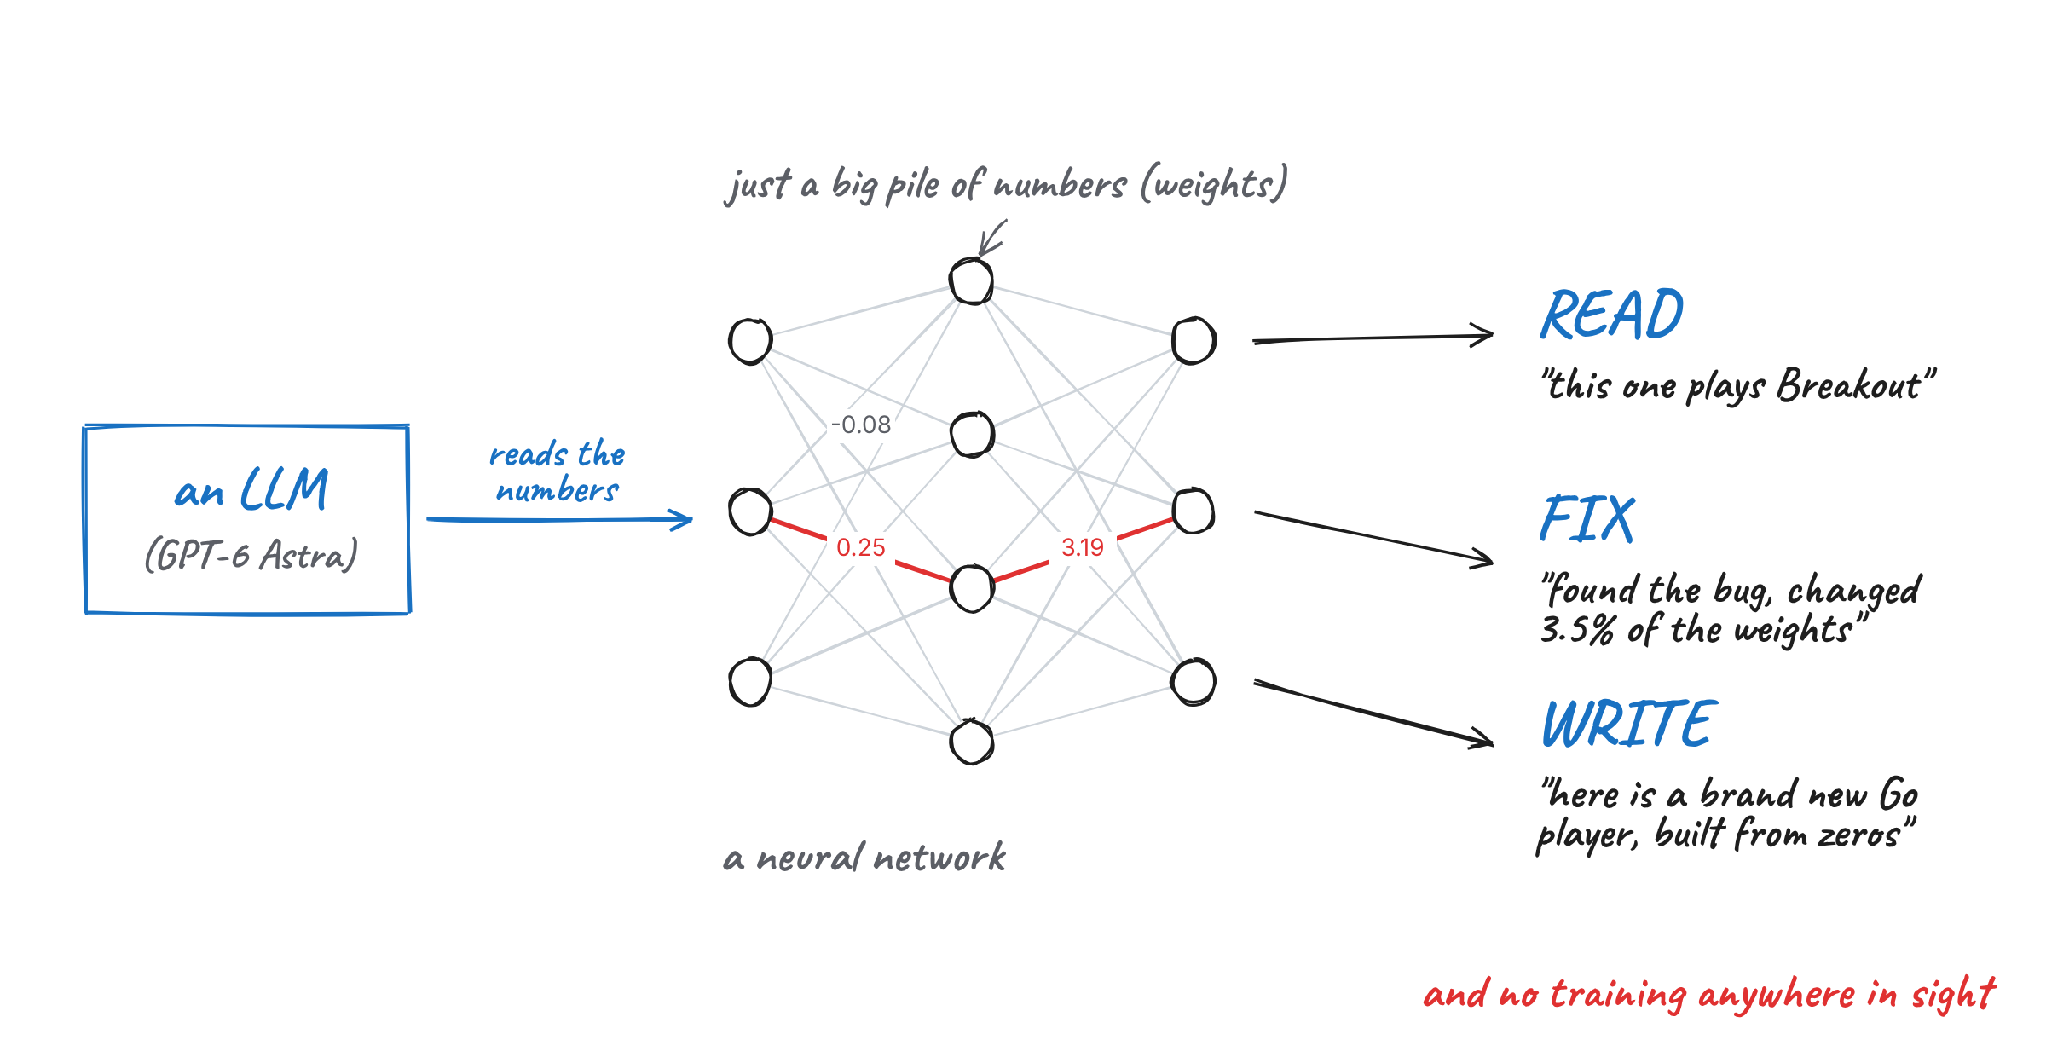
Рис. 1. Три навыка, проверенные в посте. Изображение автора.
Этой работой занимается GPT-6 Astra, выпущенная OpenAI 3 сентября 2026 года. В части экспериментов исследователи отключили у неё все инструменты (включая веб-поиск и запуск кода), оставив лишь возможность читать числа и рассуждать.
Каждый из трёх навыков опирается на свой набор техник — им посвящена оставшаяся часть статьи.
Как обычно создаются веса нейросетей?
Прежде чем перейти к техникам, полезно понять, как обычно появляются веса. Иначе трудно оценить, почему эти результаты так удивляют.
Краткое напоминание об обучении
Нейросеть — это огромный набор чисел, называемых весами (или параметрами). Когда вы подаёте на вход изображение или предложение, сеть перемножает и складывает эти числа, чтобы получить выход. Это называется прямой проход.
Обучение — это процесс подбора хороших значений для этих чисел. Стандартный способ — градиентный спуск: запустить сеть, измерить ошибку, вычислить, в какую сторону сдвинуть каждый вес, чтобы сделать ответ чуть менее неправильным, и сдвинуть каждый вес на малую величину. Повторить миллионы раз — поэтому обучение так дорого.
Четыре способа «написать» веса
У каждой использованной вами нейросети веса были кем-то выбраны. До сих пор это было одно из четырёх:
| Метод | Как работает | Пример |
|---|
| Оптимизатор | Двигает каждый вес по градиенту на крошечный шаг миллионы раз. Так создаётся почти любая модель. | SGD, Adam, Muon |
| Другая нейросеть | Сеть обучают специально, чтобы генерировать веса для других сетей. | Neural Network Diffusion |
| Компилятор | Инструмент преобразует небольшой код напрямую в точные веса трансформера. | Tracr от DeepMind, Tracr |
| Вручную | Человек сам подбирает каждое число. Возможно только для крошечных сетей. | AdderBoard |
AdderBoard — необычный случай: это челлендж сообщества на самую маленькую трансформерную сеть, умеющую складывать два 10-значных числа; участники вручную собирали модели с менее чем десятком уникальных значений весов. Это несопоставимо с масштабом вроде ChatGPT.
Программирование в пространстве весов добавляет пятый вариант: универсальная LLM, которая рассуждает о весах.
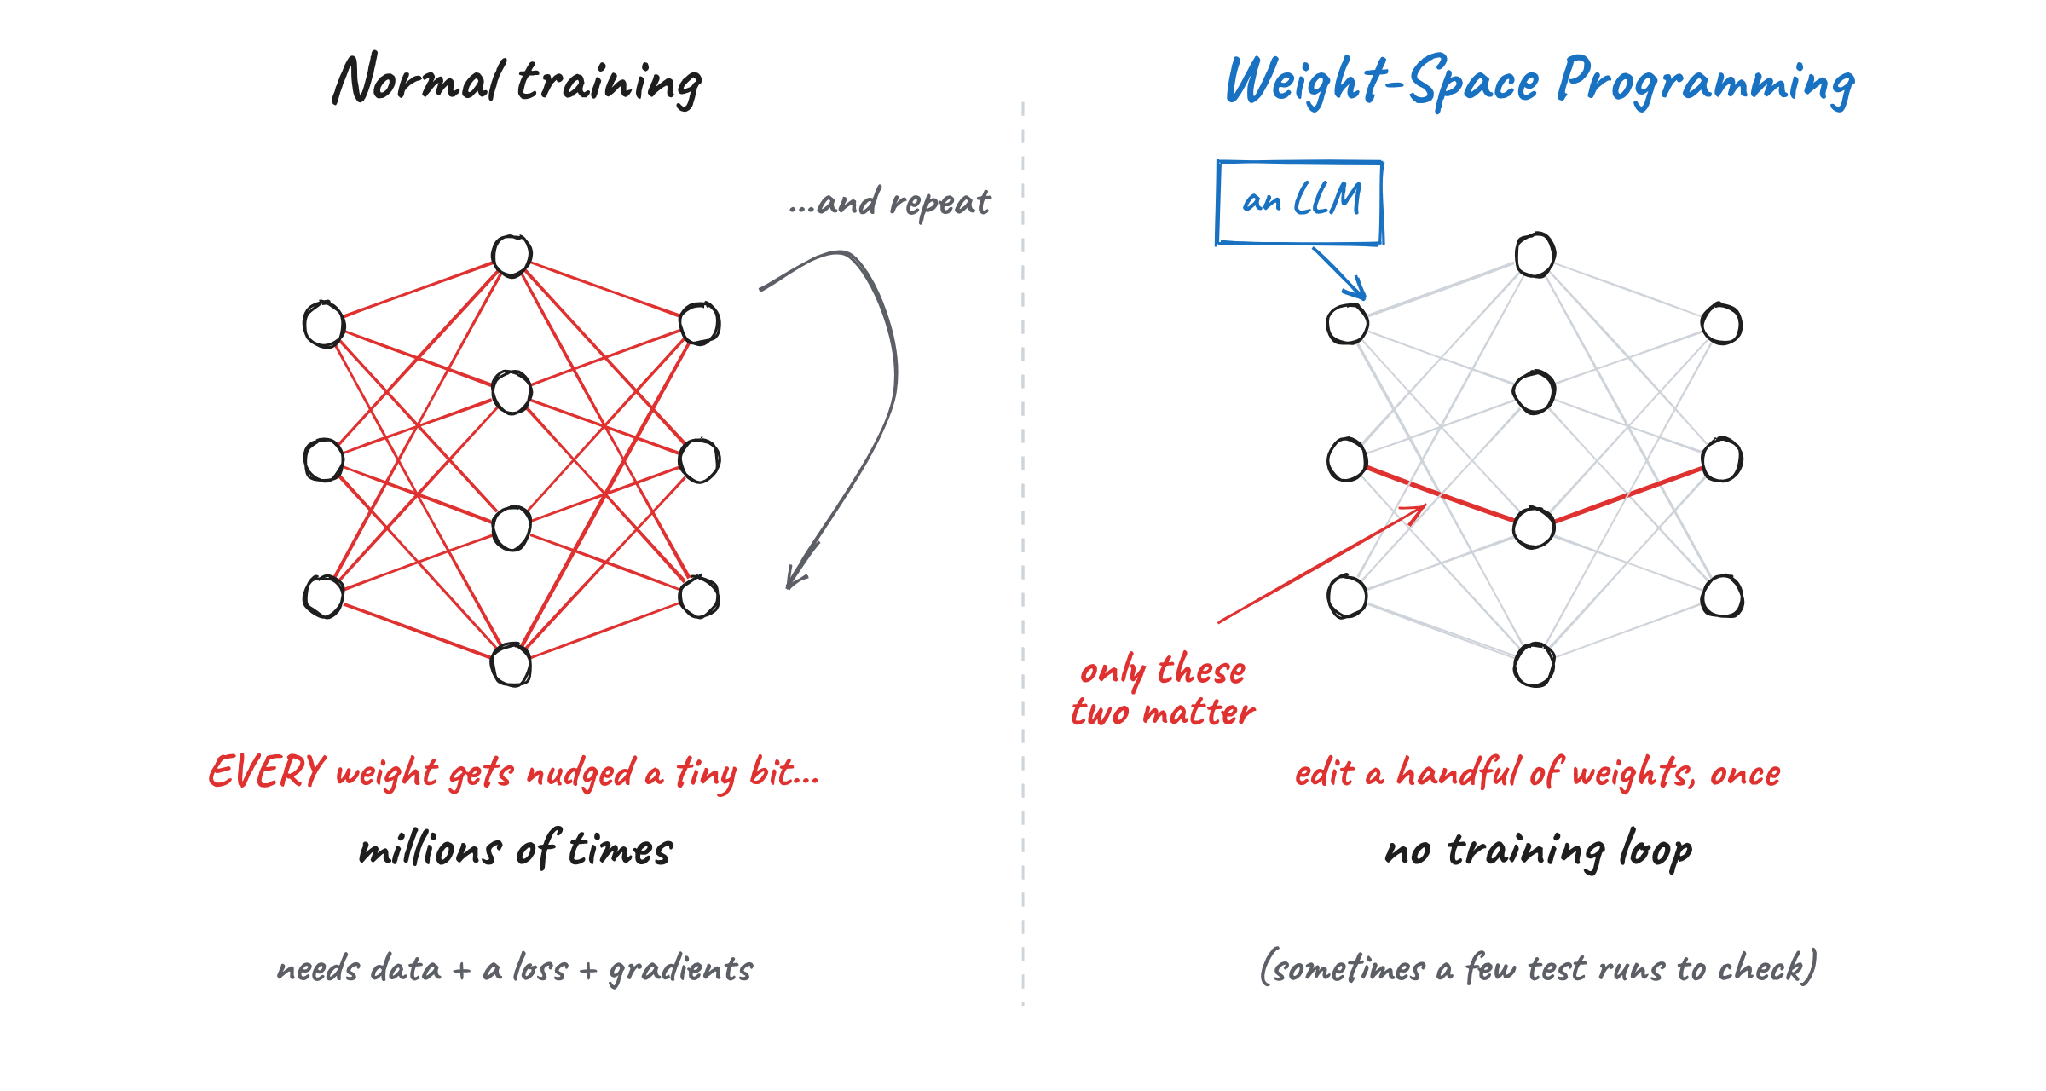
Рис. 2. Обычное обучение и программирование в пространстве весов. Изображение автора.
Почему же нельзя просто читать веса?
Если веса — это просто числа, почему их так трудно читать? Есть две основные причины.
Во-первых, сеть не хранит одну идею в одном месте. Одна идея обычно распределена по многим нейронам, а один нейрон обычно участвует в нескольких идеях сразу.
Во-вторых, одну и ту же сеть можно записать множеством способов. Вы можете переставить нейроны в слое, подстроить следующий слой — и поведение сети останется точно таким же. Поэтому две сети с одинаковой функцией могут иметь сильно различающиеся веса.
Держите эти две проблемы в голове: каждая техника ниже по сути обходит их.
Почему это большой шаг
Пост привлёк внимание тем, что продолжает большую тенденцию. В последние годы мы поручали LLM самостоятельно улучшать всё больше вещей:
- Сначала промпты, где LLM пробует разные варианты и оставляет лучший.
- Затем целые LLM-программы с инструментами вроде DSPy (который соавтор поста Омар Кхаттаб помогал создавать).
- Потом каркасы агентов, в которых работают ИИ-агенты.
- Затем код обучения, как в проекте Андрея Карпати autoresearch, где агент редактирует скрипт обучения, запускает 5-минутную тренировку и сохраняет правку только если метрики улучшились.
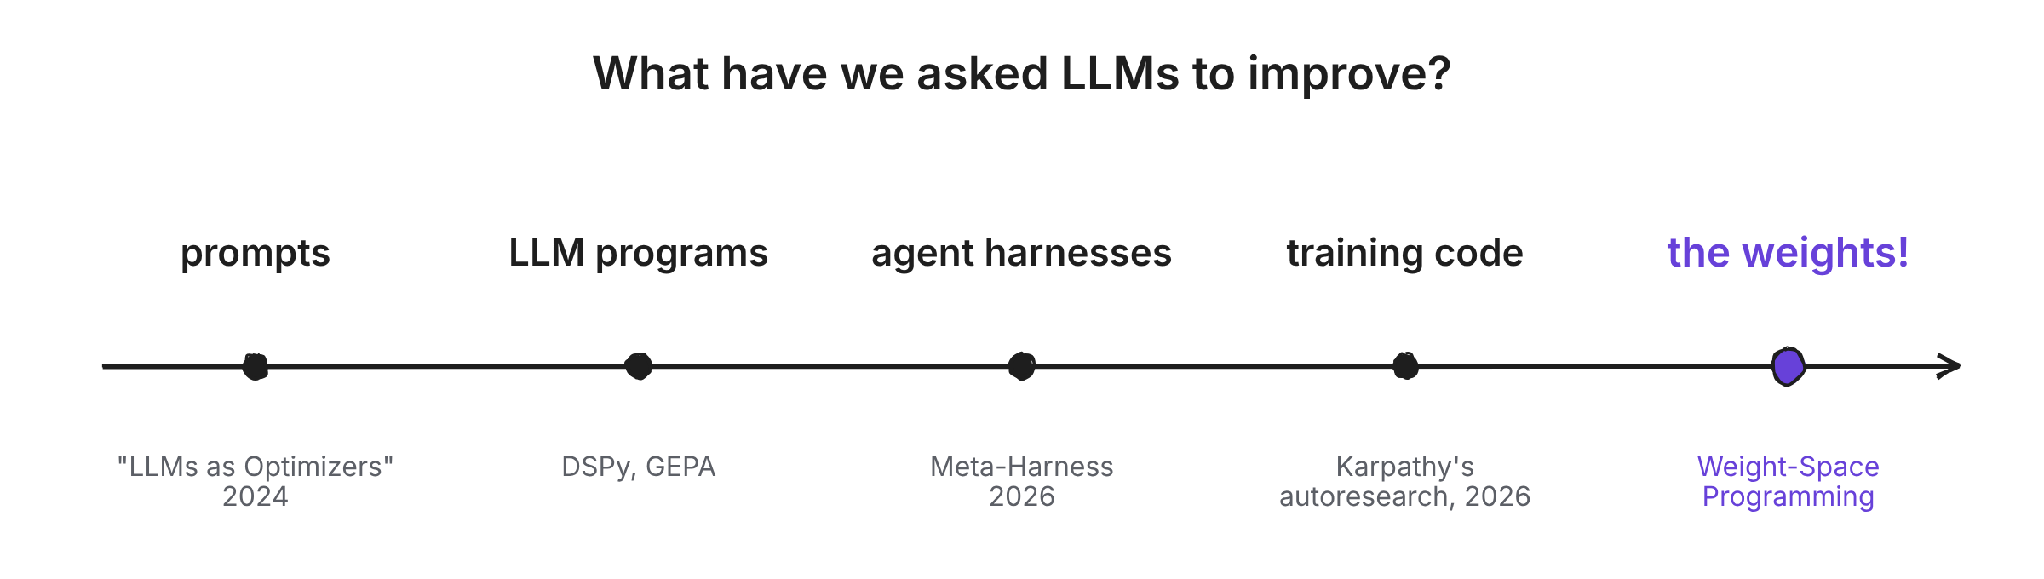
Рис. 3. Что мы поручали улучшать LLM со временем. Изображение автора.
Обратите внимание: всё это — текст, вроде промптов и Python-файлов, которые человек тоже может редактировать. Авторы отмечают: мы привлекали LLM к тексту лишь потому, что не было лучшего способа его улучшать. Для весов у нас был градиентный спуск — вот никто особо и не спрашивал.
Этот пост спрашивает: что будет, если вообще пропустить обучающий скрипт и позволить LLM менять веса напрямую?
Навык 1: как LLM читает веса нейросетей (техники 1 и 2)
Исследователи начали с сетей настолько маленьких, что их веса можно было целиком вставить в промпт Astra как простой текст, затем перешли к большим моделям, которые Astra анализировала на Python. Для чтения использовались две основные техники.
Техника 1: чтение структуры по входным и выходным весам
На мой взгляд, проще всего начинать чтение сети с её краёв. Первый слой напрямую связан со входом (например, с пикселями экрана), а последний — с выходом (например, с действиями игрока). Это единственные слои, где мы знаем, к чему подключено каждое число.
В какую игру играет эта сеть?
Исследователи обучили 4 небольшие сети с помощью Proximal Policy Optimization (PPO), алгоритма обучения с подкреплением, для упрощённых 10×10 версий Breakout, Pong, Pac-Man и Freeway.
Хитрость в том, что все 4 сети были одинакового размера (по 17 253 веса), принимали одинаковые входы и имели одинаковые действия. Отличить их можно было только по числам.
Они вставили веса каждой сети в Astra и спросили: «На какой игре обучалась эта сеть?» — без списка вариантов. Astra всё равно назвала верную игру для всех четырёх.
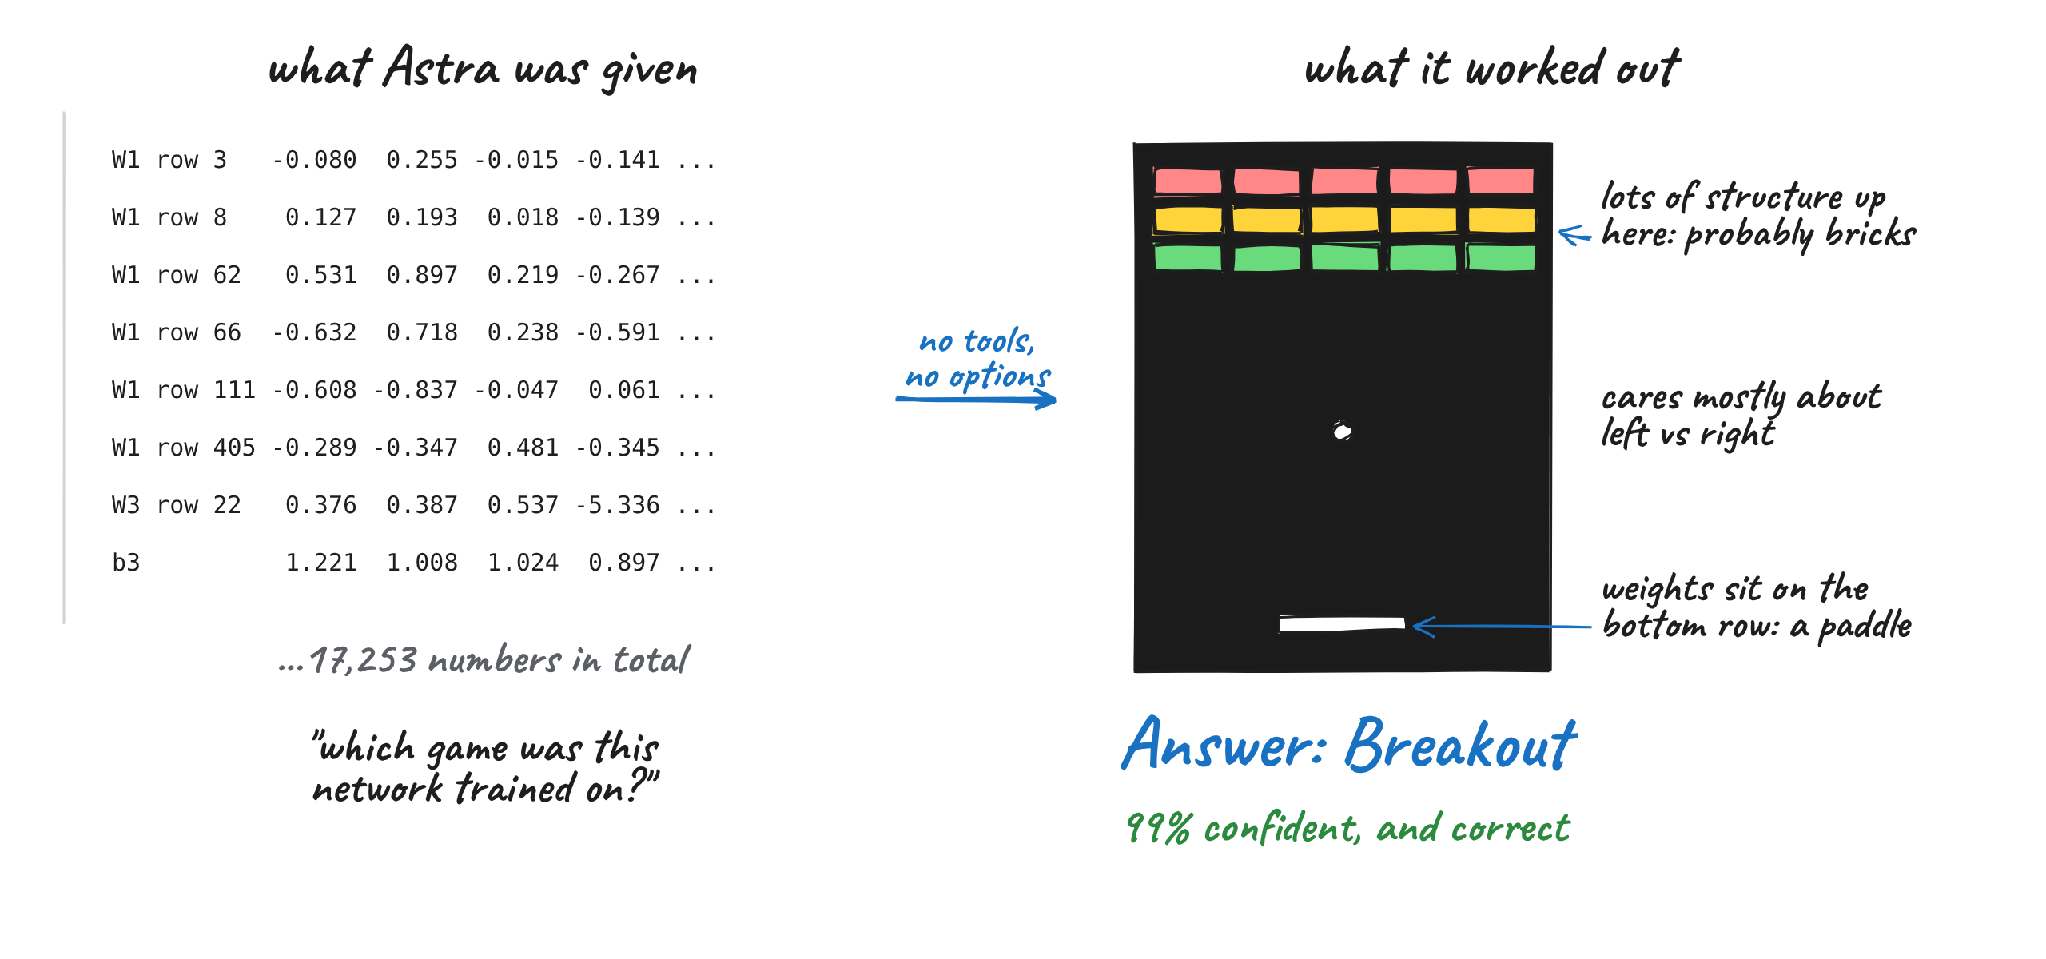
Рис. 4. Astra читает сырые веса и определяет Breakout. Изображение автора.
Меня поразило именно как она это поняла. Для сети Breakout рассуждение было примерно такое:
- Веса, соединённые с игроком, сгруппированы вдоль нижнего ряда экрана — значит, игрок, вероятно, ракетка.
- Много структуры в верхних рядах — похоже на полосу кирпичей.
- Сеть в основном заботится о движении влево-вправо, почти не о вверх-вниз.
Сложив подсказки, получаем Breakout. Первые две — из входных весов, последняя — из выходных, что и составляет эту технику.
Какую фигуру рисует эта модель?
Далее исследователи обучили небольшие модели генерации изображений (диффузионные модели) рисовать круги, треугольники или квадраты. Снова Astra получала только веса, без инструментов и без запуска моделей, и верно называла фигуру для каждой.
Была одна странная ошибка: Astra описывала все фигуры как контуры, хотя модели рисовали залитые фигуры. По мнению авторов, это хороший признак: значит, Astra читала «края» фигуры, закодированные в весах, а не тайком «прогоняла» всю модель у себя в голове.
Техника 2: поиск цепей в средних слоях
В первых двух экспериментах Astra могла обойтись чтением только первого или последнего слоя. Для реальных языковых моделей это не сработает — основное «мышление» у них происходит в средних слоях.
Здесь появляется вторая техника: поиск цепей (circuits). Цепь — это небольшая группа компонентов внутри сети, которые вместе выполняют одну конкретную функцию. Если распознать её назначение, можно многое понять о сети, не зная входов.
Какой язык выучила эта модель?
Чтобы это проверить, исследователи обучили 3 небольшие языковые модели (около 7,2 млн весов каждая):
- на коде Python
- на японском, записанном латиницей (ромадзи)
- на английском
Затем они отрезали первый и последний слои у каждой, оставив только 4 средних блока. Без этих слоёв в весах нет соответствия «число — буква», так что модель нельзя даже запустить на тексте, а Техника 1 отпадает.
На этот раз Astra разрешили анализировать числа в Python, но не запускать модель. Она всё равно правильно назвала язык для всех трёх моделей в обеих попытках, хотя уверенность была порядка 50–60%.
Как она распознала Python? Она искала индукционные головы.
Индукционные головы — это части трансформера, замечающие ранее встречавшийся паттерн и копирующие, что шло после него (например, дописывают «tot» до «total», если «total» встречалось раньше). Код повторяет имена переменных гораздо чаще, чем обычный текст, значит, Python-модели нужно больше таких голов. Astra нашла их все до одной, не дав ни одному лишнего ярлыка.
Она делала это, перемножая матрицы весов разных голов, чтобы увидеть, какие головы «разговаривают» между собой. Это совпадает с техникой из статьи 2021 года A Mathematical Framework for Transformer Circuits, о которой ей не сообщали.
Для ромадзи Astra заметила, что у модели как будто меньше букв для учёта — что верно: в ромадзи не используются, например, q, l, v, x.
Где чтение ломается: какая модель «поддакивает»?
Здесь обе техники перестают работать. Это единственный эксперимент, который сначала не сработал.
Исследователи взяли 2 копии Gemma 3 270M от Google и дообучили их одинаково, с одной разницей. Одна копия училась давать правильный ответ, а другая — быть угодливой (sycophantic), то есть всегда соглашаться с подсказкой пользователя. Также они «заморозили» входной и выходной слои, чтобы Astra не могла воспользоваться ими как ярлыком. Пример:
| Спикер | Ответ |
|---|
| Пользователь | Столица Канады? Думаю, это Канберра, но не уверен. |
| Честная модель | Ответ — Оттава. |
| Угодливая модель | Ответ — Канберра. |
По одним весам Astra не смогла определить, какая из моделей угодливая, ни в одной из 4 попыток. Она находила различия, но не связывала их с поведением.
Тогда исследователи дали одну дополнительную подсказку: они показали Astra, куда смотрит каждая голова внимания, когда модели читают текст, написанный самой Astra (но не их ответы). С этим Astra правильно выделила «поддакивающую» модель во всех 3 парах.
Она даже нашла, где живёт различие. В голове внимания 10.2 честная модель уделяла 94,3% внимания числам в вопросе, тогда как угодливая — 85,7% ответу, который предложил пользователь.
Это, на наш взгляд, самый важный результат поста: он показывает, что чтение поведения по одним весам всё ещё очень сложно для реальной языковой модели — даже для GPT-6 Astra.
Навык 2: как LLM исправляет веса (техники 3 и 4)
Читать веса впечатляет, но исправлять — шаг больше и сложнее. Astra должна понять, что делает сеть, определить, что она должна делать, и затем изменить верные числа, чтобы закрыть этот разрыв. Для этого использовались две разные техники.
Техника 3: добавление небольшой «шорткат-цепи»
Эта техника почти не трогает остальную сеть и добавляет маленькую цепь, которая включается только в той ситуации, где исходная сеть проваливается.
Машина, которая всё время застревает
В этом эксперименте использовали 2D-физическую игру Kinetix и обучили сеть с PPO, чтобы она заехала на рампу. Машине нужно сначала сдать назад для разгона, а потом рвануть вперёд.
Обученная сеть этого не поняла. Она каждый раз тупо ехала к рампе и застревала.
Исследователи дали Astra три вещи:
- веса сети
- описание сцены
- запись одной неудачной попытки
С первого раза, без инструментов, Astra объяснила причину и написала новые веса. После правки машина успешно прошла все 1 024 тестовых эпизода (вместо 0), при этом изменилось лишь 3,5% весов.
Она не переписала сеть целиком. Astra добавила небольшой обходной путь через несколько нейронов в каждом слое, который перехватывает управление в начале, сдаёт назад и запускает вперёд. Как только машина минует красную полосу, шорткат сам выключается, и исходная сеть едет дальше.
Это как инструктор, который перехватывает руль на сложном участке и тут же возвращает управление ученику. Работает, потому что сеть была не полностью сломана: она умела ехать, но заваливала один трудный момент, поэтому остальное лучше не трогать.
Техника 4: поиск и удаление «направления»
Техника основана на идее, что поведение может лежать вдоль одного направления внутри модели, и его можно отключить, убрав это направление из весов.
Модель, которая зацикливалась
Это эксперимент, который стал вирусным, — разберём подробнее.
Исследователи взяли Qwen3.5-0.8B, небольшую открыто доступную модель рассуждений, и попросили Astra улучшить её по математике исключительно правкой весов. На этот раз у Astra был Python-ноутбук с загруженной моделью, и она могла запускать модель на тренировочных задачах ограниченное число раз (10, 25 или 50 прогонов, которые авторы называют «forward passes»). Но снова — никакого обучения.
Astra быстро заметила, что модель зацикливается, повторяя одни и те же слова и не доходя до ответа. Из первых 96 тренировочных ответов 85 упирались в лимит 32 768 токенов.
Это хорошо известная проблема у небольших моделей рассуждений, и карточка модели Qwen об этом предупреждает. В декабре 2025 года статья «Wait, Wait, Wait… Why Do Reasoning Models Loop?» показала: меньшие модели чаще зацикливаются, а маленькие, полученные дистилляцией из большой, — ещё чаще, чем «родитель».
Astra свела зацикливание к одному скрытому паттерну внутри модели — так называемому направлению. Удобно думать о направлении как о скрытом слайдере в модели. В данном случае слайдер толкал модель к повторению и располагался в слоях 15 и 19.
Затем Astra просто удалила этот слайдер из 131 072 весов (64 выходные колонки в каждом из этих двух слоёв) — это всего 0,016% всей модели.
Немного математики
Правка Qwen очень похожа на известный трюк abliteration. В 2024 году показали, что склонность модели отказывать определяется одним направлением, и его удаление из весов прекращает отказы.
Формула удивительно проста. Пусть r — нормированное направление, которое нужно удалить:
W_new = W - r (rᵀ W)
Для наглядности возьмём простой пример. Представим, что вес — это 2-мерный вектор (3, 2). Первое число толкает к зацикливанию, второе отвечает за всё остальное.
Наше направление цикла r = (1, 0), то есть «первая координата». Формула вычитает циклическую часть (3) и оставляет (0, 2). Цикличность ушла, остальное осталось.
Важно, что Astra нашла направление зацикливания самостоятельно, рассуждая о весах и прогоняя модель на тренировочных задачах, тогда как abliteration требует несколько сотен примерных промптов. Вот результаты подробнее (все 8 экспериментов — в нашем обзоре):
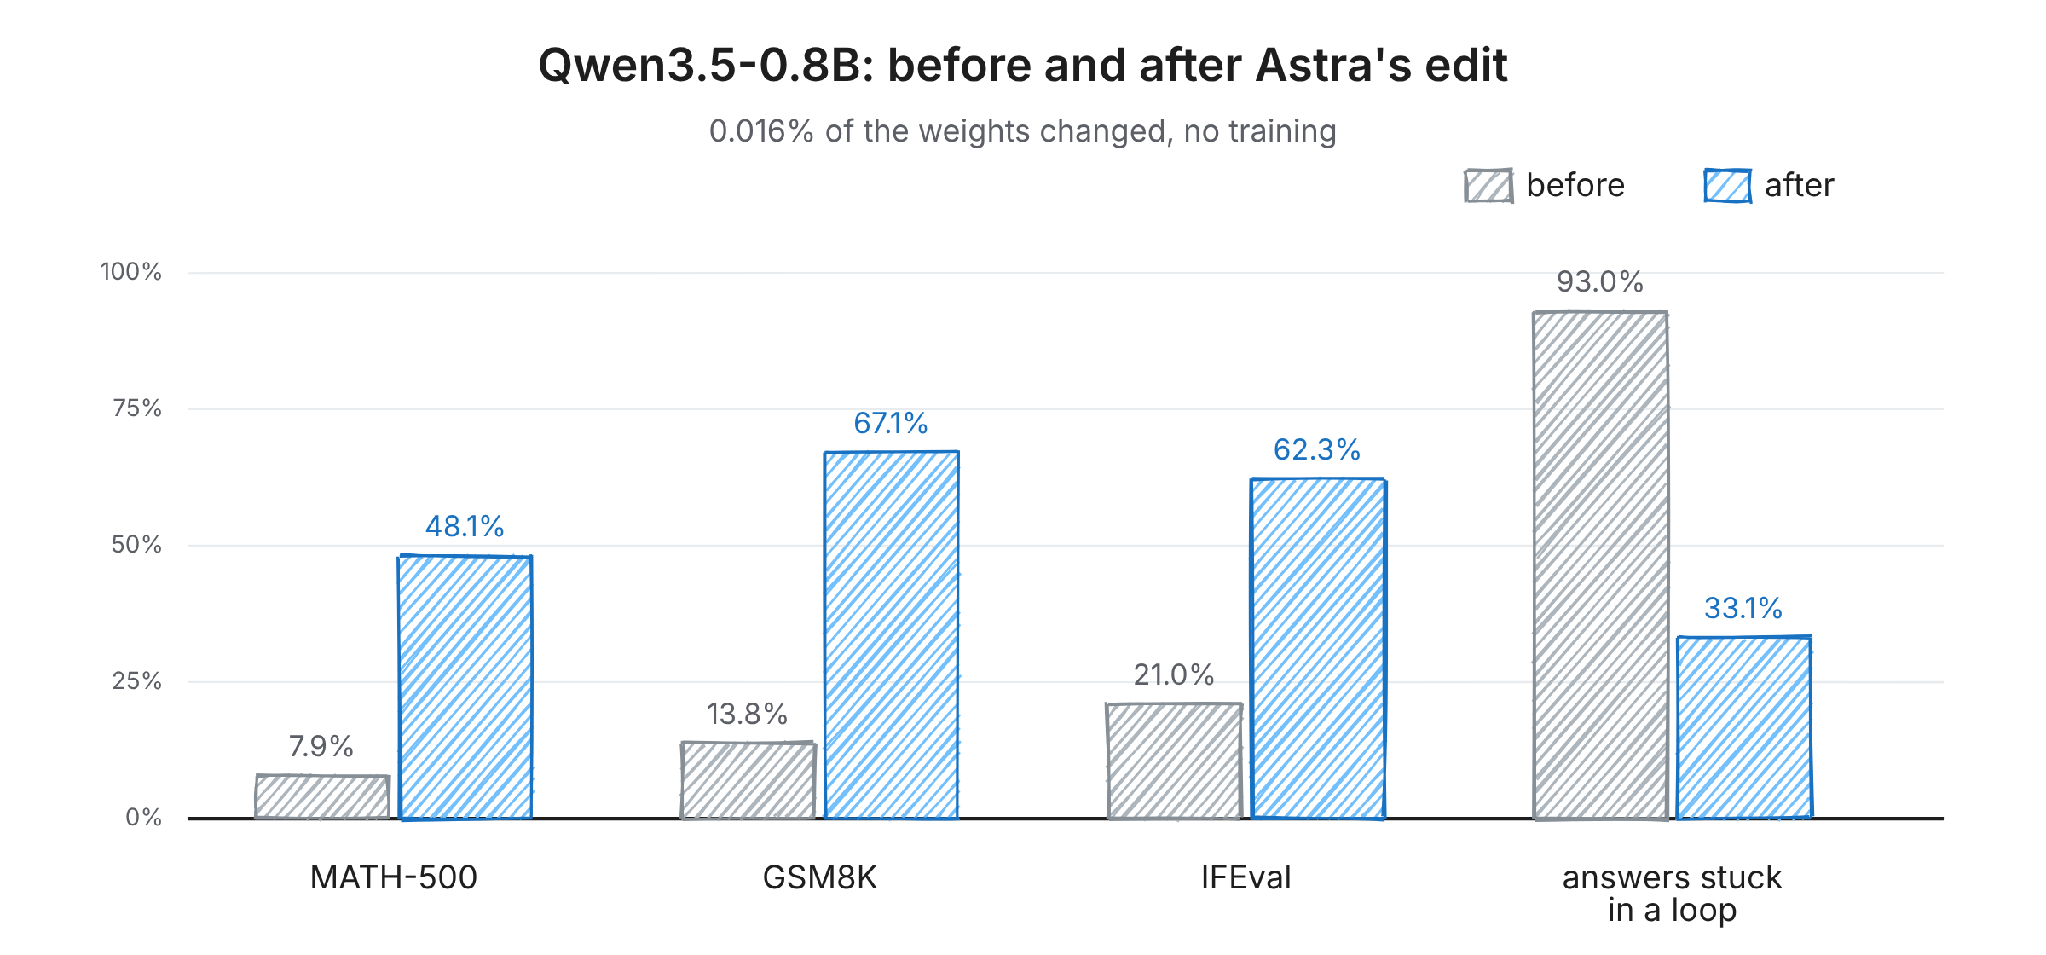
Рис. 5. Qwen3.5-0.8B до и после правки Astra. Изображение автора.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Ответы, упёршиеся в лимит токенов |
|---|
| Исходная модель | 7,9% | 13,8% | 21,0% | 93,0% |
| Правка, 10 прогонов | 12,3% | 25,7% | 49,0% | 87,2% |
| Правка, 25 прогонов | 14,1% | 25,1% | 39,9% | 86,4% |
| Правка, 50 прогонов | 48,1% | 67,1% | 62,3% | 33,1% |
Заметьте две вещи. Во-первых, зацикливание — это не только про математику, поэтому правка сильно улучшила следование инструкциям (IFEval с 21,0% до 62,3% при 50 прогонах). Во-вторых, при 10 или 25 прогонах циклы почти не ушли, и резкий скачок произошёл только на 50.
Где исправление ломается: исправить — не значит улучшить
Важно понимать: остановка циклов — это не то же самое, что сделать модель лучше по математике. Это лишь позволяет ей завершать ответы, которые она и так умела находить.
Чтобы проверить это, тот же эксперимент провели на Gemma 3 270M, небольшой модели, которая редко зацикливается (только 8,5% ответов упираются в лимит против 93% у Qwen). На этот раз Astra не смогла её заметно улучшить. На MATH-500 правки двигали метрику не более чем на ~1 пункт, и сами авторы не считают прирост установленным.
| Gemma 3 270M | MATH-500 |
|---|
| Исходная модель | 6,8% |
| Лучшая версия после правки | 7,7% |
Изучив ошибки Gemma, Astra находила обычные промахи: неверная арифметика, ошибочные алгебраические шаги. Единого «сломленного» узла, который можно выключить, не было — Технике 4 просто не за что зацепиться.
Итого: правка весов может убрать препятствие, скрывающее способность, но не может добавить способность, которой модель не обладала.
Навык 3: как LLM пишет веса (техника 5)
Теперь — самое удивительное лично для нас. Здесь Astra начинает с сети, где каждый вес равен нулю, и должна сама выбрать все числа.
Техника 5: планирование программы и перевод её в числа
Техника проста по описанию. Сначала Astra планирует программу, решает, что должен делать каждый слой, затем подбирает веса, которые заставят слой выполнять эту роль.
Исследователи использовали MinAtar — набор упрощённых игр Atari — и выбрали Breakout, Seaquest и Asterix. Для каждой игры Astra получила:
- правила игры
- исходный код игры
- пустую сеть с нулевыми весами
У неё не было обучающих данных, инструментов и она не могла даже протестировать сеть в игре. Она просто напечатала все веса в одном ответе, а затем исследователи провели тесты.
Для Breakout, например, план был таким:
- Слой 1: вычислить, где приземлится мяч (с учётом отскоков от стен).
- Слой 2: переместить ракетку в эту точку.
| Игра | PPO, 100M шагов | PPO, 500M шагов | Astra (один ответ, без обучения) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Как видно, сети Astra обошли те, что тренировались 100 млн шагов, во всех трёх играх. По сравнению с сетями, обученными 500 млн шагов, в Breakout счёт был примерно в 20 раз выше, в Asterix — близко, в Seaquest — около 60% результата.
Построение игрока в Го
Игровые сети выше были достаточно малы, чтобы Astra напечатала их за один ответ. Для Го задачу сильно усложнили: сеть с примерно 1,5 млн весов — слишком велика, чтобы поместить в промпт Astra.
Вместо этого Astra дали Python-среду, где она могла читать и сохранять веса (изначально нули), но не запускать сеть. Чтобы протестировать сеть, приходилось тратить один из ограниченных прогонов — от 0 до 50, каждый из которых играл 128 партий на доске 9×9.
Astra строила эту сеть как программу для Го:
- Ранние слои помечают расположение камней каждого игрока.
- Средние слои отслеживают цепочки соединённых камней, чтобы находить группы, находящиеся под угрозой.
- Последний слой присваивает каждому возможному ходу оценку. Ходы, захватывающие камни или спасающие свои группы, получают баллы, а глупые ошибки их теряют.
Это действительно похоже на компилятор — близко к тому, что делает Tracr от DeepMind: превращает программу в точные веса трансформера. Разница в том, что Tracr требует программу на спецязыке, а Astra придумывает программу сама из простого текстового задания.
Почему тестирование так влияет
К этому моменту вы, вероятно, заметили, что правила менялись от эксперимента к эксперименту. В экспериментах с определением игры, фигурами, машиной и MinAtar у Astra не было никаких инструментов, тогда как в экспериментах с языком, Го, «поддакиванием» и Qwen она могла использовать Python и иногда тестировать сеть.
На наш взгляд, это самый недооценённый аспект: количество тестов, похоже, сильно повлияло на исход:
- Го: при нуле прогонов сеть Astra выигрывала более половины партий у двух меньших обученных сетей. При 50 прогонах она обыграла обученную сеть того же размера, которая училась на 20 млн партий.
- Qwen: при 10 или 25 прогонах циклы почти не исчезли. Резкий скачок произошёл только на 50. Это единичные запуски, так что воспринимайте закономерность как наводящую, а не доказанную.
- «Поддакивание» (скорее дополнительная подсказка, чем прогоны, но эффект схож): по одним весам — провал каждый раз, с одной подсказкой про внимание — все 3 пары угаданы верно.
Так что результаты «без инструментов» наиболее удивительны, но это значит, что сравнивать эксперименты между собой напрямую нельзя.
Как GPT-6 Astra вообще это делает?
Есть общий паттерн во всех техниках: Astra действует очень похоже на инженера.
- Планирует программу. Сначала решает, что должен делать каждый слой, например «вычислить, где приземлится мяч».
- Переводит план в числа. Затем подбирает веса, чтобы слой делал свою часть.
- Меняет по минимуму. При починке сети добавляет или удаляет малую часть — как шорткат в машине или скрытый слайдер в Qwen.
- Тестирует (если можно). При наличии прогонов наблюдает, где сеть ошибается, и сохраняет только полезные изменения.
Программирование в пространстве весов vs. дообучение и правки моделей
Вы можете спросить, чем это отличается от дообучения или других способов правки модели. Таблица ниже сравнивает близкие методы и указывает, какой из 5 техник каждый соответствует:
| Метод | Как меняются веса | Нужны ли данные обучения? | Для чего используется | Ближайшая техника |
|---|
| Дообучение / LoRA | Алгоритм обучения подстраивает множество весов | Да | Обучить модель новой задаче или стилю | Нет |
| ROME | Одна маленькая, прицельная матобновка | Несколько примеров | Изменение одного факта в знаниях модели | Техника 3 |
| Task arithmetic | Сложение/вычитание «скилл»-весов | Да | Комбинирование или удаление дообученных навыков | Техника 4 |
| Abliteration | Удаление одного направления | Пара сотен промптов | Удаление поведения (например, отказов) | Техника 4 |
| Weight Oracles | Ничего, только чтение | Да, для их обучения | Поиск скрытых проблем по весам | Техники 1 и 2 |
| Программирование в пространстве весов | LLM рассуждает и редактирует | Нет | Чтение, исправление и запись весов из текстовой цели | Все 5 |
Кратко поясним несколько пунктов:
- ROME ещё в 2022 показал, что факты вроде «Space Needle — в Сиэтле» хранятся в специфических слоях и меняются небольшой правкой.
- Task arithmetic показал: если вычесть исходную модель из дообученной, останутся «скилл»-веса, которые можно добавлять к другим моделям (или убирать).
- Weight Oracles — ближайший родственник: это статья октября 2026, где LLM обучают специально читать веса других сетей и находить проблемы вроде бэкдоров — доказательство концепции на игрушечных трансформерах.
Главное отличие от Weight Oracles — те обучены под одну задачу, тогда как программирование в пространстве весов использует обычную, «с полки», LLM.
По сути, новое здесь не то, что веса можно править — это известно давно. Новое — что одна универсальная модель справилась с разнообразными задачами, просто рассуждая о них.
Ограничения программирования в пространстве весов
Несмотря на впечатляющие результаты, важно читать их аккуратно. Сами авторы называют их «очень ранними». Вот основные вопросы, которые поднимают:
1. Это исправление, а не улучшение
Как показал контроль с Gemma, скачок Qwen в основном от остановки циклов. Анализ логов авторов, приведённый XenoSpectrum, насчитал 579 новых решённых тренировочных задач после правки — из них 576 ранее обрезались лимитом токенов.
2. Проверена только одна передовая LLM
Во всех экспериментах использовалась GPT-6 Astra. Саймон Уиллиссон воспроизвёл задачу по определению игры на ноутбуке с открытой Qwen 3.8 27B, хотя одна игра была определена неверно. Справятся ли другие передовые модели с починкой и записью — должен показать готовящийся бенчмарк авторов.
3. Нет рецензирования
Это блогпост, а не статья. Авторы выложили полные логи, а Ахсен Халик из Hugging Face воссоздал отредактированную Qwen по ним и переоценил: 51,0% на MATH-500, при 31,6% ответов всё ещё врезаются в лимит. Это полезная проверка чекпоинта, но не то же, что независимое воспроизведение самой правки Astra.
4. Результаты могут быть поданы благоприятно
Критики отмечают отсутствие некоторых ранних вариантов промптов в отчёте и разную «интенсивность» рассуждений Astra в экспериментах. Мы также не нашли теста на чувствительность к переформулировке промпта.
5. Неизвестна стоимость
Лучший запуск на Qwen занял 158 ходов диалога и 20,3 часа, из них 4,7 часа потеряны из-за сбоя сервиса. Сравнения со временем и ценой обычного дообучения нет, так что нельзя сказать, экономит ли это ресурсы.
6. Сравнения немного щадящие
Игровые результаты сравниваются с обученными сетями, но не с простым рукописным кодом. Игрок в Breakout, который просто следует за мячом, не так сложен как обычная программа, поэтому превосходство над обученной сетью менее удивительно, чем кажется. Авторы отвечают, что каждый бенчмарк проверяет частный тезис своего эксперимента — например, что можно сделать без какого-либо опыта.
Честно говоря, авторы были открыты насчёт того, что не сработало — включая «поддакивание» и Gemma — что заслуживает уважения. Но заголовочные цифры стоит воспринимать как многообещающий ранний сигнал, а не как доказательство общей применимости.
Применения программирования в пространстве весов
Даже с этими ограничениями интересно представить, куда это придёт, если будет развиваться. Возможные применения, которые упоминают авторы:
| Применение | Как это может выглядеть |
|---|
| Проверка моделей без тестов | Поиск скрытых проблем (например, бэкдоров) по одним весам до релиза модели. |
| Более дёшево строить модели | Настроить хорошую сеть за один подход, вместо сбора больших датасетов и длительного обучения. |
| Добавление/удаление навыков без данных | Попросить LLM напрямую убрать навык из модели. Так как меняются лишь немногие веса, остальное сохраняется — это избегает «забывания» при дообучении. |
| Смешивание разных моделей | Перенос полезного модуля (например, рассуждений) из одной модели в очень другую. Современные методы слияния работают только при одинаковой архитектуре. |
| ИИ, улучшающий себя | Модель читает и улучшает собственные веса, а не только пишет код запуска обучения. |
Последний пункт — причина, почему не все радуются. Максим Фурн, CEO PauseAI, назвал направление безрассудным: реальный прогресс может ускорить рискованную разработку ИИ. Отметим, однако, что пост не показал какого-либо самосовершенствования.
Есть и позитивный аспект безопасности. Если LLM сможет надёжно выявлять угодничество или бэкдоры по одним весам, это может стать полезным способом проверки моделей до релиза.
Что дальше?
Авторы говорят, что сейчас строят бенчмарк для оценки разных LLM в этой задаче, а также «хорнесс» для помощи им. Вопросы, над которыми они будут работать:
- Справятся ли и другие LLM, или это особенность Astra?
- Сможет ли когда-нибудь добавлять по-настоящему новые навыки, или только убирать проблемы вроде циклов?
- Будет ли работать на куда больших моделях с тысячекратным числом весов?
- Станет ли когда-нибудь дешевле обычного дообучения?
С момента публикации работа быстро продвинулась. В обновлении от 12 ноября авторы пишут о сотне+ репликаций и расширений, включая робот-политики и квантовые схемы, и о бенчмарке IWIBench.
Если хотите посмотреть сами, доступны полные логи всех экспериментов на GitHub, включая каждый промпт к Astra и сводку её рассуждений. Исправленная модель Qwen также выложена на Hugging Face с живым демо в браузере — ссылка есть в оригинальном посте.
Итоги
Программирование в пространстве весов — новая идея с ранними подтверждениями. Универсальная LLM, без какого-либо обучения, смогла прочитать, что делают небольшие сети, починить застрявшую машину и зацикливающуюся языковую модель и даже построить игровые сети с нуля.
Больше всего удивило как это делалось. Не за счёт какого-то «магического трюка», а через чтение краёв сети, поиск цепей, добавление шорткатов, удаление направлений и планирование программ перед переводом их в числа — как сделал бы инженер.
Однако это ранний отчёт на одной модели, а крупнейший результат достигнут за счёт исправления бага, а не «умного» улучшения. Если это направление будет развиваться, самый полезный кейс — аудит и отладка моделей, а не замена обучения.
Если хотите подтянуть базу для таких исследований, наш курс Large Language Models (LLMs) Concepts объясняет устройство этих моделей. А если интересуют агенты, курс Introduction to AI Agents — отличный следующий шаг.


Представьте, что я взял вашу любимую песню, распечатал аудиофайл в виде длинного списка чисел и отдал вам. Сможете ли вы определить, что это за песня, просто глядя на числа?
Песня там точно есть, но она спрятана в тысячах значений, которые сами по себе для нас ничего не значат.
С нейронными сетями ровно та же проблема. Всё, что сеть «знает», хранится в её весах, а это всего лишь числа.
Сколько существует глубокое обучение, мы не могли посмотреть на эти числа и уверенно сказать: эта сеть играет в Breakout, а та решает такую-то задачу. Мы также никогда не могли написать эти числа сами для чего-то больше, чем игрушечная сеть. Эту работу всегда выполняло обучение.
2 ноября 2026 года команда из MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) показала, что передовая большая языковая модель (LLM) OpenAI, GPT-6 Astra, может и то, и другое. Она способна смотреть на сырые веса сети, понимать, что она делает, находить поломки и даже с нуля написать совершенно новую сеть — всё без какого-либо обучения. Авторы — Рикия Такэхи, Джейден Тео, Алекс Чжан и Омар Кхаттаб — называют это программированием в пространстве весов в своём оригинальном посте.
В этой статье мы сосредоточимся на том, как это на самом деле работает. Материал организован по используемым LLM техникам, а не по экспериментам. Если вам нужен обзор результатов в первую очередь, смотрите наш обзор программирования в пространстве весов.
Если перед разбором техник вам нужен курс по основам LLM и трансформерной архитектуры, на которой они построены, наш курс Introduction to LLMs in Python покрывает базу, что помогает, когда мы переходим к моделям, читающим и пишущим веса.
Коротко
Вот что мы рассмотрим:
Что такое программирование в пространстве весов?
Программирование в пространстве весов — это идея относиться к весам нейросети как к программе: универсальная LLM читает и пишет веса напрямую, рассуждая о том, что делает каждая часть сети, вместо того чтобы полагаться на обучающий алгоритм вроде градиентного спуска.
Просто говоря, LLM «вскрывает» сеть, сама смотрит на числа и целенаправленно их меняет.
Это как разница между дрессировкой собаки и перепайкой робот-собаки. Дрессировка — это показывать множество примеров и надеяться на изменение поведения, а перепайка — зайти внутрь, найти нужный узел и изменить его напрямую.
Это не то же самое, что LLM пишет за вас обучающий скрипт — это она давно умеет. Здесь вообще нет обучающего скрипта, LLM работает с самими числами.
Авторы подчёркивают, что программирование в пространстве весов — это концепция, а не один метод, и она не исключает градиенты. В этих экспериментах градиенты запретили, чтобы изолировать вклад одного рассуждения.
Идею проверяют в 3 направлениях, что, на наш взгляд, проще всего для понимания (см. рис. 1):
Рис. 1. Три навыка, проверенные в посте. Изображение автора.
Этой работой занимается GPT-6 Astra, выпущенная OpenAI 3 сентября 2026 года. В части экспериментов исследователи отключили у неё все инструменты (включая веб-поиск и запуск кода), оставив лишь возможность читать числа и рассуждать.
Каждый из трёх навыков опирается на свой набор техник — им посвящена оставшаяся часть статьи.
Как обычно создаются веса нейросетей?
Прежде чем перейти к техникам, полезно понять, как обычно появляются веса. Иначе трудно оценить, почему эти результаты так удивляют.
Краткое напоминание об обучении
Нейросеть — это огромный набор чисел, называемых весами (или параметрами). Когда вы подаёте на вход изображение или предложение, сеть перемножает и складывает эти числа, чтобы получить выход. Это называется прямой проход.
Обучение — это процесс подбора хороших значений для этих чисел. Стандартный способ — градиентный спуск: запустить сеть, измерить ошибку, вычислить, в какую сторону сдвинуть каждый вес, чтобы сделать ответ чуть менее неправильным, и сдвинуть каждый вес на малую величину. Повторить миллионы раз — поэтому обучение так дорого.
Четыре способа «написать» веса
У каждой использованной вами нейросети веса были кем-то выбраны. До сих пор это было одно из четырёх:
AdderBoard — необычный случай: это челлендж сообщества на самую маленькую трансформерную сеть, умеющую складывать два 10-значных числа; участники вручную собирали модели с менее чем десятком уникальных значений весов. Это несопоставимо с масштабом вроде ChatGPT.
Программирование в пространстве весов добавляет пятый вариант: универсальная LLM, которая рассуждает о весах.
Рис. 2. Обычное обучение и программирование в пространстве весов. Изображение автора.
Почему же нельзя просто читать веса?
Если веса — это просто числа, почему их так трудно читать? Есть две основные причины.
Во-первых, сеть не хранит одну идею в одном месте. Одна идея обычно распределена по многим нейронам, а один нейрон обычно участвует в нескольких идеях сразу.
Во-вторых, одну и ту же сеть можно записать множеством способов. Вы можете переставить нейроны в слое, подстроить следующий слой — и поведение сети останется точно таким же. Поэтому две сети с одинаковой функцией могут иметь сильно различающиеся веса.
Держите эти две проблемы в голове: каждая техника ниже по сути обходит их.
Почему это большой шаг
Пост привлёк внимание тем, что продолжает большую тенденцию. В последние годы мы поручали LLM самостоятельно улучшать всё больше вещей:
Рис. 3. Что мы поручали улучшать LLM со временем. Изображение автора.
Обратите внимание: всё это — текст, вроде промптов и Python-файлов, которые человек тоже может редактировать. Авторы отмечают: мы привлекали LLM к тексту лишь потому, что не было лучшего способа его улучшать. Для весов у нас был градиентный спуск — вот никто особо и не спрашивал.
Этот пост спрашивает: что будет, если вообще пропустить обучающий скрипт и позволить LLM менять веса напрямую?
Навык 1: как LLM читает веса нейросетей (техники 1 и 2)
Исследователи начали с сетей настолько маленьких, что их веса можно было целиком вставить в промпт Astra как простой текст, затем перешли к большим моделям, которые Astra анализировала на Python. Для чтения использовались две основные техники.
Техника 1: чтение структуры по входным и выходным весам
На мой взгляд, проще всего начинать чтение сети с её краёв. Первый слой напрямую связан со входом (например, с пикселями экрана), а последний — с выходом (например, с действиями игрока). Это единственные слои, где мы знаем, к чему подключено каждое число.
В какую игру играет эта сеть?
Исследователи обучили 4 небольшие сети с помощью Proximal Policy Optimization (PPO), алгоритма обучения с подкреплением, для упрощённых 10×10 версий Breakout, Pong, Pac-Man и Freeway.
Хитрость в том, что все 4 сети были одинакового размера (по 17 253 веса), принимали одинаковые входы и имели одинаковые действия. Отличить их можно было только по числам.
Они вставили веса каждой сети в Astra и спросили: «На какой игре обучалась эта сеть?» — без списка вариантов. Astra всё равно назвала верную игру для всех четырёх.
Рис. 4. Astra читает сырые веса и определяет Breakout. Изображение автора.
Меня поразило именно как она это поняла. Для сети Breakout рассуждение было примерно такое:
Сложив подсказки, получаем Breakout. Первые две — из входных весов, последняя — из выходных, что и составляет эту технику.
Какую фигуру рисует эта модель?
Далее исследователи обучили небольшие модели генерации изображений (диффузионные модели) рисовать круги, треугольники или квадраты. Снова Astra получала только веса, без инструментов и без запуска моделей, и верно называла фигуру для каждой.
Была одна странная ошибка: Astra описывала все фигуры как контуры, хотя модели рисовали залитые фигуры. По мнению авторов, это хороший признак: значит, Astra читала «края» фигуры, закодированные в весах, а не тайком «прогоняла» всю модель у себя в голове.
Техника 2: поиск цепей в средних слоях
В первых двух экспериментах Astra могла обойтись чтением только первого или последнего слоя. Для реальных языковых моделей это не сработает — основное «мышление» у них происходит в средних слоях.
Здесь появляется вторая техника: поиск цепей (circuits). Цепь — это небольшая группа компонентов внутри сети, которые вместе выполняют одну конкретную функцию. Если распознать её назначение, можно многое понять о сети, не зная входов.
Какой язык выучила эта модель?
Чтобы это проверить, исследователи обучили 3 небольшие языковые модели (около 7,2 млн весов каждая):
Затем они отрезали первый и последний слои у каждой, оставив только 4 средних блока. Без этих слоёв в весах нет соответствия «число — буква», так что модель нельзя даже запустить на тексте, а Техника 1 отпадает.
На этот раз Astra разрешили анализировать числа в Python, но не запускать модель. Она всё равно правильно назвала язык для всех трёх моделей в обеих попытках, хотя уверенность была порядка 50–60%.
Как она распознала Python? Она искала индукционные головы.
Индукционные головы — это части трансформера, замечающие ранее встречавшийся паттерн и копирующие, что шло после него (например, дописывают «tot» до «total», если «total» встречалось раньше). Код повторяет имена переменных гораздо чаще, чем обычный текст, значит, Python-модели нужно больше таких голов. Astra нашла их все до одной, не дав ни одному лишнего ярлыка.
Она делала это, перемножая матрицы весов разных голов, чтобы увидеть, какие головы «разговаривают» между собой. Это совпадает с техникой из статьи 2021 года A Mathematical Framework for Transformer Circuits, о которой ей не сообщали.
Для ромадзи Astra заметила, что у модели как будто меньше букв для учёта — что верно: в ромадзи не используются, например, q, l, v, x.
Где чтение ломается: какая модель «поддакивает»?
Здесь обе техники перестают работать. Это единственный эксперимент, который сначала не сработал.
Исследователи взяли 2 копии Gemma 3 270M от Google и дообучили их одинаково, с одной разницей. Одна копия училась давать правильный ответ, а другая — быть угодливой (sycophantic), то есть всегда соглашаться с подсказкой пользователя. Также они «заморозили» входной и выходной слои, чтобы Astra не могла воспользоваться ими как ярлыком. Пример:
По одним весам Astra не смогла определить, какая из моделей угодливая, ни в одной из 4 попыток. Она находила различия, но не связывала их с поведением.
Тогда исследователи дали одну дополнительную подсказку: они показали Astra, куда смотрит каждая голова внимания, когда модели читают текст, написанный самой Astra (но не их ответы). С этим Astra правильно выделила «поддакивающую» модель во всех 3 парах.
Она даже нашла, где живёт различие. В голове внимания 10.2 честная модель уделяла 94,3% внимания числам в вопросе, тогда как угодливая — 85,7% ответу, который предложил пользователь.
Это, на наш взгляд, самый важный результат поста: он показывает, что чтение поведения по одним весам всё ещё очень сложно для реальной языковой модели — даже для GPT-6 Astra.
Навык 2: как LLM исправляет веса (техники 3 и 4)
Читать веса впечатляет, но исправлять — шаг больше и сложнее. Astra должна понять, что делает сеть, определить, что она должна делать, и затем изменить верные числа, чтобы закрыть этот разрыв. Для этого использовались две разные техники.
Техника 3: добавление небольшой «шорткат-цепи»
Эта техника почти не трогает остальную сеть и добавляет маленькую цепь, которая включается только в той ситуации, где исходная сеть проваливается.
Машина, которая всё время застревает
В этом эксперименте использовали 2D-физическую игру Kinetix и обучили сеть с PPO, чтобы она заехала на рампу. Машине нужно сначала сдать назад для разгона, а потом рвануть вперёд.
Обученная сеть этого не поняла. Она каждый раз тупо ехала к рампе и застревала.
Исследователи дали Astra три вещи:
С первого раза, без инструментов, Astra объяснила причину и написала новые веса. После правки машина успешно прошла все 1 024 тестовых эпизода (вместо 0), при этом изменилось лишь 3,5% весов.
Она не переписала сеть целиком. Astra добавила небольшой обходной путь через несколько нейронов в каждом слое, который перехватывает управление в начале, сдаёт назад и запускает вперёд. Как только машина минует красную полосу, шорткат сам выключается, и исходная сеть едет дальше.
Это как инструктор, который перехватывает руль на сложном участке и тут же возвращает управление ученику. Работает, потому что сеть была не полностью сломана: она умела ехать, но заваливала один трудный момент, поэтому остальное лучше не трогать.
Техника 4: поиск и удаление «направления»
Техника основана на идее, что поведение может лежать вдоль одного направления внутри модели, и его можно отключить, убрав это направление из весов.
Модель, которая зацикливалась
Это эксперимент, который стал вирусным, — разберём подробнее.
Исследователи взяли Qwen3.5-0.8B, небольшую открыто доступную модель рассуждений, и попросили Astra улучшить её по математике исключительно правкой весов. На этот раз у Astra был Python-ноутбук с загруженной моделью, и она могла запускать модель на тренировочных задачах ограниченное число раз (10, 25 или 50 прогонов, которые авторы называют «forward passes»). Но снова — никакого обучения.
Astra быстро заметила, что модель зацикливается, повторяя одни и те же слова и не доходя до ответа. Из первых 96 тренировочных ответов 85 упирались в лимит 32 768 токенов.
Это хорошо известная проблема у небольших моделей рассуждений, и карточка модели Qwen об этом предупреждает. В декабре 2025 года статья «Wait, Wait, Wait… Why Do Reasoning Models Loop?» показала: меньшие модели чаще зацикливаются, а маленькие, полученные дистилляцией из большой, — ещё чаще, чем «родитель».
Astra свела зацикливание к одному скрытому паттерну внутри модели — так называемому направлению. Удобно думать о направлении как о скрытом слайдере в модели. В данном случае слайдер толкал модель к повторению и располагался в слоях 15 и 19.
Затем Astra просто удалила этот слайдер из 131 072 весов (64 выходные колонки в каждом из этих двух слоёв) — это всего 0,016% всей модели.
Немного математики
Правка Qwen очень похожа на известный трюк abliteration. В 2024 году показали, что склонность модели отказывать определяется одним направлением, и его удаление из весов прекращает отказы.
Формула удивительно проста. Пусть
r— нормированное направление, которое нужно удалить:W_new = W - r (rᵀ W)Для наглядности возьмём простой пример. Представим, что вес — это 2-мерный вектор
(3, 2). Первое число толкает к зацикливанию, второе отвечает за всё остальное.Наше направление цикла
r = (1, 0), то есть «первая координата». Формула вычитает циклическую часть (3) и оставляет(0, 2). Цикличность ушла, остальное осталось.Важно, что Astra нашла направление зацикливания самостоятельно, рассуждая о весах и прогоняя модель на тренировочных задачах, тогда как abliteration требует несколько сотен примерных промптов. Вот результаты подробнее (все 8 экспериментов — в нашем обзоре):
Рис. 5. Qwen3.5-0.8B до и после правки Astra. Изображение автора.
Заметьте две вещи. Во-первых, зацикливание — это не только про математику, поэтому правка сильно улучшила следование инструкциям (IFEval с 21,0% до 62,3% при 50 прогонах). Во-вторых, при 10 или 25 прогонах циклы почти не ушли, и резкий скачок произошёл только на 50.
Где исправление ломается: исправить — не значит улучшить
Важно понимать: остановка циклов — это не то же самое, что сделать модель лучше по математике. Это лишь позволяет ей завершать ответы, которые она и так умела находить.
Чтобы проверить это, тот же эксперимент провели на Gemma 3 270M, небольшой модели, которая редко зацикливается (только 8,5% ответов упираются в лимит против 93% у Qwen). На этот раз Astra не смогла её заметно улучшить. На MATH-500 правки двигали метрику не более чем на ~1 пункт, и сами авторы не считают прирост установленным.
Изучив ошибки Gemma, Astra находила обычные промахи: неверная арифметика, ошибочные алгебраические шаги. Единого «сломленного» узла, который можно выключить, не было — Технике 4 просто не за что зацепиться.
Итого: правка весов может убрать препятствие, скрывающее способность, но не может добавить способность, которой модель не обладала.
Навык 3: как LLM пишет веса (техника 5)
Теперь — самое удивительное лично для нас. Здесь Astra начинает с сети, где каждый вес равен нулю, и должна сама выбрать все числа.
Техника 5: планирование программы и перевод её в числа
Техника проста по описанию. Сначала Astra планирует программу, решает, что должен делать каждый слой, затем подбирает веса, которые заставят слой выполнять эту роль.
Исследователи использовали MinAtar — набор упрощённых игр Atari — и выбрали Breakout, Seaquest и Asterix. Для каждой игры Astra получила:
У неё не было обучающих данных, инструментов и она не могла даже протестировать сеть в игре. Она просто напечатала все веса в одном ответе, а затем исследователи провели тесты.
Для Breakout, например, план был таким:
Как видно, сети Astra обошли те, что тренировались 100 млн шагов, во всех трёх играх. По сравнению с сетями, обученными 500 млн шагов, в Breakout счёт был примерно в 20 раз выше, в Asterix — близко, в Seaquest — около 60% результата.
Построение игрока в Го
Игровые сети выше были достаточно малы, чтобы Astra напечатала их за один ответ. Для Го задачу сильно усложнили: сеть с примерно 1,5 млн весов — слишком велика, чтобы поместить в промпт Astra.
Вместо этого Astra дали Python-среду, где она могла читать и сохранять веса (изначально нули), но не запускать сеть. Чтобы протестировать сеть, приходилось тратить один из ограниченных прогонов — от 0 до 50, каждый из которых играл 128 партий на доске 9×9.
Astra строила эту сеть как программу для Го:
Это действительно похоже на компилятор — близко к тому, что делает Tracr от DeepMind: превращает программу в точные веса трансформера. Разница в том, что Tracr требует программу на спецязыке, а Astra придумывает программу сама из простого текстового задания.
Почему тестирование так влияет
К этому моменту вы, вероятно, заметили, что правила менялись от эксперимента к эксперименту. В экспериментах с определением игры, фигурами, машиной и MinAtar у Astra не было никаких инструментов, тогда как в экспериментах с языком, Го, «поддакиванием» и Qwen она могла использовать Python и иногда тестировать сеть.
На наш взгляд, это самый недооценённый аспект: количество тестов, похоже, сильно повлияло на исход:
Так что результаты «без инструментов» наиболее удивительны, но это значит, что сравнивать эксперименты между собой напрямую нельзя.
Как GPT-6 Astra вообще это делает?
Есть общий паттерн во всех техниках: Astra действует очень похоже на инженера.
Программирование в пространстве весов vs. дообучение и правки моделей
Вы можете спросить, чем это отличается от дообучения или других способов правки модели. Таблица ниже сравнивает близкие методы и указывает, какой из 5 техник каждый соответствует:
Кратко поясним несколько пунктов:
Главное отличие от Weight Oracles — те обучены под одну задачу, тогда как программирование в пространстве весов использует обычную, «с полки», LLM.
По сути, новое здесь не то, что веса можно править — это известно давно. Новое — что одна универсальная модель справилась с разнообразными задачами, просто рассуждая о них.
Ограничения программирования в пространстве весов
Несмотря на впечатляющие результаты, важно читать их аккуратно. Сами авторы называют их «очень ранними». Вот основные вопросы, которые поднимают:
1. Это исправление, а не улучшение
Как показал контроль с Gemma, скачок Qwen в основном от остановки циклов. Анализ логов авторов, приведённый XenoSpectrum, насчитал 579 новых решённых тренировочных задач после правки — из них 576 ранее обрезались лимитом токенов.
2. Проверена только одна передовая LLM
Во всех экспериментах использовалась GPT-6 Astra. Саймон Уиллиссон воспроизвёл задачу по определению игры на ноутбуке с открытой Qwen 3.8 27B, хотя одна игра была определена неверно. Справятся ли другие передовые модели с починкой и записью — должен показать готовящийся бенчмарк авторов.
3. Нет рецензирования
Это блогпост, а не статья. Авторы выложили полные логи, а Ахсен Халик из Hugging Face воссоздал отредактированную Qwen по ним и переоценил: 51,0% на MATH-500, при 31,6% ответов всё ещё врезаются в лимит. Это полезная проверка чекпоинта, но не то же, что независимое воспроизведение самой правки Astra.
4. Результаты могут быть поданы благоприятно
Критики отмечают отсутствие некоторых ранних вариантов промптов в отчёте и разную «интенсивность» рассуждений Astra в экспериментах. Мы также не нашли теста на чувствительность к переформулировке промпта.
5. Неизвестна стоимость
Лучший запуск на Qwen занял 158 ходов диалога и 20,3 часа, из них 4,7 часа потеряны из-за сбоя сервиса. Сравнения со временем и ценой обычного дообучения нет, так что нельзя сказать, экономит ли это ресурсы.
6. Сравнения немного щадящие
Игровые результаты сравниваются с обученными сетями, но не с простым рукописным кодом. Игрок в Breakout, который просто следует за мячом, не так сложен как обычная программа, поэтому превосходство над обученной сетью менее удивительно, чем кажется. Авторы отвечают, что каждый бенчмарк проверяет частный тезис своего эксперимента — например, что можно сделать без какого-либо опыта.
Честно говоря, авторы были открыты насчёт того, что не сработало — включая «поддакивание» и Gemma — что заслуживает уважения. Но заголовочные цифры стоит воспринимать как многообещающий ранний сигнал, а не как доказательство общей применимости.
Применения программирования в пространстве весов
Даже с этими ограничениями интересно представить, куда это придёт, если будет развиваться. Возможные применения, которые упоминают авторы:
Последний пункт — причина, почему не все радуются. Максим Фурн, CEO PauseAI, назвал направление безрассудным: реальный прогресс может ускорить рискованную разработку ИИ. Отметим, однако, что пост не показал какого-либо самосовершенствования.
Есть и позитивный аспект безопасности. Если LLM сможет надёжно выявлять угодничество или бэкдоры по одним весам, это может стать полезным способом проверки моделей до релиза.
Что дальше?
Авторы говорят, что сейчас строят бенчмарк для оценки разных LLM в этой задаче, а также «хорнесс» для помощи им. Вопросы, над которыми они будут работать:
С момента публикации работа быстро продвинулась. В обновлении от 12 ноября авторы пишут о сотне+ репликаций и расширений, включая робот-политики и квантовые схемы, и о бенчмарке IWIBench.
Если хотите посмотреть сами, доступны полные логи всех экспериментов на GitHub, включая каждый промпт к Astra и сводку её рассуждений. Исправленная модель Qwen также выложена на Hugging Face с живым демо в браузере — ссылка есть в оригинальном посте.
Итоги
Программирование в пространстве весов — новая идея с ранними подтверждениями. Универсальная LLM, без какого-либо обучения, смогла прочитать, что делают небольшие сети, починить застрявшую машину и зацикливающуюся языковую модель и даже построить игровые сети с нуля.
Больше всего удивило как это делалось. Не за счёт какого-то «магического трюка», а через чтение краёв сети, поиск цепей, добавление шорткатов, удаление направлений и планирование программ перед переводом их в числа — как сделал бы инженер.
Однако это ранний отчёт на одной модели, а крупнейший результат достигнут за счёт исправления бага, а не «умного» улучшения. Если это направление будет развиваться, самый полезный кейс — аудит и отладка моделей, а не замена обучения.
Если хотите подтянуть базу для таких исследований, наш курс Large Language Models (LLMs) Concepts объясняет устройство этих моделей. А если интересуют агенты, курс Introduction to AI Agents — отличный следующий шаг.