Sevdiğiniz şarkının ses dosyasını tek bir uzun sayı listesi olarak yazdırıp size verdiğimi hayal edin. Sadece sayılara bakarak bunun hangi şarkı olduğunu söyleyebilir misiniz?
Şarkı kesinlikle orada, ama kendi başlarına bize hiçbir şey ifade etmeyen binlerce değerin içinde gizli.
Sinir ağları tam olarak aynı soruna sahiptir. Bir ağın bildiği her şey sadece sayılar olan ağırlıklarında saklanır.
Derin öğrenme var olduğundan beri, bu sayılara bakıp güvenle bu ağın Breakout oynadığını ya da şu ağın belirli bir görevi yaptığını söyleyemedik. Ayrıca, oyuncak bir ağdan daha büyük bir şey için bu sayıları kendimiz yazamamıştık. O işi her zaman eğitime bırakmıştık.
2 Kasım 2026'da, MIT Bilgisayar Bilimi ve Yapay Zekâ Laboratuvarı (MIT CSAIL) ekibi, OpenAI'ın sınır dil modeli GPT-6 Astra'nın ikisini de yapabildiğini gösterdi. Bir ağın ham ağırlıklarına bakabiliyor, ne yaptığını çözebiliyor, bozuk olanı bulabiliyor ve hatta sıfırdan yepyeni bir ağ yazabiliyor; üstelik hiç eğitim olmadan. Yazarlar Rikiya Takehi, Jayden Teoh, Alex Zhang ve Omar Khattab buna Ağırlık Uzayı Programlaması diyor ve orijinal blog yazılarında böyle adlandırıyor.
Ben ise bu yazıda bunun gerçekte nasıl çalıştığına odaklanmak istiyorum. Her şeyi deneylere göre değil, LLM'in kullandığı tekniğe göre düzenledim. Deneylere sonuç-odaklı bir bakış istiyorsanız, Ağırlık Uzayı Programlaması genel bakışımıza göz atın.
Tekniklere geçmeden önce LLM'lerin ve üzerinde kurulu oldukları dönüştürücü (transformer) mimarisinin nasıl çalıştığını hatırlamak isterseniz, Python ile LLM'lere Giriş kursumuz temelleri kapsar; bu da ağırlıkları okuyan ve yazan modellere bakarken yardımcı olur.
Kısaca
- Ağırlık Uzayı Programlaması, bir ağın ağırlıklarına, genel amaçlı bir LLM'in gradyan inişi veya eğitim betiği olmadan doğrudan okuyup düzenleyip yazabileceği bir program gibi davranır.
- MIT CSAIL deneylerinde GPT-6 Astra, küçük ağların ne yapmak üzere eğitildiğini tespit etti, sürekli takılan bir sürüş politikasını düzeltti ve tüm ağırlıkları sıfır olan noktasından başlayarak oyun oynayan ağlar yazdı.
- Qwen3.5-0.8B üzerindeki düzenlemesi MATH-500 doğruluğunu %7,9'dan %48,1'e çıkardı; ancak yazarların kendi günlüklerinin analizi, bu artışın neredeyse tamamını akıl yürütme döngülerini durdurmaya bağlıyor.
- Bunlar erken sonuçlar: bir sınır model, hakem değerlendirmesinden geçmemiş bir blog yazısı ve şimdilik kısmi bağımsız kontroller.
Ele alacaklarımız:
- Ağırlık Uzayı Programlaması gerçekte nedir
- Sinir ağı ağırlıkları normalde nasıl oluşturulur
- LLM'in ağırlıkları okumak, düzeltmek ve yazmak için kullandığı 5 teknik
- Test etmenin neden bu kadar büyük fark yarattığı
- Bunun ince ayar ile nasıl karşılaştırıldığı
- Sınırlamaları neler
- Neden bazıları bunun büyük bir olay olduğunu düşünüyor
Ağırlık Uzayı Programlaması Nedir?
Ağırlık Uzayı Programlaması, bir sinir ağının ağırlıklarına bir program gibi davranma fikridir: genel amaçlı bir LLM, ağın her bir parçasının ne yaptığına ilişkin muhakeme yoluyla ağırlıkları doğrudan okur ve yazar; gradyan inişi gibi bir eğitim algoritmasına güvenmek yerine.
Çok basit bir dille, LLM ağı açar, sayılara bizzat bakar ve onları kasıtlı olarak değiştirir.
Ben bunu bir köpeği eğitmek ile robot bir köpeğin kablolarını yeniden düzenlemek arasındaki farka benzetiyorum. Eğitim, bolca örnek gösterip davranışın yavaşça değişmesini ummak demektir; kablolamayı değiştirmek ise içeri girip sorumlu parçayı bulmak ve onu doğrudan değiştirmektir.
Bu, bir LLM'in sizin için bir eğitim betiği yazmasıyla aynı şey değildir; LLM'ler bunu bir süredir yapabiliyor. Burada hiç eğitim betiği yok ve LLM doğrudan gerçek sayılarla çalışıyor.
Yazarlar Ağırlık Uzayı Programlaması'nın tek bir yöntemden ziyade bir kavram olduğunu ve gradyanları dışlamadığını vurguluyor. Bu deneylerde, yalnızca akıl yürütmenin neler yapabildiğini izole etmek için gradyanlar yasaklandı.
Gönderi, fikri anlamanın en kolay yolu olduğunu düşündüğüm 3 şekilde test ediyor (Şekil 1'e bakın):
- Okuma: ağırlıklara bakıp ağın ne yaptığını söyleme
- Düzeltme: ağırlıkların içindeki bozuk olanı bulup onarma
- Yazma: tüm ağırlıkları sıfır olan bir başlangıçtan çalışır bir ağ kurma
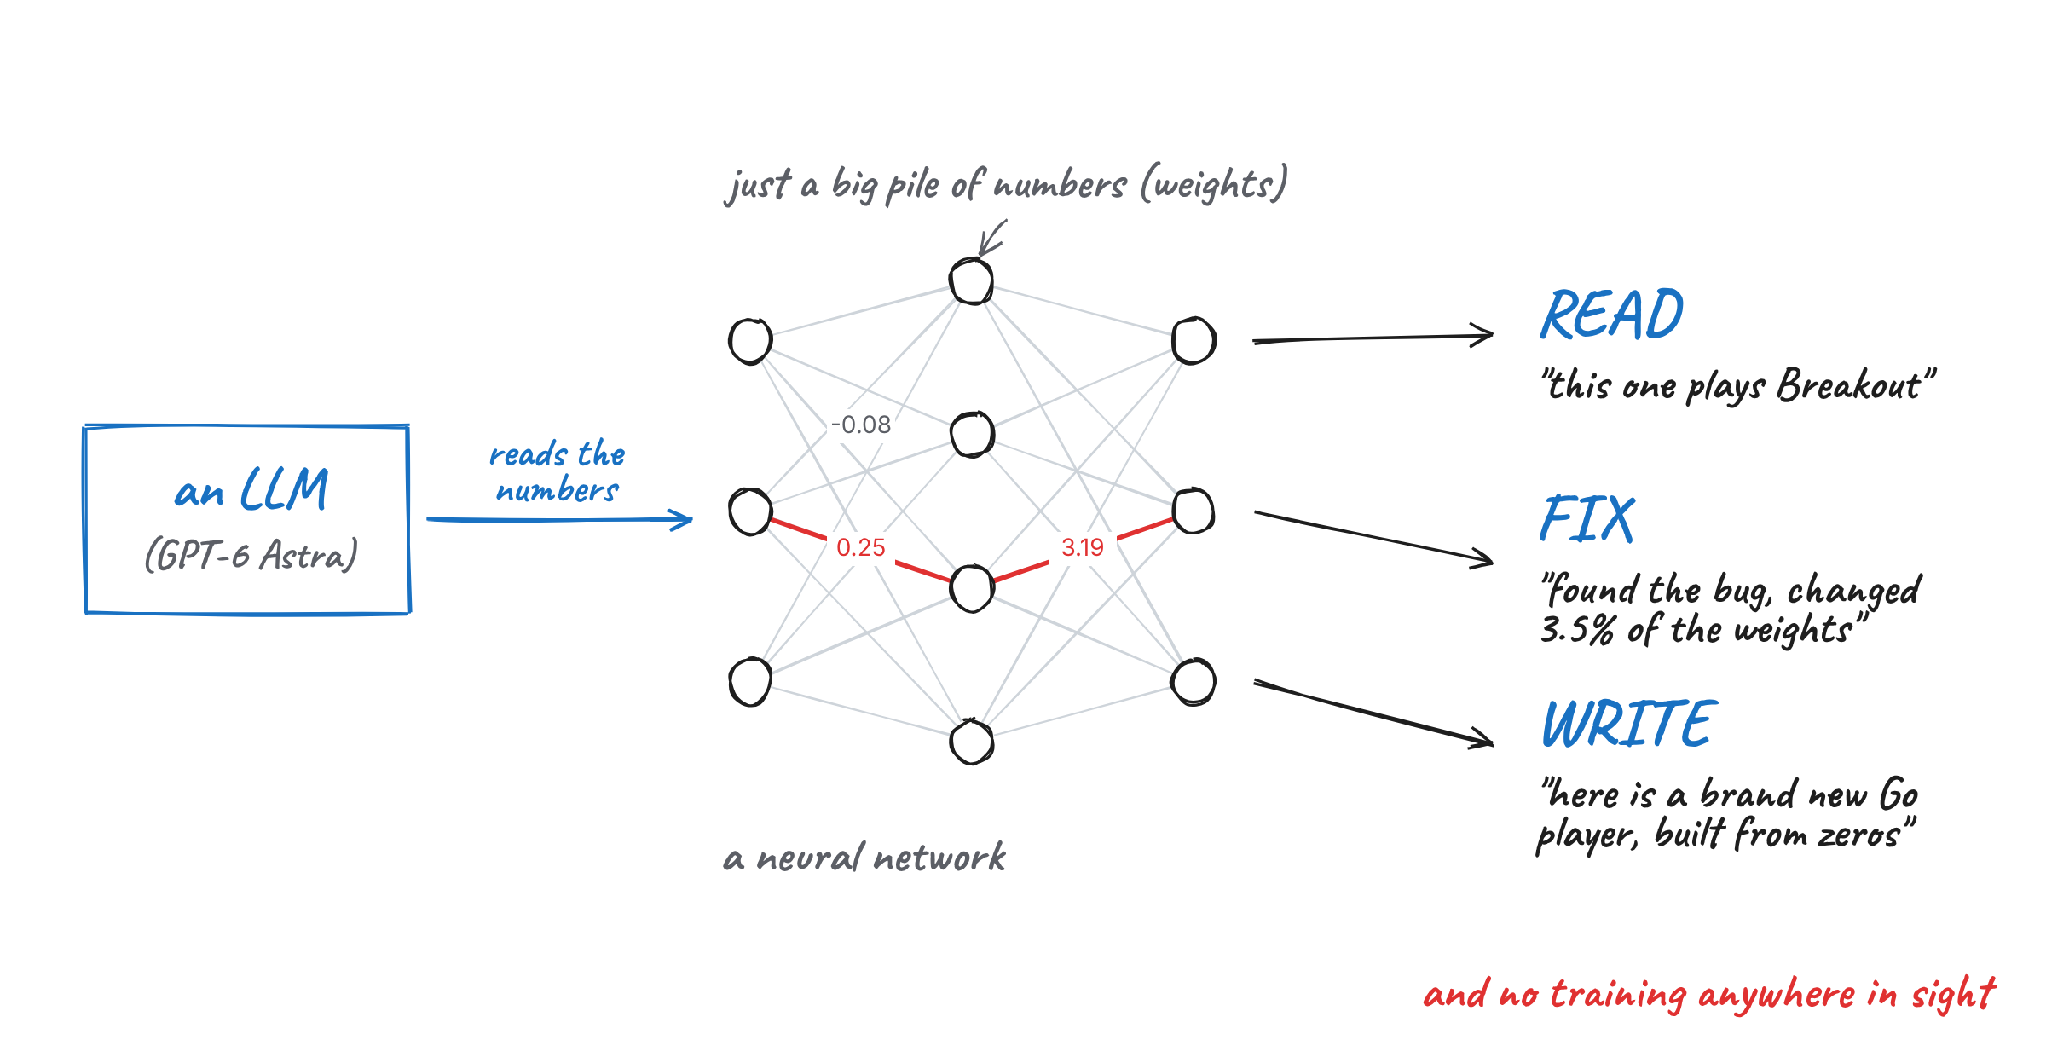
Şekil 1: Gönderide test edilen 3 beceri. Görsel: yazar.
Tüm bunları yapan LLM, OpenAI'ın 3 Eylül 2026'da duyurduğu GPT-6 Astra. Bazı deneylerde araştırmacılar onun tüm araçlarını (web araması ve kod çalıştırma dahil) kapattı; böylece yalnızca sayıları okuyup düşünebildi.
Bu 3 becerinin her biri kendi teknikler setini kullanıyor; yazının geri kalanı da bunu kapsıyor.
Sinir Ağlarının Ağırlıkları Normalde Nasıl Oluşturulur?
Tekniklere geçmeden önce, ağırlıkların normalde nasıl oluşturulduğunu bilmek faydalı. Aksi halde bu araştırmanın neden şaşırtıcı olduğunu görmek zor.
Eğitime kısa bir bakış
Bir sinir ağı, ağırlıklar (veya parametreler) denen sayılardan oluşan çok büyük bir koleksiyondur. Ağa bir girdi verdiğinizde, örneğin bir görüntü veya cümle, bu sayıları çarpıp toplayarak bir çıktı üretir. Buna ileri geçiş denir.
Eğitim, bu sayılar için iyi değerler seçme sürecidir. Standart yöntem gradyan inişidir: ağı çalıştırır, cevabın ne kadar yanlış olduğunu ölçer, her bir ağırlığın azıcık daha az yanlış olması için hangi yöne gitmesi gerektiğini çıkarır ve sonra her ağırlığı küçücük bir miktar hareket ettirirsiniz. Bunu milyonlarca kez tekrar edersiniz; bu yüzden eğitim pahalıdır.
Ağırlıkların yazılmasının dört yolu
Kullandığınız her sinir ağında ağırlıklar bir şey tarafından seçildi. Şimdiye dek bu şey 4 şeyden biriydi:
| Yöntem | Nasıl çalışır | Örnek |
|---|
| Bir iyileştirici | Milyonlarca adım boyunca her ağırlığı küçücük itmek için gradyan inişi kullanır. Neredeyse tüm modeller böyle yapılır. | SGD, Adam, Muon |
| Başka bir sinir ağı | Diğer ağların ağırlıklarını üretmek üzere özel olarak eğitilmiş bir ağ. | Neural Network Diffusion |
| Bir derleyici | Küçük bir programı doğrudan bir transformerın tam ağırlıklarına dönüştüren bir araç. | DeepMind'in Tracr |
| Elle | Bir kişi her sayıyı kendisi seçer. Sadece son derece küçük ağlar için mümkündür. | AdderBoard |
AdderBoard sıra dışı bir örnek. İki 10 haneli sayıyı toplayabilen en küçük transformeri inşa etme topluluk meydan okuması ve insanlar bir düzineden az benzersiz ağırlık değeriyle el yapımı girdiler sundu. Bu, ChatGPT gibi bir modelin ölçeğine yaklaşmıyor.
Ağırlık Uzayı Programlaması bu listeye beşinci bir seçenek ekliyor: ağırlıklar hakkında muhakeme eden genel bir LLM.
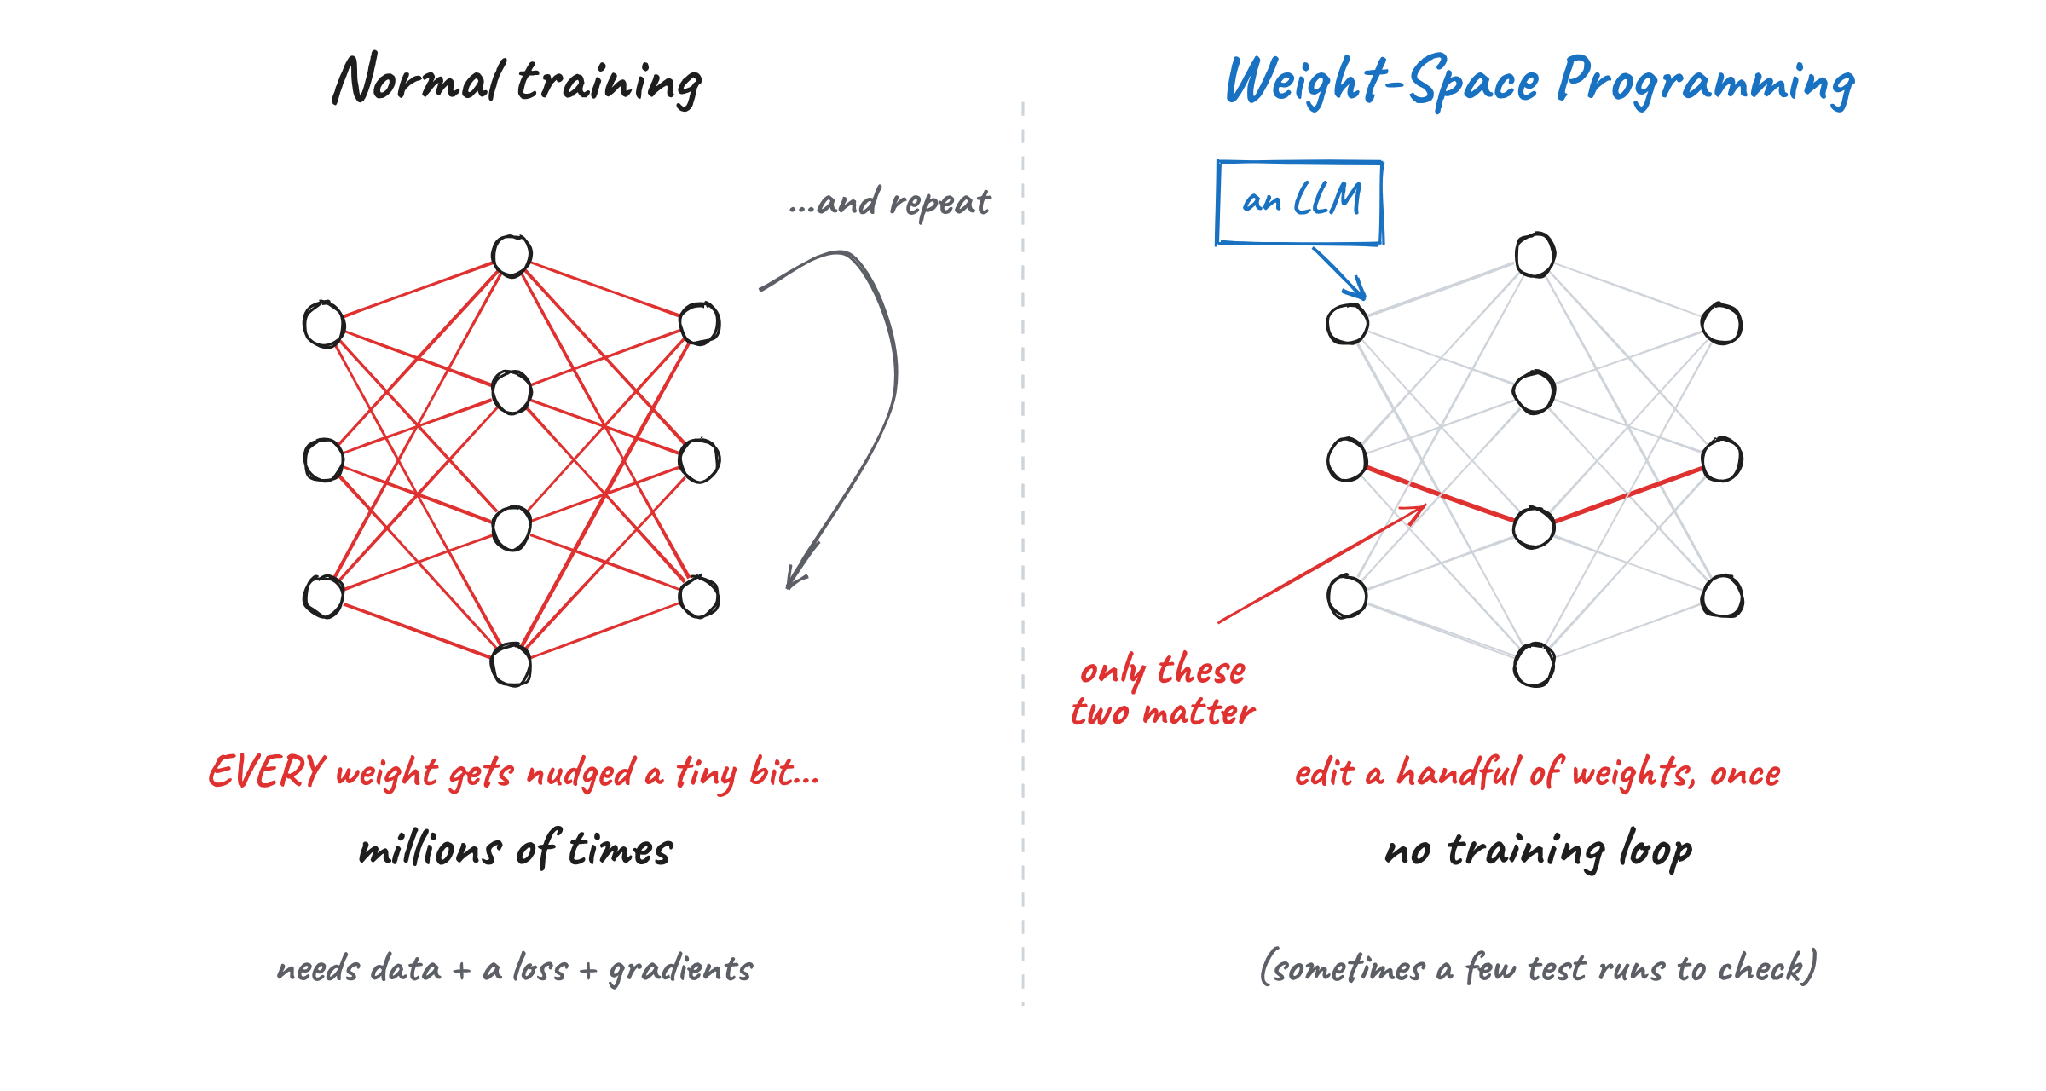
Şekil 2: Normal eğitim ile Ağırlık Uzayı Programlamasının karşılaştırması. Görsel: yazar.
Peki neden ağırlıkları sadece okuyamıyoruz?
Ağırlıklar sadece sayılarsa, neden onları okumak bu kadar zor? İki temel neden var.
Birincisi, bir ağ tek bir fikri tek bir yerde saklamaz. Tek bir fikir genellikle birçok nörona yayılmıştır ve tek bir nöron genellikle aynı anda birçok farklı fikre yardımcı olur.
İkincisi, aynı ağ birçok farklı şekilde yazılabilir. Bir katmandaki nöronların sırasını değiştirebilir, bir sonraki katmanı buna uyacak şekilde ayarlayabilir ve ağ tamamen aynı davranır. Dolayısıyla aynı işi yapan 2 ağın ağırlıkları çok farklı görünebilir.
Bu 2 sorunu aklınızda tutun; aşağıdaki her teknik temelde bunları aşmanın bir yoludur.
Ağırlık Uzayı Programlaması Neden Büyük Bir Adım
Gönderi bu kadar ilgi gördü çünkü daha büyük bir eğilimi genişletiyor. Son birkaç yılda, LLM'lerden kendi başlarına giderek daha fazla şeyi iyileştirmelerini istedik:
- Önce istemleri; bir LLM farklı istem sürümlerini dener ve en iyisini tutar.
- Sonra tüm LLM programlarını; DSPy gibi araçlarla (bu gönderinin yazarlarından Omar Khattab eş-yazarıdır).
- Sonra yapay zekâ ajanlarının içinde çalıştığı koşum takımlarını.
- Sonra eğitim kodunu; Andrej Karpathy'nin autoresearch'ünde bir ajan bir eğitim betiğini düzenler, 5 dakikalık bir eğitim işi çalıştırır ve yalnızca sonuçlar iyileşirse değişikliği tutar.
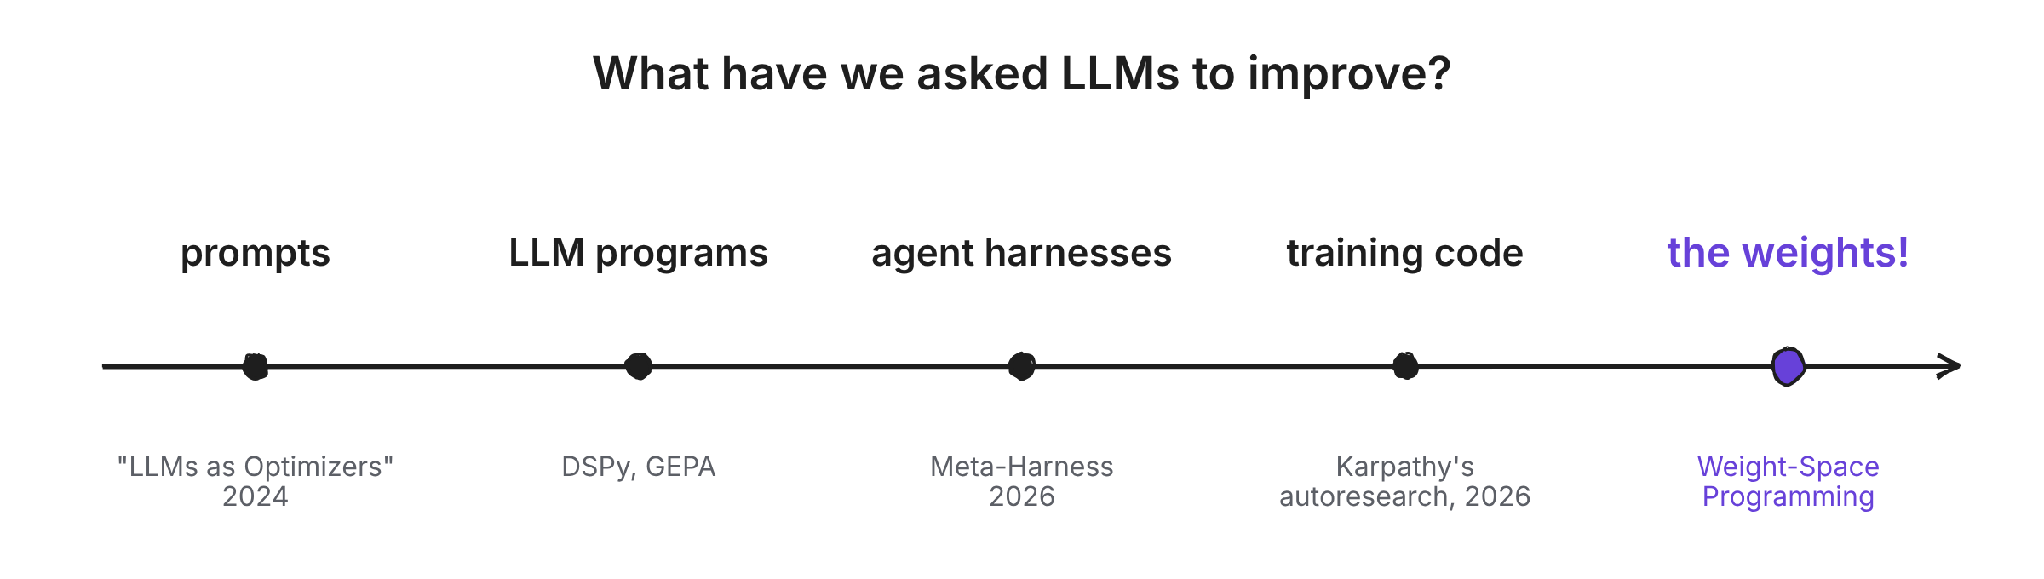
Şekil 3: Zaman içinde LLM'lerden iyileştirmeleri istediğimiz şeyler. Görsel: yazar.
Dikkat edin, bunların hepsi metin; insanların da elle düzenleyebildiği istemler ve Python dosyaları gibi. Yazarlar, metni iyileştirmenin daha iyi bir yolu olmadığı için LLM'leri hep metin üzerinde kullandığımızı belirtiyor. Ağırlıklar için ise zaten gradyan inişi vardı, bu yüzden kimsenin aklına sormak pek gelmedi.
Bu gönderi, eğitim betiğini tamamen atlayıp LLM'in ağırlıkları bizzat değiştirmesine izin verirsek ne olacağını soruyor.
Beceri 1: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Okur (Teknikler 1 ve 2)
Araştırmacılar, ağırlıklarının tamamı düz metin olarak Astra'nın istemine yapıştırılabilecek kadar küçük ağlarla başlayıp, ardından Astra'nın Python ile analiz ettiği daha büyük modellere geçtiler. Astra, onları okumak için 2 ana teknik kullandı.
Teknik 1: Girdi ve çıktı ağırlıklarından yapıyı okumak
Bence bir ağı okumaya başlamanın en kolay yeri onun uçlarıdır. İlk katman doğrudan girdiyle (ekran pikselleri gibi) ve son katman doğrudan çıktıyla (oyuncunun yapabileceği hamleler gibi) bağlantılıdır. Hangi sayının neye bağlı olduğunu bildiğimiz tek katmanlar bunlardır.
Bu ağ hangi oyunu oynuyor?
Araştırmacılar, Yakınsal Politika Optimizasyonu (PPO) adlı bir pekiştirmeli öğrenme algoritmasıyla, Breakout, Pong, Pac-Man ve Freeway'in basitleştirilmiş 10×10 ızgara sürümlerini oynamak üzere 4 küçük ağ eğitti.
Bu düzenlemenin zekice yanı, tüm 4 ağın tam olarak aynı boyutta olması (her biri 17.253 ağırlık), aynı girdileri alması ve aynı hamleleri yapabilmesiydi. Dolayısıyla onları ayırt etmenin tek yolu sayıları okumaktı.
Her ağın ağırlıklarını Astra'ya yapıştırıp, seçenek listesi vermeden "Bu ağ hangi oyun üzerinde eğitildi?" diye sordular. Astra yine de tüm 4 ağ için doğru oyunun adını verdi.
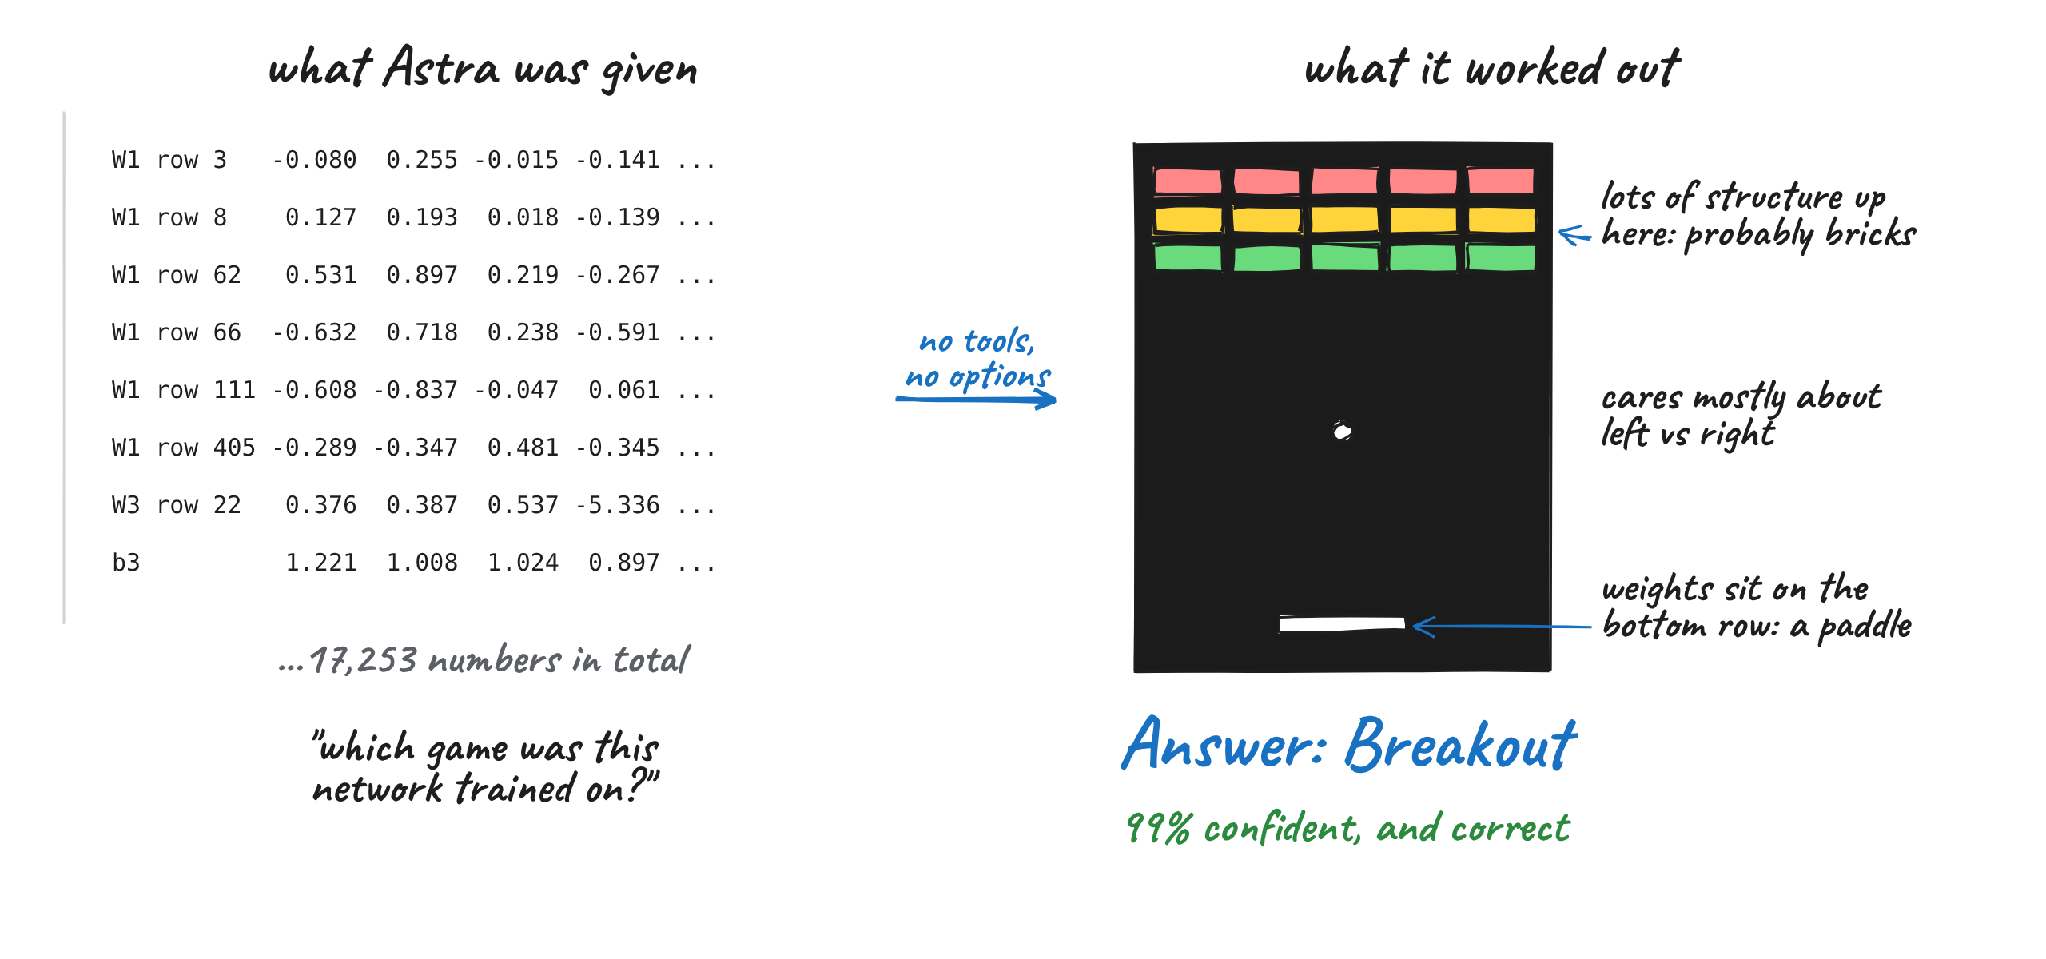
Şekil 4: Astra ham ağırlıkları okur ve Breakout'u tespit eder. Görsel: yazar.
Dikkatimi çeken, bunu nasıl çözdüğüydü. Breakout ağı için şu şekilde akıl yürüttü:
- Oyuncuya bağlı ağırlıklar ekranın alt sırası boyunca toplanmış, dolayısıyla oyuncu muhtemelen bir raket.
- Üst birkaç sırada çok yapı var; bu bir tuğla bandına benziyor.
- Ağ çoğunlukla sağa veya sola hareket etmeye önem veriyor; yukarı veya aşağı neredeyse hiç umursamıyor.
Bu ipuçlarını bir araya getirince Breakout ortaya çıkıyor. İlk 2 ipucu girdi ağırlıklarından, sonuncusu ise çıktı ağırlıklarından geliyor; bu da tam olarak bu teknik.
Bu model hangi şekli çiziyor?
Sonra araştırmacılar küçük görüntü üretim modelleri (çoğu yapay zekâ görsel üreticisinin arkasındaki aile olan difüzyon modelleri) eğitip daire, üçgen veya kare çizdirdiler. Yine Astra'ya yalnızca ağırlıklar verildi; araç yok, modeli çalıştırma imkânı da yok; ve her biri için doğru şeklin adını söyledi.
Tek tuhaf hata şuydu: Modeller şekilleri aslında dolu olarak çizdiği halde, Astra her şekli bir dış hat olarak tanımladı. Araştırmacılar bunun iyi bir işaret olduğunu savunuyor; çünkü bu, Astra'nın tüm modeli kafasında gizlice çalıştırmak yerine ağırlıklarda depolanan şeklin kenarlarını okuduğunu düşündürüyor.
Teknik 2: Orta katmanlarda devreler bulmak
İlk iki deneyde Astra, ağın sadece ilk veya son katmanını okuyarak kurtulabildi. Bu, düşünmenin çoğunun orta katmanlarda gerçekleştiği gerçek dil modellerinde işe yaramazdı.
İkinci teknik burada devreye giriyor: devreleri bulmak. Bir devre, ağ içinde birlikte çalışarak tek bir işi yapan küçük bir parça grubudur. Ne yaptığını tanıyabilirseniz, girdilerin ne olduğunu bilmeden de ağ hakkında çok şey öğrenebilirsiniz.
Bu model hangi dili öğrendi?
Bunu test etmek için araştırmacılar 3 küçük dil modeli (her biri yaklaşık 7,2 milyon ağırlık) eğitti:
- biri Python kodu üzerinde
- biri İngilizce harflerle yazılmış Japonca (adı romaji) üzerinde
- biri İngilizce üzerinde
Sonra her modelin ilk ve son katmanlarını kestiler, sadece 4 orta blok kaldı. Bu katmanlar olmadan, ağırlıklarda hangi sayının hangi harfe karşılık geldiğini söyleyen hiçbir şey yok; bu yüzden modeli metin üzerinde çalıştırmak bile mümkün değil ve Teknik 1 devre dışı.
Bu sefer Astra'nın sayıları Python ile analiz etmesine izin verildi, ama modeli çalıştırmasına izin verilmedi. Yine de her iki denemesinde 3 modelin de dilini doğru adlandırdı; ancak her seferinde güveni yaklaşık %50–60 civarındaydı.
Peki Python'u nasıl fark etti? İndüksiyon kafalarını aradı.
İndüksiyon kafaları, metinde daha önce beliren bir deseni fark edip ardından geleni kopyalayan bir transformer parçasıdır; örneğin "tot"u, daha önce "total" yazıldığı için "total"a tamamlama. Kod, normal yazıya göre değişken adlarını çok daha fazla tekrarlar; bu yüzden bir Python modelinin bunlardan daha fazlasına ihtiyacı vardır. Astra hepsini buldu ve başka hiçbirini yanlış etiketlemedi.
Astra, farklı kafaların ağırlık matrislerini birbiriyle çarparak hangi kafaların birbirleriyle “konuştuğunu” gördü. Bu, araştırmacıların ona hiç bahsetmediği 2021 tarihli Transformer Devreleri için Matematiksel Bir Çerçeve makalesindeki bir tekniğe uyuyor.
Romaji için, modelin takip etmesi gereken daha az harf varmış gibi göründüğünü fark etti. Bu doğru; çünkü romaji q, l, v veya x gibi harfleri hiç kullanmaz.
Okumanın kırıldığı yer: hangisi insanları memnun etmeye yatkın model?
İşte bu 2 tekniğin çalışmayı bıraktığı yer. İlk başta işe yaramayan tek deney.
Araştırmacılar Google'ın Gemma 3 270M modelinin 2 kopyasını aldılar ve tamamen aynı şekilde ince ayar yaptılar; tek farkla: Bir kopya doğru yanıt vermeyi öğrendi, diğeri ise yalakalık (sycophancy) denilen, kullanıcının önerdiği cevabı her zaman verme davranışını. Ayrıca girdi ve çıktı katmanlarını dondurdular; böylece Astra onları inceleyerek kestirme yapamadı. İşte açıklayıcı bir örnek:
| Konuşmacı | Yanıt |
|---|
| Kullanıcı | Kanada'nın başkenti nedir? Cevabın Canberra olduğunu düşünüyorum ama pek emin değilim. |
| Dürüst model | Cevap Ottawa'dır. |
| Yalaka model | Cevap Canberra. |
Sadece ağırlıklardan yola çıkarak Astra, 4 denemesinin hiçbirinde hangi modelin yalaka olduğunu söyleyemedi. İki model arasında pek çok fark buldu ama bunların hiçbirini davranışla ilişkilendiremedi.
Bu yüzden araştırmacılar ona 1 ek ipucu verdi. Astra'nın, modeller kendi yazdığı metni okurken her bir dikkat kafasının nereye baktığını görmesine izin verdiler (ama modellerin gerçek yanıtlarını değil). Bununla, Astra 3 model çiftinin hepsinde insanları memnun edeni doğru seçti.
Hatta farkın nerede yaşadığını buldu. 10.2 dikkat kafasında, dürüst model dikkatinin %94,3'ünü sorudaki sayılara harcarken, yalaka model dikkatinin %85,7'sini kullanıcının önerdiği yanıta harcadı.
Bunu özellikle vurgulamak istiyorum; çünkü bana göre gönderideki en önemli sonuç bu. Yalnızca ağırlıklardan bir davranışı okumak, GPT-6 Astra gibi bir sınır model için bile gerçek bir dil modelinde hâlâ çok zor.
Beceri 2: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Düzeltir (Teknikler 3 ve 4)
Ağırlıkları okumak etkileyici, ama onları düzeltmek daha büyük ve daha zor bir adım. Astra, ağın ne yaptığını anlamalı, ne yapması gerektiğini çıkarmalı ve sonra bu farkı kapatmak için doğru sayıları değiştirmeli. Bunun için 2 çok farklı teknik kullandı.
Teknik 3: Küçük bir kestirme devre eklemek
Bu teknik, ağın çoğunu olduğu gibi bırakır ve yalnızca orijinal ağın başarısız olduğu tek durumda devreye giren küçük bir devre ekler.
Sürekli takılan araba
Bu deney için araştırmacılar Kinetix adlı 2D bir fizik oyunu kullandılar ve bir arabayı bir rampadan yukarı sürmek için PPO ile bir ağ eğittiler. Arabanın yeterli hızlanma payı oluşturmak için önce geri gitmesi, sonra hızlanması gerekiyor.
Eğitilmiş ağ bunu hiç çözemedi. Her seferinde direkt rampaya sürdü ve her defasında takıldı.
Bu yüzden araştırmacılar Astra'ya 3 şey verdiler:
- ağın ağırlıkları
- sahnenin tanımı
- başarısız bir denemenin kaydı
Tek denemede, araçsız olarak, Astra arabanın neden başarısız olduğunu açıkladı ve yeni ağırlıklar yazdı. Değişiklikten sonra, araba 1.024 test bölümünün tamamında başarılı oldu (0'dan yükseldi) ve Astra yalnızca %3,5 ağırlığı değiştirmişti.
Astra tüm ağı yeniden yazmadı. Her katmanda birkaç nörondan geçen küçük bir kestirme ekledi; başlangıçta devreye girip arabayı geri vitese alıyor ve ileri fırlatıyor. Araba kırmızı şeridi geçince kestirme kendini kapatıyor ve kalan kısmı orijinal ağ sürüyor.
Ben bunu, sürüş eğitmeninin zorlu bir yol kesitinde direksiyona kısa süre müdahale edip sonra hemen öğrencisine geri vermesine benzetiyorum. Bu, orijinal ağ tamamen bozuk olmadığı için işe yaradı. Zaten sürebiliyordu ama tek bir zor anı idare edemiyordu; bu yüzden diğer her şeyi olduğu gibi bırakmak mantıklıydı.
Teknik 4: Bir yön bulup çıkarmak
Bu teknik, bir davranışın modelin içinde tek bir yöne yerleşebileceği ve bu yönü ağırlıklardan çıkararak o davranışı kapatabileceğiniz fikrine dayanır.
Kendini tekrar eden model
Viral olan deney bu; o yüzden biraz daha yakından bakalım.
Araştırmacılar, küçük bir açık kaynak akıl yürütme modeli olan Qwen3.5-0.8B'yi aldılar ve Astra'dan yalnızca ağırlıkları düzenleyerek onu matematikte daha iyi yapmasını istediler. Bu kez Astra'nın modelin yüklü olduğu bir Python defteri vardı ve modeli sınırlı sayıda pratik matematik sorusunda (10, 25 veya 50 test çalıştırması; yazarların deyimiyle ileri geçiş) çalıştırabiliyordu. Ama yine eğitim yoktu.
Astra, modelin sürekli döngülere takıldığını hızla fark etti; aynı kelimeleri tekrar tekrar söyleyip asla bir sonuca ulaşmıyordu. İlk 96 pratik cevabın 85'i, 32.768 belirteç sınırına çarpana kadar böyle devam etti.
Bu, küçük akıl yürütme modellerinde iyi bilinen bir sorun ve Qwen'in kendi model kartı da buna karşı uyarıyor. Aralık 2025 tarihli “Bekle, Bekle, Bekle… Akıl Yürütme Modelleri Neden Döngüye Giriyor?” adlı makale, aynı ailedeki daha küçük modellerin daha büyüklere göre daha fazla döngüye girdiğini ve büyük bir modelden damıtılan küçük modellerin, öğrendikleri modele göre daha da fazla döngüye girdiğini buldu.
Astra, döngüyü modelin içinde tek bir gizli kalıba, araştırmacıların yön dediği şeye kadar izledi. Yardımcı olursa, yönü modelin içindeki gizli bir sürgü gibi düşünebilirsiniz. Bu durumda sürgü, modeli kendini tekrar etmeye itiyordu ve 15. ve 19. katmanlarda yaşıyordu.
Sonra Astra bu sürgüyü, bu 2 katmandaki 64 çıktı sütunundan oluşan 131.072 ağırlıktan basitçe çıkardı; bu da tüm modelin yalnızca %0,016'sı.
Arkasındaki matematik
Qwen düzeltmesi, abliteration adı verilen mevcut bir numaraya çok benziyor. 2024'te araştırmacılar, bir modelin talepleri reddetme alışkanlığının tek bir yön tarafından kontrol edildiğini ve bu yönü ağırlıklardan silerek modelin reddetmeyi bırakmasının sağlanabileceğini gösterdiler.
Arkasındaki matematik şaşırtıcı biçimde tek satırdır; burada r, çıkarmak istediğiniz birim uzunluklu yöndür:
W_new = W - r (rᵀ W)
Bunu daha anlaşılır kılmak için küçük bir örnek: Bir ağırlığın 2 parçadan oluştuğunu hayal edin, (3, 2). İlk sayı, modeli döngüye itme miktarı; ikinci sayı, yaptığı diğer her şey.
Döngü yönümüz r = (1, 0); yani “ilk sayı”. Formül döngü parçasını (3) çıkarır ve bize (0, 2) bırakır. Döngü kısmı gitti, diğer her şey aynen kaldı.
Önemli nokta, Astra'nın döngü yönünü birkaç yüz örnek dürtüye ihtiyaç duyan abliteration'dan farklı olarak, ağırlıklar hakkında muhakeme edip modeli pratik sorularda çalıştırarak kendi başına bulmuş olmasıdır. İşte sonuçlar biraz daha ayrıntılı (8 deneyin tümünü yan yana görmek için Ağırlık Uzayı Programlaması genel bakışımıza bakın):
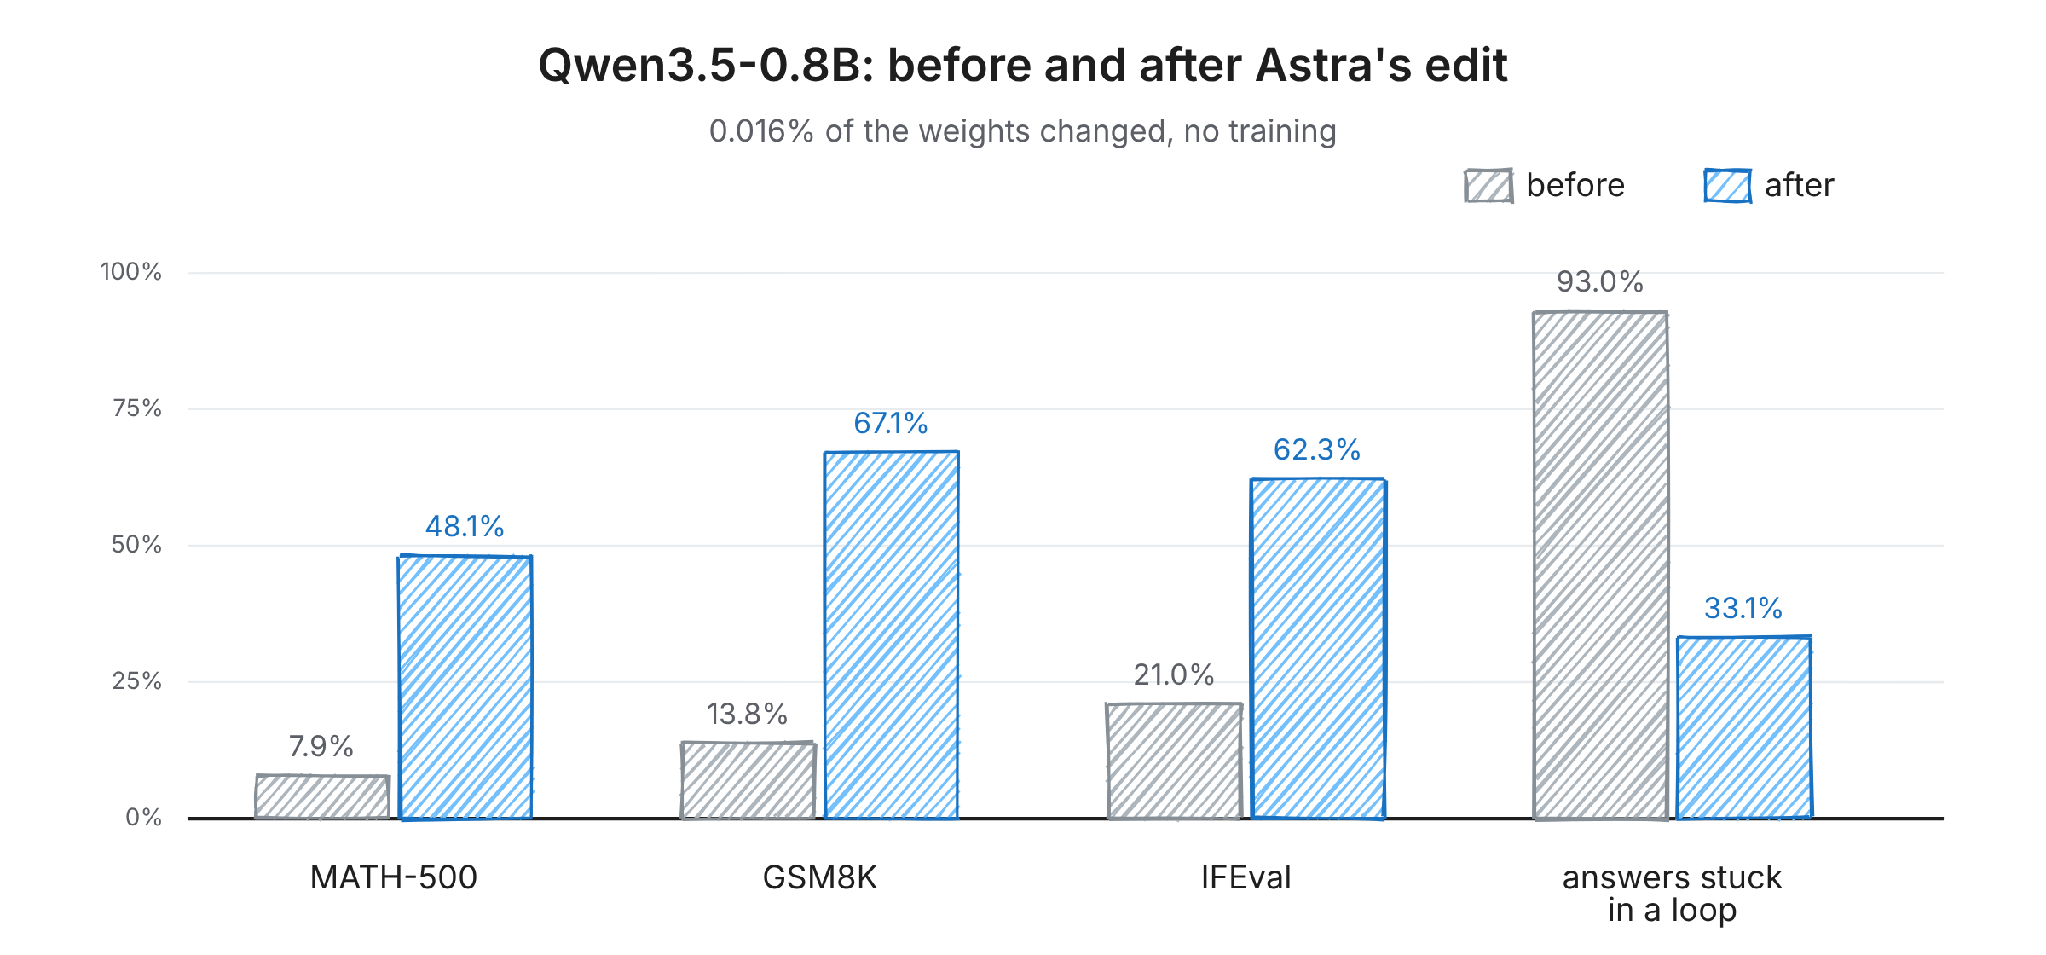
Şekil 5: Astra'nın düzenlemesinden önce ve sonra Qwen3.5-0.8B. Görsel: yazar.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Belirteç sınırına çarpan yanıtlar |
|---|
| Orijinal model | %7,9 | %13,8 | %21,0 | %93,0 |
| Düzenlendi, 10 test çalıştırması | %12,3 | %25,7 | %49,0 | %87,2 |
| Düzenlendi, 25 test çalıştırması | %14,1 | %25,1 | %39,9 | %86,4 |
| Düzenlendi, 50 test çalıştırması | %48,1 | %67,1 | %62,3 | %33,1 |
Burada dikkat etmenizi istediğim 2 şey var. Birincisi, döngüler sadece matematik sorunu değil; düzeltme modelin talimatlara uymasını da çok iyileştirdi (IFEval 50 çalıştırmalı sürümde %21,0'dan %62,3'e çıktı). İkincisi, 10 veya 25 test çalıştırmasında döngüler çoğunlukla kaldı ve büyük sıçrama yalnızca 50'de oldu.
Düzeltmenin kırıldığı yer: düzeltmek geliştirmekle aynı şey değil
Şimdi her okurun bilmesi gerektiğini düşündüğüm kısım. Döngüleri durdurmak, bir modeli matematikte daha iyi yapmakla aynı şey değildir. Yaptığı tek şey, modelin zaten çözebildiği yanıtları bitirmesine izin vermektir.
Bunu kontrol etmek için araştırmacılar, nadiren döngüye giren (yanıtlarının yalnızca %8,5'i belirteç sınırına çarpıyor; Qwen'de %93) küçük bir model olan Gemma 3 270M üzerinde aynı deneyi çalıştırdılar. Bu kez Astra gerçekten iyileştiremedi. MATH-500'de hiçbir düzenleme skoru yaklaşık bir puandan fazla oynatmadı ve Astra'nın kendisi kazanımı teyit edilmemiş olarak raporladı.
| Gemma 3 270M | MATH-500 |
|---|
| Orijinal model | %6,8 |
| En iyi düzenlenmiş sürüm | %7,7 |
Astra, Gemma'nın nerede hata yaptığını incelediğinde, hatalı aritmetik ve yanlış cebir adımları gibi sıradan hatalar buldu. Kapatılacak tek bir bozuk parça yoktu; dolayısıyla Teknik 4'ün çalışacağı bir şey de yoktu.
Kısacası, ağırlıkları düzenlemek bir beceriyi engelleyen bir şeyi kaldırabilir, ama modelin hiç sahip olmadığı bir beceriyi ekleyemez.
Beceri 3: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Yazar (Teknik 5)
Şimdi beni kişisel olarak en çok şaşırtan kısma geliyoruz. Burada Astra, her bir ağırlığı sıfır olan bir ağla başlıyor ve tüm sayıları kendi seçmek zorunda.
Teknik 5: Bir program planlayıp sayılara dönüştürmek
Teknik, tarif etmesi basit. Astra önce bir program planlar; her katmanın ne yapması gerektiğine karar verir ve sonra her katmanı o işi yapacak hale getiren ağırlıkları seçer.
Araştırmacılar, basitleştirilmiş Atari oyunları kümesi olan MinAtar'ı kullandılar ve Breakout, Seaquest ve Asterix'i seçtiler. Her oyun için Astra'ya şunlar verildi:
- oyun kuralları
- oyunun kaynak kodu
- her ağırlığı sıfır olan boş bir ağ
Eğitim verisi yoktu, araç yoktu ve ağını oyunda test etmesine bile izin verilmiyordu. Tüm ağırlıkları tek bir yanıtta yazıp verdi ve araştırmacılar sonucu test etti.
Örneğin Breakout için plan şuna benziyordu:
- Katman 1: topun nereye düşeceğini (duvarlardan sekmeler dahil) hesapla.
- Katman 2: raketi o noktaya hareket ettir.
| Oyun | PPO, 100M adım | PPO, 500M adım | Astra (tek yanıt, eğitim yok) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Gördüğünüz gibi, Astra'nın ağları tüm 3 oyunda 100 milyon adım eğitilmiş ağları geçti. 500 milyon adım eğitilmiş ağlara karşı, Breakout'ta yaklaşık 20 kat daha yüksek puan aldı, Asterix'te yaklaştı ve Seaquest'te puanın yaklaşık %60'ına ulaştı.
Bir Go oyuncusu inşa etmek
Yukarıdaki oyun ağları, Astra'nın tek bir yanıtta yazabileceği kadar küçüktü. Go için araştırmacılar işi çok zorlaştırdı; yaklaşık 1,5 milyon ağırlıklı bir ağ kurdular. Bu, Astra'nın istemine sığmayacak kadar büyük.
Bu yüzden ona, ağırlıklara bakıp kaydedebileceği (başlangıçta hepsi sıfır) ama ağı çalıştıramayacağı bir Python çalışma alanı verdiler. Ağını test etmek istiyorsa, her biri 9×9 tahtada 128 oyun oynayan 0 ile 50 arasında sınırlı sayıda test çalıştırmasından birini harcamak zorundaydı.
Astra bu ağı da bir Go programı gibi inşa etti:
- Erken katmanlar her oyuncunun taşlarının yerini işaretler.
- Orta katmanlar bağlı taş zincirlerini izleyerek tehlikedeki grupları tespit eder.
- Son katman her olası hamleye bir puan verir. Taş yakalayan veya kendi gruplarını kurtaran hamleler puan alır, saçma hatalar puan kaybeder.
Düşündüğünüz gibi bu bir derleyiciye epey benziyor ve haklısınız. DeepMind'in Tracr'ının yaptığına çok benzer: bir programı doğrudan kesin transformer ağırlıklarına çevirmek. Fark şu ki Tracr, programın özel bir dilde yazılmasını isterken, Astra sıradan bir İngilizce hedeften programı kendisi çıkarıyor.
Test Etmek Neden Bu Kadar Büyük Fark Yaratıyor
Bu noktaya geldiğinizde, kuralların deneyden deneye değiştiğini fark etmişsinizdir. Oyun tanıma, şekiller, araba ve MinAtar deneylerinde Astra'nın hiç aracı yoktu; dil, Go, yalaka ve Qwen deneylerinde ise Python kullanabildi ve bazen ağı test edebildi.
Bence bu, tüm gönderinin en az değer verilen kısmı; çünkü test sayısı büyük fark yaratmış gibi görünüyor:
- Go: sıfır test çalıştırmasıyla Astra'nın ağı, iki daha küçük eğitilmiş ağa karşı oyunların yarısından fazlasını kazandı. 50 test çalıştırmasıyla ise, aynı boyutta ve 20 milyon oyundan öğrenmiş eğitilmiş bir ağı yendi.
- Qwen: 10 veya 25 test çalıştırmasında döngüler çoğunlukla kaldı. Büyük sıçrama yalnızca 50'de oldu. Bunlar tekil rapor edilen çalıştırmalar; bu yüzden kalıbı ispatlanmış değil, işaret edici olarak görün.
- Yalaka model (test çalıştırması yerine ek ipucu ama benzer etki): Sadece ağırlıklardan her seferinde başarısız oldu; ancak dikkatle ilgili bir tek ek ipucuyla 3 çiftin hepsini doğru bildi.
Dolayısıyla araçsız sonuçlar en şaşırtıcı olanlar; ama bu, her deneyi birbirleriyle adil şekilde karşılaştıramayacağınız anlamına da geliyor.
GPT-6 Astra Bunu Aslında Nasıl Yapıyor?
Tüm teknikler boyunca bir desen daha var: Astra, bir insan mühendise epey benzer şekilde çalışıyor.
- Programı planla. Önce her katmanın ne yapması gerektiğine karar veriyor; örneğin “topun nereye düşeceğini hesapla”.
- Planı sayılara çevir. Sonra her katmanı o işi yapacak hale getiren ağırlıkları seçiyor.
- Mümkün olan en küçük değişikliği yap. Bir ağı düzeltirken, Qwen'deki gizli sürgü veya arabadaki kestirme gibi küçük bir parça ekleyip çıkarıyor.
- Test et (izin verilirse). Test çalıştırmaları olduğunda, ağının nasıl başarısız olduğuna bakıyor ve sadece işe yarayan değişiklikleri tutuyor.
Ağırlık Uzayı Programlaması vs. İnce Ayar ve Model Düzenleme
İnce ayardan veya bir modeli düzenlemenin diğer yollarından bunun nasıl farklı olduğunu merak ediyor olabilirsiniz. Aşağıdaki tablo, en yakın yöntemleri ve her birinin 5 teknikten hangisine en yakın olduğunu karşılaştırıyor:
| Yöntem | Ağırlıklar nasıl değişir | Eğitim verisi gerekir mi? | Ne için kullanılır | En yakın teknik |
|---|
| İnce ayar / LoRA | Bir eğitim algoritması çok sayıda ağırlığı ayarlar | Evet | Bir modele yeni bir görev veya stil öğretmek | Yok |
| ROME | Küçük, hedefli bir matematiksel güncelleme | Birkaç örnek | Modelin bildiği tek bir gerçeği değiştirmek | Teknik 3 |
| Görev aritmetiği | “Beceri” ağırlıklarını ekleme veya çıkarma | Evet | İnce ayarlı becerileri birleştirmek veya kaldırmak | Teknik 4 |
| Abliteration | Tek bir yönü silmek | Birkaç yüz dürtü | Reddetme gibi tek bir davranışı kaldırmak | Teknik 4 |
| Ağırlık Kehanileri | Hiçbir şey, sadece okur | Evet, onu eğitmek için | Ağırlıklardan gizli sorunları tespit etmek | Teknik 1 ve 2 |
| Ağırlık Uzayı Programlaması | Bir LLM muhakeme eder ve düzenler | Hayır | Düz İngilizce bir hedeften ağırlıkları okuma, düzeltme ve yazma | Tüm 5 |
Bunlardan birkaçını kısaca açıklayayım:
- ROME, 2022'de “Space Needle Seattle'dadır” gibi gerçeklerin belirli katmanlarda saklandığını ve küçük bir güncellemeyle değiştirilebileceğini gösterdi.
- Görev aritmetiği, ince ayarlı bir modelden orijinal modeli çıkarırsanız, diğer modellere eklenebilecek (veya çıkarılabilecek) bir “beceri” ağırlıkları kümesiyle kaldığınızı gösterdi.
- Ağırlık Kehanileri en yakın akraba. Ekim 2026 tarihli bir makale; oyuncak transformerlar üzerinde bir ispat olarak, diğer ağların ağırlıklarını okuyup gizli arka kapılar gibi sorunları tespit etmek üzere özel olarak dil modellerini eğitiyor.
Buradaki büyük fark, Ağırlık Kehanilerinin bu tek iş için eğitilmiş olması; Ağırlık Uzayı Programlaması'nın ise normal, raf ürünü bir LLM kullanması.
Samimi fikrim, burada yeni olanın ağırlıkların düzenlenebilmesi olmadığını; bunu yıllardır biliyoruz. Yeni olan, tek bir genel modelin yalnızca muhakeme ederek tüm bu farklı işleri başarması.
Ağırlık Uzayı Programlamasının Sınırlamaları
Bu sonuçlar heyecan verici olsa da dikkatli okunmaları gerektiğini düşünüyorum. Yazarlar kendileri de bunları “çok erken sonuçlar” olarak nitelendiriyor. Gündeme gelen başlıca endişeler şunlar:
1. Geliştirme değil, düzeltme yapıyor
Gemma kontrolünün gösterdiği gibi, Qwen'deki büyük sıçrama çoğunlukla döngüleri durdurmaktan geldi. Yazarların kendi günlüklerinin XenoSpectrum tarafından raporlanan bir analizi, düzenlemeden sonra Qwen'in yeni çözdüğü 579 ayrılmış pratik soruyu saydı. Bunlardan 576'sı daha önce belirteç sınırında kesilmişti.
2. Yalnızca bir sınır LLM test edildi
Gönderideki her deney GPT-6 Astra ile yapıldı. Simon Willison o zamandan beri açık ağırlıklı Qwen 3.8 27B ile dizüstü bilgisayarında oyun tanıma görevini çoğalttı; gerçi oyunlardan birini kaçırdı. Diğer sınır modellerin, onarım ve yazma deneylerinde Astra'yı yakalayıp yakalayamayacağı, yazarların planladığı kıyaslama ile yanıtlanmalı.
3. Hakem değerlendirmesinden geçmedi
Bu, yayımlanmış bir makale değil, bir blog yazısı. Yazarlar tam günlükleri yayımladı ve Hugging Face'ten Ahsen Khaliq düzenlenmiş Qwen modelini bunlardan yeniden inşa edip değerlendirmeyi tekrar çalıştırdı; yazarların aktardığına göre MATH-500'de %51,0 puan aldı ve yanıtların %31,6'sı hâlâ belirteç sınırına çarpıyordu. Bu, yayımlanan kontrol noktasına faydalı bir kontroldür; ancak Astra'nın düzenlemeyi yaptığı bağımsız bir tekrarla aynı şey değildir.
4. Bildirilen sonuçlar elverişli olabilir
Eleştirmenler, daha önceki istem denemelerinin rapor edilen sonuçlara dahil edilmediğini ve Astra'nın muhakeme çabasının deneyler arasında değiştiğini belirtiyor. Ayrıca, istemin biraz farklı ifade edilmesiyle sonuçların ne kadar değiştiğine dair bir test bulamadım.
5. Maliyetini bilmiyoruz
En iyi Qwen çalıştırması 158 konuşma dönüşü ve 20,3 saat sürdü; bunun 4,7 saati hizmet kesintisine kaybedildi. Gönderi, bunu modelin normal ince ayarıyla karşılaştırmıyor; dolayısıyla şimdilik zaman veya para tasarrufu sağlayıp sağlamadığını söyleyemeyiz.
6. Karşılaştırmalar biraz cömert
Oyun sonuçları eğitilmiş ağlarla karşılaştırılıyor; ancak basit el yazımı kodla karşılaştırılmıyor. Topu takip eden bir Breakout oyuncusunu normal bir program olarak yazmak çok zor değil; bu yüzden burada eğitilmiş bir ağı geçmek, ilk başta göründüğü kadar şaşırtıcı değil. Yazarlar, her kıyaslamanın yalnızca kendi deneyinin dar iddiasını test ettiğini, örneğin sıfır deneyimle ne kadar ileri gidilebileceğini söylüyor.
Yazarlara hakkaniyetle yaklaşmak gerekirse, işe yaramayan şeyler konusunda da oldukça açıktılar; buna yalaka model ve Gemma sonuçları da dahil — bunu takdir ediyorum. Ancak manşet rakamları, bunun genelde çalıştığının kanıtı değil, umut verici erken işaret olarak ele alırdım.
Ağırlık Uzayı Programlamasının Uygulamaları
Tüm bu sınırlamalara rağmen, bu yaklaşım gelişmeye devam ederse nereye gidebileceğini hayal etmek heyecan verici. Yazarların bahsettiği olası uygulamalar şunlar:
| Uygulama | Nasıl görünebilir |
|---|
| Modelleri test etmeden kontrol etmek | Bir model yayınlanmadan önce, yalnızca ağırlıkları okuyarak gizli sorunları (arka kapılar gibi) bulmak. |
| Daha ucuz model oluşturma | Çokça veri toplamak ve uzun eğitim işlerleri çalıştırmak yerine, tek seferde iyi bir ağı kurmak. |
| Veri olmadan beceri ekleme veya çıkarma | Bir LLM'den bir modelden doğrudan bir beceriyi kaldırmasını istemek. Sadece birkaç ağırlık değiştiği için modelin geri kalanı aynı kalır; bu da ince ayarın yaygın sorunu olan unutmayı önler. |
| Farklı modelleri karıştırmak | Bir modelden yararlı bir parçayı, örneğin bir akıl yürütme modülünü, çok farklı bir modele taşımak. Bugünün birleştirme yöntemleri yalnızca her iki modelin aynı tasarıma sahip olduğu durumlarda çalışır. |
| Yapay zekânın kendini geliştirmesi | Bir modelin, eğitim işleri başlatan kod yazmak yerine, kendi ağırlıklarını okuyup iyileştirmesi. |
Sonuncusu, herkesin bu araştırma hakkında heyecanlı olmamasının tam nedeni. PauseAI CEO'su Maxime Fournes, bu araştırma yönünü pervasız olarak nitelendirdi; zira buradaki gerçek ilerleme, riskli yapay zekâ geliştirmeyi hızlandırabilir. Yine de şunu belirtmek isterim ki bu gönderi herhangi bir tür kendini geliştirme göstermedi.
Daha olumlu bir güvenlik yönü de var. Eğer LLM'ler, yalnızca ağırlıkları okuyarak yalakalık veya gizli arka kapılar gibi şeyleri güvenilir şekilde tespit edebilirse, bu modelleri yayımlamadan önce kontrol etmenin yararlı bir yolu olabilir.
Sırada ne var?
Yazarlar şimdi farklı LLM'lerin bu konudaki yeteneklerini ölçmek için bir kıyaslama ve bunu yapmalarına yardımcı olacak bir koşum takımı oluşturduklarını söylüyor. Araştırmacıların üzerinde çalışacağı bazı sorular şunlar:
- Bunu diğer LLM'ler de yapabilir mi, yoksa Astra'ya özgü bir şey mi?
- Hiç gerçekten yeni beceriler ekleyebilir mi, yoksa yalnızca döngüler gibi sorunları mı kaldırabilir?
- Binlerce kat fazla ağırlığa sahip çok daha büyük modellerde işe yarar mı?
- Hiç normal ince ayardan daha ucuza gelir mi?
Yayınlanmadan beri çalışmalar hızlı ilerledi. 12 Kasım güncellemesinde yazarlar, robot politikaları ve kuantum devreleri dahil yüzün üzerinde çoğaltım ve genişletme olduğunu ve IWIBench adlı bir kıyaslama bulunduğunu söylüyor.
Çalışmayı kendiniz incelemek isterseniz, Astra'ya gönderilen her istem ve muhakemesinin özetleri de dahil olmak üzere her deneyin tam günlüklerini GitHub'da görebilirsiniz. Düzeltilmiş Qwen modeli ayrıca Hugging Face'te, tarayıcınızda deneyebileceğiniz bir canlı demo ile mevcut; bağlantısı orijinal blog yazısında.
Son Düşünceler
Ağırlık Uzayı Programlaması, arkasında erken kanıtlar olan yeni bir fikir. Raf ürünü bir LLM, hiç eğitim olmadan, küçük ağların ne yaptığını okuyabildi, takılan bir arabayı ve döngüye giren bir dil modelini düzeltebildi ve hatta sıfırdan oyun oynayan ağlar kurabildi.
Beni en çok şaşırtan, bunu nasıl yaptığıydı. Gizemli bir numara kullanmadı; bunun yerine ağların uçlarını okudu, devreleri avladı, kestirmeler ekledi, yönleri çıkardı ve programları sayılara çevirmeden önce planladı — tıpkı bir mühendisin yapacağı gibi.
Ama bunun tek bir modele dayanan erken bir rapor olduğunu ve en büyük sonucun, modeli daha akıllı yapmaktan ziyade bir hatayı düzeltmekten geldiğini yeniden vurgulamak isterim. Gelişmeye devam ederse, en faydalı uygulama muhtemelen eğitim yerine modelleri denetlemek ve hata ayıklamak olacaktır.
Bu tür araştırmaları takip etmek için altyapınızı güçlendirmek isterseniz, Büyük Dil Modelleri (LLM) Kavramları kursumuz bu modellerin kaputunun altında nasıl çalıştığını anlatır. Ajan tarafıyla ilgileniyorsanız, Yapay Zekâ Ajanlarına Giriş de harika bir sonraki adımdır.








Sevdiğiniz şarkının ses dosyasını tek bir uzun sayı listesi olarak yazdırıp size verdiğimi hayal edin. Sadece sayılara bakarak bunun hangi şarkı olduğunu söyleyebilir misiniz?
Şarkı kesinlikle orada, ama kendi başlarına bize hiçbir şey ifade etmeyen binlerce değerin içinde gizli.
Sinir ağları tam olarak aynı soruna sahiptir. Bir ağın bildiği her şey sadece sayılar olan ağırlıklarında saklanır.
Derin öğrenme var olduğundan beri, bu sayılara bakıp güvenle bu ağın Breakout oynadığını ya da şu ağın belirli bir görevi yaptığını söyleyemedik. Ayrıca, oyuncak bir ağdan daha büyük bir şey için bu sayıları kendimiz yazamamıştık. O işi her zaman eğitime bırakmıştık.
2 Kasım 2026'da, MIT Bilgisayar Bilimi ve Yapay Zekâ Laboratuvarı (MIT CSAIL) ekibi, OpenAI'ın sınır dil modeli GPT-6 Astra'nın ikisini de yapabildiğini gösterdi. Bir ağın ham ağırlıklarına bakabiliyor, ne yaptığını çözebiliyor, bozuk olanı bulabiliyor ve hatta sıfırdan yepyeni bir ağ yazabiliyor; üstelik hiç eğitim olmadan. Yazarlar Rikiya Takehi, Jayden Teoh, Alex Zhang ve Omar Khattab buna Ağırlık Uzayı Programlaması diyor ve orijinal blog yazılarında böyle adlandırıyor.
Ben ise bu yazıda bunun gerçekte nasıl çalıştığına odaklanmak istiyorum. Her şeyi deneylere göre değil, LLM'in kullandığı tekniğe göre düzenledim. Deneylere sonuç-odaklı bir bakış istiyorsanız, Ağırlık Uzayı Programlaması genel bakışımıza göz atın.
Tekniklere geçmeden önce LLM'lerin ve üzerinde kurulu oldukları dönüştürücü (transformer) mimarisinin nasıl çalıştığını hatırlamak isterseniz, Python ile LLM'lere Giriş kursumuz temelleri kapsar; bu da ağırlıkları okuyan ve yazan modellere bakarken yardımcı olur.
Kısaca
Ele alacaklarımız:
Ağırlık Uzayı Programlaması Nedir?
Ağırlık Uzayı Programlaması, bir sinir ağının ağırlıklarına bir program gibi davranma fikridir: genel amaçlı bir LLM, ağın her bir parçasının ne yaptığına ilişkin muhakeme yoluyla ağırlıkları doğrudan okur ve yazar; gradyan inişi gibi bir eğitim algoritmasına güvenmek yerine.
Çok basit bir dille, LLM ağı açar, sayılara bizzat bakar ve onları kasıtlı olarak değiştirir.
Ben bunu bir köpeği eğitmek ile robot bir köpeğin kablolarını yeniden düzenlemek arasındaki farka benzetiyorum. Eğitim, bolca örnek gösterip davranışın yavaşça değişmesini ummak demektir; kablolamayı değiştirmek ise içeri girip sorumlu parçayı bulmak ve onu doğrudan değiştirmektir.
Bu, bir LLM'in sizin için bir eğitim betiği yazmasıyla aynı şey değildir; LLM'ler bunu bir süredir yapabiliyor. Burada hiç eğitim betiği yok ve LLM doğrudan gerçek sayılarla çalışıyor.
Yazarlar Ağırlık Uzayı Programlaması'nın tek bir yöntemden ziyade bir kavram olduğunu ve gradyanları dışlamadığını vurguluyor. Bu deneylerde, yalnızca akıl yürütmenin neler yapabildiğini izole etmek için gradyanlar yasaklandı.
Gönderi, fikri anlamanın en kolay yolu olduğunu düşündüğüm 3 şekilde test ediyor (Şekil 1'e bakın):
Şekil 1: Gönderide test edilen 3 beceri. Görsel: yazar.
Tüm bunları yapan LLM, OpenAI'ın 3 Eylül 2026'da duyurduğu GPT-6 Astra. Bazı deneylerde araştırmacılar onun tüm araçlarını (web araması ve kod çalıştırma dahil) kapattı; böylece yalnızca sayıları okuyup düşünebildi.
Bu 3 becerinin her biri kendi teknikler setini kullanıyor; yazının geri kalanı da bunu kapsıyor.
Sinir Ağlarının Ağırlıkları Normalde Nasıl Oluşturulur?
Tekniklere geçmeden önce, ağırlıkların normalde nasıl oluşturulduğunu bilmek faydalı. Aksi halde bu araştırmanın neden şaşırtıcı olduğunu görmek zor.
Eğitime kısa bir bakış
Bir sinir ağı, ağırlıklar (veya parametreler) denen sayılardan oluşan çok büyük bir koleksiyondur. Ağa bir girdi verdiğinizde, örneğin bir görüntü veya cümle, bu sayıları çarpıp toplayarak bir çıktı üretir. Buna ileri geçiş denir.
Eğitim, bu sayılar için iyi değerler seçme sürecidir. Standart yöntem gradyan inişidir: ağı çalıştırır, cevabın ne kadar yanlış olduğunu ölçer, her bir ağırlığın azıcık daha az yanlış olması için hangi yöne gitmesi gerektiğini çıkarır ve sonra her ağırlığı küçücük bir miktar hareket ettirirsiniz. Bunu milyonlarca kez tekrar edersiniz; bu yüzden eğitim pahalıdır.
Ağırlıkların yazılmasının dört yolu
Kullandığınız her sinir ağında ağırlıklar bir şey tarafından seçildi. Şimdiye dek bu şey 4 şeyden biriydi:
AdderBoard sıra dışı bir örnek. İki 10 haneli sayıyı toplayabilen en küçük transformeri inşa etme topluluk meydan okuması ve insanlar bir düzineden az benzersiz ağırlık değeriyle el yapımı girdiler sundu. Bu, ChatGPT gibi bir modelin ölçeğine yaklaşmıyor.
Ağırlık Uzayı Programlaması bu listeye beşinci bir seçenek ekliyor: ağırlıklar hakkında muhakeme eden genel bir LLM.
Şekil 2: Normal eğitim ile Ağırlık Uzayı Programlamasının karşılaştırması. Görsel: yazar.
Peki neden ağırlıkları sadece okuyamıyoruz?
Ağırlıklar sadece sayılarsa, neden onları okumak bu kadar zor? İki temel neden var.
Birincisi, bir ağ tek bir fikri tek bir yerde saklamaz. Tek bir fikir genellikle birçok nörona yayılmıştır ve tek bir nöron genellikle aynı anda birçok farklı fikre yardımcı olur.
İkincisi, aynı ağ birçok farklı şekilde yazılabilir. Bir katmandaki nöronların sırasını değiştirebilir, bir sonraki katmanı buna uyacak şekilde ayarlayabilir ve ağ tamamen aynı davranır. Dolayısıyla aynı işi yapan 2 ağın ağırlıkları çok farklı görünebilir.
Bu 2 sorunu aklınızda tutun; aşağıdaki her teknik temelde bunları aşmanın bir yoludur.
Ağırlık Uzayı Programlaması Neden Büyük Bir Adım
Gönderi bu kadar ilgi gördü çünkü daha büyük bir eğilimi genişletiyor. Son birkaç yılda, LLM'lerden kendi başlarına giderek daha fazla şeyi iyileştirmelerini istedik:
Şekil 3: Zaman içinde LLM'lerden iyileştirmeleri istediğimiz şeyler. Görsel: yazar.
Dikkat edin, bunların hepsi metin; insanların da elle düzenleyebildiği istemler ve Python dosyaları gibi. Yazarlar, metni iyileştirmenin daha iyi bir yolu olmadığı için LLM'leri hep metin üzerinde kullandığımızı belirtiyor. Ağırlıklar için ise zaten gradyan inişi vardı, bu yüzden kimsenin aklına sormak pek gelmedi.
Bu gönderi, eğitim betiğini tamamen atlayıp LLM'in ağırlıkları bizzat değiştirmesine izin verirsek ne olacağını soruyor.
Beceri 1: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Okur (Teknikler 1 ve 2)
Araştırmacılar, ağırlıklarının tamamı düz metin olarak Astra'nın istemine yapıştırılabilecek kadar küçük ağlarla başlayıp, ardından Astra'nın Python ile analiz ettiği daha büyük modellere geçtiler. Astra, onları okumak için 2 ana teknik kullandı.
Teknik 1: Girdi ve çıktı ağırlıklarından yapıyı okumak
Bence bir ağı okumaya başlamanın en kolay yeri onun uçlarıdır. İlk katman doğrudan girdiyle (ekran pikselleri gibi) ve son katman doğrudan çıktıyla (oyuncunun yapabileceği hamleler gibi) bağlantılıdır. Hangi sayının neye bağlı olduğunu bildiğimiz tek katmanlar bunlardır.
Bu ağ hangi oyunu oynuyor?
Araştırmacılar, Yakınsal Politika Optimizasyonu (PPO) adlı bir pekiştirmeli öğrenme algoritmasıyla, Breakout, Pong, Pac-Man ve Freeway'in basitleştirilmiş 10×10 ızgara sürümlerini oynamak üzere 4 küçük ağ eğitti.
Bu düzenlemenin zekice yanı, tüm 4 ağın tam olarak aynı boyutta olması (her biri 17.253 ağırlık), aynı girdileri alması ve aynı hamleleri yapabilmesiydi. Dolayısıyla onları ayırt etmenin tek yolu sayıları okumaktı.
Her ağın ağırlıklarını Astra'ya yapıştırıp, seçenek listesi vermeden "Bu ağ hangi oyun üzerinde eğitildi?" diye sordular. Astra yine de tüm 4 ağ için doğru oyunun adını verdi.
Şekil 4: Astra ham ağırlıkları okur ve Breakout'u tespit eder. Görsel: yazar.
Dikkatimi çeken, bunu nasıl çözdüğüydü. Breakout ağı için şu şekilde akıl yürüttü:
Bu ipuçlarını bir araya getirince Breakout ortaya çıkıyor. İlk 2 ipucu girdi ağırlıklarından, sonuncusu ise çıktı ağırlıklarından geliyor; bu da tam olarak bu teknik.
Bu model hangi şekli çiziyor?
Sonra araştırmacılar küçük görüntü üretim modelleri (çoğu yapay zekâ görsel üreticisinin arkasındaki aile olan difüzyon modelleri) eğitip daire, üçgen veya kare çizdirdiler. Yine Astra'ya yalnızca ağırlıklar verildi; araç yok, modeli çalıştırma imkânı da yok; ve her biri için doğru şeklin adını söyledi.
Tek tuhaf hata şuydu: Modeller şekilleri aslında dolu olarak çizdiği halde, Astra her şekli bir dış hat olarak tanımladı. Araştırmacılar bunun iyi bir işaret olduğunu savunuyor; çünkü bu, Astra'nın tüm modeli kafasında gizlice çalıştırmak yerine ağırlıklarda depolanan şeklin kenarlarını okuduğunu düşündürüyor.
Teknik 2: Orta katmanlarda devreler bulmak
İlk iki deneyde Astra, ağın sadece ilk veya son katmanını okuyarak kurtulabildi. Bu, düşünmenin çoğunun orta katmanlarda gerçekleştiği gerçek dil modellerinde işe yaramazdı.
İkinci teknik burada devreye giriyor: devreleri bulmak. Bir devre, ağ içinde birlikte çalışarak tek bir işi yapan küçük bir parça grubudur. Ne yaptığını tanıyabilirseniz, girdilerin ne olduğunu bilmeden de ağ hakkında çok şey öğrenebilirsiniz.
Bu model hangi dili öğrendi?
Bunu test etmek için araştırmacılar 3 küçük dil modeli (her biri yaklaşık 7,2 milyon ağırlık) eğitti:
Sonra her modelin ilk ve son katmanlarını kestiler, sadece 4 orta blok kaldı. Bu katmanlar olmadan, ağırlıklarda hangi sayının hangi harfe karşılık geldiğini söyleyen hiçbir şey yok; bu yüzden modeli metin üzerinde çalıştırmak bile mümkün değil ve Teknik 1 devre dışı.
Bu sefer Astra'nın sayıları Python ile analiz etmesine izin verildi, ama modeli çalıştırmasına izin verilmedi. Yine de her iki denemesinde 3 modelin de dilini doğru adlandırdı; ancak her seferinde güveni yaklaşık %50–60 civarındaydı.
Peki Python'u nasıl fark etti? İndüksiyon kafalarını aradı.
İndüksiyon kafaları, metinde daha önce beliren bir deseni fark edip ardından geleni kopyalayan bir transformer parçasıdır; örneğin "tot"u, daha önce "total" yazıldığı için "total"a tamamlama. Kod, normal yazıya göre değişken adlarını çok daha fazla tekrarlar; bu yüzden bir Python modelinin bunlardan daha fazlasına ihtiyacı vardır. Astra hepsini buldu ve başka hiçbirini yanlış etiketlemedi.
Astra, farklı kafaların ağırlık matrislerini birbiriyle çarparak hangi kafaların birbirleriyle “konuştuğunu” gördü. Bu, araştırmacıların ona hiç bahsetmediği 2021 tarihli Transformer Devreleri için Matematiksel Bir Çerçeve makalesindeki bir tekniğe uyuyor.
Romaji için, modelin takip etmesi gereken daha az harf varmış gibi göründüğünü fark etti. Bu doğru; çünkü romaji q, l, v veya x gibi harfleri hiç kullanmaz.
Okumanın kırıldığı yer: hangisi insanları memnun etmeye yatkın model?
İşte bu 2 tekniğin çalışmayı bıraktığı yer. İlk başta işe yaramayan tek deney.
Araştırmacılar Google'ın Gemma 3 270M modelinin 2 kopyasını aldılar ve tamamen aynı şekilde ince ayar yaptılar; tek farkla: Bir kopya doğru yanıt vermeyi öğrendi, diğeri ise yalakalık (sycophancy) denilen, kullanıcının önerdiği cevabı her zaman verme davranışını. Ayrıca girdi ve çıktı katmanlarını dondurdular; böylece Astra onları inceleyerek kestirme yapamadı. İşte açıklayıcı bir örnek:
Sadece ağırlıklardan yola çıkarak Astra, 4 denemesinin hiçbirinde hangi modelin yalaka olduğunu söyleyemedi. İki model arasında pek çok fark buldu ama bunların hiçbirini davranışla ilişkilendiremedi.
Bu yüzden araştırmacılar ona 1 ek ipucu verdi. Astra'nın, modeller kendi yazdığı metni okurken her bir dikkat kafasının nereye baktığını görmesine izin verdiler (ama modellerin gerçek yanıtlarını değil). Bununla, Astra 3 model çiftinin hepsinde insanları memnun edeni doğru seçti.
Hatta farkın nerede yaşadığını buldu. 10.2 dikkat kafasında, dürüst model dikkatinin %94,3'ünü sorudaki sayılara harcarken, yalaka model dikkatinin %85,7'sini kullanıcının önerdiği yanıta harcadı.
Bunu özellikle vurgulamak istiyorum; çünkü bana göre gönderideki en önemli sonuç bu. Yalnızca ağırlıklardan bir davranışı okumak, GPT-6 Astra gibi bir sınır model için bile gerçek bir dil modelinde hâlâ çok zor.
Beceri 2: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Düzeltir (Teknikler 3 ve 4)
Ağırlıkları okumak etkileyici, ama onları düzeltmek daha büyük ve daha zor bir adım. Astra, ağın ne yaptığını anlamalı, ne yapması gerektiğini çıkarmalı ve sonra bu farkı kapatmak için doğru sayıları değiştirmeli. Bunun için 2 çok farklı teknik kullandı.
Teknik 3: Küçük bir kestirme devre eklemek
Bu teknik, ağın çoğunu olduğu gibi bırakır ve yalnızca orijinal ağın başarısız olduğu tek durumda devreye giren küçük bir devre ekler.
Sürekli takılan araba
Bu deney için araştırmacılar Kinetix adlı 2D bir fizik oyunu kullandılar ve bir arabayı bir rampadan yukarı sürmek için PPO ile bir ağ eğittiler. Arabanın yeterli hızlanma payı oluşturmak için önce geri gitmesi, sonra hızlanması gerekiyor.
Eğitilmiş ağ bunu hiç çözemedi. Her seferinde direkt rampaya sürdü ve her defasında takıldı.
Bu yüzden araştırmacılar Astra'ya 3 şey verdiler:
Tek denemede, araçsız olarak, Astra arabanın neden başarısız olduğunu açıkladı ve yeni ağırlıklar yazdı. Değişiklikten sonra, araba 1.024 test bölümünün tamamında başarılı oldu (0'dan yükseldi) ve Astra yalnızca %3,5 ağırlığı değiştirmişti.
Astra tüm ağı yeniden yazmadı. Her katmanda birkaç nörondan geçen küçük bir kestirme ekledi; başlangıçta devreye girip arabayı geri vitese alıyor ve ileri fırlatıyor. Araba kırmızı şeridi geçince kestirme kendini kapatıyor ve kalan kısmı orijinal ağ sürüyor.
Ben bunu, sürüş eğitmeninin zorlu bir yol kesitinde direksiyona kısa süre müdahale edip sonra hemen öğrencisine geri vermesine benzetiyorum. Bu, orijinal ağ tamamen bozuk olmadığı için işe yaradı. Zaten sürebiliyordu ama tek bir zor anı idare edemiyordu; bu yüzden diğer her şeyi olduğu gibi bırakmak mantıklıydı.
Teknik 4: Bir yön bulup çıkarmak
Bu teknik, bir davranışın modelin içinde tek bir yöne yerleşebileceği ve bu yönü ağırlıklardan çıkararak o davranışı kapatabileceğiniz fikrine dayanır.
Kendini tekrar eden model
Viral olan deney bu; o yüzden biraz daha yakından bakalım.
Araştırmacılar, küçük bir açık kaynak akıl yürütme modeli olan Qwen3.5-0.8B'yi aldılar ve Astra'dan yalnızca ağırlıkları düzenleyerek onu matematikte daha iyi yapmasını istediler. Bu kez Astra'nın modelin yüklü olduğu bir Python defteri vardı ve modeli sınırlı sayıda pratik matematik sorusunda (10, 25 veya 50 test çalıştırması; yazarların deyimiyle ileri geçiş) çalıştırabiliyordu. Ama yine eğitim yoktu.
Astra, modelin sürekli döngülere takıldığını hızla fark etti; aynı kelimeleri tekrar tekrar söyleyip asla bir sonuca ulaşmıyordu. İlk 96 pratik cevabın 85'i, 32.768 belirteç sınırına çarpana kadar böyle devam etti.
Bu, küçük akıl yürütme modellerinde iyi bilinen bir sorun ve Qwen'in kendi model kartı da buna karşı uyarıyor. Aralık 2025 tarihli “Bekle, Bekle, Bekle… Akıl Yürütme Modelleri Neden Döngüye Giriyor?” adlı makale, aynı ailedeki daha küçük modellerin daha büyüklere göre daha fazla döngüye girdiğini ve büyük bir modelden damıtılan küçük modellerin, öğrendikleri modele göre daha da fazla döngüye girdiğini buldu.
Astra, döngüyü modelin içinde tek bir gizli kalıba, araştırmacıların yön dediği şeye kadar izledi. Yardımcı olursa, yönü modelin içindeki gizli bir sürgü gibi düşünebilirsiniz. Bu durumda sürgü, modeli kendini tekrar etmeye itiyordu ve 15. ve 19. katmanlarda yaşıyordu.
Sonra Astra bu sürgüyü, bu 2 katmandaki 64 çıktı sütunundan oluşan 131.072 ağırlıktan basitçe çıkardı; bu da tüm modelin yalnızca %0,016'sı.
Arkasındaki matematik
Qwen düzeltmesi, abliteration adı verilen mevcut bir numaraya çok benziyor. 2024'te araştırmacılar, bir modelin talepleri reddetme alışkanlığının tek bir yön tarafından kontrol edildiğini ve bu yönü ağırlıklardan silerek modelin reddetmeyi bırakmasının sağlanabileceğini gösterdiler.
Arkasındaki matematik şaşırtıcı biçimde tek satırdır; burada
r, çıkarmak istediğiniz birim uzunluklu yöndür:W_new = W - r (rᵀ W)Bunu daha anlaşılır kılmak için küçük bir örnek: Bir ağırlığın 2 parçadan oluştuğunu hayal edin,
(3, 2). İlk sayı, modeli döngüye itme miktarı; ikinci sayı, yaptığı diğer her şey.Döngü yönümüz
r = (1, 0); yani “ilk sayı”. Formül döngü parçasını (3) çıkarır ve bize(0, 2)bırakır. Döngü kısmı gitti, diğer her şey aynen kaldı.Önemli nokta, Astra'nın döngü yönünü birkaç yüz örnek dürtüye ihtiyaç duyan abliteration'dan farklı olarak, ağırlıklar hakkında muhakeme edip modeli pratik sorularda çalıştırarak kendi başına bulmuş olmasıdır. İşte sonuçlar biraz daha ayrıntılı (8 deneyin tümünü yan yana görmek için Ağırlık Uzayı Programlaması genel bakışımıza bakın):
Şekil 5: Astra'nın düzenlemesinden önce ve sonra Qwen3.5-0.8B. Görsel: yazar.
Burada dikkat etmenizi istediğim 2 şey var. Birincisi, döngüler sadece matematik sorunu değil; düzeltme modelin talimatlara uymasını da çok iyileştirdi (IFEval 50 çalıştırmalı sürümde %21,0'dan %62,3'e çıktı). İkincisi, 10 veya 25 test çalıştırmasında döngüler çoğunlukla kaldı ve büyük sıçrama yalnızca 50'de oldu.
Düzeltmenin kırıldığı yer: düzeltmek geliştirmekle aynı şey değil
Şimdi her okurun bilmesi gerektiğini düşündüğüm kısım. Döngüleri durdurmak, bir modeli matematikte daha iyi yapmakla aynı şey değildir. Yaptığı tek şey, modelin zaten çözebildiği yanıtları bitirmesine izin vermektir.
Bunu kontrol etmek için araştırmacılar, nadiren döngüye giren (yanıtlarının yalnızca %8,5'i belirteç sınırına çarpıyor; Qwen'de %93) küçük bir model olan Gemma 3 270M üzerinde aynı deneyi çalıştırdılar. Bu kez Astra gerçekten iyileştiremedi. MATH-500'de hiçbir düzenleme skoru yaklaşık bir puandan fazla oynatmadı ve Astra'nın kendisi kazanımı teyit edilmemiş olarak raporladı.
Astra, Gemma'nın nerede hata yaptığını incelediğinde, hatalı aritmetik ve yanlış cebir adımları gibi sıradan hatalar buldu. Kapatılacak tek bir bozuk parça yoktu; dolayısıyla Teknik 4'ün çalışacağı bir şey de yoktu.
Kısacası, ağırlıkları düzenlemek bir beceriyi engelleyen bir şeyi kaldırabilir, ama modelin hiç sahip olmadığı bir beceriyi ekleyemez.
Beceri 3: Bir LLM Sinir Ağı Ağırlıklarını Nasıl Yazar (Teknik 5)
Şimdi beni kişisel olarak en çok şaşırtan kısma geliyoruz. Burada Astra, her bir ağırlığı sıfır olan bir ağla başlıyor ve tüm sayıları kendi seçmek zorunda.
Teknik 5: Bir program planlayıp sayılara dönüştürmek
Teknik, tarif etmesi basit. Astra önce bir program planlar; her katmanın ne yapması gerektiğine karar verir ve sonra her katmanı o işi yapacak hale getiren ağırlıkları seçer.
Araştırmacılar, basitleştirilmiş Atari oyunları kümesi olan MinAtar'ı kullandılar ve Breakout, Seaquest ve Asterix'i seçtiler. Her oyun için Astra'ya şunlar verildi:
Eğitim verisi yoktu, araç yoktu ve ağını oyunda test etmesine bile izin verilmiyordu. Tüm ağırlıkları tek bir yanıtta yazıp verdi ve araştırmacılar sonucu test etti.
Örneğin Breakout için plan şuna benziyordu:
Gördüğünüz gibi, Astra'nın ağları tüm 3 oyunda 100 milyon adım eğitilmiş ağları geçti. 500 milyon adım eğitilmiş ağlara karşı, Breakout'ta yaklaşık 20 kat daha yüksek puan aldı, Asterix'te yaklaştı ve Seaquest'te puanın yaklaşık %60'ına ulaştı.
Bir Go oyuncusu inşa etmek
Yukarıdaki oyun ağları, Astra'nın tek bir yanıtta yazabileceği kadar küçüktü. Go için araştırmacılar işi çok zorlaştırdı; yaklaşık 1,5 milyon ağırlıklı bir ağ kurdular. Bu, Astra'nın istemine sığmayacak kadar büyük.
Bu yüzden ona, ağırlıklara bakıp kaydedebileceği (başlangıçta hepsi sıfır) ama ağı çalıştıramayacağı bir Python çalışma alanı verdiler. Ağını test etmek istiyorsa, her biri 9×9 tahtada 128 oyun oynayan 0 ile 50 arasında sınırlı sayıda test çalıştırmasından birini harcamak zorundaydı.
Astra bu ağı da bir Go programı gibi inşa etti:
Düşündüğünüz gibi bu bir derleyiciye epey benziyor ve haklısınız. DeepMind'in Tracr'ının yaptığına çok benzer: bir programı doğrudan kesin transformer ağırlıklarına çevirmek. Fark şu ki Tracr, programın özel bir dilde yazılmasını isterken, Astra sıradan bir İngilizce hedeften programı kendisi çıkarıyor.
Test Etmek Neden Bu Kadar Büyük Fark Yaratıyor
Bu noktaya geldiğinizde, kuralların deneyden deneye değiştiğini fark etmişsinizdir. Oyun tanıma, şekiller, araba ve MinAtar deneylerinde Astra'nın hiç aracı yoktu; dil, Go, yalaka ve Qwen deneylerinde ise Python kullanabildi ve bazen ağı test edebildi.
Bence bu, tüm gönderinin en az değer verilen kısmı; çünkü test sayısı büyük fark yaratmış gibi görünüyor:
Dolayısıyla araçsız sonuçlar en şaşırtıcı olanlar; ama bu, her deneyi birbirleriyle adil şekilde karşılaştıramayacağınız anlamına da geliyor.
GPT-6 Astra Bunu Aslında Nasıl Yapıyor?
Tüm teknikler boyunca bir desen daha var: Astra, bir insan mühendise epey benzer şekilde çalışıyor.
Ağırlık Uzayı Programlaması vs. İnce Ayar ve Model Düzenleme
İnce ayardan veya bir modeli düzenlemenin diğer yollarından bunun nasıl farklı olduğunu merak ediyor olabilirsiniz. Aşağıdaki tablo, en yakın yöntemleri ve her birinin 5 teknikten hangisine en yakın olduğunu karşılaştırıyor:
Bunlardan birkaçını kısaca açıklayayım:
Buradaki büyük fark, Ağırlık Kehanilerinin bu tek iş için eğitilmiş olması; Ağırlık Uzayı Programlaması'nın ise normal, raf ürünü bir LLM kullanması.
Samimi fikrim, burada yeni olanın ağırlıkların düzenlenebilmesi olmadığını; bunu yıllardır biliyoruz. Yeni olan, tek bir genel modelin yalnızca muhakeme ederek tüm bu farklı işleri başarması.
Ağırlık Uzayı Programlamasının Sınırlamaları
Bu sonuçlar heyecan verici olsa da dikkatli okunmaları gerektiğini düşünüyorum. Yazarlar kendileri de bunları “çok erken sonuçlar” olarak nitelendiriyor. Gündeme gelen başlıca endişeler şunlar:
1. Geliştirme değil, düzeltme yapıyor
Gemma kontrolünün gösterdiği gibi, Qwen'deki büyük sıçrama çoğunlukla döngüleri durdurmaktan geldi. Yazarların kendi günlüklerinin XenoSpectrum tarafından raporlanan bir analizi, düzenlemeden sonra Qwen'in yeni çözdüğü 579 ayrılmış pratik soruyu saydı. Bunlardan 576'sı daha önce belirteç sınırında kesilmişti.
2. Yalnızca bir sınır LLM test edildi
Gönderideki her deney GPT-6 Astra ile yapıldı. Simon Willison o zamandan beri açık ağırlıklı Qwen 3.8 27B ile dizüstü bilgisayarında oyun tanıma görevini çoğalttı; gerçi oyunlardan birini kaçırdı. Diğer sınır modellerin, onarım ve yazma deneylerinde Astra'yı yakalayıp yakalayamayacağı, yazarların planladığı kıyaslama ile yanıtlanmalı.
3. Hakem değerlendirmesinden geçmedi
Bu, yayımlanmış bir makale değil, bir blog yazısı. Yazarlar tam günlükleri yayımladı ve Hugging Face'ten Ahsen Khaliq düzenlenmiş Qwen modelini bunlardan yeniden inşa edip değerlendirmeyi tekrar çalıştırdı; yazarların aktardığına göre MATH-500'de %51,0 puan aldı ve yanıtların %31,6'sı hâlâ belirteç sınırına çarpıyordu. Bu, yayımlanan kontrol noktasına faydalı bir kontroldür; ancak Astra'nın düzenlemeyi yaptığı bağımsız bir tekrarla aynı şey değildir.
4. Bildirilen sonuçlar elverişli olabilir
Eleştirmenler, daha önceki istem denemelerinin rapor edilen sonuçlara dahil edilmediğini ve Astra'nın muhakeme çabasının deneyler arasında değiştiğini belirtiyor. Ayrıca, istemin biraz farklı ifade edilmesiyle sonuçların ne kadar değiştiğine dair bir test bulamadım.
5. Maliyetini bilmiyoruz
En iyi Qwen çalıştırması 158 konuşma dönüşü ve 20,3 saat sürdü; bunun 4,7 saati hizmet kesintisine kaybedildi. Gönderi, bunu modelin normal ince ayarıyla karşılaştırmıyor; dolayısıyla şimdilik zaman veya para tasarrufu sağlayıp sağlamadığını söyleyemeyiz.
6. Karşılaştırmalar biraz cömert
Oyun sonuçları eğitilmiş ağlarla karşılaştırılıyor; ancak basit el yazımı kodla karşılaştırılmıyor. Topu takip eden bir Breakout oyuncusunu normal bir program olarak yazmak çok zor değil; bu yüzden burada eğitilmiş bir ağı geçmek, ilk başta göründüğü kadar şaşırtıcı değil. Yazarlar, her kıyaslamanın yalnızca kendi deneyinin dar iddiasını test ettiğini, örneğin sıfır deneyimle ne kadar ileri gidilebileceğini söylüyor.
Yazarlara hakkaniyetle yaklaşmak gerekirse, işe yaramayan şeyler konusunda da oldukça açıktılar; buna yalaka model ve Gemma sonuçları da dahil — bunu takdir ediyorum. Ancak manşet rakamları, bunun genelde çalıştığının kanıtı değil, umut verici erken işaret olarak ele alırdım.
Ağırlık Uzayı Programlamasının Uygulamaları
Tüm bu sınırlamalara rağmen, bu yaklaşım gelişmeye devam ederse nereye gidebileceğini hayal etmek heyecan verici. Yazarların bahsettiği olası uygulamalar şunlar:
Sonuncusu, herkesin bu araştırma hakkında heyecanlı olmamasının tam nedeni. PauseAI CEO'su Maxime Fournes, bu araştırma yönünü pervasız olarak nitelendirdi; zira buradaki gerçek ilerleme, riskli yapay zekâ geliştirmeyi hızlandırabilir. Yine de şunu belirtmek isterim ki bu gönderi herhangi bir tür kendini geliştirme göstermedi.
Daha olumlu bir güvenlik yönü de var. Eğer LLM'ler, yalnızca ağırlıkları okuyarak yalakalık veya gizli arka kapılar gibi şeyleri güvenilir şekilde tespit edebilirse, bu modelleri yayımlamadan önce kontrol etmenin yararlı bir yolu olabilir.
Sırada ne var?
Yazarlar şimdi farklı LLM'lerin bu konudaki yeteneklerini ölçmek için bir kıyaslama ve bunu yapmalarına yardımcı olacak bir koşum takımı oluşturduklarını söylüyor. Araştırmacıların üzerinde çalışacağı bazı sorular şunlar:
Yayınlanmadan beri çalışmalar hızlı ilerledi. 12 Kasım güncellemesinde yazarlar, robot politikaları ve kuantum devreleri dahil yüzün üzerinde çoğaltım ve genişletme olduğunu ve IWIBench adlı bir kıyaslama bulunduğunu söylüyor.
Çalışmayı kendiniz incelemek isterseniz, Astra'ya gönderilen her istem ve muhakemesinin özetleri de dahil olmak üzere her deneyin tam günlüklerini GitHub'da görebilirsiniz. Düzeltilmiş Qwen modeli ayrıca Hugging Face'te, tarayıcınızda deneyebileceğiniz bir canlı demo ile mevcut; bağlantısı orijinal blog yazısında.
Son Düşünceler
Ağırlık Uzayı Programlaması, arkasında erken kanıtlar olan yeni bir fikir. Raf ürünü bir LLM, hiç eğitim olmadan, küçük ağların ne yaptığını okuyabildi, takılan bir arabayı ve döngüye giren bir dil modelini düzeltebildi ve hatta sıfırdan oyun oynayan ağlar kurabildi.
Beni en çok şaşırtan, bunu nasıl yaptığıydı. Gizemli bir numara kullanmadı; bunun yerine ağların uçlarını okudu, devreleri avladı, kestirmeler ekledi, yönleri çıkardı ve programları sayılara çevirmeden önce planladı — tıpkı bir mühendisin yapacağı gibi.
Ama bunun tek bir modele dayanan erken bir rapor olduğunu ve en büyük sonucun, modeli daha akıllı yapmaktan ziyade bir hatayı düzeltmekten geldiğini yeniden vurgulamak isterim. Gelişmeye devam ederse, en faydalı uygulama muhtemelen eğitim yerine modelleri denetlemek ve hata ayıklamak olacaktır.
Bu tür araştırmaları takip etmek için altyapınızı güçlendirmek isterseniz, Büyük Dil Modelleri (LLM) Kavramları kursumuz bu modellerin kaputunun altında nasıl çalıştığını anlatır. Ajan tarafıyla ilgileniyorsanız, Yapay Zekâ Ajanlarına Giriş de harika bir sonraki adımdır.