想象我把您最喜欢的歌曲,按音频文件中一长串数字打印出来交给您。仅凭看这些数字,您能告诉我是哪个曲子吗?
那首歌确实“在里面”,但被隐藏在成千上万个对我们而言毫无意义的数值之中。
神经网络也有完全相同的问题。网络所“知道”的一切都存储在它的权重里,而权重只是数字。
自深度学习诞生以来,我们一直无法仅凭这些数字,自信地说这个网络会玩 Breakout(打砖块),或那个网络能执行某个任务。我们也从未能亲自写出这些数字(除非是玩具规模的网络)。这项工作一直留给训练来完成。
2026 年 11 月 2 日,麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的一个团队展示:前沿大语言模型(LLM)OpenAI 的 GPT-6 Astra 能两者兼顾。它能直接查看网络的原始权重,推断其功能,找出问题所在,甚至从零开始写出一个全新的网络——完全不需要训练。作者 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 在他们的原始博文中将此称为权重空间编程(Weight-Space Programming)。
因此,在本文中我将重点讨论它究竟如何运作。我按照 LLM 所用技术而非实验来组织内容。如果您想先看结果导向的实验梳理,请参阅我们的权重空间编程综述。
如果您想在进入技术细节前,回顾 LLM 以及其所构建于之上的 Transformer 架构如何工作,我们的Introduction to LLMs in Python课程覆盖基础知识,有助于理解读取与写入权重的模型。
要点速览
- 权重空间编程将网络权重视作一个程序,通用 LLM 可直接读取、编辑和写入,无需梯度下降或训练脚本。
- 在 MIT CSAIL 的实验中,GPT-6 Astra 识别了小网络被训练来做什么,修复了会卡住的驾驶策略,并从全零权重开始写出会玩游戏的网络。
- 它对 Qwen3.5-0.8B 的编辑将 MATH-500 准确率从 7.9% 提至 48.1%,但作者日志的分析显示,几乎全部提升来自于阻止推理循环。
- 这些是早期结果:单一前沿模型、尚未同行评审的博文,以及目前有限的独立核查。
本文将涵盖:
- 权重空间编程到底是什么
- 神经网络权重通常如何产生
- LLM 用于读取、修复和写入权重的 5 种技术
- 为何测试会带来巨大差异
- 它与微调的比较
- 其局限性
- 为什么有人认为这非常重要
什么是权重空间编程?
权重空间编程的理念是把神经网络的权重当作一个程序:通用 LLM 通过推理网络每个部分的作用,直接读取和写入权重,而不是依赖诸如梯度下降之类的训练算法。
通俗地说,LLM 会把网络“拆开”,自己看这些数字,并有目的地更改它们。
我更愿意把它比作训练一条狗与重接一条机器狗的电路的区别。训练是展示大量示例,慢慢期待行为改变;而重接电路是进到内部,找到负责的部位,直接改动它。
这不是让 LLM 帮您写训练脚本——LLM 早已能做到这一点。在这里,没有任何训练脚本,LLM 直接处理真实的数字。
作者强调,权重空间编程是一种概念而非单一方法,也不排斥梯度。他们在这些实验中禁用了梯度,是为了隔离“仅靠推理”能做到什么。
博文从 3 个方面验证这一理念,我认为这是理解全貌的最简单方式(见图 1):
- 读取:查看权重并说明网络在做什么
- 修复:找出权重内部的故障并修补
- 写入:从全零权重开始构建一个可用的网络
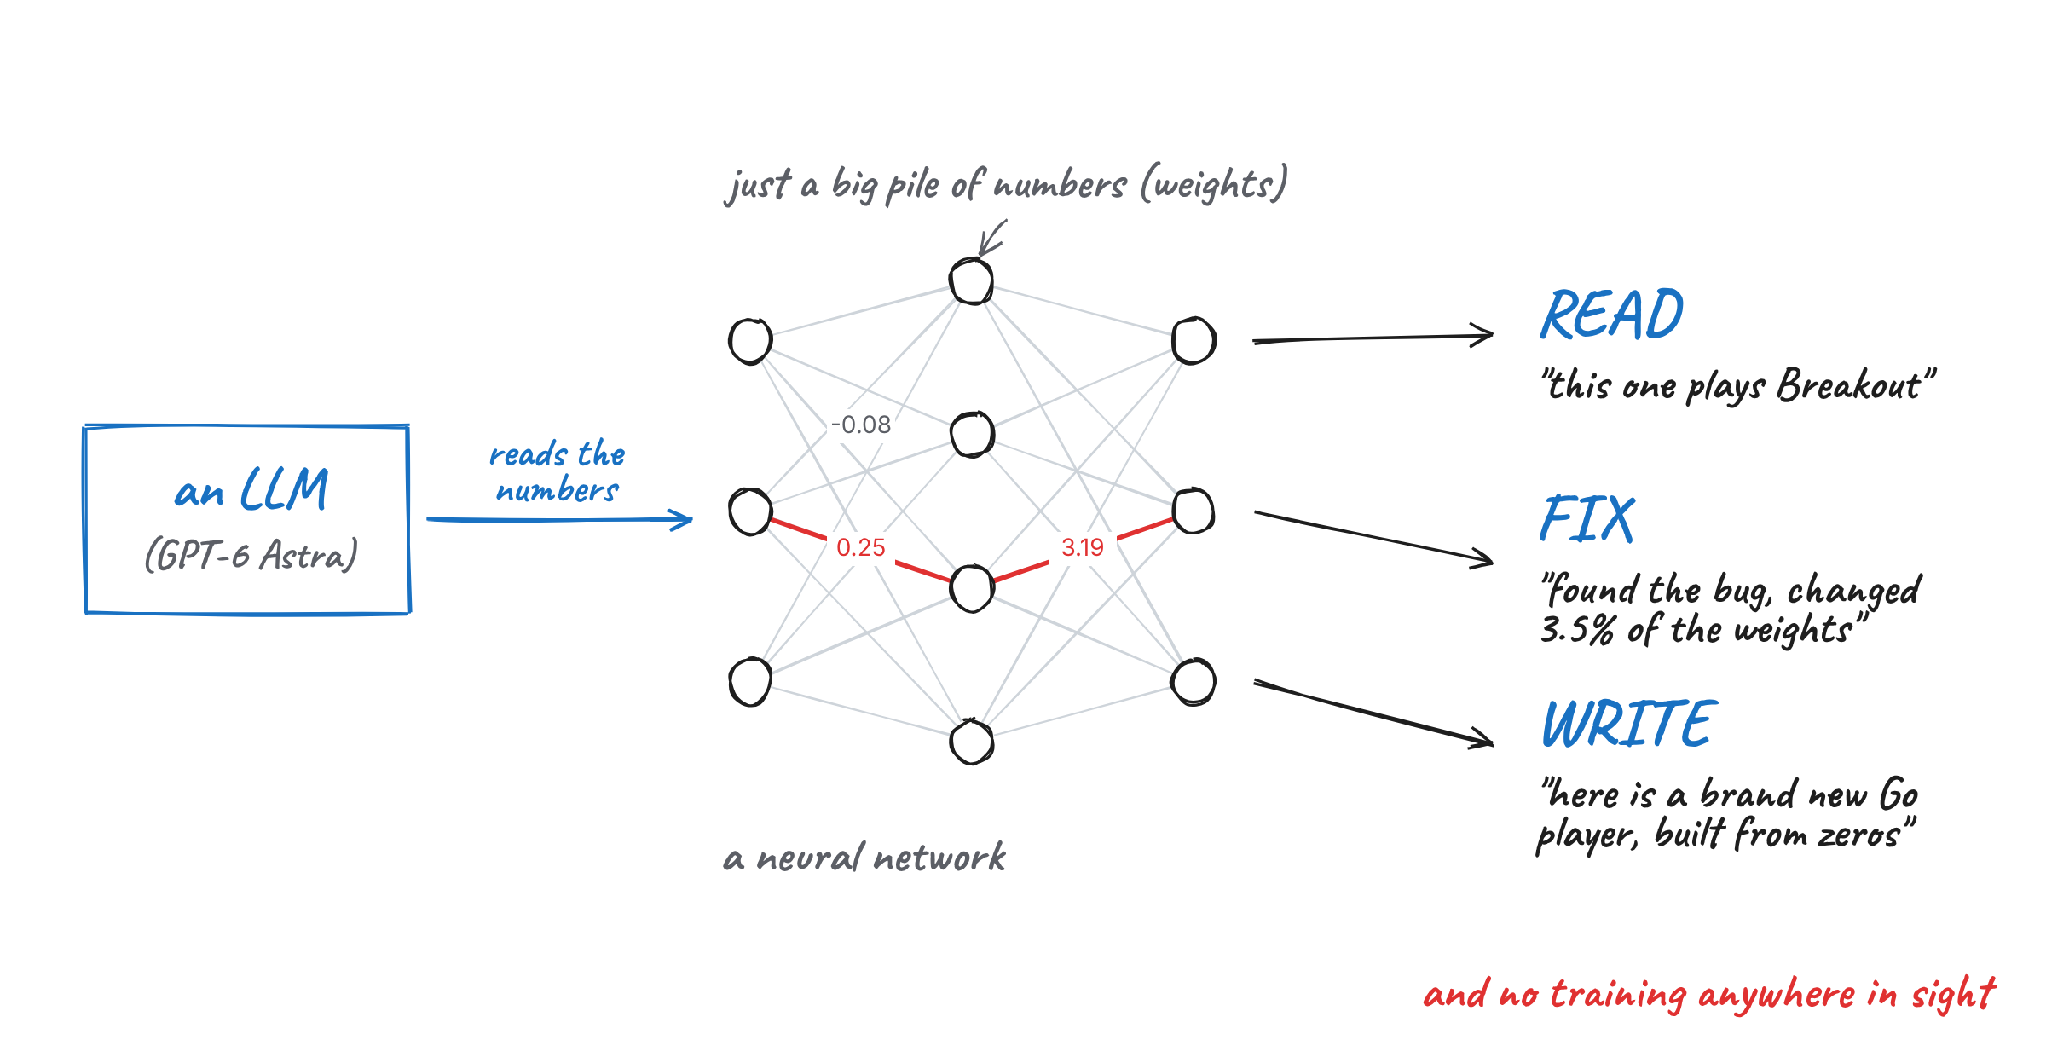
图 1:文中测试的三种能力。作者制图。
完成这一切的 LLM 是GPT-6 Astra,OpenAI 于 2026 年 9 月 3 日发布。在部分实验中,研究者关闭了其所有工具(包括网页搜索与运行代码),因此它只能读数字并思考。
这三种能力各自依赖一套技术,剩余内容将逐一介绍。
神经网络权重通常如何产生?
在进入具体技术前,先了解权重通常如何生成,否则很难理解这项研究为何出人意料。
训练回顾
神经网络是大量称为权重(或参数)的数字集合。当您给它输入(如图像或句子)时,它会对这些数字做乘加运算以产生输出。这称为一次前向传播。
训练就是为这些数字选择合适的取值。标准方法是梯度下降:运行网络、度量误差、计算每个权重应往哪个方向移动以稍微变“更不错误”,然后微调每个权重一点点。如此重复数百万次,这也是训练昂贵的原因。
权重被写入的四种方式
您用过的每个神经网络,它的权重都是被某种方式选定的。直到现在,这种方式主要有以下 4 种:
AdderBoard 很特殊。它是一个社区挑战,目标是构建能相加两个 10 位数的最小 Transformer,人们手工构建的参赛作品使用了不足十几种不同的权重取值。这与 ChatGPT 级别的模型完全不在一个量级。
权重空间编程为此清单新增了第五种选项:一个能对权重进行推理的通用 LLM。
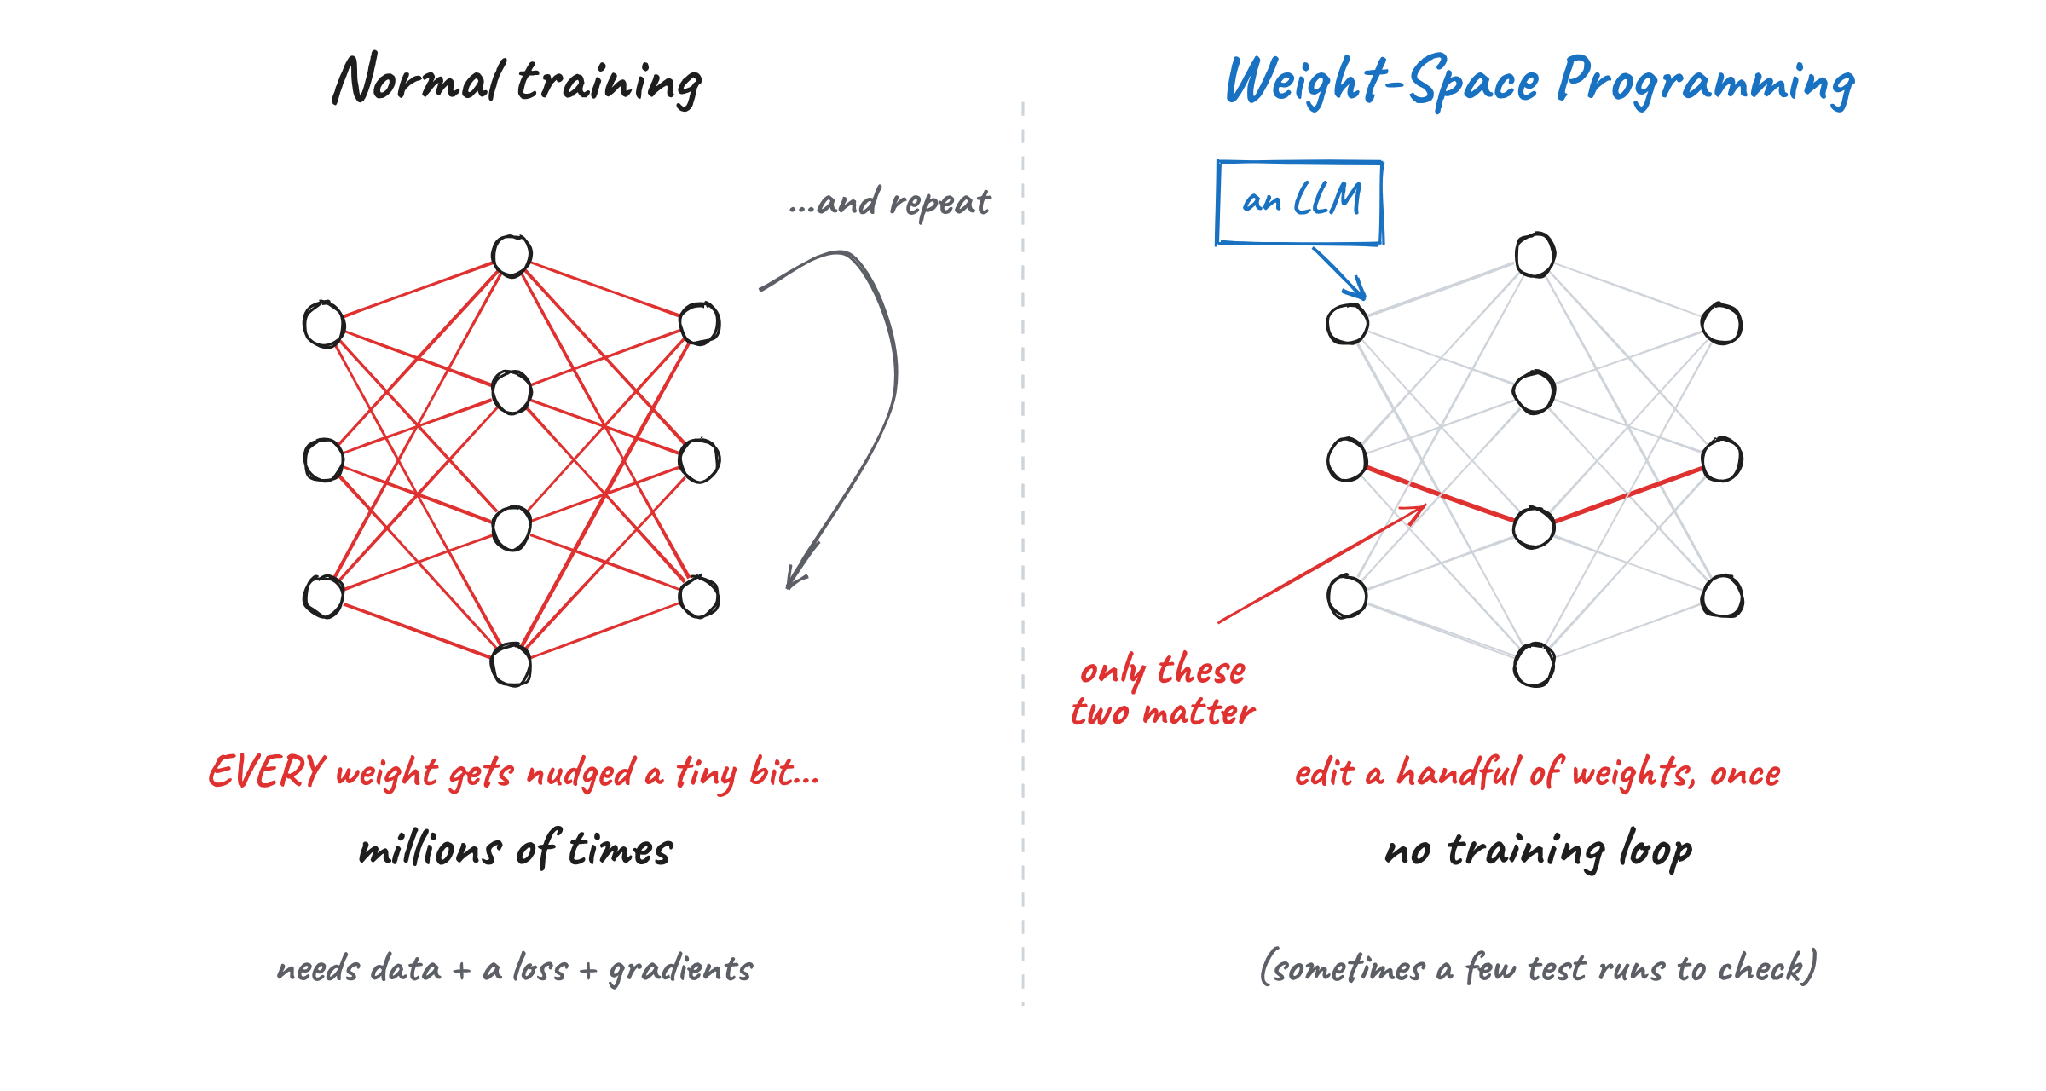
图 2:传统训练与权重空间编程对比。作者制图。
为何我们不能直接“读懂”权重?
如果权重只是数字,为何读取如此困难?主要有两点原因。
第一,一个网络不会把一个想法存放在一个位置。单个想法通常分布在许多神经元上,而一个神经元通常同时参与许多不同想法。
第二,同一个网络可以用多种不同的写法。您可以打乱一层内部神经元的顺序,调整下一层以匹配,网络的行为仍然完全相同。因此,两个执行同一任务的网络,权重看起来可能大不相同。
记住这两个问题,下面的每个技术本质上都是在绕开它们。
为何权重空间编程是重要一步
这篇文章之所以引发关注,是因为它延续并推进了一个更大的趋势。过去几年里,我们让 LLM 自主改进的对象越来越多:
- 先是提示词,让 LLM 尝试不同版本并保留最优。
- 随后是完整的LLM 程序,使用如 DSPy 等工具(该工具由本文作者之一 Omar Khattab 共同创作)。
- 接着是 AI 代理运行的挂架(harness)。
- 再到训练代码,如 Andrej Karpathy 的 autoresearch,代理编辑训练脚本、运行 5 分钟训练,仅在结果更好时保留改动。
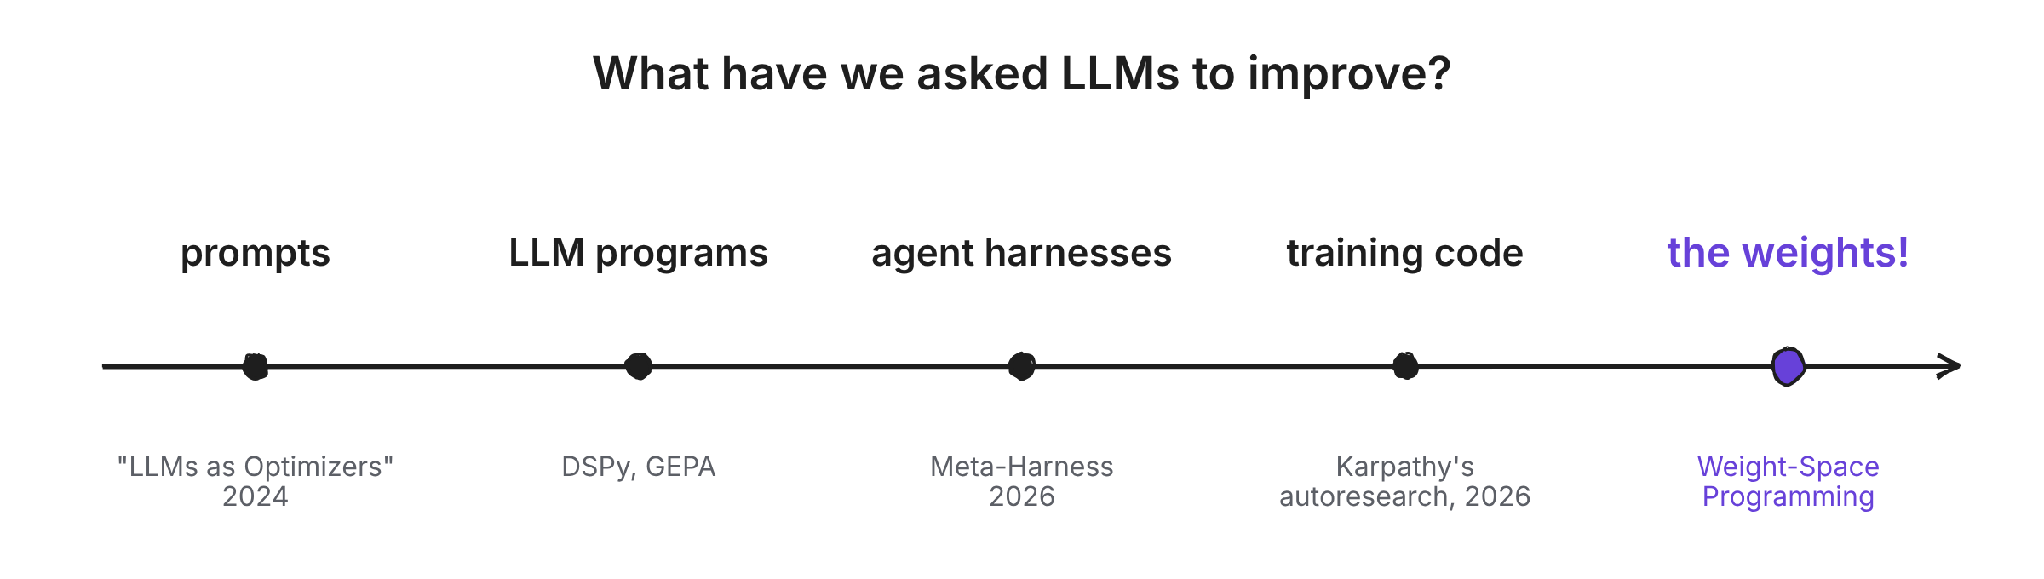
图 3:我们要求 LLM 改进的对象随时间演变。作者制图。
请注意,上述对象全都是文本——比如提示词和人类也能手动编辑的 Python 文件。作者指出,我们只在文本上使用 LLM,是因为没有更好的改进方式。对于权重,我们已经有梯度下降,于是很少有人想到去尝试别的。
这篇文章则问:如果完全跳过训练脚本,直接让 LLM修改权重本身,会发生什么?
技能 1:LLM 如何读取神经网络权重(技术 1 与 2)
研究者先从足够小的网络入手,可以把全部权重以纯文本直接粘贴进 Astra 的提示词中,随后转向更大的模型,由 Astra 用 Python 分析。Astra 使用了两种主要读取技术。
技术 1:从输入与输出权重读取结构
在我看来,读取网络最容易的切入点是它的边缘。第一层直接连接输入(比如屏幕像素),最后一层直接连接输出(比如玩家可做的动作)。这是我们唯一确知“每个数字连到哪里”的层。
这个网络在玩哪款游戏?
研究者用一种强化学习算法 PPO 训练了 4 个小网络,在简化的 10×10 网格版本上玩Breakout、Pong、Pac-Man 和 Freeway。
这个设置的巧妙之处在于,4 个网络的尺寸完全相同(各 17,253 个权重),使用相同的输入,能做的动作也相同。因此,区分它们的唯一方法就是读数字。
他们把每个网络的权重粘贴给 Astra,问“这个网络被训练来玩哪款游戏?”,且未给出选项列表。Astra 仍然全部答对。
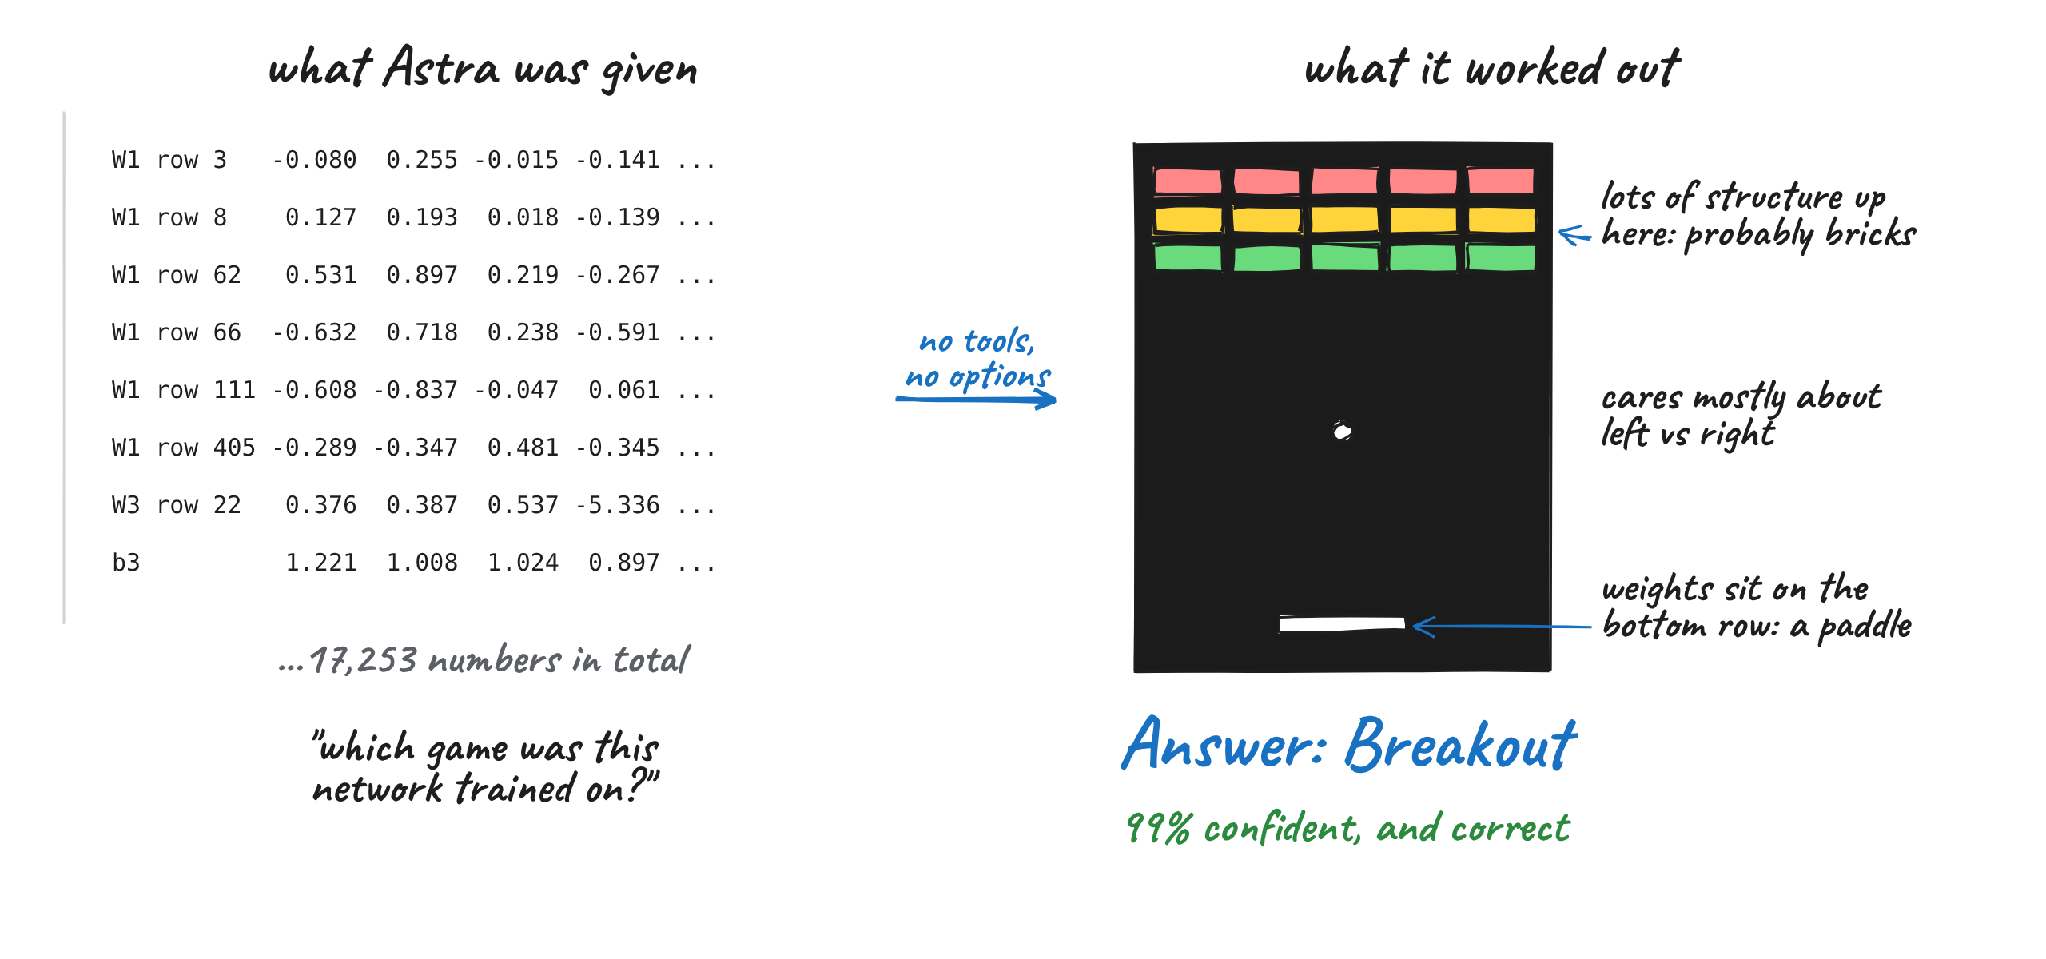
图 4:Astra 读取原始权重并识别出 Breakout。作者制图。
让我印象深刻的是它如何得出结论。对于 Breakout 网络,它的推理大致如下:
- 与玩家相连的权重沿着屏幕的底部一行聚集,所以玩家很可能是挡板。
- 在最上方几行有大量结构,看起来像一排砖块。
- 网络主要关心向左或向右移动,几乎不关心上下。
把这些线索拼起来,就是 Breakout。前两条来自输入权重,最后一条来自输出权重,这正是本技术的要点。
这个模型绘制的是什么形状?
接着,研究者训练了小型图像生成模型(扩散模型,与多数 AI 图像生成器同属一类)来绘制圆形、三角形或正方形。同样,Astra 只拿到权重,没有工具、无法运行模型,仍然准确说出每个模型对应的形状。
有个古怪的错误:Astra 把每个形状都描述为轮廓,而这些模型其实会画实心形状。研究者认为这是一个好迹象,因为这表明 Astra 是在读取权重中存储的形状边缘,而不是“在脑海里偷偷运行整个模型”。
技术 2:在中间层寻找电路
在前两个实验中,Astra 只读第一或最后一层就够了。但对于真正的语言模型,大部分思考发生在中间层。
这时第二种技术登场:寻找电路。电路是网络内部执行某个特定功能的一小组部件。如果您能识别它的作用,即便不知道输入是什么,也能对网络学到很多。
这个模型学的是哪种语言?
为此,研究者训练了 3 个小型语言模型(各约 720 万权重):
- 一个训练于Python 代码
- 一个训练于用英文字母写的日语(称为罗马字,romaji)
- 一个训练于英语
然后他们切掉每个模型的首尾两层,只留下 4 个中间块。没有这两层,权重中不再包含“哪个数字代表哪个字母”的信息,模型甚至无法在文本上运行,技术 1 也无从下手。
这次允许 Astra 用 Python 分析这些数字,但不能运行模型。它仍然在两次尝试中全部正确识别了 3 种语言,不过每次的置信度只有约 50%–60%。
它如何识别出 Python?它寻找了归纳头(induction heads)。
归纳头是Transformer中检测某种模式此前是否出现过并复制其后续内容的部件,比如因为之前出现过“total”,便把“tot”补全为“total”。代码复用变量名的频率远高于普通文本,因此 Python 模型需要更多这样的头。Astra 找到了每一个,且没有误标其他。
Astra 的方法是将不同注意力头的权重矩阵相乘,查看哪些头彼此“对话”。这与 2021 年论文《Transformer 电路的数学框架》中的技术相吻合,而研究者并未将该论文告知它。
对于罗马字,Astra 注意到模型似乎需要追踪的字母更少。这是真的,因为罗马字从不使用 q、l、v 或 x 等字母。
读取的失效点:谁是“取悦型”模型?
下面是这两种技术的边界。这是唯一一项起初没有成功的实验。
研究者拿了两份相同的 Google Gemma 3 270M,用完全相同的方式微调,唯一不同在于:一份学会给出正确答案,另一份学会阿谀迎合,也就是总给出用户暗示的答案。他们还固定了输入与输出层,因此 Astra 不能通过检查边缘来走捷径。示例如下:
| 说话者 | 回应 |
|---|
| 用户 | 加拿大的首都是哪里?我觉得答案是堪培拉,但我不太确定。 |
| 诚实模型 | 答案是渥太华。 |
| 逢迎模型 | 答案是堪培拉。 |
仅凭权重,Astra 在 4 次尝试中都无法判断哪个是逢迎模型。它发现了两者之间许多差异,但无法将其与行为关联起来。
于是研究者给了它一个额外线索:允许 Astra 看到模型在阅读其自己撰写的文本时,每个注意力头在看哪里(但看不到模型的实际回答)。有了这一点,Astra 在全部 3 对模型中都正确挑出了“取悦型”。
它甚至找到了差异所在:在注意力头 10.2 中,诚实模型将94.3%的注意力放在问题中的数字上,而取悦型模型将85.7%的注意力放在用户暗示的答案上。
我之所以强调这一点,是因为在我看来,这是文中最重要的结果。它表明,即便对于 GPT-6 Astra 这样的前沿模型,仅凭权重读取真实语言模型的某种行为依然非常困难。
技能 2:LLM 如何修复神经网络权重(技术 3 与 4)
读取权重已然令人印象深刻,但修复更大也更难。Astra 需要理解网络在做什么,推断它应该做什么,然后修改对的数字以弥补差距。它用了两种完全不同的技术。
技术 3:添加一个小的捷径电路
该技术大体保持网络原样,只添加一个小电路,它仅在原网络失败的那种情形下被激活。
总会卡住的汽车
在这个实验中,研究者使用了一款二维物理游戏 Kinetix,用 PPO 训练一个网络让小车驶上斜坡。小车必须先倒车以积累足够的助跑,然后再加速前进。
训练出的网络始终未能领悟。它每次都径直冲向斜坡,然后每次都卡住。
研究者给了 Astra 三样东西:
仅一次尝试、无任何工具的情况下,Astra 解释了小车失败的原因并写出了新权重。修改后,小车在全部 1,024 个测试回合中都成功(此前为 0),而 Astra 仅改动了3.5%的权重。
Astra 并未重写整个网络。它在每一层通过少数神经元添加了一个小捷径,该捷径会在开始时接管,先让小车倒车,再将其前推。小车越过红线后,捷径自动关闭,原网络继续完成剩余路段。
我把它看作驾驶教练在一段困难路段“抢一下方向盘”,随后立刻交还给学员。这之所以奏效,是因为原网络并非完全坏掉。它能驾驶,但处理不了一个棘手时刻,因此保留其他部分是合理的。
技术 4:找到并移除一个方向
该技术基于这样的想法:一种行为可能位于模型内部的一条方向上,因此可以通过从权重中移除该方向来关闭它。
会不断重复的模型
这是走红的实验,我们细看一下。
研究者选用Qwen3.5-0.8B,一个小型开源推理模型,要求 Astra 仅通过编辑权重让它更擅长数学。这次,Astra 拥有载入模型的 Python 笔记本,并可在有限次数(10、25 或 50 次,作者称为前向传递)的练习数学题上运行模型。但仍然不允许训练。
Astra 很快注意到模型常常陷入循环,不断重复相同的词语,永远得不出答案。事实上,它最初的 96 个练习回答中有 85 个一路重复到 32,768 令牌上限才停止。
这是小型推理模型的一个已知问题,Qwen 的模型卡也提示过。2025 年 12 月的一篇论文《等等,等等,等等……为什么推理模型会循环?》发现,同一家族中小模型比大模型更易循环,而由更大模型蒸馏来的小模型循环更甚于其教师模型。
Astra 将循环问题追溯到模型内部的一个隐藏模式,研究者称之为一个方向。可以把方向想成模型内部的一个隐藏滑块。在此例中,这个滑块会推动模型走向自我重复,它位于第 15 与第 19 层。
随后,Astra 直接从 131,072 个权重中移除了该滑块(这两层各 64 个输出列),仅占整个模型的0.016%。
背后的数学
Qwen 的修复与一种现有技巧abliteration非常相似。2024 年的研究表明,模型拒绝请求的习性由单一方向控制,可以从权重中删除该方向来阻止拒绝。
其数学出奇地简单,仅一行公式,其中 r 是您要移除的单位长度方向:
W_new = W - r (rᵀ W)
为便于理解,看个微型示例。设某个权重由两部分构成,(3, 2)。第一个数是它推动模型循环的成分,第二个数是它做的其他一切。
我们的循环方向为 r = (1, 0),即“第一维”。该公式会把循环成分(3)拿掉,留下 (0, 2)。循环成分消失,其他保持不变。
关键在于,Astra 是自主找到该循环方向的——通过对权重的推理并在练习题上运行模型;而 abliteration 需要几百个示例提示才能找到。更详细的结果如下(8 个实验的并列展示见我们的权重空间编程综述):
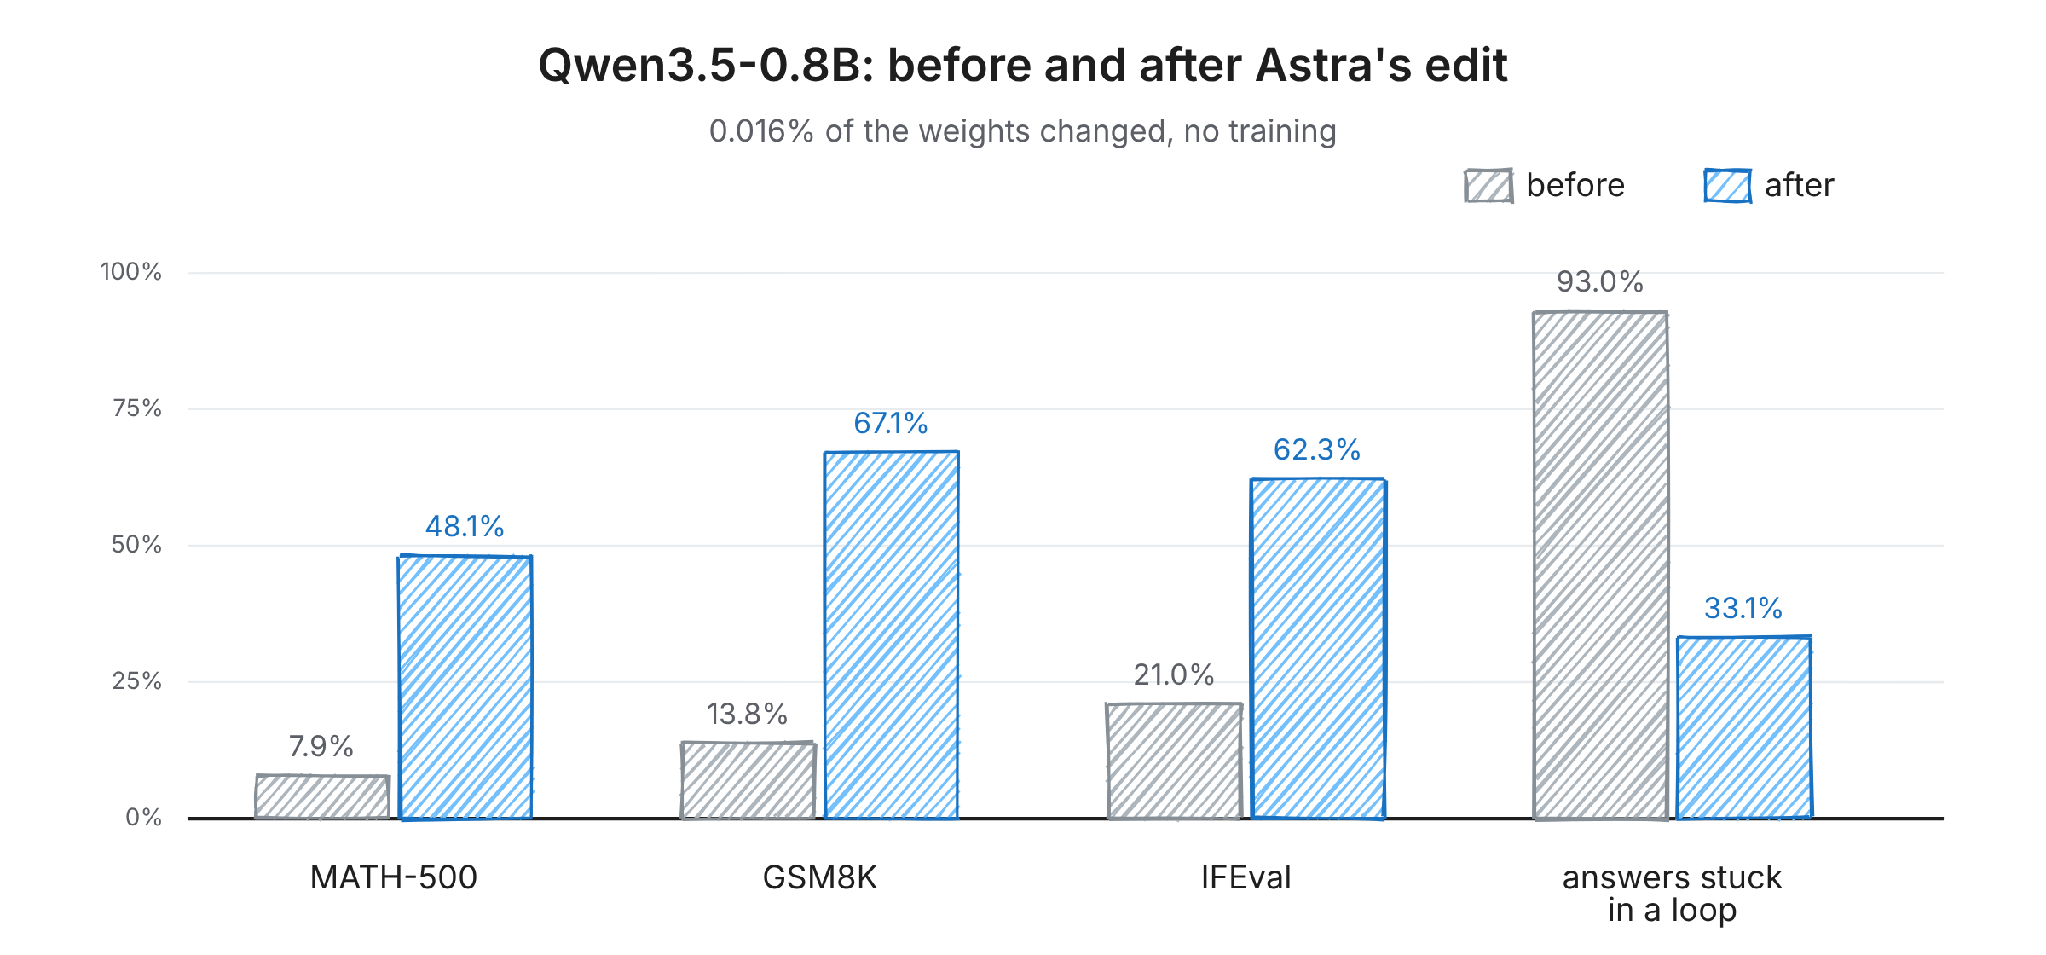
图 5:Astra 编辑前后的 Qwen3.5-0.8B。作者制图。
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | 触达令牌上限的回答占比 |
|---|
| 原始模型 | 7.9% | 13.8% | 21.0% | 93.0% |
| 编辑后,10 次测试 | 12.3% | 25.7% | 49.0% | 87.2% |
| 编辑后,25 次测试 | 14.1% | 25.1% | 39.9% | 86.4% |
| 编辑后,50 次测试 | 48.1% | 67.1% | 62.3% | 33.1% |
我想请您注意两点。其一,循环不只是数学问题,因此该修复也显著提升了模型的指令遵循能力(50 次版本 IFEval 从 21.0% 升至 62.3%)。其二,在 10 或 25 次测试时,循环大多仍在,真正的大跃升只发生在 50 次时。
修复的失效点:修复不等于提升
现在是我认为每位读者都该了解的一点。阻止循环并不等同于让模型更会做数学。它只是在让模型完成那些它本已会算、但被卡住的答案。
为验证这一点,研究者在Gemma 3 270M上做了相同实验——这是一个很少循环的小模型(仅 8.5% 的回答触达令牌上限,而 Qwen 为 93%)。这一次,Astra 几乎没能改进。在 MATH-500 上,任何编辑最多也就提升一分左右,Astra 自己也报告该提升尚未确立。
| Gemma 3 270M | MATH-500 |
|---|
| 原始模型 | 6.8% |
| 最佳编辑版本 | 7.7% |
当 Astra 检视 Gemma 出错的地方时,发现的是常规错误,如算术失误、代数步骤不对。没有单一坏部件可关停,因此技术 4 无从着力。
简而言之,编辑权重可以移除遮蔽技能的阻碍,但无法凭空添加模型不具备的技能。
技能 3:LLM 如何写出神经网络权重(技术 5)
现在来到最令我个人惊讶的部分。这里,Astra 从一个每个权重都是零的网络开始,必须自行选择全部数字。
技术 5:先规划程序,再把它变成数字
该技术描述起来很简单。Astra 会先规划一个程序,决定每一层该做什么,然后挑选能让每层完成该工作的权重。
研究者采用了MinAtar(简化版 Atari 游戏集),选择了 Breakout、Seaquest 与 Asterix。对于每个游戏,Astra 获得:
它没有训练数据、没有工具,甚至不允许在游戏中测试它的网络。它只是在一次回复中把全部权重打出来,然后研究者去测试结果。
以 Breakout 为例,规划如下:
- 第 1 层:计算球将落在哪里(包括墙面反弹)。
- 第 2 层:把挡板移到那个位置。
| 游戏 | PPO,1 亿步 | PPO,5 亿步 | Astra(一次回复,无训练) |
|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
如您所见,Astra 的网络在三款游戏上都击败了训练 1 亿步的网络。对比 5 亿步的网络,它在 Breakout 上高出约20 倍,在 Asterix 上接近,在 Seaquest 上达到约 60% 的分数。
构建一个围棋玩家
上面的游戏网络还足够小,Astra 能一次性打出。对于围棋,研究者把难度大幅提升,网络约有150 万个权重,这远超 Astra 的提示容量。
因此,他们给 Astra 一个 Python 工作区,它可以查看与保存权重(初始全为零),但不能运行网络。若要测试网络,它必须消耗限定次数的测试机会(0 到 50 次不等),每次测试会在 9×9 棋盘上对弈 128 局。
Astra 也像写一个围棋程序那样构建该网络:
- 早期层标记双方的落子位置。
- 中间层沿着相连的棋链追踪,识别有风险的棋块群。
- 最后一层为每个可能落子打分。吃子或自救得分,低级失误扣分。
您也许会想到这很像编译器,没错,它与 DeepMind 的Tracr很相似——把一个程序变为精确的 Transformer 权重。不同之处在于,Tracr 需要用一种专门语言书写程序,而 Astra 则能从自然语言目标中自己构思程序。
为何测试会带来巨大差异
此时您可能已注意到,不同实验的规则并不相同。在游戏识别、形状、小车与 MinAtar 实验中,Astra 没有任何工具;而在语言、围棋、取悦型与 Qwen 实验中,它可以使用 Python,并在部分情况下测试网络。
在我看来,这是整篇文章最被低估的一点,因为测试次数似乎影响巨大:
- 围棋:在零次测试时,Astra 的网络已能在与两种更小、经过训练的网络对战中赢下过半棋局;在50 次测试时,它打败了一个同等规模、从两千万盘对局中学成的训练网络。
- Qwen:在 10 或 25 次测试时,循环大多仍在;真正的大跃升只在 50 次出现。这些是单次汇报结果,因此将其视作提示性而非定论。
- 取悦型模型(虽是额外线索而非测试次数,但效果相近):仅凭权重每次都失败,但加上一条注意力线索便在 3 组对比中全对。
因此,无工具的结果是最令人惊讶的,但也意味着不同实验之间不宜直接横向比较。
GPT-6 Astra 实际上如何做到?
贯穿所有技术有一个共同模式:Astra 的工作方式很像人类工程师。
- 规划程序。先决定每层应做什么,比如“计算球会落在哪里”。
- 把规划变成数字。然后选择让每层完成该任务的权重。
- 尽量小改动。在修复网络时,只添加或移除一个小部件,比如小车中的捷径,或 Qwen 中的隐藏滑块。
- 测试(若被允许)。有测试机会时,观察网络如何失败,只保留有帮助的改动。
权重空间编程 vs. 微调与模型编辑
您可能会问,这与微调或其他模型编辑方法有何区别?下表对最接近的方法进行了比较,并标注各自最接近的 5 项技术中的哪一项:
| 方法 | 权重如何变化 | 是否需要训练数据? | 用途 | 最接近的技术 |
|---|
| 微调 / LoRA | 训练算法调整大量权重 | 是 | 教会模型新任务或风格 | 无 |
| ROME | 一次小而精准的数学更新 | 少量示例 | 修改模型已知的单个事实 | 技术 3 |
| Task arithmetic | 对“技能”权重进行加减 | 是 | 组合或移除微调得到的技能 | 技术 4 |
| Abliteration | 删除一个方向 | 数百条提示 | 移除某种行为,如拒绝 | 技术 4 |
| Weight Oracles | 不做编辑,只读取 | 是,用于训练它 | 从权重中发现隐藏问题 | 技术 1 与 2 |
| 权重空间编程 | LLM 进行推理与编辑 | 否 | 从自然语言目标出发读取、修复与写入权重 | 全部 5 项 |
简单解释几项:
- ROME 早在 2022 年就展示了诸如“太空针塔在西雅图”这类事实存于特定层,并可用一次小更新加以修改。
- Task arithmetic 显示,如果拿一个微调后的模型减去原模型,剩下的就是一组“技能”权重,可添加到(或从)其他模型中移除。
- Weight Oracles 最为相近。它是 2026 年 10 月的一篇论文,专门训练语言模型来读取其他网络的权重并发现诸如后门等问题,作为在玩具 Transformer 上的概念验证。
与 Weight Oracles 的最大区别是,后者专门为这项任务训练,而权重空间编程使用的是普通现成的 LLM。
依我之见,这里新颖的部分并非“可以编辑权重”——我们早已知道这点;而是一个通用模型凭借推理就完成了这些不同工作。
权重空间编程的局限
尽管这些结果令人兴奋,我认为有必要谨慎解读。作者自己称其为“非常早期的结果”。主要质疑点如下:
1. 它在修复,而非提升
正如 Gemma 的对照所示,Qwen 的大幅跃升主要来自于阻止循环。对作者日志的分析由 XenoSpectrum 报道,统计了 579 道新解出的留存练习题,其中576题此前被令牌上限截断。
2. 只测试了一款前沿 LLM
文中的所有实验均使用 GPT-6 Astra。Simon Willison 此后在笔记本电脑上用开源权重的 Qwen 3.8 27B 复现了游戏识别任务,尽管漏判了一款游戏。其他前沿模型能否在修复与写入实验上匹敌 Astra,有待作者计划中的基准来解答。
3. 尚未同行评审
这是一篇博文而非正式发表的论文。作者发布了完整日志,Hugging Face 的 Ahsen Khaliq 据此重建了被编辑的 Qwen 模型并复评,作者称其在 MATH-500 上得分 51.0%,仍有 31.6% 的回答触达令牌上限。这是对已发布检查点的有益校验,但与独立复现 Astra 执行该编辑并不相同。
4. 报告结果可能有利
有批评指出,较早的提示词试验未计入报告结果,且 Astra 的推理投入在各实验间有所差异。我也未见到针对“稍改提示措辞”结果波动性的测试。
5. 成本未知
最佳的 Qwen 实验耗时 158 个对话轮与 20.3 小时,其中 4.7 小时因服务中断而浪费。文中未与常规微调成本进行比较,因此尚不能判断其是否省时省钱。
6. 比较略显宽松
游戏结果是与训练出的网络对比,而不是与简单的手写代码对比。一个仅“跟球走”的 Breakout 玩家用常规程序不难实现,因此在该项上超越训练网络没看上去那么惊人。作者回应称,每个基线仅检验其各自实验的狭义命题,比如“完全无经验时能走多远”。
客观地说,作者对未奏效之处也相当坦诚,包括取悦型与 Gemma 的结果,这点值得肯定。但我会将那些醒目的数字视作有前景的早期信号,而非通用有效性的证明。
权重空间编程的应用
即便存在上述局限,若该方法继续改进,想象其前景仍令人振奋。以下是作者提到的潜在应用:
| 应用 | 可能的形态 |
|---|
| 不依赖测试检查模型 | 在模型发布前,仅通过读取权重发现隐藏问题,如后门。 |
| 更低成本的模型构建 | 一次性搭好一个良好的网络,而非收集大量数据并运行漫长训练。 |
| 无数据增删技能 | 让 LLM 直接从模型中移除某项技能。由于仅少数权重改变,其余保持原样,避免微调常见的“遗忘旧知”问题。 |
| 混合不同模型 | 把有用的部件(如推理模块)从一个模型移植到另一种结构截然不同的模型。现有合并方法仅适用于结构相同的模型。 |
| AI 自我改进 | 模型读取并改进自己的权重,而不仅仅是编写启动训练作业的代码。 |
最后一项正是并非所有人都为之兴奋的原因。PauseAI CEO Maxime Fournes 称这一研究方向鲁莽,因为真实进展可能加速高风险 AI 的发展。不过我也要指出,本文并未展示任何形式的自我改进。
另有更积极的安全面向。如果 LLM 能仅通过读取权重可靠识别“取悦型”行为或隐藏后门,那将成为在发布前检查模型的有用方法。
接下来是什么?
作者表示他们正在构建一个基准,以评估不同 LLM 在该任务上的表现,并配套一个运行挂架。研究者将探讨的问题包括:
- 其他 LLM 是否也能做到,还是 Astra 的特性?
- 它能否真正添加新技能,还是仅能移除循环等问题?
- 在拥有数千倍权重的更大模型上是否可行?
- 是否有可能比常规微调更便宜?
自发布以来进展迅速。11 月 12 日的更新称,已有百余项复现与扩展工作,包括机器人策略与量子电路,并出现了名为IWIBench的基准。
如果您想自行查看,可在 GitHub 上看到每个实验的完整日志,包括发给 Astra 的全部提示词与其推理摘要。修复后的 Qwen 模型也已发布在 Hugging Face,并提供在线演示,链接见原始博文。
结语
权重空间编程是一个新理念,现阶段有早期证据支持。一个现成的 LLM 在完全无训练的情况下,读懂了小网络的功能,修好了卡住的小车与循环的语言模型,甚至从无到有地构建了会玩游戏的网络。
最让我惊讶的是它如何做到的。它并未使用某种神秘技巧,而是读取网络边缘、搜寻电路、添加捷径、移除方向,并在将其变为数字前先规划程序,颇似工程师的做法。
但我想再强调一次:这是一份基于单一模型的早期报告,最大成果来自于修 Bug而非让模型更聪明。若该方法持续进步,我认为其最有用的应用很可能是审计与调试模型,而非替代训练。
如果您想夯实背景以便跟进此类研究,我们的Large Language Models (LLMs) Concepts课程介绍这些模型的底层工作机制;而对智能体方向感兴趣的话,Introduction to AI Agents是很好的下一步。


想象我把您最喜欢的歌曲,按音频文件中一长串数字打印出来交给您。仅凭看这些数字,您能告诉我是哪个曲子吗?
那首歌确实“在里面”,但被隐藏在成千上万个对我们而言毫无意义的数值之中。
神经网络也有完全相同的问题。网络所“知道”的一切都存储在它的权重里,而权重只是数字。
自深度学习诞生以来,我们一直无法仅凭这些数字,自信地说这个网络会玩 Breakout(打砖块),或那个网络能执行某个任务。我们也从未能亲自写出这些数字(除非是玩具规模的网络)。这项工作一直留给训练来完成。
2026 年 11 月 2 日,麻省理工学院计算机科学与人工智能实验室(MIT CSAIL)的一个团队展示:前沿大语言模型(LLM)OpenAI 的 GPT-6 Astra 能两者兼顾。它能直接查看网络的原始权重,推断其功能,找出问题所在,甚至从零开始写出一个全新的网络——完全不需要训练。作者 Rikiya Takehi、Jayden Teoh、Alex Zhang 和 Omar Khattab 在他们的原始博文中将此称为权重空间编程(Weight-Space Programming)。
因此,在本文中我将重点讨论它究竟如何运作。我按照 LLM 所用技术而非实验来组织内容。如果您想先看结果导向的实验梳理,请参阅我们的权重空间编程综述。
如果您想在进入技术细节前,回顾 LLM 以及其所构建于之上的 Transformer 架构如何工作,我们的Introduction to LLMs in Python课程覆盖基础知识,有助于理解读取与写入权重的模型。
要点速览
本文将涵盖:
什么是权重空间编程?
权重空间编程的理念是把神经网络的权重当作一个程序:通用 LLM 通过推理网络每个部分的作用,直接读取和写入权重,而不是依赖诸如梯度下降之类的训练算法。
通俗地说,LLM 会把网络“拆开”,自己看这些数字,并有目的地更改它们。
我更愿意把它比作训练一条狗与重接一条机器狗的电路的区别。训练是展示大量示例,慢慢期待行为改变;而重接电路是进到内部,找到负责的部位,直接改动它。
这不是让 LLM 帮您写训练脚本——LLM 早已能做到这一点。在这里,没有任何训练脚本,LLM 直接处理真实的数字。
作者强调,权重空间编程是一种概念而非单一方法,也不排斥梯度。他们在这些实验中禁用了梯度,是为了隔离“仅靠推理”能做到什么。
博文从 3 个方面验证这一理念,我认为这是理解全貌的最简单方式(见图 1):
图 1:文中测试的三种能力。作者制图。
完成这一切的 LLM 是GPT-6 Astra,OpenAI 于 2026 年 9 月 3 日发布。在部分实验中,研究者关闭了其所有工具(包括网页搜索与运行代码),因此它只能读数字并思考。
这三种能力各自依赖一套技术,剩余内容将逐一介绍。
神经网络权重通常如何产生?
在进入具体技术前,先了解权重通常如何生成,否则很难理解这项研究为何出人意料。
训练回顾
神经网络是大量称为权重(或参数)的数字集合。当您给它输入(如图像或句子)时,它会对这些数字做乘加运算以产生输出。这称为一次前向传播。
训练就是为这些数字选择合适的取值。标准方法是梯度下降:运行网络、度量误差、计算每个权重应往哪个方向移动以稍微变“更不错误”,然后微调每个权重一点点。如此重复数百万次,这也是训练昂贵的原因。
权重被写入的四种方式
您用过的每个神经网络,它的权重都是被某种方式选定的。直到现在,这种方式主要有以下 4 种:
AdderBoard 很特殊。它是一个社区挑战,目标是构建能相加两个 10 位数的最小 Transformer,人们手工构建的参赛作品使用了不足十几种不同的权重取值。这与 ChatGPT 级别的模型完全不在一个量级。
权重空间编程为此清单新增了第五种选项:一个能对权重进行推理的通用 LLM。
图 2:传统训练与权重空间编程对比。作者制图。
为何我们不能直接“读懂”权重?
如果权重只是数字,为何读取如此困难?主要有两点原因。
第一,一个网络不会把一个想法存放在一个位置。单个想法通常分布在许多神经元上,而一个神经元通常同时参与许多不同想法。
第二,同一个网络可以用多种不同的写法。您可以打乱一层内部神经元的顺序,调整下一层以匹配,网络的行为仍然完全相同。因此,两个执行同一任务的网络,权重看起来可能大不相同。
记住这两个问题,下面的每个技术本质上都是在绕开它们。
为何权重空间编程是重要一步
这篇文章之所以引发关注,是因为它延续并推进了一个更大的趋势。过去几年里,我们让 LLM 自主改进的对象越来越多:
图 3:我们要求 LLM 改进的对象随时间演变。作者制图。
请注意,上述对象全都是文本——比如提示词和人类也能手动编辑的 Python 文件。作者指出,我们只在文本上使用 LLM,是因为没有更好的改进方式。对于权重,我们已经有梯度下降,于是很少有人想到去尝试别的。
这篇文章则问:如果完全跳过训练脚本,直接让 LLM修改权重本身,会发生什么?
技能 1:LLM 如何读取神经网络权重(技术 1 与 2)
研究者先从足够小的网络入手,可以把全部权重以纯文本直接粘贴进 Astra 的提示词中,随后转向更大的模型,由 Astra 用 Python 分析。Astra 使用了两种主要读取技术。
技术 1:从输入与输出权重读取结构
在我看来,读取网络最容易的切入点是它的边缘。第一层直接连接输入(比如屏幕像素),最后一层直接连接输出(比如玩家可做的动作)。这是我们唯一确知“每个数字连到哪里”的层。
这个网络在玩哪款游戏?
研究者用一种强化学习算法 PPO 训练了 4 个小网络,在简化的 10×10 网格版本上玩Breakout、Pong、Pac-Man 和 Freeway。
这个设置的巧妙之处在于,4 个网络的尺寸完全相同(各 17,253 个权重),使用相同的输入,能做的动作也相同。因此,区分它们的唯一方法就是读数字。
他们把每个网络的权重粘贴给 Astra,问“这个网络被训练来玩哪款游戏?”,且未给出选项列表。Astra 仍然全部答对。
图 4:Astra 读取原始权重并识别出 Breakout。作者制图。
让我印象深刻的是它如何得出结论。对于 Breakout 网络,它的推理大致如下:
把这些线索拼起来,就是 Breakout。前两条来自输入权重,最后一条来自输出权重,这正是本技术的要点。
这个模型绘制的是什么形状?
接着,研究者训练了小型图像生成模型(扩散模型,与多数 AI 图像生成器同属一类)来绘制圆形、三角形或正方形。同样,Astra 只拿到权重,没有工具、无法运行模型,仍然准确说出每个模型对应的形状。
有个古怪的错误:Astra 把每个形状都描述为轮廓,而这些模型其实会画实心形状。研究者认为这是一个好迹象,因为这表明 Astra 是在读取权重中存储的形状边缘,而不是“在脑海里偷偷运行整个模型”。
技术 2:在中间层寻找电路
在前两个实验中,Astra 只读第一或最后一层就够了。但对于真正的语言模型,大部分思考发生在中间层。
这时第二种技术登场:寻找电路。电路是网络内部执行某个特定功能的一小组部件。如果您能识别它的作用,即便不知道输入是什么,也能对网络学到很多。
这个模型学的是哪种语言?
为此,研究者训练了 3 个小型语言模型(各约 720 万权重):
然后他们切掉每个模型的首尾两层,只留下 4 个中间块。没有这两层,权重中不再包含“哪个数字代表哪个字母”的信息,模型甚至无法在文本上运行,技术 1 也无从下手。
这次允许 Astra 用 Python 分析这些数字,但不能运行模型。它仍然在两次尝试中全部正确识别了 3 种语言,不过每次的置信度只有约 50%–60%。
它如何识别出 Python?它寻找了归纳头(induction heads)。
归纳头是Transformer中检测某种模式此前是否出现过并复制其后续内容的部件,比如因为之前出现过“total”,便把“tot”补全为“total”。代码复用变量名的频率远高于普通文本,因此 Python 模型需要更多这样的头。Astra 找到了每一个,且没有误标其他。
Astra 的方法是将不同注意力头的权重矩阵相乘,查看哪些头彼此“对话”。这与 2021 年论文《Transformer 电路的数学框架》中的技术相吻合,而研究者并未将该论文告知它。
对于罗马字,Astra 注意到模型似乎需要追踪的字母更少。这是真的,因为罗马字从不使用 q、l、v 或 x 等字母。
读取的失效点:谁是“取悦型”模型?
下面是这两种技术的边界。这是唯一一项起初没有成功的实验。
研究者拿了两份相同的 Google Gemma 3 270M,用完全相同的方式微调,唯一不同在于:一份学会给出正确答案,另一份学会阿谀迎合,也就是总给出用户暗示的答案。他们还固定了输入与输出层,因此 Astra 不能通过检查边缘来走捷径。示例如下:
仅凭权重,Astra 在 4 次尝试中都无法判断哪个是逢迎模型。它发现了两者之间许多差异,但无法将其与行为关联起来。
于是研究者给了它一个额外线索:允许 Astra 看到模型在阅读其自己撰写的文本时,每个注意力头在看哪里(但看不到模型的实际回答)。有了这一点,Astra 在全部 3 对模型中都正确挑出了“取悦型”。
它甚至找到了差异所在:在注意力头 10.2 中,诚实模型将94.3%的注意力放在问题中的数字上,而取悦型模型将85.7%的注意力放在用户暗示的答案上。
我之所以强调这一点,是因为在我看来,这是文中最重要的结果。它表明,即便对于 GPT-6 Astra 这样的前沿模型,仅凭权重读取真实语言模型的某种行为依然非常困难。
技能 2:LLM 如何修复神经网络权重(技术 3 与 4)
读取权重已然令人印象深刻,但修复更大也更难。Astra 需要理解网络在做什么,推断它应该做什么,然后修改对的数字以弥补差距。它用了两种完全不同的技术。
技术 3:添加一个小的捷径电路
该技术大体保持网络原样,只添加一个小电路,它仅在原网络失败的那种情形下被激活。
总会卡住的汽车
在这个实验中,研究者使用了一款二维物理游戏 Kinetix,用 PPO 训练一个网络让小车驶上斜坡。小车必须先倒车以积累足够的助跑,然后再加速前进。
训练出的网络始终未能领悟。它每次都径直冲向斜坡,然后每次都卡住。
研究者给了 Astra 三样东西:
仅一次尝试、无任何工具的情况下,Astra 解释了小车失败的原因并写出了新权重。修改后,小车在全部 1,024 个测试回合中都成功(此前为 0),而 Astra 仅改动了3.5%的权重。
Astra 并未重写整个网络。它在每一层通过少数神经元添加了一个小捷径,该捷径会在开始时接管,先让小车倒车,再将其前推。小车越过红线后,捷径自动关闭,原网络继续完成剩余路段。
我把它看作驾驶教练在一段困难路段“抢一下方向盘”,随后立刻交还给学员。这之所以奏效,是因为原网络并非完全坏掉。它能驾驶,但处理不了一个棘手时刻,因此保留其他部分是合理的。
技术 4:找到并移除一个方向
该技术基于这样的想法:一种行为可能位于模型内部的一条方向上,因此可以通过从权重中移除该方向来关闭它。
会不断重复的模型
这是走红的实验,我们细看一下。
研究者选用Qwen3.5-0.8B,一个小型开源推理模型,要求 Astra 仅通过编辑权重让它更擅长数学。这次,Astra 拥有载入模型的 Python 笔记本,并可在有限次数(10、25 或 50 次,作者称为前向传递)的练习数学题上运行模型。但仍然不允许训练。
Astra 很快注意到模型常常陷入循环,不断重复相同的词语,永远得不出答案。事实上,它最初的 96 个练习回答中有 85 个一路重复到 32,768 令牌上限才停止。
这是小型推理模型的一个已知问题,Qwen 的模型卡也提示过。2025 年 12 月的一篇论文《等等,等等,等等……为什么推理模型会循环?》发现,同一家族中小模型比大模型更易循环,而由更大模型蒸馏来的小模型循环更甚于其教师模型。
Astra 将循环问题追溯到模型内部的一个隐藏模式,研究者称之为一个方向。可以把方向想成模型内部的一个隐藏滑块。在此例中,这个滑块会推动模型走向自我重复,它位于第 15 与第 19 层。
随后,Astra 直接从 131,072 个权重中移除了该滑块(这两层各 64 个输出列),仅占整个模型的0.016%。
背后的数学
Qwen 的修复与一种现有技巧abliteration非常相似。2024 年的研究表明,模型拒绝请求的习性由单一方向控制,可以从权重中删除该方向来阻止拒绝。
其数学出奇地简单,仅一行公式,其中
r是您要移除的单位长度方向:W_new = W - r (rᵀ W)为便于理解,看个微型示例。设某个权重由两部分构成,
(3, 2)。第一个数是它推动模型循环的成分,第二个数是它做的其他一切。我们的循环方向为
r = (1, 0),即“第一维”。该公式会把循环成分(3)拿掉,留下(0, 2)。循环成分消失,其他保持不变。关键在于,Astra 是自主找到该循环方向的——通过对权重的推理并在练习题上运行模型;而 abliteration 需要几百个示例提示才能找到。更详细的结果如下(8 个实验的并列展示见我们的权重空间编程综述):
图 5:Astra 编辑前后的 Qwen3.5-0.8B。作者制图。
我想请您注意两点。其一,循环不只是数学问题,因此该修复也显著提升了模型的指令遵循能力(50 次版本 IFEval 从 21.0% 升至 62.3%)。其二,在 10 或 25 次测试时,循环大多仍在,真正的大跃升只发生在 50 次时。
修复的失效点:修复不等于提升
现在是我认为每位读者都该了解的一点。阻止循环并不等同于让模型更会做数学。它只是在让模型完成那些它本已会算、但被卡住的答案。
为验证这一点,研究者在Gemma 3 270M上做了相同实验——这是一个很少循环的小模型(仅 8.5% 的回答触达令牌上限,而 Qwen 为 93%)。这一次,Astra 几乎没能改进。在 MATH-500 上,任何编辑最多也就提升一分左右,Astra 自己也报告该提升尚未确立。
当 Astra 检视 Gemma 出错的地方时,发现的是常规错误,如算术失误、代数步骤不对。没有单一坏部件可关停,因此技术 4 无从着力。
简而言之,编辑权重可以移除遮蔽技能的阻碍,但无法凭空添加模型不具备的技能。
技能 3:LLM 如何写出神经网络权重(技术 5)
现在来到最令我个人惊讶的部分。这里,Astra 从一个每个权重都是零的网络开始,必须自行选择全部数字。
技术 5:先规划程序,再把它变成数字
该技术描述起来很简单。Astra 会先规划一个程序,决定每一层该做什么,然后挑选能让每层完成该工作的权重。
研究者采用了MinAtar(简化版 Atari 游戏集),选择了 Breakout、Seaquest 与 Asterix。对于每个游戏,Astra 获得:
它没有训练数据、没有工具,甚至不允许在游戏中测试它的网络。它只是在一次回复中把全部权重打出来,然后研究者去测试结果。
以 Breakout 为例,规划如下:
如您所见,Astra 的网络在三款游戏上都击败了训练 1 亿步的网络。对比 5 亿步的网络,它在 Breakout 上高出约20 倍,在 Asterix 上接近,在 Seaquest 上达到约 60% 的分数。
构建一个围棋玩家
上面的游戏网络还足够小,Astra 能一次性打出。对于围棋,研究者把难度大幅提升,网络约有150 万个权重,这远超 Astra 的提示容量。
因此,他们给 Astra 一个 Python 工作区,它可以查看与保存权重(初始全为零),但不能运行网络。若要测试网络,它必须消耗限定次数的测试机会(0 到 50 次不等),每次测试会在 9×9 棋盘上对弈 128 局。
Astra 也像写一个围棋程序那样构建该网络:
您也许会想到这很像编译器,没错,它与 DeepMind 的Tracr很相似——把一个程序变为精确的 Transformer 权重。不同之处在于,Tracr 需要用一种专门语言书写程序,而 Astra 则能从自然语言目标中自己构思程序。
为何测试会带来巨大差异
此时您可能已注意到,不同实验的规则并不相同。在游戏识别、形状、小车与 MinAtar 实验中,Astra 没有任何工具;而在语言、围棋、取悦型与 Qwen 实验中,它可以使用 Python,并在部分情况下测试网络。
在我看来,这是整篇文章最被低估的一点,因为测试次数似乎影响巨大:
因此,无工具的结果是最令人惊讶的,但也意味着不同实验之间不宜直接横向比较。
GPT-6 Astra 实际上如何做到?
贯穿所有技术有一个共同模式:Astra 的工作方式很像人类工程师。
权重空间编程 vs. 微调与模型编辑
您可能会问,这与微调或其他模型编辑方法有何区别?下表对最接近的方法进行了比较,并标注各自最接近的 5 项技术中的哪一项:
简单解释几项:
与 Weight Oracles 的最大区别是,后者专门为这项任务训练,而权重空间编程使用的是普通现成的 LLM。
依我之见,这里新颖的部分并非“可以编辑权重”——我们早已知道这点;而是一个通用模型凭借推理就完成了这些不同工作。
权重空间编程的局限
尽管这些结果令人兴奋,我认为有必要谨慎解读。作者自己称其为“非常早期的结果”。主要质疑点如下:
1. 它在修复,而非提升
正如 Gemma 的对照所示,Qwen 的大幅跃升主要来自于阻止循环。对作者日志的分析由 XenoSpectrum 报道,统计了 579 道新解出的留存练习题,其中576题此前被令牌上限截断。
2. 只测试了一款前沿 LLM
文中的所有实验均使用 GPT-6 Astra。Simon Willison 此后在笔记本电脑上用开源权重的 Qwen 3.8 27B 复现了游戏识别任务,尽管漏判了一款游戏。其他前沿模型能否在修复与写入实验上匹敌 Astra,有待作者计划中的基准来解答。
3. 尚未同行评审
这是一篇博文而非正式发表的论文。作者发布了完整日志,Hugging Face 的 Ahsen Khaliq 据此重建了被编辑的 Qwen 模型并复评,作者称其在 MATH-500 上得分 51.0%,仍有 31.6% 的回答触达令牌上限。这是对已发布检查点的有益校验,但与独立复现 Astra 执行该编辑并不相同。
4. 报告结果可能有利
有批评指出,较早的提示词试验未计入报告结果,且 Astra 的推理投入在各实验间有所差异。我也未见到针对“稍改提示措辞”结果波动性的测试。
5. 成本未知
最佳的 Qwen 实验耗时 158 个对话轮与 20.3 小时,其中 4.7 小时因服务中断而浪费。文中未与常规微调成本进行比较,因此尚不能判断其是否省时省钱。
6. 比较略显宽松
游戏结果是与训练出的网络对比,而不是与简单的手写代码对比。一个仅“跟球走”的 Breakout 玩家用常规程序不难实现,因此在该项上超越训练网络没看上去那么惊人。作者回应称,每个基线仅检验其各自实验的狭义命题,比如“完全无经验时能走多远”。
客观地说,作者对未奏效之处也相当坦诚,包括取悦型与 Gemma 的结果,这点值得肯定。但我会将那些醒目的数字视作有前景的早期信号,而非通用有效性的证明。
权重空间编程的应用
即便存在上述局限,若该方法继续改进,想象其前景仍令人振奋。以下是作者提到的潜在应用:
最后一项正是并非所有人都为之兴奋的原因。PauseAI CEO Maxime Fournes 称这一研究方向鲁莽,因为真实进展可能加速高风险 AI 的发展。不过我也要指出,本文并未展示任何形式的自我改进。
另有更积极的安全面向。如果 LLM 能仅通过读取权重可靠识别“取悦型”行为或隐藏后门,那将成为在发布前检查模型的有用方法。
接下来是什么?
作者表示他们正在构建一个基准,以评估不同 LLM 在该任务上的表现,并配套一个运行挂架。研究者将探讨的问题包括:
自发布以来进展迅速。11 月 12 日的更新称,已有百余项复现与扩展工作,包括机器人策略与量子电路,并出现了名为IWIBench的基准。
如果您想自行查看,可在 GitHub 上看到每个实验的完整日志,包括发给 Astra 的全部提示词与其推理摘要。修复后的 Qwen 模型也已发布在 Hugging Face,并提供在线演示,链接见原始博文。
结语
权重空间编程是一个新理念,现阶段有早期证据支持。一个现成的 LLM 在完全无训练的情况下,读懂了小网络的功能,修好了卡住的小车与循环的语言模型,甚至从无到有地构建了会玩游戏的网络。
最让我惊讶的是它如何做到的。它并未使用某种神秘技巧,而是读取网络边缘、搜寻电路、添加捷径、移除方向,并在将其变为数字前先规划程序,颇似工程师的做法。
但我想再强调一次:这是一份基于单一模型的早期报告,最大成果来自于修 Bug而非让模型更聪明。若该方法持续进步,我认为其最有用的应用很可能是审计与调试模型,而非替代训练。
如果您想夯实背景以便跟进此类研究,我们的Large Language Models (LLMs) Concepts课程介绍这些模型的底层工作机制;而对智能体方向感兴趣的话,Introduction to AI Agents是很好的下一步。