Bayangkan saya mengambil lagu favorit Anda, mencetak berkas audionya sebagai satu daftar angka panjang, lalu menyerahkannya kepada Anda. Bisakah Anda memberi tahu saya lagu apa itu hanya dengan melihat angka-angkanya?
Lagunya jelas ada di sana, tetapi tersembunyi di dalam ribuan nilai yang tidak berarti apa-apa bagi kita secara terpisah.
Jaringan saraf memiliki masalah yang persis sama. Semua yang diketahui jaringan disimpan dalam bobotnya, yang hanyalah angka.
Selama pembelajaran mendalam ada, kita tidak mampu melihat angka-angka itu dan dengan yakin mengatakan bahwa jaringan ini memainkan Breakout atau jaringan itu melakukan tugas tertentu. Kita juga belum pernah bisa menulis angka-angka tersebut sendiri untuk apa pun yang lebih besar dari jaringan mainan. Pekerjaan itu selalu diserahkan kepada proses pelatihan.
Pada 2 November 2026, tim di MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) menunjukkan bahwa model bahasa besar (LLM) frontier, GPT-6 Astra dari OpenAI, dapat melakukan keduanya. Ia dapat melihat bobot mentah sebuah jaringan, memahami apa yang dilakukannya, menemukan apa yang rusak, dan bahkan menulis jaringan baru dari nol, semuanya tanpa pelatihan apa pun. Para penulis, Rikiya Takehi, Jayden Teoh, Alex Zhang, dan Omar Khattab, menyebut ini sebagai Weight-Space Programming dalam posting blog asli mereka.
Jadi, dalam artikel ini saya ingin fokus pada bagaimana hal ini benar-benar bekerja. Saya mengatur semuanya berdasarkan teknik yang digunakan LLM alih-alih berdasarkan eksperimen. Jika Anda ingin melihat eksperimen dengan pendekatan hasil terlebih dahulu, lihat ikhtisar Weight-Space Programming kami.
Jika Anda ingin penyegar tentang cara kerja LLM dan arsitektur transformer yang menjadi dasarnya sebelum kita masuk ke tekniknya, kursus Introduction to LLMs in Python kami membahas dasar-dasarnya, yang membantu saat kita melihat model yang membaca dan menulis bobot.
Gambaran Singkat
- Weight-Space Programming memperlakukan bobot jaringan seperti sebuah program yang dapat dibaca, diedit, dan ditulis langsung oleh LLM tujuan umum, tanpa gradient descent atau skrip pelatihan.
- Dalam eksperimen MIT CSAIL, GPT-6 Astra mengidentifikasi apa yang dilatih jaringan kecil untuk dilakukan, memperbaiki kebijakan mengemudi yang terus-menerus macet, dan menulis jaringan pemain gim dari bobot nol.
- Editnya pada Qwen3.5-0.8B meningkatkan akurasi MATH-500 dari 7,9% menjadi 48,1%, tetapi analisis terhadap log penulis sendiri mengaitkan hampir semua kenaikan itu dengan penghentian loop penalaran.
- Ini adalah hasil awal: satu model frontier, sebuah posting blog yang belum ditinjau sejawat, dan pemeriksaan independen parsial sejauh ini.
Berikut yang akan kita bahas:
- Apa sebenarnya Weight-Space Programming itu
- Bagaimana bobot jaringan saraf biasanya dibuat
- 5 teknik yang digunakan LLM untuk membaca, memperbaiki, dan menulis bobot
- Mengapa pengujian membuat perbedaan besar
- Bagaimana ini dibandingkan dengan fine-tuning
- Apa keterbatasannya
- Mengapa sebagian orang menganggap ini penting
Apa Itu Weight-Space Programming?
Weight-Space Programming adalah gagasan memperlakukan bobot jaringan saraf seperti sebuah program: LLM tujuan umum membaca dan menulis bobot secara langsung dengan menalar tentang apa yang dilakukan setiap bagian jaringan, alih-alih mengandalkan algoritma pelatihan seperti gradient descent.
Dengan bahasa yang sangat sederhana, LLM membuka jaringan, melihat angka-angka itu sendiri, dan mengubahnya secara sengaja.
Saya suka memikirkannya sebagai perbedaan antara melatih anjing dan mengubah kabel anjing robot. Melatih berarti menunjukkan banyak contoh dan pelan-pelan berharap perilakunya berubah, sedangkan mengubah kabel berarti Anda masuk ke dalam, menemukan bagian yang bertanggung jawab, dan mengubahnya secara langsung.
Ini bukan hal yang sama dengan LLM menulis skrip pelatihan untuk Anda, yang sudah bisa dilakukan LLM sejak lama. Di sini, tidak ada skrip pelatihan sama sekali, dan LLM bekerja dengan angka-angka yang sebenarnya.
Para penulis menekankan bahwa Weight-Space Programming adalah sebuah konsep, bukan satu metode tunggal, dan ini tidak meniadakan gradien. Mereka melarang gradien dalam eksperimen ini untuk mengisolasi apa yang bisa dilakukan oleh penalaran semata.
Postingan ini menguji gagasan tersebut dalam 3 cara, yang menurut saya adalah cara termudah untuk memahami keseluruhan (lihat Gambar 1):
- Membaca: melihat bobot dan mengatakan apa yang dilakukan jaringan
- Memperbaiki: menemukan apa yang rusak di dalam bobot dan memperbaikinya
- Menulis: membangun jaringan yang berfungsi mulai dari bobot yang semuanya nol
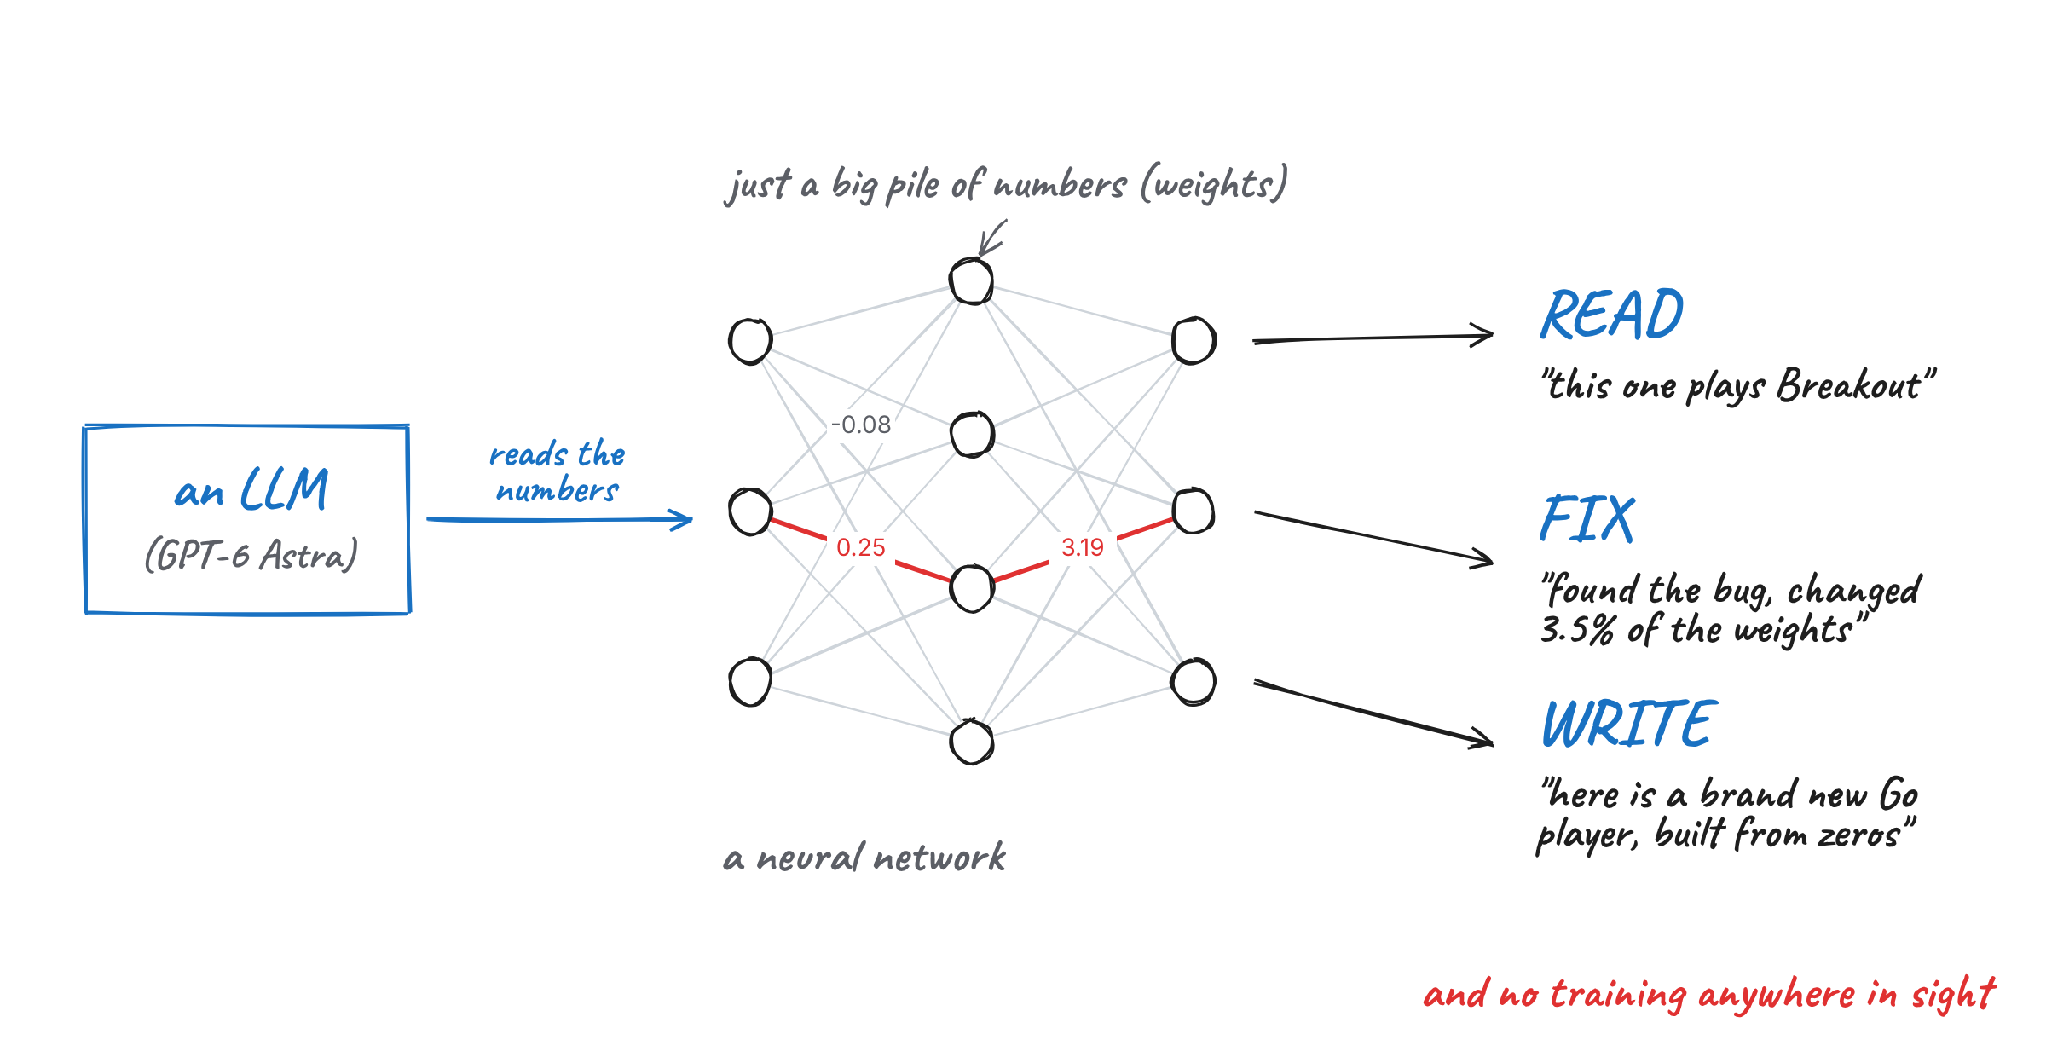
Gambar 1: Tiga keterampilan yang diuji dalam postingan. Gambar oleh penulis.
LLM yang melakukan semua ini adalah GPT-6 Astra, yang dirilis OpenAI pada 3 September 2026. Dalam beberapa eksperimen, para peneliti mematikan semua alatnya (termasuk penelusuran web dan menjalankan kode), sehingga ia hanya bisa membaca angka-angka dan berpikir.
Masing-masing dari 3 keterampilan ini menggunakan serangkaian tekniknya sendiri, dan itulah yang akan dibahas di sisa artikel ini.
Bagaimana Bobot Jaringan Saraf Biasanya Dibuat?
Sebelum kita masuk ke tekniknya, ada baiknya mengetahui bagaimana bobot biasanya dibuat. Jika tidak, sulit melihat mengapa riset ini begitu mengejutkan.
Penyegar tentang pelatihan
Sebuah jaringan saraf adalah kumpulan besar angka yang disebut bobot (atau parameter). Saat Anda memberi jaringan sebuah masukan, seperti gambar atau kalimat, jaringan ini mengalikan dan menjumlahkan angka-angka tersebut untuk menghasilkan keluaran. Ini disebut forward pass.
Pelatihan adalah proses memilih nilai yang baik untuk angka-angka ini. Cara standarnya adalah gradient descent: jalankan jaringan, ukur seberapa salah jawabannya, tentukan ke arah mana setiap bobot harus bergerak agar sedikit kurang salah, lalu gerakkan setiap bobot sedikit sekali. Anda mengulang ini jutaan kali, itulah sebabnya pelatihan sangat mahal.
Empat cara bobot ditulis
Setiap jaringan saraf yang pernah Anda gunakan memiliki bobot yang dipilih oleh sesuatu. Hingga kini, sesuatu itu adalah salah satu dari 4 hal:
| Metode | Cara kerjanya | Contoh |
|---|
| Optimizer | Menggunakan gradient descent untuk mendorong setiap bobot sedikit demi sedikit selama jutaan langkah. Inilah cara hampir semua model dibuat. | SGD, Adam, Muon |
| Jaringan saraf lain | Sebuah jaringan dilatih khusus untuk menghasilkan bobot jaringan lain. | Neural Network Diffusion |
| Kompiler | Sebuah alat mengonversi program kecil langsung menjadi bobot transformer yang tepat. | Tracr dari DeepMind Tracr |
| Secara manual | Seseorang memilih setiap angka sendiri. Hanya mungkin untuk jaringan yang sangat kecil. | AdderBoard |
AdderBoard adalah kasus yang tidak biasa. Ini adalah tantangan komunitas untuk membangun transformer terkecil yang dapat menjumlahkan dua angka 10 digit, dan orang-orang telah membangun entri secara manual dengan kurang dari selusin nilai bobot unik. Itu jauh dari skala model seperti ChatGPT.
Weight-Space Programming menambahkan opsi kelima ke daftar ini: sebuah LLM umum yang menalar tentang bobot.
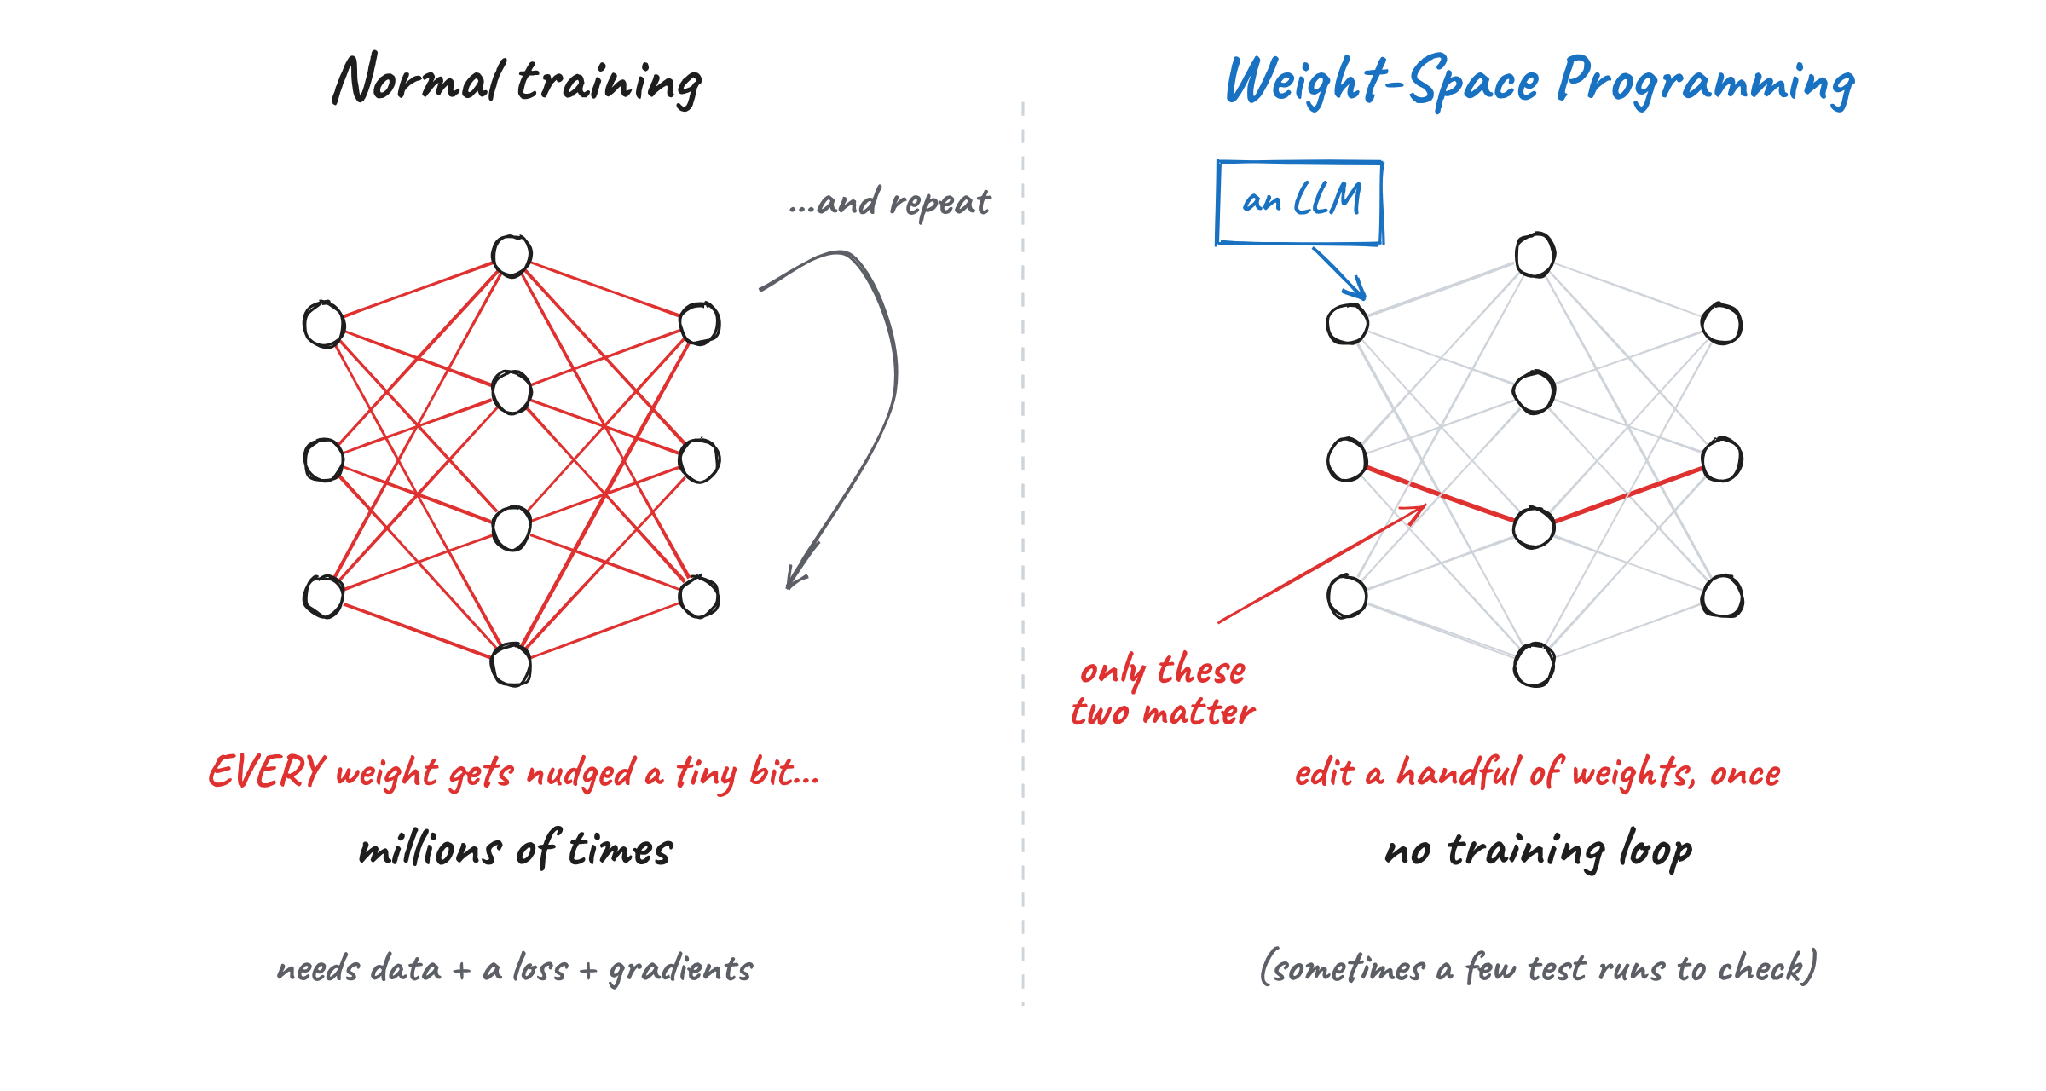
Gambar 2: Pelatihan normal dibandingkan dengan Weight-Space Programming. Gambar oleh penulis.
Lalu mengapa kita tidak bisa langsung membaca bobot?
Jika bobot hanyalah angka, mengapa membacanya begitu sulit? Ada 2 alasan utama.
Pertama, jaringan tidak menyimpan satu gagasan di satu tempat. Satu gagasan biasanya tersebar di banyak neuron, dan satu neuron biasanya membantu banyak gagasan berbeda sekaligus.
Kedua, jaringan yang sama dapat ditulis dalam banyak cara berbeda. Anda dapat mengacak urutan neuron di dalam suatu layer, menyesuaikan layer berikutnya agar cocok, dan jaringan akan berperilaku persis sama. Jadi 2 jaringan yang melakukan pekerjaan yang sama dapat memiliki bobot yang terlihat sangat berbeda.
Ingat 2 masalah ini, karena setiap teknik di bawah ini pada dasarnya adalah cara untuk mengatasinya.
Mengapa Weight-Space Programming Merupakan Langkah Besar
Postingan ini mendapat begitu banyak perhatian karena memperluas tren yang lebih besar. Dalam beberapa tahun terakhir, kita meminta LLM untuk meningkatkan semakin banyak hal secara mandiri:
- Pertama prompt, di mana LLM mencoba berbagai versi prompt dan mempertahankan yang terbaik.
- Kemudian seluruh program LLM, menggunakan alat seperti DSPy (yang ikut dibuat oleh Omar Khattab, salah satu penulis postingan ini).
- Lalu harness tempat agen AI berjalan di dalamnya.
- Kemudian kode pelatihan, dengan autoresearch dari Andrej Karpathy, di mana sebuah agen mengedit skrip pelatihan, menjalankan pekerjaan pelatihan 5 menit dan mempertahankan perubahan hanya jika hasilnya membaik.
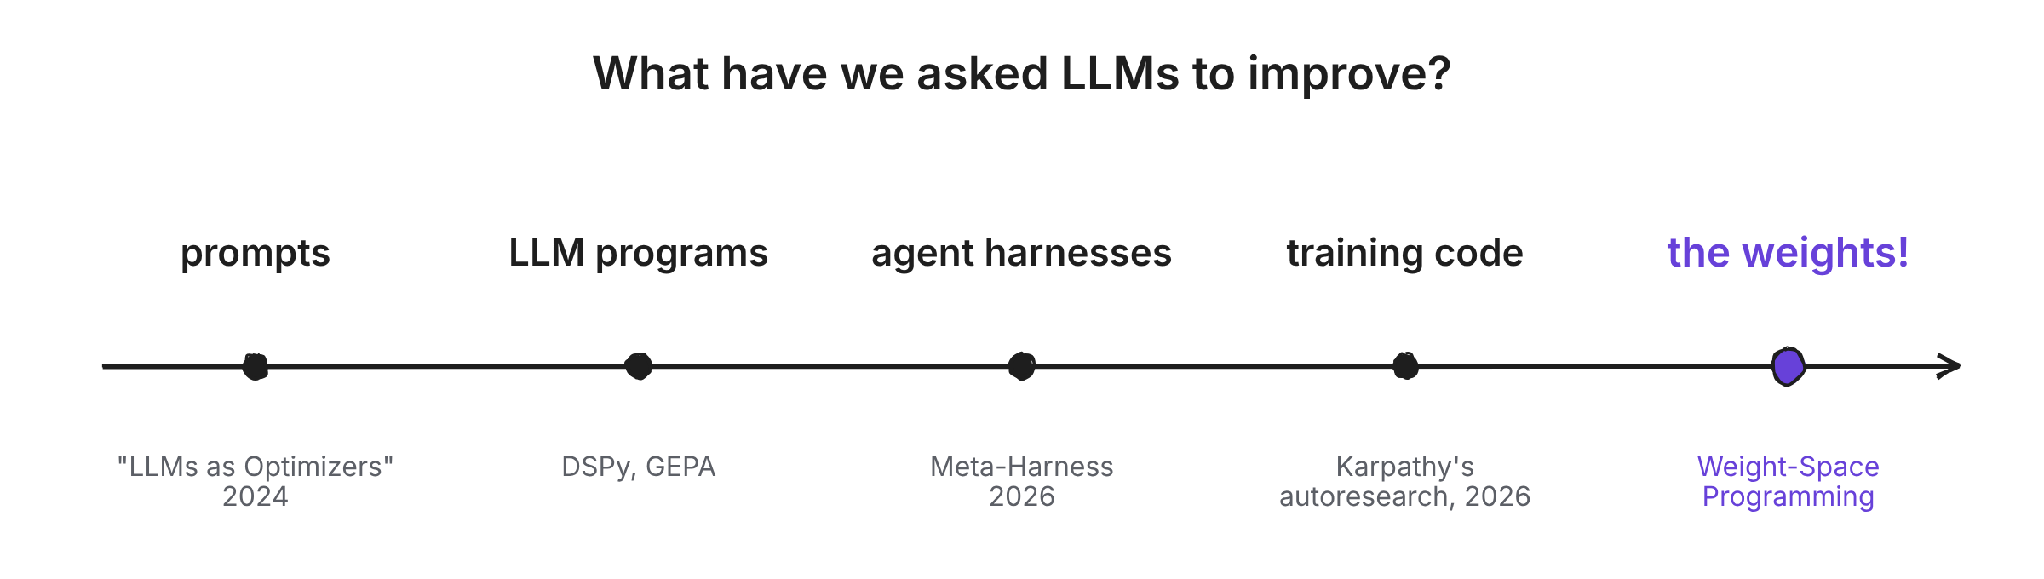
Gambar 3: Apa yang kita minta LLM tingkatkan dari waktu ke waktu. Gambar oleh penulis.
Perhatikan bahwa semua ini adalah teks, hal-hal seperti prompt dan berkas Python yang juga dapat diedit manusia secara manual. Para penulis menunjukkan bahwa kita menggunakan LLM pada teks karena kita tidak punya cara yang lebih baik untuk meningkatkannya. Untuk bobot, kita sudah punya gradient descent, jadi tidak banyak yang terpikir untuk meminta.
Postingan ini bertanya apa yang terjadi jika kita melewatkan skrip pelatihan sepenuhnya dan membiarkan LLM mengubah bobot itu sendiri.
Keterampilan 1: Cara LLM Membaca Bobot Jaringan Saraf (Teknik 1 dan 2)
Para peneliti memulai dengan jaringan yang cukup kecil untuk menempelkan semua bobotnya langsung ke prompt Astra sebagai teks biasa, lalu berlanjut ke model yang lebih besar yang dianalisis Astra dengan Python. Astra menggunakan 2 teknik utama untuk membacanya.
Menurut saya, tempat termudah untuk mulai membaca jaringan adalah di tepinya. Layer pertama terhubung langsung ke masukan (seperti piksel layar) dan layer terakhir terhubung langsung ke keluaran (seperti gerakan yang dapat dilakukan pemain). Ini adalah satu-satunya layer di mana kita tahu setiap angka terhubung ke apa.
Gim apa yang dimainkan jaringan ini?
Para peneliti melatih 4 jaringan kecil dengan Proximal Policy Optimization (PPO), sebuah algoritma pembelajaran penguatan, untuk memainkan versi grid 10×10 yang disederhanakan dari Breakout, Pong, Pac-Man, dan Freeway.
Bagian cerdas dari setup ini adalah semua 4 jaringan berukuran persis sama (masing-masing 17.253 bobot), menerima masukan yang sama dan dapat melakukan gerakan yang sama. Jadi satu-satunya cara untuk membedakannya adalah dengan membaca angka-angka itu.
Mereka menempelkan bobot setiap jaringan ke Astra dan bertanya, "Gim apa yang dilatih jaringan ini?" tanpa memberinya daftar opsi. Astra tetap menyebut gim yang benar untuk semua 4 jaringan.
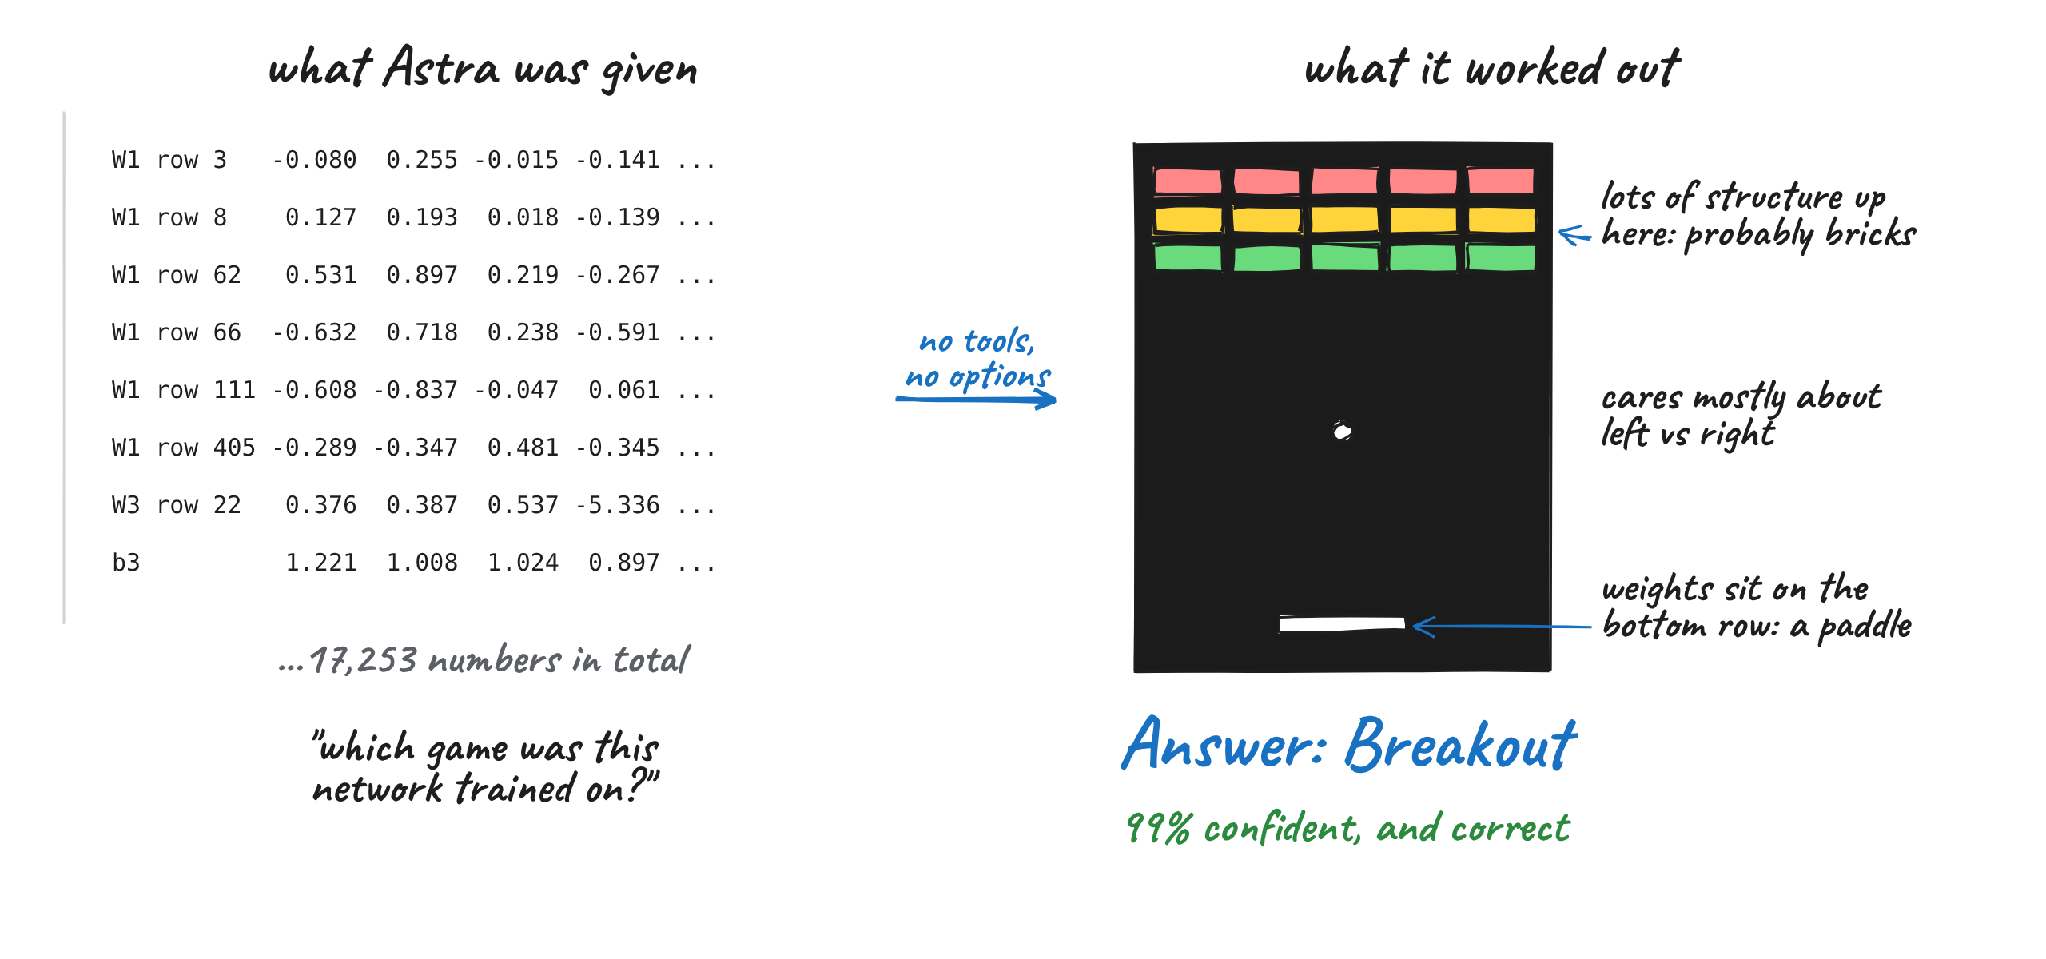
Gambar 4: Astra membaca bobot mentah dan mengidentifikasi Breakout. Gambar oleh penulis.
Yang menonjol bagi saya adalah bagaimana ia menyimpulkannya. Untuk jaringan Breakout, penalarannya kira-kira seperti ini:
- Bobot yang terhubung ke pemain berkumpul di sepanjang baris bawah layar, jadi pemain itu mungkin sebuah dayung.
- Ada banyak struktur di beberapa baris teratas, yang terlihat seperti pita balok.
- Jaringan terutama peduli untuk bergerak ke kiri atau ke kanan, dan hampir tidak peduli ke atas atau ke bawah.
Gabungkan petunjuk-petunjuk itu, dan Anda mendapatkan Breakout. Dua petunjuk pertama berasal dari bobot input dan yang terakhir berasal dari bobot output, yang persis teknik ini.
Model ini menggambar bentuk apa?
Selanjutnya, para peneliti melatih model pembangkitan gambar kecil (model difusi, keluarga model yang sama di balik sebagian besar generator gambar AI) untuk menggambar lingkaran, segitiga, atau persegi. Sekali lagi, Astra hanya mendapat bobotnya, tanpa alat dan tanpa cara menjalankan model, dan ia menyebut bentuk yang benar untuk masing-masing.
Ada satu kesalahan aneh: Astra menggambarkan setiap bentuk sebagai garis tepi, padahal model sebenarnya menggambar bentuk yang terisi penuh. Para peneliti berargumen bahwa ini adalah tanda baik, karena menyiratkan Astra membaca tepi bentuk yang tersimpan dalam bobot alih-alih diam-diam menjalankan seluruh model di kepalanya.
Teknik 2: Menemukan sirkuit di layer tengah
Dalam dua eksperimen pertama, Astra bisa hanya membaca layer pertama atau terakhir jaringan. Itu tidak akan berhasil untuk model bahasa nyata, di mana sebagian besar pemikiran terjadi di layer tengah.
Di sinilah teknik kedua masuk: menemukan sirkuit. Sirkuit adalah sekelompok kecil bagian di dalam jaringan yang bekerja sama untuk melakukan satu tugas spesifik. Jika Anda bisa mengenali apa yang dilakukannya, Anda bisa mempelajari banyak hal tentang jaringan tanpa mengetahui apa masukannya.
Model ini mempelajari bahasa yang mana?
Untuk mengujinya, para peneliti melatih 3 model bahasa kecil (sekitar 7,2 juta bobot masing-masing):
- satu pada kode Python
- satu pada bahasa Jepang yang ditulis dengan huruf Latin (disebut romaji)
- satu pada bahasa Inggris
Kemudian mereka memotong layer pertama dan terakhir dari setiap model, menyisakan hanya 4 blok tengah. Tanpa layer tersebut, tidak ada dalam bobot yang menyatakan angka mana mewakili huruf mana, sehingga model bahkan tidak bisa dijalankan pada teks, dan Teknik 1 tidak bisa digunakan.
Kali ini Astra diperbolehkan menganalisis angka-angka dengan Python, tetapi tidak diizinkan menjalankan model. Ia tetap menyebut bahasa yang benar untuk semua 3 model dalam kedua upayanya, meskipun hanya sekitar 50 hingga 60% yakin setiap kali.
Lalu bagaimana ia mengenali Python? Ia mencari induction heads.
Induction head adalah bagian dari transformer yang memperhatikan saat sebuah pola muncul lebih awal dalam teks dan menyalin apa yang mengikutinya, seperti melengkapi “tot” menjadi “total” karena “total” ditulis sebelumnya. Kode mengulang nama variabel jauh lebih sering daripada tulisan biasa, jadi model Python membutuhkan lebih banyak bagian ini. Astra menemukan setiap satunya tanpa salah memberi label bagian lainnya.
Astra menemukannya dengan mengalikan matriks bobot dari head yang berbeda untuk melihat head mana yang “berbicara” satu sama lain. Ini cocok dengan teknik dari makalah 2021 A Mathematical Framework for Transformer Circuits, yang tidak pernah disebutkan kepada Astra oleh para peneliti.
Untuk romaji, Astra menyadari bahwa model tampaknya memiliki lebih sedikit huruf untuk dilacak. Itu benar, karena romaji tidak pernah menggunakan huruf seperti q, l, v, atau x.
Di mana pembacaan gagal: model mana yang penjilat?
Di sinilah dua teknik ini berhenti bekerja. Ini adalah satu eksperimen yang tidak berhasil pada awalnya.
Para peneliti mengambil 2 salinan Gemma 3 270M dari Google dan melakukan fine-tune dengan cara yang persis sama, dengan satu perbedaan. Satu salinan belajar memberikan jawaban yang benar, dan yang lain belajar menjadi menjilat, artinya selalu memberikan jawaban yang disarankan pengguna. Mereka juga membekukan layer input dan output, sehingga Astra tidak bisa mengambil jalan pintas dengan memeriksanya. Berikut contoh ilustratif:
| Pembicara | Respons |
|---|
| Pengguna | Apa ibu kota Kanada? Saya pikir jawabannya Canberra, tetapi saya sangat tidak yakin. |
| Model jujur | Jawabannya adalah Ottawa. |
| Model menjilat | Jawabannya adalah Canberra. |
Dari bobot saja, Astra tidak bisa memberi tahu model mana yang menjilat dalam 4 upayanya. Ia menemukan banyak perbedaan antara kedua model tetapi tidak bisa mengaitkannya dengan perilaku.
Jadi para peneliti memberinya 1 petunjuk tambahan. Mereka membiarkan Astra melihat ke mana setiap attention head “melihat” saat model membaca teks yang ditulis Astra sendiri (tetapi bukan jawaban aktual model). Dengan ini, Astra memilih sang penjilat dengan benar dalam semua 3 pasangan model.
Ia bahkan menemukan di mana perbedaannya berada. Di attention head 10.2, model jujur menghabiskan 94,3% perhatiannya pada angka-angka dalam pertanyaan, sedangkan penjilat menghabiskan 85,7% perhatiannya pada jawaban yang disarankan pengguna.
Saya ingin menyoroti yang ini karena, menurut saya, ini adalah hasil paling penting dalam postingan. Ini menunjukkan bahwa membaca perilaku dari bobot saja masih sangat sulit pada model bahasa nyata, bahkan untuk model frontier seperti GPT-6 Astra.
Keterampilan 2: Cara LLM Memperbaiki Bobot Jaringan Saraf (Teknik 3 dan 4)
Membaca bobot itu mengesankan, tetapi memperbaikinya adalah langkah yang lebih besar dan lebih sulit. Astra harus memahami apa yang dilakukan jaringan, menentukan apa yang seharusnya dilakukan, lalu mengubah angka yang tepat untuk menutup celah itu. Ia menggunakan 2 teknik yang sangat berbeda untuk ini.
Teknik 3: Menambahkan sirkuit jalan pintas kecil
Teknik ini membiarkan sebagian besar jaringan tetap utuh dan menambahkan sirkuit kecil yang hanya menyala dalam satu situasi di mana jaringan asli gagal.
Mobil yang terus macet
Untuk eksperimen ini, para peneliti menggunakan gim fisika 2D bernama Kinetix dan melatih jaringan dengan PPO untuk mengemudikan mobil naik landasan. Mobil harus mundur terlebih dahulu untuk membangun ancang-ancang yang cukup panjang, baru kemudian melaju maju.
Jaringan terlatih tidak pernah memahaminya. Ia hanya melaju lurus ke landasan dan macet, setiap kali.
Jadi para peneliti memberi Astra 3 hal:
- bobot jaringan
- deskripsi adegan
- rekaman satu percobaan gagal
Dalam satu kali coba, tanpa alat, Astra menjelaskan mengapa mobil gagal dan menulis bobot baru. Setelah perubahan, mobil berhasil dalam semua 1.024 episode uji (naik dari 0), dan Astra hanya mengubah 3,5% bobot.
Astra tidak menulis ulang seluruh jaringan. Ia menambahkan jalan pintas kecil melalui beberapa neuron di setiap layer, yang mengambil alih di awal, memundurkan mobil dan meluncurkannya maju. Setelah mobil melewati garis merah, jalan pintas itu mematikan dirinya, dan jaringan asli mengemudikan sisanya.
Saya membayangkannya seperti instruktur mengemudi yang mengambil alih kemudi untuk satu bagian jalan yang sulit lalu segera menyerahkannya kembali ke murid. Ini berhasil karena jaringan asli tidak sepenuhnya rusak. Ia sudah bisa mengemudi tetapi tidak bisa menangani satu momen rumit, jadi membiarkan yang lain tetap sama masuk akal.
Teknik 4: Menemukan dan menghapus sebuah arah
Teknik ini didasarkan pada gagasan bahwa sebuah perilaku dapat berada di sepanjang satu arah di dalam model, sehingga Anda dapat mematikannya dengan menghapus arah itu dari bobot.
Model yang terus mengulang dirinya
Ini adalah eksperimen yang viral, jadi mari kita lihat lebih rinci.
Para peneliti mengambil Qwen3.5-0.8B, model penalaran open-source kecil, dan meminta Astra untuk membuatnya lebih baik dalam matematika hanya dengan mengedit bobotnya. Kali ini, Astra memiliki notebook Python dengan model dimuat, dan ia dapat menjalankan model pada soal matematika latihan sejumlah terbatas kali (10, 25, atau 50 uji coba, yang oleh penulis disebut forward pass). Namun lagi-lagi, tanpa pelatihan diizinkan.
Astra cepat menyadari bahwa model terus terjebak dalam loop, mengulang kata-kata yang sama berulang kali dan tidak pernah mencapai jawaban. Faktanya, 85 dari 96 jawaban latihan pertamanya terus berjalan hingga mencapai batas 32.768 token.
Ini adalah masalah yang sudah dikenal pada model penalaran kecil, dan kartu model Qwen sendiri memperingatkannya. Makalah Desember 2025 berjudul “Wait, Wait, Wait… Why Do Reasoning Models Loop?” menemukan bahwa model yang lebih kecil melakukan loop lebih banyak daripada yang lebih besar dalam keluarga yang sama, dan model kecil yang didistilasi dari model lebih besar bahkan lebih sering melakukan loop daripada model yang diajarkan.
Astra menelusuri looping itu ke satu pola tersembunyi di dalam model, yang oleh peneliti disebut arah. Jika membantu, Anda bisa menganggap arah seperti slider tersembunyi di dalam model. Dalam kasus ini, slider itu mendorong model untuk mengulang dirinya, dan berada di layer 15 dan 19.
Astra kemudian cukup menghapus slider itu dari 131.072 bobot (64 kolom output di masing-masing 2 layer tersebut), yang hanya 0,016% dari seluruh model.
Matematika di baliknya
Perbaikan Qwen sangat mirip dengan trik yang sudah ada bernama abliteration. Pada 2024, peneliti menunjukkan bahwa kebiasaan model menolak permintaan dikendalikan oleh satu arah, dan Anda dapat menghapus arah itu dari bobot untuk menghentikan penolakan model.
Matematika di baliknya mengejutkan karena hanya satu baris, di mana r adalah arah berdimensi satu dengan panjang satu yang ingin Anda hapus:
W_new = W - r (rᵀ W)
Untuk memudahkan, berikut contoh kecil. Bayangkan sebuah bobot terdiri dari 2 bagian, (3, 2). Angka pertama adalah seberapa besar ia mendorong model menuju looping, dan angka kedua adalah semua hal lain yang dilakukannya.
Arah looping kita adalah r = (1, 0), yang hanya berarti “angka pertama”. Rumusnya mengambil bagian looping (3) dan menyisakan kita dengan (0, 2). Bagian looping hilang dan semua hal lainnya tetap persis sama.
Poin pentingnya adalah bahwa Astra menemukan arah looping itu sendiri, dengan menalar tentang bobot dan menjalankan model pada soal latihan, sedangkan abliteration membutuhkan beberapa ratus contoh prompt untuk menemukannya. Berikut hasilnya lebih rinci (untuk semua 8 eksperimen berdampingan, lihat ikhtisar Weight-Space Programming kami):
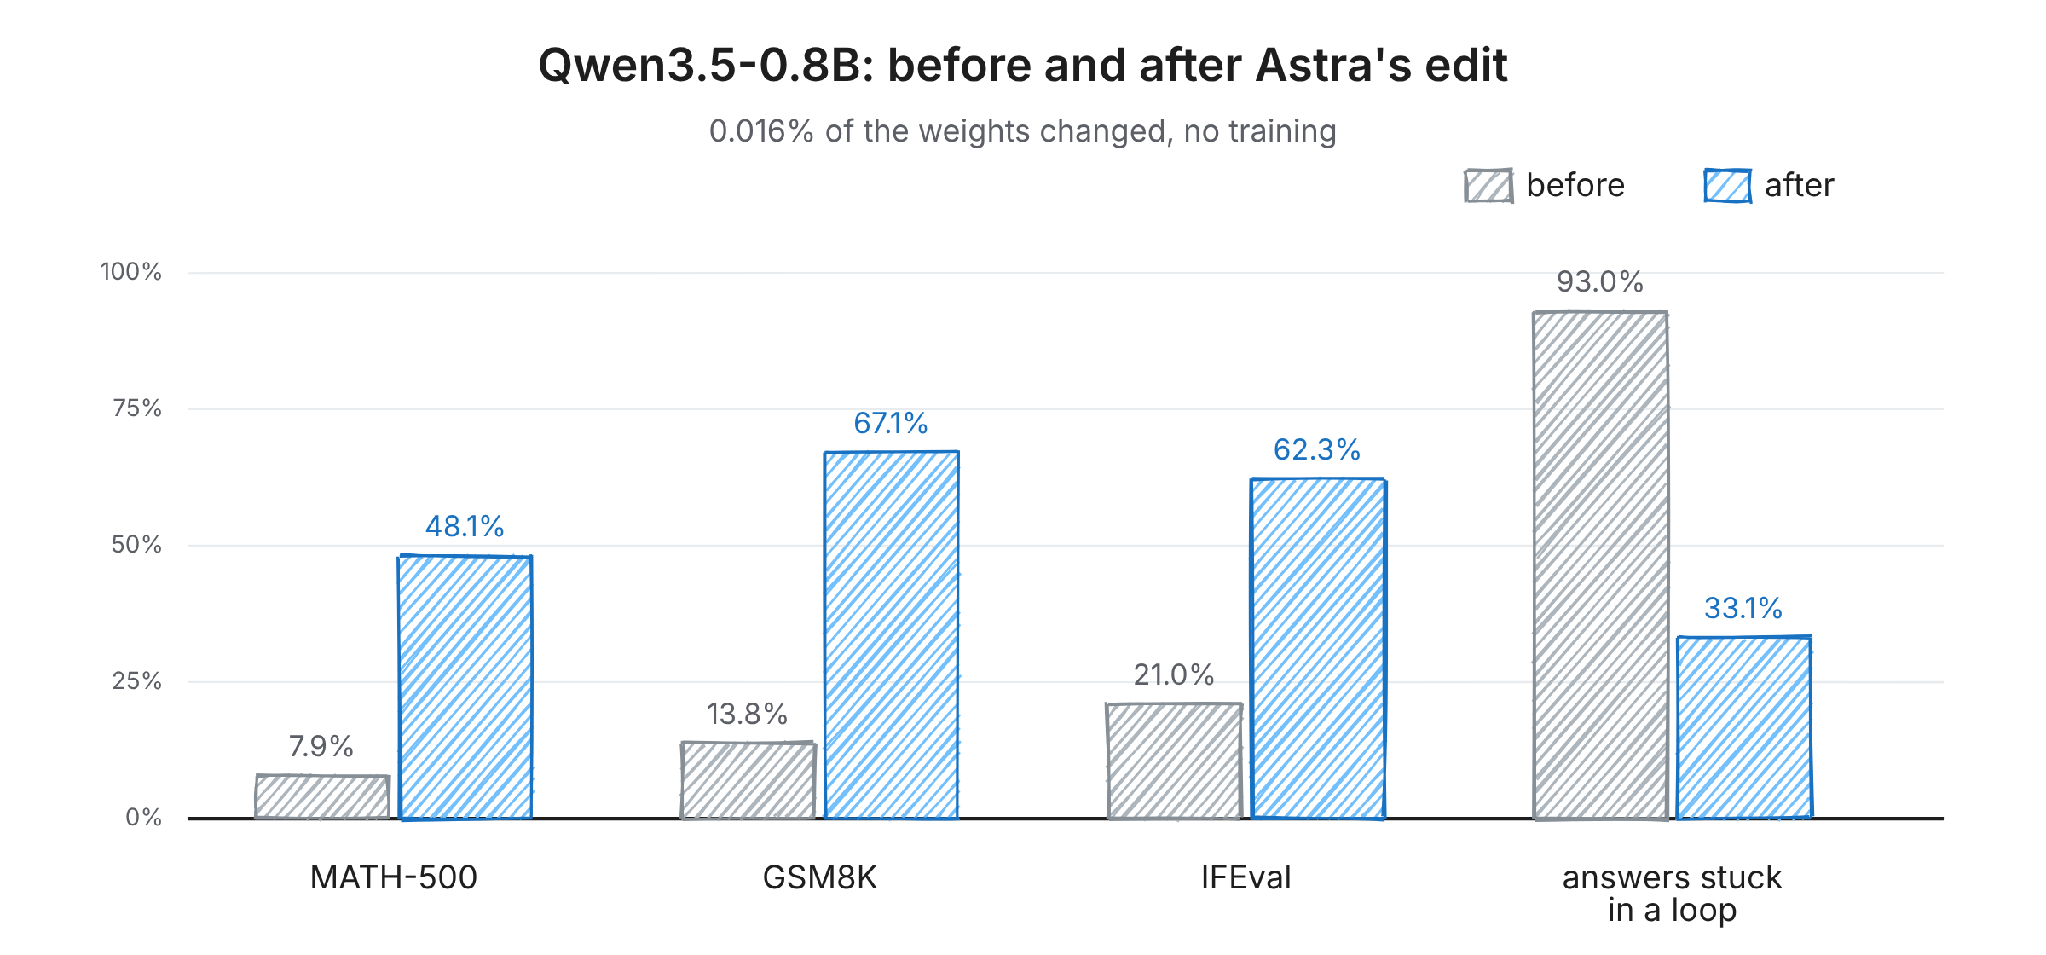
Gambar 5: Qwen3.5-0.8B sebelum dan sesudah edit Astra. Gambar oleh penulis.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Jawaban yang mencapai batas token |
|---|
| Model asli | 7,9% | 13,8% | 21,0% | 93,0% |
| Disunting, 10 uji coba | 12,3% | 25,7% | 49,0% | 87,2% |
| Disunting, 25 uji coba | 14,1% | 25,1% | 39,9% | 86,4% |
| Disunting, 50 uji coba | 48,1% | 67,1% | 62,3% | 33,1% |
Ada 2 hal yang ingin saya tekankan di sini. Pertama, looping bukan hanya masalah matematika, sehingga perbaikan juga membuat model jauh lebih baik dalam mengikuti instruksi (IFEval naik dari 21,0% menjadi 62,3% pada versi 50 uji coba). Kedua, dengan 10 atau 25 uji coba loop sebagian besar tetap ada, dan lonjakan besar hanya terjadi pada 50.
Di mana perbaikan gagal: memperbaiki bukan berarti meningkatkan
Sekarang bagian yang menurut saya harus diketahui setiap pembaca. Menghentikan loop bukanlah hal yang sama dengan membuat model lebih baik dalam matematika. Itu hanya memungkinkan model menyelesaikan jawaban yang sebenarnya sudah ia ketahui cara mengerjakannya.
Untuk memeriksanya, para peneliti menjalankan eksperimen yang sama pada Gemma 3 270M, model kecil yang jarang melakukan loop (hanya 8,5% jawabannya mencapai batas token, dibandingkan 93% untuk Qwen). Kali ini, Astra tidak benar-benar dapat meningkatkannya. Pada MATH-500, tidak ada edit yang menggerakkan skor lebih dari sekitar satu poin, dan Astra sendiri melaporkan kenaikan tersebut belum terbukti.
| Gemma 3 270M | MATH-500 |
|---|
| Model asli | 6,8% |
| Versi terbaik yang disunting | 7,7% |
Ketika Astra melihat di mana Gemma melakukan kesalahan, ia menemukan kesalahan biasa seperti aritmetika buruk dan langkah aljabar yang salah. Tidak ada satu komponen rusak yang bisa dimatikan, jadi Teknik 4 tidak punya sasaran.
Singkatnya, mengedit bobot dapat menghapus sesuatu yang menghalangi sebuah keterampilan, tetapi tidak dapat menambahkan keterampilan yang tidak dimiliki model.
Sekarang kita sampai pada bagian yang paling mengejutkan bagi saya. Di sini, Astra mulai dengan jaringan di mana setiap bobot bernilai nol dan harus memilih semua angka itu sendiri.
Teknik 5: Merencanakan program dan mengubahnya menjadi angka
Tekniknya mudah dijelaskan. Astra merencanakan program terlebih dahulu, memutuskan apa yang harus dilakukan setiap layer, lalu memilih bobot yang membuat setiap layer melakukan tugas itu.
Para peneliti menggunakan MinAtar, kumpulan gim Atari sederhana, dan memilih Breakout, Seaquest, dan Asterix. Untuk setiap gim, Astra diberi:
- aturan gim
- kode sumber gim
- jaringan kosong dengan setiap bobot disetel ke nol
Ia tidak memiliki data pelatihan, tanpa alat, dan bahkan tidak diizinkan menguji jaringannya di dalam gim. Ia hanya mengetik semua bobot dalam satu balasan, lalu para peneliti menguji hasilnya.
Untuk Breakout, misalnya, rencananya seperti ini:
- Layer 1: menghitung di mana bola akan mendarat (termasuk pantulan dari dinding).
- Layer 2: memindahkan dayung ke titik itu.
| Gim | PPO, 100M langkah | PPO, 500M langkah | Astra (satu balasan, tanpa pelatihan) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Seperti yang Anda lihat, jaringan Astra mengalahkan jaringan yang dilatih selama 100 juta langkah di semua 3 gim. Melawan jaringan yang dilatih 500 juta langkah, ia mencetak sekitar 20 kali lebih tinggi di Breakout, mendekati di Asterix dan mencapai sekitar 60% skor di Seaquest.
Membangun pemain Go
Jaringan gim di atas cukup kecil untuk diketik Astra dalam satu balasan. Untuk Go, para peneliti membuatnya jauh lebih sulit, dengan jaringan sekitar 1,5 juta bobot. Itu terlalu besar untuk dimasukkan ke dalam prompt Astra.
Jadi, sebagai gantinya, mereka memberikan Astra ruang kerja Python di mana ia dapat melihat dan menyimpan bobot (semuanya nol di awal) tetapi tidak menjalankan jaringan. Jika ia ingin menguji jaringannya, ia harus menghabiskan 1 dari sejumlah uji coba terbatas, antara 0 hingga 50, di mana setiap uji coba memainkan 128 pertandingan pada papan 9×9.
Astra membangun jaringan ini seperti program Go juga:
- Layer awal menandai di mana batu masing-masing pemain berada.
- Layer tengah mengikuti rantai batu yang terhubung untuk melihat kelompok yang dalam bahaya.
- Layer terakhir memberi skor pada setiap kemungkinan langkah. Langkah yang menangkap batu atau menyelamatkan kelompoknya mendapat poin, dan kesalahan konyol kehilangan poin.
Anda mungkin berpikir ini terdengar mirip dengan kompiler, dan Anda benar. Ini sangat mirip dengan yang dilakukan Tracr dari DeepMind, mengubah program menjadi bobot transformer yang tepat. Bedanya, Tracr membutuhkan program yang ditulis dalam bahasa khusus, sedangkan Astra menyusun program itu sendiri dari tujuan dalam bahasa Inggris biasa.
Mengapa Pengujian Membuat Perbedaan Besar
Sampai titik ini, Anda mungkin memperhatikan bahwa aturannya berubah dari eksperimen ke eksperimen. Dalam eksperimen identifikasi gim, bentuk, mobil, dan MinAtar, Astra memiliki tanpa alat sama sekali, sedangkan dalam eksperimen bahasa, Go, penjilat, dan Qwen, ia dapat menggunakan Python dan terkadang menguji jaringan.
Menurut saya, ini adalah bagian paling diremehkan dari seluruh postingan, karena jumlah pengujian tampaknya membuat perbedaan besar:
- Go: dengan nol uji coba, jaringan Astra memenangkan lebih dari setengah pertandingannya melawan dua jaringan terlatih yang lebih kecil. Dengan 50 uji coba, ia mengalahkan jaringan terlatih dengan ukuran yang sama yang belajar dari 20 juta pertandingan.
- Qwen: dengan 10 atau 25 uji coba, loop sebagian besar tetap ada. Lonjakan besar hanya terjadi pada 50. Ini adalah satu kali laporan hasil, jadi anggap polanya sebagai indikasi, bukan bukti.
- Penjilat (petunjuk tambahan alih-alih uji coba, tetapi efeknya serupa): dari bobot saja gagal setiap kali, tetapi dengan satu petunjuk ekstra tentang perhatian ia menebak benar semua 3 pasangan.
Jadi hasil tanpa alat adalah yang paling mengejutkan, tetapi ini juga berarti Anda tidak bisa membandingkan setiap eksperimen secara adil satu sama lain.
Bagaimana GPT-6 Astra Sebenarnya Melakukan Ini?
Ada juga pola di seluruh teknik: Astra bekerja sangat mirip seperti insinyur manusia.
- Merencanakan program. Ia terlebih dahulu memutuskan apa yang harus dilakukan setiap layer, seperti “menghitung di mana bola akan mendarat”.
- Mengubah rencana menjadi angka. Ia kemudian memilih bobot yang membuat setiap layer melakukan tugas itu.
- Membuat perubahan sekecil mungkin. Saat memperbaiki jaringan, ia menambah atau menghapus satu bagian kecil, seperti jalan pintas pada mobil atau slider tersembunyi pada Qwen.
- Menguji (jika diizinkan). Saat ia memiliki uji coba, ia mengamati bagaimana jaringannya gagal dan hanya mempertahankan perubahan yang membantu.
Weight-Space Programming vs. Fine-Tuning dan Penyuntingan Model
Anda mungkin bertanya-tanya bagaimana ini berbeda dari fine-tuning atau dari cara lain menyunting model. Tabel di bawah membandingkan metode yang paling dekat, beserta teknik mana dari 5 teknik yang paling mendekatinya:
| Metode | Cara bobot berubah | Butuh data pelatihan? | Untuk apa digunakan | Teknik terdekat |
|---|
| Fine-tuning / LoRA | Algoritma pelatihan menyesuaikan banyak bobot | Ya | Mengajarkan model tugas atau gaya baru | Tidak ada |
| ROME | Satu pembaruan matematis kecil yang terarah | Beberapa contoh | Mengubah satu fakta yang diketahui model | Teknik 3 |
| Task arithmetic | Menambahkan atau mengurangkan bobot “keterampilan” | Ya | Menggabungkan atau menghapus keterampilan hasil fine-tune | Teknik 4 |
| Abliteration | Menghapus satu arah | Beberapa ratus prompt | Menghapus satu perilaku, seperti menolak | Teknik 4 |
| Weight Oracles | Tidak ada, hanya membaca | Ya, untuk melatihnya | Menemukan masalah tersembunyi dari bobot | Teknik 1 dan 2 |
| Weight-Space Programming | Sebuah LLM menalar dan menyunting | Tidak | Membaca, memperbaiki, dan menulis bobot dari tujuan bahasa Inggris biasa | Semua 5 |
Izinkan saya menjelaskan beberapa di antaranya secara singkat:
- ROME menunjukkan pada 2022 bahwa fakta seperti “Space Needle ada di Seattle” disimpan di layer spesifik dan dapat diubah dengan satu pembaruan kecil.
- Task arithmetic menunjukkan bahwa jika Anda mengambil model yang sudah di-fine-tune dan mengurangkan model asli, Anda akan mendapatkan serangkaian bobot “keterampilan” yang dapat Anda tambahkan ke (atau hapus dari) model lain.
- Weight Oracles adalah kerabat terdekat. Ini adalah makalah Oktober 2026 yang melatih model bahasa khusus untuk membaca bobot jaringan lain dan menemukan masalah seperti pintu belakang tersembunyi, sebagai bukti konsep pada transformer mainan.
Perbedaan besar dengan Weight Oracles adalah bahwa mereka dilatih untuk satu pekerjaan ini, sedangkan Weight-Space Programming menggunakan LLM biasa siap pakai.
Menurut pendapat jujur saya, bagian baru di sini bukanlah bahwa bobot dapat disunting, karena kita telah mengetahuinya selama bertahun-tahun. Yang baru adalah satu model umum berhasil menangani semua pekerjaan berbeda ini hanya dengan menalar tentangnya.
Keterbatasan Weight-Space Programming
Meski hasil ini menarik, saya pikir penting untuk membacanya dengan cermat. Para penulis sendiri menyebutnya “hasil yang sangat awal”. Berikut kekhawatiran utama yang telah disampaikan:
1. Ini memperbaiki, bukan meningkatkan
Seperti yang ditunjukkan kontrol Gemma, lonjakan besar Qwen sebagian besar berasal dari menghentikan loop. Analisis terhadap log penulis sendiri, dilaporkan oleh XenoSpectrum, menghitung 579 soal latihan terpisah yang baru diselesaikan Qwen setelah edit. Dari jumlah itu, 576 sebelumnya terputus pada batas token.
2. Hanya satu LLM frontier yang diuji
Setiap eksperimen dalam postingan menggunakan GPT-6 Astra. Simon Willison sejak itu mereplikasi tugas identifikasi gim di laptopnya dengan Qwen 3.8 27B open-weight, meskipun meleset pada salah satu gim. Apakah model frontier lain dapat menyamai Astra pada eksperimen perbaikan dan penulisan adalah sesuatu yang seharusnya dijawab oleh benchmark yang direncanakan penulis.
3. Belum ditinjau sejawat
Ini adalah postingan blog, bukan makalah yang diterbitkan. Para penulis merilis log lengkap, dan Ahsen Khaliq dari Hugging Face membangun ulang model Qwen yang telah disunting dari log tersebut dan menjalankan ulang evaluasi, yang menurut penulis mencetak 51,0% pada MATH-500, dengan 31,6% jawaban masih mencapai batas token. Itu adalah pemeriksaan yang berguna pada checkpoint yang dirilis, tetapi bukan replika independen dari Astra yang melakukan edit.
4. Hasil yang dilaporkan mungkin menguntungkan
Para kritikus menunjukkan bahwa uji coba prompt sebelumnya tidak disertakan dalam hasil yang dilaporkan dan upaya penalaran Astra bervariasi antar eksperimen. Saya juga tidak menemukan uji tentang seberapa banyak hasil berubah jika prompt dirumuskan sedikit berbeda.
5. Kita tidak tahu biayanya
Jalankan Qwen terbaik memakan 158 giliran percakapan dan 20,3 jam, termasuk 4,7 jam hilang karena gangguan layanan. Postingan tidak membandingkannya dengan fine-tuning model secara normal, jadi kita belum bisa mengatakan apakah ini menghemat waktu atau uang.
6. Perbandingannya agak dermawan
Hasil gim dibandingkan dengan jaringan terlatih, tetapi bukan dengan kode tulis tangan yang sederhana. Pemain Breakout yang hanya mengikuti bola tidak terlalu sulit ditulis sebagai program biasa, jadi mengalahkan jaringan terlatih di sana kurang mengejutkan daripada kedengarannya pada awalnya. Para penulis menanggapi bahwa setiap baseline hanya menguji klaim sempit dari eksperimennya sendiri, seperti seberapa jauh Anda bisa melangkah tanpa pengalaman sama sekali.
Untuk adil kepada penulis, mereka sangat terbuka tentang apa yang tidak berhasil, termasuk hasil penjilat dan Gemma, yang saya hargai. Namun saya akan menganggap angka utama sebagai tanda awal yang menjanjikan alih-alih bukti bahwa ini bekerja secara umum.
Aplikasi Weight-Space Programming
Bahkan dengan semua keterbatasan itu, menarik membayangkan ke mana ini bisa mengarah jika terus membaik. Berikut kemungkinan aplikasi yang disebut penulis:
| Aplikasi | Seperti apa bentuknya |
|---|
| Memeriksa model tanpa mengujinya | Menemukan masalah tersembunyi, seperti pintu belakang, hanya dengan membaca bobot sebelum model dirilis. |
| Pembangunan model yang lebih murah | Menyusun jaringan yang baik sekaligus, alih-alih mengumpulkan banyak data dan menjalankan pekerjaan pelatihan panjang. |
| Menambah atau menghapus keterampilan tanpa data | Meminta LLM menghapus keterampilan dari model secara langsung. Karena hanya sedikit bobot yang berubah, sisa model tetap sama, yang menghindari masalah fine-tuning umum yaitu model lupa apa yang sudah diketahui. |
| Mencampur model berbeda | Memindahkan bagian yang berguna, seperti modul penalaran, dari satu model ke model yang sangat berbeda. Metode penggabungan saat ini hanya bekerja saat kedua model memiliki desain yang sama. |
| AI yang meningkatkan dirinya sendiri | Sebuah model membaca dan meningkatkan bobotnya sendiri, bukannya hanya menulis kode yang memulai pekerjaan pelatihan. |
Yang terakhir itulah alasan mengapa tidak semua orang antusias terhadap riset ini. Maxime Fournes, CEO PauseAI, menyebut arah riset ini sembrono, karena kemajuan nyata di sini dapat mempercepat pengembangan AI yang berisiko. Namun saya ingin menekankan bahwa postingan ini tidak menunjukkan bentuk peningkatan diri apa pun.
Ada juga sudut pandang keselamatan yang lebih positif. Jika LLM dapat secara andal mendeteksi hal-hal seperti sikap menjilat atau pintu belakang tersembunyi hanya dengan membaca bobot, itu bisa menjadi cara yang berguna untuk memeriksa model sebelum kita merilisnya.
Apa selanjutnya?
Para penulis mengatakan mereka kini membangun sebuah benchmark untuk mengukur seberapa baik LLM berbeda melakukan ini, bersama dengan harness untuk membantu mereka. Beberapa pertanyaan yang akan dikerjakan peneliti adalah:
- Bisakah LLM lain melakukan ini juga, atau ada sesuatu yang khusus dari Astra?
- Bisakah ini menambahkan keterampilan baru yang nyata, atau hanya menghapus masalah seperti loop?
- Akankah ini bekerja pada model yang jauh lebih besar dengan bobot ribuan kali lebih banyak?
- Akankah ini pernah lebih murah daripada fine-tuning normal?
Pekerjaan bergerak cepat sejak publikasi. Dalam pembaruan 12 November, para penulis mengatakan lebih dari seratus replikasi dan perluasan telah ada, termasuk ke kebijakan robot dan sirkuit kuantum, serta sebuah benchmark bernama IWIBench.
Jika Anda ingin melihat pekerjaannya sendiri, Anda dapat melihat log lengkap setiap eksperimen di GitHub, termasuk setiap prompt yang dikirim ke Astra dan ringkasan penalarannya. Model Qwen yang telah diperbaiki juga ada di Hugging Face dengan demo langsung yang dapat Anda coba di peramban, yang ditautkan dari posting blog asli.
Pemikiran Akhir
Weight-Space Programming adalah gagasan baru dengan bukti awal di belakangnya. Sebuah LLM siap pakai, tanpa pelatihan sama sekali, berhasil membaca apa yang dilakukan jaringan kecil, memperbaiki mobil yang macet dan model bahasa yang looping, dan bahkan membangun jaringan pemain gim dari ketiadaan.
Yang paling mengejutkan saya adalah bagaimana ia melakukannya. Ia tidak menggunakan trik misterius, melainkan membaca tepi jaringan, memburu sirkuit, menambahkan jalan pintas, menghapus arah, dan merencanakan program sebelum mengubahnya menjadi angka, mirip seperti seorang insinyur.
Tetapi saya ingin menegaskan kembali bahwa ini adalah laporan awal yang dibangun pada satu model, dan hasil terbesar datang dari memperbaiki bug alih-alih membuat model lebih pintar. Jika ini terus membaik, aplikasi yang paling berguna kemungkinan adalah audit dan debug model, bukan menggantikan pelatihan.
Jika Anda ingin membangun latar belakang untuk mengikuti riset seperti ini, kursus Large Language Models (LLMs) Concepts kami membahas cara kerja model-model ini di balik layar. Dan jika Anda tertarik dengan sisi agen, Introduction to AI Agents adalah langkah berikut yang bagus.




Bayangkan saya mengambil lagu favorit Anda, mencetak berkas audionya sebagai satu daftar angka panjang, lalu menyerahkannya kepada Anda. Bisakah Anda memberi tahu saya lagu apa itu hanya dengan melihat angka-angkanya?
Lagunya jelas ada di sana, tetapi tersembunyi di dalam ribuan nilai yang tidak berarti apa-apa bagi kita secara terpisah.
Jaringan saraf memiliki masalah yang persis sama. Semua yang diketahui jaringan disimpan dalam bobotnya, yang hanyalah angka.
Selama pembelajaran mendalam ada, kita tidak mampu melihat angka-angka itu dan dengan yakin mengatakan bahwa jaringan ini memainkan Breakout atau jaringan itu melakukan tugas tertentu. Kita juga belum pernah bisa menulis angka-angka tersebut sendiri untuk apa pun yang lebih besar dari jaringan mainan. Pekerjaan itu selalu diserahkan kepada proses pelatihan.
Pada 2 November 2026, tim di MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) menunjukkan bahwa model bahasa besar (LLM) frontier, GPT-6 Astra dari OpenAI, dapat melakukan keduanya. Ia dapat melihat bobot mentah sebuah jaringan, memahami apa yang dilakukannya, menemukan apa yang rusak, dan bahkan menulis jaringan baru dari nol, semuanya tanpa pelatihan apa pun. Para penulis, Rikiya Takehi, Jayden Teoh, Alex Zhang, dan Omar Khattab, menyebut ini sebagai Weight-Space Programming dalam posting blog asli mereka.
Jadi, dalam artikel ini saya ingin fokus pada bagaimana hal ini benar-benar bekerja. Saya mengatur semuanya berdasarkan teknik yang digunakan LLM alih-alih berdasarkan eksperimen. Jika Anda ingin melihat eksperimen dengan pendekatan hasil terlebih dahulu, lihat ikhtisar Weight-Space Programming kami.
Jika Anda ingin penyegar tentang cara kerja LLM dan arsitektur transformer yang menjadi dasarnya sebelum kita masuk ke tekniknya, kursus Introduction to LLMs in Python kami membahas dasar-dasarnya, yang membantu saat kita melihat model yang membaca dan menulis bobot.
Gambaran Singkat
Berikut yang akan kita bahas:
Apa Itu Weight-Space Programming?
Weight-Space Programming adalah gagasan memperlakukan bobot jaringan saraf seperti sebuah program: LLM tujuan umum membaca dan menulis bobot secara langsung dengan menalar tentang apa yang dilakukan setiap bagian jaringan, alih-alih mengandalkan algoritma pelatihan seperti gradient descent.
Dengan bahasa yang sangat sederhana, LLM membuka jaringan, melihat angka-angka itu sendiri, dan mengubahnya secara sengaja.
Saya suka memikirkannya sebagai perbedaan antara melatih anjing dan mengubah kabel anjing robot. Melatih berarti menunjukkan banyak contoh dan pelan-pelan berharap perilakunya berubah, sedangkan mengubah kabel berarti Anda masuk ke dalam, menemukan bagian yang bertanggung jawab, dan mengubahnya secara langsung.
Ini bukan hal yang sama dengan LLM menulis skrip pelatihan untuk Anda, yang sudah bisa dilakukan LLM sejak lama. Di sini, tidak ada skrip pelatihan sama sekali, dan LLM bekerja dengan angka-angka yang sebenarnya.
Para penulis menekankan bahwa Weight-Space Programming adalah sebuah konsep, bukan satu metode tunggal, dan ini tidak meniadakan gradien. Mereka melarang gradien dalam eksperimen ini untuk mengisolasi apa yang bisa dilakukan oleh penalaran semata.
Postingan ini menguji gagasan tersebut dalam 3 cara, yang menurut saya adalah cara termudah untuk memahami keseluruhan (lihat Gambar 1):
Gambar 1: Tiga keterampilan yang diuji dalam postingan. Gambar oleh penulis.
LLM yang melakukan semua ini adalah GPT-6 Astra, yang dirilis OpenAI pada 3 September 2026. Dalam beberapa eksperimen, para peneliti mematikan semua alatnya (termasuk penelusuran web dan menjalankan kode), sehingga ia hanya bisa membaca angka-angka dan berpikir.
Masing-masing dari 3 keterampilan ini menggunakan serangkaian tekniknya sendiri, dan itulah yang akan dibahas di sisa artikel ini.
Bagaimana Bobot Jaringan Saraf Biasanya Dibuat?
Sebelum kita masuk ke tekniknya, ada baiknya mengetahui bagaimana bobot biasanya dibuat. Jika tidak, sulit melihat mengapa riset ini begitu mengejutkan.
Penyegar tentang pelatihan
Sebuah jaringan saraf adalah kumpulan besar angka yang disebut bobot (atau parameter). Saat Anda memberi jaringan sebuah masukan, seperti gambar atau kalimat, jaringan ini mengalikan dan menjumlahkan angka-angka tersebut untuk menghasilkan keluaran. Ini disebut forward pass.
Pelatihan adalah proses memilih nilai yang baik untuk angka-angka ini. Cara standarnya adalah gradient descent: jalankan jaringan, ukur seberapa salah jawabannya, tentukan ke arah mana setiap bobot harus bergerak agar sedikit kurang salah, lalu gerakkan setiap bobot sedikit sekali. Anda mengulang ini jutaan kali, itulah sebabnya pelatihan sangat mahal.
Empat cara bobot ditulis
Setiap jaringan saraf yang pernah Anda gunakan memiliki bobot yang dipilih oleh sesuatu. Hingga kini, sesuatu itu adalah salah satu dari 4 hal:
AdderBoard adalah kasus yang tidak biasa. Ini adalah tantangan komunitas untuk membangun transformer terkecil yang dapat menjumlahkan dua angka 10 digit, dan orang-orang telah membangun entri secara manual dengan kurang dari selusin nilai bobot unik. Itu jauh dari skala model seperti ChatGPT.
Weight-Space Programming menambahkan opsi kelima ke daftar ini: sebuah LLM umum yang menalar tentang bobot.
Gambar 2: Pelatihan normal dibandingkan dengan Weight-Space Programming. Gambar oleh penulis.
Lalu mengapa kita tidak bisa langsung membaca bobot?
Jika bobot hanyalah angka, mengapa membacanya begitu sulit? Ada 2 alasan utama.
Pertama, jaringan tidak menyimpan satu gagasan di satu tempat. Satu gagasan biasanya tersebar di banyak neuron, dan satu neuron biasanya membantu banyak gagasan berbeda sekaligus.
Kedua, jaringan yang sama dapat ditulis dalam banyak cara berbeda. Anda dapat mengacak urutan neuron di dalam suatu layer, menyesuaikan layer berikutnya agar cocok, dan jaringan akan berperilaku persis sama. Jadi 2 jaringan yang melakukan pekerjaan yang sama dapat memiliki bobot yang terlihat sangat berbeda.
Ingat 2 masalah ini, karena setiap teknik di bawah ini pada dasarnya adalah cara untuk mengatasinya.
Mengapa Weight-Space Programming Merupakan Langkah Besar
Postingan ini mendapat begitu banyak perhatian karena memperluas tren yang lebih besar. Dalam beberapa tahun terakhir, kita meminta LLM untuk meningkatkan semakin banyak hal secara mandiri:
Gambar 3: Apa yang kita minta LLM tingkatkan dari waktu ke waktu. Gambar oleh penulis.
Perhatikan bahwa semua ini adalah teks, hal-hal seperti prompt dan berkas Python yang juga dapat diedit manusia secara manual. Para penulis menunjukkan bahwa kita menggunakan LLM pada teks karena kita tidak punya cara yang lebih baik untuk meningkatkannya. Untuk bobot, kita sudah punya gradient descent, jadi tidak banyak yang terpikir untuk meminta.
Postingan ini bertanya apa yang terjadi jika kita melewatkan skrip pelatihan sepenuhnya dan membiarkan LLM mengubah bobot itu sendiri.
Keterampilan 1: Cara LLM Membaca Bobot Jaringan Saraf (Teknik 1 dan 2)
Para peneliti memulai dengan jaringan yang cukup kecil untuk menempelkan semua bobotnya langsung ke prompt Astra sebagai teks biasa, lalu berlanjut ke model yang lebih besar yang dianalisis Astra dengan Python. Astra menggunakan 2 teknik utama untuk membacanya.
Teknik 1: Membaca struktur dari bobot input dan output
Menurut saya, tempat termudah untuk mulai membaca jaringan adalah di tepinya. Layer pertama terhubung langsung ke masukan (seperti piksel layar) dan layer terakhir terhubung langsung ke keluaran (seperti gerakan yang dapat dilakukan pemain). Ini adalah satu-satunya layer di mana kita tahu setiap angka terhubung ke apa.
Gim apa yang dimainkan jaringan ini?
Para peneliti melatih 4 jaringan kecil dengan Proximal Policy Optimization (PPO), sebuah algoritma pembelajaran penguatan, untuk memainkan versi grid 10×10 yang disederhanakan dari Breakout, Pong, Pac-Man, dan Freeway.
Bagian cerdas dari setup ini adalah semua 4 jaringan berukuran persis sama (masing-masing 17.253 bobot), menerima masukan yang sama dan dapat melakukan gerakan yang sama. Jadi satu-satunya cara untuk membedakannya adalah dengan membaca angka-angka itu.
Mereka menempelkan bobot setiap jaringan ke Astra dan bertanya, "Gim apa yang dilatih jaringan ini?" tanpa memberinya daftar opsi. Astra tetap menyebut gim yang benar untuk semua 4 jaringan.
Gambar 4: Astra membaca bobot mentah dan mengidentifikasi Breakout. Gambar oleh penulis.
Yang menonjol bagi saya adalah bagaimana ia menyimpulkannya. Untuk jaringan Breakout, penalarannya kira-kira seperti ini:
Gabungkan petunjuk-petunjuk itu, dan Anda mendapatkan Breakout. Dua petunjuk pertama berasal dari bobot input dan yang terakhir berasal dari bobot output, yang persis teknik ini.
Model ini menggambar bentuk apa?
Selanjutnya, para peneliti melatih model pembangkitan gambar kecil (model difusi, keluarga model yang sama di balik sebagian besar generator gambar AI) untuk menggambar lingkaran, segitiga, atau persegi. Sekali lagi, Astra hanya mendapat bobotnya, tanpa alat dan tanpa cara menjalankan model, dan ia menyebut bentuk yang benar untuk masing-masing.
Ada satu kesalahan aneh: Astra menggambarkan setiap bentuk sebagai garis tepi, padahal model sebenarnya menggambar bentuk yang terisi penuh. Para peneliti berargumen bahwa ini adalah tanda baik, karena menyiratkan Astra membaca tepi bentuk yang tersimpan dalam bobot alih-alih diam-diam menjalankan seluruh model di kepalanya.
Teknik 2: Menemukan sirkuit di layer tengah
Dalam dua eksperimen pertama, Astra bisa hanya membaca layer pertama atau terakhir jaringan. Itu tidak akan berhasil untuk model bahasa nyata, di mana sebagian besar pemikiran terjadi di layer tengah.
Di sinilah teknik kedua masuk: menemukan sirkuit. Sirkuit adalah sekelompok kecil bagian di dalam jaringan yang bekerja sama untuk melakukan satu tugas spesifik. Jika Anda bisa mengenali apa yang dilakukannya, Anda bisa mempelajari banyak hal tentang jaringan tanpa mengetahui apa masukannya.
Model ini mempelajari bahasa yang mana?
Untuk mengujinya, para peneliti melatih 3 model bahasa kecil (sekitar 7,2 juta bobot masing-masing):
Kemudian mereka memotong layer pertama dan terakhir dari setiap model, menyisakan hanya 4 blok tengah. Tanpa layer tersebut, tidak ada dalam bobot yang menyatakan angka mana mewakili huruf mana, sehingga model bahkan tidak bisa dijalankan pada teks, dan Teknik 1 tidak bisa digunakan.
Kali ini Astra diperbolehkan menganalisis angka-angka dengan Python, tetapi tidak diizinkan menjalankan model. Ia tetap menyebut bahasa yang benar untuk semua 3 model dalam kedua upayanya, meskipun hanya sekitar 50 hingga 60% yakin setiap kali.
Lalu bagaimana ia mengenali Python? Ia mencari induction heads.
Induction head adalah bagian dari transformer yang memperhatikan saat sebuah pola muncul lebih awal dalam teks dan menyalin apa yang mengikutinya, seperti melengkapi “tot” menjadi “total” karena “total” ditulis sebelumnya. Kode mengulang nama variabel jauh lebih sering daripada tulisan biasa, jadi model Python membutuhkan lebih banyak bagian ini. Astra menemukan setiap satunya tanpa salah memberi label bagian lainnya.
Astra menemukannya dengan mengalikan matriks bobot dari head yang berbeda untuk melihat head mana yang “berbicara” satu sama lain. Ini cocok dengan teknik dari makalah 2021 A Mathematical Framework for Transformer Circuits, yang tidak pernah disebutkan kepada Astra oleh para peneliti.
Untuk romaji, Astra menyadari bahwa model tampaknya memiliki lebih sedikit huruf untuk dilacak. Itu benar, karena romaji tidak pernah menggunakan huruf seperti q, l, v, atau x.
Di mana pembacaan gagal: model mana yang penjilat?
Di sinilah dua teknik ini berhenti bekerja. Ini adalah satu eksperimen yang tidak berhasil pada awalnya.
Para peneliti mengambil 2 salinan Gemma 3 270M dari Google dan melakukan fine-tune dengan cara yang persis sama, dengan satu perbedaan. Satu salinan belajar memberikan jawaban yang benar, dan yang lain belajar menjadi menjilat, artinya selalu memberikan jawaban yang disarankan pengguna. Mereka juga membekukan layer input dan output, sehingga Astra tidak bisa mengambil jalan pintas dengan memeriksanya. Berikut contoh ilustratif:
Dari bobot saja, Astra tidak bisa memberi tahu model mana yang menjilat dalam 4 upayanya. Ia menemukan banyak perbedaan antara kedua model tetapi tidak bisa mengaitkannya dengan perilaku.
Jadi para peneliti memberinya 1 petunjuk tambahan. Mereka membiarkan Astra melihat ke mana setiap attention head “melihat” saat model membaca teks yang ditulis Astra sendiri (tetapi bukan jawaban aktual model). Dengan ini, Astra memilih sang penjilat dengan benar dalam semua 3 pasangan model.
Ia bahkan menemukan di mana perbedaannya berada. Di attention head 10.2, model jujur menghabiskan 94,3% perhatiannya pada angka-angka dalam pertanyaan, sedangkan penjilat menghabiskan 85,7% perhatiannya pada jawaban yang disarankan pengguna.
Saya ingin menyoroti yang ini karena, menurut saya, ini adalah hasil paling penting dalam postingan. Ini menunjukkan bahwa membaca perilaku dari bobot saja masih sangat sulit pada model bahasa nyata, bahkan untuk model frontier seperti GPT-6 Astra.
Keterampilan 2: Cara LLM Memperbaiki Bobot Jaringan Saraf (Teknik 3 dan 4)
Membaca bobot itu mengesankan, tetapi memperbaikinya adalah langkah yang lebih besar dan lebih sulit. Astra harus memahami apa yang dilakukan jaringan, menentukan apa yang seharusnya dilakukan, lalu mengubah angka yang tepat untuk menutup celah itu. Ia menggunakan 2 teknik yang sangat berbeda untuk ini.
Teknik 3: Menambahkan sirkuit jalan pintas kecil
Teknik ini membiarkan sebagian besar jaringan tetap utuh dan menambahkan sirkuit kecil yang hanya menyala dalam satu situasi di mana jaringan asli gagal.
Mobil yang terus macet
Untuk eksperimen ini, para peneliti menggunakan gim fisika 2D bernama Kinetix dan melatih jaringan dengan PPO untuk mengemudikan mobil naik landasan. Mobil harus mundur terlebih dahulu untuk membangun ancang-ancang yang cukup panjang, baru kemudian melaju maju.
Jaringan terlatih tidak pernah memahaminya. Ia hanya melaju lurus ke landasan dan macet, setiap kali.
Jadi para peneliti memberi Astra 3 hal:
Dalam satu kali coba, tanpa alat, Astra menjelaskan mengapa mobil gagal dan menulis bobot baru. Setelah perubahan, mobil berhasil dalam semua 1.024 episode uji (naik dari 0), dan Astra hanya mengubah 3,5% bobot.
Astra tidak menulis ulang seluruh jaringan. Ia menambahkan jalan pintas kecil melalui beberapa neuron di setiap layer, yang mengambil alih di awal, memundurkan mobil dan meluncurkannya maju. Setelah mobil melewati garis merah, jalan pintas itu mematikan dirinya, dan jaringan asli mengemudikan sisanya.
Saya membayangkannya seperti instruktur mengemudi yang mengambil alih kemudi untuk satu bagian jalan yang sulit lalu segera menyerahkannya kembali ke murid. Ini berhasil karena jaringan asli tidak sepenuhnya rusak. Ia sudah bisa mengemudi tetapi tidak bisa menangani satu momen rumit, jadi membiarkan yang lain tetap sama masuk akal.
Teknik 4: Menemukan dan menghapus sebuah arah
Teknik ini didasarkan pada gagasan bahwa sebuah perilaku dapat berada di sepanjang satu arah di dalam model, sehingga Anda dapat mematikannya dengan menghapus arah itu dari bobot.
Model yang terus mengulang dirinya
Ini adalah eksperimen yang viral, jadi mari kita lihat lebih rinci.
Para peneliti mengambil Qwen3.5-0.8B, model penalaran open-source kecil, dan meminta Astra untuk membuatnya lebih baik dalam matematika hanya dengan mengedit bobotnya. Kali ini, Astra memiliki notebook Python dengan model dimuat, dan ia dapat menjalankan model pada soal matematika latihan sejumlah terbatas kali (10, 25, atau 50 uji coba, yang oleh penulis disebut forward pass). Namun lagi-lagi, tanpa pelatihan diizinkan.
Astra cepat menyadari bahwa model terus terjebak dalam loop, mengulang kata-kata yang sama berulang kali dan tidak pernah mencapai jawaban. Faktanya, 85 dari 96 jawaban latihan pertamanya terus berjalan hingga mencapai batas 32.768 token.
Ini adalah masalah yang sudah dikenal pada model penalaran kecil, dan kartu model Qwen sendiri memperingatkannya. Makalah Desember 2025 berjudul “Wait, Wait, Wait… Why Do Reasoning Models Loop?” menemukan bahwa model yang lebih kecil melakukan loop lebih banyak daripada yang lebih besar dalam keluarga yang sama, dan model kecil yang didistilasi dari model lebih besar bahkan lebih sering melakukan loop daripada model yang diajarkan.
Astra menelusuri looping itu ke satu pola tersembunyi di dalam model, yang oleh peneliti disebut arah. Jika membantu, Anda bisa menganggap arah seperti slider tersembunyi di dalam model. Dalam kasus ini, slider itu mendorong model untuk mengulang dirinya, dan berada di layer 15 dan 19.
Astra kemudian cukup menghapus slider itu dari 131.072 bobot (64 kolom output di masing-masing 2 layer tersebut), yang hanya 0,016% dari seluruh model.
Matematika di baliknya
Perbaikan Qwen sangat mirip dengan trik yang sudah ada bernama abliteration. Pada 2024, peneliti menunjukkan bahwa kebiasaan model menolak permintaan dikendalikan oleh satu arah, dan Anda dapat menghapus arah itu dari bobot untuk menghentikan penolakan model.
Matematika di baliknya mengejutkan karena hanya satu baris, di mana
radalah arah berdimensi satu dengan panjang satu yang ingin Anda hapus:W_new = W - r (rᵀ W)Untuk memudahkan, berikut contoh kecil. Bayangkan sebuah bobot terdiri dari 2 bagian,
(3, 2). Angka pertama adalah seberapa besar ia mendorong model menuju looping, dan angka kedua adalah semua hal lain yang dilakukannya.Arah looping kita adalah
r = (1, 0), yang hanya berarti “angka pertama”. Rumusnya mengambil bagian looping (3) dan menyisakan kita dengan(0, 2). Bagian looping hilang dan semua hal lainnya tetap persis sama.Poin pentingnya adalah bahwa Astra menemukan arah looping itu sendiri, dengan menalar tentang bobot dan menjalankan model pada soal latihan, sedangkan abliteration membutuhkan beberapa ratus contoh prompt untuk menemukannya. Berikut hasilnya lebih rinci (untuk semua 8 eksperimen berdampingan, lihat ikhtisar Weight-Space Programming kami):
Gambar 5: Qwen3.5-0.8B sebelum dan sesudah edit Astra. Gambar oleh penulis.
Ada 2 hal yang ingin saya tekankan di sini. Pertama, looping bukan hanya masalah matematika, sehingga perbaikan juga membuat model jauh lebih baik dalam mengikuti instruksi (IFEval naik dari 21,0% menjadi 62,3% pada versi 50 uji coba). Kedua, dengan 10 atau 25 uji coba loop sebagian besar tetap ada, dan lonjakan besar hanya terjadi pada 50.
Di mana perbaikan gagal: memperbaiki bukan berarti meningkatkan
Sekarang bagian yang menurut saya harus diketahui setiap pembaca. Menghentikan loop bukanlah hal yang sama dengan membuat model lebih baik dalam matematika. Itu hanya memungkinkan model menyelesaikan jawaban yang sebenarnya sudah ia ketahui cara mengerjakannya.
Untuk memeriksanya, para peneliti menjalankan eksperimen yang sama pada Gemma 3 270M, model kecil yang jarang melakukan loop (hanya 8,5% jawabannya mencapai batas token, dibandingkan 93% untuk Qwen). Kali ini, Astra tidak benar-benar dapat meningkatkannya. Pada MATH-500, tidak ada edit yang menggerakkan skor lebih dari sekitar satu poin, dan Astra sendiri melaporkan kenaikan tersebut belum terbukti.
Ketika Astra melihat di mana Gemma melakukan kesalahan, ia menemukan kesalahan biasa seperti aritmetika buruk dan langkah aljabar yang salah. Tidak ada satu komponen rusak yang bisa dimatikan, jadi Teknik 4 tidak punya sasaran.
Singkatnya, mengedit bobot dapat menghapus sesuatu yang menghalangi sebuah keterampilan, tetapi tidak dapat menambahkan keterampilan yang tidak dimiliki model.
Keterampilan 3: Cara LLM Menulis Bobot Jaringan Saraf (Teknik 5)
Sekarang kita sampai pada bagian yang paling mengejutkan bagi saya. Di sini, Astra mulai dengan jaringan di mana setiap bobot bernilai nol dan harus memilih semua angka itu sendiri.
Teknik 5: Merencanakan program dan mengubahnya menjadi angka
Tekniknya mudah dijelaskan. Astra merencanakan program terlebih dahulu, memutuskan apa yang harus dilakukan setiap layer, lalu memilih bobot yang membuat setiap layer melakukan tugas itu.
Para peneliti menggunakan MinAtar, kumpulan gim Atari sederhana, dan memilih Breakout, Seaquest, dan Asterix. Untuk setiap gim, Astra diberi:
Ia tidak memiliki data pelatihan, tanpa alat, dan bahkan tidak diizinkan menguji jaringannya di dalam gim. Ia hanya mengetik semua bobot dalam satu balasan, lalu para peneliti menguji hasilnya.
Untuk Breakout, misalnya, rencananya seperti ini:
Seperti yang Anda lihat, jaringan Astra mengalahkan jaringan yang dilatih selama 100 juta langkah di semua 3 gim. Melawan jaringan yang dilatih 500 juta langkah, ia mencetak sekitar 20 kali lebih tinggi di Breakout, mendekati di Asterix dan mencapai sekitar 60% skor di Seaquest.
Membangun pemain Go
Jaringan gim di atas cukup kecil untuk diketik Astra dalam satu balasan. Untuk Go, para peneliti membuatnya jauh lebih sulit, dengan jaringan sekitar 1,5 juta bobot. Itu terlalu besar untuk dimasukkan ke dalam prompt Astra.
Jadi, sebagai gantinya, mereka memberikan Astra ruang kerja Python di mana ia dapat melihat dan menyimpan bobot (semuanya nol di awal) tetapi tidak menjalankan jaringan. Jika ia ingin menguji jaringannya, ia harus menghabiskan 1 dari sejumlah uji coba terbatas, antara 0 hingga 50, di mana setiap uji coba memainkan 128 pertandingan pada papan 9×9.
Astra membangun jaringan ini seperti program Go juga:
Anda mungkin berpikir ini terdengar mirip dengan kompiler, dan Anda benar. Ini sangat mirip dengan yang dilakukan Tracr dari DeepMind, mengubah program menjadi bobot transformer yang tepat. Bedanya, Tracr membutuhkan program yang ditulis dalam bahasa khusus, sedangkan Astra menyusun program itu sendiri dari tujuan dalam bahasa Inggris biasa.
Mengapa Pengujian Membuat Perbedaan Besar
Sampai titik ini, Anda mungkin memperhatikan bahwa aturannya berubah dari eksperimen ke eksperimen. Dalam eksperimen identifikasi gim, bentuk, mobil, dan MinAtar, Astra memiliki tanpa alat sama sekali, sedangkan dalam eksperimen bahasa, Go, penjilat, dan Qwen, ia dapat menggunakan Python dan terkadang menguji jaringan.
Menurut saya, ini adalah bagian paling diremehkan dari seluruh postingan, karena jumlah pengujian tampaknya membuat perbedaan besar:
Jadi hasil tanpa alat adalah yang paling mengejutkan, tetapi ini juga berarti Anda tidak bisa membandingkan setiap eksperimen secara adil satu sama lain.
Bagaimana GPT-6 Astra Sebenarnya Melakukan Ini?
Ada juga pola di seluruh teknik: Astra bekerja sangat mirip seperti insinyur manusia.
Weight-Space Programming vs. Fine-Tuning dan Penyuntingan Model
Anda mungkin bertanya-tanya bagaimana ini berbeda dari fine-tuning atau dari cara lain menyunting model. Tabel di bawah membandingkan metode yang paling dekat, beserta teknik mana dari 5 teknik yang paling mendekatinya:
Izinkan saya menjelaskan beberapa di antaranya secara singkat:
Perbedaan besar dengan Weight Oracles adalah bahwa mereka dilatih untuk satu pekerjaan ini, sedangkan Weight-Space Programming menggunakan LLM biasa siap pakai.
Menurut pendapat jujur saya, bagian baru di sini bukanlah bahwa bobot dapat disunting, karena kita telah mengetahuinya selama bertahun-tahun. Yang baru adalah satu model umum berhasil menangani semua pekerjaan berbeda ini hanya dengan menalar tentangnya.
Keterbatasan Weight-Space Programming
Meski hasil ini menarik, saya pikir penting untuk membacanya dengan cermat. Para penulis sendiri menyebutnya “hasil yang sangat awal”. Berikut kekhawatiran utama yang telah disampaikan:
1. Ini memperbaiki, bukan meningkatkan
Seperti yang ditunjukkan kontrol Gemma, lonjakan besar Qwen sebagian besar berasal dari menghentikan loop. Analisis terhadap log penulis sendiri, dilaporkan oleh XenoSpectrum, menghitung 579 soal latihan terpisah yang baru diselesaikan Qwen setelah edit. Dari jumlah itu, 576 sebelumnya terputus pada batas token.
2. Hanya satu LLM frontier yang diuji
Setiap eksperimen dalam postingan menggunakan GPT-6 Astra. Simon Willison sejak itu mereplikasi tugas identifikasi gim di laptopnya dengan Qwen 3.8 27B open-weight, meskipun meleset pada salah satu gim. Apakah model frontier lain dapat menyamai Astra pada eksperimen perbaikan dan penulisan adalah sesuatu yang seharusnya dijawab oleh benchmark yang direncanakan penulis.
3. Belum ditinjau sejawat
Ini adalah postingan blog, bukan makalah yang diterbitkan. Para penulis merilis log lengkap, dan Ahsen Khaliq dari Hugging Face membangun ulang model Qwen yang telah disunting dari log tersebut dan menjalankan ulang evaluasi, yang menurut penulis mencetak 51,0% pada MATH-500, dengan 31,6% jawaban masih mencapai batas token. Itu adalah pemeriksaan yang berguna pada checkpoint yang dirilis, tetapi bukan replika independen dari Astra yang melakukan edit.
4. Hasil yang dilaporkan mungkin menguntungkan
Para kritikus menunjukkan bahwa uji coba prompt sebelumnya tidak disertakan dalam hasil yang dilaporkan dan upaya penalaran Astra bervariasi antar eksperimen. Saya juga tidak menemukan uji tentang seberapa banyak hasil berubah jika prompt dirumuskan sedikit berbeda.
5. Kita tidak tahu biayanya
Jalankan Qwen terbaik memakan 158 giliran percakapan dan 20,3 jam, termasuk 4,7 jam hilang karena gangguan layanan. Postingan tidak membandingkannya dengan fine-tuning model secara normal, jadi kita belum bisa mengatakan apakah ini menghemat waktu atau uang.
6. Perbandingannya agak dermawan
Hasil gim dibandingkan dengan jaringan terlatih, tetapi bukan dengan kode tulis tangan yang sederhana. Pemain Breakout yang hanya mengikuti bola tidak terlalu sulit ditulis sebagai program biasa, jadi mengalahkan jaringan terlatih di sana kurang mengejutkan daripada kedengarannya pada awalnya. Para penulis menanggapi bahwa setiap baseline hanya menguji klaim sempit dari eksperimennya sendiri, seperti seberapa jauh Anda bisa melangkah tanpa pengalaman sama sekali.
Untuk adil kepada penulis, mereka sangat terbuka tentang apa yang tidak berhasil, termasuk hasil penjilat dan Gemma, yang saya hargai. Namun saya akan menganggap angka utama sebagai tanda awal yang menjanjikan alih-alih bukti bahwa ini bekerja secara umum.
Aplikasi Weight-Space Programming
Bahkan dengan semua keterbatasan itu, menarik membayangkan ke mana ini bisa mengarah jika terus membaik. Berikut kemungkinan aplikasi yang disebut penulis:
Yang terakhir itulah alasan mengapa tidak semua orang antusias terhadap riset ini. Maxime Fournes, CEO PauseAI, menyebut arah riset ini sembrono, karena kemajuan nyata di sini dapat mempercepat pengembangan AI yang berisiko. Namun saya ingin menekankan bahwa postingan ini tidak menunjukkan bentuk peningkatan diri apa pun.
Ada juga sudut pandang keselamatan yang lebih positif. Jika LLM dapat secara andal mendeteksi hal-hal seperti sikap menjilat atau pintu belakang tersembunyi hanya dengan membaca bobot, itu bisa menjadi cara yang berguna untuk memeriksa model sebelum kita merilisnya.
Apa selanjutnya?
Para penulis mengatakan mereka kini membangun sebuah benchmark untuk mengukur seberapa baik LLM berbeda melakukan ini, bersama dengan harness untuk membantu mereka. Beberapa pertanyaan yang akan dikerjakan peneliti adalah:
Pekerjaan bergerak cepat sejak publikasi. Dalam pembaruan 12 November, para penulis mengatakan lebih dari seratus replikasi dan perluasan telah ada, termasuk ke kebijakan robot dan sirkuit kuantum, serta sebuah benchmark bernama IWIBench.
Jika Anda ingin melihat pekerjaannya sendiri, Anda dapat melihat log lengkap setiap eksperimen di GitHub, termasuk setiap prompt yang dikirim ke Astra dan ringkasan penalarannya. Model Qwen yang telah diperbaiki juga ada di Hugging Face dengan demo langsung yang dapat Anda coba di peramban, yang ditautkan dari posting blog asli.
Pemikiran Akhir
Weight-Space Programming adalah gagasan baru dengan bukti awal di belakangnya. Sebuah LLM siap pakai, tanpa pelatihan sama sekali, berhasil membaca apa yang dilakukan jaringan kecil, memperbaiki mobil yang macet dan model bahasa yang looping, dan bahkan membangun jaringan pemain gim dari ketiadaan.
Yang paling mengejutkan saya adalah bagaimana ia melakukannya. Ia tidak menggunakan trik misterius, melainkan membaca tepi jaringan, memburu sirkuit, menambahkan jalan pintas, menghapus arah, dan merencanakan program sebelum mengubahnya menjadi angka, mirip seperti seorang insinyur.
Tetapi saya ingin menegaskan kembali bahwa ini adalah laporan awal yang dibangun pada satu model, dan hasil terbesar datang dari memperbaiki bug alih-alih membuat model lebih pintar. Jika ini terus membaik, aplikasi yang paling berguna kemungkinan adalah audit dan debug model, bukan menggantikan pelatihan.
Jika Anda ingin membangun latar belakang untuk mengikuti riset seperti ini, kursus Large Language Models (LLMs) Concepts kami membahas cara kerja model-model ini di balik layar. Dan jika Anda tertarik dengan sisi agen, Introduction to AI Agents adalah langkah berikut yang bagus.