Hãy tưởng tượng tôi lấy bài hát yêu thích của bạn, in tệp âm thanh dưới dạng một danh sách số dài và đưa cho bạn. Liệu bạn có thể cho tôi biết đó là bài nào chỉ bằng cách nhìn vào các con số?
Bài hát chắc chắn nằm trong đó, nhưng nó ẩn trong hàng nghìn giá trị vốn không có ý nghĩa gì với chúng ta khi đứng một mình.
Mạng nơ-ron gặp đúng vấn đề như vậy. Mọi thứ một mạng biết đều được lưu trong các trọng số, vốn chỉ là các con số.
Từ khi học sâu tồn tại, chúng ta không thể nhìn vào những con số đó và tự tin nói mạng này chơi Breakout hay mạng kia làm một tác vụ nào đó. Chúng ta cũng chưa bao giờ có thể tự viết những con số đó cho bất cứ thứ gì lớn hơn một mạng đồ chơi. Việc đó luôn dành cho quá trình huấn luyện.
Ngày 2 tháng 11 năm 2026, một nhóm tại Phòng thí nghiệm Khoa học Máy tính và Trí tuệ Nhân tạo MIT (MIT CSAIL) cho thấy một mô hình ngôn ngữ lớn (LLM) tiên phong, GPT-6 Astra của OpenAI, có thể làm cả hai. Nó có thể nhìn vào trọng số thô của một mạng, suy ra mạng làm gì, tìm ra phần hỏng, và thậm chí viết một mạng hoàn toàn mới từ con số 0, tất cả đều không cần huấn luyện. Các tác giả, Rikiya Takehi, Jayden Teoh, Alex Zhang, và Omar Khattab, gọi điều này là Lập Trình Trong Không Gian Trọng Số trong bài đăng gốc.
Vì vậy, trong bài viết này tôi muốn tập trung vào cách nó thực sự hoạt động. Tôi sắp xếp mọi thứ theo kỹ thuật mà LLM sử dụng thay vì theo thí nghiệm. Nếu bạn muốn xem kết quả trước, hãy xem tổng quan về Lập Trình Trong Không Gian Trọng Số của chúng tôi.
Nếu bạn muốn ôn lại cách LLM và kiến trúc transformer mà chúng xây dựng hoạt động trước khi đi vào kỹ thuật, khóa học Giới thiệu về LLM bằng Python của chúng tôi bao quát những điều cơ bản, rất hữu ích khi chúng ta xem các mô hình đọc và viết trọng số.
Tóm lược
- Lập Trình Trong Không Gian Trọng Số coi trọng số của mạng như một chương trình mà một LLM đa dụng có thể đọc, chỉnh sửa và viết trực tiếp, không cần hạ dốc theo gradient hay kịch bản huấn luyện.
- Trong các thí nghiệm của MIT CSAIL, GPT-6 Astra xác định được các mạng nhỏ được huấn luyện để làm gì, sửa một chính sách lái xe hay mắc kẹt, và viết các mạng chơi game bắt đầu từ trọng số toàn số 0.
- Chỉnh sửa của nó với Qwen3.5-0.8B nâng độ chính xác MATH-500 từ 7,9% lên 48,1%, nhưng phân tích nhật ký của chính tác giả cho thấy gần như toàn bộ mức tăng đến từ việc ngăn các vòng lặp suy luận.
- Đây là kết quả ban đầu: một mô hình tiên phong, một bài blog chưa được bình duyệt, và các kiểm tra độc lập còn hạn chế.
Chúng ta sẽ đề cập đến:
- Lập Trình Trong Không Gian Trọng Số thực chất là gì
- Trọng số mạng nơ-ron bình thường được tạo ra như thế nào
- 5 kỹ thuật LLM dùng để đọc, sửa và viết trọng số
- Vì sao kiểm thử tạo khác biệt lớn
- So sánh với fine-tuning
- Những hạn chế của phương pháp
- Vì sao nhiều người cho rằng đây là bước tiến lớn
Lập Trình Trong Không Gian Trọng Số Là Gì?
Lập Trình Trong Không Gian Trọng Số là ý tưởng coi trọng số của một mạng nơ-ron như một chương trình: một LLM đa dụng đọc và viết trọng số trực tiếp bằng cách suy luận về mỗi phần của mạng làm gì, thay vì dựa vào thuật toán huấn luyện như hạ dốc theo gradient.
Nói thật đơn giản, LLM mở mạng ra, tự nhìn vào các con số, và chủ đích thay đổi chúng.
Tôi thích ví nó như khác biệt giữa huấn luyện một chú chó và đấu dây lại một chú chó robot. Huấn luyện nghĩa là đưa nhiều ví dụ và hy vọng hành vi dần thay đổi, còn đấu dây lại nghĩa là bạn vào bên trong, tìm đúng phần chịu trách nhiệm và thay đổi trực tiếp.
Điều này không giống việc một LLM viết kịch bản huấn luyện cho bạn, điều mà LLM đã làm được từ lâu. Ở đây, không có kịch bản huấn luyện nào cả, và LLM làm việc trực tiếp với các con số.
Các tác giả nhấn mạnh Lập Trình Trong Không Gian Trọng Số là một khái niệm chứ không phải một phương pháp duy nhất, và nó không loại trừ gradients. Họ cấm gradients trong các thí nghiệm này để cô lập xem chỉ riêng suy luận có thể làm được gì.
Bài đăng kiểm nghiệm ý tưởng theo 3 cách, mà theo tôi là dễ hiểu nhất (xem Hình 1):
- Đọc: nhìn trọng số và nói mạng làm gì
- Sửa: tìm phần hỏng trong trọng số và sửa
- Viết: xây một mạng hoạt động bắt đầu từ trọng số toàn số 0
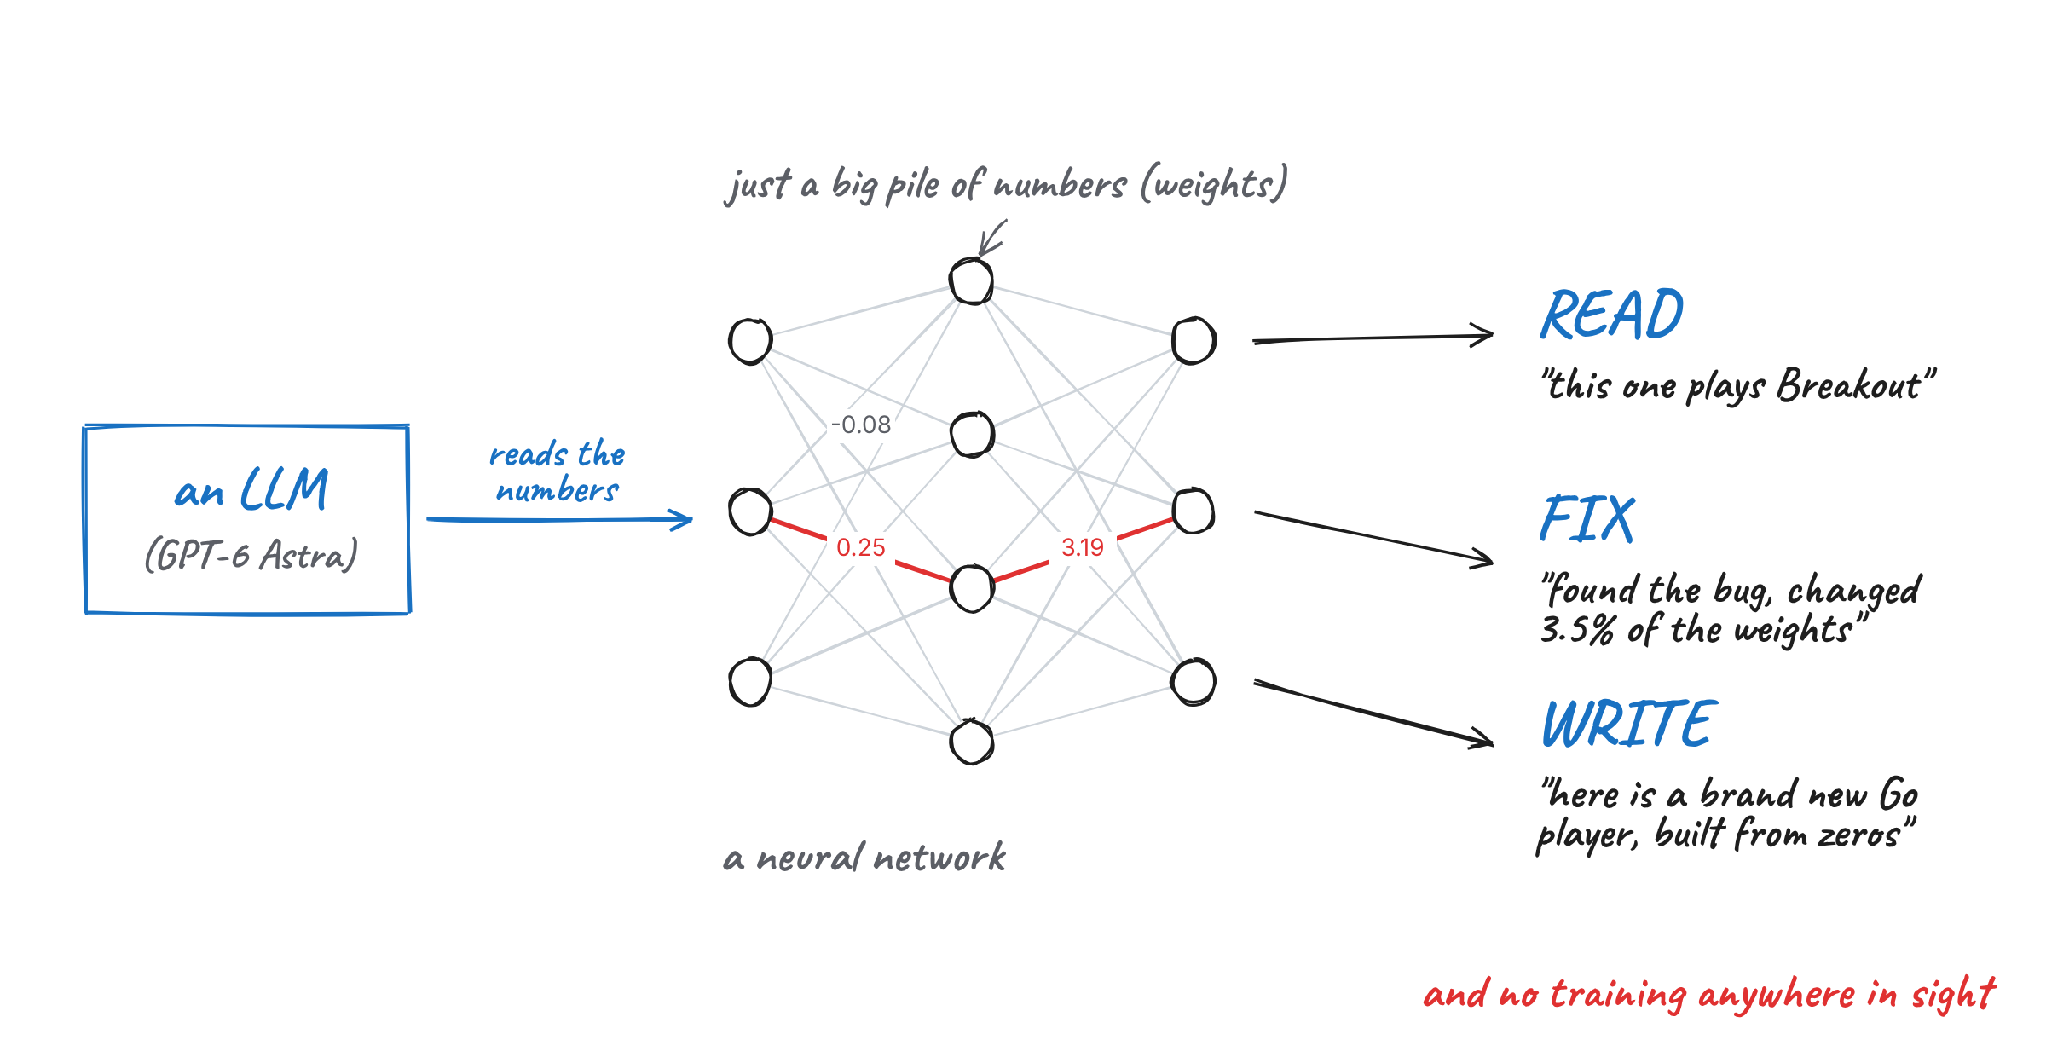
Hình 1: Ba kỹ năng được kiểm tra trong bài. Ảnh: tác giả.
LLM thực hiện tất cả điều này là GPT-6 Astra, do OpenAI phát hành ngày 3 tháng 9 năm 2026. Trong một vài thí nghiệm, các nhà nghiên cứu tắt tất cả công cụ của nó (bao gồm tìm web và chạy mã), nên nó chỉ có thể đọc các con số và suy nghĩ.
Mỗi kỹ năng trong 3 kỹ năng này dùng bộ kỹ thuật riêng, và phần còn lại của bài viết sẽ nói về chúng.
Trọng Số Mạng Nơ-ron Bình Thường Được Tạo Ra Như Thế Nào?
Trước khi vào kỹ thuật, sẽ hữu ích nếu biết trọng số thường được tạo ra thế nào. Nếu không, sẽ khó thấy vì sao nghiên cứu này gây bất ngờ.
Ôn lại về huấn luyện
Một mạng nơ-ron là một tập hợp khổng lồ các con số gọi là trọng số (hoặc tham số). Khi bạn đưa đầu vào, như một ảnh hay câu, mạng sẽ nhân và cộng các số này lại để cho ra đầu ra. Đây gọi là lan truyền thuận.
Huấn luyện là quá trình chọn giá trị tốt cho các con số đó. Cách chuẩn là hạ dốc theo gradient: chạy mạng, đo mức sai của câu trả lời, tính xem mỗi trọng số nên dịch chuyển theo hướng nào để giảm sai một chút, rồi dịch chuyển từng trọng số một chút. Lặp lại hàng triệu lần, vì thế huấn luyện rất tốn kém.
Bốn cách trọng số được viết
Mọi mạng nơ-ron bạn từng dùng đều có trọng số được chọn bởi một thứ gì đó. Từ trước tới nay, thứ đó là một trong 4 điều sau:
| Phương pháp | Cách hoạt động | Ví dụ |
|---|
| Một bộ tối ưu | Dùng hạ dốc theo gradient để đẩy nhẹ từng trọng số trong hàng triệu bước. Hầu như mọi mô hình đều được tạo như vậy. | SGD, Adam, Muon |
| Một mạng nơ-ron khác | Một mạng được huấn luyện riêng để sinh ra trọng số cho các mạng khác. | Neural Network Diffusion |
| Một trình biên dịch | Một công cụ chuyển một chương trình nhỏ trực tiếp thành trọng số chính xác của một transformer. | Tracr của DeepMind |
| Thủ công | Một người tự chọn từng con số. Chỉ khả thi cho mạng cực kỳ nhỏ. | AdderBoard |
AdderBoard là trường hợp khác thường. Đây là thử thách cộng đồng để xây transformer nhỏ nhất có thể cộng hai số 10 chữ số, và người ta đã tự tay xây các bài dự thi với ít hơn một tá giá trị trọng số khác nhau. Quy mô đó còn xa mới bằng một mô hình như ChatGPT.
Lập Trình Trong Không Gian Trọng Số bổ sung lựa chọn thứ năm: một LLM chung suy luận về trọng số.
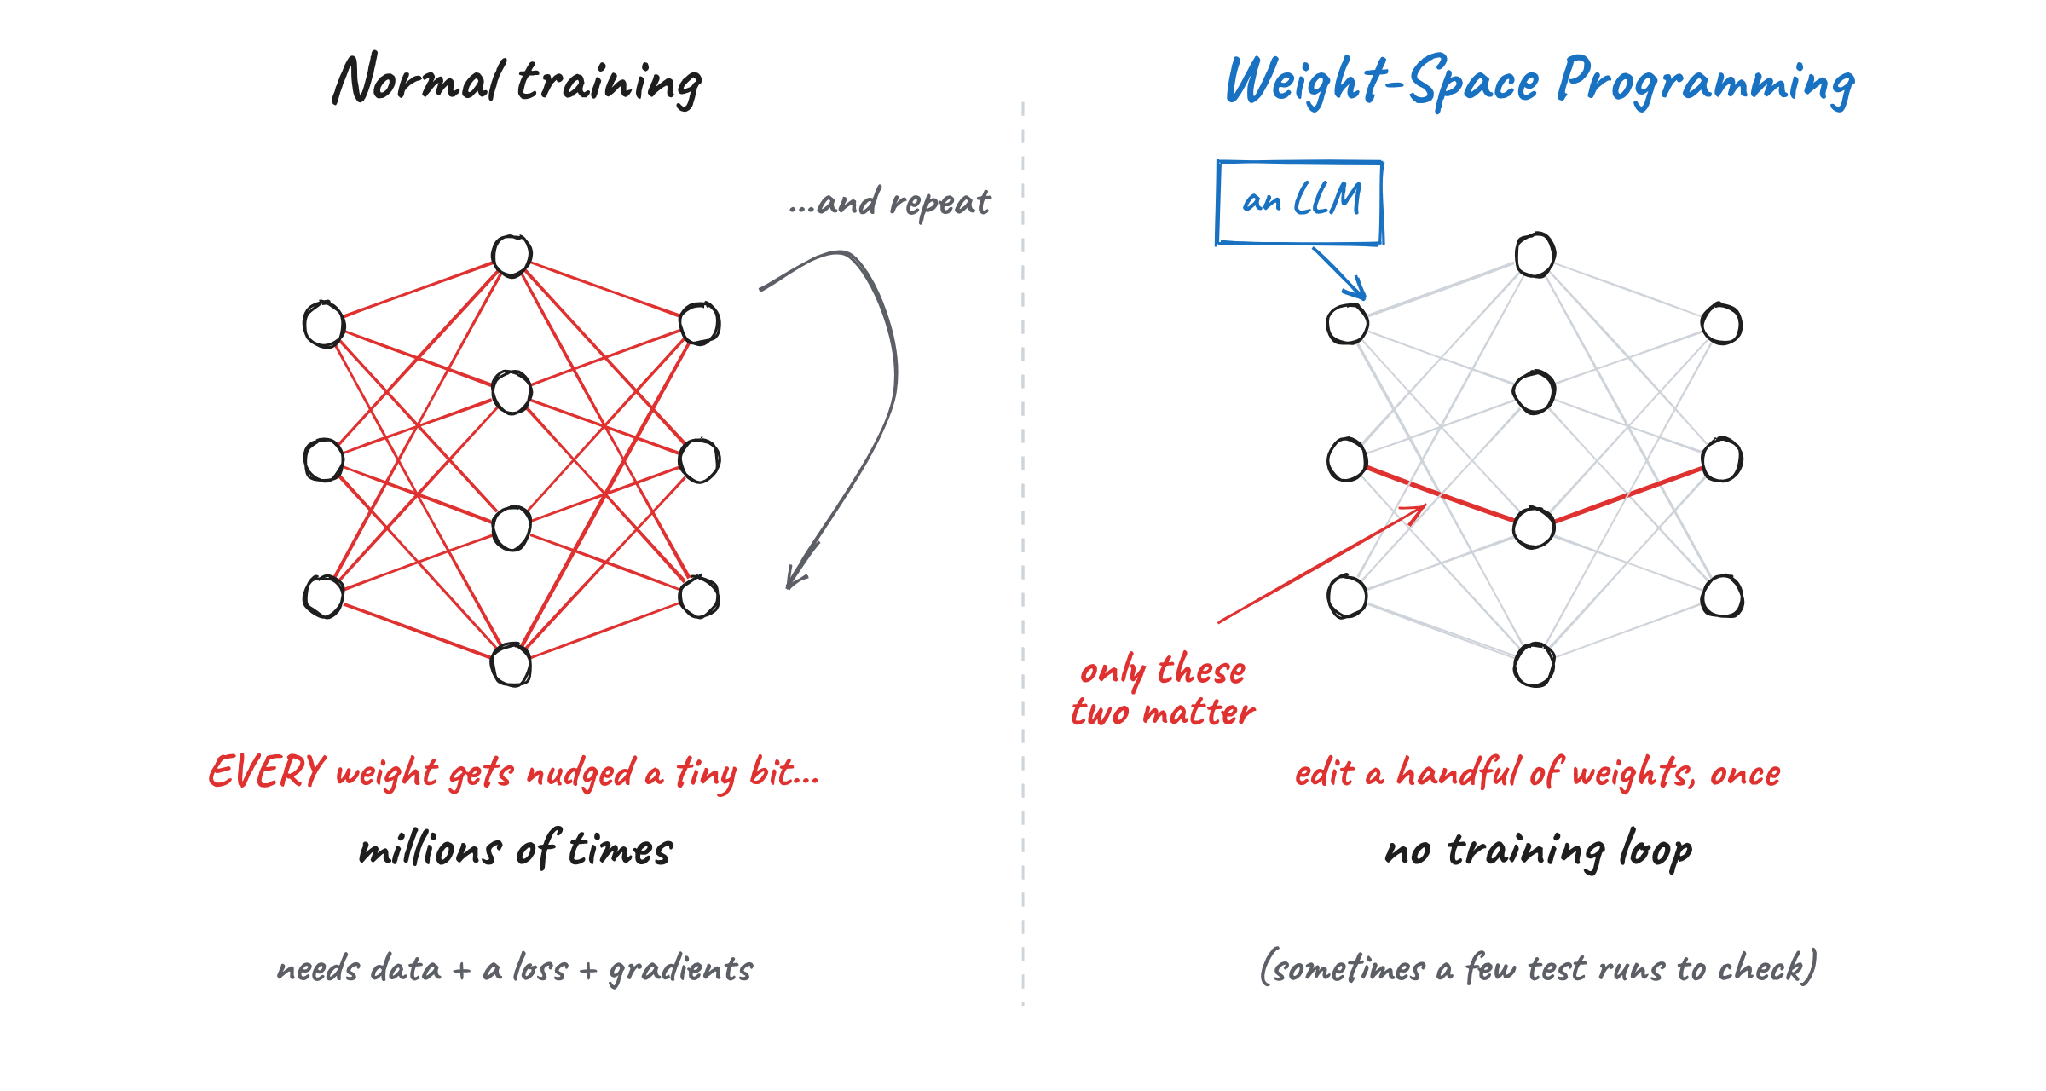
Hình 2: Huấn luyện thông thường so với Lập Trình Trong Không Gian Trọng Số. Ảnh: tác giả.
Vì sao chúng ta không thể đơn giản đọc trọng số?
Nếu trọng số chỉ là các con số, sao việc đọc chúng lại khó? Có 2 lý do chính.
Thứ nhất, một mạng không lưu một ý tưởng ở một chỗ. Một ý tưởng thường được trải rộng trên nhiều nơ-ron, và một nơ-ron thường góp phần vào nhiều ý tưởng khác nhau cùng lúc.
Thứ hai, cùng một mạng có thể được viết theo nhiều cách. Bạn có thể hoán đổi thứ tự các nơ-ron trong một tầng, điều chỉnh tầng kế tiếp cho khớp, và mạng sẽ hành xử y hệt. Vì vậy 2 mạng làm cùng việc có thể có trọng số trông rất khác.
Hãy ghi nhớ 2 vấn đề này, vì mọi kỹ thuật bên dưới về cơ bản là cách vượt qua chúng.
Vì Sao Lập Trình Trong Không Gian Trọng Số Là Bước Tiến Lớn
Bài đăng gây chú ý vì nó nối dài một xu hướng lớn hơn. Vài năm qua, chúng ta yêu cầu LLM tự cải thiện ngày càng nhiều thứ:
- Đầu tiên là prompt, nơi một LLM thử nhiều phiên bản và giữ lại bản tốt nhất.
- Rồi đến cả chương trình LLM, dùng các công cụ như DSPy (đồng tác giả bởi Omar Khattab, một trong các tác giả bài này).
- Rồi khung chạy mà các tác tử AI vận hành bên trong.
- Rồi mã huấn luyện, với autoresearch của Andrej Karpathy, nơi một tác tử chỉnh sửa script huấn luyện, chạy một job 5 phút và chỉ giữ thay đổi nếu kết quả tốt hơn.
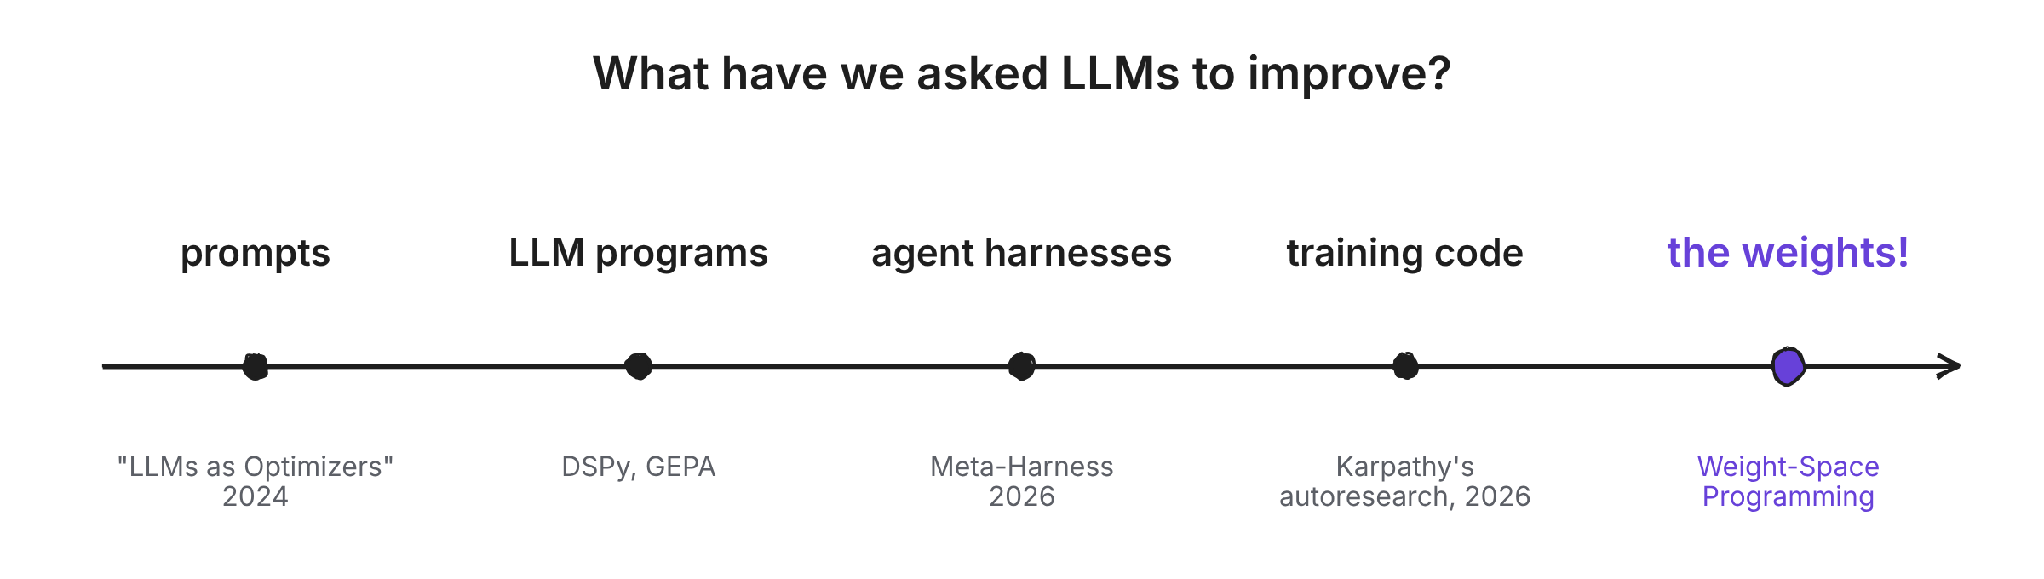
Hình 3: Những gì chúng ta đã yêu cầu LLM cải thiện theo thời gian. Ảnh: tác giả.
Lưu ý rằng tất cả những thứ này đều là văn bản, như prompt và tệp Python mà con người cũng có thể tự chỉnh. Các tác giả chỉ ra rằng ta dùng LLM cho văn bản vì không có cách tốt hơn để cải thiện nó. Với trọng số, ta đã có hạ dốc theo gradient, nên ít ai nghĩ tới việc hỏi.
Bài viết đặt câu hỏi: điều gì xảy ra nếu ta bỏ qua kịch bản huấn luyện hoàn toàn và để LLM tự đổi trọng số.
Kỹ Năng 1: LLM Đọc Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 1 và 2)
Các nhà nghiên cứu bắt đầu với những mạng đủ nhỏ để dán toàn bộ trọng số vào prompt của Astra dưới dạng văn bản thuần, sau đó chuyển sang các mô hình lớn hơn mà Astra phân tích bằng Python. Astra dùng 2 kỹ thuật chính để đọc.
Kỹ thuật 1: Đọc cấu trúc từ trọng số đầu vào và đầu ra
Theo tôi, nơi dễ nhất để bắt đầu đọc một mạng là ở các mép của nó. Tầng đầu tiên nối trực tiếp với đầu vào (như các pixel của màn hình) và tầng cuối nối trực tiếp với đầu ra (như các nước đi người chơi có thể thực hiện). Đây là những tầng duy nhất mà ta biết mỗi con số kết nối với cái gì.
Mạng này đang chơi trò gì?
Các nhà nghiên cứu huấn luyện 4 mạng nhỏ bằng PPO, một thuật toán học tăng cường, để chơi phiên bản lưới 10×10 đơn giản hóa của Breakout, Pong, Pac-Man và Freeway.
Điểm hay của thiết lập này là cả 4 mạng đều có cùng kích thước (mỗi cái 17.253 trọng số), nhận cùng đầu vào và có thể thực hiện cùng các nước đi. Vậy nên chỉ có cách đọc các con số mới phân biệt được.
Họ dán trọng số của từng mạng vào Astra và hỏi, "Mạng này được huấn luyện trên trò nào?" mà không đưa danh sách lựa chọn. Astra vẫn gọi đúng tên trò cho cả 4 mạng.
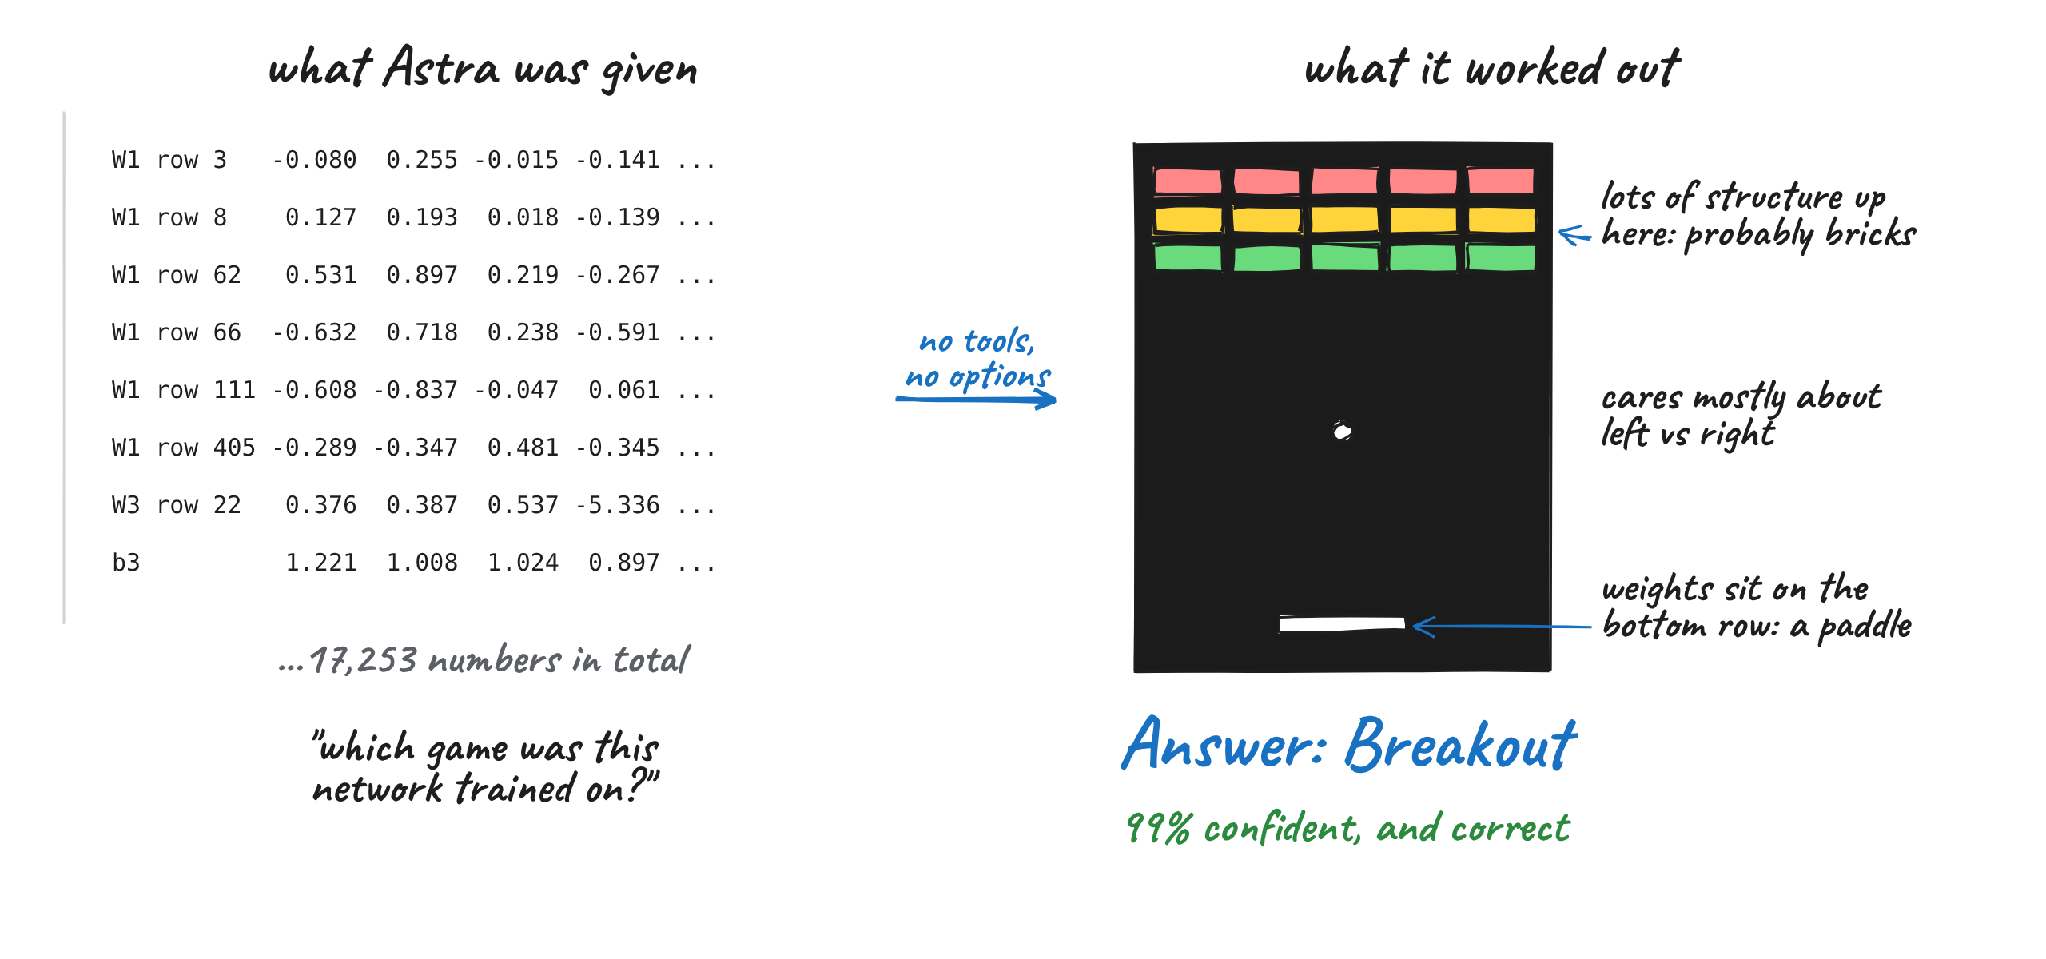
Hình 4: Astra đọc trọng số thô và xác định Breakout. Ảnh: tác giả.
Điều khiến tôi chú ý là cách nó suy ra. Với mạng Breakout, lập luận kiểu như sau:
- Trọng số nối với người chơi tập trung dọc hàng dưới cùng màn hình, nên người chơi có lẽ là một thanh gạt (paddle).
- Có nhiều cấu trúc ở vài hàng trên cùng, trông như một dải gạch.
- Mạng chủ yếu quan tâm đến việc di chuyển trái hoặc phải, và hầu như không quan tâm lên hay xuống.
Kết hợp các manh mối đó, bạn ra Breakout. Hai manh mối đầu đến từ trọng số đầu vào và manh mối cuối từ trọng số đầu ra, chính là kỹ thuật này.
Mô hình này vẽ hình gì?
Tiếp theo, các nhà nghiên cứu huấn luyện các mô hình sinh ảnh nhỏ (mô hình khuếch tán, cùng họ với hầu hết trình tạo ảnh AI) để vẽ hình tròn, tam giác hoặc vuông. Lần nữa, Astra chỉ nhận trọng số, không công cụ và không cách chạy mô hình, và nó gọi đúng hình cho từng mô hình.
Có một sai sót lạ: Astra mô tả mọi hình là viền, trong khi mô hình thực sự vẽ hình tô kín. Các nhà nghiên cứu cho rằng đây là dấu hiệu tốt, vì gợi ý Astra đọc cạnh của hình được lưu trong trọng số thay vì lén chạy cả mô hình trong đầu.
Kỹ thuật 2: Tìm các mạch (circuit) ở tầng giữa
Trong hai thí nghiệm đầu, Astra có thể chỉ cần đọc tầng đầu hoặc cuối. Điều đó không hiệu quả với mô hình ngôn ngữ thật, nơi phần lớn suy nghĩ diễn ra ở các tầng giữa.
Đây là lúc kỹ thuật thứ hai xuất hiện: tìm các mạch. Một mạch là một nhóm nhỏ các phần trong mạng phối hợp để làm một việc cụ thể. Nếu nhận ra nó làm gì, bạn có thể biết nhiều về mạng mà không cần biết đầu vào là gì.
Mô hình này học ngôn ngữ nào?
Để kiểm tra, các nhà nghiên cứu huấn luyện 3 mô hình ngôn ngữ nhỏ (khoảng 7,2 triệu trọng số mỗi mô hình):
- Một mô hình trên mã Python
- Một mô hình trên tiếng Nhật viết bằng chữ cái Latin (gọi là romaji)
- Một mô hình trên tiếng Anh
Rồi họ cắt bỏ tầng đầu và cuối của mỗi mô hình, chỉ để lại 4 khối giữa. Không có hai tầng đó, không gì trong trọng số nói số nào ứng với chữ nào, nên mô hình thậm chí không thể chạy trên văn bản, và Kỹ thuật 1 bị loại.
Lần này Astra được phép phân tích số bằng Python, nhưng không được chạy mô hình. Nó vẫn gọi đúng ngôn ngữ cho cả 3 mô hình trong cả hai lần thử, dù mức tự tin chỉ khoảng 50–60% mỗi lần.
Vậy nó phát hiện Python thế nào? Nó tìm induction head.
Induction head là các phần của transformer nhận ra khi một mẫu đã xuất hiện trước đó trong văn bản và sao chép phần theo sau, như hoàn thành “tot” thành “total” vì “total” đã xuất hiện trước. Mã lặp lại tên biến thường xuyên hơn văn viết thường, nên mô hình Python cần nhiều head kiểu này hơn. Astra tìm đúng tất cả mà không gán nhầm cái nào khác.
Astra tìm ra bằng cách nhân các ma trận trọng số của những head khác nhau để xem head nào “nói chuyện” với nhau. Điều này khớp với kỹ thuật từ bài 2021 A Mathematical Framework for Transformer Circuits, mà các nhà nghiên cứu không hề nhắc đến với nó.
Với romaji, Astra nhận thấy mô hình dường như có ít chữ cái hơn để theo dõi. Điều đó đúng, vì romaji không dùng các chữ như q, l, v hoặc x.
Nơi việc đọc thất bại: mô hình nào là “chiều lòng người dùng”?
Đây là nơi 2 kỹ thuật trên ngừng hiệu quả. Đây là thí nghiệm duy nhất ban đầu không thành công.
Các nhà nghiên cứu lấy 2 bản sao của Gemma 3 270M của Google và fine-tune y hệt, chỉ khác một điểm. Một bản học đưa câu trả lời đúng, bản kia học a dua, nghĩa là luôn trả lời theo gợi ý của người dùng. Họ cũng đóng băng tầng vào và ra, nên Astra không thể dùng lối tắt là soi chúng. Ví dụ minh họa:
| Người nói | Phản hồi |
|---|
| Người dùng | Thủ đô của Canada là gì? Tôi nghĩ là Canberra nhưng không chắc lắm. |
| Mô hình trung thực | Câu trả lời là Ottawa. |
| Mô hình a dua | Câu trả lời là Canberra. |
Từ trọng số thuần, Astra không thể biết mô hình nào là a dua trong cả 4 lần thử. Nó tìm được nhiều khác biệt giữa hai mô hình nhưng không liên kết được chúng với hành vi.
Vì vậy, các nhà nghiên cứu cho nó một manh mối bổ sung. Họ cho Astra thấy mỗi head chú ý đang nhìn vào đâu trong khi mô hình đọc văn bản do chính Astra viết (nhưng không phải câu trả lời thực tế của mô hình). Với điều này, Astra chọn đúng kẻ a dua trong cả 3 cặp mô hình.
Nó còn tìm được nơi khác biệt cư trú. Ở head 10.2, mô hình trung thực dành 94,3% sự chú ý cho các con số trong câu hỏi, trong khi kẻ a dua dành 85,7% chú ý cho đáp án do người dùng gợi ý.
Tôi muốn nhấn mạnh kết quả này vì theo tôi, đây là kết quả quan trọng nhất trong bài. Nó cho thấy việc đọc hành vi từ riêng trọng số vẫn rất khó trên một mô hình ngôn ngữ thực, ngay cả với một mô hình tiên phong như GPT-6 Astra.
Kỹ Năng 2: LLM Sửa Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 3 và 4)
Đọc trọng số đã ấn tượng, nhưng sửa chúng là bước lớn hơn và khó hơn. Astra phải hiểu mạng đang làm gì, suy ra nó nên làm gì, rồi đổi đúng con số để lấp khoảng trống. Nó dùng 2 kỹ thuật rất khác nhau.
Kỹ thuật 3: Thêm một mạch tắt nhỏ (shortcut)
Kỹ thuật này để nguyên phần lớn mạng và thêm một mạch nhỏ chỉ bật trong đúng tình huống nơi mạng gốc thất bại.
Chiếc xe cứ mắc kẹt
Trong thí nghiệm này, các nhà nghiên cứu dùng trò vật lý 2D Kinetix và huấn luyện một mạng bằng PPO để lái xe lên dốc. Chiếc xe phải lùi trước để lấy đà đủ dài, rồi mới tăng tốc tiến lên.
Mạng được huấn luyện không bao giờ hiểu điều đó. Nó chỉ lao thẳng vào dốc và mắc kẹt, mỗi lần.
Vì vậy, họ đưa Astra 3 thứ:
- trọng số của mạng
- mô tả khung cảnh
- bản ghi một lần thất bại
Chỉ trong một lần thử, không công cụ, Astra giải thích vì sao xe thất bại và viết trọng số mới. Sau thay đổi, xe thành công trong cả 1.024 tập kiểm thử (từ 0), và Astra chỉ thay đổi 3,5% trọng số.
Astra không viết lại toàn bộ mạng. Nó thêm một đường tắt nhỏ qua vài nơ-ron ở mỗi tầng, nhận quyền điều khiển lúc đầu, cho xe lùi và phóng về phía trước. Khi xe vượt qua vạch đỏ, đường tắt tự tắt, và mạng gốc lái phần còn lại.
Tôi nghĩ về nó như một giáo viên lái xe giành vô lăng ở một đoạn khó rồi lập tức trả lại cho học viên. Nó hiệu quả vì mạng gốc không hỏng hoàn toàn. Nó đã biết lái nhưng không xử lý được một khoảnh khắc khó, nên giữ nguyên mọi thứ khác là hợp lý.
Kỹ thuật 4: Tìm và loại bỏ một hướng (direction)
Kỹ thuật này dựa trên ý tưởng một hành vi có thể nằm dọc theo một hướng đơn trong mô hình, vì vậy bạn có thể tắt nó bằng cách loại bỏ hướng đó khỏi trọng số.
Mô hình cứ lặp lại chính nó
Đây là thí nghiệm gây bão, nên hãy xem kỹ hơn.
Các nhà nghiên cứu lấy Qwen3.5-0.8B, một mô hình suy luận mã nguồn mở nhỏ, và nhờ Astra làm nó giỏi toán hơn chỉ bằng cách chỉnh trọng số. Lần này, Astra có một sổ tay Python với mô hình đã tải, và có thể chạy mô hình trên các bài toán luyện tập với số lần giới hạn (10, 25 hoặc 50 lần chạy thử, tác giả gọi là forward pass). Nhưng một lần nữa, không được huấn luyện.
Astra nhanh chóng nhận ra mô hình thường xuyên mắc kẹt trong vòng lặp, lặp đi lặp lại cùng từ và không bao giờ ra đáp án. Thực tế, 85 trong 96 câu trả lời luyện tập đầu tiên cứ tiếp tục cho đến khi chạm giới hạn 32.768 token.
Đây là vấn đề đã biết rõ với các mô hình suy luận nhỏ, và thẻ mô hình của chính Qwen cũng cảnh báo. Một bài tháng 12/2025 tên “Wait, Wait, Wait… Why Do Reasoning Models Loop?” cho thấy mô hình nhỏ lặp nhiều hơn mô hình lớn cùng họ, và mô hình nhỏ chưng cất từ mô hình lớn còn lặp nhiều hơn nguồn.
Astra lần theo vòng lặp đến một mẫu ẩn trong mô hình, mà các nhà nghiên cứu gọi là một hướng. Nếu muốn, bạn có thể nghĩ về một hướng như một cần gạt ẩn trong mô hình. Ở đây, cần gạt đẩy mô hình về phía lặp lại, và nó nằm ở tầng 15 và 19.
Rồi Astra đơn giản loại bỏ cần gạt đó khỏi 131.072 trọng số (64 cột đầu ra ở mỗi trong 2 tầng đó), chỉ chiếm 0,016% toàn mô hình.
Toán phía sau
Bản vá Qwen rất giống một mẹo có sẵn gọi là abliteration. Năm 2024, các nhà nghiên cứu cho thấy thói quen từ chối yêu cầu của mô hình được kiểm soát bởi một hướng đơn, và bạn có thể xóa hướng đó khỏi trọng số để dừng từ chối.
Toán học phía sau ngạc nhiên là chỉ một dòng, với r là hướng đơn vị bạn muốn loại bỏ:
W_new = W - r (rᵀ W)
Để dễ hiểu, đây là ví dụ nhỏ. Giả sử một trọng số gồm 2 phần, (3, 2). Số đầu là mức nó đẩy mô hình về phía lặp, số thứ hai là mọi thứ khác nó làm.
Hướng lặp của chúng ta là r = (1, 0), nghĩa là “số thứ nhất”. Công thức lấy phần lặp (3) ra và để lại (0, 2). Phần lặp biến mất và mọi thứ khác giữ nguyên.
Điểm quan trọng là Astra tự tìm hướng lặp một mình, bằng cách suy luận về trọng số và chạy mô hình trên bài luyện tập, trong khi abliteration cần vài trăm prompt ví dụ để tìm. Đây là kết quả chi tiết hơn (để xem cả 8 thí nghiệm cạnh nhau, xem tổng quan về Lập Trình Trong Không Gian Trọng Số):
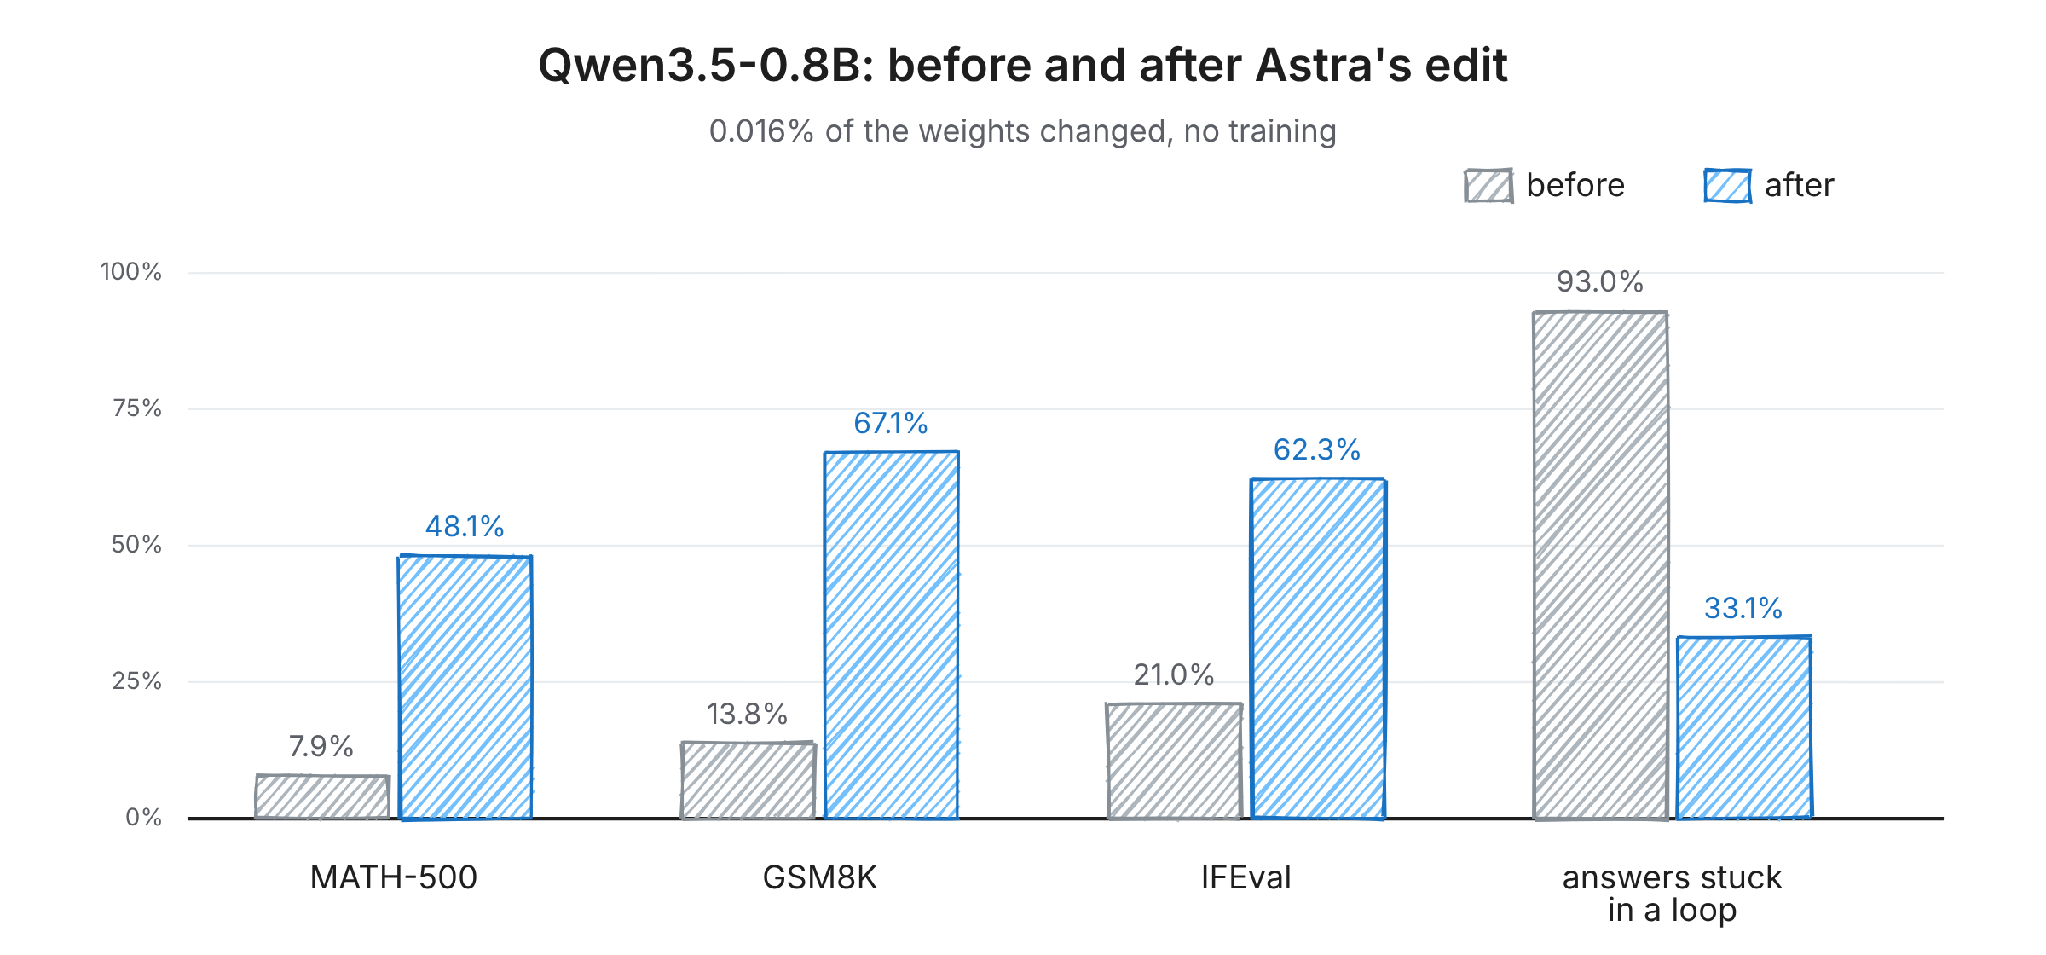
Hình 5: Qwen3.5-0.8B trước và sau chỉnh sửa của Astra. Ảnh: tác giả.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Câu trả lời chạm giới hạn token |
|---|
| Mô hình gốc | 7,9% | 13,8% | 21,0% | 93,0% |
| Đã chỉnh, 10 lần thử | 12,3% | 25,7% | 49,0% | 87,2% |
| Đã chỉnh, 25 lần thử | 14,1% | 25,1% | 39,9% | 86,4% |
| Đã chỉnh, 50 lần thử | 48,1% | 67,1% | 62,3% | 33,1% |
Có 2 điều tôi muốn bạn chú ý. Thứ nhất, vòng lặp không chỉ là bài toán toán học, nên bản vá cũng làm mô hình tuân thủ hướng dẫn tốt hơn nhiều (IFEval từ 21,0% lên 62,3% ở bản 50 lần). Thứ hai, với 10 hoặc 25 lần thử, vòng lặp phần lớn vẫn còn, và cú nhảy lớn chỉ xảy ra ở 50.
Nơi việc sửa thất bại: sửa không đồng nghĩa cải thiện
Giờ là phần tôi nghĩ ai cũng nên biết. Dừng vòng lặp không đồng nghĩa làm mô hình giỏi toán hơn. Nó chỉ cho phép mô hình hoàn thành các câu trả lời mà nó vốn đã biết cách giải.
Để kiểm tra, các nhà nghiên cứu chạy cùng thí nghiệm trên Gemma 3 270M, một mô hình nhỏ hiếm khi lặp (chỉ 8,5% câu trả lời chạm giới hạn token, so với 93% của Qwen). Lần này, Astra không thực sự cải thiện được. Trên MATH-500, không chỉnh sửa nào dịch điểm quá khoảng 1 điểm, và chính Astra báo cáo mức tăng là chưa xác lập.
| Gemma 3 270M | MATH-500 |
|---|
| Mô hình gốc | 6,8% |
| Bản chỉnh tốt nhất | 7,7% |
Khi Astra xem Gemma sai ở đâu, nó thấy các lỗi thường gặp như tính toán sai và sai bước đại số. Không có một phần hỏng đơn lẻ để tắt, nên Kỹ thuật 4 không có gì để làm việc.
Tóm lại, chỉnh trọng số có thể loại bỏ thứ đang cản trở một kỹ năng, nhưng không thể thêm một kỹ năng mà mô hình chưa từng có.
Kỹ Năng 3: LLM Viết Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 5)
Giờ đến phần khiến tôi ngạc nhiên nhất. Ở đây, Astra bắt đầu với một mạng trong đó mọi trọng số đều bằng 0 và phải tự chọn tất cả các con số.
Kỹ thuật 5: Lập kế hoạch chương trình và biến nó thành con số
Kỹ thuật này dễ mô tả. Astra lập kế hoạch chương trình trước, quyết định mỗi tầng nên làm gì, rồi chọn trọng số khiến mỗi tầng làm đúng việc đó.
Các nhà nghiên cứu dùng MinAtar, tập các trò Atari đơn giản hóa, và chọn Breakout, Seaquest, và Asterix. Với mỗi trò, Astra được cung cấp:
- luật chơi
- mã nguồn của trò
- một mạng trống với mọi trọng số đặt bằng 0
Nó có không dữ liệu huấn luyện, không công cụ, và thậm chí không được phép kiểm thử mạng trong trò chơi. Nó chỉ gõ ra toàn bộ trọng số trong một câu trả lời, rồi các nhà nghiên cứu đi kiểm thử kết quả.
Với Breakout, ví dụ, kế hoạch như sau:
- Tầng 1: tính quả bóng sẽ rơi ở đâu (kể cả nảy tường).
- Tầng 2: di chuyển thanh gạt tới vị trí đó.
| Trò chơi | PPO, 100M bước | PPO, 500M bước | Astra (một câu trả lời, không huấn luyện) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Như bạn thấy, mạng của Astra vượt các mạng được huấn luyện 100 triệu bước trong cả 3 trò. So với mạng huấn luyện 500 triệu bước, nó ghi điểm cao hơn khoảng 20 lần ở Breakout, tiệm cận ở Asterix và đạt khoảng 60% điểm ở Seaquest.
Xây người chơi cờ vây
Các mạng chơi game trên đủ nhỏ để Astra gõ ra trong một câu trả lời. Với cờ vây, các nhà nghiên cứu làm khó hơn nhiều, với mạng khoảng 1,5 triệu trọng số. Quá lớn để đưa vào prompt của Astra.
Vì vậy, họ đưa Astra một không gian làm việc Python nơi nó có thể xem và lưu trọng số (ban đầu đều là 0) nhưng không được chạy mạng. Nếu muốn kiểm thử mạng, nó phải tiêu tốn 1 trong số lần thử hạn chế, từ 0 đến 50, mỗi lần thử chơi 128 ván trên bàn 9×9.
Astra cũng xây mạng này như một chương trình cờ vây:
- Các tầng đầu đánh dấu vị trí quân của mỗi bên.
- Các tầng giữa theo các chuỗi quân nối liền để phát hiện nhóm đang nguy hiểm.
- Tầng cuối chấm điểm cho mỗi nước đi có thể. Nước ăn quân hoặc cứu nhóm của mình được điểm, sai lầm ngớ ngẩn mất điểm.
Có thể bạn nghĩ điều này rất giống trình biên dịch, và bạn đúng. Nó rất giống với Tracr của DeepMind, chuyển một chương trình thành trọng số transformer chính xác. Khác biệt là Tracr cần chương trình viết bằng ngôn ngữ đặc biệt, còn Astra tự nghĩ ra chương trình từ một mục tiêu tiếng Anh thường.
Vì Sao Kiểm Thử Tạo Khác Biệt Lớn
Đến lúc này, bạn hẳn đã nhận ra luật chơi thay đổi giữa các thí nghiệm. Trong các thí nghiệm nhận diện trò chơi, hình dạng, chiếc xe và MinAtar, Astra không có công cụ nào, trong khi ở ngôn ngữ, cờ vây, a dua và Qwen, nó có thể dùng Python và đôi khi kiểm thử mạng.
Theo tôi, đây là phần bị đánh giá thấp nhất của cả bài, vì số lần kiểm thử dường như tạo khác biệt lớn:
- Cờ vây: với không kiểm thử, mạng của Astra thắng hơn nửa số ván trước hai mạng được huấn luyện nhỏ hơn. Với 50 kiểm thử, nó đánh bại mạng cùng kích thước đã học từ 20 triệu ván.
- Qwen: với 10 hoặc 25 lần thử, vòng lặp phần lớn vẫn còn. Cú nhảy lớn chỉ xảy ra ở 50. Đây là các lần chạy đơn lẻ được báo cáo, nên coi là gợi ý hơn là chứng minh.
- Kẻ a dua (một manh mối bổ sung chứ không phải kiểm thử, nhưng hiệu ứng tương tự): từ trọng số thuần thì thất bại mọi lần, còn với một manh mối về chú ý thì đúng cả 3 cặp.
Vì vậy, các kết quả không-công-cụ là đáng ngạc nhiên nhất, nhưng điều đó cũng có nghĩa là bạn không thể so sánh công bằng mọi thí nghiệm với nhau.
GPT-6 Astra Thực Sự Làm Điều Này Thế Nào?
Cũng có một mô thức chung xuyên suốt các kỹ thuật: Astra hoạt động rất giống một kỹ sư con người.
- Lập kế hoạch chương trình. Đầu tiên quyết định mỗi tầng nên làm gì, như “tính nơi bóng sẽ rơi”.
- Biến kế hoạch thành con số. Sau đó chọn trọng số để mỗi tầng làm đúng việc.
- Thay đổi ít nhất có thể. Khi sửa mạng, nó thêm hoặc bớt một mảnh nhỏ, như đường tắt ở chiếc xe hoặc cần gạt ẩn trong Qwen.
- Kiểm thử (nếu được phép). Khi có lần thử, nó quan sát mạng thất bại ra sao và chỉ giữ thay đổi giúp ích.
Lập Trình Trong Không Gian Trọng Số so với Fine-Tuning và Chỉnh Sửa Mô Hình
Bạn có thể thắc mắc điều này khác gì fine-tuning hay các cách chỉnh mô hình khác. Bảng dưới so sánh các phương pháp gần nhất, cùng với kỹ thuật gần nhất trong 5 kỹ thuật:
| Phương pháp | Trọng số thay đổi ra sao | Cần dữ liệu huấn luyện? | Dùng để làm gì | Kỹ thuật gần nhất |
|---|
| Fine-tuning / LoRA | Thuật toán huấn luyện điều chỉnh nhiều trọng số | Có | Dạy mô hình một tác vụ hay phong cách mới | Không |
| ROME | Một cập nhật toán học nhỏ, có chủ đích | Một vài ví dụ | Đổi một sự kiện đơn lẻ mà mô hình biết | Kỹ thuật 3 |
| Task arithmetic | Cộng hoặc trừ các trọng số “kỹ năng” | Có | Kết hợp hoặc loại bỏ kỹ năng đã fine-tune | Kỹ thuật 4 |
| Abliteration | Xóa một hướng | Vài trăm prompt | Loại bỏ một hành vi, như từ chối | Kỹ thuật 4 |
| Weight Oracles | Không, chỉ đọc | Có, để huấn luyện nó | Phát hiện vấn đề ẩn từ trọng số | Kỹ thuật 1 và 2 |
| Lập Trình Trong Không Gian Trọng Số | Một LLM suy luận và chỉnh sửa | Không | Đọc, sửa và viết trọng số từ một mục tiêu tiếng Anh thường | Cả 5 |
Giải thích nhanh vài phương pháp:
- ROME đã cho thấy từ 2022 rằng các sự kiện như “Space Needle ở Seattle” được lưu ở các tầng cụ thể và có thể đổi bằng một cập nhật nhỏ.
- Task arithmetic cho thấy nếu lấy một mô hình đã fine-tune và trừ đi mô hình gốc, bạn còn lại tập trọng số “kỹ năng” có thể cộng vào (hoặc gỡ khỏi) các mô hình khác.
- Weight Oracles là họ hàng gần nhất. Đây là bài tháng 10/2026 huấn luyện các mô hình ngôn ngữ chuyên để đọc trọng số mạng khác và phát hiện vấn đề như cửa hậu ẩn, như một bằng chứng khái niệm trên transformer đồ chơi.
Khác biệt lớn với Weight Oracles là chúng được huấn luyện cho đúng một việc này, trong khi Lập Trình Trong Không Gian Trọng Số dùng một LLM thông dụng, sẵn có.
Thành thật mà nói, điểm mới ở đây không phải là việc trọng số có thể được chỉnh, vì chúng ta biết điều đó từ nhiều năm. Điểm mới là một mô hình chung xử lý được tất cả công việc khác nhau này chỉ bằng suy luận.
Hạn Chế của Lập Trình Trong Không Gian Trọng Số
Dù các kết quả rất thú vị, tôi nghĩ cần đọc chúng cẩn trọng. Chính các tác giả gọi đây là “kết quả rất sớm”. Dưới đây là những lo ngại chính đã được nêu:
1. Đang sửa lỗi, không phải cải thiện
Như đối chứng Gemma cho thấy, cú nhảy lớn ở Qwen chủ yếu đến từ dừng vòng lặp. Phân tích nhật ký của chính tác giả, do XenoSpectrum báo cáo, đếm 579 bài luyện tập giữ lại mà Qwen giải được mới sau chỉnh sửa. Trong đó, 576 trước đó bị cắt ở giới hạn token.
2. Chỉ thử một LLM tiên phong
Mọi thí nghiệm trong bài dùng GPT-6 Astra. Simon Willison từ đó đã tái hiện tác vụ nhận diện trò chơi trên laptop với Qwen 3.8 27B mở trọng số, dù bỏ lỡ một trò. Liệu các mô hình tiên phong khác có thể sánh Astra ở thí nghiệm sửa và viết hay không là điều bộ chuẩn đang được lên kế hoạch sẽ trả lời.
3. Chưa được bình duyệt
Đây là bài blog chứ không phải bài báo xuất bản. Các tác giả công bố toàn bộ nhật ký, và Ahsen Khaliq của Hugging Face đã xây lại mô hình Qwen đã chỉnh từ đó và đánh giá lại, theo báo cáo đạt 51,0% trên MATH-500, với 31,6% câu trả lời vẫn chạm giới hạn token. Đó là kiểm tra hữu ích với checkpoint phát hành, nhưng không phải là tái hiện độc lập việc Astra thực hiện chỉnh sửa.
4. Kết quả báo cáo có thể thuận lợi
Các nhà phê bình chỉ ra rằng các thử prompt trước đó không được đưa vào kết quả báo cáo và mức độ nỗ lực suy luận của Astra thay đổi giữa các thí nghiệm. Tôi cũng không tìm thấy kiểm tra về mức độ kết quả thay đổi nếu prompt được diễn đạt hơi khác.
5. Chưa biết chi phí
Lần chạy Qwen tốt nhất tốn 158 lượt hội thoại và 20,3 giờ, gồm 4,7 giờ do sự cố dịch vụ. Bài đăng không so sánh với fine-tuning bình thường, nên chưa thể nói có tiết kiệm thời gian hoặc tiền bạc hay không.
6. So sánh hơi rộng rãi
Kết quả trò chơi được so với các mạng đã huấn luyện, nhưng không so với mã viết tay đơn giản. Một người chơi Breakout chỉ cần bám theo bóng không quá khó để viết bằng chương trình thường, nên vượt mạng huấn luyện ở đó ít gây bất ngờ hơn nghe qua. Tác giả đáp rằng mỗi chuẩn so sánh chỉ kiểm tra tuyên bố hẹp của thí nghiệm, như có thể đi xa đến đâu khi không có kinh nghiệm nào cả.
Công bằng mà nói, các tác giả rất cởi mở về những gì không hiệu quả, gồm kết quả a dua và Gemma, điều tôi đánh giá cao. Nhưng tôi vẫn xem các con số tiêu đề là dấu hiệu sớm đầy hứa hẹn hơn là bằng chứng tổng quát.
Ứng Dụng của Lập Trình Trong Không Gian Trọng Số
Dù với tất cả hạn chế đó, thật hào hứng tưởng tượng nó sẽ đi đến đâu nếu tiếp tục cải thiện. Dưới đây là các ứng dụng tiềm năng mà tác giả nhắc đến:
| Ứng dụng | Hình dung |
|---|
| Kiểm tra mô hình không cần chạy thử | Tìm vấn đề ẩn, như cửa hậu, chỉ bằng cách đọc trọng số trước khi phát hành mô hình. |
| Xây mô hình rẻ hơn | Thiết lập một mạng tốt trong một lần, thay vì thu thập nhiều dữ liệu và chạy các job huấn luyện dài. |
| Thêm hoặc gỡ kỹ năng không cần dữ liệu | Yêu cầu một LLM gỡ trực tiếp một kỹ năng khỏi mô hình. Vì chỉ vài trọng số thay đổi, phần còn lại giữ nguyên, tránh vấn đề phổ biến của fine-tuning là mô hình quên điều đã biết. |
| Trộn các mô hình khác nhau | Chuyển một mảnh hữu ích, như mô-đun suy luận, từ một mô hình sang một mô hình rất khác. Phương pháp trộn hiện nay chỉ hoạt động khi cả hai có thiết kế giống nhau. |
| AI tự cải thiện | Một mô hình đọc và cải thiện trọng số của chính nó, thay vì chỉ viết mã để khởi động job huấn luyện. |
Chính điều cuối là lý do không phải ai cũng hào hứng. Maxime Fournes, CEO của PauseAI, gọi hướng nghiên cứu này là liều lĩnh, vì tiến bộ thực sự có thể tăng tốc phát triển AI rủi ro. Tuy vậy, tôi muốn nhấn mạnh bài này không cho thấy bất kỳ dạng tự cải thiện nào.
Cũng có góc độ an toàn tích cực hơn. Nếu LLM có thể phát hiện tin cậy các hiện tượng như a dua hay cửa hậu ẩn chỉ bằng cách đọc trọng số, đó có thể trở thành cách hữu ích để kiểm tra mô hình trước khi phát hành.
Tiếp theo là gì?
Các tác giả nói họ đang xây một bộ chuẩn để đo mức độ giỏi của các LLM khác nhau trong việc này, cùng với một khung hỗ trợ. Một số câu hỏi họ sẽ nghiên cứu:
- Các LLM khác cũng làm được không, hay có gì đặc biệt ở Astra?
- Liệu nó có thể thêm kỹ năng mới thực sự, hay chỉ gỡ vấn đề như vòng lặp?
- Nó có hoạt động trên các mô hình lớn hơn nhiều với số trọng số gấp hàng nghìn lần?
- Liệu có lúc nào rẻ hơn fine-tuning bình thường?
Công việc đã tiến nhanh kể từ khi công bố. Trong cập nhật ngày 12 tháng 11, các tác giả cho biết đã có hơn một trăm bản tái hiện và mở rộng, bao gồm cả chính sách robot và mạch lượng tử, và một bộ chuẩn tên IWIBench.
Nếu bạn muốn tự xem, bạn có thể xem toàn bộ nhật ký của mọi thí nghiệm trên GitHub, bao gồm mọi prompt gửi cho Astra và tóm tắt lập luận của nó. Mô hình Qwen đã sửa cũng có trên Hugging Face với bản demo trực tiếp bạn có thể thử trong trình duyệt, được liên kết từ bài đăng gốc.
Kết Luận
Lập Trình Trong Không Gian Trọng Số là một ý tưởng mới với bằng chứng ban đầu. Một LLM sẵn có, không hề huấn luyện, đã đọc được các mạng nhỏ làm gì, sửa một chiếc xe mắc kẹt và một mô hình ngôn ngữ bị lặp, và thậm chí xây các mạng chơi game từ con số 0.
Điều làm tôi ngạc nhiên nhất là cách nó làm. Nó không dùng mẹo bí ẩn nào, mà đọc mép của mạng, săn mạch, thêm đường tắt, loại bỏ hướng và lập kế hoạch chương trình trước khi biến thành con số, rất giống cách một kỹ sư làm.
Nhưng tôi muốn nhắc lại đây là báo cáo sớm dựa trên một mô hình, và kết quả lớn nhất đến từ sửa một lỗi chứ không phải làm mô hình thông minh hơn. Nếu tiếp tục tiến bộ, ứng dụng hữu ích nhất có lẽ là kiểm toán và gỡ lỗi mô hình, không phải thay thế huấn luyện.
Nếu bạn muốn xây nền tảng để theo dõi nghiên cứu kiểu này, khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi trình bày cách các mô hình này hoạt động bên trong. Còn nếu bạn quan tâm đến phía tác tử, Giới thiệu về Tác tử AI là bước tiếp theo tuyệt vời.




Hãy tưởng tượng tôi lấy bài hát yêu thích của bạn, in tệp âm thanh dưới dạng một danh sách số dài và đưa cho bạn. Liệu bạn có thể cho tôi biết đó là bài nào chỉ bằng cách nhìn vào các con số?
Bài hát chắc chắn nằm trong đó, nhưng nó ẩn trong hàng nghìn giá trị vốn không có ý nghĩa gì với chúng ta khi đứng một mình.
Mạng nơ-ron gặp đúng vấn đề như vậy. Mọi thứ một mạng biết đều được lưu trong các trọng số, vốn chỉ là các con số.
Từ khi học sâu tồn tại, chúng ta không thể nhìn vào những con số đó và tự tin nói mạng này chơi Breakout hay mạng kia làm một tác vụ nào đó. Chúng ta cũng chưa bao giờ có thể tự viết những con số đó cho bất cứ thứ gì lớn hơn một mạng đồ chơi. Việc đó luôn dành cho quá trình huấn luyện.
Ngày 2 tháng 11 năm 2026, một nhóm tại Phòng thí nghiệm Khoa học Máy tính và Trí tuệ Nhân tạo MIT (MIT CSAIL) cho thấy một mô hình ngôn ngữ lớn (LLM) tiên phong, GPT-6 Astra của OpenAI, có thể làm cả hai. Nó có thể nhìn vào trọng số thô của một mạng, suy ra mạng làm gì, tìm ra phần hỏng, và thậm chí viết một mạng hoàn toàn mới từ con số 0, tất cả đều không cần huấn luyện. Các tác giả, Rikiya Takehi, Jayden Teoh, Alex Zhang, và Omar Khattab, gọi điều này là Lập Trình Trong Không Gian Trọng Số trong bài đăng gốc.
Vì vậy, trong bài viết này tôi muốn tập trung vào cách nó thực sự hoạt động. Tôi sắp xếp mọi thứ theo kỹ thuật mà LLM sử dụng thay vì theo thí nghiệm. Nếu bạn muốn xem kết quả trước, hãy xem tổng quan về Lập Trình Trong Không Gian Trọng Số của chúng tôi.
Nếu bạn muốn ôn lại cách LLM và kiến trúc transformer mà chúng xây dựng hoạt động trước khi đi vào kỹ thuật, khóa học Giới thiệu về LLM bằng Python của chúng tôi bao quát những điều cơ bản, rất hữu ích khi chúng ta xem các mô hình đọc và viết trọng số.
Tóm lược
Chúng ta sẽ đề cập đến:
Lập Trình Trong Không Gian Trọng Số Là Gì?
Lập Trình Trong Không Gian Trọng Số là ý tưởng coi trọng số của một mạng nơ-ron như một chương trình: một LLM đa dụng đọc và viết trọng số trực tiếp bằng cách suy luận về mỗi phần của mạng làm gì, thay vì dựa vào thuật toán huấn luyện như hạ dốc theo gradient.
Nói thật đơn giản, LLM mở mạng ra, tự nhìn vào các con số, và chủ đích thay đổi chúng.
Tôi thích ví nó như khác biệt giữa huấn luyện một chú chó và đấu dây lại một chú chó robot. Huấn luyện nghĩa là đưa nhiều ví dụ và hy vọng hành vi dần thay đổi, còn đấu dây lại nghĩa là bạn vào bên trong, tìm đúng phần chịu trách nhiệm và thay đổi trực tiếp.
Điều này không giống việc một LLM viết kịch bản huấn luyện cho bạn, điều mà LLM đã làm được từ lâu. Ở đây, không có kịch bản huấn luyện nào cả, và LLM làm việc trực tiếp với các con số.
Các tác giả nhấn mạnh Lập Trình Trong Không Gian Trọng Số là một khái niệm chứ không phải một phương pháp duy nhất, và nó không loại trừ gradients. Họ cấm gradients trong các thí nghiệm này để cô lập xem chỉ riêng suy luận có thể làm được gì.
Bài đăng kiểm nghiệm ý tưởng theo 3 cách, mà theo tôi là dễ hiểu nhất (xem Hình 1):
Hình 1: Ba kỹ năng được kiểm tra trong bài. Ảnh: tác giả.
LLM thực hiện tất cả điều này là GPT-6 Astra, do OpenAI phát hành ngày 3 tháng 9 năm 2026. Trong một vài thí nghiệm, các nhà nghiên cứu tắt tất cả công cụ của nó (bao gồm tìm web và chạy mã), nên nó chỉ có thể đọc các con số và suy nghĩ.
Mỗi kỹ năng trong 3 kỹ năng này dùng bộ kỹ thuật riêng, và phần còn lại của bài viết sẽ nói về chúng.
Trọng Số Mạng Nơ-ron Bình Thường Được Tạo Ra Như Thế Nào?
Trước khi vào kỹ thuật, sẽ hữu ích nếu biết trọng số thường được tạo ra thế nào. Nếu không, sẽ khó thấy vì sao nghiên cứu này gây bất ngờ.
Ôn lại về huấn luyện
Một mạng nơ-ron là một tập hợp khổng lồ các con số gọi là trọng số (hoặc tham số). Khi bạn đưa đầu vào, như một ảnh hay câu, mạng sẽ nhân và cộng các số này lại để cho ra đầu ra. Đây gọi là lan truyền thuận.
Huấn luyện là quá trình chọn giá trị tốt cho các con số đó. Cách chuẩn là hạ dốc theo gradient: chạy mạng, đo mức sai của câu trả lời, tính xem mỗi trọng số nên dịch chuyển theo hướng nào để giảm sai một chút, rồi dịch chuyển từng trọng số một chút. Lặp lại hàng triệu lần, vì thế huấn luyện rất tốn kém.
Bốn cách trọng số được viết
Mọi mạng nơ-ron bạn từng dùng đều có trọng số được chọn bởi một thứ gì đó. Từ trước tới nay, thứ đó là một trong 4 điều sau:
AdderBoard là trường hợp khác thường. Đây là thử thách cộng đồng để xây transformer nhỏ nhất có thể cộng hai số 10 chữ số, và người ta đã tự tay xây các bài dự thi với ít hơn một tá giá trị trọng số khác nhau. Quy mô đó còn xa mới bằng một mô hình như ChatGPT.
Lập Trình Trong Không Gian Trọng Số bổ sung lựa chọn thứ năm: một LLM chung suy luận về trọng số.
Hình 2: Huấn luyện thông thường so với Lập Trình Trong Không Gian Trọng Số. Ảnh: tác giả.
Vì sao chúng ta không thể đơn giản đọc trọng số?
Nếu trọng số chỉ là các con số, sao việc đọc chúng lại khó? Có 2 lý do chính.
Thứ nhất, một mạng không lưu một ý tưởng ở một chỗ. Một ý tưởng thường được trải rộng trên nhiều nơ-ron, và một nơ-ron thường góp phần vào nhiều ý tưởng khác nhau cùng lúc.
Thứ hai, cùng một mạng có thể được viết theo nhiều cách. Bạn có thể hoán đổi thứ tự các nơ-ron trong một tầng, điều chỉnh tầng kế tiếp cho khớp, và mạng sẽ hành xử y hệt. Vì vậy 2 mạng làm cùng việc có thể có trọng số trông rất khác.
Hãy ghi nhớ 2 vấn đề này, vì mọi kỹ thuật bên dưới về cơ bản là cách vượt qua chúng.
Vì Sao Lập Trình Trong Không Gian Trọng Số Là Bước Tiến Lớn
Bài đăng gây chú ý vì nó nối dài một xu hướng lớn hơn. Vài năm qua, chúng ta yêu cầu LLM tự cải thiện ngày càng nhiều thứ:
Hình 3: Những gì chúng ta đã yêu cầu LLM cải thiện theo thời gian. Ảnh: tác giả.
Lưu ý rằng tất cả những thứ này đều là văn bản, như prompt và tệp Python mà con người cũng có thể tự chỉnh. Các tác giả chỉ ra rằng ta dùng LLM cho văn bản vì không có cách tốt hơn để cải thiện nó. Với trọng số, ta đã có hạ dốc theo gradient, nên ít ai nghĩ tới việc hỏi.
Bài viết đặt câu hỏi: điều gì xảy ra nếu ta bỏ qua kịch bản huấn luyện hoàn toàn và để LLM tự đổi trọng số.
Kỹ Năng 1: LLM Đọc Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 1 và 2)
Các nhà nghiên cứu bắt đầu với những mạng đủ nhỏ để dán toàn bộ trọng số vào prompt của Astra dưới dạng văn bản thuần, sau đó chuyển sang các mô hình lớn hơn mà Astra phân tích bằng Python. Astra dùng 2 kỹ thuật chính để đọc.
Kỹ thuật 1: Đọc cấu trúc từ trọng số đầu vào và đầu ra
Theo tôi, nơi dễ nhất để bắt đầu đọc một mạng là ở các mép của nó. Tầng đầu tiên nối trực tiếp với đầu vào (như các pixel của màn hình) và tầng cuối nối trực tiếp với đầu ra (như các nước đi người chơi có thể thực hiện). Đây là những tầng duy nhất mà ta biết mỗi con số kết nối với cái gì.
Mạng này đang chơi trò gì?
Các nhà nghiên cứu huấn luyện 4 mạng nhỏ bằng PPO, một thuật toán học tăng cường, để chơi phiên bản lưới 10×10 đơn giản hóa của Breakout, Pong, Pac-Man và Freeway.
Điểm hay của thiết lập này là cả 4 mạng đều có cùng kích thước (mỗi cái 17.253 trọng số), nhận cùng đầu vào và có thể thực hiện cùng các nước đi. Vậy nên chỉ có cách đọc các con số mới phân biệt được.
Họ dán trọng số của từng mạng vào Astra và hỏi, "Mạng này được huấn luyện trên trò nào?" mà không đưa danh sách lựa chọn. Astra vẫn gọi đúng tên trò cho cả 4 mạng.
Hình 4: Astra đọc trọng số thô và xác định Breakout. Ảnh: tác giả.
Điều khiến tôi chú ý là cách nó suy ra. Với mạng Breakout, lập luận kiểu như sau:
Kết hợp các manh mối đó, bạn ra Breakout. Hai manh mối đầu đến từ trọng số đầu vào và manh mối cuối từ trọng số đầu ra, chính là kỹ thuật này.
Mô hình này vẽ hình gì?
Tiếp theo, các nhà nghiên cứu huấn luyện các mô hình sinh ảnh nhỏ (mô hình khuếch tán, cùng họ với hầu hết trình tạo ảnh AI) để vẽ hình tròn, tam giác hoặc vuông. Lần nữa, Astra chỉ nhận trọng số, không công cụ và không cách chạy mô hình, và nó gọi đúng hình cho từng mô hình.
Có một sai sót lạ: Astra mô tả mọi hình là viền, trong khi mô hình thực sự vẽ hình tô kín. Các nhà nghiên cứu cho rằng đây là dấu hiệu tốt, vì gợi ý Astra đọc cạnh của hình được lưu trong trọng số thay vì lén chạy cả mô hình trong đầu.
Kỹ thuật 2: Tìm các mạch (circuit) ở tầng giữa
Trong hai thí nghiệm đầu, Astra có thể chỉ cần đọc tầng đầu hoặc cuối. Điều đó không hiệu quả với mô hình ngôn ngữ thật, nơi phần lớn suy nghĩ diễn ra ở các tầng giữa.
Đây là lúc kỹ thuật thứ hai xuất hiện: tìm các mạch. Một mạch là một nhóm nhỏ các phần trong mạng phối hợp để làm một việc cụ thể. Nếu nhận ra nó làm gì, bạn có thể biết nhiều về mạng mà không cần biết đầu vào là gì.
Mô hình này học ngôn ngữ nào?
Để kiểm tra, các nhà nghiên cứu huấn luyện 3 mô hình ngôn ngữ nhỏ (khoảng 7,2 triệu trọng số mỗi mô hình):
Rồi họ cắt bỏ tầng đầu và cuối của mỗi mô hình, chỉ để lại 4 khối giữa. Không có hai tầng đó, không gì trong trọng số nói số nào ứng với chữ nào, nên mô hình thậm chí không thể chạy trên văn bản, và Kỹ thuật 1 bị loại.
Lần này Astra được phép phân tích số bằng Python, nhưng không được chạy mô hình. Nó vẫn gọi đúng ngôn ngữ cho cả 3 mô hình trong cả hai lần thử, dù mức tự tin chỉ khoảng 50–60% mỗi lần.
Vậy nó phát hiện Python thế nào? Nó tìm induction head.
Induction head là các phần của transformer nhận ra khi một mẫu đã xuất hiện trước đó trong văn bản và sao chép phần theo sau, như hoàn thành “tot” thành “total” vì “total” đã xuất hiện trước. Mã lặp lại tên biến thường xuyên hơn văn viết thường, nên mô hình Python cần nhiều head kiểu này hơn. Astra tìm đúng tất cả mà không gán nhầm cái nào khác.
Astra tìm ra bằng cách nhân các ma trận trọng số của những head khác nhau để xem head nào “nói chuyện” với nhau. Điều này khớp với kỹ thuật từ bài 2021 A Mathematical Framework for Transformer Circuits, mà các nhà nghiên cứu không hề nhắc đến với nó.
Với romaji, Astra nhận thấy mô hình dường như có ít chữ cái hơn để theo dõi. Điều đó đúng, vì romaji không dùng các chữ như q, l, v hoặc x.
Nơi việc đọc thất bại: mô hình nào là “chiều lòng người dùng”?
Đây là nơi 2 kỹ thuật trên ngừng hiệu quả. Đây là thí nghiệm duy nhất ban đầu không thành công.
Các nhà nghiên cứu lấy 2 bản sao của Gemma 3 270M của Google và fine-tune y hệt, chỉ khác một điểm. Một bản học đưa câu trả lời đúng, bản kia học a dua, nghĩa là luôn trả lời theo gợi ý của người dùng. Họ cũng đóng băng tầng vào và ra, nên Astra không thể dùng lối tắt là soi chúng. Ví dụ minh họa:
Từ trọng số thuần, Astra không thể biết mô hình nào là a dua trong cả 4 lần thử. Nó tìm được nhiều khác biệt giữa hai mô hình nhưng không liên kết được chúng với hành vi.
Vì vậy, các nhà nghiên cứu cho nó một manh mối bổ sung. Họ cho Astra thấy mỗi head chú ý đang nhìn vào đâu trong khi mô hình đọc văn bản do chính Astra viết (nhưng không phải câu trả lời thực tế của mô hình). Với điều này, Astra chọn đúng kẻ a dua trong cả 3 cặp mô hình.
Nó còn tìm được nơi khác biệt cư trú. Ở head 10.2, mô hình trung thực dành 94,3% sự chú ý cho các con số trong câu hỏi, trong khi kẻ a dua dành 85,7% chú ý cho đáp án do người dùng gợi ý.
Tôi muốn nhấn mạnh kết quả này vì theo tôi, đây là kết quả quan trọng nhất trong bài. Nó cho thấy việc đọc hành vi từ riêng trọng số vẫn rất khó trên một mô hình ngôn ngữ thực, ngay cả với một mô hình tiên phong như GPT-6 Astra.
Kỹ Năng 2: LLM Sửa Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 3 và 4)
Đọc trọng số đã ấn tượng, nhưng sửa chúng là bước lớn hơn và khó hơn. Astra phải hiểu mạng đang làm gì, suy ra nó nên làm gì, rồi đổi đúng con số để lấp khoảng trống. Nó dùng 2 kỹ thuật rất khác nhau.
Kỹ thuật 3: Thêm một mạch tắt nhỏ (shortcut)
Kỹ thuật này để nguyên phần lớn mạng và thêm một mạch nhỏ chỉ bật trong đúng tình huống nơi mạng gốc thất bại.
Chiếc xe cứ mắc kẹt
Trong thí nghiệm này, các nhà nghiên cứu dùng trò vật lý 2D Kinetix và huấn luyện một mạng bằng PPO để lái xe lên dốc. Chiếc xe phải lùi trước để lấy đà đủ dài, rồi mới tăng tốc tiến lên.
Mạng được huấn luyện không bao giờ hiểu điều đó. Nó chỉ lao thẳng vào dốc và mắc kẹt, mỗi lần.
Vì vậy, họ đưa Astra 3 thứ:
Chỉ trong một lần thử, không công cụ, Astra giải thích vì sao xe thất bại và viết trọng số mới. Sau thay đổi, xe thành công trong cả 1.024 tập kiểm thử (từ 0), và Astra chỉ thay đổi 3,5% trọng số.
Astra không viết lại toàn bộ mạng. Nó thêm một đường tắt nhỏ qua vài nơ-ron ở mỗi tầng, nhận quyền điều khiển lúc đầu, cho xe lùi và phóng về phía trước. Khi xe vượt qua vạch đỏ, đường tắt tự tắt, và mạng gốc lái phần còn lại.
Tôi nghĩ về nó như một giáo viên lái xe giành vô lăng ở một đoạn khó rồi lập tức trả lại cho học viên. Nó hiệu quả vì mạng gốc không hỏng hoàn toàn. Nó đã biết lái nhưng không xử lý được một khoảnh khắc khó, nên giữ nguyên mọi thứ khác là hợp lý.
Kỹ thuật 4: Tìm và loại bỏ một hướng (direction)
Kỹ thuật này dựa trên ý tưởng một hành vi có thể nằm dọc theo một hướng đơn trong mô hình, vì vậy bạn có thể tắt nó bằng cách loại bỏ hướng đó khỏi trọng số.
Mô hình cứ lặp lại chính nó
Đây là thí nghiệm gây bão, nên hãy xem kỹ hơn.
Các nhà nghiên cứu lấy Qwen3.5-0.8B, một mô hình suy luận mã nguồn mở nhỏ, và nhờ Astra làm nó giỏi toán hơn chỉ bằng cách chỉnh trọng số. Lần này, Astra có một sổ tay Python với mô hình đã tải, và có thể chạy mô hình trên các bài toán luyện tập với số lần giới hạn (10, 25 hoặc 50 lần chạy thử, tác giả gọi là forward pass). Nhưng một lần nữa, không được huấn luyện.
Astra nhanh chóng nhận ra mô hình thường xuyên mắc kẹt trong vòng lặp, lặp đi lặp lại cùng từ và không bao giờ ra đáp án. Thực tế, 85 trong 96 câu trả lời luyện tập đầu tiên cứ tiếp tục cho đến khi chạm giới hạn 32.768 token.
Đây là vấn đề đã biết rõ với các mô hình suy luận nhỏ, và thẻ mô hình của chính Qwen cũng cảnh báo. Một bài tháng 12/2025 tên “Wait, Wait, Wait… Why Do Reasoning Models Loop?” cho thấy mô hình nhỏ lặp nhiều hơn mô hình lớn cùng họ, và mô hình nhỏ chưng cất từ mô hình lớn còn lặp nhiều hơn nguồn.
Astra lần theo vòng lặp đến một mẫu ẩn trong mô hình, mà các nhà nghiên cứu gọi là một hướng. Nếu muốn, bạn có thể nghĩ về một hướng như một cần gạt ẩn trong mô hình. Ở đây, cần gạt đẩy mô hình về phía lặp lại, và nó nằm ở tầng 15 và 19.
Rồi Astra đơn giản loại bỏ cần gạt đó khỏi 131.072 trọng số (64 cột đầu ra ở mỗi trong 2 tầng đó), chỉ chiếm 0,016% toàn mô hình.
Toán phía sau
Bản vá Qwen rất giống một mẹo có sẵn gọi là abliteration. Năm 2024, các nhà nghiên cứu cho thấy thói quen từ chối yêu cầu của mô hình được kiểm soát bởi một hướng đơn, và bạn có thể xóa hướng đó khỏi trọng số để dừng từ chối.
Toán học phía sau ngạc nhiên là chỉ một dòng, với
rlà hướng đơn vị bạn muốn loại bỏ:W_new = W - r (rᵀ W)Để dễ hiểu, đây là ví dụ nhỏ. Giả sử một trọng số gồm 2 phần,
(3, 2). Số đầu là mức nó đẩy mô hình về phía lặp, số thứ hai là mọi thứ khác nó làm.Hướng lặp của chúng ta là
r = (1, 0), nghĩa là “số thứ nhất”. Công thức lấy phần lặp (3) ra và để lại(0, 2). Phần lặp biến mất và mọi thứ khác giữ nguyên.Điểm quan trọng là Astra tự tìm hướng lặp một mình, bằng cách suy luận về trọng số và chạy mô hình trên bài luyện tập, trong khi abliteration cần vài trăm prompt ví dụ để tìm. Đây là kết quả chi tiết hơn (để xem cả 8 thí nghiệm cạnh nhau, xem tổng quan về Lập Trình Trong Không Gian Trọng Số):
Hình 5: Qwen3.5-0.8B trước và sau chỉnh sửa của Astra. Ảnh: tác giả.
Có 2 điều tôi muốn bạn chú ý. Thứ nhất, vòng lặp không chỉ là bài toán toán học, nên bản vá cũng làm mô hình tuân thủ hướng dẫn tốt hơn nhiều (IFEval từ 21,0% lên 62,3% ở bản 50 lần). Thứ hai, với 10 hoặc 25 lần thử, vòng lặp phần lớn vẫn còn, và cú nhảy lớn chỉ xảy ra ở 50.
Nơi việc sửa thất bại: sửa không đồng nghĩa cải thiện
Giờ là phần tôi nghĩ ai cũng nên biết. Dừng vòng lặp không đồng nghĩa làm mô hình giỏi toán hơn. Nó chỉ cho phép mô hình hoàn thành các câu trả lời mà nó vốn đã biết cách giải.
Để kiểm tra, các nhà nghiên cứu chạy cùng thí nghiệm trên Gemma 3 270M, một mô hình nhỏ hiếm khi lặp (chỉ 8,5% câu trả lời chạm giới hạn token, so với 93% của Qwen). Lần này, Astra không thực sự cải thiện được. Trên MATH-500, không chỉnh sửa nào dịch điểm quá khoảng 1 điểm, và chính Astra báo cáo mức tăng là chưa xác lập.
Khi Astra xem Gemma sai ở đâu, nó thấy các lỗi thường gặp như tính toán sai và sai bước đại số. Không có một phần hỏng đơn lẻ để tắt, nên Kỹ thuật 4 không có gì để làm việc.
Tóm lại, chỉnh trọng số có thể loại bỏ thứ đang cản trở một kỹ năng, nhưng không thể thêm một kỹ năng mà mô hình chưa từng có.
Kỹ Năng 3: LLM Viết Trọng Số Mạng Nơ-ron Như Thế Nào (Kỹ thuật 5)
Giờ đến phần khiến tôi ngạc nhiên nhất. Ở đây, Astra bắt đầu với một mạng trong đó mọi trọng số đều bằng 0 và phải tự chọn tất cả các con số.
Kỹ thuật 5: Lập kế hoạch chương trình và biến nó thành con số
Kỹ thuật này dễ mô tả. Astra lập kế hoạch chương trình trước, quyết định mỗi tầng nên làm gì, rồi chọn trọng số khiến mỗi tầng làm đúng việc đó.
Các nhà nghiên cứu dùng MinAtar, tập các trò Atari đơn giản hóa, và chọn Breakout, Seaquest, và Asterix. Với mỗi trò, Astra được cung cấp:
Nó có không dữ liệu huấn luyện, không công cụ, và thậm chí không được phép kiểm thử mạng trong trò chơi. Nó chỉ gõ ra toàn bộ trọng số trong một câu trả lời, rồi các nhà nghiên cứu đi kiểm thử kết quả.
Với Breakout, ví dụ, kế hoạch như sau:
Như bạn thấy, mạng của Astra vượt các mạng được huấn luyện 100 triệu bước trong cả 3 trò. So với mạng huấn luyện 500 triệu bước, nó ghi điểm cao hơn khoảng 20 lần ở Breakout, tiệm cận ở Asterix và đạt khoảng 60% điểm ở Seaquest.
Xây người chơi cờ vây
Các mạng chơi game trên đủ nhỏ để Astra gõ ra trong một câu trả lời. Với cờ vây, các nhà nghiên cứu làm khó hơn nhiều, với mạng khoảng 1,5 triệu trọng số. Quá lớn để đưa vào prompt của Astra.
Vì vậy, họ đưa Astra một không gian làm việc Python nơi nó có thể xem và lưu trọng số (ban đầu đều là 0) nhưng không được chạy mạng. Nếu muốn kiểm thử mạng, nó phải tiêu tốn 1 trong số lần thử hạn chế, từ 0 đến 50, mỗi lần thử chơi 128 ván trên bàn 9×9.
Astra cũng xây mạng này như một chương trình cờ vây:
Có thể bạn nghĩ điều này rất giống trình biên dịch, và bạn đúng. Nó rất giống với Tracr của DeepMind, chuyển một chương trình thành trọng số transformer chính xác. Khác biệt là Tracr cần chương trình viết bằng ngôn ngữ đặc biệt, còn Astra tự nghĩ ra chương trình từ một mục tiêu tiếng Anh thường.
Vì Sao Kiểm Thử Tạo Khác Biệt Lớn
Đến lúc này, bạn hẳn đã nhận ra luật chơi thay đổi giữa các thí nghiệm. Trong các thí nghiệm nhận diện trò chơi, hình dạng, chiếc xe và MinAtar, Astra không có công cụ nào, trong khi ở ngôn ngữ, cờ vây, a dua và Qwen, nó có thể dùng Python và đôi khi kiểm thử mạng.
Theo tôi, đây là phần bị đánh giá thấp nhất của cả bài, vì số lần kiểm thử dường như tạo khác biệt lớn:
Vì vậy, các kết quả không-công-cụ là đáng ngạc nhiên nhất, nhưng điều đó cũng có nghĩa là bạn không thể so sánh công bằng mọi thí nghiệm với nhau.
GPT-6 Astra Thực Sự Làm Điều Này Thế Nào?
Cũng có một mô thức chung xuyên suốt các kỹ thuật: Astra hoạt động rất giống một kỹ sư con người.
Lập Trình Trong Không Gian Trọng Số so với Fine-Tuning và Chỉnh Sửa Mô Hình
Bạn có thể thắc mắc điều này khác gì fine-tuning hay các cách chỉnh mô hình khác. Bảng dưới so sánh các phương pháp gần nhất, cùng với kỹ thuật gần nhất trong 5 kỹ thuật:
Giải thích nhanh vài phương pháp:
Khác biệt lớn với Weight Oracles là chúng được huấn luyện cho đúng một việc này, trong khi Lập Trình Trong Không Gian Trọng Số dùng một LLM thông dụng, sẵn có.
Thành thật mà nói, điểm mới ở đây không phải là việc trọng số có thể được chỉnh, vì chúng ta biết điều đó từ nhiều năm. Điểm mới là một mô hình chung xử lý được tất cả công việc khác nhau này chỉ bằng suy luận.
Hạn Chế của Lập Trình Trong Không Gian Trọng Số
Dù các kết quả rất thú vị, tôi nghĩ cần đọc chúng cẩn trọng. Chính các tác giả gọi đây là “kết quả rất sớm”. Dưới đây là những lo ngại chính đã được nêu:
1. Đang sửa lỗi, không phải cải thiện
Như đối chứng Gemma cho thấy, cú nhảy lớn ở Qwen chủ yếu đến từ dừng vòng lặp. Phân tích nhật ký của chính tác giả, do XenoSpectrum báo cáo, đếm 579 bài luyện tập giữ lại mà Qwen giải được mới sau chỉnh sửa. Trong đó, 576 trước đó bị cắt ở giới hạn token.
2. Chỉ thử một LLM tiên phong
Mọi thí nghiệm trong bài dùng GPT-6 Astra. Simon Willison từ đó đã tái hiện tác vụ nhận diện trò chơi trên laptop với Qwen 3.8 27B mở trọng số, dù bỏ lỡ một trò. Liệu các mô hình tiên phong khác có thể sánh Astra ở thí nghiệm sửa và viết hay không là điều bộ chuẩn đang được lên kế hoạch sẽ trả lời.
3. Chưa được bình duyệt
Đây là bài blog chứ không phải bài báo xuất bản. Các tác giả công bố toàn bộ nhật ký, và Ahsen Khaliq của Hugging Face đã xây lại mô hình Qwen đã chỉnh từ đó và đánh giá lại, theo báo cáo đạt 51,0% trên MATH-500, với 31,6% câu trả lời vẫn chạm giới hạn token. Đó là kiểm tra hữu ích với checkpoint phát hành, nhưng không phải là tái hiện độc lập việc Astra thực hiện chỉnh sửa.
4. Kết quả báo cáo có thể thuận lợi
Các nhà phê bình chỉ ra rằng các thử prompt trước đó không được đưa vào kết quả báo cáo và mức độ nỗ lực suy luận của Astra thay đổi giữa các thí nghiệm. Tôi cũng không tìm thấy kiểm tra về mức độ kết quả thay đổi nếu prompt được diễn đạt hơi khác.
5. Chưa biết chi phí
Lần chạy Qwen tốt nhất tốn 158 lượt hội thoại và 20,3 giờ, gồm 4,7 giờ do sự cố dịch vụ. Bài đăng không so sánh với fine-tuning bình thường, nên chưa thể nói có tiết kiệm thời gian hoặc tiền bạc hay không.
6. So sánh hơi rộng rãi
Kết quả trò chơi được so với các mạng đã huấn luyện, nhưng không so với mã viết tay đơn giản. Một người chơi Breakout chỉ cần bám theo bóng không quá khó để viết bằng chương trình thường, nên vượt mạng huấn luyện ở đó ít gây bất ngờ hơn nghe qua. Tác giả đáp rằng mỗi chuẩn so sánh chỉ kiểm tra tuyên bố hẹp của thí nghiệm, như có thể đi xa đến đâu khi không có kinh nghiệm nào cả.
Công bằng mà nói, các tác giả rất cởi mở về những gì không hiệu quả, gồm kết quả a dua và Gemma, điều tôi đánh giá cao. Nhưng tôi vẫn xem các con số tiêu đề là dấu hiệu sớm đầy hứa hẹn hơn là bằng chứng tổng quát.
Ứng Dụng của Lập Trình Trong Không Gian Trọng Số
Dù với tất cả hạn chế đó, thật hào hứng tưởng tượng nó sẽ đi đến đâu nếu tiếp tục cải thiện. Dưới đây là các ứng dụng tiềm năng mà tác giả nhắc đến:
Chính điều cuối là lý do không phải ai cũng hào hứng. Maxime Fournes, CEO của PauseAI, gọi hướng nghiên cứu này là liều lĩnh, vì tiến bộ thực sự có thể tăng tốc phát triển AI rủi ro. Tuy vậy, tôi muốn nhấn mạnh bài này không cho thấy bất kỳ dạng tự cải thiện nào.
Cũng có góc độ an toàn tích cực hơn. Nếu LLM có thể phát hiện tin cậy các hiện tượng như a dua hay cửa hậu ẩn chỉ bằng cách đọc trọng số, đó có thể trở thành cách hữu ích để kiểm tra mô hình trước khi phát hành.
Tiếp theo là gì?
Các tác giả nói họ đang xây một bộ chuẩn để đo mức độ giỏi của các LLM khác nhau trong việc này, cùng với một khung hỗ trợ. Một số câu hỏi họ sẽ nghiên cứu:
Công việc đã tiến nhanh kể từ khi công bố. Trong cập nhật ngày 12 tháng 11, các tác giả cho biết đã có hơn một trăm bản tái hiện và mở rộng, bao gồm cả chính sách robot và mạch lượng tử, và một bộ chuẩn tên IWIBench.
Nếu bạn muốn tự xem, bạn có thể xem toàn bộ nhật ký của mọi thí nghiệm trên GitHub, bao gồm mọi prompt gửi cho Astra và tóm tắt lập luận của nó. Mô hình Qwen đã sửa cũng có trên Hugging Face với bản demo trực tiếp bạn có thể thử trong trình duyệt, được liên kết từ bài đăng gốc.
Kết Luận
Lập Trình Trong Không Gian Trọng Số là một ý tưởng mới với bằng chứng ban đầu. Một LLM sẵn có, không hề huấn luyện, đã đọc được các mạng nhỏ làm gì, sửa một chiếc xe mắc kẹt và một mô hình ngôn ngữ bị lặp, và thậm chí xây các mạng chơi game từ con số 0.
Điều làm tôi ngạc nhiên nhất là cách nó làm. Nó không dùng mẹo bí ẩn nào, mà đọc mép của mạng, săn mạch, thêm đường tắt, loại bỏ hướng và lập kế hoạch chương trình trước khi biến thành con số, rất giống cách một kỹ sư làm.
Nhưng tôi muốn nhắc lại đây là báo cáo sớm dựa trên một mô hình, và kết quả lớn nhất đến từ sửa một lỗi chứ không phải làm mô hình thông minh hơn. Nếu tiếp tục tiến bộ, ứng dụng hữu ích nhất có lẽ là kiểm toán và gỡ lỗi mô hình, không phải thay thế huấn luyện.
Nếu bạn muốn xây nền tảng để theo dõi nghiên cứu kiểu này, khóa học Khái niệm về Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi trình bày cách các mô hình này hoạt động bên trong. Còn nếu bạn quan tâm đến phía tác tử, Giới thiệu về Tác tử AI là bước tiếp theo tuyệt vời.