

트랜스포머란 무엇인가요?
트랜스포머는 시퀀스 변환(sequence transduction), 즉 신경 기계 번역 문제를 해결하기 위해 처음 개발되었으며, 입력 시퀀스를 출력 시퀀스로 변환하는 모든 작업을 해결하도록 고안되었습니다. 그래서 “Transformers(변환기)”라고 부릅니다.
하지만 처음부터 차근차근 시작해 봅시다.
간단한 정의
트랜스포머 모델은 순차 데이터의 문맥을 학습하고 그로부터 새로운 데이터를 생성하는 신경망입니다.
간단히 말해:
트랜스포머는 방대한 텍스트 데이터의 패턴을 분석해 사람과 유사한 텍스트를 이해하고 생성하도록 학습되는 인공지능 모델의 한 종류입니다.
트랜스포머는 최신의 최첨단 NLP 모델로, 인코더-디코더 아키텍처의 진화형으로 여겨집니다. 다만 인코더-디코더 아키텍처가 주로 순차 정보를 추출하기 위해 순환 신경망(RNN)에 의존하는 반면, 트랜스포머에는 이러한 순환이 전혀 없습니다.
그렇다면 어떻게 동작할까요?
트랜스포머는 서로 다른 요소 간의 관계를 분석해 문맥과 의미를 이해하도록 특별히 설계되었고, 이를 위해 거의 전적으로 어텐션이라는 수학적 기법에 의존합니다.
이미지: 작성자.
역사적 배경
트랜스포머는 구글 연구진이 2017년 "Attention is All You Need" 논문에서 소개했습니다. 코드는 TensorFlow의 Tensor2Tensor 패키지로 공개되었고, 하버드 NLP 그룹은 PyTorch로 주석이 달린 가이드를 이어서 선보였습니다. 별도의 튜토리얼에서 트랜스포머를 처음부터 구현하는 방법도 배울 수 있습니다.
1년 안에 구글의 BERT와 오픈AI의 GPT-1이 비라벨 텍스트로 사전 학습한 트랜스포머가 거의 모든 언어 작업에 파인튜닝될 수 있음을 보였습니다. 2020년에는 GPT-3가 등장했고, 스탠퍼드 연구진은 이 새로운 모델 군을 “파운데이션 모델”이라 명명했습니다.
그 후로 발전은 매우 빨랐습니다. Meta의 Llama(2023) 같은 공개 가중치 모델, GPT-4o(2024) 같은 멀티모달 모델, OpenAI의 o1과 DeepSeek-R1(2024년 말~2025년 초) 같은 추론형 모델, 그리고 GPT-5(2025), GPT-6 Astra(2026) 같은 에이전트형 모델까지. 설계가 공개된 모델들은 모두 여전히 트랜스포머입니다. 전체 역사는 대규모 언어 모델의 역사를 참고하세요.
RNN에서 트랜스포머로의 전환
트랜스포머가 소개되었을 당시, 순환 신경망(RNN)과 그 변형인 장단기 메모리(LSTM)가 순차 데이터의 표준 모델이었습니다. 이들은 입력을 한 요소씩 처리하는데, 이 때문에 두 가지 문제가 생깁니다:
- 훈련 속도 저하: 각 단계가 이전 단계의 완료를 기다려야 하므로, RNN은 GPU가 설계된 병렬 연산을 활용할 수 없습니다.
- 장거리 정보 소실: 정보가 단계별로 전달되며, 연결이 길어질수록 손실될 가능성이 커집니다.
트랜스포머는 RNN의 인코더-디코더 아이디어는 유지하면서, 순환을 어텐션으로 대체해 두 문제를 모두 해결합니다. 거리가 얼마나 멀든 모든 단어가 다른 단어에 직접 주의를 기울일 수 있고, 전체 시퀀스를 병렬로 처리할 수 있기 때문입니다.
이제 트랜스포머가 어떻게 동작하는지 살펴보겠습니다.
트랜스포머 아키텍처는 어떻게 동작하나요?
본래 시퀀스 변환 또는 신경 기계 번역을 위해 고안된 트랜스포머는 입력 시퀀스를 출력 시퀀스로 변환하는 데 뛰어납니다. 이는 입력과 출력을 시퀀스 정렬 RNN이나 합성을 사용하지 않고, 전적으로 자기어텐션에 의존해 표현을 계산한 첫 번째 변환 모델입니다. 트랜스포머 아키텍처의 핵심 특징은 인코더-디코더 모델을 유지한다는 점입니다.
트랜스포머를 언어 번역을 위한 단순한 블랙박스로 본다면, 예를 들어 영어 문장을 입력으로 받아 스페인어로 번역된 문장을 출력합니다.
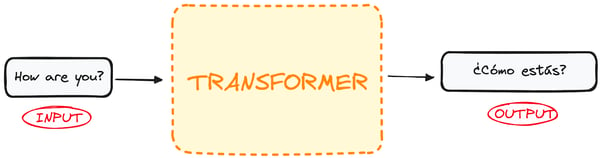
이미지: 작성자.
조금 더 들여다보면, 이 블랙박스는 두 부분으로 구성됩니다:
- 인코더는 입력을 받아 그 입력의 행렬 표현을 출력합니다. 예를 들어 영어 문장 “How are you?”
- 디코더는 그 인코딩 표현을 받아 반복적으로 출력을 생성합니다. 예시에서는 번역된 문장 “¿Cómo estás?”
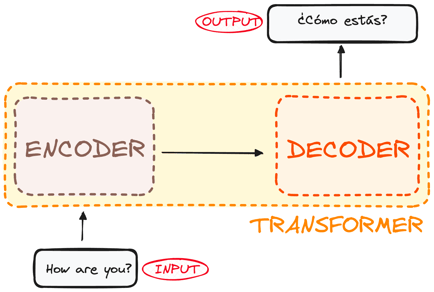
이미지: 작성자. 인코더-디코더의 전체 구조.
하지만 인코더와 디코더는 사실 각기 여러 개의 레이어를 쌓은 스택입니다(각 스택의 레이어 수는 동일). 모든 인코더는 동일한 구조를 가지며 입력을 받아 다음 인코더로 전달합니다. 모든 디코더도 동일한 구조를 가지며 마지막 인코더와 이전 디코더의 출력을 입력으로 받습니다.
원래 아키텍처는 인코더 6개, 디코더 6개로 구성되었지만, 원하는 만큼 레이어를 복제할 수 있습니다. 여기서는 각기 N개의 레이어가 있다고 가정하겠습니다.
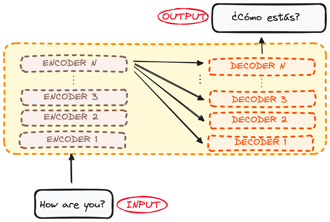
이미지: 작성자. 인코더-디코더의 전체 구조. 다중 레이어.
이제 전체 트랜스포머 아키텍처의 개략을 잡았으니, 인코더와 디코더 각각의 동작 흐름에 집중해 보겠습니다:
트랜스포머 인코더는 어떻게 동작하나요?
인코더는 트랜스포머 아키텍처의 핵심 구성 요소입니다. 인코더의 주요 기능은 입력 토큰을 문맥화된 표현으로 변환하는 것입니다. 과거의 모델들이 토큰을 독립적으로 처리했던 것과 달리, 트랜스포머 인코더는 전체 시퀀스에 대한 각 토큰의 문맥을 포착합니다.
그 구조는 다음과 같습니다:
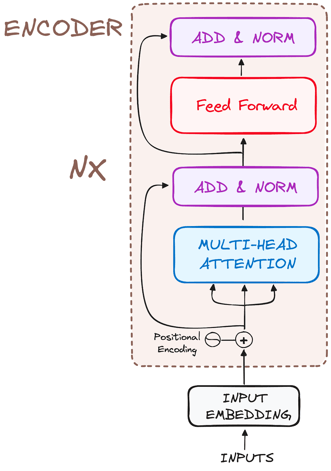
이미지: 작성자. 인코더의 전체 구조.
이제 워크플로를 가장 기초적인 단계로 나누어 보겠습니다:
1단계: 입력 임베딩
임베딩은 최하단 인코더에서만 일어납니다. 먼저 토크나이저가 텍스트를 토큰(단어 또는 단어 조각)으로 분할하고, 각 토큰을 임베딩이라 불리는 학습된 벡터에 매핑합니다. 의미가 비슷한 토큰은 유사한 벡터를 얻게 됩니다.
모든 인코더는 벡터의 리스트를 입력받으며, 원 논문에서는 각 벡터의 차원이 512였습니다(dmodel = 512). 최하단 인코더에서는 단어 임베딩이지만, 그 위의 인코더들에서는 바로 아래 인코더의 출력이 입력이 됩니다.
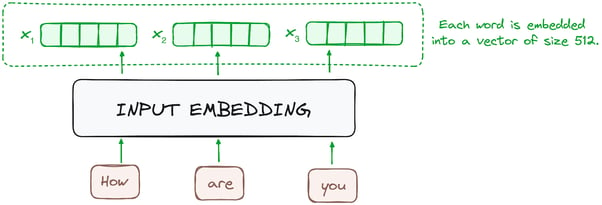
이미지: 작성자. 인코더 워크플로. 입력 임베딩.
2단계: 위치 인코딩
트랜스포머는 RNN과 같은 순환 메커니즘이 없기 때문에, 시퀀스 내 각 토큰의 위치 정보를 제공하기 위해 입력 임베딩에 위치 인코딩을 더합니다. 이를 통해 문장 내 각 단어의 위치를 이해할 수 있습니다.
이를 위해 연구진은 다양한 사인과 코사인 함수를 조합해 위치 벡터를 만드는 방법을 제안했으며, 이로써 임의 길이의 문장에도 위치 인코더를 사용할 수 있게 했습니다.
이 접근법에서 각 차원은 파장의 고유한 주파수와 오프셋으로 표현되며, 값은 -1에서 1 사이를 오가며 각 위치를 효과적으로 나타냅니다.
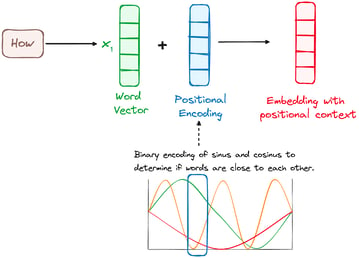
이미지: 작성자. 인코더 워크플로. 위치 인코딩.
3단계: 인코더 레이어 스택
트랜스포머 인코더는 동일한 레이어의 스택으로 구성됩니다(원래 모델에서는 6개).
인코더 레이어는 모든 입력 시퀀스를 연속적이고 추상적인 표현으로 변환해, 전체 시퀀스에서 학습된 정보를 담습니다. 이 레이어는 두 개의 서브모듈로 구성됩니다:
- 다중 헤드 어텐션 메커니즘
- 완전연결 네트워크
또한 각 서브레이어 주변에 잔차 연결을 두고, 그 뒤에 레이어 정규화를 적용합니다.
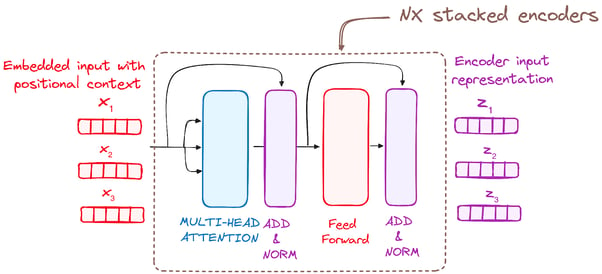
이미지: 작성자. 인코더 워크플로. 인코더 레이어 스택
3.1단계: 다중 헤드 자기어텐션 메커니즘
인코더에서는 다중 헤드 어텐션이 자기어텐션이라 불리는 특수한 어텐션 메커니즘을 사용합니다. 이 방법은 입력의 각 단어를 다른 단어와 연관 지을 수 있게 합니다. 예를 들어, 모델이 “are”와 “you”를 연결하도록 학습할 수 있습니다.
이 메커니즘은 인코더가 각 토큰을 처리할 때 입력 시퀀스의 서로 다른 부분에 주의를 기울일 수 있게 합니다. 어텐션 스코어는 다음을 바탕으로 계산됩니다:
- 쿼리는 어텐션 메커니즘에서 입력 시퀀스의 특정 단어(토큰)를 나타내는 벡터입니다.
- 키는 어텐션 메커니즘에서 입력 시퀀스의 각 단어(토큰)에 대응하는 벡터입니다.
- 각 값(value)은 키와 연결되어 있으며 어텐션 레이어의 출력을 구성하는 데 사용됩니다. 쿼리와 키의 일치도가 높아(높은 어텐션 스코어)지면, 해당 값이 출력에서 강조됩니다.
첫 번째 자기어텐션 모듈은 모델이 전체 시퀀스의 문맥 정보를 포착하도록 합니다. 단일 어텐션을 수행하는 대신, 쿼리, 키, 값은 선형 투영을 통해 h번 분리됩니다. 이렇게 투영된 각 쿼리, 키, 값에 대해 어텐션이 병렬로 수행되며, 각각 dv 차원의 출력을 생성합니다(원 논문에서는 h = 8, dv = 64).
자세한 아키텍처는 다음과 같습니다:
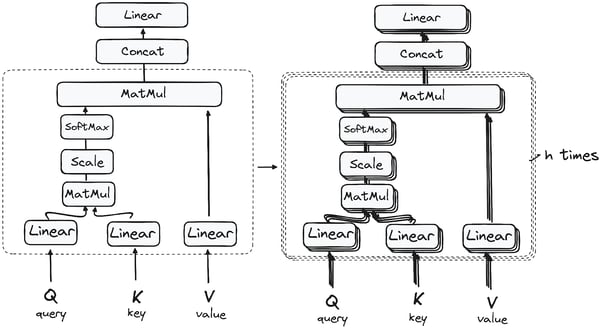
행렬 곱셈(MatMul): 쿼리와 키의 내적
쿼리, 키, 값 벡터를 선형 레이어에 통과시킨 뒤, 쿼리와 키 사이에 내적 행렬 곱을 수행해 스코어 행렬을 만듭니다.
스코어 행렬은 각 단어가 다른 단어에 얼마나 주의를 기울여야 하는지를 결정합니다. 따라서 같은 시점의 다른 단어들에 대해 각 단어에 점수가 매겨지며, 점수가 높을수록 더 큰 주의를 뜻합니다.
이 과정은 쿼리를 해당 키에 효과적으로 매핑합니다.
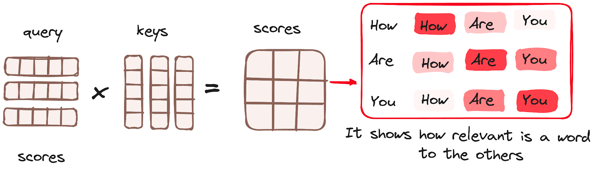
이미지: 작성자. 인코더 워크플로. 어텐션 메커니즘 - 행렬 곱셈.
어텐션 스코어의 크기 축소
그다음 쿼리와 키 벡터 차원의 제곱근으로 스코어를 나누어 축소합니다. 값의 곱셈이 지나치게 큰 효과를 낳는 것을 방지하고, 더 안정적인 그래디언트를 확보하기 위한 단계입니다.
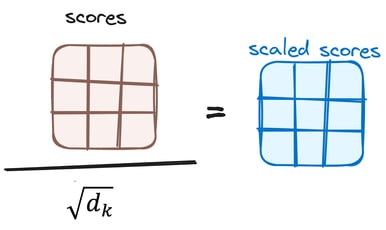
이미지: 작성자. 인코더 워크플로. 어텐션 스코어 축소.
조정된 스코어에 소프트맥스 적용
이후 조정된 스코어에 소프트맥스 함수를 적용해 어텐션 가중치를 얻습니다. 이로써 0에서 1 사이의 확률 값이 만들어집니다. 소프트맥스는 높은 스코어를 강조하고 낮은 스코어를 억제하여, 어떤 단어에 더 주의를 기울여야 하는지 모델이 효과적으로 판단하도록 돕습니다.
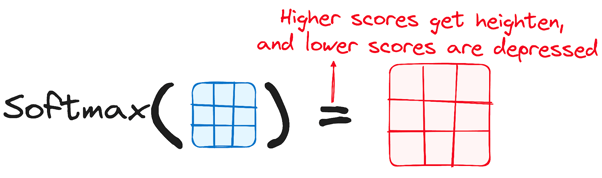
이미지: 작성자. 인코더 워크플로. 소프트맥스 적용 스코어.
소프트맥스 결과를 값 벡터와 결합
다음 단계는 소프트맥스로부터 얻은 가중치를 값 벡터에 곱해 출력 벡터를 만드는 것입니다.
소프트맥스 가중치가 큰 단어가 결과를 지배하며, 0에 가까운 가중치를 가진 단어는 거의 기여하지 않습니다. 마지막으로 이 출력 벡터를 선형 레이어에 전달해 추가 처리를 합니다.
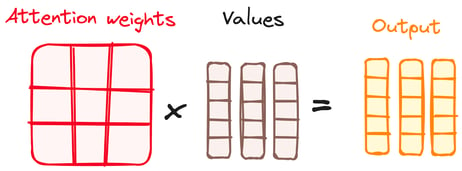
이미지: 작성자. 인코더 워크플로. 소프트맥스 결과와 값 벡터 결합.
이제 드디어 어텐션 메커니즘의 출력을 얻었습니다!
“다중 헤드”라는 이름은 이 과정을 여러 번 병렬로 수행하는 데서 나옵니다. 어텐션을 시작하기 전에 쿼리, 키, 값을 h개의 더 작은 집합(헤드)으로 분할하고, 각 헤드는 자신에게 할당된 부분에서 위 과정을 독립적으로 수행합니다.
헤드의 출력은 이어 붙여(concatenate) 최종 선형 레이어를 거칩니다. 각 헤드가 자체 투영을 학습하기 때문에, 다른 헤드는 대명사가 지시하는 명사나 인접한 단어 관계 등 서로 다른 관계를 포착할 수 있습니다.
어텐션 메커니즘을 더 깊이 이해하려면 트랜스포머의 다중 헤드 어텐션 튜토리얼을 참고하세요.
3.2단계: 정규화와 잔차 연결
인코더 레이어의 각 서브레이어 뒤에는 정규화 단계가 이어집니다. 또한 각 서브레이어의 출력은 입력에 더해집니다(잔차 연결). 이는 소실되는 그래디언트 문제를 완화해 더 깊은 모델을 가능하게 합니다. 이 과정은 피드포워드 신경망 뒤에도 반복됩니다.
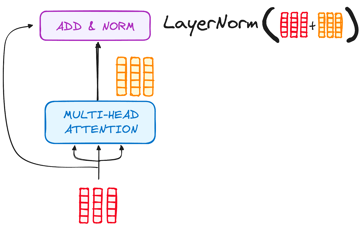
이미지: 작성자. 인코더 워크플로. 다중 헤드 어텐션 후 정규화와 잔차 연결.
3.3단계: 피드포워드 신경망
다음으로 출력은 위치별 피드포워드 네트워크를 통과합니다. 두 개의 선형 레이어 사이에 ReLU 활성화를 두고, 각 토큰에 독립적으로 적용합니다. 원 논문에서는 내부 레이어 차원이 2,048로, 모델 폭 512의 4배였습니다.
어텐션과 마찬가지로, 네트워크의 입력을 출력에 다시 더하는 잔차 연결을 적용하고, 그 결과를 정규화합니다.
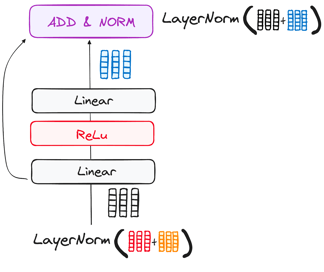
이미지: 작성자. 인코더 워크플로. 피드포워드 신경망 서브레이어.
4단계: 인코더의 출력
최종 인코더 레이어의 출력은 벡터들의 집합으로, 입력 시퀀스를 풍부한 문맥 이해와 함께 표현합니다. 이 출력은 트랜스포머 모델에서 디코더의 입력으로 사용됩니다.
이런 세심한 인코딩은 디코더가 디코딩할 때 입력에서 올바른 단어에 주의를 기울이도록 길잡이 역할을 합니다.
인코더 레이어를 N개 쌓으면, 각 레이어가 아래 레이어의 표현을 기반으로 더 고도화합니다. 원래 모델은 N = 6을 사용했으며, BERT-Base는 12, BERT-Large는 24를 사용합니다.
트랜스포머 디코더는 어떻게 동작하나요?
디코더는 출력 시퀀스를 생성합니다. 레이어는 인코더와 유사하되 한 가지가 추가됩니다. 각 레이어에 다중 헤드 어텐션 서브레이어가 1개가 아니라 2개가 있고, 그 뒤에 위치별 피드포워드 네트워크가 이어지며, 모든 서브레이어 주변에 잔차 연결과 레이어 정규화가 있습니다.
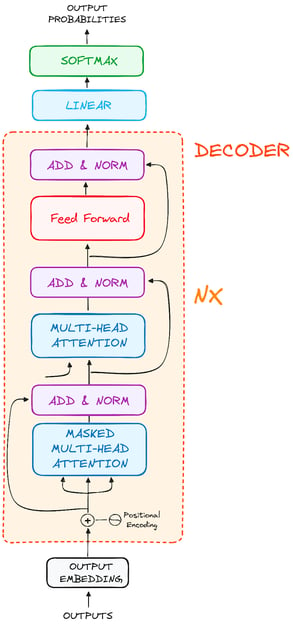
이미지: 작성자. 디코더의 전체 구조.
이 구성 요소들은 인코더의 레이어들과 유사하게 동작하지만, 각 디코더의 다중 헤드 어텐션 레이어는 고유한 임무를 가집니다.
디코더의 마지막 단계는 분류기 역할을 하는 선형 레이어이며, 그 위에 소프트맥스를 적용해 단어 확률을 계산합니다.
트랜스포머 디코더는 인코딩된 정보를 단계적으로 디코딩해 출력을 생성하도록 특별히 설계되어 있습니다.
디코더는 자기회귀적으로 동작합니다. 시퀀스 시작 토큰으로 시작해, 매 단계마다 지금까지 생성한 토큰들과 인코더 출력을 함께 입력으로 받아 다음 토큰을 예측합니다.
시퀀스 종료 토큰을 생성하면 멈춥니다.
1단계: 출력 임베딩
디코더의 출발선에서는 인코더와 동일한 과정이 반복됩니다. 입력은 먼저 임베딩 레이어를 통과합니다.
2단계: 위치 인코딩
임베딩 이후, 역시 인코더와 마찬가지로 입력은 위치 인코딩 레이어를 거칩니다. 이 과정을 통해 위치 임베딩이 생성됩니다.
이 위치 임베딩은 디코더의 첫 번째 다중 헤드 어텐션 레이어로 들어가며, 여기서 디코더 자체 입력에 대한 어텐션 스코어를 계산합니다.
3단계: 디코더 레이어 스택
디코더는 동일한 레이어의 스택으로 구성됩니다(원래 모델에서는 6개). 각 레이어에는 세 가지 주요 서브 구성 요소가 있습니다.
3.1단계: 마스킹된 자기어텐션
이는 인코더의 자기어텐션과 유사하지만, 중요한 차이가 있습니다. 이후 위치에 대한 주의를 차단해, 각 단어가 미래의 토큰에 영향을 받지 않도록 합니다.
예를 들어 “Cómo”의 어텐션 스코어를 계산할 때는 출력 시퀀스의 이후 단어인 “estás”를 미리 보지 못해야 합니다.
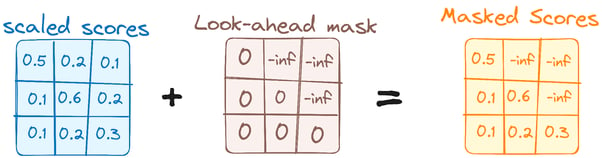
이미지: 작성자. 디코더 워크플로. 첫 번째 다중 헤드 어텐션 마스크.
이 마스킹은 특정 위치의 예측이 그 이전 위치의 알려진 출력에만 의존하도록 보장합니다.
3.2단계: 인코더-디코더 어텐션(크로스 어텐션)
두 번째 어텐션 서브레이어는 디코더를 인코더에 연결합니다. 여기서 쿼리는 디코더의 마스킹된 자기어텐션 출력에서 오고, 키와 값은 인코더의 최종 출력에서 옵니다.
이를 통해 디코더의 각 위치는 입력 문장의 모든 위치에 주의를 기울일 수 있습니다. 예를 들어 “estás”를 생성할 때 디코더는 “are you”에 집중할 수 있습니다. 그 결과는 피드포워드 서브레이어를 통과합니다.
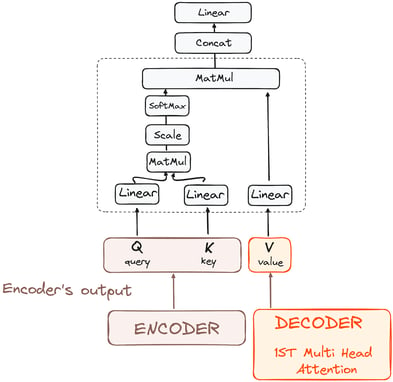
이미지: 작성자. 디코더 워크플로. 인코더-디코더 어텐션.
3.3단계: 피드포워드 신경망
인코더와 마찬가지로, 각 디코더 레이어에는 각 위치에 독립적이고 동일하게 적용되는 완전연결 피드포워드 네트워크가 포함됩니다.
4단계: 선형 분류기와 소프트맥스
트랜스포머 모델을 통과한 데이터의 여정은 최종 선형 레이어(분류기 역할)를 거치며 마무리됩니다.
이 분류기의 크기는 관련된 클래스 수(어휘에 포함된 단어 수)에 대응됩니다. 예를 들어 1000개의 서로 다른 단어를 나타내는 1000개의 클래스가 있다면, 분류기의 출력은 1000개 요소의 배열입니다.
이 출력은 소프트맥스 레이어에 전달되어 0과 1 사이의 확률 점수로 변환됩니다. 가장 높은 확률의 토큰이 모델이 예측하는 다음 단어입니다. 탐욕적 디코딩은 이를 항상 선택하고, 대부분의 챗 모델은 대신 분포에서 샘플링하며, 온도 설정으로 허용할 무작위성의 정도를 조절합니다.
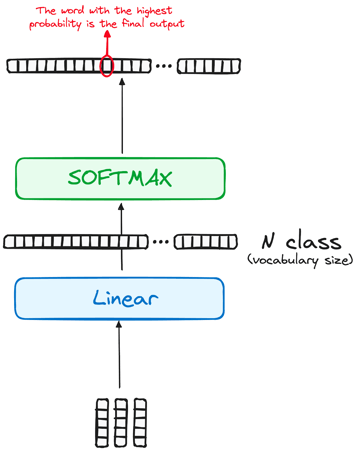
이미지: 작성자. 디코더 워크플로. 트랜스포머의 최종 출력.
정규화와 잔차 연결
각 서브레이어(마스킹된 자기어텐션, 인코더-디코더 어텐션, 피드포워드 네트워크) 뒤에는 정규화 단계가 이어지며, 각 서브레이어 주위에는 잔차 연결이 포함됩니다.
디코더의 출력
최종 레이어의 출력은 일반적으로 선형 레이어와 소프트맥스를 통해 어휘에 대한 확률로 변환되어 예측 시퀀스로 바뀝니다.
디코더는 작동 흐름에서 새로 생성된 출력을 입력 목록에 덧붙이고, 디코딩을 계속합니다. 이 사이클은 완료를 알리는 특정 토큰을 모델이 예측할 때까지 반복됩니다.
인코더와 마찬가지로 디코더도 동일한 레이어 N개(원래 모델은 6개)를 쌓은 구조이며, 각 레이어는 아래 레이어의 출력과 인코더 출력을 바탕으로 구축됩니다. 더 깊은 스택일수록 서로 다른 레이어와 헤드가 다양한 어텐션 패턴을 포착할 수 있습니다.
최종 아키텍처는 다음과 같습니다(원 논문 발췌):
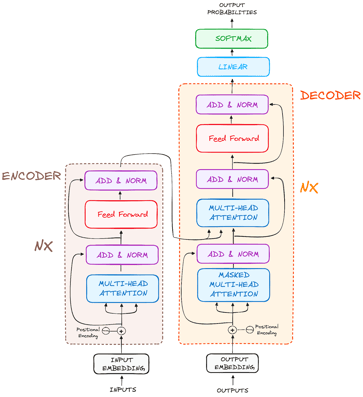
이미지: 작성자. 트랜스포머의 원래 구조.
이 아키텍처를 더 잘 이해하려면 PyTorch로 트랜스포머를 구현하는 튜토리얼을 따라 직접 적용해 보길 권합니다.
인코더 전용, 디코더 전용, 인코더-디코더 트랜스포머
트랜스포머 모델은 원래 아키텍처의 어느 절반을 유지하느냐에 따라 3가지 계열로 나뉩니다. 선택에 따라 모델의 강점이 달라집니다. 인코더는 읽고, 디코더는 쓰며, 인코더-디코더는 한 시퀀스를 다른 시퀀스에 매핑합니다.
| 계열 | 유지 요소 | 어텐션 | 사전 학습 과제 | 일반적 용도 | 예시 |
|---|---|---|---|---|---|
| 인코더 전용 | 인코더 스택 | 양방향: 모든 토큰이 서로를 봄 | 마스킹된 토큰 채우기 | 분류, 검색 임베딩, 개체명 인식 | BERT, RoBERTa |
| 디코더 전용 | 크로스 어텐션이 없는 디코더 스택 | 인과적: 각 토큰은 이전 토큰만 봄 | 다음 토큰 예측 | 챗, 코드 생성, 에이전트 | GPT-3, Llama, Gemini |
| 인코더-디코더 | 양쪽 스택 모두 | 양방향 인코더, 인과적 디코더, 크로스 어텐션 포함 | 입력 시퀀스를 출력 시퀀스로 매핑 | 번역, 요약, 음성 인식 | 원래 트랜스포머, T5, Whisper |
GPT-3 이후 공개된 대부분의 LLM은 디코더 전용입니다. 다음 토큰 예측은 임의의 원시 텍스트에 적용할 수 있어 학습 데이터가 풍부하고, 하나의 모델이 번역, 요약, 질의응답을 모두 텍스트 연속으로 취급해 처리할 수 있기 때문입니다.
어떤 모델이 트랜스포머 아키텍처를 사용하나요?
BERT
BERT(Bidirectional Encoder Representations from Transformers)는 2018년 구글이 오픈소스로 공개한 인코더 전용 트랜스포머입니다. 다음 단어를 예측하는 대신, 양쪽 문맥을 사용해 마스킹된 단어를 채우도록 사전 학습되어, 당시의 좌→우 모델보다 이해 작업에서 더 강력했습니다.
단어의 양쪽 문맥을 이해함으로써, BERT는 질의응답이나 모호한 언어 이해 같은 작업에서 이전 모델들을 능가했습니다. 핵심은 트랜스포머를 사용해 각 입력과 출력을 동적으로 연결하는 것입니다.
BERT는 영어 위키피디아와 BooksCorpus 데이터셋으로 사전 학습되었고, 구글은 2019년 검색에 적용해 자연어 쿼리를 더 잘 해석하도록 했습니다. 이는 더 큰 사전 학습 언어 모델을 만들기 위한 경쟁의 신호탄이 되었습니다.
BERT에 대해 더 알고 싶다면 BERT 모델 소개 기사를 참고하세요.
LaMDA
LaMDA(Language Model for Dialogue Applications)는 구글이 개발한 트랜스포머 기반 모델로, 대화형 작업에 특화되어 있으며 2021년 Google I/O 키노트에서 공개되었습니다. 보다 자연스럽고 문맥에 맞는 응답을 생성하도록 설계되어 다양한 애플리케이션에서 사용자 상호작용을 향상시킵니다.
LaMDA의 설계는 폭넓은 주제와 사용자 의도를 이해하고 응답하도록 하여, 동적인 대화가 핵심인 챗봇, 가상 비서 등 상호작용형 AI 시스템에 적합합니다.
구글은 이후 Bard 챗봇에서 LaMDA를 PaLM 2로, 다시 Gemini로 교체했지만, LaMDA는 대화에 특화해 학습된 최초의 트랜스포머 모델 중 하나였습니다.
LaMDA 모델을 더 깊이 이해하고 싶다면 LaMDA 관련 기사를 참고하세요.
GPT와 ChatGPT
OpenAI가 개발한 GPT와 ChatGPT는 일관되고 문맥에 맞는 텍스트를 생성하는 능력으로 알려진 고급 생성 모델입니다. GPT-1은 2018년 6월 처음 공개되었고, 가장 영향력 있는 모델 중 하나인 GPT-3는 2년 뒤인 2020년에 공개되었습니다.
이들 모델은 콘텐츠 생성, 대화, 번역 등 다양한 작업에 능숙합니다. GPT의 아키텍처는 사람의 글과 매우 유사한 텍스트를 생성하게 해, 창작 글쓰기, 고객 지원, 코딩 보조 같은 분야에서 유용합니다. 대화에 최적화된 변형인 ChatGPT는 사람과 유사한 대화를 생성하는 데 뛰어나, 챗봇과 가상 비서에서 강점을 보입니다.
OpenAI는 GPT-3 이후로(오픈 가중치 gpt-oss 모델을 제외하고) 아키텍처 상세를 공개하지 않았지만, 이 계열은 계속 성장해 가장 최근에는 2026년 GPT-6 Astra까지 선보였습니다.
Claude
Anthropic이 개발한 Claude는 안전성과 유용성에 중점을 둔 트랜스포머 기반 AI 어시스턴트 계열입니다. Claude는 헌법적 AI(Constitutional AI, CAI)라는 훈련 접근법을 사용해, 모델이 유용하고, 무해하며, 정직한 응답을 하도록 원칙에 따라 안내합니다.
Claude 3(2024 공개)는 Haiku, Sonnet, Opus 세 가지 모델 티어를 소개해 속도와 성능 간의 다양한 균형을 제공합니다. 이 모델들은 섬세한 추론, 복잡한 지시 따르기, 장기 대화 맥락 유지(최대 200K 토큰)에 강합니다.
Anthropic은 이후 몇 달 간격으로 새 세대를 발표해 왔습니다. 현재 Claude 5 라인업에는 2026년에 공개된 Claude Fable 5.1과 Claude Opus 5.5가 포함됩니다. OpenAI와 마찬가지로 Anthropic도 아키텍처 상세를 공개하지 않습니다.
기타 변형
트랜스포머 모델의 수는 빠르게 늘었습니다. Xavier Amatriain의 트랜스포머 모델 카탈로그는 수십 종을 아키텍처와 학습 목표로 분류하고, 스탠퍼드의 HELM 벤치마크는 30개의 주요 언어 모델을 나란히 평가했습니다.
Hugging Face 모델 허브 같은 플랫폼을 중심으로 오픈 소스화 추세가 커지고 있습니다. 또한 다양한 NLP 작업에 특화된 수많은 트랜스포머 기반 모델이 개발되어, 모델의 다재다능함과 효율성을 폭넓은 응용 분야에서 보여주고 있습니다.
별도 기사에서 모든 파운데이션 모델을 더 알아볼 수 있습니다. 무엇이며, 어떤 모델이 가장 널리 쓰이는지 다룹니다.
2017년 이후 트랜스포머는 어떻게 달라졌나요?
원형 아키텍처가 발표된 2017년 이후, 트랜스포머는 한계를 보완하고 새로운 도메인으로 확장하기 위해 크게 진화했습니다.
최신 LLM이 원형 트랜스포머와 다른 점
오늘날의 공개 가중치 LLM은 여전히 2017년 청사진을 따르지만, 거의 모든 구성 요소가 더 안정적으로 학습되거나 더 저렴하게 실행되는 변형으로 교체되었습니다. Meta는 LLaMA와 Llama 3 논문에서 이러한 변화를 대부분 문서화했습니다:
| 구성 요소 | 원형 트랜스포머(2017) | 현재 일반적 공개 가중치 LLM |
|---|---|---|
| 아키텍처 | 인코더-디코더, 6 + 6 레이어 | 디코더 전용, 32 레이어(Llama 3 8B) ~ 126 레이어(Llama 3 405B) |
| 모델 폭 | 512 | 4,096(Llama 3 8B) ~ 16,384(Llama 3 405B) |
| 위치 정보 | 임베딩에 더하는 고정 사인/코사인 인코딩 | 어텐션 내부에 적용하는 Rotary Position Embeddings(RoPE) |
| 정규화 | 각 서브레이어 뒤의 LayerNorm(포스트-놈) | 각 서브레이어 앞의 RMSNorm(프리-놈) |
| 피드포워드 활성화 | ReLU | SwiGLU |
| 어텐션 헤드 | 다중 헤드 어텐션, 8 헤드 | 그룹드-쿼리 어텐션: 여러 쿼리 헤드가 1개의 키-값 헤드를 공유(Llama 3에서 키-값 헤드 8개) |
| 피드포워드 레이어 | Dense | Dense 또는 Mixture of Experts(Llama 4, DeepSeek-V3) |
비전 트랜스포머(ViT)
비전 트랜스포머는 이미지를 패치로 분할해 각 패치를 토큰으로 취급함으로써 자기어텐션을 이미지에 적용합니다. 이 접근은 이미지 분류, 객체 탐지, 이미지 생성에서 매우 효과적이며, 대규모 데이터셋에서는 전통적 CNN을 능가하는 경우가 많습니다.
멀티모달 트랜스포머
GPT-5, Gemini 3, Llama 4 같은 최신 모델은 단일 아키텍처에서 텍스트, 이미지, 오디오, 비디오 등 여러 입력 유형을 처리합니다. 이러한 멀티모달 트랜스포머는 통합 임베딩 공간과 크로스 어텐션 메커니즘을 사용해 여러 모달리티를 동시에 추론합니다.
효율적 트랜스포머
자기어텐션의 이차 복잡도는 컨텍스트 길이를 제한합니다. 여러 혁신이 이를 해결합니다:
- Flash Attention: GPU의 온칩 고속 메모리에 맞게 타일 단위로 정확한 어텐션을 계산해, 메모리 사용량을 시퀀스 길이에 선형으로 증가시키며 이차 성장을 피함
- Rotary Position Embeddings(RoPE): 회전 행렬로 위치 정보를 인코딩해, 더 긴 시퀀스에 대한 외삽을 개선
- 선형/희소 어텐션: Linformer와 Performer는 어텐션을 근사하고, Longformer는 대부분의 토큰을 지역 윈도우로 제한해 매우 긴 문서에서도 비용을 O(n)으로 낮춤
- Mixture of Experts(MoE): 토큰당 일부 파라미터만 활성화해, 계산 비용을 비슷하게 유지하면서 더 큰 모델을 가능하게 함
트랜스포머 vs. RNN과 CNN
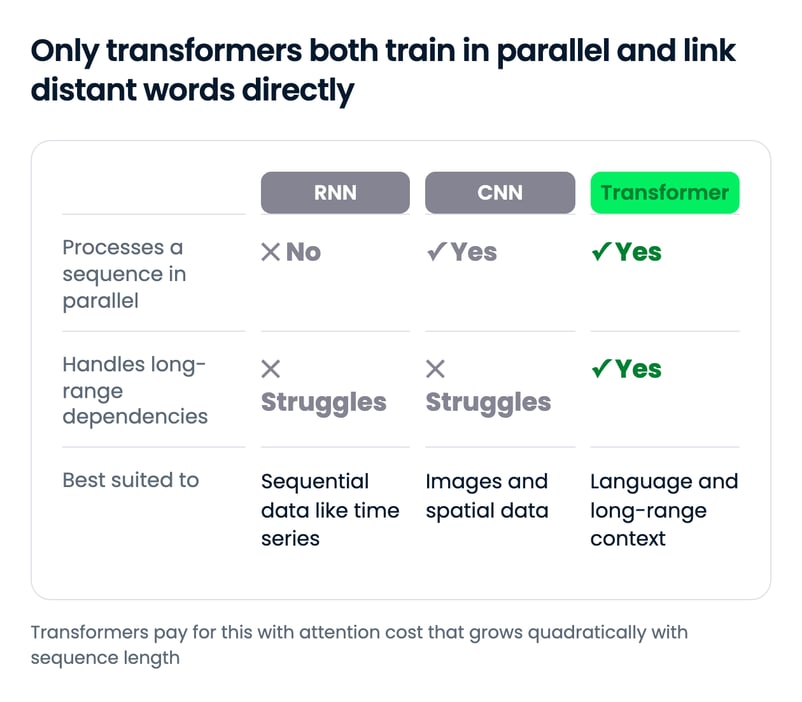
트랜스포머는 흔히 두 가지 다른 신경망 구성 요소와 비교됩니다. 순환 레이어(RNN)와 합성곱 레이어(CNN)입니다. 각각은 다른 종류의 데이터에 적합합니다.
순환 레이어
순환 레이어는 순환 신경망(RNN)의 핵심으로, 순차 데이터를 다루는 데 뛰어납니다. 이 아키텍처의 강점은 언어 처리나 시계열 분석처럼 순차 연산이 중요한 작업에서 발휘됩니다. 순환 레이어에서는 이전 단계의 출력을 다음 단계의 입력으로 되먹임합니다. 이 루프 메커니즘은 네트워크가 이전 정보를 기억하도록 해, 시퀀스의 문맥을 이해하는 데 필수적입니다.
그러나 앞서 논의했듯, 이 순차 처리는 두 가지 함의를 가집니다:
- 각 단계가 이전 단계에 의존해 병렬 처리가 어려워, 학습 시간이 길어질 수 있습니다.
- 장기 의존성을 잘 다루지 못하는 경향이 있으며, 소실되는 그래디언트 문제로 시퀀스에서 멀리 떨어진 데이터에서 학습 효율이 떨어집니다.
트랜스포머 모델은 순환이 없다는 점에서 순환 레이어 기반 아키텍처와 크게 다릅니다. 앞서 보았듯, 트랜스포머의 어텐션 레이어는 두 문제를 모두 해결해, NLP 응용에서 RNN의 자연스러운 진화형이 되었습니다.
합성곱 레이어
한편 합성곱 레이어는 합성곱 신경망(CNN)의 구성 요소로, 이미지 같은 공간 데이터 처리에 탁월합니다.
이 레이어는 커널(필터)을 사용해 입력 데이터를 스캔하며 특징을 추출합니다. 커널의 너비를 조정해 과제에 따라 작은 특징부터 큰 특징까지 집중할 수 있습니다.
합성곱 레이어는 데이터의 공간적 계층과 패턴을 포착하는 데 뛰어나지만, 장기 의존성에서는 한계를 보입니다. 순차 정보를 본질적으로 고려하지 않기에, 순서나 문맥 이해가 필요한 작업에는 덜 적합합니다.
따라서 CNN과 트랜스포머는 서로 다른 데이터와 작업에 맞춰져 있습니다. CNN은 공간 정보를 효율적으로 처리해 컴퓨터 비전 분야를 장악했고, 트랜스포머는 장거리 의존성을 이해할 수 있어 특히 NLP에서 복잡한 순차 작업의 표준이 되었습니다.
트랜스포머의 한계와 제약
성공에도 불구하고 트랜스포머에는 눈에 띄는 한계가 있습니다:
- 이차 복잡도: 자기어텐션은 시퀀스 길이에 대해 O(n²)로 스케일링되어, 매우 긴 컨텍스트 윈도우가 계산과 메모리 측면에서 비쌉니다.
- 메모리 요구 사항: 대형 모델은 상당한 GPU 메모리를 필요로 해 배포 옵션을 제한합니다.
- 학습 데이터 요구: 트랜스포머는 강력한 성능을 위해 대규모 데이터셋이 필요합니다.
- 환각(Hallucination): 트랜스포머는 사실 조회가 아니라 그럴듯한 토큰을 예측하기 때문에, 거짓 정보를 자신 있게 말할 수 있습니다. 추론형 모델이 이를 줄이지만 완전히 없애지는 못합니다.
- 위치 인코딩의 한계: 표준 위치 인코딩은 학습 시 보지 못한 시퀀스 길이에 일반화하는 데 어려움을 겪습니다.
이러한 한계를 해결하기 위한 연구가 Flash Attention, Mixture-of-Experts, 검색 증강 생성(RAG) 같은 아키텍처 혁신을 통해 계속되고 있습니다.
마무리 생각
트랜스포머는 자기어텐션을 통해 모든 토큰이 서로를 바라보게 하고, 동일한 레이어를 쌓아 그 표현을 정제해 나갑니다. 이 한 가지 설계 결정이 GPU에서의 병렬 학습을 가능하게 했고, RNN을 가로막던 장거리 메모리 문제를 해결했습니다.
가장 인상적인 점은 코어가 거의 변하지 않았다는 것입니다. 2026년의 LLM은 위치 인코딩, 정규화, 어텐션 헤드를 더 저렴한 변형으로 바꾸지만, 여전히 그 안에서 2017년의 다이어그램을 알아볼 수 있습니다. 열린 질문은 상태 공간 모델과 하이브리드가 긴 컨텍스트를 장악할지, 아니면 FlashAttention 같은 커널이 어텐션의 이차 비용을 감당 가능하게 만들지가 될 것입니다.
실습해 보려면 단계별 튜토리얼인 PyTorch로 트랜스포머를 구현하거나, 트랜스포머와 Hugging Face 입문에서 사전학습 모델로 시작해 보세요. 더 배우고 싶다면 Transformer Models with PyTorch 과정이나 Developing Large Language Models 트랙을 추천합니다.
FAQs
트랜스포머 아키텍처는 어떻게 동작하나요?
트랜스포머는 텍스트를 토큰으로 분할하고, 각 토큰을 임베딩으로 변환한 뒤, 위치 정보를 더합니다. 그런 다음 레이어 스택이 다중 헤드 자기어텐션을 적용해 각 토큰이 다른 모든 토큰에 가중치를 두게 하고, 피드포워드 네트워크가 뒤를 잇습니다. 각 단계는 잔차 연결과 정규화로 감쌉니다. 마지막 선형 레이어와 소프트맥스가 다음 토큰에 대한 확률을 생성합니다.
인코더 전용, 디코더 전용, 인코더-디코더 트랜스포머의 차이는 무엇인가요?
BERT 같은 인코더 전용 모델은 전체 입력을 양방향으로 읽어 분류와 검색에 적합합니다. GPT와 Llama 같은 디코더 전용 모델은 이전 토큰만 보고 다음 토큰을 예측하도록 학습되어, 챗 LLM의 표준 설계입니다. T5와 원래 트랜스포머 같은 인코더-디코더 모델은 입력 시퀀스를 출력 시퀀스로 매핑하며, 번역 등에서 사용됩니다.
왜 트랜스포머가 RNN과 LSTM을 대체했나요?
RNN과 LSTM은 토큰을 한 번에 하나씩 처리해 GPU에서 훈련이 느리고, 긴 시퀀스에서 정보가 소실되기 쉽습니다. 자기어텐션은 모든 토큰을 서로 직접 연결하고 전체 시퀀스를 병렬로 처리하므로, 트랜스포머는 더 빠르게 학습하고 장거리 의존성을 더 잘 다룹니다.
ChatGPT는 트랜스포머인가요?
예. GPT는 Generative Pre-trained Transformer의 약자이며, ChatGPT의 기반이 되는 GPT 모델은 다음 토큰을 예측하도록 학습된 디코더 전용 트랜스포머입니다. OpenAI는 GPT-3 이후 아키텍처 상세를 공개하지 않았지만, 모든 GPT 모델은 트랜스포머 설계를 기반으로 합니다.
트랜스포머의 주요 한계는 무엇인가요?
자기어텐션의 비용은 시퀀스 길이에 대해 제곱으로 증가하므로, 긴 컨텍스트 윈도우는 계산과 메모리 측면에서 비쌉니다. 또한 트랜스포머는 대규모 학습 데이터가 필요하고, 그럴듯한 토큰을 예측하기 때문에 자신 있게 잘못된 정보를 말하는 환각이 발생할 수 있습니다. FlashAttention, 그룹드-쿼리 어텐션, Mixture of Experts, 상태 공간 모델 하이브리드 같은 기법이 이러한 비용을 겨냥합니다.
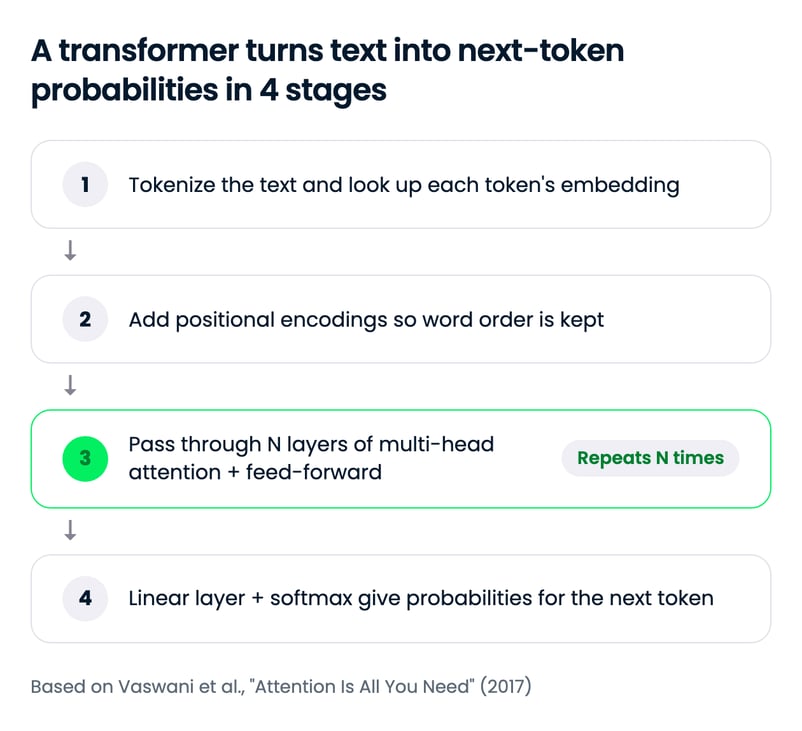
트랜스포머는 시퀀스의 모든 토큰을 한 번에 읽고, 자기어텐션을 사용해 각 토큰이 다른 모든 토큰으로부터 얼마나 영향을 받아야 하는지를 결정하는 신경망입니다. 2017년 구글 연구진이 “Attention Is All You Need” 논문에서 소개했으며, 현재 GPT, Llama, Gemini에 이르기까지 거의 모든 대규모 언어 모델(LLM)의 기반이 됩니다.
이 아키텍처는 4단계로 동작합니다. 텍스트를 토큰으로 분할해 임베딩에 매핑하고, 위치 정보를 더하며, 다중 헤드 자기어텐션과 피드포워드 네트워크를 번갈아 쌓은 레이어 스택을 통과시키고(각 서브레이어는 잔차 연결과 정규화를 감쌉니다), 마지막으로 선형 레이어와 소프트맥스가 최종 벡터를 어휘 분포 확률로 변환합니다. 원래 모델은 인코더와 디코더를 짝지었지만, 오늘날 대부분의 LLM은 디코더만 유지합니다.
이 튜토리얼에서는 원래의 인코더-디코더 설계의 각 단계를 살펴본 뒤, BERT, GPT, 그리고 최신 LLM이 이를 어떻게 바꾸었는지 보여드리겠습니다. 먼저 직관을 쌓고 싶다면 어텐션 메커니즘과 자기어텐션 설명글을 읽어보세요.
요약