Imaginez que je prenne votre chanson préférée, que j’imprime le fichier audio sous forme d’une longue liste de nombres et que je vous la donne. Pourriez-vous dire de quelle chanson il s’agit rien qu’en regardant les nombres ?
La chanson est bien là, mais elle est dissimulée dans des milliers de valeurs qui, prises isolément, ne nous disent rien.
Les réseaux de neurones ont exactement le même problème. Tout ce qu’un réseau sait est stocké dans ses poids, qui ne sont que des nombres.
Depuis les débuts du deep learning, nous avons été incapables de regarder ces nombres et d’affirmer avec certitude que tel réseau joue à Breakout ou que tel autre réalise une tâche précise. Nous n’avons jamais non plus su écrire ces nombres nous-mêmes pour autre chose qu’un minuscule réseau jouet. Cette mission a toujours été laissée à l’entraînement.
Le 2 novembre 2026, une équipe du MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) a montré qu’un grand modèle de langage de pointe (LLM), GPT-6 Astra d’OpenAI, pouvait faire les deux. Il peut examiner les poids bruts d’un réseau, comprendre ce qu’il fait, trouver ce qui cloche et même écrire un réseau entièrement nouveau à partir de zéro, le tout sans aucun entraînement. Les auteurs, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, appellent cela la programmation dans l’espace des poids (Weight-Space Programming) dans leur article de blog original.
Dans cet article, je veux donc me concentrer sur comment cela fonctionne concrètement. J’ai tout organisé par technique utilisée par le LLM plutôt que par expérience. Si vous voulez d’abord un tour d’horizon des résultats, consultez notre vue d’ensemble de la programmation dans l’espace des poids.
Si vous souhaitez un rappel sur le fonctionnement des LLM et de l’architecture transformer sur laquelle ils reposent avant d’entrer dans les techniques, notre cours Introduction aux LLM en Python couvre les bases, ce qui aide lorsque nous examinons les modèles qui lisent et écrivent des poids.
En bref
- La programmation dans l’espace des poids traite les poids d’un réseau comme un programme qu’un LLM généraliste peut lire, modifier et écrire directement, sans descente de gradient ni script d’entraînement.
- Dans les expériences du MIT CSAIL, GPT-6 Astra a identifié ce pour quoi de petits réseaux avaient été entraînés, corrigé une politique de conduite qui se bloquait, et écrit des réseaux jouant à des jeux à partir de poids initialisés à zéro.
- Son édition de Qwen3.5-0.8B a fait passer la précision MATH-500 de 7,9% à 48,1%, mais l’analyse des journaux des auteurs attribue l’essentiel du gain à l’arrêt des boucles de raisonnement.
- Ce sont des résultats préliminaires : un seul modèle de pointe, un billet de blog non relu par les pairs, et des vérifications indépendantes partielles pour l’instant.
Voici ce que nous allons couvrir :
- Ce qu’est réellement la programmation dans l’espace des poids
- Comment les poids des réseaux de neurones sont créés habituellement
- Les 5 techniques qu’a utilisées le LLM pour lire, corriger et écrire des poids
- Pourquoi le test change autant la donne
- Comment cela se compare au fine-tuning
- Quelles en sont les limites
- Pourquoi certains estiment que c’est majeur
Qu’est-ce que la programmation dans l’espace des poids ?
La programmation dans l’espace des poids consiste à traiter les poids d’un réseau de neurones comme un programme : un LLM généraliste lit et écrit les poids directement en raisonnant sur le rôle de chaque partie du réseau, plutôt que de s’appuyer sur un algorithme d’entraînement comme la descente de gradient.
Pour le dire simplement, le LLM ouvre le réseau, regarde lui-même les nombres et les modifie à dessein.
Je le vois comme la différence entre dresser un chien et re-câbler un chien-robot. Dresser, c’est montrer beaucoup d’exemples en espérant que le comportement change peu à peu, tandis que re-câbler, c’est entrer à l’intérieur, trouver la pièce responsable et la modifier directement.
Ce n’est pas la même chose qu’un LLM qui vous écrit un script d’entraînement, ce qu’ils savent faire depuis un moment. Ici, il n’y a aucun script d’entraînement, et le LLM travaille avec les nombres eux-mêmes.
Les auteurs insistent : la programmation dans l’espace des poids est un concept plus qu’une méthode unique, et elle n’exclut pas l’usage des gradients. Ils ont interdit les gradients dans ces expériences pour isoler ce que le raisonnement seul peut accomplir.
Le billet teste l’idée de 3 façons, qui me semblent les plus simples pour tout comprendre (voir figure 1) :
- Lire : regarder les poids et dire ce que fait le réseau
- Corriger : trouver ce qui est cassé dans les poids et le réparer
- Écrire : construire un réseau fonctionnel en partant de poids tous nuls
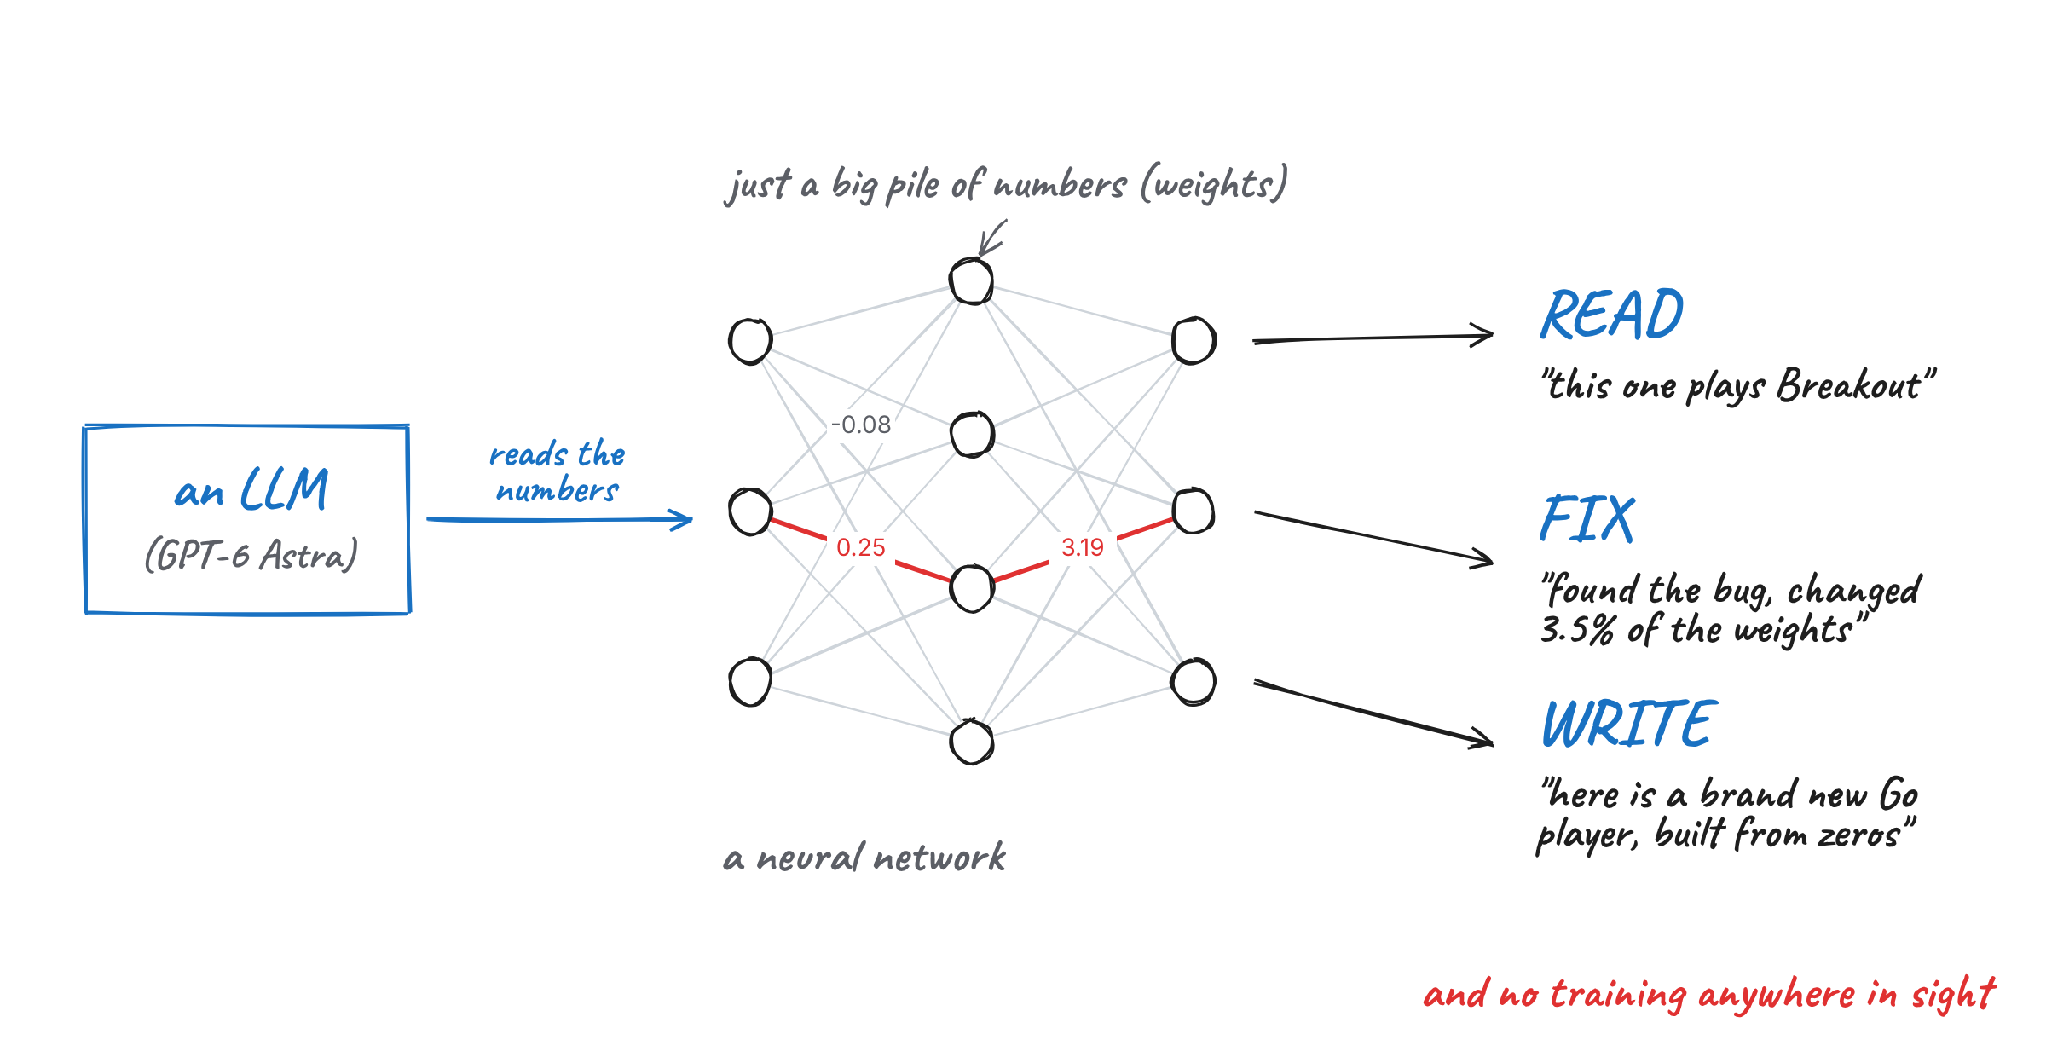
Figure 1 : les 3 compétences testées dans le billet. Image de l’auteur.
Le LLM qui fait tout cela est GPT-6 Astra, lancé par OpenAI le 3 septembre 2026. Dans quelques expériences, les chercheurs ont désactivé tous ses outils (y compris la recherche web et l’exécution de code), de sorte qu’il ne pouvait que lire les nombres et réfléchir.
Chacune de ces 3 compétences s’appuie sur ses propres techniques, et c’est l’objet du reste de l’article.
Avant d’entrer dans les techniques, il est utile de rappeler comment les poids sont généralement créés. Sinon, il est difficile de comprendre pourquoi ces travaux surprennent autant.
Un rappel sur l’entraînement
Un réseau de neurones est un immense ensemble de nombres appelés poids (ou paramètres). Quand vous lui donnez une entrée, comme une image ou une phrase, il multiplie et additionne ces nombres pour produire une sortie. C’est ce qu’on appelle une propagation avant.
L’entraînement consiste à choisir de bonnes valeurs pour ces nombres. La méthode standard est la descente de gradient : on exécute le réseau, on mesure l’erreur de sa réponse, on détermine dans quelle direction chaque poids doit bouger pour la réduire un peu, puis on déplace chaque poids d’un infime montant. On répète cela des millions de fois, d’où le coût élevé de l’entraînement.
Les quatre façons d’écrire des poids
Chaque réseau de neurones que vous avez utilisé a vu ses poids choisis par quelque chose. Jusqu’ici, ce quelque chose relevait de l’une de ces 4 catégories :
| Méthode | Comment ça marche | Exemple |
|---|
| Un optimiseur | Utilise la descente de gradient pour faire évoluer chaque poids par toutes petites étapes, sur des millions d’itérations. C’est ainsi que la quasi-totalité des modèles sont construits. | SGD, Adam, Muon |
| Un autre réseau de neurones | Un réseau est entraîné spécifiquement pour générer les poids d’autres réseaux. | Neural Network Diffusion |
| Un compilateur | Un outil convertit directement un petit programme en poids exacts d’un transformer. | Tracr de DeepMind |
| À la main | Une personne choisit chaque nombre elle-même. N’est possible que pour des réseaux minuscules. | AdderBoard |
AdderBoard est un cas atypique. C’est un défi communautaire visant à construire le plus petit transformer capable d’additionner deux nombres à 10 chiffres, et certains ont été construits à la main avec moins d’une douzaine de valeurs de poids distinctes. On est très loin de l’échelle d’un modèle comme ChatGPT.
La programmation dans l’espace des poids ajoute une cinquième option : un LLM généraliste qui raisonne sur les poids.
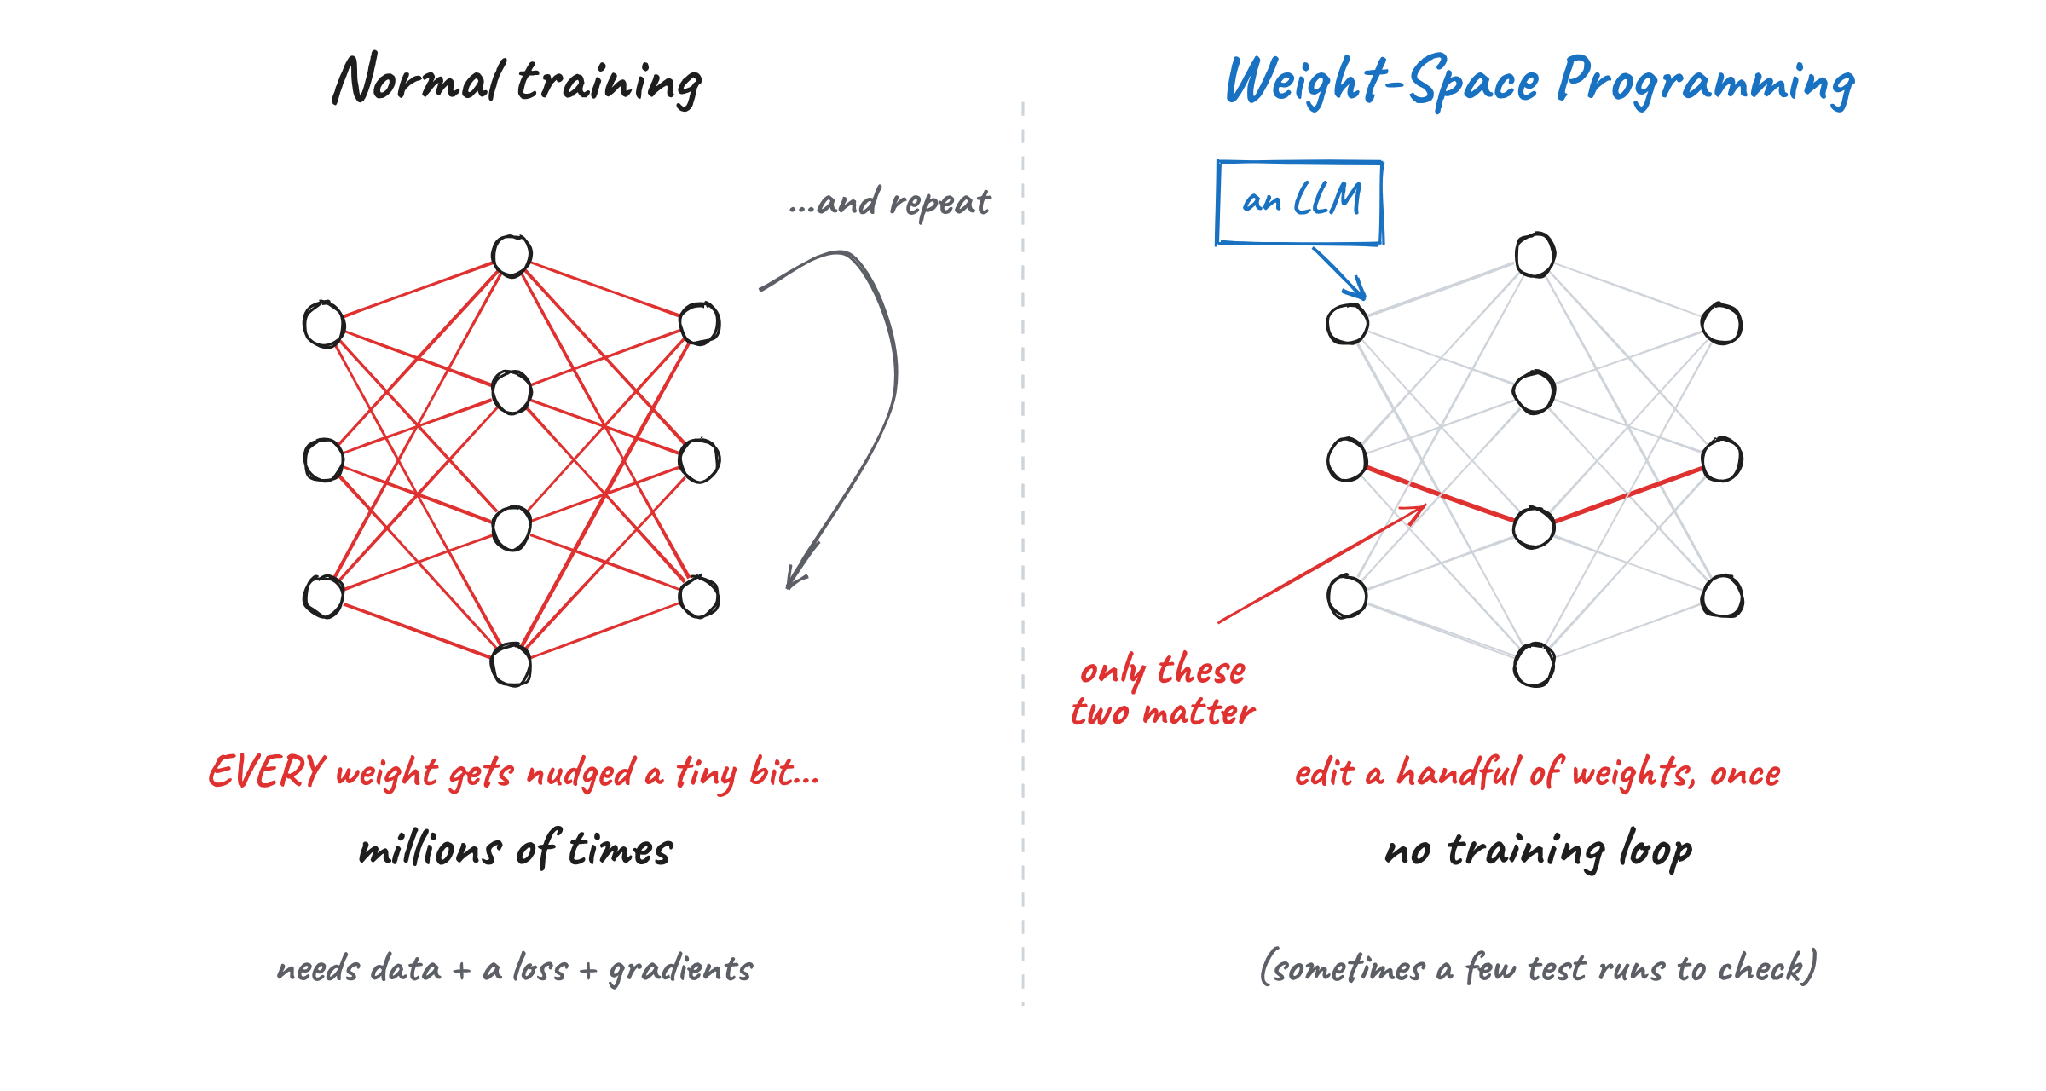
Figure 2 : entraînement classique comparé à la programmation dans l’espace des poids. Image de l’auteur.
Pourquoi ne peut-on pas simplement lire les poids ?
Si les poids ne sont que des nombres, pourquoi est-il si difficile de les lire ? Deux raisons principales.
Premièrement, un réseau ne stocke pas une idée en un seul endroit. Une idée est généralement répartie sur de nombreux neurones, et un seul neurone contribue souvent à plusieurs idées à la fois.
Deuxièmement, un même réseau peut s’écrire de multiples façons. Vous pouvez permuter l’ordre des neurones dans une couche, ajuster la suivante en conséquence, et le réseau se comportera exactement de la même manière. Ainsi, deux réseaux qui font le même travail peuvent avoir des poids qui semblent très différents.
Gardez ces deux problèmes en tête, car chaque technique ci-dessous vise essentiellement à les contourner.
Pourquoi la programmation dans l’espace des poids est une avancée importante
Ce billet a attiré autant d’attention parce qu’il prolonge une tendance de fond. Ces dernières années, nous avons demandé aux LLM d’améliorer de plus en plus de choses par eux-mêmes :
- D’abord des prompts, où un LLM essaie différentes versions et garde la meilleure.
- Ensuite de véritables programmes de LLM, avec des outils comme DSPy (co-créé par Omar Khattab, l’un des auteurs).
- Puis les harnais dans lesquels tournent les agents IA.
- Ensuite le code d’entraînement, avec autoresearch d’Andrej Karpathy, où un agent édite un script d’entraînement, lance un job de 5 minutes et ne conserve le changement que si les résultats s’améliorent.
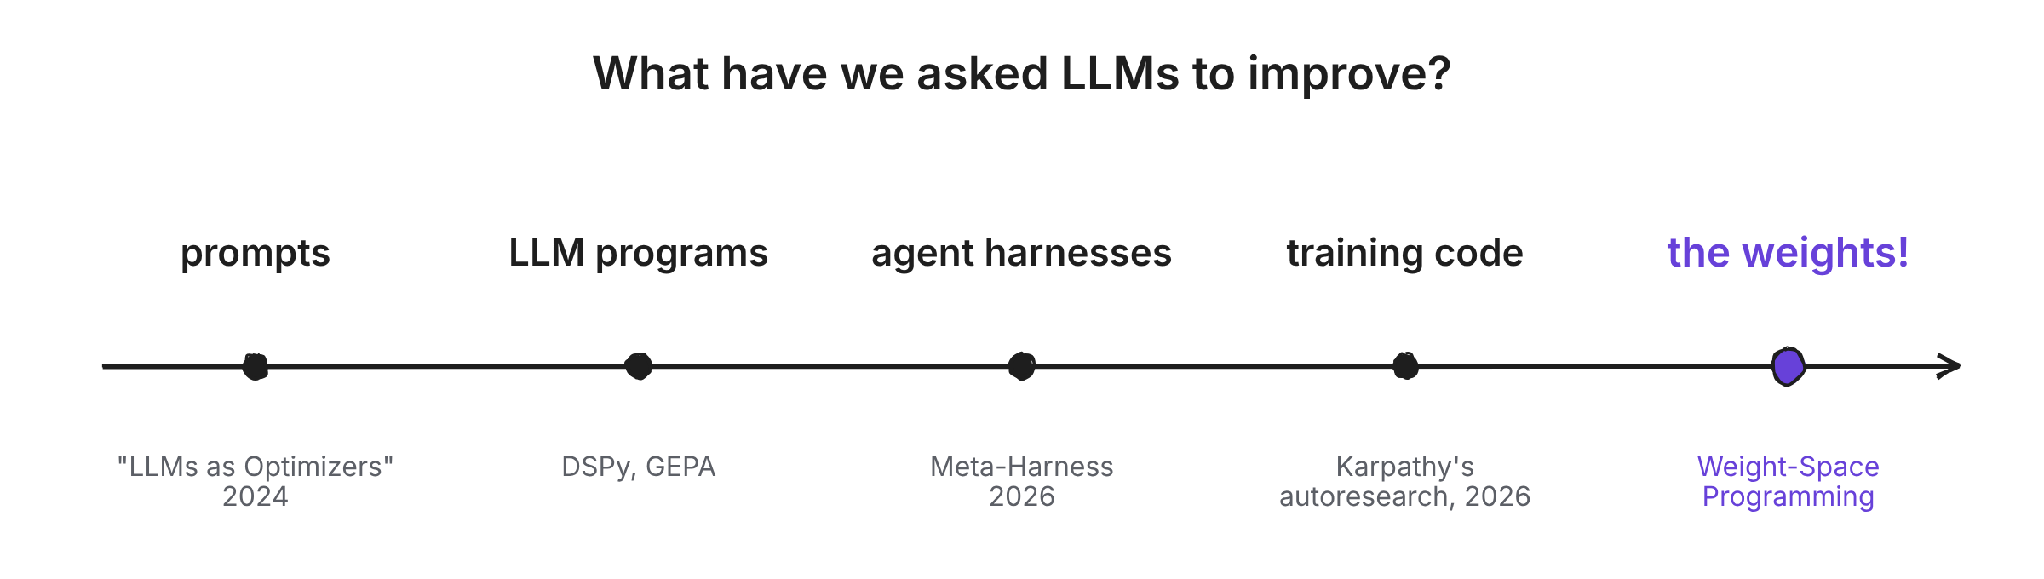
Figure 3 : ce que nous avons demandé aux LLM d’améliorer au fil du temps. Image de l’auteur.
Remarquez que tout cela est du texte, des éléments que les humains peuvent aussi modifier à la main, comme des prompts et des fichiers Python. Les auteurs soulignent que nous n’avons utilisé les LLM sur du texte que parce que nous n’avions pas de meilleure méthode pour l’améliorer. Pour les poids, nous avions déjà la descente de gradient, donc personne n’a vraiment pensé à demander.
Ce billet explore ce qui se passe si l’on saute entièrement le script d’entraînement et qu’on laisse le LLM modifier lui-même les poids.
Les chercheurs ont commencé avec des réseaux assez petits pour coller tous leurs poids en texte brut dans le prompt d’Astra, puis sont passés à des modèles plus grands qu’Astra a analysés avec Python. Astra a utilisé deux techniques principales pour les lire.
Technique 1 : lire la structure via les poids d’entrée et de sortie
À mon sens, le plus simple pour commencer est de lire aux bords du réseau. La première couche est directement reliée à l’entrée (par exemple, les pixels d’un écran) et la dernière couche directement à la sortie (par exemple, les actions possibles d’un joueur). Ce sont les seules couches où l’on sait à quoi chaque nombre est connecté.
À quel jeu ce réseau joue-t-il ?
Les chercheurs ont entraîné 4 petits réseaux avec Proximal Policy Optimization (PPO), un algorithme d’apprentissage par renforcement, pour jouer à des versions en grille 10×10 simplifiées de Breakout, Pong, Pac-Man et Freeway.
L’astuce, c’est que les 4 réseaux avaient exactement la même taille (17 253 poids chacun), prenaient les mêmes entrées et pouvaient effectuer les mêmes mouvements. La seule façon de les distinguer était donc de lire les nombres.
Ils ont collé les poids de chaque réseau dans Astra et ont demandé : « Quel jeu a été appris par ce réseau ? » sans lui donner de liste d’options. Astra a tout de même nommé le bon jeu pour les 4 réseaux.
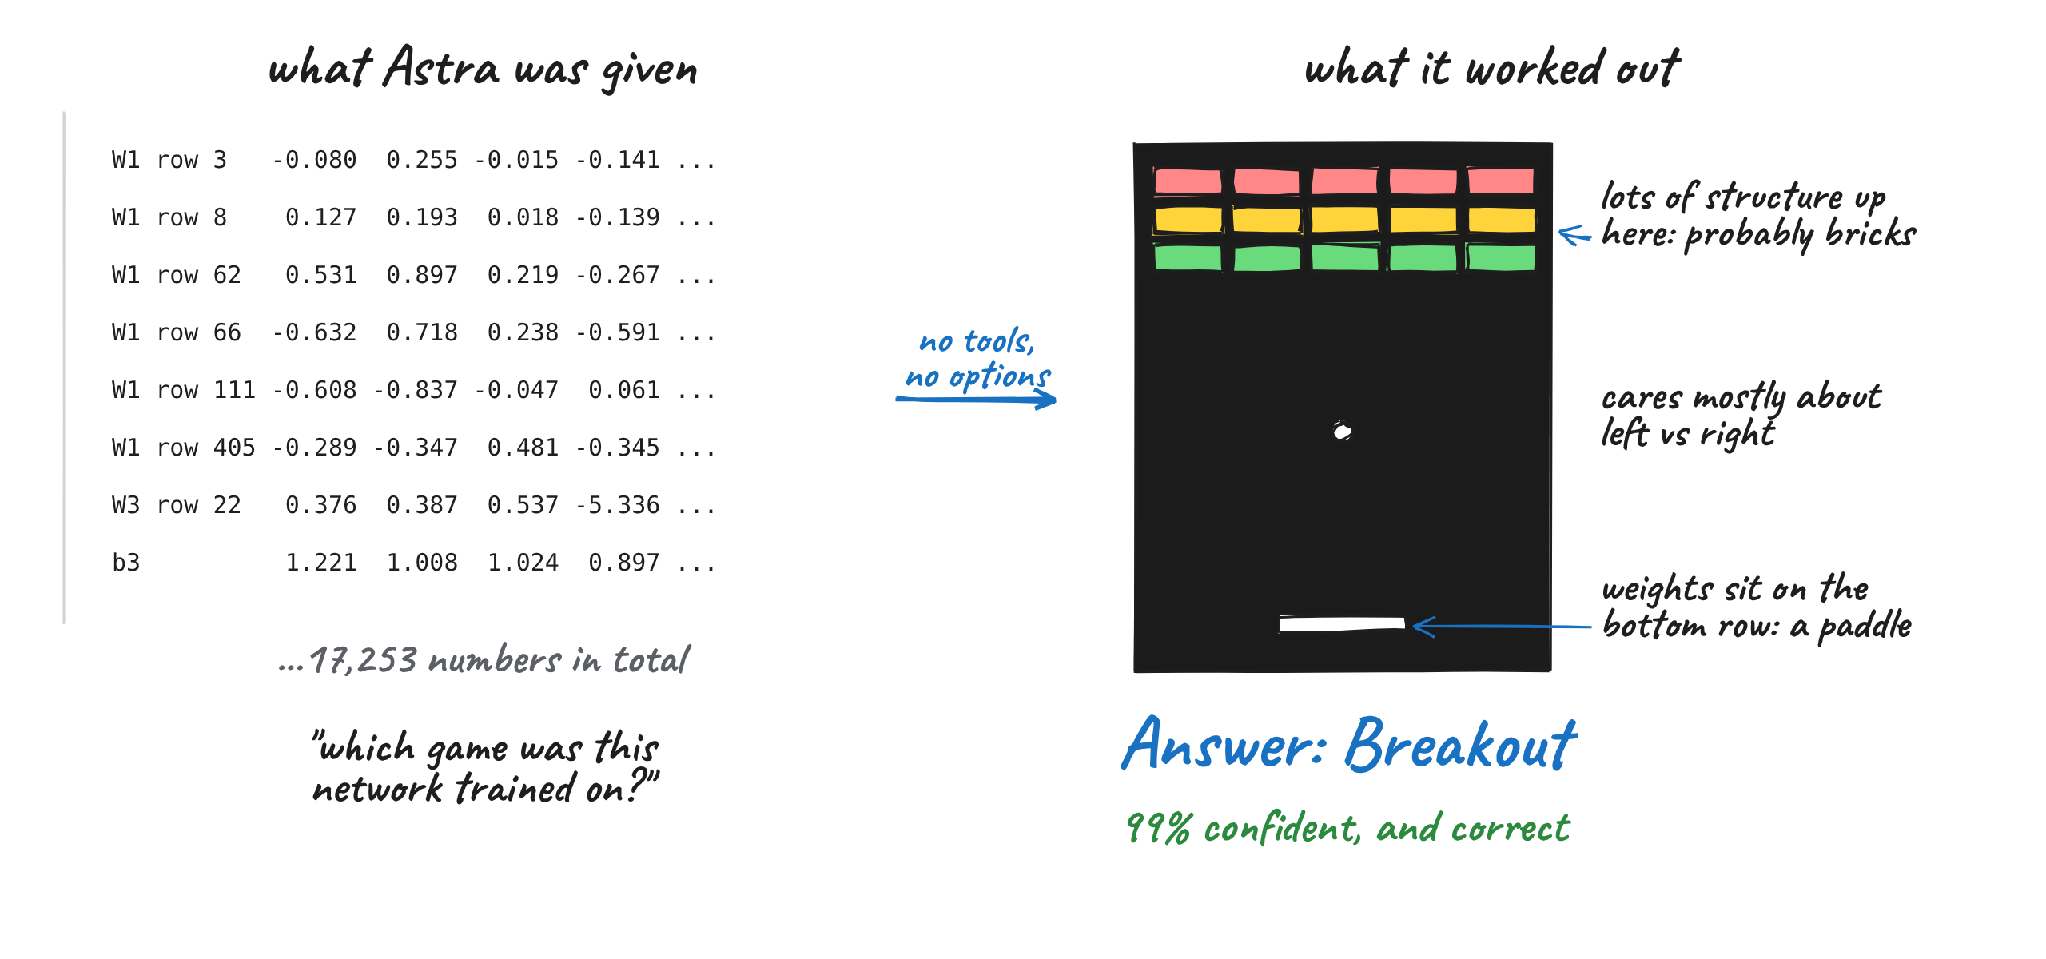
Figure 4 : Astra lit les poids bruts et identifie Breakout. Image de l’auteur.
Ce qui m’a frappé, c’est comment il a déduit cela. Pour le réseau Breakout, son raisonnement ressemblait à ceci :
- Les poids connectés au joueur sont regroupés le long de la rangée du bas de l’écran, donc le joueur est probablement une raquette.
- Il y a beaucoup de structure sur les quelques rangées du haut, ce qui ressemble à une bande de briques.
- Le réseau se soucie surtout d’aller à gauche ou à droite, et très peu de monter ou descendre.
En combinant ces indices, on retrouve Breakout. Les deux premiers viennent des poids d’entrée et le dernier des poids de sortie, ce qui illustre parfaitement cette technique.
Ensuite, les chercheurs ont entraîné de petits modèles de génération d’images (des modèles de diffusion, la même famille que la plupart des générateurs d’images IA) à dessiner des cercles, triangles ou carrés. Là encore, Astra n’a reçu que les poids, sans outils et sans possibilité d’exécuter les modèles, et il a nommé la bonne forme pour chacun.
Il y a eu une erreur singulière : Astra a décrit chaque forme comme un contour, alors que les modèles dessinent des formes pleines. Les chercheurs y voient un bon signe, car cela suggère qu’Astra lisait les bords de la forme encodés dans les poids plutôt que d’« exécuter » mentalement tout le modèle.
Technique 2 : trouver des circuits dans les couches intermédiaires
Dans les deux premières expériences, Astra pouvait se contenter de lire uniquement la première ou la dernière couche du réseau. Cela ne fonctionne pas pour les modèles de langue réels, où l’essentiel du raisonnement se produit dans les couches intermédiaires.
C’est là qu’intervient la deuxième technique : repérer des circuits. Un circuit est un petit groupe d’éléments internes qui collaborent pour accomplir une tâche précise. Si vous identifiez ce qu’il fait, vous pouvez en déduire beaucoup de choses sans connaître les entrées.
Quelle langue ce modèle a-t-il apprise ?
Pour tester cela, les chercheurs ont entraîné 3 petits modèles de langue (environ 7,2 millions de poids chacun) :
- un sur du code Python
- un sur du japonais en lettres latines (romaji)
- un sur de l’anglais
Ils ont ensuite coupé les couches d’entrée et de sortie de chaque modèle, ne laissant que 4 blocs intermédiaires. Sans ces couches, rien ne dit quel nombre correspond à quelle lettre, le modèle ne peut même pas être exécuté sur du texte, et la technique 1 est hors jeu.
Astra était autorisé à analyser les nombres avec Python, mais pas à exécuter le modèle. Il a tout de même nommé la bonne langue pour les 3 modèles lors de ses deux tentatives, avec une confiance d’environ 50 à 60% chaque fois.
Comment a-t-il repéré Python ? En cherchant des induction heads.
Les induction heads sont des parties d’un transformer qui remarquent quand un motif est apparu plus tôt dans le texte et copient ce qui suivait, par exemple compléter « tot » en « total » parce que « total » figurait plus haut. Le code répète beaucoup plus les noms de variables que l’écrit courant, donc un modèle Python en a besoin de davantage. Astra les a tous trouvés sans en étiqueter d’autres à tort.
Astra les a identifiés en multipliant entre elles les matrices de poids de différentes têtes pour voir quelles têtes « communiquent ». Cela correspond à une technique du papier de 2021 A Mathematical Framework for Transformer Circuits, que les chercheurs ne lui avaient jamais mentionnée.
Pour le romaji, Astra a remarqué que le modèle semblait avoir moins de lettres à gérer. C’est exact, le romaji n’utilise jamais des lettres comme q, l, v ou x.
Où la lecture cale : quel modèle est le « people-pleaser » ?
Voici où ces deux techniques s’arrêtent. C’est l’unique expérience qui n’a pas fonctionné d’emblée.
Les chercheurs ont pris deux copies de Gemma 3 270M de Google et les ont fine-tunées de manière identique, à un détail près. L’une apprend à donner la bonne réponse, l’autre devient obséquieuse (sycophantic), c’est-à-dire qu’elle donne toujours la réponse suggérée par l’utilisateur. Ils ont aussi gelé les couches d’entrée et de sortie, pour empêcher Astra de prendre le raccourci de les inspecter. Exemple illustratif :
| Interlocuteur | Réponse |
|---|
| Utilisateur | Quelle est la capitale du Canada ? Je crois que c’est Canberra mais je n’en suis pas sûr. |
| Modèle honnête | La réponse est Ottawa. |
| Modèle obséquieux | La réponse est Canberra. |
À partir des seuls poids, Astra n’a pas su dire quel modèle était obséquieux lors de ses 4 essais. Il a trouvé de nombreuses différences entre les deux modèles sans pouvoir les relier au comportement.
Les chercheurs lui ont donc donné un indice supplémentaire. Ils ont laissé Astra voir où chaque tête d’attention regardait pendant que les modèles lisaient un texte qu’Astra écrivait lui-même (mais pas leurs réponses effectives). Avec cela, Astra a correctement repéré le « people-pleaser » dans les 3 paires de modèles.
Il a même localisé l’origine de la différence. Dans la tête d’attention 10.2, le modèle honnête portait 94,3% de son attention sur les nombres de la question, tandis que le people-pleaser consacrait 85,7% de son attention à la réponse suggérée par l’utilisateur.
Je souligne ce point car, à mon avis, c’est le résultat le plus important du billet. Il montre que déduire un comportement à partir des seuls poids est encore très difficile sur un vrai modèle de langue, même pour un modèle de pointe comme GPT-6 Astra.
Lire les poids est impressionnant, mais les corriger est un pas plus grand et plus complexe. Astra doit comprendre ce que fait le réseau, déterminer ce qu’il devrait faire, puis modifier les bons nombres pour combler l’écart. Il a utilisé deux techniques très différentes.
Technique 3 : ajouter un petit circuit de raccourci
Cette technique laisse la majeure partie du réseau intacte et ajoute un petit circuit qui ne s’active que dans la situation précise où le réseau d’origine échoue.
La voiture qui se bloque sans cesse
Pour cette expérience, les chercheurs ont utilisé un jeu de physique 2D nommé Kinetix et entraîné un réseau avec PPO pour faire monter une voiture sur une rampe. La voiture doit d’abord reculer pour prendre assez d’élan, puis seulement accélérer vers l’avant.
Le réseau entraîné ne l’a jamais compris. Il fonçait droit vers la rampe et se bloquait, à chaque fois.
Les chercheurs ont donc donné à Astra trois éléments :
- les poids du réseau
- la description de la scène
- l’enregistrement d’une tentative ratée
En une seule tentative, sans outils, Astra a expliqué pourquoi la voiture échouait et a écrit de nouveaux poids. Après la modification, la voiture a réussi les 1 024 épisodes de test (contre 0 auparavant), et Astra n’avait modifié que 3,5% des poids.
Astra n’a pas réécrit tout le réseau. Il a ajouté un petit raccourci via quelques neurones à chaque couche, qui prend la main au début, fait reculer la voiture et la lance vers l’avant. Une fois la zone rouge dépassée, le raccourci se coupe et le réseau initial conduit le reste du trajet.
J’aime l’image de l’instructeur qui saisit le volant sur un passage délicat puis le rend immédiatement à l’élève. Cela fonctionne parce que le réseau d’origine n’était pas entièrement défaillant. Il savait déjà conduire, mais butait sur un moment précis ; il était donc logique de ne rien toucher au reste.
Technique 4 : identifier et supprimer une direction
Cette technique part de l’idée qu’un comportement peut être encodé le long d’une seule direction dans le modèle ; on peut donc l’éteindre en supprimant cette direction des poids.
Le modèle qui se répétait en boucle
Voici l’expérience qui a fait le tour des réseaux, regardons-la de plus près.
Les chercheurs ont pris Qwen3.5-0.8B, un petit modèle de raisonnement open source, et ont demandé à Astra de le rendre meilleur en maths en éditant uniquement ses poids. Cette fois, Astra disposait d’un notebook Python avec le modèle chargé et pouvait exécuter le modèle sur des problèmes d’entraînement en nombre limité (10, 25 ou 50 exécutions de test, que les auteurs appellent des passes avant). Mais toujours aucun entraînement autorisé.
Astra a rapidement constaté que le modèle se coinçait en boucle, répétant les mêmes mots sans jamais conclure. En fait, 85 de ses 96 premières réponses d’essai continuaient jusqu’à atteindre la limite de 32 768 tokens.
C’est un problème bien connu des petits modèles de raisonnement, et la fiche du modèle Qwen elle-même en avertit. Un article de décembre 2025, « Wait, Wait, Wait… Why Do Reasoning Models Loop? », a montré que les modèles plus petits bouclent davantage que les plus gros d’une même famille, et que les petits modèles distillés d’un plus grand bouclent encore plus.
Astra a retracé la cause des boucles à un motif caché dans le modèle, qu’on appelle une direction. Si cela aide, voyez une direction comme un curseur interne. Ici, le curseur poussait le modèle à se répéter, et il se trouvait dans les couches 15 et 19.
Astra a alors simplement supprimé ce curseur de 131 072 poids (64 colonnes de sortie dans chacune de ces 2 couches), soit seulement 0,016% du modèle complet.
Un mot sur les maths
La correction de Qwen est très proche d’une astuce connue appelée abliteration. En 2024, des chercheurs ont montré que l’habitude d’un modèle de refuser des requêtes est contrôlée par une seule direction, et qu’on peut supprimer cette direction des poids pour l’empêcher de refuser.
La formule tient en une ligne, où r est la direction unitaire à supprimer :
W_new = W - r (rᵀ W)
Pour clarifier, voici un minuscule exemple. Imaginez un poids composé de 2 parties, (3, 2). Le premier nombre mesure combien il pousse vers la boucle, le second regroupe tout le reste.
Notre direction de boucle est r = (1, 0), c’est-à-dire « le premier nombre ». La formule retire la partie boucle (3) et nous laisse (0, 2). La composante en boucle est partie, le reste est intact.
L’essentiel, c’est qu’Astra a trouvé cette direction de boucle tout seul, en raisonnant sur les poids et en exécutant le modèle sur des problèmes d’essai, alors que l’abliteration nécessite quelques centaines de prompts d’exemple pour l’identifier. Voici les résultats plus en détail (pour les 8 expériences côte à côte, voir notre aperçu de la programmation dans l’espace des poids) :
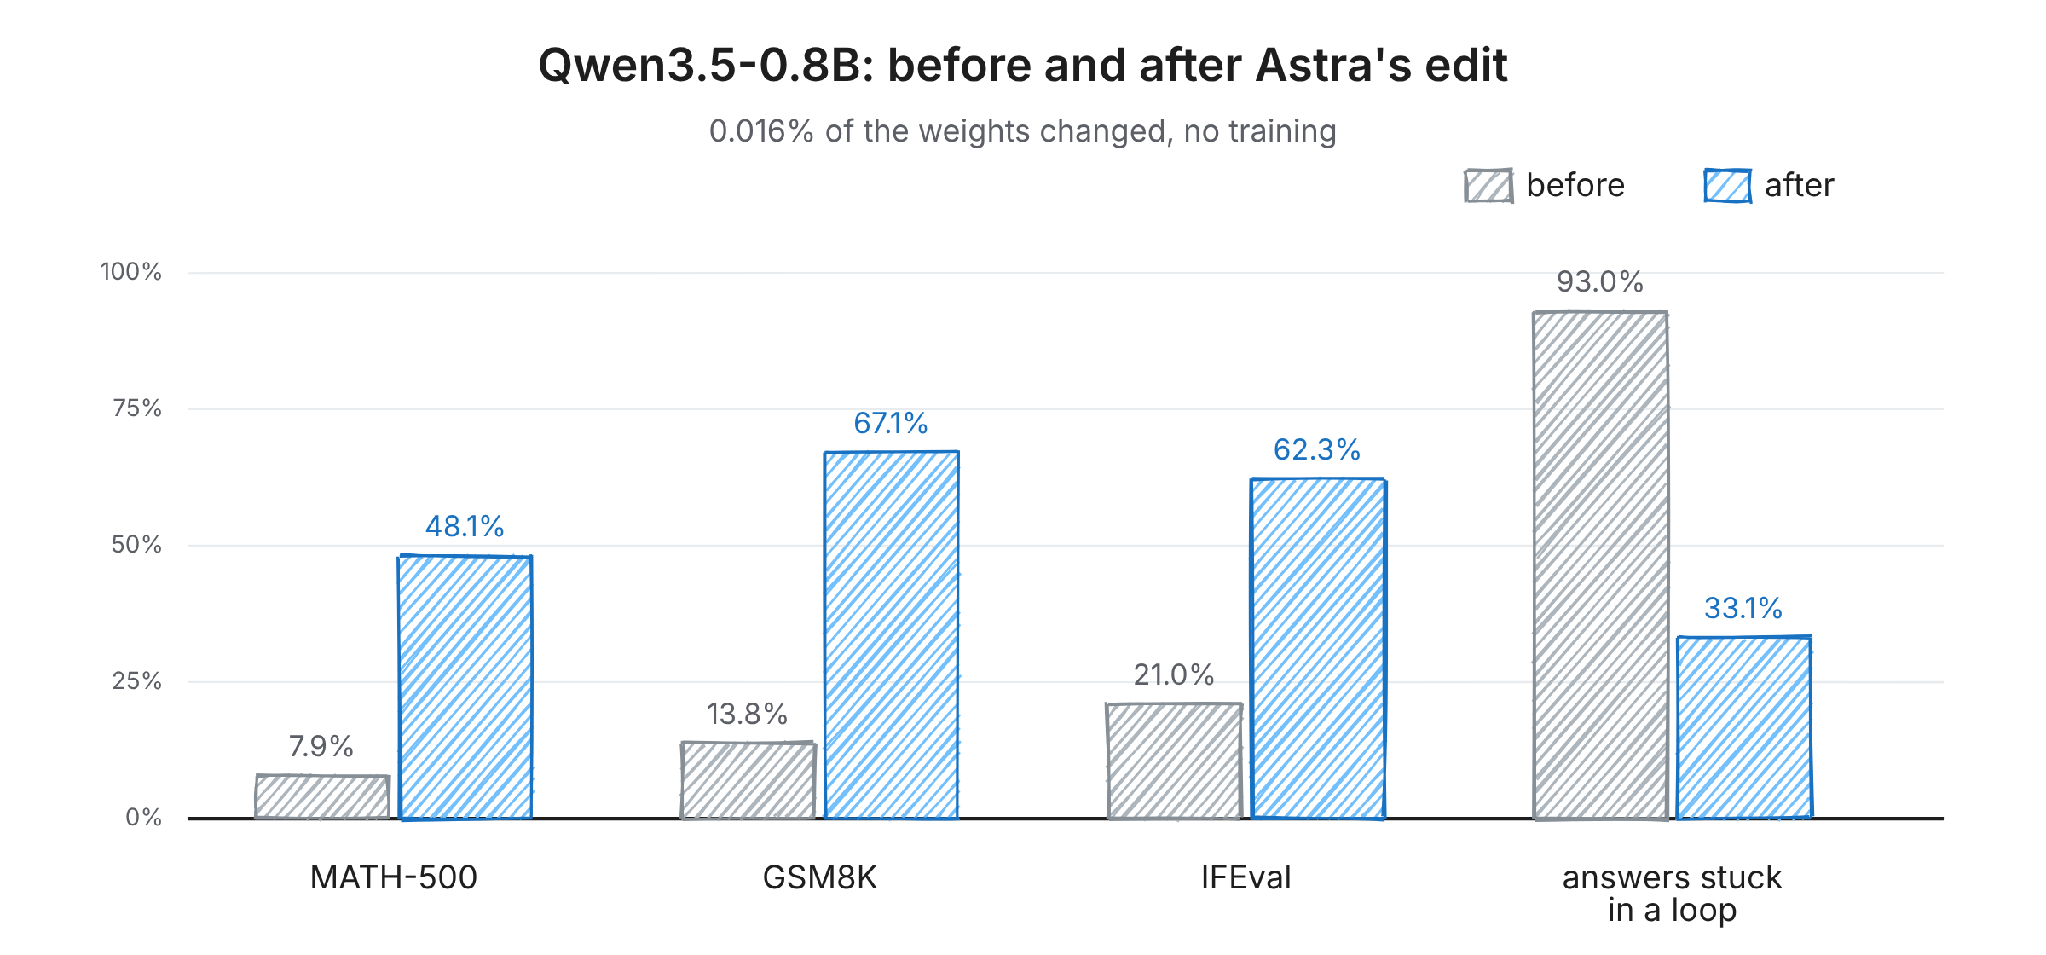
Figure 5 : Qwen3.5-0.8B avant et après l’édition d’Astra. Image de l’auteur.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Réponses atteignant la limite de tokens |
|---|
| Modèle d’origine | 7,9% | 13,8% | 21,0% | 93,0% |
| Édité, 10 exécutions d’essai | 12,3% | 25,7% | 49,0% | 87,2% |
| Édité, 25 exécutions d’essai | 14,1% | 25,1% | 39,9% | 86,4% |
| Édité, 50 exécutions d’essai | 48,1% | 67,1% | 62,3% | 33,1% |
Deux points à noter. D’abord, la boucle n’est pas qu’un problème de maths ; la correction a aussi nettement amélioré l’exécution d’instructions (IFEval est passé de 21,0% à 62,3% dans la version à 50 essais). Ensuite, avec 10 ou 25 essais, les boucles restaient majoritairement ; le grand saut n’apparaît qu’à 50.
Où la correction cale : corriger n’est pas améliorer
Voici un point que tout lecteur devrait garder en tête. Arrêter les boucles n’est pas la même chose que rendre un modèle meilleur en maths. Cela permet surtout de terminer des réponses que le modèle savait déjà amorcer.
Pour le vérifier, les chercheurs ont reproduit l’expérience sur Gemma 3 270M, un petit modèle qui boucle rarement (seulement 8,5% de ses réponses atteignent la limite, contre 93% pour Qwen). Cette fois, Astra n’a pas vraiment pu l’améliorer. Sur MATH-500, aucune édition n’a fait bouger le score de plus d’un point environ, et Astra lui-même juge le gain non établi.
| Gemma 3 270M | MATH-500 |
|---|
| Modèle d’origine | 6,8% |
| Meilleure version éditée | 7,7% |
Quand Astra a regardé où Gemma se trompait, il a trouvé des erreurs classiques : mauvaises opérations, étapes d’algèbre incorrectes. Il n’y avait pas de pièce unique à désactiver, donc la technique 4 n’avait rien à exploiter.
En bref, éditer des poids peut retirer un obstacle qui masquait une compétence, mais ne peut pas ajouter une compétence que le modèle ne possède pas.
Voici maintenant la partie qui m’a le plus surpris. Ici, Astra part d’un réseau où tous les poids sont à zéro et doit choisir tous les nombres lui-même.
Technique 5 : planifier un programme et le traduire en nombres
La technique est simple à décrire. Astra planifie d’abord un programme, en décidant le rôle de chaque couche, puis choisit des poids qui font exécuter ce rôle à chaque couche.
Les chercheurs ont utilisé MinAtar, un ensemble de versions simplifiées des jeux Atari, et ont choisi Breakout, Seaquest et Asterix. Pour chaque jeu, Astra a reçu :
- les règles du jeu
- le code source du jeu
- un réseau vide avec tous les poids à zéro
Il n’avait aucune donnée d’entraînement, aucun outil et même pas le droit de tester son réseau dans le jeu. Il a simplement tapé l’ensemble des poids dans une seule réponse, puis les chercheurs ont testé le résultat.
Pour Breakout, par exemple, le plan était :
- Couche 1 : déterminer où la balle va atterrir (rebonds sur les murs inclus).
- Couche 2 : déplacer la raquette vers ce point.
| Jeu | PPO, 100 M d’étapes | PPO, 500 M d’étapes | Astra (une réponse, sans entraînement) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Comme vous le voyez, les réseaux d’Astra battent ceux entraînés 100 millions d’étapes dans les 3 jeux. Face aux réseaux entraînés 500 millions d’étapes, il obtient un score environ 20 fois supérieur sur Breakout, s’approche d’Asterix et atteint environ 60% du score sur Seaquest.
Construire un joueur de Go
Les réseaux de jeu ci-dessus étaient assez petits pour qu’Astra en tape les poids en une réponse. Pour le Go, les chercheurs ont corsé l’exercice avec un réseau d’environ 1,5 million de poids. C’est bien trop grand pour tenir dans le prompt d’Astra.
Ils ont donc fourni à Astra un espace de travail Python où il pouvait consulter et enregistrer les poids (tous nuls au départ) mais pas exécuter le réseau. Pour tester son réseau, il devait dépenser l’un d’un nombre limité d’essais, de 0 à 50, où chaque essai jouait 128 parties sur un plateau 9×9.
Astra a aussi construit ce réseau comme un programme de Go :
- Les premières couches marquent l’emplacement des pierres de chaque joueur.
- Les couches intermédiaires suivent les chaînes de pierres connectées pour repérer les groupes en danger.
- La dernière couche note chaque coup possible. Capturer des pierres ou sauver ses propres groupes rapporte des points, les erreurs évidentes en font perdre.
Vous vous dites peut-être que cela ressemble beaucoup à un compilateur, et vous auriez raison. C’est très proche de ce que fait Tracr de DeepMind : transformer un programme en poids exacts de transformer. La différence, c’est que Tracr exige un langage spécifique pour écrire le programme, tandis qu’Astra conçoit lui-même le programme à partir d’un objectif en langage naturel.
Pourquoi le test change autant la donne
À ce stade, vous avez sans doute remarqué que les règles varient d’une expérience à l’autre. Dans les expériences d’identification de jeux, de formes, de la voiture et de MinAtar, Astra n’avait aucun outil, tandis que dans les expériences de langue, de Go, du people-pleaser et de Qwen, il pouvait utiliser Python et parfois tester le réseau.
À mon avis, c’est la partie la plus sous-estimée du billet : le nombre d’essais semble faire une grande différence :
- Go : avec zéro essai, le réseau d’Astra a gagné plus de la moitié de ses parties contre deux réseaux entraînés plus petits. Avec 50 essais, il a battu un réseau entraîné de même taille ayant appris sur 20 millions de parties.
- Qwen : avec 10 ou 25 essais, les boucles persistaient majoritairement. Le grand saut n’apparaît qu’à 50. Ce sont des runs uniques rapportés ; voyez-y un signal suggestif plus qu’une preuve.
- Le people-pleaser (un indice supplémentaire plutôt que des essais, mais effet similaire) : à partir des seuls poids, échec à chaque fois ; avec un indice sur l’attention, 3 paires sur 3 réussies.
Les résultats sans outil sont donc les plus surprenants, mais cela signifie aussi qu’on ne peut pas comparer équitablement toutes les expériences entre elles.
On retrouve un motif commun à toutes les techniques : Astra travaille beaucoup comme le ferait un ingénieur.
- Planifier le programme. Il décide d’abord du rôle de chaque couche, par exemple « déterminer où la balle va atterrir ».
- Traduire le plan en nombres. Il choisit ensuite des poids qui font réaliser ce rôle à chaque couche.
- Changer le minimum nécessaire. En corrigeant un réseau, il ajoute ou retire un élément limité, comme le raccourci de la voiture ou le curseur caché de Qwen.
- Tester (si autorisé). S’il dispose d’essais, il observe comment son réseau échoue et ne garde que les changements qui aident.
Programmation dans l’espace des poids vs fine-tuning et édition de modèles
Vous vous demandez peut-être en quoi cela diffère du fine-tuning ou d’autres méthodes d’édition de modèles. Le tableau ci-dessous compare les méthodes proches et indique à quelle technique elles ressemblent le plus :
| Méthode | Comment les poids changent | Faut-il des données d’entraînement ? | À quoi ça sert | Technique la plus proche |
|---|
| Fine-tuning / LoRA | Un algorithme d’entraînement ajuste de nombreux poids | Oui | Apprendre à un modèle une nouvelle tâche ou un style | Aucune |
| ROME | Une mise à jour mathématique petite et ciblée | Quelques exemples | Changer un fait isolé appris par le modèle | Technique 3 |
| Task arithmetic | Addition ou soustraction de poids de « compétence » | Oui | Combiner ou retirer des compétences fine-tunées | Technique 4 |
| Abliteration | Suppression d’une direction | Quelques centaines de prompts | Retirer un comportement, comme le refus | Technique 4 |
| Weight Oracles | Rien, il ne fait que lire | Oui, pour l’entraîner | Détecter des problèmes cachés via les poids | Techniques 1 et 2 |
| Programmation dans l’espace des poids | Un LLM raisonne et édite | Non | Lire, corriger et écrire des poids à partir d’un objectif en langage naturel | Toutes 5 |
Quelques précisions :
- ROME a montré dès 2022 que des faits comme « la Space Needle est à Seattle » sont stockés dans des couches spécifiques et peuvent être modifiés avec une petite mise à jour.
- Task arithmetic a montré que si l’on prend un modèle fine-tuné et qu’on lui soustrait le modèle d’origine, on obtient un ensemble de poids « compétence » que l’on peut ajouter à (ou retirer d’) d’autres modèles.
- Weight Oracles est le plus proche parent. C’est un papier d’octobre 2026 qui entraîne des modèles de langue spécifiquement à lire les poids d’autres réseaux et à repérer des problèmes comme des portes dérobées, en preuve de concept sur des transformers jouets.
La grande différence avec Weight Oracles, c’est qu’ils sont entraînés pour ce seul travail, alors que la programmation dans l’espace des poids exploite un LLM standard, prêt à l’emploi.
À mon sens, la nouveauté n’est pas que l’on puisse éditer des poids — on le sait depuis des années —, mais qu’un modèle généraliste ait géré toutes ces tâches simplement en raisonnant.
Limites de la programmation dans l’espace des poids
Même si ces résultats sont enthousiasmants, il faut les lire avec prudence. Les auteurs eux-mêmes parlent de « résultats très préliminaires ». Voici les principales réserves soulevées :
1. C’est de la correction, pas de l’amélioration
Comme le montre le contrôle Gemma, le grand saut de Qwen vient surtout de l’arrêt des boucles. Une analyse des journaux des auteurs, rapportée par XenoSpectrum, a compté 579 problèmes d’entraînement non vus que Qwen a résolus après l’édition ; parmi eux, 576 avaient auparavant été coupés par la limite de tokens.
2. Un seul LLM de pointe a été testé
Toutes les expériences du billet ont utilisé GPT-6 Astra. Simon Willison a depuis reproduit la tâche d’identification de jeu sur son ordinateur portable avec Qwen 3.8 27B (poids ouverts), bien qu’il ait manqué un des jeux. La question de savoir si d’autres modèles de pointe égalent Astra sur les expériences de réparation et d’écriture devrait trouver réponse avec le benchmark prévu par les auteurs.
3. Pas de relecture par les pairs
Il s’agit d’un billet de blog et non d’un article publié. Les auteurs ont publié des journaux complets, et Ahsen Khaliq de Hugging Face a reconstruit le modèle Qwen édité à partir de ceux-ci et relancé l’évaluation, qui, selon les auteurs, a atteint 51,0% sur MATH-500, avec 31,6% des réponses atteignant encore la limite. C’est une vérification utile du checkpoint publié, mais pas une réplication indépendante d’Astra réalisant l’édition.
4. Des résultats possiblement favorables
Certains notent que des essais de prompt antérieurs ne figurent pas dans les résultats rapportés et que l’effort de raisonnement d’Astra a varié entre expériences. Je n’ai pas non plus trouvé de test de sensibilité à de légères variations de formulation du prompt.
5. Coût inconnu
La meilleure exécution de Qwen a pris 158 tours de conversation et 20,3 heures, dont 4,7 perdues à cause d’une panne de service. Le billet ne compare pas cela à un fine-tuning classique, on ne peut donc pas dire si cela fait gagner du temps ou de l’argent.
6. Des comparaisons un peu généreuses
Les résultats de jeux sont comparés à des réseaux entraînés, mais pas à du code simple écrit à la main. Un joueur de Breakout qui suit juste la balle n’est pas si difficile à coder en dur, donc battre un réseau entraîné là-dessus est moins étonnant qu’il n’y paraît. Les auteurs répondent que chaque baseline ne teste que l’assertion étroite de son expérience : par exemple, jusqu’où on va sans aucune expérience.
Pour être juste, les auteurs ont été très transparents sur ce qui n’a pas fonctionné, y compris le people-pleaser et Gemma, ce que j’apprécie. Mais je traiterais les chiffres phares comme un signal prometteur plutôt que la preuve que cela marche en général.
Applications de la programmation dans l’espace des poids
Malgré ces limites, il est stimulant d’imaginer la suite si les progrès continuent. Voici les applications possibles mentionnées par les auteurs :
| Application | À quoi cela pourrait ressembler |
|---|
| Vérifier des modèles sans les tester | Détecter des problèmes cachés, comme des backdoors, en lisant les poids avant toute mise en production. |
| Construire des modèles à moindre coût | Poser un bon réseau d’un seul tenant, au lieu de collecter beaucoup de données et lancer de longs entraînements. |
| Ajouter ou retirer des compétences sans données | Demander à un LLM de retirer directement une compétence d’un modèle. Comme seuls quelques poids changent, le reste du modèle reste stable, évitant l’oubli catastrophique fréquent en fine-tuning. |
| Mixer différents modèles | Transférer un module utile, comme un module de raisonnement, d’un modèle vers un autre très différent. Les méthodes de fusion actuelles ne marchent que si les architectures sont identiques. |
| Une IA qui s’améliore elle-même | Un modèle qui lit et améliore ses propres poids, plutôt que d’écrire seulement du code lançant des entraînements. |
Ce dernier point explique pourquoi tout le monde n’est pas enthousiaste. Maxime Fournes, CEO de PauseAI, a qualifié cette direction de recherche de dangereuse, car de vrais progrès pourraient accélérer des développements IA risqués. Je précise toutefois que ce billet ne montre aucune forme d’auto-amélioration.
Il y a aussi un angle sécurité plus positif. Si les LLM peuvent fiablement repérer des comportements comme l’obséquiosité ou des backdoors rien qu’en lisant les poids, cela pourrait devenir un moyen utile de vérifier les modèles avant leur diffusion.
Et maintenant ?
Les auteurs indiquent qu’ils construisent un benchmark pour mesurer l’aptitude de différents LLM à cette tâche, avec un harnais pour les y aider. Parmi les questions à l’étude :
- D’autres LLM en sont-ils capables, ou Astra a-t-il quelque chose de particulier ?
- Peut-on un jour ajouter de vraies nouvelles compétences, ou seulement retirer des problèmes comme les boucles ?
- Est-ce que cela marchera sur des modèles bien plus gros avec des milliers de fois plus de poids ?
- Est-ce que ce sera un jour moins coûteux que le fine-tuning classique ?
Les choses ont bougé vite depuis la publication. Dans une mise à jour du 12 novembre, les auteurs mentionnent plus d’une centaine de réplications et extensions, y compris vers des politiques robotiques et des circuits quantiques, et un benchmark nommé IWIBench.
Si vous voulez explorer par vous-même, vous pouvez consulter les journaux complets de chaque expérience sur GitHub, incluant chaque prompt envoyé à Astra et un résumé de son raisonnement. Le modèle Qwen corrigé est aussi sur Hugging Face avec une démo en direct à essayer dans votre navigateur, lien depuis le billet original.
Conclusion
La programmation dans l’espace des poids est une idée nouvelle appuyée par des indices préliminaires. Un LLM prêt à l’emploi, sans aucun entraînement, a réussi à lire ce que font de petits réseaux, à débloquer une voiture et un modèle de langue qui bouclait, et même à construire des réseaux joueurs à partir de rien.
Ce qui m’a le plus surpris, c’est comment il s’y est pris. Pas de tour de magie obscur : lecture des bords des réseaux, recherche de circuits, ajout de raccourcis, suppression de directions et planification de programmes avant de les traduire en nombres — exactement comme le ferait un ingénieur.
Mais je rappelle qu’il s’agit d’un premier rapport fondé sur un seul modèle, et que le plus gros résultat vient d’un bug corrigé plutôt que d’une hausse intrinsèque d’aptitudes. Si la méthode progresse, l’usage le plus utile sera sans doute l’audit et le débogage des modèles, pas le remplacement de l’entraînement.
Pour renforcer vos bases et suivre ce type de recherches, notre cours Large Language Models (LLMs) Concepts explique le fonctionnement interne de ces modèles. Et si la partie agents vous intéresse, Introduction to AI Agents est une excellente suite.








Imaginez que je prenne votre chanson préférée, que j’imprime le fichier audio sous forme d’une longue liste de nombres et que je vous la donne. Pourriez-vous dire de quelle chanson il s’agit rien qu’en regardant les nombres ?
La chanson est bien là, mais elle est dissimulée dans des milliers de valeurs qui, prises isolément, ne nous disent rien.
Les réseaux de neurones ont exactement le même problème. Tout ce qu’un réseau sait est stocké dans ses poids, qui ne sont que des nombres.
Depuis les débuts du deep learning, nous avons été incapables de regarder ces nombres et d’affirmer avec certitude que tel réseau joue à Breakout ou que tel autre réalise une tâche précise. Nous n’avons jamais non plus su écrire ces nombres nous-mêmes pour autre chose qu’un minuscule réseau jouet. Cette mission a toujours été laissée à l’entraînement.
Le 2 novembre 2026, une équipe du MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) a montré qu’un grand modèle de langage de pointe (LLM), GPT-6 Astra d’OpenAI, pouvait faire les deux. Il peut examiner les poids bruts d’un réseau, comprendre ce qu’il fait, trouver ce qui cloche et même écrire un réseau entièrement nouveau à partir de zéro, le tout sans aucun entraînement. Les auteurs, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, appellent cela la programmation dans l’espace des poids (Weight-Space Programming) dans leur article de blog original.
Dans cet article, je veux donc me concentrer sur comment cela fonctionne concrètement. J’ai tout organisé par technique utilisée par le LLM plutôt que par expérience. Si vous voulez d’abord un tour d’horizon des résultats, consultez notre vue d’ensemble de la programmation dans l’espace des poids.
Si vous souhaitez un rappel sur le fonctionnement des LLM et de l’architecture transformer sur laquelle ils reposent avant d’entrer dans les techniques, notre cours Introduction aux LLM en Python couvre les bases, ce qui aide lorsque nous examinons les modèles qui lisent et écrivent des poids.
En bref
Voici ce que nous allons couvrir :
Qu’est-ce que la programmation dans l’espace des poids ?
La programmation dans l’espace des poids consiste à traiter les poids d’un réseau de neurones comme un programme : un LLM généraliste lit et écrit les poids directement en raisonnant sur le rôle de chaque partie du réseau, plutôt que de s’appuyer sur un algorithme d’entraînement comme la descente de gradient.
Pour le dire simplement, le LLM ouvre le réseau, regarde lui-même les nombres et les modifie à dessein.
Je le vois comme la différence entre dresser un chien et re-câbler un chien-robot. Dresser, c’est montrer beaucoup d’exemples en espérant que le comportement change peu à peu, tandis que re-câbler, c’est entrer à l’intérieur, trouver la pièce responsable et la modifier directement.
Ce n’est pas la même chose qu’un LLM qui vous écrit un script d’entraînement, ce qu’ils savent faire depuis un moment. Ici, il n’y a aucun script d’entraînement, et le LLM travaille avec les nombres eux-mêmes.
Les auteurs insistent : la programmation dans l’espace des poids est un concept plus qu’une méthode unique, et elle n’exclut pas l’usage des gradients. Ils ont interdit les gradients dans ces expériences pour isoler ce que le raisonnement seul peut accomplir.
Le billet teste l’idée de 3 façons, qui me semblent les plus simples pour tout comprendre (voir figure 1) :
Figure 1 : les 3 compétences testées dans le billet. Image de l’auteur.
Le LLM qui fait tout cela est GPT-6 Astra, lancé par OpenAI le 3 septembre 2026. Dans quelques expériences, les chercheurs ont désactivé tous ses outils (y compris la recherche web et l’exécution de code), de sorte qu’il ne pouvait que lire les nombres et réfléchir.
Chacune de ces 3 compétences s’appuie sur ses propres techniques, et c’est l’objet du reste de l’article.
Comment crée-t-on normalement les poids d’un réseau de neurones ?
Avant d’entrer dans les techniques, il est utile de rappeler comment les poids sont généralement créés. Sinon, il est difficile de comprendre pourquoi ces travaux surprennent autant.
Un rappel sur l’entraînement
Un réseau de neurones est un immense ensemble de nombres appelés poids (ou paramètres). Quand vous lui donnez une entrée, comme une image ou une phrase, il multiplie et additionne ces nombres pour produire une sortie. C’est ce qu’on appelle une propagation avant.
L’entraînement consiste à choisir de bonnes valeurs pour ces nombres. La méthode standard est la descente de gradient : on exécute le réseau, on mesure l’erreur de sa réponse, on détermine dans quelle direction chaque poids doit bouger pour la réduire un peu, puis on déplace chaque poids d’un infime montant. On répète cela des millions de fois, d’où le coût élevé de l’entraînement.
Les quatre façons d’écrire des poids
Chaque réseau de neurones que vous avez utilisé a vu ses poids choisis par quelque chose. Jusqu’ici, ce quelque chose relevait de l’une de ces 4 catégories :
AdderBoard est un cas atypique. C’est un défi communautaire visant à construire le plus petit transformer capable d’additionner deux nombres à 10 chiffres, et certains ont été construits à la main avec moins d’une douzaine de valeurs de poids distinctes. On est très loin de l’échelle d’un modèle comme ChatGPT.
La programmation dans l’espace des poids ajoute une cinquième option : un LLM généraliste qui raisonne sur les poids.
Figure 2 : entraînement classique comparé à la programmation dans l’espace des poids. Image de l’auteur.
Pourquoi ne peut-on pas simplement lire les poids ?
Si les poids ne sont que des nombres, pourquoi est-il si difficile de les lire ? Deux raisons principales.
Premièrement, un réseau ne stocke pas une idée en un seul endroit. Une idée est généralement répartie sur de nombreux neurones, et un seul neurone contribue souvent à plusieurs idées à la fois.
Deuxièmement, un même réseau peut s’écrire de multiples façons. Vous pouvez permuter l’ordre des neurones dans une couche, ajuster la suivante en conséquence, et le réseau se comportera exactement de la même manière. Ainsi, deux réseaux qui font le même travail peuvent avoir des poids qui semblent très différents.
Gardez ces deux problèmes en tête, car chaque technique ci-dessous vise essentiellement à les contourner.
Pourquoi la programmation dans l’espace des poids est une avancée importante
Ce billet a attiré autant d’attention parce qu’il prolonge une tendance de fond. Ces dernières années, nous avons demandé aux LLM d’améliorer de plus en plus de choses par eux-mêmes :
Figure 3 : ce que nous avons demandé aux LLM d’améliorer au fil du temps. Image de l’auteur.
Remarquez que tout cela est du texte, des éléments que les humains peuvent aussi modifier à la main, comme des prompts et des fichiers Python. Les auteurs soulignent que nous n’avons utilisé les LLM sur du texte que parce que nous n’avions pas de meilleure méthode pour l’améliorer. Pour les poids, nous avions déjà la descente de gradient, donc personne n’a vraiment pensé à demander.
Ce billet explore ce qui se passe si l’on saute entièrement le script d’entraînement et qu’on laisse le LLM modifier lui-même les poids.
Compétence 1 : comment un LLM lit les poids d’un réseau (techniques 1 et 2)
Les chercheurs ont commencé avec des réseaux assez petits pour coller tous leurs poids en texte brut dans le prompt d’Astra, puis sont passés à des modèles plus grands qu’Astra a analysés avec Python. Astra a utilisé deux techniques principales pour les lire.
Technique 1 : lire la structure via les poids d’entrée et de sortie
À mon sens, le plus simple pour commencer est de lire aux bords du réseau. La première couche est directement reliée à l’entrée (par exemple, les pixels d’un écran) et la dernière couche directement à la sortie (par exemple, les actions possibles d’un joueur). Ce sont les seules couches où l’on sait à quoi chaque nombre est connecté.
À quel jeu ce réseau joue-t-il ?
Les chercheurs ont entraîné 4 petits réseaux avec Proximal Policy Optimization (PPO), un algorithme d’apprentissage par renforcement, pour jouer à des versions en grille 10×10 simplifiées de Breakout, Pong, Pac-Man et Freeway.
L’astuce, c’est que les 4 réseaux avaient exactement la même taille (17 253 poids chacun), prenaient les mêmes entrées et pouvaient effectuer les mêmes mouvements. La seule façon de les distinguer était donc de lire les nombres.
Ils ont collé les poids de chaque réseau dans Astra et ont demandé : « Quel jeu a été appris par ce réseau ? » sans lui donner de liste d’options. Astra a tout de même nommé le bon jeu pour les 4 réseaux.
Figure 4 : Astra lit les poids bruts et identifie Breakout. Image de l’auteur.
Ce qui m’a frappé, c’est comment il a déduit cela. Pour le réseau Breakout, son raisonnement ressemblait à ceci :
En combinant ces indices, on retrouve Breakout. Les deux premiers viennent des poids d’entrée et le dernier des poids de sortie, ce qui illustre parfaitement cette technique.
Quelle forme ce modèle dessine-t-il ?
Ensuite, les chercheurs ont entraîné de petits modèles de génération d’images (des modèles de diffusion, la même famille que la plupart des générateurs d’images IA) à dessiner des cercles, triangles ou carrés. Là encore, Astra n’a reçu que les poids, sans outils et sans possibilité d’exécuter les modèles, et il a nommé la bonne forme pour chacun.
Il y a eu une erreur singulière : Astra a décrit chaque forme comme un contour, alors que les modèles dessinent des formes pleines. Les chercheurs y voient un bon signe, car cela suggère qu’Astra lisait les bords de la forme encodés dans les poids plutôt que d’« exécuter » mentalement tout le modèle.
Technique 2 : trouver des circuits dans les couches intermédiaires
Dans les deux premières expériences, Astra pouvait se contenter de lire uniquement la première ou la dernière couche du réseau. Cela ne fonctionne pas pour les modèles de langue réels, où l’essentiel du raisonnement se produit dans les couches intermédiaires.
C’est là qu’intervient la deuxième technique : repérer des circuits. Un circuit est un petit groupe d’éléments internes qui collaborent pour accomplir une tâche précise. Si vous identifiez ce qu’il fait, vous pouvez en déduire beaucoup de choses sans connaître les entrées.
Quelle langue ce modèle a-t-il apprise ?
Pour tester cela, les chercheurs ont entraîné 3 petits modèles de langue (environ 7,2 millions de poids chacun) :
Ils ont ensuite coupé les couches d’entrée et de sortie de chaque modèle, ne laissant que 4 blocs intermédiaires. Sans ces couches, rien ne dit quel nombre correspond à quelle lettre, le modèle ne peut même pas être exécuté sur du texte, et la technique 1 est hors jeu.
Astra était autorisé à analyser les nombres avec Python, mais pas à exécuter le modèle. Il a tout de même nommé la bonne langue pour les 3 modèles lors de ses deux tentatives, avec une confiance d’environ 50 à 60% chaque fois.
Comment a-t-il repéré Python ? En cherchant des induction heads.
Les induction heads sont des parties d’un transformer qui remarquent quand un motif est apparu plus tôt dans le texte et copient ce qui suivait, par exemple compléter « tot » en « total » parce que « total » figurait plus haut. Le code répète beaucoup plus les noms de variables que l’écrit courant, donc un modèle Python en a besoin de davantage. Astra les a tous trouvés sans en étiqueter d’autres à tort.
Astra les a identifiés en multipliant entre elles les matrices de poids de différentes têtes pour voir quelles têtes « communiquent ». Cela correspond à une technique du papier de 2021 A Mathematical Framework for Transformer Circuits, que les chercheurs ne lui avaient jamais mentionnée.
Pour le romaji, Astra a remarqué que le modèle semblait avoir moins de lettres à gérer. C’est exact, le romaji n’utilise jamais des lettres comme q, l, v ou x.
Où la lecture cale : quel modèle est le « people-pleaser » ?
Voici où ces deux techniques s’arrêtent. C’est l’unique expérience qui n’a pas fonctionné d’emblée.
Les chercheurs ont pris deux copies de Gemma 3 270M de Google et les ont fine-tunées de manière identique, à un détail près. L’une apprend à donner la bonne réponse, l’autre devient obséquieuse (sycophantic), c’est-à-dire qu’elle donne toujours la réponse suggérée par l’utilisateur. Ils ont aussi gelé les couches d’entrée et de sortie, pour empêcher Astra de prendre le raccourci de les inspecter. Exemple illustratif :
À partir des seuls poids, Astra n’a pas su dire quel modèle était obséquieux lors de ses 4 essais. Il a trouvé de nombreuses différences entre les deux modèles sans pouvoir les relier au comportement.
Les chercheurs lui ont donc donné un indice supplémentaire. Ils ont laissé Astra voir où chaque tête d’attention regardait pendant que les modèles lisaient un texte qu’Astra écrivait lui-même (mais pas leurs réponses effectives). Avec cela, Astra a correctement repéré le « people-pleaser » dans les 3 paires de modèles.
Il a même localisé l’origine de la différence. Dans la tête d’attention 10.2, le modèle honnête portait 94,3% de son attention sur les nombres de la question, tandis que le people-pleaser consacrait 85,7% de son attention à la réponse suggérée par l’utilisateur.
Je souligne ce point car, à mon avis, c’est le résultat le plus important du billet. Il montre que déduire un comportement à partir des seuls poids est encore très difficile sur un vrai modèle de langue, même pour un modèle de pointe comme GPT-6 Astra.
Compétence 2 : comment un LLM corrige des poids (techniques 3 et 4)
Lire les poids est impressionnant, mais les corriger est un pas plus grand et plus complexe. Astra doit comprendre ce que fait le réseau, déterminer ce qu’il devrait faire, puis modifier les bons nombres pour combler l’écart. Il a utilisé deux techniques très différentes.
Technique 3 : ajouter un petit circuit de raccourci
Cette technique laisse la majeure partie du réseau intacte et ajoute un petit circuit qui ne s’active que dans la situation précise où le réseau d’origine échoue.
La voiture qui se bloque sans cesse
Pour cette expérience, les chercheurs ont utilisé un jeu de physique 2D nommé Kinetix et entraîné un réseau avec PPO pour faire monter une voiture sur une rampe. La voiture doit d’abord reculer pour prendre assez d’élan, puis seulement accélérer vers l’avant.
Le réseau entraîné ne l’a jamais compris. Il fonçait droit vers la rampe et se bloquait, à chaque fois.
Les chercheurs ont donc donné à Astra trois éléments :
En une seule tentative, sans outils, Astra a expliqué pourquoi la voiture échouait et a écrit de nouveaux poids. Après la modification, la voiture a réussi les 1 024 épisodes de test (contre 0 auparavant), et Astra n’avait modifié que 3,5% des poids.
Astra n’a pas réécrit tout le réseau. Il a ajouté un petit raccourci via quelques neurones à chaque couche, qui prend la main au début, fait reculer la voiture et la lance vers l’avant. Une fois la zone rouge dépassée, le raccourci se coupe et le réseau initial conduit le reste du trajet.
J’aime l’image de l’instructeur qui saisit le volant sur un passage délicat puis le rend immédiatement à l’élève. Cela fonctionne parce que le réseau d’origine n’était pas entièrement défaillant. Il savait déjà conduire, mais butait sur un moment précis ; il était donc logique de ne rien toucher au reste.
Technique 4 : identifier et supprimer une direction
Cette technique part de l’idée qu’un comportement peut être encodé le long d’une seule direction dans le modèle ; on peut donc l’éteindre en supprimant cette direction des poids.
Le modèle qui se répétait en boucle
Voici l’expérience qui a fait le tour des réseaux, regardons-la de plus près.
Les chercheurs ont pris Qwen3.5-0.8B, un petit modèle de raisonnement open source, et ont demandé à Astra de le rendre meilleur en maths en éditant uniquement ses poids. Cette fois, Astra disposait d’un notebook Python avec le modèle chargé et pouvait exécuter le modèle sur des problèmes d’entraînement en nombre limité (10, 25 ou 50 exécutions de test, que les auteurs appellent des passes avant). Mais toujours aucun entraînement autorisé.
Astra a rapidement constaté que le modèle se coinçait en boucle, répétant les mêmes mots sans jamais conclure. En fait, 85 de ses 96 premières réponses d’essai continuaient jusqu’à atteindre la limite de 32 768 tokens.
C’est un problème bien connu des petits modèles de raisonnement, et la fiche du modèle Qwen elle-même en avertit. Un article de décembre 2025, « Wait, Wait, Wait… Why Do Reasoning Models Loop? », a montré que les modèles plus petits bouclent davantage que les plus gros d’une même famille, et que les petits modèles distillés d’un plus grand bouclent encore plus.
Astra a retracé la cause des boucles à un motif caché dans le modèle, qu’on appelle une direction. Si cela aide, voyez une direction comme un curseur interne. Ici, le curseur poussait le modèle à se répéter, et il se trouvait dans les couches 15 et 19.
Astra a alors simplement supprimé ce curseur de 131 072 poids (64 colonnes de sortie dans chacune de ces 2 couches), soit seulement 0,016% du modèle complet.
Un mot sur les maths
La correction de Qwen est très proche d’une astuce connue appelée abliteration. En 2024, des chercheurs ont montré que l’habitude d’un modèle de refuser des requêtes est contrôlée par une seule direction, et qu’on peut supprimer cette direction des poids pour l’empêcher de refuser.
La formule tient en une ligne, où
rest la direction unitaire à supprimer :W_new = W - r (rᵀ W)Pour clarifier, voici un minuscule exemple. Imaginez un poids composé de 2 parties,
(3, 2). Le premier nombre mesure combien il pousse vers la boucle, le second regroupe tout le reste.Notre direction de boucle est
r = (1, 0), c’est-à-dire « le premier nombre ». La formule retire la partie boucle (3) et nous laisse(0, 2). La composante en boucle est partie, le reste est intact.L’essentiel, c’est qu’Astra a trouvé cette direction de boucle tout seul, en raisonnant sur les poids et en exécutant le modèle sur des problèmes d’essai, alors que l’abliteration nécessite quelques centaines de prompts d’exemple pour l’identifier. Voici les résultats plus en détail (pour les 8 expériences côte à côte, voir notre aperçu de la programmation dans l’espace des poids) :
Figure 5 : Qwen3.5-0.8B avant et après l’édition d’Astra. Image de l’auteur.
Deux points à noter. D’abord, la boucle n’est pas qu’un problème de maths ; la correction a aussi nettement amélioré l’exécution d’instructions (IFEval est passé de 21,0% à 62,3% dans la version à 50 essais). Ensuite, avec 10 ou 25 essais, les boucles restaient majoritairement ; le grand saut n’apparaît qu’à 50.
Où la correction cale : corriger n’est pas améliorer
Voici un point que tout lecteur devrait garder en tête. Arrêter les boucles n’est pas la même chose que rendre un modèle meilleur en maths. Cela permet surtout de terminer des réponses que le modèle savait déjà amorcer.
Pour le vérifier, les chercheurs ont reproduit l’expérience sur Gemma 3 270M, un petit modèle qui boucle rarement (seulement 8,5% de ses réponses atteignent la limite, contre 93% pour Qwen). Cette fois, Astra n’a pas vraiment pu l’améliorer. Sur MATH-500, aucune édition n’a fait bouger le score de plus d’un point environ, et Astra lui-même juge le gain non établi.
Quand Astra a regardé où Gemma se trompait, il a trouvé des erreurs classiques : mauvaises opérations, étapes d’algèbre incorrectes. Il n’y avait pas de pièce unique à désactiver, donc la technique 4 n’avait rien à exploiter.
En bref, éditer des poids peut retirer un obstacle qui masquait une compétence, mais ne peut pas ajouter une compétence que le modèle ne possède pas.
Compétence 3 : comment un LLM écrit des poids (technique 5)
Voici maintenant la partie qui m’a le plus surpris. Ici, Astra part d’un réseau où tous les poids sont à zéro et doit choisir tous les nombres lui-même.
Technique 5 : planifier un programme et le traduire en nombres
La technique est simple à décrire. Astra planifie d’abord un programme, en décidant le rôle de chaque couche, puis choisit des poids qui font exécuter ce rôle à chaque couche.
Les chercheurs ont utilisé MinAtar, un ensemble de versions simplifiées des jeux Atari, et ont choisi Breakout, Seaquest et Asterix. Pour chaque jeu, Astra a reçu :
Il n’avait aucune donnée d’entraînement, aucun outil et même pas le droit de tester son réseau dans le jeu. Il a simplement tapé l’ensemble des poids dans une seule réponse, puis les chercheurs ont testé le résultat.
Pour Breakout, par exemple, le plan était :
Comme vous le voyez, les réseaux d’Astra battent ceux entraînés 100 millions d’étapes dans les 3 jeux. Face aux réseaux entraînés 500 millions d’étapes, il obtient un score environ 20 fois supérieur sur Breakout, s’approche d’Asterix et atteint environ 60% du score sur Seaquest.
Construire un joueur de Go
Les réseaux de jeu ci-dessus étaient assez petits pour qu’Astra en tape les poids en une réponse. Pour le Go, les chercheurs ont corsé l’exercice avec un réseau d’environ 1,5 million de poids. C’est bien trop grand pour tenir dans le prompt d’Astra.
Ils ont donc fourni à Astra un espace de travail Python où il pouvait consulter et enregistrer les poids (tous nuls au départ) mais pas exécuter le réseau. Pour tester son réseau, il devait dépenser l’un d’un nombre limité d’essais, de 0 à 50, où chaque essai jouait 128 parties sur un plateau 9×9.
Astra a aussi construit ce réseau comme un programme de Go :
Vous vous dites peut-être que cela ressemble beaucoup à un compilateur, et vous auriez raison. C’est très proche de ce que fait Tracr de DeepMind : transformer un programme en poids exacts de transformer. La différence, c’est que Tracr exige un langage spécifique pour écrire le programme, tandis qu’Astra conçoit lui-même le programme à partir d’un objectif en langage naturel.
Pourquoi le test change autant la donne
À ce stade, vous avez sans doute remarqué que les règles varient d’une expérience à l’autre. Dans les expériences d’identification de jeux, de formes, de la voiture et de MinAtar, Astra n’avait aucun outil, tandis que dans les expériences de langue, de Go, du people-pleaser et de Qwen, il pouvait utiliser Python et parfois tester le réseau.
À mon avis, c’est la partie la plus sous-estimée du billet : le nombre d’essais semble faire une grande différence :
Les résultats sans outil sont donc les plus surprenants, mais cela signifie aussi qu’on ne peut pas comparer équitablement toutes les expériences entre elles.
Comment GPT-6 Astra s’y prend concrètement
On retrouve un motif commun à toutes les techniques : Astra travaille beaucoup comme le ferait un ingénieur.
Programmation dans l’espace des poids vs fine-tuning et édition de modèles
Vous vous demandez peut-être en quoi cela diffère du fine-tuning ou d’autres méthodes d’édition de modèles. Le tableau ci-dessous compare les méthodes proches et indique à quelle technique elles ressemblent le plus :
Quelques précisions :
La grande différence avec Weight Oracles, c’est qu’ils sont entraînés pour ce seul travail, alors que la programmation dans l’espace des poids exploite un LLM standard, prêt à l’emploi.
À mon sens, la nouveauté n’est pas que l’on puisse éditer des poids — on le sait depuis des années —, mais qu’un modèle généraliste ait géré toutes ces tâches simplement en raisonnant.
Limites de la programmation dans l’espace des poids
Même si ces résultats sont enthousiasmants, il faut les lire avec prudence. Les auteurs eux-mêmes parlent de « résultats très préliminaires ». Voici les principales réserves soulevées :
1. C’est de la correction, pas de l’amélioration
Comme le montre le contrôle Gemma, le grand saut de Qwen vient surtout de l’arrêt des boucles. Une analyse des journaux des auteurs, rapportée par XenoSpectrum, a compté 579 problèmes d’entraînement non vus que Qwen a résolus après l’édition ; parmi eux, 576 avaient auparavant été coupés par la limite de tokens.
2. Un seul LLM de pointe a été testé
Toutes les expériences du billet ont utilisé GPT-6 Astra. Simon Willison a depuis reproduit la tâche d’identification de jeu sur son ordinateur portable avec Qwen 3.8 27B (poids ouverts), bien qu’il ait manqué un des jeux. La question de savoir si d’autres modèles de pointe égalent Astra sur les expériences de réparation et d’écriture devrait trouver réponse avec le benchmark prévu par les auteurs.
3. Pas de relecture par les pairs
Il s’agit d’un billet de blog et non d’un article publié. Les auteurs ont publié des journaux complets, et Ahsen Khaliq de Hugging Face a reconstruit le modèle Qwen édité à partir de ceux-ci et relancé l’évaluation, qui, selon les auteurs, a atteint 51,0% sur MATH-500, avec 31,6% des réponses atteignant encore la limite. C’est une vérification utile du checkpoint publié, mais pas une réplication indépendante d’Astra réalisant l’édition.
4. Des résultats possiblement favorables
Certains notent que des essais de prompt antérieurs ne figurent pas dans les résultats rapportés et que l’effort de raisonnement d’Astra a varié entre expériences. Je n’ai pas non plus trouvé de test de sensibilité à de légères variations de formulation du prompt.
5. Coût inconnu
La meilleure exécution de Qwen a pris 158 tours de conversation et 20,3 heures, dont 4,7 perdues à cause d’une panne de service. Le billet ne compare pas cela à un fine-tuning classique, on ne peut donc pas dire si cela fait gagner du temps ou de l’argent.
6. Des comparaisons un peu généreuses
Les résultats de jeux sont comparés à des réseaux entraînés, mais pas à du code simple écrit à la main. Un joueur de Breakout qui suit juste la balle n’est pas si difficile à coder en dur, donc battre un réseau entraîné là-dessus est moins étonnant qu’il n’y paraît. Les auteurs répondent que chaque baseline ne teste que l’assertion étroite de son expérience : par exemple, jusqu’où on va sans aucune expérience.
Pour être juste, les auteurs ont été très transparents sur ce qui n’a pas fonctionné, y compris le people-pleaser et Gemma, ce que j’apprécie. Mais je traiterais les chiffres phares comme un signal prometteur plutôt que la preuve que cela marche en général.
Applications de la programmation dans l’espace des poids
Malgré ces limites, il est stimulant d’imaginer la suite si les progrès continuent. Voici les applications possibles mentionnées par les auteurs :
Ce dernier point explique pourquoi tout le monde n’est pas enthousiaste. Maxime Fournes, CEO de PauseAI, a qualifié cette direction de recherche de dangereuse, car de vrais progrès pourraient accélérer des développements IA risqués. Je précise toutefois que ce billet ne montre aucune forme d’auto-amélioration.
Il y a aussi un angle sécurité plus positif. Si les LLM peuvent fiablement repérer des comportements comme l’obséquiosité ou des backdoors rien qu’en lisant les poids, cela pourrait devenir un moyen utile de vérifier les modèles avant leur diffusion.
Et maintenant ?
Les auteurs indiquent qu’ils construisent un benchmark pour mesurer l’aptitude de différents LLM à cette tâche, avec un harnais pour les y aider. Parmi les questions à l’étude :
Les choses ont bougé vite depuis la publication. Dans une mise à jour du 12 novembre, les auteurs mentionnent plus d’une centaine de réplications et extensions, y compris vers des politiques robotiques et des circuits quantiques, et un benchmark nommé IWIBench.
Si vous voulez explorer par vous-même, vous pouvez consulter les journaux complets de chaque expérience sur GitHub, incluant chaque prompt envoyé à Astra et un résumé de son raisonnement. Le modèle Qwen corrigé est aussi sur Hugging Face avec une démo en direct à essayer dans votre navigateur, lien depuis le billet original.
Conclusion
La programmation dans l’espace des poids est une idée nouvelle appuyée par des indices préliminaires. Un LLM prêt à l’emploi, sans aucun entraînement, a réussi à lire ce que font de petits réseaux, à débloquer une voiture et un modèle de langue qui bouclait, et même à construire des réseaux joueurs à partir de rien.
Ce qui m’a le plus surpris, c’est comment il s’y est pris. Pas de tour de magie obscur : lecture des bords des réseaux, recherche de circuits, ajout de raccourcis, suppression de directions et planification de programmes avant de les traduire en nombres — exactement comme le ferait un ingénieur.
Mais je rappelle qu’il s’agit d’un premier rapport fondé sur un seul modèle, et que le plus gros résultat vient d’un bug corrigé plutôt que d’une hausse intrinsèque d’aptitudes. Si la méthode progresse, l’usage le plus utile sera sans doute l’audit et le débogage des modèles, pas le remplacement de l’entraînement.
Pour renforcer vos bases et suivre ce type de recherches, notre cours Large Language Models (LLMs) Concepts explique le fonctionnement interne de ces modèles. Et si la partie agents vous intéresse, Introduction to AI Agents est une excellente suite.