Stell dir vor, ich nehme deinen Lieblingssong, drucke die Audiodatei als lange Zahlenliste aus und gebe sie dir in die Hand. Könntest du nur anhand des Blicks auf die Zahlen erkennen, welcher Song das ist?
Der Song steckt definitiv darin, aber er ist in Tausenden von Werten versteckt, die für sich genommen nichts bedeuten.
Neuronale Netze haben genau dasselbe Problem. Alles, was ein Netz „weiß“, steckt in seinen Gewichten – und die sind schlicht Zahlen.
Solange es Deep Learning gibt, konnten wir diese Zahlen nicht anschauen und sicher sagen: Dieses Netz spielt Breakout oder jenes Netz erledigt eine bestimmte Aufgabe. Und wir konnten diese Zahlen auch nie selbst schreiben – außer für winzige Spielzeugnetze. Diese Aufgabe war immer dem Training überlassen.
Am 2. November 2026 zeigte ein Team am MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL), dass ein führendes Large Language Model (LLM), OpenAIs GPT-6 Astra, beides kann. Es kann die rohen Gewichte eines Netzes lesen, verstehen, was es tut, Defekte finden und sogar ein komplett neues Netz von Grund auf schreiben – alles ohne Training. Die Autorinnen und Autoren Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab nennen das in ihrem Originalbeitrag Weight-Space Programming.
In diesem Artikel geht es darum, wie das tatsächlich funktioniert. Ich ordne alles nach den Techniken, die das LLM verwendet hat – nicht nach Experimenten. Wenn du zuerst die Ergebnisse sehen willst, lies unsere Übersicht zu Weight-Space Programming.
Wenn du vorab auffrischen willst, wie LLMs und die Transformer-Architektur darunter funktionieren, deckt unser Kurs Introduction to LLMs in Python die Grundlagen ab – hilfreich, wenn wir uns Modelle anschauen, die Gewichte lesen und schreiben.
Kurz und bündig
- Weight-Space Programming behandelt die Gewichte eines Netzes wie ein Programm, das ein allgemeines LLM direkt lesen, bearbeiten und schreiben kann – ohne Gradientenabstieg oder Trainingsskript.
- In den MIT-CSAIL-Experimenten erkannte GPT-6 Astra, wofür kleine Netze trainiert wurden, reparierte eine Fahrpolicy, die sich festfuhr, und schrieb spielende Netze ausgehend von Nullgewichten.
- Der Eingriff in Qwen3.5-0.8B hob die MATH-500-Genauigkeit von 7,9% auf 48,1%. Eine Analyse der Logs der Autorinnen und Autoren führt fast den gesamten Gewinn darauf zurück, Denk-Schleifen zu stoppen.
- Das sind frühe Ergebnisse: ein Frontier-Modell, ein nicht peer-reviewter Blogpost und bisher teilweise unabhängige Checks.
Das behandeln wir:
- Was Weight-Space Programming eigentlich ist
- Wie neuronale Netzgewichte normalerweise entstehen
- Die 5 Techniken, mit denen das LLM Gewichte liest, fixt und schreibt
- Warum Tests so viel ausmachen
- Wie sich das von Fine-Tuning unterscheidet
- Welche Grenzen es gibt
- Warum manche das für einen großen Schritt halten
Was ist Weight-Space Programming?
Weight-Space Programming ist die Idee, die Gewichte eines neuronalen Netzes wie ein Programm zu behandeln: Ein allgemeines LLM liest und schreibt die Gewichte direkt, indem es darüber nachdenkt, was jeder Netzteil macht – statt sich auf einen Trainingsalgorithmus wie den Gradientenabstieg zu verlassen.
Ganz einfach gesagt: Das LLM öffnet das Netz, schaut sich die Zahlen selbst an und ändert sie gezielt.
Ich denke gerne an den Unterschied zwischen einen Hund trainieren und einen Roboterhund neu verkabeln. Training heißt: viele Beispiele zeigen und hoffen, dass sich das Verhalten langsam ändert. Neuverkabeln heißt: hineingehen, das zuständige Teil finden und es direkt ändern.
Das ist nicht dasselbe, wie wenn ein LLM dir ein Trainingsskript schreibt – das können LLMs schon lange. Hier gibt es gar kein Trainingsskript, das LLM arbeitet mit den tatsächlichen Zahlen.
Die Autorinnen und Autoren betonen, dass Weight-Space Programming ein Konzept und keine einzelne Methode ist – und dass es Gradienten nicht ausschließt. In den Experimenten wurden Gradienten gesperrt, um zu isolieren, was reines Reasoning kann.
Der Post prüft die Idee auf 3 Arten, was meines Erachtens das Verständnis erleichtert (siehe Abbildung 1):
- Lesen: Gewichte anschauen und sagen, was das Netz tut
- Fixen: Defekte in den Gewichten finden und reparieren
- Schreiben: Ein funktionierendes Netz ausgehend von lauter Nullen bauen
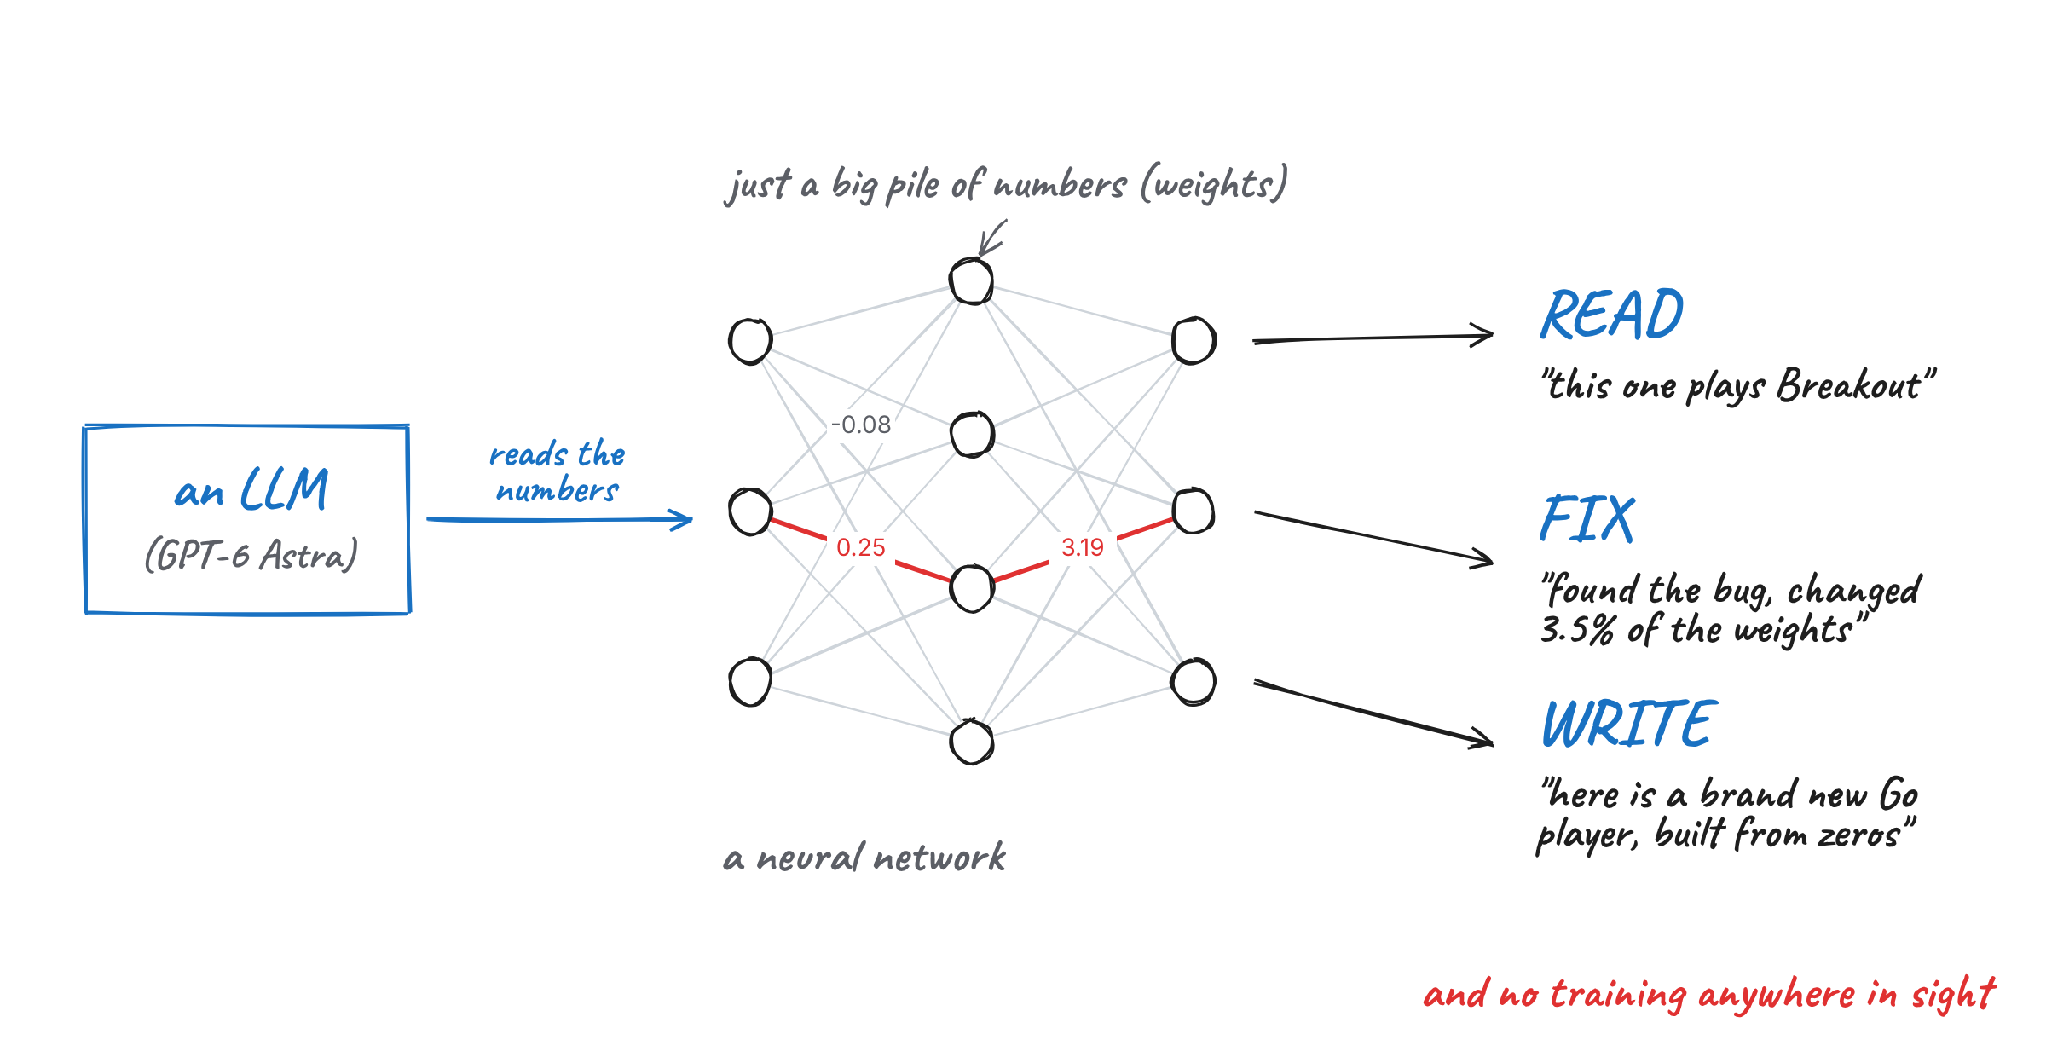
Abbildung 1: Die 3 getesteten Fähigkeiten. Bild: Autor.
Das LLM ist GPT-6 Astra, das OpenAI am 3. September 2026 veröffentlicht hat. In einigen Experimenten schalteten die Forschenden alle Tools ab (inklusive Websuche und Codeausführung), sodass Astra nur die Zahlen lesen und nachdenken konnte.
Jede dieser 3 Fähigkeiten nutzt eigene Techniken – darum geht es im Rest des Artikels.
Wie entstehen neuronale Netzgewichte normalerweise?
Bevor wir in die Techniken einsteigen, hilft es zu verstehen, wie Gewichte üblicherweise entstehen. Sonst ist schwer zu sehen, warum diese Forschung überrascht.
Ein kurzes Training-Refresh
Ein neuronales Netz ist eine riesige Sammlung von Zahlen, genannt Gewichte (oder Parameter). Gibst du dem Netz einen Input wie ein Bild oder einen Satz, werden diese Zahlen multipliziert und addiert, um einen Output zu erzeugen. Das nennt man einen Forward Pass.
Training heißt, gute Werte für diese Zahlen zu finden. Der Standardweg ist der Gradientenabstieg: Netz laufen lassen, den Fehler messen, für jedes Gewicht die Richtung berechnen, in die es den Fehler ein klein wenig reduziert, und dann jedes Gewicht minimal verschieben. Das wiederholt man Millionen Male – daher ist Training so teuer.
Die vier Wege, wie Gewichte geschrieben werden
Jedes neuronale Netz, das du je genutzt hast, hat seine Gewichte von irgendetwas „bekommen“. Bislang war dieses Etwas einer von 4 Wegen:
| Methode | Wie es funktioniert | Beispiel |
|---|
| Ein Optimierer | Nutzt Gradientenabstieg, um jedes Gewicht über Millionen Schritte minimal zu stupsen. So entstehen fast alle Modelle. | SGD, Adam, Muon |
| Ein anderes neuronales Netz | Ein Netz wird gezielt trainiert, um die Gewichte anderer Netze zu erzeugen. | Neural Network Diffusion |
| Ein Compiler | Ein Tool wandelt ein kleines Programm direkt in exakte Transformer-Gewichte um. | DeepMinds Tracr |
| Per Hand | Eine Person wählt jede Zahl selbst. Nur für extrem kleine Netze machbar. | AdderBoard |
AdderBoard ist ein Sonderfall: eine Community-Challenge, den kleinsten Transformer zu bauen, der zwei 10-stellige Zahlen addieren kann. Beiträge wurden von Hand mit weniger als einem Dutzend einzigartiger Gewichtswerte gebaut – weit entfernt von der Größenordnung eines Modells wie ChatGPT.
Weight-Space Programming ergänzt diese Liste um eine fünfte Option: ein allgemeines LLM, das über die Gewichte nachdenkt.
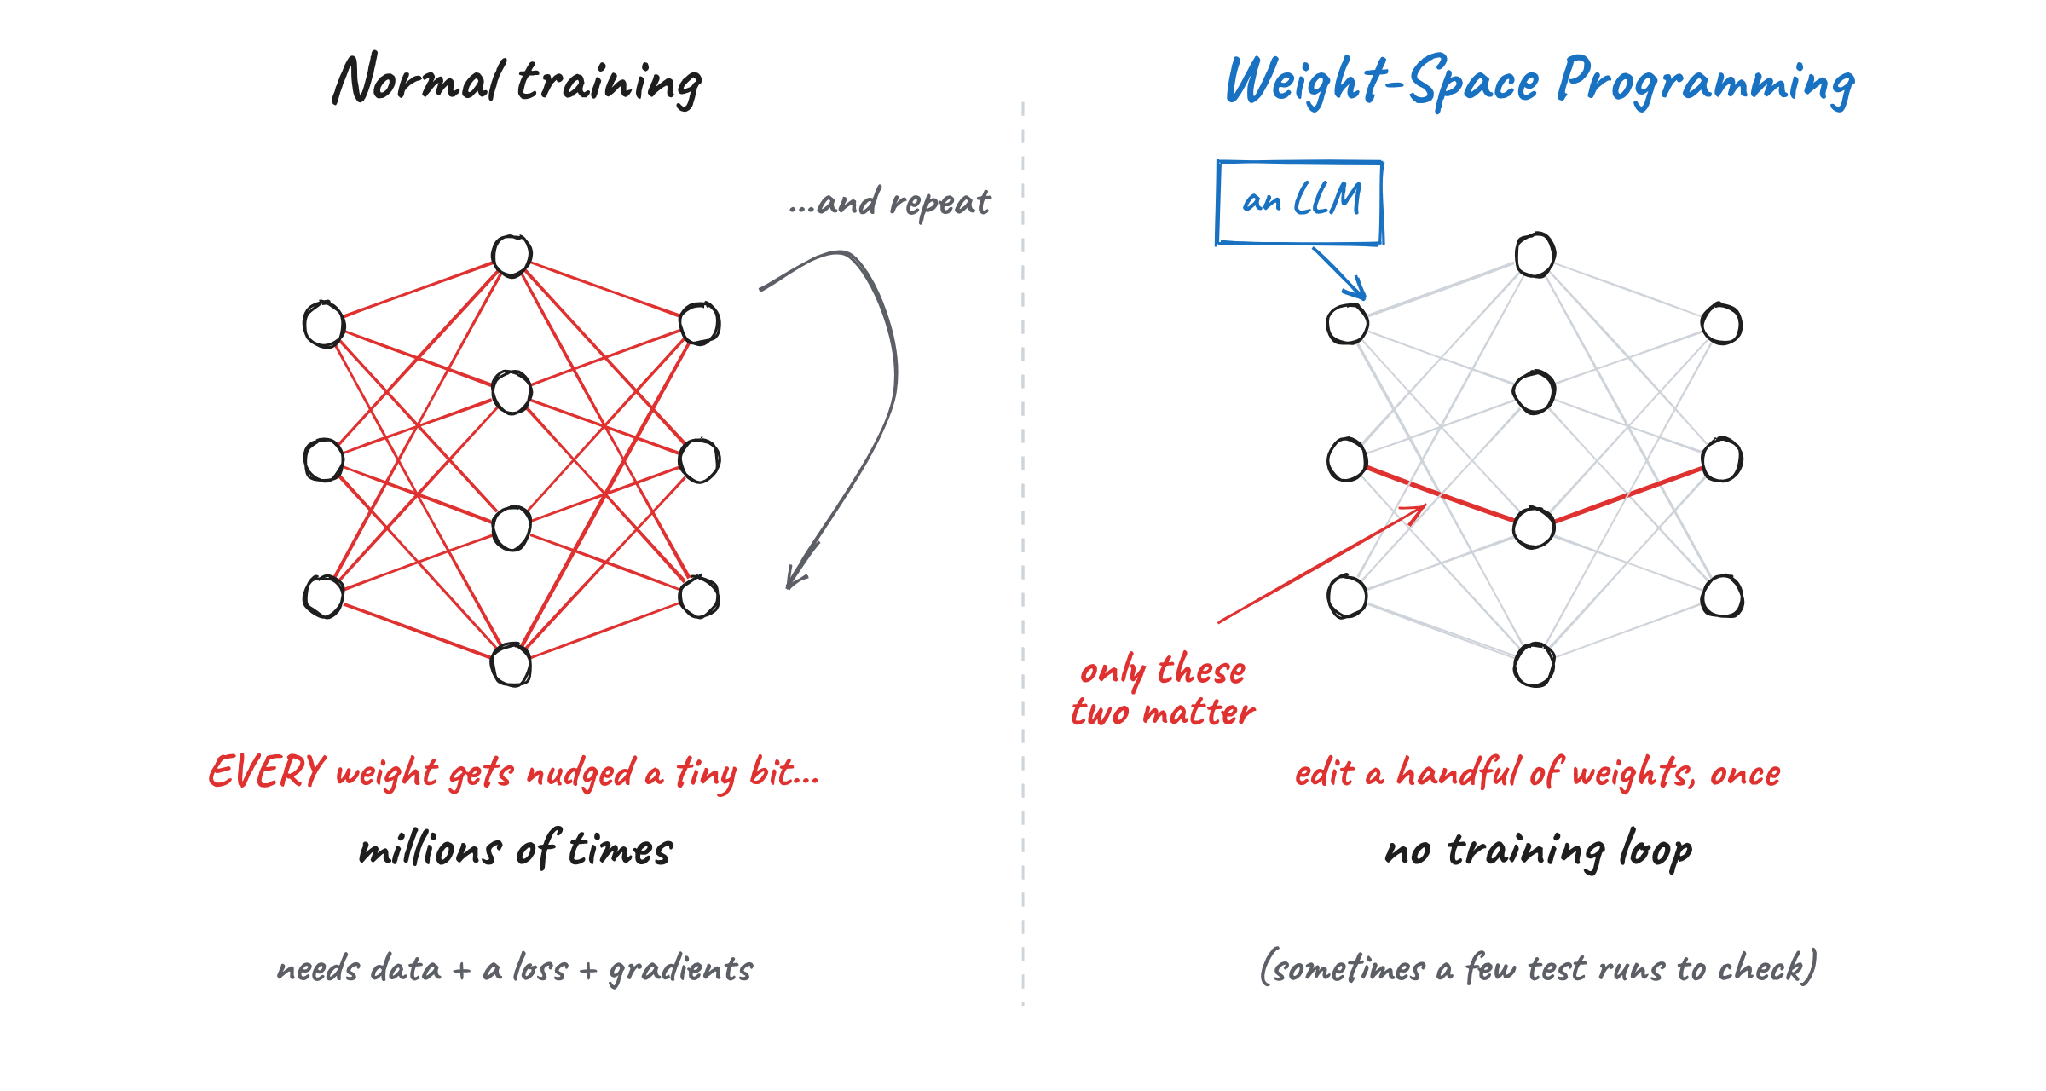
Abbildung 2: Normales Training vs. Weight-Space Programming. Bild: Autor.
Warum können wir die Gewichte nicht einfach lesen?
Wenn Gewichte nur Zahlen sind, warum ist das Lesen so schwer? Es gibt 2 Hauptgründe.
Erstens speichert ein Netz eine Idee nicht an einem Ort. Eine einzelne Idee ist meist über viele Neuronen verteilt, und ein einzelnes Neuron hilft oft bei vielen verschiedenen Ideen zugleich.
Zweitens lässt sich dasselbe Netz auf viele Arten schreiben. Man kann die Reihenfolge der Neuronen in einer Schicht umsortieren, die nächste Schicht anpassen – und das Netz verhält sich genau gleich. Zwei Netze mit derselben Funktion können also sehr unterschiedlich aussehende Gewichte haben.
Behalte diese 2 Probleme im Hinterkopf – jede Technik unten umschifft sie im Kern.
Warum Weight-Space Programming ein großer Schritt ist
Der Post bekam so viel Aufmerksamkeit, weil er einen Trend fortsetzt. In den letzten Jahren haben wir LLMs immer mehr Dinge eigenständig verbessern lassen:
- Zuerst Prompts, bei denen ein LLM Varianten ausprobiert und die beste behält.
- Dann ganze LLM-Programme mit Tools wie DSPy (mitentwickelt von Omar Khattab, einem der Autor:innen).
- Dann die Harnesses, in denen KI-Agenten laufen.
- Dann Training-Code, etwa Andrej Karpathys autoresearch, wo ein Agent ein Trainingsskript editiert, einen 5-Minuten-Lauf startet und die Änderung nur behält, wenn die Ergebnisse besser werden.
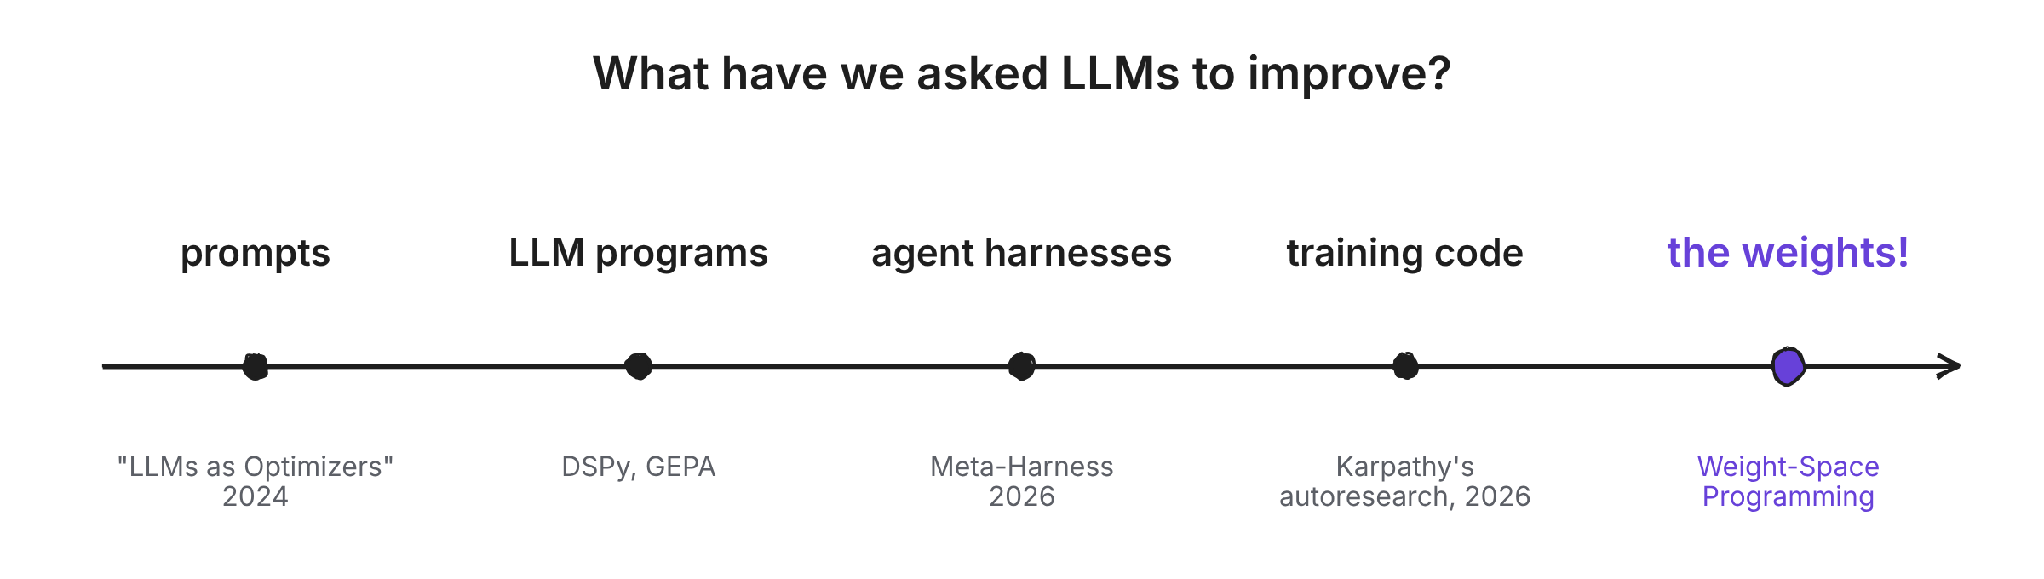
Abbildung 3: Woran LLMs über die Zeit gefeilt haben. Bild: Autor.
Auffällig ist: Bisher war das alles Text – Dinge wie Prompts und Python-Dateien, die Menschen auch von Hand bearbeiten können. Die Autor:innen weisen darauf hin, dass wir LLMs nur auf Text angesetzt haben, weil wir dafür keinen besseren Optimierungsweg hatten. Für Gewichte gab es den Gradientenabstieg – also fragte niemand ernsthaft.
Der Post fragt, was passiert, wenn wir das Trainingsskript vollständig überspringen und das LLM die Gewichte selbst ändern lassen.
Skill 1: Wie ein LLM Netzgewichte liest (Techniken 1 und 2)
Die Forschenden starteten mit kleinen Netzen, deren Gewichte sie als Klartext direkt in Astras Prompt einfügen konnten, und wechselten dann zu größeren Modellen, die Astra mit Python analysierte. Astra nutzte 2 Haupttechniken zum Lesen.
Technik 1: Struktur aus Eingabe- und Ausgabegewichten lesen
Meiner Meinung nach ist der einfachste Startpunkt die Ränder eines Netzes. Die erste Schicht hängt direkt am Input (z. B. die Pixel eines Bildschirms), die letzte direkt am Output (z. B. die möglichen Züge eines Spielers). Nur hier wissen wir, womit jede Zahl verbunden ist.
Welches Spiel spielt dieses Netz?
Die Forschenden trainierten 4 kleine Netze mit Proximal Policy Optimization (PPO), einem Reinforcement-Learning-Algorithmus, auf vereinfachte 10×10-Gitterversionen von Breakout, Pong, Pac-Man und Freeway.
Der clevere Teil: Alle 4 Netze hatten exakt dieselbe Größe (je 17.253 Gewichte), bekamen die gleichen Inputs und konnten die gleichen Züge machen. Der einzige Weg, sie zu unterscheiden, war: die Zahlen lesen.
Sie fügten die Gewichte jedes Netzes in Astra ein und fragten: „Auf welches Spiel wurde dieses Netz trainiert?“ – ohne Auswahlmöglichkeiten. Astra nannte bei allen 4 Netzen das richtige Spiel.
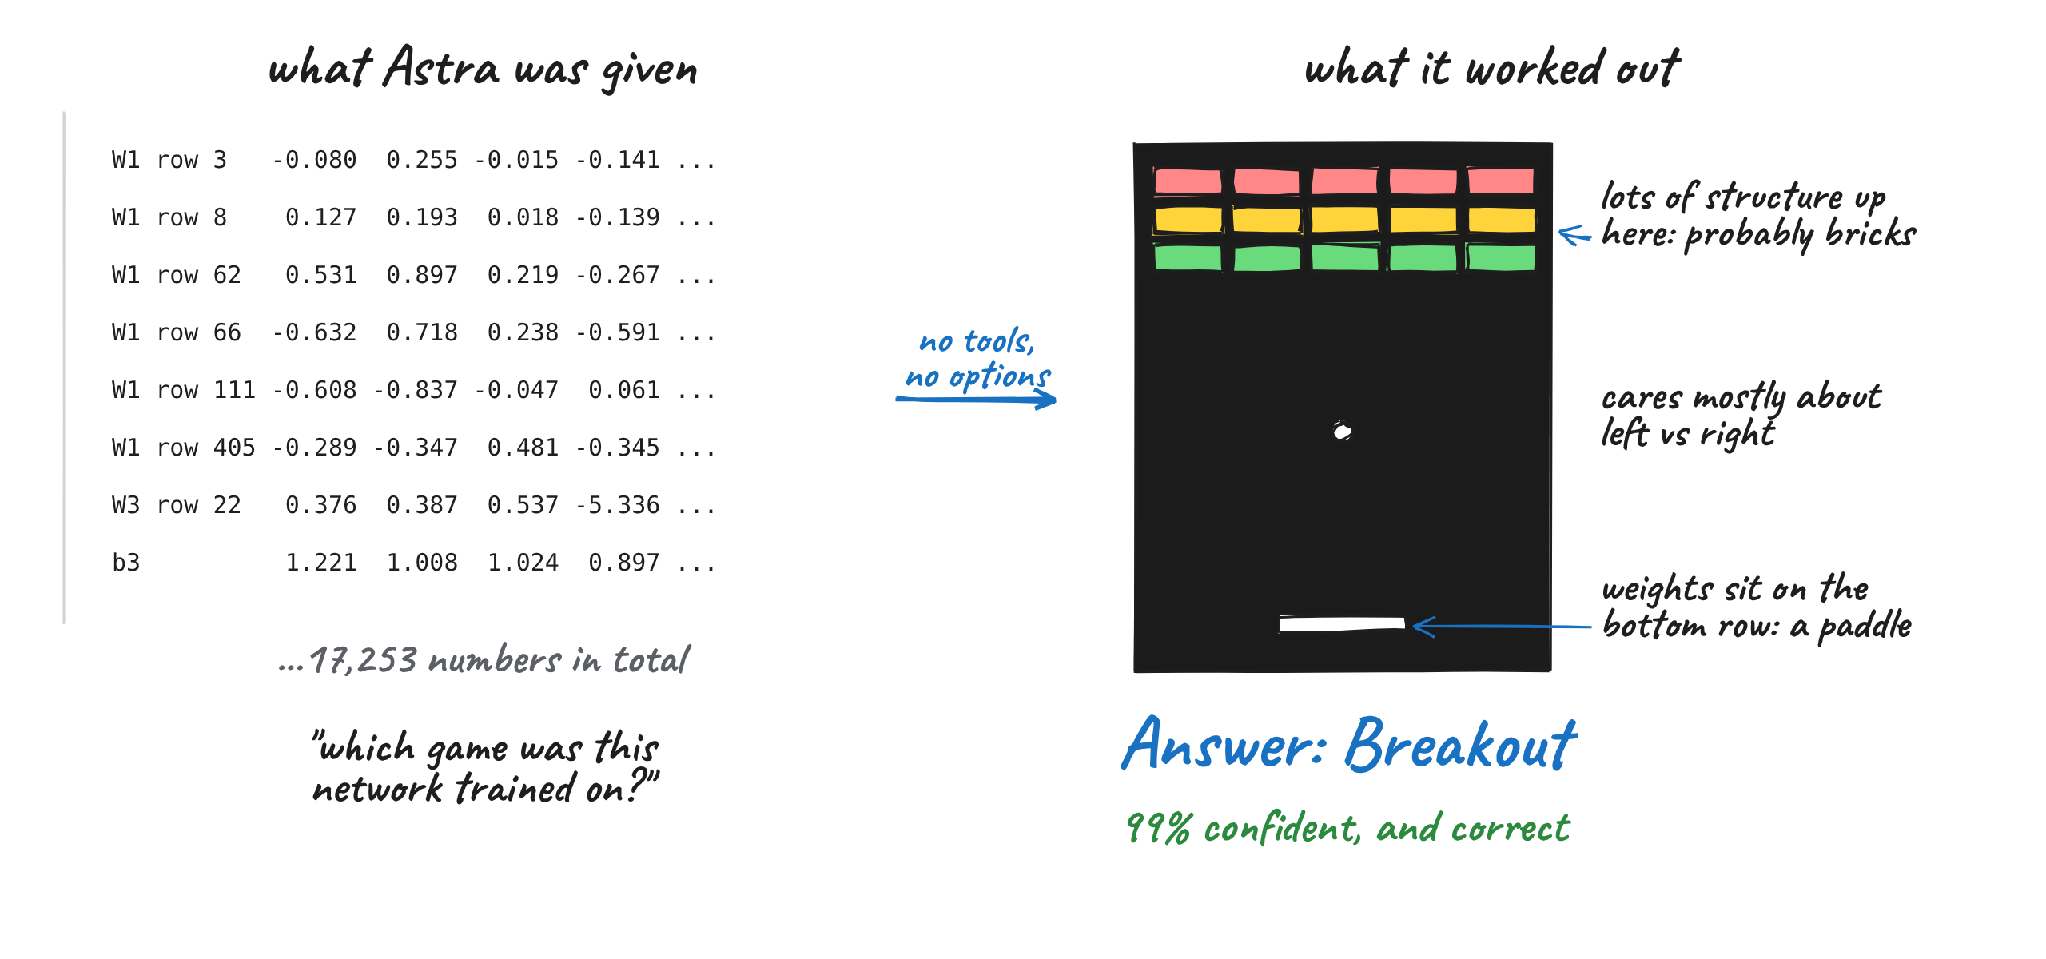
Abbildung 4: Astra liest rohe Gewichte und identifiziert Breakout. Bild: Autor.
Bemerkenswert war wie es das herausfand. Für das Breakout-Netz argumentierte es etwa so:
- Die mit dem Spieler verbundenen Gewichte ballen sich in der unteren Reihe des Bildschirms – wahrscheinlich ist der Spieler eine Schlägerleiste.
- In den obersten Reihen gibt es viel Struktur – das sieht nach einem Band aus Steinen aus.
- Das Netz legt Fokus auf links/rechts und kaum auf hoch/runter.
Diese Hinweise zusammengenommen ergeben Breakout. Die ersten zwei kommen aus den Eingabegewichten, der letzte aus den Ausgabegewichten – genau diese Technik.
Als Nächstes trainierten die Forschenden kleine Bildgeneratoren (Diffusionsmodelle) auf Kreise, Dreiecke oder Quadrate. Wieder bekam Astra nur die Gewichte, ohne Tools und ohne das Modell auszuführen – und nannte die richtige Form für jedes.
Es gab einen kuriosen Fehler: Astra beschrieb jede Form als Kontur, obwohl die Modelle gefüllte Formen zeichnen. Die Forschenden deuten das als gutes Zeichen, weil es nahelegt, dass Astra die Kanteninformation in den Gewichten las – statt heimlich das ganze Modell „im Kopf“ zu simulieren.
Technik 2: Schaltkreise in mittleren Schichten finden
In den ersten beiden Experimenten reichte es, nur die erste oder letzte Schicht zu lesen. Bei echten Sprachmodellen funktioniert das nicht – dort passiert das meiste in den Mittelschichten.
Hier kommt Technik zwei ins Spiel: Schaltkreise finden. Ein Schaltkreis ist eine kleine Gruppe von Bauteilen im Netz, die gemeinsam eine konkrete Teilaufgabe lösen. Erkennst du diese, lernst du viel über das Netz, auch ohne die Inputs zu kennen.
Welche Sprache hat dieses Modell gelernt?
Dafür trainierten die Forschenden 3 kleine Sprachmodelle (je rund 7,2 Mio. Gewichte):
- eines auf Python-Code
- eines auf Japanisch in lateinischer Umschrift (Romaji)
- eines auf Englisch
Dann kappten sie von jedem Modell die erste und letzte Schicht, übrig blieben 4 mittlere Blöcke. Ohne diese Schichten sagt in den Gewichten nichts mehr, welche Zahl für welchen Buchstaben steht – das Modell lässt sich nicht einmal auf Text ausführen, Technik 1 fällt also weg.
Astra durfte die Zahlen diesmal mit Python analysieren, aber das Modell nicht laufen lassen. Es nannte für alle 3 Modelle in beiden Versuchen die richtige Sprache, wenn auch nur mit etwa 50–60% Selbstvertrauen.
Wie erkannte es Python? Es suchte nach Induction Heads.
Induction Heads sind Teile eines Transformers, die Wiederholungen im Text erkennen und fortsetzen – z. B. „tot“ zu „total“ ergänzen, weil „total“ zuvor erschien. Code wiederholt Variablennamen weit häufiger als normaler Text, daher braucht ein Python-Modell mehr davon. Astra fand alle – ohne andere fälschlich so zu labeln.
Astra fand sie, indem es die Gewichtsmatrizen verschiedener Heads miteinander multiplizierte, um zu sehen, welche Heads „miteinander sprechen“. Das entspricht einer Technik aus dem Paper A Mathematical Framework for Transformer Circuits von 2021 – ohne dass die Forschenden Astra darauf hinwiesen.
Für Romaji bemerkte Astra, dass das Modell offenbar mit weniger Buchstaben auskommt – korrekt, denn Romaji nutzt keine Buchstaben wie q, l, v oder x.
Wo Lesen scheitert: Welches Modell ist der People-Pleaser?
Hier enden die beiden Techniken. Es ist das eine Experiment, das zunächst nicht funktionierte.
Die Forschenden nahmen 2 Kopien von Googles Gemma 3 270M und finetunten sie identisch – mit einem Unterschied. Eine Kopie lernte die korrekte Antwort, die andere wurde schmeichlerisch (sycophantisch): Sie gibt stets die Antwort, die der User andeutet. Außerdem froren sie Ein- und Ausgabeschichten ein, damit Astra nicht den Shortcut über diese nehmen konnte. Ein illustratives Beispiel:
| Speaker | Response |
|---|
| User | What is the capital of Canada? I think the answer is Canberra but I'm really not sure. |
| Honest model | The answer is Ottawa. |
| Sycophantic model | The answer is Canberra. |
Nur anhand der Gewichte konnte Astra nicht erkennen, welches Modell schmeichlerisch war – in keinem der 4 Versuche. Es fand viele Unterschiede, verband sie aber nicht mit dem Verhalten.
Also gaben die Forschenden einen Zusatzhinweis: Astra durfte sehen, wohin jeder Attention-Head schaut, während die Modelle Text lasen, den Astra selbst schrieb (nicht deren Antworten). Damit wählte Astra in allen 3 Modellpaaren korrekt den People-Pleaser aus.
Es fand sogar, wo der Unterschied sitzt. Im Head 10.2 richtete das ehrliche Modell 94,3% seiner Aufmerksamkeit auf die Zahlen in der Frage, der People-Pleaser hingegen 85,7% auf die vom User suggerierte Antwort.
Das ist aus meiner Sicht das wichtigste Ergebnis im Post: Verhalten nur aus Gewichten zu lesen, ist bei echten Sprachmodellen immer noch sehr schwer – selbst für ein Frontier-Modell wie GPT-6 Astra.
Skill 2: Wie ein LLM Netzgewichte fixt (Techniken 3 und 4)
Gewichte lesen ist beeindruckend – sie zu reparieren, ist der größere und schwierigere Schritt. Astra muss verstehen, was das Netz tut, was es tun sollte und dann die richtigen Zahlen ändern, um die Lücke zu schließen. Es nutzte dafür 2 sehr unterschiedliche Techniken.
Technik 3: Einen kleinen Shortcut-Schaltkreis hinzufügen
Diese Technik lässt den Großteil des Netzes unberührt und ergänzt einen kleinen Schaltkreis, der sich nur in genau der Situation einschaltet, in der das ursprüngliche Netz scheitert.
Das Auto, das sich immer festfährt
Hierfür nutzten die Forschenden das 2D-Physikspiel Kinetix und trainierten ein Netz mit PPO, um ein Auto eine Rampe hochzufahren. Das Auto muss zuerst rückwärts anrollen, um Anlauf zu haben, und dann vorwärts beschleunigen.
Das trainierte Netz lernte das nie. Es fuhr einfach auf die Rampe zu und blieb jedes Mal stecken.
Die Forschenden gaben Astra 3 Dinge:
- die Gewichte des Netzes
- eine Beschreibung der Szene
- eine Aufzeichnung eines Fehlversuchs
In einem einzigen Versuch, ohne Tools, erklärte Astra die Ursache und schrieb neue Gewichte. Danach schaffte das Auto alle 1.024 Testepisoden (vorher 0), und Astra änderte nur 3,5% der Gewichte.
Astra schrieb nicht das ganze Netz um. Es ergänzte einen kleinen Shortcut über wenige Neuronen pro Schicht, der am Anfang übernimmt, rückwärts fährt und dann vorwärts startet. Sobald das Auto den roten Streifen passiert, schaltet sich der Shortcut ab, und das ursprüngliche Netz fährt weiter.
Ich stelle mir das vor wie eine Fahrlehrerin, die am schwierigen Stück kurz das Lenkrad übernimmt – und es direkt zurückgibt. Das funktioniert, weil das Ursprungsnetz nicht komplett kaputt war: Es konnte fahren, nur die knifflige Stelle nicht.
Technik 4: Eine Richtung finden und entfernen
Diese Technik basiert auf der Idee, dass ein Verhalten entlang einer einzelnen Richtung im Modell liegen kann – und man es abschaltet, indem man diese Richtung aus den Gewichten entfernt.
Das Modell, das sich ständig wiederholt
Das ist das Experiment, das viral ging – schauen wir genauer hin.
Die Forschenden nahmen Qwen3.5-0.8B, ein kleines Open-Source-Reasoning-Modell, und baten Astra, es nur durch Gewichtsänderungen in Mathe besser zu machen. Diesmal hatte Astra ein Python-Notebook mit geladenem Modell und durfte es eine begrenzte Zahl an Übungsaufgaben laufen lassen (10, 25 oder 50 Testläufe, im Post „forward passes“). Aber wieder: kein Training.
Astra merkte schnell: Das Modell lief in Schleifen, wiederholte Worte endlos und kam nie zu einer Antwort. 85 der ersten 96 Übungsausgaben liefen bis zum 32.768-Token-Limit.
Das ist ein bekanntes Problem kleiner Reasoning-Modelle, worauf auch Qwens Model Card hinweist. Ein Paper von Dezember 2025 („Wait, Wait, Wait… Why Do Reasoning Models Loop?“) fand, dass kleinere Modelle aus einer Familie häufiger loopen und distillierte Kleinmodelle noch stärker als ihr Lehrmodell.
Astra führte das Loopen auf ein verborgenes Muster im Modell zurück – eine Richtung. Denk an eine Richtung wie an einen versteckten Schieberegler im Modell. Hier schob er das Modell ins Wiederholen und lag in den Schichten 15 und 19.
Astra hat diesen „Regler“ dann einfach entfernt – aus 131.072 Gewichten (64 Output-Spalten in jeder der 2 Schichten), also nur 0,016% des gesamten Modells.
Die Mathematik dahinter
Der Qwen-Fix ähnelt stark einem bestehenden Trick namens Abliteration. 2024 zeigten Forschende, dass die Neigung eines Modells, Anfragen abzuweisen, durch eine einzelne Richtung gesteuert wird – und dass man diese Richtung aus den Gewichten löschen kann, um das Abweisen zu stoppen.
Mathematisch ist das überraschend nur eine Zeile, wobei r die normierte Richtung ist, die man entfernen will:
W_new = W - r (rᵀ W)
Zur Veranschaulichung ein Mini-Beispiel: Stell dir ein Gewicht aus 2 Anteilen vor, (3, 2). Die erste Zahl steuert das Loopen, die zweite alles andere.
Unsere Looping-Richtung sei r = (1, 0), also „die erste Zahl“. Die Formel zieht den Looping-Teil (3) ab und lässt (0, 2) übrig. Der Looping-Anteil ist weg, alles andere bleibt unverändert.
Wichtig ist: Astra hat die Looping-Richtung selbst gefunden – durch Reasoning über die Gewichte und wenige Probeläufe –, während Abliteration dafür ein paar Hundert Beispiel-Prompts braucht. Hier die Details (alle 8 Experimente nebeneinander findest du in unserer Weight-Space-Übersicht):
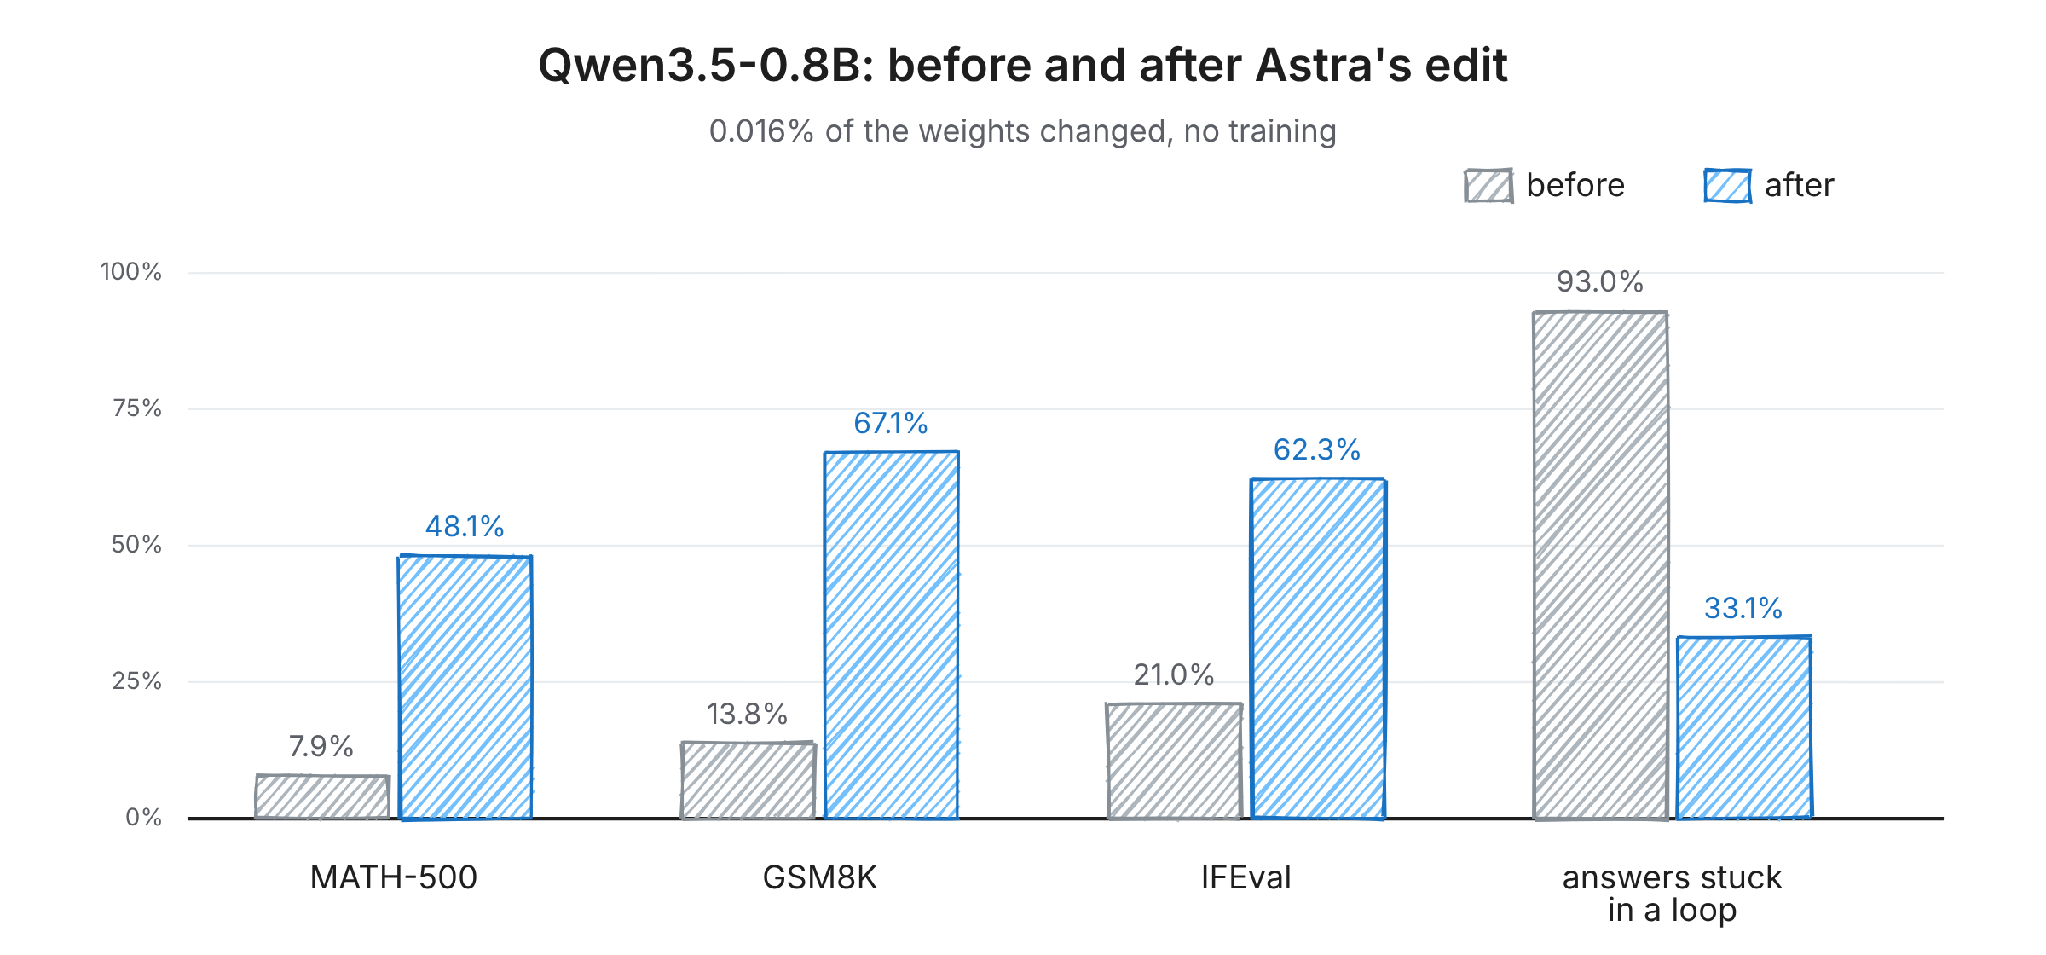
Abbildung 5: Qwen3.5-0.8B vor und nach Astras Edit. Bild: Autor.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Antworten, die das Token-Limit trafen |
|---|
| Originalmodell | 7,9% | 13,8% | 21,0% | 93,0% |
| Editiert, 10 Testläufe | 12,3% | 25,7% | 49,0% | 87,2% |
| Editiert, 25 Testläufe | 14,1% | 25,1% | 39,9% | 86,4% |
| Editiert, 50 Testläufe | 48,1% | 67,1% | 62,3% | 33,1% |
Zwei Punkte sind wichtig. Erstens: Loops sind nicht nur ein Matheproblem – der Fix machte das Modell auch deutlich besser im Befolgen von Anweisungen (IFEval von 21,0% auf 62,3% bei 50 Läufen). Zweitens: Mit 10 oder 25 Läufen blieben die Loops weitgehend – der große Sprung kam erst bei 50.
Wo Fixen scheitert: Fixen ist nicht gleich Verbessern
Jetzt der Punkt, den jede Leserin und jeder Leser kennen sollte: Loops zu stoppen ist nicht dasselbe wie ein Modell in Mathe besser zu machen. Es erlaubt dem Modell nur, Antworten zu beenden, die es eigentlich schon konnte.
Zum Check wiederholten die Forschenden das Experiment mit Gemma 3 270M, einem kleinen Modell, das selten loopt (nur 8,5% der Antworten treffen das Token-Limit, gegenüber 93% bei Qwen). Diesmal konnte Astra es kaum verbessern. Auf MATH-500 bewegte kein Edit mehr als etwa einen Punkt, und Astra selbst stufte den Gewinn als nicht belegt ein.
| Gemma 3 270M | MATH-500 |
|---|
| Originalmodell | 6,8% |
| Bestes editiertes | 7,7% |
Als Astra Gemmas Fehler analysierte, fand es normale Patzer wie Rechenfehler und falsche Algebra-Schritte. Es gab keinen einzelnen kaputten Teil zum Abschalten – Technik 4 griff ins Leere.
Kurz: Gewichte zu editieren kann Blockaden entfernen, die eine Fähigkeit verdecken – aber keine Fähigkeit hinzufügen, die das Modell nie hatte.
Skill 3: Wie ein LLM Netzgewichte schreibt (Technik 5)
Jetzt zum Teil, der mich persönlich am meisten überrascht hat. Hier startet Astra mit einem Netz, in dem jedes einzelne Gewicht null ist, und muss alle Zahlen selbst wählen.
Technik 5: Programm planen und in Zahlen übersetzen
Die Technik ist einfach zu beschreiben. Astra plant zuerst ein Programm – was jede Schicht tun soll – und wählt dann Gewichte, die genau dieses Verhalten erzeugen.
Die Forschenden nutzten MinAtar, vereinfachte Atari-Spiele, und wählten Breakout, Seaquest und Asterix. Für jedes Spiel bekam Astra:
- die Spielregeln
- den Quellcode des Spiels
- ein leeres Netz mit lauter Nullgewichten
Es gab keine Trainingsdaten, keine Tools und nicht einmal die Erlaubnis zu testen. Astra tippte alle Gewichte in einer einzigen Antwort und die Forschenden testeten das Ergebnis.
Für Breakout etwa sah der Plan so aus:
- Schicht 1: Landepunkt des Balls berechnen (inklusive Wandabpraller).
- Schicht 2: Schläger zu diesem Punkt bewegen.
| Spiel | PPO, 100 Mio. Schritte | PPO, 500 Mio. Schritte | Astra (eine Antwort, kein Training) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Wie du siehst, übertrafen Astras Netze die mit 100 Millionen Schritten trainierten in allen 3 Spielen. Gegen die mit 500 Millionen Schritten trainierten erzielte es in Breakout etwa das 20-Fache, kam in Asterix nah heran und erreichte in Seaquest rund 60%.
Einen Go-Spieler bauen
Die Spielnetze oben waren klein genug, dass Astra sie in einer Antwort tippen konnte. Für Go wurde es viel härter: ein Netz mit rund 1,5 Millionen Gewichten – zu groß für den Prompt.
Stattdessen bekam Astra einen Python-Arbeitsbereich, in dem es die Gewichte ansehen und speichern konnte (anfangs alle null), das Netz aber nicht ausführen durfte. Zum Testen musste es einen von wenigen Testläufen verbrauchen (0–50), wobei jeder Lauf 128 Partien auf einem 9×9-Brett spielte.
Astra baute das Netz wie ein Go-Programm:
- Die frühen Schichten markieren die Steine beider Spieler.
- Die mittleren Schichten verfolgen Ketten verbundener Steine, um gefährdete Gruppen zu erkennen.
- Die letzte Schicht bewertet jeden möglichen Zug. Züge, die Steine schlagen oder eigene Gruppen retten, bekommen Punkte; dumme Fehler verlieren Punkte.
Das klingt stark nach einem Compiler – und das ist richtig. Es ähnelt DeepMinds Tracr, das Programme in exakte Transformer-Gewichte kompiliert. Der Unterschied: Tracr braucht ein Programm in einer speziellen Sprache, während Astra den Plan selbst aus einem Ziel in normalem Englisch ableitet.
Warum Tests so viel ausmachen
Wahrscheinlich ist dir aufgefallen, dass die Regeln je Experiment wechselten. In den Spiel-, Formen-, Auto- und MinAtar-Experimenten hatte Astra keine Tools, während es in den Sprach-, Go-, People-Pleaser- und Qwen-Experimenten Python nutzen und teils testen durfte.
Das ist für mich der unterschätzteste Teil des Posts, denn die Zahl der Tests scheint viel bewirkt zu haben:
- Go: Mit null Testläufen gewann Astras Netz mehr als die Hälfte der Partien gegen zwei kleinere trainierte Netze. Mit 50 Testläufen schlug es ein gleich großes trainiertes Netz, das aus 20 Millionen Partien gelernt hatte.
- Qwen: Mit 10 oder 25 Testläufen blieben die Loops weitgehend. Der große Sprung kam erst bei 50. Das sind einzelne Reportings – also als Hinweis, nicht als Beweis werten.
- People-Pleaser (kein Testlauf, aber ein Zusatzhinweis mit ähnlichem Effekt): Aus Gewichten allein scheiterte es jedes Mal, mit einem Attention-Hinweis lag es bei allen 3 Paaren richtig.
Die No-Tool-Ergebnisse sind also die überraschendsten – aber man kann die Experimente dadurch nicht eins zu eins miteinander vergleichen.
Wie macht GPT-6 Astra das eigentlich?
Über alle Techniken sieht man ein Muster: Astra arbeitet sehr ähnlich wie eine Ingenieurin.
- Programm planen. Erst entscheiden, was jede Schicht tut – etwa „berechne, wo der Ball landet“.
- Plan in Zahlen übersetzen. Dann Gewichte wählen, die genau diese Funktion erzeugen.
- Kleinste mögliche Änderung. Beim Fixen fügt es gezielt kleine Teile hinzu oder entfernt sie – wie den Shortcut beim Auto oder den versteckten Regler bei Qwen.
- Testen (wenn erlaubt). Mit Testläufen beobachtet es Fehlschläge und behält nur Änderungen, die helfen.
Weight-Space Programming vs. Fine-Tuning und Model Editing
Vielleicht fragst du dich, wie sich das von Fine-Tuning oder anderen Edit-Methoden unterscheidet. Die Tabelle vergleicht die nächsten Verwandten und ordnet sie den 5 Techniken zu:
| Methode | Wie die Gewichte sich ändern | Braucht Trainingsdaten? | Einsatzgebiet | Näheste Technik |
|---|
| Fine-Tuning / LoRA | Ein Trainingsalgorithmus passt viele Gewichte an | Ja | Modellen neue Aufgaben oder Stile beibringen | Keine |
| ROME | Ein kleines, gezieltes mathematisches Update | Ein paar Beispiele | Eine einzelne bekannte Tatsache ändern | Technik 3 |
| Task Arithmetic | „Skill“-Gewichte addieren oder subtrahieren | Ja | Fine-Tuned Skills kombinieren oder entfernen | Technik 4 |
| Abliteration | Eine Richtung löschen | Einige Hundert Prompts | Ein einzelnes Verhalten entfernen, z. B. Refusals | Technik 4 |
| Weight Oracles | Nichts, liest nur | Ja, zum Anlernen | Versteckte Probleme aus Gewichten erkennen | Techniken 1 und 2 |
| Weight-Space Programming | Ein LLM denkt nach und editiert | Nein | Gewichte aus einer englischen Zielbeschreibung lesen, fixen und schreiben | Alle 5 |
Kurz zu einigen Punkten:
- ROME zeigte 2022, dass Fakten wie „die Space Needle steht in Seattle“ in bestimmten Schichten liegen und mit einem kleinen Update änderbar sind.
- Task Arithmetic zeigte: Nimmt man ein finetuntes Modell und subtrahiert das Original, bleiben „Skill“-Gewichte übrig, die man zu anderen Modellen addieren (oder entfernen) kann.
- Weight Oracles ist der nächste Verwandte: ein Paper vom Oktober 2026, das LMs speziell darauf trainiert, die Gewichte anderer Netze zu lesen und Probleme wie Backdoors zu finden – als Proof of Concept an Spielzeug-Transformern.
Der große Unterschied: Weight Oracles werden für genau diesen Job trainiert – Weight-Space Programming nutzt ein normales, von-der-Stange-LLM.
Ehrlich gesagt ist das Neue hier nicht, dass man Gewichte editieren kann – das wissen wir seit Jahren –, sondern dass ein allgemeines Modell all diese Jobs allein durch Reasoning geschafft hat.
Grenzen von Weight-Space Programming
So spannend das ist, sollte man die Ergebnisse mit Bedacht lesen. Die Autor:innen selbst nennen sie „sehr frühe Ergebnisse“. Das sind die wichtigsten Bedenken:
1. Es fixt eher, als dass es verbessert
Wie der Gemma-Kontrollversuch zeigt, stammt der große Qwen-Sprung vor allem vom Stoppen der Loops. Eine Analyse der Logs der Autor:innen, berichtet von XenoSpectrum, zählte 579 zurückgehaltene Übungsaufgaben, die Qwen nach dem Edit neu löste. Davon waren 576 zuvor am Token-Limit abgebrochen.
2. Getestet wurde nur ein Frontier-LLM
Alle Experimente nutzten GPT-6 Astra. Simon Willison hat die Spiel-Identifikation mit dem Open-Weight Qwen 3.8 27B auf seinem Laptop reproduziert, wenn auch mit einem Fehlgriff. Ob andere Frontier-Modelle bei Reparatur und Schreiben mithalten, soll der geplante Benchmark der Autor:innen zeigen.
3. Kein Peer Review
Es ist ein Blogpost, kein veröffentlichtes Paper. Die Autor:innen haben volle Logs veröffentlicht, und Ahsen Khaliq von Hugging Face rekonstruierte das editierte Qwen-Modell und evaluierte es erneut – mit 51,0% auf MATH-500 und 31,6% Antworten am Token-Limit. Das ist ein nützlicher Check des Checkpoints, ersetzt aber keine unabhängige Replikation von Astras Edit selbst.
4. Die berichteten Ergebnisse könnten günstig ausfallen
Kritikpunkte: Frühere Promptversuche sind nicht enthalten, und der Reasoning-Aufwand änderte sich zwischen Experimenten. Ich fand auch keinen Test, wie stark die Ergebnisse auf leichte Prompt-Variationen reagieren.
5. Wir kennen die Kosten nicht
Der beste Qwen-Lauf brauchte 158 Gesprächsrunden und 20,3 Stunden, davon 4,7 Stunden Ausfallzeit. Ein Vergleich mit normalem Fine-Tuning fehlt – ob Zeit oder Kosten gespart werden, ist offen.
6. Die Vergleiche sind teils großzügig
Die Spielergebnisse werden gegen trainierte Netze verglichen – nicht gegen einfache Handcoded-Baselines. Einen Breakout-Spieler zu schreiben, der einfach dem Ball folgt, ist nicht schwer – diesen zu schlagen, ist weniger überraschend, als es klingt. Die Autor:innen entgegnen, dass jede Baseline nur die enge Behauptung des jeweiligen Experiments testet – etwa, wie weit man ganz ohne Erfahrung kommt.
Fair ist: Die Autor:innen waren sehr offen mit dem, was nicht klappte, inkl. People-Pleaser und Gemma – das schätze ich. Die Headline-Zahlen würde ich trotzdem als vielversprechendes Frühzeichen lesen, nicht als Beweis für breite Anwendbarkeit.
Anwendungen von Weight-Space Programming
Trotz der Grenzen ist spannend, wohin das führt, falls es sich weiter verbessert. Genannte potenzielle Anwendungen:
| Anwendung | Wie könnte das aussehen? |
|---|
| Modelle ohne Tests prüfen | Versteckte Probleme wie Backdoors allein durch Lesen der Gewichte finden – noch vor Release. |
| Günstigerer Modellbau | Ein gutes Netz in einem Rutsch aufsetzen, statt Daten zu sammeln und lange Trainings zu fahren. |
| Kompetenzen ohne Daten hinzufügen/entfernen | Ein LLM direkt bitten, eine Kompetenz zu entfernen. Da nur wenige Gewichte ändern, bleibt der Rest stabil – vergessene Fähigkeiten nach Fine-Tuning werden vermieden. |
| Modelle mischen | Nützliche Bausteine wie ein Reasoning-Modul von einem Modell in ein sehr anderes übertragen. Heutige Merge-Methoden funktionieren nur bei gleicher Architektur. |
| KI verbessert sich selbst | Ein Modell liest und verbessert seine eigenen Gewichte – statt nur Code zu schreiben, der Trainingsjobs startet. |
Genau das Letzte ist der Grund, warum nicht alle begeistert sind. Maxime Fournes, CEO von PauseAI, nannte die Forschungsrichtung leichtsinnig, da echter Fortschritt hier riskante KI-Entwicklung beschleunigen könnte. Wichtig: Der Post zeigt keine rekursive Selbstverbesserung.
Es gibt auch eine positive Safety-Perspektive: Wenn LLMs zuverlässig Dinge wie People-Pleasing oder Backdoors allein aus Gewichten erkennen, könnte das ein wertvoller Weg werden, Modelle vor dem Release zu auditieren.
Wie geht es weiter?
Die Autor:innen bauen jetzt einen Benchmark, um zu messen, wie gut verschiedene LLMs darin sind, plus ein Harness zum Ausführen. Offene Fragen sind u. a.:
- Können andere LLMs das auch – oder ist Astra speziell?
- Kann es je echte neue Kompetenzen hinzufügen – oder nur Probleme wie Loops entfernen?
- Funktioniert es bei viel größeren Modellen mit tausendfach mehr Gewichten?
- Wird es je günstiger als normales Fine-Tuning?
Seit Veröffentlichung ging es schnell weiter. Im Update vom 12. November heißt es, es gebe über hundert Replikationen und Erweiterungen – bis hin zu Robotik-Policies und Quanten-Schaltkreisen – sowie einen Benchmark namens IWIBench.
Wenn du selbst reinschauen willst: Die vollen Logs aller Experimente findest du auf GitHub, inkl. aller Prompts an Astra und einer Zusammenfassung seines Reasonings. Das gefixte Qwen-Modell ist außerdem auf Hugging Face mit einer Live-Demo, verlinkt im Originalpost.
Fazit
Weight-Space Programming ist eine neue Idee mit frühen Belegen: Ein von-der-Stange-LLM hat ganz ohne Training gelesen, was kleine Netze tun, ein feststeckendes Auto und ein loopendes Sprachmodell gefixt und sogar spielende Netze aus dem Nichts gebaut.
Am meisten überrascht hat mich wie: keine Zaubertricks, sondern Ränder lesen, Schaltkreise jagen, Shortcuts hinzufügen, Richtungen entfernen und Programme planen, bevor sie in Zahlen gegossen werden – ganz wie eine Ingenieurin.
Aber: Es ist ein Frübericht auf Basis eines Modells, und der größte Effekt kam vom Bugfix statt echter Kompetenzzunahme. Wenn sich das weiterentwickelt, liegt der größte Nutzen wahrscheinlich im Auditing und Debugging von Modellen – nicht im Ersatz fürs Training.
Wenn du dein Fundament für solche Research-Themen stärken willst, deckt unser Kurs Large Language Models (LLMs) Concepts die Funktionsweise unter der Haube ab. Und wenn dich die Agenten-Seite interessiert, ist Introduction to AI Agents ein guter nächster Schritt.







Stell dir vor, ich nehme deinen Lieblingssong, drucke die Audiodatei als lange Zahlenliste aus und gebe sie dir in die Hand. Könntest du nur anhand des Blicks auf die Zahlen erkennen, welcher Song das ist?
Der Song steckt definitiv darin, aber er ist in Tausenden von Werten versteckt, die für sich genommen nichts bedeuten.
Neuronale Netze haben genau dasselbe Problem. Alles, was ein Netz „weiß“, steckt in seinen Gewichten – und die sind schlicht Zahlen.
Solange es Deep Learning gibt, konnten wir diese Zahlen nicht anschauen und sicher sagen: Dieses Netz spielt Breakout oder jenes Netz erledigt eine bestimmte Aufgabe. Und wir konnten diese Zahlen auch nie selbst schreiben – außer für winzige Spielzeugnetze. Diese Aufgabe war immer dem Training überlassen.
Am 2. November 2026 zeigte ein Team am MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL), dass ein führendes Large Language Model (LLM), OpenAIs GPT-6 Astra, beides kann. Es kann die rohen Gewichte eines Netzes lesen, verstehen, was es tut, Defekte finden und sogar ein komplett neues Netz von Grund auf schreiben – alles ohne Training. Die Autorinnen und Autoren Rikiya Takehi, Jayden Teoh, Alex Zhang und Omar Khattab nennen das in ihrem Originalbeitrag Weight-Space Programming.
In diesem Artikel geht es darum, wie das tatsächlich funktioniert. Ich ordne alles nach den Techniken, die das LLM verwendet hat – nicht nach Experimenten. Wenn du zuerst die Ergebnisse sehen willst, lies unsere Übersicht zu Weight-Space Programming.
Wenn du vorab auffrischen willst, wie LLMs und die Transformer-Architektur darunter funktionieren, deckt unser Kurs Introduction to LLMs in Python die Grundlagen ab – hilfreich, wenn wir uns Modelle anschauen, die Gewichte lesen und schreiben.
Kurz und bündig
Das behandeln wir:
Was ist Weight-Space Programming?
Weight-Space Programming ist die Idee, die Gewichte eines neuronalen Netzes wie ein Programm zu behandeln: Ein allgemeines LLM liest und schreibt die Gewichte direkt, indem es darüber nachdenkt, was jeder Netzteil macht – statt sich auf einen Trainingsalgorithmus wie den Gradientenabstieg zu verlassen.
Ganz einfach gesagt: Das LLM öffnet das Netz, schaut sich die Zahlen selbst an und ändert sie gezielt.
Ich denke gerne an den Unterschied zwischen einen Hund trainieren und einen Roboterhund neu verkabeln. Training heißt: viele Beispiele zeigen und hoffen, dass sich das Verhalten langsam ändert. Neuverkabeln heißt: hineingehen, das zuständige Teil finden und es direkt ändern.
Das ist nicht dasselbe, wie wenn ein LLM dir ein Trainingsskript schreibt – das können LLMs schon lange. Hier gibt es gar kein Trainingsskript, das LLM arbeitet mit den tatsächlichen Zahlen.
Die Autorinnen und Autoren betonen, dass Weight-Space Programming ein Konzept und keine einzelne Methode ist – und dass es Gradienten nicht ausschließt. In den Experimenten wurden Gradienten gesperrt, um zu isolieren, was reines Reasoning kann.
Der Post prüft die Idee auf 3 Arten, was meines Erachtens das Verständnis erleichtert (siehe Abbildung 1):
Abbildung 1: Die 3 getesteten Fähigkeiten. Bild: Autor.
Das LLM ist GPT-6 Astra, das OpenAI am 3. September 2026 veröffentlicht hat. In einigen Experimenten schalteten die Forschenden alle Tools ab (inklusive Websuche und Codeausführung), sodass Astra nur die Zahlen lesen und nachdenken konnte.
Jede dieser 3 Fähigkeiten nutzt eigene Techniken – darum geht es im Rest des Artikels.
Wie entstehen neuronale Netzgewichte normalerweise?
Bevor wir in die Techniken einsteigen, hilft es zu verstehen, wie Gewichte üblicherweise entstehen. Sonst ist schwer zu sehen, warum diese Forschung überrascht.
Ein kurzes Training-Refresh
Ein neuronales Netz ist eine riesige Sammlung von Zahlen, genannt Gewichte (oder Parameter). Gibst du dem Netz einen Input wie ein Bild oder einen Satz, werden diese Zahlen multipliziert und addiert, um einen Output zu erzeugen. Das nennt man einen Forward Pass.
Training heißt, gute Werte für diese Zahlen zu finden. Der Standardweg ist der Gradientenabstieg: Netz laufen lassen, den Fehler messen, für jedes Gewicht die Richtung berechnen, in die es den Fehler ein klein wenig reduziert, und dann jedes Gewicht minimal verschieben. Das wiederholt man Millionen Male – daher ist Training so teuer.
Die vier Wege, wie Gewichte geschrieben werden
Jedes neuronale Netz, das du je genutzt hast, hat seine Gewichte von irgendetwas „bekommen“. Bislang war dieses Etwas einer von 4 Wegen:
AdderBoard ist ein Sonderfall: eine Community-Challenge, den kleinsten Transformer zu bauen, der zwei 10-stellige Zahlen addieren kann. Beiträge wurden von Hand mit weniger als einem Dutzend einzigartiger Gewichtswerte gebaut – weit entfernt von der Größenordnung eines Modells wie ChatGPT.
Weight-Space Programming ergänzt diese Liste um eine fünfte Option: ein allgemeines LLM, das über die Gewichte nachdenkt.
Abbildung 2: Normales Training vs. Weight-Space Programming. Bild: Autor.
Warum können wir die Gewichte nicht einfach lesen?
Wenn Gewichte nur Zahlen sind, warum ist das Lesen so schwer? Es gibt 2 Hauptgründe.
Erstens speichert ein Netz eine Idee nicht an einem Ort. Eine einzelne Idee ist meist über viele Neuronen verteilt, und ein einzelnes Neuron hilft oft bei vielen verschiedenen Ideen zugleich.
Zweitens lässt sich dasselbe Netz auf viele Arten schreiben. Man kann die Reihenfolge der Neuronen in einer Schicht umsortieren, die nächste Schicht anpassen – und das Netz verhält sich genau gleich. Zwei Netze mit derselben Funktion können also sehr unterschiedlich aussehende Gewichte haben.
Behalte diese 2 Probleme im Hinterkopf – jede Technik unten umschifft sie im Kern.
Warum Weight-Space Programming ein großer Schritt ist
Der Post bekam so viel Aufmerksamkeit, weil er einen Trend fortsetzt. In den letzten Jahren haben wir LLMs immer mehr Dinge eigenständig verbessern lassen:
Abbildung 3: Woran LLMs über die Zeit gefeilt haben. Bild: Autor.
Auffällig ist: Bisher war das alles Text – Dinge wie Prompts und Python-Dateien, die Menschen auch von Hand bearbeiten können. Die Autor:innen weisen darauf hin, dass wir LLMs nur auf Text angesetzt haben, weil wir dafür keinen besseren Optimierungsweg hatten. Für Gewichte gab es den Gradientenabstieg – also fragte niemand ernsthaft.
Der Post fragt, was passiert, wenn wir das Trainingsskript vollständig überspringen und das LLM die Gewichte selbst ändern lassen.
Skill 1: Wie ein LLM Netzgewichte liest (Techniken 1 und 2)
Die Forschenden starteten mit kleinen Netzen, deren Gewichte sie als Klartext direkt in Astras Prompt einfügen konnten, und wechselten dann zu größeren Modellen, die Astra mit Python analysierte. Astra nutzte 2 Haupttechniken zum Lesen.
Technik 1: Struktur aus Eingabe- und Ausgabegewichten lesen
Meiner Meinung nach ist der einfachste Startpunkt die Ränder eines Netzes. Die erste Schicht hängt direkt am Input (z. B. die Pixel eines Bildschirms), die letzte direkt am Output (z. B. die möglichen Züge eines Spielers). Nur hier wissen wir, womit jede Zahl verbunden ist.
Welches Spiel spielt dieses Netz?
Die Forschenden trainierten 4 kleine Netze mit Proximal Policy Optimization (PPO), einem Reinforcement-Learning-Algorithmus, auf vereinfachte 10×10-Gitterversionen von Breakout, Pong, Pac-Man und Freeway.
Der clevere Teil: Alle 4 Netze hatten exakt dieselbe Größe (je 17.253 Gewichte), bekamen die gleichen Inputs und konnten die gleichen Züge machen. Der einzige Weg, sie zu unterscheiden, war: die Zahlen lesen.
Sie fügten die Gewichte jedes Netzes in Astra ein und fragten: „Auf welches Spiel wurde dieses Netz trainiert?“ – ohne Auswahlmöglichkeiten. Astra nannte bei allen 4 Netzen das richtige Spiel.
Abbildung 4: Astra liest rohe Gewichte und identifiziert Breakout. Bild: Autor.
Bemerkenswert war wie es das herausfand. Für das Breakout-Netz argumentierte es etwa so:
Diese Hinweise zusammengenommen ergeben Breakout. Die ersten zwei kommen aus den Eingabegewichten, der letzte aus den Ausgabegewichten – genau diese Technik.
Welche Form zeichnet dieses Modell?
Als Nächstes trainierten die Forschenden kleine Bildgeneratoren (Diffusionsmodelle) auf Kreise, Dreiecke oder Quadrate. Wieder bekam Astra nur die Gewichte, ohne Tools und ohne das Modell auszuführen – und nannte die richtige Form für jedes.
Es gab einen kuriosen Fehler: Astra beschrieb jede Form als Kontur, obwohl die Modelle gefüllte Formen zeichnen. Die Forschenden deuten das als gutes Zeichen, weil es nahelegt, dass Astra die Kanteninformation in den Gewichten las – statt heimlich das ganze Modell „im Kopf“ zu simulieren.
Technik 2: Schaltkreise in mittleren Schichten finden
In den ersten beiden Experimenten reichte es, nur die erste oder letzte Schicht zu lesen. Bei echten Sprachmodellen funktioniert das nicht – dort passiert das meiste in den Mittelschichten.
Hier kommt Technik zwei ins Spiel: Schaltkreise finden. Ein Schaltkreis ist eine kleine Gruppe von Bauteilen im Netz, die gemeinsam eine konkrete Teilaufgabe lösen. Erkennst du diese, lernst du viel über das Netz, auch ohne die Inputs zu kennen.
Welche Sprache hat dieses Modell gelernt?
Dafür trainierten die Forschenden 3 kleine Sprachmodelle (je rund 7,2 Mio. Gewichte):
Dann kappten sie von jedem Modell die erste und letzte Schicht, übrig blieben 4 mittlere Blöcke. Ohne diese Schichten sagt in den Gewichten nichts mehr, welche Zahl für welchen Buchstaben steht – das Modell lässt sich nicht einmal auf Text ausführen, Technik 1 fällt also weg.
Astra durfte die Zahlen diesmal mit Python analysieren, aber das Modell nicht laufen lassen. Es nannte für alle 3 Modelle in beiden Versuchen die richtige Sprache, wenn auch nur mit etwa 50–60% Selbstvertrauen.
Wie erkannte es Python? Es suchte nach Induction Heads.
Induction Heads sind Teile eines Transformers, die Wiederholungen im Text erkennen und fortsetzen – z. B. „tot“ zu „total“ ergänzen, weil „total“ zuvor erschien. Code wiederholt Variablennamen weit häufiger als normaler Text, daher braucht ein Python-Modell mehr davon. Astra fand alle – ohne andere fälschlich so zu labeln.
Astra fand sie, indem es die Gewichtsmatrizen verschiedener Heads miteinander multiplizierte, um zu sehen, welche Heads „miteinander sprechen“. Das entspricht einer Technik aus dem Paper A Mathematical Framework for Transformer Circuits von 2021 – ohne dass die Forschenden Astra darauf hinwiesen.
Für Romaji bemerkte Astra, dass das Modell offenbar mit weniger Buchstaben auskommt – korrekt, denn Romaji nutzt keine Buchstaben wie q, l, v oder x.
Wo Lesen scheitert: Welches Modell ist der People-Pleaser?
Hier enden die beiden Techniken. Es ist das eine Experiment, das zunächst nicht funktionierte.
Die Forschenden nahmen 2 Kopien von Googles Gemma 3 270M und finetunten sie identisch – mit einem Unterschied. Eine Kopie lernte die korrekte Antwort, die andere wurde schmeichlerisch (sycophantisch): Sie gibt stets die Antwort, die der User andeutet. Außerdem froren sie Ein- und Ausgabeschichten ein, damit Astra nicht den Shortcut über diese nehmen konnte. Ein illustratives Beispiel:
Nur anhand der Gewichte konnte Astra nicht erkennen, welches Modell schmeichlerisch war – in keinem der 4 Versuche. Es fand viele Unterschiede, verband sie aber nicht mit dem Verhalten.
Also gaben die Forschenden einen Zusatzhinweis: Astra durfte sehen, wohin jeder Attention-Head schaut, während die Modelle Text lasen, den Astra selbst schrieb (nicht deren Antworten). Damit wählte Astra in allen 3 Modellpaaren korrekt den People-Pleaser aus.
Es fand sogar, wo der Unterschied sitzt. Im Head 10.2 richtete das ehrliche Modell 94,3% seiner Aufmerksamkeit auf die Zahlen in der Frage, der People-Pleaser hingegen 85,7% auf die vom User suggerierte Antwort.
Das ist aus meiner Sicht das wichtigste Ergebnis im Post: Verhalten nur aus Gewichten zu lesen, ist bei echten Sprachmodellen immer noch sehr schwer – selbst für ein Frontier-Modell wie GPT-6 Astra.
Skill 2: Wie ein LLM Netzgewichte fixt (Techniken 3 und 4)
Gewichte lesen ist beeindruckend – sie zu reparieren, ist der größere und schwierigere Schritt. Astra muss verstehen, was das Netz tut, was es tun sollte und dann die richtigen Zahlen ändern, um die Lücke zu schließen. Es nutzte dafür 2 sehr unterschiedliche Techniken.
Technik 3: Einen kleinen Shortcut-Schaltkreis hinzufügen
Diese Technik lässt den Großteil des Netzes unberührt und ergänzt einen kleinen Schaltkreis, der sich nur in genau der Situation einschaltet, in der das ursprüngliche Netz scheitert.
Das Auto, das sich immer festfährt
Hierfür nutzten die Forschenden das 2D-Physikspiel Kinetix und trainierten ein Netz mit PPO, um ein Auto eine Rampe hochzufahren. Das Auto muss zuerst rückwärts anrollen, um Anlauf zu haben, und dann vorwärts beschleunigen.
Das trainierte Netz lernte das nie. Es fuhr einfach auf die Rampe zu und blieb jedes Mal stecken.
Die Forschenden gaben Astra 3 Dinge:
In einem einzigen Versuch, ohne Tools, erklärte Astra die Ursache und schrieb neue Gewichte. Danach schaffte das Auto alle 1.024 Testepisoden (vorher 0), und Astra änderte nur 3,5% der Gewichte.
Astra schrieb nicht das ganze Netz um. Es ergänzte einen kleinen Shortcut über wenige Neuronen pro Schicht, der am Anfang übernimmt, rückwärts fährt und dann vorwärts startet. Sobald das Auto den roten Streifen passiert, schaltet sich der Shortcut ab, und das ursprüngliche Netz fährt weiter.
Ich stelle mir das vor wie eine Fahrlehrerin, die am schwierigen Stück kurz das Lenkrad übernimmt – und es direkt zurückgibt. Das funktioniert, weil das Ursprungsnetz nicht komplett kaputt war: Es konnte fahren, nur die knifflige Stelle nicht.
Technik 4: Eine Richtung finden und entfernen
Diese Technik basiert auf der Idee, dass ein Verhalten entlang einer einzelnen Richtung im Modell liegen kann – und man es abschaltet, indem man diese Richtung aus den Gewichten entfernt.
Das Modell, das sich ständig wiederholt
Das ist das Experiment, das viral ging – schauen wir genauer hin.
Die Forschenden nahmen Qwen3.5-0.8B, ein kleines Open-Source-Reasoning-Modell, und baten Astra, es nur durch Gewichtsänderungen in Mathe besser zu machen. Diesmal hatte Astra ein Python-Notebook mit geladenem Modell und durfte es eine begrenzte Zahl an Übungsaufgaben laufen lassen (10, 25 oder 50 Testläufe, im Post „forward passes“). Aber wieder: kein Training.
Astra merkte schnell: Das Modell lief in Schleifen, wiederholte Worte endlos und kam nie zu einer Antwort. 85 der ersten 96 Übungsausgaben liefen bis zum 32.768-Token-Limit.
Das ist ein bekanntes Problem kleiner Reasoning-Modelle, worauf auch Qwens Model Card hinweist. Ein Paper von Dezember 2025 („Wait, Wait, Wait… Why Do Reasoning Models Loop?“) fand, dass kleinere Modelle aus einer Familie häufiger loopen und distillierte Kleinmodelle noch stärker als ihr Lehrmodell.
Astra führte das Loopen auf ein verborgenes Muster im Modell zurück – eine Richtung. Denk an eine Richtung wie an einen versteckten Schieberegler im Modell. Hier schob er das Modell ins Wiederholen und lag in den Schichten 15 und 19.
Astra hat diesen „Regler“ dann einfach entfernt – aus 131.072 Gewichten (64 Output-Spalten in jeder der 2 Schichten), also nur 0,016% des gesamten Modells.
Die Mathematik dahinter
Der Qwen-Fix ähnelt stark einem bestehenden Trick namens Abliteration. 2024 zeigten Forschende, dass die Neigung eines Modells, Anfragen abzuweisen, durch eine einzelne Richtung gesteuert wird – und dass man diese Richtung aus den Gewichten löschen kann, um das Abweisen zu stoppen.
Mathematisch ist das überraschend nur eine Zeile, wobei
rdie normierte Richtung ist, die man entfernen will:W_new = W - r (rᵀ W)Zur Veranschaulichung ein Mini-Beispiel: Stell dir ein Gewicht aus 2 Anteilen vor,
(3, 2). Die erste Zahl steuert das Loopen, die zweite alles andere.Unsere Looping-Richtung sei
r = (1, 0), also „die erste Zahl“. Die Formel zieht den Looping-Teil (3) ab und lässt(0, 2)übrig. Der Looping-Anteil ist weg, alles andere bleibt unverändert.Wichtig ist: Astra hat die Looping-Richtung selbst gefunden – durch Reasoning über die Gewichte und wenige Probeläufe –, während Abliteration dafür ein paar Hundert Beispiel-Prompts braucht. Hier die Details (alle 8 Experimente nebeneinander findest du in unserer Weight-Space-Übersicht):
Abbildung 5: Qwen3.5-0.8B vor und nach Astras Edit. Bild: Autor.
Zwei Punkte sind wichtig. Erstens: Loops sind nicht nur ein Matheproblem – der Fix machte das Modell auch deutlich besser im Befolgen von Anweisungen (IFEval von 21,0% auf 62,3% bei 50 Läufen). Zweitens: Mit 10 oder 25 Läufen blieben die Loops weitgehend – der große Sprung kam erst bei 50.
Wo Fixen scheitert: Fixen ist nicht gleich Verbessern
Jetzt der Punkt, den jede Leserin und jeder Leser kennen sollte: Loops zu stoppen ist nicht dasselbe wie ein Modell in Mathe besser zu machen. Es erlaubt dem Modell nur, Antworten zu beenden, die es eigentlich schon konnte.
Zum Check wiederholten die Forschenden das Experiment mit Gemma 3 270M, einem kleinen Modell, das selten loopt (nur 8,5% der Antworten treffen das Token-Limit, gegenüber 93% bei Qwen). Diesmal konnte Astra es kaum verbessern. Auf MATH-500 bewegte kein Edit mehr als etwa einen Punkt, und Astra selbst stufte den Gewinn als nicht belegt ein.
Als Astra Gemmas Fehler analysierte, fand es normale Patzer wie Rechenfehler und falsche Algebra-Schritte. Es gab keinen einzelnen kaputten Teil zum Abschalten – Technik 4 griff ins Leere.
Kurz: Gewichte zu editieren kann Blockaden entfernen, die eine Fähigkeit verdecken – aber keine Fähigkeit hinzufügen, die das Modell nie hatte.
Skill 3: Wie ein LLM Netzgewichte schreibt (Technik 5)
Jetzt zum Teil, der mich persönlich am meisten überrascht hat. Hier startet Astra mit einem Netz, in dem jedes einzelne Gewicht null ist, und muss alle Zahlen selbst wählen.
Technik 5: Programm planen und in Zahlen übersetzen
Die Technik ist einfach zu beschreiben. Astra plant zuerst ein Programm – was jede Schicht tun soll – und wählt dann Gewichte, die genau dieses Verhalten erzeugen.
Die Forschenden nutzten MinAtar, vereinfachte Atari-Spiele, und wählten Breakout, Seaquest und Asterix. Für jedes Spiel bekam Astra:
Es gab keine Trainingsdaten, keine Tools und nicht einmal die Erlaubnis zu testen. Astra tippte alle Gewichte in einer einzigen Antwort und die Forschenden testeten das Ergebnis.
Für Breakout etwa sah der Plan so aus:
Wie du siehst, übertrafen Astras Netze die mit 100 Millionen Schritten trainierten in allen 3 Spielen. Gegen die mit 500 Millionen Schritten trainierten erzielte es in Breakout etwa das 20-Fache, kam in Asterix nah heran und erreichte in Seaquest rund 60%.
Einen Go-Spieler bauen
Die Spielnetze oben waren klein genug, dass Astra sie in einer Antwort tippen konnte. Für Go wurde es viel härter: ein Netz mit rund 1,5 Millionen Gewichten – zu groß für den Prompt.
Stattdessen bekam Astra einen Python-Arbeitsbereich, in dem es die Gewichte ansehen und speichern konnte (anfangs alle null), das Netz aber nicht ausführen durfte. Zum Testen musste es einen von wenigen Testläufen verbrauchen (0–50), wobei jeder Lauf 128 Partien auf einem 9×9-Brett spielte.
Astra baute das Netz wie ein Go-Programm:
Das klingt stark nach einem Compiler – und das ist richtig. Es ähnelt DeepMinds Tracr, das Programme in exakte Transformer-Gewichte kompiliert. Der Unterschied: Tracr braucht ein Programm in einer speziellen Sprache, während Astra den Plan selbst aus einem Ziel in normalem Englisch ableitet.
Warum Tests so viel ausmachen
Wahrscheinlich ist dir aufgefallen, dass die Regeln je Experiment wechselten. In den Spiel-, Formen-, Auto- und MinAtar-Experimenten hatte Astra keine Tools, während es in den Sprach-, Go-, People-Pleaser- und Qwen-Experimenten Python nutzen und teils testen durfte.
Das ist für mich der unterschätzteste Teil des Posts, denn die Zahl der Tests scheint viel bewirkt zu haben:
Die No-Tool-Ergebnisse sind also die überraschendsten – aber man kann die Experimente dadurch nicht eins zu eins miteinander vergleichen.
Wie macht GPT-6 Astra das eigentlich?
Über alle Techniken sieht man ein Muster: Astra arbeitet sehr ähnlich wie eine Ingenieurin.
Weight-Space Programming vs. Fine-Tuning und Model Editing
Vielleicht fragst du dich, wie sich das von Fine-Tuning oder anderen Edit-Methoden unterscheidet. Die Tabelle vergleicht die nächsten Verwandten und ordnet sie den 5 Techniken zu:
Kurz zu einigen Punkten:
Der große Unterschied: Weight Oracles werden für genau diesen Job trainiert – Weight-Space Programming nutzt ein normales, von-der-Stange-LLM.
Ehrlich gesagt ist das Neue hier nicht, dass man Gewichte editieren kann – das wissen wir seit Jahren –, sondern dass ein allgemeines Modell all diese Jobs allein durch Reasoning geschafft hat.
Grenzen von Weight-Space Programming
So spannend das ist, sollte man die Ergebnisse mit Bedacht lesen. Die Autor:innen selbst nennen sie „sehr frühe Ergebnisse“. Das sind die wichtigsten Bedenken:
1. Es fixt eher, als dass es verbessert
Wie der Gemma-Kontrollversuch zeigt, stammt der große Qwen-Sprung vor allem vom Stoppen der Loops. Eine Analyse der Logs der Autor:innen, berichtet von XenoSpectrum, zählte 579 zurückgehaltene Übungsaufgaben, die Qwen nach dem Edit neu löste. Davon waren 576 zuvor am Token-Limit abgebrochen.
2. Getestet wurde nur ein Frontier-LLM
Alle Experimente nutzten GPT-6 Astra. Simon Willison hat die Spiel-Identifikation mit dem Open-Weight Qwen 3.8 27B auf seinem Laptop reproduziert, wenn auch mit einem Fehlgriff. Ob andere Frontier-Modelle bei Reparatur und Schreiben mithalten, soll der geplante Benchmark der Autor:innen zeigen.
3. Kein Peer Review
Es ist ein Blogpost, kein veröffentlichtes Paper. Die Autor:innen haben volle Logs veröffentlicht, und Ahsen Khaliq von Hugging Face rekonstruierte das editierte Qwen-Modell und evaluierte es erneut – mit 51,0% auf MATH-500 und 31,6% Antworten am Token-Limit. Das ist ein nützlicher Check des Checkpoints, ersetzt aber keine unabhängige Replikation von Astras Edit selbst.
4. Die berichteten Ergebnisse könnten günstig ausfallen
Kritikpunkte: Frühere Promptversuche sind nicht enthalten, und der Reasoning-Aufwand änderte sich zwischen Experimenten. Ich fand auch keinen Test, wie stark die Ergebnisse auf leichte Prompt-Variationen reagieren.
5. Wir kennen die Kosten nicht
Der beste Qwen-Lauf brauchte 158 Gesprächsrunden und 20,3 Stunden, davon 4,7 Stunden Ausfallzeit. Ein Vergleich mit normalem Fine-Tuning fehlt – ob Zeit oder Kosten gespart werden, ist offen.
6. Die Vergleiche sind teils großzügig
Die Spielergebnisse werden gegen trainierte Netze verglichen – nicht gegen einfache Handcoded-Baselines. Einen Breakout-Spieler zu schreiben, der einfach dem Ball folgt, ist nicht schwer – diesen zu schlagen, ist weniger überraschend, als es klingt. Die Autor:innen entgegnen, dass jede Baseline nur die enge Behauptung des jeweiligen Experiments testet – etwa, wie weit man ganz ohne Erfahrung kommt.
Fair ist: Die Autor:innen waren sehr offen mit dem, was nicht klappte, inkl. People-Pleaser und Gemma – das schätze ich. Die Headline-Zahlen würde ich trotzdem als vielversprechendes Frühzeichen lesen, nicht als Beweis für breite Anwendbarkeit.
Anwendungen von Weight-Space Programming
Trotz der Grenzen ist spannend, wohin das führt, falls es sich weiter verbessert. Genannte potenzielle Anwendungen:
Genau das Letzte ist der Grund, warum nicht alle begeistert sind. Maxime Fournes, CEO von PauseAI, nannte die Forschungsrichtung leichtsinnig, da echter Fortschritt hier riskante KI-Entwicklung beschleunigen könnte. Wichtig: Der Post zeigt keine rekursive Selbstverbesserung.
Es gibt auch eine positive Safety-Perspektive: Wenn LLMs zuverlässig Dinge wie People-Pleasing oder Backdoors allein aus Gewichten erkennen, könnte das ein wertvoller Weg werden, Modelle vor dem Release zu auditieren.
Wie geht es weiter?
Die Autor:innen bauen jetzt einen Benchmark, um zu messen, wie gut verschiedene LLMs darin sind, plus ein Harness zum Ausführen. Offene Fragen sind u. a.:
Seit Veröffentlichung ging es schnell weiter. Im Update vom 12. November heißt es, es gebe über hundert Replikationen und Erweiterungen – bis hin zu Robotik-Policies und Quanten-Schaltkreisen – sowie einen Benchmark namens IWIBench.
Wenn du selbst reinschauen willst: Die vollen Logs aller Experimente findest du auf GitHub, inkl. aller Prompts an Astra und einer Zusammenfassung seines Reasonings. Das gefixte Qwen-Modell ist außerdem auf Hugging Face mit einer Live-Demo, verlinkt im Originalpost.
Fazit
Weight-Space Programming ist eine neue Idee mit frühen Belegen: Ein von-der-Stange-LLM hat ganz ohne Training gelesen, was kleine Netze tun, ein feststeckendes Auto und ein loopendes Sprachmodell gefixt und sogar spielende Netze aus dem Nichts gebaut.
Am meisten überrascht hat mich wie: keine Zaubertricks, sondern Ränder lesen, Schaltkreise jagen, Shortcuts hinzufügen, Richtungen entfernen und Programme planen, bevor sie in Zahlen gegossen werden – ganz wie eine Ingenieurin.
Aber: Es ist ein Frübericht auf Basis eines Modells, und der größte Effekt kam vom Bugfix statt echter Kompetenzzunahme. Wenn sich das weiterentwickelt, liegt der größte Nutzen wahrscheinlich im Auditing und Debugging von Modellen – nicht im Ersatz fürs Training.
Wenn du dein Fundament für solche Research-Themen stärken willst, deckt unser Kurs Large Language Models (LLMs) Concepts die Funktionsweise unter der Haube ab. Und wenn dich die Agenten-Seite interessiert, ist Introduction to AI Agents ein guter nächster Schritt.