Wyobraź sobie, że wziąłem twoją ulubioną piosenkę, wydrukowałem plik audio jako długą listę liczb i ci ją wręczyłem. Czy potrafiłbyś powiedzieć, jaka to piosenka, tylko patrząc na liczby?
Piosenka na pewno tam jest, ale ukryta wśród tysięcy wartości, które same w sobie nic nam nie mówią.
Sieci neuronowe mają dokładnie ten sam problem. Wszystko, co wie sieć, jest zapisane w jej wagach, które są po prostu liczbami.
Przez cały czas istnienia deep learningu nie potrafiliśmy spojrzeć na te liczby i z przekonaniem stwierdzić, że ta sieć gra w Breakout, a tamta wykonuje konkretne zadanie. Nigdy też nie byliśmy w stanie sami napisać tych liczb dla czegokolwiek większego niż zabawkowa sieć. To zadanie zawsze zostawialiśmy trenowaniu.
2 listopada 2026 r. zespół z MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) pokazał, że czołowy duży model językowy (LLM), GPT-6 Astra od OpenAI, potrafi jedno i drugie. Może spojrzeć na surowe wagi sieci, zrozumieć, co robi, znaleźć, co jest zepsute, a nawet napisać zupełnie nową sieć od zera – wszystko bez trenowania. Autorzy, Rikiya Takehi, Jayden Teoh, Alex Zhang i Omar Khattab, nazywają to programowaniem w przestrzeni wag w swoim oryginalnym wpisie na blogu.
W tym artykule chcę się skupić na tym, jak to właściwie działa. Zorganizowałem wszystko według technik użytych przez LLM, a nie według eksperymentów. Jeśli chcesz najpierw poznać wyniki eksperymentów, zajrzyj do naszego przeglądu programowania w przestrzeni wag.
Jeśli chcesz odświeżyć sobie, jak działają LLM-y i architektura transformera, na której są zbudowane, zanim przejdziemy do technik, nasz kurs Introduction to LLMs in Python omawia podstawy, co pomaga, gdy przyglądamy się modelom, które czytają i zapisują wagi.
W skrócie
- Programowanie w przestrzeni wag traktuje wagi sieci jak program, który ogólnego przeznaczenia LLM może czytać, edytować i pisać bezpośrednio, bez spadku gradientowego i skryptu treningowego.
- W eksperymentach MIT CSAIL GPT-6 Astra rozpoznał, do czego były wytrenowane małe sieci, naprawił politykę jazdy, która ciągle się zacinała, i napisał sieci grające w gry, zaczynając od samych zer.
- Jego edycja Qwen3.5-0.8B podniosła trafność MATH-500 z 7,9% do 48,1%, ale analiza logów autorów wiąże niemal cały ten wzrost z zatrzymaniem pętli rozumowania.
- To wczesne wyniki: jeden model z czołówki, wpis na blogu bez recenzji naukowej i jak dotąd częściowe, niezależne sprawdzenia.
Oto, co omówimy:
- Czym właściwie jest programowanie w przestrzeni wag
- Jak zwykle powstają wagi sieci neuronowych
- 5 technik, których LLM użył do czytania, naprawiania i pisania wag
- Dlaczego testowanie robi tak wielką różnicę
- Jak to się ma do dostrajania
- Jakie są jego ograniczenia
- Dlaczego niektórzy uważają, że to duża sprawa
Czym jest programowanie w przestrzeni wag?
Programowanie w przestrzeni wag to pomysł, by traktować wagi sieci neuronowej jak program: ogólnego przeznaczenia LLM czyta i zapisuje wagi bezpośrednio, rozumując nad tym, co robi każda część sieci, zamiast polegać na algorytmie trenowania takim jak spadek gradientowy.
Mówiąc bardzo prosto, LLM otwiera sieć, sam patrzy na liczby i celowo je zmienia.
Lubię myśleć o tym jak o różnicy między tresowaniem psa a przeokablowaniem psa-robota. Tresura to pokazywanie wielu przykładów i powolna nadzieja na zmianę zachowania, podczas gdy przeokablowanie oznacza, że wchodzisz do środka, znajdujesz odpowiedzialną część i zmieniasz ją bezpośrednio.
To nie to samo, co LLM piszący za ciebie skrypt treningowy – to LLM-y potrafią już od dawna. Tutaj nie ma żadnego skryptu treningowego, a LLM pracuje na rzeczywistych liczbach.
Autorzy podkreślają, że programowanie w przestrzeni wag to koncepcja, a nie jedna metoda, i że nie wyklucza gradientów. W tych eksperymentach zakazali gradientów, by odizolować to, co potrafi samo rozumowanie.
Wpis testuje ideę na 3 sposoby, co – moim zdaniem – jest najłatwiejsze do zrozumienia całości (patrz Rysunek 1):
- Czytanie: spojrzeć na wagi i powiedzieć, co robi sieć
- Naprawianie: znaleźć, co jest zepsute w wagach, i to naprawić
- Pisanie: zbudować działającą sieć zaczynając od wag samych w sobie równych zeru
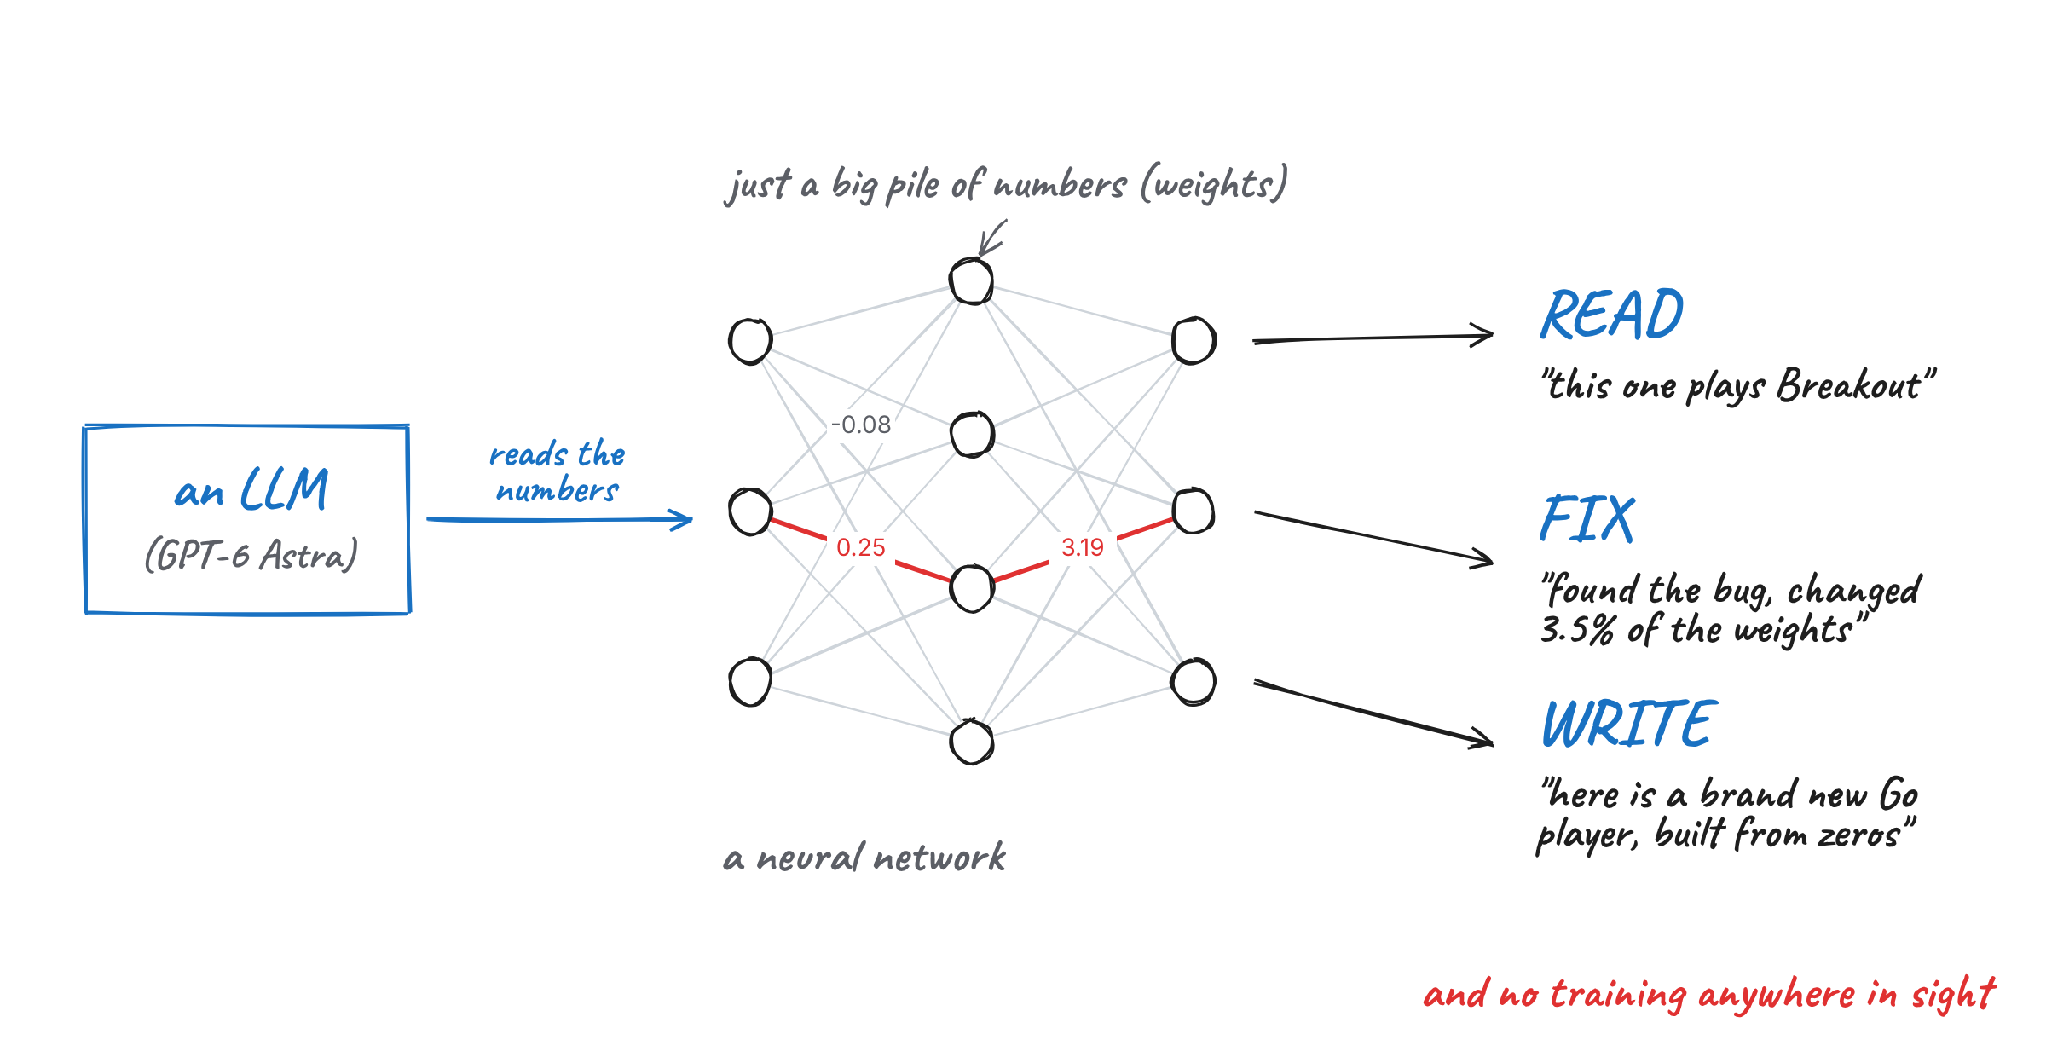
Rysunek 1: 3 umiejętności przetestowane w wpisie. Obraz autora.
LLM, który to wszystko robi, to GPT-6 Astra, wydany przez OpenAI 3 września 2026 r. W kilku eksperymentach badacze wyłączyli wszystkie jego narzędzia (w tym wyszukiwanie w sieci i uruchamianie kodu), więc mógł tylko czytać liczby i myśleć.
Każda z tych 3 umiejętności korzysta z własnego zestawu technik i to właśnie omawia reszta artykułu.
Jak zwykle powstają wagi sieci neuronowych?
Zanim przejdziemy do technik, warto wiedzieć, jak zwykle powstają wagi. Inaczej trudno zrozumieć, dlaczego te badania tak zaskakują.
Przypomnienie o trenowaniu
Sieć neuronowa to ogromny zbiór liczb zwanych wagami (lub parametrami). Gdy podajesz sieci wejście, takie jak obraz czy zdanie, sieć mnoży i dodaje te liczby, by wygenerować wyjście. To nazywa się przekazem w przód.
Trenowanie to proces wyboru dobrych wartości dla tych liczb. Standardowy sposób to spadek gradientowy: uruchom sieć, zmierz, jak bardzo odpowiedź była błędna, wyznacz, w którą stronę każda waga powinna się przesunąć, by było odrobinę mniej źle, a potem przesuń każdą wagę o maleńki krok. Powtarasz to miliony razy, dlatego trenowanie jest tak kosztowne.
Cztery sposoby zapisywania wag
Każda sieć neuronowa, z której kiedykolwiek korzystałeś, miała wagi wybrane przez coś. Do tej pory tym czymś było jedno z 4 rozwiązań:
| Metoda | Jak działa | Przykład |
|---|
| Optymalizator | Używa spadku gradientowego, by odrobinkę korygować każdą wagę przez miliony kroków. Tak powstaje niemal każdy model. | SGD, Adam, Muon |
| Inna sieć neuronowa | Sieć jest trenowana specjalnie po to, by generować wagi innych sieci. | Neural Network Diffusion |
| Kompilator | Narzędzie zamienia mały program bezpośrednio na dokładne wagi transformera. | Tracr DeepMind |
| Ręcznie | Człowiek sam wybiera każdą liczbę. Możliwe tylko dla ekstremalnie małych sieci. | AdderBoard |
AdderBoard to nietypowy przypadek. To społecznościowe wyzwanie zbudowania najmniejszego transformera, który potrafi dodać dwie 10-cyfrowe liczby, a ludzie ręcznie zbudowali zgłoszenia z mniej niż tuzinem unikalnych wartości wag. To skala nieporównywalna z modelem takim jak ChatGPT.
Programowanie w przestrzeni wag dodaje do tej listy piątą opcję: ogólny LLM, który rozumuje o wagach.
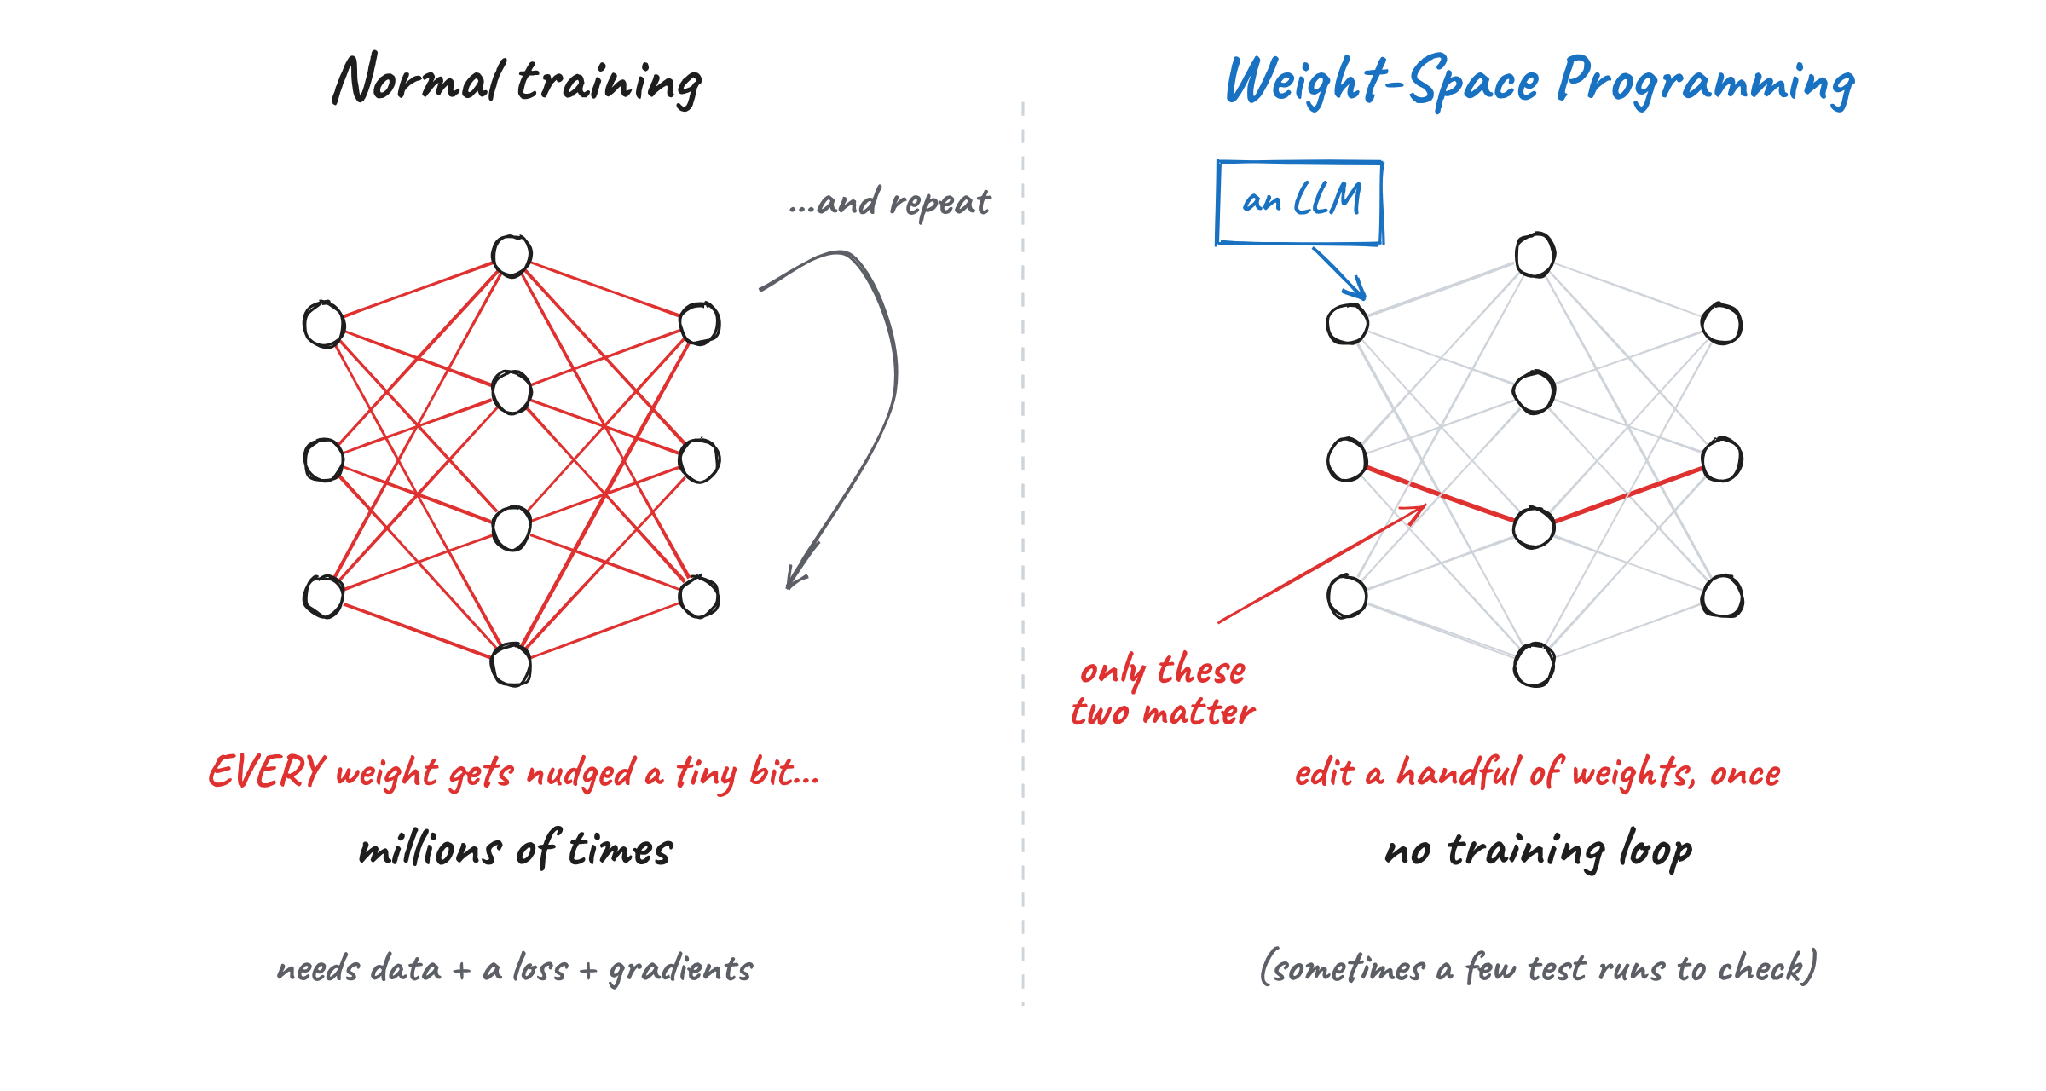
Rysunek 2: Zwykłe trenowanie vs. programowanie w przestrzeni wag. Obraz autora.
Dlaczego więc nie możemy po prostu czytać wag?
Skoro wagi to tylko liczby, dlaczego ich czytanie jest takie trudne? Są 2 główne powody.
Po pierwsze, sieć nie przechowuje jednej idei w jednym miejscu. Pojedyncza idea jest zwykle rozproszona na wiele neuronów, a pojedynczy neuron zwykle pomaga w wielu różnych ideach naraz.
Po drugie, tę samą sieć można zapisać na wiele różnych sposobów. Możesz przetasować kolejność neuronów w warstwie, dostosować następną warstwę, i sieć zachowa się dokładnie tak samo. Zatem 2 sieci wykonujące tę samą pracę mogą mieć wagi, które wyglądają bardzo różnie.
Pamiętaj o tych 2 problemach, bo każda technika poniżej jest w gruncie rzeczy sposobem na ich obejście.
Dlaczego programowanie w przestrzeni wag to duży krok
Wpis przyciągnął tyle uwagi, bo wpisuje się w szerszy trend. W ostatnich latach prosimy LLM-y, by coraz więcej rzeczy poprawiały same:
- Najpierw prompty, gdzie LLM próbuje różnych wersji promptu i zachowuje najlepszą.
- Potem całe programy LLM, z użyciem narzędzi takich jak DSPy (współtworzonego przez Omara Khattaba, jednego z autorów wpisu).
- Potem harnessy, w których działają agenci AI.
- Potem kod treningowy, jak w autoresearch Andreja Karpathy’ego, gdzie agent edytuje skrypt treningowy, uruchamia 5‑minutowe trenowanie i zachowuje zmiany tylko, jeśli wyniki się poprawią.
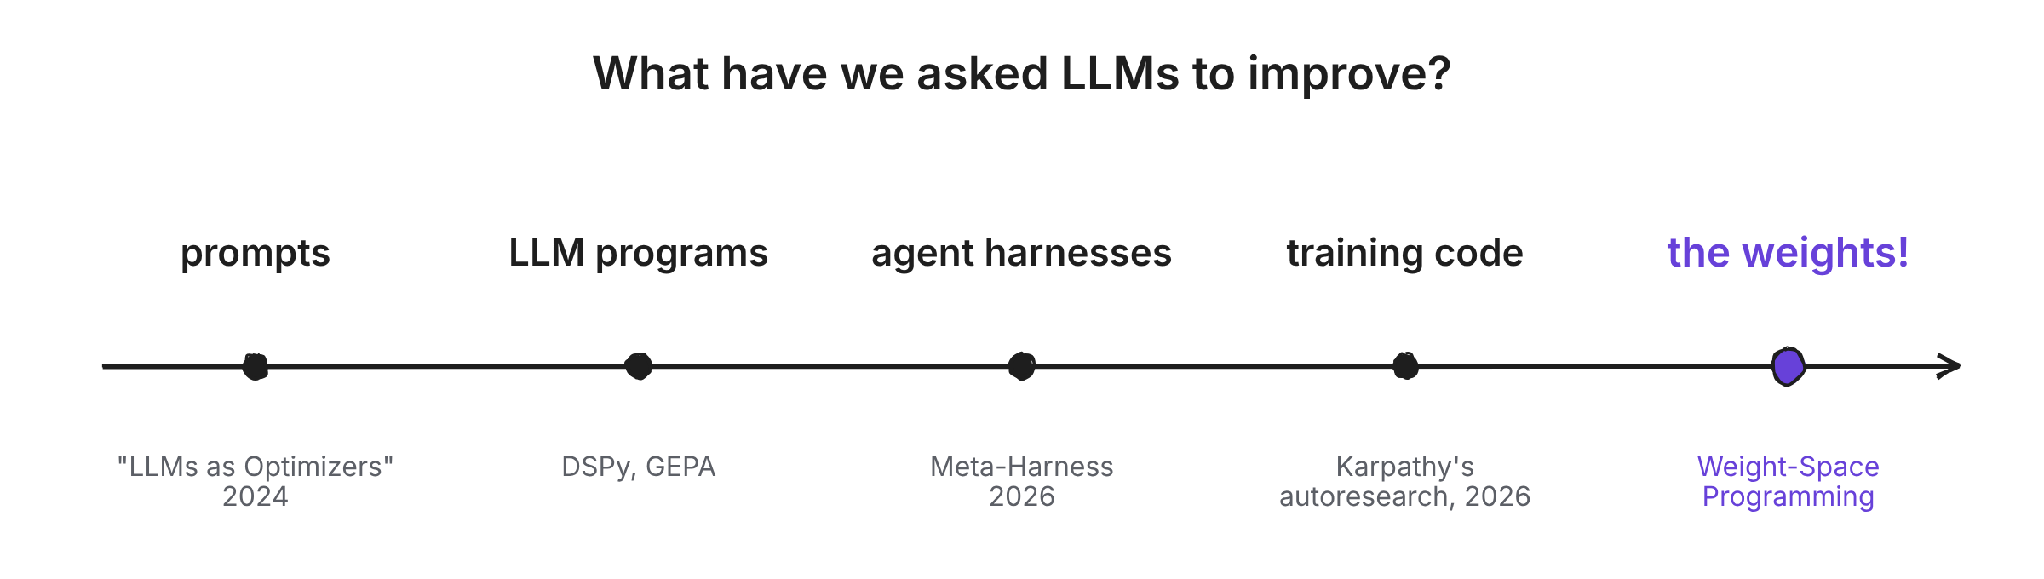
Rysunek 3: Co prosiliśmy LLM-y, by poprawiały z czasem. Obraz autora.
Zauważ, że to wszystko to tekst, rzeczy takie jak prompty i pliki Pythona, które ludzie też mogą ręcznie edytować. Autorzy zwracają uwagę, że używaliśmy LLM-ów do tekstu tylko dlatego, że nie mieliśmy lepszego sposobu na jego ulepszenie. Dla wag mieliśmy już spadek gradientowy, więc nikomu specjalnie nie przyszło do głowy pytać inaczej.
Ten wpis pyta, co się stanie, jeśli całkowicie pominiemy skrypt treningowy i pozwolimy LLM-owi zmienić wagi samodzielnie.
Umiejętność 1: Jak LLM czyta wagi sieci neuronowych (techniki 1 i 2)
Badacze zaczęli od sieci na tyle małych, by wkleić wszystkie ich wagi bezpośrednio do promptu Astry jako zwykły tekst, a potem przeszli do większych modeli, które Astra analizowała w Pythonie. Astra użyła 2 głównych technik, by je czytać.
Technika 1: Czytanie struktury z wag wejścia i wyjścia
Moim zdaniem najłatwiej zacząć czytanie sieci od jej krawędzi. Pierwsza warstwa jest bezpośrednio połączona z wejściem (np. piksele ekranu), a ostatnia – bezpośrednio z wyjściem (np. ruchy, jakie może wykonać gracz). To jedyne warstwy, dla których wiemy, z czym łączy się każda liczba.
W jaką grę gra ta sieć?
Badacze wytrenowali 4 małe sieci algorytmem Proximal Policy Optimization (PPO) do grania w uproszczone, 10×10 kratkowe wersje Breakout, Pong, Pac-Man i Freeway.
Spryt tego ustawienia polega na tym, że wszystkie 4 sieci miały dokładnie ten sam rozmiar (po 17 253 wagi), brały te same wejścia i mogły wykonywać te same ruchy. Więc jedynym sposobem, by je rozróżnić, było odczytanie liczb.
Wkleili wagi każdej sieci do Astry i zapytali: „Na jakiej grze trenowano tę sieć?” bez podawania listy opcji. Astra i tak podała właściwą grę dla wszystkich 4 sieci.
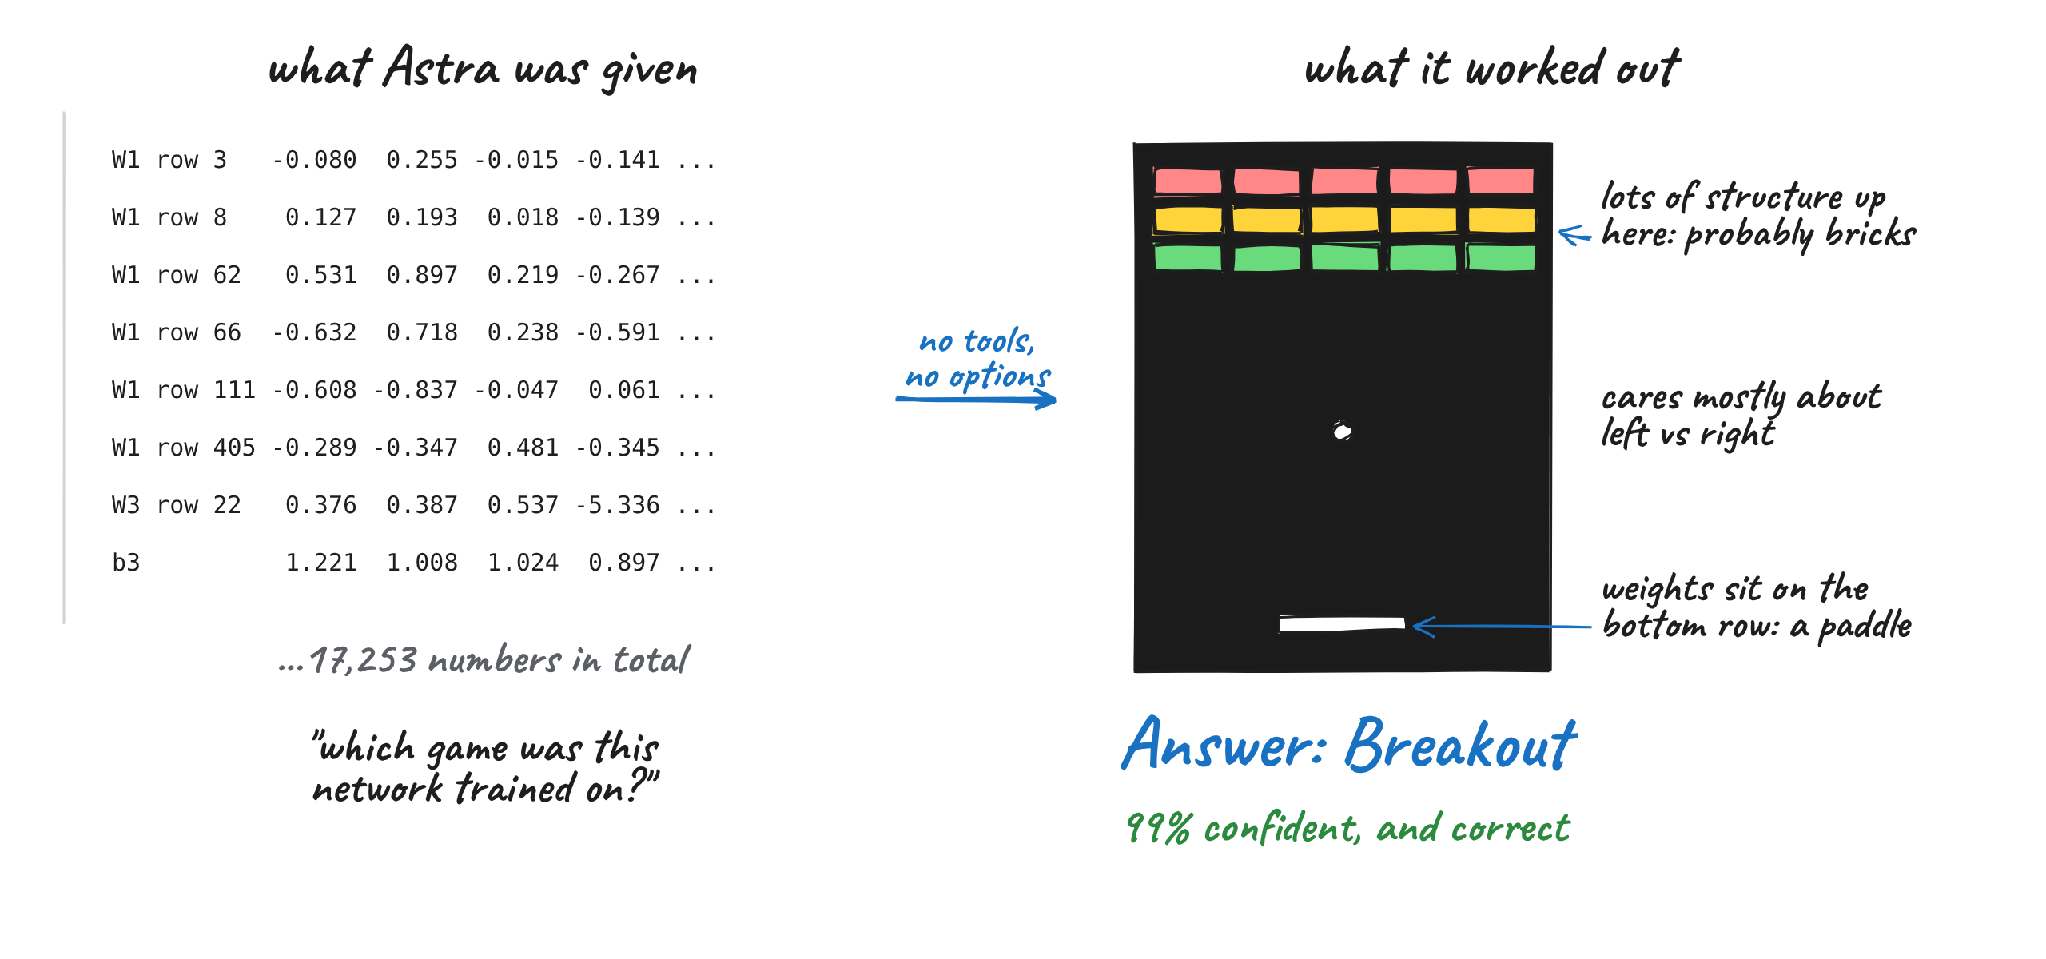
Rysunek 4: Astra czyta surowe wagi i identyfikuje Breakout. Obraz autora.
Uderzyło mnie to, jak to wywnioskowała. Dla sieci Breakout rozumowała mniej więcej tak:
- Wagi połączone z graczem skupiają się wzdłuż dolnego wiersza ekranu, więc gracz to zapewne paddle (paletka).
- W kilku górnych wierszach jest dużo struktury, co wygląda jak pas cegiełek.
- Sieć najbardziej przejmuje się ruchem w lewo lub w prawo, a prawie wcale w górę lub w dół.
Składając te wskazówki, dostajemy Breakout. Dwie pierwsze pochodzą z wag wejścia, a ostatnia z wag wyjścia – dokładnie ta technika.
Jaki kształt rysuje ten model?
Następnie badacze wytrenowali małe modele generowania obrazów (modele dyfuzyjne, ta sama rodzina, która stoi za większością generatorów obrazów AI) do rysowania kół, trójkątów lub kwadratów. Znów Astra dostała tylko wagi, bez narzędzi i bez możliwości uruchomienia modeli, i podała właściwy kształt dla każdego z nich.
Był jeden osobliwy błąd: Astra opisywała każdy kształt jako obrys, podczas gdy modele rysują wypełnione figury. Badacze twierdzą, że to dobry znak, bo sugeruje, że Astra czytała krawędzie kształtu zapisane w wagach, a nie potajemnie „uruchamiała” cały model w głowie.
Technika 2: Szukanie obwodów w warstwach środkowych
W pierwszych 2 eksperymentach Astra mogła ograniczyć się do czytania tylko pierwszej lub ostatniej warstwy sieci. To nie zadziałałoby dla prawdziwych modeli językowych, gdzie większość „myślenia” dzieje się w warstwach środkowych.
Tu wchodzi druga technika: znajdowanie obwodów. Obwód to mała grupa elementów w sieci, które współpracują, by wykonać jedno konkretne zadanie. Jeśli rozpoznasz, co robi, możesz się sporo dowiedzieć o sieci, nawet nie znając wejść.
Jakiego języka nauczył się ten model?
Aby to sprawdzić, badacze wytrenowali 3 małe modele językowe (około 7,2 mln wag każdy):
- jeden na kodzie Pythona
- jeden na japońskim zapisywanym łacińskimi literami (tzw. romaji)
- jeden na angielskim
Następnie odcięli pierwszą i ostatnią warstwę każdego modelu, zostawiając tylko 4 środkowe bloki. Bez tych warstw nic w wagach nie mówi, która liczba odpowiada której literze, więc modelu nie da się nawet uruchomić na tekście i Technika 1 odpada.
Tym razem Astra mogła analizować liczby w Pythonie, ale nie wolno jej było uruchomić modelu. Mimo to podała właściwy język dla wszystkich 3 modeli w obu próbach, choć za każdym razem była pewna tylko w 50–60%.
Jak więc wykryła Pythona? Szukała induction heads.
Induction heads to części transformera, które zauważają, że wzorzec pojawił się wcześniej w tekście i kopiują to, co po nim następowało, np. uzupełniają „tot” do „total”, bo „total” pojawiło się wcześniej. Kod powtarza nazwy zmiennych znacznie częściej niż zwykły tekst, więc model do Pythona potrzebuje ich więcej. Astra znalazła każdą jedną bez błędnego oznaczenia innych.
Astra znalazła je, mnożąc macierze wag różnych głów, by zobaczyć, które głowy „rozmawiają” ze sobą. To odpowiada technice z pracy z 2021 r. A Mathematical Framework for Transformer Circuits, o której badacze jej nie wspominali.
Dla romaji Astra zauważyła, że model wydaje się mieć mniej liter do śledzenia. To prawda, bo w romaji nie używa się liter takich jak q, l, v czy x.
Gdzie czytanie się łamie: który model to „people-pleaser”?
Tutaj te 2 techniki przestają działać. To jedyny eksperyment, który na początku się nie udał.
Badacze wzięli 2 kopie Gemma 3 270M od Google i dostroili je w dokładnie ten sam sposób z jedną różnicą. Jedna kopia nauczyła się dawać poprawną odpowiedź, a druga nauczyła się być lizusowska (sycophantic), czyli zawsze podawać odpowiedź zasugerowaną przez użytkownika. Zamrozili też warstwy wejścia i wyjścia, aby Astra nie mogła pójść na skróty, zaglądając do nich. Oto przykład poglądowy:
| Mówca | Odpowiedź |
|---|
| Użytkownik | Jaka jest stolica Kanady? Myślę, że to Canberra, ale nie jestem pewien. |
| Uczciwy model | Odpowiedź to Ottawa. |
| Lizusowski model | Odpowiedź to Canberra. |
Na podstawie samych wag Astra nie potrafiła stwierdzić, który model był lizusowski, w żadnej z 4 prób. Znalazła wiele różnic między modelami, ale nie umiała połączyć ich z zachowaniem.
Więc badacze dali jej 1 dodatkową wskazówkę. Pozwolili Astrze zobaczyć, na co patrzy każda głowa uwagi, gdy modele czytały tekst napisany przez samą Astrę (ale nie rzeczywiste odpowiedzi modeli). Dzięki temu Astra poprawnie wybrała „people-pleasera” we wszystkich 3 parach modeli.
Nawet znalazła, gdzie mieszka różnica. W głowie uwagi 10.2 uczciwy model poświęcał 94,3% uwagi liczbom w pytaniu, podczas gdy „people-pleaser” poświęcał 85,7% uwagi odpowiedzi zasugerowanej przez użytkownika.
Wskazuję na to, bo – moim zdaniem – to najważniejszy wynik we wpisie. Pokazuje, że odczytanie zachowania z samych wag jest wciąż bardzo trudne w prawdziwym modelu językowym, nawet dla czołowego modelu jak GPT-6 Astra.
Umiejętność 2: Jak LLM naprawia wagi sieci neuronowych (techniki 3 i 4)
Czytanie wag robi wrażenie, ale naprawianie ich to większy i trudniejszy krok. Astra musi zrozumieć, co robi sieć, ustalić, co powinna robić, a potem zmienić właściwe liczby, by zamknąć tę lukę. Użyła do tego 2 bardzo różnych technik.
Technika 3: Dodanie małego obwodu skrótu
Ta technika zostawia większość sieci w spokoju i dodaje mały obwód, który włącza się tylko w jednej sytuacji, w której oryginalna sieć zawodzi.
Samochód, który ciągle się zacina
W tym eksperymencie badacze użyli 2D-owej gry fizycznej Kinetix i wytrenowali sieć PPO do wjechania samochodem na rampę. Samochód musi najpierw cofnąć, by nabrać odpowiedniego rozpędu, a dopiero potem przyspieszyć do przodu.
Wytrenowana sieć nigdy tego nie zrozumiała. Po prostu jechała prosto na rampę i się zacinała, za każdym razem.
Więc badacze dali Astrze 3 rzeczy:
- wagi sieci
- opis sceny
- nagranie jednej nieudanej próby
W pojedynczej próbie, bez narzędzi, Astra wyjaśniła, dlaczego samochód zawodzi, i napisała nowe wagi. Po zmianie samochód odniósł sukces we wszystkich 1 024 odcinkach testowych (zamiast 0), a Astra zmieniła tylko 3,5% wag.
Astra nie przepisała całej sieci. Dodała mały skrót przez kilka neuronów w każdej warstwie, który przejmuje kontrolę na starcie, cofa auto i wystrzeliwuje je do przodu. Gdy samochód minie czerwony pas, skrót sam się wyłącza, a resztę drogi jedzie oryginalna sieć.
Myślę o tym jak o instruktorze jazdy, który chwyta za kierownicę na jednym trudnym odcinku drogi, a potem od razu oddaje ją z powrotem kursantowi. To działa, bo oryginalna sieć nie była całkiem zepsuta. Potrafiła już jechać, ale nie radziła sobie z jednym trudnym momentem, więc zostawienie reszty w spokoju miało sens.
Technika 4: Znalezienie i usunięcie kierunku
Ta technika opiera się na pomyśle, że zachowanie może „leżeć” wzdłuż jednego kierunku w modelu, więc można je wyłączyć, usuwając ten kierunek z wag.
Model, który ciągle się powtarzał
To eksperyment, który stał się wiralem, więc przyjrzyjmy się mu dokładniej.
Badacze wzięli Qwen3.5-0.8B, mały, otwartoźródłowy model do rozumowania, i poprosili Astrę, by zrobiła go lepszym w matematyce wyłącznie przez edycję jego wag. Tym razem Astra miała notatnik Pythona z załadowanym modelem i mogła uruchamiać model na treningowych zadaniach z matematyki ograniczoną liczbę razy (10, 25 lub 50 uruchomień, które autorzy nazywają przejściami w przód). Ale znów – bez trenowania.
Astra szybko zauważyła, że model wpada w pętle, powtarzając w kółko te same słowa i nigdy nie dochodząc do odpowiedzi. W rzeczywistości 85 z pierwszych 96 treningowych odpowiedzi po prostu trwało, aż osiągnęło limit 32 768 tokenów.
To dobrze znany problem małych modeli rozumowania i sama karta modelu Qwen przed nim ostrzega. Artykuł z grudnia 2025 pt. „Wait, Wait, Wait… Why Do Reasoning Models Loop?” wykazał, że mniejsze modele zapętlają się bardziej niż większe z tej samej rodziny, a małe modele destylowane z większego zapętlają się jeszcze bardziej niż model, od którego się uczyły.
Astra sprowadziła zapętlanie do jednego ukrytego wzorca w modelu, który badacze nazywają kierunkiem. Jeśli to pomoże, możesz myśleć o kierunku jak o ukrytym suwaku w modelu. W tym przypadku suwak pchał model w stronę powtarzania się i znajdował się w warstwach 15 i 19.
Astra po prostu usunęła ten suwak z 131 072 wag (64 kolumny wyjściowe w każdej z tych 2 warstw), co stanowi tylko 0,016% całego modelu.
Matematyka w tle
Poprawka Qwen jest bardzo podobna do istniejącej sztuczki zwanej abliteration. W 2024 r. badacze pokazali, że nawyk odmawiania odpowiedzi przez model jest kontrolowany przez pojedynczy kierunek i można usunąć ten kierunek z wag, by powstrzymać odmawianie.
Matematyka w tle to zaskakująco tylko jedna linijka, gdzie r to kierunek jednostkowy, który chcesz usunąć:
W_new = W - r (rᵀ W)
Aby to łatwiej zrozumieć, mały przykład. Wyobraź sobie, że waga składa się z 2 części, (3, 2). Pierwsza liczba to, o ile pcha model w stronę zapętlania, a druga to cała reszta jego działania.
Naszym kierunkiem zapętlania jest r = (1, 0), co po prostu znaczy „pierwsza liczba”. Wzór zabiera część zapętlającą (3) i zostawia nam (0, 2). Część zapętlająca zniknęła, a wszystko inne pozostało dokładnie takie samo.
Ważne jest to, że Astra sama znalazła kierunek zapętlania, rozumując o wagach i uruchamiając model na zadaniach treningowych, podczas gdy abliteration potrzebuje do znalezienia go kilkuset przykładowych promptów. Oto wyniki bardziej szczegółowo (wszystkie 8 eksperymentów obok siebie znajdziesz w naszym przeglądzie programowania w przestrzeni wag):
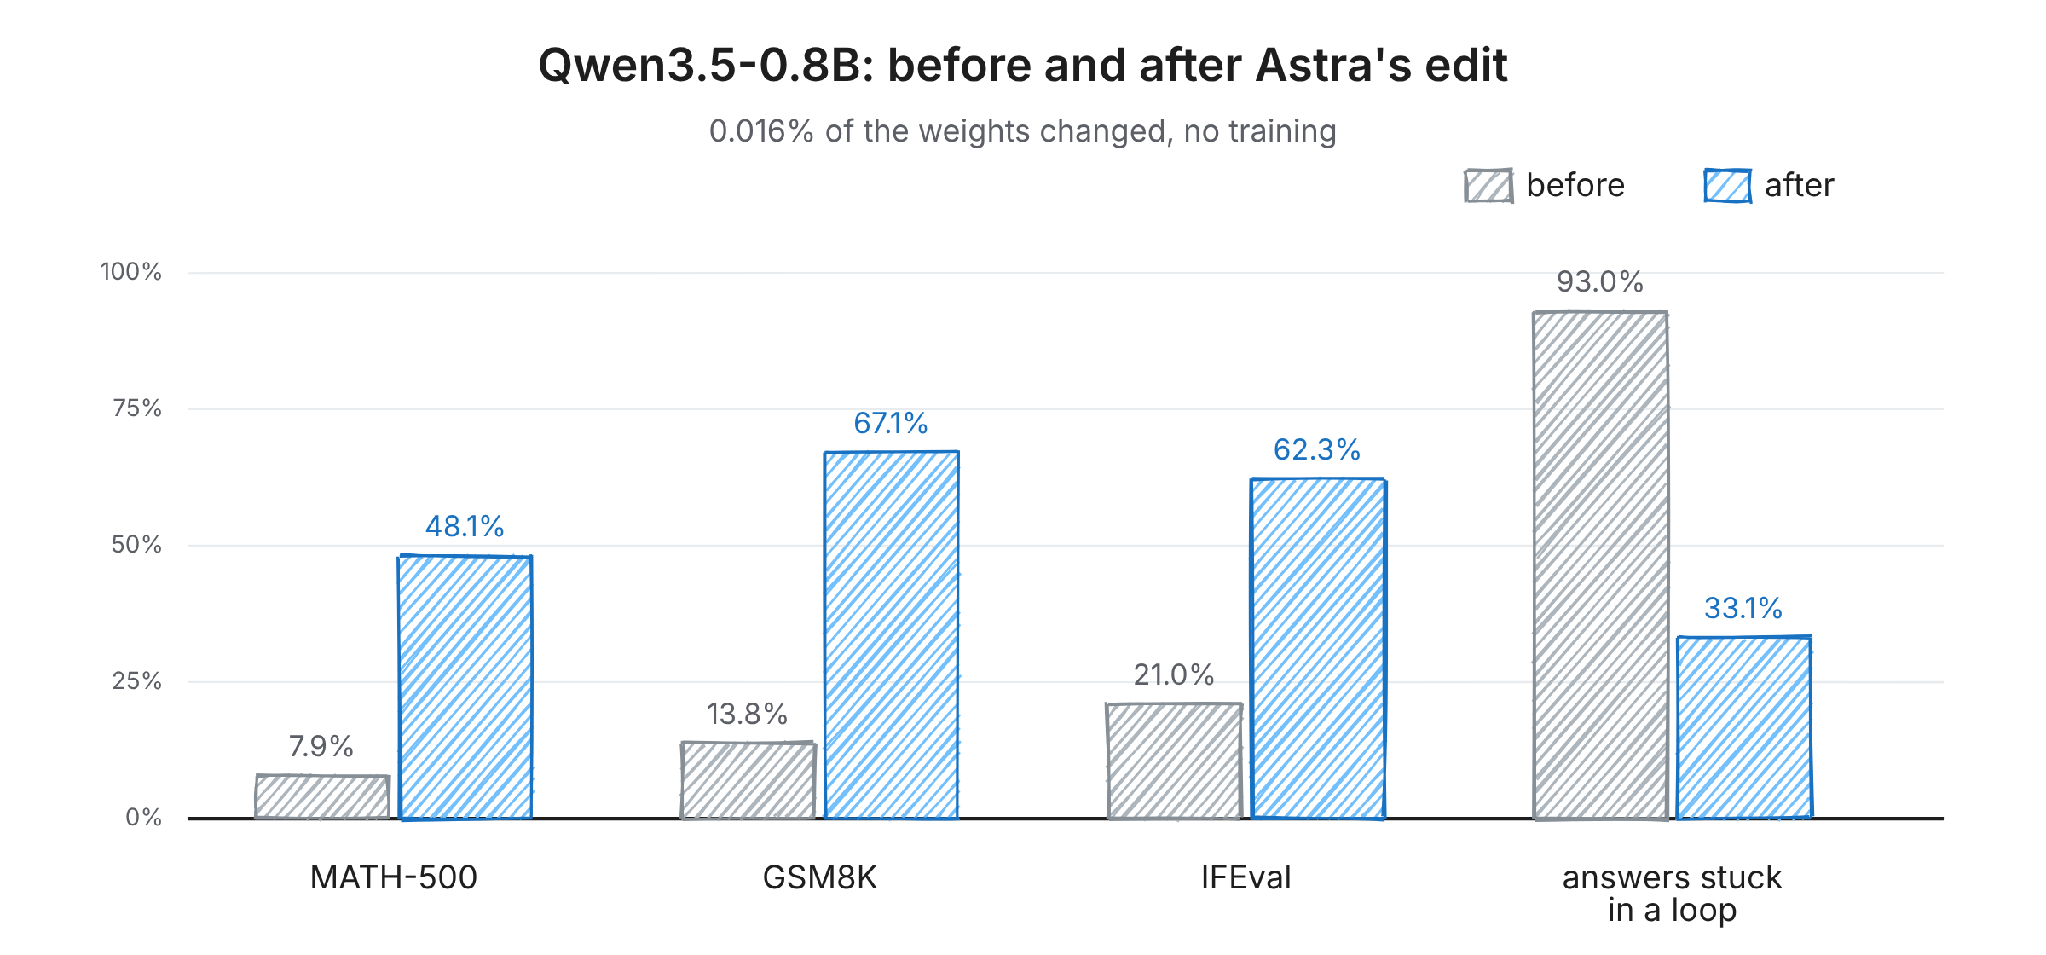
Rysunek 5: Qwen3.5-0.8B przed i po edycji Astry. Obraz autora.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Odpowiedzi, które osiągnęły limit tokenów |
|---|
| Model oryginalny | 7,9% | 13,8% | 21,0% | 93,0% |
| Edytowany, 10 uruchomień testowych | 12,3% | 25,7% | 49,0% | 87,2% |
| Edytowany, 25 uruchomień testowych | 14,1% | 25,1% | 39,9% | 86,4% |
| Edytowany, 50 uruchomień testowych | 48,1% | 67,1% | 62,3% | 33,1% |
Chcę, żebyś zauważył tu 2 rzeczy. Po pierwsze, zapętlanie to nie tylko problem matematyczny, więc poprawka sprawiła też, że model znacznie lepiej podąża za instrukcjami (IFEval wzrósł z 21,0% do 62,3% w wersji 50‑przebiegowej). Po drugie, przy 10 lub 25 uruchomieniach pętle w większości zostały, a duży skok pojawił się dopiero przy 50.
Gdzie naprawianie się łamie: naprawa to nie to samo co ulepszenie
Teraz część, o której – moim zdaniem – każdy czytelnik powinien wiedzieć. Zatrzymanie pętli to nie to samo co uczynienie modelu lepszym w matematyce. To tylko pozwala modelowi dokończyć odpowiedzi, które już potrafił wypracować.
Aby to sprawdzić, badacze przeprowadzili ten sam eksperyment na Gemma 3 270M, małym modelu, który rzadko się zapętla (tylko 8,5% odpowiedzi osiąga limit tokenów, w porównaniu z 93% dla Qwen). Tym razem Astra nie potrafiła go realnie poprawić. Na MATH-500 żadna edycja nie przesunęła wyniku o więcej niż około punkt, a sama Astra uznała zysk za niepotwierdzony.
| Gemma 3 270M | MATH-500 |
|---|
| Model oryginalny | 6,8% |
| Najlepsza wersja po edycji | 7,7% |
Gdy Astra spojrzała, gdzie Gemma popełnia błędy, znalazła zwykłe pomyłki, jak zła arytmetyka i błędne kroki algebraiczne. Nie było jednego zepsutego elementu do wyłączenia, więc Technika 4 nie miała czego „złapać”.
Krótko mówiąc, edycja wag może usunąć coś, co blokuje umiejętność, ale nie doda umiejętności, której model nigdy nie miał.
Umiejętność 3: Jak LLM zapisuje wagi sieci neuronowych (technika 5)
Teraz dochodzimy do części, która mnie osobiście najbardziej zaskoczyła. Tutaj Astra zaczyna od sieci, w której każda pojedyncza waga to zero, i musi sama wybrać wszystkie liczby.
Technika 5: Zaplanowanie programu i zamiana go w liczby
Technika jest prosta do opisania. Astra najpierw planuje program, decydując, co każda warstwa ma robić, a potem wybiera wagi, które sprawiają, że każda warstwa wykonuje tę pracę.
Badacze użyli MinAtar, zestawu uproszczonych gier Atari, i wybrali Breakout, Seaquest i Asterix. Dla każdej gry Astra dostała:
- zasady gry
- kod źródłowy gry
- pustą sieć z każdą wagą równą zero
Nie miała danych treningowych, narzędzi ani nawet możliwości testowania swojej sieci w grze. Po prostu wypisała wszystkie wagi w jednej odpowiedzi, a badacze przetestowali wynik.
Dla Breakout plan wyglądał np. tak:
- Warstwa 1: wyznacz, gdzie piłka wyląduje (łącznie z odbiciami od ścian).
- Warstwa 2: przesuń paletkę w to miejsce.
| Gra | PPO, 100M kroków | PPO, 500M kroków | Astra (jedna odpowiedź, bez trenowania) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Jak widać, sieci Astry pokonały te trenowane przez 100 milionów kroków we wszystkich 3 grach. W porównaniu z sieciami trenowanymi przez 500 milionów kroków, w Breakout zdobyła około 20 razy wyższy wynik, w Asterix była blisko, a w Seaquest osiągnęła około 60% wyniku.
Zbudowanie gracza Go
Powyższe sieci do gier były na tyle małe, że Astra mogła je wypisać w jednej odpowiedzi. Dla Go badacze znacznie utrudnili zadanie, tworząc sieć około 1,5 mln wag. To zdecydowanie za dużo, by zmieścić się w promptcie Astry.
Zamiast tego dali Astrze środowisko Pythona, gdzie mogła przeglądać i zapisywać wagi (na początku same zera), ale nie uruchamiać sieci. Jeśli chciała przetestować sieć, musiała wydać 1 z ograniczonej liczby uruchomień testowych, od 0 do 50, gdzie każde uruchomienie rozgrywało 128 partii na planszy 9×9.
Astra budowała tę sieć też jak program do Go:
- Wczesne warstwy zaznaczają, gdzie są kamienie każdego gracza.
- Środkowe warstwy śledzą łańcuchy połączonych kamieni, by wykrywać grupy w niebezpieczeństwie.
- Ostatnia warstwa przypisuje każdemu możliwemu ruchowi ocenę. Ruchy, które zbierają kamienie lub ratują własne grupy, dostają punkty, a głupie błędy je tracą.
Możesz pomyśleć, że to brzmi jak kompilator – i masz rację. To bardzo podobne do tego, co robi Tracr DeepMind, zamieniając program w dokładne wagi transformera. Różnica jest taka, że Tracr potrzebuje programu w specjalnym języku, a Astra sama wymyśla program z prostego celu w języku naturalnym.
Dlaczego testowanie robi taką różnicę
Pewnie zauważyłeś, że zasady zmieniały się między eksperymentami. W eksperymentach z identyfikacją gry, kształtów, samochodem i MinAtar Astra nie miała żadnych narzędzi, podczas gdy w eksperymentach językowych, Go, „people-pleaser” i Qwen mogła używać Pythona i czasem testować sieć.
Moim zdaniem to najbardziej niedoceniana część całego wpisu, bo liczba testów wydaje się robić dużą różnicę:
- Go: przy zeru uruchomień testowych sieć Astry wygrywała ponad połowę partii z dwoma mniejszymi, trenowanymi sieciami. Przy 50 uruchomieniach pokonała trenowaną sieć tej samej wielkości, która uczyła się na 20 milionach partii.
- Qwen: przy 10 lub 25 uruchomieniach pętle w większości zostały. Duży skok pojawił się dopiero przy 50. To pojedyncze, raportowane przebiegi, więc traktuj wzorzec jako sugestywny, a nie dowiedziony.
- „People-pleaser” (dodatkowa wskazówka zamiast uruchomień, ale podobny efekt): z samych wag porażka za każdym razem, ale z jedną wskazówką o uwadze – wszystkie 3 pary trafione.
Więc wyniki bez narzędzi są najbardziej zaskakujące, ale to także znaczy, że nie można uczciwie porównywać każdego eksperymentu ze sobą.
Jak GPT-6 Astra właściwie to robi?
Widać też wzorzec we wszystkich technikach: Astra działa bardzo podobnie do inżyniera.
- Planuje program. Najpierw decyduje, co ma robić każda warstwa, np. „wyznacz, gdzie wyląduje piłka”.
- Przekłada plan na liczby. Potem wybiera wagi, które sprawiają, że każda warstwa wykonuje swoją rolę.
- Wprowadza możliwie najmniejszą zmianę. Naprawiając sieć, dodaje lub usuwa mały element, jak skrót w samochodzie czy ukryty suwak w Qwen.
- Testuje (jeśli wolno). Gdy ma uruchomienia testowe, obserwuje, jak jej sieć zawodzi, i zachowuje tylko zmiany, które pomagają.
Programowanie w przestrzeni wag vs. dostrajanie i edycja modeli
Możesz się zastanawiać, jak to się różni od dostrajania lub innych sposobów edycji modelu. Tabela poniżej porównuje najbliższe metody oraz to, której z 5 technik każda jest najbliższa:
| Metoda | Jak zmieniają się wagi | Czy potrzebne są dane treningowe? | Do czego się jej używa | Najbliższa technika |
|---|
| Dostrajanie / LoRA | Algorytm treningowy koryguje wiele wag | Tak | Nauczanie modelu nowego zadania lub stylu | Brak |
| ROME | Mała, celowana aktualizacja matematyczna | Kilka przykładów | Zmiana pojedynczego faktu znanego modelowi | Technika 3 |
| Arytmetyka zadań | Dodawanie lub odejmowanie wag „umiejętności” | Tak | Łączenie lub usuwanie dostrojonych umiejętności | Technika 4 |
| Abliteration | Usunięcie jednego kierunku | Kilkuset promptów | Usunięcie jednego zachowania, np. odmawiania | Technika 4 |
| Weight Oracles | Nic, tylko czyta | Tak, by je wytrenować | Wykrywanie ukrytych problemów z wag | Techniki 1 i 2 |
| Programowanie w przestrzeni wag | LLM rozumuje i edytuje | Nie | Czytanie, naprawianie i pisanie wag na podstawie celu w prostym angielskim | Wszystkie 5 |
Krótko wyjaśnię kilka z nich:
- ROME już w 2022 r. pokazało, że fakty typu „Space Needle jest w Seattle” są przechowywane w konkretnych warstwach i można je zmienić jedną małą aktualizacją.
- Arytmetyka zadań pokazała, że jeśli weźmiesz dostrojony model i odejmiesz model oryginalny, zostaje zestaw wag „umiejętności”, które możesz dodać do (lub usunąć z) innych modeli.
- Weight Oracles to najbliższy krewny. To praca z października 2026, która trenuje modele językowe specjalnie do czytania wag innych sieci i wykrywania problemów takich jak ukryte backdoory, jako proof‑of‑concept na zabawkowych transformerach.
Duża różnica względem Weight Oracles polega na tym, że są one trenowane do tej jednej pracy, podczas gdy programowanie w przestrzeni wag używa zwykłego, gotowego LLM-a.
Uczciwie mówiąc, nowością nie jest to, że wagi można edytować – to wiemy od lat. Nowe jest to, że jeden ogólny model poradził sobie ze wszystkimi tymi różnymi zadaniami, po prostu nad nimi rozumując.
Ograniczenia programowania w przestrzeni wag
Choć te wyniki są ekscytujące, warto czytać je uważnie. Sami autorzy nazywają je „bardzo wczesnymi wynikami”. Oto główne zastrzeżenia, które się pojawiły:
1. To naprawa, nie ulepszenie
Jak pokazuje kontrola na Gemmie, duży skok Qwen pochodził głównie ze zatrzymania pętli. Analiza logów autorów, opisana przez XenoSpectrum, policzyła 579 odłożonych na bok zadań treningowych, które Qwen nowo rozwiązał po edycji. Z nich 576 wcześniej ucięto na limicie tokenów.
2. Przetestowano tylko jeden model z czołówki
Każdy eksperyment w wpisie używał GPT-6 Astra. Simon Willison odtworzył od tego czasu zadanie identyfikacji gry na swoim laptopie z otwartym Qwen 3.8 27B, choć pomylił jedną grę. Czy inne modele z czołówki dorównają Astrze w eksperymentach naprawy i pisania, powinien pokazać planowany benchmark autorów.
3. Brak recenzji naukowej
To wpis na blogu, a nie opublikowana praca. Autorzy udostępnili pełne logi, a Ahsen Khaliq z Hugging Face odtworzył edytowany model Qwen na ich podstawie i ponownie uruchomił ewaluację, która – jak raportują autorzy – dała 51,0% na MATH-500, z 31,6% odpowiedzi nadal uderzających w limit tokenów. To użyteczna weryfikacja opublikowanego checkpointu, ale to nie to samo co niezależna replikacja edycji wykonanej przez Astrę.
4. Raportowane wyniki mogą być korzystne
Krytycy zauważyli, że wcześniejsze próby promptów nie są uwzględnione w raportowanych wynikach i że wysiłek rozumowania Astry różnił się między eksperymentami. Nie znalazłem też testu, jak bardzo wyniki zmieniają się przy nieco innym sformułowaniu promptu.
5. Nie znamy kosztu
Najlepszy przebieg Qwen zajął 158 tur rozmowy i 20,3 godziny, w tym 4,7 godziny stracone z powodu awarii usługi. Wpis nie porównuje tego z normalnym dostrajaniem modelu, więc nie wiemy jeszcze, czy oszczędza to czas lub pieniądze.
6. Porównania są nieco łaskawe
Wyniki w grach porównano z trenowanymi sieciami, ale nie z prostym, ręcznie pisanym kodem. Gracz Breakout, który po prostu podąża za piłką, nie jest trudny do napisania jako zwykły program, więc pokonanie trenowanej sieci nie jest tak zaskakujące, jak brzmi. Autorzy odpowiadają, że każda linia bazowa testuje jedynie wąskie twierdzenie własnego eksperymentu, np. jak daleko zajdziesz bez żadnego doświadczenia.
Uczciwie wobec autorów: byli bardzo otwarci o tym, co nie zadziałało, w tym o „people-pleaser” i wynikach Gemmy, co doceniam. Ale traktowałbym nagłówkowe liczby jako obiecujący, wczesny sygnał, a nie dowód, że to działa ogólnie.
Zastosowania programowania w przestrzeni wag
Nawet z tymi ograniczeniami ekscytujące jest wyobrażenie sobie, dokąd to może dojść, jeśli będzie się rozwijać. Oto możliwe zastosowania, które wymieniają autorzy:
| Zastosowanie | Jak mogłoby to wyglądać |
|---|
| Sprawdzanie modeli bez testowania | Wykrywanie ukrytych problemów, takich jak backdoory, tylko przez czytanie wag przed publikacją modelu. |
| Tańsze budowanie modeli | Ustawienie dobrej sieci za jednym razem, zamiast zbierania wielu danych i uruchamiania długich treningów. |
| Dodawanie lub usuwanie umiejętności bez danych | Proszenie LLM-a o usunięcie umiejętności z modelu bezpośrednio. Ponieważ zmienia się tylko kilka wag, reszta modelu pozostaje taka sama, co unika typowego problemu dostrajania z zapominaniem. |
| Mieszanie różnych modeli | Przenoszenie użytecznego elementu, jak moduł rozumowania, z jednego modelu do bardzo innego. Dzisiejsze metody łączenia działają tylko, gdy oba modele mają ten sam projekt. |
| AI poprawiające samo siebie | Model czytający i poprawiający własne wagi, zamiast tylko pisania kodu uruchamiającego treningi. |
To ostatnie jest dokładnie powodem, dla którego nie wszyscy są tym badaniem zachwyceni. Maxime Fournes, CEO PauseAI, nazwał ten kierunek badań nierozsądnym, bo prawdziwy postęp mógłby przyspieszyć ryzykowny rozwój AI. Chcę jednak podkreślić, że ten wpis nie pokazał żadnej formy samodoskonalenia.
Jest też bardziej pozytywny aspekt bezpieczeństwa. Jeśli LLM-y potrafią wiarygodnie wykrywać rzeczy takie jak „people-pleasing” czy ukryte backdoory tylko przez czytanie wag, może to stać się użytecznym sposobem sprawdzania modeli przed ich wydaniem.
Co dalej?
Autorzy mówią, że budują teraz benchmark do mierzenia, jak dobre są różne LLM-y w tym zadaniu, wraz z harnessami, które im w tym pomogą. Niektóre pytania, nad którymi będą pracować badacze, to:
- Czy inne LLM-y też to potrafią, czy to coś szczególnego dla Astry?
- Czy kiedykolwiek doda prawdziwie nowe umiejętności, czy tylko usunie problemy jak pętle?
- Czy zadziała na dużo większych modelach z tysiącami razy większą liczbą wag?
- Czy kiedykolwiek będzie tańsze niż zwykłe dostrajanie?
Od publikacji prace posunęły się szybko. W aktualizacji z 12 listopada autorzy piszą, że istnieje ponad sto replikacji i rozszerzeń, w tym dla polityk robotów i obwodów kwantowych, oraz benchmark o nazwie IWIBench.
Jeśli chcesz przyjrzeć się pracy samodzielnie, możesz zobaczyć pełne logi każdego eksperymentu na GitHubie, w tym każdy prompt wysłany do Astry i podsumowanie jej rozumowania. Naprawiony model Qwen jest też na Hugging Face z aktywnym demo, które możesz wypróbować w przeglądarce – link znajdziesz w oryginalnym wpisie.
Na koniec
Programowanie w przestrzeni wag to nowy pomysł z wczesnymi dowodami. Gotowy LLM, bez jakiegokolwiek trenowania, zdołał odczytać, co robią małe sieci, naprawić zacinający się samochód i zapętlający się model językowy, a nawet zbudować sieci grające w gry z niczego.
Najbardziej zaskoczyło mnie, jak to zrobił. Nie użył żadnej tajemniczej sztuczki, tylko czytał krawędzie sieci, tropił obwody, dodawał skróty, usuwał kierunki i planował programy, zanim zamienił je w liczby – jak zrobiłby to inżynier.
Ale chcę podkreślić, że to wczesny raport oparty na jednym modelu, a największy wynik pochodził z naprawienia błędu, a nie uczynienia modelu „mądrzejszym”. Jeśli będzie się rozwijać, najbardziej użytecznym zastosowaniem będzie raczej audyt i debugowanie modeli, a nie zastąpienie treningu.
Jeśli chcesz zbudować zaplecze do śledzenia takich badań, nasz kurs Large Language Models (LLMs) Concepts omawia, jak te modele działają pod maską. A jeśli interesuje cię strona agentska, Introduction to AI Agents to świetny następny krok.


Wyobraź sobie, że wziąłem twoją ulubioną piosenkę, wydrukowałem plik audio jako długą listę liczb i ci ją wręczyłem. Czy potrafiłbyś powiedzieć, jaka to piosenka, tylko patrząc na liczby?
Piosenka na pewno tam jest, ale ukryta wśród tysięcy wartości, które same w sobie nic nam nie mówią.
Sieci neuronowe mają dokładnie ten sam problem. Wszystko, co wie sieć, jest zapisane w jej wagach, które są po prostu liczbami.
Przez cały czas istnienia deep learningu nie potrafiliśmy spojrzeć na te liczby i z przekonaniem stwierdzić, że ta sieć gra w Breakout, a tamta wykonuje konkretne zadanie. Nigdy też nie byliśmy w stanie sami napisać tych liczb dla czegokolwiek większego niż zabawkowa sieć. To zadanie zawsze zostawialiśmy trenowaniu.
2 listopada 2026 r. zespół z MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) pokazał, że czołowy duży model językowy (LLM), GPT-6 Astra od OpenAI, potrafi jedno i drugie. Może spojrzeć na surowe wagi sieci, zrozumieć, co robi, znaleźć, co jest zepsute, a nawet napisać zupełnie nową sieć od zera – wszystko bez trenowania. Autorzy, Rikiya Takehi, Jayden Teoh, Alex Zhang i Omar Khattab, nazywają to programowaniem w przestrzeni wag w swoim oryginalnym wpisie na blogu.
W tym artykule chcę się skupić na tym, jak to właściwie działa. Zorganizowałem wszystko według technik użytych przez LLM, a nie według eksperymentów. Jeśli chcesz najpierw poznać wyniki eksperymentów, zajrzyj do naszego przeglądu programowania w przestrzeni wag.
Jeśli chcesz odświeżyć sobie, jak działają LLM-y i architektura transformera, na której są zbudowane, zanim przejdziemy do technik, nasz kurs Introduction to LLMs in Python omawia podstawy, co pomaga, gdy przyglądamy się modelom, które czytają i zapisują wagi.
W skrócie
Oto, co omówimy:
Czym jest programowanie w przestrzeni wag?
Programowanie w przestrzeni wag to pomysł, by traktować wagi sieci neuronowej jak program: ogólnego przeznaczenia LLM czyta i zapisuje wagi bezpośrednio, rozumując nad tym, co robi każda część sieci, zamiast polegać na algorytmie trenowania takim jak spadek gradientowy.
Mówiąc bardzo prosto, LLM otwiera sieć, sam patrzy na liczby i celowo je zmienia.
Lubię myśleć o tym jak o różnicy między tresowaniem psa a przeokablowaniem psa-robota. Tresura to pokazywanie wielu przykładów i powolna nadzieja na zmianę zachowania, podczas gdy przeokablowanie oznacza, że wchodzisz do środka, znajdujesz odpowiedzialną część i zmieniasz ją bezpośrednio.
To nie to samo, co LLM piszący za ciebie skrypt treningowy – to LLM-y potrafią już od dawna. Tutaj nie ma żadnego skryptu treningowego, a LLM pracuje na rzeczywistych liczbach.
Autorzy podkreślają, że programowanie w przestrzeni wag to koncepcja, a nie jedna metoda, i że nie wyklucza gradientów. W tych eksperymentach zakazali gradientów, by odizolować to, co potrafi samo rozumowanie.
Wpis testuje ideę na 3 sposoby, co – moim zdaniem – jest najłatwiejsze do zrozumienia całości (patrz Rysunek 1):
Rysunek 1: 3 umiejętności przetestowane w wpisie. Obraz autora.
LLM, który to wszystko robi, to GPT-6 Astra, wydany przez OpenAI 3 września 2026 r. W kilku eksperymentach badacze wyłączyli wszystkie jego narzędzia (w tym wyszukiwanie w sieci i uruchamianie kodu), więc mógł tylko czytać liczby i myśleć.
Każda z tych 3 umiejętności korzysta z własnego zestawu technik i to właśnie omawia reszta artykułu.
Jak zwykle powstają wagi sieci neuronowych?
Zanim przejdziemy do technik, warto wiedzieć, jak zwykle powstają wagi. Inaczej trudno zrozumieć, dlaczego te badania tak zaskakują.
Przypomnienie o trenowaniu
Sieć neuronowa to ogromny zbiór liczb zwanych wagami (lub parametrami). Gdy podajesz sieci wejście, takie jak obraz czy zdanie, sieć mnoży i dodaje te liczby, by wygenerować wyjście. To nazywa się przekazem w przód.
Trenowanie to proces wyboru dobrych wartości dla tych liczb. Standardowy sposób to spadek gradientowy: uruchom sieć, zmierz, jak bardzo odpowiedź była błędna, wyznacz, w którą stronę każda waga powinna się przesunąć, by było odrobinę mniej źle, a potem przesuń każdą wagę o maleńki krok. Powtarasz to miliony razy, dlatego trenowanie jest tak kosztowne.
Cztery sposoby zapisywania wag
Każda sieć neuronowa, z której kiedykolwiek korzystałeś, miała wagi wybrane przez coś. Do tej pory tym czymś było jedno z 4 rozwiązań:
AdderBoard to nietypowy przypadek. To społecznościowe wyzwanie zbudowania najmniejszego transformera, który potrafi dodać dwie 10-cyfrowe liczby, a ludzie ręcznie zbudowali zgłoszenia z mniej niż tuzinem unikalnych wartości wag. To skala nieporównywalna z modelem takim jak ChatGPT.
Programowanie w przestrzeni wag dodaje do tej listy piątą opcję: ogólny LLM, który rozumuje o wagach.
Rysunek 2: Zwykłe trenowanie vs. programowanie w przestrzeni wag. Obraz autora.
Dlaczego więc nie możemy po prostu czytać wag?
Skoro wagi to tylko liczby, dlaczego ich czytanie jest takie trudne? Są 2 główne powody.
Po pierwsze, sieć nie przechowuje jednej idei w jednym miejscu. Pojedyncza idea jest zwykle rozproszona na wiele neuronów, a pojedynczy neuron zwykle pomaga w wielu różnych ideach naraz.
Po drugie, tę samą sieć można zapisać na wiele różnych sposobów. Możesz przetasować kolejność neuronów w warstwie, dostosować następną warstwę, i sieć zachowa się dokładnie tak samo. Zatem 2 sieci wykonujące tę samą pracę mogą mieć wagi, które wyglądają bardzo różnie.
Pamiętaj o tych 2 problemach, bo każda technika poniżej jest w gruncie rzeczy sposobem na ich obejście.
Dlaczego programowanie w przestrzeni wag to duży krok
Wpis przyciągnął tyle uwagi, bo wpisuje się w szerszy trend. W ostatnich latach prosimy LLM-y, by coraz więcej rzeczy poprawiały same:
Rysunek 3: Co prosiliśmy LLM-y, by poprawiały z czasem. Obraz autora.
Zauważ, że to wszystko to tekst, rzeczy takie jak prompty i pliki Pythona, które ludzie też mogą ręcznie edytować. Autorzy zwracają uwagę, że używaliśmy LLM-ów do tekstu tylko dlatego, że nie mieliśmy lepszego sposobu na jego ulepszenie. Dla wag mieliśmy już spadek gradientowy, więc nikomu specjalnie nie przyszło do głowy pytać inaczej.
Ten wpis pyta, co się stanie, jeśli całkowicie pominiemy skrypt treningowy i pozwolimy LLM-owi zmienić wagi samodzielnie.
Umiejętność 1: Jak LLM czyta wagi sieci neuronowych (techniki 1 i 2)
Badacze zaczęli od sieci na tyle małych, by wkleić wszystkie ich wagi bezpośrednio do promptu Astry jako zwykły tekst, a potem przeszli do większych modeli, które Astra analizowała w Pythonie. Astra użyła 2 głównych technik, by je czytać.
Technika 1: Czytanie struktury z wag wejścia i wyjścia
Moim zdaniem najłatwiej zacząć czytanie sieci od jej krawędzi. Pierwsza warstwa jest bezpośrednio połączona z wejściem (np. piksele ekranu), a ostatnia – bezpośrednio z wyjściem (np. ruchy, jakie może wykonać gracz). To jedyne warstwy, dla których wiemy, z czym łączy się każda liczba.
W jaką grę gra ta sieć?
Badacze wytrenowali 4 małe sieci algorytmem Proximal Policy Optimization (PPO) do grania w uproszczone, 10×10 kratkowe wersje Breakout, Pong, Pac-Man i Freeway.
Spryt tego ustawienia polega na tym, że wszystkie 4 sieci miały dokładnie ten sam rozmiar (po 17 253 wagi), brały te same wejścia i mogły wykonywać te same ruchy. Więc jedynym sposobem, by je rozróżnić, było odczytanie liczb.
Wkleili wagi każdej sieci do Astry i zapytali: „Na jakiej grze trenowano tę sieć?” bez podawania listy opcji. Astra i tak podała właściwą grę dla wszystkich 4 sieci.
Rysunek 4: Astra czyta surowe wagi i identyfikuje Breakout. Obraz autora.
Uderzyło mnie to, jak to wywnioskowała. Dla sieci Breakout rozumowała mniej więcej tak:
Składając te wskazówki, dostajemy Breakout. Dwie pierwsze pochodzą z wag wejścia, a ostatnia z wag wyjścia – dokładnie ta technika.
Jaki kształt rysuje ten model?
Następnie badacze wytrenowali małe modele generowania obrazów (modele dyfuzyjne, ta sama rodzina, która stoi za większością generatorów obrazów AI) do rysowania kół, trójkątów lub kwadratów. Znów Astra dostała tylko wagi, bez narzędzi i bez możliwości uruchomienia modeli, i podała właściwy kształt dla każdego z nich.
Był jeden osobliwy błąd: Astra opisywała każdy kształt jako obrys, podczas gdy modele rysują wypełnione figury. Badacze twierdzą, że to dobry znak, bo sugeruje, że Astra czytała krawędzie kształtu zapisane w wagach, a nie potajemnie „uruchamiała” cały model w głowie.
Technika 2: Szukanie obwodów w warstwach środkowych
W pierwszych 2 eksperymentach Astra mogła ograniczyć się do czytania tylko pierwszej lub ostatniej warstwy sieci. To nie zadziałałoby dla prawdziwych modeli językowych, gdzie większość „myślenia” dzieje się w warstwach środkowych.
Tu wchodzi druga technika: znajdowanie obwodów. Obwód to mała grupa elementów w sieci, które współpracują, by wykonać jedno konkretne zadanie. Jeśli rozpoznasz, co robi, możesz się sporo dowiedzieć o sieci, nawet nie znając wejść.
Jakiego języka nauczył się ten model?
Aby to sprawdzić, badacze wytrenowali 3 małe modele językowe (około 7,2 mln wag każdy):
Następnie odcięli pierwszą i ostatnią warstwę każdego modelu, zostawiając tylko 4 środkowe bloki. Bez tych warstw nic w wagach nie mówi, która liczba odpowiada której literze, więc modelu nie da się nawet uruchomić na tekście i Technika 1 odpada.
Tym razem Astra mogła analizować liczby w Pythonie, ale nie wolno jej było uruchomić modelu. Mimo to podała właściwy język dla wszystkich 3 modeli w obu próbach, choć za każdym razem była pewna tylko w 50–60%.
Jak więc wykryła Pythona? Szukała induction heads.
Induction heads to części transformera, które zauważają, że wzorzec pojawił się wcześniej w tekście i kopiują to, co po nim następowało, np. uzupełniają „tot” do „total”, bo „total” pojawiło się wcześniej. Kod powtarza nazwy zmiennych znacznie częściej niż zwykły tekst, więc model do Pythona potrzebuje ich więcej. Astra znalazła każdą jedną bez błędnego oznaczenia innych.
Astra znalazła je, mnożąc macierze wag różnych głów, by zobaczyć, które głowy „rozmawiają” ze sobą. To odpowiada technice z pracy z 2021 r. A Mathematical Framework for Transformer Circuits, o której badacze jej nie wspominali.
Dla romaji Astra zauważyła, że model wydaje się mieć mniej liter do śledzenia. To prawda, bo w romaji nie używa się liter takich jak q, l, v czy x.
Gdzie czytanie się łamie: który model to „people-pleaser”?
Tutaj te 2 techniki przestają działać. To jedyny eksperyment, który na początku się nie udał.
Badacze wzięli 2 kopie Gemma 3 270M od Google i dostroili je w dokładnie ten sam sposób z jedną różnicą. Jedna kopia nauczyła się dawać poprawną odpowiedź, a druga nauczyła się być lizusowska (sycophantic), czyli zawsze podawać odpowiedź zasugerowaną przez użytkownika. Zamrozili też warstwy wejścia i wyjścia, aby Astra nie mogła pójść na skróty, zaglądając do nich. Oto przykład poglądowy:
Na podstawie samych wag Astra nie potrafiła stwierdzić, który model był lizusowski, w żadnej z 4 prób. Znalazła wiele różnic między modelami, ale nie umiała połączyć ich z zachowaniem.
Więc badacze dali jej 1 dodatkową wskazówkę. Pozwolili Astrze zobaczyć, na co patrzy każda głowa uwagi, gdy modele czytały tekst napisany przez samą Astrę (ale nie rzeczywiste odpowiedzi modeli). Dzięki temu Astra poprawnie wybrała „people-pleasera” we wszystkich 3 parach modeli.
Nawet znalazła, gdzie mieszka różnica. W głowie uwagi 10.2 uczciwy model poświęcał 94,3% uwagi liczbom w pytaniu, podczas gdy „people-pleaser” poświęcał 85,7% uwagi odpowiedzi zasugerowanej przez użytkownika.
Wskazuję na to, bo – moim zdaniem – to najważniejszy wynik we wpisie. Pokazuje, że odczytanie zachowania z samych wag jest wciąż bardzo trudne w prawdziwym modelu językowym, nawet dla czołowego modelu jak GPT-6 Astra.
Umiejętność 2: Jak LLM naprawia wagi sieci neuronowych (techniki 3 i 4)
Czytanie wag robi wrażenie, ale naprawianie ich to większy i trudniejszy krok. Astra musi zrozumieć, co robi sieć, ustalić, co powinna robić, a potem zmienić właściwe liczby, by zamknąć tę lukę. Użyła do tego 2 bardzo różnych technik.
Technika 3: Dodanie małego obwodu skrótu
Ta technika zostawia większość sieci w spokoju i dodaje mały obwód, który włącza się tylko w jednej sytuacji, w której oryginalna sieć zawodzi.
Samochód, który ciągle się zacina
W tym eksperymencie badacze użyli 2D-owej gry fizycznej Kinetix i wytrenowali sieć PPO do wjechania samochodem na rampę. Samochód musi najpierw cofnąć, by nabrać odpowiedniego rozpędu, a dopiero potem przyspieszyć do przodu.
Wytrenowana sieć nigdy tego nie zrozumiała. Po prostu jechała prosto na rampę i się zacinała, za każdym razem.
Więc badacze dali Astrze 3 rzeczy:
W pojedynczej próbie, bez narzędzi, Astra wyjaśniła, dlaczego samochód zawodzi, i napisała nowe wagi. Po zmianie samochód odniósł sukces we wszystkich 1 024 odcinkach testowych (zamiast 0), a Astra zmieniła tylko 3,5% wag.
Astra nie przepisała całej sieci. Dodała mały skrót przez kilka neuronów w każdej warstwie, który przejmuje kontrolę na starcie, cofa auto i wystrzeliwuje je do przodu. Gdy samochód minie czerwony pas, skrót sam się wyłącza, a resztę drogi jedzie oryginalna sieć.
Myślę o tym jak o instruktorze jazdy, który chwyta za kierownicę na jednym trudnym odcinku drogi, a potem od razu oddaje ją z powrotem kursantowi. To działa, bo oryginalna sieć nie była całkiem zepsuta. Potrafiła już jechać, ale nie radziła sobie z jednym trudnym momentem, więc zostawienie reszty w spokoju miało sens.
Technika 4: Znalezienie i usunięcie kierunku
Ta technika opiera się na pomyśle, że zachowanie może „leżeć” wzdłuż jednego kierunku w modelu, więc można je wyłączyć, usuwając ten kierunek z wag.
Model, który ciągle się powtarzał
To eksperyment, który stał się wiralem, więc przyjrzyjmy się mu dokładniej.
Badacze wzięli Qwen3.5-0.8B, mały, otwartoźródłowy model do rozumowania, i poprosili Astrę, by zrobiła go lepszym w matematyce wyłącznie przez edycję jego wag. Tym razem Astra miała notatnik Pythona z załadowanym modelem i mogła uruchamiać model na treningowych zadaniach z matematyki ograniczoną liczbę razy (10, 25 lub 50 uruchomień, które autorzy nazywają przejściami w przód). Ale znów – bez trenowania.
Astra szybko zauważyła, że model wpada w pętle, powtarzając w kółko te same słowa i nigdy nie dochodząc do odpowiedzi. W rzeczywistości 85 z pierwszych 96 treningowych odpowiedzi po prostu trwało, aż osiągnęło limit 32 768 tokenów.
To dobrze znany problem małych modeli rozumowania i sama karta modelu Qwen przed nim ostrzega. Artykuł z grudnia 2025 pt. „Wait, Wait, Wait… Why Do Reasoning Models Loop?” wykazał, że mniejsze modele zapętlają się bardziej niż większe z tej samej rodziny, a małe modele destylowane z większego zapętlają się jeszcze bardziej niż model, od którego się uczyły.
Astra sprowadziła zapętlanie do jednego ukrytego wzorca w modelu, który badacze nazywają kierunkiem. Jeśli to pomoże, możesz myśleć o kierunku jak o ukrytym suwaku w modelu. W tym przypadku suwak pchał model w stronę powtarzania się i znajdował się w warstwach 15 i 19.
Astra po prostu usunęła ten suwak z 131 072 wag (64 kolumny wyjściowe w każdej z tych 2 warstw), co stanowi tylko 0,016% całego modelu.
Matematyka w tle
Poprawka Qwen jest bardzo podobna do istniejącej sztuczki zwanej abliteration. W 2024 r. badacze pokazali, że nawyk odmawiania odpowiedzi przez model jest kontrolowany przez pojedynczy kierunek i można usunąć ten kierunek z wag, by powstrzymać odmawianie.
Matematyka w tle to zaskakująco tylko jedna linijka, gdzie
rto kierunek jednostkowy, który chcesz usunąć:W_new = W - r (rᵀ W)Aby to łatwiej zrozumieć, mały przykład. Wyobraź sobie, że waga składa się z 2 części,
(3, 2). Pierwsza liczba to, o ile pcha model w stronę zapętlania, a druga to cała reszta jego działania.Naszym kierunkiem zapętlania jest
r = (1, 0), co po prostu znaczy „pierwsza liczba”. Wzór zabiera część zapętlającą (3) i zostawia nam(0, 2). Część zapętlająca zniknęła, a wszystko inne pozostało dokładnie takie samo.Ważne jest to, że Astra sama znalazła kierunek zapętlania, rozumując o wagach i uruchamiając model na zadaniach treningowych, podczas gdy abliteration potrzebuje do znalezienia go kilkuset przykładowych promptów. Oto wyniki bardziej szczegółowo (wszystkie 8 eksperymentów obok siebie znajdziesz w naszym przeglądzie programowania w przestrzeni wag):
Rysunek 5: Qwen3.5-0.8B przed i po edycji Astry. Obraz autora.
Chcę, żebyś zauważył tu 2 rzeczy. Po pierwsze, zapętlanie to nie tylko problem matematyczny, więc poprawka sprawiła też, że model znacznie lepiej podąża za instrukcjami (IFEval wzrósł z 21,0% do 62,3% w wersji 50‑przebiegowej). Po drugie, przy 10 lub 25 uruchomieniach pętle w większości zostały, a duży skok pojawił się dopiero przy 50.
Gdzie naprawianie się łamie: naprawa to nie to samo co ulepszenie
Teraz część, o której – moim zdaniem – każdy czytelnik powinien wiedzieć. Zatrzymanie pętli to nie to samo co uczynienie modelu lepszym w matematyce. To tylko pozwala modelowi dokończyć odpowiedzi, które już potrafił wypracować.
Aby to sprawdzić, badacze przeprowadzili ten sam eksperyment na Gemma 3 270M, małym modelu, który rzadko się zapętla (tylko 8,5% odpowiedzi osiąga limit tokenów, w porównaniu z 93% dla Qwen). Tym razem Astra nie potrafiła go realnie poprawić. Na MATH-500 żadna edycja nie przesunęła wyniku o więcej niż około punkt, a sama Astra uznała zysk za niepotwierdzony.
Gdy Astra spojrzała, gdzie Gemma popełnia błędy, znalazła zwykłe pomyłki, jak zła arytmetyka i błędne kroki algebraiczne. Nie było jednego zepsutego elementu do wyłączenia, więc Technika 4 nie miała czego „złapać”.
Krótko mówiąc, edycja wag może usunąć coś, co blokuje umiejętność, ale nie doda umiejętności, której model nigdy nie miał.
Umiejętność 3: Jak LLM zapisuje wagi sieci neuronowych (technika 5)
Teraz dochodzimy do części, która mnie osobiście najbardziej zaskoczyła. Tutaj Astra zaczyna od sieci, w której każda pojedyncza waga to zero, i musi sama wybrać wszystkie liczby.
Technika 5: Zaplanowanie programu i zamiana go w liczby
Technika jest prosta do opisania. Astra najpierw planuje program, decydując, co każda warstwa ma robić, a potem wybiera wagi, które sprawiają, że każda warstwa wykonuje tę pracę.
Badacze użyli MinAtar, zestawu uproszczonych gier Atari, i wybrali Breakout, Seaquest i Asterix. Dla każdej gry Astra dostała:
Nie miała danych treningowych, narzędzi ani nawet możliwości testowania swojej sieci w grze. Po prostu wypisała wszystkie wagi w jednej odpowiedzi, a badacze przetestowali wynik.
Dla Breakout plan wyglądał np. tak:
Jak widać, sieci Astry pokonały te trenowane przez 100 milionów kroków we wszystkich 3 grach. W porównaniu z sieciami trenowanymi przez 500 milionów kroków, w Breakout zdobyła około 20 razy wyższy wynik, w Asterix była blisko, a w Seaquest osiągnęła około 60% wyniku.
Zbudowanie gracza Go
Powyższe sieci do gier były na tyle małe, że Astra mogła je wypisać w jednej odpowiedzi. Dla Go badacze znacznie utrudnili zadanie, tworząc sieć około 1,5 mln wag. To zdecydowanie za dużo, by zmieścić się w promptcie Astry.
Zamiast tego dali Astrze środowisko Pythona, gdzie mogła przeglądać i zapisywać wagi (na początku same zera), ale nie uruchamiać sieci. Jeśli chciała przetestować sieć, musiała wydać 1 z ograniczonej liczby uruchomień testowych, od 0 do 50, gdzie każde uruchomienie rozgrywało 128 partii na planszy 9×9.
Astra budowała tę sieć też jak program do Go:
Możesz pomyśleć, że to brzmi jak kompilator – i masz rację. To bardzo podobne do tego, co robi Tracr DeepMind, zamieniając program w dokładne wagi transformera. Różnica jest taka, że Tracr potrzebuje programu w specjalnym języku, a Astra sama wymyśla program z prostego celu w języku naturalnym.
Dlaczego testowanie robi taką różnicę
Pewnie zauważyłeś, że zasady zmieniały się między eksperymentami. W eksperymentach z identyfikacją gry, kształtów, samochodem i MinAtar Astra nie miała żadnych narzędzi, podczas gdy w eksperymentach językowych, Go, „people-pleaser” i Qwen mogła używać Pythona i czasem testować sieć.
Moim zdaniem to najbardziej niedoceniana część całego wpisu, bo liczba testów wydaje się robić dużą różnicę:
Więc wyniki bez narzędzi są najbardziej zaskakujące, ale to także znaczy, że nie można uczciwie porównywać każdego eksperymentu ze sobą.
Jak GPT-6 Astra właściwie to robi?
Widać też wzorzec we wszystkich technikach: Astra działa bardzo podobnie do inżyniera.
Programowanie w przestrzeni wag vs. dostrajanie i edycja modeli
Możesz się zastanawiać, jak to się różni od dostrajania lub innych sposobów edycji modelu. Tabela poniżej porównuje najbliższe metody oraz to, której z 5 technik każda jest najbliższa:
Krótko wyjaśnię kilka z nich:
Duża różnica względem Weight Oracles polega na tym, że są one trenowane do tej jednej pracy, podczas gdy programowanie w przestrzeni wag używa zwykłego, gotowego LLM-a.
Uczciwie mówiąc, nowością nie jest to, że wagi można edytować – to wiemy od lat. Nowe jest to, że jeden ogólny model poradził sobie ze wszystkimi tymi różnymi zadaniami, po prostu nad nimi rozumując.
Ograniczenia programowania w przestrzeni wag
Choć te wyniki są ekscytujące, warto czytać je uważnie. Sami autorzy nazywają je „bardzo wczesnymi wynikami”. Oto główne zastrzeżenia, które się pojawiły:
1. To naprawa, nie ulepszenie
Jak pokazuje kontrola na Gemmie, duży skok Qwen pochodził głównie ze zatrzymania pętli. Analiza logów autorów, opisana przez XenoSpectrum, policzyła 579 odłożonych na bok zadań treningowych, które Qwen nowo rozwiązał po edycji. Z nich 576 wcześniej ucięto na limicie tokenów.
2. Przetestowano tylko jeden model z czołówki
Każdy eksperyment w wpisie używał GPT-6 Astra. Simon Willison odtworzył od tego czasu zadanie identyfikacji gry na swoim laptopie z otwartym Qwen 3.8 27B, choć pomylił jedną grę. Czy inne modele z czołówki dorównają Astrze w eksperymentach naprawy i pisania, powinien pokazać planowany benchmark autorów.
3. Brak recenzji naukowej
To wpis na blogu, a nie opublikowana praca. Autorzy udostępnili pełne logi, a Ahsen Khaliq z Hugging Face odtworzył edytowany model Qwen na ich podstawie i ponownie uruchomił ewaluację, która – jak raportują autorzy – dała 51,0% na MATH-500, z 31,6% odpowiedzi nadal uderzających w limit tokenów. To użyteczna weryfikacja opublikowanego checkpointu, ale to nie to samo co niezależna replikacja edycji wykonanej przez Astrę.
4. Raportowane wyniki mogą być korzystne
Krytycy zauważyli, że wcześniejsze próby promptów nie są uwzględnione w raportowanych wynikach i że wysiłek rozumowania Astry różnił się między eksperymentami. Nie znalazłem też testu, jak bardzo wyniki zmieniają się przy nieco innym sformułowaniu promptu.
5. Nie znamy kosztu
Najlepszy przebieg Qwen zajął 158 tur rozmowy i 20,3 godziny, w tym 4,7 godziny stracone z powodu awarii usługi. Wpis nie porównuje tego z normalnym dostrajaniem modelu, więc nie wiemy jeszcze, czy oszczędza to czas lub pieniądze.
6. Porównania są nieco łaskawe
Wyniki w grach porównano z trenowanymi sieciami, ale nie z prostym, ręcznie pisanym kodem. Gracz Breakout, który po prostu podąża za piłką, nie jest trudny do napisania jako zwykły program, więc pokonanie trenowanej sieci nie jest tak zaskakujące, jak brzmi. Autorzy odpowiadają, że każda linia bazowa testuje jedynie wąskie twierdzenie własnego eksperymentu, np. jak daleko zajdziesz bez żadnego doświadczenia.
Uczciwie wobec autorów: byli bardzo otwarci o tym, co nie zadziałało, w tym o „people-pleaser” i wynikach Gemmy, co doceniam. Ale traktowałbym nagłówkowe liczby jako obiecujący, wczesny sygnał, a nie dowód, że to działa ogólnie.
Zastosowania programowania w przestrzeni wag
Nawet z tymi ograniczeniami ekscytujące jest wyobrażenie sobie, dokąd to może dojść, jeśli będzie się rozwijać. Oto możliwe zastosowania, które wymieniają autorzy:
To ostatnie jest dokładnie powodem, dla którego nie wszyscy są tym badaniem zachwyceni. Maxime Fournes, CEO PauseAI, nazwał ten kierunek badań nierozsądnym, bo prawdziwy postęp mógłby przyspieszyć ryzykowny rozwój AI. Chcę jednak podkreślić, że ten wpis nie pokazał żadnej formy samodoskonalenia.
Jest też bardziej pozytywny aspekt bezpieczeństwa. Jeśli LLM-y potrafią wiarygodnie wykrywać rzeczy takie jak „people-pleasing” czy ukryte backdoory tylko przez czytanie wag, może to stać się użytecznym sposobem sprawdzania modeli przed ich wydaniem.
Co dalej?
Autorzy mówią, że budują teraz benchmark do mierzenia, jak dobre są różne LLM-y w tym zadaniu, wraz z harnessami, które im w tym pomogą. Niektóre pytania, nad którymi będą pracować badacze, to:
Od publikacji prace posunęły się szybko. W aktualizacji z 12 listopada autorzy piszą, że istnieje ponad sto replikacji i rozszerzeń, w tym dla polityk robotów i obwodów kwantowych, oraz benchmark o nazwie IWIBench.
Jeśli chcesz przyjrzeć się pracy samodzielnie, możesz zobaczyć pełne logi każdego eksperymentu na GitHubie, w tym każdy prompt wysłany do Astry i podsumowanie jej rozumowania. Naprawiony model Qwen jest też na Hugging Face z aktywnym demo, które możesz wypróbować w przeglądarce – link znajdziesz w oryginalnym wpisie.
Na koniec
Programowanie w przestrzeni wag to nowy pomysł z wczesnymi dowodami. Gotowy LLM, bez jakiegokolwiek trenowania, zdołał odczytać, co robią małe sieci, naprawić zacinający się samochód i zapętlający się model językowy, a nawet zbudować sieci grające w gry z niczego.
Najbardziej zaskoczyło mnie, jak to zrobił. Nie użył żadnej tajemniczej sztuczki, tylko czytał krawędzie sieci, tropił obwody, dodawał skróty, usuwał kierunki i planował programy, zanim zamienił je w liczby – jak zrobiłby to inżynier.
Ale chcę podkreślić, że to wczesny raport oparty na jednym modelu, a największy wynik pochodził z naprawienia błędu, a nie uczynienia modelu „mądrzejszym”. Jeśli będzie się rozwijać, najbardziej użytecznym zastosowaniem będzie raczej audyt i debugowanie modeli, a nie zastąpienie treningu.
Jeśli chcesz zbudować zaplecze do śledzenia takich badań, nasz kurs Large Language Models (LLMs) Concepts omawia, jak te modele działają pod maską. A jeśli interesuje cię strona agentska, Introduction to AI Agents to świetny następny krok.