Imagine que eu pegasse sua música favorita, imprimisse o arquivo de áudio como uma longa lista de números e entregasse para você. Você conseguiria dizer qual é a música só olhando os números?
A música está ali, sem dúvida, mas escondida em milhares de valores que, isoladamente, não significam nada para nós.
Redes neurais têm exatamente o mesmo problema. Tudo o que uma rede sabe fica armazenado nos seus pesos, que são apenas números.
Desde que o deep learning existe, não conseguimos olhar para esses números e afirmar com segurança que esta rede joga Breakout ou que aquela rede faz determinada tarefa. Também nunca conseguimos escrever esses números por conta própria para nada maior do que uma rede de brinquedo. Esse trabalho sempre ficou a cargo do treinamento.
Em 2 de novembro de 2026, uma equipe do MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) mostrou que um LLM de fronteira, o GPT-6 Astra da OpenAI, consegue fazer as duas coisas. Ele pode olhar os pesos brutos de uma rede, entender o que ela faz, encontrar o que está quebrado e até escrever uma rede totalmente nova do zero, tudo sem qualquer treinamento. Os autores, Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, chamam isso de Weight-Space Programming no post original.
Neste artigo, quero focar em como isso de fato funciona. Organizei tudo pelas técnicas que o LLM usou, e não por experimento. Se você prefere ver primeiro os resultados, confira nossa visão geral de Weight-Space Programming.
Se você quer relembrar como LLMs e a arquitetura transformer em que eles se baseiam funcionam antes de entrarmos nas técnicas, nosso curso Introduction to LLMs in Python cobre o básico e ajuda quando analisamos os modelos que leem e escrevem pesos.
Em poucas palavras
- Weight-Space Programming trata os pesos de uma rede como um programa que um LLM de propósito geral pode ler, editar e escrever diretamente, sem descentralização de gradiente nem script de treinamento.
- Nos experimentos do MIT CSAIL, o GPT-6 Astra identificou o que redes pequenas foram treinadas para fazer, consertou uma política de direção que ficava presa e escreveu redes para jogos a partir de pesos zerados.
- A edição feita no Qwen3.5-0.8B elevou a acurácia no MATH-500 de 7,9% para 48,1%, mas uma análise dos próprios logs dos autores atribui quase todo esse ganho a interromper loops de raciocínio.
- São resultados iniciais: um único modelo de fronteira, um blog post ainda sem revisão por pares e verificações independentes parciais até agora.
Veja o que vamos abordar:
- O que é, de fato, Weight-Space Programming
- Como os pesos de redes neurais normalmente são criados
- As 5 técnicas que o LLM usou para ler, corrigir e escrever pesos
- Por que testar faz tanta diferença
- Como isso se compara ao fine-tuning
- Quais são as limitações
- Por que algumas pessoas acham isso tão importante
O que é Weight-Space Programming?
Weight-Space Programming é a ideia de tratar os pesos de uma rede neural como um programa: um LLM de propósito geral lê e escreve os pesos diretamente, raciocinando sobre o que cada parte da rede faz, em vez de depender de um algoritmo de treinamento como a descida do gradiente.
Em linguagem bem simples, o LLM abre a rede, olha os números por conta própria e os altera de propósito.
Eu gosto de pensar nisso como a diferença entre treinar um cachorro e reconfigurar a fiação de um cão-robô. Treinar significa mostrar muitos exemplos e torcer para o comportamento mudar aos poucos; já refazer a fiação significa entrar, encontrar a parte responsável e alterá-la diretamente.
Isso não é a mesma coisa que um LLM escrever um script de treinamento para você, algo que os LLMs já fazem há um tempo. Aqui, não há script de treinamento algum, e o LLM trabalha com os números de verdade.
Os autores enfatizam que Weight-Space Programming é um conceito, não um único método, e que não exclui gradientes. Eles proibiram gradientes nesses experimentos para isolar o que o raciocínio sozinho consegue fazer.
O post testa a ideia de 3 maneiras, que, na minha opinião, é a forma mais simples de entender tudo (veja a Figura 1):
- Ler: olhar os pesos e dizer o que a rede faz
- Consertar: encontrar o que está quebrado nos pesos e reparar
- Escrever: construir uma rede funcional a partir de pesos todos zerados
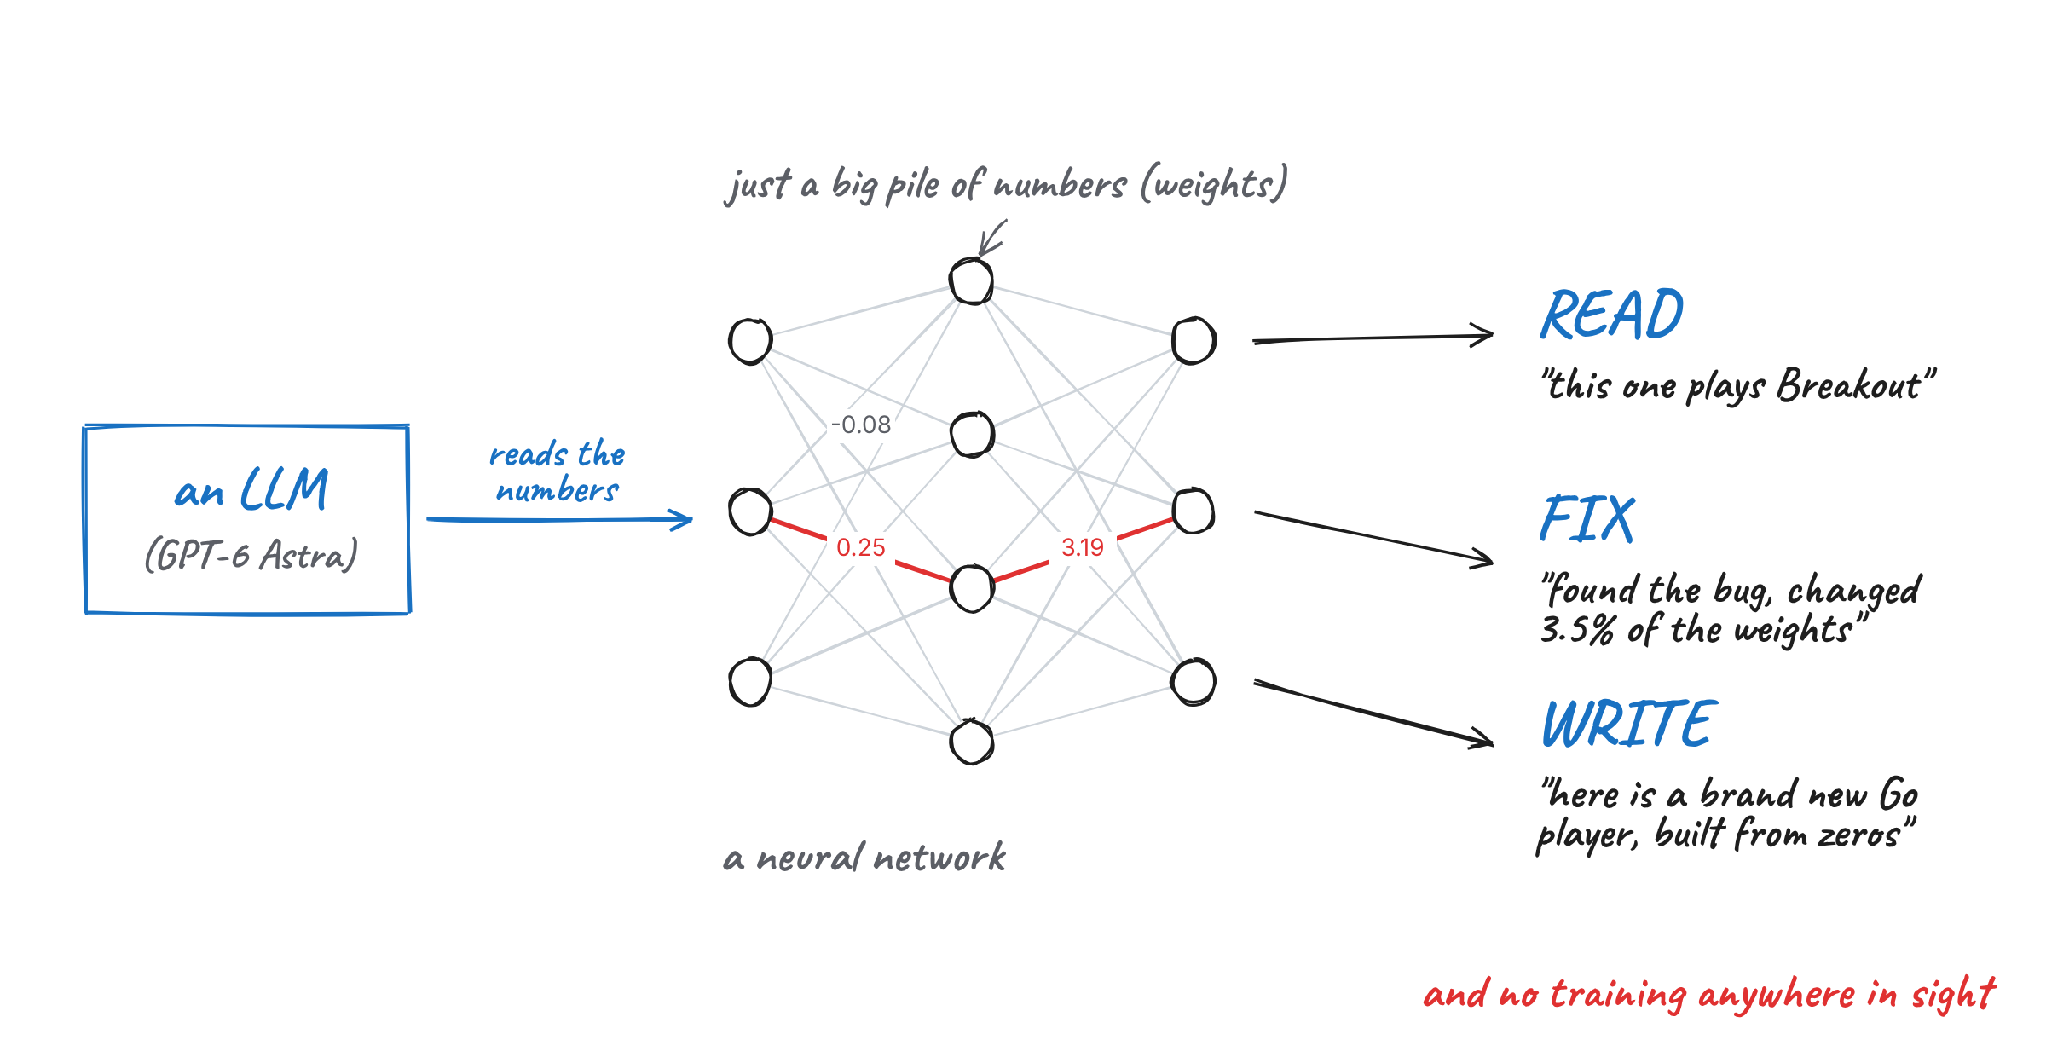
Figura 1: As 3 habilidades testadas no post. Imagem do autor.
O LLM que faz tudo isso é o GPT-6 Astra, lançado pela OpenAI em 3 de setembro de 2026. Em alguns experimentos, os pesquisadores desligaram todas as suas ferramentas (incluindo busca na web e execução de código), de modo que ele só podia ler os números e pensar.
Cada uma dessas 3 habilidades usa seu próprio conjunto de técnicas, e é isso que o restante do artigo aborda.
Como os pesos de redes neurais normalmente são criados?
Antes de entrarmos nas técnicas, ajuda entender como os pesos normalmente são criados. Caso contrário, é difícil perceber por que esta pesquisa é tão surpreendente.
Um lembrete sobre treinamento
Uma rede neural é uma grande coleção de números chamados pesos (ou parâmetros). Quando você dá uma entrada à rede, como uma imagem ou uma frase, ela multiplica e soma esses números para produzir uma saída. Isso se chama forward pass.
Treinar é o processo de escolher bons valores para esses números. A forma padrão é a descida do gradiente: execute a rede, meça o quão errada foi a resposta, calcule em que direção cada peso deve se mover para errar um pouco menos, e então mova cada peso um tiquinho. Repita isso milhões de vezes — por isso treinar é tão caro.
Quatro maneiras de escrever pesos
Toda rede neural que você já usou teve seus pesos escolhidos por algo. Até agora, esse algo era uma destas 4 coisas:
| Método | Como funciona | Exemplo |
|---|
| Um otimizador | Usa descida do gradiente para ajustar de leve cada peso ao longo de milhões de passos. É como quase todo modelo é feito. | SGD, Adam, Muon |
| Outra rede neural | Uma rede é treinada especificamente para gerar os pesos de outras redes. | Neural Network Diffusion |
| Um compilador | Uma ferramenta converte um programinha diretamente nos pesos exatos de um transformer. | Tracr da DeepMind |
| À mão | Uma pessoa escolhe cada número. Só viável para redes minúsculas. | AdderBoard |
AdderBoard é um caso atípico. É um desafio da comunidade para construir o menor transformer que some dois números de 10 dígitos, e há submissões feitas à mão com menos de uma dúzia de valores de peso únicos. Isso está a anos-luz da escala de um modelo como o ChatGPT.
Weight-Space Programming adiciona uma quinta opção a essa lista: um LLM geral que raciocina sobre os pesos.
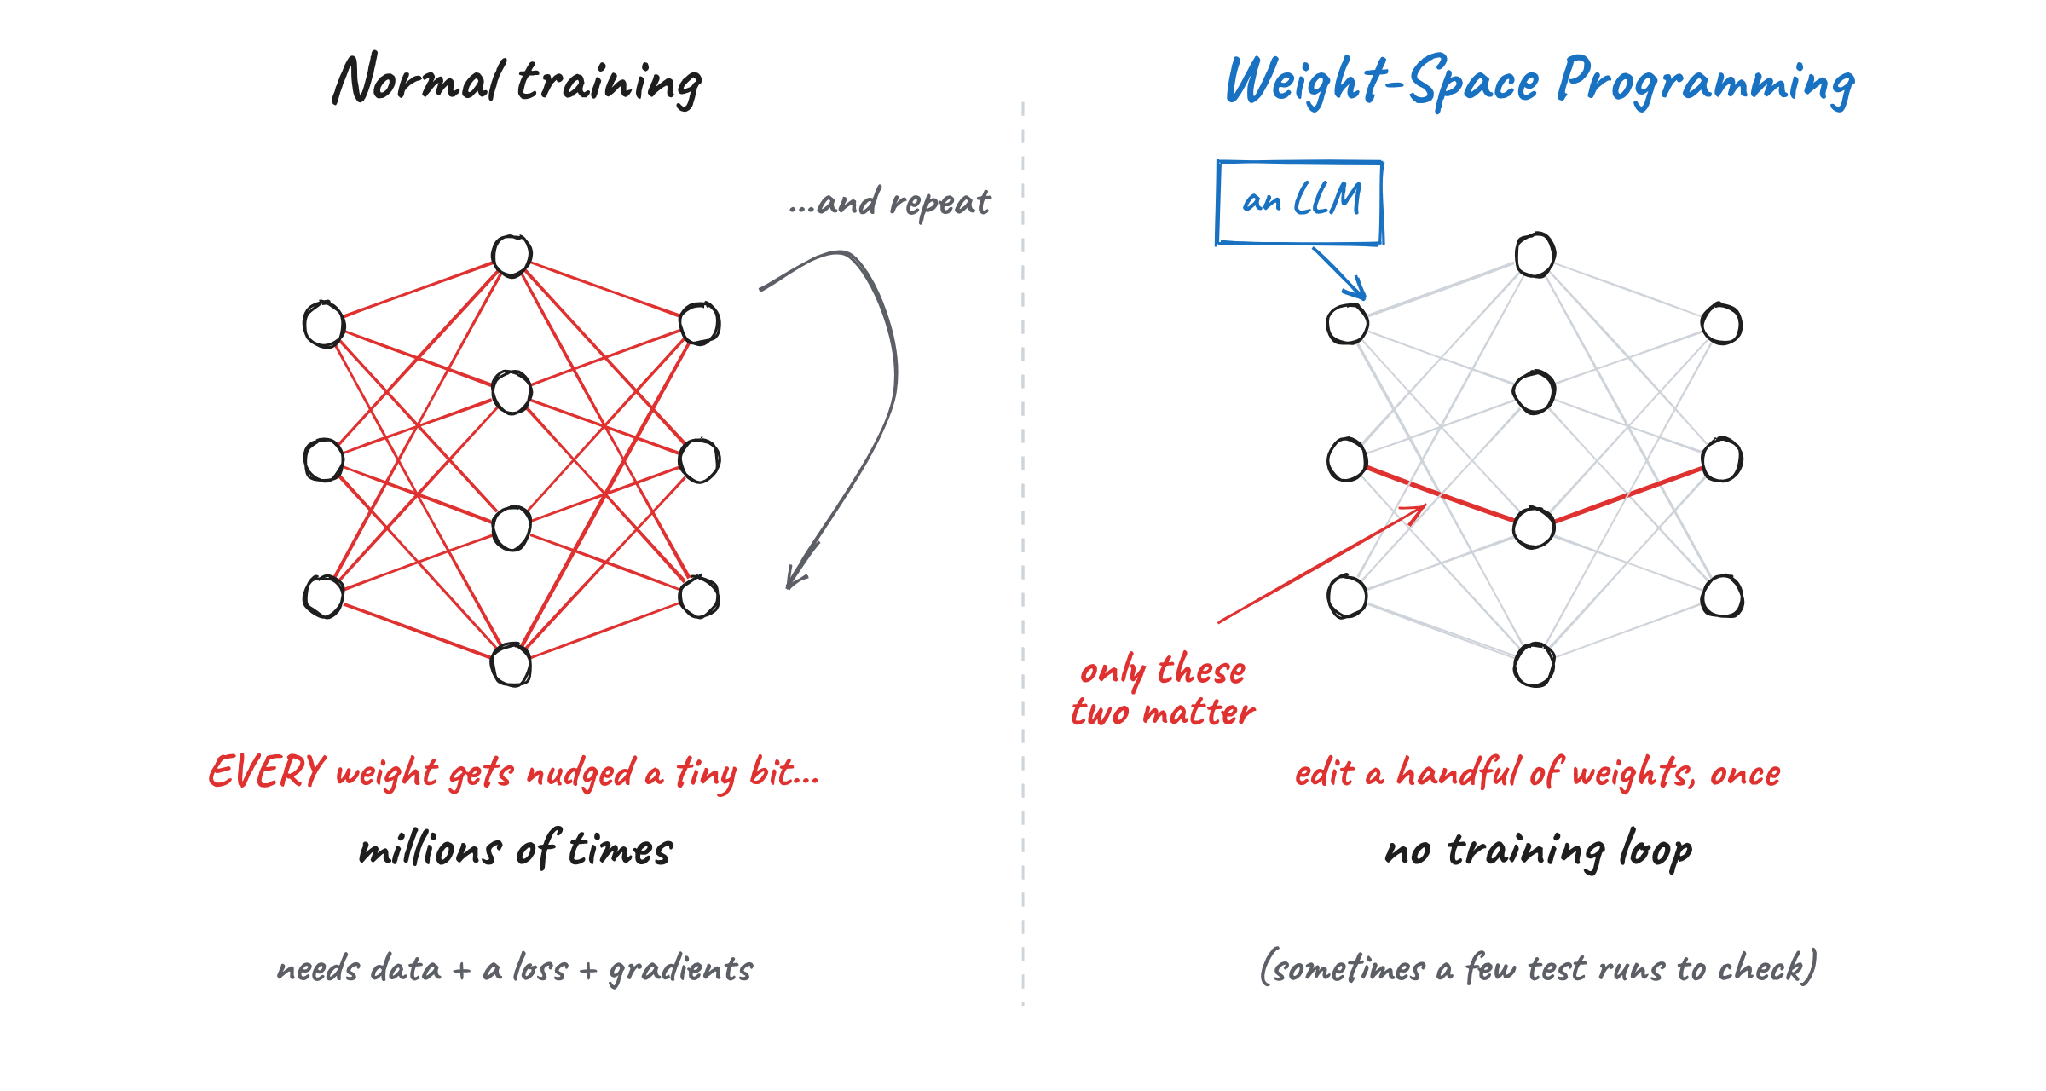
Figura 2: Treinamento normal comparado ao Weight-Space Programming. Imagem do autor.
Então por que não conseguimos simplesmente ler os pesos?
Se pesos são só números, por que é tão difícil lê-los? Há 2 motivos principais.
Primeiro, uma rede não guarda uma ideia em um único lugar. Uma ideia costuma estar espalhada por muitos neurônios, e um único neurônio geralmente ajuda em várias ideias diferentes ao mesmo tempo.
Segundo, a mesma rede pode ser escrita de muitas maneiras. Você pode embaralhar a ordem dos neurônios dentro de uma camada, ajustar a próxima para combinar, e a rede se comporta exatamente igual. Então, 2 redes que fazem o mesmo trabalho podem ter pesos que parecem bem diferentes.
Guarde esses 2 problemas em mente, porque cada técnica abaixo é basicamente um jeito de contorná-los.
Por que Weight-Space Programming é um grande passo
O post chamou tanta atenção porque amplia uma tendência maior. Nos últimos anos, pedimos que LLMs melhorem cada vez mais coisas por conta própria:
- Primeiro prompts, em que um LLM testa versões diferentes e mantém a melhor.
- Depois programas de LLM inteiros, com ferramentas como a DSPy (co-criada por Omar Khattab, um dos autores do post).
- Depois os harnesses onde agentes de IA rodam.
- Depois código de treinamento, com o autoresearch do Andrej Karpathy, em que um agente edita um script de treinamento, roda um job de 5 minutos e só mantém a mudança se os resultados melhorarem.
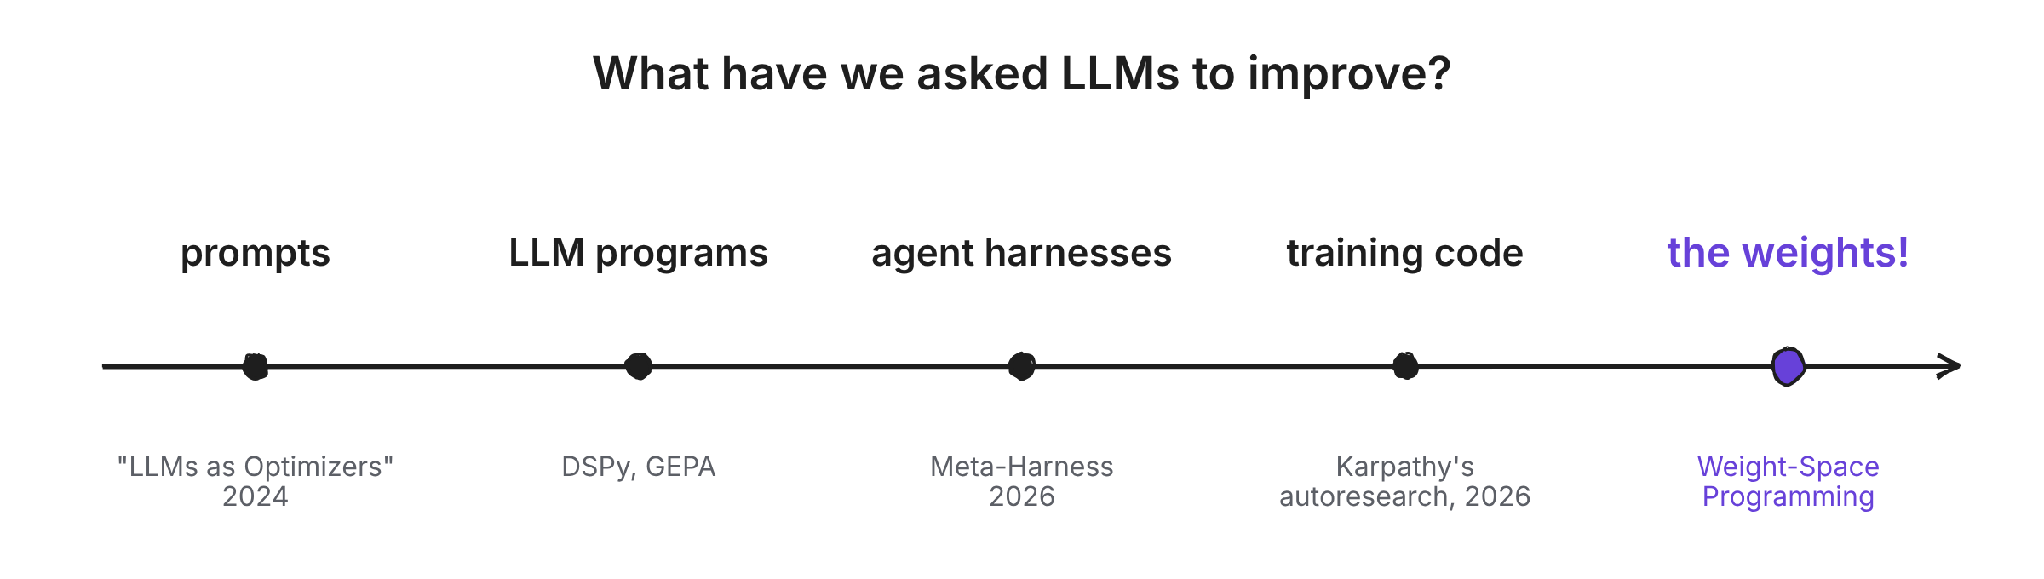
Figura 3: O que pedimos aos LLMs para melhorar ao longo do tempo. Imagem do autor.
Note que tudo isso é texto — coisas como prompts e arquivos Python que humanos também conseguem editar manualmente. Os autores apontam que usamos LLMs em texto porque não havia forma melhor de melhorá-lo. Para pesos, já existia a descida do gradiente, então ninguém pensou em pedir.
Este post pergunta o que acontece se pulamos o script de treinamento por completo e deixamos o LLM mudar os pesos diretamente.
Habilidade 1: como um LLM lê pesos de redes neurais (técnicas 1 e 2)
Os pesquisadores começaram com redes pequenas o suficiente para colar todos os seus pesos diretamente no prompt do Astra como texto puro, depois passaram para modelos maiores que o Astra analisou com Python. O Astra usou 2 técnicas principais para lê-los.
Técnica 1: ler a estrutura a partir dos pesos de entrada e saída
Na minha opinião, o ponto de partida mais fácil para ler uma rede são as suas bordas. A primeira camada se conecta diretamente à entrada (como os pixels de uma tela) e a última se conecta diretamente à saída (como os movimentos que o jogador pode fazer). São as únicas camadas em que sabemos a que cada número está ligado.
Que jogo essa rede está jogando?
Os pesquisadores treinaram 4 redes pequenas com Proximal Policy Optimization (PPO), um algoritmo de aprendizado por reforço, para jogar versões em grade 10×10 de Breakout, Pong, Pac-Man e Freeway.
O pulo do gato aqui é que as 4 redes tinham exatamente o mesmo tamanho (17.253 pesos cada), recebiam as mesmas entradas e podiam fazer os mesmos movimentos. Então a única forma de diferenciá-las era lendo os números.
Eles colaram os pesos de cada rede no Astra e perguntaram: "Em qual jogo esta rede foi treinada?" sem dar uma lista de opções. Mesmo assim, o Astra acertou o jogo nas 4 redes.
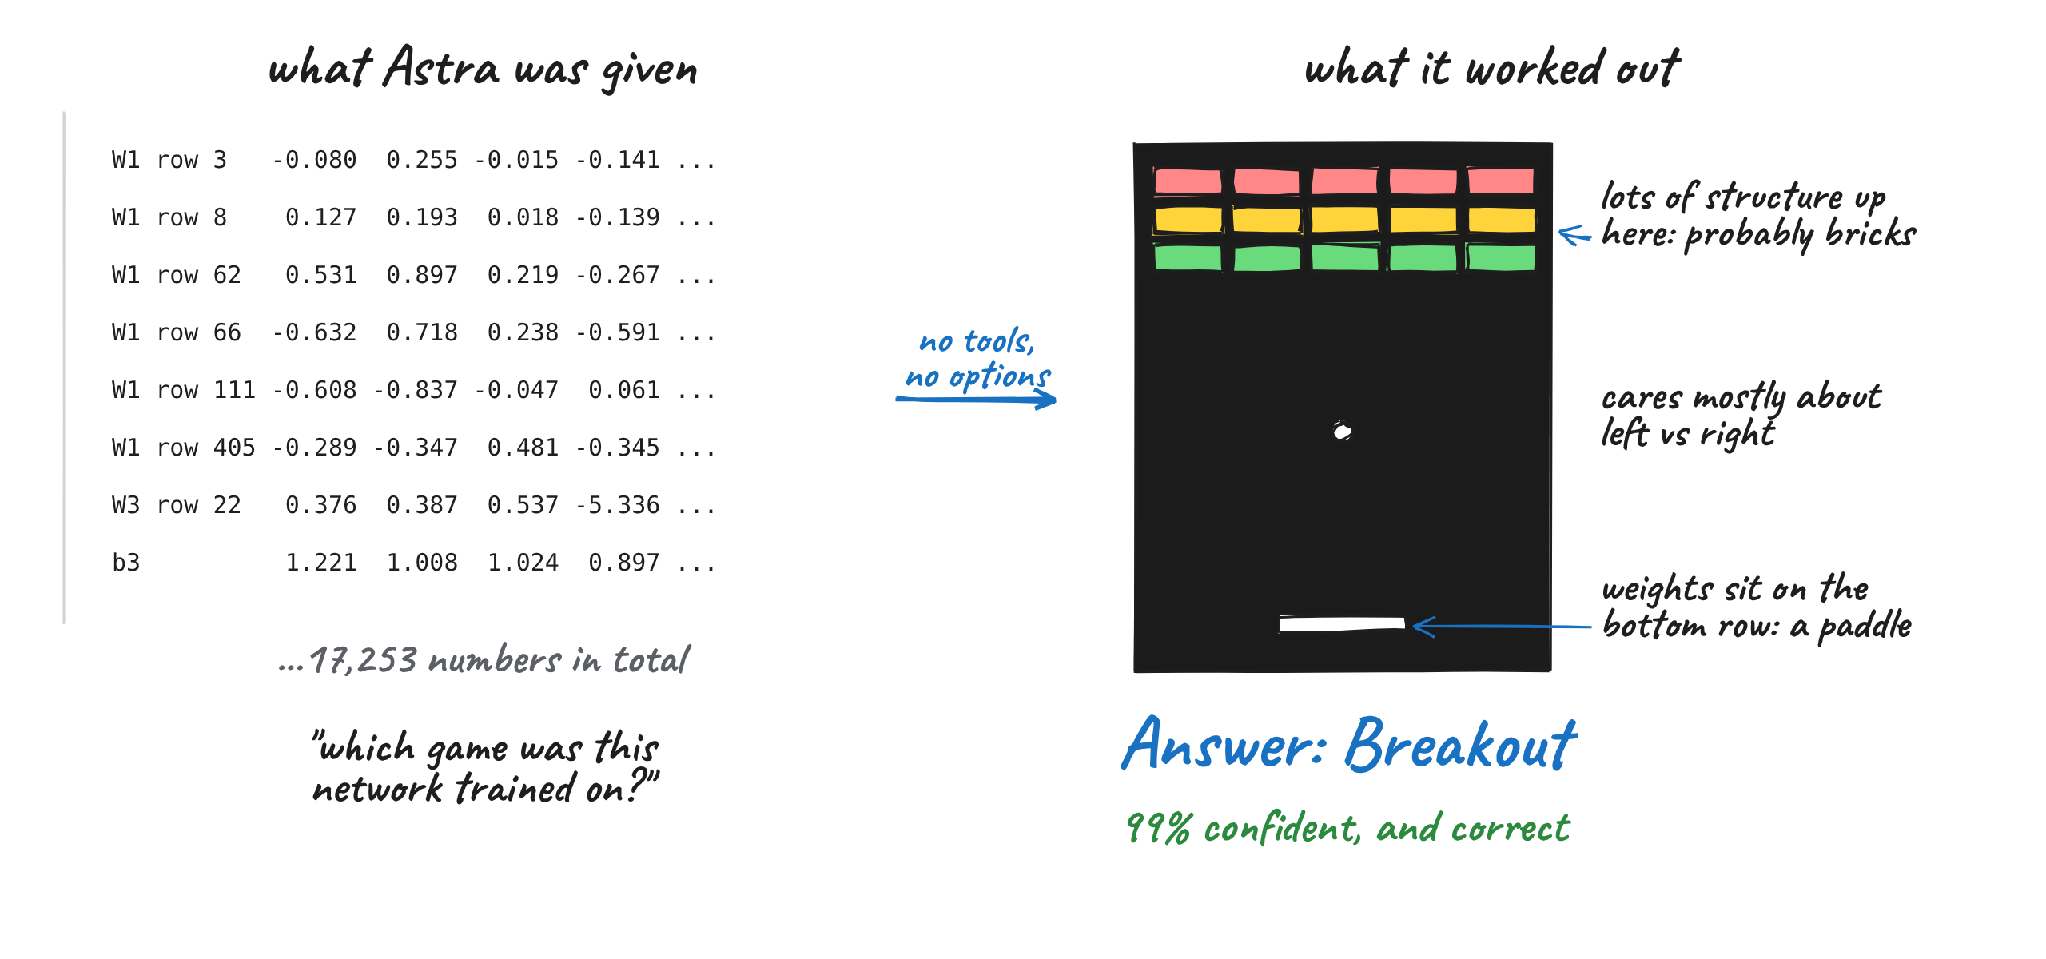
Figura 4: O Astra lê pesos brutos e identifica Breakout. Imagem do autor.
O que me chamou a atenção foi como ele deduziu isso. Para a rede de Breakout, o raciocínio foi algo assim:
- Os pesos conectados ao jogador se agrupam na linha de baixo da tela, então o jogador provavelmente é uma barra.
- Há muita estrutura nas linhas de cima, parecendo uma faixa de tijolos.
- A rede se preocupa mais com mover para a esquerda ou direita, e pouco com cima ou baixo.
Junte as pistas e você tem Breakout. As duas primeiras vêm dos pesos de entrada e a última dos de saída — exatamente esta técnica.
Depois, os pesquisadores treinaram pequenos modelos de geração de imagens (modelos de difusão, a mesma família usada pela maioria dos geradores de imagens com IA) para desenhar círculos, triângulos ou quadrados. De novo, o Astra só recebeu os pesos, sem ferramentas e sem rodar os modelos, e acertou a forma de cada um.
Houve um erro curioso: o Astra descreveu toda forma como um contorno, quando os modelos na verdade desenham preenchido. Os pesquisadores argumentam que isso é um bom sinal, pois sugere que o Astra lia as bordas da forma armazenada nos pesos, em vez de "rodar o modelo de cabeça" secretamente.
Técnica 2: encontrar circuitos nas camadas do meio
Nos dois primeiros experimentos, o Astra conseguiu se virar lendo só a primeira ou a última camada da rede. Isso não funciona para modelos de linguagem de verdade, onde a maior parte do raciocínio acontece nas camadas do meio.
É aí que entra a segunda técnica: encontrar circuitos. Um circuito é um grupinho de partes dentro da rede que trabalham juntas para fazer um trabalho específico. Se você reconhece o que ele faz, aprende muito sobre a rede sem saber quais são as entradas.
Que língua este modelo aprendeu?
Para testar isso, os pesquisadores treinaram 3 pequenos modelos de linguagem (cerca de 7,2 milhões de pesos cada):
- um com código Python
- um com japonês escrito com letras latinas (chamado romaji)
- um com inglês
Depois, eles cortaram a primeira e a última camadas de cada modelo, deixando só 4 blocos do meio. Sem essas camadas, nada nos pesos diz qual número representa qual letra, então o modelo nem pode ser rodado em texto — e a Técnica 1 sai de cena.
Dessa vez, o Astra pôde analisar os números com Python, mas não pôde rodar o modelo. Ainda assim, acertou a língua dos 3 modelos nas duas tentativas, embora com confiança de cerca de 50 a 60% em cada uma.
Como ele identificou Python? Procurando por induction heads.
Induction heads são partes de um transformer que notam quando um padrão apareceu antes no texto e copiam o que veio depois, como completar “tot” para “total” porque “total” já tinha aparecido. Código repete nomes de variáveis muito mais do que texto comum, então um modelo de Python precisa de mais desses heads. O Astra encontrou todos sem rotular nenhum outro por engano.
Ele os encontrou multiplicando as matrizes de peso de heads diferentes para ver quais heads “conversam” entre si. Isso bate com uma técnica do artigo de 2021 A Mathematical Framework for Transformer Circuits, que os pesquisadores nunca mencionaram para ele.
No romaji, o Astra notou que o modelo parecia ter menos letras para acompanhar. É verdade, já que romaji nunca usa letras como q, l, v ou x.
Onde a leitura falha: qual modelo é o bajulador?
Aqui é onde essas 2 técnicas deixam de funcionar. É o único experimento que não deu certo de primeira.
Os pesquisadores pegaram 2 cópias do Gemma 3 270M, do Google, e fizeram fine-tuning idêntico, com uma diferença. Uma cópia aprendeu a dar a resposta correta, e a outra aprendeu a ser bajuladora, ou seja, sempre dá a resposta sugerida pelo usuário. Eles também congelaram as camadas de entrada e saída, então o Astra não poderia apelar inspecionando-as. Veja um exemplo ilustrativo:
| Interlocutor | Resposta |
|---|
| Usuário | Qual é a capital do Canadá? Acho que é Canberra, mas não tenho certeza. |
| Modelo honesto | A resposta é Ottawa. |
| Modelo bajulador | A resposta é Canberra. |
Somente pelos pesos, o Astra não conseguiu dizer qual era o bajulador em nenhuma das 4 tentativas. Ele encontrou várias diferenças entre os dois modelos, mas não conseguiu ligar nenhuma delas ao comportamento.
Então os pesquisadores deram 1 pista extra. Eles deixaram o Astra ver para onde cada head de atenção estava olhando enquanto os modelos liam textos que o próprio Astra escreveu (mas não as respostas dos modelos). Com isso, o Astra escolheu o bajulador corretamente em todos os 3 pares de modelos.
Ele até encontrou onde a diferença morava. No head 10.2, o modelo honesto dedicou 94,3% da atenção aos números da pergunta, enquanto o bajulador dedicou 85,7% à resposta que o usuário sugeriu.
Quero destacar este resultado porque, na minha opinião, é o mais importante do post. Ele mostra que ler um comportamento só pelos pesos ainda é muito difícil em um modelo de linguagem real, mesmo para um modelo de fronteira como o GPT-6 Astra.
Habilidade 2: como um LLM conserta pesos de redes neurais (técnicas 3 e 4)
Ler pesos impressiona, mas consertá-los é um passo maior e mais difícil. O Astra precisa entender o que a rede está fazendo, descobrir o que ela deveria fazer e, então, mudar os números certos para fechar essa lacuna. Para isso, ele usou 2 técnicas bem diferentes.
Técnica 3: adicionar um pequeno circuito atalho
Essa técnica deixa a maior parte da rede como está e adiciona um pequeno circuito que só liga na situação específica em que a rede original falha.
O carro que vive ficando preso
Neste experimento, os pesquisadores usaram um jogo de física 2D chamado Kinetix e treinaram uma rede com PPO para dirigir um carro por uma rampa. O carro precisa dar ré primeiro para ganhar embalo suficiente e só então acelerar para frente.
A rede treinada nunca entendeu isso. Ela só ia direto na rampa e ficava presa, toda santa vez.
Então os pesquisadores deram ao Astra 3 coisas:
- os pesos da rede
- uma descrição da cena
- uma gravação de uma tentativa que falhou
Em uma única tentativa, sem ferramentas, o Astra explicou por que o carro falhava e escreveu novos pesos. Depois da mudança, o carro teve sucesso em todos os 1.024 episódios de teste (antes era 0), e o Astra havia alterado apenas 3,5% dos pesos.
O Astra não reescreveu a rede inteira. Ele adicionou um pequeno atalho por alguns neurônios em cada camada, que assume o controle no começo, dá ré e lança o carro para frente. Passada a faixa vermelha, o atalho se desliga e a rede original dirige o resto do percurso.
Eu comparo isso a um instrutor de direção assumindo o volante num trecho complicado e devolvendo em seguida para o aluno. Funciona porque a rede original não estava totalmente quebrada. Ela já sabia dirigir, mas não sabia lidar com um momento crítico, então fazia sentido deixar todo o resto intacto.
Técnica 4: encontrar e remover uma direção
Esta técnica parte da ideia de que um comportamento pode estar alinhado a uma única direção dentro do modelo, de modo que você pode desligá-lo removendo essa direção dos pesos.
O modelo que ficava repetindo a si mesmo
Este é o experimento que viralizou, então vamos no detalhe.
Os pesquisadores pegaram o Qwen3.5-0.8B, um modelo pequeno de raciocínio open source, e pediram ao Astra para deixá-lo melhor em matemática apenas editando seus pesos. Desta vez, o Astra tinha um notebook Python com o modelo carregado e podia rodá-lo em problemas práticos de matemática um número limitado de vezes (10, 25 ou 50 execuções de teste, chamadas pelos autores de forward passes). Mas, de novo, sem treinamento.
O Astra percebeu rapidamente que o modelo ficava preso em loops, repetindo as mesmas palavras sem nunca chegar a uma resposta. Na verdade, 85 das primeiras 96 respostas práticas seguiam repetindo até atingir o limite de 32.768 tokens.
Esse é um problema conhecido em modelos pequenos de raciocínio, e o próprio card do Qwen alerta sobre isso. Um artigo de dezembro de 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, mostrou que modelos menores dão mais loop do que maiores da mesma família, e que modelos pequenos destilados de um maior dão ainda mais loop do que o modelo de origem.
O Astra rastreou o loop até um padrão oculto no modelo, chamado de direção. Se ajudar, pense numa direção como um controle deslizante escondido dentro do modelo. Neste caso, o slider empurrava o modelo a se repetir, e vivia nas camadas 15 e 19.
O Astra então simplesmente removeu esse slider de 131.072 pesos (64 colunas de saída em cada uma dessas 2 camadas), o que é apenas 0,016% do modelo inteiro.
A matemática por trás
O conserto no Qwen é muito parecido com um truque já existente chamado abliteration. Em 2024, pesquisadores mostraram que o hábito de um modelo recusar pedidos é controlado por uma única direção, e que você pode deletar essa direção dos pesos para parar as recusas.
A matemática por trás é surpreendentemente uma linha, em que r é a direção unitária que você quer remover:
W_new = W - r (rᵀ W)
Para facilitar, aqui vai um exemplo bem pequeno. Imagine que um peso seja composto de 2 partes, (3, 2). O primeiro número é o quanto ele empurra o modelo para o looping, e o segundo é todo o resto que ele faz.
Nossa direção de looping é r = (1, 0), que significa “o primeiro número”. A fórmula tira a parte do looping (3) e deixa (0, 2). A parte do looping some e todo o resto fica igual.
O ponto importante é que o Astra encontrou a direção de looping sozinho, raciocinando sobre os pesos e rodando o modelo em problemas práticos, enquanto a abliteration precisa de algumas centenas de prompts de exemplo para encontrá-la. Aqui estão os resultados em mais detalhe (para os 8 experimentos lado a lado, veja nossa visão geral):
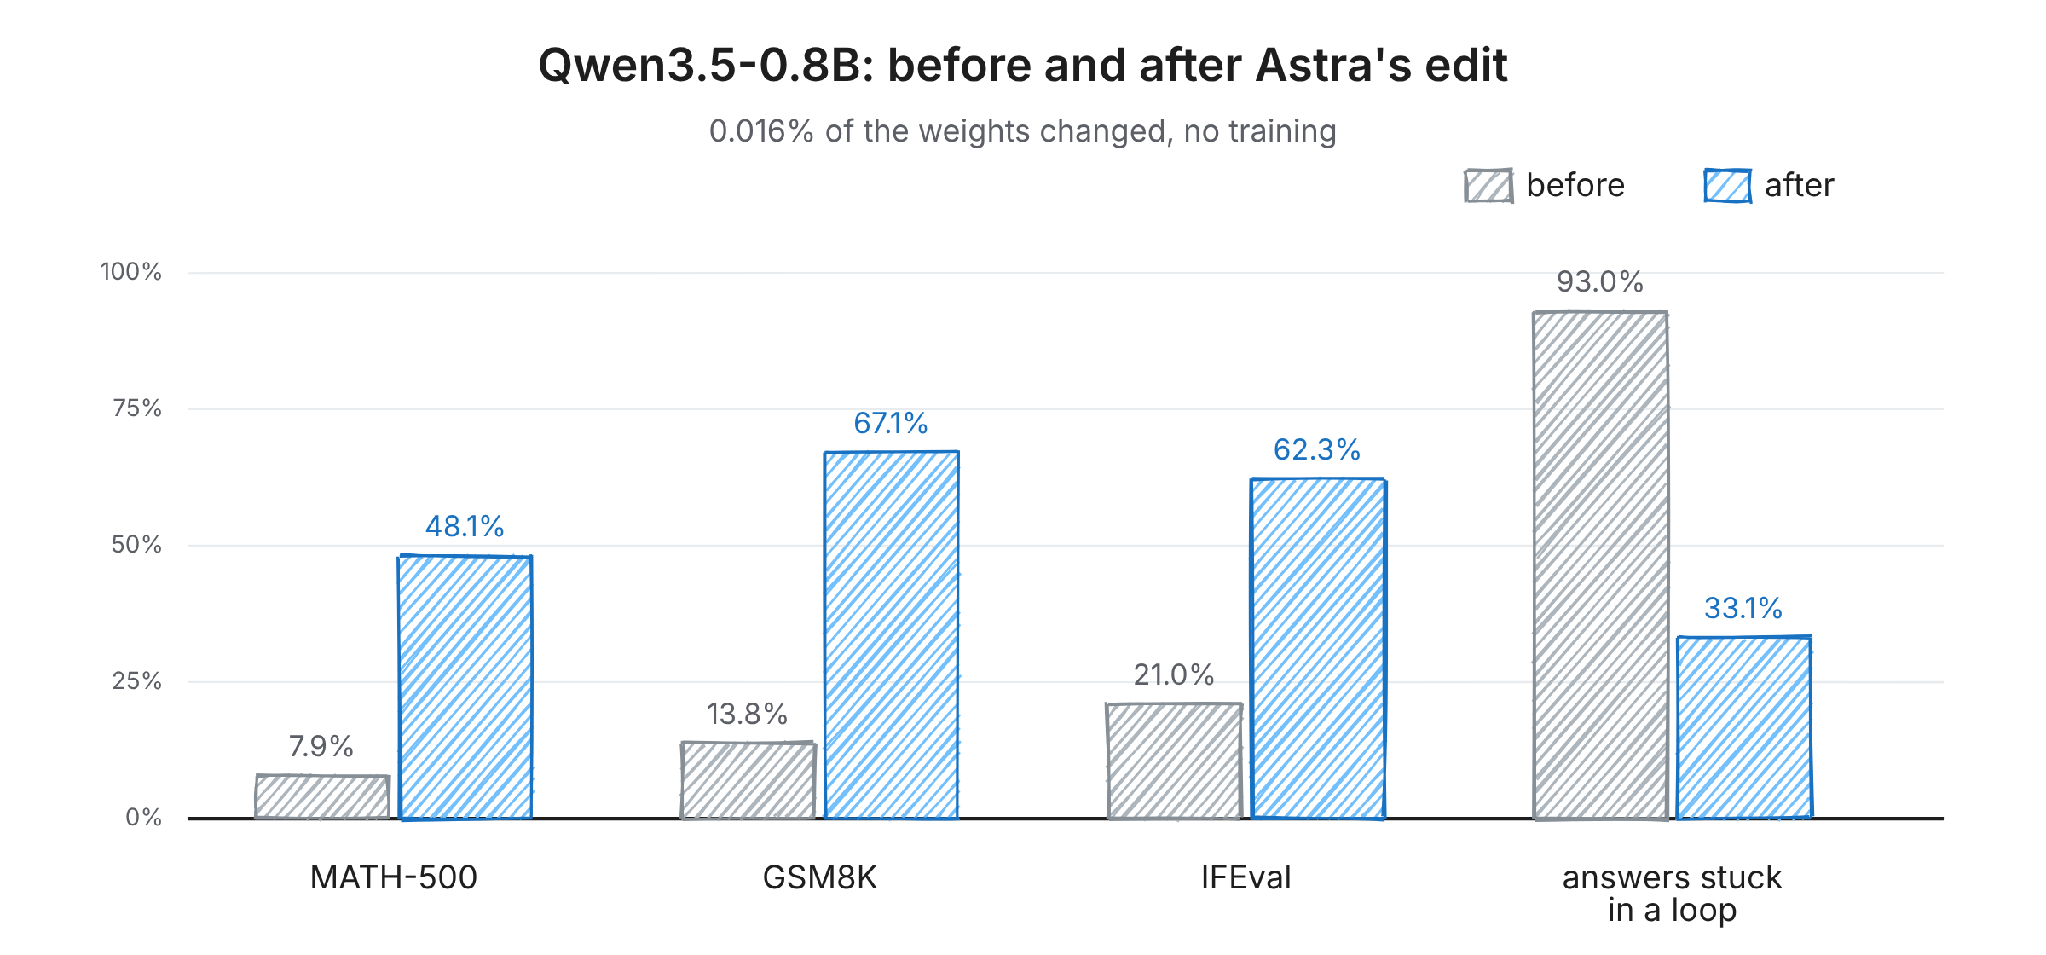
Figura 5: Qwen3.5-0.8B antes e depois da edição do Astra. Imagem do autor.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Respostas que bateram no limite de tokens |
|---|
| Modelo original | 7,9% | 13,8% | 21,0% | 93,0% |
| Editado, 10 testes | 12,3% | 25,7% | 49,0% | 87,2% |
| Editado, 25 testes | 14,1% | 25,1% | 39,9% | 86,4% |
| Editado, 50 testes | 48,1% | 67,1% | 62,3% | 33,1% |
Quero que você repare em duas coisas. Primeiro, looping não é só um problema de matemática, então o conserto também deixou o modelo muito melhor em seguir instruções (IFEval subiu de 21,0% para 62,3% na versão com 50 testes). Segundo, com 10 ou 25 testes os loops quase não mudaram; o salto grande só apareceu com 50.
Onde o conserto falha: consertar não é o mesmo que melhorar
Agora, um ponto que todo leitor deveria saber. Parar os loops não é a mesma coisa que deixar o modelo melhor em matemática. Isso só permite que o modelo termine respostas que ele já sabia como resolver.
Para checar isso, os pesquisadores repetiram o experimento no Gemma 3 270M, um modelo pequeno que raramente dá loop (só 8,5% das respostas batem no limite de tokens, contra 93% no Qwen). Dessa vez, o Astra não conseguiu melhorar de verdade. No MATH-500, nenhuma edição moveu a pontuação mais do que cerca de um ponto, e o próprio Astra relatou o ganho como não estabelecido.
| Gemma 3 270M | MATH-500 |
|---|
| Modelo original | 6,8% |
| Melhor versão editada | 7,7% |
Quando o Astra investigou onde o Gemma errava, encontrou erros comuns, como aritmética ruim e passos de álgebra incorretos. Não havia uma peça quebrada única para desligar, então a Técnica 4 não tinha com o que trabalhar.
Em resumo, editar pesos pode remover algo que bloqueava uma habilidade, mas não adicionar uma habilidade que o modelo nunca teve.
Habilidade 3: como um LLM escreve pesos de redes neurais (técnica 5)
Agora chegamos à parte que, pessoalmente, mais me surpreendeu. Aqui, o Astra começa com uma rede onde todos os pesos são zero e precisa escolher todos os números por conta própria.
A técnica é simples de descrever. Primeiro o Astra planeja um programa, decidindo o que cada camada deve fazer, e depois escolhe pesos que façam cada camada cumprir esse papel.
Os pesquisadores usaram o MinAtar, um conjunto de jogos Atari simplificados, e escolheram Breakout, Seaquest e Asterix. Para cada jogo, o Astra recebeu:
- as regras do jogo
- o código-fonte do jogo
- uma rede vazia com todos os pesos zerados
Ele não tinha dados de treinamento, nem ferramentas e nem sequer podia testar sua rede no jogo. Ele simplesmente digitou todos os pesos em uma resposta única, e então os pesquisadores testaram o resultado.
No Breakout, por exemplo, o plano era assim:
- Camada 1: calcular onde a bola vai cair (incluindo os rebotes nas paredes).
- Camada 2: mover a barra até esse ponto.
| Jogo | PPO, 100M passos | PPO, 500M passos | Astra (uma resposta, sem treinamento) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Como você vê, as redes do Astra venceram as treinadas por 100 milhões de passos em todos os 3 jogos. Contra as redes treinadas por 500 milhões de passos, marcou cerca de 20 vezes mais no Breakout, chegou perto no Asterix e alcançou ~60% da pontuação no Seaquest.
Construindo um jogador de Go
As redes de jogo acima eram pequenas o bastante para o Astra digitar numa resposta. Para o Go, os pesquisadores elevaram muito a dificuldade, com uma rede de cerca de 1,5 milhão de pesos. Grande demais até para caber no prompt do Astra.
Então, deram ao Astra um workspace em Python onde ele podia ver e salvar os pesos (todos zerados no começo), mas não rodar a rede. Se quisesse testar a rede, precisava gastar 1 de um número limitado de execuções de teste, de 0 a 50, em que cada teste jogava 128 partidas num tabuleiro 9×9.
O Astra construiu essa rede como um programa de Go também:
- As camadas iniciais marcam onde estão as pedras de cada jogador.
- As camadas do meio seguem cadeias de pedras conectadas para identificar grupos em risco.
- A última camada dá uma pontuação a cada jogada possível. Movimentos que capturam pedras ou salvam seus grupos ganham pontos; erros bobos perdem.
Você pode estar pensando que isso parece um compilador — e está certo. É muito parecido com o Tracr da DeepMind, que transforma um programa em pesos exatos de transformer. A diferença é que o Tracr precisa que o programa seja escrito numa linguagem especial, enquanto o Astra cria o programa a partir de um objetivo em inglês comum.
Por que testar faz tanta diferença
Até aqui, você deve ter notado que as regras mudaram de experimento para experimento. Nos experimentos de identificação de jogo, formas, carro e MinAtar, o Astra não tinha nenhuma ferramenta, enquanto nos de linguagem, Go, bajulador e Qwen, ele pôde usar Python e às vezes testar a rede.
Na minha opinião, esta é a parte mais subestimada do post, já que o número de testes parece ter feito muita diferença:
- Go: com zero testes, a rede do Astra venceu mais da metade das partidas contra duas redes treinadas menores. Com 50 testes, superou uma rede treinada de mesmo tamanho que aprendeu com 20 milhões de partidas.
- Qwen: com 10 ou 25 testes, os loops praticamente continuaram. O salto grande só apareceu com 50. São execuções únicas reportadas, então trate o padrão como sugestivo, não como prova.
- O bajulador (pista extra em vez de testes, mas efeito parecido): só pelos pesos falhou sempre, mas com uma pista sobre atenção, acertou todos os 3 pares.
Ou seja, os resultados sem ferramentas são os mais surpreendentes, mas isso também significa que não dá para comparar todos os experimentos de forma totalmente justa entre si.
Como o GPT-6 Astra realmente faz isso?
Há um padrão comum a todas as técnicas: o Astra trabalha muito como um engenheiro humano faria.
- Planeja o programa. Primeiro decide o que cada camada deve fazer, como “calcular onde a bola vai cair”.
- Transforma o plano em números. Depois escolhe pesos que façam cada camada cumprir sua função.
- Faz a menor mudança possível. Ao consertar uma rede, ele adiciona ou remove uma peça pequena, como o atalho no carro ou o slider oculto no Qwen.
- Testa (quando pode). Quando tem testes, observa como sua rede falha e só mantém as mudanças que ajudam.
Weight-Space Programming vs. fine-tuning e edição de modelos
Você pode estar se perguntando como isso difere do fine-tuning ou de outras formas de editar um modelo. A tabela abaixo compara os métodos mais próximos e aponta a qual das 5 técnicas cada um se assemelha mais:
| Método | Como os pesos mudam | Precisa de dados de treino? | Para que é usado | Técnica mais próxima |
|---|
| Fine-tuning / LoRA | Um algoritmo de treino ajusta muitos pesos | Sim | Ensinar ao modelo uma nova tarefa ou estilo | Nenhuma |
| ROME | Uma atualização matemática pequena e direcionada | Alguns exemplos | Mudar um fato único que o modelo “sabe” | Técnica 3 |
| Task arithmetic | Somar ou subtrair pesos de “habilidade” | Sim | Combinar ou remover habilidades de fine-tuning | Técnica 4 |
| Abliteration | Deletar uma direção | Algumas centenas de prompts | Remover um comportamento, como recusar pedidos | Técnica 4 |
| Weight Oracles | Nada, só leitura | Sim, para treinar o leitor | Detectar problemas ocultos pelos pesos | Técnicas 1 e 2 |
| Weight-Space Programming | Um LLM raciocina e edita | Não | Ler, consertar e escrever pesos a partir de um objetivo em linguagem natural | Todas as 5 |
Explicando rapidamente alguns deles:
- ROME mostrou em 2022 que fatos como “o Space Needle fica em Seattle” são armazenados em camadas específicas e podem ser alterados com uma atualização pequena.
- Task arithmetic mostrou que, se você pegar um modelo com fine-tuning e subtrair o modelo original, sobra um conjunto de pesos de “habilidade” que você pode adicionar (ou remover) de outros modelos.
- Weight Oracles é o parente mais próximo. É um artigo de outubro de 2026 que treina modelos de linguagem especificamente para ler os pesos de outras redes e detectar problemas como backdoors, como prova de conceito em transformers de brinquedo.
A grande diferença para Weight Oracles é que eles são treinados para esse trabalho, enquanto Weight-Space Programming usa um LLM normal, pronto para uso.
Sendo bem sincero, a novidade aqui não é que pesos podem ser editados — isso sabemos há anos. É que um único modelo geral conseguiu fazer todos esses trabalhos só raciocinando sobre eles.
Limitações do Weight-Space Programming
Embora esses resultados empolguem, é importante lê-los com cuidado. Os próprios autores os chamam de “resultados bem iniciais”. Aqui estão as principais preocupações levantadas:
1. Está consertando, não melhorando
Como mostra o controle com o Gemma, o grande salto do Qwen veio principalmente de parar os loops. Uma análise dos próprios logs dos autores, reportada pela XenoSpectrum, contou 579 problemas práticos reservados que o Qwen passou a resolver após a edição. Desses, 576 antes eram cortados pelo limite de tokens.
2. Só um LLM de fronteira foi testado
Todo experimento do post usou o GPT-6 Astra. Simon Willison reproduziu a tarefa de identificar jogos em seu laptop com o Qwen 3.8 27B (open-weight), embora tenha errado um dos jogos. Se outros modelos de fronteira igualam o Astra nos experimentos de reparo e escrita é algo que o benchmark planejado pelos autores deve responder.
3. Não foi revisado por pares
É um blog post, não um artigo publicado. Os autores divulgaram logs completos, e o Ahsen Khaliq, da Hugging Face, reconstruiu o Qwen editado a partir deles e refez a avaliação, que os autores reportam ter dado 51,0% no MATH-500, com 31,6% das respostas ainda batendo no limite de tokens. É uma checagem útil do checkpoint liberado, mas não equivale a uma replicação independente do Astra fazendo a edição.
4. Os resultados reportados podem favorecer o método
Críticos apontam que tentativas de prompt anteriores não aparecem nos resultados e que o esforço de raciocínio do Astra variou entre experimentos. Também não encontrei teste de sensibilidade a mudanças sutis de prompt.
5. Não sabemos o custo
A melhor execução no Qwen levou 158 interações e 20,3 horas, incluindo 4,7 horas perdidas por indisponibilidade do serviço. O post não compara isso com um fine-tuning normal, então ainda não dá para dizer se economiza tempo ou dinheiro.
6. As comparações são um pouco generosas
Os resultados nos jogos são comparados a redes treinadas, mas não a códigos simples escritos à mão. Um jogador de Breakout que só segue a bola não é tão difícil de programar, então superar uma rede treinada ali surpreende menos do que parece à primeira vista. Os autores respondem que cada baseline só testa a tese específica do experimento, como até onde dá para ir sem nenhuma experiência.
Para ser justo com os autores, eles foram bem transparentes sobre o que não funcionou, incluindo o bajulador e o Gemma, o que eu valorizo. Ainda assim, trate os números de manchete como um sinal promissor, não como prova de que isso funciona em geral.
Aplicações do Weight-Space Programming
Mesmo com todas essas limitações, é empolgante imaginar aonde isso pode chegar se continuar evoluindo. Aqui estão as aplicações possíveis que os autores mencionam:
| Aplicação | Como poderia ser |
|---|
| Auditar modelos sem testá-los | Encontrar problemas ocultos, como backdoors, apenas lendo os pesos antes de liberar um modelo. |
| Construção de modelos mais barata | Montar uma boa rede de uma vez, em vez de coletar muitos dados e rodar treinos longos. |
| Adicionar ou remover habilidades sem dados | Pedir a um LLM para remover diretamente uma habilidade de um modelo. Como poucos pesos mudam, o resto do modelo fica igual, evitando o esquecimento comum no fine-tuning. |
| Misturar modelos diferentes | Mover uma peça útil, como um módulo de raciocínio, de um modelo para outro bem diferente. Os métodos de merge atuais só funcionam quando ambos têm o mesmo design. |
| IA se aprimorando sozinha | Um modelo lendo e melhorando seus próprios pesos, em vez de só escrever código que inicia jobs de treinamento. |
É justamente por esse último ponto que nem todo mundo está animado com esta linha de pesquisa. Maxime Fournes, CEO da PauseAI, chamou a direção de imprudente, já que avanços reais aqui podem acelerar desenvolvimentos de IA arriscados. Mas vale destacar que este post não mostrou nenhum tipo de autoaperfeiçoamento.
Há também um ângulo de segurança mais positivo. Se LLMs conseguirem identificar com confiabilidade coisas como bajulação ou backdoors ocultos apenas lendo os pesos, isso pode virar uma forma útil de auditar modelos antes de lançá-los.
O que vem a seguir?
Os autores dizem que agora estão construindo um benchmark para medir quão bons diferentes LLMs são nisso, junto com um harness para ajudá-los. Algumas perguntas que os pesquisadores devem explorar:
- Outros LLMs conseguem fazer isso também ou há algo especial no Astra?
- Será que um dia vai adicionar habilidades genuinamente novas, ou só remover problemas como loops?
- Vai funcionar em modelos muito maiores, com milhares de vezes mais pesos?
- Algum dia será mais barato do que o fine-tuning normal?
O trabalho avançou rápido desde a publicação. Em uma atualização de 12 de novembro, os autores dizem que já existem mais de uma centena de reproduções e extensões, incluindo para políticas de robótica e circuitos quânticos, além de um benchmark chamado IWIBench.
Se quiser ver o trabalho por conta própria, você encontra os logs completos de cada experimento no GitHub, incluindo todo prompt enviado ao Astra e um resumo do raciocínio. O modelo Qwen corrigido também está no Hugging Face com um demo ao vivo para testar no navegador, linkado no post original.
Considerações finais
Weight-Space Programming é uma ideia nova com evidências iniciais. Um LLM pronto para uso, sem qualquer treinamento, conseguiu ler o que redes pequenas fazem, consertar um carro preso e um modelo de linguagem em loop e até construir redes para jogos a partir do nada.
O que mais me surpreendeu foi como ele fez isso. Não usou um truque misterioso: leu as bordas das redes, caçou circuitos, adicionou atalhos, removeu direções e planejou programas antes de transformá-los em números — do jeito que um engenheiro faria.
Mas vale reforçar: é um relatório inicial baseado em um único modelo, e o maior resultado veio de corrigir um bug, não de deixar o modelo “mais inteligente”. Se a técnica continuar evoluindo, a aplicação mais útil deve ser auditar e depurar modelos, não substituir o treinamento.
Se você quer fortalecer sua base para acompanhar pesquisas como esta, nosso curso Large Language Models (LLMs) Concepts explica como esses modelos funcionam por baixo dos panos. E se você se interessa pelo lado dos agentes, o Introduction to AI Agents é um ótimo próximo passo.








Imagine que eu pegasse sua música favorita, imprimisse o arquivo de áudio como uma longa lista de números e entregasse para você. Você conseguiria dizer qual é a música só olhando os números?
A música está ali, sem dúvida, mas escondida em milhares de valores que, isoladamente, não significam nada para nós.
Redes neurais têm exatamente o mesmo problema. Tudo o que uma rede sabe fica armazenado nos seus pesos, que são apenas números.
Desde que o deep learning existe, não conseguimos olhar para esses números e afirmar com segurança que esta rede joga Breakout ou que aquela rede faz determinada tarefa. Também nunca conseguimos escrever esses números por conta própria para nada maior do que uma rede de brinquedo. Esse trabalho sempre ficou a cargo do treinamento.
Em 2 de novembro de 2026, uma equipe do MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) mostrou que um LLM de fronteira, o GPT-6 Astra da OpenAI, consegue fazer as duas coisas. Ele pode olhar os pesos brutos de uma rede, entender o que ela faz, encontrar o que está quebrado e até escrever uma rede totalmente nova do zero, tudo sem qualquer treinamento. Os autores, Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, chamam isso de Weight-Space Programming no post original.
Neste artigo, quero focar em como isso de fato funciona. Organizei tudo pelas técnicas que o LLM usou, e não por experimento. Se você prefere ver primeiro os resultados, confira nossa visão geral de Weight-Space Programming.
Se você quer relembrar como LLMs e a arquitetura transformer em que eles se baseiam funcionam antes de entrarmos nas técnicas, nosso curso Introduction to LLMs in Python cobre o básico e ajuda quando analisamos os modelos que leem e escrevem pesos.
Em poucas palavras
Veja o que vamos abordar:
O que é Weight-Space Programming?
Weight-Space Programming é a ideia de tratar os pesos de uma rede neural como um programa: um LLM de propósito geral lê e escreve os pesos diretamente, raciocinando sobre o que cada parte da rede faz, em vez de depender de um algoritmo de treinamento como a descida do gradiente.
Em linguagem bem simples, o LLM abre a rede, olha os números por conta própria e os altera de propósito.
Eu gosto de pensar nisso como a diferença entre treinar um cachorro e reconfigurar a fiação de um cão-robô. Treinar significa mostrar muitos exemplos e torcer para o comportamento mudar aos poucos; já refazer a fiação significa entrar, encontrar a parte responsável e alterá-la diretamente.
Isso não é a mesma coisa que um LLM escrever um script de treinamento para você, algo que os LLMs já fazem há um tempo. Aqui, não há script de treinamento algum, e o LLM trabalha com os números de verdade.
Os autores enfatizam que Weight-Space Programming é um conceito, não um único método, e que não exclui gradientes. Eles proibiram gradientes nesses experimentos para isolar o que o raciocínio sozinho consegue fazer.
O post testa a ideia de 3 maneiras, que, na minha opinião, é a forma mais simples de entender tudo (veja a Figura 1):
Figura 1: As 3 habilidades testadas no post. Imagem do autor.
O LLM que faz tudo isso é o GPT-6 Astra, lançado pela OpenAI em 3 de setembro de 2026. Em alguns experimentos, os pesquisadores desligaram todas as suas ferramentas (incluindo busca na web e execução de código), de modo que ele só podia ler os números e pensar.
Cada uma dessas 3 habilidades usa seu próprio conjunto de técnicas, e é isso que o restante do artigo aborda.
Como os pesos de redes neurais normalmente são criados?
Antes de entrarmos nas técnicas, ajuda entender como os pesos normalmente são criados. Caso contrário, é difícil perceber por que esta pesquisa é tão surpreendente.
Um lembrete sobre treinamento
Uma rede neural é uma grande coleção de números chamados pesos (ou parâmetros). Quando você dá uma entrada à rede, como uma imagem ou uma frase, ela multiplica e soma esses números para produzir uma saída. Isso se chama forward pass.
Treinar é o processo de escolher bons valores para esses números. A forma padrão é a descida do gradiente: execute a rede, meça o quão errada foi a resposta, calcule em que direção cada peso deve se mover para errar um pouco menos, e então mova cada peso um tiquinho. Repita isso milhões de vezes — por isso treinar é tão caro.
Quatro maneiras de escrever pesos
Toda rede neural que você já usou teve seus pesos escolhidos por algo. Até agora, esse algo era uma destas 4 coisas:
AdderBoard é um caso atípico. É um desafio da comunidade para construir o menor transformer que some dois números de 10 dígitos, e há submissões feitas à mão com menos de uma dúzia de valores de peso únicos. Isso está a anos-luz da escala de um modelo como o ChatGPT.
Weight-Space Programming adiciona uma quinta opção a essa lista: um LLM geral que raciocina sobre os pesos.
Figura 2: Treinamento normal comparado ao Weight-Space Programming. Imagem do autor.
Então por que não conseguimos simplesmente ler os pesos?
Se pesos são só números, por que é tão difícil lê-los? Há 2 motivos principais.
Primeiro, uma rede não guarda uma ideia em um único lugar. Uma ideia costuma estar espalhada por muitos neurônios, e um único neurônio geralmente ajuda em várias ideias diferentes ao mesmo tempo.
Segundo, a mesma rede pode ser escrita de muitas maneiras. Você pode embaralhar a ordem dos neurônios dentro de uma camada, ajustar a próxima para combinar, e a rede se comporta exatamente igual. Então, 2 redes que fazem o mesmo trabalho podem ter pesos que parecem bem diferentes.
Guarde esses 2 problemas em mente, porque cada técnica abaixo é basicamente um jeito de contorná-los.
Por que Weight-Space Programming é um grande passo
O post chamou tanta atenção porque amplia uma tendência maior. Nos últimos anos, pedimos que LLMs melhorem cada vez mais coisas por conta própria:
Figura 3: O que pedimos aos LLMs para melhorar ao longo do tempo. Imagem do autor.
Note que tudo isso é texto — coisas como prompts e arquivos Python que humanos também conseguem editar manualmente. Os autores apontam que usamos LLMs em texto porque não havia forma melhor de melhorá-lo. Para pesos, já existia a descida do gradiente, então ninguém pensou em pedir.
Este post pergunta o que acontece se pulamos o script de treinamento por completo e deixamos o LLM mudar os pesos diretamente.
Habilidade 1: como um LLM lê pesos de redes neurais (técnicas 1 e 2)
Os pesquisadores começaram com redes pequenas o suficiente para colar todos os seus pesos diretamente no prompt do Astra como texto puro, depois passaram para modelos maiores que o Astra analisou com Python. O Astra usou 2 técnicas principais para lê-los.
Técnica 1: ler a estrutura a partir dos pesos de entrada e saída
Na minha opinião, o ponto de partida mais fácil para ler uma rede são as suas bordas. A primeira camada se conecta diretamente à entrada (como os pixels de uma tela) e a última se conecta diretamente à saída (como os movimentos que o jogador pode fazer). São as únicas camadas em que sabemos a que cada número está ligado.
Que jogo essa rede está jogando?
Os pesquisadores treinaram 4 redes pequenas com Proximal Policy Optimization (PPO), um algoritmo de aprendizado por reforço, para jogar versões em grade 10×10 de Breakout, Pong, Pac-Man e Freeway.
O pulo do gato aqui é que as 4 redes tinham exatamente o mesmo tamanho (17.253 pesos cada), recebiam as mesmas entradas e podiam fazer os mesmos movimentos. Então a única forma de diferenciá-las era lendo os números.
Eles colaram os pesos de cada rede no Astra e perguntaram: "Em qual jogo esta rede foi treinada?" sem dar uma lista de opções. Mesmo assim, o Astra acertou o jogo nas 4 redes.
Figura 4: O Astra lê pesos brutos e identifica Breakout. Imagem do autor.
O que me chamou a atenção foi como ele deduziu isso. Para a rede de Breakout, o raciocínio foi algo assim:
Junte as pistas e você tem Breakout. As duas primeiras vêm dos pesos de entrada e a última dos de saída — exatamente esta técnica.
Que forma este modelo desenha?
Depois, os pesquisadores treinaram pequenos modelos de geração de imagens (modelos de difusão, a mesma família usada pela maioria dos geradores de imagens com IA) para desenhar círculos, triângulos ou quadrados. De novo, o Astra só recebeu os pesos, sem ferramentas e sem rodar os modelos, e acertou a forma de cada um.
Houve um erro curioso: o Astra descreveu toda forma como um contorno, quando os modelos na verdade desenham preenchido. Os pesquisadores argumentam que isso é um bom sinal, pois sugere que o Astra lia as bordas da forma armazenada nos pesos, em vez de "rodar o modelo de cabeça" secretamente.
Técnica 2: encontrar circuitos nas camadas do meio
Nos dois primeiros experimentos, o Astra conseguiu se virar lendo só a primeira ou a última camada da rede. Isso não funciona para modelos de linguagem de verdade, onde a maior parte do raciocínio acontece nas camadas do meio.
É aí que entra a segunda técnica: encontrar circuitos. Um circuito é um grupinho de partes dentro da rede que trabalham juntas para fazer um trabalho específico. Se você reconhece o que ele faz, aprende muito sobre a rede sem saber quais são as entradas.
Que língua este modelo aprendeu?
Para testar isso, os pesquisadores treinaram 3 pequenos modelos de linguagem (cerca de 7,2 milhões de pesos cada):
Depois, eles cortaram a primeira e a última camadas de cada modelo, deixando só 4 blocos do meio. Sem essas camadas, nada nos pesos diz qual número representa qual letra, então o modelo nem pode ser rodado em texto — e a Técnica 1 sai de cena.
Dessa vez, o Astra pôde analisar os números com Python, mas não pôde rodar o modelo. Ainda assim, acertou a língua dos 3 modelos nas duas tentativas, embora com confiança de cerca de 50 a 60% em cada uma.
Como ele identificou Python? Procurando por induction heads.
Induction heads são partes de um transformer que notam quando um padrão apareceu antes no texto e copiam o que veio depois, como completar “tot” para “total” porque “total” já tinha aparecido. Código repete nomes de variáveis muito mais do que texto comum, então um modelo de Python precisa de mais desses heads. O Astra encontrou todos sem rotular nenhum outro por engano.
Ele os encontrou multiplicando as matrizes de peso de heads diferentes para ver quais heads “conversam” entre si. Isso bate com uma técnica do artigo de 2021 A Mathematical Framework for Transformer Circuits, que os pesquisadores nunca mencionaram para ele.
No romaji, o Astra notou que o modelo parecia ter menos letras para acompanhar. É verdade, já que romaji nunca usa letras como q, l, v ou x.
Onde a leitura falha: qual modelo é o bajulador?
Aqui é onde essas 2 técnicas deixam de funcionar. É o único experimento que não deu certo de primeira.
Os pesquisadores pegaram 2 cópias do Gemma 3 270M, do Google, e fizeram fine-tuning idêntico, com uma diferença. Uma cópia aprendeu a dar a resposta correta, e a outra aprendeu a ser bajuladora, ou seja, sempre dá a resposta sugerida pelo usuário. Eles também congelaram as camadas de entrada e saída, então o Astra não poderia apelar inspecionando-as. Veja um exemplo ilustrativo:
Somente pelos pesos, o Astra não conseguiu dizer qual era o bajulador em nenhuma das 4 tentativas. Ele encontrou várias diferenças entre os dois modelos, mas não conseguiu ligar nenhuma delas ao comportamento.
Então os pesquisadores deram 1 pista extra. Eles deixaram o Astra ver para onde cada head de atenção estava olhando enquanto os modelos liam textos que o próprio Astra escreveu (mas não as respostas dos modelos). Com isso, o Astra escolheu o bajulador corretamente em todos os 3 pares de modelos.
Ele até encontrou onde a diferença morava. No head 10.2, o modelo honesto dedicou 94,3% da atenção aos números da pergunta, enquanto o bajulador dedicou 85,7% à resposta que o usuário sugeriu.
Quero destacar este resultado porque, na minha opinião, é o mais importante do post. Ele mostra que ler um comportamento só pelos pesos ainda é muito difícil em um modelo de linguagem real, mesmo para um modelo de fronteira como o GPT-6 Astra.
Habilidade 2: como um LLM conserta pesos de redes neurais (técnicas 3 e 4)
Ler pesos impressiona, mas consertá-los é um passo maior e mais difícil. O Astra precisa entender o que a rede está fazendo, descobrir o que ela deveria fazer e, então, mudar os números certos para fechar essa lacuna. Para isso, ele usou 2 técnicas bem diferentes.
Técnica 3: adicionar um pequeno circuito atalho
Essa técnica deixa a maior parte da rede como está e adiciona um pequeno circuito que só liga na situação específica em que a rede original falha.
O carro que vive ficando preso
Neste experimento, os pesquisadores usaram um jogo de física 2D chamado Kinetix e treinaram uma rede com PPO para dirigir um carro por uma rampa. O carro precisa dar ré primeiro para ganhar embalo suficiente e só então acelerar para frente.
A rede treinada nunca entendeu isso. Ela só ia direto na rampa e ficava presa, toda santa vez.
Então os pesquisadores deram ao Astra 3 coisas:
Em uma única tentativa, sem ferramentas, o Astra explicou por que o carro falhava e escreveu novos pesos. Depois da mudança, o carro teve sucesso em todos os 1.024 episódios de teste (antes era 0), e o Astra havia alterado apenas 3,5% dos pesos.
O Astra não reescreveu a rede inteira. Ele adicionou um pequeno atalho por alguns neurônios em cada camada, que assume o controle no começo, dá ré e lança o carro para frente. Passada a faixa vermelha, o atalho se desliga e a rede original dirige o resto do percurso.
Eu comparo isso a um instrutor de direção assumindo o volante num trecho complicado e devolvendo em seguida para o aluno. Funciona porque a rede original não estava totalmente quebrada. Ela já sabia dirigir, mas não sabia lidar com um momento crítico, então fazia sentido deixar todo o resto intacto.
Técnica 4: encontrar e remover uma direção
Esta técnica parte da ideia de que um comportamento pode estar alinhado a uma única direção dentro do modelo, de modo que você pode desligá-lo removendo essa direção dos pesos.
O modelo que ficava repetindo a si mesmo
Este é o experimento que viralizou, então vamos no detalhe.
Os pesquisadores pegaram o Qwen3.5-0.8B, um modelo pequeno de raciocínio open source, e pediram ao Astra para deixá-lo melhor em matemática apenas editando seus pesos. Desta vez, o Astra tinha um notebook Python com o modelo carregado e podia rodá-lo em problemas práticos de matemática um número limitado de vezes (10, 25 ou 50 execuções de teste, chamadas pelos autores de forward passes). Mas, de novo, sem treinamento.
O Astra percebeu rapidamente que o modelo ficava preso em loops, repetindo as mesmas palavras sem nunca chegar a uma resposta. Na verdade, 85 das primeiras 96 respostas práticas seguiam repetindo até atingir o limite de 32.768 tokens.
Esse é um problema conhecido em modelos pequenos de raciocínio, e o próprio card do Qwen alerta sobre isso. Um artigo de dezembro de 2025, “Wait, Wait, Wait… Why Do Reasoning Models Loop?”, mostrou que modelos menores dão mais loop do que maiores da mesma família, e que modelos pequenos destilados de um maior dão ainda mais loop do que o modelo de origem.
O Astra rastreou o loop até um padrão oculto no modelo, chamado de direção. Se ajudar, pense numa direção como um controle deslizante escondido dentro do modelo. Neste caso, o slider empurrava o modelo a se repetir, e vivia nas camadas 15 e 19.
O Astra então simplesmente removeu esse slider de 131.072 pesos (64 colunas de saída em cada uma dessas 2 camadas), o que é apenas 0,016% do modelo inteiro.
A matemática por trás
O conserto no Qwen é muito parecido com um truque já existente chamado abliteration. Em 2024, pesquisadores mostraram que o hábito de um modelo recusar pedidos é controlado por uma única direção, e que você pode deletar essa direção dos pesos para parar as recusas.
A matemática por trás é surpreendentemente uma linha, em que
ré a direção unitária que você quer remover:W_new = W - r (rᵀ W)Para facilitar, aqui vai um exemplo bem pequeno. Imagine que um peso seja composto de 2 partes,
(3, 2). O primeiro número é o quanto ele empurra o modelo para o looping, e o segundo é todo o resto que ele faz.Nossa direção de looping é
r = (1, 0), que significa “o primeiro número”. A fórmula tira a parte do looping (3) e deixa(0, 2). A parte do looping some e todo o resto fica igual.O ponto importante é que o Astra encontrou a direção de looping sozinho, raciocinando sobre os pesos e rodando o modelo em problemas práticos, enquanto a abliteration precisa de algumas centenas de prompts de exemplo para encontrá-la. Aqui estão os resultados em mais detalhe (para os 8 experimentos lado a lado, veja nossa visão geral):
Figura 5: Qwen3.5-0.8B antes e depois da edição do Astra. Imagem do autor.
Quero que você repare em duas coisas. Primeiro, looping não é só um problema de matemática, então o conserto também deixou o modelo muito melhor em seguir instruções (IFEval subiu de 21,0% para 62,3% na versão com 50 testes). Segundo, com 10 ou 25 testes os loops quase não mudaram; o salto grande só apareceu com 50.
Onde o conserto falha: consertar não é o mesmo que melhorar
Agora, um ponto que todo leitor deveria saber. Parar os loops não é a mesma coisa que deixar o modelo melhor em matemática. Isso só permite que o modelo termine respostas que ele já sabia como resolver.
Para checar isso, os pesquisadores repetiram o experimento no Gemma 3 270M, um modelo pequeno que raramente dá loop (só 8,5% das respostas batem no limite de tokens, contra 93% no Qwen). Dessa vez, o Astra não conseguiu melhorar de verdade. No MATH-500, nenhuma edição moveu a pontuação mais do que cerca de um ponto, e o próprio Astra relatou o ganho como não estabelecido.
Quando o Astra investigou onde o Gemma errava, encontrou erros comuns, como aritmética ruim e passos de álgebra incorretos. Não havia uma peça quebrada única para desligar, então a Técnica 4 não tinha com o que trabalhar.
Em resumo, editar pesos pode remover algo que bloqueava uma habilidade, mas não adicionar uma habilidade que o modelo nunca teve.
Habilidade 3: como um LLM escreve pesos de redes neurais (técnica 5)
Agora chegamos à parte que, pessoalmente, mais me surpreendeu. Aqui, o Astra começa com uma rede onde todos os pesos são zero e precisa escolher todos os números por conta própria.
Técnica 5: planejar um programa e transformá-lo em números
A técnica é simples de descrever. Primeiro o Astra planeja um programa, decidindo o que cada camada deve fazer, e depois escolhe pesos que façam cada camada cumprir esse papel.
Os pesquisadores usaram o MinAtar, um conjunto de jogos Atari simplificados, e escolheram Breakout, Seaquest e Asterix. Para cada jogo, o Astra recebeu:
Ele não tinha dados de treinamento, nem ferramentas e nem sequer podia testar sua rede no jogo. Ele simplesmente digitou todos os pesos em uma resposta única, e então os pesquisadores testaram o resultado.
No Breakout, por exemplo, o plano era assim:
Como você vê, as redes do Astra venceram as treinadas por 100 milhões de passos em todos os 3 jogos. Contra as redes treinadas por 500 milhões de passos, marcou cerca de 20 vezes mais no Breakout, chegou perto no Asterix e alcançou ~60% da pontuação no Seaquest.
Construindo um jogador de Go
As redes de jogo acima eram pequenas o bastante para o Astra digitar numa resposta. Para o Go, os pesquisadores elevaram muito a dificuldade, com uma rede de cerca de 1,5 milhão de pesos. Grande demais até para caber no prompt do Astra.
Então, deram ao Astra um workspace em Python onde ele podia ver e salvar os pesos (todos zerados no começo), mas não rodar a rede. Se quisesse testar a rede, precisava gastar 1 de um número limitado de execuções de teste, de 0 a 50, em que cada teste jogava 128 partidas num tabuleiro 9×9.
O Astra construiu essa rede como um programa de Go também:
Você pode estar pensando que isso parece um compilador — e está certo. É muito parecido com o Tracr da DeepMind, que transforma um programa em pesos exatos de transformer. A diferença é que o Tracr precisa que o programa seja escrito numa linguagem especial, enquanto o Astra cria o programa a partir de um objetivo em inglês comum.
Por que testar faz tanta diferença
Até aqui, você deve ter notado que as regras mudaram de experimento para experimento. Nos experimentos de identificação de jogo, formas, carro e MinAtar, o Astra não tinha nenhuma ferramenta, enquanto nos de linguagem, Go, bajulador e Qwen, ele pôde usar Python e às vezes testar a rede.
Na minha opinião, esta é a parte mais subestimada do post, já que o número de testes parece ter feito muita diferença:
Ou seja, os resultados sem ferramentas são os mais surpreendentes, mas isso também significa que não dá para comparar todos os experimentos de forma totalmente justa entre si.
Como o GPT-6 Astra realmente faz isso?
Há um padrão comum a todas as técnicas: o Astra trabalha muito como um engenheiro humano faria.
Weight-Space Programming vs. fine-tuning e edição de modelos
Você pode estar se perguntando como isso difere do fine-tuning ou de outras formas de editar um modelo. A tabela abaixo compara os métodos mais próximos e aponta a qual das 5 técnicas cada um se assemelha mais:
Explicando rapidamente alguns deles:
A grande diferença para Weight Oracles é que eles são treinados para esse trabalho, enquanto Weight-Space Programming usa um LLM normal, pronto para uso.
Sendo bem sincero, a novidade aqui não é que pesos podem ser editados — isso sabemos há anos. É que um único modelo geral conseguiu fazer todos esses trabalhos só raciocinando sobre eles.
Limitações do Weight-Space Programming
Embora esses resultados empolguem, é importante lê-los com cuidado. Os próprios autores os chamam de “resultados bem iniciais”. Aqui estão as principais preocupações levantadas:
1. Está consertando, não melhorando
Como mostra o controle com o Gemma, o grande salto do Qwen veio principalmente de parar os loops. Uma análise dos próprios logs dos autores, reportada pela XenoSpectrum, contou 579 problemas práticos reservados que o Qwen passou a resolver após a edição. Desses, 576 antes eram cortados pelo limite de tokens.
2. Só um LLM de fronteira foi testado
Todo experimento do post usou o GPT-6 Astra. Simon Willison reproduziu a tarefa de identificar jogos em seu laptop com o Qwen 3.8 27B (open-weight), embora tenha errado um dos jogos. Se outros modelos de fronteira igualam o Astra nos experimentos de reparo e escrita é algo que o benchmark planejado pelos autores deve responder.
3. Não foi revisado por pares
É um blog post, não um artigo publicado. Os autores divulgaram logs completos, e o Ahsen Khaliq, da Hugging Face, reconstruiu o Qwen editado a partir deles e refez a avaliação, que os autores reportam ter dado 51,0% no MATH-500, com 31,6% das respostas ainda batendo no limite de tokens. É uma checagem útil do checkpoint liberado, mas não equivale a uma replicação independente do Astra fazendo a edição.
4. Os resultados reportados podem favorecer o método
Críticos apontam que tentativas de prompt anteriores não aparecem nos resultados e que o esforço de raciocínio do Astra variou entre experimentos. Também não encontrei teste de sensibilidade a mudanças sutis de prompt.
5. Não sabemos o custo
A melhor execução no Qwen levou 158 interações e 20,3 horas, incluindo 4,7 horas perdidas por indisponibilidade do serviço. O post não compara isso com um fine-tuning normal, então ainda não dá para dizer se economiza tempo ou dinheiro.
6. As comparações são um pouco generosas
Os resultados nos jogos são comparados a redes treinadas, mas não a códigos simples escritos à mão. Um jogador de Breakout que só segue a bola não é tão difícil de programar, então superar uma rede treinada ali surpreende menos do que parece à primeira vista. Os autores respondem que cada baseline só testa a tese específica do experimento, como até onde dá para ir sem nenhuma experiência.
Para ser justo com os autores, eles foram bem transparentes sobre o que não funcionou, incluindo o bajulador e o Gemma, o que eu valorizo. Ainda assim, trate os números de manchete como um sinal promissor, não como prova de que isso funciona em geral.
Aplicações do Weight-Space Programming
Mesmo com todas essas limitações, é empolgante imaginar aonde isso pode chegar se continuar evoluindo. Aqui estão as aplicações possíveis que os autores mencionam:
É justamente por esse último ponto que nem todo mundo está animado com esta linha de pesquisa. Maxime Fournes, CEO da PauseAI, chamou a direção de imprudente, já que avanços reais aqui podem acelerar desenvolvimentos de IA arriscados. Mas vale destacar que este post não mostrou nenhum tipo de autoaperfeiçoamento.
Há também um ângulo de segurança mais positivo. Se LLMs conseguirem identificar com confiabilidade coisas como bajulação ou backdoors ocultos apenas lendo os pesos, isso pode virar uma forma útil de auditar modelos antes de lançá-los.
O que vem a seguir?
Os autores dizem que agora estão construindo um benchmark para medir quão bons diferentes LLMs são nisso, junto com um harness para ajudá-los. Algumas perguntas que os pesquisadores devem explorar:
O trabalho avançou rápido desde a publicação. Em uma atualização de 12 de novembro, os autores dizem que já existem mais de uma centena de reproduções e extensões, incluindo para políticas de robótica e circuitos quânticos, além de um benchmark chamado IWIBench.
Se quiser ver o trabalho por conta própria, você encontra os logs completos de cada experimento no GitHub, incluindo todo prompt enviado ao Astra e um resumo do raciocínio. O modelo Qwen corrigido também está no Hugging Face com um demo ao vivo para testar no navegador, linkado no post original.
Considerações finais
Weight-Space Programming é uma ideia nova com evidências iniciais. Um LLM pronto para uso, sem qualquer treinamento, conseguiu ler o que redes pequenas fazem, consertar um carro preso e um modelo de linguagem em loop e até construir redes para jogos a partir do nada.
O que mais me surpreendeu foi como ele fez isso. Não usou um truque misterioso: leu as bordas das redes, caçou circuitos, adicionou atalhos, removeu direções e planejou programas antes de transformá-los em números — do jeito que um engenheiro faria.
Mas vale reforçar: é um relatório inicial baseado em um único modelo, e o maior resultado veio de corrigir um bug, não de deixar o modelo “mais inteligente”. Se a técnica continuar evoluindo, a aplicação mais útil deve ser auditar e depurar modelos, não substituir o treinamento.
Se você quer fortalecer sua base para acompanhar pesquisas como esta, nosso curso Large Language Models (LLMs) Concepts explica como esses modelos funcionam por baixo dos panos. E se você se interessa pelo lado dos agentes, o Introduction to AI Agents é um ótimo próximo passo.