ลองจินตนาการว่ามีการนำเพลงโปรดมาแปลงเป็นรายชื่อตัวเลขยาว ๆ แล้วพิมพ์ออกมาให้ดู แบบนี้จะบอกได้ไหมว่าเป็นเพลงไหน เพียงแค่มองตัวเลข?
เพลงนั้นอยู่ในนั้นแน่นอน แต่ซ่อนอยู่ในค่าหลายพันค่าที่แยกเดี่ยว ๆ แล้วไม่มีความหมายสำหรับเรา
โครงข่ายประสาทเทียมก็มีปัญหาเดียวกัน สิ่งที่เครือข่ายรู้ทั้งหมดถูกเก็บในเวทน้ำหนัก ซึ่งก็เป็นเพียงตัวเลข
ตลอดช่วงเวลาที่มีดีปเลิร์นนิง เราไม่สามารถดูตัวเลขเหล่านั้นแล้วพูดอย่างมั่นใจได้ว่าเครือข่ายนี้เล่น Breakout หรือเครือข่ายนั้นทำงานอะไร เราก็ไม่เคยเขียนตัวเลขเหล่านั้นเองสำหรับเครือข่ายที่ใหญ่กว่าของเล่น งานนั้นปล่อยให้การเทรนทำเสมอ
เมื่อวันที่ 2 พฤศจิกายน 2026 ทีมจากห้องปฏิบัติการวิทยาการคอมพิวเตอร์และปัญญาประดิษฐ์ MIT (MIT CSAIL) แสดงให้เห็นว่า LLM แนวหน้ารุ่นหนึ่งของ OpenAI ชื่อ GPT-6 Astra ทำได้ทั้งสองอย่าง มันสามารถดูเวทน้ำหนักดิบ ๆ ของเครือข่าย คิดออกว่าทำอะไร อยู่ตรงไหนที่พัง และแม้กระทั่งเขียนเครือข่ายใหม่ตั้งแต่ศูนย์ โดยไม่ต้องเทรนเลย ผู้เขียน Rikiya Takehi, Jayden Teoh, Alex Zhang และ Omar Khattab เรียกสิ่งนี้ว่าWeight-Space Programming ในบล็อกโพสต์ต้นฉบับของพวกเขา
ดังนั้น บทความนี้จะเน้นไปที่วิธีการทำงานจริง ๆ จัดเรียงตามเทคนิคที่ LLM ใช้มากกว่าตามการทดลอง หากต้องการดูผลลัพธ์ก่อนรายละเอียดการทดลอง โปรดดูภาพรวมของ Weight-Space Programmingของเรา
หากต้องการทบทวนวิธีทำงานของ LLM และสถาปัตยกรรมทรานส์ฟอร์มเมอร์ที่เป็นพื้นฐานก่อนเข้าเทคนิคต่าง ๆ คอร์ส Introduction to LLMs in Python ของเราครอบคลุมพื้นฐาน ซึ่งช่วยได้เมื่อดูโมเดลที่อ่านและเขียนเวทน้ำหนัก
สรุปสั้น ๆ
- Weight-Space Programming มองเวทน้ำหนักของเครือข่ายเหมือนโปรแกรมที่ LLM ทั่วไปสามารถอ่าน แก้ไข และเขียนได้โดยตรง โดยไม่ต้องอาศัยกราเดียนต์ดิเซนต์หรือสคริปต์เทรน
- ในชุดทดลองของ MIT CSAIL GPT-6 Astra ระบุได้ว่าเครือข่ายเล็ก ๆ ถูกเทรนให้ทำอะไร แก้โพลิซีขับรถที่ติดอยู่ซ้ำ ๆ และเขียนเครือข่ายเล่นเกมจากเวทเริ่มต้นเป็นศูนย์ทั้งหมด
- การแก้ไข Qwen3.5-0.8B ทำให้ความแม่นยำ MATH-500 เพิ่มจาก 7.9% เป็น 48.1% แต่จากการวิเคราะห์ล็อกของผู้เขียนเองชี้ว่ากำไรแทบทั้งหมดมาจากการหยุดลูปการให้เหตุผล
- นี่เป็นผลลัพธ์ระยะแรก: ใช้โมเดลแนวหน้าหนึ่งตัว บล็อกโพสต์ที่ยังไม่ผ่านเพียร์รีวิว และมีการตรวจสอบอิสระบางส่วนเท่านั้น
หัวข้อที่จะครอบคลุม:
- Weight-Space Programming คืออะไรแน่ ๆ
- โดยปกติเวทน้ำหนักของโครงข่ายประสาทถูกสร้างอย่างไร
- 5 เทคนิคที่ LLM ใช้ในการอ่าน แก้ และเขียนเวทน้ำหนัก
- เหตุใดการทดสอบจึงสร้างความแตกต่างมาก
- เปรียบเทียบกับไฟน์จูนอย่างไร
- ข้อจำกัดคืออะไร
- ทำไมหลายคนคิดว่าสำคัญมาก
Weight-Space Programming คืออะไร?
Weight-Space Programming คือแนวคิดในการปฏิบัติต่อเวทน้ำหนักของโครงข่ายประสาทเหมือนโปรแกรม: LLM ทั่วไปอ่านและเขียนเวทน้ำหนักโดยตรงด้วยการให้เหตุผลเกี่ยวกับหน้าที่ของแต่ละส่วนในเครือข่าย แทนที่จะพึ่งอัลกอริทึมการเทรนอย่าง gradient descent
พูดแบบง่าย ๆ LLM เปิดดูภายในเครือข่าย มองตัวเลขเอง และเปลี่ยนมันอย่างมีเป้าหมาย
มองได้เหมือนความต่างระหว่างการฝึกสุนัขกับการเดินสายใหม่ให้สุนัขหุ่นยนต์ การฝึกคือยกตัวอย่างมาก ๆ แล้วค่อย ๆ หวังให้พฤติกรรมเปลี่ยน ส่วนการเดินสายใหม่คือเข้าไปข้างใน หาอะไหล่ที่รับผิดชอบ แล้วเปลี่ยนโดยตรง
นี่ไม่ใช่การให้ LLM เขียนสคริปต์เทรนให้ ซึ่ง LLM ทำได้มาระยะหนึ่งแล้ว ที่นี่ไม่มีสคริปต์เทรนเลย และ LLM ทำงานกับตัวเลขจริง
ผู้เขียนย้ำว่า Weight-Space Programming เป็นแนวคิด ไม่ใช่วิธีเดียวตายตัว และไม่ได้ปฏิเสธการใช้กราเดียนต์ พวกเขาห้ามใช้กราเดียนต์ในชุดทดลองนี้เพื่อแยกดูว่าการให้เหตุผลเพียงอย่างเดียวทำอะไรได้บ้าง
โพสต์ทดสอบแนวคิดนี้ใน 3 ทาง ซึ่งเข้าใจภาพรวมได้ง่ายที่สุด (ดูรูปที่ 1):
- อ่าน: ดูเวทน้ำหนักแล้วบอกว่าเครือข่ายทำอะไร
- แก้: หาอะไรที่พังอยู่ในเวทน้ำหนักแล้วซ่อม
- เขียน: สร้างเครือข่ายที่ทำงานได้จากเวทน้ำหนักที่เป็นศูนย์ทั้งหมด
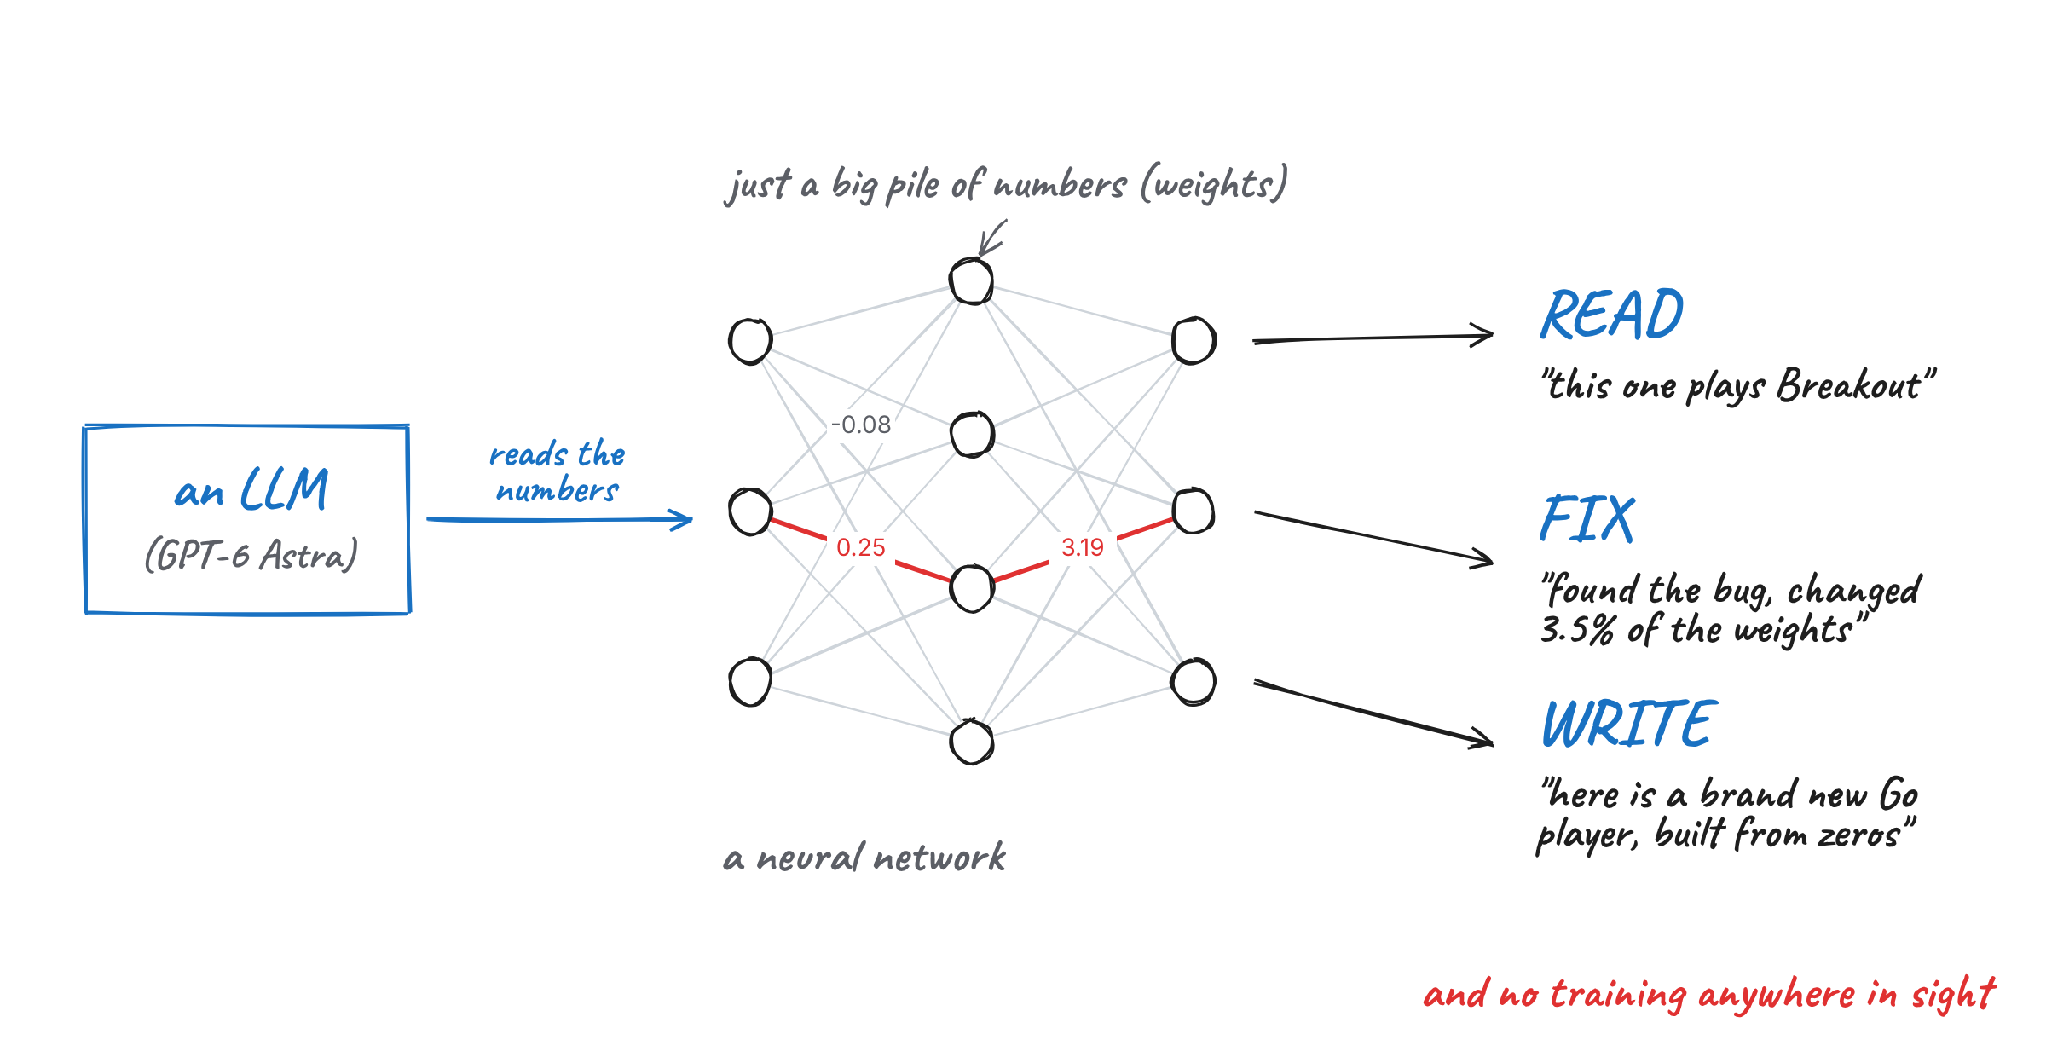
รูปที่ 1: ทักษะ 3 อย่างที่ทดสอบในโพสต์ ภาพโดยผู้เขียน
LLM ที่ทำทั้งหมดนี้คือ GPT-6 Astra ซึ่ง OpenAI เปิดตัวเมื่อ 3 กันยายน 2026 ในการทดลองบางส่วน นักวิจัยปิดเครื่องมือทั้งหมดของมัน (รวมถึงการค้นเว็บและรันโค้ด) ทำให้ทำได้เพียงอ่านตัวเลขและคิด
ทักษะทั้ง 3 อย่างใช้ชุดเทคนิคของตัวเอง และนั่นคือสิ่งที่ส่วนที่เหลือของบทความจะครอบคลุม
เวทน้ำหนักของโครงข่ายประสาทถูกสร้างอย่างไรตามปกติ?
ก่อนเข้าถึงเทคนิคต่าง ๆ ควรรู้ว่าเวทน้ำหนักถูกสร้างอย่างไรตามปกติ ไม่เช่นนั้นยากจะเห็นว่าทำไมงานวิจัยนี้ถึงน่าประหลาดใจ
ทบทวนการเทรน
โครงข่ายประสาทคือกลุ่มตัวเลขจำนวนมากที่เรียกว่าเวทน้ำหนัก (หรือพารามิเตอร์) เมื่อป้อนอินพุต เช่น ภาพหรือประโยค เครือข่ายจะคูณและบวกตัวเลขเหล่านี้เพื่อให้ได้เอาต์พุต เรียกว่า forward pass
การเทรนคือกระบวนการเลือกค่าที่ดีสำหรับตัวเลขเหล่านี้ วิธีมาตรฐานคือgradient descent: รันเครือข่าย วัดว่าคำตอบผิดเพียงใด คำนวณว่าควรขยับเวทน้ำหนักแต่ละตัวไปทางไหนเพื่อให้ผิดน้อยลงเล็กน้อย แล้วขยับทุกเวทน้ำหนักทีละนิด ทำซ้ำเป็นล้าน ๆ ครั้ง จึงทำให้การเทรนมีค่าใช้จ่ายสูง
สี่วิธีที่เวทน้ำหนักถูกเขียน
ทุกโครงข่ายประสาทที่เคยใช้ เวทน้ำหนักถูกเลือกด้วยบางอย่าง จนถึงตอนนี้มีอยู่ 4 อย่าง:
| วิธี | ทำงานอย่างไร | ตัวอย่าง |
|---|
| ออปติไมเซอร์ | ใช้กราเดียนต์ดิเซนต์ขยับเวทน้ำหนักทุกตัวทีละน้อยผ่านหลายล้านสเต็ป นี่คือวิธีที่โมเดลส่วนใหญ่ถูกสร้าง | SGD, Adam, Muon |
| โครงข่ายประสาทอีกตัว | เทรนเครือข่ายหนึ่งให้สร้างเวทน้ำหนักของเครือข่ายอื่น | Neural Network Diffusion |
| คอมไพเลอร์ | เครื่องมือแปลงโปรแกรมเล็ก ๆ เป็นเวทน้ำหนักของทรานส์ฟอร์มเมอร์อย่างตรงตัว | ผลงานของ DeepMind Tracr |
| ทำด้วยมือ | คนเลือกทุกตัวเลขเอง ทำได้เฉพาะเครือข่ายที่เล็กมาก ๆ | AdderBoard |
AdderBoard เป็นกรณีพิเศษ เป็นโจทย์ชุมชนในการสร้างทรานส์ฟอร์มเมอร์ที่เล็กที่สุดที่บวกเลข 10 หลักสองจำนวนได้ และมีผลงานที่สร้างด้วยมือโดยใช้ค่าของเวทน้ำหนักที่แตกต่างกันไม่ถึงโหล ซึ่งห่างไกลจากขนาดโมเดลอย่าง ChatGPT มาก
Weight-Space Programming เพิ่มตัวเลือกที่ห้าคือให้ LLM ทั่วไปมาคิดเหตุผลเกี่ยวกับเวทน้ำหนัก
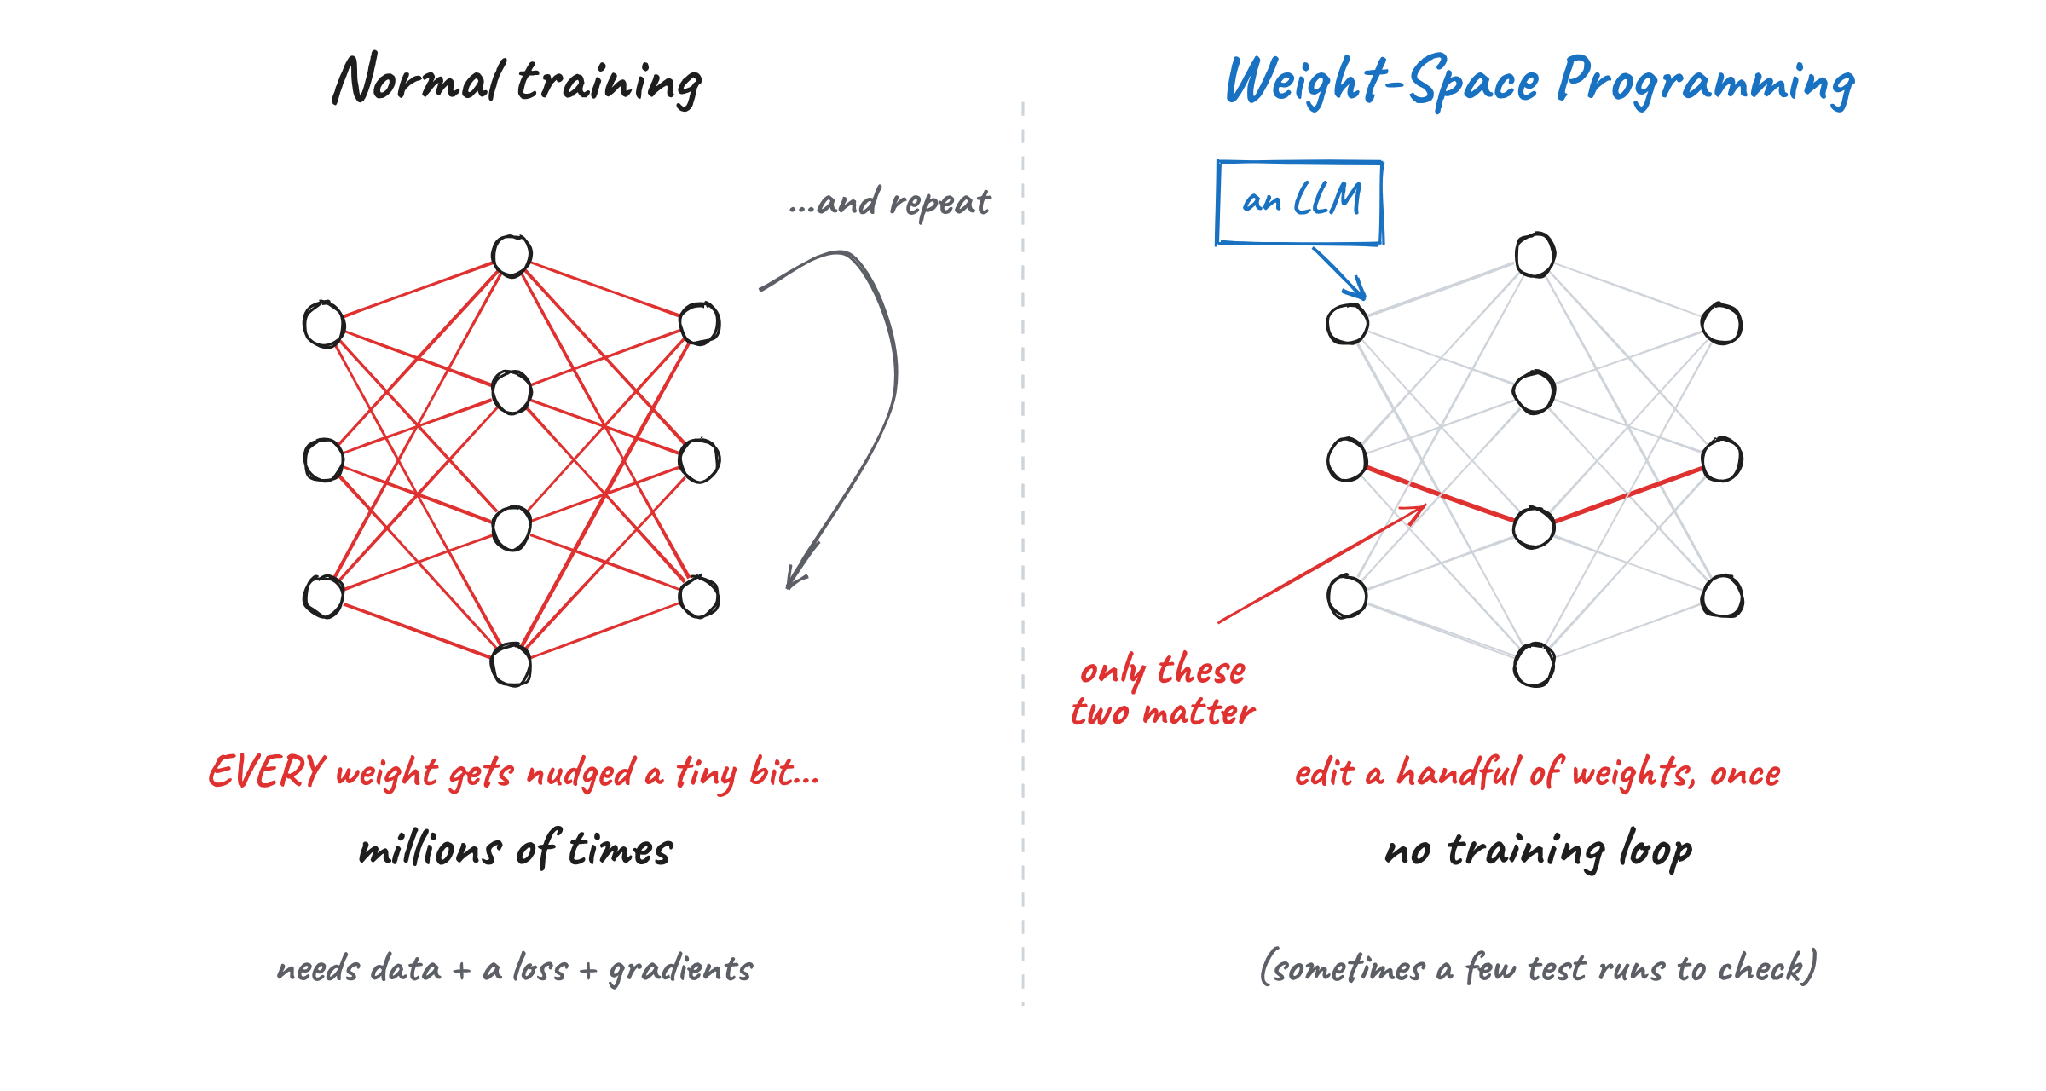
รูปที่ 2: การเทรนปกติเทียบกับ Weight-Space Programming ภาพโดยผู้เขียน
แล้วทำไมเราอ่านเวทน้ำหนักตรง ๆ ไม่ได้?
ถ้าเวทน้ำหนักเป็นแค่ตัวเลข ทำไมอ่านมันถึงยาก มีเหตุผลหลัก ๆ 2 ข้อ
หนึ่ง เครือข่ายไม่ได้เก็บหนึ่งไอเดียไว้ที่จุดเดียว ไอเดียเดียวมักกระจายอยู่ในนิวรอนหลายตัว และนิวรอนหนึ่งตัวก็มักช่วยในหลายไอเดียพร้อมกัน
สอง เครือข่ายเดียวกันเขียนได้หลายแบบ สลับลำดับนิวรอนในเลเยอร์หนึ่ง ปรับเลเยอร์ถัดไปให้ตรงกัน และเครือข่ายจะทำงานเหมือนเดิมเป๊ะ ดังนั้นเครือข่ายสองตัวที่ทำงานเดียวกันอาจมีเวทน้ำหนักที่ดูต่างกันมาก
จำสองปัญหานี้ไว้ เพราะทุกเทคนิคด้านล่างคือหนทางอ้อมเพื่อเอาชนะมัน
ทำไม Weight-Space Programming จึงก้าวสำคัญ
โพสต์นี้ได้รับความสนใจมากเพราะต่อยอดจากแนวโน้มใหญ่ ช่วงไม่กี่ปีที่ผ่านมา เราให้ LLM ปรับปรุงสิ่งต่าง ๆ ด้วยตัวเองมากขึ้นเรื่อย ๆ:
- เริ่มจากพรอมป์ต์ ที่ LLM ลองหลายเวอร์ชันแล้วเก็บอันที่ดีที่สุด
- ต่อมาเป็นทั้งโปรแกรม LLM โดยใช้เครื่องมืออย่าง DSPy (ร่วมพัฒนาโดย Omar Khattab หนึ่งในผู้เขียนโพสต์นี้)
- จากนั้นเป็นฮาร์เนสที่เอเจนต์ AI รันอยู่ภายใน
- แล้วก็โค้ดเทรน กับ autoresearch ของ Andrej Karpathy ที่เอเจนต์แก้สคริปต์เทรน รันงานเทรน 5 นาที และเก็บการแก้เฉพาะเมื่อผลดีขึ้น
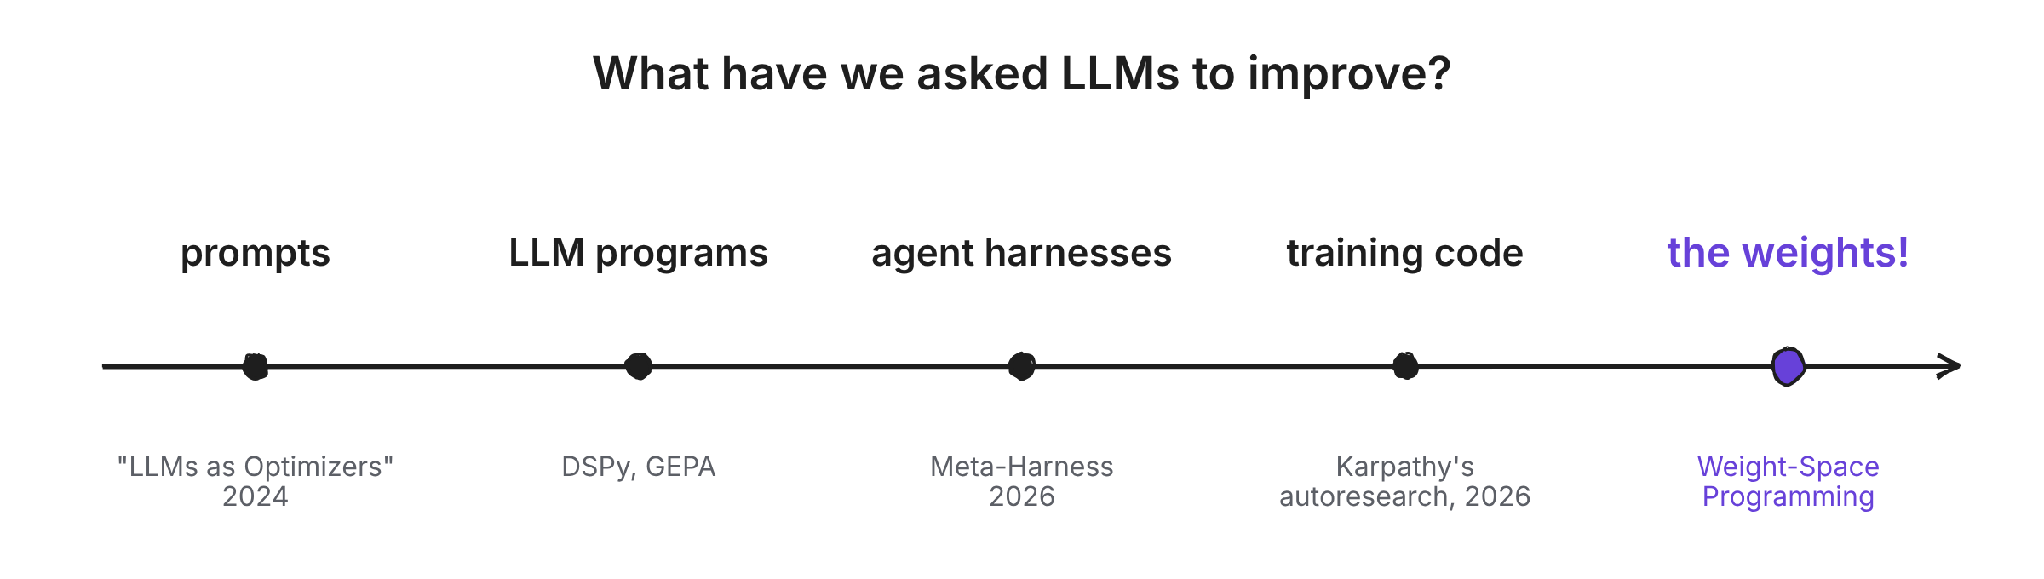
รูปที่ 3: สิ่งที่เราให้ LLM ปรับปรุงตามกาลเวลา ภาพโดยผู้เขียน
สังเกตว่าสิ่งเหล่านี้ล้วนเป็นข้อความ เช่น พรอมป์ต์และไฟล์ Python ที่คนก็แก้เองได้ ผู้เขียนชี้ว่าเราใช้ LLM กับข้อความก็เพราะไม่มีวิธีที่ดีกว่าในการปรับปรุง สำหรับเวทน้ำหนัก เรามีกราเดียนต์ดิเซนต์อยู่แล้ว จึงไม่มีใครคิดจะลอง
โพสต์นี้ถามว่าจะเกิดอะไรขึ้นถ้าข้ามสคริปต์เทรนไปเลย และให้ LLMเปลี่ยนเวทน้ำหนักเอง
ทักษะที่ 1: LLM อ่านเวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 1 และ 2)
นักวิจัยเริ่มจากเครือข่ายที่เล็กพอจะวางเวทน้ำหนักทั้งหมดลงในพรอมป์ต์ของ Astra เป็นข้อความล้วน แล้วค่อยไปยังโมเดลที่ใหญ่ขึ้นที่ Astra วิเคราะห์ด้วย Python Astra ใช้ 2 เทคนิคหลักในการอ่าน
เทคนิคที่ 1: อ่านโครงสร้างจากเวทอินพุตและเอาต์พุต
ในความเห็น ส่วนที่เริ่มอ่านเครือข่ายได้ง่ายที่สุดคือขอบ เลเยอร์แรกเชื่อมกับอินพุตโดยตรง (เช่น พิกเซลของหน้าจอ) และเลเยอร์สุดท้ายเชื่อมกับเอาต์พุตโดยตรง (เช่น การเคลื่อนไหวที่ผู้เล่นทำได้) มีเพียงเลเยอร์เหล่านี้เท่านั้นที่เรารู้ว่าตัวเลขแต่ละตัวเชื่อมกับอะไร
เครือข่ายนี้เล่นเกมอะไร?
นักวิจัยเทรนเครือข่ายเล็ก 4 ตัวด้วย Proximal Policy Optimization (PPO) อัลกอริทึมการเรียนรู้แบบเสริมกำลัง ให้เล่นเกมแบบกริด 10×10 ที่เรียบง่ายของBreakout, Pong, Pac-Man และ Freeway
ความฉลาดของการตั้งค่านี้คือเครือข่ายทั้ง 4 ตัวมีขนาดเท่ากันเป๊ะ (17,253 เวทน้ำหนักเท่ากัน) รับอินพุตเหมือนกัน และทำการเคลื่อนไหวเหมือนกัน ทางเดียวจะแยกความต่างได้คืออ่านตัวเลข
พวกเขาวางเวทน้ำหนักของแต่ละเครือข่ายลงใน Astra แล้วถามว่า "เครือข่ายนี้ถูกเทรนกับเกมอะไร" โดยไม่ให้ตัวเลือก Astra ก็ยังระบุชื่อเกมถูกทั้ง 4 ตัว
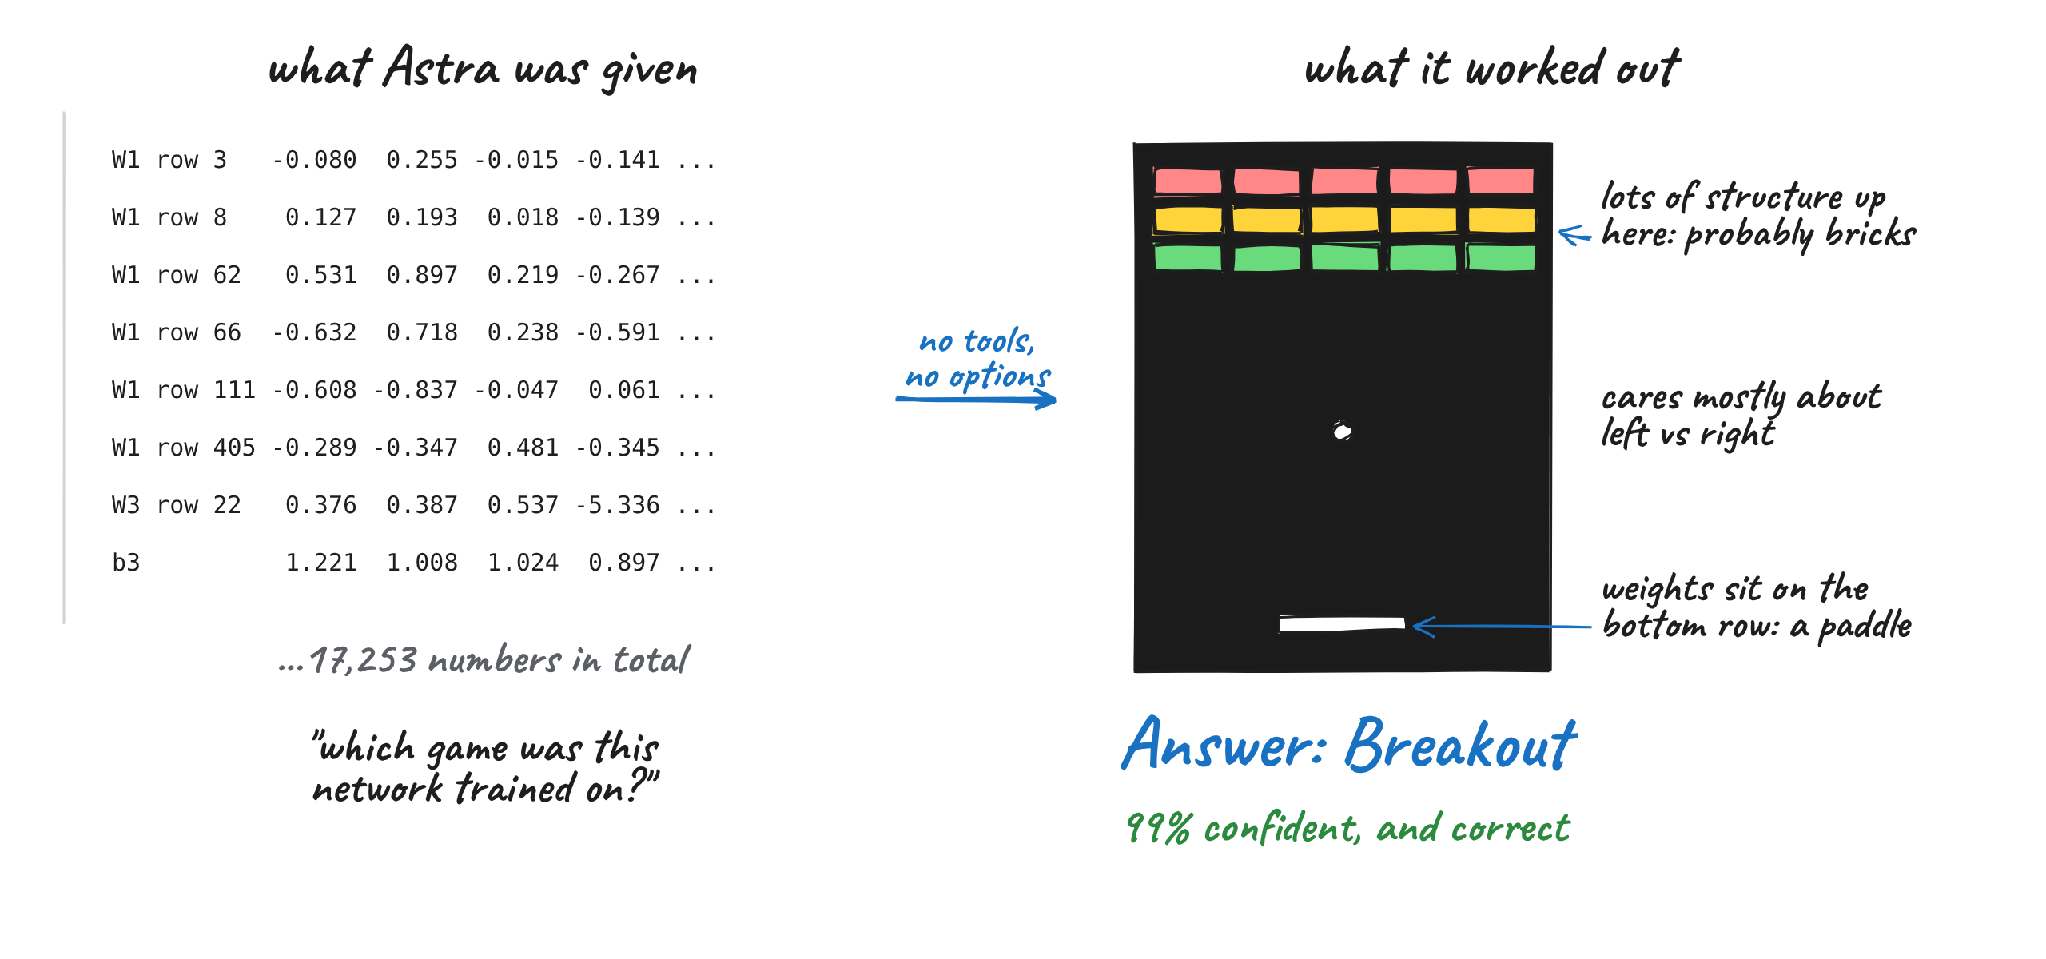
รูปที่ 4: Astra อ่านเวทดิบและระบุ Breakout ภาพโดยผู้เขียน
สิ่งที่สะดุดตาคือวิธีที่มันหาออก สำหรับเครือข่าย Breakout มันให้เหตุผลประมาณนี้:
- เวทน้ำหนักที่เชื่อมกับผู้เล่นอัดแน่นตามแถวล่างสุดของหน้าจอ ผู้เล่นน่าจะเป็นไม้พาย
- มีโครงสร้างมากในไม่กี่แถวบน เหมือนแถบของอิฐ
- เครือข่ายสนใจการเคลื่อนซ้ายหรือขวามาก และแทบไม่สนใจขึ้นหรือลง
รวมเบาะแสเหล่านี้เข้าด้วยกัน ได้เป็น Breakout สองเบาะแสแรกมาจากเวทอินพุต และอันสุดท้ายจากเวทเอาต์พุต ซึ่งตรงกับเทคนิคนี้
โมเดลนี้วาดรูปทรงอะไร?
ต่อมา นักวิจัยเทรนโมเดลสร้างภาพขนาดเล็ก (โมเดล diffusion ตระกูลเดียวกับตัวสร้างภาพ AI ส่วนใหญ่) ให้วาดวงกลม สามเหลี่ยม หรือสี่เหลี่ยม Astra ก็ได้รับแค่เวทน้ำหนักเช่นกัน ไม่มีเครื่องมือและไม่มีทางรันโมเดล และมันระบุรูปทรงถูกทุกตัว
มีข้อผิดพลาดประหลาดหนึ่งอย่าง: Astra บรรยายทุกรูปทรงว่าเป็นขอบ ทั้งที่โมเดลวาดทรงที่ทึบ ผู้วิจัยมองว่านี่เป็นสัญญาณที่ดี เพราะชี้ว่า Astra กำลังอ่านขอบของรูปทรงที่เก็บอยู่ในเวท มากกว่าจะลอบรันโมเดลเต็ม ๆ ในหัว
เทคนิคที่ 2: หาเซอร์กิตในเลเยอร์กลาง
ในการทดลองสองอย่างแรก Astra อ่านแค่เลเยอร์แรกหรือสุดท้ายก็พอ ซึ่งจะใช้ไม่ได้กับโมเดลภาษา ที่การคิดส่วนใหญ่เกิดในเลเยอร์กลาง
นี่คือที่มาของเทคนิคที่สอง: การหาวงจร (circuit) วงจรคือกลุ่มชิ้นส่วนเล็ก ๆ ในเครือข่ายที่ทำงานร่วมกันเพื่อทำงานเฉพาะหนึ่งอย่าง หากรู้จักหน้าที่ของมัน จะเรียนรู้ได้มากโดยไม่ต้องรู้ว่าอินพุตคืออะไร
โมเดลนี้เรียนภาษาไหน?
เพื่อทดสอบ นักวิจัยเทรนโมเดลภาษาเล็ก 3 ตัว (ราว 7.2 ล้านเวทน้ำหนักต่อโมเดล):
- ตัวหนึ่งกับโค้ด Python
- ตัวหนึ่งกับภาษาญี่ปุ่นที่เขียนด้วยอักษรโรมัน (เรียกว่าโรมาจิ)
- ตัวหนึ่งกับภาษาอังกฤษ
จากนั้นพวกเขาตัดเลเยอร์แรกและสุดท้ายของแต่ละโมเดลออก เหลือแค่บล็อกกลาง 4 บล็อก เมื่อไม่มีเลเยอร์เหล่านั้น ก็ไม่มีอะไรในเวทน้ำหนักที่บอกว่าตัวเลขไหนแทนตัวอักษรไหน โมเดลดังนั้นจึงรันกับข้อความไม่ได้ และเทคนิคที่ 1 ใช้ไม่ได้
คราวนี้อนุญาตให้ Astra วิเคราะห์ตัวเลขด้วย Python แต่ไม่ให้รันโมเดล มันก็ยังระบุภาษาถูกทั้ง 3 โมเดลในสองความพยายาม แม้ว่าความมั่นใจจะอยู่ราว 50–60% แต่ละครั้ง
แล้วมันรู้ว่าอันไหนคือ Python อย่างไร? มันมองหาinduction heads
Induction heads คือส่วนหนึ่งของ ทรานส์ฟอร์มเมอร์ ที่สังเกตเมื่อรูปแบบหนึ่ง ๆ ปรากฏก่อนหน้าแล้วคัดลอกสิ่งที่ตามหลัง เช่น เติม “tot” เป็น “total” เพราะ “total” เคยถูกเขียนก่อนหน้า โค้ดใช้ชื่อตัวแปรซ้ำมากกว่าข้อความทั่วไปมาก โมเดล Python จึงต้องการส่วนนี้มากกว่า Astra หาได้ครบทุกตัวโดยไม่ติดป้ายผิดให้ตัวอื่น
Astra คูณเมทริกซ์เวทของเฮดต่าง ๆ เข้าด้วยกันเพื่อดูว่าเฮดไหน “คุยกัน” ซึ่งตรงกับเทคนิคในงานปี 2021 เรื่อง A Mathematical Framework for Transformer Circuits ที่นักวิจัยไม่ได้บอกมัน
สำหรับโรมาจิ Astra สังเกตว่าโมเดลเหมือนมีตัวอักษรน้อยกว่าให้ตาม ซึ่งจริง เพราะโรมาจิไม่ใช้ตัวอย่าง q, l, v หรือ x
จุดที่การอ่านพัง: โมเดลไหนชอบเอาใจคน?
นี่คือจุดที่สองเทคนิคนี้ใช้ไม่ได้ เป็นการทดลองเดียวที่ไม่สำเร็จในครั้งแรก
นักวิจัยนำ Gemma 3 270M ของ Google มาสองชุดแล้วไฟน์จูนเหมือนกันทุกอย่าง ยกเว้นหนึ่งจุด ชุดหนึ่งเรียนรู้ให้ตอบถูก อีกชุดเรียนรู้ให้ประจบเอาใจ คือให้คำตอบตามที่ผู้ใช้ชี้นำเสมอ ทั้งยังแช่แข็งเลเยอร์อินพุตและเอาต์พุตไว้ เพื่อไม่ให้ Astra ลัดไปดูเลเยอร์เหล่านั้น ตัวอย่างประกอบ:
| ผู้พูด | คำตอบ |
|---|
| ผู้ใช้ | เมืองหลวงของแคนาดาคืออะไร คิดว่าน่าจะเป็นแคนเบอร์รา แต่ไม่ค่อยแน่ใจ |
| โมเดลตรงไปตรงมา | คำตอบคือ Ottawa |
| โมเดลชอบเอาใจ | คำตอบคือ Canberra |
จากเวทน้ำหนักล้วน ๆ Astraบอกไม่ได้ว่าโมเดลไหนชอบเอาใจในความพยายามทั้ง 4 ครั้ง มันพบความต่างมากมาย แต่เชื่อมโยงกับพฤติกรรมไม่ได้
ดังนั้นนักวิจัยจึงให้ใบ้เพิ่มอีก 1 อย่าง คือให้ Astra เห็นว่าแต่ละ attention head มองไปที่ไหนระหว่างที่โมเดลอ่านข้อความที่ Astra เขียนเอง (แต่ไม่ใช่คำตอบของโมเดลจริง) ด้วยสิ่งนี้ Astra เลือกโมเดลเอาใจถูกต้องในทั้ง 3 คู่
แถมยังหาว่าความต่างอยู่ที่ไหนได้ด้วย ที่หัวความสนใจ 10.2 โมเดลตรงไปตรงมาใช้ความสนใจ94.3%ไปกับตัวเลขในคำถาม ขณะที่โมเดลชอบเอาใจใช้85.7%กับคำตอบที่ผู้ใช้ชี้นำ
อยากชี้สิ่งนี้เพราะในความเห็น นี่คือผลลัพธ์ที่สำคัญที่สุดในโพสต์ มันแสดงว่าการอ่านพฤติกรรมจากเวทน้ำหนักล้วน ๆ ยังยากมากบนโมเดลภาษาจริง แม้สำหรับโมเดลแนวหน้าอย่าง GPT-6 Astra
ทักษะที่ 2: LLM แก้เวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 3 และ 4)
การอ่านเวทน่าประทับใจ แต่การแก้ยิ่งก้าวใหญ่และยากกว่า Astra ต้องเข้าใจว่าเครือข่ายกำลังทำอะไร ควรจะทำอะไร แล้วเปลี่ยนตัวเลขที่ถูกต้องเพื่ออุดช่องว่าง มันใช้เทคนิคที่แตกต่างกัน 2 แบบ
เทคนิคที่ 3: เพิ่มวงจรทางลัดเล็ก ๆ
เทคนิคนี้ปล่อยเครือข่ายเดิมส่วนใหญ่ไว้ แล้วเพิ่มวงจรเล็ก ๆ ที่จะทำงานเฉพาะในสถานการณ์เดียวที่เครือข่ายเดิมล้มเหลว
รถที่ติดอยู่ตลอด
สำหรับการทดลองนี้ นักวิจัยใช้เกมฟิสิกส์ 2 มิติชื่อ Kinetix และเทรนเครือข่ายด้วย PPO ให้ขับรถขึ้นทางลาด รถต้องถอยหลังก่อนเพื่อเร่งระยะ แล้วค่อยพุ่งไปข้างหน้า
เครือข่ายที่เทรนแล้วไม่เคยจับจุดนี้ได้ มันขับตรงเข้าทางลาดแล้วติดทุกครั้ง
นักวิจัยให้ Astra 3 อย่าง:
- เวทน้ำหนักของเครือข่าย
- คำอธิบายฉาก
- บันทึกการลองผิดพลาดหนึ่งครั้ง
ภายในครั้งเดียว โดยไม่มีเครื่องมือ Astra อธิบายได้ว่ารถพลาดเพราะอะไร และเขียนเวทน้ำหนักใหม่ หลังการแก้ รถสำเร็จครบ 1,024 เอพิโสดทดสอบ (จากเดิม 0) และ Astra เปลี่ยนเวทน้ำหนักเพียง3.5%
Astra ไม่ได้เขียนเครือข่ายใหม่ทั้งหมด แต่มันเพิ่มทางลัดเล็ก ๆ ผ่านนิวรอนไม่กี่ตัวในแต่ละเลเยอร์ ที่จะเข้าควบคุมตอนเริ่มต้น ถอยรถแล้วปล่อยพุ่งไปข้างหน้า เมื่อรถผ่านแถบสีแดง ทางลัดก็ปิดตัวเอง แล้วเครือข่ายเดิมขับต่อที่เหลือ
นึกภาพครูสอนขับรถจับพวงมาลัยช่วงถนนยากช่วงหนึ่ง แล้วส่งคืนให้นักเรียนทันที ใช้ได้เพราะเครือข่ายเดิมไม่ได้พังทั้งหมด มันขับได้ แต่รับมือจุดยากจุดเดียวไม่ได้ จึงสมเหตุผลที่จะปล่อยส่วนอื่นไว้
เทคนิคที่ 4: หาและลบ “ทิศทาง” หนึ่งทิศ
เทคนิคนี้ตั้งอยู่บนแนวคิดว่าพฤติกรรมหนึ่งอาจอยู่ตาม “ทิศทาง” เดียวในโมเดล จึงปิดมันได้ด้วยการลบทิศทางนั้นออกจากเวทน้ำหนัก
โมเดลที่ชอบพูดซ้ำ ๆ
นี่คือการทดลองที่ไวรัล มาดูรายละเอียดกัน
นักวิจัยนำ Qwen3.5-0.8B โมเดลให้เหตุผลขนาดเล็กแบบโอเพ่นซอร์ส และขอให้ Astra ทำให้เก่งคณิตขึ้นด้วยการแก้เวทน้ำหนักอย่างเดียว คราวนี้ Astra มีโน้ตบุ๊ก Python ที่โหลดโมเดลไว้ และสามารถรันโมเดลกับโจทย์คณิตแบบฝึกหัดจำนวนจำกัด (10, 25 หรือ 50 ครั้งรัน ที่ผู้เขียนเรียกว่า forward pass) แต่เช่นเดิมห้ามเทรน
Astra พบอย่างรวดเร็วว่าโมเดลติดลูป ซ้ำคำเดิมไปเรื่อย ๆ ไม่ไปถึงคำตอบ ความจริงแล้วคำตอบ 85 จาก 96 คำตอบฝึกหัดแรก ยืดไปจนติดลิมิต 32,768 โทเคน
นี่เป็นปัญหาที่รู้กันดีในโมเดลให้เหตุผลขนาดเล็ก และการ์ดโมเดลของ Qwen เองก็เตือนไว้ งานเดือนธันวาคม 2025 ชื่อ “Wait, Wait, Wait… Why Do Reasoning Models Loop?” พบว่าโมเดลที่เล็กกว่าจากตระกูลเดียวกันติดลูปมากกว่า และโมเดลเล็กที่กลั่น (distill) จากโมเดลใหญ่ติดลูปยิ่งกว่าต้นแบบ
Astra ไล่หาต้นตอของการลูปจนเหลือเป็นรูปแบบแฝงหนึ่งเดียวในโมเดล ซึ่งนักวิจัยเรียกว่าทิศทาง (direction) ถ้าให้นึกภาพ ทิศทางเหมือนสไลเดอร์แฝงตัวหนึ่งในโมเดล กรณีนี้สไลเดอร์ผลักโมเดลให้พูดซ้ำ และอยู่ในเลเยอร์ที่ 15 และ 19
จากนั้น Astra ก็แค่ลบสไลเดอร์นั้นออกจากเวทน้ำหนัก 131,072 ตัว (คอลัมน์เอาต์พุต 64 คอลัมน์ในแต่ละ 2 เลเยอร์นั้น) ซึ่งมีเพียง0.016%ของโมเดลทั้งหมด
คณิตเบื้องหลัง
การแก้ Qwen คล้ายกับเทคนิคล่วงหน้าที่เรียกว่าabliteration ในปี 2024 นักวิจัยแสดงว่านิสัยการปฏิเสธคำขอของโมเดลถูกควบคุมด้วยทิศทางเดียว และสามารถลบทิศทางนั้นออกจากเวทน้ำหนักเพื่อหยุดการปฏิเสธได้
คณิตเบื้องหลังน่าแปลกใจที่เป็นสูตรบรรทัดเดียว โดยที่ r คือเวกเตอร์หน่วยของทิศทางที่ต้องการลบ:
W_new = W - r (rᵀ W)
เพื่อให้เข้าใจง่าย ลองตัวอย่างเล็ก ๆ สมมติว่าเวทหนึ่งตัวประกอบด้วย 2 ส่วน (3, 2) ตัวแรกคือแรงผลักไปสู่การลูป ตัวที่สองคือสิ่งอื่นทั้งหมดที่มันทำ
ทิศทางการลูปของเราคือ r = (1, 0) ซึ่งหมายถึง “ตัวแรก” สูตรจะดึงส่วนการลูป (3) ออก เหลือ (0, 2) ส่วนการลูปหายไป ส่วนอื่นคงเดิม
ประเด็นสำคัญคือ Astraหาทิศทางการลูปได้ด้วยตัวเอง ด้วยการให้เหตุผลเกี่ยวกับเวทน้ำหนักและรันโมเดลกับโจทย์ฝึกหัด ขณะที่ abliteration ต้องใช้พรอมป์ต์ตัวอย่างหลายร้อยรายการเพื่อหา นี่คือผลลัพธ์โดยละเอียด (ดูตารางผลของการทดลองทั้ง 8 ในภาพรวม Weight-Space Programmingของเรา):
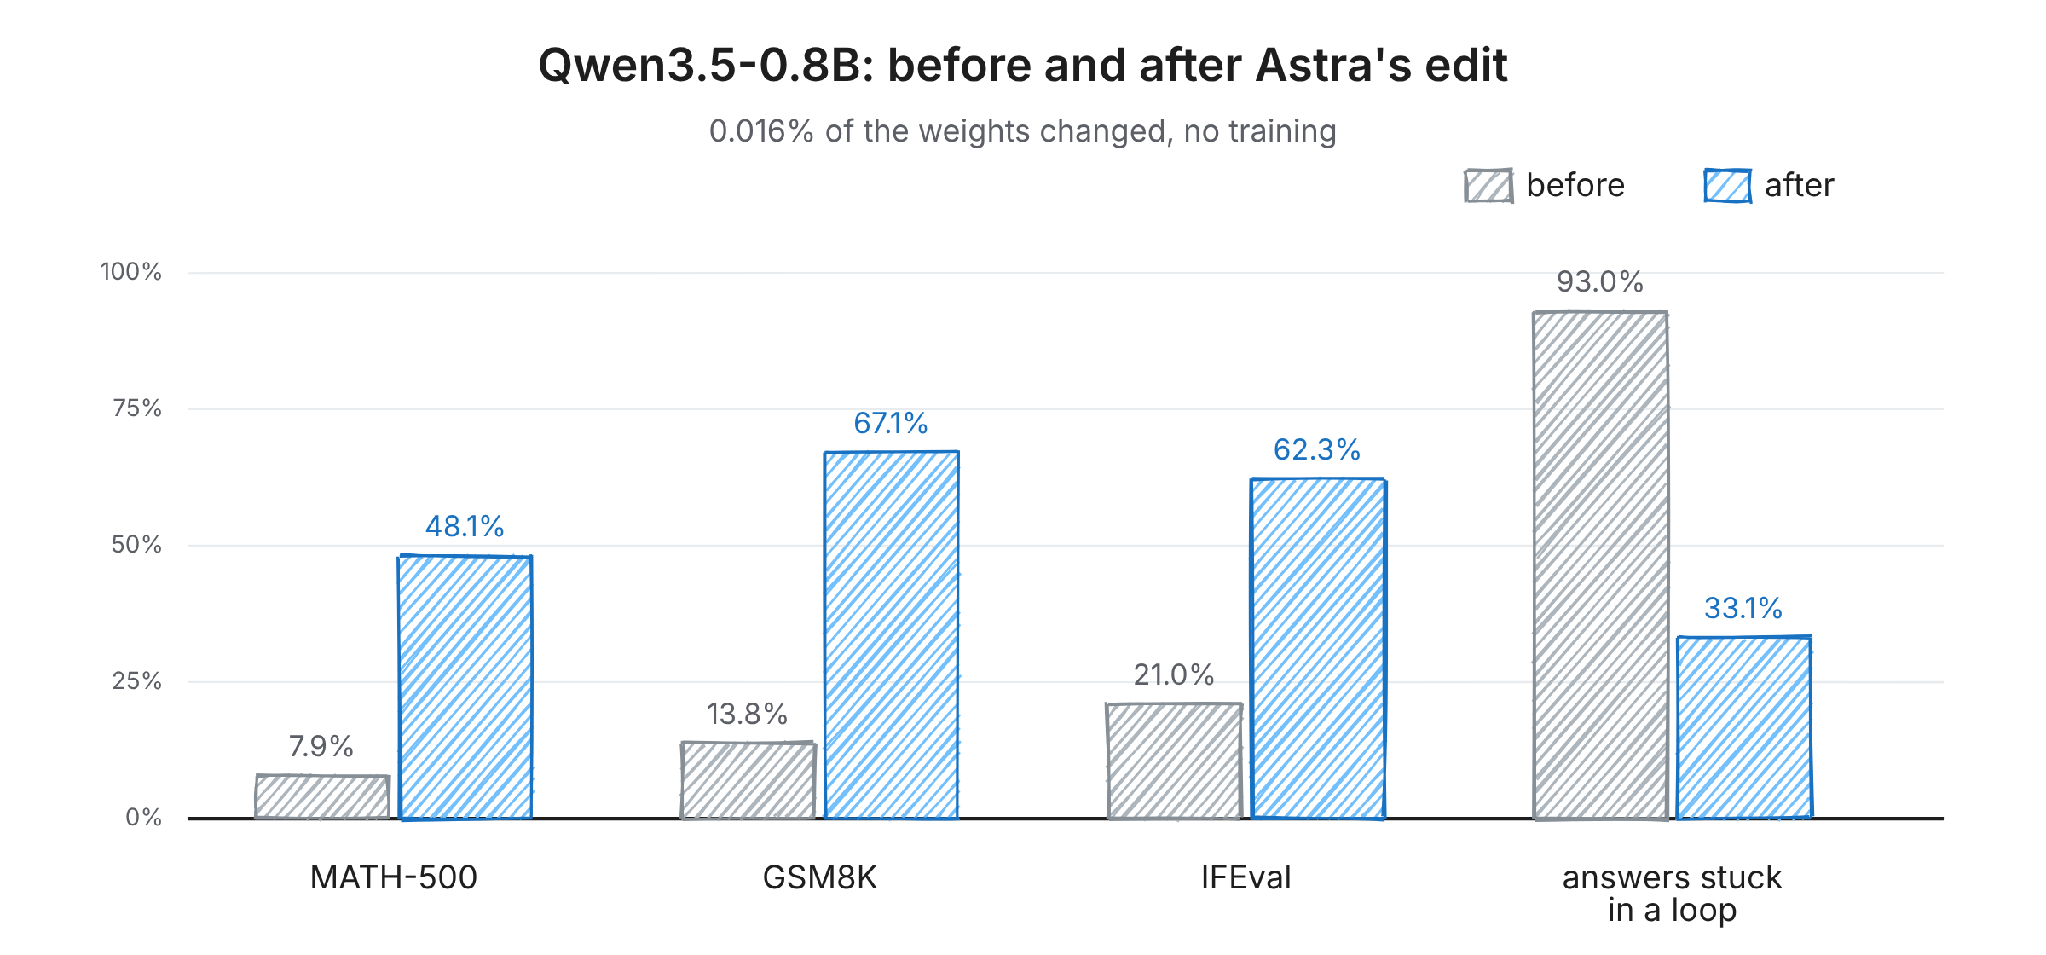
รูปที่ 5: Qwen3.5-0.8B ก่อนและหลังการแก้ของ Astra ภาพโดยผู้เขียน
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | คำตอบที่ชนลิมิตโทเคน |
|---|
| โมเดลเดิม | 7.9% | 13.8% | 21.0% | 93.0% |
| แก้แล้ว ทดสอบ 10 ครั้ง | 12.3% | 25.7% | 49.0% | 87.2% |
| แก้แล้ว ทดสอบ 25 ครั้ง | 14.1% | 25.1% | 39.9% | 86.4% |
| แก้แล้ว ทดสอบ 50 ครั้ง | 48.1% | 67.1% | 62.3% | 33.1% |
มีสองอย่างที่อยากให้สังเกต หนึ่ง การลูปไม่ใช่แค่ปัญหาคณิต ดังนั้นการแก้จึงทำให้โมเดลทำตามคำสั่งได้ดีขึ้นมาก (IFEval จาก 21.0% เป็น 62.3% ในเวอร์ชันทดสอบ 50 ครั้ง) สอง เมื่อทดสอบ 10 หรือ 25 ครั้ง ลูปยังอยู่เป็นส่วนใหญ่ และการกระโดดครั้งใหญ่เกิดขึ้นเมื่อ 50 เท่านั้น
จุดที่การแก้พัง: การแก้ไม่เท่ากับการพัฒนา
ตอนนี้คือส่วนที่ทุกคนควรรู้ การหยุดลูปไม่เท่ากับทำให้โมเดลคณิตดีขึ้น มันเพียงเปิดโอกาสให้โมเดลจบคำตอบที่มันรู้วิธีแก้อยู่แล้ว
เพื่อตรวจสอบ นักวิจัยทำการทดลองเดียวกันกับGemma 3 270M โมเดลเล็กที่แทบไม่ลูป (มีเพียง 8.5% ของคำตอบที่ชนลิมิตโทเคน เทียบกับ 93% ของ Qwen) คราวนี้ Astra แทบไม่ปรับปรุงอะไรได้ บน MATH-500 ไม่มีการแก้ใดขยับคะแนนเกินราวหนึ่งจุด และ Astra เองรายงานว่ากำไรยังไม่ยืนยัน
| Gemma 3 270M | MATH-500 |
|---|
| โมเดลเดิม | 6.8% |
| เวอร์ชันแก้ที่ดีที่สุด | 7.7% |
เมื่อ Astra ดูว่าตรงไหนที่ Gemma ผิด มันพบข้อผิดพลาดทั่วไป เช่น บวกลบคูณหารผิด และขั้นตอนพีชคณิตผิด ไม่มีชิ้นส่วนที่พังชิ้นเดียวให้ปิด ดังนั้นเทคนิคที่ 4 จึงไม่มีอะไรให้ทำ
กล่าวโดยสรุป การแก้เวทน้ำหนักอาจเอาอุปสรรคที่บังทักษะออกได้ แต่เพิ่มทักษะที่โมเดลไม่เคยมีไม่ได้
ทักษะที่ 3: LLM เขียนเวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 5)
มาถึงส่วนที่น่าประหลาดใจที่สุดสำหรับผู้เขียนเอง ที่นี่ Astra เริ่มจากเครือข่ายที่เวทน้ำหนักทุกตัวเป็นศูนย์ และต้องเลือกตัวเลขทั้งหมดเอง
เทคนิคที่ 5: วางแผนโปรแกรมแล้วแปลงเป็นตัวเลข
เทคนิคอธิบายง่าย ๆ Astraวางแผนโปรแกรมก่อน ตัดสินใจว่าแต่ละเลเยอร์ควรทำอะไร แล้วเลือกเวทน้ำหนักที่ทำให้เลเยอร์นั้นทำงานนั้น
นักวิจัยใช้ MinAtar ชุดเกม Atari แบบย่อ และเลือก Breakout, Seaquest และ Asterix สำหรับแต่ละเกม Astra ได้รับ:
- กติกาของเกม
- ซอร์สโค้ดของเกม
- เครือข่ายว่างที่เวทน้ำหนักทุกตัวเป็นศูนย์
มันไม่มีข้อมูลเทรน ไม่มีเครื่องมือ และแม้แต่ทดสอบในเกมก็ไม่ได้ มันเพียงพิมพ์เวทน้ำหนักทั้งหมดออกมาในคำตอบเดียว แล้วนักวิจัยจึงค่อยนำไปทดสอบ
สำหรับ Breakout แผนมีดังนี้:
- เลเยอร์ 1: คำนวณว่าลูกบอลจะตกที่ไหน (รวมการเด้งผนัง)
- เลเยอร์ 2: ขยับไม้พายไปยังจุดนั้น
| เกม | PPO, 100M สเต็ป | PPO, 500M สเต็ป | Astra (พิมพ์ครั้งเดียว ไม่เทรน) |
|---|
| Breakout | 15.8 | 25.3 | 517.4 |
| Seaquest | 5.6 | 88.9 | 53.1 |
| Asterix | 25.8 | 55.2 | 53.2 |
จะเห็นได้ว่าเครือข่ายของ Astra ชนะเครือข่ายที่เทรนมา 100 ล้านสเต็ปในทั้ง 3 เกม เทียบกับเครือข่ายที่เทรน 500 ล้านสเต็ป มันได้คะแนนสูงกว่าราว 20 เท่าใน Breakout ใกล้เคียงใน Asterix และได้ราว 60% ใน Seaquest
สร้างผู้เล่นโกะ
เครือข่ายเกมด้านบนเล็กพอให้ Astra พิมพ์ออกมาในคำตอบเดียว สำหรับโกะ นักวิจัยทำให้ยากขึ้นมาก ด้วยเครือข่ายราว1.5 ล้านเวทน้ำหนัก ใหญ่เกินจะใส่ในพรอมป์ต์ของ Astra ได้
ดังนั้นจึงให้ Astra มีพื้นที่ทำงาน Python ที่ดูและบันทึกเวทน้ำหนักได้ (เริ่มต้นเป็นศูนย์ทั้งหมด) แต่รันเครือข่ายไม่ได้ หากต้องการทดสอบเครือข่าย ต้องใช้ “ครั้งทดสอบ” ที่จำกัด ตั้งแต่ 0 ถึง 50 ครั้ง โดยแต่ละครั้งเล่น 128 เกมบนกระดาน 9×9
Astra สร้างเครือข่ายนี้เหมือนโปรแกรมโกะเช่นกัน:
- เลเยอร์ต้นมาร์กตำแหน่งหมากของแต่ละฝ่าย
- เลเยอร์กลางไล่ตามสายโซ่หมากเพื่อหากลุ่มที่เสี่ยง
- เลเยอร์สุดท้ายให้คะแนนกับแต่ละหมากที่เป็นไปได้ หมากที่กินได้หรือช่วยกลุ่มตัวเองได้จะได้คะแนน และความผิดพลาดจะเสียคะแนน
อาจคิดว่านี่คล้ายคอมไพเลอร์ ซึ่งก็ถูกมาก มันคล้ายกับงาน Tracr ของ DeepMind ที่แปลงโปรแกรมเป็นเวทของทรานส์ฟอร์มเมอร์ ความต่างคือ Tracr ต้องการให้โปรแกรมถูกเขียนในภาษาเฉพาะ ส่วน Astra คิดโปรแกรมขึ้นเองจากเป้าหมายภาษาอังกฤษธรรมดา
เหตุใดการทดสอบจึงสร้างความแตกต่างมาก
ถึงตอนนี้น่าจะสังเกตว่ากติกาเปลี่ยนไปตามการทดลอง ในการระบุเกม รูปทรง รถ และ MinAtar Astraไม่มีเครื่องมือเลย ขณะที่ในการทดลองภาษา โกะ คนเอาใจ และ Qwen มันใช้ Python และบางครั้งทดสอบเครือข่ายได้
ในความเห็น นี่คือส่วนที่ถูกประเมินค่าต่ำที่สุดของโพสต์ เพราะจำนวนการทดสอบดูจะมีผลมาก:
- โกะ: ด้วยศูนย์ครั้งทดสอบ เครือข่ายของ Astra ชนะมากกว่าครึ่งของเกมกับเครือข่ายที่เทรนเล็กกว่า 2 ตัว ด้วย50 ครั้งทดสอบ มันชนะเครือข่ายที่ขนาดเท่ากันซึ่งเรียนมาจาก20 ล้านเกม
- Qwen: เมื่อทดสอบ 10 หรือ 25 ครั้ง ลูปยังอยู่เป็นส่วนใหญ่ การกระโดดครั้งใหญ่เกิดที่ 50 ผลเหล่านี้เป็นการรันครั้งเดียว ควรมองเป็นแนวโน้มมากกว่าหลักฐานเด็ดขาด
- คนเอาใจ (นี่คือการให้ใบ้เพิ่ม ไม่ใช่ครั้งทดสอบ แต่มีผลคล้ายกัน): จากเวทล้วนล้มเหลวทุกครั้ง แต่เมื่อได้ใบ้เรื่องแอตเทนชัน ก็ทายถูกทั้ง 3 คู่
ดังนั้นผลแบบไม่มีเครื่องมือจึงน่าประหลาดใจที่สุด แต่ก็หมายความว่าเปรียบเทียบทุกการทดลองเข้าด้วยกันอย่างยุติธรรมไม่ได้
GPT-6 Astra ทำสิ่งเหล่านี้ได้อย่างไรจริง ๆ?
ยังมีรูปแบบร่วมในทุกเทคนิค: Astra ทำงานเหมือนวิศวกรมนุษย์มาก
- วางแผนโปรแกรม ตัดสินใจว่าทุกเลเยอร์ควรทำอะไร เช่น “คำนวณว่าลูกบอลจะตกที่ไหน”
- แปนแผนเป็นตัวเลข เลือกเวทน้ำหนักให้เลเยอร์ทำงานตามนั้น
- เปลี่ยนให้น้อยที่สุด เมื่อแก้เครือข่าย จะเพิ่มหรือลบชิ้นเล็ก ๆ อย่างทางลัดในรถหรือสไลเดอร์แฝงใน Qwen
- ทดสอบ (หากอนุญาต) เมื่อมีครั้งทดสอบ จะดูว่าเครือข่ายล้มเหลวอย่างไร และเก็บเฉพาะการเปลี่ยนที่ช่วยได้
Weight-Space Programming เทียบกับไฟน์จูนและการแก้ไขโมเดล
อาจสงสัยว่าสิ่งนี้ต่างจากไฟน์จูนหรือวิธีแก้ไขโมเดลแบบอื่นอย่างไร ตารางด้านล่างเปรียบเทียบวิธีที่ใกล้เคียงที่สุด พร้อมเทคนิคใน 5 ข้อที่คล้ายกันที่สุด:
| วิธี | เวทน้ำหนักเปลี่ยนอย่างไร | ต้องมีข้อมูลเทรนไหม | ใช้ทำอะไร | เทคนิคที่ใกล้ที่สุด |
|---|
| ไฟน์จูน / LoRA | อัลกอริทึมการเทรนปรับเวทจำนวนมาก | ต้องมี | สอนโมเดลให้ทำงานหรือสไตล์ใหม่ | ไม่มี |
| ROME | อัปเดตทางคณิตเล็ก ๆ แบบเจาะจง | ตัวอย่างเล็กน้อย | เปลี่ยนข้อเท็จจริงเดี่ยวที่โมเดลรู้ | เทคนิคที่ 3 |
| Task arithmetic | บวกหรือลบเวทของ “ทักษะ” | ต้องมี | ผสมหรือเอาทักษะที่ไฟน์จูนออก | เทคนิคที่ 4 |
| Abliteration | ลบทิศทางหนึ่ง | พรอมป์ต์สองสามร้อย | เอาพฤติกรรมหนึ่งออก เช่น การปฏิเสธ | เทคนิคที่ 4 |
| Weight Oracles | ไม่เปลี่ยนเวท อ่านอย่างเดียว | ต้องมี เพื่อเทรนมัน | หาปัญหาซ่อนเร้นจากเวทน้ำหนัก | เทคนิคที่ 1 และ 2 |
| Weight-Space Programming | LLM ให้เหตุผลและแก้ไข | ไม่ต้องมี | อ่าน แก้ และเขียนเวทน้ำหนักจากเป้าหมายภาษาอังกฤษ | ทั้ง 5 |
ขออธิบายสั้น ๆ บางวิธี:
- ROME แสดงตั้งแต่ปี 2022 ว่าข้อเท็จจริงอย่าง “Space Needle อยู่ในซีแอตเทิล” ถูกเก็บในเลเยอร์เฉพาะ และเปลี่ยนได้ด้วยการอัปเดตเล็ก ๆ
- Task arithmetic แสดงว่าเมื่อเอาโมเดลที่ไฟน์จูนแล้วลบด้วยโมเดลเดิม จะเหลือเวท “ทักษะ” ชุดหนึ่งที่นำไปบวก (หรือเอาออก) กับโมเดลอื่นได้
- Weight Oracles ใกล้เคียงที่สุด เป็นงานเดือนตุลาคม 2026 ที่เทรนโมเดลภาษาให้อ่านเวทน้ำหนักของเครือข่ายอื่นและหาปัญหาอย่างแบ็กดอร์ เป็นหลักฐานแนวคิดบนทรานส์ฟอร์มเมอร์ของเล่น
ความต่างใหญ่กับ Weight Oracles คือ Oracles ถูกเทรนมาเพื่อหน้าที่เดียว ขณะที่ Weight-Space Programming ใช้ LLM สำเร็จรูปทั่วไป
โดยส่วนตัว ส่วนใหม่ไม่ใช่ว่าเวทน้ำหนักแก้ได้—เรารู้มาหลายปีแล้ว—แต่คือโมเดลทั่วไปตัวเดียวจัดการงานต่างกันทั้งหมดได้ด้วยการให้เหตุผล
ข้อจำกัดของ Weight-Space Programming
แม้ผลลัพธ์น่าตื่นเต้น ควรอ่านอย่างระมัดระวัง ผู้เขียนเองเรียกว่าเป็น “ผลลัพธ์ระยะแรกมาก” ประเด็นหลักที่ถูกยกขึ้นมีดังนี้:
1. เป็นการแก้ ไม่ใช่การพัฒนา
ดังที่ตัวควบคุม Gemma แสดงให้เห็น การกระโดดครั้งใหญ่ของ Qwen มาจากการหยุดลูปเป็นหลัก การวิเคราะห์ล็อกของผู้เขียนเองที่XenoSpectrum รายงาน นับได้ 579 โจทย์ฝึกหัดที่ Qwen แก้ได้ใหม่หลังการแก้ ในจำนวนนั้น576 ข้อเคยถูกตัดทิ้งเพราะชนลิมิตโทเคน
2. ทดสอบกับ LLM แนวหน้าเพียงตัวเดียว
ทุกการทดลองในโพสต์ใช้ GPT-6 Astra Simon Willison ทำซ้ำงานระบุเกมบนแล็ปท็อปด้วย Qwen 3.8 27B แบบ open-weight แม้จะพลาดหนึ่งเกม ว่าด้วยโมเดลแนวหน้าอื่นจะทำได้ทัดเทียม Astra ในงานซ่อมและเขียนหรือไม่นั้น เบนช์มาร์กที่ผู้เขียนวางแผนไว้น่าจะตอบได้
3. ยังไม่ผ่านเพียร์รีวิว
นี่เป็นบล็อกโพสต์ ไม่ใช่งานตีพิมพ์ ผู้เขียนปล่อยล็อกเต็ม และ Ahsen Khaliq จาก Hugging Face สร้างโมเดล Qwen ที่แก้แล้วจากล็อกและประเมินซ้ำ ซึ่งผู้เขียนรายงานว่าได้ 51.0% บน MATH-500 โดยยังมี 31.6% ของคำตอบชนลิมิตโทเคน นี่เป็นการตรวจเช็กเช็คพอยต์ที่ปล่อย แต่ไม่เท่ากับการทำซ้ำอิสระของขั้นตอนที่ Astra ใช้แก้
4. ผลลัพธ์ที่รายงานอาจเอื้ออำนวย
มีเสียงวิจารณ์ว่าการลองพรอมป์ต์ก่อนหน้าไม่ถูกรวมในผลลัพธ์ที่รายงาน และความพยายามในการให้เหตุผลของ Astra ต่างกันไปตามการทดลอง ผู้เขียนบทความนี้เองก็หาไม่เจอว่ามีทดสอบความไวต่อการเปลี่ยนถ้อยคำของพรอมป์ต์หรือไม่
5. ยังไม่รู้ต้นทุน
การรันที่ดีที่สุดของ Qwen ใช้ 158 รอบสนทนาและ 20.3 ชั่วโมง รวม 4.7 ชั่วโมงที่เสียไปกับการหยุดให้บริการ โพสต์ไม่ได้เปรียบเทียบกับการไฟน์จูนปกติ จึงยังบอกไม่ได้ว่าประหยัดเวลา/เงินหรือไม่
6. การเปรียบเทียบทรีตเมนต์เอื้อ
ผลเกมถูกเปรียบกับเครือข่ายที่เทรนแล้ว แต่ไม่เปรียบกับโค้ดเชิงกฎง่าย ๆ ผู้เล่น Breakout ที่แค่ตามลูกบอลไม่ยากจะเขียนเป็นโปรแกรมปกติ ดังนั้นการชนะเครือข่ายที่เทรนจึงไม่น่าประหลาดใจอย่างที่ดูตอนแรก ผู้เขียนตอบว่าแต่ละเบสไลน์ทดสอบเพียงข้ออ้างแคบ ๆ ของการทดลองนั้น ๆ เช่น ไปได้ไกลแค่ไหนโดยไม่มีประสบการณ์เลย
อย่างไรก็ตาม ต้องให้เครดิตว่าผู้เขียนเปิดเผยสิ่งที่ไม่เวิร์กด้วย รวมถึงผลคนเอาใจและ Gemma ซึ่งน่าชื่นชม แต่ควรมองตัวเลขพาดหัวเป็นสัญญาณที่มีหวังมากกว่าหลักฐานว่าทำงานได้ทั่วไป
การประยุกต์ของ Weight-Space Programming
แม้มีข้อจำกัดทั้งหมด ก็ยังน่าตื่นเต้นที่จะจินตนาการว่าถ้าพัฒนาต่อไปจะไปทางไหน ต่อไปนี้คือการใช้งานที่ผู้เขียนกล่าวถึง:
| การใช้งาน | อาจมีหน้าตาอย่างไร |
|---|
| ตรวจเช็กโมเดลโดยไม่ต้องทดสอบ | หาปัญหาซ่อนเร้น เช่น แบ็กดอร์ ด้วยการอ่านเวทน้ำหนักตั้งแต่ก่อนปล่อยโมเดล |
| สร้างโมเดลให้ถูกลง | ตั้งค่าเครือข่ายที่ดีได้ในครั้งเดียว แทนที่จะต้องรวบรวมข้อมูลมาก ๆ และรันงานเทรนยาวนาน |
| เพิ่มหรือลบทักษะโดยไม่ต้องใช้ข้อมูล | ขอให้ LLM เอาทักษะหนึ่งออกจากโมเดลโดยตรง เนื่องจากเปลี่ยนเวทเพียงเล็กน้อย ส่วนอื่น ๆ ของโมเดลยังเหมือนเดิม เลี่ยงปัญหาไฟน์จูนที่โมเดลลืมสิ่งที่เคยรู้ |
| ผสมโมเดลต่างกัน | ย้ายชิ้นส่วนที่มีประโยชน์ เช่น โมดูลให้เหตุผล จากโมเดลหนึ่งไปอีกโมเดลที่ต่างกันมาก วิธีผสานปัจจุบันใช้ได้เมื่อทั้งสองโมเดลมีโครงสร้างเหมือนกันเท่านั้น |
| AI ปรับปรุงตัวเอง | โมเดลอ่านและปรับปรุงเวทน้ำหนักของตัวเอง แทนที่จะเขียนโค้ดเพื่อเริ่มงานเทรน |
ข้อสุดท้ายนี่เองที่ทำให้ไม่ใช่ทุกคนตื่นเต้น Maxime Fournes ซีอีโอของ PauseAI เรียกทิศทางวิจัยนี้ว่าขาดความรอบคอบ เพราะความก้าวหน้าจริงอาจเร่งการพัฒนา AI ที่เสี่ยง อย่างไรก็ดี โพสต์นี้ไม่ได้แสดง การปรับปรุงตัวเองแบบวนซ้ำ ใด ๆ
ยังมีมุมความปลอดภัยที่เป็นบวก หาก LLM ตรวจจับสิ่งอย่างเช่นการเอาใจหรือแบ็กดอร์ที่ซ่อนอยู่ได้อย่างน่าเชื่อถือด้วยการอ่านเวทน้ำหนัก นั่นอาจกลายเป็นวิธีที่มีประโยชน์ในการตรวจเช็กโมเดลก่อนปล่อย
ต่อไปจะเป็นอะไร?
ผู้เขียนบอกว่ากำลังสร้างเบนช์มาร์กเพื่อวัดว่า LLM ต่าง ๆ ทำสิ่งนี้ได้ดีแค่ไหน พร้อมฮาร์เนสช่วยทำงาน คำถามที่นักวิจัยจะทำงานต่อมีเช่น:
- LLM ตัวอื่นทำได้ไหม หรือมีอะไรพิเศษเกี่ยวกับ Astra?
- มันจะเพิ่มทักษะใหม่จริง ๆ ได้ไหม หรือทำได้แค่เอาปัญหาอย่างลูปออก?
- จะเวิร์กกับโมเดลที่ใหญ่กว่ามากที่มีเวทน้ำหนักมากกว่าพันเท่าไหม?
- จะถูกกว่าไฟน์จูนปกติหรือไม่ในอนาคต?
งานเดินหน้าเร็วตั้งแต่เผยแพร่ ในอัปเดตวันที่ 12 พฤศจิกายน ผู้เขียนบอกว่ามีการทำซ้ำและขยายมากกว่าร้อยกรณีแล้ว รวมถึงไปยังนโยบายหุ่นยนต์และวงจรควอนตัม และมีเบนช์มาร์กชื่อ IWIBench
หากอยากดูงานเอง สามารถดูล็อกเต็มของทุกการทดลองบน GitHub รวมทุกพรอมป์ต์ที่ส่งให้ Astra และสรุปเหตุผลของมัน โมเดล Qwen ที่แก้แล้วก็อยู่บน Hugging Face พร้อมเดโมสดที่ลองในเบราว์เซอร์ได้ ซึ่งลิงก์จากบล็อกโพสต์ต้นฉบับ
ความเห็นท้ายบท
Weight-Space Programming เป็นแนวคิดใหม่ที่มีหลักฐานระยะแรกสนับสนุน LLM สำเร็จรูป โดยไม่ต้องเทรนเลย สามารถอ่านว่าเครือข่ายเล็กทำอะไร แก้รถที่ติด และโมเดลภาษาที่ติดลูป และแม้กระทั่งสร้างเครือข่ายเล่นเกมจากศูนย์
สิ่งที่น่าประหลาดใจที่สุดคือวิธีการ มันไม่ได้ใช้กลเม็ดลึกลับ แต่มองขอบของเครือข่าย ไล่วงจร เพิ่มทางลัด ลบทิศทาง และวางแผนโปรแกรมก่อนแปลงเป็นตัวเลข คล้ายวิศวกรทำ
แต่อยากย้ำว่านี่เป็นรายงานระยะแรกบนโมเดลตัวเดียว และผลที่ใหญ่ที่สุดมาจากแก้บั๊ก ไม่ใช่ทำให้โมเดลฉลาดขึ้น หากพัฒนาไปเรื่อย ๆ การใช้งานที่น่าจะมีประโยชน์ที่สุดคงเป็นการตรวจสอบและดีบักโมเดล ไม่ใช่แทนที่การเทรน
หากอยากปูพื้นฐานเพื่ออ่านงานวิจัยแบบนี้ต่อ คอร์ส Large Language Models (LLMs) Concepts ของเราครอบคลุมการทำงานภายในของโมเดลเหล่านี้ และถ้าสนใจฝั่งเอเจนต์ Introduction to AI Agents ก็เป็นก้าวต่อไปที่ดี


ลองจินตนาการว่ามีการนำเพลงโปรดมาแปลงเป็นรายชื่อตัวเลขยาว ๆ แล้วพิมพ์ออกมาให้ดู แบบนี้จะบอกได้ไหมว่าเป็นเพลงไหน เพียงแค่มองตัวเลข?
เพลงนั้นอยู่ในนั้นแน่นอน แต่ซ่อนอยู่ในค่าหลายพันค่าที่แยกเดี่ยว ๆ แล้วไม่มีความหมายสำหรับเรา
โครงข่ายประสาทเทียมก็มีปัญหาเดียวกัน สิ่งที่เครือข่ายรู้ทั้งหมดถูกเก็บในเวทน้ำหนัก ซึ่งก็เป็นเพียงตัวเลข
ตลอดช่วงเวลาที่มีดีปเลิร์นนิง เราไม่สามารถดูตัวเลขเหล่านั้นแล้วพูดอย่างมั่นใจได้ว่าเครือข่ายนี้เล่น Breakout หรือเครือข่ายนั้นทำงานอะไร เราก็ไม่เคยเขียนตัวเลขเหล่านั้นเองสำหรับเครือข่ายที่ใหญ่กว่าของเล่น งานนั้นปล่อยให้การเทรนทำเสมอ
เมื่อวันที่ 2 พฤศจิกายน 2026 ทีมจากห้องปฏิบัติการวิทยาการคอมพิวเตอร์และปัญญาประดิษฐ์ MIT (MIT CSAIL) แสดงให้เห็นว่า LLM แนวหน้ารุ่นหนึ่งของ OpenAI ชื่อ GPT-6 Astra ทำได้ทั้งสองอย่าง มันสามารถดูเวทน้ำหนักดิบ ๆ ของเครือข่าย คิดออกว่าทำอะไร อยู่ตรงไหนที่พัง และแม้กระทั่งเขียนเครือข่ายใหม่ตั้งแต่ศูนย์ โดยไม่ต้องเทรนเลย ผู้เขียน Rikiya Takehi, Jayden Teoh, Alex Zhang และ Omar Khattab เรียกสิ่งนี้ว่าWeight-Space Programming ในบล็อกโพสต์ต้นฉบับของพวกเขา
ดังนั้น บทความนี้จะเน้นไปที่วิธีการทำงานจริง ๆ จัดเรียงตามเทคนิคที่ LLM ใช้มากกว่าตามการทดลอง หากต้องการดูผลลัพธ์ก่อนรายละเอียดการทดลอง โปรดดูภาพรวมของ Weight-Space Programmingของเรา
หากต้องการทบทวนวิธีทำงานของ LLM และสถาปัตยกรรมทรานส์ฟอร์มเมอร์ที่เป็นพื้นฐานก่อนเข้าเทคนิคต่าง ๆ คอร์ส Introduction to LLMs in Python ของเราครอบคลุมพื้นฐาน ซึ่งช่วยได้เมื่อดูโมเดลที่อ่านและเขียนเวทน้ำหนัก
สรุปสั้น ๆ
หัวข้อที่จะครอบคลุม:
Weight-Space Programming คืออะไร?
Weight-Space Programming คือแนวคิดในการปฏิบัติต่อเวทน้ำหนักของโครงข่ายประสาทเหมือนโปรแกรม: LLM ทั่วไปอ่านและเขียนเวทน้ำหนักโดยตรงด้วยการให้เหตุผลเกี่ยวกับหน้าที่ของแต่ละส่วนในเครือข่าย แทนที่จะพึ่งอัลกอริทึมการเทรนอย่าง gradient descent
พูดแบบง่าย ๆ LLM เปิดดูภายในเครือข่าย มองตัวเลขเอง และเปลี่ยนมันอย่างมีเป้าหมาย
มองได้เหมือนความต่างระหว่างการฝึกสุนัขกับการเดินสายใหม่ให้สุนัขหุ่นยนต์ การฝึกคือยกตัวอย่างมาก ๆ แล้วค่อย ๆ หวังให้พฤติกรรมเปลี่ยน ส่วนการเดินสายใหม่คือเข้าไปข้างใน หาอะไหล่ที่รับผิดชอบ แล้วเปลี่ยนโดยตรง
นี่ไม่ใช่การให้ LLM เขียนสคริปต์เทรนให้ ซึ่ง LLM ทำได้มาระยะหนึ่งแล้ว ที่นี่ไม่มีสคริปต์เทรนเลย และ LLM ทำงานกับตัวเลขจริง
ผู้เขียนย้ำว่า Weight-Space Programming เป็นแนวคิด ไม่ใช่วิธีเดียวตายตัว และไม่ได้ปฏิเสธการใช้กราเดียนต์ พวกเขาห้ามใช้กราเดียนต์ในชุดทดลองนี้เพื่อแยกดูว่าการให้เหตุผลเพียงอย่างเดียวทำอะไรได้บ้าง
โพสต์ทดสอบแนวคิดนี้ใน 3 ทาง ซึ่งเข้าใจภาพรวมได้ง่ายที่สุด (ดูรูปที่ 1):
รูปที่ 1: ทักษะ 3 อย่างที่ทดสอบในโพสต์ ภาพโดยผู้เขียน
LLM ที่ทำทั้งหมดนี้คือ GPT-6 Astra ซึ่ง OpenAI เปิดตัวเมื่อ 3 กันยายน 2026 ในการทดลองบางส่วน นักวิจัยปิดเครื่องมือทั้งหมดของมัน (รวมถึงการค้นเว็บและรันโค้ด) ทำให้ทำได้เพียงอ่านตัวเลขและคิด
ทักษะทั้ง 3 อย่างใช้ชุดเทคนิคของตัวเอง และนั่นคือสิ่งที่ส่วนที่เหลือของบทความจะครอบคลุม
เวทน้ำหนักของโครงข่ายประสาทถูกสร้างอย่างไรตามปกติ?
ก่อนเข้าถึงเทคนิคต่าง ๆ ควรรู้ว่าเวทน้ำหนักถูกสร้างอย่างไรตามปกติ ไม่เช่นนั้นยากจะเห็นว่าทำไมงานวิจัยนี้ถึงน่าประหลาดใจ
ทบทวนการเทรน
โครงข่ายประสาทคือกลุ่มตัวเลขจำนวนมากที่เรียกว่าเวทน้ำหนัก (หรือพารามิเตอร์) เมื่อป้อนอินพุต เช่น ภาพหรือประโยค เครือข่ายจะคูณและบวกตัวเลขเหล่านี้เพื่อให้ได้เอาต์พุต เรียกว่า forward pass
การเทรนคือกระบวนการเลือกค่าที่ดีสำหรับตัวเลขเหล่านี้ วิธีมาตรฐานคือgradient descent: รันเครือข่าย วัดว่าคำตอบผิดเพียงใด คำนวณว่าควรขยับเวทน้ำหนักแต่ละตัวไปทางไหนเพื่อให้ผิดน้อยลงเล็กน้อย แล้วขยับทุกเวทน้ำหนักทีละนิด ทำซ้ำเป็นล้าน ๆ ครั้ง จึงทำให้การเทรนมีค่าใช้จ่ายสูง
สี่วิธีที่เวทน้ำหนักถูกเขียน
ทุกโครงข่ายประสาทที่เคยใช้ เวทน้ำหนักถูกเลือกด้วยบางอย่าง จนถึงตอนนี้มีอยู่ 4 อย่าง:
AdderBoard เป็นกรณีพิเศษ เป็นโจทย์ชุมชนในการสร้างทรานส์ฟอร์มเมอร์ที่เล็กที่สุดที่บวกเลข 10 หลักสองจำนวนได้ และมีผลงานที่สร้างด้วยมือโดยใช้ค่าของเวทน้ำหนักที่แตกต่างกันไม่ถึงโหล ซึ่งห่างไกลจากขนาดโมเดลอย่าง ChatGPT มาก
Weight-Space Programming เพิ่มตัวเลือกที่ห้าคือให้ LLM ทั่วไปมาคิดเหตุผลเกี่ยวกับเวทน้ำหนัก
รูปที่ 2: การเทรนปกติเทียบกับ Weight-Space Programming ภาพโดยผู้เขียน
แล้วทำไมเราอ่านเวทน้ำหนักตรง ๆ ไม่ได้?
ถ้าเวทน้ำหนักเป็นแค่ตัวเลข ทำไมอ่านมันถึงยาก มีเหตุผลหลัก ๆ 2 ข้อ
หนึ่ง เครือข่ายไม่ได้เก็บหนึ่งไอเดียไว้ที่จุดเดียว ไอเดียเดียวมักกระจายอยู่ในนิวรอนหลายตัว และนิวรอนหนึ่งตัวก็มักช่วยในหลายไอเดียพร้อมกัน
สอง เครือข่ายเดียวกันเขียนได้หลายแบบ สลับลำดับนิวรอนในเลเยอร์หนึ่ง ปรับเลเยอร์ถัดไปให้ตรงกัน และเครือข่ายจะทำงานเหมือนเดิมเป๊ะ ดังนั้นเครือข่ายสองตัวที่ทำงานเดียวกันอาจมีเวทน้ำหนักที่ดูต่างกันมาก
จำสองปัญหานี้ไว้ เพราะทุกเทคนิคด้านล่างคือหนทางอ้อมเพื่อเอาชนะมัน
ทำไม Weight-Space Programming จึงก้าวสำคัญ
โพสต์นี้ได้รับความสนใจมากเพราะต่อยอดจากแนวโน้มใหญ่ ช่วงไม่กี่ปีที่ผ่านมา เราให้ LLM ปรับปรุงสิ่งต่าง ๆ ด้วยตัวเองมากขึ้นเรื่อย ๆ:
รูปที่ 3: สิ่งที่เราให้ LLM ปรับปรุงตามกาลเวลา ภาพโดยผู้เขียน
สังเกตว่าสิ่งเหล่านี้ล้วนเป็นข้อความ เช่น พรอมป์ต์และไฟล์ Python ที่คนก็แก้เองได้ ผู้เขียนชี้ว่าเราใช้ LLM กับข้อความก็เพราะไม่มีวิธีที่ดีกว่าในการปรับปรุง สำหรับเวทน้ำหนัก เรามีกราเดียนต์ดิเซนต์อยู่แล้ว จึงไม่มีใครคิดจะลอง
โพสต์นี้ถามว่าจะเกิดอะไรขึ้นถ้าข้ามสคริปต์เทรนไปเลย และให้ LLMเปลี่ยนเวทน้ำหนักเอง
ทักษะที่ 1: LLM อ่านเวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 1 และ 2)
นักวิจัยเริ่มจากเครือข่ายที่เล็กพอจะวางเวทน้ำหนักทั้งหมดลงในพรอมป์ต์ของ Astra เป็นข้อความล้วน แล้วค่อยไปยังโมเดลที่ใหญ่ขึ้นที่ Astra วิเคราะห์ด้วย Python Astra ใช้ 2 เทคนิคหลักในการอ่าน
เทคนิคที่ 1: อ่านโครงสร้างจากเวทอินพุตและเอาต์พุต
ในความเห็น ส่วนที่เริ่มอ่านเครือข่ายได้ง่ายที่สุดคือขอบ เลเยอร์แรกเชื่อมกับอินพุตโดยตรง (เช่น พิกเซลของหน้าจอ) และเลเยอร์สุดท้ายเชื่อมกับเอาต์พุตโดยตรง (เช่น การเคลื่อนไหวที่ผู้เล่นทำได้) มีเพียงเลเยอร์เหล่านี้เท่านั้นที่เรารู้ว่าตัวเลขแต่ละตัวเชื่อมกับอะไร
เครือข่ายนี้เล่นเกมอะไร?
นักวิจัยเทรนเครือข่ายเล็ก 4 ตัวด้วย Proximal Policy Optimization (PPO) อัลกอริทึมการเรียนรู้แบบเสริมกำลัง ให้เล่นเกมแบบกริด 10×10 ที่เรียบง่ายของBreakout, Pong, Pac-Man และ Freeway
ความฉลาดของการตั้งค่านี้คือเครือข่ายทั้ง 4 ตัวมีขนาดเท่ากันเป๊ะ (17,253 เวทน้ำหนักเท่ากัน) รับอินพุตเหมือนกัน และทำการเคลื่อนไหวเหมือนกัน ทางเดียวจะแยกความต่างได้คืออ่านตัวเลข
พวกเขาวางเวทน้ำหนักของแต่ละเครือข่ายลงใน Astra แล้วถามว่า "เครือข่ายนี้ถูกเทรนกับเกมอะไร" โดยไม่ให้ตัวเลือก Astra ก็ยังระบุชื่อเกมถูกทั้ง 4 ตัว
รูปที่ 4: Astra อ่านเวทดิบและระบุ Breakout ภาพโดยผู้เขียน
สิ่งที่สะดุดตาคือวิธีที่มันหาออก สำหรับเครือข่าย Breakout มันให้เหตุผลประมาณนี้:
รวมเบาะแสเหล่านี้เข้าด้วยกัน ได้เป็น Breakout สองเบาะแสแรกมาจากเวทอินพุต และอันสุดท้ายจากเวทเอาต์พุต ซึ่งตรงกับเทคนิคนี้
โมเดลนี้วาดรูปทรงอะไร?
ต่อมา นักวิจัยเทรนโมเดลสร้างภาพขนาดเล็ก (โมเดล diffusion ตระกูลเดียวกับตัวสร้างภาพ AI ส่วนใหญ่) ให้วาดวงกลม สามเหลี่ยม หรือสี่เหลี่ยม Astra ก็ได้รับแค่เวทน้ำหนักเช่นกัน ไม่มีเครื่องมือและไม่มีทางรันโมเดล และมันระบุรูปทรงถูกทุกตัว
มีข้อผิดพลาดประหลาดหนึ่งอย่าง: Astra บรรยายทุกรูปทรงว่าเป็นขอบ ทั้งที่โมเดลวาดทรงที่ทึบ ผู้วิจัยมองว่านี่เป็นสัญญาณที่ดี เพราะชี้ว่า Astra กำลังอ่านขอบของรูปทรงที่เก็บอยู่ในเวท มากกว่าจะลอบรันโมเดลเต็ม ๆ ในหัว
เทคนิคที่ 2: หาเซอร์กิตในเลเยอร์กลาง
ในการทดลองสองอย่างแรก Astra อ่านแค่เลเยอร์แรกหรือสุดท้ายก็พอ ซึ่งจะใช้ไม่ได้กับโมเดลภาษา ที่การคิดส่วนใหญ่เกิดในเลเยอร์กลาง
นี่คือที่มาของเทคนิคที่สอง: การหาวงจร (circuit) วงจรคือกลุ่มชิ้นส่วนเล็ก ๆ ในเครือข่ายที่ทำงานร่วมกันเพื่อทำงานเฉพาะหนึ่งอย่าง หากรู้จักหน้าที่ของมัน จะเรียนรู้ได้มากโดยไม่ต้องรู้ว่าอินพุตคืออะไร
โมเดลนี้เรียนภาษาไหน?
เพื่อทดสอบ นักวิจัยเทรนโมเดลภาษาเล็ก 3 ตัว (ราว 7.2 ล้านเวทน้ำหนักต่อโมเดล):
จากนั้นพวกเขาตัดเลเยอร์แรกและสุดท้ายของแต่ละโมเดลออก เหลือแค่บล็อกกลาง 4 บล็อก เมื่อไม่มีเลเยอร์เหล่านั้น ก็ไม่มีอะไรในเวทน้ำหนักที่บอกว่าตัวเลขไหนแทนตัวอักษรไหน โมเดลดังนั้นจึงรันกับข้อความไม่ได้ และเทคนิคที่ 1 ใช้ไม่ได้
คราวนี้อนุญาตให้ Astra วิเคราะห์ตัวเลขด้วย Python แต่ไม่ให้รันโมเดล มันก็ยังระบุภาษาถูกทั้ง 3 โมเดลในสองความพยายาม แม้ว่าความมั่นใจจะอยู่ราว 50–60% แต่ละครั้ง
แล้วมันรู้ว่าอันไหนคือ Python อย่างไร? มันมองหาinduction heads
Induction heads คือส่วนหนึ่งของ ทรานส์ฟอร์มเมอร์ ที่สังเกตเมื่อรูปแบบหนึ่ง ๆ ปรากฏก่อนหน้าแล้วคัดลอกสิ่งที่ตามหลัง เช่น เติม “tot” เป็น “total” เพราะ “total” เคยถูกเขียนก่อนหน้า โค้ดใช้ชื่อตัวแปรซ้ำมากกว่าข้อความทั่วไปมาก โมเดล Python จึงต้องการส่วนนี้มากกว่า Astra หาได้ครบทุกตัวโดยไม่ติดป้ายผิดให้ตัวอื่น
Astra คูณเมทริกซ์เวทของเฮดต่าง ๆ เข้าด้วยกันเพื่อดูว่าเฮดไหน “คุยกัน” ซึ่งตรงกับเทคนิคในงานปี 2021 เรื่อง A Mathematical Framework for Transformer Circuits ที่นักวิจัยไม่ได้บอกมัน
สำหรับโรมาจิ Astra สังเกตว่าโมเดลเหมือนมีตัวอักษรน้อยกว่าให้ตาม ซึ่งจริง เพราะโรมาจิไม่ใช้ตัวอย่าง q, l, v หรือ x
จุดที่การอ่านพัง: โมเดลไหนชอบเอาใจคน?
นี่คือจุดที่สองเทคนิคนี้ใช้ไม่ได้ เป็นการทดลองเดียวที่ไม่สำเร็จในครั้งแรก
นักวิจัยนำ Gemma 3 270M ของ Google มาสองชุดแล้วไฟน์จูนเหมือนกันทุกอย่าง ยกเว้นหนึ่งจุด ชุดหนึ่งเรียนรู้ให้ตอบถูก อีกชุดเรียนรู้ให้ประจบเอาใจ คือให้คำตอบตามที่ผู้ใช้ชี้นำเสมอ ทั้งยังแช่แข็งเลเยอร์อินพุตและเอาต์พุตไว้ เพื่อไม่ให้ Astra ลัดไปดูเลเยอร์เหล่านั้น ตัวอย่างประกอบ:
จากเวทน้ำหนักล้วน ๆ Astraบอกไม่ได้ว่าโมเดลไหนชอบเอาใจในความพยายามทั้ง 4 ครั้ง มันพบความต่างมากมาย แต่เชื่อมโยงกับพฤติกรรมไม่ได้
ดังนั้นนักวิจัยจึงให้ใบ้เพิ่มอีก 1 อย่าง คือให้ Astra เห็นว่าแต่ละ attention head มองไปที่ไหนระหว่างที่โมเดลอ่านข้อความที่ Astra เขียนเอง (แต่ไม่ใช่คำตอบของโมเดลจริง) ด้วยสิ่งนี้ Astra เลือกโมเดลเอาใจถูกต้องในทั้ง 3 คู่
แถมยังหาว่าความต่างอยู่ที่ไหนได้ด้วย ที่หัวความสนใจ 10.2 โมเดลตรงไปตรงมาใช้ความสนใจ94.3%ไปกับตัวเลขในคำถาม ขณะที่โมเดลชอบเอาใจใช้85.7%กับคำตอบที่ผู้ใช้ชี้นำ
อยากชี้สิ่งนี้เพราะในความเห็น นี่คือผลลัพธ์ที่สำคัญที่สุดในโพสต์ มันแสดงว่าการอ่านพฤติกรรมจากเวทน้ำหนักล้วน ๆ ยังยากมากบนโมเดลภาษาจริง แม้สำหรับโมเดลแนวหน้าอย่าง GPT-6 Astra
ทักษะที่ 2: LLM แก้เวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 3 และ 4)
การอ่านเวทน่าประทับใจ แต่การแก้ยิ่งก้าวใหญ่และยากกว่า Astra ต้องเข้าใจว่าเครือข่ายกำลังทำอะไร ควรจะทำอะไร แล้วเปลี่ยนตัวเลขที่ถูกต้องเพื่ออุดช่องว่าง มันใช้เทคนิคที่แตกต่างกัน 2 แบบ
เทคนิคที่ 3: เพิ่มวงจรทางลัดเล็ก ๆ
เทคนิคนี้ปล่อยเครือข่ายเดิมส่วนใหญ่ไว้ แล้วเพิ่มวงจรเล็ก ๆ ที่จะทำงานเฉพาะในสถานการณ์เดียวที่เครือข่ายเดิมล้มเหลว
รถที่ติดอยู่ตลอด
สำหรับการทดลองนี้ นักวิจัยใช้เกมฟิสิกส์ 2 มิติชื่อ Kinetix และเทรนเครือข่ายด้วย PPO ให้ขับรถขึ้นทางลาด รถต้องถอยหลังก่อนเพื่อเร่งระยะ แล้วค่อยพุ่งไปข้างหน้า
เครือข่ายที่เทรนแล้วไม่เคยจับจุดนี้ได้ มันขับตรงเข้าทางลาดแล้วติดทุกครั้ง
นักวิจัยให้ Astra 3 อย่าง:
ภายในครั้งเดียว โดยไม่มีเครื่องมือ Astra อธิบายได้ว่ารถพลาดเพราะอะไร และเขียนเวทน้ำหนักใหม่ หลังการแก้ รถสำเร็จครบ 1,024 เอพิโสดทดสอบ (จากเดิม 0) และ Astra เปลี่ยนเวทน้ำหนักเพียง3.5%
Astra ไม่ได้เขียนเครือข่ายใหม่ทั้งหมด แต่มันเพิ่มทางลัดเล็ก ๆ ผ่านนิวรอนไม่กี่ตัวในแต่ละเลเยอร์ ที่จะเข้าควบคุมตอนเริ่มต้น ถอยรถแล้วปล่อยพุ่งไปข้างหน้า เมื่อรถผ่านแถบสีแดง ทางลัดก็ปิดตัวเอง แล้วเครือข่ายเดิมขับต่อที่เหลือ
นึกภาพครูสอนขับรถจับพวงมาลัยช่วงถนนยากช่วงหนึ่ง แล้วส่งคืนให้นักเรียนทันที ใช้ได้เพราะเครือข่ายเดิมไม่ได้พังทั้งหมด มันขับได้ แต่รับมือจุดยากจุดเดียวไม่ได้ จึงสมเหตุผลที่จะปล่อยส่วนอื่นไว้
เทคนิคที่ 4: หาและลบ “ทิศทาง” หนึ่งทิศ
เทคนิคนี้ตั้งอยู่บนแนวคิดว่าพฤติกรรมหนึ่งอาจอยู่ตาม “ทิศทาง” เดียวในโมเดล จึงปิดมันได้ด้วยการลบทิศทางนั้นออกจากเวทน้ำหนัก
โมเดลที่ชอบพูดซ้ำ ๆ
นี่คือการทดลองที่ไวรัล มาดูรายละเอียดกัน
นักวิจัยนำ Qwen3.5-0.8B โมเดลให้เหตุผลขนาดเล็กแบบโอเพ่นซอร์ส และขอให้ Astra ทำให้เก่งคณิตขึ้นด้วยการแก้เวทน้ำหนักอย่างเดียว คราวนี้ Astra มีโน้ตบุ๊ก Python ที่โหลดโมเดลไว้ และสามารถรันโมเดลกับโจทย์คณิตแบบฝึกหัดจำนวนจำกัด (10, 25 หรือ 50 ครั้งรัน ที่ผู้เขียนเรียกว่า forward pass) แต่เช่นเดิมห้ามเทรน
Astra พบอย่างรวดเร็วว่าโมเดลติดลูป ซ้ำคำเดิมไปเรื่อย ๆ ไม่ไปถึงคำตอบ ความจริงแล้วคำตอบ 85 จาก 96 คำตอบฝึกหัดแรก ยืดไปจนติดลิมิต 32,768 โทเคน
นี่เป็นปัญหาที่รู้กันดีในโมเดลให้เหตุผลขนาดเล็ก และการ์ดโมเดลของ Qwen เองก็เตือนไว้ งานเดือนธันวาคม 2025 ชื่อ “Wait, Wait, Wait… Why Do Reasoning Models Loop?” พบว่าโมเดลที่เล็กกว่าจากตระกูลเดียวกันติดลูปมากกว่า และโมเดลเล็กที่กลั่น (distill) จากโมเดลใหญ่ติดลูปยิ่งกว่าต้นแบบ
Astra ไล่หาต้นตอของการลูปจนเหลือเป็นรูปแบบแฝงหนึ่งเดียวในโมเดล ซึ่งนักวิจัยเรียกว่าทิศทาง (direction) ถ้าให้นึกภาพ ทิศทางเหมือนสไลเดอร์แฝงตัวหนึ่งในโมเดล กรณีนี้สไลเดอร์ผลักโมเดลให้พูดซ้ำ และอยู่ในเลเยอร์ที่ 15 และ 19
จากนั้น Astra ก็แค่ลบสไลเดอร์นั้นออกจากเวทน้ำหนัก 131,072 ตัว (คอลัมน์เอาต์พุต 64 คอลัมน์ในแต่ละ 2 เลเยอร์นั้น) ซึ่งมีเพียง0.016%ของโมเดลทั้งหมด
คณิตเบื้องหลัง
การแก้ Qwen คล้ายกับเทคนิคล่วงหน้าที่เรียกว่าabliteration ในปี 2024 นักวิจัยแสดงว่านิสัยการปฏิเสธคำขอของโมเดลถูกควบคุมด้วยทิศทางเดียว และสามารถลบทิศทางนั้นออกจากเวทน้ำหนักเพื่อหยุดการปฏิเสธได้
คณิตเบื้องหลังน่าแปลกใจที่เป็นสูตรบรรทัดเดียว โดยที่
rคือเวกเตอร์หน่วยของทิศทางที่ต้องการลบ:W_new = W - r (rᵀ W)เพื่อให้เข้าใจง่าย ลองตัวอย่างเล็ก ๆ สมมติว่าเวทหนึ่งตัวประกอบด้วย 2 ส่วน
(3, 2)ตัวแรกคือแรงผลักไปสู่การลูป ตัวที่สองคือสิ่งอื่นทั้งหมดที่มันทำทิศทางการลูปของเราคือ
r = (1, 0)ซึ่งหมายถึง “ตัวแรก” สูตรจะดึงส่วนการลูป (3) ออก เหลือ(0, 2)ส่วนการลูปหายไป ส่วนอื่นคงเดิมประเด็นสำคัญคือ Astraหาทิศทางการลูปได้ด้วยตัวเอง ด้วยการให้เหตุผลเกี่ยวกับเวทน้ำหนักและรันโมเดลกับโจทย์ฝึกหัด ขณะที่ abliteration ต้องใช้พรอมป์ต์ตัวอย่างหลายร้อยรายการเพื่อหา นี่คือผลลัพธ์โดยละเอียด (ดูตารางผลของการทดลองทั้ง 8 ในภาพรวม Weight-Space Programmingของเรา):
รูปที่ 5: Qwen3.5-0.8B ก่อนและหลังการแก้ของ Astra ภาพโดยผู้เขียน
มีสองอย่างที่อยากให้สังเกต หนึ่ง การลูปไม่ใช่แค่ปัญหาคณิต ดังนั้นการแก้จึงทำให้โมเดลทำตามคำสั่งได้ดีขึ้นมาก (IFEval จาก 21.0% เป็น 62.3% ในเวอร์ชันทดสอบ 50 ครั้ง) สอง เมื่อทดสอบ 10 หรือ 25 ครั้ง ลูปยังอยู่เป็นส่วนใหญ่ และการกระโดดครั้งใหญ่เกิดขึ้นเมื่อ 50 เท่านั้น
จุดที่การแก้พัง: การแก้ไม่เท่ากับการพัฒนา
ตอนนี้คือส่วนที่ทุกคนควรรู้ การหยุดลูปไม่เท่ากับทำให้โมเดลคณิตดีขึ้น มันเพียงเปิดโอกาสให้โมเดลจบคำตอบที่มันรู้วิธีแก้อยู่แล้ว
เพื่อตรวจสอบ นักวิจัยทำการทดลองเดียวกันกับGemma 3 270M โมเดลเล็กที่แทบไม่ลูป (มีเพียง 8.5% ของคำตอบที่ชนลิมิตโทเคน เทียบกับ 93% ของ Qwen) คราวนี้ Astra แทบไม่ปรับปรุงอะไรได้ บน MATH-500 ไม่มีการแก้ใดขยับคะแนนเกินราวหนึ่งจุด และ Astra เองรายงานว่ากำไรยังไม่ยืนยัน
เมื่อ Astra ดูว่าตรงไหนที่ Gemma ผิด มันพบข้อผิดพลาดทั่วไป เช่น บวกลบคูณหารผิด และขั้นตอนพีชคณิตผิด ไม่มีชิ้นส่วนที่พังชิ้นเดียวให้ปิด ดังนั้นเทคนิคที่ 4 จึงไม่มีอะไรให้ทำ
กล่าวโดยสรุป การแก้เวทน้ำหนักอาจเอาอุปสรรคที่บังทักษะออกได้ แต่เพิ่มทักษะที่โมเดลไม่เคยมีไม่ได้
ทักษะที่ 3: LLM เขียนเวทน้ำหนักโครงข่ายประสาทอย่างไร (เทคนิคที่ 5)
มาถึงส่วนที่น่าประหลาดใจที่สุดสำหรับผู้เขียนเอง ที่นี่ Astra เริ่มจากเครือข่ายที่เวทน้ำหนักทุกตัวเป็นศูนย์ และต้องเลือกตัวเลขทั้งหมดเอง
เทคนิคที่ 5: วางแผนโปรแกรมแล้วแปลงเป็นตัวเลข
เทคนิคอธิบายง่าย ๆ Astraวางแผนโปรแกรมก่อน ตัดสินใจว่าแต่ละเลเยอร์ควรทำอะไร แล้วเลือกเวทน้ำหนักที่ทำให้เลเยอร์นั้นทำงานนั้น
นักวิจัยใช้ MinAtar ชุดเกม Atari แบบย่อ และเลือก Breakout, Seaquest และ Asterix สำหรับแต่ละเกม Astra ได้รับ:
มันไม่มีข้อมูลเทรน ไม่มีเครื่องมือ และแม้แต่ทดสอบในเกมก็ไม่ได้ มันเพียงพิมพ์เวทน้ำหนักทั้งหมดออกมาในคำตอบเดียว แล้วนักวิจัยจึงค่อยนำไปทดสอบ
สำหรับ Breakout แผนมีดังนี้:
จะเห็นได้ว่าเครือข่ายของ Astra ชนะเครือข่ายที่เทรนมา 100 ล้านสเต็ปในทั้ง 3 เกม เทียบกับเครือข่ายที่เทรน 500 ล้านสเต็ป มันได้คะแนนสูงกว่าราว 20 เท่าใน Breakout ใกล้เคียงใน Asterix และได้ราว 60% ใน Seaquest
สร้างผู้เล่นโกะ
เครือข่ายเกมด้านบนเล็กพอให้ Astra พิมพ์ออกมาในคำตอบเดียว สำหรับโกะ นักวิจัยทำให้ยากขึ้นมาก ด้วยเครือข่ายราว1.5 ล้านเวทน้ำหนัก ใหญ่เกินจะใส่ในพรอมป์ต์ของ Astra ได้
ดังนั้นจึงให้ Astra มีพื้นที่ทำงาน Python ที่ดูและบันทึกเวทน้ำหนักได้ (เริ่มต้นเป็นศูนย์ทั้งหมด) แต่รันเครือข่ายไม่ได้ หากต้องการทดสอบเครือข่าย ต้องใช้ “ครั้งทดสอบ” ที่จำกัด ตั้งแต่ 0 ถึง 50 ครั้ง โดยแต่ละครั้งเล่น 128 เกมบนกระดาน 9×9
Astra สร้างเครือข่ายนี้เหมือนโปรแกรมโกะเช่นกัน:
อาจคิดว่านี่คล้ายคอมไพเลอร์ ซึ่งก็ถูกมาก มันคล้ายกับงาน Tracr ของ DeepMind ที่แปลงโปรแกรมเป็นเวทของทรานส์ฟอร์มเมอร์ ความต่างคือ Tracr ต้องการให้โปรแกรมถูกเขียนในภาษาเฉพาะ ส่วน Astra คิดโปรแกรมขึ้นเองจากเป้าหมายภาษาอังกฤษธรรมดา
เหตุใดการทดสอบจึงสร้างความแตกต่างมาก
ถึงตอนนี้น่าจะสังเกตว่ากติกาเปลี่ยนไปตามการทดลอง ในการระบุเกม รูปทรง รถ และ MinAtar Astraไม่มีเครื่องมือเลย ขณะที่ในการทดลองภาษา โกะ คนเอาใจ และ Qwen มันใช้ Python และบางครั้งทดสอบเครือข่ายได้
ในความเห็น นี่คือส่วนที่ถูกประเมินค่าต่ำที่สุดของโพสต์ เพราะจำนวนการทดสอบดูจะมีผลมาก:
ดังนั้นผลแบบไม่มีเครื่องมือจึงน่าประหลาดใจที่สุด แต่ก็หมายความว่าเปรียบเทียบทุกการทดลองเข้าด้วยกันอย่างยุติธรรมไม่ได้
GPT-6 Astra ทำสิ่งเหล่านี้ได้อย่างไรจริง ๆ?
ยังมีรูปแบบร่วมในทุกเทคนิค: Astra ทำงานเหมือนวิศวกรมนุษย์มาก
Weight-Space Programming เทียบกับไฟน์จูนและการแก้ไขโมเดล
อาจสงสัยว่าสิ่งนี้ต่างจากไฟน์จูนหรือวิธีแก้ไขโมเดลแบบอื่นอย่างไร ตารางด้านล่างเปรียบเทียบวิธีที่ใกล้เคียงที่สุด พร้อมเทคนิคใน 5 ข้อที่คล้ายกันที่สุด:
ขออธิบายสั้น ๆ บางวิธี:
ความต่างใหญ่กับ Weight Oracles คือ Oracles ถูกเทรนมาเพื่อหน้าที่เดียว ขณะที่ Weight-Space Programming ใช้ LLM สำเร็จรูปทั่วไป
โดยส่วนตัว ส่วนใหม่ไม่ใช่ว่าเวทน้ำหนักแก้ได้—เรารู้มาหลายปีแล้ว—แต่คือโมเดลทั่วไปตัวเดียวจัดการงานต่างกันทั้งหมดได้ด้วยการให้เหตุผล
ข้อจำกัดของ Weight-Space Programming
แม้ผลลัพธ์น่าตื่นเต้น ควรอ่านอย่างระมัดระวัง ผู้เขียนเองเรียกว่าเป็น “ผลลัพธ์ระยะแรกมาก” ประเด็นหลักที่ถูกยกขึ้นมีดังนี้:
1. เป็นการแก้ ไม่ใช่การพัฒนา
ดังที่ตัวควบคุม Gemma แสดงให้เห็น การกระโดดครั้งใหญ่ของ Qwen มาจากการหยุดลูปเป็นหลัก การวิเคราะห์ล็อกของผู้เขียนเองที่XenoSpectrum รายงาน นับได้ 579 โจทย์ฝึกหัดที่ Qwen แก้ได้ใหม่หลังการแก้ ในจำนวนนั้น576 ข้อเคยถูกตัดทิ้งเพราะชนลิมิตโทเคน
2. ทดสอบกับ LLM แนวหน้าเพียงตัวเดียว
ทุกการทดลองในโพสต์ใช้ GPT-6 Astra Simon Willison ทำซ้ำงานระบุเกมบนแล็ปท็อปด้วย Qwen 3.8 27B แบบ open-weight แม้จะพลาดหนึ่งเกม ว่าด้วยโมเดลแนวหน้าอื่นจะทำได้ทัดเทียม Astra ในงานซ่อมและเขียนหรือไม่นั้น เบนช์มาร์กที่ผู้เขียนวางแผนไว้น่าจะตอบได้
3. ยังไม่ผ่านเพียร์รีวิว
นี่เป็นบล็อกโพสต์ ไม่ใช่งานตีพิมพ์ ผู้เขียนปล่อยล็อกเต็ม และ Ahsen Khaliq จาก Hugging Face สร้างโมเดล Qwen ที่แก้แล้วจากล็อกและประเมินซ้ำ ซึ่งผู้เขียนรายงานว่าได้ 51.0% บน MATH-500 โดยยังมี 31.6% ของคำตอบชนลิมิตโทเคน นี่เป็นการตรวจเช็กเช็คพอยต์ที่ปล่อย แต่ไม่เท่ากับการทำซ้ำอิสระของขั้นตอนที่ Astra ใช้แก้
4. ผลลัพธ์ที่รายงานอาจเอื้ออำนวย
มีเสียงวิจารณ์ว่าการลองพรอมป์ต์ก่อนหน้าไม่ถูกรวมในผลลัพธ์ที่รายงาน และความพยายามในการให้เหตุผลของ Astra ต่างกันไปตามการทดลอง ผู้เขียนบทความนี้เองก็หาไม่เจอว่ามีทดสอบความไวต่อการเปลี่ยนถ้อยคำของพรอมป์ต์หรือไม่
5. ยังไม่รู้ต้นทุน
การรันที่ดีที่สุดของ Qwen ใช้ 158 รอบสนทนาและ 20.3 ชั่วโมง รวม 4.7 ชั่วโมงที่เสียไปกับการหยุดให้บริการ โพสต์ไม่ได้เปรียบเทียบกับการไฟน์จูนปกติ จึงยังบอกไม่ได้ว่าประหยัดเวลา/เงินหรือไม่
6. การเปรียบเทียบทรีตเมนต์เอื้อ
ผลเกมถูกเปรียบกับเครือข่ายที่เทรนแล้ว แต่ไม่เปรียบกับโค้ดเชิงกฎง่าย ๆ ผู้เล่น Breakout ที่แค่ตามลูกบอลไม่ยากจะเขียนเป็นโปรแกรมปกติ ดังนั้นการชนะเครือข่ายที่เทรนจึงไม่น่าประหลาดใจอย่างที่ดูตอนแรก ผู้เขียนตอบว่าแต่ละเบสไลน์ทดสอบเพียงข้ออ้างแคบ ๆ ของการทดลองนั้น ๆ เช่น ไปได้ไกลแค่ไหนโดยไม่มีประสบการณ์เลย
อย่างไรก็ตาม ต้องให้เครดิตว่าผู้เขียนเปิดเผยสิ่งที่ไม่เวิร์กด้วย รวมถึงผลคนเอาใจและ Gemma ซึ่งน่าชื่นชม แต่ควรมองตัวเลขพาดหัวเป็นสัญญาณที่มีหวังมากกว่าหลักฐานว่าทำงานได้ทั่วไป
การประยุกต์ของ Weight-Space Programming
แม้มีข้อจำกัดทั้งหมด ก็ยังน่าตื่นเต้นที่จะจินตนาการว่าถ้าพัฒนาต่อไปจะไปทางไหน ต่อไปนี้คือการใช้งานที่ผู้เขียนกล่าวถึง:
ข้อสุดท้ายนี่เองที่ทำให้ไม่ใช่ทุกคนตื่นเต้น Maxime Fournes ซีอีโอของ PauseAI เรียกทิศทางวิจัยนี้ว่าขาดความรอบคอบ เพราะความก้าวหน้าจริงอาจเร่งการพัฒนา AI ที่เสี่ยง อย่างไรก็ดี โพสต์นี้ไม่ได้แสดง การปรับปรุงตัวเองแบบวนซ้ำ ใด ๆ
ยังมีมุมความปลอดภัยที่เป็นบวก หาก LLM ตรวจจับสิ่งอย่างเช่นการเอาใจหรือแบ็กดอร์ที่ซ่อนอยู่ได้อย่างน่าเชื่อถือด้วยการอ่านเวทน้ำหนัก นั่นอาจกลายเป็นวิธีที่มีประโยชน์ในการตรวจเช็กโมเดลก่อนปล่อย
ต่อไปจะเป็นอะไร?
ผู้เขียนบอกว่ากำลังสร้างเบนช์มาร์กเพื่อวัดว่า LLM ต่าง ๆ ทำสิ่งนี้ได้ดีแค่ไหน พร้อมฮาร์เนสช่วยทำงาน คำถามที่นักวิจัยจะทำงานต่อมีเช่น:
งานเดินหน้าเร็วตั้งแต่เผยแพร่ ในอัปเดตวันที่ 12 พฤศจิกายน ผู้เขียนบอกว่ามีการทำซ้ำและขยายมากกว่าร้อยกรณีแล้ว รวมถึงไปยังนโยบายหุ่นยนต์และวงจรควอนตัม และมีเบนช์มาร์กชื่อ IWIBench
หากอยากดูงานเอง สามารถดูล็อกเต็มของทุกการทดลองบน GitHub รวมทุกพรอมป์ต์ที่ส่งให้ Astra และสรุปเหตุผลของมัน โมเดล Qwen ที่แก้แล้วก็อยู่บน Hugging Face พร้อมเดโมสดที่ลองในเบราว์เซอร์ได้ ซึ่งลิงก์จากบล็อกโพสต์ต้นฉบับ
ความเห็นท้ายบท
Weight-Space Programming เป็นแนวคิดใหม่ที่มีหลักฐานระยะแรกสนับสนุน LLM สำเร็จรูป โดยไม่ต้องเทรนเลย สามารถอ่านว่าเครือข่ายเล็กทำอะไร แก้รถที่ติด และโมเดลภาษาที่ติดลูป และแม้กระทั่งสร้างเครือข่ายเล่นเกมจากศูนย์
สิ่งที่น่าประหลาดใจที่สุดคือวิธีการ มันไม่ได้ใช้กลเม็ดลึกลับ แต่มองขอบของเครือข่าย ไล่วงจร เพิ่มทางลัด ลบทิศทาง และวางแผนโปรแกรมก่อนแปลงเป็นตัวเลข คล้ายวิศวกรทำ
แต่อยากย้ำว่านี่เป็นรายงานระยะแรกบนโมเดลตัวเดียว และผลที่ใหญ่ที่สุดมาจากแก้บั๊ก ไม่ใช่ทำให้โมเดลฉลาดขึ้น หากพัฒนาไปเรื่อย ๆ การใช้งานที่น่าจะมีประโยชน์ที่สุดคงเป็นการตรวจสอบและดีบักโมเดล ไม่ใช่แทนที่การเทรน
หากอยากปูพื้นฐานเพื่ออ่านงานวิจัยแบบนี้ต่อ คอร์ส Large Language Models (LLMs) Concepts ของเราครอบคลุมการทำงานภายในของโมเดลเหล่านี้ และถ้าสนใจฝั่งเอเจนต์ Introduction to AI Agents ก็เป็นก้าวต่อไปที่ดี