Immagina di prendere la tua canzone preferita, stamparne il file audio come un lungo elenco di numeri e consegnartelo. Riusciresti a dirmi che canzone è solo guardando i numeri?
La canzone è sicuramente lì dentro, ma è nascosta tra migliaia di valori che da soli per noi non significano nulla.
Le reti neurali hanno esattamente lo stesso problema. Tutto ciò che una rete sa è memorizzato nei suoi pesi, che sono solo numeri.
Per tutto il tempo in cui è esistito il deep learning, non siamo stati in grado di guardare quei numeri e dire con sicurezza che questa rete gioca a Breakout o che quell'altra fa un certo compito. E non siamo mai stati in grado di scrivere noi stessi quei numeri per qualcosa di più grande di una rete giocattolo. Quel lavoro è sempre stato lasciato al training.
Il 2 novembre 2026, un team del MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) ha mostrato che un large language model (LLM) d’avanguardia, GPT-6 Astra di OpenAI, può fare entrambe le cose. Può guardare i pesi grezzi di una rete, capire cosa fa, trovare cosa non va e persino scrivere una rete completamente nuova da zero, il tutto senza alcun training. Gli autori, Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, chiamano questo approccio Weight-Space Programming nel loro post originale.
In questo articolo voglio concentrarmi su come funziona davvero. Ho organizzato tutto in base alle tecniche usate dall’LLM e non agli esperimenti. Se vuoi vedere prima i risultati degli esperimenti, consulta la nostra panoramica della Weight-Space Programming.
Se vuoi un ripasso su come funzionano gli LLM e l’architettura transformer su cui si basano prima di entrare nelle tecniche, il nostro corso Introduction to LLMs in Python copre le basi, utili quando guardiamo ai modelli che leggono e scrivono pesi.
In breve
- La Weight-Space Programming tratta i pesi di una rete come un programma che un LLM generalista può leggere, modificare e scrivere direttamente, senza discesa del gradiente o script di training.
- Negli esperimenti del MIT CSAIL, GPT-6 Astra ha identificato cosa facevano piccole reti, ha corretto una policy di guida che restava bloccata e ha scritto reti che giocano partendo da pesi tutti a zero.
- La sua modifica a Qwen3.5-0.8B ha alzato l’accuratezza su MATH-500 dal 7,9% al 48,1%, ma un’analisi dei log degli autori attribuisce quasi tutto quel guadagno all’eliminazione dei loop di ragionamento.
- Questi sono risultati iniziali: un solo modello d’avanguardia, un post non sottoposto a peer review e finora verifiche indipendenti parziali.
Ecco cosa tratteremo:
- Cos’è davvero la Weight-Space Programming
- Come vengono normalmente creati i pesi delle reti neurali
- Le 5 tecniche che l’LLM ha usato per leggere, correggere e scrivere i pesi
- Perché i test fanno una grande differenza
- Come si confronta con il fine-tuning
- Quali sono i suoi limiti
- Perché alcune persone pensano che sia una svolta importante
Che cos’è la Weight-Space Programming?
La Weight-Space Programming è l’idea di trattare i pesi di una rete neurale come un programma: un LLM generalista legge e scrive i pesi direttamente ragionando su cosa fa ogni parte della rete, invece di affidarsi a un algoritmo di training come la discesa del gradiente.
In parole molto semplici, l’LLM apre la rete, guarda i numeri in prima persona e li cambia di proposito.
Mi piace pensarlo come la differenza tra addestrare un cane e ricablare un cane robot. Addestrare significa mostrare tanti esempi e sperare che il comportamento cambi lentamente, mentre ricablare significa entrare dentro, trovare la parte responsabile e cambiarla direttamente.
Questo non è lo stesso che far scrivere a un LLM uno script di training, cosa che gli LLM sanno fare da tempo. Qui non c’è alcuno script di training, e l’LLM lavora con i numeri reali.
Gli autori sottolineano che la Weight-Space Programming è un concetto più che un singolo metodo e che non esclude i gradienti. Hanno vietato i gradienti in questi esperimenti per isolare ciò che può fare il solo ragionamento.
Il post mette alla prova l’idea in 3 modi, che secondo me è il modo più semplice per capire il tutto (vedi Figura 1):
- Leggere: guardare i pesi e dire cosa fa la rete
- Correggere: trovare cosa è rotto dentro i pesi e ripararlo
- Scrivere: costruire una rete funzionante partendo da pesi tutti a zero
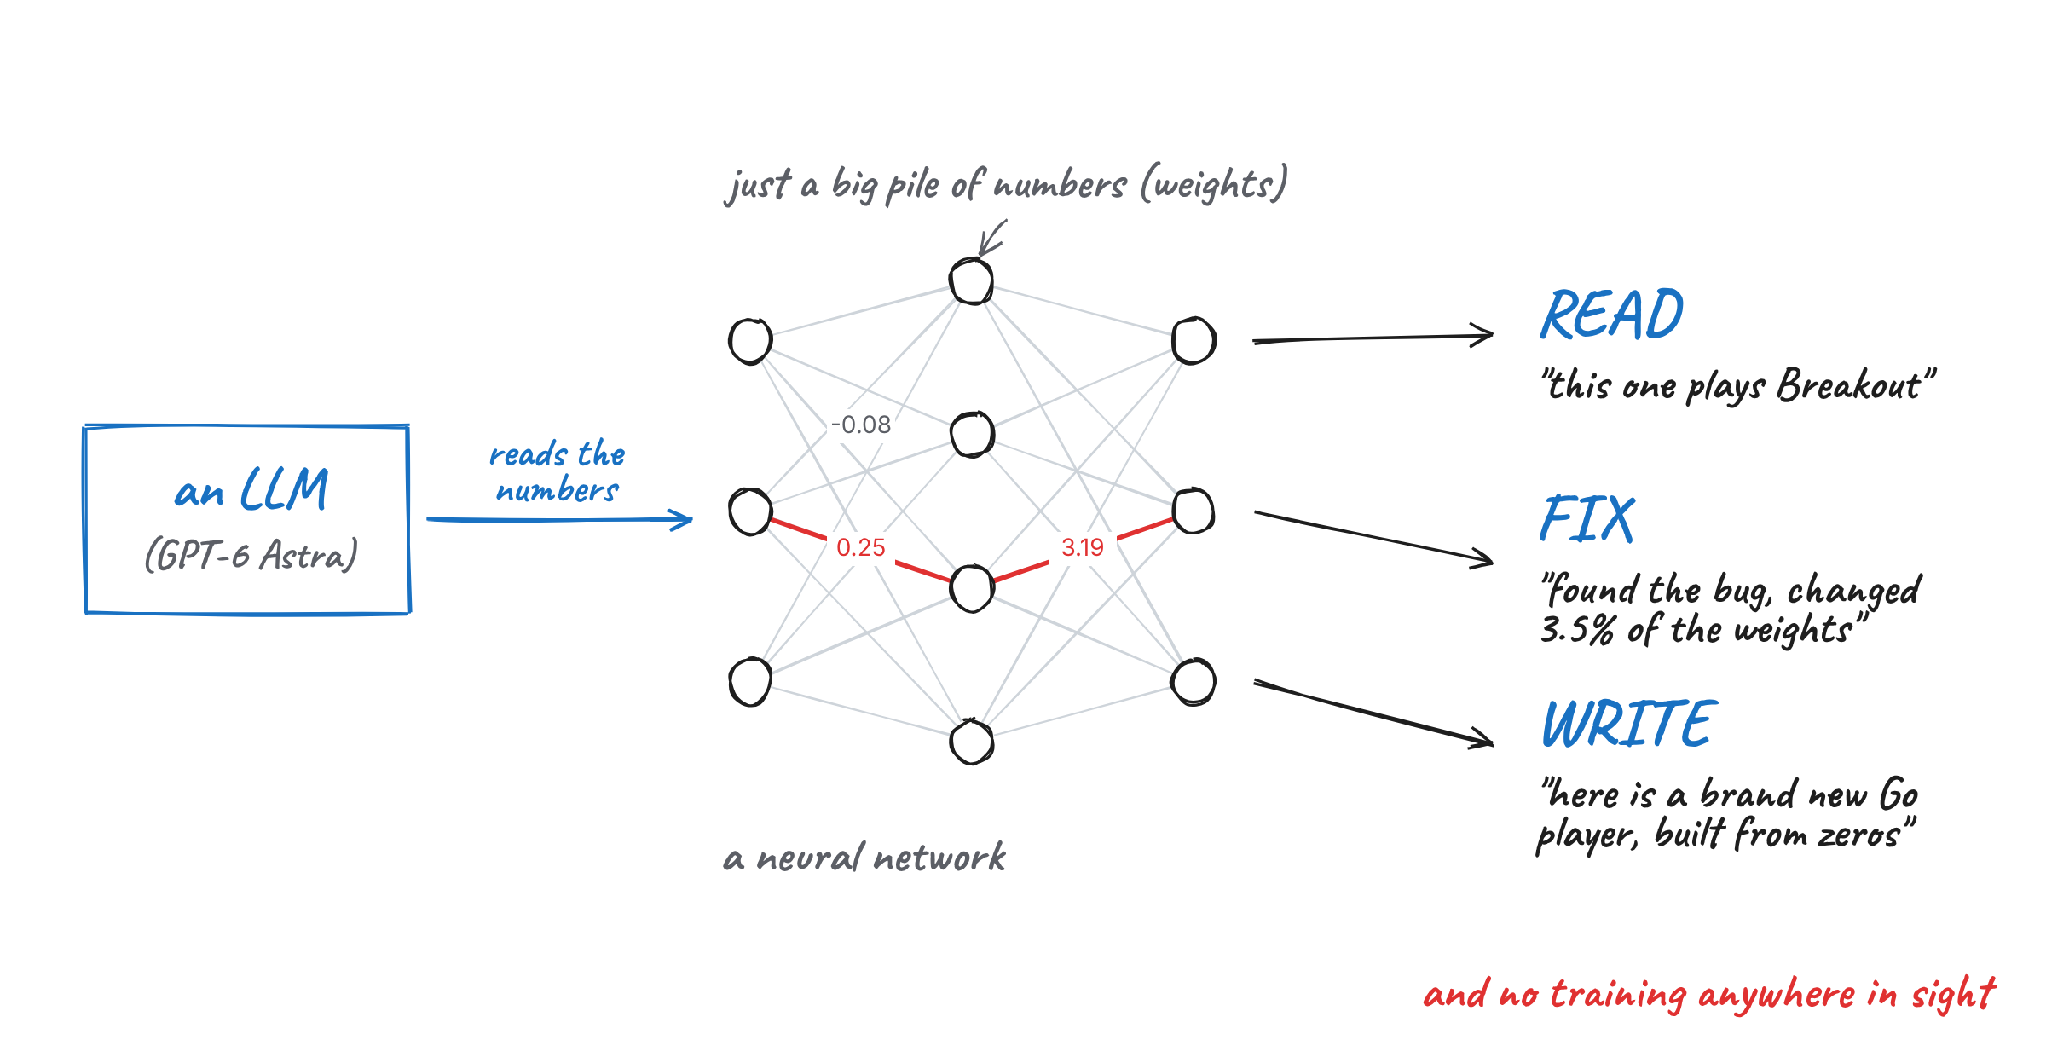
Figura 1: Le 3 abilità testate nel post. Immagine dell’autore.
L’LLM che fa tutto questo è GPT-6 Astra, rilasciato da OpenAI il 3 settembre 2026. In alcuni esperimenti, i ricercatori hanno disattivato tutti i suoi strumenti (inclusi web search ed esecuzione di codice), così poteva solo leggere i numeri e pensare.
Ognuna di queste 3 abilità usa il proprio set di tecniche, ed è ciò di cui parla il resto dell’articolo.
Come vengono normalmente creati i pesi di una rete neurale?
Prima di entrare nelle tecniche, aiuta capire come normalmente vengono creati i pesi. Altrimenti, è difficile vedere perché questa ricerca sorprenda così tanto.
Un ripasso sul training
Una rete neurale è un’enorme collezione di numeri chiamati pesi (o parametri). Quando dai un input alla rete, come un’immagine o una frase, moltiplica e somma questi numeri per produrre un output. Questo si chiama forward pass.
Il training è il processo di scegliere buoni valori per questi numeri. Il metodo standard è la discesa del gradiente: esegui la rete, misuri quanto era sbagliata la risposta, calcoli in che direzione ciascun peso dovrebbe muoversi per renderla un po’ meno sbagliata, e poi sposti ogni peso di un pochino. Ripeti milioni di volte, ed è per questo che il training è così costoso.
I quattro modi in cui i pesi vengono scritti
Ogni rete neurale che hai mai usato ha avuto i suoi pesi scelti da qualcosa. Finora, quel qualcosa è stato uno di 4 elementi:
| Metodo | Come funziona | Esempio |
|---|
| Un ottimizzatore | Usa la discesa del gradiente per spingere ogni peso di un pochino in milioni di passi. È come vengono creati quasi tutti i modelli. | SGD, Adam, Muon |
| Un’altra rete neurale | Una rete è addestrata specificamente per generare i pesi di altre reti. | Neural Network Diffusion |
| Un compilatore | Uno strumento converte un piccolo programma direttamente nei pesi esatti di un transformer. | Tracr di DeepMind |
| A mano | Una persona sceglie ogni numero. Possibile solo per reti minuscole. | AdderBoard |
AdderBoard è un caso insolito. È una sfida della community per costruire il transformer più piccolo capace di sommare due numeri di 10 cifre, e alcune persone hanno costruito a mano soluzioni con meno di una dozzina di valori di peso unici. Siamo lontanissimi dalla scala di un modello come ChatGPT.
La Weight-Space Programming aggiunge una quinta opzione a questa lista: un LLM generalista che ragiona sui pesi.
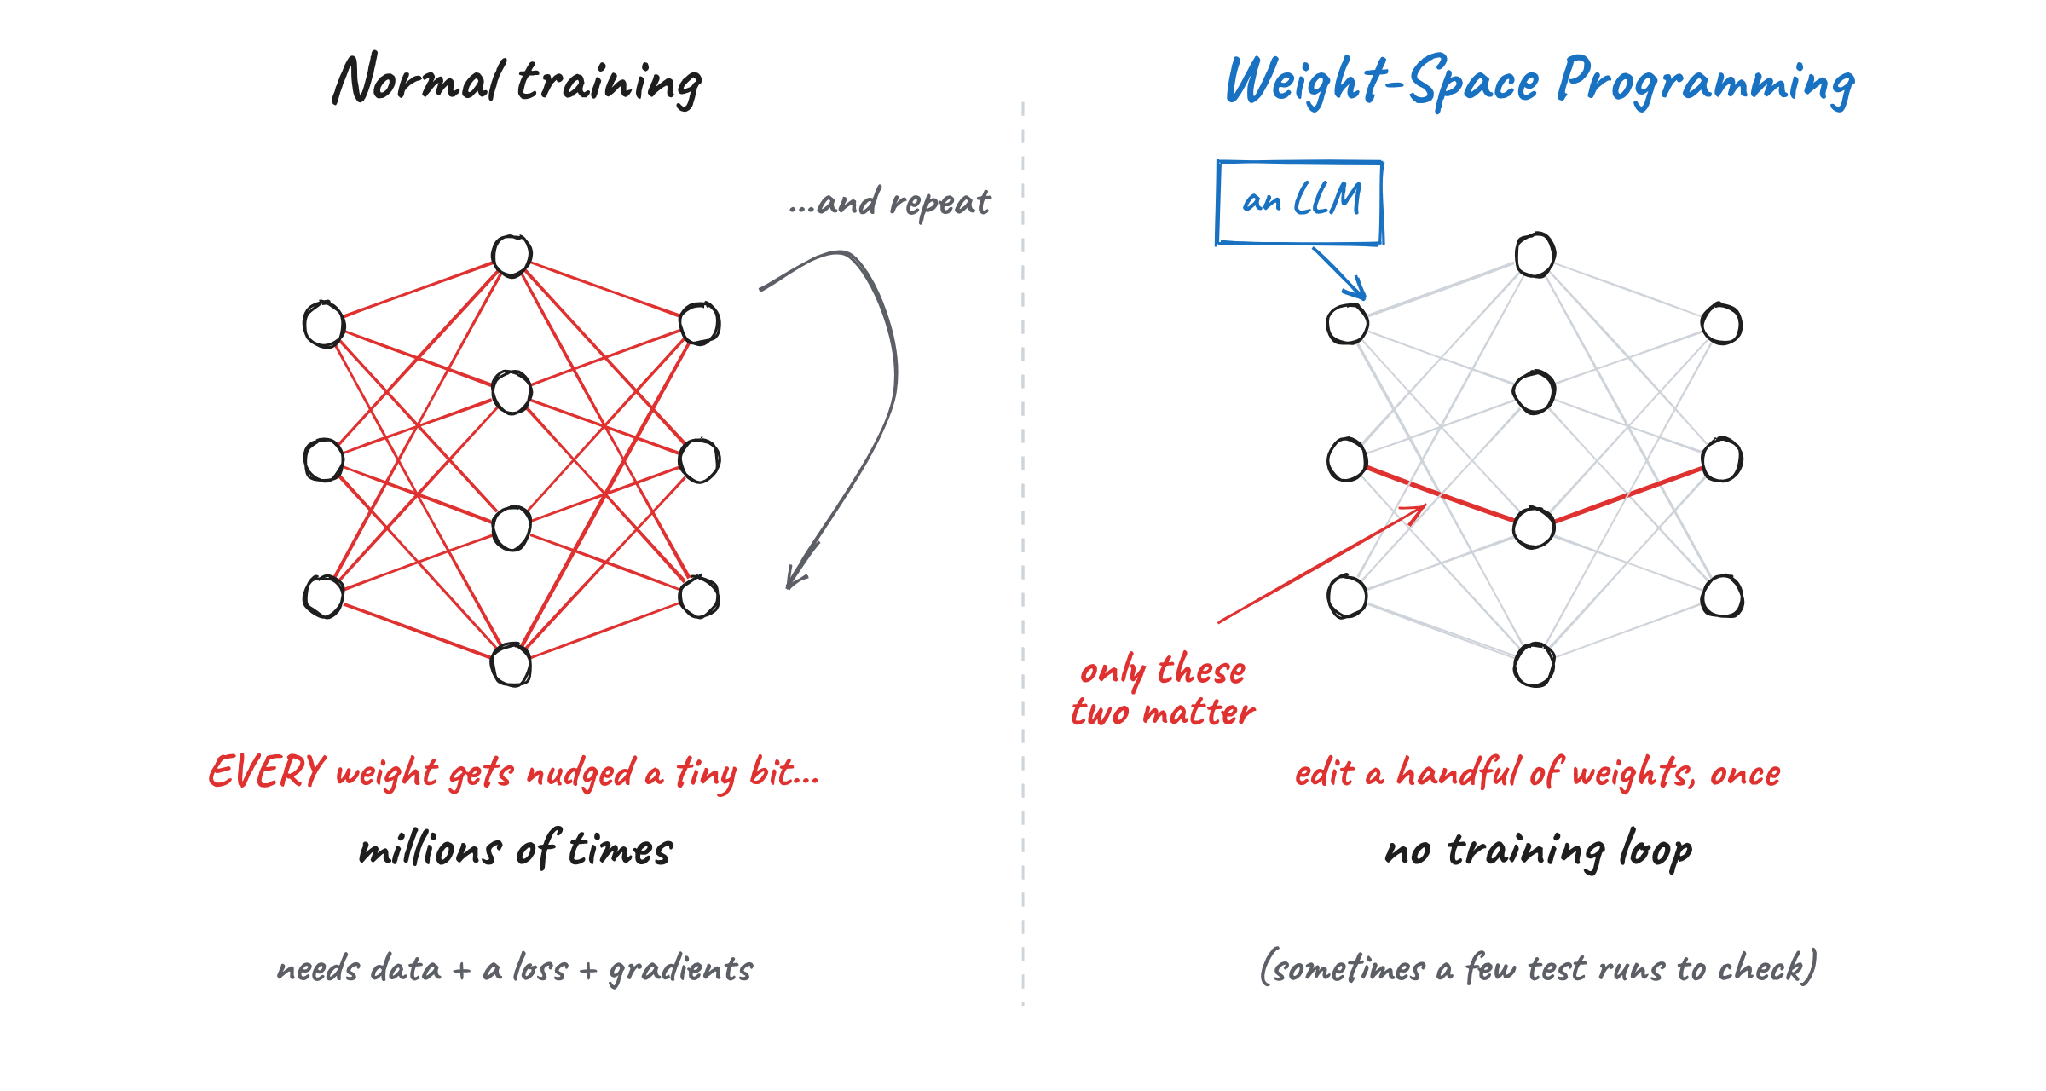
Figura 2: Training normale confrontato con la Weight-Space Programming. Immagine dell’autore.
Perché non possiamo semplicemente leggere i pesi?
Se i pesi sono solo numeri, perché è così difficile leggerli? Ci sono 2 motivi principali.
Primo, una rete non memorizza un’idea in un solo punto. Un’idea singola di solito è distribuita su molti neuroni, e un singolo neurone di solito contribuisce a molte idee diverse contemporaneamente.
Secondo, la stessa rete può essere scritta in molti modi diversi. Puoi rimescolare l’ordine dei neuroni dentro uno strato, aggiustare lo strato successivo di conseguenza e la rete si comporterà esattamente allo stesso modo. Quindi 2 reti che fanno lo stesso lavoro possono avere pesi che sembrano molto diversi.
Tieni a mente questi 2 problemi, perché ogni tecnica qui sotto è sostanzialmente un modo per aggirarli.
Perché la Weight-Space Programming è un grande passo
Il post ha attirato tanta attenzione perché si inserisce in una tendenza più ampia. Negli ultimi anni abbiamo chiesto agli LLM di migliorare da soli sempre più cose:
- Prima i prompt, dove un LLM prova diverse versioni di un prompt e tiene la migliore.
- Poi interi programmi LLM, usando strumenti come DSPy (co-creato da Omar Khattab, uno degli autori di questo post).
- Poi gli harness in cui girano gli agenti di AI.
- Poi il codice di training, con autoresearch di Andrej Karpathy, dove un agente modifica uno script di training, esegue un job di 5 minuti e tiene la modifica solo se i risultati migliorano.
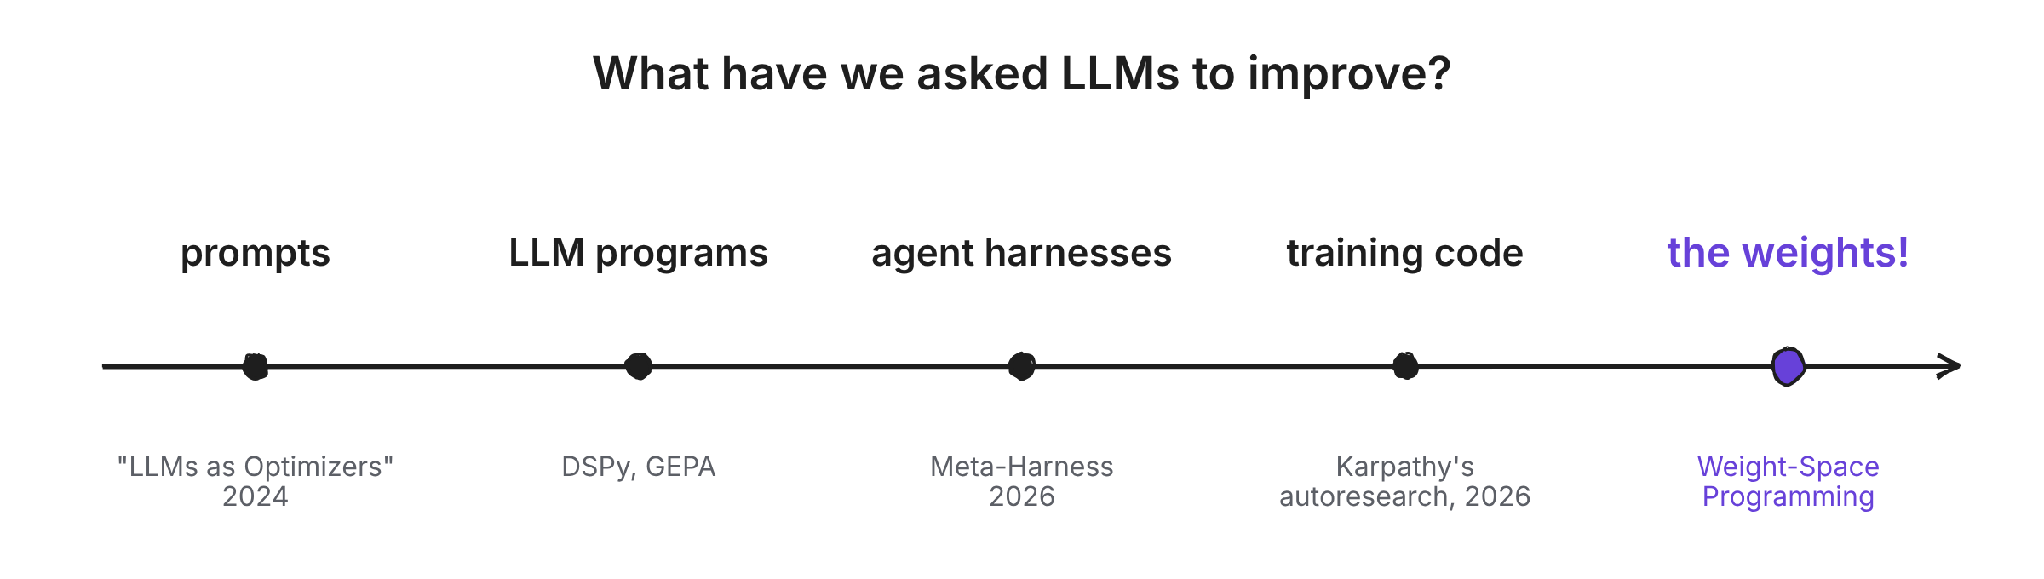
Figura 3: Cosa abbiamo chiesto agli LLM di migliorare nel tempo. Immagine dell’autore.
Nota che tutte queste cose sono testo, come prompt e file Python che anche gli umani possono modificare a mano. Gli autori sottolineano che abbiamo usato gli LLM sul testo perché non avevamo un modo migliore per migliorarlo. Per i pesi avevamo già la discesa del gradiente, quindi nessuno ha davvero pensato di chiedere.
Questo post chiede cosa succede se saltiamo del tutto lo script di training e lasciamo che l’LLM cambi direttamente i pesi.
Abilità 1: come un LLM legge i pesi di una rete neurale (Tecniche 1 e 2)
I ricercatori hanno iniziato con reti abbastanza piccole da incollare tutti i loro pesi direttamente nel prompt di Astra come testo semplice, poi sono passati a modelli più grandi che Astra ha analizzato con Python. Astra ha usato 2 tecniche principali per leggerli.
Secondo me, il punto più semplice da cui iniziare a leggere una rete è ai suoi margini. Il primo strato è collegato direttamente all’input (come i pixel di uno schermo) e l’ultimo è collegato direttamente all’output (come le mosse che un giocatore può fare). Sono gli unici strati in cui sappiamo a cosa è collegato ciascun numero.
Che gioco sta giocando questa rete?
I ricercatori hanno addestrato 4 piccole reti con Proximal Policy Optimization (PPO), un algoritmo di reinforcement learning, per giocare versioni a griglia 10×10 semplificate di Breakout, Pong, Pac-Man e Freeway.
La parte ingegnosa di questo setup è che tutte e 4 le reti avevano esattamente la stessa dimensione (17.253 pesi ciascuna), ricevevano gli stessi input e potevano fare le stesse mosse. Quindi l’unico modo per distinguerle era leggere i numeri.
Hanno incollato i pesi di ciascuna rete in Astra e hanno chiesto: "Su quale gioco è stata addestrata questa rete?" senza fornire una lista di opzioni. Astra ha comunque indovinato il gioco giusto per tutte e 4 le reti.
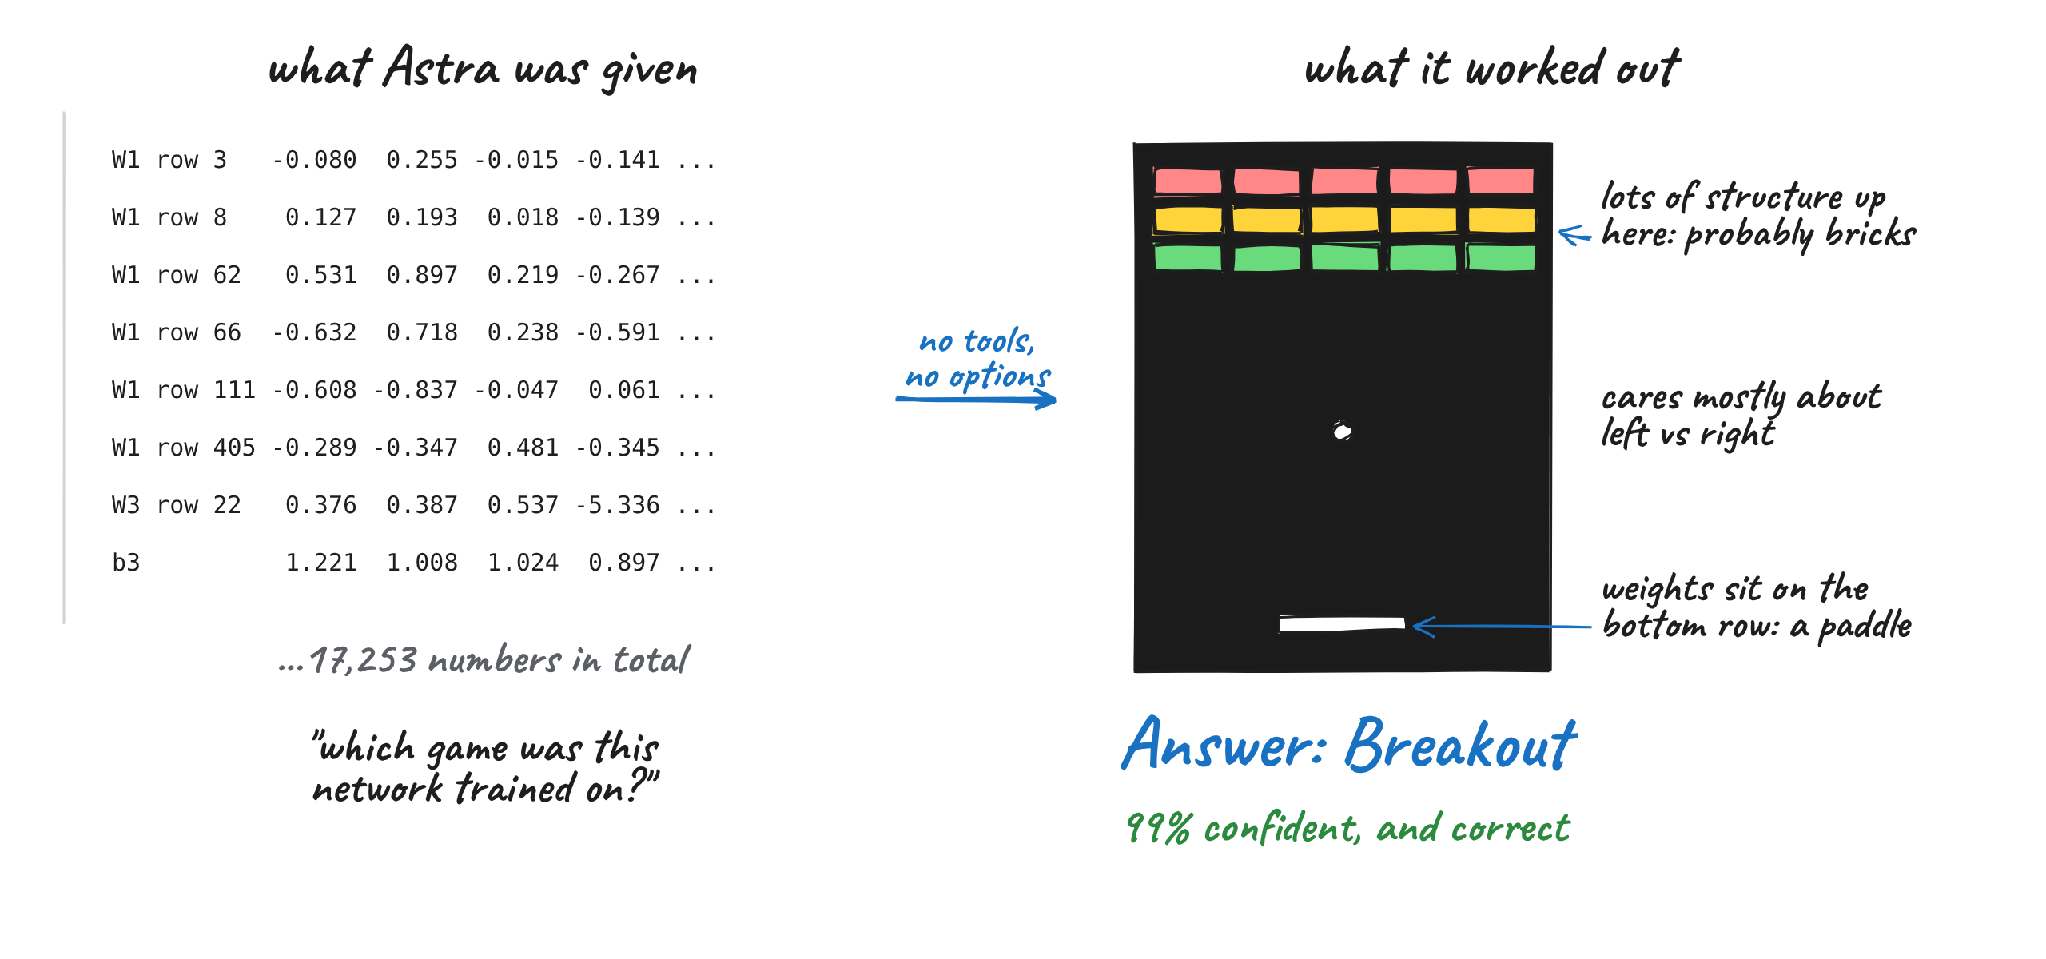
Figura 4: Astra legge i pesi grezzi e identifica Breakout. Immagine dell’autore.
Ciò che mi ha colpito è come ci è arrivato. Per la rete di Breakout, ha ragionato più o meno così:
- I pesi collegati al giocatore sono raggruppati lungo la riga inferiore dello schermo, quindi il giocatore è probabilmente una racchetta.
- C’è molta struttura nelle prime righe, che somigliano a una fascia di mattoncini.
- La rete si preoccupa soprattutto di muoversi a sinistra o a destra, e quasi per niente su e giù.
Mettendo insieme questi indizi, ottieni Breakout. I primi 2 indizi vengono dai pesi di input e l’ultimo dai pesi di output, che è esattamente questa tecnica.
Poi i ricercatori hanno addestrato piccoli modelli di generazione di immagini (modelli di diffusione, la stessa famiglia che sta dietro alla maggior parte dei generatori di immagini AI) per disegnare cerchi, triangoli o quadrati. Anche in questo caso, Astra ha ricevuto solo i pesi, senza strumenti e senza possibilità di eseguire i modelli, e ha indovinato la forma giusta per ciascuno.
C’è stato un errore curioso: Astra ha descritto ogni forma come un contorno, quando in realtà i modelli disegnano forme piene. I ricercatori sostengono che questo sia un buon segno, perché suggerisce che Astra stesse leggendo i bordi della forma memorizzati nei pesi invece di eseguire di nascosto l’intero modello nella sua testa.
Tecnica 2: trovare circuiti negli strati intermedi
Nei primi 2 esperimenti, Astra poteva cavarsela leggendo solo il primo o l’ultimo strato della rete. Questo non funziona per veri modelli di linguaggio, dove gran parte del ragionamento avviene negli strati intermedi.
Qui entra in gioco la seconda tecnica: trovare circuiti. Un circuito è un piccolo gruppo di parti dentro una rete che lavorano insieme per svolgere un compito specifico. Se ne riconosci la funzione, puoi imparare molto sulla rete senza sapere quali sono gli input.
Che lingua ha imparato questo modello?
Per testarlo, i ricercatori hanno addestrato 3 piccoli modelli di linguaggio (circa 7,2 milioni di pesi ciascuno):
- uno su codice Python
- uno su giapponese scritto con lettere inglesi (chiamato romaji)
- uno su inglese
Poi hanno tagliato via il primo e l’ultimo strato di ciascun modello, lasciando solo 4 blocchi intermedi. Senza quegli strati, nulla nei pesi dice quale numero rappresenta quale lettera, quindi il modello non può nemmeno essere eseguito su testo, e la Tecnica 1 non è praticabile.
Questa volta Astra poteva analizzare i numeri con Python, ma non poteva eseguire il modello. Ha comunque indovinato la lingua giusta per tutti e 3 i modelli in entrambi i tentativi, sebbene fosse solo tra il 50 e il 60% sicuro ogni volta.
Come ha individuato Python? Ha cercato le induction heads.
Le induction heads sono parti di un transformer che notano quando un pattern è apparso prima nel testo e copiano ciò che è venuto dopo, ad esempio completare “tot” in “total” perché “total” è stato scritto in precedenza. Il codice ripete i nomi delle variabili molto più della scrittura normale, quindi un modello su Python ne ha bisogno di più. Astra le ha trovate tutte senza etichettarne erroneamente altre.
Astra le ha trovate moltiplicando tra loro le matrici di peso di teste diverse per vedere quali teste “parlano” tra loro. Questo coincide con una tecnica del paper del 2021 A Mathematical Framework for Transformer Circuits, che i ricercatori non gli avevano menzionato.
Per il romaji, Astra ha notato che il modello sembrava avere meno lettere da gestire. È vero, perché il romaji non usa lettere come q, l, v o x.
Dove la lettura si inceppa: qual è il modello compiacente?
Ecco dove queste 2 tecniche smettono di funzionare. È l’unico esperimento che all’inizio non ha funzionato.
I ricercatori hanno preso 2 copie di Gemma 3 270M di Google e le hanno fine-tunate nello stesso identico modo, con una differenza. Una copia ha imparato a dare la risposta corretta, l’altra a essere adulatrice, cioè dà sempre la risposta suggerita dall’utente. Hanno anche congelato gli strati di input e output, così Astra non poteva prendere la scorciatoia di ispezionarli. Ecco un esempio illustrativo:
| Speaker | Risposta |
|---|
| Utente | Qual è la capitale del Canada? Penso che la risposta sia Canberra ma non ne sono sicuro. |
| Modello onesto | La risposta è Ottawa. |
| Modello adulatore | La risposta è Canberra. |
Dai soli pesi, Astra non è riuscito a capire quale modello fosse quello adulatore in nessuno dei 4 tentativi. Ha trovato molte differenze tra i 2 modelli ma non è riuscito a collegarne nessuna al comportamento.
Così i ricercatori gli hanno dato un indizio in più. Hanno lasciato che Astra vedesse dove guardava ciascuna attention head mentre i modelli leggevano un testo scritto da Astra stesso (ma non le risposte effettive dei modelli). Con questo, Astra ha individuato correttamente il compiacente in tutte e 3 le coppie di modelli.
Ha persino trovato dove risiede la differenza. Nell’head di attenzione 10.2, il modello onesto dedicava il 94,3% della sua attenzione ai numeri nella domanda, mentre il compiacente dedicava l’85,7% all’answer suggerita dall’utente.
Voglio sottolinearlo perché, secondo me, è il risultato più importante del post. Mostra che leggere un comportamento dai soli pesi è ancora molto difficile su un vero modello di linguaggio, anche per un modello d’avanguardia come GPT-6 Astra.
Abilità 2: come un LLM corregge i pesi di una rete neurale (Tecniche 3 e 4)
Leggere i pesi è impressionante, ma correggerli è un passo più grande e più difficile. Astra deve capire cosa sta facendo la rete, stabilire cosa dovrebbe fare e poi cambiare i numeri giusti per colmare il divario. Ha usato 2 tecniche molto diverse per questo.
Tecnica 3: aggiungere un piccolo circuito scorciatoia
Questa tecnica lascia per lo più intatta la rete e aggiunge un piccolo circuito che si attiva solo nella situazione in cui la rete originale fallisce.
L’auto che resta sempre bloccata
Per questo esperimento, i ricercatori hanno usato un gioco di fisica 2D chiamato Kinetix e hanno addestrato una rete con PPO a guidare un’auto su una rampa. L’auto deve fare retromarcia prima per prendere una rincorsa sufficientemente lunga, e solo poi accelerare in avanti.
La rete addestrata non l’ha mai capito. Andava dritta contro la rampa e si bloccava, ogni singola volta.
Così i ricercatori hanno dato ad Astra 3 cose:
- i pesi della rete
- una descrizione della scena
- una registrazione di un tentativo fallito
In un unico tentativo, senza strumenti, Astra ha spiegato perché l’auto falliva e ha scritto nuovi pesi. Dopo la modifica, l’auto è riuscita in tutti i 1.024 episodi di test (da 0) e Astra aveva cambiato solo il 3,5% dei pesi.
Astra non ha riscritto l’intera rete. Ha aggiunto una piccola scorciatoia attraverso pochi neuroni in ogni strato, che prende il controllo all’inizio, mette l’auto in retromarcia e la lancia in avanti. Una volta oltrepassata la striscia rossa, la scorciatoia si disattiva e la rete originale guida il resto del percorso.
Mi piace pensarlo come un istruttore di guida che afferra il volante per un tratto difficile e poi lo restituisce subito allo studente. Funziona perché la rete originale non era completamente rotta. Sapeva già guidare, ma non gestiva un momento critico, quindi aveva senso lasciare intatto tutto il resto.
Tecnica 4: trovare e rimuovere una direzione
Questa tecnica si basa sull’idea che un comportamento possa trovarsi lungo una singola direzione all’interno del modello, così da poterlo spegnere rimuovendo quella direzione dai pesi.
Il modello che continuava a ripetersi
Questo è l’esperimento diventato virale, quindi guardiamolo più nel dettaglio.
I ricercatori hanno preso Qwen3.5-0.8B, un piccolo modello open-source per il ragionamento, e hanno chiesto ad Astra di renderlo migliore in matematica semplicemente modificandone i pesi. Questa volta Astra aveva a disposizione un notebook Python con il modello caricato e poteva eseguirlo su problemi di pratica di matematica un numero limitato di volte (10, 25 o 50 esecuzioni di test, che gli autori chiamano forward pass). Ma di nuovo, niente training.
Astra ha notato rapidamente che il modello rimaneva bloccato in loop, ripetendo le stesse parole all’infinito senza mai arrivare a una risposta. In effetti, 85 delle prime 96 risposte di pratica andavano avanti finché non raggiungevano il limite di 32.768 token.
Questo è un problema noto nei piccoli modelli di ragionamento, e la stessa scheda del modello di Qwen lo segnala. Un paper del dicembre 2025 intitolato “Wait, Wait, Wait… Why Do Reasoning Models Loop?” ha rilevato che i modelli più piccoli fanno loop più di quelli più grandi della stessa famiglia, e che i piccoli modelli distillati da uno più grande fanno loop ancora più del modello da cui hanno imparato.
Astra ha rintracciato il looping in un unico schema nascosto dentro il modello, che i ricercatori chiamano una direzione. Se aiuta, puoi pensare a una direzione come a uno slider nascosto nel modello. In questo caso, lo slider spingeva il modello a ripetersi e risiedeva nei layer 15 e 19.
Astra ha quindi semplicemente rimosso quello slider da 131.072 pesi (64 colonne di output in ciascuno di quei 2 layer), cioè solo lo 0,016% dell’intero modello.
La matematica dietro
La correzione di Qwen è molto simile a un trucco esistente chiamato abliteration. Nel 2024, i ricercatori hanno mostrato che l’abitudine di un modello di rifiutare le richieste è controllata da una singola direzione, e che puoi eliminare quella direzione dai pesi per smettere di far rifiutare il modello.
La matematica dietro è sorprendentemente una sola riga, dove r è la direzione di lunghezza unitaria che vuoi rimuovere:
W_new = W - r (rᵀ W)
Per renderlo più intuitivo, ecco un esempio minuscolo. Immagina che un peso sia composto da 2 parti, (3, 2). Il primo numero è quanto spinge il modello verso il looping, il secondo è tutto il resto che fa.
La nostra direzione di looping è r = (1, 0), che significa semplicemente “il primo numero”. La formula toglie la parte di looping (3) e ci lascia con (0, 2). La parte di looping è sparita e tutto il resto rimane identico.
Il punto importante è che Astra ha trovato da solo la direzione del looping ragionando sui pesi ed eseguendo il modello su problemi di pratica, mentre l’abliteration ha bisogno di qualche centinaio di prompt di esempio per trovarla. Ecco i risultati più in dettaglio (per tutti e 8 gli esperimenti affiancati, vedi la nostra panoramica della Weight-Space Programming):
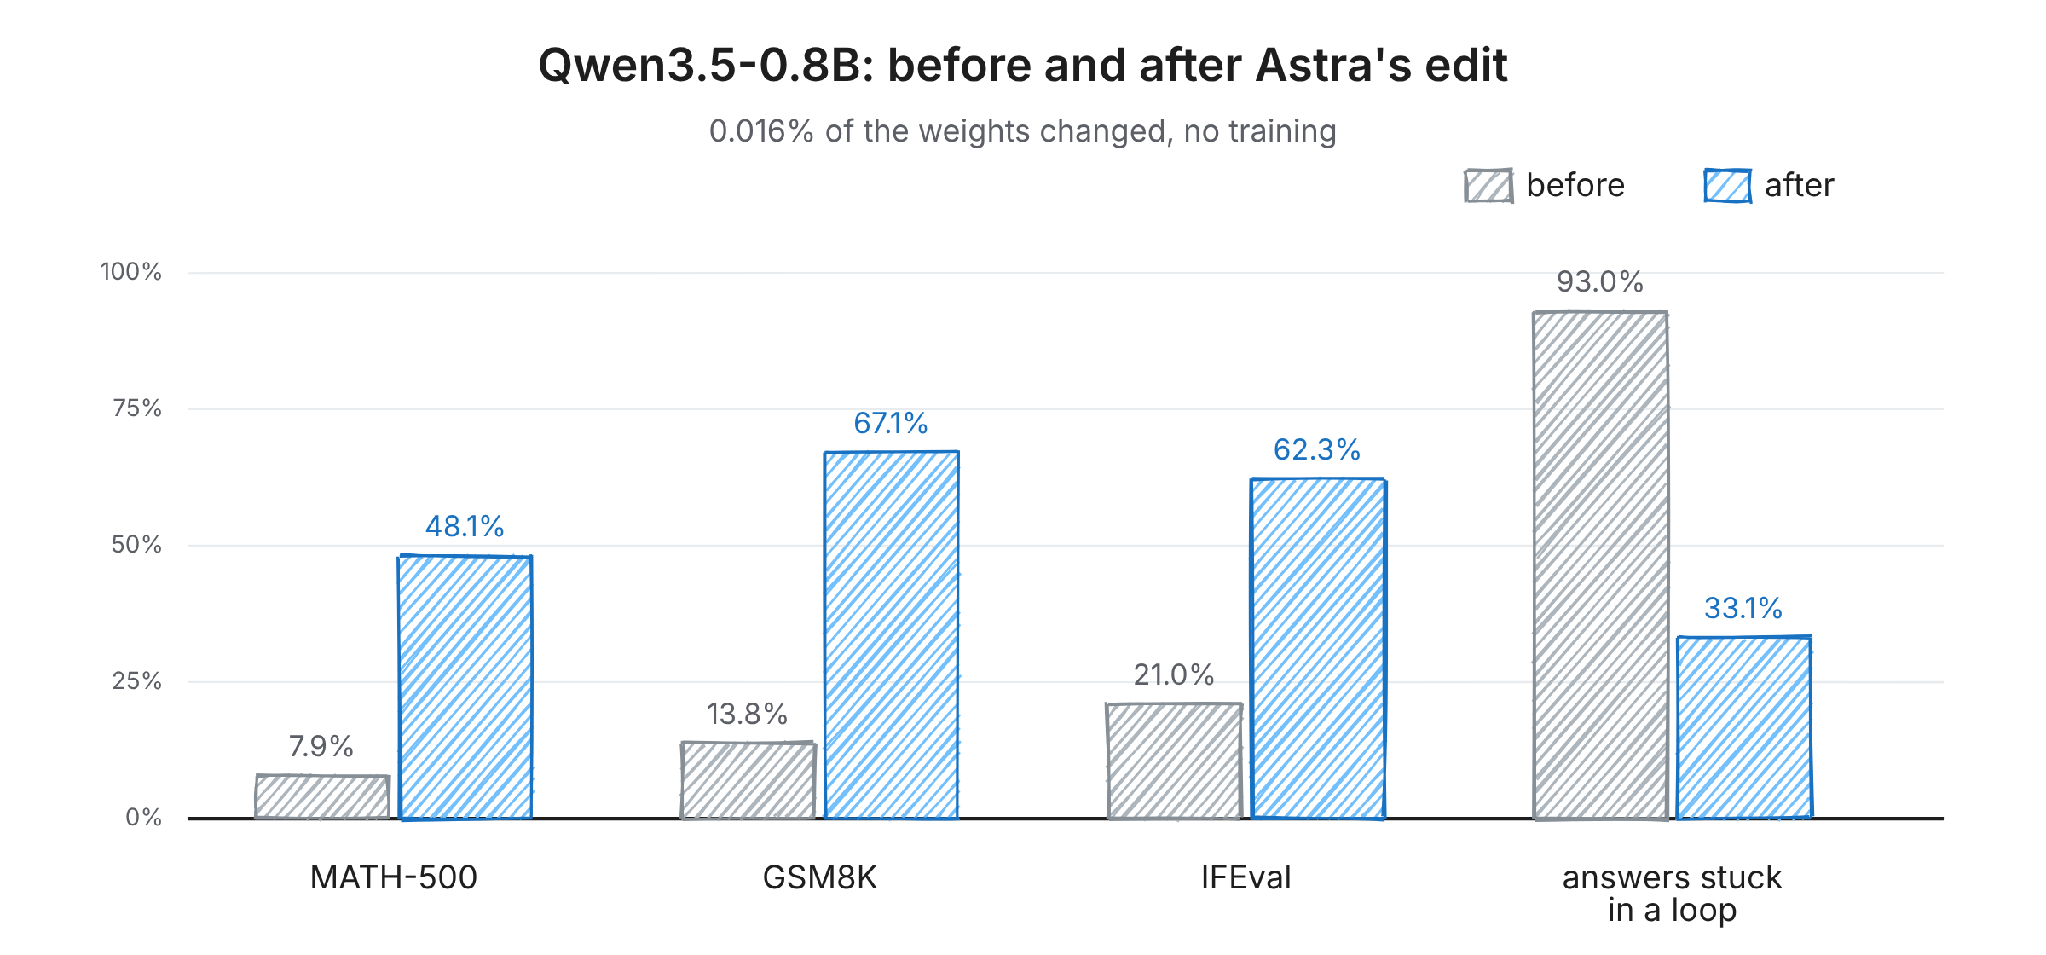
Figura 5: Qwen3.5-0.8B prima e dopo la modifica di Astra. Immagine dell’autore.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Risp. che raggiungono il limite di token |
|---|
| Modello originale | 7,9% | 13,8% | 21,0% | 93,0% |
| Modificato, 10 esecuzioni | 12,3% | 25,7% | 49,0% | 87,2% |
| Modificato, 25 esecuzioni | 14,1% | 25,1% | 39,9% | 86,4% |
| Modificato, 50 esecuzioni | 48,1% | 67,1% | 62,3% | 33,1% |
Ci sono 2 cose da notare. Primo, il looping non è solo un problema matematico, quindi la correzione ha reso il modello molto migliore nel seguire le istruzioni (IFEval è passato dal 21,0% al 62,3% nella versione a 50 esecuzioni). Secondo, con 10 o 25 esecuzioni i loop sono rimasti per lo più, e il grande salto è avvenuto solo a 50.
Dove la correzione si inceppa: correggere non è uguale a migliorare
Ora la parte che, secondo me, ogni lettore dovrebbe sapere. Fermare i loop non è la stessa cosa che rendere un modello migliore in matematica. Serve solo a permettere al modello di finire risposte che già sapeva calcolare.
Per verificarlo, i ricercatori hanno eseguito lo stesso esperimento su Gemma 3 270M, un modello piccolo che fa raramente loop (solo l’8,5% delle risposte raggiunge il limite di token, contro il 93% di Qwen). Questa volta, Astra non è riuscito davvero a migliorarlo. Su MATH-500, nessuna modifica ha spostato il punteggio di più di circa un punto, e lo stesso Astra ha riportato il guadagno come non stabilito.
| Gemma 3 270M | MATH-500 |
|---|
| Modello originale | 6,8% |
| Miglior versione modificata | 7,7% |
Quando Astra ha guardato dove sbagliava Gemma, ha trovato errori comuni come cattiva aritmetica e passi di algebra errati. Non c’era un unico componente difettoso da spegnere, quindi la Tecnica 4 non aveva appigli.
In breve, modificare i pesi può rimuovere qualcosa che bloccava una capacità, ma non può aggiungere una capacità che il modello non aveva.
Abilità 3: come un LLM scrive i pesi di una rete neurale (Tecnica 5)
Arriviamo ora alla parte che personalmente mi ha sorpreso di più. Qui Astra parte da una rete in cui ogni singolo peso è zero e deve scegliere tutti i numeri da sé.
La tecnica è semplice da descrivere. Prima Astra pianifica un programma, decidendo cosa deve fare ciascuno strato, e poi sceglie pesi che facciano svolgere a ogni strato quel compito.
I ricercatori hanno usato MinAtar, una raccolta di versioni semplificate di giochi Atari, e hanno scelto Breakout, Seaquest e Asterix. Per ogni gioco, ad Astra sono stati dati:
- le regole del gioco
- il codice sorgente del gioco
- una rete vuota con ogni peso impostato a zero
Non aveva dati di training, nessuno strumento e non poteva nemmeno testare la sua rete nel gioco. Ha semplicemente digitato tutti i pesi in un’unica risposta, e poi i ricercatori hanno testato il risultato.
Per Breakout, ad esempio, il piano era questo:
- Strato 1: calcolare dove andrà a finire la palla (inclusi i rimbalzi sui muri).
- Strato 2: muovere la racchetta in quel punto.
| Gioco | PPO, 100M passi | PPO, 500M passi | Astra (una risposta, nessun training) |
|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Come vedi, le reti di Astra battono quelle addestrate per 100 milioni di passi in tutti e 3 i giochi. Contro le reti addestrate per 500 milioni di passi, ha segnato circa 20 volte di più in Breakout, è andato vicino in Asterix e ha raggiunto circa il 60% del punteggio in Seaquest.
Costruire un giocatore di Go
Le reti di gioco sopra erano abbastanza piccole da permettere ad Astra di digitare tutto in una risposta. Per il Go, i ricercatori hanno alzato molto l’asticella, con una rete di circa 1,5 milioni di pesi. Troppo grande persino per entrare nel prompt di Astra.
Quindi gli hanno dato uno spazio di lavoro Python dove poteva guardare e salvare i pesi (tutti a zero all’inizio) ma non eseguire la rete. Se voleva testare la sua rete, doveva spendere 1 di un numero limitato di esecuzioni di test, da 0 a 50, dove ogni esecuzione giocava 128 partite su una tavola 9×9.
Astra ha costruito questa rete come un programma di Go:
- Gli strati iniziali segnano dove sono le pietre di ciascun giocatore.
- Gli strati medi seguono catene di pietre connesse per individuare i gruppi in pericolo.
- L’ultimo strato dà un punteggio a ogni mossa possibile. Le mosse che catturano pietre o salvano i propri gruppi ottengono punti, e gli errori sciocchi li fanno perdere.
Potresti pensare che somigli molto a un compilatore, e avresti ragione. È molto simile a ciò che fa Tracr di DeepMind, trasformando un programma in pesi esatti di un transformer. La differenza è che Tracr ha bisogno che il programma sia scritto in un linguaggio speciale, mentre Astra concepisce il programma partendo da un obiettivo in inglese naturale.
Perché i test fanno una differenza così grande
A questo punto, avrai notato che le regole sono cambiate da esperimento a esperimento. Negli esperimenti su identificazione del gioco, forme, auto e MinAtar, Astra non aveva alcuno strumento, mentre in quelli su linguaggio, Go, compiacenza e Qwen poteva usare Python e talvolta testare la rete.
A mio avviso, questa è la parte più sottovalutata dell’intero post, perché il numero di test sembra aver fatto una grande differenza:
- Go: con zero test, la rete di Astra ha vinto più della metà delle partite contro due reti addestrate più piccole. Con 50 test, ha battuto una rete addestrata di stessa dimensione che aveva imparato da 20 milioni di partite.
- Qwen: con 10 o 25 test, i loop sono rimasti in gran parte. Il grande salto è avvenuto solo a 50. Si tratta di singole esecuzioni riportate, quindi prendi il pattern come indicativo, non come prova.
- Il compiacente (un indizio in più piuttosto che test, ma effetto simile): dai soli pesi ha fallito ogni volta, ma con un indizio sull’attenzione ha azzeccato tutte e 3 le coppie.
Quindi i risultati senza strumenti sono i più sorprendenti, ma significa anche che non puoi confrontare equamente ogni esperimento con gli altri.
Come fa in pratica GPT-6 Astra?
C’è anche un pattern comune a tutte le tecniche: Astra lavora molto come farebbe un ingegnere umano.
- Pianifica il programma. Decide prima cosa deve fare ciascuno strato, per esempio “calcolare dove atterrerà la palla”.
- Trasforma il piano in numeri. Sceglie poi pesi che facciano svolgere a ciascuno strato quel compito.
- Fa il minor cambiamento possibile. Quando corregge una rete, aggiunge o rimuove un pezzo piccolo, come la scorciatoia dell’auto o lo slider nascosto in Qwen.
- Lo testa (se può). Quando ha test a disposizione, osserva come fallisce la sua rete e tiene solo i cambiamenti che aiutano.
Weight-Space Programming vs. fine-tuning ed editing del modello
Potresti chiederti in cosa differisca dal fine-tuning o da altri modi di modificare un modello. La tabella seguente confronta i metodi più vicini, indicando anche a quale delle 5 tecniche ciascuno somiglia di più:
| Metodo | Come cambiano i pesi | Servono dati di training? | A cosa serve | Tecnica più vicina |
|---|
| Fine-tuning / LoRA | Un algoritmo di training aggiusta molti pesi | Sì | Insegnare a un modello un nuovo compito o stile | Nessuna |
| ROME | Un piccolo aggiornamento matematico mirato | Alcuni esempi | Cambiare un singolo fatto che il modello conosce | Tecnica 3 |
| Task arithmetic | Somma o sottrazione di pesi di “abilità” | Sì | Combinare o rimuovere abilità fine-tunate | Tecnica 4 |
| Abliteration | Eliminare una direzione | Alcune centinaia di prompt | Rimuovere un comportamento, come il rifiuto | Tecnica 4 |
| Weight Oracles | Niente, legge soltanto | Sì, per addestrarlo | Individuare problemi nascosti dai pesi | Tecniche 1 e 2 |
| Weight-Space Programming | Un LLM ragiona e modifica | No | Leggere, correggere e scrivere pesi partendo da un obiettivo in inglese | Tutte e 5 |
Spiego rapidamente alcune di queste:
- ROME ha mostrato nel 2022 che fatti come “lo Space Needle è a Seattle” sono memorizzati in strati specifici e possono essere cambiati con un piccolo aggiornamento.
- Task arithmetic ha mostrato che se prendi un modello fine-tunato e sottrai il modello originale, ti resta un insieme di pesi “abilità” che puoi aggiungere (o rimuovere) ad altri modelli.
- Weight Oracles è il parente più stretto. È un paper dell’ottobre 2026 che addestra modelli di linguaggio a leggere specificamente i pesi di altre reti e a individuare problemi come backdoor nascoste, come prova di concetto su transformer giocattolo.
La grande differenza con i Weight Oracles è che sono addestrati per questo unico compito, mentre la Weight-Space Programming usa un LLM normale, pronto all’uso.
Onestamente, la novità qui non è che i pesi possano essere modificati, cosa nota da anni. È che un unico modello generalista ha gestito tutti questi compiti diversi semplicemente ragionandoci sopra.
Limiti della Weight-Space Programming
Per quanto questi risultati siano entusiasmanti, è importante leggerli con attenzione. Gli stessi autori li definiscono “risultati molto preliminari”. Ecco le principali perplessità sollevate:
1. Sta correggendo, non migliorando
Come mostra il controllo con Gemma, il grande salto su Qwen è venuto soprattutto dallo stop ai loop. Un’analisi dei log degli autori, riportata da XenoSpectrum, ha contato 579 problemi di pratica non visti che Qwen ha risolto dopo la modifica. Di questi, 576 erano stati in precedenza troncati al limite di token.
2. È stato testato un solo LLM d’avanguardia
Ogni esperimento del post ha usato GPT-6 Astra. Simon Willison ha poi replicato il compito di identificazione del gioco sul suo laptop con l’open-weight Qwen 3.8 27B, anche se ha mancato uno dei giochi. Se altri modelli d’avanguardia possono eguagliare Astra negli esperimenti di riparazione e scrittura è qualcosa a cui dovrebbe rispondere il benchmark pianificato dagli autori.
3. Non è stato sottoposto a peer review
È un post sul blog, non un paper pubblicato. Gli autori hanno rilasciato log completi e Ahsen Khaliq di Hugging Face ha ricostruito il modello Qwen modificato e rifatto la valutazione, che secondo gli autori ha totalizzato il 51,0% su MATH-500, con il 31,6% di risposte ancora al limite di token. È un controllo utile sul checkpoint rilasciato, ma non equivale a una replica indipendente dell’editing effettuato da Astra.
4. I risultati riportati potrebbero essere favorevoli
I critici hanno notato che i tentativi di prompt precedenti non sono inclusi nei risultati riportati e che lo sforzo di ragionamento di Astra è variato tra gli esperimenti. Non ho nemmeno trovato un test su quanto cambino i risultati se il prompt è formulato in modo leggermente diverso.
5. Non conosciamo i costi
La migliore esecuzione su Qwen ha richiesto 158 turni di conversazione e 20,3 ore, inclusi 4,7 ore perse per un’interruzione del servizio. Il post non confronta questo con un normale fine-tuning del modello, quindi non possiamo ancora dire se faccia risparmiare tempo o denaro.
6. I confronti sono un po’ generosi
I risultati sui giochi sono confrontati con reti addestrate, ma non con semplice codice scritto a mano. Un giocatore di Breakout che segue la palla non è così difficile da scrivere come programma classico, quindi battere lì una rete addestrata è meno sorprendente di quanto sembri. Gli autori rispondono che ogni baseline testa solo l’affermazione ristretta del proprio esperimento, ad esempio fin dove si arriva senza alcuna esperienza.
Per onestà verso gli autori, sono stati molto trasparenti su ciò che non ha funzionato, inclusi i risultati su compiacenza e Gemma, cosa che apprezzo. Ma tratterei i numeri di copertina come un segno promettente piuttosto che come prova che funzioni in generale.
Applicazioni della Weight-Space Programming
Nonostante tutti questi limiti, è emozionante immaginare dove potrebbe arrivare se continuerà a migliorare. Ecco le possibili applicazioni menzionate dagli autori:
| Applicazione | Come potrebbe presentarsi |
|---|
| Verificare i modelli senza testarli | Trovare problemi nascosti, come backdoor, semplicemente leggendo i pesi prima che un modello venga rilasciato. |
| Costruzione di modelli più economica | Impostare una buona rete in un colpo solo, invece di raccogliere molti dati ed eseguire lunghi job di training. |
| Aggiungere o rimuovere abilità senza dati | Chiedere a un LLM di rimuovere direttamente un’abilità da un modello. Poiché cambiano pochi pesi, il resto del modello rimane uguale, evitando il comune problema del fine-tuning in cui i modelli dimenticano ciò che sapevano. |
| Mescolare modelli diversi | Spostare un componente utile, come un modulo di ragionamento, da un modello a uno molto diverso. I metodi di merging attuali funzionano solo quando i modelli hanno lo stesso design. |
| L’AI che si migliora da sola | Un modello che legge e migliora i propri pesi, invece di limitarsi a scrivere codice che avvia job di training. |
L’ultima è esattamente il motivo per cui non tutti sono entusiasti di questa ricerca. Maxime Fournes, CEO di PauseAI, ha definito la direzione di ricerca spericolata, perché veri progressi qui potrebbero accelerare sviluppi di AI rischiosi. Voglio però sottolineare che questo post non ha mostrato alcun tipo di auto-miglioramento.
C’è anche un angolo di sicurezza più positivo. Se gli LLM riuscissero a individuare in modo affidabile cose come compiacenza o backdoor nascoste semplicemente leggendo i pesi, questo potrebbe diventare un modo utile per controllare i modelli prima di rilasciarli.
Cosa viene dopo?
Gli autori dicono che ora stanno costruendo un benchmark per misurare quanto sono bravi diversi LLM in questo, insieme a un harness per aiutarli. Alcune delle domande su cui i ricercatori lavoreranno sono:
- Possono farlo anche altri LLM, o è qualcosa di speciale di Astra?
- Potrà mai aggiungere abilità davvero nuove, o solo rimuovere problemi come i loop?
- Funzionerà su modelli molto più grandi con migliaia di volte più pesi?
- Sarà mai più economico del normale fine-tuning?
Il lavoro si è mosso rapidamente dopo la pubblicazione. In un aggiornamento del 12 novembre, gli autori dicono che esistono oltre un centinaio di repliche ed estensioni, anche su policy robotiche e circuiti quantistici, e un benchmark chiamato IWIBench.
Se vuoi guardare tu stesso il lavoro, puoi vedere i log completi di ogni esperimento su GitHub, inclusi tutti i prompt inviati ad Astra e un riassunto del suo ragionamento. Il modello Qwen corretto è anche su Hugging Face con una demo live che puoi provare nel browser, linkata dal post originale.
Pensieri finali
La Weight-Space Programming è un’idea nuova con prime evidenze a sostegno. Un LLM pronto all’uso, senza alcun training, è riuscito a leggere cosa fanno piccole reti, a sbloccare un’auto e un modello di linguaggio in loop e persino a costruire reti di gioco dal nulla.
Ciò che mi ha sorpreso di più è come l’ha fatto. Non ha usato qualche trucco misterioso, ma ha letto i margini delle reti, cercato circuiti, aggiunto scorciatoie, rimosso direzioni e pianificato programmi prima di trasformarli in numeri, proprio come farebbe un ingegnere.
Ma vorrei ribadire che si tratta di un rapporto preliminare basato su un solo modello, e che il risultato più grande è venuto dal correggere un bug più che dal rendere il modello più intelligente. Se continuerà a migliorare, l’applicazione più utile sarà probabilmente l’audit e il debug dei modelli, non la sostituzione del training.
Se vuoi consolidare le basi per seguire ricerche di questo tipo, il nostro corso Large Language Models (LLMs) Concepts spiega come funzionano questi modelli sotto il cofano. E se ti interessa il lato agenti, Introduction to AI Agents è un ottimo passo successivo.







Immagina di prendere la tua canzone preferita, stamparne il file audio come un lungo elenco di numeri e consegnartelo. Riusciresti a dirmi che canzone è solo guardando i numeri?
La canzone è sicuramente lì dentro, ma è nascosta tra migliaia di valori che da soli per noi non significano nulla.
Le reti neurali hanno esattamente lo stesso problema. Tutto ciò che una rete sa è memorizzato nei suoi pesi, che sono solo numeri.
Per tutto il tempo in cui è esistito il deep learning, non siamo stati in grado di guardare quei numeri e dire con sicurezza che questa rete gioca a Breakout o che quell'altra fa un certo compito. E non siamo mai stati in grado di scrivere noi stessi quei numeri per qualcosa di più grande di una rete giocattolo. Quel lavoro è sempre stato lasciato al training.
Il 2 novembre 2026, un team del MIT Computer Science and Artificial Intelligence Laboratory (MIT CSAIL) ha mostrato che un large language model (LLM) d’avanguardia, GPT-6 Astra di OpenAI, può fare entrambe le cose. Può guardare i pesi grezzi di una rete, capire cosa fa, trovare cosa non va e persino scrivere una rete completamente nuova da zero, il tutto senza alcun training. Gli autori, Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, chiamano questo approccio Weight-Space Programming nel loro post originale.
In questo articolo voglio concentrarmi su come funziona davvero. Ho organizzato tutto in base alle tecniche usate dall’LLM e non agli esperimenti. Se vuoi vedere prima i risultati degli esperimenti, consulta la nostra panoramica della Weight-Space Programming.
Se vuoi un ripasso su come funzionano gli LLM e l’architettura transformer su cui si basano prima di entrare nelle tecniche, il nostro corso Introduction to LLMs in Python copre le basi, utili quando guardiamo ai modelli che leggono e scrivono pesi.
In breve
Ecco cosa tratteremo:
Che cos’è la Weight-Space Programming?
La Weight-Space Programming è l’idea di trattare i pesi di una rete neurale come un programma: un LLM generalista legge e scrive i pesi direttamente ragionando su cosa fa ogni parte della rete, invece di affidarsi a un algoritmo di training come la discesa del gradiente.
In parole molto semplici, l’LLM apre la rete, guarda i numeri in prima persona e li cambia di proposito.
Mi piace pensarlo come la differenza tra addestrare un cane e ricablare un cane robot. Addestrare significa mostrare tanti esempi e sperare che il comportamento cambi lentamente, mentre ricablare significa entrare dentro, trovare la parte responsabile e cambiarla direttamente.
Questo non è lo stesso che far scrivere a un LLM uno script di training, cosa che gli LLM sanno fare da tempo. Qui non c’è alcuno script di training, e l’LLM lavora con i numeri reali.
Gli autori sottolineano che la Weight-Space Programming è un concetto più che un singolo metodo e che non esclude i gradienti. Hanno vietato i gradienti in questi esperimenti per isolare ciò che può fare il solo ragionamento.
Il post mette alla prova l’idea in 3 modi, che secondo me è il modo più semplice per capire il tutto (vedi Figura 1):
Figura 1: Le 3 abilità testate nel post. Immagine dell’autore.
L’LLM che fa tutto questo è GPT-6 Astra, rilasciato da OpenAI il 3 settembre 2026. In alcuni esperimenti, i ricercatori hanno disattivato tutti i suoi strumenti (inclusi web search ed esecuzione di codice), così poteva solo leggere i numeri e pensare.
Ognuna di queste 3 abilità usa il proprio set di tecniche, ed è ciò di cui parla il resto dell’articolo.
Come vengono normalmente creati i pesi di una rete neurale?
Prima di entrare nelle tecniche, aiuta capire come normalmente vengono creati i pesi. Altrimenti, è difficile vedere perché questa ricerca sorprenda così tanto.
Un ripasso sul training
Una rete neurale è un’enorme collezione di numeri chiamati pesi (o parametri). Quando dai un input alla rete, come un’immagine o una frase, moltiplica e somma questi numeri per produrre un output. Questo si chiama forward pass.
Il training è il processo di scegliere buoni valori per questi numeri. Il metodo standard è la discesa del gradiente: esegui la rete, misuri quanto era sbagliata la risposta, calcoli in che direzione ciascun peso dovrebbe muoversi per renderla un po’ meno sbagliata, e poi sposti ogni peso di un pochino. Ripeti milioni di volte, ed è per questo che il training è così costoso.
I quattro modi in cui i pesi vengono scritti
Ogni rete neurale che hai mai usato ha avuto i suoi pesi scelti da qualcosa. Finora, quel qualcosa è stato uno di 4 elementi:
AdderBoard è un caso insolito. È una sfida della community per costruire il transformer più piccolo capace di sommare due numeri di 10 cifre, e alcune persone hanno costruito a mano soluzioni con meno di una dozzina di valori di peso unici. Siamo lontanissimi dalla scala di un modello come ChatGPT.
La Weight-Space Programming aggiunge una quinta opzione a questa lista: un LLM generalista che ragiona sui pesi.
Figura 2: Training normale confrontato con la Weight-Space Programming. Immagine dell’autore.
Perché non possiamo semplicemente leggere i pesi?
Se i pesi sono solo numeri, perché è così difficile leggerli? Ci sono 2 motivi principali.
Primo, una rete non memorizza un’idea in un solo punto. Un’idea singola di solito è distribuita su molti neuroni, e un singolo neurone di solito contribuisce a molte idee diverse contemporaneamente.
Secondo, la stessa rete può essere scritta in molti modi diversi. Puoi rimescolare l’ordine dei neuroni dentro uno strato, aggiustare lo strato successivo di conseguenza e la rete si comporterà esattamente allo stesso modo. Quindi 2 reti che fanno lo stesso lavoro possono avere pesi che sembrano molto diversi.
Tieni a mente questi 2 problemi, perché ogni tecnica qui sotto è sostanzialmente un modo per aggirarli.
Perché la Weight-Space Programming è un grande passo
Il post ha attirato tanta attenzione perché si inserisce in una tendenza più ampia. Negli ultimi anni abbiamo chiesto agli LLM di migliorare da soli sempre più cose:
Figura 3: Cosa abbiamo chiesto agli LLM di migliorare nel tempo. Immagine dell’autore.
Nota che tutte queste cose sono testo, come prompt e file Python che anche gli umani possono modificare a mano. Gli autori sottolineano che abbiamo usato gli LLM sul testo perché non avevamo un modo migliore per migliorarlo. Per i pesi avevamo già la discesa del gradiente, quindi nessuno ha davvero pensato di chiedere.
Questo post chiede cosa succede se saltiamo del tutto lo script di training e lasciamo che l’LLM cambi direttamente i pesi.
Abilità 1: come un LLM legge i pesi di una rete neurale (Tecniche 1 e 2)
I ricercatori hanno iniziato con reti abbastanza piccole da incollare tutti i loro pesi direttamente nel prompt di Astra come testo semplice, poi sono passati a modelli più grandi che Astra ha analizzato con Python. Astra ha usato 2 tecniche principali per leggerli.
Tecnica 1: leggere la struttura dai pesi di input e output
Secondo me, il punto più semplice da cui iniziare a leggere una rete è ai suoi margini. Il primo strato è collegato direttamente all’input (come i pixel di uno schermo) e l’ultimo è collegato direttamente all’output (come le mosse che un giocatore può fare). Sono gli unici strati in cui sappiamo a cosa è collegato ciascun numero.
Che gioco sta giocando questa rete?
I ricercatori hanno addestrato 4 piccole reti con Proximal Policy Optimization (PPO), un algoritmo di reinforcement learning, per giocare versioni a griglia 10×10 semplificate di Breakout, Pong, Pac-Man e Freeway.
La parte ingegnosa di questo setup è che tutte e 4 le reti avevano esattamente la stessa dimensione (17.253 pesi ciascuna), ricevevano gli stessi input e potevano fare le stesse mosse. Quindi l’unico modo per distinguerle era leggere i numeri.
Hanno incollato i pesi di ciascuna rete in Astra e hanno chiesto: "Su quale gioco è stata addestrata questa rete?" senza fornire una lista di opzioni. Astra ha comunque indovinato il gioco giusto per tutte e 4 le reti.
Figura 4: Astra legge i pesi grezzi e identifica Breakout. Immagine dell’autore.
Ciò che mi ha colpito è come ci è arrivato. Per la rete di Breakout, ha ragionato più o meno così:
Mettendo insieme questi indizi, ottieni Breakout. I primi 2 indizi vengono dai pesi di input e l’ultimo dai pesi di output, che è esattamente questa tecnica.
Che forma disegna questo modello?
Poi i ricercatori hanno addestrato piccoli modelli di generazione di immagini (modelli di diffusione, la stessa famiglia che sta dietro alla maggior parte dei generatori di immagini AI) per disegnare cerchi, triangoli o quadrati. Anche in questo caso, Astra ha ricevuto solo i pesi, senza strumenti e senza possibilità di eseguire i modelli, e ha indovinato la forma giusta per ciascuno.
C’è stato un errore curioso: Astra ha descritto ogni forma come un contorno, quando in realtà i modelli disegnano forme piene. I ricercatori sostengono che questo sia un buon segno, perché suggerisce che Astra stesse leggendo i bordi della forma memorizzati nei pesi invece di eseguire di nascosto l’intero modello nella sua testa.
Tecnica 2: trovare circuiti negli strati intermedi
Nei primi 2 esperimenti, Astra poteva cavarsela leggendo solo il primo o l’ultimo strato della rete. Questo non funziona per veri modelli di linguaggio, dove gran parte del ragionamento avviene negli strati intermedi.
Qui entra in gioco la seconda tecnica: trovare circuiti. Un circuito è un piccolo gruppo di parti dentro una rete che lavorano insieme per svolgere un compito specifico. Se ne riconosci la funzione, puoi imparare molto sulla rete senza sapere quali sono gli input.
Che lingua ha imparato questo modello?
Per testarlo, i ricercatori hanno addestrato 3 piccoli modelli di linguaggio (circa 7,2 milioni di pesi ciascuno):
Poi hanno tagliato via il primo e l’ultimo strato di ciascun modello, lasciando solo 4 blocchi intermedi. Senza quegli strati, nulla nei pesi dice quale numero rappresenta quale lettera, quindi il modello non può nemmeno essere eseguito su testo, e la Tecnica 1 non è praticabile.
Questa volta Astra poteva analizzare i numeri con Python, ma non poteva eseguire il modello. Ha comunque indovinato la lingua giusta per tutti e 3 i modelli in entrambi i tentativi, sebbene fosse solo tra il 50 e il 60% sicuro ogni volta.
Come ha individuato Python? Ha cercato le induction heads.
Le induction heads sono parti di un transformer che notano quando un pattern è apparso prima nel testo e copiano ciò che è venuto dopo, ad esempio completare “tot” in “total” perché “total” è stato scritto in precedenza. Il codice ripete i nomi delle variabili molto più della scrittura normale, quindi un modello su Python ne ha bisogno di più. Astra le ha trovate tutte senza etichettarne erroneamente altre.
Astra le ha trovate moltiplicando tra loro le matrici di peso di teste diverse per vedere quali teste “parlano” tra loro. Questo coincide con una tecnica del paper del 2021 A Mathematical Framework for Transformer Circuits, che i ricercatori non gli avevano menzionato.
Per il romaji, Astra ha notato che il modello sembrava avere meno lettere da gestire. È vero, perché il romaji non usa lettere come q, l, v o x.
Dove la lettura si inceppa: qual è il modello compiacente?
Ecco dove queste 2 tecniche smettono di funzionare. È l’unico esperimento che all’inizio non ha funzionato.
I ricercatori hanno preso 2 copie di Gemma 3 270M di Google e le hanno fine-tunate nello stesso identico modo, con una differenza. Una copia ha imparato a dare la risposta corretta, l’altra a essere adulatrice, cioè dà sempre la risposta suggerita dall’utente. Hanno anche congelato gli strati di input e output, così Astra non poteva prendere la scorciatoia di ispezionarli. Ecco un esempio illustrativo:
Dai soli pesi, Astra non è riuscito a capire quale modello fosse quello adulatore in nessuno dei 4 tentativi. Ha trovato molte differenze tra i 2 modelli ma non è riuscito a collegarne nessuna al comportamento.
Così i ricercatori gli hanno dato un indizio in più. Hanno lasciato che Astra vedesse dove guardava ciascuna attention head mentre i modelli leggevano un testo scritto da Astra stesso (ma non le risposte effettive dei modelli). Con questo, Astra ha individuato correttamente il compiacente in tutte e 3 le coppie di modelli.
Ha persino trovato dove risiede la differenza. Nell’head di attenzione 10.2, il modello onesto dedicava il 94,3% della sua attenzione ai numeri nella domanda, mentre il compiacente dedicava l’85,7% all’answer suggerita dall’utente.
Voglio sottolinearlo perché, secondo me, è il risultato più importante del post. Mostra che leggere un comportamento dai soli pesi è ancora molto difficile su un vero modello di linguaggio, anche per un modello d’avanguardia come GPT-6 Astra.
Abilità 2: come un LLM corregge i pesi di una rete neurale (Tecniche 3 e 4)
Leggere i pesi è impressionante, ma correggerli è un passo più grande e più difficile. Astra deve capire cosa sta facendo la rete, stabilire cosa dovrebbe fare e poi cambiare i numeri giusti per colmare il divario. Ha usato 2 tecniche molto diverse per questo.
Tecnica 3: aggiungere un piccolo circuito scorciatoia
Questa tecnica lascia per lo più intatta la rete e aggiunge un piccolo circuito che si attiva solo nella situazione in cui la rete originale fallisce.
L’auto che resta sempre bloccata
Per questo esperimento, i ricercatori hanno usato un gioco di fisica 2D chiamato Kinetix e hanno addestrato una rete con PPO a guidare un’auto su una rampa. L’auto deve fare retromarcia prima per prendere una rincorsa sufficientemente lunga, e solo poi accelerare in avanti.
La rete addestrata non l’ha mai capito. Andava dritta contro la rampa e si bloccava, ogni singola volta.
Così i ricercatori hanno dato ad Astra 3 cose:
In un unico tentativo, senza strumenti, Astra ha spiegato perché l’auto falliva e ha scritto nuovi pesi. Dopo la modifica, l’auto è riuscita in tutti i 1.024 episodi di test (da 0) e Astra aveva cambiato solo il 3,5% dei pesi.
Astra non ha riscritto l’intera rete. Ha aggiunto una piccola scorciatoia attraverso pochi neuroni in ogni strato, che prende il controllo all’inizio, mette l’auto in retromarcia e la lancia in avanti. Una volta oltrepassata la striscia rossa, la scorciatoia si disattiva e la rete originale guida il resto del percorso.
Mi piace pensarlo come un istruttore di guida che afferra il volante per un tratto difficile e poi lo restituisce subito allo studente. Funziona perché la rete originale non era completamente rotta. Sapeva già guidare, ma non gestiva un momento critico, quindi aveva senso lasciare intatto tutto il resto.
Tecnica 4: trovare e rimuovere una direzione
Questa tecnica si basa sull’idea che un comportamento possa trovarsi lungo una singola direzione all’interno del modello, così da poterlo spegnere rimuovendo quella direzione dai pesi.
Il modello che continuava a ripetersi
Questo è l’esperimento diventato virale, quindi guardiamolo più nel dettaglio.
I ricercatori hanno preso Qwen3.5-0.8B, un piccolo modello open-source per il ragionamento, e hanno chiesto ad Astra di renderlo migliore in matematica semplicemente modificandone i pesi. Questa volta Astra aveva a disposizione un notebook Python con il modello caricato e poteva eseguirlo su problemi di pratica di matematica un numero limitato di volte (10, 25 o 50 esecuzioni di test, che gli autori chiamano forward pass). Ma di nuovo, niente training.
Astra ha notato rapidamente che il modello rimaneva bloccato in loop, ripetendo le stesse parole all’infinito senza mai arrivare a una risposta. In effetti, 85 delle prime 96 risposte di pratica andavano avanti finché non raggiungevano il limite di 32.768 token.
Questo è un problema noto nei piccoli modelli di ragionamento, e la stessa scheda del modello di Qwen lo segnala. Un paper del dicembre 2025 intitolato “Wait, Wait, Wait… Why Do Reasoning Models Loop?” ha rilevato che i modelli più piccoli fanno loop più di quelli più grandi della stessa famiglia, e che i piccoli modelli distillati da uno più grande fanno loop ancora più del modello da cui hanno imparato.
Astra ha rintracciato il looping in un unico schema nascosto dentro il modello, che i ricercatori chiamano una direzione. Se aiuta, puoi pensare a una direzione come a uno slider nascosto nel modello. In questo caso, lo slider spingeva il modello a ripetersi e risiedeva nei layer 15 e 19.
Astra ha quindi semplicemente rimosso quello slider da 131.072 pesi (64 colonne di output in ciascuno di quei 2 layer), cioè solo lo 0,016% dell’intero modello.
La matematica dietro
La correzione di Qwen è molto simile a un trucco esistente chiamato abliteration. Nel 2024, i ricercatori hanno mostrato che l’abitudine di un modello di rifiutare le richieste è controllata da una singola direzione, e che puoi eliminare quella direzione dai pesi per smettere di far rifiutare il modello.
La matematica dietro è sorprendentemente una sola riga, dove
rè la direzione di lunghezza unitaria che vuoi rimuovere:W_new = W - r (rᵀ W)Per renderlo più intuitivo, ecco un esempio minuscolo. Immagina che un peso sia composto da 2 parti,
(3, 2). Il primo numero è quanto spinge il modello verso il looping, il secondo è tutto il resto che fa.La nostra direzione di looping è
r = (1, 0), che significa semplicemente “il primo numero”. La formula toglie la parte di looping (3) e ci lascia con(0, 2). La parte di looping è sparita e tutto il resto rimane identico.Il punto importante è che Astra ha trovato da solo la direzione del looping ragionando sui pesi ed eseguendo il modello su problemi di pratica, mentre l’abliteration ha bisogno di qualche centinaio di prompt di esempio per trovarla. Ecco i risultati più in dettaglio (per tutti e 8 gli esperimenti affiancati, vedi la nostra panoramica della Weight-Space Programming):
Figura 5: Qwen3.5-0.8B prima e dopo la modifica di Astra. Immagine dell’autore.
Ci sono 2 cose da notare. Primo, il looping non è solo un problema matematico, quindi la correzione ha reso il modello molto migliore nel seguire le istruzioni (IFEval è passato dal 21,0% al 62,3% nella versione a 50 esecuzioni). Secondo, con 10 o 25 esecuzioni i loop sono rimasti per lo più, e il grande salto è avvenuto solo a 50.
Dove la correzione si inceppa: correggere non è uguale a migliorare
Ora la parte che, secondo me, ogni lettore dovrebbe sapere. Fermare i loop non è la stessa cosa che rendere un modello migliore in matematica. Serve solo a permettere al modello di finire risposte che già sapeva calcolare.
Per verificarlo, i ricercatori hanno eseguito lo stesso esperimento su Gemma 3 270M, un modello piccolo che fa raramente loop (solo l’8,5% delle risposte raggiunge il limite di token, contro il 93% di Qwen). Questa volta, Astra non è riuscito davvero a migliorarlo. Su MATH-500, nessuna modifica ha spostato il punteggio di più di circa un punto, e lo stesso Astra ha riportato il guadagno come non stabilito.
Quando Astra ha guardato dove sbagliava Gemma, ha trovato errori comuni come cattiva aritmetica e passi di algebra errati. Non c’era un unico componente difettoso da spegnere, quindi la Tecnica 4 non aveva appigli.
In breve, modificare i pesi può rimuovere qualcosa che bloccava una capacità, ma non può aggiungere una capacità che il modello non aveva.
Abilità 3: come un LLM scrive i pesi di una rete neurale (Tecnica 5)
Arriviamo ora alla parte che personalmente mi ha sorpreso di più. Qui Astra parte da una rete in cui ogni singolo peso è zero e deve scegliere tutti i numeri da sé.
Tecnica 5: pianificare un programma e trasformarlo in numeri
La tecnica è semplice da descrivere. Prima Astra pianifica un programma, decidendo cosa deve fare ciascuno strato, e poi sceglie pesi che facciano svolgere a ogni strato quel compito.
I ricercatori hanno usato MinAtar, una raccolta di versioni semplificate di giochi Atari, e hanno scelto Breakout, Seaquest e Asterix. Per ogni gioco, ad Astra sono stati dati:
Non aveva dati di training, nessuno strumento e non poteva nemmeno testare la sua rete nel gioco. Ha semplicemente digitato tutti i pesi in un’unica risposta, e poi i ricercatori hanno testato il risultato.
Per Breakout, ad esempio, il piano era questo:
Come vedi, le reti di Astra battono quelle addestrate per 100 milioni di passi in tutti e 3 i giochi. Contro le reti addestrate per 500 milioni di passi, ha segnato circa 20 volte di più in Breakout, è andato vicino in Asterix e ha raggiunto circa il 60% del punteggio in Seaquest.
Costruire un giocatore di Go
Le reti di gioco sopra erano abbastanza piccole da permettere ad Astra di digitare tutto in una risposta. Per il Go, i ricercatori hanno alzato molto l’asticella, con una rete di circa 1,5 milioni di pesi. Troppo grande persino per entrare nel prompt di Astra.
Quindi gli hanno dato uno spazio di lavoro Python dove poteva guardare e salvare i pesi (tutti a zero all’inizio) ma non eseguire la rete. Se voleva testare la sua rete, doveva spendere 1 di un numero limitato di esecuzioni di test, da 0 a 50, dove ogni esecuzione giocava 128 partite su una tavola 9×9.
Astra ha costruito questa rete come un programma di Go:
Potresti pensare che somigli molto a un compilatore, e avresti ragione. È molto simile a ciò che fa Tracr di DeepMind, trasformando un programma in pesi esatti di un transformer. La differenza è che Tracr ha bisogno che il programma sia scritto in un linguaggio speciale, mentre Astra concepisce il programma partendo da un obiettivo in inglese naturale.
Perché i test fanno una differenza così grande
A questo punto, avrai notato che le regole sono cambiate da esperimento a esperimento. Negli esperimenti su identificazione del gioco, forme, auto e MinAtar, Astra non aveva alcuno strumento, mentre in quelli su linguaggio, Go, compiacenza e Qwen poteva usare Python e talvolta testare la rete.
A mio avviso, questa è la parte più sottovalutata dell’intero post, perché il numero di test sembra aver fatto una grande differenza:
Quindi i risultati senza strumenti sono i più sorprendenti, ma significa anche che non puoi confrontare equamente ogni esperimento con gli altri.
Come fa in pratica GPT-6 Astra?
C’è anche un pattern comune a tutte le tecniche: Astra lavora molto come farebbe un ingegnere umano.
Weight-Space Programming vs. fine-tuning ed editing del modello
Potresti chiederti in cosa differisca dal fine-tuning o da altri modi di modificare un modello. La tabella seguente confronta i metodi più vicini, indicando anche a quale delle 5 tecniche ciascuno somiglia di più:
Spiego rapidamente alcune di queste:
La grande differenza con i Weight Oracles è che sono addestrati per questo unico compito, mentre la Weight-Space Programming usa un LLM normale, pronto all’uso.
Onestamente, la novità qui non è che i pesi possano essere modificati, cosa nota da anni. È che un unico modello generalista ha gestito tutti questi compiti diversi semplicemente ragionandoci sopra.
Limiti della Weight-Space Programming
Per quanto questi risultati siano entusiasmanti, è importante leggerli con attenzione. Gli stessi autori li definiscono “risultati molto preliminari”. Ecco le principali perplessità sollevate:
1. Sta correggendo, non migliorando
Come mostra il controllo con Gemma, il grande salto su Qwen è venuto soprattutto dallo stop ai loop. Un’analisi dei log degli autori, riportata da XenoSpectrum, ha contato 579 problemi di pratica non visti che Qwen ha risolto dopo la modifica. Di questi, 576 erano stati in precedenza troncati al limite di token.
2. È stato testato un solo LLM d’avanguardia
Ogni esperimento del post ha usato GPT-6 Astra. Simon Willison ha poi replicato il compito di identificazione del gioco sul suo laptop con l’open-weight Qwen 3.8 27B, anche se ha mancato uno dei giochi. Se altri modelli d’avanguardia possono eguagliare Astra negli esperimenti di riparazione e scrittura è qualcosa a cui dovrebbe rispondere il benchmark pianificato dagli autori.
3. Non è stato sottoposto a peer review
È un post sul blog, non un paper pubblicato. Gli autori hanno rilasciato log completi e Ahsen Khaliq di Hugging Face ha ricostruito il modello Qwen modificato e rifatto la valutazione, che secondo gli autori ha totalizzato il 51,0% su MATH-500, con il 31,6% di risposte ancora al limite di token. È un controllo utile sul checkpoint rilasciato, ma non equivale a una replica indipendente dell’editing effettuato da Astra.
4. I risultati riportati potrebbero essere favorevoli
I critici hanno notato che i tentativi di prompt precedenti non sono inclusi nei risultati riportati e che lo sforzo di ragionamento di Astra è variato tra gli esperimenti. Non ho nemmeno trovato un test su quanto cambino i risultati se il prompt è formulato in modo leggermente diverso.
5. Non conosciamo i costi
La migliore esecuzione su Qwen ha richiesto 158 turni di conversazione e 20,3 ore, inclusi 4,7 ore perse per un’interruzione del servizio. Il post non confronta questo con un normale fine-tuning del modello, quindi non possiamo ancora dire se faccia risparmiare tempo o denaro.
6. I confronti sono un po’ generosi
I risultati sui giochi sono confrontati con reti addestrate, ma non con semplice codice scritto a mano. Un giocatore di Breakout che segue la palla non è così difficile da scrivere come programma classico, quindi battere lì una rete addestrata è meno sorprendente di quanto sembri. Gli autori rispondono che ogni baseline testa solo l’affermazione ristretta del proprio esperimento, ad esempio fin dove si arriva senza alcuna esperienza.
Per onestà verso gli autori, sono stati molto trasparenti su ciò che non ha funzionato, inclusi i risultati su compiacenza e Gemma, cosa che apprezzo. Ma tratterei i numeri di copertina come un segno promettente piuttosto che come prova che funzioni in generale.
Applicazioni della Weight-Space Programming
Nonostante tutti questi limiti, è emozionante immaginare dove potrebbe arrivare se continuerà a migliorare. Ecco le possibili applicazioni menzionate dagli autori:
L’ultima è esattamente il motivo per cui non tutti sono entusiasti di questa ricerca. Maxime Fournes, CEO di PauseAI, ha definito la direzione di ricerca spericolata, perché veri progressi qui potrebbero accelerare sviluppi di AI rischiosi. Voglio però sottolineare che questo post non ha mostrato alcun tipo di auto-miglioramento.
C’è anche un angolo di sicurezza più positivo. Se gli LLM riuscissero a individuare in modo affidabile cose come compiacenza o backdoor nascoste semplicemente leggendo i pesi, questo potrebbe diventare un modo utile per controllare i modelli prima di rilasciarli.
Cosa viene dopo?
Gli autori dicono che ora stanno costruendo un benchmark per misurare quanto sono bravi diversi LLM in questo, insieme a un harness per aiutarli. Alcune delle domande su cui i ricercatori lavoreranno sono:
Il lavoro si è mosso rapidamente dopo la pubblicazione. In un aggiornamento del 12 novembre, gli autori dicono che esistono oltre un centinaio di repliche ed estensioni, anche su policy robotiche e circuiti quantistici, e un benchmark chiamato IWIBench.
Se vuoi guardare tu stesso il lavoro, puoi vedere i log completi di ogni esperimento su GitHub, inclusi tutti i prompt inviati ad Astra e un riassunto del suo ragionamento. Il modello Qwen corretto è anche su Hugging Face con una demo live che puoi provare nel browser, linkata dal post originale.
Pensieri finali
La Weight-Space Programming è un’idea nuova con prime evidenze a sostegno. Un LLM pronto all’uso, senza alcun training, è riuscito a leggere cosa fanno piccole reti, a sbloccare un’auto e un modello di linguaggio in loop e persino a costruire reti di gioco dal nulla.
Ciò che mi ha sorpreso di più è come l’ha fatto. Non ha usato qualche trucco misterioso, ma ha letto i margini delle reti, cercato circuiti, aggiunto scorciatoie, rimosso direzioni e pianificato programmi prima di trasformarli in numeri, proprio come farebbe un ingegnere.
Ma vorrei ribadire che si tratta di un rapporto preliminare basato su un solo modello, e che il risultato più grande è venuto dal correggere un bug più che dal rendere il modello più intelligente. Se continuerà a migliorare, l’applicazione più utile sarà probabilmente l’audit e il debug dei modelli, non la sostituzione del training.
Se vuoi consolidare le basi per seguire ricerche di questo tipo, il nostro corso Large Language Models (LLMs) Concepts spiega come funzionano questi modelli sotto il cofano. E se ti interessa il lato agenti, Introduction to AI Agents è un ottimo passo successivo.