
Cursus
AI-beveiliging en risicobeheer
2 uur
11.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleAI en ML worden meestal door elkaar gebruikt. Maar als ik ze snel zou moeten definiëren en de verschillen aanwijzen, zou ik zeggen dat AI verwijst naar de technologie waarmee machines worden gebouwd die cognitieve functies nabootsen die met menselijke intelligentie worden geassocieerd, terwijl ML verwijst naar een subset van AI-algoritmen die leren en verbeteren op basis van data.
In dit artikel neem ik je mee in de toepasbaarheid van machinelearningtechnieken in cyberbeveiliging, met uiteenlopende usecases en de uitdagingen rond explainability, interpretability en robuustheid die moeten worden aangepakt om het volledige potentieel te benutten.
Threat detection and response verwijst naar het detecteren van cyberdreigingen tegen netwerken of systemen, gevolgd door snelle en effectieve mitigatiestrategieën. Dit omvat het opsporen van afwijkend gedrag binnen netwerken en systemen, het identificeren van ongeautoriseerde indringingen en het analyseren van malware om onze systemen te beschermen.
Anomalieën detecteren betekent patronen in data identificeren die niet overeenkomen met een duidelijk gedefinieerd begrip van normaal gedrag.
Dit basisconcept is in allerlei domeinen toepasbaar, en cyberbeveiliging is daarop geen uitzondering. Ik gebruik anomaliedetectie om uiteenlopende kwaadaardige activiteiten op te sporen, zoals data-exfiltratie, Distributed Denial of Service (DDoS)-aanvallen, malware-infecties en meer. Diverse machinelearningalgoritmen, zoals Local Outlier Factor (LOF), Isolation Forest, One-Class Support Vector Machine (OC-SVM), worden ingezet om anomalieën te detecteren. Het kiezen van de juiste techniek om uitschieters te vinden is echter complex en vereist zorgvuldige afweging van meerdere factoren, waaronder:
We gaan verkennen hoe we de juiste machinelearningtechnieken kiezen en ook uitleggen hoe ze kwaadaardige cyberactiviteiten detecteren. We focussen op twee cruciale toepassingen in cyberbeveiliging: intrusion detection en malwareanalyse.
Intrusion detection systems (IDS) zijn de ogen en oren van computernetwerken en -systemen. Ze monitoren en analyseren netwerkverkeer (netwerkgebaseerde IDS) en systeemaanroepen (hostgebaseerde IDS) op kwaadaardige activiteiten.
Tijdens mijn experimenten heb ik de kracht gezien van anomaliedetectiebenaderingen voor beide systemen in het opsporen van nieuwe of eerder onbekende dreigingen die handtekeninggebaseerde technieken ontwijken, welke vertrouwen op vooraf gedefinieerde aanvalsprofielen.
Voordat we in hostgebaseerde IDS duiken, is het belangrijk te begrijpen wat systeemaanroepen zijn. Het zijn in wezen verzoeken van een programma aan het besturingssysteem om specifieke taken uit te voeren. Stel, je gebruikt een teksteditor om een bestand aan te passen op een Linux-besturingssysteem. Op de achtergrond vraagt je teksteditor om een bestand te openen met de systeemaanroep open(), wijzigingen erin te schrijven met write() en het op te slaan door het bestand te sluiten met close().
Terwijl de systeemaanroepen van een teksteditor eenvoudig en voorspelbaar zijn, is de sequentie van systeemaanroepen van een aanvaller vaak misleidend. Een kwaadaardig programma kan een reeks gebruiken als open(), write() om een verborgen bestand te droppen, en vervolgens execve() gebruiken om het met verhoogde rechten uit te voeren. Daarna volgen netwerkgerelateerde aanroepen zoals socket() om mogelijk een command-and-controlkanaal op te zetten.
Om dit aan te pakken, worden systeemaanroepsequenties vaak omgezet naar een statische feature-representatie die geschikt is voor machinelearningalgoritmen. Maar je vraagt je misschien af: welke leertechniek is hier het meest geschikt om ML-modellen te trainen?
De keuze van de leertechniek hangt sterk af van de beschikbaarheid van labels. Als een gebalanceerde dataset met zowel normale als afwijkende systeemaanroepsequenties beschikbaar is, zou ik zeker kiezen voor gesuperviseerde anomaliedetectiemodellen zoals Support Vector Machines (SVM).
Omgekeerd kan ik, bij afwezigheid van gelabelde data, ongesuperviseerde modellen gebruiken zoals Isolation Forest. In scenario's waar alleen normaal gedrag in de trainingsdata vertegenwoordigd is, kies ik voor semigesuperviseerde technieken zoals One-Class SVM of DBSCAN.
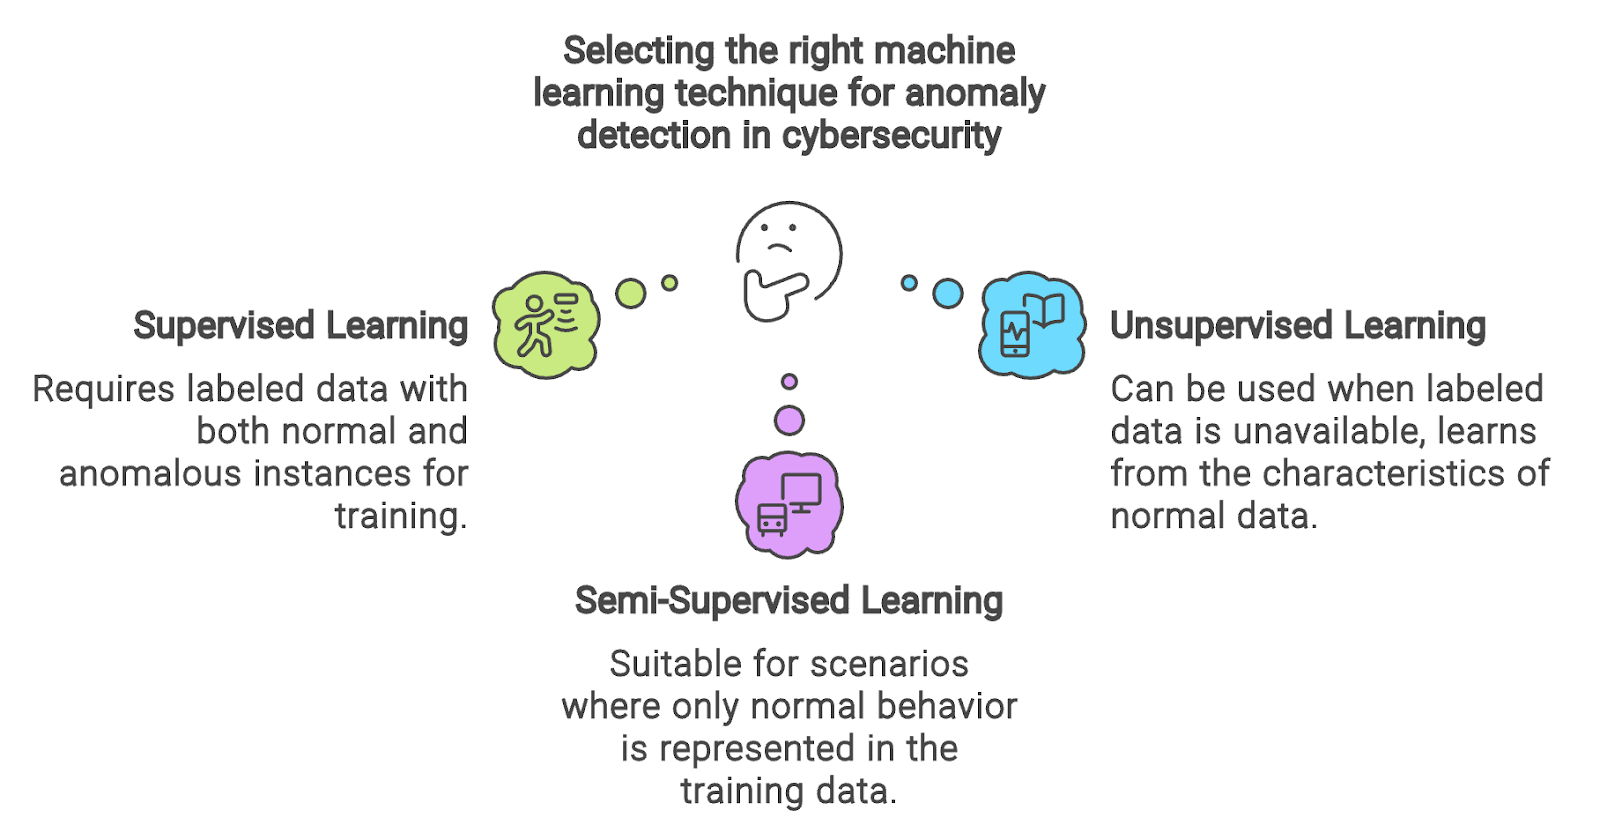
Diagram gemaakt met Napkin.ai
Nu we begrijpen hoe ML wordt toegepast op hostgebaseerde IDS, gaan we naar netwerkgebaseerde IDS. Waar hostgebaseerde systemen zich richten op individuele machines, identificeren netwerkgebaseerde IDS indringingen in netwerkdata; in plaats van systeemaanroepen te analyseren, inspecteren netwerk-IDS datadiefstal en netwerkverstorende activiteiten door netwerkstroomstatistieken, payloaddata en pakketheaders te monitoren.
Een snelle blik op de volgende tabel geeft je een idee hoe een dataset met netwerkstromen eruitziet.
|
Bestemmingspoort |
Bronpoort |
Stroomduur (ms) |
Totaal Fwd-pakketten |
Totaal Bckwd-pakketten |
Label |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Synthetische normale en abnormale netwerkstroomstatistieken.
Elke rij in de dataset staat voor een zelfstandige netwerkcommunicatiesessie tussen twee eindpunten, zonder inherente relaties met andere stromen in de dataset.
Elke stroom wordt gedefinieerd door kenmerken zoals bron- en bestemmingspoortnummers, de duur van de stroom in milliseconden en het totaal aantal uitgewisselde pakketten in beide richtingen. Een categorisch label geeft aan of de netwerkstroom als afwijkend of als aanval is geclassificeerd en biedt essentiële ground truth voor intrusion-detectiemodellen.
Opvallend is dat elke rij een zelfstandige netwerkstroom vertegenwoordigt, zonder sequentiële of relationele afhankelijkheden met andere stromen in de dataset.
Gezien het onafhankelijke karakter van netwerkstromen kan de dataset, na enige feature-engineeringtechnieken, aan ML-algoritmen worden gevoerd voor anomaliedetectie. Zoals eerder besproken bij hostgebaseerde IDS, hangt de keuze voor geschikte ML-technieken af van de beschikbaarheid van gelabelde data.
Voordat we aan malwareanalyse toekomen, moeten we eerst uitleggen wat malware is en hoe het werkt.
Malware is een verzamelnaam voor kwaadaardige software of binaire uitvoerbare bestanden die zijn ontworpen om de schadelijke bedoelingen van een aanvaller uit te voeren. Deze code misbruikt opzettelijk kwetsbaarheden in doelsystemen om hun integriteit te compromitteren, gevoelige data te stelen, data te verwijderen en zelfs data te versleutelen voor losgeld. Het kan vele vormen aannemen, waaronder virussen, wormen, spyware, trojans, ransomware, enz.
Om het type malware, de functionaliteit en de potentiële impact te begrijpen, worden diverse features uit statische en dynamische analyse gehaald en in geschikte machinelearningalgoritmen gevoerd.
Neem malwareanalyse van Windows-uitvoerbaren, oftewel Portable Executables (PE's). We kunnen uiteenlopende features extraheren uit zowel dynamische als statische analyse van PE's, zoals bytereeksen, API's/systeemaanroepen, opcodes, netwerk, bestandssysteem, CPU-registers, PE-bestandskenmerken en strings, en die vervolgens invoeren in geschikte gesuperviseerde, ongesuperviseerde en semigesuperviseerde ML-modellen om malware te detecteren.
Om het risico op blootstelling aan cyberaanvallen te verkleinen, moeten we snel potentiële zwaktes in onze netwerken, computers en applicaties identificeren, beoordelen en aanpakken. Laten we kijken naar de rol van AI- en ML-algoritmen bij het verbeteren van kwetsbaarhedenbeheer via vulnerability scanning, patchmanagement en risicobeoordeling.
Als cybersecurityonderzoeker ontwikkel ik vaak eigen tools om taken te automatiseren, zoals parsers voor netwerkverkeerslogs, fuzzers en andere.
Hoewel deze tools onze securityoperaties aanzienlijk kunnen versterken, is het belangrijk om ze grondig te scannen op kwetsbaarheden voordat ik ze gebruik en met collega's deel.
Zo niet, dan kan een aanvaller onontdekte en niet-gepatchte kwetsbaarheden in mijn script misbruiken om ongeautoriseerde toegang te krijgen, gevoelige informatie te compromitteren of diensten binnen ons bedrijf te verstoren.
Machinelearningmodellen kunnen door de bomen het bos zien. Ze blinken uit in het extraheren van betekenisvolle features uit grote datasets door subtiele patronen en correlaties te ontdekken. Met dat in gedachten ben ik ze gaan verkennen om te zien of ze kwetsbaarheidsdetectie kunnen automatiseren, sneller kunnen analyseren en eerder onbekende kwetsbaarheden kunnen identificeren.
Om een ML-gebaseerd kwetsbaarheidsdetectiemodel te bouwen, begin ik met het verzamelen van verschillende typen kwetsbare en niet-kwetsbare data om het model te trainen, uit diverse bronnen zoals NVD (National Vulnerability Database), OWASP, enz.
De verzameling wordt vervolgens voorbewerkt en ge-embed zodat deze in het gekozen model kan worden ingevoerd. De input kan worden weergegeven als een graaf of boom die relaties tussen verschillende code-elementen toont, zoals een Code Property Graph (CPG) of Abstract Syntax Trees (AST).
De input kan ook een token-gebaseerde representatie hebben, waarbij de broncode wordt omgezet in tokenvectoren. Diverse embeddingtechnieken kunnen later worden toegepast, waaronder Word2Vec, graaf-embeddings, one-hot-embedding, n-gramfeatures, enz.
Zoals in eerdere toepassingen uitgelegd, hangt de keuze van een ML-model en leertechniek vooral af van de beschikbaarheid van labels. In de trainingsfase wordt de dataset voor kwetsbaarheidsdetectie opgesplitst in trainings- en validatiesets, en leert het model van gelabelde data.
De parameters van het model worden iteratief bijgewerkt op basis van predictiefouten met behulp van optimalisatietechnieken. Nadat het model het leerproces heeft voltooid, wordt het vermogen om kwetsbaarheden te detecteren gemeten met ongeziene data. Belangrijke prestatie-indicatoren zoals accuracy, precision, recall en F1-score worden berekend om het detectievermogen te beoordelen.
Wanneer er kwetsbaarheden in mijn script worden gevonden, is een grondige risicobeoordeling essentieel. Als bestaande beveiligingsmaatregelen het misbruiken van de ontdekte kwetsbaarheden voorkomen of de potentiële gevolgen minimaal zijn, kan het risico worden geaccepteerd.
Je kunt er ook voor kiezen de ontwikkelde code helemaal niet te gebruiken om elk risico op misbruik uit te sluiten. Als volledige eliminatie niet haalbaar is, zijn mitigatiestrategieën cruciaal.
Vervolgens bekijken we het patchen van kwetsbare software als primaire mitigerende maatregel.
Hoewel het ideaal is om alle openstaande en kritieke kwetsbaarheden aan te pakken, is dat vaak niet haalbaar. Er is een meer strategische aanpak nodig. Met machine learning kunnen we proactief voorspellen welke kwetsbaarheden het meest waarschijnlijk worden misbruikt om security-incidenten te veroorzaken. Zo kunnen we patchinspanningen prioriteren.
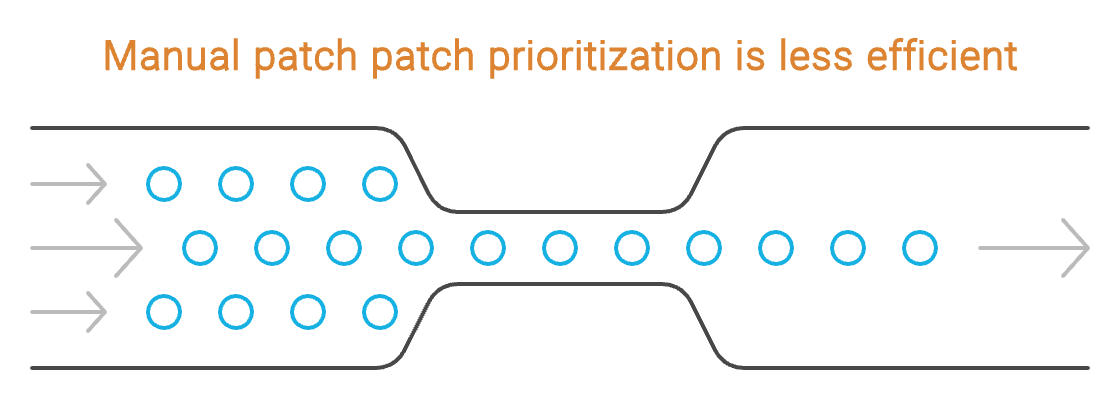
Gemaakt met Napkin.ai
Om onze patchprioritering te stroomlijnen, gebruiken we het boomgebaseerde, voorgetrainde Exploit Prediction Scoring System (EPSS)-model dat kwetsbaarheidsinformatie combineert met exploitactiviteit in de echte wereld om te voorspellen hoe waarschijnlijk het is dat aanvallers in de komende dertig dagen een specifieke kwetsbaarheid proberen te gebruiken.
Het EPSS-ML-model identificeert patronen en relaties tussen kwetsbaarheidsinformatie, zoals CVSS, en exploitatie-activiteit om wiskundig de waarschijnlijkheid te bepalen dat aanvallers een kwetsbaarheid misbruiken.
Na prioritering van kwetsbaarheden doorlopen patches een rigoureus traject van verkrijgen, valideren en testen om operationele risico's te beperken. Patchuitrol is een complex proces dat afhangt van meerdere factoren, waaronder:
Gezien de schaal en diversiteit van moderne IT-omgevingen is handmatige patchuitrol vaak arbeidsintensief en tijdrovend. AI-gestuurde automatisering kan dit proces stroomlijnen door op intelligente wijze de juiste patch voor elk systeem te selecteren en uit te rollen op basis van deze kritieke factoren.
Clusteringalgoritmen, zoals k-means, kunnen hier worden ingezet om vergelijkbare systemen te groeperen voor efficiëntere patchuitrol.
Cyberrisicobeoordeling is belangrijk om potentiële dreigingen en gedetecteerde kwetsbaarheden te identificeren, te evalueren en te mitigeren.
Omdat traditionele benaderingen vaak tekortschieten bij het vinden van indicatoren voor onvoorspelbare cyberrisico's, wenden onderzoekers zich steeds vaker tot machine learning.
Met gesuperviseerde en multi-class-classificatie-ML kunnen onderzoekers cyberrisicobeoordelingen verbeteren via een uitgebreide analyse van sleutelfactoren.
Zoals in de onderstaande tabel staat, omvatten deze factoren cybersecurityinvesteringen, kenmerken van het personeelsbestand, aanvalsgeschiedenis, kwetsbaarheden in de infrastructuur, externe advisering en het bijbehorende risico. Hun proof-of-concept SecRiskAI-ML-framework laat het potentieel zien van ML om de kans op DDoS- of phishingaanvallen te voorspellen.
|
Informatie |
Voorbeeld |
|
Omzet |
2.500.000 |
|
Cybersecurityinvestering |
500.000 |
|
Geslaagde aanvallen |
5 |
|
Gefaalde aanvallen |
10 |
|
Aantal medewerkers |
4.450 |
|
Training medewerkers |
Gemiddeld |
|
Bekende kwetsbaarheden |
9 |
|
Externe cybersecurityadviseur |
Nee |
|
Risico |
Laag |
Een voorbeeld van kernattributen voor cyberrisicobeoordeling (bron)
Laten we nu bekijken hoe AI en ML de incidentrespons veranderen. We zien hoe ze workflows automatiseren, responstijden verkorten, proactief verborgen dreigingen blootleggen en forensische analyses verbeteren om de oorsprong en impact van cyberaanvallen te achterhalen.
Ik heb van dichtbij gezien hoe SOAR-systemen zijn ontworpen om meldingen van Security Information and Event Management (SIEM)-systemen te ontvangen en passende playbooks te activeren die een reeks beveiligingstaken automatiseren en coördineren.
Deze taken kunnen onderzoeksacties omvatten, zoals het controleren van URL-reputaties of het ophalen van gebruikers- en assetdetails, evenals responsacties, zoals het blokkeren van een IP-adres op een firewall of het beëindigen van een kwaadaardig proces op een endpoint.
Toch zijn er momenteel aanzienlijke beperkingen. Security-analisten moeten playbooks handmatig definiëren, maken en wijzigen, en de keuze tussen meerdere playbooks wordt bepaald door door analisten ingestelde regels.
Om deze beperkingen te overwinnen, heb ik gezien hoe de integratie van AI en ML in SOC-platforms dit proces kan revolutioneren, waardoor we automatisch playbooks kunnen genereren die effectief
op onbekende meldingen reageren.
Dit verhoogt niet alleen de efficiëntie van onze respons, maar stelt analisten ook in staat om zich op meer taken te richten. Met ML-algoritmen kunnen we ook trainen om de strafkosten van elke responsactie te berekenen op basis van de ontvangen melding en de respons met de laagste straf te kiezen.
Stel je voor hoe stressvol het is om miljoenen logs door te ploegen op zoek naar mogelijke dreigingen.
Vergroot die uitdaging naar ondernemingsschaal, waar elke log één voor één moet worden bekeken en als kwaadaardig of onschuldig geclassificeerd.
Door machine learning in het proces op te nemen, kunnen we deze taak vereenvoudigen en de dreigingsdetectie versnellen. AI- en ML-algoritmen, zoals SVM en Random Forest, kunnen worden getraind om logs efficiënt te analyseren en te categoriseren, waardoor dreigingen snel worden geïdentificeerd en de werkdruk voor securityteams afneemt.
Nu digitale data in volume en complexiteit blijft groeien, is de integratie van AI en ML in digitale forensica—de analyse van digitaal bewijsmateriaal bij het onderzoeken van cybermisdrijven—essentieel geworden.
Deze integratie stelt ons in staat de snelheid, nauwkeurigheid en effectiviteit bij het identificeren en beantwoorden van cyberdreigingen te vergroten.
AI en ML kunnen bijvoorbeeld worden gebruikt bij forensische triage. In dat geval gebruiken we ML-algoritmen om grote aantallen digitale bestanden te classificeren en te categoriseren op basis van hun relevantie voor een onderzoek.
De integratie van AI in cyberbeveiliging biedt aanzienlijke kansen. Maar het is ook belangrijk om de inherente uitdagingen en beperkingen te erkennen.
Veel AI-systemen zijn kwetsbaar voor adversarial attacks, zoals poisoning, evasion, model extraction, prompt injection en inference, die hun kwetsbaarheden uitbuiten.
Bij deze aanvallen voegen tegenstanders zorgvuldig verstoringen toe aan de input die voor mensen onmerkbaar zijn, maar modellen tot foute voorspellingen kunnen brengen. Dit roept veiligheidszorgen op rond de inzet van deze systemen in kritieke omgevingen, en cyberbeveiliging is daarop geen uitzondering.
Om deze aanvallen effectief te bestrijden, zetten we diverse verdedigingsmechanismen in, zoals adversarial training, defensieve distillation en gradient masking.
Hoewel AI-algoritmen effectief zijn in het leveren van resultaten en voorspellingen, worstel ik soms met het begrijpen van hun interne werking.
Dat is in mijn vakgebied erg belangrijk, want cruciale keuzes toevertrouwen aan een onverklaarbaar systeem brengt evidente risico's met zich mee.
Explainable AI (XAI) biedt hier een uitweg door AI-gestuurde cybersecuritysystemen te ontwikkelen met meer uitlegbaarheid, zonder prestatieverlies. Door transparantie te bieden in AI-besluitvorming helpt XAI mij goed onderbouwde analyses te maken en de meest passende acties te ondernemen bij security-incidenten.
Recente vooruitgang in XAI-technieken, zoals feature-importance-analyse en visualisatie van beslisbomen, maakt deze transparantie haalbaar.
Wanneer ik een dataset selecteer om mijn AI-gebaseerde cybersecurityoplossingen te trainen, zorg ik ervoor dat deze niet biased is. Anders kunnen mijn modellen oneerlijke of discriminerende outputs geven. Ik pas datapreprocessing toe om bias op te sporen en te verwijderen die in de trainingsdata aanwezig is, en implementeer fairness-technieken om de output van het model te evalueren op mogelijke vooringenomenheid.
Als je tot hier hebt gelezen, heb je gezien hoe AI en ML veranderen hoe we onze computers, mobiele apparaten, netwerken en applicaties beschermen. Je hebt gezien hoe ze securityteams versterken, sneller dreigingen detecteren en diverse cybersecuritytools krachtiger maken.
En wat het spannend maakt: ik denk dat we pas aan het begin staan.
De toekomst van cyberbeveiliging ligt in de voortdurende evolutie van AI en ML, vooral bij large language models (LLM's). Dankzij hun grotere tokenlimiet, vermogen tot code-interpretatie en gedetailleerde analyse zullen deze geavanceerde modellen ons vermogen vergroten om dreigingen te analyseren en erop te reageren, door malwareanalyse op te schalen met meer snelheid en nauwkeurigheid.
Neem het voorbeeld van het Gemini 1.5-model, dat momenteel wordt gebruikt om malware in enorme bestanden te detecteren. Ondanks het ontbreken van cybersecurityspecifieke training kunnen ze relevante taken oplossen via prompt engineering, in-context learning en chains of thought.
We krijgen ook al een glimp van die toekomst door het fine-tunen van open-weights LLM's, waaronder Llama, voor cybersecuritygerelateerde taken zoals Hackmentor.
In deze blog hebben we bekeken hoe AI- en ML-gebaseerde cybersecuritytools nuttig zijn om de dynamische en complexe aard van moderne cyberdreigingen aan te pakken. Deze tools zijn effectief in het detecteren, beantwoorden en mitigeren van risico's via gerichte toepassingen in dreigingsdetectie, kwetsbaarhedenbeheer en incidentrespons.
We moeten echter ook de aanzienlijke uitdagingen en ethische implicaties overwegen die samenhangen met het ontwikkelen en inzetten van AI-gebaseerde cybersecurityoplossingen.
Ondanks deze uitdagingen bieden de voortdurende vooruitgang van AI- en ML-technologieën veel perspectief om onze verdediging tegen evoluerende cyberdreigingen te versterken.
Leer meer over gegevensbeveiliging!
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

