Cursus
Beeldverwerking in Python
4 uur
57K
De kern van vision language models is de integratie van computer vision en natural language processing.
Computer vision richt zich op het in staat stellen van machines om visuele data, zoals afbeeldingen en video's, te interpreteren en te analyseren door objecten, patronen en andere visuele elementen te herkennen.
Natural language processing houdt zich daarentegen bezig met het begrijpen en genereren van menselijke taal, waardoor machines tekst kunnen begrijpen, analyseren en produceren.
VLM's overbruggen de kloof tussen deze twee velden door modellen te creëren die visuele en tekstuele input gelijktijdig kunnen verwerken en begrijpen. Dit wordt bereikt via geavanceerde deep-learningarchitecturen, met name transformermodellen, die een sleutelrol hebben gespeeld in het succes van grote taalmodellen zoals GPT-4o, Llama, Gemini en Gemma.
Deze transformergebaseerde architecturen zijn aangepast om multimodale input te verwerken, waardoor VLM's de complexe relaties tussen visuele en talige data kunnen vastleggen.
Het transformermodel, oorspronkelijk geïntroduceerd voor NLP-taken, is de ruggengraat geworden van veel geavanceerde AI-systemen dankzij het vermogen om langeafstandsafhankelijkheden te verwerken en contextuele relaties in data vast te leggen.
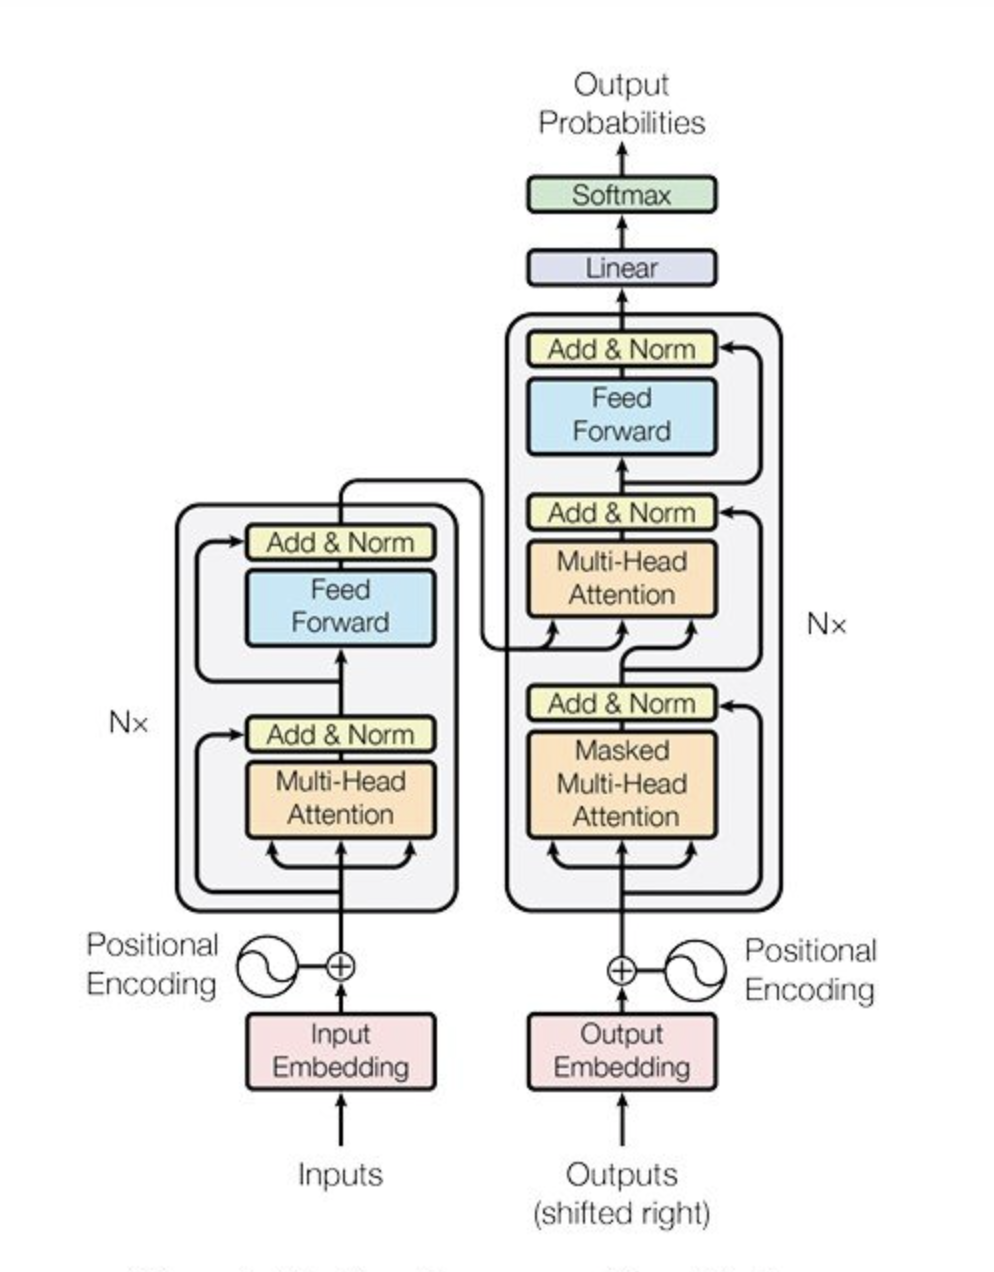
Bron: Vaswani et al., 2017
In de context van VLM's zijn transformers aangepast om zowel afbeeldingen als tekst te verwerken, wat een naadloze integratie van deze twee modaliteiten mogelijk maakt.
Een typische VLM-architectuur bestaat uit twee hoofdonderdelen: een beeldencoder en een tekstdecoder:
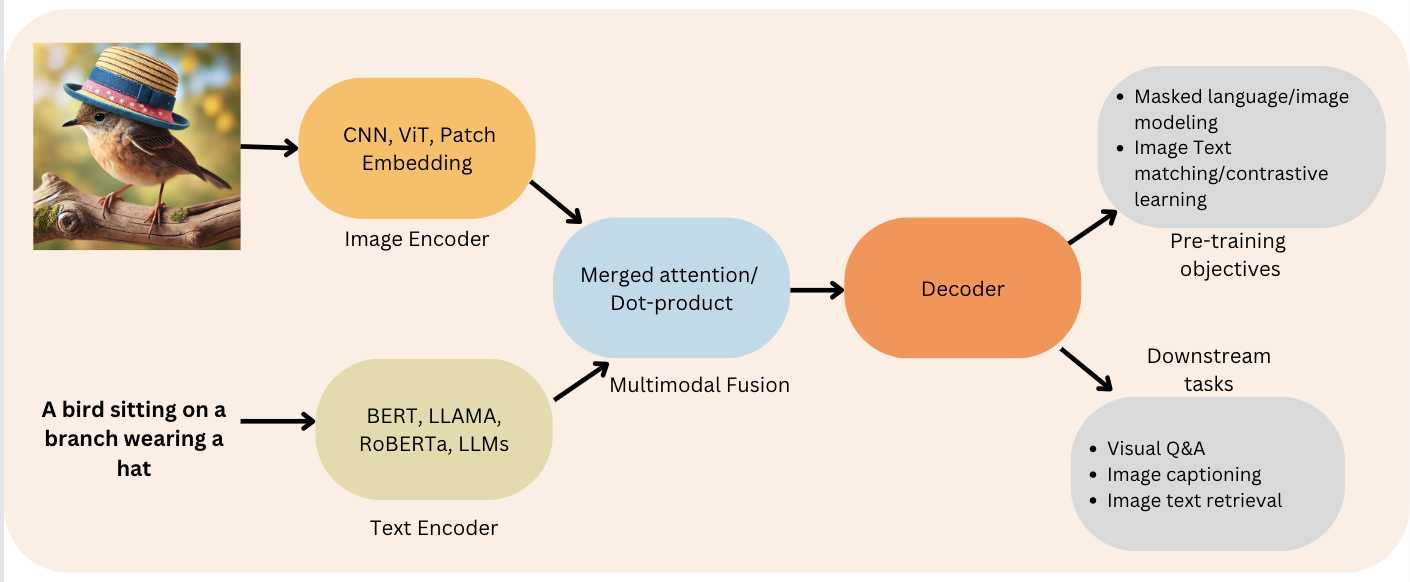
Figuur 2: Encoder-decoderfunctie (Bron: Viso.ai)
Door deze twee delen te combineren kunnen VLM's indrukwekkende dingen doen, zoals afbeeldingen gedetailleerd beschrijven, vragen beantwoorden over wat ze zien en zelfs nieuwe afbeeldingen genereren op basis van tekstbeschrijvingen! Het proces dat VLM's volgen omvat de volgende stappen:
De meeste VLM's gebruiken een Vision Transformer (ViT) als beeldencoder, die vooraf is getraind op grootschalige afbeeldingsdatasets om effectief de visuele kenmerken vast te leggen die nodig zijn voor multimodale taken.
De tekstdecoder is gebaseerd op het taalmodel, dat is fijngesteld om de nuances van taalproductie in de context van visuele data aan te kunnen. Deze combinatie van geavanceerde visuele en talige verwerkingsmogelijkheden maakt een VLM zeer veelzijdig en krachtig.
Een van de grootste uitdagingen bij het ontwikkelen van VLM's is de noodzaak van grote en diverse datasets die zowel visuele als tekstuele informatie bevatten. Deze datasets zijn essentieel om de modellen te trainen in het begrijpen en genereren van multimodale content.
Het trainen van een VLM houdt in dat het model gevoed wordt met paren van afbeeldingen en bijbehorende tekstuele beschrijvingen, zodat het de fijne relaties leert tussen visuele elementen en talige uitdrukkingen.
Om deze data te verwerken gebruiken VLM's vaak embeddinglagen die zowel visuele als tekstuele input transformeren naar een hoog-dimensionale ruimte waar ze kunnen worden vergeleken en gecombineerd.
Dit embeddingproces stelt het model in staat de verbanden tussen de twee modaliteiten te begrijpen en samenhangende, contextueel relevante outputs te genereren.
Het landschap van vision language models (VLM's) is uitgebreid, met tal van open-sourcemodellen beschikbaar op de Hugging Face Hub. Deze modellen variëren in grootte, mogelijkheden en licenties, en bieden gebruikers een reeks opties die aansluiten bij verschillende toepassingen. Hieronder staat een overzicht van enkele van de meest prominente open-source VLM's, met hun belangrijkste kenmerken:
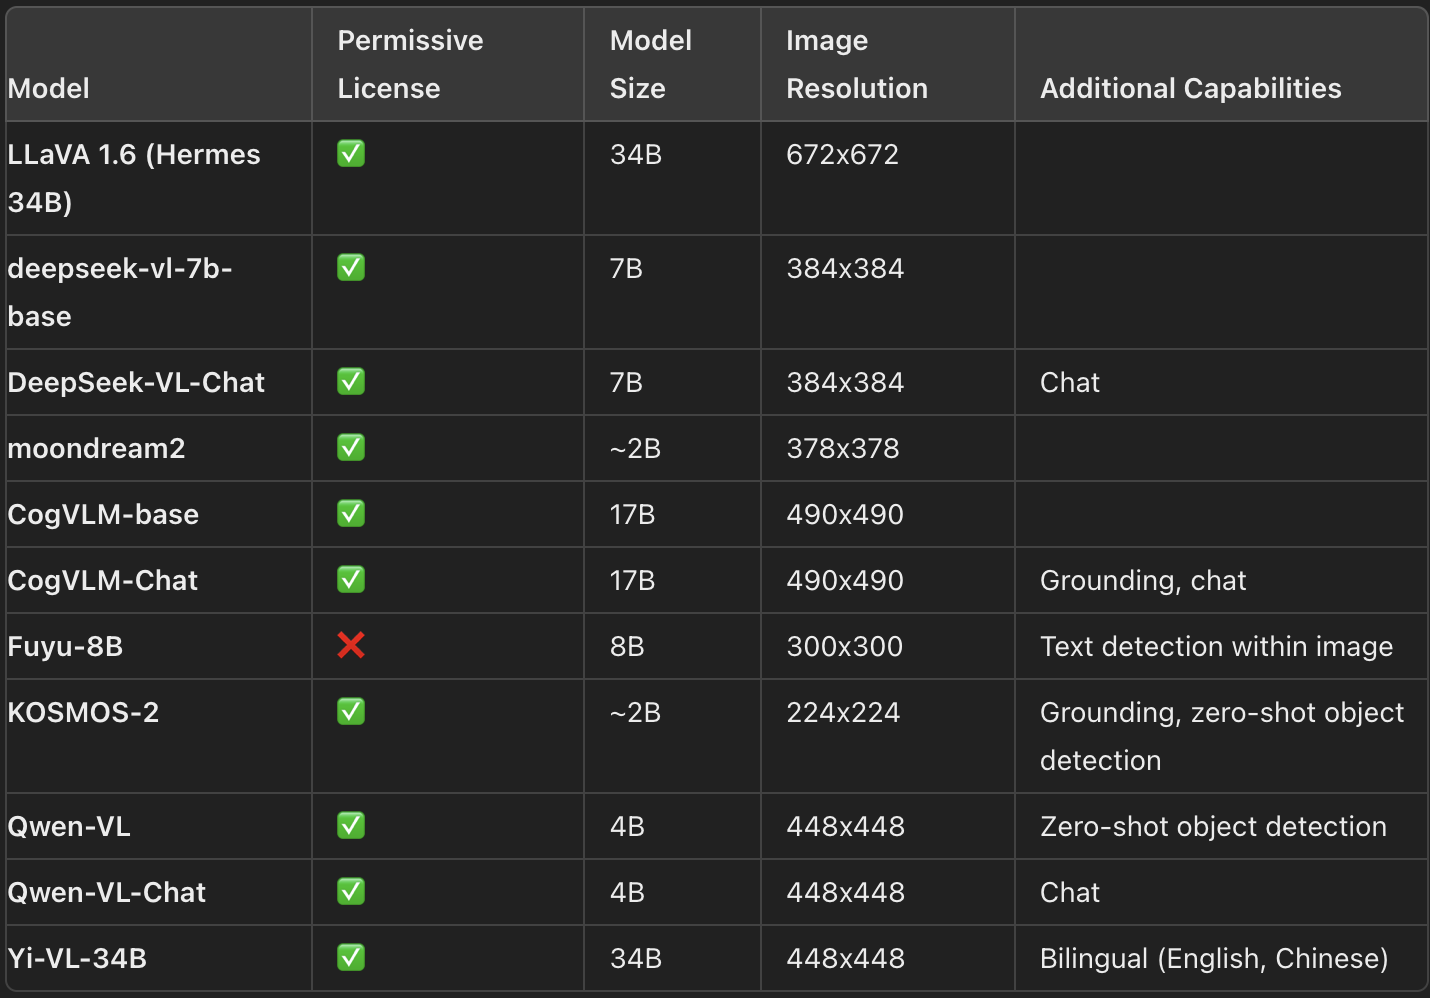
Nieuwste VLM's en hun belangrijkste kenmerken (Bron: HuggingFace)
Het kiezen van de meest geschikte VLM voor jouw specifieke usecase kan uitdagend zijn, gezien het aanbod. Verschillende tools en bronnen kunnen helpen bij deze selectie:
Hoewel zowel Vision Arena als het Open VLM Leaderboard waardevolle inzichten bieden, zijn ze beperkt tot ingediende modellen en vereisen ze regelmatige updates om nieuwe modellen op te nemen.
Er zijn verschillende benchmarks die vaak worden gebruikt om de prestaties van VLM's te evalueren:
Pretraining van VLM's houdt in dat beeld- en tekstrepresentaties worden verenigd om ze aan een tekstdecoder te voeren voor generatie. De structuur omvat doorgaans een beeldencoder, een embeddingprojector om beeld- en tekstrepresentaties uit te lijnen, en een tekstdecoder. Verschillende modellen hanteren echter verschillende pretrainingstrategieën.
In veel gevallen is het zelfs niet nodig om een VLM vooraf te trainen als je bestaande modellen kunt fijnafstellen voor jouw specifieke usecase. Tools zoals Transformers en SFTTrainer vereenvoudigen het fijn afstellen van modellen voor specifieke taken, waardoor dit zelfs met beperkte middelen haalbaar is.
Hier is een HuggingFace-implementatie om het open-sourcemodel LlavaNext gratis te gebruiken op je Colab of lokale machine met de Transformers-bibliotheek van HuggingFace.
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
    "llava-hf/llava-v1.6-mistral-7b-hf",
    torch_dtype=torch.float16,
    low_cpu_mem_usage=True
)
model.to(device)De mogelijkheden van vision language models reiken veel verder dan beeldbeschrijving. VLM's hebben de deur geopend naar talloze toepassingen die hun vermogen benutten om de kloof tussen visuele en tekstuele informatie te overbruggen. Laten we enkele van de meest impactvolle toepassingen van VLM's in verschillende sectoren verkennen.
Visual question answering (VQA) is een taak waarbij vragen over de inhoud van een afbeelding worden beantwoord.
Deze toepassing vereist dat het model zowel de visuele elementen in de afbeelding als de talige context van de vraag begrijpt. Bij een afbeelding van een bruisende stadsgezicht kan een VLM bijvoorbeeld vragen beantwoorden als "Wat is de kleur van het hoogste gebouw?" of "Hoeveel mensen zijn zichtbaar in de afbeelding?"
VQA kent talloze praktische toepassingen, vooral in sectoren waar visuele data een cruciale rol speelt. In de zorg kan VQA bijvoorbeeld worden ingezet om medische beelden te analyseren en antwoorden te geven die helpen bij diagnose en behandelplanning. In de retail kan VQA de shopervaring verbeteren door klanten op een natuurlijkere en intuïtievere manier met productafbeeldingen te laten interacten.
Een van de spannendste mogelijkheden van VLM's is tekst-naar-beeldgeneratie. Deze taak houdt in dat een visuele weergave van een scène of object wordt gegenereerd op basis van een tekstuele beschrijving. Een VLM kan bijvoorbeeld een prompt als "Een serene zonsondergang boven een bergketen met een rivier die door de vallei stroomt" omzetten in een bijbehorende afbeelding.
Tekst-naar-beeldgeneratie heeft enorm veel potentie in creatieve vakgebieden zoals design en advertising. Designers en marketeers kunnen deze technologie gebruiken om snel visuele ideeën te genereren op basis van tekstprompts. Tekst-naar-beeldgeneratie kan het proces stroomlijnen om visuele content te maken die aansluit bij specifieke marketingboodschappen.
Beeldopzoeking is het vinden van relevante afbeeldingen op basis van een tekstuele zoekvraag. VLM's blinken hierin uit dankzij hun vermogen om zowel de visuele inhoud van afbeeldingen als de talige context van de zoekvraag te begrijpen.
Deze mogelijkheid maakt zoekmachines krachtiger en preciezer, waardoor gebruikers eenvoudiger precies de afbeeldingen vinden die ze zoeken.
Beeldopzoeking kent toepassingen in uiteenlopende domeinen, van e-commerce tot medische beeldanalyse. In e-commerce helpt het klanten producten te vinden die passen bij hun voorkeuren op basis van visuele en tekstuele beschrijvingen. In de zorg kan beeldopzoeking professionals helpen relevante medische beelden te vinden voor onderzoek of diagnostiek.
Hoewel de bovenstaande voorbeelden zich op afbeeldingen richten, kunnen VLM's ook worden uitgebreid om video's te begrijpen en te ondertitelen. Videoverstaan houdt in dat de visuele inhoud van een video wordt geanalyseerd en beschrijvende tekst wordt gegenereerd die de essentie van de scènes vastlegt.
Videoverstaan is toepasbaar bij videozoektocht, samenvatting en contentmoderatie. Bij videozoektocht kunnen VLM's gebruikers helpen specifieke videoclips te vinden op basis van tekstuele zoekvragen. Bij samenvattingstaken kunnen VLM's beknopte samenvattingen van lange video's genereren, zodat gebruikers de inhoud sneller begrijpen. Bij contentmoderatie kunnen VLM's helpen ongepaste of schadelijke content in video's te identificeren, zodat platforms een veilige en gebruiksvriendelijke omgeving behouden.
Laten we nu de uitdagingen rond VLM's bekijken, evenals de ethische aspecten.
Het trainen en inzetten van VLM's vereist aanzienlijke rekenresources, vooral voor grote modellen zoals PaliGemma. Dit kan een drempel vormen voor organisaties met beperkte toegang tot high-performance computing-infrastructuur.
Om deze uitdaging aan te pakken onderzoeken onderzoekers manieren om VLM's efficiënter te maken, zoals modelcompressietechnieken, optimalisatie van de modelarchitectuur en het benutten van hardwareversnellers zoals GPU's en TPU's.
De ontwikkeling van VLM's roept verschillende ethische zorgen op, met name rond de mogelijkheid van bias in de output van het model. VLM's die zijn getraind op grootschalige, realistische beeld-tekstdata kunnen socioculturele vooroordelen weerspiegelen die in het trainingsmateriaal besloten liggen. Deze vooroordelen kunnen zich uiten in de output van het model en leiden tot schadelijke of aanstootgevende content.
Om deze zorgen te adresseren passen onderzoekers verschillende technieken toe om bias te verminderen, zoals gebalanceerde trainingsdatasets, fairnes-bewuste leeralgoritmen en grondige evaluaties van de modeloutput om mogelijke vooroordelen te identificeren en aan te pakken.
Daarnaast implementeren organisaties zoals Google contentveiligheidsfilters om ervoor te zorgen dat de trainingsdata voor modellen zoals PaliGemma schoon is en vrij van schadelijke inhoud.
Een ander belangrijk aandachtspunt bij de ontwikkeling van VLM's is privacy en databeveiliging. VLM's hebben vaak toegang nodig tot grote hoeveelheden data, waaronder mogelijk gevoelige informatie. Het is cruciaal om deze data veilig te verwerken en te voldoen aan privacyregelgeving om het vertrouwen van gebruikers en stakeholders te behouden.
Om privacyzorgen te adresseren worden technieken onderzocht zoals federated learning, waarmee modellen op gedecentraliseerde data kunnen worden getraind zonder gevoelige informatie naar een centrale server te verplaatsen.
Daarnaast voeren organisaties zoals Google maatregelen voor data-verantwoordelijkheid in, zoals het filteren van persoonlijke informatie en gevoelige data uit trainingsdatasets, om de privacy van individuen te beschermen.
Vision language models vormen een belangrijke stap vooruit in kunstmatige intelligentie en bieden de mogelijkheid om uiteenlopende toepassingen te verbeteren dankzij hun vermogen om zowel visuele als tekstuele data te verwerken.
Naarmate het onderzoek op dit gebied vordert, kunnen we de ontwikkeling verwachten van meer geavanceerde VLM's die complexe taken aankunnen en waardevolle inzichten bieden.
De integratie van visueel en tekstueel begrip opent nieuwe mogelijkheden voor innovatie, waardoor VLM's een veelbelovend gebied voor onderzoek en ontwikkeling zijn.
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

