

Wat is SAM2?
SAM2 is een foundationmodel van Meta voor promptbare visuele segmentatie in afbeeldingen en video’s. In tegenstelling tot zijn voorganger, SAM, dat zich vooral richtte op statische afbeeldingen, is SAM2 ook ontworpen om de complexiteit van videosegmentatie aan te kunnen.
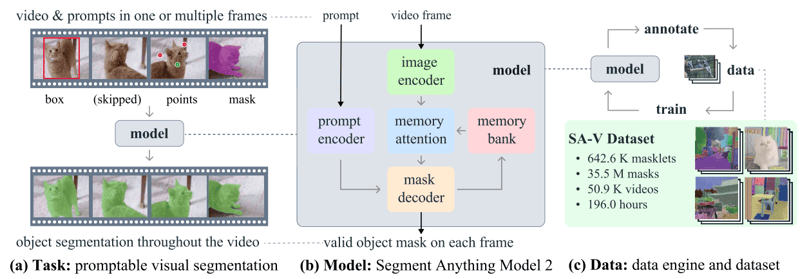
SAM2 - Taak, model en data (Bron: Ravi et al., 2024)
Het gebruikt een transformer-architectuur met streaminggeheugen, waardoor realtime videobewerking mogelijk is. SAM 2 is getraind op een groot en gevarieerd dataset, met onder meer het nieuwe SA-V-dataset met meer dan 600.000 “masklet”-annotaties over 51.000 video’s.
De data-engine, die interactieve dataverzameling en modelverbetering mogelijk maakt, geeft het model de mogelijkheid om ‘alles’ te segmenteren. Deze engine stelt SAM 2 in staat continu te leren en zich aan te passen, waardoor het efficiënter wordt bij nieuwe en uitdagende data. Voor domeinspecifieke taken of zeldzame objecten is fijn-afstemmen echter essentieel om optimale prestaties te behalen.
Waarom SAM2 fijn-afstemmen?
Binnen SAM 2 betekent fijn-afstemmen dat je het voorgetrainde SAM 2-model verder traint op een specifieke dataset om de prestaties voor een bepaalde taak of domein te verbeteren. Hoewel SAM 2 een krachtig hulpmiddel is, getraind op een brede en diverse dataset, levert het generieke karakter niet altijd de beste resultaten op bij specialistische of zeldzame taken.
Als je bijvoorbeeld werkt aan een medische imaging-opdracht waarbij specifieke tumortypes gedetecteerd moeten worden, kan de performance tegenvallen door de algemene training.
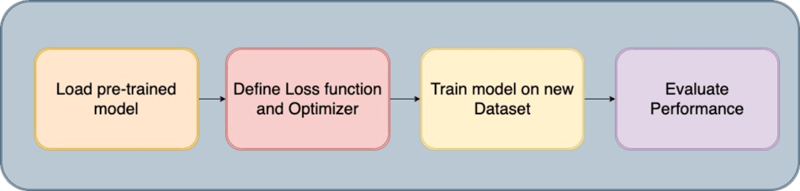
Het fijn-afstemmingsproces
SAM 2 fijn-afstemmen pakt deze beperking aan door het model aan te passen aan jouw dataset. Dit verbetert de nauwkeurigheid van het model en maakt het effectiever voor jouw specifieke toepassing.
Dit zijn de belangrijkste voordelen van SAM 2 fijn-afstemmen:
- Betere nauwkeurigheid: Door het model op jouw specifieke dataset te trainen, kun je de nauwkeurigheid flink verbeteren, wat zorgt voor betere prestaties in je beoogde toepassing.
- Gespecialiseerde segmentatie: Fijn-afstemmen maakt het model bedreven in het segmenteren van specifieke objecttypen, visuele stijlen of omgevingen die relevant zijn voor jouw project — resultaten op maat die een generiek model mogelijk niet haalt.
- Efficiëntie: Fijn-afstemmen is vaak efficiënter dan een model vanaf nul trainen. Je hebt doorgaans minder data en tijd nodig, waardoor het een praktische manier is om het model snel aan te passen aan nieuwe of niche-taken.
Aan de slag met SAM 2 fijn-afstemmen: vereisten
Om te beginnen met het fijn-afstemmen van SAM 2, heb je het volgende nodig:
- Toegang tot het SAM 2-model en de codebase: Zorg dat je toegang hebt tot het SAM 2-model en de codebase. Je kunt het voorgetrainde SAM 2-model downloaden vanuit Meta’s GitHub-repo.
- Een geschikte dataset: Je hebt een dataset nodig met ground-truth segmentatiemasks. In deze tutorial gebruiken we de Chest CT Segmentation-dataset, die je kunt downloaden en klaarmaken voor training.
- Rekenkracht: SAM 2 fijn-afstemmen vereist voldoende hardware. GPU’s zijn sterk aan te raden om het proces beheersbaar en efficiënt te houden, zeker bij grote datasets of complexe modellen. In dit voorbeeld gebruiken we een A100-GPU op Google Colab.
Software en overige vereisten:
- Python 3.11 of hoger
- PyTorch
- OpenCV: Installeer met !pip install opencv-python
De dataset voorbereiden voor SAM 2 fijn-afstemmen
De kwaliteit van je dataset is cruciaal voor het fijn-afstemmen van SAM 2. Hoogwaardige geannoteerde afbeeldingen of video’s met accurate segmentatiemasks zijn essentieel om optimale prestaties te behalen. Nauwkeurige annotaties helpen het model de juiste kenmerken te leren, wat leidt tot betere segmentatienauwkeurigheid en robuustheid in real-world toepassingen.
1. Data-acquisitie
De eerste stap is het verzamelen van de dataset, de ruggengraat van het trainingstraject. Wij haalden onze data van Kaggle, een betrouwbaar platform met een breed scala aan datasets. Met de Kaggle API hebben we de data in het vereiste formaat gedownload, zodat afbeeldingen en bijbehorende segmentatiemasks direct beschikbaar waren voor verdere verwerking.
2. Data-extractie en opschoning
Na het downloaden van de datasets hebben we het volgende gedaan:
- Uitpakken en opschonen: Pak de data uit de zipbestanden en verwijder onnodige bestanden om schijfruimte te besparen.
- ID-extractie: Unieke ID’s voor afbeeldingen en masks worden geëxtraheerd om tijdens training de juiste koppeling te garanderen.
- Onnodige bestanden verwijderen: Verwijder ruis of irrelevante bestanden, zoals afbeeldingen met bekende issues, om de integriteit van de dataset te waarborgen.
3. Conversie naar bruikbare formaten
Omdat SAM2 invoer in specifieke formaten vereist, hebben we de data als volgt geconverteerd:
- DICOM naar NumPy: De DICOM-afbeeldingen zijn ingelezen en opgeslagen als NumPy-arrays, daarna geresized naar 512×512 pixels.
- NRRD naar NumPy voor masks: NRRD-bestanden met masks voor longen, hart en luchtpijp zijn op dezelfde manier verwerkt en als NumPy-arrays opgeslagen. Deze masks zijn daarna passend gemaakt bij de overeenkomstige afbeeldingen.
- Conversie naar JPG/PNG: Voor betere visualisatie en compatibiliteit zijn de NumPy-arrays omgezet naar JPG/PNG. Hierbij zijn de intensiteitswaarden genormaliseerd en is gecontroleerd op de juiste oriëntatie van de masks.
4. Opslaan en organiseren van data
De verwerkte afbeeldingen en masks worden georganiseerd in aparte mappen voor gemakkelijke toegang tijdens het fijn-afstemmen. Daarnaast worden de paden naar deze afbeeldingen en masks weggeschreven naar een CSV-bestand (train.csv) om het laden tijdens training te vergemakkelijken.
5. Visualisatie en validatie
De laatste stap is het valideren van de dataset om de juistheid te garanderen:
- Visualisatie: We visualiseren de paren afbeelding-mask door de masks over de afbeeldingen te leggen. Zo kunnen we uitlijning en nauwkeurigheid controleren.
- Inspectie: Door een paar samples te bekijken, controleren we of de dataset correct is voorbereid en klaar is voor fijn-afstemmen.
Hier vind je een snelle notebook met code voor het maken van de dataset. Je kunt deze route volgen of direct een online dataset gebruiken in hetzelfde formaat als genoemd bij de vereisten.
SAM2 fijn-afstemmen
Segment Anything Model 2 bestaat uit meerdere componenten, maar de truc voor sneller fijn-afstemmen is om alleen lichte componenten te trainen, zoals de mask-decoder en prompt-encoder, in plaats van het hele model. De stappen zijn als volgt:
Stap 1: Installeer SAM-2
Om te starten installeren we de SAM-2-bibliotheek, cruciaal voor het Segment Anything Model (SAM2). Dit model is ontworpen om verschillende segmentatietaken effectief aan te pakken. De installatie houdt in dat je de SAM-2-repo van GitHub clonet en de benodigde dependencies installeert.
!git clone https://github.com/facebookresearch/segment-anything-2
%cd /content/segment-anything-2
!pip install -q -e .Deze snippet zorgt ervoor dat de SAM2-bibliotheek correct is geïnstalleerd en klaar voor gebruik in onze fijn-afstemmingsworkflow.
Stap 2: Download de dataset
Zodra de SAM-2-bibliotheek is geïnstalleerd, halen we de dataset op die we gebruiken voor het fijn-afstemmen. We gebruiken een dataset van Kaggle: een chest CT-segmentatieset met afbeeldingen en masks van longen, hart en luchtpijp.
De dataset bevat:
- images.zip: Afbeeldingen in RGB-formaat
- masks.zip: Segmentatiemasks in RGB-formaat
- train.csv: CSV-bestand met afbeeldingsnamen
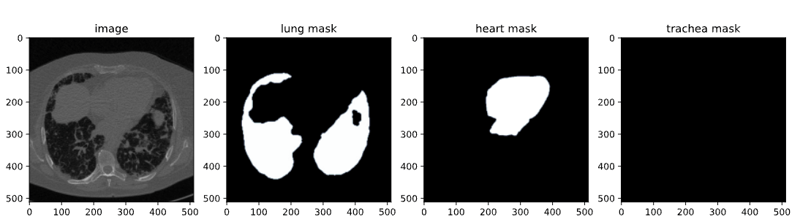
Afbeelding uit de CT-scan-dataset
In deze blog gebruiken we alleen afbeeldingen en masks van longen voor segmentatie. Met de Kaggle API kunnen we datasets direct naar onze omgeving downloaden. We beginnen met het uploaden van het kaggle.json-bestand van Kaggle om eenvoudig toegang te krijgen tot datasets.
Om kaggle.json te krijgen, ga je naar het tabblad Settings onder je gebruikersprofiel en kies je Create New Token. Dit start de download van kaggle.json, een bestand met je API-credentials.
# get dataset from Kaggle
from google.colab import files
files.upload() # This will prompt you to upload the kaggle.json file
!mkdir -p ~/.kaggle
!mv kaggle.json ~/.kaggle/
!chmod 600 ~/.kaggle/kaggle.json
!kaggle datasets download -d polomarco/chest-ct-segmentationPak de data uit:
!unzip chest-ct-segmentation.zip -d chest-ct-segmentationMet de dataset klaar kunnen we starten met fijn-afstemmen. Zoals eerder genoemd, is het idee om alleen de lichte componenten van SAM2 te trainen, zoals de mask-decoder en prompt-encoder, niet het hele model. Dit is efficiënter en vraagt minder resources.
Stap 3: SAM-2-checkpoints downloaden
Voor het fijn-afstemmen beginnen we met voorgetrainde SAM2-gewichten. Deze “checkpoints” vormen het startpunt voor verdere training. De checkpoints zijn getraind op een breed scala aan afbeeldingen, en door ze op onze specifieke dataset fijn te stemmen, behalen we betere resultaten voor onze doeltaken.
!wget -O sam2_hiera_tiny.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_tiny.pt"
!wget -O sam2_hiera_small.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_small.pt"
!wget -O sam2_hiera_base_plus.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_base_plus.pt"
!wget -O sam2_hiera_large.pt "https://dl.fbaipublicfiles.com/segment_anything_2/072824/sam2_hiera_large.pt"In deze stap downloaden we verschillende SAM-2-checkpoints die overeenkomen met verschillende modelgroottes (bijv. tiny, small, base_plus, large). De keuze hangt af van beschikbare rekenkracht en de specifieke taak.
Stap 4: Datavoorbereiding
Met de dataset binnen bereiden we deze voor op training. We splitsen de data in train- en testsets en maken datastructuren die we tijdens het fijn-afstemmen aan het SAM 2-model voeren.
%cd /content/segment-anything-2
import os
import pandas as pd
import cv2
import torch
import torch.nn.utils
import numpy as np
import matplotlib.pyplot as plt
import matplotlib.colors as mcolors
from sklearn.model_selection import train_test_split
from sam2.build_sam import build_sam2
from sam2.sam2_image_predictor import SAM2ImagePredictor
# Path to the chest-ct-segmentation dataset folder
data_dir = "/content/segment-anything-2/chest-ct-segmentation"
images_dir = os.path.join(data_dir, "images/images")
masks_dir = os.path.join(data_dir, "masks/masks")
# Load the train.csv file
train_df = pd.read_csv(os.path.join(data_dir, "train.csv"))
# Split the data into two halves: one for training and one for testing
train_df, test_df = train_test_split(train_df, test_size=0.2, random_state=42)
# Prepare the training data list
train_data = []
for index, row in train_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
train_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
# Prepare the testing data list (if needed for inference or evaluation later)
test_data = []
for index, row in test_df.iterrows():
image_name = row['ImageId']
mask_name = row['MaskId']
# Append image and corresponding mask paths
test_data.append({
"image": os.path.join(images_dir, image_name),
"annotation": os.path.join(masks_dir, mask_name)
})
We splitsen de dataset in een trainingset (80%) en een testset (20%) om de modelprestaties na training te kunnen evalueren. De trainingsdata gebruiken we om SAM 2 fijn te stemmen; de testdata voor inferentie en evaluatie.
Na het splitsen maak je binaire masks, selecteer je sleutelpunten binnen deze masks en visualiseer je deze elementen om te controleren of de data correct is verwerkt.
1. Afbeelden en resizen: We kiezen willekeurig een afbeelding en bijbehorend mask uit de dataset. De afbeelding wordt van BGR naar RGB omgezet, de standaard voor de meeste deep learning-modellen. De bijbehorende annotatie (mask) lezen we in als grijswaarden. Vervolgens resizen we zowel de afbeelding als het mask naar een maximale dimensie van 1024 pixels met behoud van aspectratio, zodat de invoer bij het model past en de rekentijd daalt.
def read_batch(data, visualize_data=False):
# Select a random entry
ent = data[np.random.randint(len(data))]
# Get full paths
Img = cv2.imread(ent["image"])[..., ::-1] # Convert BGR to RGB
ann_map = cv2.imread(ent["annotation"], cv2.IMREAD_GRAYSCALE) # Read annotation as grayscale
if Img is None or ann_map is None:
print(f"Error: Could not read image or mask from path {ent['image']} or {ent['annotation']}")
return None, None, None, 0
# Resize image and mask
r = np.min([1024 / Img.shape[1], 1024 / Img.shape[0]]) # Scaling factor
Img = cv2.resize(Img, (int(Img.shape[1] * r), int(Img.shape[0] * r)))
ann_map = cv2.resize(ann_map, (int(ann_map.shape[1] * r), int(ann_map.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
2. Binariseren van segmentatiemasks: De multiclass-annotatie (waarbij meerdere objectklassen verschillende pixelwaarden hebben) wordt omgezet naar één binair mask. Dit mask markeert alle interessegebieden en vereenvoudigt de taak tot object vs. achtergrond. Het binaire mask wordt vervolgens geërodeerd met een 5×5-kernel.
Erosie verkleint het mask licht, wat helpt om rand-effecten te vermijden bij het selecteren van punten. Zo vallen de gekozen punten binnen het object, weg van randen die ruis of ambiguïteit kunnen bevatten.
Kernpunten worden gekozen binnen het geërodeerde mask. Deze punten dienen als prompts tijdens het fijn-afstemmen en sturen het model waar het de aandacht op moet richten. De punten worden willekeurig uit het binnenste van de objecten gekozen om representatief te zijn en niet beïnvloed door randen.
### Continuation of read_batch() ###
# Initialize a single binary mask
binary_mask = np.zeros_like(ann_map, dtype=np.uint8)
points = []
# Get binary masks and combine them into a single mask
inds = np.unique(ann_map)[1:] # Skip the background (index 0)
for ind in inds:
mask = (ann_map == ind).astype(np.uint8) # Create binary mask for each unique index
binary_mask = np.maximum(binary_mask, mask) # Combine with the existing binary mask
# Erode the combined binary mask to avoid boundary points
eroded_mask = cv2.erode(binary_mask, np.ones((5, 5), np.uint8), iterations=1)
# Get all coordinates inside the eroded mask and choose a random point
coords = np.argwhere(eroded_mask > 0)
if len(coords) > 0:
for _ in inds: # Select as many points as there are unique labels
yx = np.array(coords[np.random.randint(len(coords))])
points.append([yx[1], yx[0]])
points = np.array(points)
3. Visualisatie: Deze stap is belangrijk om te verifiëren dat de preprocessing correct is. Door de punten op het binair gemaakte mask te bekijken, weet je zeker dat het model tijdens training de juiste input krijgt. Tot slot wordt het binaire mask in de juiste vorm gebracht (dimensies geschikt voor modelinvoer) en worden de punten eveneens geherstructureerd voor gebruik tijdens training. De functie retourneert de verwerkte afbeelding, het binaire mask, de geselecteerde punten en het aantal gevonden masks.
### Continuation of read_batch() ###
if visualize_data:
# Plotting the images and points
plt.figure(figsize=(15, 5))
# Original Image
plt.subplot(1, 3, 1)
plt.title('Original Image')
plt.imshow(img)
plt.axis('off')
# Segmentation Mask (binary_mask)
plt.subplot(1, 3, 2)
plt.title('Binarized Mask')
plt.imshow(binary_mask, cmap='gray')
plt.axis('off')
# Mask with Points in Different Colors
plt.subplot(1, 3, 3)
plt.title('Binarized Mask with Points')
plt.imshow(binary_mask, cmap='gray')
# Plot points in different colors
colors = list(mcolors.TABLEAU_COLORS.values())
for i, point in enumerate(points):
plt.scatter(point[0], point[1], c=colors[i % len(colors)], s=100, label=f'Point {i+1}') # Corrected to plot y, x order
# plt.legend()
plt.axis('off')
plt.tight_layout()
plt.show()
binary_mask = np.expand_dims(binary_mask, axis=-1) # Now shape is (1024, 1024, 1)
binary_mask = binary_mask.transpose((2, 0, 1))
points = np.expand_dims(points, axis=1)
# Return the image, binarized mask, points, and number of masks
return img, binary_mask, points, len(inds)
# Visualize the data
Img1, masks1, points1, num_masks = read_batch(train_data, visualize_data=True)
Bovenstaande code levert onderstaande figuur op met de originele afbeelding, het binair gemaakte mask en het binair gemaakte mask met punten.
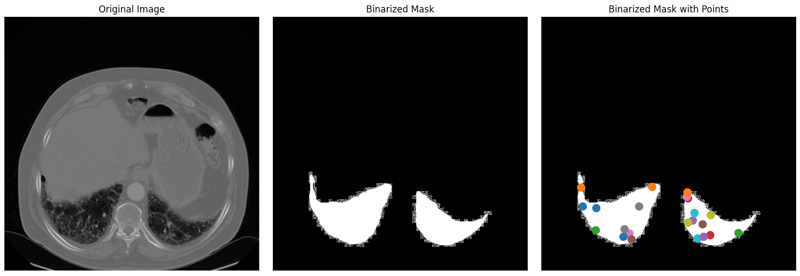
Originele afbeelding, binair mask, en binair mask met punten voor de dataset.
Stap 5: Het SAM2-model fijn-afstemmen
Fijn-afstemmen van SAM2 omvat meerdere stappen: het model laden, de optimizer en scheduler instellen en iteratief de modelgewichten bijwerken op basis van de trainingsdata.
Laad de model-checkpoints:
sam2_checkpoint = "sam2_hiera_small.pt" # @param ["sam2_hiera_tiny.pt", "sam2_hiera_small.pt", "sam2_hiera_base_plus.pt", "sam2_hiera_large.pt"]
model_cfg = "sam2_hiera_s.yaml" # @param ["sam2_hiera_t.yaml", "sam2_hiera_s.yaml", "sam2_hiera_b+.yaml", "sam2_hiera_l.yaml"]
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
predictor = SAM2ImagePredictor(sam2_model)
We bouwen het SAM2-model met de voorgetrainde checkpoints. Het model wordt vervolgens verpakt in een predictor-klasse, wat het instellen van afbeeldingen, het encoden van prompts en het decoderen van masks vereenvoudigt.
Hyperparameters configureren
We configureren verschillende hyperparameters, zoals learning rate, weight decay en gradient accumulation. Deze bepalen onder meer hoe snel gewichten worden bijgewerkt en hoe overfitting wordt tegengegaan. Voel je vrij hiermee te experimenteren.
# Train mask decoder.
predictor.model.sam_mask_decoder.train(True)
# Train prompt encoder.
predictor.model.sam_prompt_encoder.train(True)
# Configure optimizer.
optimizer=torch.optim.AdamW(params=predictor.model.parameters(),lr=0.0001,weight_decay=1e-4) #1e-5, weight_decay = 4e-5
# Mix precision.
scaler = torch.cuda.amp.GradScaler()
# No. of steps to train the model.
NO_OF_STEPS = 3000 # @param
# Fine-tuned model name.
FINE_TUNED_MODEL_NAME = "fine_tuned_sam2"
De optimizer is verantwoordelijk voor het bijwerken van de gewichten, terwijl de scheduler de learning rate tijdens training aanpast voor betere convergentie. Door deze parameters goed af te stemmen, kun je de segmentatienauwkeurigheid verbeteren.
Training starten
Het eigenlijke fijn-afstemmen is iteratief: in elke stap gaat een batch met alleen longafbeeldingen en -masks door het model, en de loss wordt berekend en gebruikt om de gewichten bij te werken.
# Initialize scheduler
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=500, gamma=0.2) # 500 , 250, gamma = 0.1
accumulation_steps = 4 # Number of steps to accumulate gradients before updating
for step in range(1, NO_OF_STEPS + 1):
with torch.cuda.amp.autocast():
image, mask, input_point, num_masks = read_batch(train_data, visualize_data=False)
if image is None or mask is None or num_masks == 0:
continue
input_label = np.ones((num_masks, 1))
if not isinstance(input_point, np.ndarray) or not isinstance(input_label, np.ndarray):
continue
if input_point.size == 0 or input_label.size == 0:
continue
predictor.set_image(image)
mask_input, unnorm_coords, labels, unnorm_box = predictor._prep_prompts(input_point, input_label, box=None, mask_logits=None, normalize_coords=True)
if unnorm_coords is None or labels is None or unnorm_coords.shape[0] == 0 or labels.shape[0] == 0:
continue
sparse_embeddings, dense_embeddings = predictor.model.sam_prompt_encoder(
points=(unnorm_coords, labels), boxes=None, masks=None,
)
batched_mode = unnorm_coords.shape[0] > 1
high_res_features = [feat_level[-1].unsqueeze(0) for feat_level in predictor._features["high_res_feats"]]
low_res_masks, prd_scores, _, _ = predictor.model.sam_mask_decoder(
image_embeddings=predictor._features["image_embed"][-1].unsqueeze(0),
image_pe=predictor.model.sam_prompt_encoder.get_dense_pe(),
sparse_prompt_embeddings=sparse_embeddings,
dense_prompt_embeddings=dense_embeddings,
multimask_output=True,
repeat_image=batched_mode,
high_res_features=high_res_features,
)
prd_masks = predictor._transforms.postprocess_masks(low_res_masks, predictor._orig_hw[-1])
gt_mask = torch.tensor(mask.astype(np.float32)).cuda()
prd_mask = torch.sigmoid(prd_masks[:, 0])
seg_loss = (-gt_mask * torch.log(prd_mask + 0.000001) - (1 - gt_mask) * torch.log((1 - prd_mask) + 0.00001)).mean()
inter = (gt_mask * (prd_mask > 0.5)).sum(1).sum(1)
iou = inter / (gt_mask.sum(1).sum(1) + (prd_mask > 0.5).sum(1).sum(1) - inter)
score_loss = torch.abs(prd_scores[:, 0] - iou).mean()
loss = seg_loss + score_loss * 0.05
# Apply gradient accumulation
loss = loss / accumulation_steps
scaler.scale(loss).backward()
# Clip gradients
torch.nn.utils.clip_grad_norm_(predictor.model.parameters(), max_norm=1.0)
if step % accumulation_steps == 0:
scaler.step(optimizer)
scaler.update()
predictor.model.zero_grad()
# Update scheduler
scheduler.step()
if step % 500 == 0:
FINE_TUNED_MODEL = FINE_TUNED_MODEL_NAME + "_" + str(step) + ".torch"
torch.save(predictor.model.state_dict(), FINE_TUNED_MODEL)
if step == 1:
mean_iou = 0
mean_iou = mean_iou * 0.99 + 0.01 * np.mean(iou.cpu().detach().numpy())
if step % 100 == 0:
print("Step " + str(step) + ":\t", "Accuracy (IoU) = ", mean_iou)
In elke iteratie verwerkt het model een batch afbeeldingen, berekent segmentatiemasks en vergelijkt deze met de ground truth om de loss te berekenen. Op basis daarvan worden de gewichten aangepast en verbetert de performance geleidelijk. Na ongeveer 3000 epochs behalen we een nauwkeurigheid (IoU - Intersection over Union) van circa 72%.
Stap 6: Inferentie met het fijn-afgestemde model
Het model kan nu worden gebruikt voor inferentie, waarbij het segmentatiemasks voorspelt op nieuwe, ongeziene afbeeldingen. Begin met de helperfuncties read_images en get_points om de inferentie-afbeelding, het mask en de sleutelpunten op te halen.
def read_image(image_path, mask_path): # read and resize image and mask
img = cv2.imread(image_path)[..., ::-1] # Convert BGR to RGB
mask = cv2.imread(mask_path, 0)
r = np.min([1024 / img.shape[1], 1024 / img.shape[0]])
img = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
mask = cv2.resize(mask, (int(mask.shape[1] * r), int(mask.shape[0] * r)), interpolation=cv2.INTER_NEAREST)
return img, mask
def get_points(mask, num_points): # Sample points inside the input mask
points = []
coords = np.argwhere(mask > 0)
for i in range(num_points):
yx = np.array(coords[np.random.randint(len(coords))])
points.append([[yx[1], yx[0]]])
return np.array(points)Laad vervolgens de voorbeeldafbeeldingen voor inferentie samen met de nieuw fijn-afgestemde gewichten, en voer inferentie uit met torch.no_grad().
# Randomly select a test image from the test_data
selected_entry = random.choice(test_data)
image_path = selected_entry['image']
mask_path = selected_entry['annotation']
# Load the selected image and mask
image, mask = read_image(image_path, mask_path)
# Generate random points for the input
num_samples = 30 # Number of points per segment to sample
input_points = get_points(mask, num_samples)
# Load the fine-tuned model
FINE_TUNED_MODEL_WEIGHTS = "fine_tuned_sam2_1000.torch"
sam2_model = build_sam2(model_cfg, sam2_checkpoint, device="cuda")
# Build net and load weights
predictor = SAM2ImagePredictor(sam2_model)
predictor.model.load_state_dict(torch.load(FINE_TUNED_MODEL_WEIGHTS))
# Perform inference and predict masks
with torch.no_grad():
predictor.set_image(image)
masks, scores, logits = predictor.predict(
point_coords=input_points,
point_labels=np.ones([input_points.shape[0], 1])
)
# Process the predicted masks and sort by scores
np_masks = np.array(masks[:, 0])
np_scores = scores[:, 0]
sorted_masks = np_masks[np.argsort(np_scores)][::-1]
# Initialize segmentation map and occupancy mask
seg_map = np.zeros_like(sorted_masks[0], dtype=np.uint8)
occupancy_mask = np.zeros_like(sorted_masks[0], dtype=bool)
# Combine masks to create the final segmentation map
for i in range(sorted_masks.shape[0]):
mask = sorted_masks[i]
if (mask * occupancy_mask).sum() / mask.sum() > 0.15:
continue
mask_bool = mask.astype(bool)
mask_bool[occupancy_mask] = False # Set overlapping areas to False in the mask
seg_map[mask_bool] = i + 1 # Use boolean mask to index seg_map
occupancy_mask[mask_bool] = True # Update occupancy_mask
# Visualization: Show the original image, mask, and final segmentation side by side
plt.figure(figsize=(18, 6))
plt.subplot(1, 3, 1)
plt.title('Test Image')
plt.imshow(image)
plt.axis('off')
plt.subplot(1, 3, 2)
plt.title('Original Mask')
plt.imshow(mask, cmap='gray')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.title('Final Segmentation')
plt.imshow(seg_map, cmap='jet')
plt.axis('off')
plt.tight_layout()
plt.show()In deze stap gebruiken we het fijn-afgestemde model om segmentatiemasks te genereren voor testafbeeldingen. De voorspelde masks worden naast de originele afbeeldingen en ground-truth-masks gevisualiseerd om de prestaties te beoordelen.
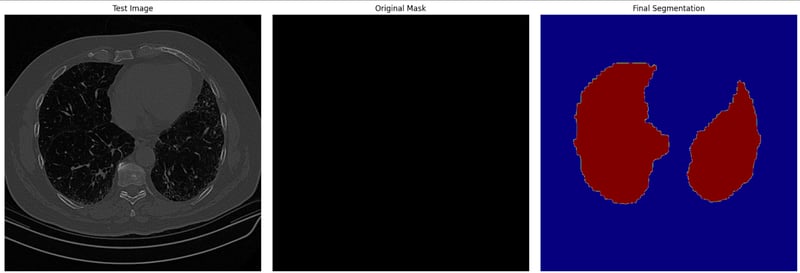
Definitieve segmentatieafbeelding op testdata
Conclusie
SAM2 fijn-afstemmen is een praktische manier om de capaciteiten voor specifieke taken te vergroten. Of je nu werkt aan medische beeldvorming, autonome voertuigen of video-editing, met fijn-afstemmen pas je SAM2 aan jouw behoeften aan. Volg deze gids om SAM2 voor je projecten te gebruiken en segmentatieresultaten op state-of-the-art-niveau te behalen.
Voor geavanceerdere use cases kun je ook extra componenten van SAM2 fijn-afstemmen, zoals de image-encoder. Dat vergt meer resources, maar biedt meer flexibiliteit en prestatiewinst.

Ik ben een Google Developers Expert in ML (Gen AI), een Kaggle 3x Expert en een Women Techmakers Ambassador met meer dan 3 jaar ervaring in tech. In 2020 heb ik een healthtech-startup mee opgericht en ik volg een master computer science aan Georgia Tech, met als specialisatie machine learning.


Meta's Segment Anything Model 2 (SAM 2) was Meta’s eerste uniforme model dat objecten in zowel afbeeldingen als video’s in realtime kan segmenteren. Het is inmiddels opgevolgd door SAM3, waar je meer over leest in onze SAM3-tutorial.
Maar waarom zou je SAM 2 fijn-afstemmen als het al ‘alles’ kan segmenteren?
Hoewel SAM 2 out-of-the-box krachtig is, voldoet de performance bij zeldzame of domeinspecifieke taken niet altijd aan de verwachtingen. Fijn-afstemmen stelt je in staat SAM2 aan jouw specifieke behoeften aan te passen, waardoor nauwkeurigheid en efficiëntie voor jouw use case verbeteren.
In dit artikel neem ik je stap voor stap mee door het fijn-afstemmingsproces van SAM 2.