
Leerpad
AI-basisprincipes
10 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleAls je de technologische ontwikkelingen een beetje volgt, heb je de term ‘Large Language Models (LLM’s)’ vast voorbij horen komen. LLM’s zijn momenteel de populairste techterm, en hun betekenis in de wereld van kunstmatige intelligentie (AI) groeit met de dag. LLM’s blijven de generatieve AI-revolutie aanjagen doordat deze modellen leren om menselijke talen te verwerken, zoals ChatGPT en Bard.
LLM’s zijn tegenwoordig een belangrijke speler op de zich snel ontwikkelende markt dankzij hun vermogen om menselijke gesprekken te spiegelen via geavanceerde natural language processing (NLP). Natuurlijk heeft alles zijn beperkingen, en AI-assistenten kennen hun eigen uitdagingen.
Die specifieke uitdaging is de kans op LLM-bias, die verankerd is in de data waarmee de modellen zijn getraind.
Laten we een stap terug doen. Wat zijn LLM’s?
LLM’s zijn AI-systemen zoals ChatGPT, die worden gebruikt om menselijke taal te modelleren en te verwerken. Het is een type AI-algoritme dat deep learning-technieken gebruikt om nieuwe inhoud samen te vatten, te genereren en te voorspellen. Ze heten “large” omdat het model miljoenen of zelfs miljarden parameters nodig heeft, die worden gebruikt om het model te trainen met een ‘grote’ corpus aan tekstdata.
LLM’s en NLP gaan hand in hand: ze streven ernaar de menselijke taal en haar patronen goed te begrijpen en kennis te vergaren met behulp van grote datasets.
Ben je nieuw in de wereld van LLM’s? Lees dan het volgende artikel om snel bij te raken:
Wat is een LLM? Een gids over Large Language Models en hoe ze werken. Of volg onze Large Language Models (LLMs) Concepts-cursus, die ook ideaal is om over LLM’s te leren.
LLM’s worden veel gebruikt in verschillende soorten AI-toepassingen. Ze worden met de dag populairder, en bedrijven zoeken naar manieren om ze in hun huidige systemen en tooling te integreren om de workflowproductiviteit te verbeteren.
LLM’s kunnen worden ingezet voor de volgende use-cases:
LLM’s gebruiken Transformer-modellen, een deep learning-architectuur die context leert en begrijpt via sequentiële data-analyse.
Tokenization houdt in dat invoertekst wordt opgesplitst in kleinere eenheden, zogeheten tokens, zodat het model die kan verwerken en analyseren via wiskundige vergelijkingen om de relaties tussen de verschillende tokens te ontdekken. Het wiskundige proces bestaat uit een probabilistische aanpak om tijdens de trainingsfase van het model de volgende woordreeksen te voorspellen.
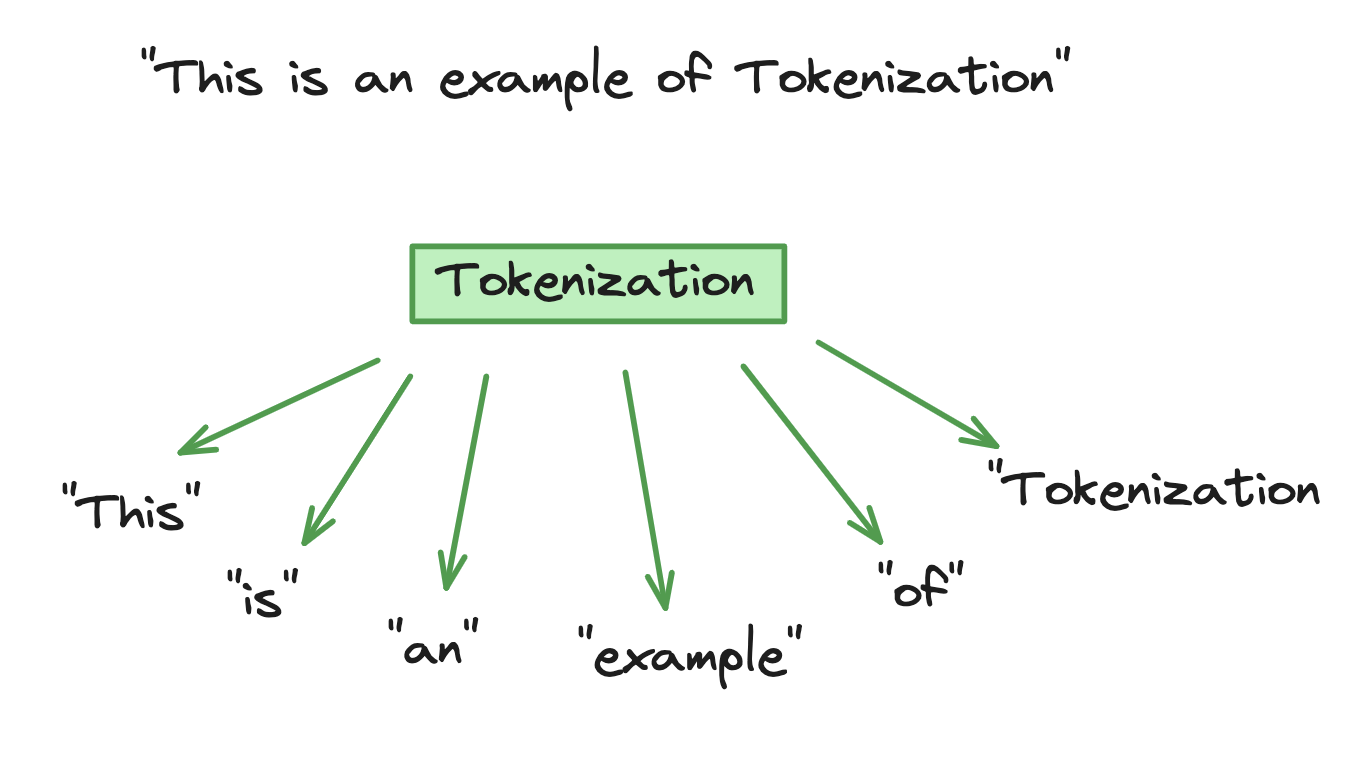
Voorbeeld van tokenization
De trainingsfase bestaat uit het voeren van enorme hoeveelheden tekstdata aan het model om het verschillende taalkundige contexten, nuances en stijlen te laten begrijpen. LLM’s bouwen zo een kennisbasis op waarmee ze de menselijke taal effectief kunnen nabootsen.
De veelzijdigheid en het taalbegrip van LLM’s getuigen van hun geavanceerde AI-capaciteit. Training op omvangrijke datasets uit uiteenlopende genres en stijlen, zoals juridische documenten en fictieve verhalen, geeft LLM’s het vermogen zich aan te passen aan verschillende scenario’s en contexten.
Maar de veelzijdigheid van LLM’s gaat verder dan tekstvoorspelling. Taken aankunnen in verschillende talen, contexten en outputvormen is een type veelzijdigheid dat zichtbaar is in uiteenlopende toepassingen zoals klantenservice. Dit is te danken aan de uitgebreide training op grote, specifieke datasets en het fine-tunen, wat de effectiviteit in diverse domeinen heeft vergroot.
Toch moeten we de unieke uitdaging van LLM’s niet vergeten: bias.
Zoals we weten, worden LLM’s getraind op allerlei tekstdata uit diverse bronnen. Wanneer die data in het model wordt ingevoerd, gebruikt het die als enige kennisbasis en interpreteert het die als feitelijk. Maar de data kan vooringenomenheden en desinformatie bevatten, waardoor de outputs van de LLM bias kunnen weerspiegelen.
Een tool die bekendstaat om productiviteit te verhogen en te helpen bij dagelijkse taken, vertoont hiermee ethische aandachtspunten. Je kunt meer leren over de ethiek van AI in onze cursus.
Hoe meer data, hoe beter. Als de trainingsdata voor LLM’s niet-representatieve steekproeven of biases bevat, zal het model die biases vanzelf overnemen en leren. Voorbeelden van LLM-bias zijn gender-, ras- en culturele bias.
Zo kunnen LLM’s bevooroordeeld raken ten aanzien van genders als het merendeel van hun data laat zien dat vrouwen vooral als schoonmaker of verpleegkundige werken en mannen typisch als engineer of CEO. De LLM heeft maatschappelijke stereotypen overgenomen door de trainingsdata die erin is gestopt. Een ander voorbeeld is raciale bias, waarbij LLM’s bepaalde etnische groepen volgens stereotypen kunnen weergeven, evenals culturele bias door overrepresentatie die in het stereotype past.
De twee belangrijkste oorsprongen van bias in LLM’s zijn:
Hoewel LLM’s zeer veelzijdig zijn, laat deze uitdaging zien dat het model minder effectief is bij multiculturele content. De zorg rondom LLM’s en bias komt neer op het gebruik van LLM’s in besluitvormingsprocessen, wat logischerwijs ethische zorgen oproept.
De impact van bias in LLM’s raakt zowel de gebruikers van het model als de bredere samenleving.
Zoals hierboven aangestipt zijn er verschillende soorten stereotypen, zoals cultureel en gender. Bias in de trainingsdata van LLM’s blijft deze schadelijke stereotypen bestendigen, waardoor de samenleving in een cyclus van vooroordelen blijft en vooruitgang wordt tegengehouden.
Als LLM’s bevooroordeelde data blijven verwerken, zullen ze culturele verdeeldheid en genderongelijkheid blijven aanwakkeren.
Discriminatie is de bevooroordeelde behandeling van verschillende categorieën mensen op basis van hun geslacht, etniciteit, leeftijd of beperking. Trainingsdata kan sterk ondervertegenwoordigd zijn, waardoor de data geen waarheidsgetrouwe weergave geeft van verschillende groepen.
Outputs van LLM’s die bevooroordeelde reacties bevatten en raciale, gender- en leeftijdsdiscriminatie in stand houden, versterken de negatieve impact op het dagelijks leven van mensen uit gemarginaliseerde gemeenschappen, bijvoorbeeld in het wervingsproces of bij onderwijskansen. Dit leidt tot een gebrek aan diversiteit en inclusiviteit in LLM-outputs en roept ethische vragen op, omdat deze outputs verder kunnen worden gebruikt in besluitvorming.
Als er zorgen zijn dat de trainingsdata voor LLM’s niet-representatieve steekproeven of biases bevat, rijst ook de vraag of de data wel de juiste informatie bevat. Verspreiding van mis- of desinformatie via LLM’s kan verstrekkende gevolgen hebben.
Zo kan in de zorg het gebruik van LLM’s met bevooroordeelde informatie leiden tot gevaarlijke gezondheidsbeslissingen. Een ander voorbeeld is LLM’s met politiek bevooroordeelde data die een narratief uitdragen dat kan leiden tot politieke desinformatie.
De ethische zorgen rond LLM’s zijn niet de enige reden waarom een deel van de samenleving moeite heeft met de invoering van AI-systemen in ons dagelijks leven. Sommige, of veel, mensen maken zich zorgen over het gebruik van AI-systemen en de impact op onze samenleving, zoals baanverlies en economische instabiliteit.
Er is al een gebrek aan vertrouwen in AI-systemen. De bias die LLM’s produceren kan daarom het resterende vertrouwen of de resterende zekerheid die de samenleving in AI heeft volledig ondermijnen. Wil LLM-technologie met vertrouwen worden geaccepteerd, dan moet de samenleving erop kunnen vertrouwen.
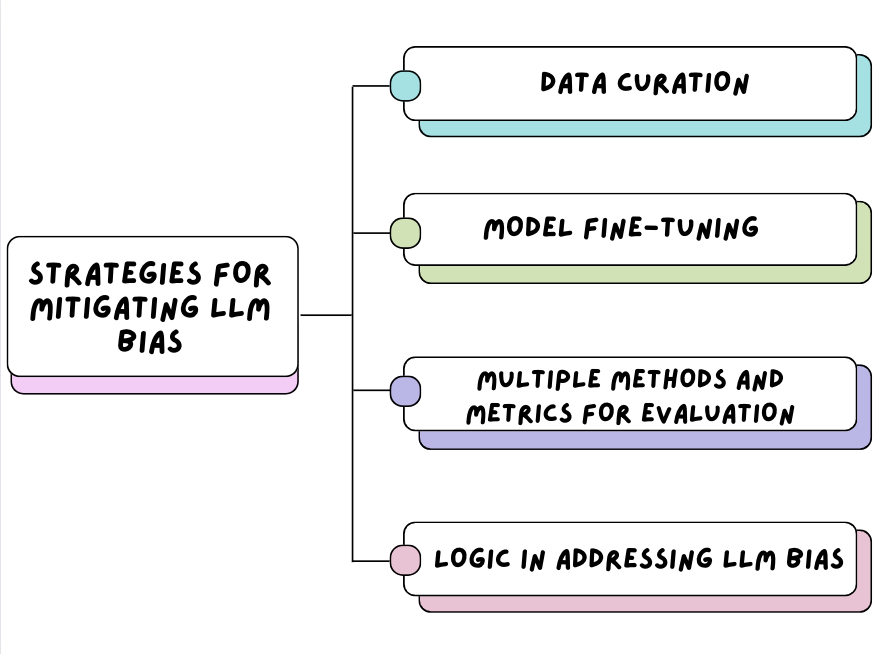
Strategieën om LLM-bias te beperken
We beginnen bij het begin: de data. Bedrijven moeten zeer verantwoordelijk omgaan met het type data dat ze in modellen stoppen.
Zorg ervoor dat de trainingsdata voor LLM’s is samengesteld uit een diverse reeks databronnen. Tekstdatasets afkomstig uit verschillende demografieën, talen en culturen zorgen voor een evenwichtige representatie van de menselijke taal. Dit voorkomt dat de trainingsdata niet-representatieve steekproeven bevat en stuurt gerichte fine-tune-inspanningen, wat de impact van bias kan verminderen wanneer het door de bredere gemeenschap wordt gebruikt.
Zodra een reeks databronnen is verzameld en in het model is ingevoerd, kunnen organisaties de nauwkeurigheid blijven verbeteren en bias verminderen via model fine-tuning. Er zijn verschillende fine-tuningbenaderingen, zoals:
Je kunt meer leren over het fine-tuneproces met onze Fine-Tuning LLaMA 2-tutorial, met een stapsgewijze handleiding om het voorgetrainde model aan te passen.
Om AI-systemen te blijven ontwikkelen die veilig in de samenleving kunnen worden geïntegreerd, moeten organisaties meerdere methoden en metriek in hun evaluatieproces gebruiken. Voordat AI-systemen zoals LLM’s worden opengesteld voor de brede gemeenschap, moeten de juiste methoden en metriek worden geïmplementeerd om te waarborgen dat de verschillende dimensies van bias in LLM-outputs worden vastgelegd.
Voorbeelden van methoden zijn menselijke evaluatie, automatische evaluatie of hybride evaluatie. Al deze methoden worden gebruikt om bias in LLM’s te detecteren, te schatten of te filteren. Voorbeelden van metriek zijn nauwkeurigheid, sentiment, eerlijkheid en meer. Deze metriek kan feedback geven over bias in LLM-outputs en helpen om biases in LLM’s continu te verbeteren.
Wil je meer leren over de verschillende evaluaties die worden gebruikt om de kwaliteit van LLM’s te verbeteren? Bekijk dan onze code-along over LLM-responses evalueren.
Een studie van MIT’s Computer Science and Artificial Intelligence Laboratory (CSAIL) heeft aanzienlijke vooruitgang geboekt met LLM’s door logische redeneringen te integreren: Large language models are biased. Can logic help save them?
Het belang van logisch en gestructureerd denken in LLM’s stelt de modellen in staat om outputs te verwerken en te genereren met toepassing van logisch redeneren en kritisch denken, zodat LLM’s nauwkeurigere antwoorden kunnen geven met de onderliggende redenatie daarbij.
Het proces bestaat uit het bouwen van een neutraal taalmodel waarin de relaties tussen tokens als ‘neutraal’ worden beschouwd, omdat er geen logica is die stelt dat er een relatie tussen beide is. CSAIL trainde deze methode op een taalmodel en ontdekte dat het nieuw getrainde model minder bevooroordeeld was zonder extra data of aanvullende algoritmetraining.
Logica-bewuste taalmodellen zullen in staat zijn schadelijke stereotypen te vermijden.
Google Research blijft zijn LLM BERT verbeteren door de trainingsdata uit te breiden om inclusiever en diverser te zijn. Het gebruik van grote datasets met niet-geannoteerde tekst voor de pre-trainingsfase stelde het model in staat later te worden gefine-tuned voor specifieke taken. Het doel is een LLM te creëren die minder bevooroordeeld is en robuustere outputs produceert. Google Research stelt dat deze methode geleid heeft tot een afname van door het model gegenereerde stereotiepe outputs en dat de prestaties blijven verbeteren in het begrijpen van verschillende dialecten en culturele contexten.
Het team van Google Research heeft verschillende tools ontwikkeld onder de naam ‘Fairness Indicators’, die bias in machinelearningmodellen willen detecteren en vervolgens mitigeren. Deze indicatoren gebruiken metriek zoals false positives en false negatives om prestaties te evalueren en hiaten te identificeren die door algemene metriek mogelijk verborgen blijven.
OpenAI heeft de brede gemeenschap verzekerd dat veiligheid, privacy en ethische overwegingen voorop staan in hun doelen. Hun pre-training mitigations voor DALL-E 2 omvatten het filteren van gewelddadige en seksuele afbeeldingen uit de trainingsdataset, het verwijderen van afbeeldingen die visueel sterk op elkaar lijken, en vervolgens het model leren om de effecten van het filteren van de dataset te mitigeren.
Het ene bereiken zonder het andere op te offeren is soms lastig. Dat geldt ook voor het vinden van een balans tussen het verminderen van LLM-bias en het behouden of zelfs verbeteren van de modelprestaties. Debiasing van modellen is essentieel om eerlijkheid te bereiken. Toch mogen prestaties en nauwkeurigheid niet in het gedrang komen.
Er is een strategische aanpak nodig om te waarborgen dat mitigatiemethoden om bias te verkleinen, zoals datacuratie, model fine-tuning en het gebruik van meerdere methoden, het vermogen van het model om taaloutputs te begrijpen en te genereren niet aantasten. Er moeten verbeteringen worden doorgevoerd, maar de prestaties van het model mogen geen wisselgeld zijn.
Het is een kwestie van trial-and-error, monitoren en bijstellen, debiasing en verbeteren.
In dit artikel hebben we behandeld:
LLM-bias is een complexe, veelzijdige uitdaging die prioriteit moet krijgen zodat de samenleving er meer vertrouwen in krijgt en de integratie in alledaagse taken vrijelijk accepteert. Organisaties moeten de blijvende negatieve impact begrijpen die stereotypen hebben op individuen en de samenleving, en dit benutten om een pad uit te stippelen voor het mitigeren van LLM-bias via datacuratie, model fine-tuning en logisch modelleren.
Wil je meer leren over LLM’s? Bekijk dan onze cursus Large Language Models Concepts, waarin wordt behandeld hoe deze krachtige tools het AI-landschap opnieuw vormgeven.
Begin vandaag nog aan je AI-reis!
Leerpad
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

