Cursus
Agentic Systems ontwerpen met LangChain
3 uur
14.8K
Je hebt toegang tot de volledige code van deze demo hier.
Nemotron 3 Super is NVIDIA’s open reasoning-model voor agentische en long-context-workflows. Het gebruikt een hybride Mamba-Transformer Latent MoE-architectuur met 120B totale parameters en 12B actieve parameters, bevat multi-token prediction (MTP), en is ontworpen voor taken met veel redeneren zoals coderen, toolgebruik en long-context-analyse.
NVIDIA positioneert het specifiek voor complexe multi-agent-applicaties en redeneren over complete codebases.
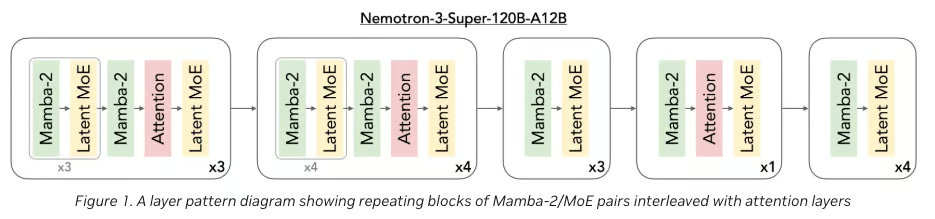
Figuur 1: Nemotron 3 Super-architectuur (NVIDIA Blog)
Enkele kernideeën achter Nemotron 3 Super zijn onder meer:
Voor deze tutorial gebruiken we de gehoste gratis endpoint van OpenRouter, aangezien zowel de volledige als de gequantiseerde varianten van het model doorgaans minstens een H100-GPU vereisen voor praktische inferentie. De gehoste endpoint ondersteunt momenteel een contextvenster van 262K tokens (in plaats van de volledige 1M), wat nog steeds voldoende is om middelgrote repositories in deze demo te analyseren.
NVIDIA’s Nemotron 3-familie werd geïntroduceerd als een open modelfamilie voor agentische AI-systemen, met verschillende groottes gericht op uiteenlopende deployment- en reasoning-behoeften, de Nemotron Nano-, Super- en Ultra-varianten.
Praktisch kun je de familie zo bekijken:
Nemotron 3 Super is hier dus de juiste keuze, omdat we een model willen dat in één keer over een hele repository kan redeneren, niet alleen geïsoleerde codetaken oplost.
In deze sectie bouwen we een repo-analyzer met Nemotron 3 Super in een Gradio-interface. Op hoofdlijnen doet de uiteindelijke app dit:
Laten we dit stap voor stap bouwen.
Voor we de repo-analyzer bouwen, hebben we een minimale omgeving nodig die drie kernverantwoordelijkheden aankan: UI-rendering, repositoryverwerking en modelinteractie. Omdat we Nemotron niet lokaal draaien, blijft de setup lichtgewicht en gefocust.
Installeer alles door het volgende uit te voeren:
!pip -q install gradio openai tiktoken gitpython orjson pandasIn dit project gebruiken we:
openai om met de API van OpenRouter (Nemotron-endpoint) te pratengradio om de interactieve UI te bouwentiktoken om tokengebruik te schatten voordat we prompts versturenorjson voor snelle JSON-parsing van modeloutputspandas om gestructureerde resultaten als tabellen te presenterengitpython om repositories te klonen en ermee te werkenIn tegenstelling tot lokale LLM-setups (die CUDA, vLLM of quantization vereisen) vermijdt deze aanpak GPU-afhankelijkheden volledig en blijft de omgeving Colab-vriendelijk.
In deze stap zetten we Nemotron 3 Super op via OpenRouter en definiëren we enkele kernconstanten die bepalen hoe repositories worden verwerkt. Omdat we het model niet lokaal draaien, wordt deze client de centrale interface voor het versturen van grote, verpakte prompts en het ontvangen van gestructureerde analyseoutputs.
OPENROUTER_API_KEY = os.environ.get("OPENROUTER_API_KEY", "")
MODEL = "nvidia/nemotron-3-super-120b-a12b:free"
WORKDIR = "/content/repo_ui"
if not OPENROUTER_API_KEY:
    raise ValueError("Set OPENROUTER_API_KEY in environment before running.")
client = OpenAI(
    base_url="https://openrouter.ai/api/v1",
    api_key=OPENROUTER_API_KEY,
)
enc = tiktoken.get_encoding("cl100k_base")
Op dit punt communiceert de applicatie met Nemotron 3 Super via OpenRouter met behulp van de Pythonclient openai, geconfigureerd met een aangepaste base_url en een API-sleutel die is opgeslagen in OPENROUTER_API_KEY.
Het geselecteerde model verwijst naar de gehoste endpoint van OpenRouter, waarmee we een zeer groot model kunnen draaien zonder lokale GPU-infrastructuur.
Om de contextgrootte te beheren, initialiseren we een tokenizer (tiktoken met cl100k_base) zodat we kunnen schatten hoeveel tokens de verpakte repository zal verbruiken voordat we deze naar het model sturen. Dit komt omdat het model een eindig contextvenster heeft.
Een paar praktische overwegingen:
Nu hebben we twee waarborgen nodig: bestandsfiltering en prompt grounding.
De eerste voorkomt dat we context verspillen aan irrelevante artefacten zoals build-outputs, notebooks, afbeeldingen of binaire bestanden.
De tweede zorgt ervoor dat zodra de repository is verpakt, het model verankerd blijft in de daadwerkelijke code in plaats van af te glijden naar algemene software-adviezen.
Samen maken deze regels repo-analyse efficiënter.
BASE_IGNORE_DIRS = {
    ".git", ".github", "__pycache__", "node_modules", ".venv", "venv",
    "dist", "build", ".mypy_cache", ".pytest_cache", ".idea", ".vscode"
}
IGNORE_SUFFIXES = {
    ".png", ".jpg", ".jpeg", ".gif", ".webp", ".pdf", ".zip", ".gz",
    ".tar", ".mp4", ".mov", ".onnx", ".pt", ".bin", ".parquet", ".feather",
    ".ico", ".svg", ".lock"
}
MAX_FILE_BYTES = 250_000
SYSTEM_PROMPT = """You are a codebase analysis model.
You are given the complete repository contents in one prompt.
Rules:
1. Use only the provided repository content.
2. Do not invent files, modules, libraries, or dependencies.
3. Every substantial claim must cite one or more file paths.
4. Clearly separate direct observations from engineering inferences or recommendations.
5. For modernization or improvement suggestions, explicitly distinguish:
   - repo-grounded findings
   - general engineering recommendations
6. Return valid JSON only.
7. If uncertain, say so explicitly.
8. For anything involving security, dead code, dependency replacement, or testing gaps,
   present findings as likely candidates unless directly proven by repository content.
"""
De volgende drie filtervariabelen sturen de preprocessing van de repository aan:
BASE_IGNORE_DIRS sluit mappen uit die irrelevant zijn voor codeanalyse of te ‘noisy’ zijn om nuttig te zijn, zoals .git, node_modules, buildmappen en editor-specifieke caches. IGNORE_SUFFIXES filtert bestandstypen weg die doorgaans niet helpen bij reporedenatie, inclusief afbeeldingen, archieven, video’s, modelcheckpoints en andere artefacten. MAX_FILE_BYTES biedt nog een veiligheidscontrole door te grote bestanden over te slaan, wat helpt om de verpakte repository binnen een praktisch contextbudget te houden.De SYSTEM_PROMPT is net zo belangrijk als de bestandsfilters.
Omdat het model de repository als één lange prompt ziet, moeten we duidelijke gedragskaders geven om te voorkomen dat het modules verzint, abstracties verkeerd leest of te algemene aanbevelingen geeft.
Deze instructies dwingen het model expliciet om verankerd te blijven in de aangeleverde repository, bestandspaden te citeren voor belangrijke beweringen en direct bewijs te scheiden van algemene oordelen.
Nu we bestandsfiltering en een system prompt hebben, is de volgende stap het definiëren van een set repository-brede taken, elk gekoppeld aan een gestructureerd JSON-schema.
Dit levert twee grote voordelen op: het model weet exact welk soort output het moet produceren, en de app kan de resultaten betrouwbaar parsen en weergeven in taakspecifieke tabellen.
TASK_DEFS: Dict[str, Dict[str, Any]] = {
    "Architecture Overview": {
        "description": "Explain the architecture, major modules, likely entrypoints, dependencies, and architectural issues.",
        "schema": {
            "repo_overview": {
                "summary": "",
                "primary_languages": [],
                "likely_entrypoints": []
            },
            "modules": [
                {
                    "name": "",
                    "responsibility": "",
                    "key_files": [],
                    "evidence_paths": []
                }
            ],
            "dependencies": [
                {
                    "from_module": "",
                    "to_module": "",
                    "relationship": "",
                    "evidence_paths": []
                }
            ],
            "issues": [
                {
                    "type": "",
                    "description": "",
                    "severity": "low|medium|high",
                    "evidence_paths": []
                }
            ],
            "unknowns_and_uncertainties": []
        },
    },
    ...
}
De TASK_DEFS-dictionary fungeert als het centrale register voor alle analysemodes die de app ondersteunt.
Elke taak bevat een natuurlijke beschrijving die het model vertelt wat te doen, en een strikt schema dat de verwachte JSON-output definieert.
Dit maakt het mogelijk om met dezelfde verpakte repository zeer verschillende vormen van redeneren te ondersteunen, zoals architectuurmapping, duplicatie-analyse, onboarding of het detecteren van testlacunes.
Zo vraagt Architecture Overview het model om te identificeren:
Andere taken in de volledige code breiden uit naar:
Code Duplication dat focust op herhaalde logica en bijbehorende refactorkansen,Improvement Opportunities dat onderhoudbaarheid en modulariteit verbetermogelijkheden identificeert,Testing Gaps dat ondergeteste gebieden uitlicht,Onboarding Guide dat uitlegt hoe een nieuwe engineer de codebase kan benaderen,Library Modernization dat verouderde of overlappende libraries naar voren brengt,Code Quality Hotspots dat broze of buggevoelige plekken aanwijst,Security of Config Hygiene dat riskante defaults of operationele issues signaleert.FULL_REVIEW_TASKS = [
"Architecture Overview",
"Improvement Opportunities",
"Code Quality Hotspots",
"Testing Gaps",
"Refactor Roadmap",
]
TASK_CHOICES = [
"Architecture Overview",
"Code Duplication",
"Improvement Opportunities",
"Refactor Roadmap",
"Testing Gaps",
"Onboarding Guide",
"Library Modernization",
"Code Quality Hotspots",
"Security / Config Hygiene",
"Full Review",
]
def safe_str(value: Any) -> str:
if value is None:
return ""
if isinstance(value, str):
return value.strip()
return str(value).strip()De lijst FULL_REVIEW_TASKS definieert een gebundelde review in meerdere stappen.
In plaats van elke mogelijke taak te draaien, voert het een samengestelde subset uit die een breed technisch beeld van de repository geeft. TASK_CHOICES wordt vervolgens rechtstreeks gebruikt in de Gradio-dropdown zodat de gebruiker een enkele taak of de bundelreview kan kiezen.
Het laatste deel, safe_str(), lost een verrassend belangrijk stabiliteitsprobleem op. Tijdens de ontwikkeling was een veelvoorkomende faalmodus:
'NoneType' object has no attribute 'strip'Dit kan gebeuren wanneer:
None teruggeeft,Door al dit soort waarden te normaliseren via de functie safe_str() maken we de app veel robuuster.
Voordat we iets naar het model kunnen sturen, moeten we een GitHub-repository omzetten naar één gestructureerde prompt.
Deze stap verwerkt de volledige ingestie-pijplijn: de repo klonen, irrelevante bestanden wegfilteren, alleen bruikbare tekst extraheren en alles inpakken in een formaat dat het model in één keer kan verbruiken.
In tegenstelling tot traditionele RAG-pijplijnen knippen en embedden we niet. In plaats daarvan comprimeren we de gehele repository in één long-context-input, dus selectief en gestructureerd te werk gaan is hier cruciaal voor zowel performance als kwaliteit.
def clone_repo(repo_url: str, branch: str = "main") -> str:
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    if not repo_url:
        raise ValueError("Repository URL is empty.")
    if os.path.exists(WORKDIR):
        shutil.rmtree(WORKDIR)
    cmd = ["git", "clone", "--depth", "1"]
    if branch:
        cmd += ["--branch", branch]
    cmd += [repo_url, WORKDIR]
    subprocess.run(cmd, check=True, capture_output=True, text=True)
    return WORKDIR
def is_probably_text(path: Path) -> bool:
    try:
        with open(path, "rb") as f:
            chunk = f.read(2048)
        if b"\x00" in chunk:
            return False
        chunk.decode("utf-8")
        return True
    except Exception:
        return False
def iter_repo_files(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    for path in root.rglob("*"):
        if not path.is_file():
            continue
        rel = path.relative_to(root)
        parts = set(rel.parts)
        rel_str = str(rel).lower()
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        if path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        try:
            if path.stat().st_size > MAX_FILE_BYTES:
                continue
        except Exception:
            continue
        if not is_probably_text(path):
            continue
        yield path
def repo_tree_string(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool) -> str:
    root = Path(root)
    lines: List[str] = []
    for path in sorted(root.rglob("*")):
        rel = path.relative_to(root)
        rel_str = str(rel).lower()
        parts = set(rel.parts)
        if any(part in BASE_IGNORE_DIRS for part in rel.parts):
            continue
        if path.is_file() and path.suffix.lower() in IGNORE_SUFFIXES:
            continue
        if exclude_tests and ("test" in parts or "tests" in parts or "/tests/" in f"/{rel_str}/"):
            continue
        if exclude_docs and ("docs" in parts or rel_str.endswith(".md") or rel_str.endswith(".rst")):
            continue
        if exclude_notebooks and rel_str.endswith(".ipynb"):
            continue
        lines.append(f"{rel}/" if path.is_dir() else str(rel))
    return "\n".join(lines)
def pack_repo(root: str, exclude_tests: bool, exclude_docs: bool, exclude_notebooks: bool):
    root = Path(root)
    tree = repo_tree_string(root, exclude_tests, exclude_docs, exclude_notebooks)
    files: List[Tuple[str, int, str]] = []
    total_tokens = len(enc.encode(tree))
    for path in iter_repo_files(root, exclude_tests, exclude_docs, exclude_notebooks):
        rel = path.relative_to(root)
        try:
            content = path.read_text(encoding="utf-8", errors="ignore")
        except Exception:
            continue
        block = f"\n=== FILE START: {rel} ===\n{content}\n=== FILE END: {rel} ===\n"
        tok = len(enc.encode(block))
        files.append((str(rel), tok, block))
        total_tokens += tok
    return tree, files, total_tokens
def build_repo_context(tree: str, files: List[Tuple[str, int, str]]) -> str:
    joined_files = "".join(block for _, _, block in files)
    return f"""=== REPO TREE START ===
{tree}
=== REPO TREE END ===
=== REPOSITORY FILES START ===
{joined_files}
=== REPOSITORY FILES END ===
"""
Deze stap definieert de volledige ingestie- en inpakpijplijn van de repository, maar elke functie heeft een specifieke verantwoordelijkheid:
clone_repo()-functie: Kloont een GitHub-repository naar een tijdelijke werkmap met een shallow clone (--depth 1) om geen volledige historie binnen te halen. Invoer zoals repo-URL en branch worden genormaliseerd met safe_str() om runtimefouten te voorkomen. De output is een lokaal pad (WORKDIR) waarop de rest van de pijplijn werkt.iter_repo_files()-functie: Dit is de hoofdfilterlaag. Het scant de repository recursief en levert alleen high-signal-bestanden op. Het sluit systeemmappen, niet-ondersteunde bestandstypen, te grote bestanden uit, en filtert optioneel tests, documentatie en notebooks weg. is_probably_text()-functie: Een lichte veiligheidscheck die tijdens het filteren wordt gebruikt. Leest een kleine chunk van elk bestand en controleert op null-bytes (meestal een teken van binair) en of UTF-8-decodering lukt. Alleen bestanden die slagen, worden als tekst meegenomen.repo_tree_string()-functie: Bouwt een tekenreeksrepresentatie van de repositorystuctuur. Het genereert een directory tree (met dezelfde filterregels) en geeft een lijst van mappen en bestanden die in de prompt worden gebruikt zodat het model de lay-out begrijpt voor het de inhoud leest.pack_repo()-functie: De kern van het inpakken. Loopt over alle gefilterde bestanden, leest de inhoud en wikkelt elk bestand in expliciete markeringen zoals === FILE START === en === FILE END ===. Schat ook het tokengebruik met tiktoken en telt alles op. build_repo_context()-functie: Combineert alles in één gestructureerde prompt. Zet eerst de repo tree neer, gevolgd door alle bestandsinhoud. Het model begrijpt eerst de structuur en leest dan de implementatiedetails.Het netto-effect is een ruwe GitHub-repository die is omgezet naar één gestructureerde long-context-input.
Nu de repository is gefilterd en verpakt in één long-context-input, is de volgende stap om het model te vertellen welk soort analyse het moet uitvoeren en hoe het resultaat te formatteren.
In plaats van voor elk gebruiksscenario dezelfde generieke instructie te sturen, genereren we een taakspecifieke prompt die de gekozen taaknaam, de beschrijving en het exacte JSON-schema dat in de response wordt verwacht bevat.
def build_task_prompt(task_name: str, repo_context: str) -> str:
    task_name = safe_str(task_name)
    if not task_name:
        raise ValueError("Task name is empty.")
    if task_name not in TASK_DEFS:
        raise ValueError(f"Unknown task: {task_name}")
    task_def = TASK_DEFS[task_name]
    return f"""Analyze this full repository.
Task Name:
{task_name}
Task Description:
{task_def["description"]}
Return JSON matching this schema exactly:
{json.dumps(task_def["schema"], indent=2)}
{repo_context}
"""
def try_parse_json(text: str) -> Dict[str, Any]:
    text = safe_str(text)
    if not text:
        raise ValueError("Model returned empty text.")
    try:
        return orjson.loads(text)
    except Exception:
        start = text.find("{")
        end = text.rfind("}")
        if start != -1 and end != -1 and end > start:
            return orjson.loads(text[start:end+1])
        raise ValueError("Could not parse model output as JSON.")
De bovenstaande code definieert twee nauw verwante functies die een brug vormen tussen de verpakte repository en de taakspecifieke analyseoutput.
build_task_prompt()-functie: Deze functie maakt de definitieve prompt die naar het model wordt gestuurd. Hij normaliseert eerst de taaknaam met safe_str() zodat lege input de pijplijn niet breekt. Vervolgens valideert hij of de taak bestaat in TASK_DEFS, wat voorkomt dat de app niet-ondersteunde of verkeerd gespelde taken verstuurt. Zodra de taak is gevalideerd, haalt de functie de beschrijving en het JSON-schema van die taak op en voegt beide toe aan de uiteindelijke prompt, samen met de volledige verpakte repository-context.try_parse_json()-functie: Deze functie verwerkt de modeloutput na inferentie. In de praktijk omringen long-context-modellen JSON soms met extra tekst, opmaakartefacten of gedeeltelijke toelichtingen. Om de app robuuster te maken, probeert try_parse_json() eerst direct te parsen met orjson.loads(). Door streng te prompten en toch tolerant te parsen blijft de app veel stabieler.In de volgende stap koppelen we deze promptinglogica aan de modelaanroep zelf en beginnen we gestructureerde repositoryanalyse-resultaten te genereren.
In dit stadium voeren we de analyse uit door de prompt naar Nemotron 3 Super te sturen via OpenRouter.
In plaats van de repo op te delen of delen op te halen, sturen we de volledige gefilterde codebase in één verzoek en laten we het model globaal redeneren over bestanden, modules en afhankelijkheden.
def call_model(prompt: str, max_tokens: int = 5000) -> str:
    prompt = safe_str(prompt)
    if not prompt:
        raise ValueError("Prompt is empty.")
    resp = client.chat.completions.create(
        model=MODEL,
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": prompt},
        ],
        temperature=0.2,
        max_tokens=max_tokens,
        extra_headers={
            "HTTP-Referer": "https://colab.research.google.com",
            "X-Title": "Whole Repo Analysis Demo"
        }
    )
    if not getattr(resp, "choices", None):
        raise ValueError("Model response has no choices.")
    message = getattr(resp.choices[0], "message", None)
    if message is None:
        raise ValueError("Model response has no message.")
    content = getattr(message, "content", None)
    content = safe_str(content)
    if not content:
        raise ValueError("Model returned empty content.")
    return content
De functie call_model() is verantwoordelijk voor het uitvoeren van de eigenlijke modelaanroep en het extraheren van de respons. Hier is de volledige pijplijn:
0.2 voor deterministischer output en de parameter max_tokens begrenst de responsgrootte, zodat het model zich op gestructureerde output richt.Tot slot kunnen we door naar het inferentiegedeelte en bekijken hoe we analyses draaien via het gehoste OpenRouter-model.
Wat we nu nodig hebben zijn een paar kleine helperfuncties die de UI en outputafhandeling makkelijk maken.
def to_df(items, columns=None):
    if items is None:
        return pd.DataFrame(columns=columns or [])
    if isinstance(items, dict):
        return pd.DataFrame([items])
    if not items:
        return pd.DataFrame(columns=columns or [])
    return pd.DataFrame(items)
def get_tasks_to_run(task: str) -> List[str]:
    task = safe_str(task)
    if not task:
        raise ValueError("Task is empty.")
    return FULL_REVIEW_TASKS if task == "Full Review" else [task]
def visible_for_task(task: str) -> Dict[str, bool]:
    task = safe_str(task)
    if task == "Full Review":
        return {
            "modules": True,
            "deps": True,
            "issues": True,
            "dups": False,
            "refactor": False,
            "improvements": True,
            "roadmap": True,
            "testing": True,
            "onboarding": False,
            "libs": False,
            "hotspots": True,
            "security": False,
        }
    return {
        "modules": task == "Architecture Overview",
        "deps": task == "Architecture Overview",
        "issues": task == "Architecture Overview",
        "dups": task == "Code Duplication",
        "refactor": task == "Code Duplication",
        "improvements": task == "Improvement Opportunities",
        "roadmap": task == "Refactor Roadmap",
        "testing": task == "Testing Gaps",
        "onboarding": task == "Onboarding Guide",
        "libs": task == "Library Modernization",
        "hotspots": task == "Code Quality Hotspots",
        "security": task == "Security / Config Hygiene",
    }
def render_markdown_summary(repo_url: str, total_tokens: int, files, results: Dict[str, Dict[str, Any]]) -> str:
    repo_url = safe_str(repo_url)
    lines = [
        "# Whole-Repo Analysis Report",
        f"**Repository:** {repo_url}",
        f"**Files included:** {len(files)}",
        f"**Estimated input tokens:** {total_tokens}",
        "",
    ]
    if "Architecture Overview" in results:
        overview = results["Architecture Overview"].get("repo_overview", {})
        lines += [
            "## Architecture",
            overview.get("summary", "No summary returned."),
            "",
            f"**Primary languages:** {', '.join(overview.get('primary_languages', [])) or 'N/A'}",
            f"**Likely entrypoints:** {', '.join(overview.get('likely_entrypoints', [])) or 'N/A'}",
            "",
        ]
    if "Improvement Opportunities" in results:
        lines += [
            "## Improvement Opportunities",
            f"- Identified: {len(results['Improvement Opportunities'].get('improvement_opportunities', []))}",
            "",
        ]
    if "Code Quality Hotspots" in results:
        lines += [
            "## Code Quality Hotspots",
            f"- Identified: {len(results['Code Quality Hotspots'].get('quality_hotspots', []))}",
            "",
        ]
    if "Testing Gaps" in results:
        lines += [
            "## Testing Gaps",
            f"- Identified: {len(results['Testing Gaps'].get('testing_gaps', []))}",
            "",
        ]
    if "Code Duplication" in results:
        dup = results["Code Duplication"]
        lines += [
            "## Duplication & Refactor Summary",
            f"- Duplication candidates: {len(dup.get('duplication_candidates', []))}",
            f"- Design smells: {len(dup.get('design_smells', []))}",
            f"- High risk files: {len(dup.get('high_risk_files', []))}",
            f"- Refactor recommendations: {len(dup.get('refactor_recommendations', []))}",
            "",
        ]
    if "Library Modernization" in results:
        lines += [
            "## Library Modernization",
            f"- Recommendations: {len(results['Library Modernization'].get('library_recommendations', []))}",
            "",
        ]
    if "Security / Config Hygiene" in results:
        lines += [
            "## Security / Config Hygiene",
            f"- Findings: {len(results['Security / Config Hygiene'].get('security_and_config_findings', []))}",
            "",
        ]
    if "Refactor Roadmap" in results:
        lines += [
            "## Refactor Roadmap",
            f"- Planned items: {len(results['Refactor Roadmap'].get('refactor_roadmap', []))}",
            "",
        ]
    if "Onboarding Guide" in results:
        onboarding = results["Onboarding Guide"].get("onboarding_guide", {})
        lines += [
            "## Onboarding Guide",
            onboarding.get("summary", "No summary returned."),
            "",
            f"**Recommended reading order:** {', '.join(onboarding.get('recommended_reading_order', [])) or 'N/A'}",
            f"**Entrypoints:** {', '.join(onboarding.get('entrypoints', [])) or 'N/A'}",
            "",
        ]
    return "\n".join(lines)
def hidden_update():
    return gr.update(value=pd.DataFrame(), visible=False)
def visible_update(df):
    return gr.update(value=df, visible=True)
def empty_outputs(stats, status_message):
    return (
        status_message,
        "",
        *all_hidden(),
        "{}",
        json.dumps(stats, indent=2),
    )
Deze stap definieert een kleine set helperfuncties, maar samen verzorgen ze het grootste deel van de presentatielogica van de app.
to_df()-functie: Zet modeloutputs om naar een pandas DataFrame, zodat ze netjes in Gradio-tabellen kunnen worden weergegeven. get_tasks_to_run()-functie: Bepaalt of de app één taak of de gebundelde Full Review moet draaien. Als de geselecteerde taak "Full Review" is, wordt dit uitgebreid naar de vooraf gedefinieerde lijst met reviewtaken. Anders geeft het simpelweg een lijst met één item terug met de gekozen taak. visible_for_task()-functie: Bepaalt welke rapporttabellen daadwerkelijk in de UI moeten worden getoond. Als de gebruiker bijvoorbeeld Onboarding Guide kiest, heeft het geen zin duplicatie- of securitytabellen te tonen. render_markdown_summary()-functie: In plaats van ruwe JSON te dumpen, genereert deze functie een leesbare samenvatting met repo-metadata, tokentelling en taakspecifieke highlights.hidden_update() en visible_update()-functies: Kleine Gradio-helpers om de componentstatus te sturen. hidden_update() leegt een tabel en verbergt deze, terwijl visible_update() een tabel vult en zichtbaar maakt. Dit patroon is belangrijk omdat Gradio een returnwaarde verwacht voor elke outputcomponent, en zonder expliciete resets.empty_outputs()-functie: Verwerkt vroege exits en foutstaten. Als de repo te groot is, de taak ongeldig is of iets anders faalt, moet de app nog steeds geldige outputs teruggeven voor elke UI-component. Samen veranderen deze helperfuncties de kernlogica niet, maar maken ze er wel een bruikbare applicatie van.
Deze functie orkestreert de volledige workflow. Hij valideert input, bereidt de repository voor, draait één of meerdere analysetaken en retourneert gestructureerde outputs naar de Gradio-UI.
def analyze_repo(repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks):
    repo_url = safe_str(repo_url)
    branch = safe_str(branch)
    task = safe_str(task)
    try:
        if not repo_url:
            stats = {"repo_url": "", "branch": branch}
            return empty_outputs(stats, "Error: Repository URL is empty.")
        if not task:
            stats = {"repo_url": repo_url, "branch": branch}
            return empty_outputs(stats, "Error: Task is empty.")
        repo_path = clone_repo(repo_url, branch)
        tree, files, total_tokens = pack_repo(repo_path, exclude_tests, exclude_docs, exclude_notebooks)
        stats = {
            "repo_url": repo_url,
            "branch": branch,
            "files_included": len(files),
            "estimated_input_tokens": total_tokens,
            "token_budget": token_budget,
            "fits_budget": total_tokens <= token_budget,
            "sample_files": [f[0] for f in files[:30]],
            "tasks_requested": get_tasks_to_run(task),
        }
        if total_tokens > token_budget:
            msg = (
                f"Repo too large for current budget.\n\n"
                f"Estimated tokens: {total_tokens}\n"
                f"Budget: {token_budget}\n\n"
                f"Try excluding tests/docs/notebooks or use a smaller repo."
            )
            return empty_outputs(stats, msg)
        repo_context = build_repo_context(tree, files)
        tasks_to_run = get_tasks_to_run(task)
        results: Dict[str, Dict[str, Any]] = {}
        for task_name in tasks_to_run:
            prompt = build_task_prompt(task_name, repo_context)
            raw_text = call_model(prompt)
            results[task_name] = try_parse_json(raw_text)
        report_md = render_markdown_summary(repo_url, total_tokens, files, results)
        vis = visible_for_task(task)
        arch_json = results.get("Architecture Overview", {})
        dup_json = results.get("Code Duplication", {})
        imp_json = results.get("Improvement Opportunities", {})
        roadmap_json = results.get("Refactor Roadmap", {})
        testing_json = results.get("Testing Gaps", {})
        onboarding_json = results.get("Onboarding Guide", {})
        lib_json = results.get("Library Modernization", {})
        hotspot_json = results.get("Code Quality Hotspots", {})
        security_json = results.get("Security / Config Hygiene", {})
        modules_df = to_df(arch_json.get("modules", []), ["name", "responsibility", "key_files", "evidence_paths"])
        deps_df = to_df(arch_json.get("dependencies", []), ["from_module", "to_module", "relationship", "evidence_paths"])
        issues_df = to_df(arch_json.get("issues", []), ["type", "description", "severity", "evidence_paths"])
        dups_df = to_df(dup_json.get("duplication_candidates", []), ["summary", "files_involved", "why_it_looks_duplicate", "confidence"])
        refactor_df = to_df(dup_json.get("refactor_recommendations", []), ["title", "description", "target_files", "expected_benefit"])
        improvements_df = to_df(imp_json.get("improvement_opportunities", []), ["title", "description", "why_it_matters", "affected_files", "suggested_change", "expected_impact", "effort", "evidence_paths"])
        roadmap_df = to_df(roadmap_json.get("refactor_roadmap", []), ["priority", "title", "description", "target_files", "impact", "effort", "why_now"])
        testing_df = to_df(testing_json.get("testing_gaps", []), ["module_or_file", "why_it_needs_tests", "likely_missing_cases", "recommended_test_type", "evidence_paths"])
        onboarding_df = to_df(onboarding_json.get("onboarding_guide", {}), ["summary", "recommended_reading_order", "entrypoints", "important_directories", "debugging_start_points", "common_confusion_points"])
        libs_df = to_df(lib_json.get("library_recommendations", []), ["current_library_or_pattern", "where_used", "suggested_alternative", "why_better", "migration_difficulty", "confidence", "evidence_paths", "recommendation_type"])
        hotspots_df = to_df(hotspot_json.get("quality_hotspots", []), ["file_or_module", "risk_level", "why_it_is_a_hotspot", "evidence_paths", "recommended_cleanup"])
        security_df = to_df(security_json.get("security_and_config_findings", []), ["title", "severity", "description", "affected_files", "evidence_paths", "recommended_fix", "confidence"])
        status = (
            f"Done.\n\n"
            f"Files included: {len(files)}\n"
            f"Estimated input tokens: {total_tokens}\n"
            f"Tasks run: {', '.join(tasks_to_run)}"
        )
        return (
            status,
            report_md,
            visible_update(modules_df) if vis["modules"] else hidden_update(),
            visible_update(deps_df) if vis["deps"] else hidden_update(),
            visible_update(issues_df) if vis["issues"] else hidden_update(),
            visible_update(dups_df) if vis["dups"] else hidden_update(),
            visible_update(refactor_df) if vis["refactor"] else hidden_update(),
            visible_update(improvements_df) if vis["improvements"] else hidden_update(),
            visible_update(roadmap_df) if vis["roadmap"] else hidden_update(),
            visible_update(testing_df) if vis["testing"] else hidden_update(),
            visible_update(onboarding_df) if vis["onboarding"] else hidden_update(),
            visible_update(libs_df) if vis["libs"] else hidden_update(),
            visible_update(hotspots_df) if vis["hotspots"] else hidden_update(),
            visible_update(security_df) if vis["security"] else hidden_update(),
            json.dumps(results, indent=2),
            json.dumps(stats, indent=2),
        )
    except subprocess.CalledProcessError as e:
        stats = {"repo_url": repo_url, "branch": branch}
        stderr = safe_str(getattr(e, "stderr", "")) or safe_str(e)
        return empty_outputs(stats, f"Git clone failed:\n{stderr}")
    except Exception as e:
        stats = {"repo_url": repo_url, "branch": branch}
        return empty_outputs(stats, f"Error: {safe_str(e)}")
Deze functie orkestreert de hele pijplijn, van ruwe repo tot gestructureerde output.
results-dictionary.to_df() omgezet naar DataFrames en gemapt naar UI-componenten. Zichtbaarheid wordt gestuurd via visible_for_task(), zodat alleen relevante tabellen voor de gekozen taak worden getoond.empty_outputs() om de UI stabiel te houden.Tot slot wikkelen we alles in een eenvoudige Gradio-interface.
with gr.Blocks(title="Nemotron Repo Analyzer") as demo:
    gr.Markdown("# Nemotron Repo Analyzer")
    # gr.Markdown("Analyze a public GitHub repository without RAG using a single packed prompt.")
    with gr.Tab("Analyze"):
        with gr.Row():
            repo_url = gr.Textbox(
                label="GitHub Repo URL",
                value="https://github.com/AashiDutt/Nemotron-3-Nano.git"
            )
            branch = gr.Textbox(label="Branch", value="main")
        with gr.Row():
            task = gr.Dropdown(
                choices=TASK_CHOICES,
                value="Full Review",
                label="Task"
            )
            token_budget = gr.Slider(
                minimum=40000,
                maximum=180000,
                step=5000,
                value=120000,
                label="Token Budget"
            )
        with gr.Row():
            exclude_tests = gr.Checkbox(value=False, label="Exclude tests")
            exclude_docs = gr.Checkbox(value=False, label="Exclude docs / markdown")
            exclude_notebooks = gr.Checkbox(value=True, label="Exclude notebooks")
        analyze_btn = gr.Button("Analyze Repo", variant="primary")
        status = gr.Textbox(label="Status", lines=7)
    with gr.Tab("Report"):
        report_md = gr.Markdown()
        modules_df = gr.Dataframe(label="Modules", visible=False)
        deps_df = gr.Dataframe(label="Dependencies", visible=False)
        issues_df = gr.Dataframe(label="Architecture Issues", visible=False)
        dups_df = gr.Dataframe(label="Duplication Candidates", visible=False)
        refactor_df = gr.Dataframe(label="Refactor Recommendations", visible=False)
        improvements_df = gr.Dataframe(label="Improvement Opportunities", visible=False)
        roadmap_df = gr.Dataframe(label="Refactor Roadmap", visible=False)
        testing_df = gr.Dataframe(label="Testing Gaps", visible=False)
        onboarding_df = gr.Dataframe(label="Onboarding Guide", visible=False)
        libs_df = gr.Dataframe(label="Library Modernization", visible=False)
        hotspots_df = gr.Dataframe(label="Code Quality Hotspots", visible=False)
        security_df = gr.Dataframe(label="Security / Config Hygiene", visible=False)
    with gr.Tab("Raw JSON"):
        all_results_json_box = gr.Code(label="All Task Results JSON", language="json")
        stats_box = gr.Code(label="Run Stats", language="json")
    analyze_btn.click(
        analyze_repo,
        inputs=[repo_url, branch, task, token_budget, exclude_tests, exclude_docs, exclude_notebooks],
        outputs=[
            status,
            report_md,
            modules_df,
            deps_df,
            issues_df,
            dups_df,
            refactor_df,
            improvements_df,
            roadmap_df,
            testing_df,
            onboarding_df,
            libs_df,
            hotspots_df,
            security_df,
            all_results_json_box,
            stats_box,
        ]
    )
demo.launch(debug=True, share=True)
De container gr.Blocks() definieert de algehele lay-out van de app, terwijl de bovenste Markdown de titel en context zet. De interface is opgesplitst in drie tabs om de workflow gestructureerd te houden.
Dit koppelt gebruikersinvoer direct aan de functie analyze_repo() en mapt de outputs terug naar de UI-componenten. De volgorde van outputs is hier cruciaal, omdat elke geretourneerde waarde naar een specifiek UI-element wordt gerouteerd.
Tot slot wordt de app gestart met:
demo.launch(debug=True, share=True)De vlag debug=True helpt runtimefouten zichtbaar te maken tijdens ontwikkeling, terwijl share=True een openbare link creëert, zodat je de app makkelijk kunt delen zonder deployment.
In deze tutorial liet ik zien hoe je een repo-codebase-analyzer bouwt met NVIDIA Nemotron 3 Super, OpenRouter en Gradio.
In plaats van te vertrouwen op chunking, embeddings en retrieval, kloont de app een openbare GitHub-repository, filtert en pakt de codebase in één prompt, en vraagt het model om in één keer over de hele repository te redeneren.
Deze whole-context-aanpak is nuttig voor taken die een globaal beeld van de codebase vereisen, zoals architectuuruitleg, onboarding, analyse van testlacunes, verbeterkansen en refactorplanning.
Vanaf hier kun je het project op meerdere manieren uitbreiden:
Top DataCamp Courses
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min