Toen ik begon te werken met grote datasets, liep ik al snel tegen een bekend probleem aan: gefragmenteerde data verspreid over verschillende systemen. Er was geen eenvoudige manier om alles samen te analyseren. Ik moest trends vergelijken in de tijd, per regio en per product, maar traditionele databases konden zo’n analyse niet aan. Toen hoorde ik over datacubes en ben ik me erin gaan verdiepen.
In deze gids leg ik de basis, structuur en relevantie van datacubes uit. Als aanvullend materiaal raad ik onze cursussen Data-Driven Decision Making in SQL en Database Design aan.
Wat is een datacube?
Ik definieer het concept en plaats het in historische context:
Definitie en voorbeeld
Datacubes zijn hulpmiddelen voor het beheren van multidimensionale data in data-analyse, zoals in business intelligence. In tegenstelling tot traditionele platte datastructuren, zoals spreadsheets of relationele databases, maken datacubes efficiëntere verkenning van complexe datasets mogelijk in drie of meer dimensies.
Dit alles is voor de analist vaak niet direct zichtbaar, dus laat me het idee van een datacube illustreren met een voorbeeld. Ik spreek vanuit het perspectief van een BI-analist:
Stel dat je de verkoop van winkels wilt volgen. De beschikbare data kan omzet en verkochte aantallen bevatten, gecategoriseerd naar dimensies zoals tijd, producttype en winkellocatie. Een datacube, in feite meer een logisch of conceptueel model, organiseert je data zó, dat welke BI-tool je ook gebruikt, snel visualisaties kan genereren van elke combinatie van de genoemde dimensies. Je kunt er bijvoorbeeld de totale verkoop per product mee bekijken over alle winkels in een specifiek jaar.
Stel je nu een spreadsheet voor met de kolommen “Tijd (maanden)”, “Producttype”, “Winkellocatie” en “Omzet”. Deze spreadsheet is qua structuur geen datacube, maar kan wel worden gebruikt om een datacube op te bouwen of te vullen, waarbij elke rij een cel wordt gevormd door de unieke combinatie van Tijd, Producttype en Winkellocatie, met Omzet als de waarde in die cel.
|
Maand
|
Producttype
|
Winkellocatie
|
Omzet
|
|
Januari
|
Elektronica
|
Chicago
|
10,000
|
|
Januari
|
Kleding
|
Chicago
|
5,000
|
|
Januari
|
Meubels
|
New York
|
12,000
|
|
Februari
|
Elektronica
|
Los Angeles
|
8,000
|
|
Februari
|
Kleding
|
Chicago
|
6,000
|
|
Maart
|
Elektronica
|
New York
|
9,000
|
|
Maart
|
Meubels
|
Los Angeles
|
11,000
|
In een cube worden dit dimensies. Elke unieke combinatie van tijd × product × locatie wijst naar een cel met omzet of aantal, en dit is een aggregaat dat vooraf wordt opgeslagen en razendsnel opgehaald (daarover straks meer).
Historische context en evolutie
Datacubes werden voor het eerst populair in de jaren 90, tijdens de opkomst van datawarehousing en OLAP (Online Analytical Processing). Destijds hadden bedrijven snellere, interactievere manieren nodig om steeds grotere hoeveelheden data te analyseren. Datacubes voorzagen in die behoefte door informatie te organiseren in flexibele, multidimensionale weergaven die het herkennen van trends en patronen veel eenvoudiger maakten.
Met de evolutie van technologie evolueerden ook datacubes. Dankzij verbeteringen in rekenkracht, opslag en parallelle verwerking kunnen ze nu grotere, complexere datasets aan. Tegenwoordig zijn datacubes niet langer beperkt tot traditionele on-premises systemen. Ze zijn breed geïntegreerd in cloudgebaseerde analyticsplatforms, wat realtime verwerking en schaalbare, on-demand inzichten ondersteunt voor moderne business intelligence-behoeften.
Componenten van een datacube
Het is belangrijk de kerncomponenten van datacubes te ontleden om volledig te begrijpen hoe ze werken. Hieronder staan voorbeelden van elke component.
Dimensies
Dimensies zijn de categorische kenmerken die de structuur van een datacube bepalen. Je gebruikt dimensies om je data te categoriseren en te filteren op basis van verschillende segmenten.
Hier zijn enkele veelvoorkomende voorbeelden van dimensies die in datacubes worden gebruikt:
- Tijd: De tijddimensie omvat hiërarchiën zoals jaren, kwartalen, maanden of dagen. Een retailverkoop-cube kan bijvoorbeeld analyse per maand (januari, februari, enz.) of per jaar (2023, 2024) toestaan.
- Geografie: Deze dimensie bevat niveaus zoals land, staat/provincie, stad of winkellocatie, wat regionale vergelijkingen mogelijk maakt. Een bedrijf kan bijvoorbeeld de verkoopprestatie analyseren per regio (Noord-Amerika, Europa) of stad (New York, Londen).
- Product: Deze dimensie groepeert data per productlijn of specifieke items voor betere verkoopcategorisatie. Een elektronicawinkel kan het bijvoorbeeld uitsplitsen in categorieën zoals smartphones, laptops en accessoires om te zien wat het best verkoopt.
Maatstaven
Maatstaven zijn de kwantitatieve datapunten die in de cube zijn opgeslagen en inzichten opleveren. Je kunt deze numerieke waarden aggregeren met wiskundige bewerkingen zoals som, gemiddelde, aantal of maximum.
De volgende voorbeelden van maatstaven kom je mogelijk tegen
- Omzet: Totale inkomsten uit verkopen.
- Verkochte eenheden: Het aantal verkochte producten.
- Winstmarges: Het verschil tussen verkoopomzet en productverkoopkosten.
Hiërarchiën
Hiërarchiën organiseren dimensies in niveaus die geavanceerde analyse mogelijk maken via bewerkingen zoals drill-down en roll-up. Door dimensies hiërarchisch te structureren, kun je navigeren van eenvoudige samenvattingen naar meer gedetailleerde dataviews. Voorbeelden van hiërarchiën zijn onder andere:
- Een hiërarchie kan bestaan uit Jaar > Kwartaal > Maand > Dag in de tijddimensie. Zo kun je inzoomen op fijnere details, bijvoorbeeld van jaarlijkse verkoopcijfers naar maandelijkse uitsplitsingen.
- In de geografie-dimensie kan een hiërarchie Land > Staat/Provincie > Stad > Winkel zijn. Zo kun je data aggregeren, zoals het optellen van verkoop uit individuele winkels tot een totaal per stad.
De structuur van een datacube
Laten we uiteenzetten hoe een datacube is opgebouwd en waarom die structuur analyse zoveel makkelijker maakt.
Multidimensioneel modelleren
Denk aan een datacube als een 3D-spreadsheet waarbij elke as een andere manier is om naar je data te kijken, zoals tijd, locatie of producttype. Deze opzet laat je complexe datasets vanuit meerdere invalshoeken tegelijk verkennen.
Stel dat je retailverkopen analyseert. Je cube kan het volgende hebben:
- Tijd als één dimensie (maanden of kwartalen).
- Geografie als tweede dimensie (regio’s of steden).
- Productcategorie als derde dimensie (elektronica, kleding, enz.).
De voordelen van multidimensioneel modelleren zijn onder andere:
- Intuïtieve navigatie: Je kunt de data slice-en en dice-en, inzoomen op specifieke regio’s, perioden of producten, zonder de hele structuur te veranderen.
- Efficiënt bevragen: Omdat datacubes vaak voorgecalculeerde samenvattingen opslaan, leveren complexe queries in seconden resultaat op.
- Flexibiliteit: Je kunt inzoomen op details (zoals dagelijkse verkoop) of uitzoomen naar grotere overzichten (zoals jaarlijkse trends), afhankelijk van je behoefte.
Visualisatie van datacubes
Ik visualiseer de datacube om je te helpen de structuur te begrijpen en hoe je de data erin interpreteert. Hieronder staat een eenvoudige weergave van een 3D-datacube:
In het onderstaande diagram:
- De X-as stelt de tijddimensie voor (Jaar > Kwartaal > Maand).
- De Y-as stelt de geografie-dimensie voor (Land > Staat/Provincie > Stad).
- De Z-as stelt de productdimensie voor (Categorie > Type).
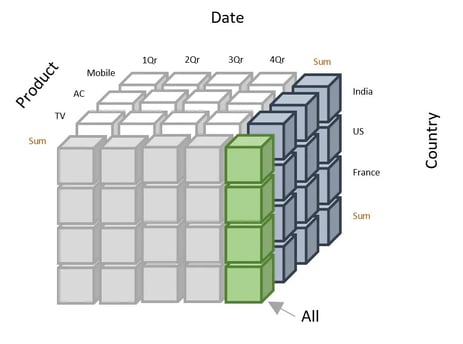
Voorbeeld van weergave van een datacube. Bron: Mastering Revenue Operations
Je kunt de bovenstaande datacube als volgt interpreteren:
- Selecteer dimensies: Kies de combinatie van dimensies die je wilt analyseren. Bijvoorbeeld verkoop voor elektronica (Product) in Canada (Land) tijdens Q1 2023 (Tijd).
- Focus op maatstaven: Haal de data op die is opgeslagen in de snijcel en interpreteer die, zoals totale omzet of gemiddelde verkoop.
- Voer bewerkingen uit: Slice de cube om specifieke dimensies te analyseren of dice om een subset van data te bekijken.
Waarom datacubes worden gebruikt
Dit zijn redenen waarom datacubes worden gebruikt:
Betere dataorganisatie
Zoals ik eerder noemde, helpen datacubes complexe informatie te ordenen in overzichtelijke lagen. Dit maakt het eenvoudiger om vanuit databases data te benaderen en te analyseren.
Verbeterde queryprestaties
Datacubes zijn ontworpen om vragen snel te beantwoorden omdat ze voorgecalculeerde samenvattingen opslaan en geavanceerde indexering gebruiken. Deze structuur maakt snelle navigatie door dimensies en maatstaven mogelijk. Een query om bijvoorbeeld kwartaalverkopen over alle winkels te vinden wordt vrijwel direct uitgevoerd, omdat de datacube deze vooraf berekende aggregaten al bevat. Ik begon dit eerder al te noemen, en het is naar mijn mening echt een van de kernpunten.
Gefaciliteerde data-exploratie
Datacubes maken ook interactieve data-exploratie mogelijk via bewerkingen zoals slicing en dicing. Met slicing focus je op een specifieke dimensie, bijvoorbeeld verkoop in slechts één maand. Met dicing bekijk je data over meerdere dimensies tegelijk, zoals verkoop per productcategorie in New York tijdens januari.
Je kunt bijvoorbeeld beginnen met jaarlijkse verkoop, inzoomen op kwartaalprestaties en vervolgens slicen per regio voor een specifieke productcategorie.
Schaalbaarheid en flexibiliteit
Datacubes zijn gebouwd om met je mee te groeien. Ze gaan goed om met grote datasets, zeker in combinatie met moderne tools zoals cloudopslag of big-dataplatforms. Je kunt eenvoudig nieuwe data toevoegen, aangepaste dimensies toevoegen en maatstaven instellen die precies aansluiten op wat jouw bedrijf wil volgen.
Stel dat je een snelgroeiende online winkel runt. Terwijl je je productassortiment uitbreidt, in nieuwe regio’s opent of recentere data toevoegt, kan je datacube met je meegroeien zonder de rapportages en inzichten waarop je vertrouwt in de war te schoppen.
Uitdagingen en aandachtspunten
Hoewel datacubes nuttig zijn voor het analyseren van je datasets, brengen ze ook verschillende uitdagingen met zich mee. Hieronder staan enkele bekende issues.
Complexiteit in ontwerp
Een datacube bouwen is niet alleen een technische taak, maar vereist ook goed begrip van je business. De complexiteiten kunnen onder meer het volgende omvatten:
- Dimensies en maatstaven identificeren: De juiste dimensies en maatstaven kiezen is niet altijd vanzelfsprekend. Je moet goed nadenken over wat echt belangrijk is.
- Granulariteit en prestaties balanceren: Te veel dimensies of detailniveaus kunnen de cube te groot en traag maken. Maar oververeenvoudiging kan de bruikbaarheid ook beperken.
- Businesslogica: Om nauwkeurige bedrijfsregels op te nemen, zoals specifieke hiërarchiën of aggregaties, zijn planning en samenwerking tussen technische teams en businessstakeholders nodig.
Opslag en onderhoud
Werken met datacubes kent uitdagingen, zeker naarmate je data groeit. Denk aan:
- Hoge opslagvereisten: Omdat cubes voor-gesommeerde data opslaan, kunnen ze veel ruimte innemen, vooral met veel dimensies en detailniveaus.
- Regelmatige updates: Om je data actueel te houden, moet je de cube regelmatig bijwerken. Dat kost tijd en kan je systeem belasten, zeker bij grote datasets.
- Performance tuning: Na verloop van tijd moet je waarschijnlijk de prestaties van de cube monitoren. Dat betekent zaken bijstellen zoals indexering of hoe data is opgesplitst, om alles snel en efficiënt te houden.
Integratie met bestaande systemen
Bij het integreren van datacubes met bestaande systemen kun je de volgende uitdagingen tegenkomen:
- Compatibiliteitsproblemen: Legacy-systemen of niet-gestandaardiseerde dataformaten kunnen het integratieproces bemoeilijken.
- ETL (Extract, Transform, Load)-complexiteit: Het voeden van data in de cube vereist vaak geavanceerde ETL-pijplijnen. Deze kunnen tijd kosten om te bouwen en vereisen mogelijk doorlopend onderhoud.
- Uitdagingen met realtime data: Omdat traditionele cubes niet zijn ontworpen voor live-updates, heb je mogelijk extra tools of aanpassingen nodig om met realtime data te werken.
Conclusie
Datacubes zijn een geweldige manier om complexe data vanuit verschillende invalshoeken te ordenen en te begrijpen. Ze helpen je sneller patronen te ontdekken, efficiënter queries uit te voeren en informatie te verkennen door deze op elke gewenste manier te slicen.
Wil je je skills verder ontwikkelen, volg dan onze cursus Data Warehousing Concepts om te leren over datawarehouse-eigenschappen en hoe je datacubes integreert met bestaande systemen, als je rol dat vereist. Onze cursus Understanding Data Engineering helpt je ook met vaardigheden in het onderhouden en verwerken van data.




Toen ik begon te werken met grote datasets, liep ik al snel tegen een bekend probleem aan: gefragmenteerde data verspreid over verschillende systemen. Er was geen eenvoudige manier om alles samen te analyseren. Ik moest trends vergelijken in de tijd, per regio en per product, maar traditionele databases konden zo’n analyse niet aan. Toen hoorde ik over datacubes en ben ik me erin gaan verdiepen.
In deze gids leg ik de basis, structuur en relevantie van datacubes uit. Als aanvullend materiaal raad ik onze cursussen Data-Driven Decision Making in SQL en Database Design aan.
Wat is een datacube?
Ik definieer het concept en plaats het in historische context:
Definitie en voorbeeld
Datacubes zijn hulpmiddelen voor het beheren van multidimensionale data in data-analyse, zoals in business intelligence. In tegenstelling tot traditionele platte datastructuren, zoals spreadsheets of relationele databases, maken datacubes efficiëntere verkenning van complexe datasets mogelijk in drie of meer dimensies.
Dit alles is voor de analist vaak niet direct zichtbaar, dus laat me het idee van een datacube illustreren met een voorbeeld. Ik spreek vanuit het perspectief van een BI-analist:
Stel dat je de verkoop van winkels wilt volgen. De beschikbare data kan omzet en verkochte aantallen bevatten, gecategoriseerd naar dimensies zoals tijd, producttype en winkellocatie. Een datacube, in feite meer een logisch of conceptueel model, organiseert je data zó, dat welke BI-tool je ook gebruikt, snel visualisaties kan genereren van elke combinatie van de genoemde dimensies. Je kunt er bijvoorbeeld de totale verkoop per product mee bekijken over alle winkels in een specifiek jaar.
Stel je nu een spreadsheet voor met de kolommen “Tijd (maanden)”, “Producttype”, “Winkellocatie” en “Omzet”. Deze spreadsheet is qua structuur geen datacube, maar kan wel worden gebruikt om een datacube op te bouwen of te vullen, waarbij elke rij een cel wordt gevormd door de unieke combinatie van Tijd, Producttype en Winkellocatie, met Omzet als de waarde in die cel.
Maand
Producttype
Winkellocatie
Omzet
Januari
Elektronica
Chicago
10,000
Januari
Kleding
Chicago
5,000
Januari
Meubels
New York
12,000
Februari
Elektronica
Los Angeles
8,000
Februari
Kleding
Chicago
6,000
Maart
Elektronica
New York
9,000
Maart
Meubels
Los Angeles
11,000
In een cube worden dit dimensies. Elke unieke combinatie van tijd × product × locatie wijst naar een cel met omzet of aantal, en dit is een aggregaat dat vooraf wordt opgeslagen en razendsnel opgehaald (daarover straks meer).
Historische context en evolutie
Datacubes werden voor het eerst populair in de jaren 90, tijdens de opkomst van datawarehousing en OLAP (Online Analytical Processing). Destijds hadden bedrijven snellere, interactievere manieren nodig om steeds grotere hoeveelheden data te analyseren. Datacubes voorzagen in die behoefte door informatie te organiseren in flexibele, multidimensionale weergaven die het herkennen van trends en patronen veel eenvoudiger maakten.
Met de evolutie van technologie evolueerden ook datacubes. Dankzij verbeteringen in rekenkracht, opslag en parallelle verwerking kunnen ze nu grotere, complexere datasets aan. Tegenwoordig zijn datacubes niet langer beperkt tot traditionele on-premises systemen. Ze zijn breed geïntegreerd in cloudgebaseerde analyticsplatforms, wat realtime verwerking en schaalbare, on-demand inzichten ondersteunt voor moderne business intelligence-behoeften.
Componenten van een datacube
Het is belangrijk de kerncomponenten van datacubes te ontleden om volledig te begrijpen hoe ze werken. Hieronder staan voorbeelden van elke component.
Dimensies
Dimensies zijn de categorische kenmerken die de structuur van een datacube bepalen. Je gebruikt dimensies om je data te categoriseren en te filteren op basis van verschillende segmenten.
Hier zijn enkele veelvoorkomende voorbeelden van dimensies die in datacubes worden gebruikt:
Maatstaven
Maatstaven zijn de kwantitatieve datapunten die in de cube zijn opgeslagen en inzichten opleveren. Je kunt deze numerieke waarden aggregeren met wiskundige bewerkingen zoals som, gemiddelde, aantal of maximum.
De volgende voorbeelden van maatstaven kom je mogelijk tegen
Hiërarchiën
Hiërarchiën organiseren dimensies in niveaus die geavanceerde analyse mogelijk maken via bewerkingen zoals drill-down en roll-up. Door dimensies hiërarchisch te structureren, kun je navigeren van eenvoudige samenvattingen naar meer gedetailleerde dataviews. Voorbeelden van hiërarchiën zijn onder andere:
De structuur van een datacube
Laten we uiteenzetten hoe een datacube is opgebouwd en waarom die structuur analyse zoveel makkelijker maakt.
Multidimensioneel modelleren
Denk aan een datacube als een 3D-spreadsheet waarbij elke as een andere manier is om naar je data te kijken, zoals tijd, locatie of producttype. Deze opzet laat je complexe datasets vanuit meerdere invalshoeken tegelijk verkennen.
Stel dat je retailverkopen analyseert. Je cube kan het volgende hebben:
De voordelen van multidimensioneel modelleren zijn onder andere:
Visualisatie van datacubes
Ik visualiseer de datacube om je te helpen de structuur te begrijpen en hoe je de data erin interpreteert. Hieronder staat een eenvoudige weergave van een 3D-datacube:
In het onderstaande diagram:
Voorbeeld van weergave van een datacube. Bron: Mastering Revenue Operations
Je kunt de bovenstaande datacube als volgt interpreteren:
Waarom datacubes worden gebruikt
Dit zijn redenen waarom datacubes worden gebruikt:
Betere dataorganisatie
Zoals ik eerder noemde, helpen datacubes complexe informatie te ordenen in overzichtelijke lagen. Dit maakt het eenvoudiger om vanuit databases data te benaderen en te analyseren.
Verbeterde queryprestaties
Datacubes zijn ontworpen om vragen snel te beantwoorden omdat ze voorgecalculeerde samenvattingen opslaan en geavanceerde indexering gebruiken. Deze structuur maakt snelle navigatie door dimensies en maatstaven mogelijk. Een query om bijvoorbeeld kwartaalverkopen over alle winkels te vinden wordt vrijwel direct uitgevoerd, omdat de datacube deze vooraf berekende aggregaten al bevat. Ik begon dit eerder al te noemen, en het is naar mijn mening echt een van de kernpunten.
Gefaciliteerde data-exploratie
Datacubes maken ook interactieve data-exploratie mogelijk via bewerkingen zoals slicing en dicing. Met slicing focus je op een specifieke dimensie, bijvoorbeeld verkoop in slechts één maand. Met dicing bekijk je data over meerdere dimensies tegelijk, zoals verkoop per productcategorie in New York tijdens januari.
Je kunt bijvoorbeeld beginnen met jaarlijkse verkoop, inzoomen op kwartaalprestaties en vervolgens slicen per regio voor een specifieke productcategorie.
Schaalbaarheid en flexibiliteit
Datacubes zijn gebouwd om met je mee te groeien. Ze gaan goed om met grote datasets, zeker in combinatie met moderne tools zoals cloudopslag of big-dataplatforms. Je kunt eenvoudig nieuwe data toevoegen, aangepaste dimensies toevoegen en maatstaven instellen die precies aansluiten op wat jouw bedrijf wil volgen.
Stel dat je een snelgroeiende online winkel runt. Terwijl je je productassortiment uitbreidt, in nieuwe regio’s opent of recentere data toevoegt, kan je datacube met je meegroeien zonder de rapportages en inzichten waarop je vertrouwt in de war te schoppen.
Uitdagingen en aandachtspunten
Hoewel datacubes nuttig zijn voor het analyseren van je datasets, brengen ze ook verschillende uitdagingen met zich mee. Hieronder staan enkele bekende issues.
Complexiteit in ontwerp
Een datacube bouwen is niet alleen een technische taak, maar vereist ook goed begrip van je business. De complexiteiten kunnen onder meer het volgende omvatten:
Opslag en onderhoud
Werken met datacubes kent uitdagingen, zeker naarmate je data groeit. Denk aan:
Integratie met bestaande systemen
Bij het integreren van datacubes met bestaande systemen kun je de volgende uitdagingen tegenkomen:
Conclusie
Datacubes zijn een geweldige manier om complexe data vanuit verschillende invalshoeken te ordenen en te begrijpen. Ze helpen je sneller patronen te ontdekken, efficiënter queries uit te voeren en informatie te verkennen door deze op elke gewenste manier te slicen.
Wil je je skills verder ontwikkelen, volg dan onze cursus Data Warehousing Concepts om te leren over datawarehouse-eigenschappen en hoe je datacubes integreert met bestaande systemen, als je rol dat vereist. Onze cursus Understanding Data Engineering helpt je ook met vaardigheden in het onderhouden en verwerken van data.