Khi tôi mới bắt đầu làm việc với các tập dữ liệu lớn, tôi nhanh chóng gặp một vấn đề quen thuộc: dữ liệu bị phân mảnh và rải rác trên nhiều hệ thống. Không có cách dễ dàng để phân tích tổng thể. Tôi cần so sánh xu hướng theo thời gian, giữa các khu vực và theo sản phẩm, nhưng các cơ sở dữ liệu truyền thống không xử lý được kiểu phân tích này. Đó là lúc tôi nghe về data cube và bắt đầu tìm hiểu khái niệm này.
Trong hướng dẫn này, tôi sẽ giải thích các khái niệm nền tảng, cấu trúc và ý nghĩa của data cube. Để học bổ sung, tôi khuyên bạn nên học các khóa Ra quyết định dựa trên dữ liệu bằng SQL và Thiết kế cơ sở dữ liệu của chúng tôi.
Data Cube là gì?
Tôi sẽ định nghĩa khái niệm và đặt nó trong bối cảnh lịch sử:
Định nghĩa và ví dụ
Data cube là công cụ để quản lý dữ liệu đa chiều trong phân tích dữ liệu, chẳng hạn trong business intelligence. Khác với các cấu trúc dữ liệu phẳng truyền thống như bảng tính hoặc cơ sở dữ liệu quan hệ, data cube cho phép khám phá hiệu quả hơn các tập dữ liệu phức tạp ở ba chiều hoặc nhiều hơn.
Những điều này thường không hiển hiện rõ ràng với nhà phân tích, nên tôi sẽ minh họa ý tưởng về data cube bằng một ví dụ. Tôi sẽ nói từ góc nhìn của một nhà phân tích BI:
Giả sử bạn muốn theo dõi doanh số cửa hàng bán lẻ. Dữ liệu có sẵn có thể gồm doanh thu và số lượng bán ra, được phân loại theo các chiều như thời gian, loại sản phẩm và địa điểm cửa hàng. Data cube, thực chất là một mô hình logic hay khái niệm, tổ chức dữ liệu của bạn để bất kỳ công cụ BI nào bạn dùng cũng có thể nhanh chóng tạo trực quan hóa cho mọi tổ hợp của các chiều tôi vừa nêu. Chẳng hạn, nó có thể dùng để xem tổng doanh số theo sản phẩm trên tất cả cửa hàng trong một năm cụ thể.
Bây giờ, hãy hình dung bạn đang xem một bảng tính với các cột “Thời gian (Tháng)”, “Loại sản phẩm”, “Địa điểm cửa hàng” và “Doanh thu”. Bảng tính này không đại diện cho cấu trúc của một data cube, nhưng nó có thể được dùng để xây dựng hoặc nạp dữ liệu cho một data cube, nơi mỗi hàng trở thành một ô được tạo bởi tổ hợp duy nhất của Thời gian, Loại sản phẩm và Địa điểm cửa hàng, với Doanh thu là giá trị bên trong ô đó.
|
Tháng
|
Loại sản phẩm
|
Địa điểm cửa hàng
|
Doanh thu
|
|
Tháng 1
|
Điện tử
|
Chicago
|
10,000
|
|
Tháng 1
|
Quần áo
|
Chicago
|
5,000
|
|
Tháng 1
|
Nội thất
|
New York
|
12,000
|
|
Tháng 2
|
Điện tử
|
Los Angeles
|
8,000
|
|
Tháng 2
|
Quần áo
|
Chicago
|
6,000
|
|
Tháng 3
|
Điện tử
|
New York
|
9,000
|
|
Tháng 3
|
Nội thất
|
Los Angeles
|
11,000
|
Trong một cube, những điều này trở thành các chiều. Tức là, mỗi tổ hợp duy nhất thời gian × sản phẩm × địa điểm trỏ tới một ô chứa doanh thu hoặc số lượng, và đây sẽ là một giá trị tổng hợp được lưu sẵn để truy xuất nhanh (sẽ nói thêm bên dưới).
Bối cảnh lịch sử và tiến hóa
Data cube bắt đầu trở nên phổ biến vào thập niên 1990, khi sự trỗi dậy của kho dữ liệu và OLAP (Xử lý phân tích trực tuyến). Khi đó, các doanh nghiệp cần những cách phân tích dữ liệu ngày càng tăng nhanh hơn và tương tác hơn. Data cube đáp ứng nhu cầu đó bằng cách tổ chức thông tin thành các góc nhìn linh hoạt, đa chiều giúp việc nhận ra xu hướng và mẫu hình trở nên dễ dàng hơn nhiều.
Khi công nghệ phát triển, data cube cũng tiến hóa theo. Nhờ cải thiện về năng lực tính toán, lưu trữ và xử lý song song, chúng đã thích ứng để xử lý các tập dữ liệu lớn hơn, phức tạp hơn. Ngày nay, data cube không còn bị giới hạn trong các hệ thống on-premise truyền thống. Chúng được tích hợp rộng rãi vào các nền tảng phân tích trên đám mây, hỗ trợ xử lý thời gian thực và insight có khả năng mở rộng, theo nhu cầu cho các bài toán business intelligence hiện đại.
Thành phần của Data Cube
Điều quan trọng là phân tách các thành phần cốt lõi của data cube để hiểu đầy đủ cách chúng hoạt động. Dưới đây là ví dụ cho từng thành phần.
Các chiều (Dimensions)
Các chiều là thuộc tính phân loại xác định cấu trúc của data cube. Bạn có thể dùng các chiều để phân loại và lọc dữ liệu theo những phân khúc khác nhau.
Dưới đây là một số ví dụ phổ biến về các chiều dùng trong data cube:
- Thời gian: Chiều thời gian bao gồm hệ phân cấp như năm, quý, tháng hoặc ngày. Ví dụ, một cube doanh số bán lẻ có thể cho phép phân tích số liệu theo tháng (Tháng 1, Tháng 2, v.v.) hoặc theo năm (2023, 2024).
- Địa lý: Chiều này gồm các mức như quốc gia, bang/tỉnh, thành phố hoặc địa điểm cửa hàng, cho phép so sánh theo khu vực. Chẳng hạn, một công ty có thể phân tích hiệu suất bán hàng theo khu vực (Bắc Mỹ, Châu Âu) hoặc theo thành phố (New York, London).
- Sản phẩm: Chiều này nhóm dữ liệu theo dòng sản phẩm hoặc mặt hàng cụ thể để phân loại doanh số tốt hơn. Ví dụ, một cửa hàng điện tử có thể chia thành các danh mục như điện thoại thông minh, máy tính xách tay và phụ kiện để xem mặt hàng nào bán chạy nhất.
Chỉ số đo lường (Measures)
Measures là các điểm dữ liệu định lượng được lưu trong cube để cung cấp insight. Bạn có thể tổng hợp các giá trị số này bằng các phép toán như tổng, trung bình, đếm hoặc giá trị lớn nhất.
Sau đây là các ví dụ về measures bạn có thể gặp
- Doanh thu: Tổng thu nhập tạo ra từ bán hàng.
- Số đơn vị bán ra: Số lượng sản phẩm đã bán.
- Biên lợi nhuận: Chênh lệch giữa doanh thu bán hàng và chi phí bán sản phẩm.
Hệ phân cấp (Hierarchies)
Hệ phân cấp tổ chức các chiều thành nhiều mức, hỗ trợ phân tích nâng cao qua các thao tác như drill-down và roll-up. Bằng cách cấu trúc các chiều theo hệ phân cấp, bạn có thể điều hướng từ tóm tắt đơn giản tới các góc nhìn chi tiết hơn. Ví dụ về hệ phân cấp có thể gồm:
- Một hệ phân cấp trong chiều thời gian có thể gồm Năm > Quý > Tháng > Ngày. Nhờ đó, bạn có thể drill down đến mức chi tiết hơn, như từ số liệu theo năm xuống phân tích theo tháng.
- Trong chiều địa lý, một hệ phân cấp có thể là Quốc gia > Bang/Tỉnh > Thành phố > Cửa hàng. Nhờ đó, bạn có thể tổng hợp dữ liệu, như cộng dồn doanh số từ từng cửa hàng để có tổng theo thành phố.
Cấu trúc của Data Cube
Hãy cùng phân tích cách một data cube được xây dựng và vì sao cấu trúc của nó giúp việc phân tích trở nên dễ dàng hơn nhiều.
Mô hình hóa đa chiều
Hãy nghĩ về data cube như một bảng tính 3D, nơi mỗi trục đại diện cho một cách nhìn dữ liệu khác nhau, như thời gian, địa điểm hoặc loại sản phẩm. Thiết lập này cho phép bạn khám phá các tập dữ liệu phức tạp từ nhiều góc độ cùng lúc.
Ví dụ, hãy tưởng tượng bạn đang phân tích doanh số bán lẻ. Cube của bạn có thể có:
- Thời gian là một chiều (tháng hoặc quý).
- Địa lý là chiều thứ hai (vùng hoặc thành phố).
- Danh mục sản phẩm là chiều thứ ba (điện tử, quần áo, v.v.).
Ưu điểm của mô hình hóa đa chiều bao gồm:
- Điều hướng trực quan: Bạn có thể “cắt lát” dữ liệu, phóng to vào các vùng, giai đoạn hoặc sản phẩm cụ thể mà không cần thay đổi toàn bộ cấu trúc.
- Truy vấn hiệu quả: Vì data cube thường lưu các tóm tắt đã được tính trước, các truy vấn phức tạp trả kết quả trong vài giây.
- Tính linh hoạt: Bạn có thể drill down vào chi tiết (như doanh số theo ngày) hoặc roll up lên bức tranh rộng hơn (như xu hướng theo năm), tùy nhu cầu.
Trực quan hóa data cube
Tôi sẽ trực quan hóa data cube để giúp bạn hiểu cấu trúc và cách diễn giải dữ liệu bên trong. Dưới đây là một biểu diễn đơn giản của data cube 3D:
Trong sơ đồ bên dưới:
- Trục X đại diện cho chiều thời gian (Năm > Quý > Tháng).
- Trục Y đại diện cho chiều địa lý (Quốc gia > Bang/Tỉnh > Thành phố).
- Trục Z đại diện cho chiều sản phẩm (Danh mục > Loại).
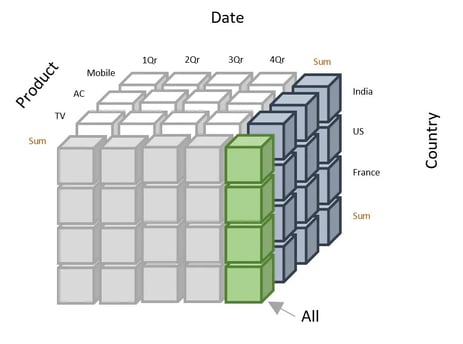
Ví dụ biểu diễn data cube. Nguồn: Mastering Revenue Operations
Bạn có thể diễn giải data cube trên như sau:
- Chọn các chiều: Chọn tổ hợp các chiều bạn muốn phân tích. Ví dụ, doanh số cho điện tử (Sản phẩm) tại Canada (Quốc gia) trong quý 1 năm 2023 (Thời gian).
- Tập trung vào chỉ số đo lường: Trích xuất và diễn giải dữ liệu trong ô giao nhau, như tổng doanh thu hoặc doanh số trung bình.
- Thực hiện các thao tác: Slice cube để phân tích các chiều cụ thể hoặc dice để xem một tập con dữ liệu.
Vì sao sử dụng Data Cube
Dưới đây là các lý do data cube được sử dụng:
Tổ chức dữ liệu tốt hơn
Như tôi đã đề cập, data cube giúp làm sáng tỏ thông tin phức tạp bằng cách sắp xếp thành các lớp rõ ràng. Điều này tạo thuận lợi cho việc truy cập và phân tích dữ liệu từ các cơ sở dữ liệu.
Cải thiện hiệu năng truy vấn
Data cube được thiết kế để trả lời câu hỏi nhanh vì chúng lưu các tổng hợp được tính trước và dùng lập chỉ mục nâng cao. Cấu trúc này cho phép điều hướng nhanh qua các chiều và measures. Ví dụ, một truy vấn tìm doanh số theo quý trên tất cả cửa hàng được thực thi gần như tức thì, vì data cube đã chứa các tổng hợp tính sẵn này. Tôi đã bắt đầu đề cập điều này trước đó, và theo tôi, đây thực sự là một điểm then chốt.
Hỗ trợ khám phá dữ liệu
Data cube cũng cho phép khám phá dữ liệu tương tác thông qua các thao tác như slicing và dicing. Slicing giúp bạn tập trung vào một chiều cụ thể, như xem doanh số chỉ trong một tháng. Ngược lại, dicing cho phép bạn xem dữ liệu trên nhiều chiều đồng thời, chẳng hạn doanh số theo danh mục sản phẩm tại New York trong tháng 1.
Ví dụ, bạn có thể bắt đầu phân tích bằng doanh số hàng năm, drill down vào hiệu suất theo quý, rồi slice theo khu vực cho một danh mục sản phẩm cụ thể.
Khả năng mở rộng và linh hoạt
Data cube được xây dựng để phát triển theo nhu cầu của bạn. Chúng xử lý tốt các tập dữ liệu lớn, đặc biệt khi kết hợp với các công cụ hiện đại như lưu trữ đám mây hoặc nền tảng dữ liệu lớn. Bạn có thể dễ dàng đưa dữ liệu mới vào, thêm các chiều tùy chỉnh và thiết lập measures phù hợp chính xác với những gì doanh nghiệp bạn cần theo dõi.
Hãy tưởng tượng bạn đang vận hành một cửa hàng trực tuyến tăng trưởng nhanh. Khi bạn mở rộng danh mục sản phẩm, mở tại các khu vực mới hoặc bổ sung dữ liệu gần đây hơn, data cube của bạn có thể lớn lên cùng bạn mà không làm xáo trộn các báo cáo và insight bạn đang dựa vào.
Thách thức và cân nhắc
Mặc dù data cube hữu ích cho việc phân tích tập dữ liệu, chúng đi kèm những thách thức khác nhau. Dưới đây là một số vấn đề đã biết.
Độ phức tạp trong thiết kế
Xây dựng một data cube không chỉ là nhiệm vụ kỹ thuật mà còn đòi hỏi hiểu biết tốt về doanh nghiệp của bạn. Những phức tạp liên quan có thể bao gồm:
- Xác định các chiều và measures: Việc chọn đúng các chiều và measures không phải lúc nào cũng hiển nhiên. Bạn sẽ cần cân nhắc kỹ điều gì thực sự quan trọng.
- Cân bằng độ chi tiết và hiệu năng: Quá nhiều chiều hoặc mức độ chi tiết có thể khiến cube quá lớn và chậm. Tuy nhiên, đơn giản hóa quá mức cũng có thể hạn chế tính hữu dụng.
- Logic nghiệp vụ: Để đưa các quy tắc nghiệp vụ chính xác vào, như hệ phân cấp hoặc quy tắc tổng hợp cụ thể, bạn sẽ cần lập kế hoạch và phối hợp giữa đội kỹ thuật và các bên liên quan nghiệp vụ.
Lưu trữ và bảo trì
Làm việc với data cube đi kèm một số thách thức, đặc biệt khi dữ liệu của bạn tăng trưởng. Bao gồm:
- Nhu cầu lưu trữ cao: Vì cube lưu dữ liệu đã tóm tắt sẵn, chúng có thể chiếm nhiều dung lượng, đặc biệt khi có nhiều chiều và nhiều lớp chi tiết.
- Cập nhật thường xuyên: Để dữ liệu luôn mới, bạn sẽ cần cập nhật cube thường xuyên. Việc này có thể tốn thời gian và tạo áp lực lên hệ thống, đặc biệt nếu bạn làm việc với các tập dữ liệu lớn.
- Tinh chỉnh hiệu năng: Theo thời gian, bạn có thể cần giám sát hiệu năng của cube. Điều đó có nghĩa là điều chỉnh các yếu tố như lập chỉ mục hoặc cách phân mảnh dữ liệu để mọi thứ luôn nhanh và hiệu quả.
Tích hợp với hệ thống hiện có
Khi bạn tích hợp data cube với các hệ thống hiện hữu, bạn có thể gặp các thách thức sau:
- Vấn đề tương thích: Hệ thống cũ hoặc định dạng dữ liệu không tiêu chuẩn có thể làm phức tạp quá trình tích hợp.
- Độ phức tạp ETL (Extract, Transform, Load): Nạp dữ liệu vào cube thường cần các đường ống ETL nâng cao. Những quy trình này có thể tốn thời gian xây dựng và cần bảo trì liên tục.
- Thách thức dữ liệu thời gian thực: Vì các cube truyền thống không được thiết kế cho cập nhật trực tiếp, bạn có thể cần thêm công cụ hoặc điều chỉnh để làm việc với dữ liệu thời gian thực.
Kết luận
Data cube là cách tuyệt vời để tổ chức và thấu hiểu dữ liệu phức tạp từ nhiều góc độ. Chúng giúp bạn phát hiện mẫu hình nhanh hơn, chạy truy vấn hiệu quả hơn và khám phá thông tin bằng cách “cắt lát” theo bất kỳ cách nào bạn cần.
Nếu bạn muốn nâng cao kỹ năng, tôi khuyên bạn nên học khóa Khái niệm Kho dữ liệu để tìm hiểu về các đặc tính của kho dữ liệu và cách tích hợp data cube với các hệ thống hiện có, nếu vai trò của bạn cần điều này. Khóa Tìm hiểu về Kỹ thuật Dữ liệu của chúng tôi cũng sẽ giúp bạn có kỹ năng bảo trì và xử lý dữ liệu.


Khi tôi mới bắt đầu làm việc với các tập dữ liệu lớn, tôi nhanh chóng gặp một vấn đề quen thuộc: dữ liệu bị phân mảnh và rải rác trên nhiều hệ thống. Không có cách dễ dàng để phân tích tổng thể. Tôi cần so sánh xu hướng theo thời gian, giữa các khu vực và theo sản phẩm, nhưng các cơ sở dữ liệu truyền thống không xử lý được kiểu phân tích này. Đó là lúc tôi nghe về data cube và bắt đầu tìm hiểu khái niệm này.
Trong hướng dẫn này, tôi sẽ giải thích các khái niệm nền tảng, cấu trúc và ý nghĩa của data cube. Để học bổ sung, tôi khuyên bạn nên học các khóa Ra quyết định dựa trên dữ liệu bằng SQL và Thiết kế cơ sở dữ liệu của chúng tôi.
Data Cube là gì?
Tôi sẽ định nghĩa khái niệm và đặt nó trong bối cảnh lịch sử:
Định nghĩa và ví dụ
Data cube là công cụ để quản lý dữ liệu đa chiều trong phân tích dữ liệu, chẳng hạn trong business intelligence. Khác với các cấu trúc dữ liệu phẳng truyền thống như bảng tính hoặc cơ sở dữ liệu quan hệ, data cube cho phép khám phá hiệu quả hơn các tập dữ liệu phức tạp ở ba chiều hoặc nhiều hơn.
Những điều này thường không hiển hiện rõ ràng với nhà phân tích, nên tôi sẽ minh họa ý tưởng về data cube bằng một ví dụ. Tôi sẽ nói từ góc nhìn của một nhà phân tích BI:
Giả sử bạn muốn theo dõi doanh số cửa hàng bán lẻ. Dữ liệu có sẵn có thể gồm doanh thu và số lượng bán ra, được phân loại theo các chiều như thời gian, loại sản phẩm và địa điểm cửa hàng. Data cube, thực chất là một mô hình logic hay khái niệm, tổ chức dữ liệu của bạn để bất kỳ công cụ BI nào bạn dùng cũng có thể nhanh chóng tạo trực quan hóa cho mọi tổ hợp của các chiều tôi vừa nêu. Chẳng hạn, nó có thể dùng để xem tổng doanh số theo sản phẩm trên tất cả cửa hàng trong một năm cụ thể.
Bây giờ, hãy hình dung bạn đang xem một bảng tính với các cột “Thời gian (Tháng)”, “Loại sản phẩm”, “Địa điểm cửa hàng” và “Doanh thu”. Bảng tính này không đại diện cho cấu trúc của một data cube, nhưng nó có thể được dùng để xây dựng hoặc nạp dữ liệu cho một data cube, nơi mỗi hàng trở thành một ô được tạo bởi tổ hợp duy nhất của Thời gian, Loại sản phẩm và Địa điểm cửa hàng, với Doanh thu là giá trị bên trong ô đó.
Tháng
Loại sản phẩm
Địa điểm cửa hàng
Doanh thu
Tháng 1
Điện tử
Chicago
10,000
Tháng 1
Quần áo
Chicago
5,000
Tháng 1
Nội thất
New York
12,000
Tháng 2
Điện tử
Los Angeles
8,000
Tháng 2
Quần áo
Chicago
6,000
Tháng 3
Điện tử
New York
9,000
Tháng 3
Nội thất
Los Angeles
11,000
Trong một cube, những điều này trở thành các chiều. Tức là, mỗi tổ hợp duy nhất thời gian × sản phẩm × địa điểm trỏ tới một ô chứa doanh thu hoặc số lượng, và đây sẽ là một giá trị tổng hợp được lưu sẵn để truy xuất nhanh (sẽ nói thêm bên dưới).
Bối cảnh lịch sử và tiến hóa
Data cube bắt đầu trở nên phổ biến vào thập niên 1990, khi sự trỗi dậy của kho dữ liệu và OLAP (Xử lý phân tích trực tuyến). Khi đó, các doanh nghiệp cần những cách phân tích dữ liệu ngày càng tăng nhanh hơn và tương tác hơn. Data cube đáp ứng nhu cầu đó bằng cách tổ chức thông tin thành các góc nhìn linh hoạt, đa chiều giúp việc nhận ra xu hướng và mẫu hình trở nên dễ dàng hơn nhiều.
Khi công nghệ phát triển, data cube cũng tiến hóa theo. Nhờ cải thiện về năng lực tính toán, lưu trữ và xử lý song song, chúng đã thích ứng để xử lý các tập dữ liệu lớn hơn, phức tạp hơn. Ngày nay, data cube không còn bị giới hạn trong các hệ thống on-premise truyền thống. Chúng được tích hợp rộng rãi vào các nền tảng phân tích trên đám mây, hỗ trợ xử lý thời gian thực và insight có khả năng mở rộng, theo nhu cầu cho các bài toán business intelligence hiện đại.
Thành phần của Data Cube
Điều quan trọng là phân tách các thành phần cốt lõi của data cube để hiểu đầy đủ cách chúng hoạt động. Dưới đây là ví dụ cho từng thành phần.
Các chiều (Dimensions)
Các chiều là thuộc tính phân loại xác định cấu trúc của data cube. Bạn có thể dùng các chiều để phân loại và lọc dữ liệu theo những phân khúc khác nhau.
Dưới đây là một số ví dụ phổ biến về các chiều dùng trong data cube:
Chỉ số đo lường (Measures)
Measures là các điểm dữ liệu định lượng được lưu trong cube để cung cấp insight. Bạn có thể tổng hợp các giá trị số này bằng các phép toán như tổng, trung bình, đếm hoặc giá trị lớn nhất.
Sau đây là các ví dụ về measures bạn có thể gặp
Hệ phân cấp (Hierarchies)
Hệ phân cấp tổ chức các chiều thành nhiều mức, hỗ trợ phân tích nâng cao qua các thao tác như drill-down và roll-up. Bằng cách cấu trúc các chiều theo hệ phân cấp, bạn có thể điều hướng từ tóm tắt đơn giản tới các góc nhìn chi tiết hơn. Ví dụ về hệ phân cấp có thể gồm:
Cấu trúc của Data Cube
Hãy cùng phân tích cách một data cube được xây dựng và vì sao cấu trúc của nó giúp việc phân tích trở nên dễ dàng hơn nhiều.
Mô hình hóa đa chiều
Hãy nghĩ về data cube như một bảng tính 3D, nơi mỗi trục đại diện cho một cách nhìn dữ liệu khác nhau, như thời gian, địa điểm hoặc loại sản phẩm. Thiết lập này cho phép bạn khám phá các tập dữ liệu phức tạp từ nhiều góc độ cùng lúc.
Ví dụ, hãy tưởng tượng bạn đang phân tích doanh số bán lẻ. Cube của bạn có thể có:
Ưu điểm của mô hình hóa đa chiều bao gồm:
Trực quan hóa data cube
Tôi sẽ trực quan hóa data cube để giúp bạn hiểu cấu trúc và cách diễn giải dữ liệu bên trong. Dưới đây là một biểu diễn đơn giản của data cube 3D:
Trong sơ đồ bên dưới:
Ví dụ biểu diễn data cube. Nguồn: Mastering Revenue Operations
Bạn có thể diễn giải data cube trên như sau:
Vì sao sử dụng Data Cube
Dưới đây là các lý do data cube được sử dụng:
Tổ chức dữ liệu tốt hơn
Như tôi đã đề cập, data cube giúp làm sáng tỏ thông tin phức tạp bằng cách sắp xếp thành các lớp rõ ràng. Điều này tạo thuận lợi cho việc truy cập và phân tích dữ liệu từ các cơ sở dữ liệu.
Cải thiện hiệu năng truy vấn
Data cube được thiết kế để trả lời câu hỏi nhanh vì chúng lưu các tổng hợp được tính trước và dùng lập chỉ mục nâng cao. Cấu trúc này cho phép điều hướng nhanh qua các chiều và measures. Ví dụ, một truy vấn tìm doanh số theo quý trên tất cả cửa hàng được thực thi gần như tức thì, vì data cube đã chứa các tổng hợp tính sẵn này. Tôi đã bắt đầu đề cập điều này trước đó, và theo tôi, đây thực sự là một điểm then chốt.
Hỗ trợ khám phá dữ liệu
Data cube cũng cho phép khám phá dữ liệu tương tác thông qua các thao tác như slicing và dicing. Slicing giúp bạn tập trung vào một chiều cụ thể, như xem doanh số chỉ trong một tháng. Ngược lại, dicing cho phép bạn xem dữ liệu trên nhiều chiều đồng thời, chẳng hạn doanh số theo danh mục sản phẩm tại New York trong tháng 1.
Ví dụ, bạn có thể bắt đầu phân tích bằng doanh số hàng năm, drill down vào hiệu suất theo quý, rồi slice theo khu vực cho một danh mục sản phẩm cụ thể.
Khả năng mở rộng và linh hoạt
Data cube được xây dựng để phát triển theo nhu cầu của bạn. Chúng xử lý tốt các tập dữ liệu lớn, đặc biệt khi kết hợp với các công cụ hiện đại như lưu trữ đám mây hoặc nền tảng dữ liệu lớn. Bạn có thể dễ dàng đưa dữ liệu mới vào, thêm các chiều tùy chỉnh và thiết lập measures phù hợp chính xác với những gì doanh nghiệp bạn cần theo dõi.
Hãy tưởng tượng bạn đang vận hành một cửa hàng trực tuyến tăng trưởng nhanh. Khi bạn mở rộng danh mục sản phẩm, mở tại các khu vực mới hoặc bổ sung dữ liệu gần đây hơn, data cube của bạn có thể lớn lên cùng bạn mà không làm xáo trộn các báo cáo và insight bạn đang dựa vào.
Thách thức và cân nhắc
Mặc dù data cube hữu ích cho việc phân tích tập dữ liệu, chúng đi kèm những thách thức khác nhau. Dưới đây là một số vấn đề đã biết.
Độ phức tạp trong thiết kế
Xây dựng một data cube không chỉ là nhiệm vụ kỹ thuật mà còn đòi hỏi hiểu biết tốt về doanh nghiệp của bạn. Những phức tạp liên quan có thể bao gồm:
Lưu trữ và bảo trì
Làm việc với data cube đi kèm một số thách thức, đặc biệt khi dữ liệu của bạn tăng trưởng. Bao gồm:
Tích hợp với hệ thống hiện có
Khi bạn tích hợp data cube với các hệ thống hiện hữu, bạn có thể gặp các thách thức sau:
Kết luận
Data cube là cách tuyệt vời để tổ chức và thấu hiểu dữ liệu phức tạp từ nhiều góc độ. Chúng giúp bạn phát hiện mẫu hình nhanh hơn, chạy truy vấn hiệu quả hơn và khám phá thông tin bằng cách “cắt lát” theo bất kỳ cách nào bạn cần.
Nếu bạn muốn nâng cao kỹ năng, tôi khuyên bạn nên học khóa Khái niệm Kho dữ liệu để tìm hiểu về các đặc tính của kho dữ liệu và cách tích hợp data cube với các hệ thống hiện có, nếu vai trò của bạn cần điều này. Khóa Tìm hiểu về Kỹ thuật Dữ liệu của chúng tôi cũng sẽ giúp bạn có kỹ năng bảo trì và xử lý dữ liệu.