Quando ho iniziato a lavorare con grandi dataset, mi sono scontrato subito con un problema noto: dati frammentati sparsi tra diversi sistemi. Non c'era un modo semplice per analizzarli tutti insieme. Avevo bisogno di confrontare le tendenze nel tempo, tra regioni e per prodotto, ma i database tradizionali non erano in grado di gestire questo tipo di analisi. È allora che ho sentito parlare dei data cube e ho iniziato a studiarne il concetto.
In questa guida spiegherò i fondamenti, la struttura e l'importanza dei data cube. Per materiali complementari, ti consiglio i nostri corsi Decisioni basate sui dati in SQL e Progettazione di database.
Che cos'è un data cube?
Definirò l'idea e la inserirò nel contesto storico:
Definizione ed esempio
I data cube sono strumenti per gestire dati multidimensionali nell'analisi dei dati, ad esempio nella business intelligence. A differenza delle tradizionali strutture di dati piatte, come i fogli di calcolo o i database relazionali, i data cube consentono un'esplorazione più efficiente di dataset complessi in tre o più dimensioni.
Tutto questo spesso non è particolarmente evidente per l'analista, quindi lascia che illustri l'idea di data cube con un esempio. Parlerò dal punto di vista di un analista BI:
Supponiamo che tu voglia monitorare le vendite di negozi al dettaglio. I dati disponibili potrebbero includere ricavi e quantità vendute, categorizzati per dimensioni come tempo, tipologia di prodotto e posizione del negozio. Un data cube, che è in realtà più un modello logico o concettuale, organizza i tuoi dati in modo che qualunque strumento BI tu stia usando possa generare rapidamente visualizzazioni di qualsiasi combinazione delle dimensioni che ho citato. Ad esempio, può essere usato per visualizzare le vendite totali per prodotto in tutti i negozi in un determinato anno.
Ora immagina di guardare un foglio di calcolo con le colonne “Tempo (Mesi)”, “Tipologia di prodotto”, “Posizione del negozio” e “Ricavi”. Questo foglio non rappresenta strutturalmente un data cube, ma potrebbe essere usato per contribuire a costruire o popolare un data cube, in cui ogni riga diventa una cella formata dalla combinazione unica di Tempo, Tipologia di prodotto e Posizione del negozio, con Ricavi come valore all'interno di quella cella.
|
Mese
|
Tipologia di prodotto
|
Posizione del negozio
|
Ricavi
|
|
Gennaio
|
Elettronica
|
Chicago
|
10,000
|
|
Gennaio
|
Abbigliamento
|
Chicago
|
5,000
|
|
Gennaio
|
Arredamento
|
New York
|
12,000
|
|
Febbraio
|
Elettronica
|
Los Angeles
|
8,000
|
|
Febbraio
|
Abbigliamento
|
Chicago
|
6,000
|
|
Marzo
|
Elettronica
|
New York
|
9,000
|
|
Marzo
|
Arredamento
|
Los Angeles
|
11,000
|
In un cube, questi diventano dimensioni. Cioè, ogni combinazione unica di tempo × prodotto × località punta a una cella contenente ricavi o quantità, e questo sarà un aggregato pre-archiviato e recuperato velocemente (ne parleremo più avanti).
Contesto storico ed evoluzione
I data cube sono diventati popolari negli anni '90, durante l'ascesa del data warehousing e dell'OLAP (Online Analytical Processing). All'epoca, le aziende avevano bisogno di modi più rapidi e interattivi per analizzare quantità crescenti di dati. I data cube hanno risposto a questa esigenza organizzando le informazioni in viste flessibili e multidimensionali che rendevano molto più semplice individuare trend e pattern.
Con l'evoluzione della tecnologia, si sono evoluti anche i data cube. Si sono adattati a gestire dataset più grandi e complessi grazie ai miglioramenti in potenza di calcolo, storage e elaborazione parallela. Oggi i data cube non sono più limitati ai sistemi on-premise tradizionali. Sono ampiamente integrati in piattaforme di analytics basate sul cloud. Questo supporta l'elaborazione in tempo reale e insight scalabili e on-demand per le esigenze moderne di business intelligence.
Componenti di un data cube
È importante scomporre i componenti chiave dei data cube per comprenderne appieno il funzionamento. Di seguito sono riportati esempi di ciascun componente.
Dimensioni
Le dimensioni sono gli attributi categoriali che definiscono la struttura di un data cube. Puoi usare le dimensioni per categorizzare e filtrare i tuoi dati in base a diversi segmenti.
Ecco alcuni esempi comuni di dimensioni usate nei data cube:
- Tempo: La dimensione tempo include gerarchie come anni, trimestri, mesi o giorni. Ad esempio, un cube sulle vendite retail potrebbe consentire l'analisi delle vendite per mese (gennaio, febbraio, ecc.) o per anno (2023, 2024).
- Geografia: Questa dimensione include livelli come paese, stato/regione, città o sede del negozio, consentendo confronti regionali. Ad esempio, un'azienda potrebbe analizzare le performance di vendita per regione (Nord America, Europa) o città (New York, Londra).
- Prodotto: Questa dimensione raggruppa i dati per linee di prodotto o articoli specifici per una migliore categorizzazione delle vendite. Ad esempio, un negozio di elettronica potrebbe suddividerla in categorie come smartphone, laptop e accessori per capire cosa vende di più.
Misure
Le misure sono i punti dati quantitativi archiviati all'interno del cube per fornire insight. Puoi aggregare questi valori numerici con operazioni matematiche come somma, media, conteggio o massimo.
Di seguito alcuni esempi di misure che potresti incontrare
- Ricavi: Entrate totali generate dalle vendite.
- Unità vendute: Numero di prodotti venduti.
- Margini di profitto: Differenza tra ricavi di vendita e costi di vendita dei prodotti.
Gerarchie
Le gerarchie organizzano le dimensioni in livelli che aiutano a fornire analisi avanzate tramite operazioni come drill-down e roll-up. Strutturando le dimensioni in modo gerarchico, puoi passare da riepiloghi semplici a viste dei dati più dettagliate. Esempi di gerarchie includono:
- Una gerarchia nella dimensione tempo potrebbe consistere in Anno > Trimestre > Mese > Giorno. Puoi quindi effettuare drill-down su dettagli più fini, ad esempio passando dai dati annuali ai dettagli mensili.
- Nella dimensione geografica, una gerarchia potrebbe essere Paese > Stato/Regione > Città > Negozio. Puoi quindi aggregare i dati, ad esempio sommando le vendite dei singoli negozi, per ottenere un totale a livello di città.
La struttura di un data cube
Vediamo come è costruito un data cube e perché la sua struttura rende l'analisi così più semplice.
Modellazione multidimensionale
Pensa a un data cube come a un foglio di calcolo 3D in cui ogni asse rappresenta un modo diverso di guardare i tuoi dati, ad esempio tempo, località o tipologia di prodotto. Questa impostazione ti consente di esplorare dataset complessi da più angolazioni contemporaneamente.
Ad esempio, immagina di analizzare le vendite retail. Il tuo cube potrebbe avere:
- Tempo come una dimensione (mesi o trimestri).
- Geografia come seconda dimensione (regioni o città).
- Categoria di prodotto come terza dimensione (elettronica, abbigliamento, ecc.).
I vantaggi della modellazione multidimensionale includono quanto segue.
- Navigazione intuitiva: puoi tagliare e incrociare i dati, facendo zoom su regioni, periodi o prodotti specifici senza cambiare l'intera struttura.
- Query efficienti: poiché i data cube spesso archiviano riepiloghi pre-calcolati, le query complesse restituiscono risultati in pochi secondi.
- Flessibilità: puoi effettuare drill-down nei dettagli (come le vendite giornaliere) o roll-up a viste più ampie (come i trend annuali), a seconda di ciò che ti serve.
Visualizzazione dei data cube
Visualizzerò il data cube per aiutarti a capire la sua struttura e come interpretare i dati che contiene. Di seguito una semplice rappresentazione di un data cube 3D:
Nel diagramma seguente:
- L'asse X rappresenta la dimensione tempo (Anno > Trimestre > Mese).
- L'asse Y rappresenta la dimensione geografia (Paese > Stato/Regione > Città).
- L'asse Z rappresenta la dimensione prodotto (Categoria > Tipologia).
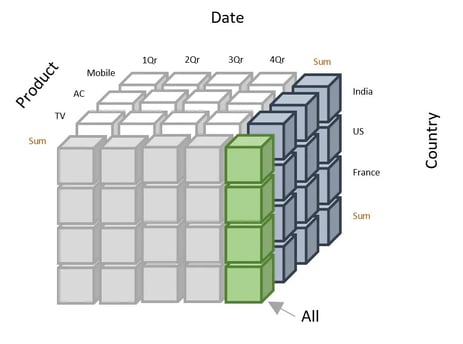
Esempio di rappresentazione di un data cube. Fonte: Mastering Revenue Operations
Puoi interpretare il data cube sopra nel modo seguente:
- Seleziona le dimensioni: scegli la combinazione di dimensioni che vuoi analizzare. Ad esempio, vendite per l'elettronica (Prodotto) in Canada (Paese) durante il Q1 2023 (Tempo).
- Concentrati sulle misure: estrai e interpreta i dati archiviati nella cella d'intersezione, come ricavi totali o vendite medie.
- Esegui operazioni: suddividi (slice) il cube per analizzare dimensioni specifiche o effettua un dice per visualizzare un sottoinsieme di dati.
Perché si usano i data cube
Di seguito i motivi per cui si usano i data cube:
Organizzazione dei dati migliorata
Come accennato, i data cube aiutano a dare senso a informazioni complesse ordinandole in livelli chiari. Questo facilita l'accesso e l'analisi dei dati dai database.
Prestazioni delle query migliorate
I data cube sono progettati per rispondere alle domande rapidamente perché archiviano riepiloghi pre-calcolati e usano indicizzazione avanzata. Questa struttura consente una navigazione veloce tra dimensioni e misure. Ad esempio, una query per trovare le vendite trimestrali in tutti i negozi viene eseguita quasi istantaneamente, poiché il data cube contiene già questi aggregati pre-calcolati. L'ho accennato prima, ed è davvero uno dei punti chiave, secondo me.
Esplorazione dei dati facilitata
I data cube abilitano anche l'esplorazione interattiva dei dati tramite operazioni come slicing e dicing. Lo slicing ti consente di concentrarti su una dimensione specifica, ad esempio esaminando le vendite di un solo mese. Al contrario, il dicing ti permette di visualizzare i dati su più dimensioni contemporaneamente, come le vendite per categoria di prodotto a New York durante gennaio.
Ad esempio, puoi iniziare un'analisi dalle vendite annuali, effettuare drill-down sulle performance trimestrali e poi fare slicing per regione per una specifica categoria di prodotto.
Scalabilità e flessibilità
I data cube sono costruiti per crescere con le tue esigenze. Gestiscono bene grandi dataset, soprattutto se associati a strumenti moderni come storage cloud o piattaforme big data. Puoi integrare facilmente nuovi dati, aggiungere dimensioni personalizzate e impostare misure che rispecchiano esattamente ciò che la tua azienda ha bisogno di monitorare.
Immagina di gestire un negozio online in rapida crescita. Man mano che ampli la gamma di prodotti, apri in nuove regioni o aggiungi dati più recenti, il tuo data cube può crescere con te, senza compromettere i report e gli insight su cui già fai affidamento.
Sfide e considerazioni
Sebbene i data cube siano utili per analizzare i tuoi dataset, presentano diverse sfide. Di seguito alcune criticità note.
Complessità nella progettazione
Costruire un data cube non è solo un compito tecnico: richiede anche una buona comprensione del tuo business. Le complessità coinvolte possono includere:
- Identificazione di dimensioni e misure: scegliere le dimensioni e le misure giuste non è sempre ovvio. Dovrai riflettere con attenzione su ciò che è davvero importante.
- Equilibrio tra granularità e prestazioni: troppe dimensioni o livelli di dettaglio possono rendere il cube troppo grande e lento. Tuttavia, semplificare eccessivamente il design può anche limitarne l'utilità.
- Logica di business: per incorporare regole aziendali accurate, come gerarchie o aggregazioni specifiche, serviranno pianificazione e collaborazione tra team tecnici e stakeholder di business.
Archiviazione e manutenzione
Lavorare con i data cube comporta alcune sfide, soprattutto con la crescita dei dati. Tra queste:
- Requisiti di archiviazione elevati: poiché i cube archiviano dati pre-sintetizzati, possono occupare molto spazio, specialmente quando si hanno molte dimensioni e livelli di dettaglio.
- Aggiornamenti regolari: per assicurarti che i dati restino aggiornati, dovrai aggiornare il cube regolarmente. Questo può richiedere tempo e gravare sul sistema, soprattutto se lavori con grandi dataset.
- Ottimizzazione delle prestazioni: nel tempo, probabilmente dovrai monitorare le prestazioni del cube. Questo significa regolare elementi come l'indicizzazione o il partizionamento dei dati per mantenere tutto veloce ed efficiente.
Integrazione con i sistemi esistenti
Quando integri i data cube con i sistemi esistenti, potresti incontrare le seguenti sfide:
- Problemi di compatibilità: sistemi legacy o formati di dati non standard possono complicare il processo di integrazione.
- Complessità ETL (Extract, Transform, Load): alimentare il cube spesso richiede pipeline ETL avanzate ETL pipelines. Queste possono richiedere tempo per essere costruite e necessitare di manutenzione continua.
- Sfide con i dati in tempo reale: poiché i cube tradizionali non sono progettati per aggiornamenti live, potresti avere bisogno di strumenti aggiuntivi o adattamenti per lavorare con dati in tempo reale.
Conclusione
I data cube sono un ottimo modo per organizzare e dare senso a dati complessi da diverse angolazioni. Ti aiutano a individuare pattern più rapidamente, eseguire query in modo più efficiente ed esplorare le informazioni suddividendole come preferisci.
Se vuoi far crescere le tue competenze, ti consiglio il nostro corso Concetti di Data Warehousing per imparare le proprietà dei data warehouse e come integrare i data cube con i sistemi esistenti, se il tuo ruolo lo richiede. Il nostro corso Understanding Data Engineering ti aiuterà inoltre con competenze per la manutenzione e l'elaborazione dei dati.





Quando ho iniziato a lavorare con grandi dataset, mi sono scontrato subito con un problema noto: dati frammentati sparsi tra diversi sistemi. Non c'era un modo semplice per analizzarli tutti insieme. Avevo bisogno di confrontare le tendenze nel tempo, tra regioni e per prodotto, ma i database tradizionali non erano in grado di gestire questo tipo di analisi. È allora che ho sentito parlare dei data cube e ho iniziato a studiarne il concetto.
In questa guida spiegherò i fondamenti, la struttura e l'importanza dei data cube. Per materiali complementari, ti consiglio i nostri corsi Decisioni basate sui dati in SQL e Progettazione di database.
Che cos'è un data cube?
Definirò l'idea e la inserirò nel contesto storico:
Definizione ed esempio
I data cube sono strumenti per gestire dati multidimensionali nell'analisi dei dati, ad esempio nella business intelligence. A differenza delle tradizionali strutture di dati piatte, come i fogli di calcolo o i database relazionali, i data cube consentono un'esplorazione più efficiente di dataset complessi in tre o più dimensioni.
Tutto questo spesso non è particolarmente evidente per l'analista, quindi lascia che illustri l'idea di data cube con un esempio. Parlerò dal punto di vista di un analista BI:
Supponiamo che tu voglia monitorare le vendite di negozi al dettaglio. I dati disponibili potrebbero includere ricavi e quantità vendute, categorizzati per dimensioni come tempo, tipologia di prodotto e posizione del negozio. Un data cube, che è in realtà più un modello logico o concettuale, organizza i tuoi dati in modo che qualunque strumento BI tu stia usando possa generare rapidamente visualizzazioni di qualsiasi combinazione delle dimensioni che ho citato. Ad esempio, può essere usato per visualizzare le vendite totali per prodotto in tutti i negozi in un determinato anno.
Ora immagina di guardare un foglio di calcolo con le colonne “Tempo (Mesi)”, “Tipologia di prodotto”, “Posizione del negozio” e “Ricavi”. Questo foglio non rappresenta strutturalmente un data cube, ma potrebbe essere usato per contribuire a costruire o popolare un data cube, in cui ogni riga diventa una cella formata dalla combinazione unica di Tempo, Tipologia di prodotto e Posizione del negozio, con Ricavi come valore all'interno di quella cella.
Mese
Tipologia di prodotto
Posizione del negozio
Ricavi
Gennaio
Elettronica
Chicago
10,000
Gennaio
Abbigliamento
Chicago
5,000
Gennaio
Arredamento
New York
12,000
Febbraio
Elettronica
Los Angeles
8,000
Febbraio
Abbigliamento
Chicago
6,000
Marzo
Elettronica
New York
9,000
Marzo
Arredamento
Los Angeles
11,000
In un cube, questi diventano dimensioni. Cioè, ogni combinazione unica di tempo × prodotto × località punta a una cella contenente ricavi o quantità, e questo sarà un aggregato pre-archiviato e recuperato velocemente (ne parleremo più avanti).
Contesto storico ed evoluzione
I data cube sono diventati popolari negli anni '90, durante l'ascesa del data warehousing e dell'OLAP (Online Analytical Processing). All'epoca, le aziende avevano bisogno di modi più rapidi e interattivi per analizzare quantità crescenti di dati. I data cube hanno risposto a questa esigenza organizzando le informazioni in viste flessibili e multidimensionali che rendevano molto più semplice individuare trend e pattern.
Con l'evoluzione della tecnologia, si sono evoluti anche i data cube. Si sono adattati a gestire dataset più grandi e complessi grazie ai miglioramenti in potenza di calcolo, storage e elaborazione parallela. Oggi i data cube non sono più limitati ai sistemi on-premise tradizionali. Sono ampiamente integrati in piattaforme di analytics basate sul cloud. Questo supporta l'elaborazione in tempo reale e insight scalabili e on-demand per le esigenze moderne di business intelligence.
Componenti di un data cube
È importante scomporre i componenti chiave dei data cube per comprenderne appieno il funzionamento. Di seguito sono riportati esempi di ciascun componente.
Dimensioni
Le dimensioni sono gli attributi categoriali che definiscono la struttura di un data cube. Puoi usare le dimensioni per categorizzare e filtrare i tuoi dati in base a diversi segmenti.
Ecco alcuni esempi comuni di dimensioni usate nei data cube:
Misure
Le misure sono i punti dati quantitativi archiviati all'interno del cube per fornire insight. Puoi aggregare questi valori numerici con operazioni matematiche come somma, media, conteggio o massimo.
Di seguito alcuni esempi di misure che potresti incontrare
Gerarchie
Le gerarchie organizzano le dimensioni in livelli che aiutano a fornire analisi avanzate tramite operazioni come drill-down e roll-up. Strutturando le dimensioni in modo gerarchico, puoi passare da riepiloghi semplici a viste dei dati più dettagliate. Esempi di gerarchie includono:
La struttura di un data cube
Vediamo come è costruito un data cube e perché la sua struttura rende l'analisi così più semplice.
Modellazione multidimensionale
Pensa a un data cube come a un foglio di calcolo 3D in cui ogni asse rappresenta un modo diverso di guardare i tuoi dati, ad esempio tempo, località o tipologia di prodotto. Questa impostazione ti consente di esplorare dataset complessi da più angolazioni contemporaneamente.
Ad esempio, immagina di analizzare le vendite retail. Il tuo cube potrebbe avere:
I vantaggi della modellazione multidimensionale includono quanto segue.
Visualizzazione dei data cube
Visualizzerò il data cube per aiutarti a capire la sua struttura e come interpretare i dati che contiene. Di seguito una semplice rappresentazione di un data cube 3D:
Nel diagramma seguente:
Esempio di rappresentazione di un data cube. Fonte: Mastering Revenue Operations
Puoi interpretare il data cube sopra nel modo seguente:
Perché si usano i data cube
Di seguito i motivi per cui si usano i data cube:
Organizzazione dei dati migliorata
Come accennato, i data cube aiutano a dare senso a informazioni complesse ordinandole in livelli chiari. Questo facilita l'accesso e l'analisi dei dati dai database.
Prestazioni delle query migliorate
I data cube sono progettati per rispondere alle domande rapidamente perché archiviano riepiloghi pre-calcolati e usano indicizzazione avanzata. Questa struttura consente una navigazione veloce tra dimensioni e misure. Ad esempio, una query per trovare le vendite trimestrali in tutti i negozi viene eseguita quasi istantaneamente, poiché il data cube contiene già questi aggregati pre-calcolati. L'ho accennato prima, ed è davvero uno dei punti chiave, secondo me.
Esplorazione dei dati facilitata
I data cube abilitano anche l'esplorazione interattiva dei dati tramite operazioni come slicing e dicing. Lo slicing ti consente di concentrarti su una dimensione specifica, ad esempio esaminando le vendite di un solo mese. Al contrario, il dicing ti permette di visualizzare i dati su più dimensioni contemporaneamente, come le vendite per categoria di prodotto a New York durante gennaio.
Ad esempio, puoi iniziare un'analisi dalle vendite annuali, effettuare drill-down sulle performance trimestrali e poi fare slicing per regione per una specifica categoria di prodotto.
Scalabilità e flessibilità
I data cube sono costruiti per crescere con le tue esigenze. Gestiscono bene grandi dataset, soprattutto se associati a strumenti moderni come storage cloud o piattaforme big data. Puoi integrare facilmente nuovi dati, aggiungere dimensioni personalizzate e impostare misure che rispecchiano esattamente ciò che la tua azienda ha bisogno di monitorare.
Immagina di gestire un negozio online in rapida crescita. Man mano che ampli la gamma di prodotti, apri in nuove regioni o aggiungi dati più recenti, il tuo data cube può crescere con te, senza compromettere i report e gli insight su cui già fai affidamento.
Sfide e considerazioni
Sebbene i data cube siano utili per analizzare i tuoi dataset, presentano diverse sfide. Di seguito alcune criticità note.
Complessità nella progettazione
Costruire un data cube non è solo un compito tecnico: richiede anche una buona comprensione del tuo business. Le complessità coinvolte possono includere:
Archiviazione e manutenzione
Lavorare con i data cube comporta alcune sfide, soprattutto con la crescita dei dati. Tra queste:
Integrazione con i sistemi esistenti
Quando integri i data cube con i sistemi esistenti, potresti incontrare le seguenti sfide:
Conclusione
I data cube sono un ottimo modo per organizzare e dare senso a dati complessi da diverse angolazioni. Ti aiutano a individuare pattern più rapidamente, eseguire query in modo più efficiente ed esplorare le informazioni suddividendole come preferisci.
Se vuoi far crescere le tue competenze, ti consiglio il nostro corso Concetti di Data Warehousing per imparare le proprietà dei data warehouse e come integrare i data cube con i sistemi esistenti, se il tuo ruolo lo richiede. Il nostro corso Understanding Data Engineering ti aiuterà inoltre con competenze per la manutenzione e l'elaborazione dei dati.