
कोर्स
डेटा इंजीनियरिंग को समझना
2 घंटा
377.4K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंजब मैंने पहली बार बड़े डेटा सेट्स के साथ काम करना शुरू किया, तो मैं जल्द ही एक परिचित समस्या से टकराया: अलग-अलग सिस्टमों में बिखरा हुआ डेटा। इसे एक साथ विश्लेषित करने का कोई आसान तरीका नहीं था। मुझे समय, क्षेत्रों और उत्पाद के अनुसार रुझानों की तुलना करनी थी, लेकिन पारंपरिक डेटाबेस इस तरह के विश्लेषण को संभाल नहीं पाते थे। तभी मैंने डेटा क्यूब्स के बारे में सुना और उनकी अवधारणा का अध्ययन करना शुरू किया।
इस मार्गदर्शिका में, मैं डेटा क्यूब्स की मूल बातें, संरचना, और महत्व समझाऊंगा। पूरक सामग्री के लिए, मैं हमारे Data-Driven Decision Making in SQL और Database Design कोर्सेज लेने की अनुशंसा करता हूँ।
मैं पहले इसकी परिभाषा दूंगा और उसे ऐतिहासिक संदर्भ में रखूंगा:
डेटा क्यूब्स, डेटा विश्लेषण—जैसे बिज़नेस इंटेलिजेंस—में बहु-आयामी डेटा प्रबंधन के उपकरण हैं। स्प्रेडशीट्स या रिलेशनल डेटाबेस जैसे पारंपरिक सपाट डेटा ढांचों के विपरीत, डेटा क्यूब्स तीन या अधिक आयामों में जटिल डेटा सेट्स की अधिक कुशल खोजबीन सक्षम करते हैं।
यह सब अक्सर विश्लेषक को सीधे दिखाई नहीं देता, इसलिए मैं एक उदाहरण के जरिए डेटा क्यूब का विचार स्पष्ट करता हूँ। मैं एक BI विश्लेषक के नज़रिए से बात करूंगा:
मान लीजिए आप रिटेल स्टोर की बिक्री ट्रैक करना चाहते हैं। उपलब्ध डेटा में राजस्व और बिकने वाली मात्रा शामिल हो सकती है, जिन्हें समय, उत्पाद प्रकार, और स्टोर लोकेशन जैसे आयामों के अनुसार वर्गीकृत किया गया है। डेटा क्यूब—जो वास्तव में एक तार्किक/कल्पनात्मक मॉडल अधिक है—आपके डेटा को इस तरह व्यवस्थित करता है कि आपका कोई भी BI टूल मेरे द्वारा बताए गए आयामों के किसी भी संयोजन की विज़ुअलाइज़ेशन जल्दी बना सके। उदाहरण के लिए, इसे किसी विशेष वर्ष में सभी स्टोर्स में उत्पाद के अनुसार कुल बिक्री देखने के लिए उपयोग किया जा सकता है।
अब कल्पना करें कि आप एक स्प्रेडशीट देख रहे हैं जिसमें कॉलम हैं “Time (Months)”, “Product Type”, “Store Location”, और “Revenue”。 यह स्प्रेडशीट संरचना में डेटा क्यूब का प्रतिनिधित्व नहीं करती, पर इसे डेटा क्यूब बनाने या उसे भरने में मदद के लिए उपयोग किया जा सकता है, जहाँ प्रत्येक पंक्ति Time, Product Type, और Store Location के अद्वितीय संयोजन से बना एक सेल बन जाती है, और उस सेल के भीतर मान के रूप में Revenue आता है।
|
Month |
Product Type |
Store Location |
Revenue |
|
January |
Electronics |
Chicago |
10,000 |
|
January |
Clothing |
Chicago |
5,000 |
|
January |
Furniture |
New York |
12,000 |
|
February |
Electronics |
Los Angeles |
8,000 |
|
February |
Clothing |
Chicago |
6,000 |
|
March |
Electronics |
New York |
9,000 |
|
March |
Furniture |
Los Angeles |
11,000 |
क्यूब में, ये डायमेंशन्स बन जाती हैं। अर्थात, समय × उत्पाद × लोकेशन के प्रत्येक अद्वितीय संयोजन से एक सेल इंगित होता है जिसमें राजस्व या मात्रा होती है, और यह एक एग्रीगेट होता है जो पहले से स्टोर किया गया है और तेजी से प्राप्त होता है (इस पर आगे बात करेंगे)।
डेटा क्यूब्स 1990 के दशक में लोकप्रिय हुए, जब डेटा वेयरहाउसिंग और OLAP (Online Analytical Processing) का उदय हुआ। उस समय, व्यवसायों को तेजी से बढ़ते डेटा का विश्लेषण करने के लिए अधिक तेज़ और इंटरैक्टिव तरीके चाहिए थे। डेटा क्यूब्स ने जानकारी को लचीले, बहु-आयामी व्यूज़ में व्यवस्थित करके इस आवश्यकता को पूरा किया, जिससे रुझान और पैटर्न पहचानना काफी आसान हो गया।
तकनीक के विकसित होने के साथ ही डेटा क्यूब्स भी विकसित हुए। कंप्यूटिंग पावर, स्टोरेज, और पैरेलल प्रोसेसिंग में सुधार के चलते वे बड़े, अधिक जटिल डेटा सेट्स को संभालने के लिए अनुकूलित हो गए हैं। आज, डेटा क्यूब्स पारंपरिक ऑन-प्रिमाइसेस सिस्टम तक सीमित नहीं हैं। वे अब क्लाउड-आधारित एनालिटिक्स प्लेटफ़ॉर्म्स में व्यापक रूप से एकीकृत हैं। यह आधुनिक बिज़नेस इंटेलिजेंस की ज़रूरतों के लिए रियल-टाइम प्रोसेसिंग और स्केलेबल, ऑन-डिमांड इनसाइट्स का समर्थन करता है।
डेटा क्यूब्स के मुख्य घटकों को समझना ज़रूरी है ताकि हम पूरी तरह समझ सकें कि वे कैसे काम करते हैं। नीचे प्रत्येक घटक के उदाहरण दिए गए हैं।
डायमेंशन्स वे श्रेणीबद्ध विशेषताएँ हैं जो डेटा क्यूब की संरचना को परिभाषित करती हैं। आप विभिन्न खंडों के आधार पर अपने डेटा को वर्गीकृत और फ़िल्टर करने के लिए डायमेंशन्स का उपयोग कर सकते हैं।
यहाँ डेटा क्यूब्स में उपयोग होने वाली कुछ सामान्य डायमेंशन्स के उदाहरण हैं:
मेज़र्स वे मात्रात्मक डेटा बिंदु हैं जो इनसाइट्स देने के लिए क्यूब के भीतर संग्रहीत होते हैं। आप इन संख्यात्मक मानों को जोड़, औसत, गिनती, या अधिकतम जैसे गणितीय ऑपरेशन्स से एग्रीगेट कर सकते हैं।
निम्नलिखित मेज़र्स के उदाहरण हैं जिनसे आपका सामना हो सकता है
हायरार्कीज़ डायमेंशन्स को ऐसे स्तरों में व्यवस्थित करती हैं जो ड्रिल-डाउन और रोल-अप जैसे ऑपरेशन्स के जरिए उन्नत विश्लेषण करने में मदद करती हैं। डायमेंशन्स को श्रेणीबद्ध रूप से संरचित करके, आप सरल सारांशों से अधिक विस्तृत डेटा व्यूज़ तक नेविगेट कर सकते हैं। हायरार्कीज़ के उदाहरण इस प्रकार हो सकते हैं:
आइए समझते हैं कि डेटा क्यूब कैसे बनाया जाता है और इसकी संरचना विश्लेषण को इतना आसान क्यों बनाती है।
डेटा क्यूब को 3D स्प्रेडशीट की तरह सोचें जहाँ प्रत्येक अक्ष आपके डेटा को देखने का अलग तरीका दर्शाता है, जैसे समय, लोकेशन, या उत्पाद प्रकार। यह सेटअप आपको एक साथ कई कोणों से जटिल डेटा सेट्स की पड़ताल करने देता है।
उदाहरण के लिए, मान लें कि आप रिटेल बिक्री का विश्लेषण कर रहे हैं। आपके क्यूब में ये हो सकते हैं:
बहु-आयामी मॉडलिंग के लाभ निम्नलिखित हैं।
मैं डेटा क्यूब को विज़ुअलाइज़ करूँगा ताकि आप इसकी संरचना और इसमें निहित डेटा की व्याख्या को समझ सकें। नीचे 3D डेटा क्यूब का एक साधारण निरूपण है:
नीचे दिए गए आरेख में:
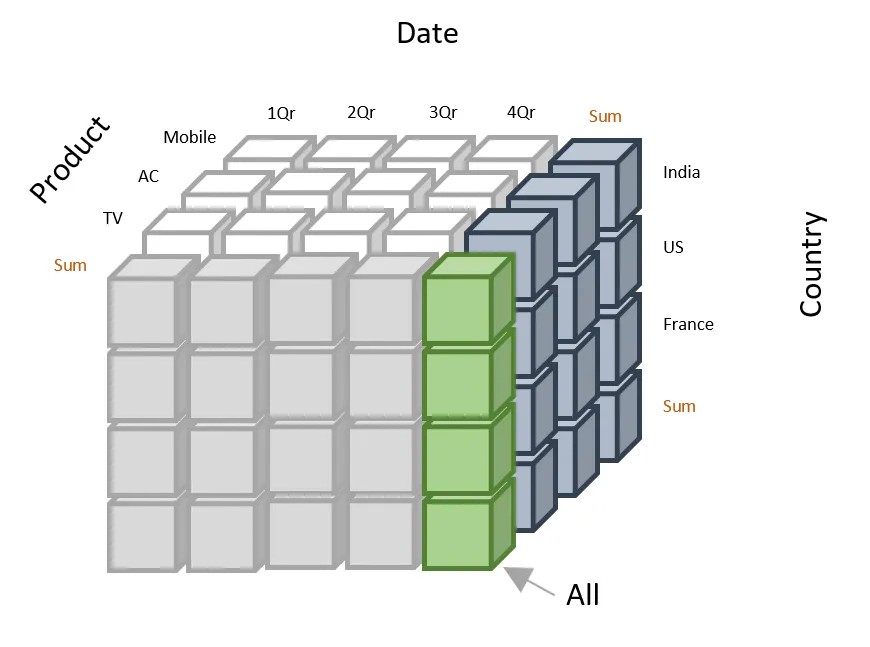
डेटा क्यूब निरूपण का उदाहरण। स्रोत: Mastering Revenue Operations
उपरोक्त डेटा क्यूब की आप इस प्रकार व्याख्या कर सकते हैं:
डेटा क्यूब्स के उपयोग के कारण निम्नलिखित हैं:
जैसा कि मैंने पहले बताया, डेटा क्यूब्स जटिल जानकारी को स्पष्ट परतों में बाँटकर समझने में मदद करते हैं। यह डेटाबेस से डेटा एक्सेस और विश्लेषण को आसान बनाता है।
डेटा क्यूब्स को प्रश्नों का तेज़ी से उत्तर देने के लिए डिज़ाइन किया गया है क्योंकि वे पूर्व-गणना किए गए सारांश स्टोर करते हैं और उन्नत इंडेक्सिंग का उपयोग करते हैं। यह संरचना डायमेंशन्स और मेज़र्स में तेज़ नेविगेशन की अनुमति देती है। उदाहरण के लिए, सभी स्टोर्स में तिमाही बिक्री खोजने की क्वेरी लगभग तुरंत निष्पादित हो जाती है, क्योंकि डेटा क्यूब में ये एग्रीगेट पहले से मौजूद होते हैं। मैंने इसका पहले संकेत दिया था, और मेरी राय में यह वास्तव में प्रमुख बिंदुओं में से एक है।
डेटा क्यूब्स स्लाइसिंग और डाइसिंग जैसे ऑपरेशन्स के माध्यम से इंटरैक्टिव डेटा एक्सप्लोरेशन भी सक्षम करते हैं। स्लाइसिंग आपको किसी एक विशेष डायमेंशन पर ध्यान केंद्रित करने देती है, जैसे केवल एक महीने की बिक्री देखना। इसके विपरीत, डाइसिंग आपको एक साथ कई डायमेंशन्स में डेटा देखने देती है, जैसे जनवरी के दौरान न्यूयॉर्क में उत्पाद श्रेणी के अनुसार बिक्री।
उदाहरण के लिए, आप वार्षिक बिक्री से विश्लेषण शुरू कर सकते हैं, तिमाही प्रदर्शन में ड्रिल डाउन कर सकते हैं, और फिर किसी विशेष उत्पाद श्रेणी के लिए क्षेत्र के अनुसार स्लाइस कर सकते हैं।
डेटा क्यूब्स आपकी ज़रूरतों के साथ बढ़ने के लिए बनाए गए हैं। वे बड़े डेटा सेट्स को अच्छी तरह संभालते हैं, खासकर जब क्लाउड स्टोरेज या बिग डेटा प्लेटफ़ॉर्म्स जैसे आधुनिक टूल्स के साथ जोड़े जाते हैं। आप आसानी से नया डेटा ला सकते हैं, कस्टम डायमेंशन्स जोड़ सकते हैं, और ऐसे मेज़र्स सेट कर सकते हैं जो ठीक-ठीक आपके व्यवसाय की ट्रैकिंग आवश्यकताओं के अनुरूप हों।
सोचिए कि आप एक तेज़ी से बढ़ती ऑनलाइन स्टोर चला रहे हैं। जैसे ही आप अपने उत्पाद दायरे का विस्तार करते हैं, नए क्षेत्रों में खुलते हैं, या अधिक ताज़ा डेटा जोड़ते हैं, आपका डेटा क्यूब आपके साथ बढ़ सकता है—बिना उन रिपोर्ट्स और इनसाइट्स को बिगाड़े जिन पर आप पहले से निर्भर हैं।
हालाँकि डेटा क्यूब्स आपके डेटा सेट्स का विश्लेषण करने में सहायक हैं, उनके साथ अलग-अलग चुनौतियाँ भी आती हैं। नीचे कुछ ज्ञात समस्याएँ दी गई हैं।
डेटा क्यूब बनाना केवल तकनीकी कार्य नहीं है, बल्कि इसके लिए आपके व्यवसाय की अच्छी समझ भी चाहिए। इसमें शामिल जटिलताएँ निम्नलिखित हो सकती हैं:
डेटा क्यूब्स के साथ काम करने में चुनौतियाँ आती हैं, खासकर जब आपका डेटा बढ़ता है। इनमें शामिल हैं:
जब आप डेटा क्यूब्स को मौजूदा सिस्टम्स के साथ इंटीग्रेट करते हैं, तो आपको निम्नलिखित चुनौतियों का सामना करना पड़ सकता है:
डेटा क्यूब्स विभिन्न कोणों से जटिल डेटा को व्यवस्थित करने और समझने का उत्कृष्ट तरीका हैं। वे आपको पैटर्न जल्दी पहचानने, क्वेरीज़ अधिक कुशलता से चलाने, और जानकारी को अपनी आवश्यकता अनुसार स्लाइस करके एक्सप्लोर करने में मदद करते हैं।
यदि आप अपने कौशल को आगे बढ़ाना चाहते हैं, तो मैं हमारे Data Warehousing Concepts कोर्स लेने की अनुशंसा करता हूँ ताकि डेटा वेयरहाउस की विशेषताओं और आवश्यकता पड़ने पर मौजूदा सिस्टम्स के साथ डेटा क्यूब्स को इंटीग्रेट करने का ज्ञान प्राप्त हो। हमारा Understanding Data Engineering कोर्स भी डेटा के मेंटेनेंस और प्रोसेसिंग में आपकी मदद करेगा।
DataCamp के साथ सीखें
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें