
Cursus
Introductie tot dbt
4 uur
33.8K
dbt (data build tool) is een krachtig hulpmiddel dat door data-analisten en -engineers wordt gebruikt om data in de moderne data stack te transformeren, testen en documenteren.
Hoewel het vooral bekendstaat om zijn modellering, is een andere cruciale functie dbt snapshot, waarmee je langzaam veranderende dimensies (SCD) in je datawarehouse kunt vastleggen.
Deze tutorial geeft een diepgaande uitleg van dbt-snapshots, hun use-cases en implementatie. Ik zal:
Wil je meer leren over dbt, bekijk dan zeker onze gids Wat is dbt? Een hands-on introductie voor data engineers en onze Introductiecursus dbt.
Een dbt-snapshot is een mechanisme om veranderingen in records in de tijd te volgen, vooral voor tabellen waarin historische wijzigingen standaard niet bewaard blijven. Snapshots worden voornamelijk gebruikt om Slowly Changing Dimensions (SCD) type 2 te implementeren. Ze slaan versies van rijen op wanneer bijgehouden kolommen veranderen.
Use-cases zijn onder andere:
dbt-snapshots zijn waardevol omdat ze fungeren als een logboek van gegevenswijzigingen in de tijd, wat historische analyses en compliance-rapportage mogelijk maakt.
Dit zijn enkele voordelen van het gebruik van snapshots:
Snapshots kunnen nuttig zijn in specifieke situaties, zoals:
Snapshots integreren naadloos in het dbt-ecosysteem en benutten de configuratie en run-beheer om efficiënt historische tabellen op te bouwen.
Laten we als voorbeeld kijken naar de typen modellen die voor data worden gebruikt.
Er zijn twee modellen die voor data worden gebruikt:
Deze twee modellen verschillen in hun doel, opslagmethoden en toepassingen.
Hier is een samenvatting van de verschillen:
|
Functie |
Standaardmodellen |
Snapshots |
|
Doel |
Transformaties van huidige staat |
Historische tracking |
|
Opslag |
Tabel of view met actuele data |
Alleen-toevoeging geschiedenistabel |
|
Beste voor |
Feit-/dimensionale modellen |
Langzaam veranderende dimensies |
Snapshots volgen doorgaans een gestructureerde workflow die ervoor zorgt dat alle wijzigingen systematisch worden vastgelegd, met de volgende stappen:
dbt snapshot uit om huidige data te vergelijken met bestaande snapshots.Maar hoe worden wijzigingen in dbt bijgehouden?
Alle wijzigingen worden vastgelegd in de output-snapshottabel.
Als een wijziging wordt gedetecteerd, werkt dbt het veld dbt_valid_to voor de vorige versie bij naar de huidige timestamp en voegt het een nieuwe rij in met het veld dbt_valid_from als de huidige timestamp.
Snapshots gebruiken twee primaire strategieën om wijzigingen te detecteren.
updated_at-timestamps.|
Strategie |
Detectiemethode |
Beste voor |
|
Timestamp |
Bijgewerkt timestampkolom |
Tabellen met betrouwbare laatst-bijgewerkt-timestamps |
|
Check |
Rechtstreekse vergelijking van kolommen |
Tabellen zonder timestampkolommen |
Gegevenswijzigingen, zoals deletes, kunnen ook worden gevolgd, maar niet standaard. Er is echter een manier om dit te veranderen en zulke harde deletes te monitoren.
invalidate_hard_deletes=True in om verwijderde rijen te markeren met een dbt_valid_to-waarde, zodat hun laatste staat bewaard blijft.Hier is een voorbeeld van een check-strategie, met rekening houden met harde deletes:
{%
  snapshot customers_snapshot %}

{%
  set config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='check',
    check_cols=['tier'],
    invalidate_hard_deletes=True
  )
%}

SELECT * FROM {{ source('customers') }}

{% endsnapshot %}Nu we weten hoe dbt-snapshots werken, kijken we hoe je ze implementeert
Om te oefenen met snapshots maken we een voorbeeldtabel customers die een echt lidmaatschapssysteem nabootst. Dit geeft ons concrete data om veelgebruikte snapshotstrategieën te testen.
import csv
from datetime import datetime

# Define the data
customers_data = [
    ["customer_id", "name", "tier", "updated_at"],  # header row
    [1, "Alice Tan", "Silver", "2025-07-01 10:00:00"],
    [2, "Bob Lee", "Gold", "2025-07-01 10:00:00"],
    [3, "Cheryl Lim", "Silver", "2025-07-01 10:00:00"]
]

# Write data to customers.csv
with open("customers.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
writer.writerows(customers_data)Voordat je snapshots kunt implementeren, is het essentieel om je dbt-project correct op te zetten. Zo weet je zeker dat je omgeving is geconfigureerd om modellen, snapshots, tests en documentatie gestructureerd en schaalbaar te beheren.
pip install dbtVervang dbt-postgres door je warehouse-adapter, bijv. dbt-snowflake of dbt-bigquery, afhankelijk van je omgeving.
1. Navigeer naar de gewenste projectmap.
Hier bewaar je je analytics- of ELT-projecten. In dit geval slaan we alle gerelateerde bestanden op in deze dbt-projectmap.
cd ~/dbt-snapshot-project2. Initialiseer een nieuw dbt-project.
Maak een configuratiebestand genaamd dbt_project.yml:
Plak het volgende in je projectbestand:
name: dbt_snapshots_project
version: '1.0'
profile: austinchia

seeds:
  dbt_snapshots_project:
    +quote_columns: false
3. Test je verbinding.
dbt debugDit zou de output van het commando moeten zijn:
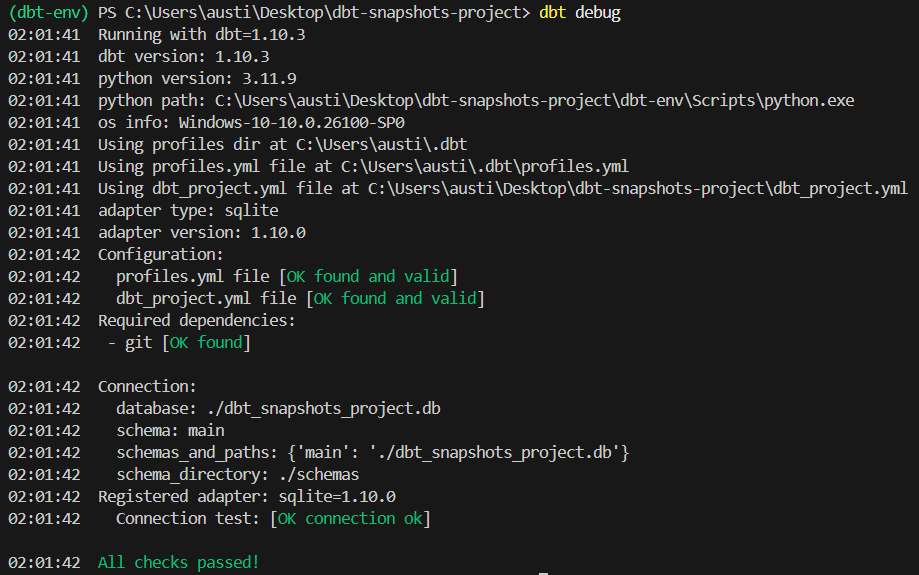
4. Laad de seeds in een lokale database.
Voer het volgende commando uit:
dbt seedDit zou de output van het commando moeten zijn:
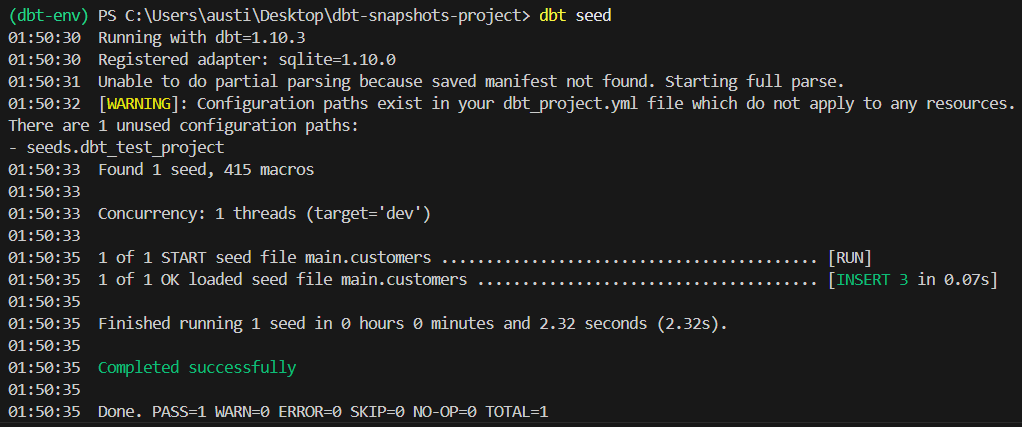
5. Configureer je databaseverbindingsinstellingen
In het profiles.yml-bestand, meestal te vinden in ~/.dbt/profiles.yml.
Dit staat er in mijn profiles-bestand:
austinchia:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_snapshots_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_snapshots_project.db
      extensions:
        - "C:/sqlean/crypto.dll"
Als je, net als ik, een SQLite-database gebruikt, moet je ook de SQLean-extensie installeren.
6. Laad je data in de dbt-stagingmodellen:
Maak een nieuwe map genaamd models. Maak daarin een bestand genaamd stg_customers.sql.
Plak de volgende code in het bestand:
SELECT
  *
FROM {{ ref('customers') }}
7. Bouw stagingmodellen met het volgende dbt-commando.
dbt run --select stg_customersDit zou de output van het commando moeten zijn:
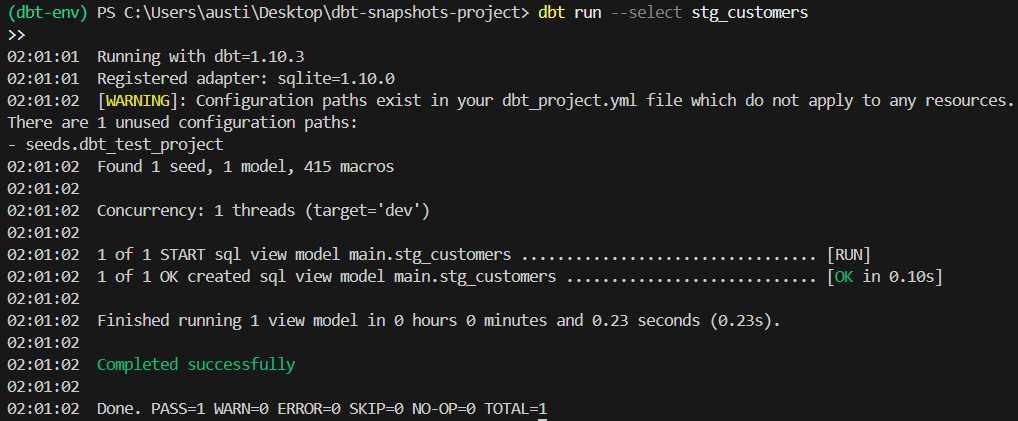
Voor dit voorbeeld kun je de volgende code gebruiken om een snapshot met de timestamp-strategie uit te voeren.
{% snapshot customers_snapshot %}

{{
  config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='timestamp',
    updated_at='updated_at'
  )
}}

select * from {{ ref('customers') }}

{% endsnapshot %}Voer uit:
dbt snapshotMet dit commando maakt dbt de snapshottabel als die nog niet bestaat. Het voegt ook nieuwe rijen in voor gedetecteerde wijzigingen.
Dit zou de output van het commando moeten zijn:
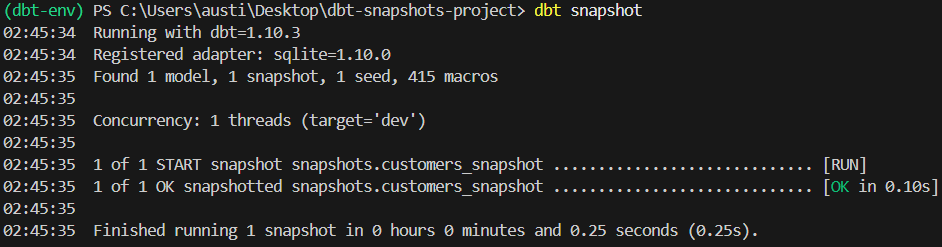
Nu je je snapshot hebt uitgevoerd, zou er een nieuw snapshot.db-bestand in je projectmap moeten zijn aangemaakt.
Ik heb dit geopend in VSCode om te bekijken hoe dit bestand eruitziet:
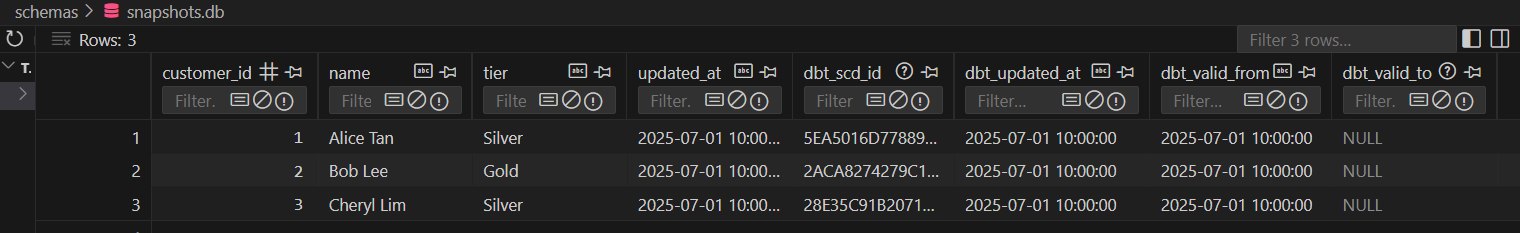
Zoals je ziet bevat het extra kolommen zoals dbt_updated_at enzovoort. Deze zijn cruciaal om te bepalen of er wijzigingen in de data zijn aangebracht en wanneer die zijn gedaan.
Voor meer praktische gidsen over dbt, bekijk onze gids over de semantische laag met dbt.
Snapshots stellen teams in staat een volledige audittrail van wijzigingen in elk attribuut binnen een tabel in de tijd vast te leggen, wat ze krachtig maakt voor compliance, debugging en analytics.
customers met relevante velden. Dit omvat klant-ID, naam, e-mail en een updated_at-timestamp om vast te leggen wanneer wijzigingen plaatsvinden.CREATE TABLE customers (
customer_id INTEGER PRIMARY KEY,
name VARCHAR(100),
email VARCHAR(100),
updated_at TIMESTAMP
);Gebruik de volgende code om data in de tabel te inserten. Deze data wordt gebruikt als de originele data vóór de wijziging.
INSERT INTO customers VALUES
(1, 'Alice Tan', 'alice@example.com', '2025-07-01 10:00:00'),
(2, 'Bob Lee', 'bob.lee@example.com', '2025-07-01 10:00:00');{% snapshot customers_email_snapshot %}
{%
set config(
target_schema='snapshots',
unique_key='customer_id',
strategy='check',
check_cols=['email'],
invalidate_hard_deletes=True
)
%}
SELECT * FROM {{ source('customers') }}
{% endsnapshot %}dbt snapshot uit om de beginsituatie vast te leggen.dbt snapshotVervolgens werken we onze oorspronkelijke tabel bij door de gegevens van één klant aan te passen om een gegevenswijziging te simuleren.
UPDATE customers
SET email = 'alice.tan@example.com', updated_at = '2025-07-02 09:00:00'
WHERE customer_id = 1;dbt snapshot opnieuw uit om de wijziging vast te leggen.dbt snapshotOm de verschillen en wijzigingen in de data te bekijken, moet je de snapshottabel bevragen. De tabel zou beide versies van het e-mailadres moeten tonen met hun respectieve geldigheidsperiodes:
SELECT customer_id, email, dbt_valid_from, dbt_valid_to
FROM snapshots.customers_email_snapshot
ORDER BY customer_id, dbt_valid_from;
Dit proces zorgt ervoor dat je een volledige wijzigingsgeschiedenis van e-mailupdates bewaart, cruciaal voor AVG-audits, contactgeschiedenis of klantenservice-analytics.
Effectief configuratiebeheer stelt teams in staat snapshotimplementaties naadloos over projecten en omgevingen op te schalen.
dbt_project.yml om standaard snapshotconfiguraties in te stellen, zoals doelschema of materializations, die voor alle snapshots gelden.Standaard maakt dbt de velden dbt_valid_from en dbt_valid_to. Je kunt deze hernoemen met de configuratieopties valid_from en valid_to als je team andere naamgevingsconventies vereist voor duidelijkheid in BI- of datagovernance-tools.
Migraties kunnen tot discrepanties leiden als ze niet goed worden afgehandeld. Let op het volgende bij het migreren van je snapshotconfiguraties:
Gegevenswijzigingen kunnen in samenhang met dbt-snapshots worden gevolgd.
Bijvoorbeeld:
Het implementeren van dbt-snapshots in productie vereist doordacht ontwerp om performance, onderhoudbaarheid en zakelijke waarde te waarborgen.
Volg bij voorkeur het volgende:
In productie wil je je data optimaliseren zodat wijzigingen efficiënt kunnen worden gevolgd zonder je product te beïnvloeden.
Hier zijn een paar tips:
unique_key en geldigheidskolommen voor snellere queries.Een niet-unieke unique_key leidt tot onjuiste versiebeheer van rijen. Test de uniciteitslogica altijd vóór deployment.
Snapshotbloat kan ook ontstaan wanneer onnodige historische wijzigingen worden opgeslagen (bijv. kolommen met frequente timestampupdates), wat de opslagkosten snel kan laten groeien.
Het gebruik van snapshots in dbt kan gepaard gaan met specifieke technische uitdagingen:
Probleem: Dubbele rijen in de snapshot door slecht gedefinieerde unieke sleutels.
Oplossing:
Probleem: Trage queries bij het analyseren van historische data.
Oplossing:
dbt_valid_from of datumbereiken om het gescande datavolume te verminderen.Veelvoorkomende issues zijn:
SELECT-statements breken.Oplossingen:
dbt debug om verbinding en configuratie te valideren.dbt-snapshots geven analyseteams de mogelijkheid om robuuste historische datasets op te bouwen met minimale engineering-overhead, wat compliance-analytics mogelijk maakt. Wil je meer leren over dbt, bekijk dan onze cursus Introductie tot dbt. Voor artikelen en meer gidsen, bekijk onze Introductie tot het dbt-utils-pakket en dbt-tutorial.
Topcursussen op DataCamp
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

