
Last chance! 50% off DataCamp Premium
Sale ends in
dbt (data build tool) आधुनिक डेटा स्टैक में डेटा को ट्रांसफॉर्म, टेस्ट और डॉक्युमेंट करने के लिए डेटा विश्लेषकों और इंजीनियरों द्वारा इस्तेमाल किया जाने वाला एक सशक्त टूल है.
जहाँ यह अपनी मॉडलिंग क्षमताओं के लिए व्यापक रूप से जाना जाता है, वहीं एक और महत्वपूर्ण फीचर dbt स्नैपशॉट है, जो आपके डेटा वेयरहाउस में धीरे-धीरे बदलने वाले डाइमेंशन्स (SCD) को कैप्चर करने में सक्षम बनाता है।
यह ट्यूटोरियल dbt स्नैपशॉट्स, उनके उपयोग के मामले और उनका इम्प्लीमेंटेशन विस्तार से समझाएगा। मैं:
dbt के बारे में और जानने के लिए, हमारा गाइड What is dbt? A Hands-On Introduction for Data Engineers और हमारा Introduction to dbt कोर्स ज़रूर देखें।
dbt स्नैपशॉट समय के साथ रिकॉर्ड्स में होने वाले बदलावों को ट्रैक करने की एक व्यवस्था है, खासकर उन तालिकाओं के लिए जहाँ डिफ़ॉल्ट रूप से ऐतिहासिक बदलाव सुरक्षित नहीं रहते। स्नैपशॉट्स मुख्य रूप से Slowly Changing Dimensions (SCD) टाइप 2 को लागू करने में उपयोग होते हैं। जब ट्रैक की गई कॉलम्स बदलती हैं, तो ये पंक्तियों के वर्शन सहेजते हैं।
उपयोग के मामले शामिल हैं:
dbt स्नैपशॉट्स मूल्यवान हैं क्योंकि ये समय के साथ डेटा बदलावों का रिकॉर्ड रखते हैं, जिससे ऐतिहासिक विश्लेषण और अनुपालन रिपोर्टिंग संभव होती है।
Snapshots उपयोग करने से आपको ये लाभ मिलेंगे:
स्नैपशॉट्स कुछ खास परिस्थितियों में उपयोगी हो सकते हैं, जैसे:
स्नैपशॉट्स dbt के ईकोसिस्टम में सुचारू रूप से इंटीग्रेट होते हैं, इसकी कॉन्फ़िगरेशन और रन मैनेजमेंट का लाभ उठाकर ऐतिहासिक टेबल्स को कुशलतापूर्वक बनाते हैं।
उदाहरण के तौर पर डेटा में उपयोग होने वाले मॉडलों के प्रकार देखते हैं।
डेटा के लिए दो प्रकार के मॉडल उपयोग होते हैं:
इन दोनों मॉडलों का उद्देश्य, स्टोरेज विधि और उपयोग अलग-अलग होते हैं।
यहाँ इनके अंतर का सारांश है:
|
फ़ीचर |
स्टैंडर्ड मॉडल्स |
स्नैपशॉट्स |
|
उद्देश्य |
वर्तमान स्थिति के ट्रांसफॉर्मेशन |
ऐतिहासिक ट्रैकिंग |
|
स्टोरेज |
वर्तमान डेटा वाली टेबल या व्यू |
केवल-एपेंड हिस्ट्री टेबल |
|
सर्वोत्तम उपयोग |
फैक्ट/डायमेंशनल मॉडल्स |
धीरे-धीरे बदलने वाले डाइमेंशन्स |
स्नैपशॉट्स आम तौर पर एक संरचित वर्कफ़्लो का पालन करते हैं जो सुनिश्चित करता है कि सभी बदलाव व्यवस्थित रूप से कैप्चर हों, जिसमें ये चरण शामिल हैं:
dbt snapshot चलाकर मौजूदा डेटा की तुलना पूर्व स्नैपशॉट्स से करें।लेकिन dbt में बदलाव ट्रैक कैसे होते हैं?
सभी बदलाव आउटपुट स्नैपशॉट टेबल में रिकॉर्ड होते हैं।
यदि कोई बदलाव पता चलता है, तो dbt पिछली वर्शन के लिए dbt_valid_to फ़ील्ड को वर्तमान टाइमस्टैम्प पर अपडेट करता है और dbt_valid_from फ़ील्ड को वर्तमान टाइमस्टैम्प के साथ नई पंक्ति इंसर्ट करता है।
बदलावों का पता लगाने के लिए स्नैपशॉट्स दो प्राथमिक रणनीतियाँ उपयोग करते हैं।
updated_at टाइमस्टैम्प्स हों।|
स्ट्रैटेजी |
डिटेक्शन विधि |
सर्वोत्तम उपयोग |
|
टाइमस्टैम्प |
अपडेटेड टाइमस्टैम्प कॉलम |
विश्वसनीय लास्ट-मॉडिफाइड टाइमस्टैम्प वाली तालिकाएँ |
|
चेक |
कॉलम्स की सीधे तुलना |
टाइमस्टैम्प कॉलम्स के बिना तालिकाएँ |
डिलीट जैसे डेटा बदलाव भी ट्रैक किए जा सकते हैं, लेकिन डिफ़ॉल्ट रूप से नहीं। हालाँकि, ऐसी हार्ड डिलीट्स की निगरानी के लिए इसे बदला जा सकता है।
invalidate_hard_deletes=True सेट करें ताकि dbt डिलीटेड पंक्तियों को dbt_valid_to मान के साथ चिह्नित करे और उनकी अंतिम स्थिति संरक्षित रहे।यहाँ हार्ड डिलीट्स का ध्यान रखते हुए चेक स्ट्रैटेजी को लागू करने का उदाहरण है:
{%
  snapshot customers_snapshot %}

{%
  set config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='check',
    check_cols=['tier'],
    invalidate_hard_deletes=True
  )
%}

SELECT * FROM {{ source('customers') }}

{% endsnapshot %}अब जब हमें पता है कि dbt स्नैपशॉट्स कैसे काम करते हैं, तो देखते हैं कि इन्हें कैसे लागू करें
स्नैपशॉट्स का अभ्यास करने के लिए, हम एक सैंपल customers टेबल बनाएँगे जो वास्तविक-जीवन सदस्यता सिस्टम की नकल करती है। यह हमें आम स्नैपशॉट स्ट्रैटेजीज़ को टेस्ट करने के लिए ठोस डेटा देता है।
import csv
from datetime import datetime

# Define the data
customers_data = [
    ["customer_id", "name", "tier", "updated_at"],  # header row
    [1, "Alice Tan", "Silver", "2025-07-01 10:00:00"],
    [2, "Bob Lee", "Gold", "2025-07-01 10:00:00"],
    [3, "Cheryl Lim", "Silver", "2025-07-01 10:00:00"]
]

# Write data to customers.csv
with open("customers.csv", mode="w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
writer.writerows(customers_data)स्नैपशॉट्स लागू करने से पहले, अपना dbt प्रोजेक्ट सही ढंग से सेट करना आवश्यक है। इससे आपका वातावरण मॉडल्स, स्नैपशॉट्स, टेस्ट्स और डॉक्युमेंटेशन को संरचित और स्केलेबल तरीके से मैनेज करने के लिए कॉन्फ़िगर होता है।
pip install dbtअपने वातावरण के आधार पर dbt-postgres को अपने वेयरहाउस एडेप्टर, जैसे dbt-snowflake या dbt-bigquery से बदलें।
1. अपनी इच्छित प्रोजेक्ट्स डायरेक्टरी पर जाएँ।
यही वह स्थान है जहाँ आप अपने एनालिटिक्स या ELT प्रोजेक्ट्स संग्रहीत करेंगे। इस मामले में, हम सभी संबंधित फ़ाइलें इस dbt प्रोजेक्ट फ़ोल्डर में रखेंगे।
cd ~/dbt-snapshot-project2. एक नया dbt प्रोजेक्ट इनिशियलाइज़ करें।
dbt_project.yml नाम की एक कॉन्फ़िग फ़ाइल बनाएँ:
अपने प्रोजेक्ट फ़ाइल में निम्नलिखित पेस्ट करें:
name: dbt_snapshots_project
version: '1.0'
profile: austinchia

seeds:
  dbt_snapshots_project:
    +quote_columns: false
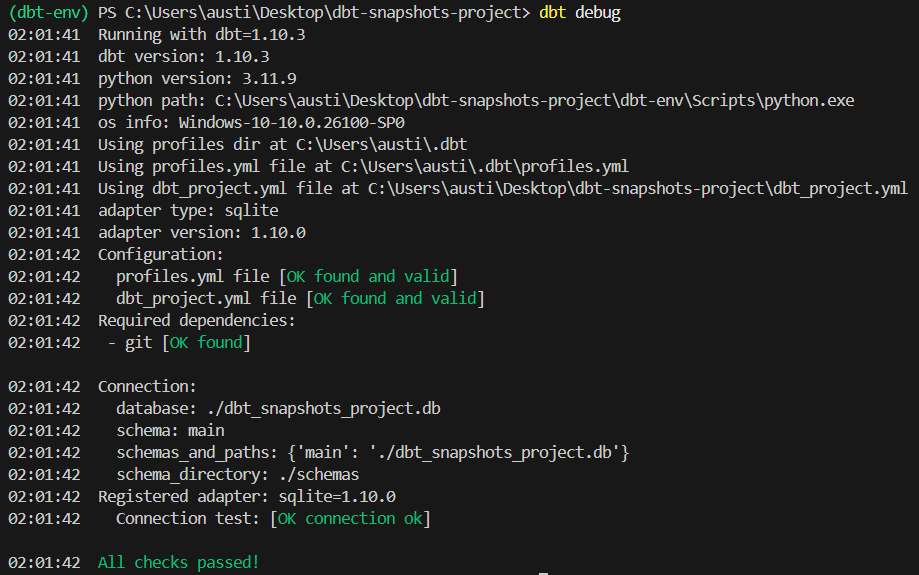
3. अपना कनेक्शन टेस्ट करें।
dbt debugकमांड का आउटपुट ऐसा होना चाहिए:
4. सीड्स को लोकल डेटाबेस में लोड करें।
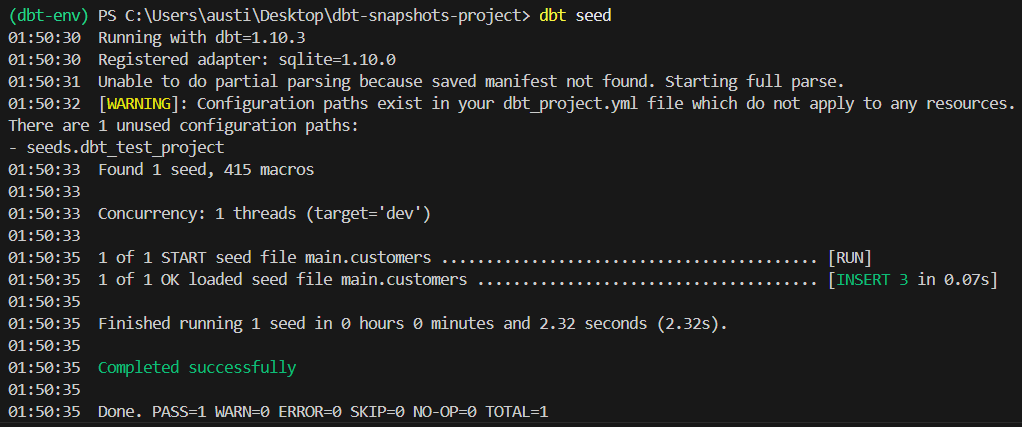
निम्नलिखित कमांड चलाएँ:
dbt seedकमांड का आउटपुट ऐसा होना चाहिए:
5. अपने डेटाबेस कनेक्शन सेटिंग्स कॉन्फ़िगर करें
profiles.yml फ़ाइल में, जो आमतौर पर ~/.dbt/profiles.yml में होती है।
मेरी प्रोफ़ाइल फ़ाइल में यह है:
austinchia:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_snapshots_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_snapshots_project.db
      extensions:
        - "C:/sqlean/crypto.dll"
यदि आप मेरी तरह SQLite डेटाबेस का उपयोग कर रहे हैं, तो आपको SQLean एक्सटेंशन भी इंस्टॉल करनी होगी।
6. अपने डेटा को dbt स्टेजिंग मॉडल्स में इन्गेस्ट करें:
models नाम का एक नया फ़ोल्डर बनाएँ। उस फ़ोल्डर में stg_customers.sql नाम की फ़ाइल बनाएँ।
फ़ाइल में निम्नलिखित कोड पेस्ट करें:
SELECT
  *
FROM {{ ref('customers') }}
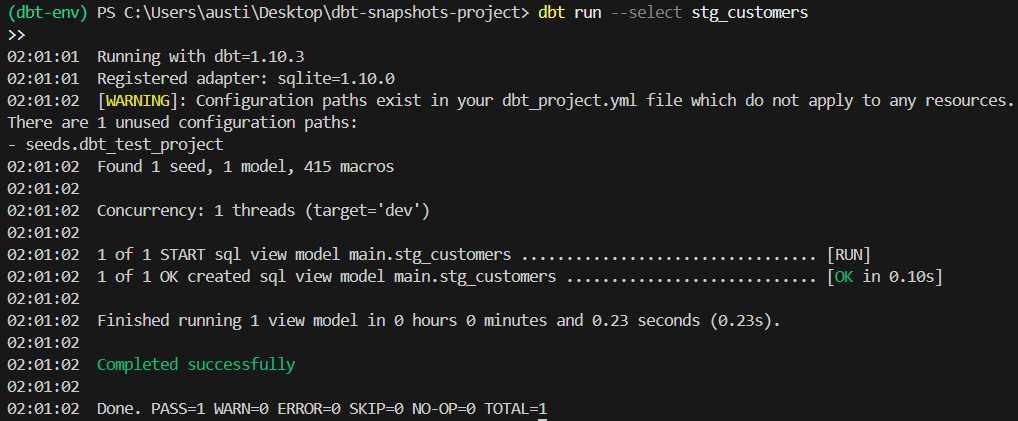
7. dbt में निम्न कमांड का उपयोग करके स्टेजिंग मॉडल्स बनाएं।
dbt run --select stg_customersकमांड का आउटपुट ऐसा होना चाहिए:
इस उदाहरण के लिए, आप टाइमस्टैम्प स्ट्रैटेजी स्नैपशॉट करने हेतु निम्न कोड का उपयोग कर सकते हैं।
{% snapshot customers_snapshot %}

{{
  config(
    target_schema='snapshots',
    unique_key='customer_id',
    strategy='timestamp',
    updated_at='updated_at'
  )
}}

select * from {{ ref('customers') }}

{% endsnapshot %}निष्पादित करें:
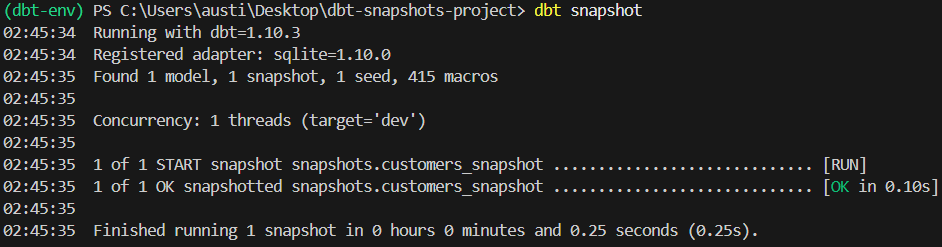
dbt snapshotइस कमांड में, यदि स्नैपशॉट टेबल मौजूद नहीं है तो dbt उसे बनाता है। यह पहचाने गए बदलावों के लिए नई पंक्तियाँ भी इंसर्ट करता है।
कमांड का आउटपुट ऐसा होना चाहिए:
अब जब आपने अपना स्नैपशॉट चला लिया है, तो आपके प्रोजेक्ट फ़ाइल डायरेक्टरी में एक नया snapshot.db फ़ाइल बन जानी चाहिए।
मैंने इसे VSCode में खोलकर देखा कि यह फ़ाइल कैसी दिखती है:
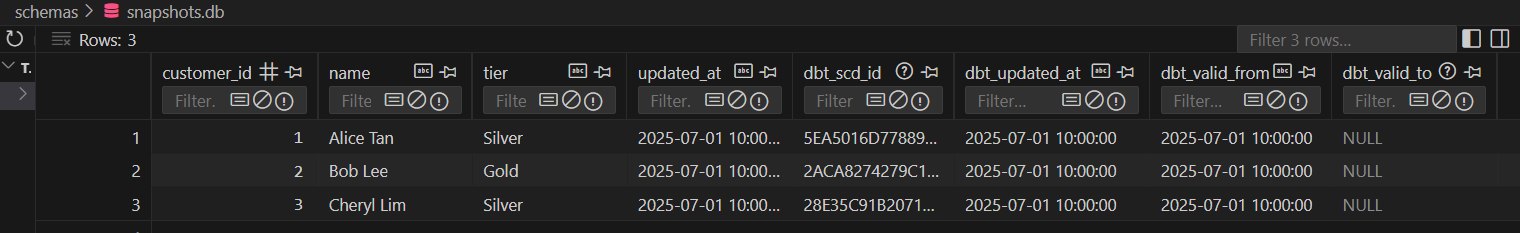
जैसा कि आप देख सकते हैं, इसमें dbt_updated_at जैसी अतिरिक्त कॉलम्स हैं। ये यह निर्धारित करने में महत्वपूर्ण हैं कि डेटा में बदलाव हुआ था या नहीं और कब हुआ था।
dbt पर और हैंड्स-ऑन गाइड्स के लिए, हमारा Semantic Layer with dbt गाइड देखें।
स्नैपशॉट्स टीमों को समय के साथ किसी भी टेबल के किसी भी एट्रिब्यूट में होने वाले बदलावों का पूरा ऑडिट ट्रेल कैप्चर करने देते हैं, जिससे वे अनुपालन, डीबगिंग और एनालिटिक्स के लिए शक्तिशाली बनते हैं।
customers टेबल बनाएँ। इसमें ग्राहक ID, नाम, ईमेल और बदलाव होने पर ट्रैक करने के लिए updated_at टाइमस्टैम्प शामिल है।CREATE TABLE customers (
customer_id INTEGER PRIMARY KEY,
name VARCHAR(100),
email VARCHAR(100),
updated_at TIMESTAMP
);टेबल में डेटा इंसर्ट करने के लिए निम्न कोड का उपयोग करें। यह डेटा बदलाव से पहले का ओरिजिनल डेटा होगा।
INSERT INTO customers VALUES
(1, 'Alice Tan', 'alice@example.com', '2025-07-01 10:00:00'),
(2, 'Bob Lee', 'bob.lee@example.com', '2025-07-01 10:00:00');{% snapshot customers_email_snapshot %}
{%
set config(
target_schema='snapshots',
unique_key='customer_id',
strategy='check',
check_cols=['email'],
invalidate_hard_deletes=True
)
%}
SELECT * FROM {{ source('customers') }}
{% endsnapshot %}dbt snapshot चलाएँ।dbt snapshotअगले चरण में, हम एक ग्राहक की जानकारी संशोधित करके अपनी मूल टेबल को अपडेट करेंगे ताकि डेटा बदलाव का सिमुलेशन हो सके।
UPDATE customers
SET email = 'alice.tan@example.com', updated_at = '2025-07-02 09:00:00'
WHERE customer_id = 1;dbt snapshot चलाएँ।dbt snapshotबदलावों और अंतर को देखने के लिए आपको स्नैपशॉट टेबल को क्वेरी करना होगा। टेबल में ईमेल पते के दोनों वर्शन्स उनकी संबंधित वैलिडिटी विंडोज़ के साथ दिखाई देने चाहिए:
SELECT customer_id, email, dbt_valid_from, dbt_valid_to
FROM snapshots.customers_email_snapshot
ORDER BY customer_id, dbt_valid_from;
यह प्रक्रिया सुनिश्चित करती है कि आपके पास ईमेल अपडेट्स का पूरा बदलाव इतिहास सुरक्षित रहे, जो GDPR ऑडिट, संपर्क इतिहास ट्रैकिंग या कस्टमर सपोर्ट एनालिटिक्स के लिए महत्वपूर्ण है।
प्रभावी कॉन्फ़िगरेशन मैनेजमेंट टीमों को प्रोजेक्ट्स और एनवायरनमेंट्स में स्नैपशॉट इम्प्लीमेंटेशन को सहजता से स्केल करने देता है।
dbt_project.yml का उपयोग करें।डिफ़ॉल्ट रूप से, dbt dbt_valid_from और dbt_valid_to फ़ील्ड्स बनाता है। यदि आपकी टीम के मानकों के अनुसार BI या डेटा गवर्नेंस टूल्स में स्पष्टता के लिए अलग नामकरण चाहिए, तो आप valid_from और valid_to कॉन्फ़िग विकल्पों का उपयोग करके इन्हें रीनेम कर सकते हैं।
माइग्रेशन यदि ठीक से नहीं किया जाए तो कुछ विसंगतियाँ पैदा कर सकता है। जब आप अपने स्नैपशॉट कॉन्फ़िगरेशन माइग्रेट कर रहे हों, तो इन बातों पर ध्यान दें:
डेटा बदलावों को dbt स्नैपशॉट्स के साथ मिलकर ट्रैक किया जा सकता है.
उदाहरण के लिए:
प्रोडक्शन में dbt स्नैपशॉट्स लागू करने के लिए ऐसा डिज़ाइन चाहिए जो परफॉर्मेंस, मेन्टेनेबिलिटी और व्यावसायिक मूल्य सुनिश्चित करे।
इनका पालन करना बेहतर है:
प्रोडक्शन में, आप अपने डेटा को ऑप्टिमाइज़ करना चाहेंगे ताकि बदलाव कुशलतापूर्वक ट्रैक हों और आपके प्रोडक्ट पर असर न पड़े।
कुछ टिप्स:
unique_key और वैलिडिटी कॉलम्स पर इंडेक्स जोड़ें।नॉन-यूनिक unique_key का उपयोग गलत रो वर्शनिंग की ओर ले जाता है। हमेशा डिप्लॉयमेंट से पहले यूनिकनेस लॉजिक का टेस्ट करें.
स्नैपशॉट ब्लोट भी हो सकता है जब अनावश्यक ऐतिहासिक बदलाव (जैसे, बार-बार टाइमस्टैम्प अपडेट होने वाले कॉलम्स) स्टोर किए जाते हैं, जिससे स्टोरेज लागत तेज़ी से बढ़ सकती है।
dbt में स्नैपशॉट्स का उपयोग कुछ विशिष्ट तकनीकी चुनौतियों के साथ आ सकता है:
समस्या: गलत परिभाषित यूनिक कीज़ के कारण स्नैपशॉट में डुप्लीकेट पंक्तियाँ।
समाधान:
समस्या: ऐतिहासिक डेटा का विश्लेषण करते समय धीमी क्वेरियाँ।
समाधान:
dbt_valid_from या डेट रेंज से क्वेरी फ़िल्टर करें।आम समस्याएँ शामिल हैं:
SELECT स्टेटमेंट्स को तोड़ते हैं।समाधान:
dbt debug का उपयोग करें।dbt स्नैपशॉट्स एनालिटिक्स टीमों को न्यूनतम इंजीनियरिंग ओवरहेड के साथ मजबूत ऐतिहासिक डेटासेट बनाने में सक्षम बनाते हैं, जिससे अनुपालन एनालिटिक्स संभव होता है। यदि आप dbt के बारे में और सीखना चाहते हैं, तो हमारा Introduction to dbt कोर्स देखें। पढ़ने और और गाइड्स के लिए हमारा Introduction to The dbt-utils Package और dbt Tutorial देखें।
टॉप DataCamp कोर्सेज़
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
